截止目前,YOLO26最新创新改进系列已更新110+种,排列组合后可达到上万种创新模型!极大节省科研时间!!! 仍在持续更新中...
畅享持续更新且可大幅度提升文章档次的纯干货工具!
YOLO26 改进:融合 DCS 的 R_PAMMD 到 ROI/Neck 特征,构建对象级原型分布对齐检测器!
前言:为什么这次改进值得写
很多 YOLO 改进文章最大的问题,不是模块不够新,而是"动机链条"不够硬:只说明加了一个模块,却没有讲清楚原始 YOLO 的痛点在哪里、这个模块到底优化了哪一层表征、为什么这个优化能够自然地写进论文创新点。
本文围绕 NeurIPS 2025 方法 DCS: Diffusion-Classifier Synergy: Reward-Aligned Learning via Mutual Boosting Loop for FSCIL 中的 R_PAMMD 思想,给出一种适合 YOLO26 的检测任务融合方案:将原本用于扩散生成奖励的 Prototype-Anchored MMD 思想,迁移为 ROI-Neck 级别的对象原型分布约束。
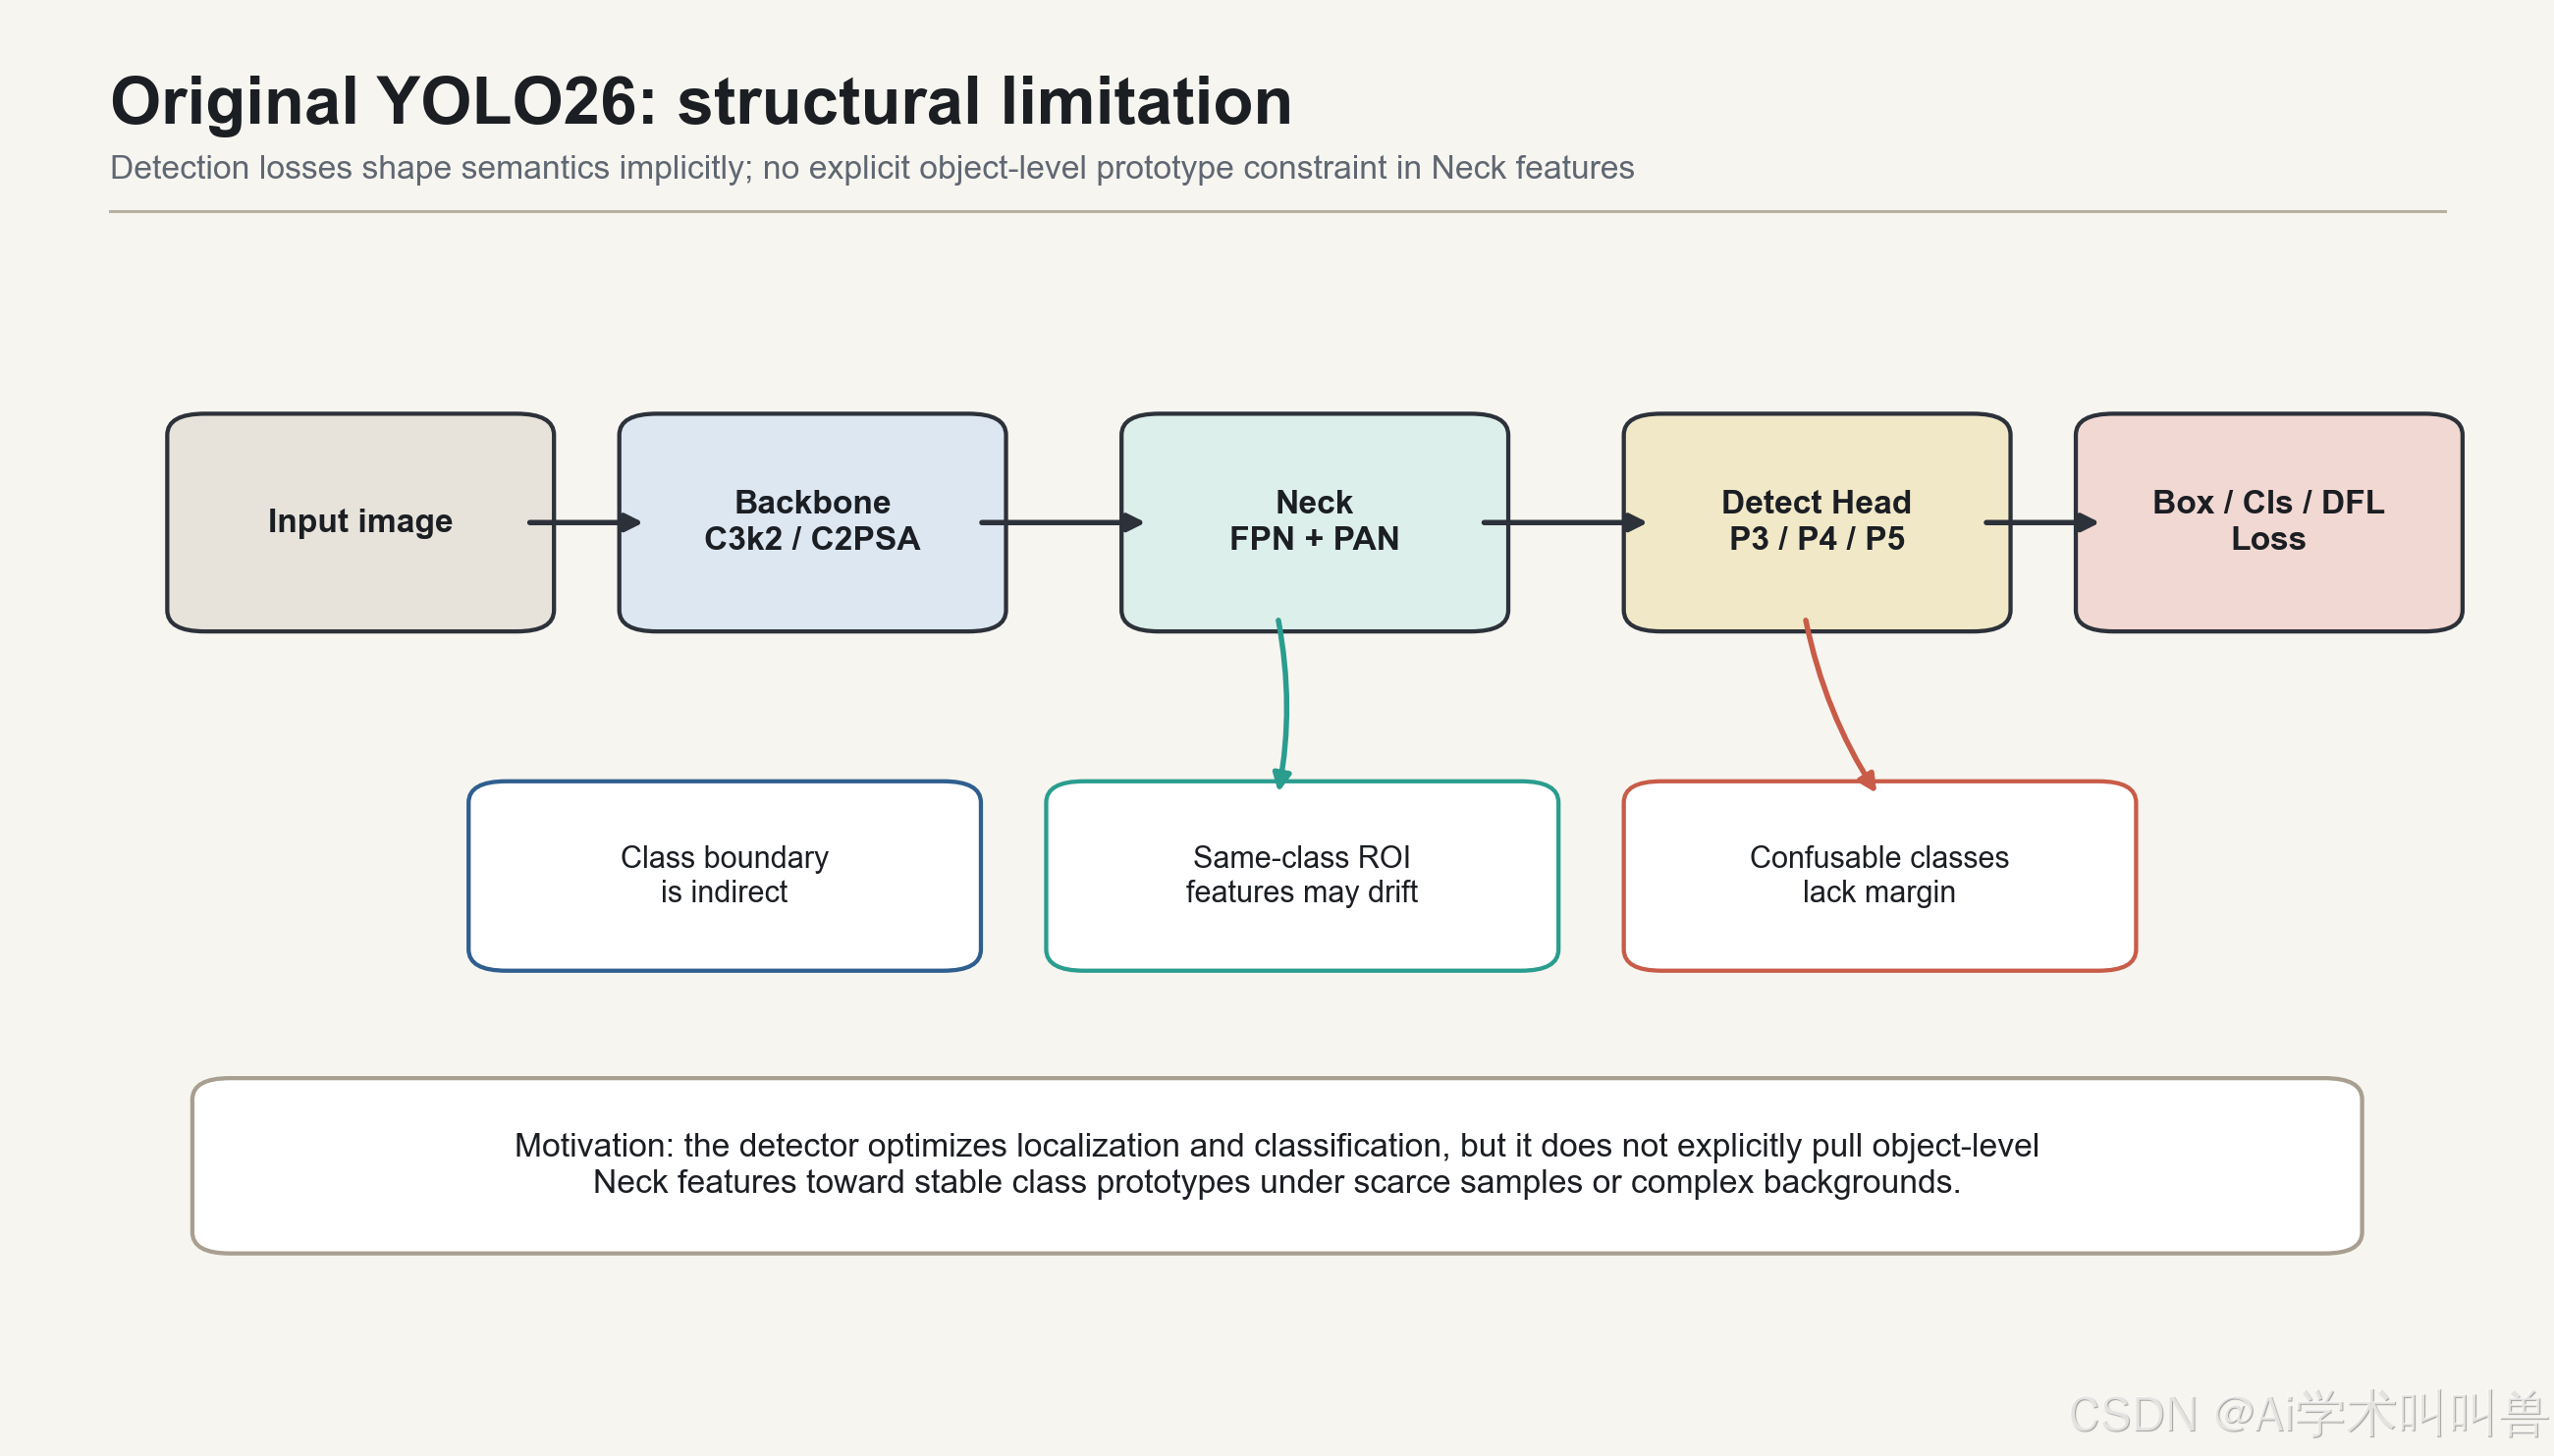
原始 YOLO26 的核心检测路径依然非常强:Backbone 负责提取层级特征,Neck 进行多尺度融合,Detect Head 输出分类、定位和分布回归。然而,在少样本、小类别间差异、复杂背景或类别相似度较高的场景中,原始 YOLO 仍存在一个容易被忽略的问题:
检测损失能够告诉模型"这个框是什么类",但不会显式要求同一类别的 ROI 特征在 Neck 空间中围绕稳定原型收敛。
换句话说,YOLO 的分类分支通常是端到端地学习类别边界,类别语义结构主要由 BCE/CE 类损失间接塑造。当同类目标的尺度、姿态、遮挡、背景差异较大时,Neck 特征可能出现类内分散;当不同类别外观相近时,类别原型之间也可能缺少足够间隔。这正是 R_PAMMD 融合的切入点。
融合后的方法并不改变 YOLO26 的推理结构,而是在训练阶段增加一个对象级语义正则分支:从 P4/P5 Neck 特征中根据 GT 框采样 ROI 特征,维护类别 EMA 原型,再用多核 MMD 约束同类 ROI 分布靠近类别原型,同时用原型间隔约束降低易混类别重叠。
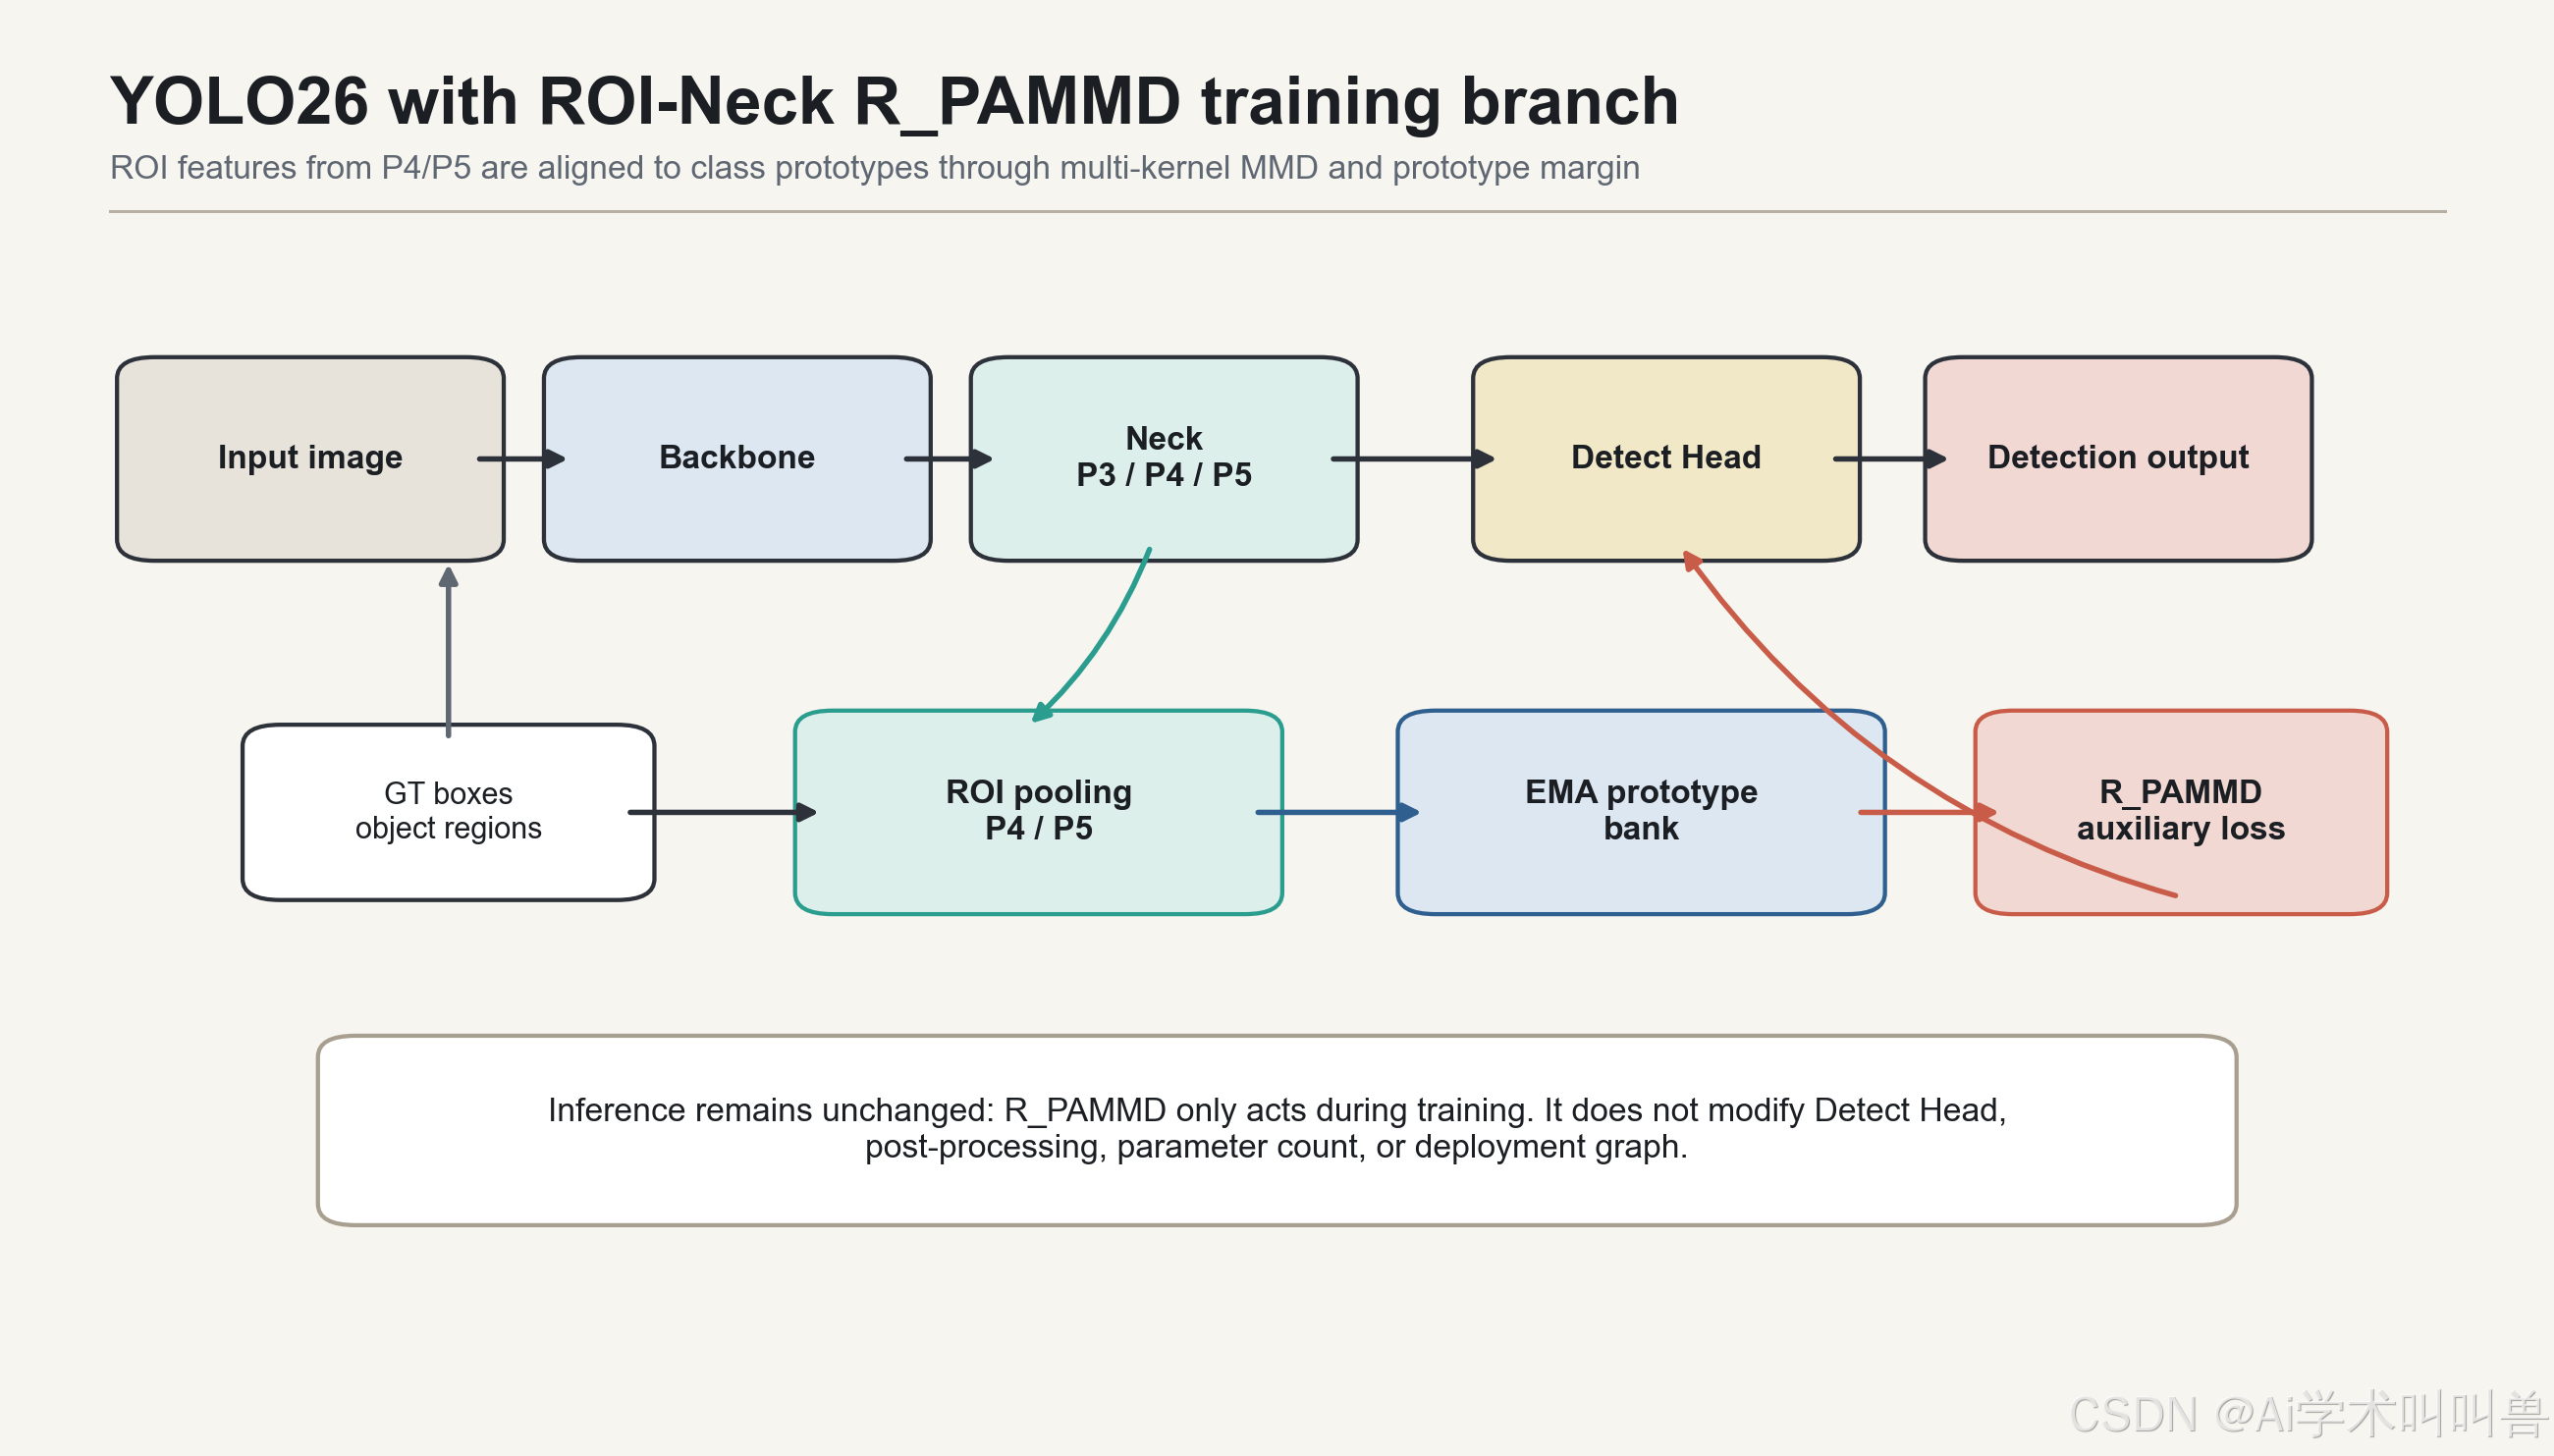
这类设计的写作价值在于:它不是简单"堆模块",而是从 检测器语义表征不足 出发,把 DCS 中的原型锚定分布对齐思想改造成适合目标检测的 对象级训练约束,能够形成完整的论文叙事:痛点明确、来源清晰、结构轻量、推理无额外负担。
1. 原文摘要精译与介绍总结
原文链接:
- NeurIPS 2025 论文主页:https://proceedings.neurips.cc/paper_files/paper/2025/hash/5cc053392052b3ee4c2b912f4da62ab5-Abstract-Conference.html
- 论文 PDF:https://proceedings.neurips.cc/paper_files/paper/2025/file/5cc053392052b3ee4c2b912f4da62ab5-Paper-Conference.pdf
1.1 摘要精译
DCS 面向 Few-Shot Class-Incremental Learning,也就是少样本类增量学习。该任务要求模型不断学习新类别,同时避免遗忘旧类别;难点来自稳定性与可塑性之间的矛盾,以及新类样本极少带来的泛化不足。
扩散模型可以生成额外图像来缓解数据不足,但如果直接用类别名称或普通提示词生成样本,容易出现语义偏移、样本多样性不足、生成结果对分类器没有实际帮助等问题。DCS 的核心思想是建立扩散模型与分类器之间的互增强闭环:分类器根据当前状态给出奖励信号,扩散模型据此生成更有价值的图像;这些图像再反过来提升分类器,使下一轮奖励更准确。
原文把奖励分为两个层面:特征层面通过 Prototype-Anchored MMD 和维度方差匹配保证语义一致性与多样性;logits 层面通过置信度重校准和跨会话混淆感知机制,引导生成更有探索价值、也更能改善类别区分边界的样本。
1.2 Introduction 部分提炼
原文 Introduction 的逻辑非常适合迁移到 YOLO 改进写作:
第一,FSCIL 的难点不是简单缺数据,而是模型面对新类时既要保持旧知识,又要快速吸收新概念。这个矛盾在目标检测中同样存在,只是表现为 同类实例特征不稳定、易混类别边界不清晰、少样本类别分类头难以形成可靠语义锚点。
第二,扩散模型生成样本不能只看"像不像",还要看是否真的能服务当前分类器。对应到 YOLO 中,特征正则也不能只看整图语义,而应该落到 检测对象 ROI 上,让模型关注"框内目标特征是否贴近类别原型"。
第三,DCS 中的 R_PAMMD 并不是普通的距离约束,它强调以类别原型为锚点进行分布级匹配。迁移到 YOLO 时,这一点可以自然转化为:在 Neck 的多尺度语义空间中,将每个目标框对应的 ROI 特征向类别原型对齐,从而增强类内紧致性和类间可分性。
2. 为什么要融合:创新切入点
2.1 原始 YOLO26 的结构性不足
框回归损失负责定位,分类损失负责类别判断,DFL 或等价分布回归项负责边界质量建模。这个范式足够简洁,也非常适合高效检测,但它有一个隐含假设:只要检测损失足够优化,Neck 特征自然会形成良好的类别结构。
这个假设在常规大样本场景中通常成立,但在以下场景中会变弱:
- 同一类别内部姿态、尺度、遮挡变化大,ROI 特征容易分散;
- 不同类别视觉相似,分类边界容易被局部纹理或背景干扰;
- 样本数量有限,分类头无法从足够多实例中学习稳定类中心;
- Neck 特征承担多尺度融合任务,但没有显式的对象级语义分布约束。
因此,本次改进不是替换 YOLO 的检测头,也不是引入复杂新 Backbone,而是在原检测损失之外增加一个训练期约束:让 YOLO26 的 Neck 特征具备更清晰的类别原型结构。
2.2 从 DCS 到 YOLO 的迁移逻辑
DCS 中的 R_PAMMD 原本服务于扩散生成:它根据分类器特征空间中的类别原型,判断生成图像是否既符合目标类别语义,又具备合理的分布差异。
迁移到 YOLO 后,任务对象发生变化:
| 维度 | DCS 原始场景 | YOLO26 融合场景 |
|---|---|---|
| 任务 | FSCIL 图像分类 | 目标检测 |
| 对齐对象 | 生成图像的全局特征 | GT 框对应的 ROI-Neck 特征 |
| 原型来源 | 分类器类别特征 | YOLO Neck 中的类别 ROI 原型 |
| 约束方式 | 奖励引导扩散采样 | 辅助损失反向优化 Neck |
| 目标 | 生成更有价值的图像 | 学到更紧致、更可分的检测特征 |
这就是创新切入点:
将 DCS 的 Prototype-Anchored MMD 从"生成奖励"转化为"检测训练正则",并把原本的图像级特征奖励改造成目标检测更需要的 ROI 级 Neck 特征分布对齐。
3. 改进模块核心结构与公式
3.1 原始 YOLO26:隐式语义边界
原始 YOLO26 的 Neck 输出多尺度特征:
F = { F 3 , F 4 , F 5 } F = \{F_3, F_4, F_5\} F={F3,F4,F5}
检测头基于这些特征预测:
B ^ , C ^ , D ^ = H e a d ( F 3 , F 4 , F 5 ) \hat{B}, \hat{C}, \hat{D} = Head(F_3, F_4, F_5) B^,C^,D^=Head(F3,F4,F5)
该方法的核心问题在于:分类损失只约束最终 logits,而不是直接约束 Neck 中每个目标实例的语义分布。因此,同类别目标的 ROI 特征可能分布松散,不同类别原型也可能在高维空间中距离不足。
3.2 融合后:ROI-Neck R_PAMMD
融合后增加训练期分支:
- 根据标注框从 Neck 特征图中截取 ROI;
- 对 ROI 特征做全局平均池化;
- 得到对象级特征向量;
- 维护每个类别的 EMA 原型;
- 用多核 MMD 进行同类分布对齐;
- 用原型间隔项拉开易混类别。
核心结构如下:
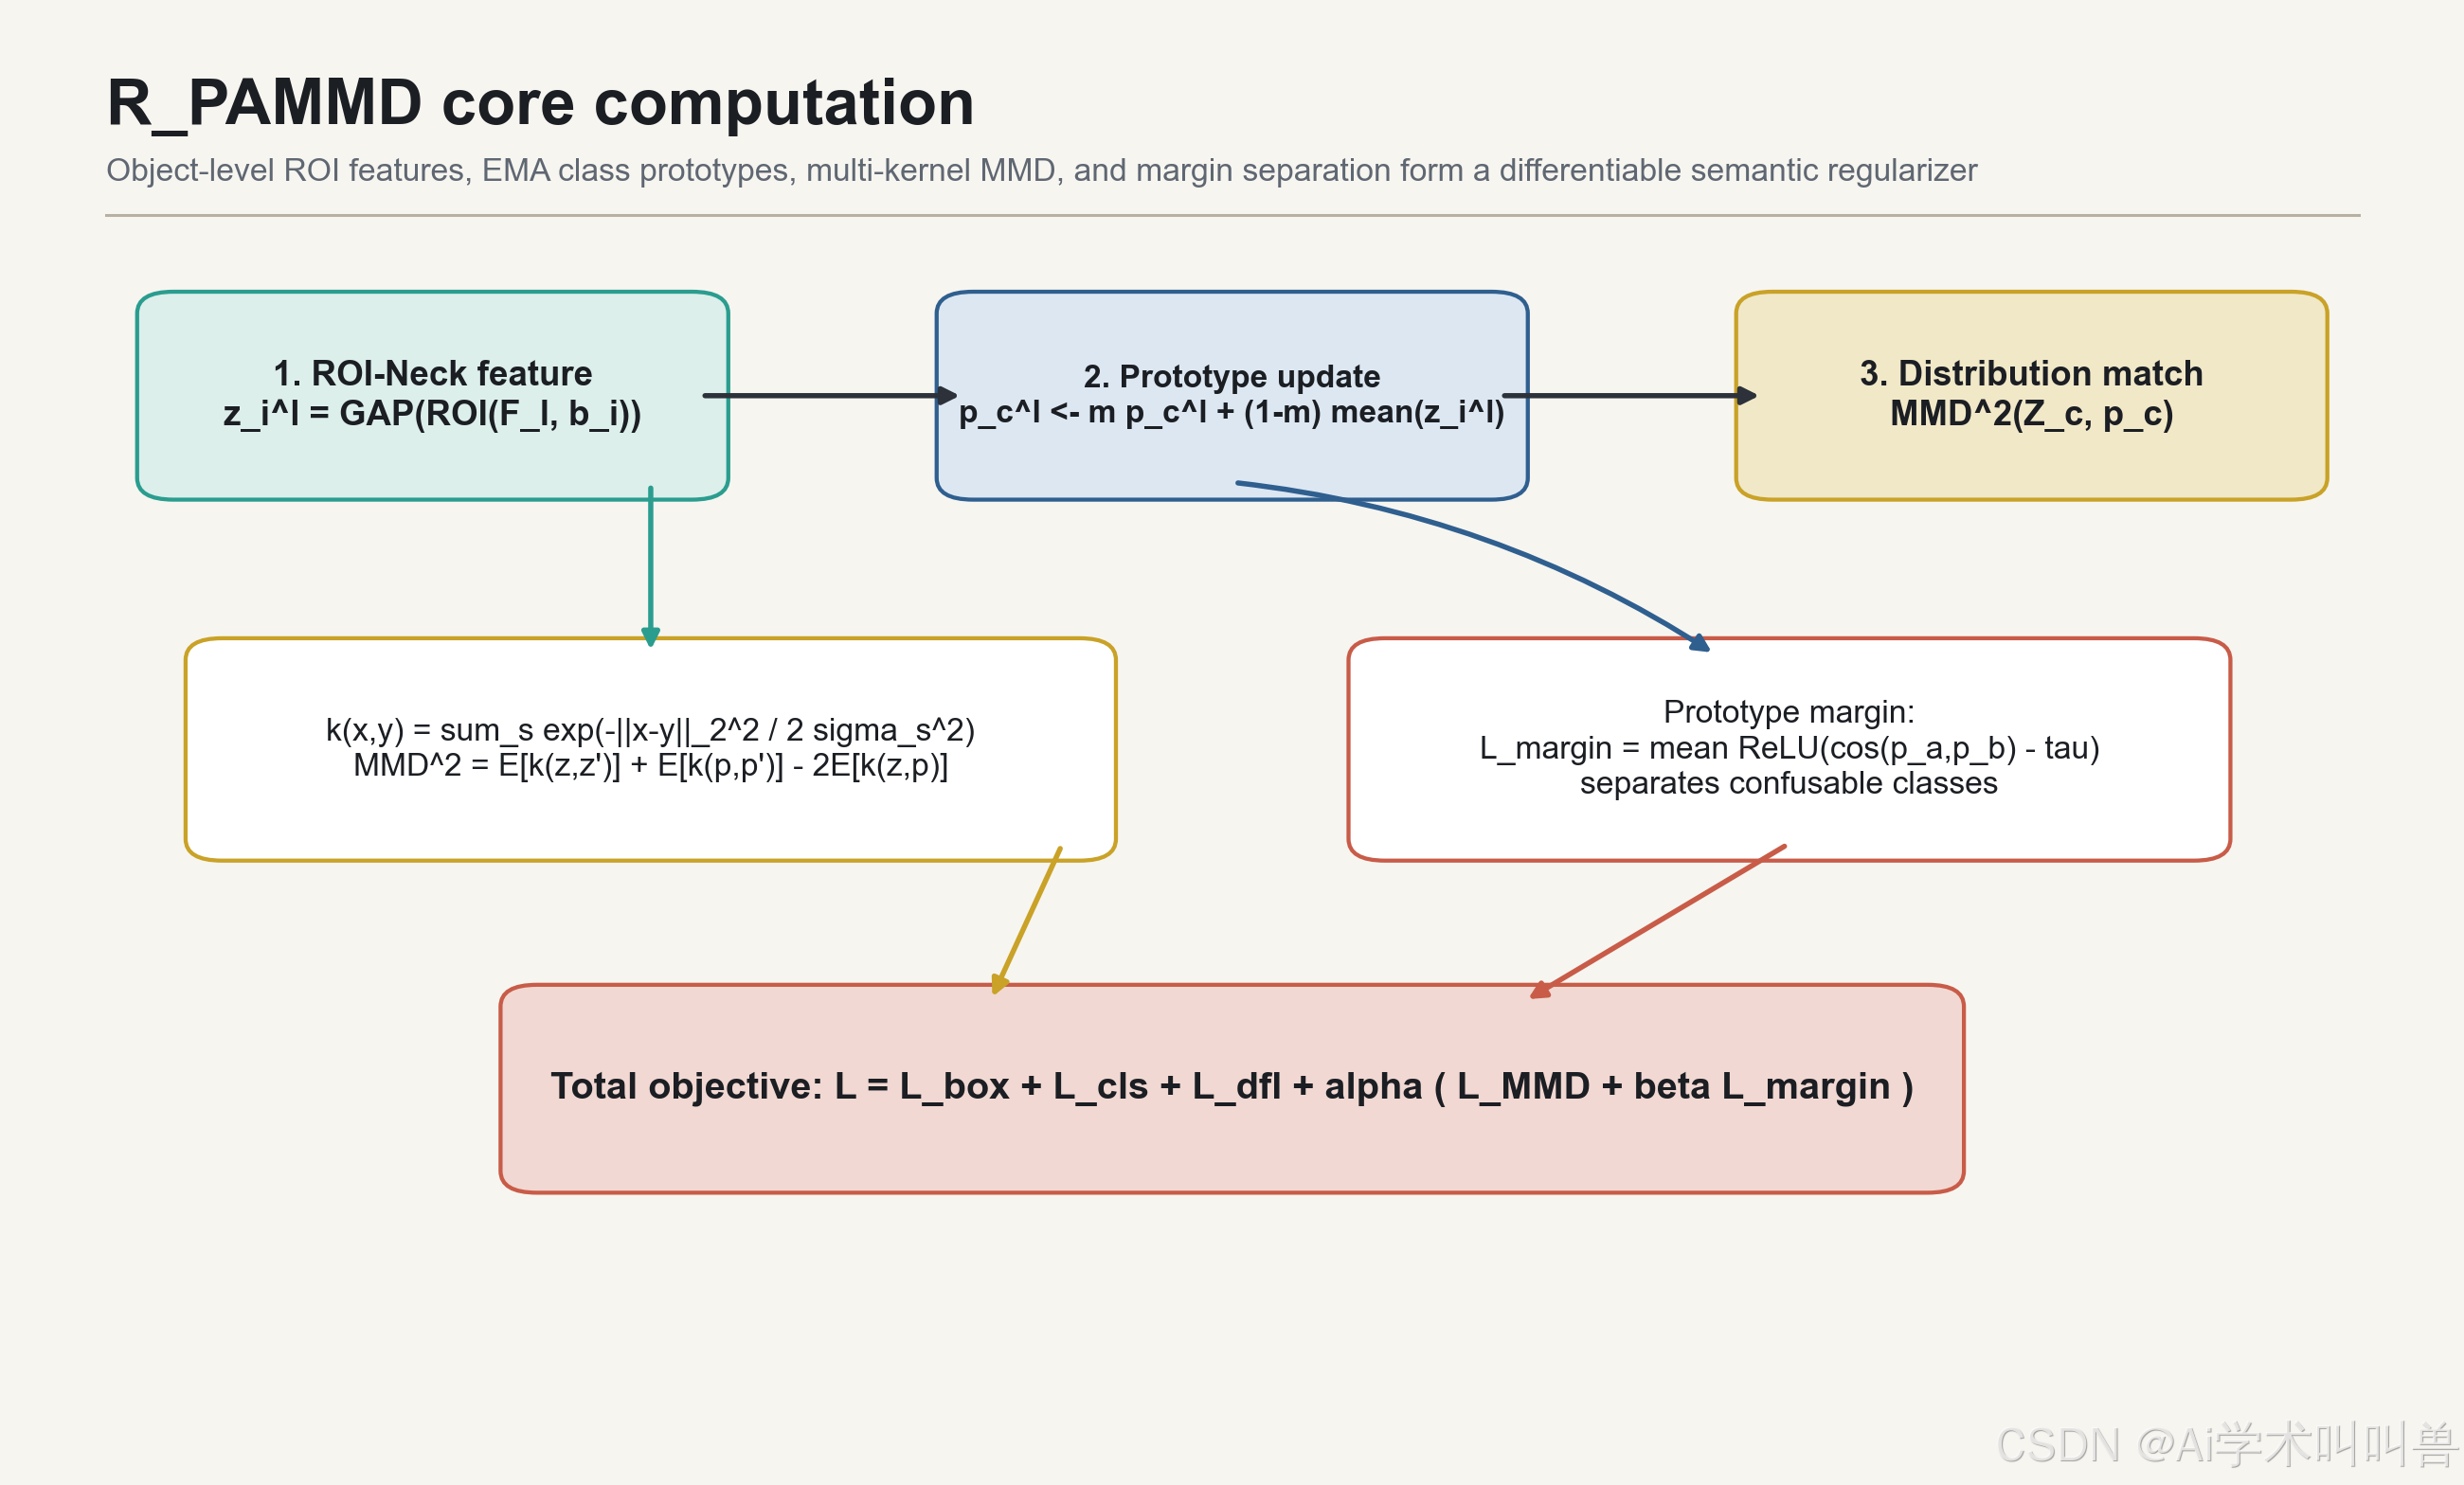
给定第 (l) 层 Neck 特征 (F_l),第 (i) 个目标框为 (b_i),类别为 (y_i=c)。首先抽取 ROI 特征:
z i l = Norm ( GAP ( ROI ( F l , b i ) ) ) z_i^l = \operatorname{Norm} \left( \operatorname{GAP} ( \operatorname{ROI}(F_l, b_i) ) \right) zil=Norm(GAP(ROI(Fl,bi)))
其中,(\operatorname{ROI}(\cdot)) 表示根据目标框映射到特征图区域,(\operatorname{GAP}) 表示空间平均池化,(\operatorname{Norm}) 表示特征归一化。
对类别 (c) 的原型,使用 EMA 更新:
p c l ← m p c l + ( 1 − m ) 1 N c ∑ i : y i = c z i l p_c^l \leftarrow m p_c^l + (1-m) \frac{1}{N_c} \sum_{i:y_i=c} z_i^l pcl←mpcl+(1−m)Nc1i:yi=c∑zil
其中,(m) 为动量系数,(N_c) 为当前 batch 内类别 (c) 的目标数量。
3.3 Prototype-Anchored MMD
MMD 的作用不是简单让特征和原型做欧式距离最小化,而是从核均值嵌入角度约束两个分布之间的差异。对类别 (c),设 ROI 特征集合为 (Z_c^l),类别原型为 (p_c^l),则:
$$
\operatorname{MMD}^2
(Z_c^l, p_c^l)
\mathbb{E}k(z,z')
多核设计比单一距离更稳,因为不同类别、不同尺度和不同语义层的特征分布宽度并不一致。小 (\sigma) 关注局部紧致性,大 (\sigma) 关注整体分布形态。
4. 整合融合方法总览
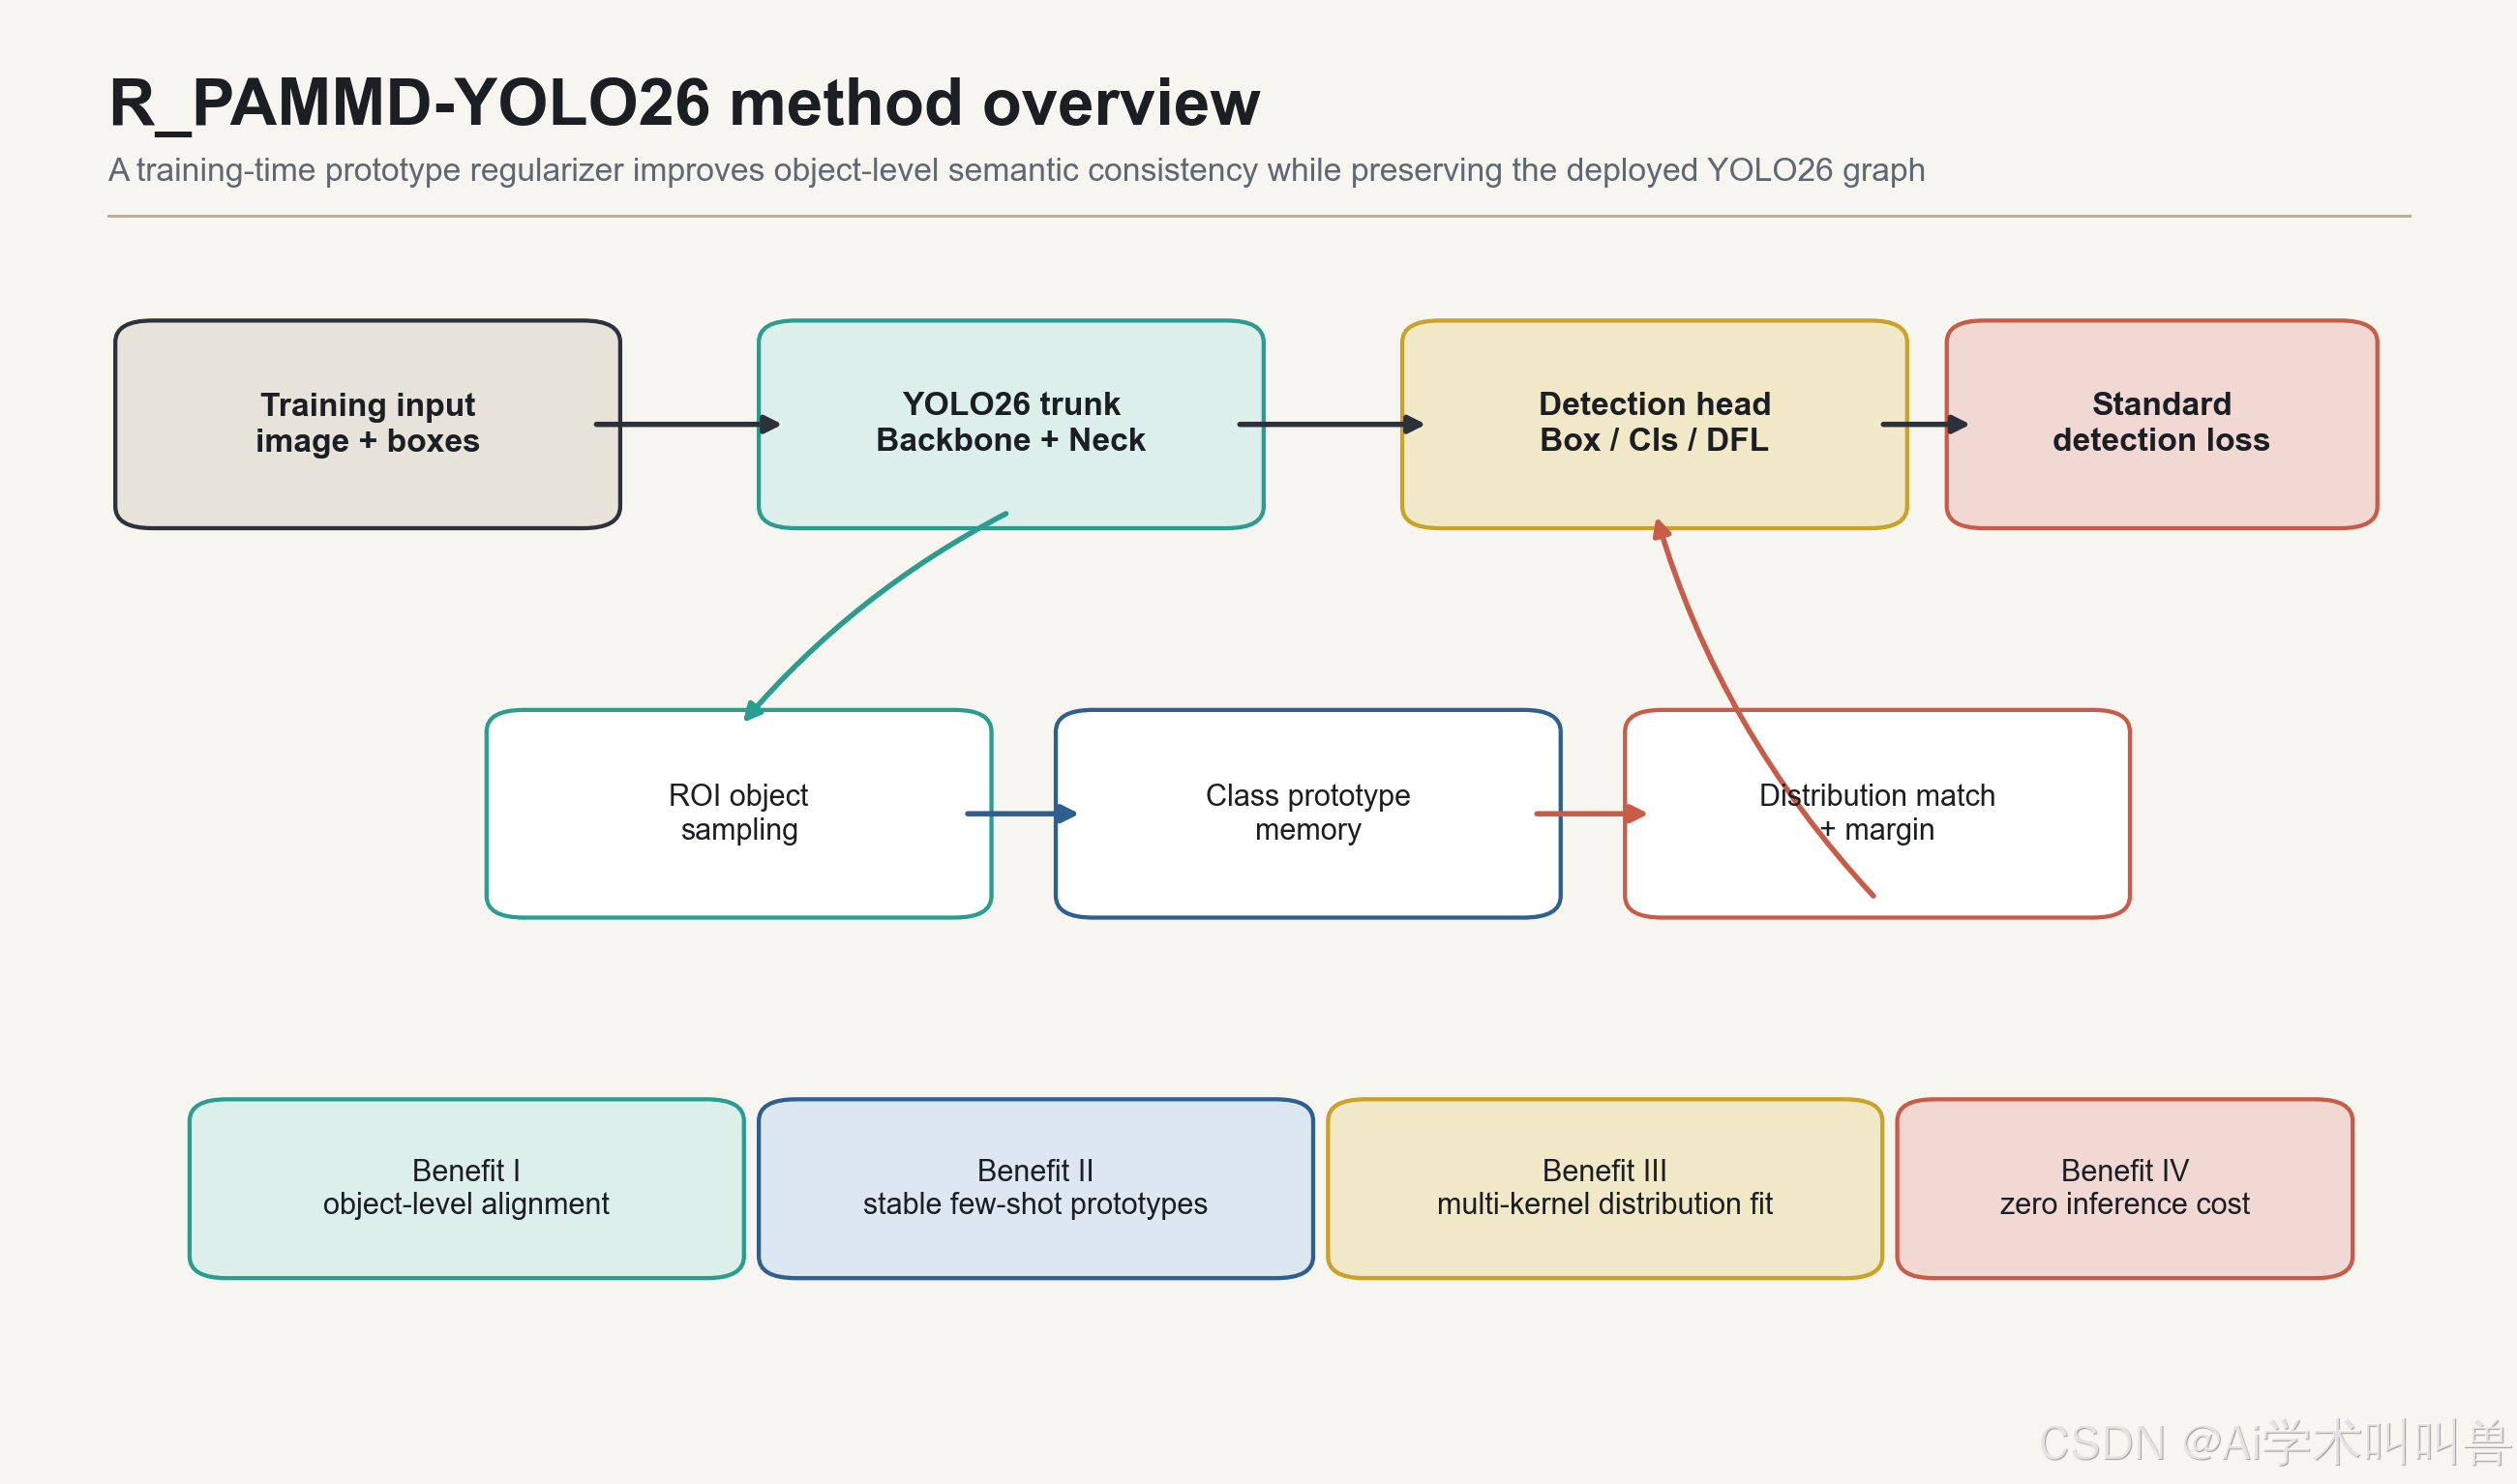
该方法可以概括为四个关键设计:
4.1 ROI 对象采样
传统分类特征对齐通常基于整图特征,但检测任务的语义主体是目标框,而不是整张图。本文将对齐对象从 image-level 改成 ROI-level,使辅助约束直接作用于目标区域。
这样做的优点是:
- 不让背景区域主导类别原型;
- 与检测任务的框级监督保持一致;
- 能够让 Neck 特征学习"目标实例"的语义结构;
- 更适合多目标、多尺度、多背景场景。
4.2 P4/P5 Neck 语义层约束
P3 特征更偏细节和局部纹理,适合小目标定位;P4/P5 具有更稳定的语义表达,更适合做类别原型对齐。因此,将 R_PAMMD 主要放在 P4/P5 层,可以减少局部噪声对类别原型的干扰。
这种设计体现了一个重要原则:
原型对齐应该发生在语义表达相对稳定的层,而不是盲目覆盖所有特征层。
4.3 EMA 类别原型
如果直接用当前 batch 均值作为类别原型,原型会受 batch 采样波动影响。EMA 原型相当于为每个类别维护一个稳定记忆:
p c ← m p c + ( 1 − m ) z ˉ c p_c \leftarrow m p_c + (1-m)\bar{z}_c pc←mpc+(1−m)zˉc
它的优势是:
- 抑制 batch 抖动;
- 适合少样本类别;
- 不需要额外标注;
- 不改变推理结构;
- 训练过程中逐步形成更可靠的类别中心。
4.4 多核 MMD + 原型间隔
单纯的余弦距离只能约束方向,单纯的 L2 距离容易受尺度影响。多核 MMD 约束的是分布差异,更适合刻画 ROI 特征集合与类别原型之间的整体一致性。
再配合类间原型间隔,可以同时优化两个目标:
- 类内更紧致:同类别目标围绕原型聚合;
- 类间更分离:易混类别原型不再过度重叠。
5. 原网络与融合后特点对比
| 对比维度 | 原始 YOLO26 | R_PAMMD-YOLO26 |
|---|---|---|
| 语义约束方式 | 主要依靠分类损失隐式学习 | 增加 ROI-Neck 级显式原型约束 |
| 对齐对象 | 检测头 logits | 目标框对应的 Neck ROI 特征 |
| 类内结构 | 无显式类内紧致约束 | 多核 MMD 拉近同类 ROI 分布 |
| 类间结构 | 由分类头间接分离 | 原型间隔显式拉开易混类别 |
| 少样本适应性 | 类中心容易不稳定 | EMA 原型增强类中心稳定性 |
| 推理开销 | 原始开销 | 不增加推理开销 |
| 论文叙事 | 常规检测框架 | 具备"对象级原型分布对齐"创新点 |
6. 适合写进论文的创新点表述
可以将本文方法写成以下三类创新点。
创新点 1:对象级原型锚定分布对齐
提出一种面向 YOLO26 的 ROI-Neck Prototype-Anchored MMD 训练约束。不同于传统图像级特征对齐方法,该方法根据目标框从 Neck 多尺度特征中提取 ROI 表征,并以类别 EMA 原型为锚点进行分布级匹配,使检测器能够在对象级语义空间中形成更紧致的类内结构。
创新点 2:训练期增强、推理期无负担
设计了一条仅在训练阶段启用的原型正则分支。该分支通过 ROI 采样、类别原型更新和多核 MMD 约束优化 Neck 特征分布,但在推理阶段完全移除,不改变 YOLO26 的 Backbone、Neck、Detect Head 和后处理流程,从而保持部署效率。
创新点 3:类内紧致与类间分离联合优化
在 Prototype-Anchored MMD 的基础上,引入类别原型间隔约束,联合优化类内分布一致性与类间判别边界。该设计能够缓解相似类别在检测特征空间中的混淆问题,使分类分支获得更稳定的语义支撑。
7. 可写作的论文段落模板
原始 YOLO 系列检测器主要依赖分类、定位与分布回归损失进行端到端优化。尽管该范式在通用检测场景中表现良好,但其分类监督通常作用于检测头输出,缺少对 Neck 中对象级特征分布的显式约束。尤其在样本有限或类别外观相近的情况下,同类 ROI 特征可能呈现较大离散性,而不同类别原型之间也可能缺少足够判别间隔。
为解决上述问题,本文引入 ROI-Neck R_PAMMD 模块。该模块从 YOLO26 的多尺度 Neck 特征中提取目标框对应的 ROI 表征,并为每个类别维护 EMA 原型。随后,利用多核 MMD 将同类 ROI 特征分布对齐到其类别原型,同时通过原型间隔项抑制易混类别之间的特征重叠。该方法在训练阶段提供对象级语义结构约束,在推理阶段不引入额外参数和计算开销。
从方法论角度看,R_PAMMD-YOLO26 将原型学习、分布匹配和目标检测的 ROI 监督统一到同一训练框架中,使检测器不仅学习"如何定位目标",也学习"目标实例在类别语义空间中应当如何聚合与分离"。
8. 方法优势总结
R_PAMMD-YOLO26 的价值不在于堆叠复杂结构,而在于补上原始 YOLO26 缺少的对象级语义分布约束。
它解决的问题可以概括为:
- 原始 YOLO 分类损失只间接塑造 Neck 特征;
- ROI 级原型对齐让目标实例获得更稳定的类别中心;
- 多核 MMD 比单一距离更适合复杂特征分布;
- 原型间隔项进一步降低易混类别重叠;
- 模块只在训练期工作,不增加推理成本;
- 改进逻辑清晰,适合整理为 SCI 论文中的结构创新点。
因此,该融合方法的核心不是"把 DCS 原封不动搬到 YOLO",而是把 DCS 中最适合检测任务的 R_PAMMD 思想重新解释为 ROI-Neck object-level prototype distribution alignment。这使改进具备更强的任务一致性和论文表达价值。
写在最后
学术因方向、个人实验和写作能力以及具体创新内容的不同而无法做到一通百通,关注UP:Ai学术叫叫兽
在所有资料中留下联系方式以便在科研之余为家人们答疑解惑,本up主获得过国奖,发表多篇SCI,擅长目标检测领域,拥有多项竞赛经历,拥有软件著作权,核心期刊等经历。
因为经历过所以更懂小白的痛苦!
因为经历过所以更具有指向性的指导!
祝所有科研工作者都能够在自己的领域上更上一层楼!