PyTorch强化学习实战(28)------遗传算法在强化学习中的应用
0. 前言
我们已经学习了进化策略 (Evolution Strategies, ES)这一黑盒优化方法在强化学习 (Reinforcement Learning, RL)中的应用,黑盒优化方法在大规模 RL 问题中具有适用性,并能与价值迭代和策略梯度方法竞争。尽管存在时间较长,这类方法在某些情境下仍然更具效率。具体而言,本节将介绍另一类黑盒优化方法:遗传算法。
1. 遗传算法
遗传算法 (Genetic Algorithm, GA) 是另一类流行的黑盒优化方法,这类方法拥有超过二十年的发展历史,其核心思想简单明了:生成包含 N 个个体的种群(即具体的模型参数),每个个体都通过适应度函数进行评估。然后,选取一些表现最好的个体,利用它们生成下一代种群。这个过程会重复进行,直到种群性能满足要求为止。
遗传算法包含多种不同方法,例如如何执行下一代个体的突变,或者如何对个体进行排序。本节中,我们将探讨 Such 等人论文《Deep neuroevolution: Genetic algorithms are a competitive alternative for training deep neural networks for reinforcement learning》中提出的带扩展的简单 GA 方法。
该论文分析了一种简单 GA 方法,该方法通过对父代权重进行高斯噪声扰动来实现突变。每次迭代时,表现最优的个体会被直接复制到下一代。用算法形式表示,简单 GA 方法的步骤可表述如下:
- 初始化突变强度 σ σ σ、种群规模 N N N、选择的个体数量 T T T 和初始种群 P 0 P_0 P0,其中 P 0 P_0 P0 是 N N N 个随机初始化的策略及其适应度: F 0 = F ( P i 0 ) ∣ i = 1 ... N F₀ = {F(P_i^0) | i = 1 ... N} F0=F(Pi0)∣i=1...N
- 对世代 g = 1 ... G g = 1 ... G g=1...G 循环:
- 根据适应度函数值 F g − 1 F^{g-1} Fg−1 降序排序上一代种群 P n − 1 P^{n-1} Pn−1
- 复制精英个体 P 1 g = P 1 g − 1 , F 1 g = F 1 g − 1 P_1^g = P_1^{g-1},F_1^g = F_1^{g-1} P1g=P1g−1,F1g=F1g−1
- 对个体 i = 2 ... N i = 2 ... N i=2...N 循环:
- 从 1 ... T 1...T 1...T 中随机选择 k k k 个父代
- 采样噪声 ϵ ∼ N ( 0 , I ) \epsilon ∼ N(0, I) ϵ∼N(0,I)
- 进行突变: P i g = P g − 1 i + σ 𝜖 P_i^g = P^i_{g-1} + σ𝜖 Pig=Pg−1i+σ𝜖
- 计算其适应度: F i g = F ( P i g ) F_i^g = F(P_i^g) Fig=F(Pig)
论文对该基础方法提出了若干改进,我们将在后续学习中进行讨论,接下来,我们先来查看核心算法的实现。
2. 遗传算法在 CartPole 上的应用
源代码位于 cartpole_ga.py 中,与进化策略 (Evolution Strategies, ES)示例有许多共同之处。区别在于缺少梯度上升代码,而是被网络突变函数所替代:
python
def mutate_parent(net: Net) -> Net:
    new_net = copy.deepcopy(net)
    for p in new_net.parameters():
        noise = np.random.normal(size=p.data.size())
        noise_t = torch.FloatTensor(noise)
        p.data += NOISE_STD * noise_t
    return new_net
该函数的目标通过对所有权重添加随机噪声,创建给定策略的突变副本。父代权重保持原样,因为父代是采用替换方式随机选择的,该网络后续可能被再次使用。
超参数数量比 ES 更少,主要包括添加到突变中的噪声的标准差、种群大小以及用于产生下一代的最优个体数量:
python
if __name__ == "__main__":
    env = gym.make("CartPole-v1")
    writer = SummaryWriter(comment="-cartpole-ga")

    gen_idx = 0
    nets = [
        Net(env.observation_space.shape[0], env.action_space.n)
        for _ in range(POPULATION_SIZE)
    ]
    population = [
        (net, common.evaluate(env, net))
        for net in nets
    ]
在训练循环开始前,我们创建随机初始化的网络种群并获取其适应度:
python
    while True:
        population.sort(key=lambda p: p[1], reverse=True)
        rewards = [p[1] for p in population[:PARENTS_COUNT]]
        reward_mean = np.mean(rewards)
        reward_max = np.max(rewards)
        reward_std = np.std(rewards)

        writer.add_scalar("reward_mean", reward_mean, gen_idx)
        writer.add_scalar("reward_std", reward_std, gen_idx)
        writer.add_scalar("reward_max", reward_max, gen_idx)
        print("%d: reward_mean=%.2f, reward_max=%.2f, reward_std=%.2f" % (
            gen_idx, reward_mean, reward_max, reward_std))
        if reward_mean > 199:
            print("Solved in %d steps" % gen_idx)
            break
在每个世代开始时,我们根据适应度对上一代进行排序,并记录关于未来父代的统计信息:
python
        prev_population = population
        population = [population[0]]
        for _ in range(POPULATION_SIZE-1):
            parent_idx = np.random.randint(0, PARENTS_COUNT)
            parent = prev_population[parent_idx][0]
            net = mutate_parent(parent)
            fitness = common.evaluate(env, net)
            population.append((net, fitness))
        gen_idx += 1
在生成新个体的独立循环中,我们随机采样一个父代,进行突变,并评估其适应度得分。
启动实现后,可以看到以下输出(具体输出和步数可能因执行随机性而有所不同):
shell
$ python3 cartpole_ga.py
可以看到,GA 方法比 ES 方法更高效。
3. 遗传算法改进方案
Such 等人提出了两种对基本遗传算法 (Genetic Algorithm, GA) 算法的改进:
- 第一项称为深度
GA,旨在提升实现的可扩展性 - 第二项称为新颖性搜索,尝试用不同的回合评估指标替代奖励目标
接下来的"遗传算法在 HalfCheetah 环境中的应用"部分中,我们将实现第一个改进,而第二个则作为可选练习。
3.1 深度遗传算法
作为一种无梯度方法,GA 在速度方面比 ES 方法具有更强的可扩展性潜力,尤其是在使用更多 CPU 参与优化时。然而,基础 GA 算法存在与ES方法类似的瓶颈:策略参数必须在工作节点之间交换。Such 等人提出了一种与共享种子方法类似但更极端的技巧(使用种子来追踪数千次变异),称之为深度 GA。其核心思想是将策略参数表示为用于创建该特定策略权重的随机种子列表。
实际上,初始网络权重在首代种群中随机生成,因此列表中的第一个种子就定义了这种初始化。在每一代种群中,变异也完全由每个变异的随机种子指定。因此,我们重建权重唯一需要的就是种子本身。这种方法需要在每个工作节点上重建权重,但通常这种开销远小于通过网络传输完整权重的开销。
3.2 新颖性搜索
对基本 GA 方法的另一项改进是新颖性搜索 (Novelty Search, NS),它由 Lehman 和 Stanley 在论文《Abandoning objectives: Evolution through the search for novelty alone》中提出。
NS 的核心思想是改变优化目标:我们不再试图提高环境中的总奖励,而是奖励智能体探索前所未见的行为(即,新颖行为)。
根据作者在迷宫导航问题上的实验(其中设置了许多陷阱),NS 的表现远优于其他奖励驱动方法。
要实现 NS,我们需要定义所谓的行为特征 (Behavior Characteristic, BC) π π π------用于描述策略行为,以及两个 BC 之间的距离。然后使用 k 近邻方法检查新策略的新奇性,并据此距离驱动 GA 进化。在 Such 等人的论文中,智能体需要进行充分探索,而 NS 方法在 RL 问题上的表现显著超越了 ES、GA 和其他传统方法。
4. 遗传算法在 HalfCheetah 环境中的应用
在本节中,我们将在 HalfCheetah 环境中实现并行化深度遗传算法 (Genetic Algorithm, GA)。完整代码位于 cheetah_ga.py 中。其架构与并行进化策略 (Evolution Strategies, ES)版本非常接近,包含一个主进程和若干工作进程。每个工作进程的目标是评估一批网络并将结果返回给主进程,主进程将部分结果合并为完整种群,根据获得的奖励对个体进行排序,并生成下一代种群供工作进程评估。
每个个体通过随机种子列表进行编码,这些种子用于初始化网络权重及所有后续突变。这种表示法可以实现非常紧凑的网络编码,即使策略参数数量不大时也是如此。例如,在我们具有 64 个神经元隐藏层的网络中,共有 1542 个浮点值(输入为 17 个值,动作为 6 个浮点数,计算公式为:17×64 + 64 + 64×6 + 6 = 1542)。每个浮点数占用 4 字节,与随机种子的大小相同。因此,论文提出的深度 GA 表示法在优化过程中最多可节省 1542 代的数据量。
4.1 算法实现
在本节中,我们将在本地 CPU 上执行并行化,因此数据的传输量不会对性能产生太大影响;但是,如果有数百个核心可用,这种表示法可能会成为重要考量因素。
(1) 超参数集与 CartPole 示例相同,区别在于种群规模更大:
python
NOISE_STD = 0.01
POPULATION_SIZE = 2000
PARENTS_COUNT = 10
WORKERS_COUNT = 6
SEEDS_PER_WORKER = POPULATION_SIZE // WORKERS_COUNT
MAX_SEED = 2**32 - 1
(2) 有两个函数用于根据给定种子构建网络。第一个函数对已创建的策略网络执行一次突变:
python
def mutate_net(net: Net, seed: int, copy_net: bool = True) -> Net:
    new_net = copy.deepcopy(net) if copy_net else net
    np.random.seed(seed)
    for p in new_net.parameters():
        noise = np.random.normal(size=p.data.size())
        noise_t = torch.FloatTensor(noise)
        p.data += NOISE_STD * noise_t
    return new_net
上述函数可根据参数选择原地执行突变或通过复制目标网络执行(第一代需要复制操作)。
(3) 第二个函数使用种子列表从头创建网络:
python
def build_net(env: gym.Env, seeds: tt.List[int]) -> Net:
    torch.manual_seed(seeds[0])
    net = Net(env.observation_space.shape[0], env.action_space.shape[0])
    for seed in seeds[1:]:
        net = mutate_net(net, seed, copy_net=False)
    return net
此处第一个种子传递给 PyTorch 以影响网络初始化,后续种子用于实施网络突变。
工作进程函数获取待评估的种子列表,并为每个获得的结果输出一个个体 OutputItem 数据类项目:
python
@dataclass
class OutputItem:
    seeds: tt.List[int]
    reward: float
    steps: int

def worker_func(input_queue: mp.Queue, output_queue: mp.Queue):
    env = gym.make("HalfCheetah-v4")
    cache = {}

    while True:
        parents = input_queue.get()
        if parents is None:
            break
        new_cache = {}
        for net_seeds in parents:
            if len(net_seeds) > 1:
                net = cache.get(net_seeds[:-1])
                if net is not None:
                    net = mutate_net(net, net_seeds[-1])
                else:
                    net = build_net(env, net_seeds)
            else:
                net = build_net(env, net_seeds)
            new_cache[net_seeds] = net
            reward, steps = common.evaluate(env, net, get_max_action=False)
            output_queue.put(OutputItem(seeds=net_seeds, reward=reward, steps=steps))
        cache = new_cache
该函数维护网络缓存以最小化从种子列表重建参数所耗时间。缓存每代清空一次,因为每个新世代都由当前世代的优胜者创建,旧网络从缓存中复用的概率极低。
(4) 主进程代码同样简明直接:
python
        batch_steps = 0
        population = []
        while len(population) < SEEDS_PER_WORKER * WORKERS_COUNT:
            out_item = output_queue.get()
            population.append((out_item.seeds, out_item.reward))
            batch_steps += out_item.steps
        if elite is not None:
            population.append(elite)
        population.sort(key=lambda p: p[1], reverse=True)
        rewards = [p[1] for p in population[:PARENTS_COUNT]]
        reward_mean = np.mean(rewards)
        reward_max = np.max(rewards)
        reward_std = np.std(rewards)
        speed = batch_steps / (time.time() - t_start)
        writer.add_scalar("speed", speed, gen_idx)
        print("%d: reward_mean=%.2f, reward_max=%.2f, reward_std=%.2f, speed=%.2f f/s" % (
            gen_idx, reward_mean, reward_max, reward_std, speed))

        elite = population[0]
        for worker_queue in input_queues:
            seeds = []
            for _ in range(SEEDS_PER_WORKER):
                parent = np.random.randint(PARENTS_COUNT)
                next_seed = np.random.randint(MAX_SEED)
                s = list(population[parent][0]) + [next_seed]
                seeds.append(tuple(s))
对于每一代,我们将当前种群的种子发送给工作进程进行评估并等待结果。随后对结果进行排序,并根据表现最优的个体生成下一代种群。在主进程端,突变仅需生成随机种子编号并将其附加到父代的种子列表中。
4.2 运行结果
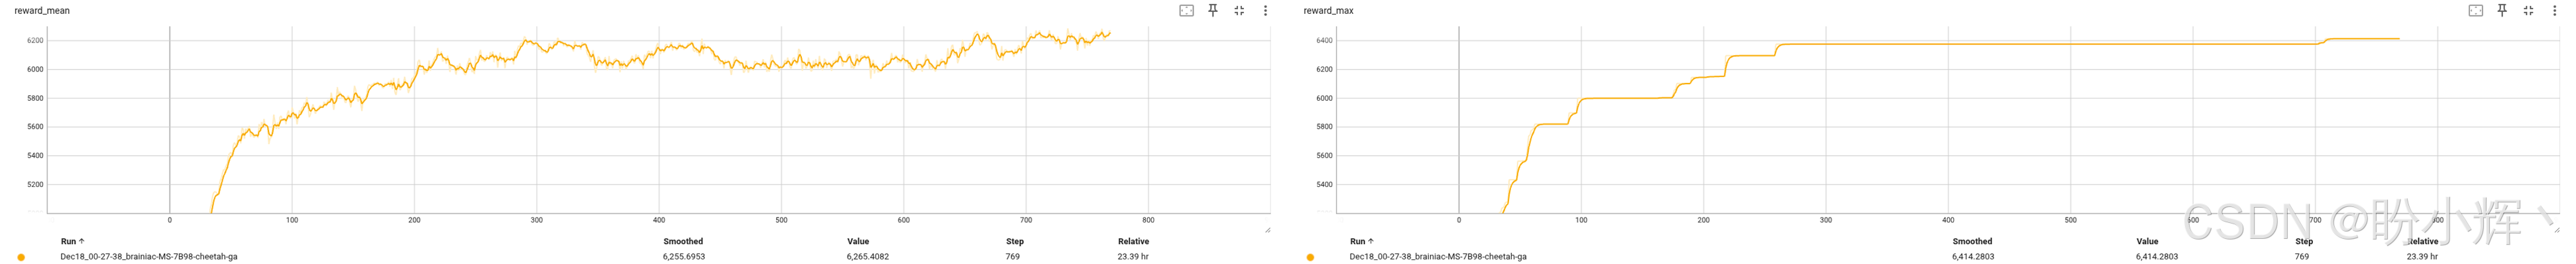
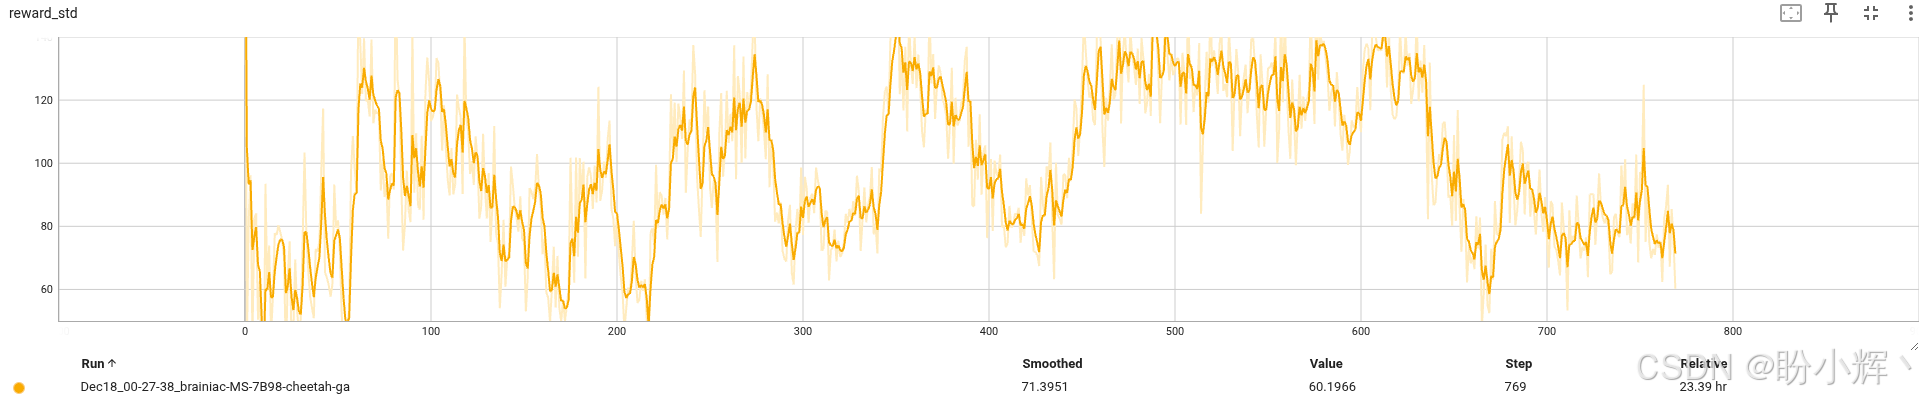
本节使用 MuJoCo 的 HalfCheetah 环境,该环境内部没有任何健康度检测机制,因此每个回合都会运行 2000 步。经过 300 轮突变,最佳策略获得了 6454 分的奖励,这是一个非常出色的结果。虽然 HalfCheetah 环境挑战性有限,但这个成绩仍然非常优秀。相关曲线如下图所示。
小结
本节介绍了遗传算法 (Genetic Algorithm, GA) 在强化学习中的应用。GA 是一种黑盒优化方法,通过维护种群、评估适应度、选择精英个体并进行突变来迭代进化策略。在 CartPole 环境中,基础 GA 通过对网络权重添加高斯噪声实现突变,每代保留最优个体并随机选择父代生成下一代。实验表明 GA 比进化策略 (Evolution Strategies, ES)更高效。针对复杂环境,本节实现了深度 GA 的改进方案:使用随机种子列表编码网络参数,而非直接传递权重,大幅降低通信开销。在 HalfCheetah 环境中采用并行架构(主进程协调、工作进程评估),经过 300 代进化获得 6454 分,表现优异。
系列链接
PyTorch强化学习实战(1)------强化学习(Reinforcement Learning,RL)详解
PyTorch强化学习实战(2)------强化学习环境库Gymnasium
PyTorch强化学习实战(3)------Gymnasium API扩展功能
PyTorch强化学习实战(4)------PyTorch基础
PyTorch强化学习实战(5)------PyTorch Ignite 事件驱动机制与实践
PyTorch强化学习实战(6)------交叉熵方法详解与实现
PyTorch强化学习实战(7)------表格学习与贝尔曼方程
PyTorch强化学习实战(8)------Q学习详解与实现
PyTorch强化学习实战(10)------强化学习高级组件
PyTorch强化学习实战(11)------N步DQN(N-step DQN)
PyTorch强化学习实战(12)------Double DQN(DDQN)
PyTorch强化学习实战(13)------噪声网络(NoisyNet-DQN)
PyTorch强化学习实战(14)------优先经验回放机制
PyTorch强化学习实战(15)------Dueling DQN
PyTorch强化学习实战(16)------Categorical DQN
PyTorch强化学习实战(17)------强化学习训练加速
PyTorch强化学习实战(18)------基于DQN处理股票交易问题
PyTorch强化学习实战(20)------优势演员-评论家(Advantage Actor-Critic, A2C)
PyTorch强化学习实战(21)------异步优势演员-评论家(Asynchronous Advantage Actor-Critic, A3C)
PyTorch强化学习实战(22)------将强化学习应用于TextWorld互动小说游戏
PyTorch强化学习实战(23)------强化学习在网页导航中的应用
PyTorch强化学习实战(24)------连续动作空间中的强化学习
PyTorch强化学习实战(25)------深度确定性策略梯度(DDPG)