一、介绍
Apache Hive是一款构建于Hadoop之上的开源数据仓库软件。它提供类似 SQL 的查询语言(HQL),能够将 SQL 语句自动转化为底层的分布式计算任务(如 MapReduce),从而让用户能够轻松地对存储在HDFS上的海量数据进行分析和处理。
二、架构及工作原理的讲解
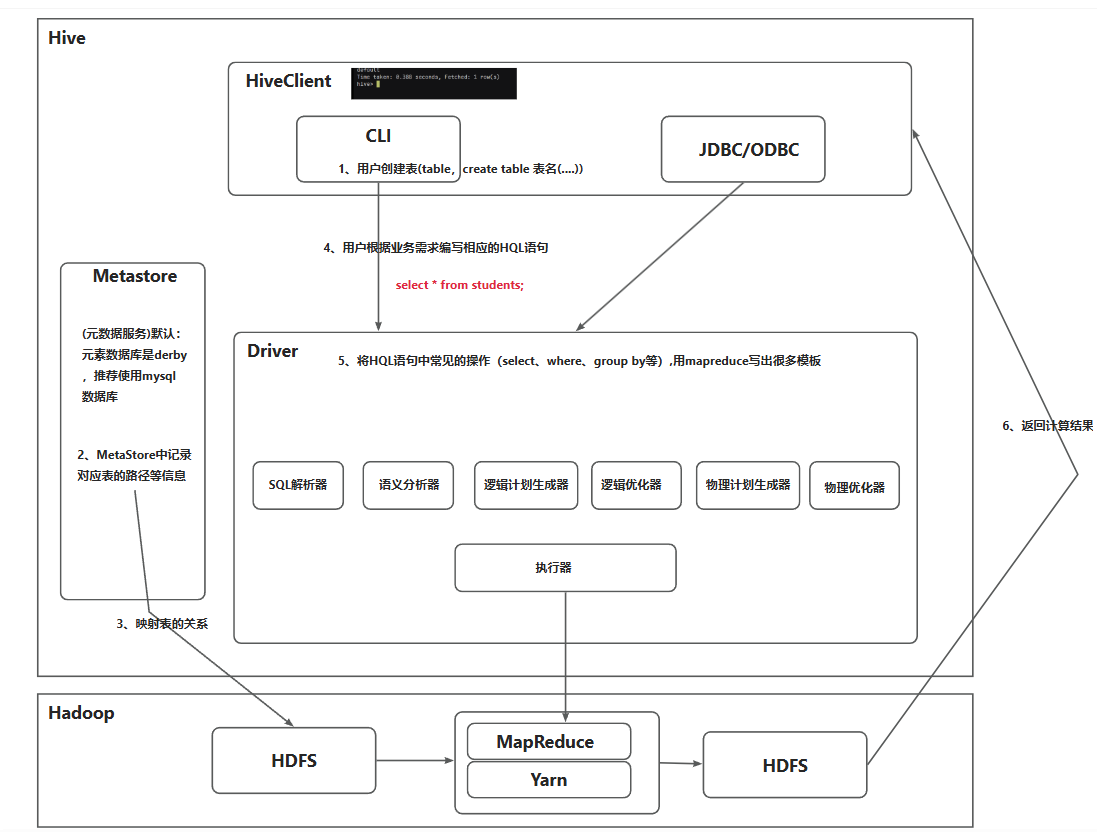
其整体架构可以划分为四个核心层次基于上面的架构截图,Hive的整体架构可以划分为四个核心层次。
2.1用户接口层(HiveClient)
这是用户与Hive系统交互的入口,主要提供两种连接方式:
CLI(命令行界面):用户可以直接在终端中创建表**(如create table 表名(...))**或执行查询。
JDBC/ODBC:供外部应用程序或其他客户端通过标准的数据库连接协议接入。用户通过这两种接口,根据业务需求编写相应的HQL查询语句**(例如 select * from students;)**并提交给系统。
2.2元数据存储层(Metastore)
Metastore是Hive的重要支撑组件,主要负责管理Hive的元数据。
元数据:简单来说就是关于数据的信息。
存储内容:它记录了表与底层数据的映射关系,包括表名、表的拥有者、列/分区字段、表的类型(内部表或外部表)以及表所在的HDFS目录路径等信息。
底层数据库:默认情况下,元数据存储在自带的derby数据库中,但由于其局限性强,生成环境中通常推荐使用MySQL来存储元数据,以支持多用户并发访问。
2.3核心驱动层(Driver)
Driver是Hive的"大脑"。负责将用户提交的HQL语句转化为底层的分布式计算任务。它包含一个完整的处理流水线,将常见的操作(如select、where、group by等)转化为MapReduce模板。其内部组件工作流程如下:
1.SQL解析器:将接受到的SQL字符串转换为抽象语法树(AST)。
2.语义分析器:将AST进一步划分为查询块(QueryBlock),并进行语义校验(如检验表是否存在、字段是否正确)。
3.逻辑计划生成器:将语法树转化为逻辑执行计划。
4.逻辑优化器:对逻辑计划进行优化,例如进行谓词下推、分区裁剪等。
5.物理计划生成器:根据优化后的逻辑计划,生成由具体MapReduce任务组成的物理计划。
6.物理优化器:对物理计划进行进一步调优。
7.执行器:负责最终执行物理计划,并将计划结果返回给客户端。
2.4底层执行环境(Hadoop)
Hive本身不存储数据,也不直接进行计算,而是完全依赖于Hadoop生态系统:
HDFS:负责海量数据的分布式存储。
MapReduce & Yarn:负责分布式计算和资源调度。执行器将生成的物理计划提交给Yarn,由Yarn分配资源并在MapReduce框架中运行。
数据流向清晰可见:计算任务从HDFS读取数据原始数据,经过MapReduce/Yarn处理完成后,将结果数据写回HDFS,并最终反馈给HiveClient。
三、整体工作流程总结
当用户通过CLI或JDBC/ODBC提交一条HQL查询时,Driver会接收该请求,并依靠Metastore提供的元数据信息对SQL进行解析、校验和优化。随后,Driver将优化后的逻辑转化为物理执行计划,提交给底层的Hadoop(由Yarn调度,MapReduce执行)。执行过程中从HDFS读取数据,计算完成后再写回HDFS,最终由Driver将计算结果返回给发起请求的用户端。