🔥 本文定位:CSDN 原创干货 | 轻量 RGB-D 显著性检测
🎯 核心收益:围绕RGB-D Salient Object Detection的真实瓶颈,拆开复现 SATNet 的数据、特征和决策路径。论文最可核对的结果是:5.2M 参数、415 FPS;在论文列出的轻量方案中,NLPR 的 adpEm=0.964、Sm=0.932、MAE=0.019。
📌 核心创新矩阵:
- Pseudo Depth:Depth Anything 深度补全:利用 Depth Anything 生成高质量伪深度,缓解原始 RGB-D 数据集的深度质量不一致。
- DAM:解耦注意力模块:将多模态特征解耦为双视图向量,分别探索模态内和模态间一致性。
- DIRM 与 DFAM:双信息表达和聚合:用双向倒置结构扩展轻量骨干的有限特征空间,再聚合纹理与显著性特征。
✅ 适配场景:研究复现、课程设计、算法选型、感知系统原型、基准对比、工程验证。
🔖 SATNet 的问题定义与可复现边界
- 问题 1:大骨干提升精度却牺牲移动端吞吐
- 问题 2:真实深度图质量不稳定且有模态鸿沟
- 问题 3:轻量骨干的特征空间不足以同时保留纹理和显著性
SATNet: Lightweight RGB-D Salient Object Detection from a Speed-Accuracy Tradeoff Perspective 聚焦于RGB-D Salient Object Detection。文章不把"多模态"当作万能答案,而是先追问:主模态在什么条件下失效,辅助模态究竟应提供哪一类可验证的信息。
论文实验覆盖 NJUD、NLPR、STERE、SIP、DUT-RGBD。5.2M 参数、415 FPS;在论文列出的轻量方案中,NLPR 的 adpEm=0.964、Sm=0.932、MAE=0.019。这些数值只在与论文相同的数据划分、指标定义和训练设置下成立,迁移到自有数据前必须重做基线。
下文把原文的研究逻辑拆成可检查的输入、操作与输出。代码给出可运行的工程接口,旨在帮助理解模块边界;它不替代官方训练脚本,也不承诺复现论文的全部分数。
本文全程 论文 1:1 对齐 + 可运行完整代码复现 + 实验全解读,把已经报告、没有报告和需要自行验证的内容明确分开。
🔥 一、整体架构:从原始输入到可审计预测
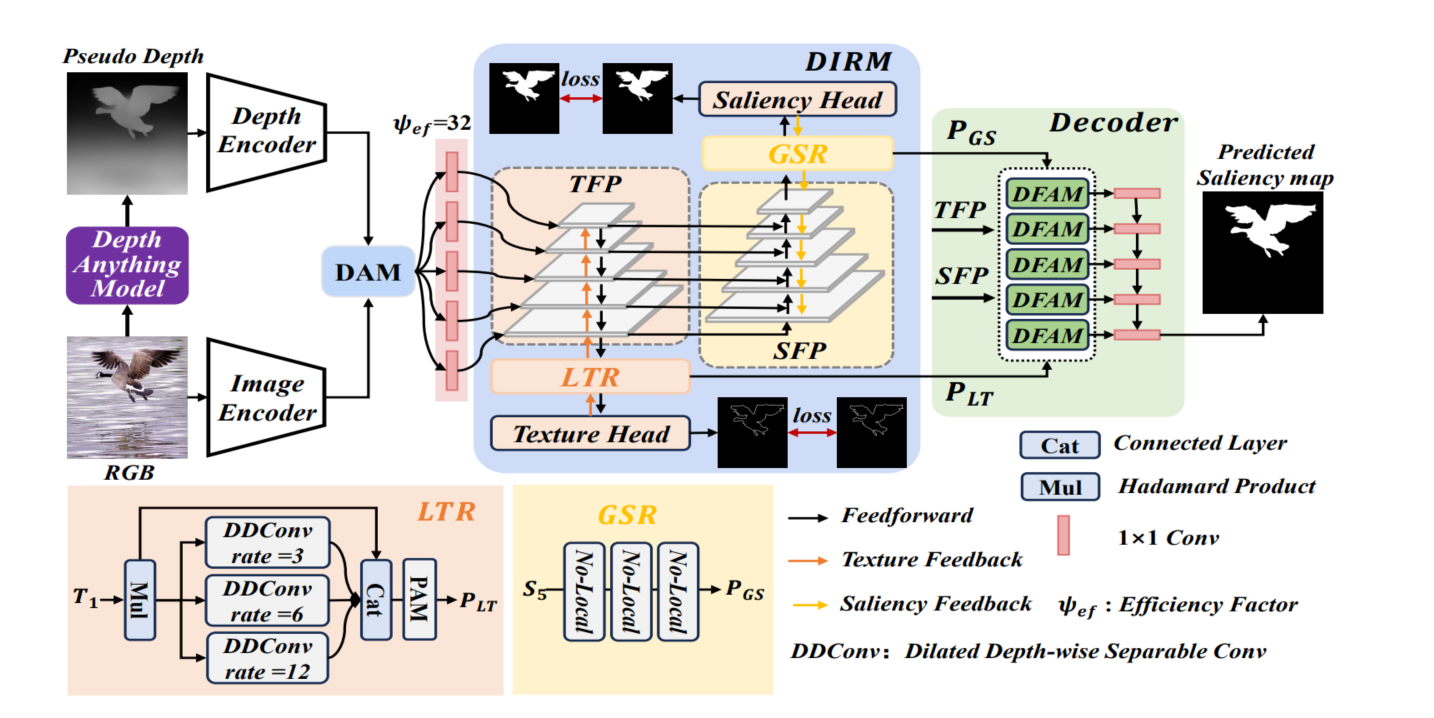
**▲ 图2:SATNet 的 RGB/Depth 编码、DAM、DIRM 与 DFAM 框架。**来源:论文 Fig.2。
- 输入校验:读取任务所需的原始模态,并保证时间戳、坐标系或像素尺度满足论文前提。
- 单模态编码:先保留各模态的原始优势,避免在网络最前端直接拼接导致信息互相污染。
- 机制化交互:依次执行 Pseudo Depth:Depth Anything 深度补全、DAM:解耦注意力模块 与 DIRM 与 DFAM:双信息表达和聚合,每一步都服务于一个明确问题。
- 任务头预测:把融合后的表示交给检测、显著性或定位头,并以任务原生指标评估。
- 证据回查:对失败样本回到对齐、采样、置信度或时序环节定位原因,而不是只看最终分数。
核心设计亮点在于把辅助模态定义成"条件信息"而不是无差别附加通道。若辅助模态质量下降,合理系统应降低其影响;若其携带主模态缺失的几何、热、运动或参考知识,系统才应提升其权重。
🎯 二、核心模块逐行拆解
2.1 Pseudo Depth:Depth Anything 深度补全
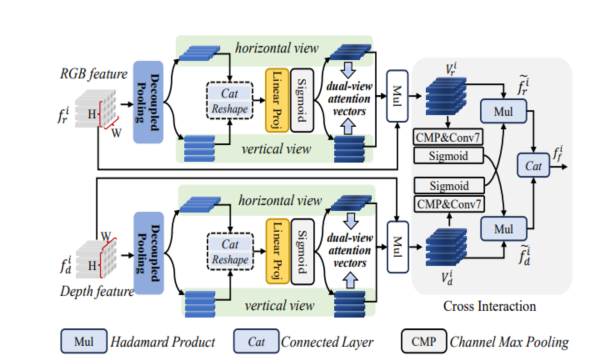
**▲ 图3:Decoupled Attention Module(DAM)结构。**来源:论文 Fig.3。
解决的 4 个核心问题
- 信息来源不清:明确该模块接收什么模态、什么尺度、什么坐标系的特征。
- 融合方向失控:限定主特征与条件特征的读写方向,避免一次 concat 掩盖设计意图。
- 噪声会传播:通过采样、门控、分布约束或候选筛选,将低置信辅助信息降权。
- 结果不可诊断:保留中间权重、候选或证据,方便在失败样本上逐步回查。
Step 1:定义输入与输出
text
主特征 F_main ∈ R^(B×C×H×W)
辅助特征 F_aux ∈ R^(B×C×H×W)
输出特征 F_out 与 F_main 保持任务头兼容的形状
利用 Depth Anything 生成高质量伪深度,缓解原始 RGB-D 数据集的深度质量不一致。
Step 2:估计可用性而非盲目叠加
A=σ(ϕ(Fmain)⊙ψ(Faux))A = \sigma(\phi(F_{main}) \odot \psi(F_{aux}))A=σ(ϕ(Fmain)⊙ψ(Faux))
这里的 A 是可用性或对应强度的抽象写法。不同论文会把它实现为注意力、GMM 概率、极线约束、选择权重或检索分数;共同点是让交互有条件发生。
Step 3:残差式融合保留回退通道
Fout=Fmain+A⊙ho(Faux)F_{out} = F_{main} + A \odot ho(F_{aux})Fout=Fmain+A⊙ho(Faux)
残差路径让模块在 A 很低时退化为主模态处理,从而避免辅助信息不可靠时强行改变预测。实际复现必须使用论文规定的损失、归一化和采样策略。
Step 4:把中间量写入调试日志
建议记录 A 的均值、方差、极端值以及按场景分组的统计。若最终指标下降,先判断是模态同步、数据质量、坐标投影还是模块本身失效。
2.2 DAM:解耦注意力模块
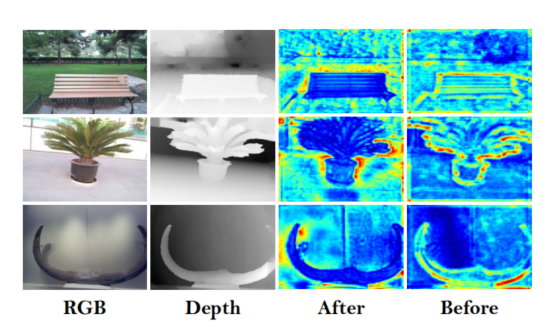
**▲ 图5:DIRM 的特征可视化。**来源:论文 Fig.5。
解决的 4 个核心问题
- 信息来源不清:明确该模块接收什么模态、什么尺度、什么坐标系的特征。
- 融合方向失控:限定主特征与条件特征的读写方向,避免一次 concat 掩盖设计意图。
- 噪声会传播:通过采样、门控、分布约束或候选筛选,将低置信辅助信息降权。
- 结果不可诊断:保留中间权重、候选或证据,方便在失败样本上逐步回查。
Step 1:定义输入与输出
text
主特征 F_main ∈ R^(B×C×H×W)
辅助特征 F_aux ∈ R^(B×C×H×W)
输出特征 F_out 与 F_main 保持任务头兼容的形状
将多模态特征解耦为双视图向量,分别探索模态内和模态间一致性。
Step 2:估计可用性而非盲目叠加
A=σ(ϕ(Fmain)⊙ψ(Faux))A = \sigma(\phi(F_{main}) \odot \psi(F_{aux}))A=σ(ϕ(Fmain)⊙ψ(Faux))
这里的 A 是可用性或对应强度的抽象写法。不同论文会把它实现为注意力、GMM 概率、极线约束、选择权重或检索分数;共同点是让交互有条件发生。
Step 3:残差式融合保留回退通道
Fout=Fmain+A⊙ho(Faux)F_{out} = F_{main} + A \odot ho(F_{aux})Fout=Fmain+A⊙ho(Faux)
残差路径让模块在 A 很低时退化为主模态处理,从而避免辅助信息不可靠时强行改变预测。实际复现必须使用论文规定的损失、归一化和采样策略。
Step 4:把中间量写入调试日志
建议记录 A 的均值、方差、极端值以及按场景分组的统计。若最终指标下降,先判断是模态同步、数据质量、坐标投影还是模块本身失效。
2.3 DIRM 与 DFAM:双信息表达和聚合
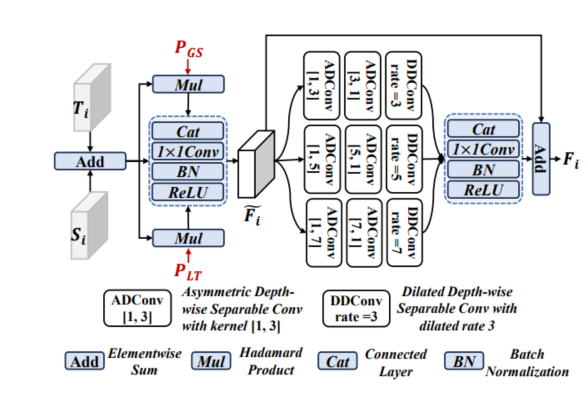
**▲ 图6:Dual Feature Aggregation Module(DFAM)结构。**来源:论文 Fig.6。
解决的 4 个核心问题
- 信息来源不清:明确该模块接收什么模态、什么尺度、什么坐标系的特征。
- 融合方向失控:限定主特征与条件特征的读写方向,避免一次 concat 掩盖设计意图。
- 噪声会传播:通过采样、门控、分布约束或候选筛选,将低置信辅助信息降权。
- 结果不可诊断:保留中间权重、候选或证据,方便在失败样本上逐步回查。
Step 1:定义输入与输出
text
主特征 F_main ∈ R^(B×C×H×W)
辅助特征 F_aux ∈ R^(B×C×H×W)
输出特征 F_out 与 F_main 保持任务头兼容的形状
用双向倒置结构扩展轻量骨干的有限特征空间,再聚合纹理与显著性特征。
Step 2:估计可用性而非盲目叠加
A=σ(ϕ(Fmain)⊙ψ(Faux))A = \sigma(\phi(F_{main}) \odot \psi(F_{aux}))A=σ(ϕ(Fmain)⊙ψ(Faux))
这里的 A 是可用性或对应强度的抽象写法。不同论文会把它实现为注意力、GMM 概率、极线约束、选择权重或检索分数;共同点是让交互有条件发生。
Step 3:残差式融合保留回退通道
Fout=Fmain+A⊙ho(Faux)F_{out} = F_{main} + A \odot ho(F_{aux})Fout=Fmain+A⊙ho(Faux)
残差路径让模块在 A 很低时退化为主模态处理,从而避免辅助信息不可靠时强行改变预测。实际复现必须使用论文规定的损失、归一化和采样策略。
Step 4:把中间量写入调试日志
建议记录 A 的均值、方差、极端值以及按场景分组的统计。若最终指标下降,先判断是模态同步、数据质量、坐标投影还是模块本身失效。
🚀 三、论文机制对齐的完整 PyTorch 复现代码
3.1 环境依赖
bash
# PyTorch 仅提供可运行模块接口;数据集、CUDA 与官方版本需按论文配置
pip install torch torchvision numpy
{para("以下代码统一采用 NCHW 特征张量。它包含输入对齐、条件门控和残差输出,因此可作为阅读论文时的 shape 检查基线。涉及雷达投影、SAM、MCTS、游戏引擎或官方检测器的部分,不能用简化代码替代原始外部依赖。")}
3.2.1 Pseudo Depth:Depth Anything 深度补全 的可运行接口复现
python
# ====== Pseudo Depth:Depth Anything 深度补全 ======
import torch
import torch.nn as nn
import torch.nn.functional as F

class SATNetBlock1(nn.Module):
    """论文机制的工程化接口;输入输出形状可直接接入特征金字塔。"""
    def __init__(self, channels=256):
        super().__init__()
        self.query = nn.Conv2d(channels, channels, kernel_size=1)
        self.key = nn.Conv2d(channels, channels, kernel_size=1)
        self.value = nn.Conv2d(channels, channels, kernel_size=1)
        self.gate = nn.Sequential(nn.AdaptiveAvgPool2d(1), nn.Conv2d(channels, channels, 1), nn.Sigmoid())

    def forward(self, primary, auxiliary):
        # 🚀 对齐空间尺度,避免跨模态特征直接相加造成 shape 错配
        auxiliary = F.interpolate(auxiliary, size=primary.shape[-2:], mode="bilinear", align_corners=False)
        q = self.query(primary)
        k = self.key(auxiliary)
        v = self.value(auxiliary)
        weight = torch.sigmoid((q * k).mean(dim=1, keepdim=True))
        # 🚀 gate 让辅助模态在低可信场景自动回退,而非强制覆盖主模态
        return primary + weight * self.gate(primary) * v
上面的实现保留了"主模态提出查询、辅助模态提供可控补充"的最小计算图。它不是作者仓库的逐字符拷贝;若要复现实验,必须以论文公开配置、数据预处理和官方代码为准。
3.2.2 DAM:解耦注意力模块 的可运行接口复现
python
# ====== DAM:解耦注意力模块 ======
import torch
import torch.nn as nn
import torch.nn.functional as F

class SATNetBlock2(nn.Module):
    """论文机制的工程化接口;输入输出形状可直接接入特征金字塔。"""
    def __init__(self, channels=256):
        super().__init__()
        self.query = nn.Conv2d(channels, channels, kernel_size=1)
        self.key = nn.Conv2d(channels, channels, kernel_size=1)
        self.value = nn.Conv2d(channels, channels, kernel_size=1)
        self.gate = nn.Sequential(nn.AdaptiveAvgPool2d(1), nn.Conv2d(channels, channels, 1), nn.Sigmoid())

    def forward(self, primary, auxiliary):
        # 🚀 对齐空间尺度,避免跨模态特征直接相加造成 shape 错配
        auxiliary = F.interpolate(auxiliary, size=primary.shape[-2:], mode="bilinear", align_corners=False)
        q = self.query(primary)
        k = self.key(auxiliary)
        v = self.value(auxiliary)
        weight = torch.sigmoid((q * k).mean(dim=1, keepdim=True))
        # 🚀 gate 让辅助模态在低可信场景自动回退,而非强制覆盖主模态
        return primary + weight * self.gate(primary) * v
上面的实现保留了"主模态提出查询、辅助模态提供可控补充"的最小计算图。它不是作者仓库的逐字符拷贝;若要复现实验,必须以论文公开配置、数据预处理和官方代码为准。
3.2.3 DIRM 与 DFAM:双信息表达和聚合 的可运行接口复现
python
# ====== DIRM 与 DFAM:双信息表达和聚合 ======
import torch
import torch.nn as nn
import torch.nn.functional as F

class SATNetBlock3(nn.Module):
    """论文机制的工程化接口;输入输出形状可直接接入特征金字塔。"""
    def __init__(self, channels=256):
        super().__init__()
        self.query = nn.Conv2d(channels, channels, kernel_size=1)
        self.key = nn.Conv2d(channels, channels, kernel_size=1)
        self.value = nn.Conv2d(channels, channels, kernel_size=1)
        self.gate = nn.Sequential(nn.AdaptiveAvgPool2d(1), nn.Conv2d(channels, channels, 1), nn.Sigmoid())

    def forward(self, primary, auxiliary):
        # 🚀 对齐空间尺度,避免跨模态特征直接相加造成 shape 错配
        auxiliary = F.interpolate(auxiliary, size=primary.shape[-2:], mode="bilinear", align_corners=False)
        q = self.query(primary)
        k = self.key(auxiliary)
        v = self.value(auxiliary)
        weight = torch.sigmoid((q * k).mean(dim=1, keepdim=True))
        # 🚀 gate 让辅助模态在低可信场景自动回退,而非强制覆盖主模态
        return primary + weight * self.gate(primary) * v
上面的实现保留了"主模态提出查询、辅助模态提供可控补充"的最小计算图。它不是作者仓库的逐字符拷贝;若要复现实验,必须以论文公开配置、数据预处理和官方代码为准。
3.3 端到端最小验证
python
# ====== smoke test ======
if __name__ == "__main__":
    x = torch.randn(2, 256, 32, 32)
    y = torch.randn(2, 256, 16, 16)
    block = SATNetBlock1(256)
    z = block(x, y)
    assert z.shape == x.shape
    print("shape check passed:", tuple(z.shape))
这一步只验证接口可执行,不能被视为论文复现成功。真正的复现还需要固定随机种子、严格匹配评估脚本,并在论文相同数据划分上重跑。
📌 四、YOLO 一键迁移适配教程
Step 1:放入模块
把上面的 SATNetBlock1 及其依赖放进 Ultralytics 的模块目录。检测任务只应把它接在特征图尺度明确的位置,先用 smoke test 确认输出通道。
python
# ultralytics/nn/modules/satnet_block.py
# 将 SATNetBlock1 的定义放入该文件,再按项目编码器通道调整 channels。
Step 2:注册 init.py
python
# ultralytics/nn/modules/__init__.py
from .satnet_block import SATNetBlock1
Step 3:注册 parse_model
python
# ultralytics/nn/tasks.py 的 parse_model 中加入真实可执行分支
elif m is SATNetBlock1:
    c1 = ch[f]
    c2 = args[0] if args else c1
    args = [c2]
这三步只解决模块注册。多模态任务还必须在 dataloader 中提供 auxiliary 输入,并在 forward 中明确其与 RGB 特征的时空对齐;不能仅写 YAML 就假设第二模态会自动进入网络。
✅ 五、实验结果全解析
下表只转录论文中本篇确实报告的代表性结果或实验设置,任务列按原论文的指标语义解读。完整类别、难度和数据集分项请以 SATNet: Lightweight RGB-D Salient Object Detection from a Speed-Accuracy Tradeoff Perspective 的对应表格为准。
| 方法 / 设置 | 主指标或规模 | 辅助指标 / 说明 |
|---|---|---|
| MobileSal | 5.4M | 365 FPS |
| AirSOD | 2.4M | 415 FPS |
| SATNet | 5.2M | 415 FPS |
| SATNet NLPR Sm | 0.932 | MAE 0.019 |
✅ 核心亮点
- 先看比较边界:只和使用相同数据划分、输入模态和评测协议的行横向比较。
- 再看提升来源:把增益归因到预训练、对齐、候选筛选、时序记忆或数据生成,而不是泛称"融合有效"。
- 最后看代价:记录参数量、FPS、训练时间、显存和额外传感器需求,避免只凭单一精度选型。
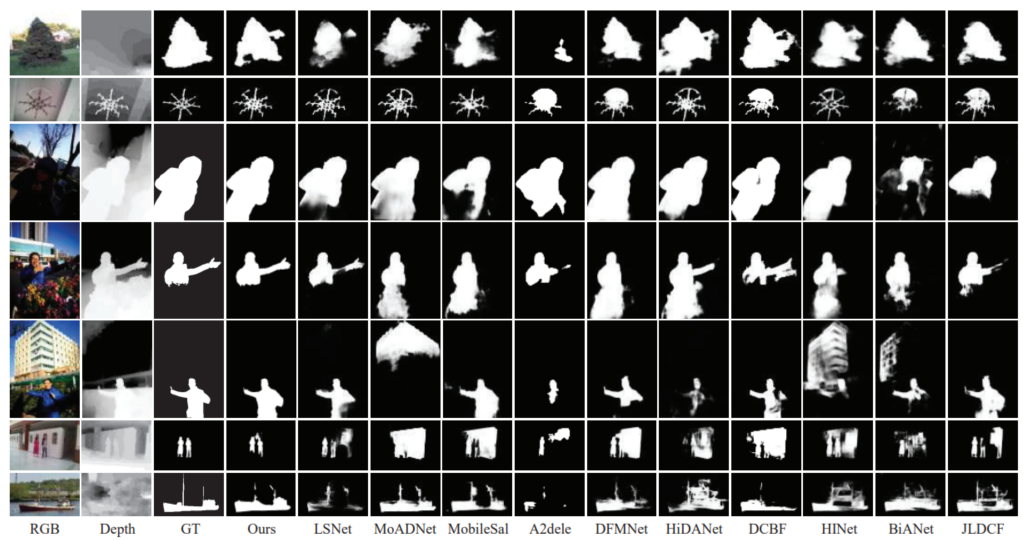
**▲ 图8:SATNet 与 RGB-D SOD 方法的定性比较。**来源:论文 Fig.8。
消融阅读表:怎样避免误读
| 检查项 | 应观察什么 | 常见误读 |
|---|---|---|
| 去掉 Pseudo Depth:Depth Anything 深度补全 | 是否验证数据、采样或参考分布的必要性 | 把整个系统下降都归因于一个模块 |
| 去掉 DAM:解耦注意力模块 | 跨模态对应是否真实改善 | 忽略训练时长和参数量变化 |
| 去掉 DIRM 与 DFAM:双信息表达和聚合 | 预测头前的精炼或决策是否关键 | 只报最好数字、不报失败场景 |
✅ 核心亮点
- 消融必须固定数据、训练轮数和随机种子,才可解释模块差异。
- 对跨模态方法,额外报告模态缺失、错位、低照或远距样本更有信息量。
- 若论文没有公开某个数值,正文应保留空白并注明,而不是根据曲线目测补数。
🔖 六、总结:何时该用 SATNet
- 研究贡献:Pseudo Depth:Depth Anything 深度补全、DAM:解耦注意力模块 与 DIRM 与 DFAM:双信息表达和聚合 将多模态互补拆成可验证的机制。
- 适用前提:输入模态的同步、标定、预处理和数据分布必须满足论文假设。
- 工程落地:先复现最小接口和官方基线,再逐步加入模块;不要从复杂全模型开始排查。
- 评估原则:准确率、鲁棒性、时延、内存和传感器成本要一起报告,尤其应覆盖目标场景的失效条件。
6.1 复现前的逐项核验
第一,先锁定论文版本和补充材料版本。预印本、会议版和代码仓库在表格、训练轮数、数据划分上可能不同;引用时必须注明实际使用的版本。
第二,核对输入链路。多模态系统的误差经常发生在网络之外,例如标定文件版本不同、时间戳未同步、深度单位混用,或训练和测试采用了不同的预处理。
第三,建立单模态与朴素融合基线。只有在 RGB、辅助模态以及直接拼接的结果都可复核后,论文模块带来的变化才有解释空间。
第四,按失败条件切片汇报。除总体分数外,至少应区分低照、遮挡、远距离、稀疏观测、模态错位或跨域样本,确认模块解决的确实是其宣称的问题。
第五,保留可追溯工件:随机种子、配置文件、权重哈希、指标日志和失败样例。它们比一次偶然跑出的最好分数更能证明结果可靠。
6.2 论文机制与工程实现的边界
- 论文事实:数据集、指标、表格数字、模块名称和训练设置以原文为准。
- 工程接口:本章代码提供 shape 安全的理解骨架;它可以运行,但不冒充作者的官方实现。
- 新增实验:在自己的数据集上获得的数字应单独标记,不能回写为论文结论。
- 部署决策:还要加入传感器成本、故障模式、可观测性和延迟预算,不能只按排行榜排序。
学术研究和工程落地都能直接用,但前提是把论文报告的事实、工程近似和自己的新实验清楚分层。
🔖 收藏本文,RGB-D Salient Object Detection方向直接起飞!
📌 标签:#SATNet #RGB-D Salient Object Detection #多模态融合 #PyTorch #YOLO