写这个系列之前,我觉着有必要先搞清楚一件事:Kafka 出现之前,世界是什么样的。2010 年 LinkedIn 着手做 Kafka 的时候,ActiveMQ 已经是 Apache 顶级项目,RabbitMQ 从 2007 年发布算起也已流行数年,两个都是久经考验的消息中间件,LinkedIn 内部也并非没有这类系统可用。一家公司明明有现成的消息中间件,还要再造一个,通常说明旧东西在某些场景下真的不好用了。
所以这第一篇我不打算急着开始聊 Kafka,而是想先看看在 Kafka 出现以前的世界究竟是什么样子:
已经有了 ActiveMQ 和 RabbitMQ,LinkedIn 为什么还要造一个 Kafka?它和前两者到底差在哪?
我的结论先放在这里:它们不是同一类东西。ActiveMQ 和 RabbitMQ 是消息中间件,核心关切是「消息怎么从 A 送到 B」;Kafka 的定位叫 Event Streaming------事件流------核心关切是「一份数据怎么被 B、C、D 各自独立地 、可回溯地消费」。二者的出发点有着根本差别。下面我尝试沿着消息模型的演化历史将这条线捋出来。
队列:先解决「交接」问题
消息队列最早的形态很朴素。系统 A 有一件事要系统 B 做,但不想站在原地等它做完------同步调用的毛病大家都有体会:B 挂了 A 跟着挂,B 慢 A 跟着慢,A 和 B 的代码互相认识。于是中间放一条队列,A 把消息丢进去就回去干别的,B 有空的时候取出来处理。
这就是点对点(Point-to-Point)模型:一条队列,一个(或一组等价的)消费者,一条消息只被处理一次。它有个现在看来非常关键的性质:消费者取走消息、处理完、发回确认,Broker 随即把这条消息删掉。消息的生命周期到确认为止。
「消费即删」在这个模型里不是偷懒,是本质。想想队列的典型用法------任务分发:订单系统把发货任务丢给物流系统,这个任务被物流系统确认之后,队列里就不该再有它。一条任务只需要被处理一次,处理完就没有价值了,留着纯粹浪费空间。这个前提成立,「消费即删」就是正确设计。
发布订阅:交接双方解体
跑了一阵子,新需求来了:一条消息,希望多个系统各拿到一份。订单创建之后,计费要记一笔,推荐要更新行为画像,审计要留痕。让订单系统挨个调用一遍?那就回到同步耦合了。让订单系统往三个队列里各发一份?发送方又得认识所有接收方,加一个下游就要改一次上游。
发布订阅(Publish/Subscribe)模型把「接收方是谁」从发送方挪到了 Broker:发送方只管把消息发到一个 Topic(JMS 的叫法,ActiveMQ 是这路的代表)或 Exchange(AMQP 的叫法),谁感兴趣谁来订阅。RabbitMQ 的建模最典型:Producer 永远只面对 Exchange,Exchange 按一组 Binding 规则把消息路由到一个或多个 Queue,Consumer 守着自己的 Queue 收消息。direct、fanout、topic 几种 Exchange 类型给了足够的路由表达能力,「routing key 匹配 order.* 的才给我」这种需求一句话就能建模。
这个模型解耦了收发双方,但它的投递语义没有变:Broker 仍然负责把每条消息主动推(push)到每个订阅者的队列,仍然在消费者确认之后把消息删掉。消息在这些系统里始终是「在途的包裹」------路由能力再强,投递完成,使命就结束了。
那消费者恰好离线怎么办?JMS 有 durable subscriber,RabbitMQ 靠持久化的 Queue 加 Binding:订阅方不在的那段时间,消息先堆在队列里,人回来了接着投。所以严格说,「补齐离线期间的消息」是做得到的。但这个补齐是投递缓冲意义上的:队列按「临时积压」来估计容量,靠 TTL 和长度上限清理堆积,消息一旦被确认就彻底消失。它缓冲的是迟到的投递,不是历史本身。这一点读者朋友们可以先留个印象,后面聊到 LinkedIn 的场景时会反复聊起它。
这两个模型合起来,就是 2010 年之前主流消息中间件的世界。它们为这样的约束设计:路由关系复杂多变、要接各种语言各种协议的客户端、单条消息的投递延迟要低、消息量级中小、一条消息的价值窗口就是「从生产到确认」。在这个约束域内,ActiveMQ 和 RabbitMQ 都是好东西------这点需要明确,这一篇文章并非踩一捧一,新、旧系统并没有所谓的孰优孰劣,只是解决的问题场景有所不同。
LinkedIn 的场景:一份数据,多个买家
然后看 LinkedIn 当时的处境。Kafka 的三位作者(Jay Kreps、Neha Narkhede、Jun Rao)在 2011 年的论文《Kafka: a Distributed Messaging System for Log Processing》里描述了他们面对的活动数据(activity data)管道:用户每一次页面浏览、搜索、点击都是一条事件,而事件的下游站着一整个梯队------Hadoop 数仓每天定时把前一天的数据拉走跑批;搜索索引要秒级跟进增量更新;还有一批实时监控与统计系统盯着同一股流。论文里给过当时的写入量级:每天数百 GB、接近十亿条消息------原文是
"Kafka accumulates hundreds of gigabytes of data and close to a billion messages per day, which we expect will grow significantly"。
写这句话时,系统在生产环境才跑了六个多月。
我们可以将文章中描述的需求同 pub/sub 模型进行比对,忽略量级的问题,可以发现有两处难以满足的地方:
-
下游的消费节奏天差地别。Hadoop 那位一天来一次,一次要拿走昨天的全部;搜索索引要求秒级跟上;监控系统的消费速度又取决于自己的负载。Broker 负责把每条消息推给每个订阅方的话,它就得为每个订阅方维护一份投递进度和积压,以最慢的那个为准管理内存和磁盘------Broker 成了所有下游速度的公约数。在日均十亿条的基数上,「为每个下游各复制一份并跟踪投递」是一笔不可小觑的开销。
-
最要命的:消费过就删。数仓凌晨的 job 跑挂了,想重跑一遍昨天的数据------数据在被确认消费的时候就没了;要接一个新的实时分析系统,想先喂一遍历史数据暖机------同样没门。对任务型消息来说「处理过一次就扔」是对的,但对这些行为事件来说,处理过不代表数据失去了价值------恰恰相反,换一个问法,它还能再回答一次。
论文在 Related Work 里把两类既有系统都诟病了一遍:企业消息系统不以吞吐为主要设计约束------JMS 连把多条消息并成一个请求的 API 都没有,每条消息要跑一趟完整的 TCP 往返,而且它们假设消息几乎立即被消费,积压一多性能明显下降;日志聚合系统有吞吐,却为离线装载设计,push 模型的数据推送速度甚至可以超过消费者的消费能力。所以摘要里他们的自我定位是两头兼得:
"incorporates ideas from existing log aggregators and messaging systems"。
我对此的理解是:LinkedIn 手里的不是「待投递的消息」,是「刚发生的事实」。事实不需要被投递给谁,事实需要被保留下来,谁要谁来读。pub/sub 是快递公司,而 LinkedIn 需要的是图书馆。
换一个角度
于是 Kafka 换了一个出发点:不从「怎么把消息送到消费者手上」出发,而从「怎么让一份数据流被多方持续消费」出发。落到具体的设计上,体现为下面三点,每一点都可以解决上面描述的某个痛点问题。
-
消息保留。Producer 写入的消息落在 Log 上,不因为任何人消费过而删除,retention 按时间或大小统一执行(默认七天,可配)。消费行为不再改变数据本身。
-
消费拉取。Broker 不追踪「每个消费者收到哪了」,也不推送------消费者自己来拉(pull),拉多少、多久拉一次,由消费者按自己的节奏定。Hadoop 一天拉一批大的,搜索引擎一秒拉一批小的,互不干扰,Broker 不再当公约数。
-
游标外置。每个 Consumer Group 在逻辑上持有自己的 Offset------「我读到了第几条」。读到哪、要不要拨回去重读,是消费者自己的事。想重跑昨天的数据?把游标拨回去。新系统要暖机?新建一个 Group,游标从最早处开始。
画成图:
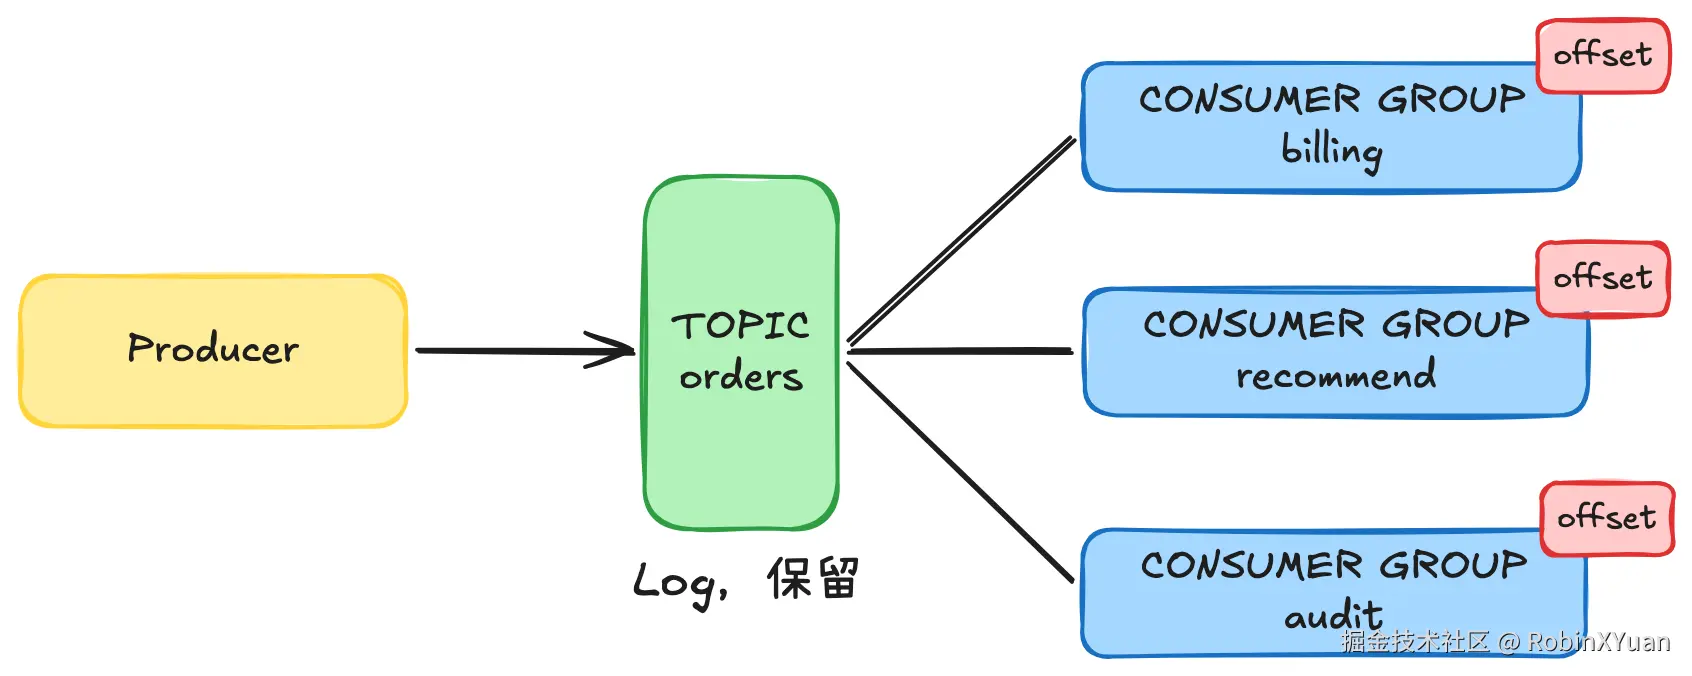
同一个 Topic 只存一份数据;扇出靠「各自持游标」,而非「各自存副本」。任意 Group 都可以把 Offset 拨回最早处,从头重放。
一个 Topic,三个 Group,各自进度,互不干扰;生产方完全无感,只管往 Log 里追加。LinkedIn 的三个痛点------多下游扇出、消费速率悬殊、需要回放------这个模型都可以很好地解决。
这就是 Event Streaming 的含义:事件不是在途的包裹,而是一条持续增长的事实流;「消费」不再是把消息搬走,而是把游标往前挪。Kafka 不是「又一个队列」,在 LinkedIn 手里它的角色是数据总线------整个公司的事件都从这条总线上流过,谁需要谁来接。
这三件事说起来轻巧,每件背后都需要大量机制支撑:Log 凭什么敢一直追加、retention 怎么执行、Offset 存在哪、Consumer Group 怎么管成员------这就是这一系列后面文章中我们要弄清楚的内容,这里先保留疑问,后面跟着源码一一解答。
动手实践
Kafka 出现的背景我们了解清楚了,为了有一个更直观的认识,我们假定一个场景,然后看看 RabbitMQ 和 Kafka 分别是什么效果。场景就用上文反复出现的:订单事件需要同时送达计费、推荐、审计三个系统。
RabbitMQ:三个 Queue,三份副本
用 Docker 起一个带管理插件的 RabbitMQ。用 curl 调用 15672 端口的 HTTP 管理 API。先给公共参数定义个小函数:
bash
docker run -d --name rabbit -p 5672:5672 -p 15672:15672 rabbitmq:4.3.6-management

api() { curl -s -u guest:guest -H 'content-type: application/json' "$@"; }
URL 里反复出现的 %2F 是默认 vhost / 的 URL 编码,guest:guest 是容器自带的默认账号,只允许本机登录。
用 fanout Exchange 建模「一份事件、三个接收方」:
bash
# fanout 类型的 Exchange:不看 routing key,绑给谁就复制给谁
api -X PUT http://localhost:15672/api/exchanges/%2F/orders -d '{"type":"fanout"}'

# 三条 Queue(4.x 起非持久化的普通 Queue 默认不让声明,所以显式 durable)
api -X PUT http://localhost:15672/api/queues/%2F/billing -d '{"durable":true}'
api -X PUT http://localhost:15672/api/queues/%2F/recommend -d '{"durable":true}'
api -X PUT http://localhost:15672/api/queues/%2F/audit -d '{"durable":true}'

# 三条 Binding:把 Exchange 绑到每条 Queue 上
api -X POST http://localhost:15672/api/bindings/%2F/e/orders/q/billing -d '{"routing_key":""}'
api -X POST http://localhost:15672/api/bindings/%2F/e/orders/q/recommend -d '{"routing_key":""}'
api -X POST http://localhost:15672/api/bindings/%2F/e/orders/q/audit -d '{"routing_key":""}'
关于 Exchange、Queue、Binding 的概念读者可以自行查找资料了解,后续我也会单独协议系列有关 RabbitMQ 的博客,这里不做过多解释,仅使用 RabbitMQ 对比 Kafka。
发两条订单事件,然后站在计费系统的位置消费。get 请求体里的 ack_requeue_false 就是「确认并且不重回队列」,对应 AMQP 的 basic.ack:
bash
api -X POST http://localhost:15672/api/exchanges/%2F/orders/publish \
  -d '{"properties":{},"routing_key":"order","payload":"{\"orderId\":1}","payload_encoding":"string"}'
api -X POST http://localhost:15672/api/exchanges/%2F/orders/publish \
  -d '{"properties":{},"routing_key":"order","payload":"{\"orderId\":2}","payload_encoding":"string"}'
# 两次都返回 {"routed":true}

# 计费系统消费:每次取一条,取走即确认
api -X POST http://localhost:15672/api/queues/%2F/billing/get \
  -d '{"count":1,"ackmode":"ack_requeue_false","encoding":"auto"}'   # 数组里 payload 是 {"orderId":1}
api -X POST http://localhost:15672/api/queues/%2F/billing/get \
  -d '{"count":1,"ackmode":"ack_requeue_false","encoding":"auto"}'   # payload 是 {"orderId":2}
api -X POST http://localhost:15672/api/queues/%2F/billing/get \
  -d '{"count":1,"ackmode":"ack_requeue_false","encoding":"auto"}'   # 返回 []
第三次 get 返回空数组------计费系统确认过的消息,没了。此刻对 audit 那条 Queue 发同样的 get,还能拿到那两条:因为 audit 是另一条 Queue,Broker 为它单独复制了一份。扇出是靠复制做到的,每条 Queue 一份。而计费系统如果发现自己刚才算错了,想把这批订单重新处理一遍------做不到,它那份副本已经清空,audit、recommend 各自的副本帮不了它,Broker 里不存在一份可供它重读的共享数据(除非专门再建一条「备份 Queue」去订阅,那是另一个话题了)。
Kafka:一个 Topic,三个 Group
换 Kafka。4.x 已经是纯 KRaft 模式,单机起一个 Broker 不需要 ZooKeeper。官方镜像 apache/kafka(tag 用 4.3.1,与本系列源码版本一致)内置了一套开箱即用的单机 KRaft 配置:
bash
docker run -d --name kafka -p 9092:9092 apache/kafka:4.3.1run 完等几秒再操作,或者拿 kafka-topics.sh --list 轮询到不再报连接错误为止。镜像默认对外通告的地址就是 localhost:9092,所以宿主机上如果装了 Kafka 客户端,不进容器也能直连;下面的命令统一走 docker exec 进容器执行,本机可以什么都不装。
很多博客会提到 config/kraft/server.properties 在 4.x 已不存在------KRaft 不再是需要单独目录的特殊模式,server.properties 本身就是 KRaft 配置。
接着建 Topic、发消息:
bash
docker exec -it kafka /opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 --create --topic orders

docker exec -it kafka /opt/kafka/bin/kafka-console-producer.sh --bootstrap-server localhost:9092 --topic orders
>{"orderId":1}
>{"orderId":2}计费系统消费。--group 就是 Consumer Group。这里要带上 --from-beginning:新 Group 在 Log 上还没有 Offset,console 工具的默认行为(auto.offset.reset 为 latest)是跳过存量、只等新消息,而计费系统上线就该处理已有订单,所以明确让它从头读:
bash
docker exec -it kafka /opt/kafka/bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 \
  --topic orders --group billing --from-beginning
{"orderId":1}
{"orderId":2}
Ctrl+C 退出,游标已提交。此刻做两个实验:
bash
# 实验一:同一个 Group 再来一次------Offset 已提交,没有新消息
#(--from-beginning 只对没有已提交 Offset 的 Group 生效,这里不起作用)
docker exec -it kafka /opt/kafka/bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 \
  --topic orders --group billing

# 实验二:推荐系统此刻才上线,从头拿------消息都在
docker exec -it kafka /opt/kafka/bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 \
  --topic orders --group recommend --from-beginning
实验二里 recommend 这个 Group 完整拿到了两条消息,而它没有给 Broker 增加任何存储------Log 还是那一份。顺手再起 --group audit --from-beginning,审计系统同样完整拿到,依然还是那份 Log:三个系统、三个 Group、一份数据。
更能说明问题的是第三个实验:让计费系统重算一遍。在 RabbitMQ 那边无处可去的诉求,这里是一条命令(前提是 billing 的 Consumer 都已退出,reset-offsets 拒绝作用于还有活跃成员的 Group):
bash
docker exec kafka /opt/kafka/bin/kafka-consumer-groups.sh --bootstrap-server localhost:9092 \
  --group billing --topic orders --reset-offsets --to-earliest --execute
把 billing 的 Offset 拨回最早处,再起一次同样的 Consumer,两条订单重新消费了一遍。RabbitMQ 里「确认后即消失」的消息,在 Kafka 里是一直躺在 Log 上、随取随用的数据。
本篇的实验脚本归档在 examples/01/ 下,可整段执行(RabbitMQ 侧);Kafka 侧的 console 工具是交互式的,照着脚本逐段敲即可。
对比参照:约束不同,所以设计不同
现在可以正面回答开头的问题了。ActiveMQ / RabbitMQ 与 Kafka 的差异,两者之间的差异本质在于约束不同,需要解决的问题场景不同,故而有着不同的设计实现。
两代系统面对的约束不同。消息中间件的约束是:路由关系复杂(谁收消息由丰富规则决定)、要接入的语言和协议多样、单条消息的投递延迟要低、流量中小、消息的价值在确认后终结。Kafka 面对的约束是:消息量级以十亿计、下游众多且消费速率悬殊、数据在消费之后仍然是资产。
约束推着设计走。前一个约束下,合理的答案是智能 Broker:Exchange 与 Binding 在服务端完成路由,Broker 精心管理每条 Queue 的投递与确认,投递完就删------腾出来的空间马上服务下一条消息,低延迟和复杂路由都是这么换来的。后一个约束下,合理的答案是功能更简单的 Broker 加聪明的客户端:Broker 只做一件事------把消息按顺序追加到 Log 上并保留;路由简化为「Topic + Partition」,扇出与进度全部外置给 Consumer Group,消费用拉取而非推送,好让每个下游按自己的节奏批量取。
所以这不是新旧替代的关系。到今天,路由复杂、流量中小、要求单条低延迟送达的场景,RabbitMQ 依然是称职的选择;一旦需求变成「事件流」、「多下游各自消费」、「要回放要补数」,Kafka 的模型才显出分量。拿 Kafka 去做复杂路由是自找麻烦,拿 RabbitMQ 去扛日志流是难为它。
工程启示
用好 Kafka:选型判据。 决定用哪个之前,先问三个问题:需不需要复杂路由?消息量级多大、要不要回放?下游是一个还是一批?RPC 式的异步化、复杂路由、中小流量,选 RabbitMQ 这类更合适;事件流、扇出、回放、高吞吐,选 Kafka。两个都用也完全正常------它们在真实系统里经常并存。
用好 Kafka:从 RabbitMQ 迁移过来最容易犯的错。 拿 Topic 去对应 Queue:为计费、推荐、审计各建一个 Topic,生产者发三份。正确的对应关系是------RabbitMQ 的 Queue 对应 Kafka 的 Consumer Group,而不是 Topic。「一份事件、多方各自消费」在 Kafka 里就是一个 Topic 加多个 Group。多建 Topic 不仅浪费存储,还把「加一个下游」从「新起一个 Group」变成「改生产者」,等于把解耦又还回去了。
设计借鉴:消费状态外置。 Kafka 把「谁消费到哪了」从 Broker 挪到消费端,换来的是 Broker 与消费者生命周期的彻底解耦:消费者可以挂、可以换、可以随时多一个、可以把游标拨回去,数据侧毫发无损。任何「一对多分发、各自进度」的场景------任务分发、业务消息表、CDC------都可以考虑这个模式:数据只存一份,进度归消费者自己管。
小结
这一篇我们了解了三件事:消息模型从点对点到发布订阅再到 Event Streaming 的演化,每一步是被什么需求推着走的;旧模型为什么不再适用于 LinkedIn 的活动数据管道;Kafka 用「Log 保留 + 拉取 + Offset 外置」三件事回答了 LinkedIn 的难题。
至于 Kafka 内部长什么样,我们还没有触及。
此外,我们还留下了几个问题:
- 凭什么敢把消息一直留在磁盘上?
- 追加写入的 Log 凭什么比想象中快得多?
- 这个「Log」到底是个什么东西------数据库里有它,文件系统里有它,Kafka 里又有它?
下一篇:Everything Is A Log。我们来看看 Log 究竟是什么。