目录
- 开头:
- 一.MySQL的基本认识
-
- 1.架构与连接方式:
- [2. 服务器、数据库、表的关系](#2. 服务器、数据库、表的关系)
- 3.存储引擎
- 4.SQL语言的四大分类
- [二.DDL(Date Define Language)](#二.DDL(Date Define Language))
-
- [1. 数据库的操作](#1. 数据库的操作)
- 2.数据表的操作
- [三. 数据类型](#三. 数据类型)
-
- 1.数值类型
-
- [(1)BIT 位类型](#(1)BIT 位类型)
- (2)小数类型
-
- [a. float](#a. float)
- [b. double 双精度浮点型](#b. double 双精度浮点型)
- [c.decimal 定点数](#c.decimal 定点数)
- 2.字符串类型
-
- [(1)char 定长字符串](#(1)char 定长字符串)
- [(2)varchar 变长字符串](#(2)varchar 变长字符串)
- [(3)text 与 blob系列](#(3)text 与 blob系列)
- 3.日期和时间类型
- [4. enum 枚举 和 set 集合](#4. enum 枚举 和 set 集合)
- 四.表的约束
- 结尾
- 往期回顾
开头:
Ok了,大家好久不见,前面我们一起通过15期的博客,完成了对Linux系统/网络的系统学习,接下来我们要进入到一个全新的板块------MySQL,废话不多说,我们直接开始。
在编程开发中,数据存储是贯穿整个系统的核心环节。最初我们可以用普通文件来保存数据,但随着业务复杂度提升,文件在查询效率、数据管理、安全性和并发控制上的短板愈发明显。数据库正是为解决这些问题而生的一套专业数据存储与管理解决方案
为什么需要数据库??
日常开发中,普通文件也能存储数据,但存在天然的短板:
- 安全性不足:文件很难实现精细的权限控制、数据防护
- 查询与管理低效:检索特定数据需要全量遍历,无法快速筛选与统计
- 不适合海量数据:文件难以支撑大规模数据的扩展、维护与并发访问
- 程序控制复杂:代码中操作文件需要处理大量底层 IO 逻辑,开发维护成本高
数据库的本质,是一套专门用于数据存储与管理的解决方案:使用者只需要通过 SQL 语句提出字段、条件、排序等需求,数据库服务就会自主完成底层的存储、检索、优化,最终直接返回结果,开发者无需直接操作原始数据文件
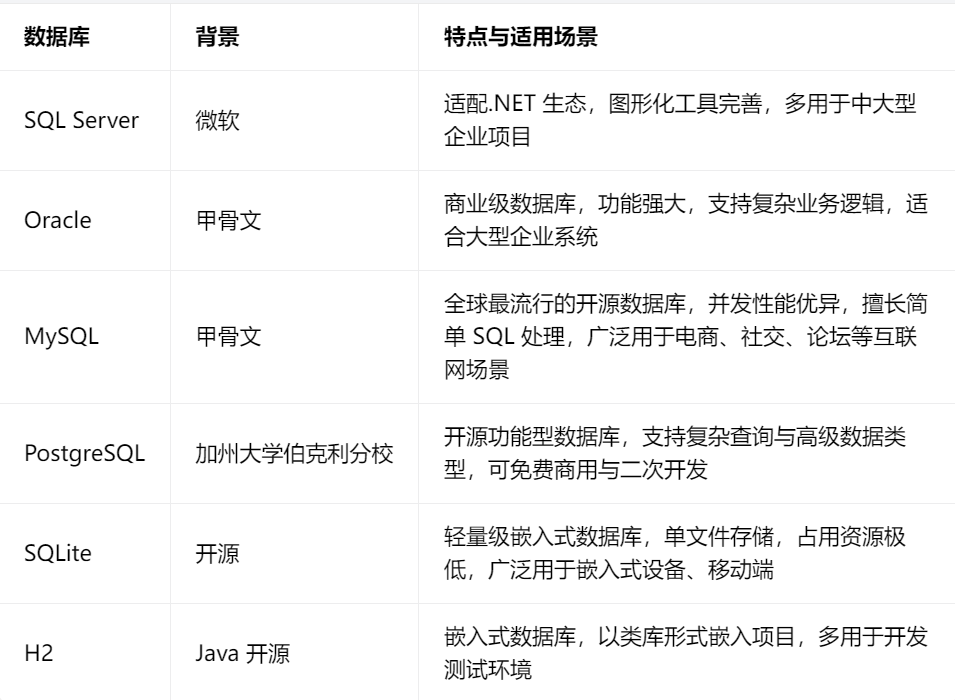
目前主流的数据库:
一.MySQL的基本认识
1.架构与连接方式:
MySQL 采用C/S(客户端/服务端)架构:
- 客户端(mysql):开发者通过客户端输入SQL,向服务端发送操作请求
- 服务端(mysqld):后台守护进程,负责接收请求、解析SQL、查询优化、执行数据操作
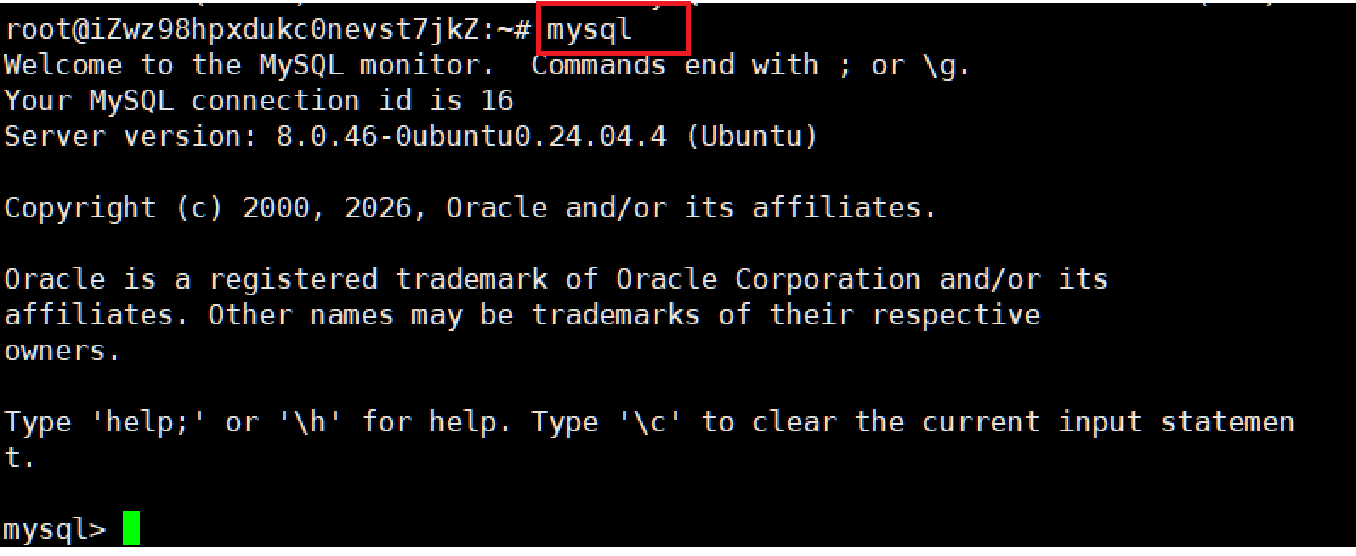
连接命令:
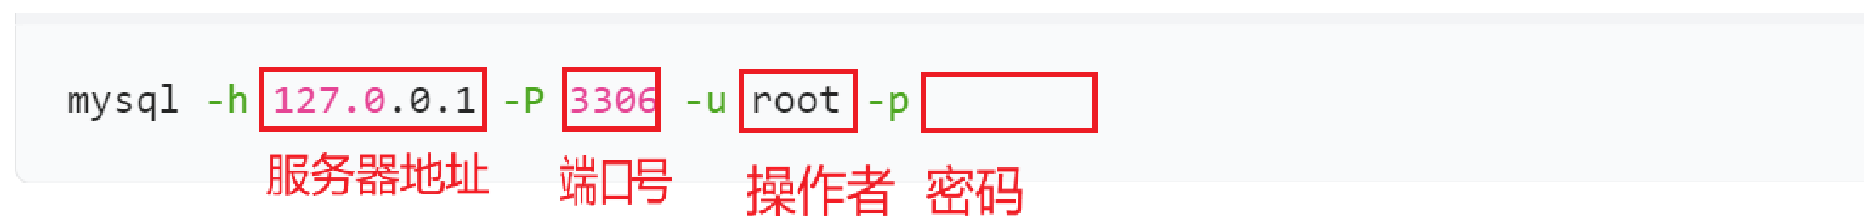
不写-h默认连接本地,不写-P默认使用 3306 端口
2. 服务器、数据库、表的关系
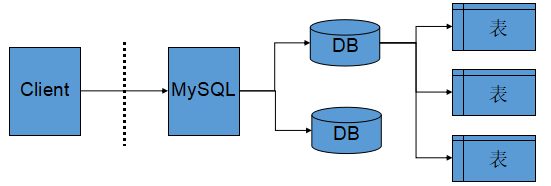
- MySQL数据库服务器
也就是我们常常说的"安装MySQL",本质上就是在机器上安装一套数据库管理系统程序,它是整个体系的核心管理者,负责:
- 接收并验证客户端的连接请求
- 解析、执行SQL指令
- 统一管理其下所有的数据库、控制权限、资源分配
- 一台物理机上可以运行一套MySQL服务实例,同时管理多个独立的数据库
- 数据库(DB/DataBases)
是数据表的''容器'',隶属于MySQL服务器
- 开发规范上,一个应用 / 一个业务对应着一个数据库 ,例如电商项目创建
shop库、博客项目创建blog库 - 不同数据库之间相互隔离,互不影响
- 数据表(Table)
是数据存储的最小单元,隶属于某一个数据库
- 同一个数据库中的每一张表对应同一个业务的一个实体,比如用户表、商品表、订单表
- 表以 "行 + 列" 的二维结构组织数据,一行对应一条完整的实体数据,一列对应该实体的一个属性
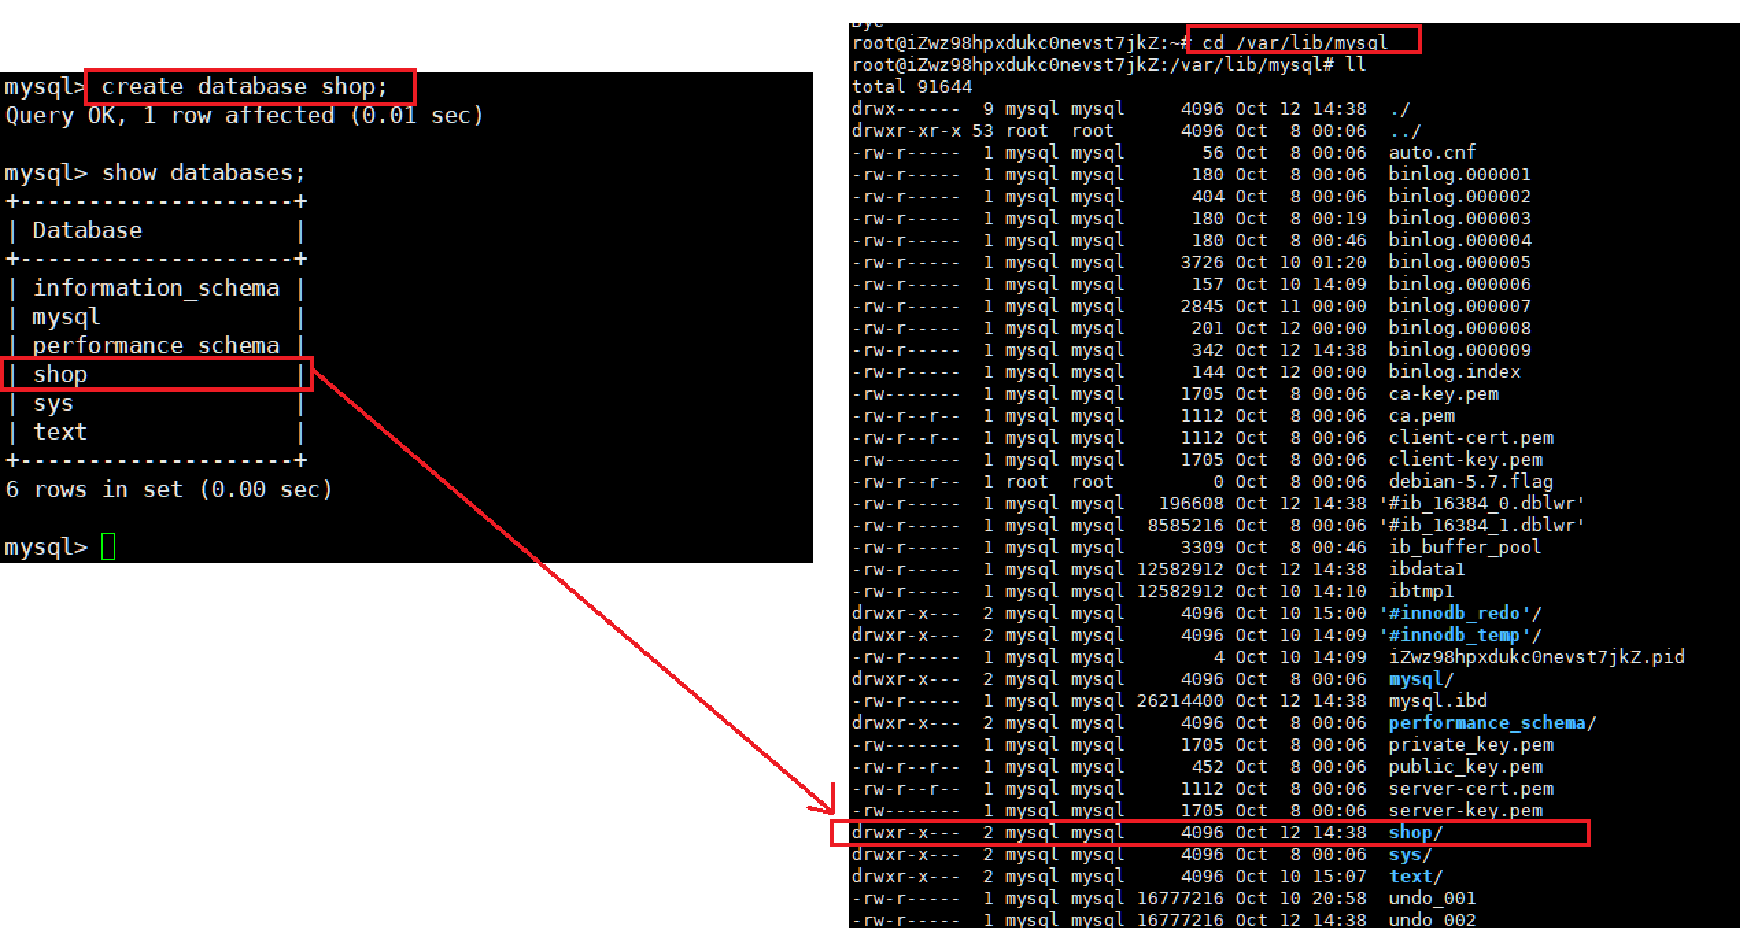
如果把上面的【逻辑层级关系】对应到Linux的磁盘文件上来,/var/lib/mysql/就是 MySQL 服务器默认的数据根目录(datadir)
在/var/lib/mysql 这个目录中:
对应「数据库(DB)」------ 一级子目录
逻辑上的每一个数据库,在磁盘上就是一个同名的文件夹 ,直接放在/var/lib/mysql目录下
- 比如执行 SQL
CREATE DATABASE shop;,系统就会在/var/lib/mysql/下创建一个shop文件夹 - 不同数据库的文件相互隔离,和逻辑上的库隔离完全对应,这也是 "一个应用对应一个数据库" 的物理体现
对应「数据表(Table)」------ 库目录内的文件
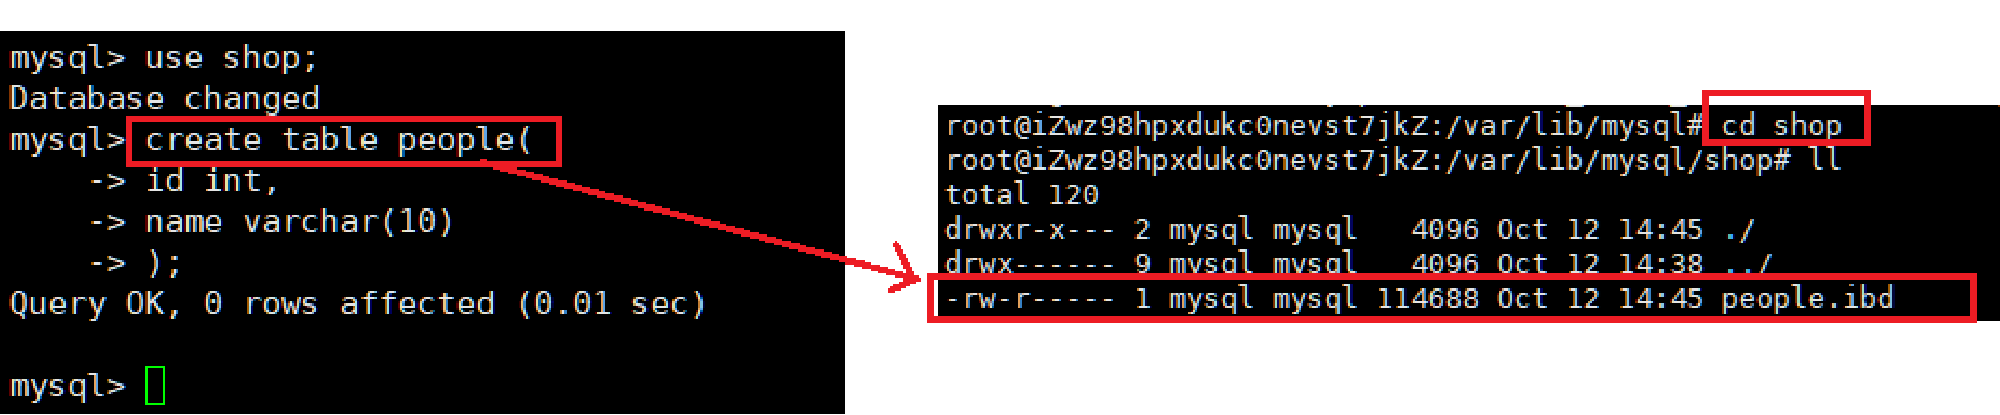
进入某个数据库的文件夹(比如/var/lib/mysql/shop),里面的文件就对应一张张数据表。具体文件格式和表的存储引擎强相关
3.存储引擎
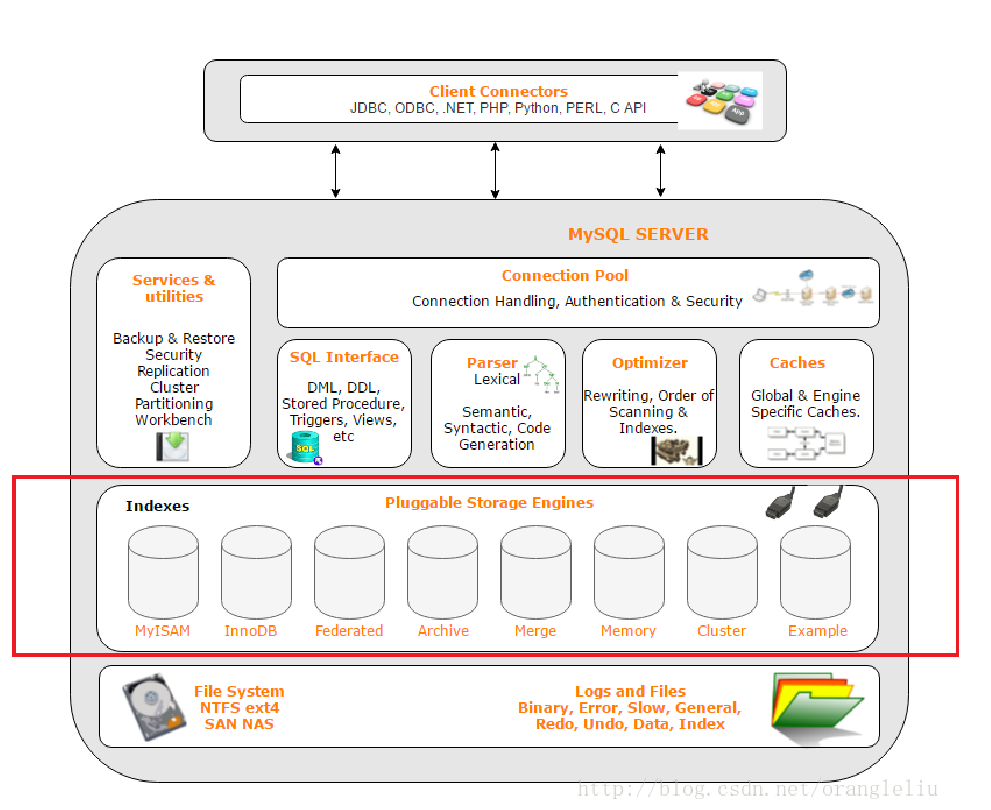
存储引擎是:数据库管理系统如何存储数据、如何为存储的数据建立索引和如何更新、查询数据等技术
的实现方法
MySQL的核心就是插件式存储引擎,支持多种存储引擎
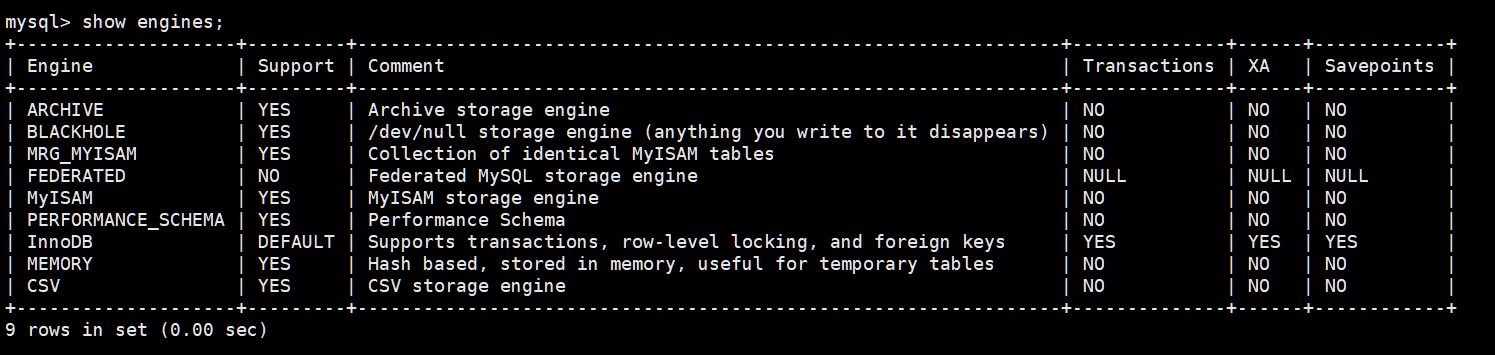
查看所有支持的引擎:SHOW ENGINES;
4.SQL语言的四大分类
SQL(结构化查询语言)按功能分为四类:
- DDL(数据定义语言):维护数据的存储结构
- DML(数据操纵语言) :对表中数据进行增删改
- 其中数据查询单独称为DQL(数据查询语言)
- DCL(数据控制语言):负责权限管理与事务控制
二.DDL(Date Define Language)
1. 数据库的操作
(1)创建数据库
语法格式(忽略大小写)
CREATE DATABASE [IF NOT EXISTS] 数据库名
[DEFAULT CHARACTER SET 字符集名]
[DEFAULT COLLATE 校验规则名];
IF NOT EXISTS:可选,数据库不存在时才创建,避免重复创建报错CHARACTER SET:指定数据库字符集,决定数据的编码方式COLLATE:指定字符集的校验规则,影响字符串的比较、排序
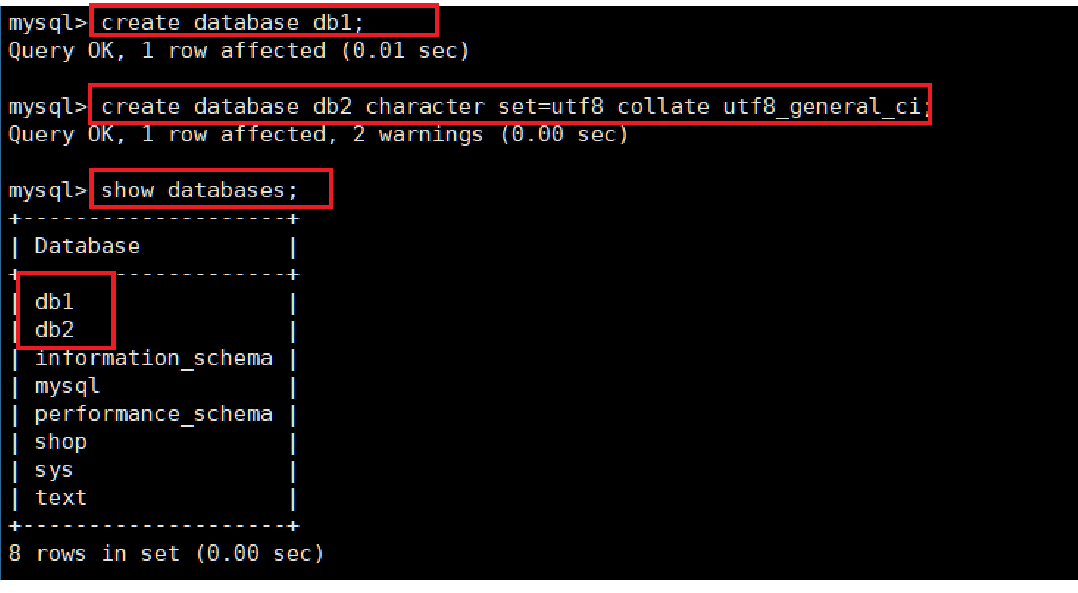
character set = XXX 也可以写成 charset = XXX
(2)字符集与校验规则
核心作用
- 字符集:定义字符的编码方式,决定数据库能存储哪些语言文字
- 校验规则:定义字符串的比较、排序逻辑,是字符集的配套规则
校验规则的实际影响
以utf8_general_ci(不区分大小写)和utf8_bin(区分大小写)为例:
- 查询差异 :不区分大小写时,
WHERE name='a'会同时匹配a和A;区分大小写时只会精确匹配小写a - 排序差异 :不区分大小写排序为
a、A、b、B;区分大小写按 ASCII 码排序为A、B、a、b
相关查看命令
-- 查看当前数据库默认字符集
SHOW VARIABLES LIKE 'character_set_database';
-- 查看当前数据库默认校验规则
SHOW VARIABLES LIKE 'collation_database';
-- 查看支持的所有字符集
SHOW CHARSET;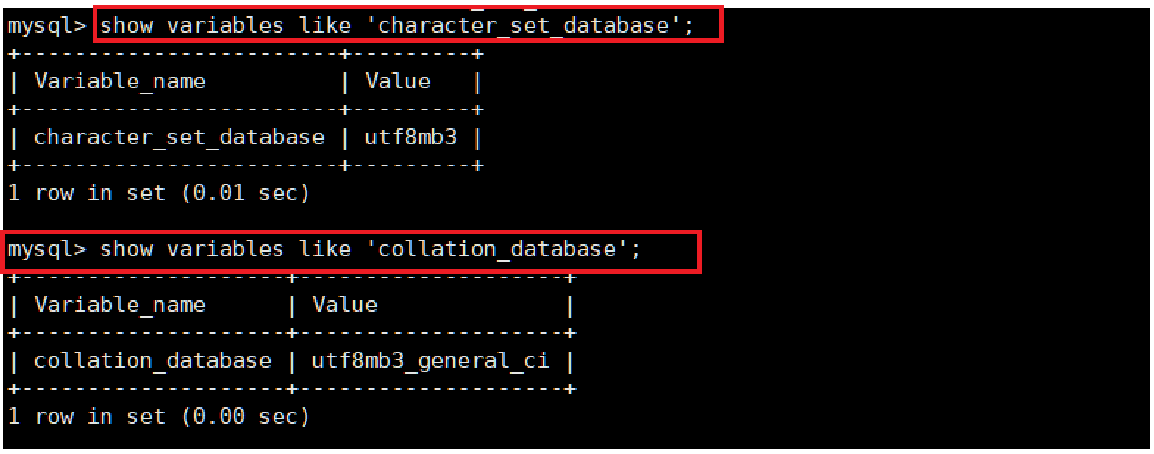
(3)数据库的查看、修改与删除
查看数据库
-- 查看当前所有数据库
SHOW DATABASES;
-- 查看指定数据库的完整创建语句
SHOW CREATE DATABASE 数据库名;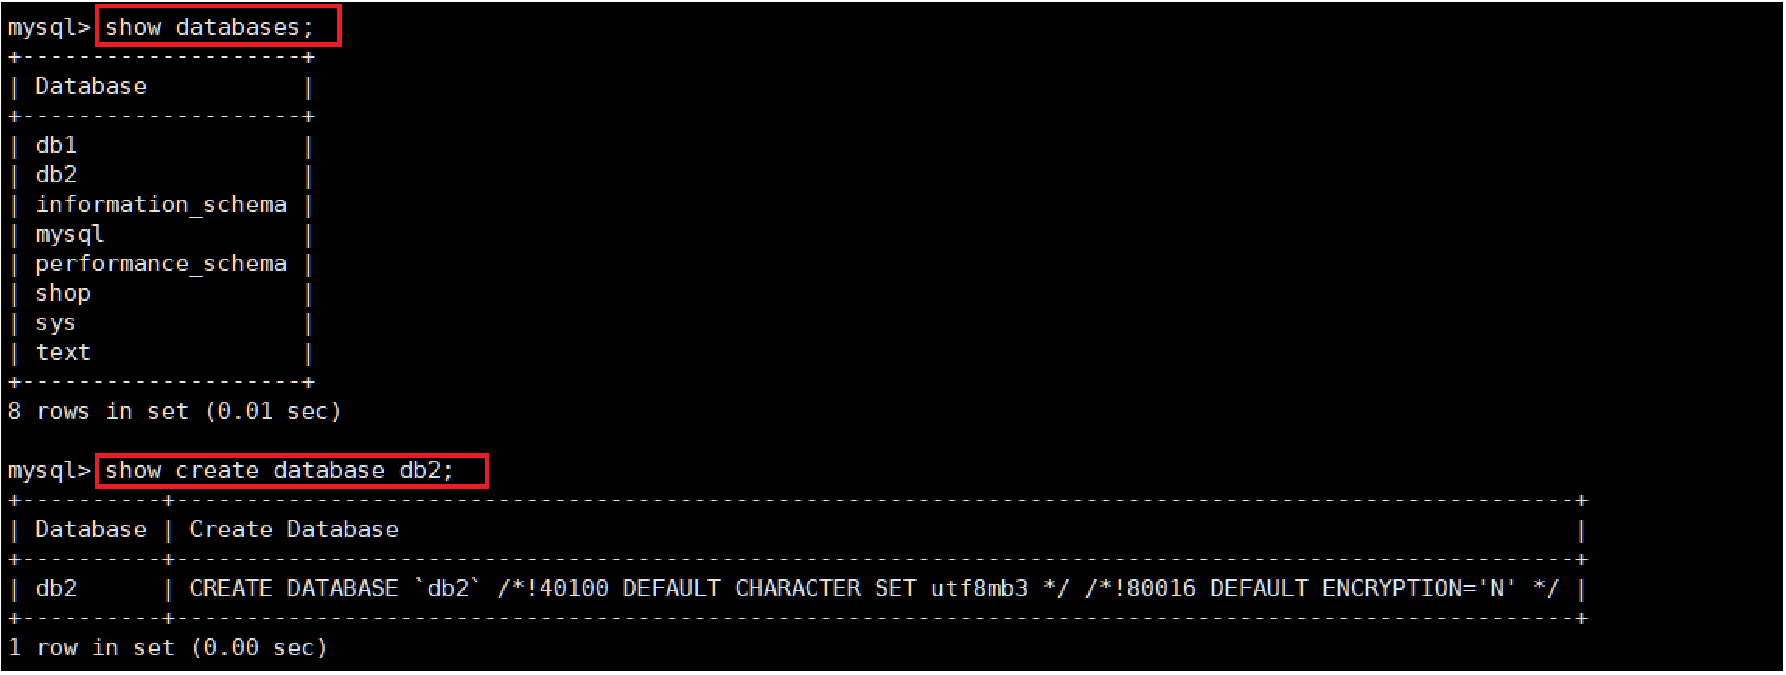
修改数据库
主要用于修改字符集和校验规则:
ALTER DATABASE 数据库名 CHARSET=gbk;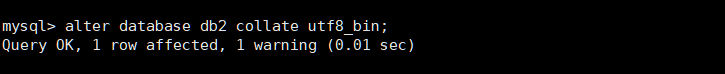
删除数据库
DROP DATABASE [IF EXISTS] 数据库名;注意:删除数据库会级联删除库中所有表和数据,操作不可逆。
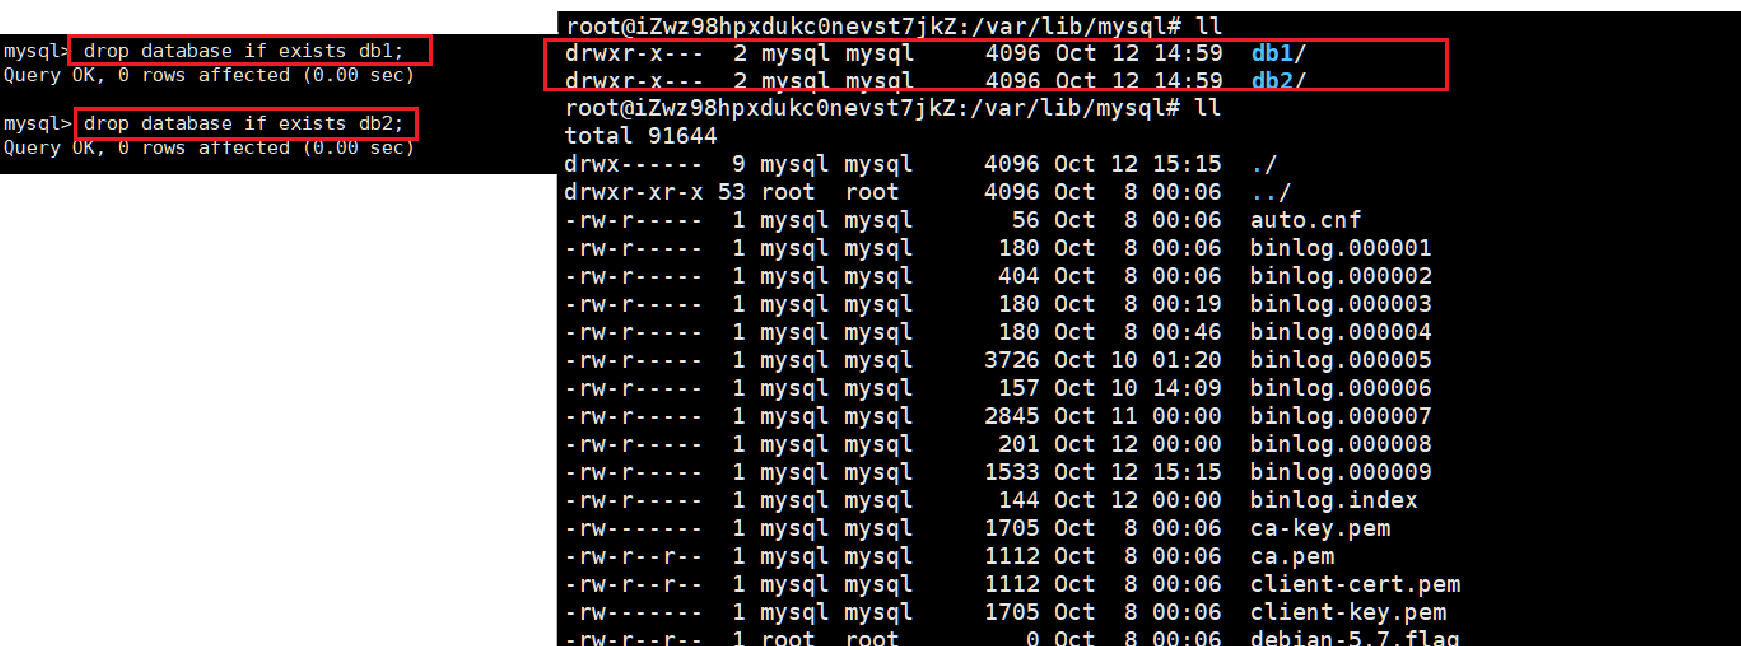
执行删除之后的结果:
- 数据库内部看不到对应的数据库
- 对应的数据库文件夹被删除,级联删除,里面的数据表全部被删
(4)数据库的备份与恢复
备份(系统命令行执行)
# 备份单个完整数据库
mysqldump -P3306 -u root -p密码 -B 数据库名 > 备份文件路径.sql

# 备份数据库中的单张表
mysqldump -u root -p 数据库名 表名 > 备份文件路径.sql

# 同时备份多个数据库
mysqldump -u root -p -B 数据库1 数据库2 > 备份文件路径.sql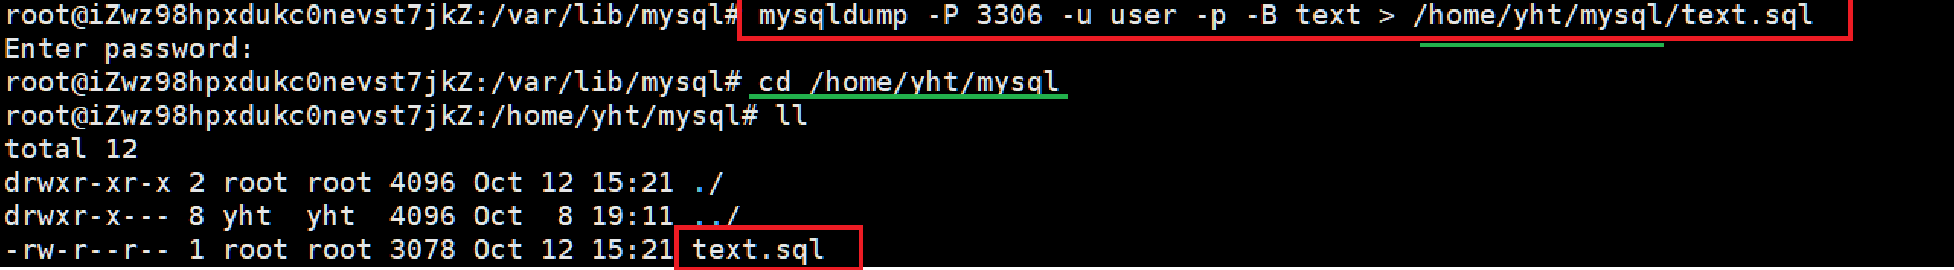
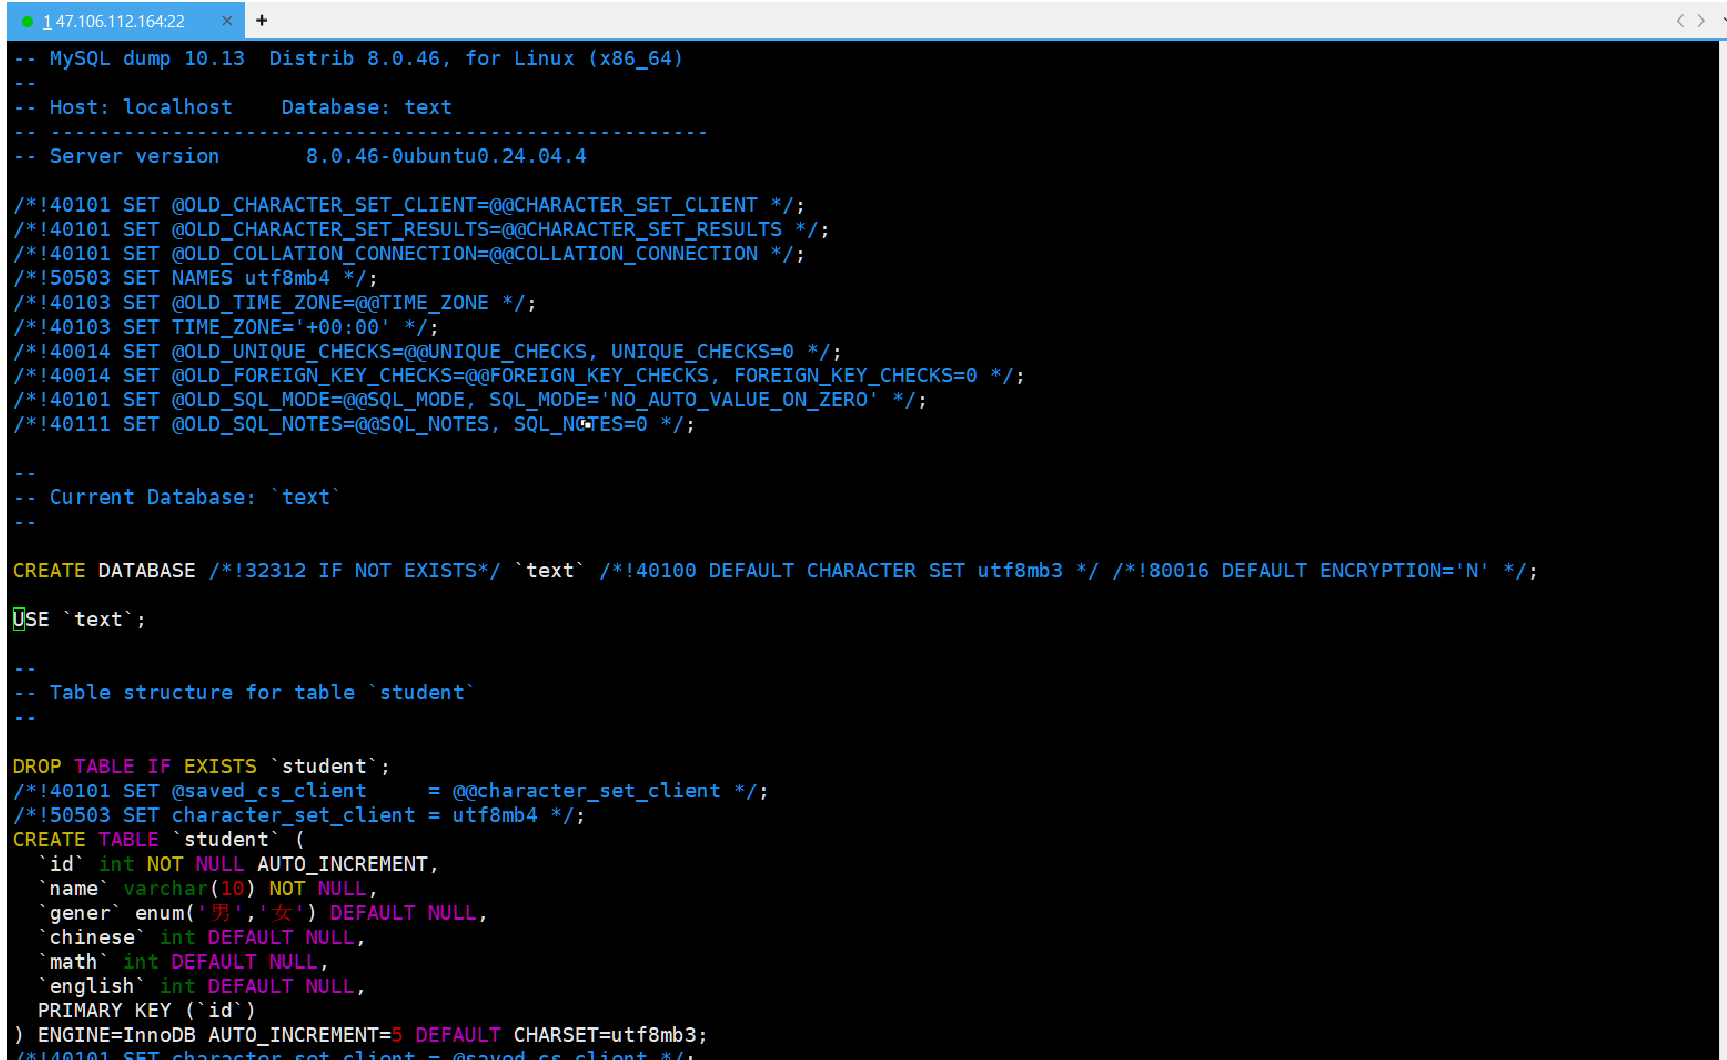
其中 .sql 文件中的内容就是历史上对这个库/表的操作指令
恢复(登录 MySQL 后执行)
-- 先进入对应数据库(备份未加-B参数时,需先创建空数据库并use)
SOURCE 备份文件路径.sql;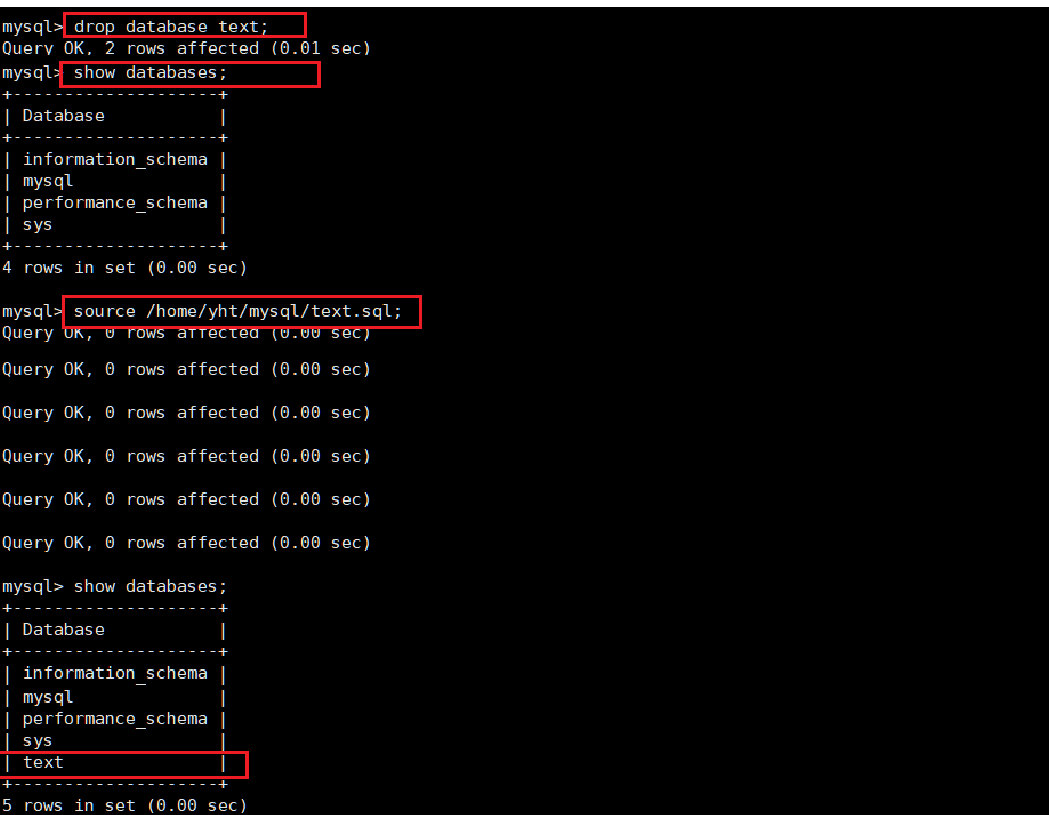
2.数据表的操作
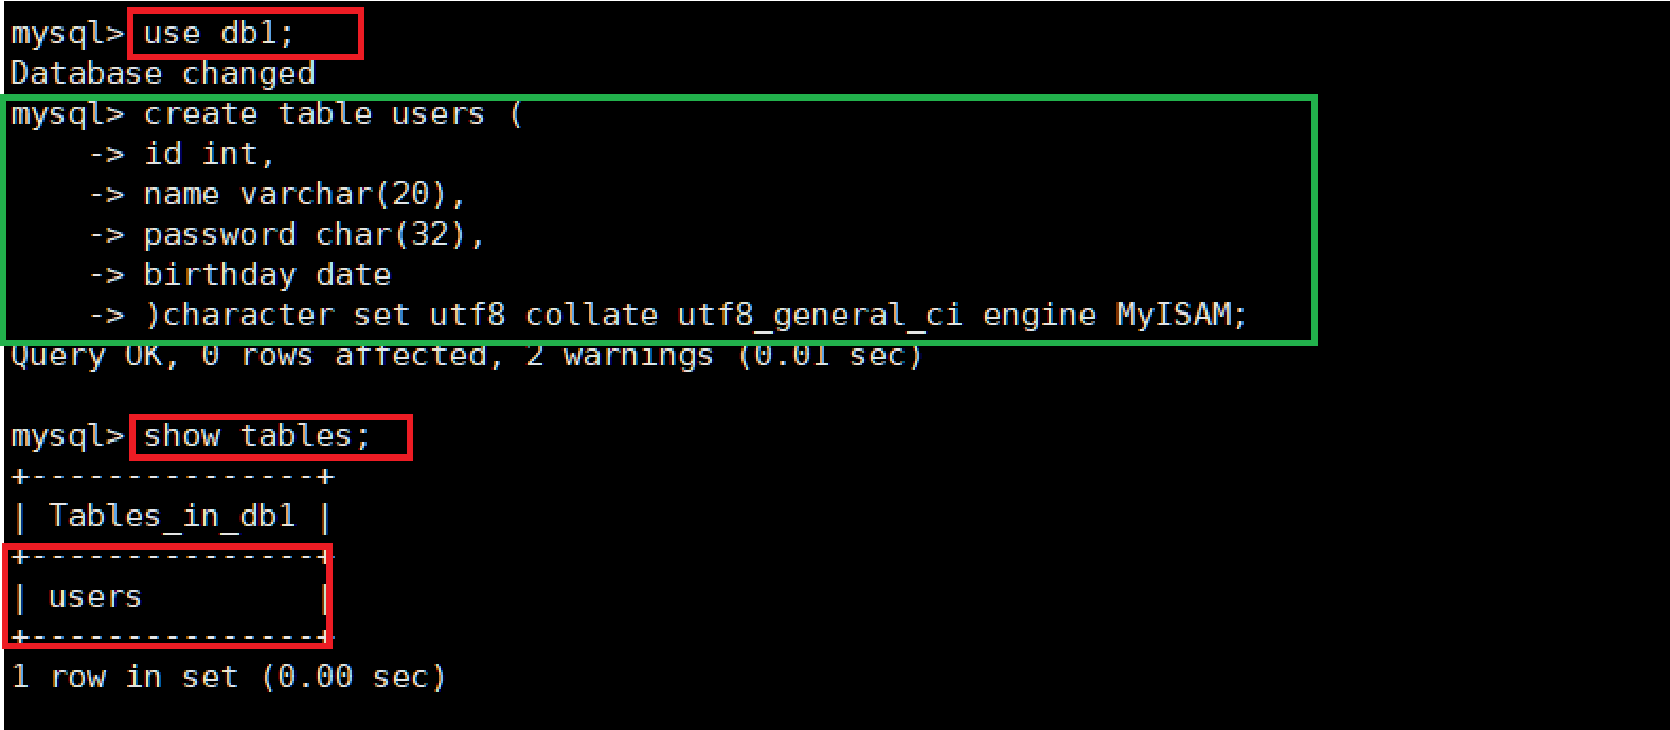
(1)创建表
语法格式
CREATE TABLE 表名 (
    字段1 数据类型 [约束条件],
    字段2 数据类型 [约束条件],
    ...
) [CHARACTER SET 字符集] [COLLATE 校验规则] [ENGINE 存储引擎];- 字符集、校验规则、存储引擎如果不指定,默认继承所在数据库的配置
(2)查看表
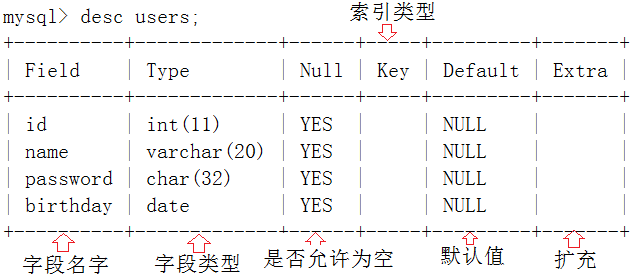
-- 快速查看字段、类型、约束等基础信息
DESC 表名;

-- 查看完整的建表语句,包含所有属性与注释
SHOW CREATE TABLE 表名;

-- 查看当前数据库里的表
SHOW TABLES;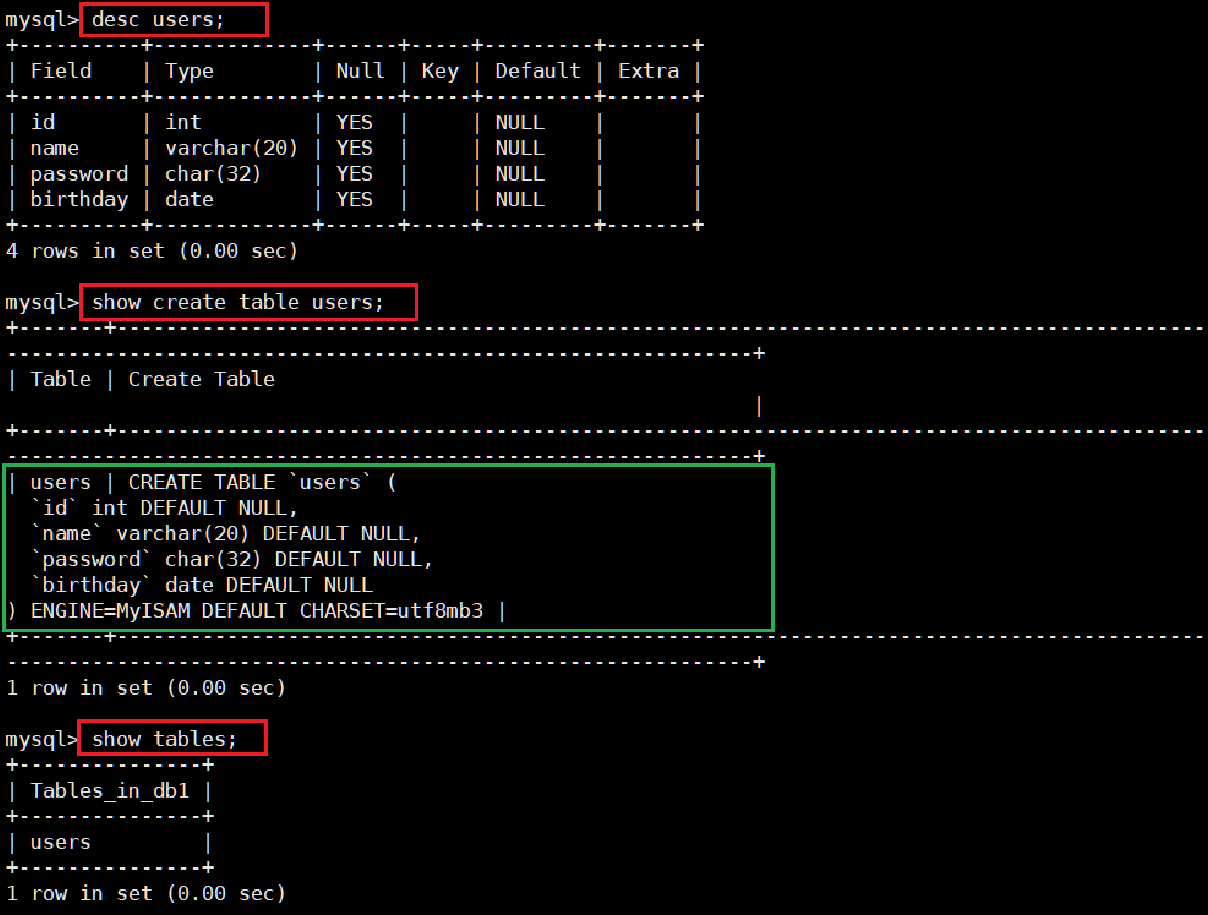
(3)修改表结构
项目迭代中经常需要调整表结构,统一使用ALTER TABLE语句
a. rename : 重命名表
核心功能 :修改数据表的表名,属于表级别的元数据修改,不影响表内数据。
语法格式:
ALTER TABLE 旧表名 RENAME [TO] 新表名;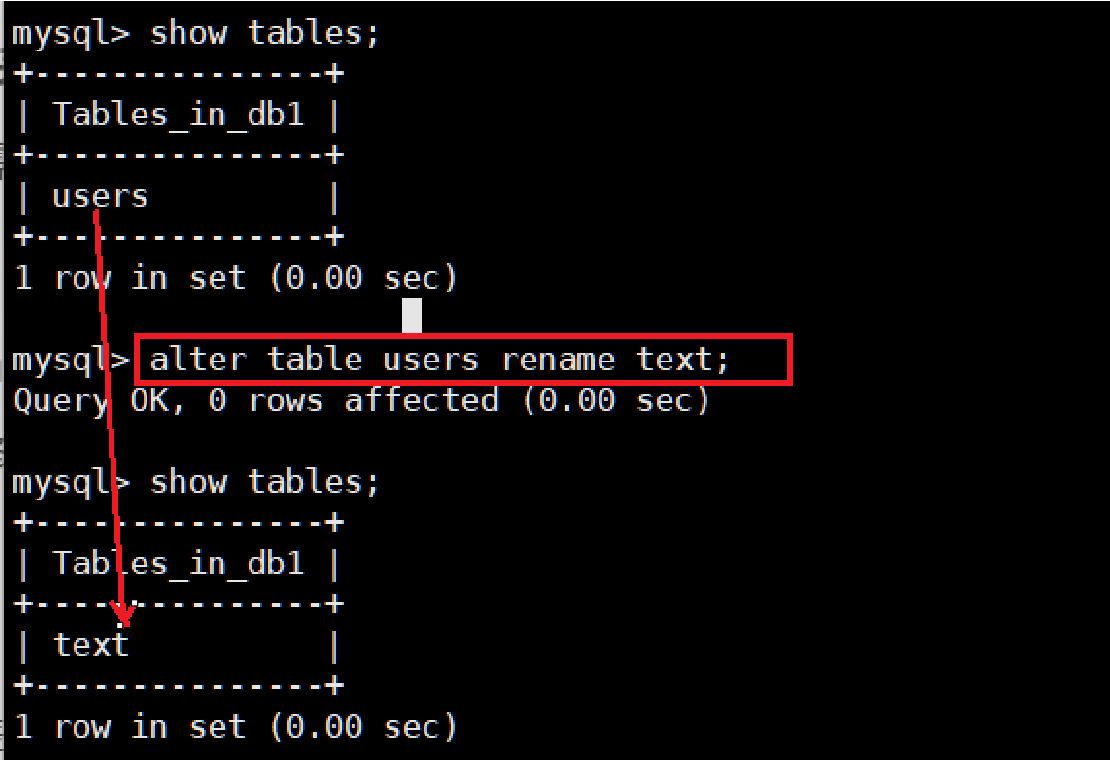
- 重命名仅修改元数据,执行速度极快;但如果表存在外键关联,重命名可能导致外键失效,需提前评估。
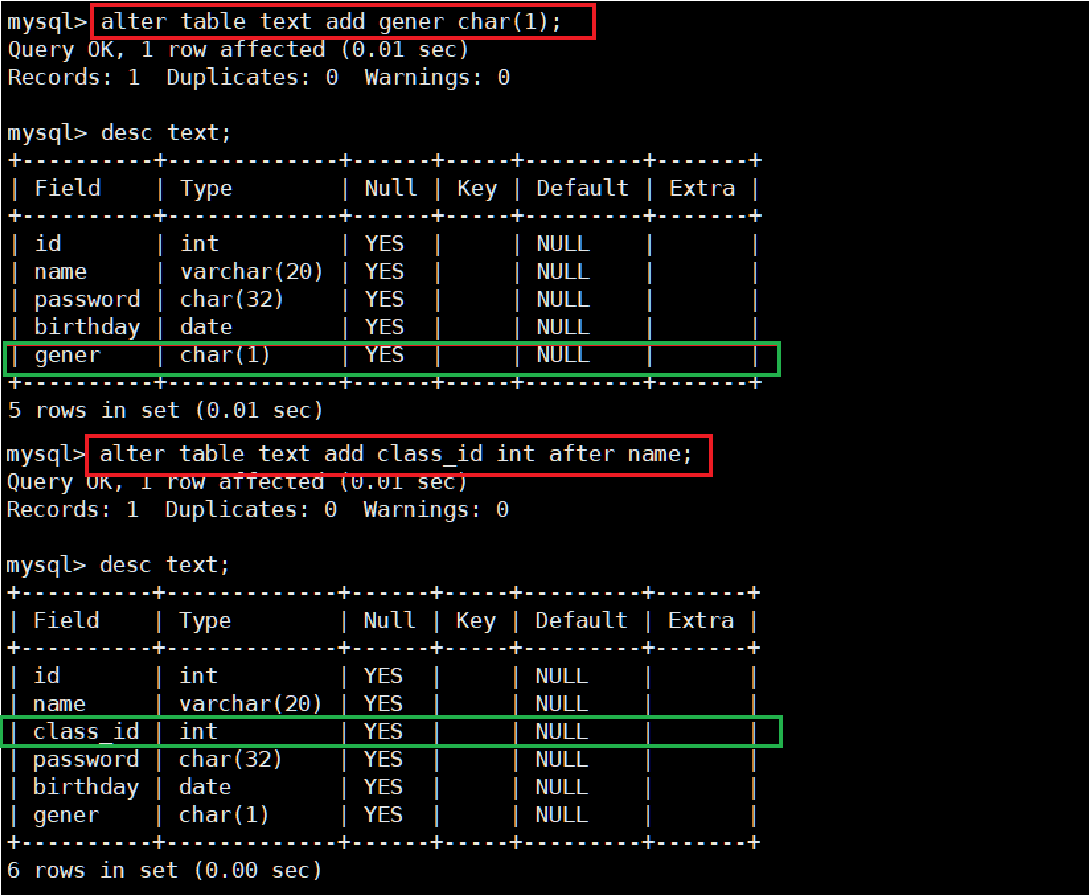
b. add : 新增列 / 约束
核心功能 :向已有表中添加新字段(列),也可用于添加索引、主键、外键等约束。
语法格式:
ALTER TABLE 表名 ADD [COLUMN] 列名 数据类型 [约束条件] [位置];位置可选参数:
FIRST:将新列放在表的第一列AFTER 已存在列名:将新列放在指定列的后方- 不写位置时,默认追加到表的最后一列
c. modify : 修改字段属性
核心功能 :修改字段的数据类型、约束条件、字段顺序,不能修改字段名 。
语法格式:
ALTER TABLE 表名 MODIFY [COLUMN] 列名 新数据类型 [新约束条件] [位置];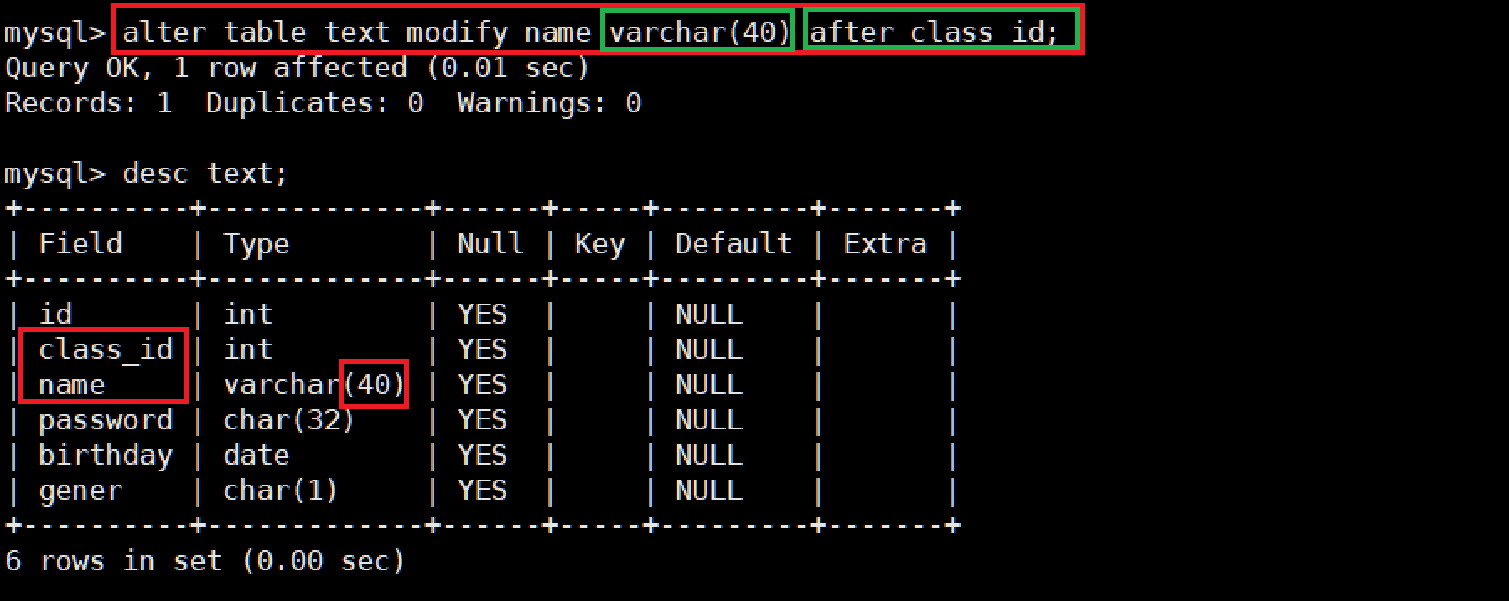
关键注意点:
- 缩小字段长度(如
VARCHAR(50)→VARCHAR(20))可能导致已有数据被截断,执行前必须确认数据范围。 - 仅修改字段属性、不需要改名时,优先使用
MODIFY,语义更清晰
d.drop : 删除列 / 约束
核心功能 :删除表中的字段、索引、约束等对象,删除后对应的数据会永久丢失。
语法格式(删除列):
ALTER TABLE 表名 DROP [COLUMN] 列名;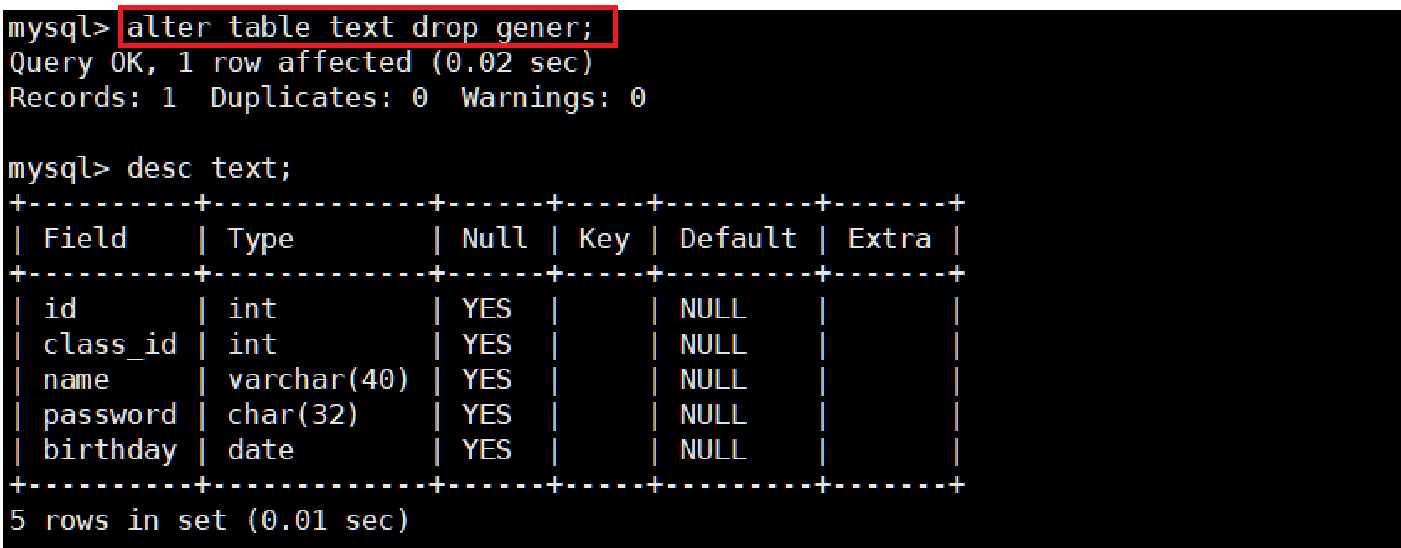
关键注意点:
- 删除列是物理删除,列内所有数据会一并清除,操作不可逆,执行前务必备份数据。
- 被外键关联的列无法直接删除,必须先删除对应的外键约束。
- 不能删除表中最后一个剩余的列
e. change : 重命名字段 + 修改属性
核心功能 :兼具「重命名字段」和「修改字段属性 / 位置」的能力,相当于 重命名 + MODIFY 的组合。
语法格式:
ALTER TABLE 表名 CHANGE [COLUMN] 旧列名 新列名 新数据类型 [新约束] [位置];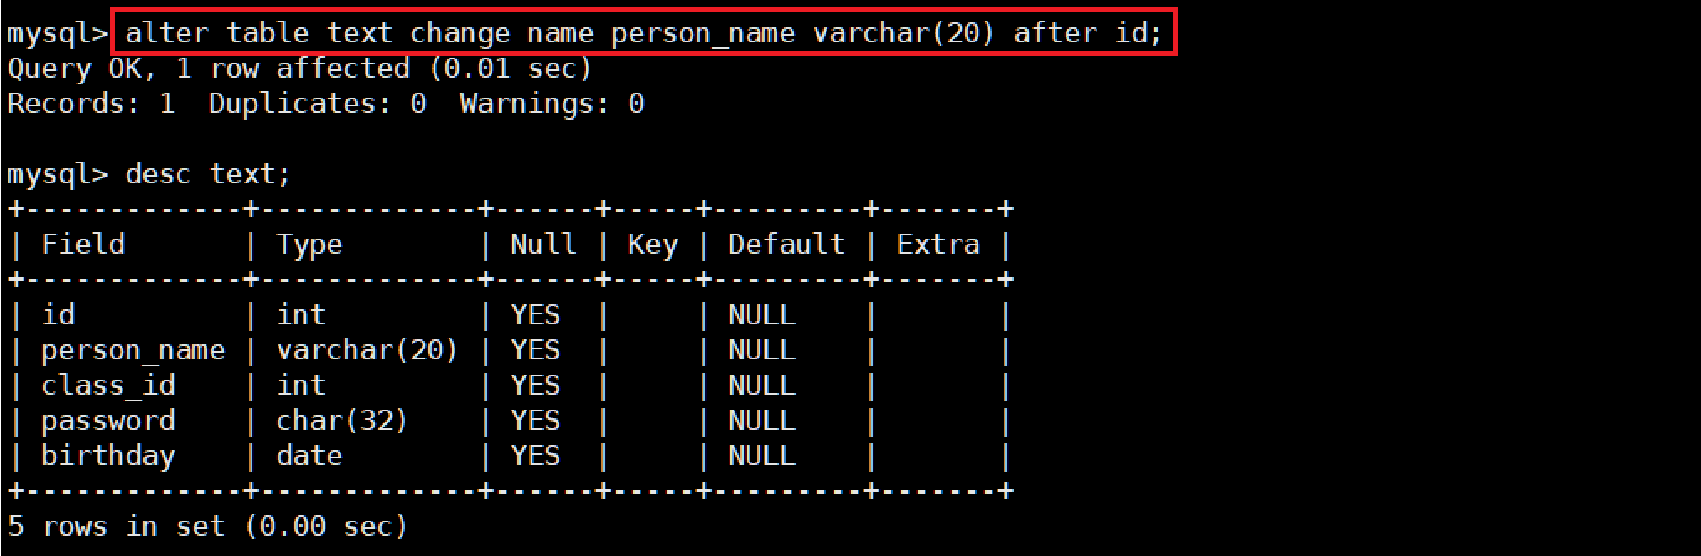
(4)删除表
DROP TABLE [IF EXISTS] 表名;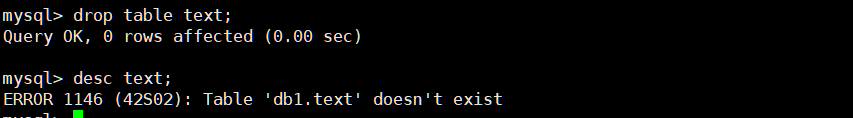
三. 数据类型
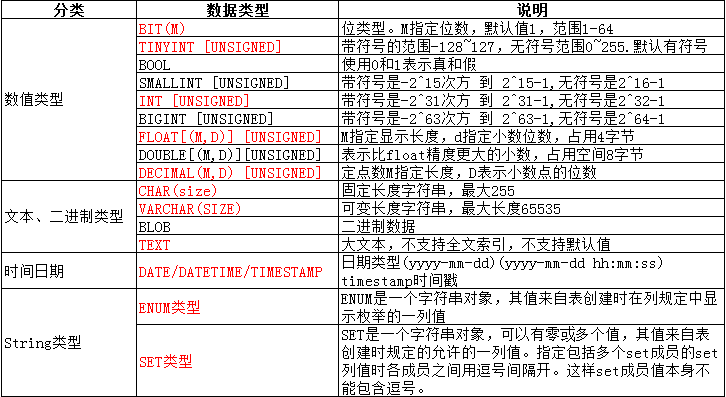
1.数值类型
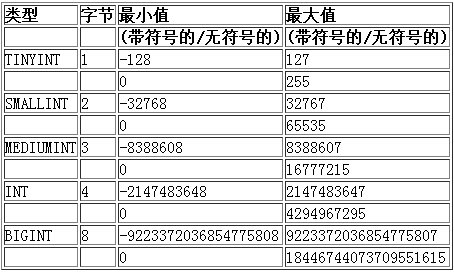
核心特性与注意事项
-
越界直接报错 :插入超出取值范围的数值会触发
Out of range value错误,数据无法写入。CREATE TABLE tt1(num TINYINT);
INSERT INTO tt1 VALUES(128); -- 报错:超出有符号 TINYINT 上限 127 -
UNSIGNED 慎用 :无符号会让正数范围翻倍,但
INT UNSIGNED依然存在溢出风险,且负数插入会直接报错。开发规范更推荐:如果 INT 容量不足,直接升级为 BIGINT,而非使用 UNSIGNED。 -
选型原则:在满足业务需求的前提下,优先选用占用空间更小的类型,降低磁盘 IO、提升查询效率
(1)BIT 位类型
BIT(M) 以二进制「位」为单位存储数据,空间利用率极高。
-
语法 :
BIT(M),M 表示位数,范围 1~64,省略 M 时默认值为 1。 -
显示特性:查询时默认按 ASCII 码对应字符显示,而非直接显示数字。
CREATE TABLE tt4(id INT, a BIT(8));
INSERT INTO tt4 VALUES(65, 65); -- 存储数值65,查询时显示字符 'A' -
典型场景 :存储布尔型标识(是否启用、删除标记、性别),用
BIT(1)存 0/1,比 TINYINT 更节省空间。 -
越界限制 :
BIT(1)仅能存 0 或 1,插入 2 会触发Data too long错误
(2)小数类型
用于存储带小数点的数值,分为**浮点型(近似值)和定点型(精确值)**两类
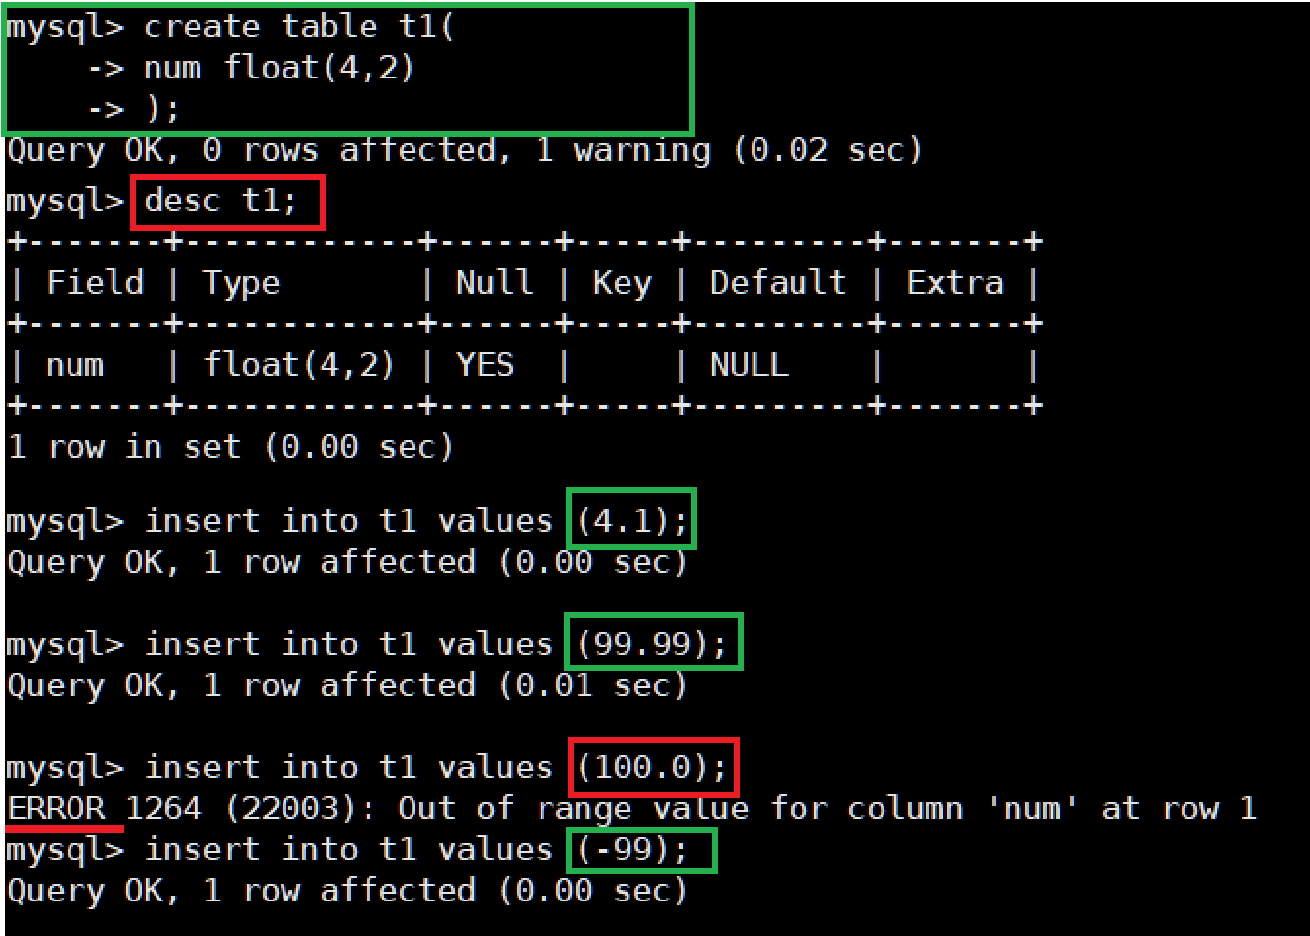
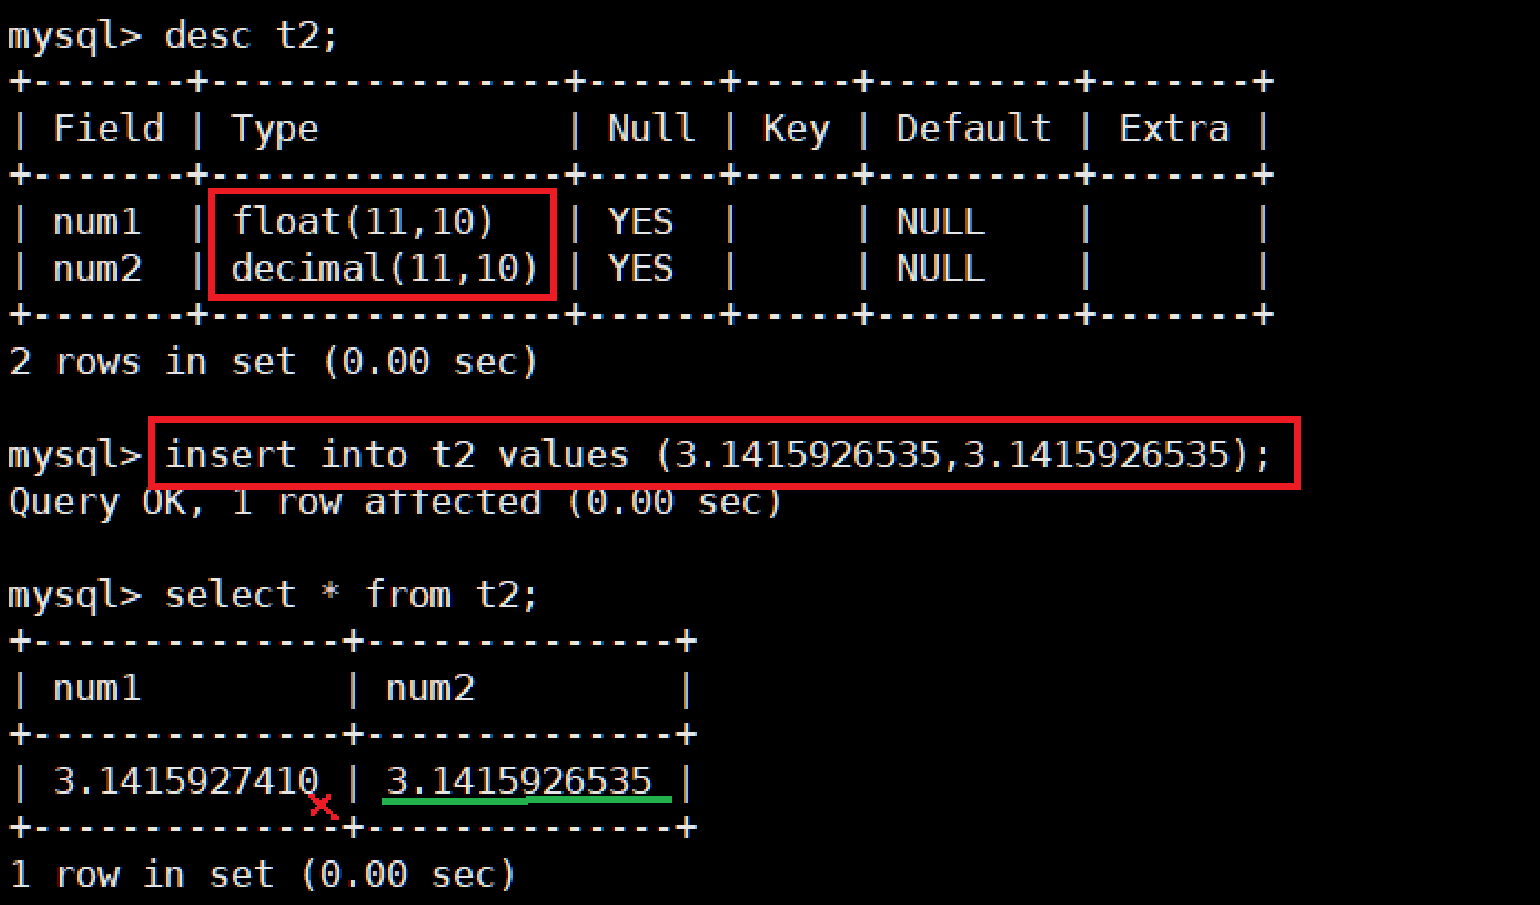
a. float
- 占用空间:4 字节
- 语法 :
FLOAT(M, D) [UNSIGNED]- M:总有效数字长度(整数位 + 小数位)
- D:小数点后的位数
- 精度特性:约 7 位有效数字,超出精度会自动四舍五入,存在精度损失。
b. double 双精度浮点型
- 占用空间:8 字节
- 精度特性:约 15~17 位有效数字,精度高于 FLOAT,但本质仍是近似值存储,依然存在精度丢失风险
c.decimal 定点数
- 语法 :
DECIMAL(M, D) [UNSIGNED],也可写作DEC、NUMERIC- M:总数字长度,最大 65,默认值 10
- D:小数位数,最大 30,默认值 0
- 核心优势 :精确存储,以字符串形式保存数值,没有任何精度损失,是金融、金额场景的标准选择
2.字符串类型
用于存储文本、二进制数据,最核心的是 CHAR 和 VARCHAR,超长文本则使用 TEXT/BLOB 系列。
(1)char 定长字符串
- 语法 :
CHAR(L),L 表示字符数,最大 255 个字符。 - 存储特性:固定长度存储,无论实际存入多少字符,都占用 L 个字符的空间。不足时自动用空格填充末尾,查询时自动去除末尾空格。
- 优势:存储效率高、读取速度快,适合长度完全固定的数据。
- 典型场景:身份证号(18 位)、手机号(11 位)、MD5 哈希值(32 位)、状态编码等长度恒定的字段。
- 上限限制:超过 255 字符会直接报错,提示改用 TEXT 或 BLOB 类型
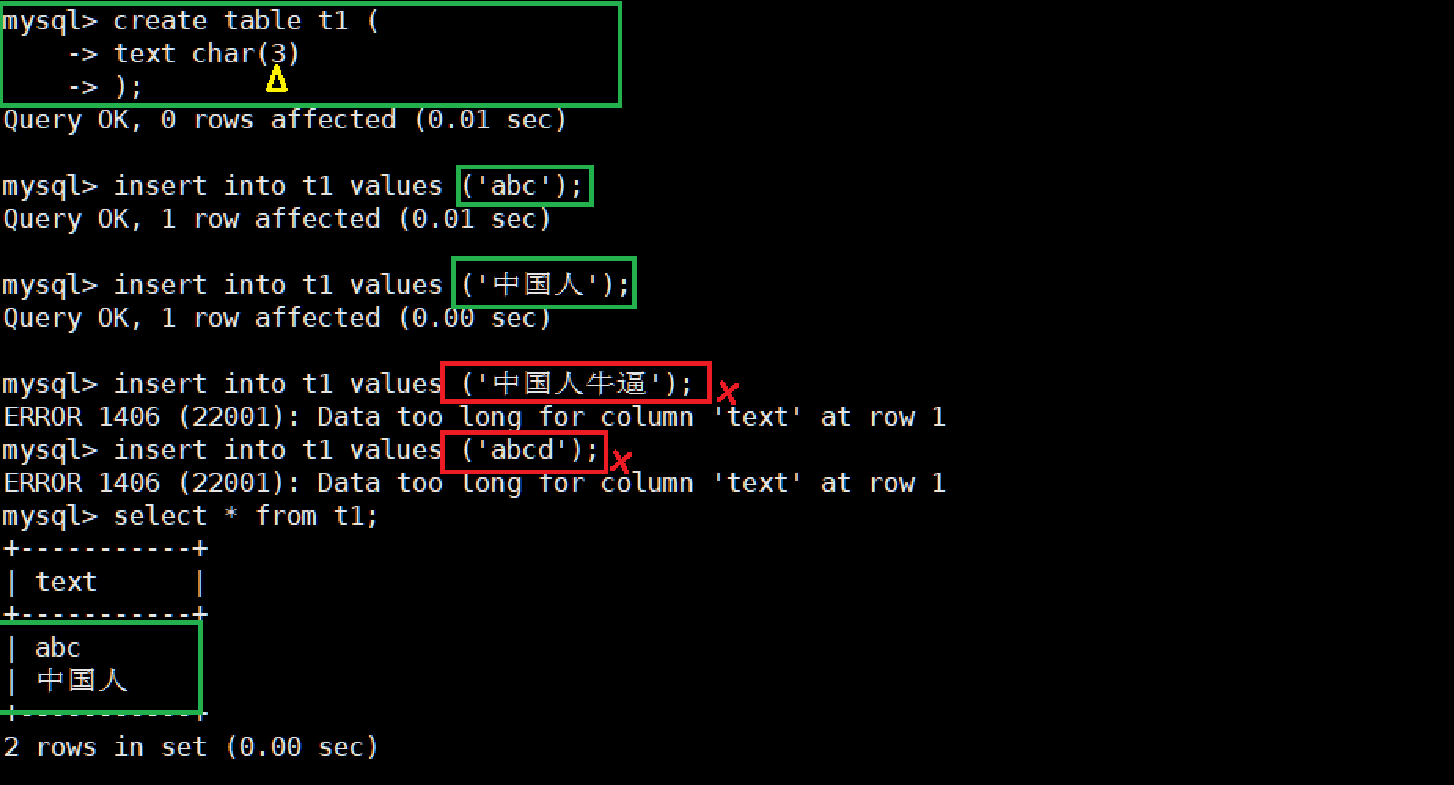
注意:在utf8 编码格式下,一个汉字占3个字节,但是MySQL中char,和下面我们要学的 varchar 中的 L 代表的是一个== 字符 ==,一个汉字是一个字符,一个字母也是一个字符
(2)varchar 变长字符串
- 语法 :
VARCHAR(L),L 表示最大字符数。 - 存储特性:可变长度存储,实际占用空间 = 数据长度 + 1~2 字节(记录数据长度),用多少占多少,更节省磁盘空间。
- 长度上限 :
- MySQL 行总长度上限为 65535 字节,因此 VARCHAR 最大有效字节数为 65532。
- 最大字符数和表的字符集强相关:
- UTF8 编码:1 字符占 3 字节 → 最大约 21844 字符
- GBK 编码:1 字符占 2 字节 → 最大约 32766 字符
- 典型场景:用户名、地址、商品名称、备注等长度不固定的文本
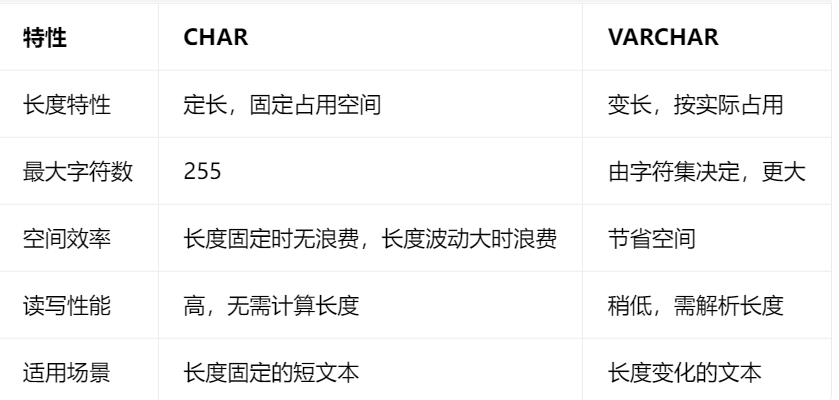
char 与 varchar 比较
(3)text 与 blob系列
当文本长度超过 VARCHAR 上限时,使用 TEXT 系列(存储文本)或 BLOB 系列(存储二进制数据,如图片、文件):
- TINYTEXT / TINYBLOB:最大 255 字节
- TEXT / BLOB:最大 64KB
- MEDIUMTEXT / MEDIUMBLOB:最大 16MB
- LONGTEXT / LONGBLOB:最大 4GB
注意:TEXT/BLOB 类型不能设置默认值,排序和索引效率低于 VARCHAR,非超长场景不推荐使用
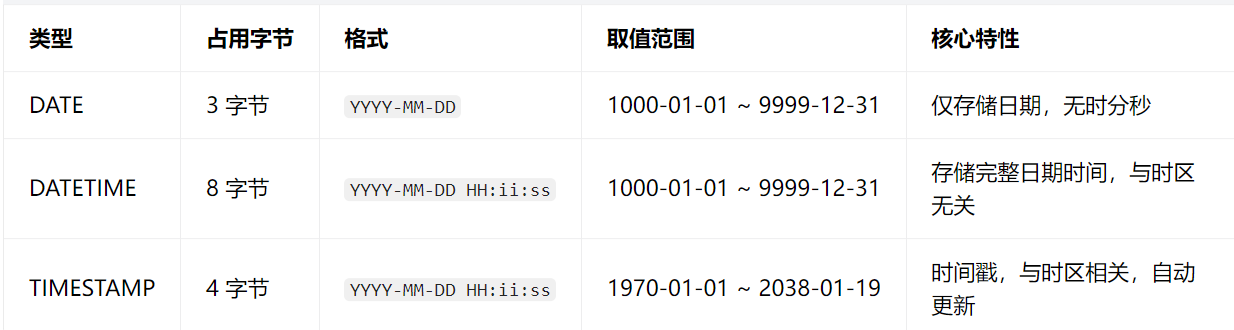
3.日期和时间类型
核心特性详解
- DATE
只记录年月日,适合生日、入职日期、下单日期等不需要时分秒的场景。 - DATETIME
存储完整的日期 + 时间,取值范围大,不受时区影响,是业务中最通用的时间类型,适合记录创建时间、事件发生时间等。 - TIMESTAMP
- 底层存储 1970-01-01 以来的秒数,占用空间更小。
- 自动更新特性:默认配置下,插入和更新数据行时,TIMESTAMP 字段会自动设置为当前时间,非常适合做「数据更新时间」字段。
- 时区相关:会根据数据库时区自动转换显示值,跨时区业务需注意。
- 范围限制:存在 2038 年问题,超出 2038 年的时间无法存储
4. enum 枚举 和 set 集合
enum 枚举(多选一)
- 语法 :
ENUM('选项1', '选项2', '选项3', ...) - 特性:单选,一个字段只能存枚举列表中的一个值。
- 底层存储:每个选项对应一个整数(1、2、3...),最多支持 65535 个选项。
- 优势:严格限制取值、数据紧凑、查询效率高。
- 典型场景:性别、订单状态、审核状态等固定单选的分类
set 集合 (多选多)
- 语法 :
SET('选项1', '选项2', '选项3', ...) - 特性:多选,一个字段可以存 0 个或多个选项,选项之间用逗号分隔。
- 底层存储:按位存储,每个选项对应 2 的幂(1、2、4、8...),最多支持 64 个选项。
- 正确查询方式 :不能直接用
=精确匹配(=要求选项完全一致),需用FIND_IN_SET('选项', 字段名)查询包含某个选项的记录
四.表的约束
1.基础字段级约束
(1) NULL / NOT NULL 空属性约束
核心作用 :控制字段是否允许存储 NULL(空值)。
NULL:默认属性,允许字段为空值。NOT NULL:强制字段必须赋值,不允许为空。
为什么推荐尽量使用 NOT NULL
-
运算异常 :
NULL参与任何数值运算,结果都为NULL,无法得到预期结果。SELECT 1 + NULL; -- 结果为 NULL
-
索引失效风险 :包含
NULL的字段会让索引、查询条件变得复杂,降低查询效率。 -
业务语义模糊:空值的含义不明确,无法区分是 "未填写" 还是 "值为 0 / 空字符串"。
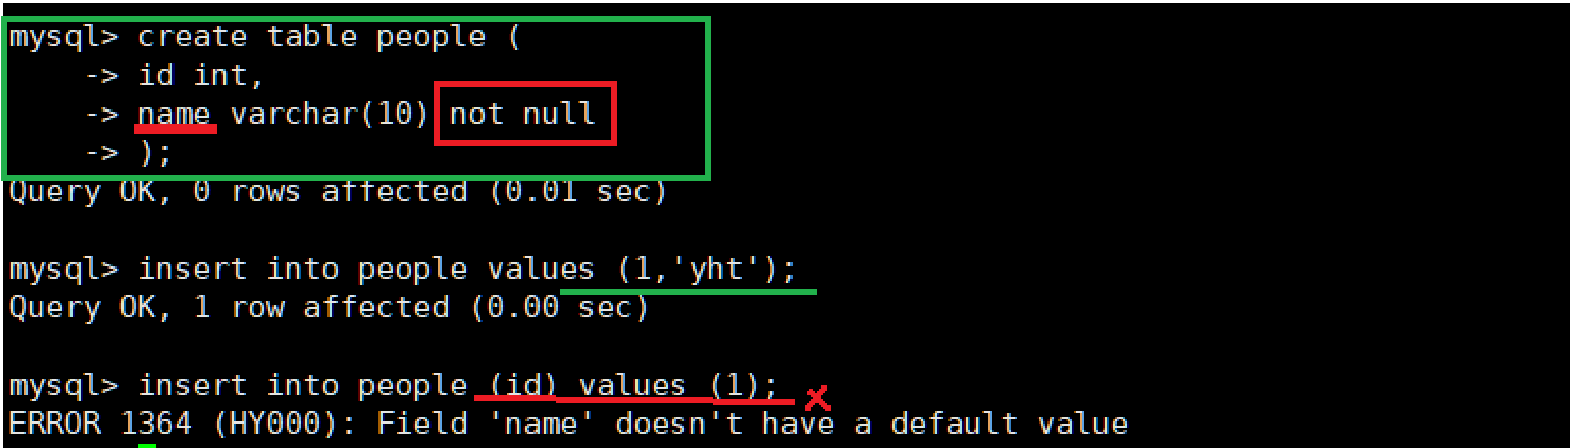
如上图,当 name 有 not null 非空约束后,插入的时候就必须有默认值,没有就会报错
(2) default 默认值约束
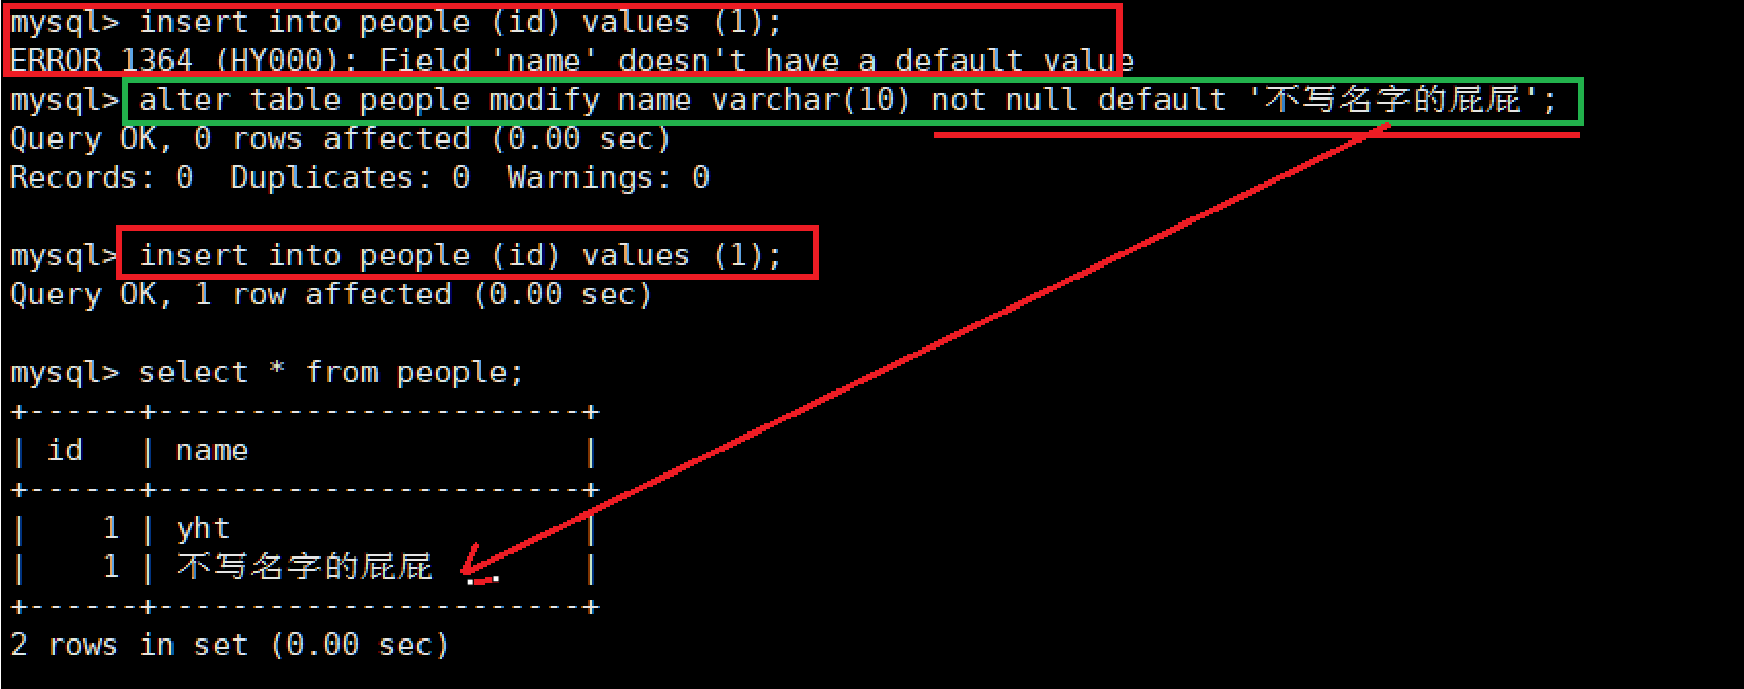
核心作用:给字段预设一个默认值,插入数据时如果不显式给该字段赋值,系统自动填充默认值。
适用场景
字段的取值有高频默认值,例如性别默认 "男"、状态默认 "正常"、数量默认 0。
特性与注意
- 设置了
DEFAULT的字段,即使是NOT NULL,插入时也可以省略,不会报空值错误。 - 开发中通常
DEFAULT与NOT NULL搭配使用,既保证非空,又提升插入便捷性。
(3) comment 列描述 (注释)
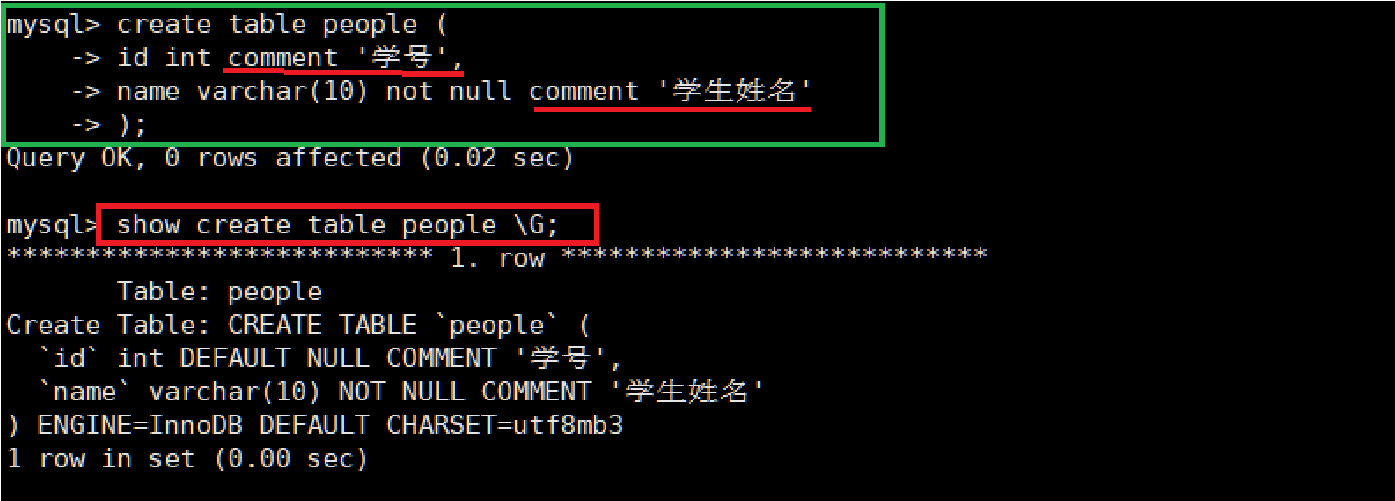
核心作用 :给字段添加业务说明,属于文档型约束,不做数据校验,仅用于提升表结构的可读性。
特性
DESC 表名无法查看注释,必须用SHOW CREATE TABLE 表名\G才能看到完整的建表语句与注释。- 生产环境强制规范:所有表、所有字段都必须加注释,方便后续开发与运维维护
(4) zerofill 零填充约束
核心作用:修饰数值类型的显示宽度,当数值的长度小于设定的显示宽度时,左侧自动补 0。
核心本质
仅改变显示格式,不改变实际存储的值 。数据库底层存储的仍然是原始数字,补 0 只是查询时的格式化输出,可用 HEX() 函数验证。
特性与注意
- 必须搭配数值长度使用,例如
INT(5) ZEROFILL,括号内的数字只有搭配 ZEROFILL 才有实际意义。 - 字段添加 ZEROFILL 后,会自动变为
UNSIGNED(无符号)
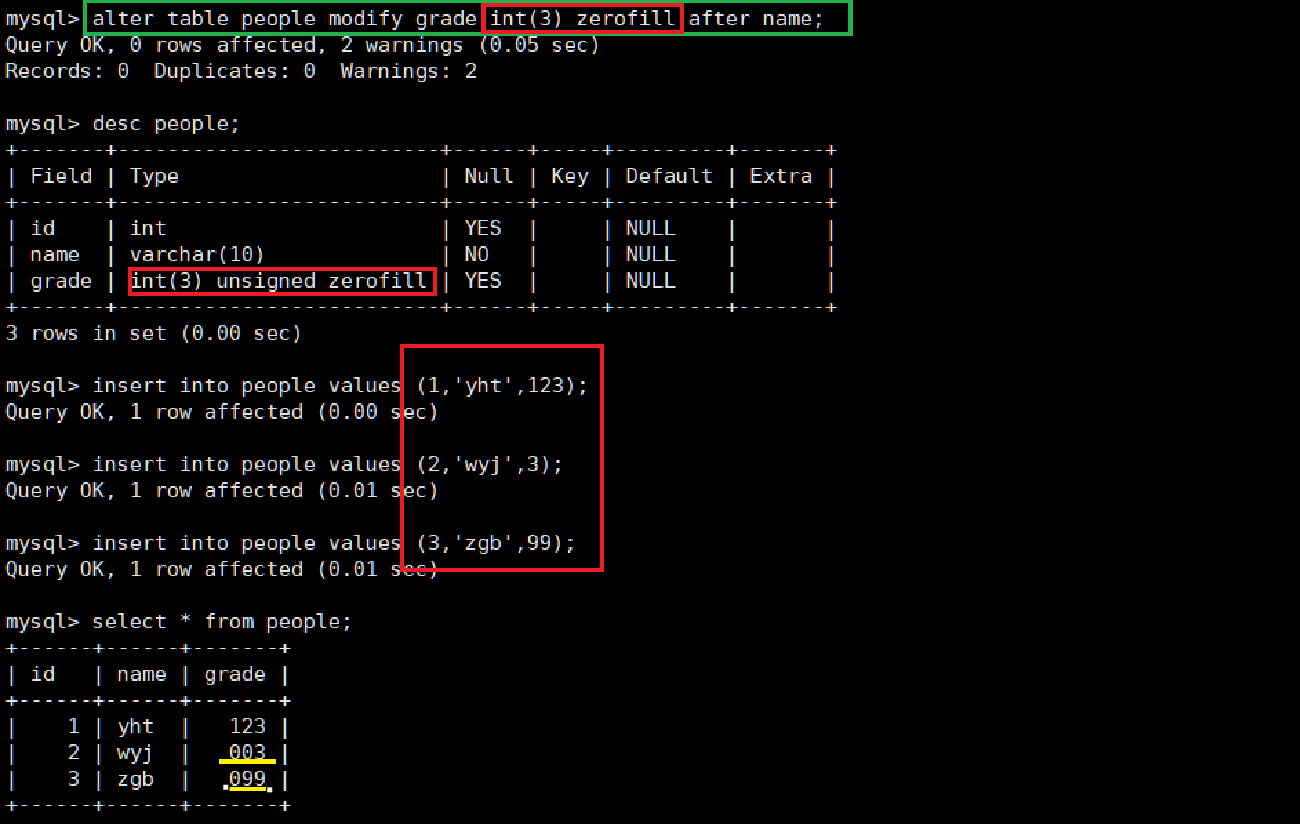
如上图,当设置 zerofill 零填充约束后,会根据 int 后括号后中的数字进行对齐,不够的位数用0填充
2.键类约束
这类约束用于保证数据唯一性、定义表间关系,是表设计的核心
(1)primary key 主键约束
核心作用 :唯一标识表中的每一行数据,强制字段值不重复、且不能为空
核心特性
- 唯一性:一张表最多只能有 1 个主键,但主键可以由多个字段组成(复合主键)
- 非空性 :主键字段默认自带
NOT NULL,无需额外声明
主键的修改操作
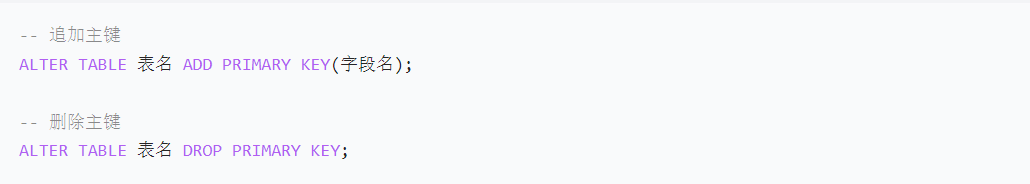
主键分类与示例
a.单字段主键
最常用的形式,直接在字段后声明
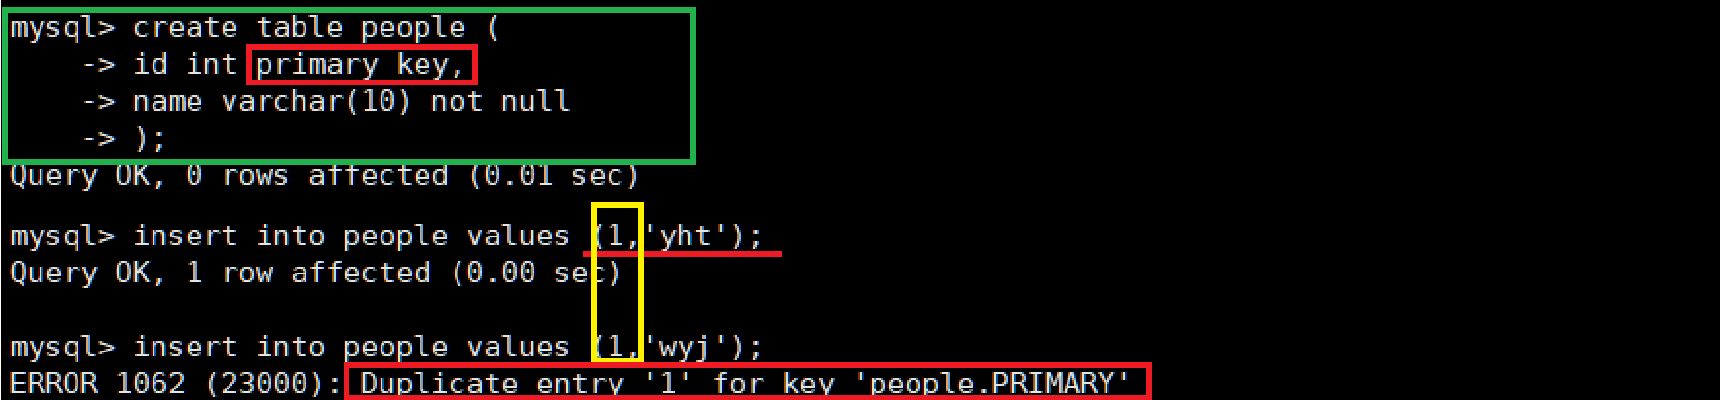
b.复合主键
多个字段共同组成主键,多个字段的组合值不重复即可。常用于多对多中间表、关联表
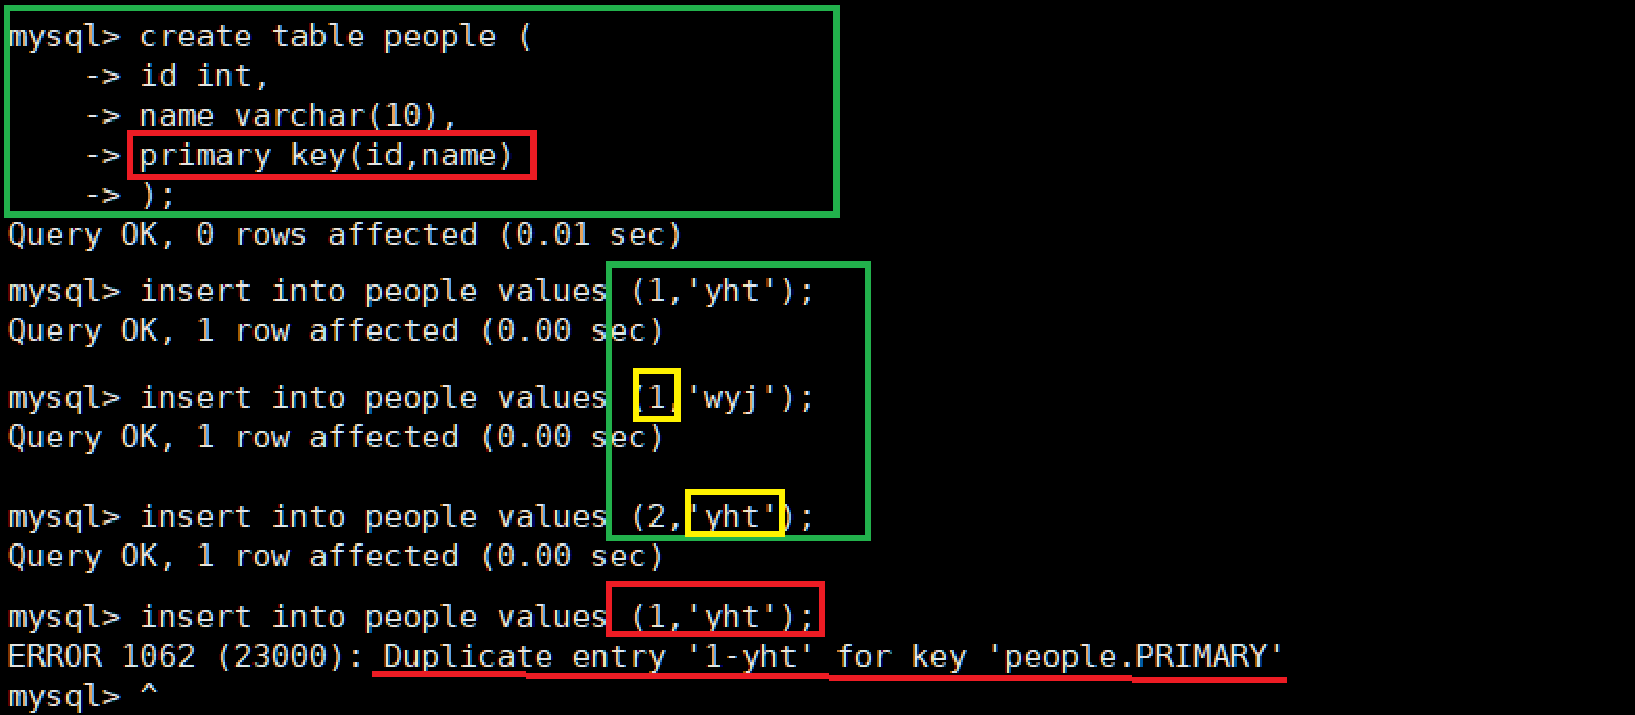
如上图,在复合主键中,要 ''其中所有字段都一致'' 才会报错,单个字段重复是可以的
(2)auto_increment 自增长约束
核心作用:修饰整数主键 / 唯一键字段,插入数据时若不给该字段赋值,系统会自动从当前最大值 +1 生成一个不重复的整数。
前置条件
- 字段必须是索引列(主键或唯一键,即表结构中
Key栏有值)。 - 字段必须是整数类型。
- 一张表最多只能有 1 个自增长字段
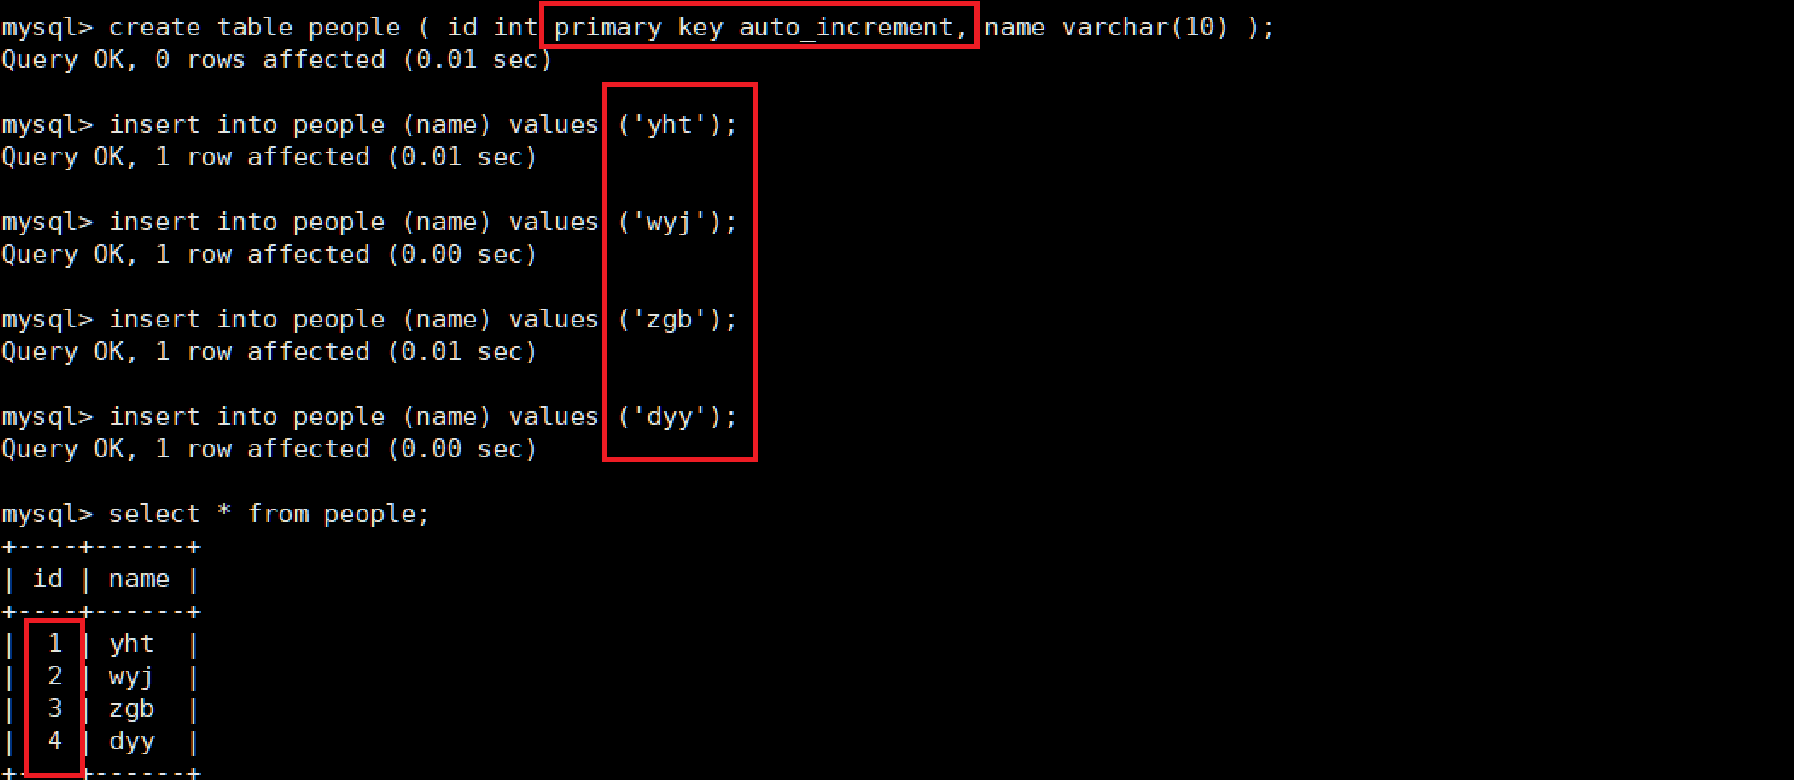
注意:如果要删除主键,要先把自增长去掉
获取自增值
SELECT LAST_INSERT_ID();
-- 返回最近一次插入生成的自增长ID;批量插入时返回第一个生成的值
(3)unique key 唯一键约束
核心作用:保证字段的值在整张表中不重复,解决 "一张表只能有一个主键,但多个业务字段都需要去重" 的问题。
核心特性
- 可空性 :唯一键允许为
NULL,且允许多个 NULL 值存在(NULL 之间不做唯一性比较)。 - 数量:一张表可以创建多个唯一键。
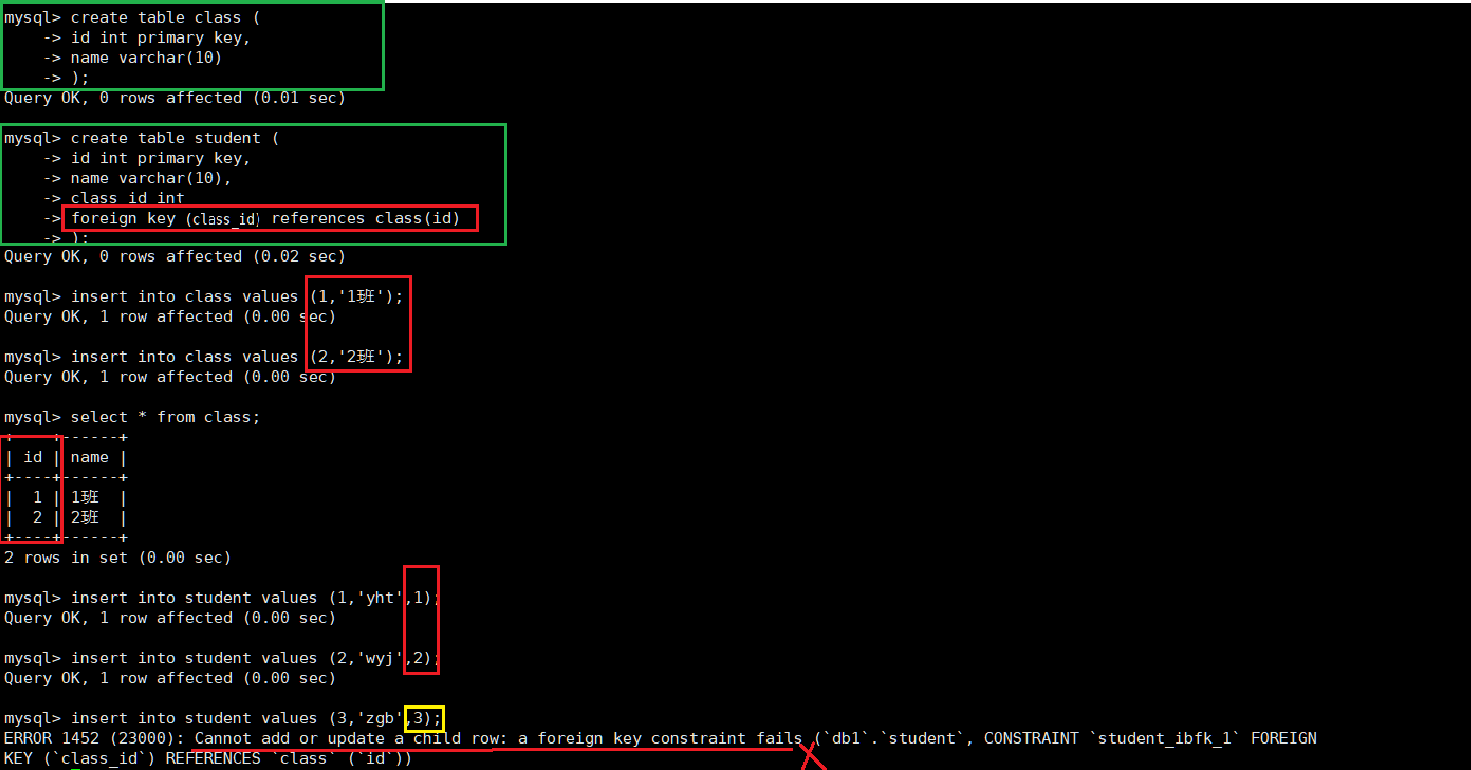
(4)foreign key 外键约束
核心作用 :定义两张表之间的引用关系,从数据库层面强制引用完整性,保证从表的外键字段值,必须在主表的主键 / 唯一键中存在,或者为 NULL。
基本概念
- 主表(父表):被引用的表,提供关联值的表,必须有主键或唯一键,例如班级表。
- 从表(子表) :设置外键的表,外键列引用主表的主键,例如学生表的
class_id
结尾
我们第一期对于MySQL的学习就到这里了,希望对你的学习有所帮助。感谢你的点赞、关注。我主页里有更好康的呦!