写在前面
【从零走向AGI 】旨在深入了解通用人工智能(AGI)的发展路径,从最基础的概念起,逐步构建完整的知识体系。
项目地址 🔗:https://github.com/AI-mzq/From-Zero-to-AGI.git
AIGC算法岗/开发岗面试面经交流社群 (涵盖AI Agent、AIGC图像创作、AI视频、LLM大模型、AI多模态、数字人、传统深度学习、具身智能等AIGC面试干货资源)欢迎大家加入:https://t.zsxq.com/YtJ09
Open X-Embodiment详解:22种机器人数据如何训练出RT-X的跨本体迁移
导读
机器人学习长期按"一个任务、一台机器人、一个环境"分别训练模型。这样的策略在单一实验室内有效,却把数据规模和泛化能力锁在单个本体中:不同机械臂的摄像头、动作坐标系、夹爪和任务分布都不一样,数据很难直接合并。Open X-Embodiment 选择先解决数据基础设施问题,再验证跨本体训练是否真的有用。
论文汇总来自 21 家机构的 60 个机器人数据集,整理出覆盖 22 种机器人本体、527 项技能和 160,266 个任务的开放数据资源。作者把观测和动作粗粒度地映射到统一格式,并在其上训练两类模型:面向机器人控制的 RT-1-X,以及把动作表示成语言 token、继续利用互联网视觉语言预训练的 RT-2-X。
实验在 6 台机器人上完成约 3,600 次评测。RT-1-X 在小数据领域相对原始方法平均提升约 50%;RT-2-X 在一个机器人没有见过、但另一种机器人数据中出现过的技能上达到 75.8%,而只用本体数据训练的 RT-2 为 27.3%,接近 3 倍差距。论文的贡献因此不是提出一个全新的 Transformer,而是证明 跨本体数据可以被统一、训练,并产生可测量的正迁移。
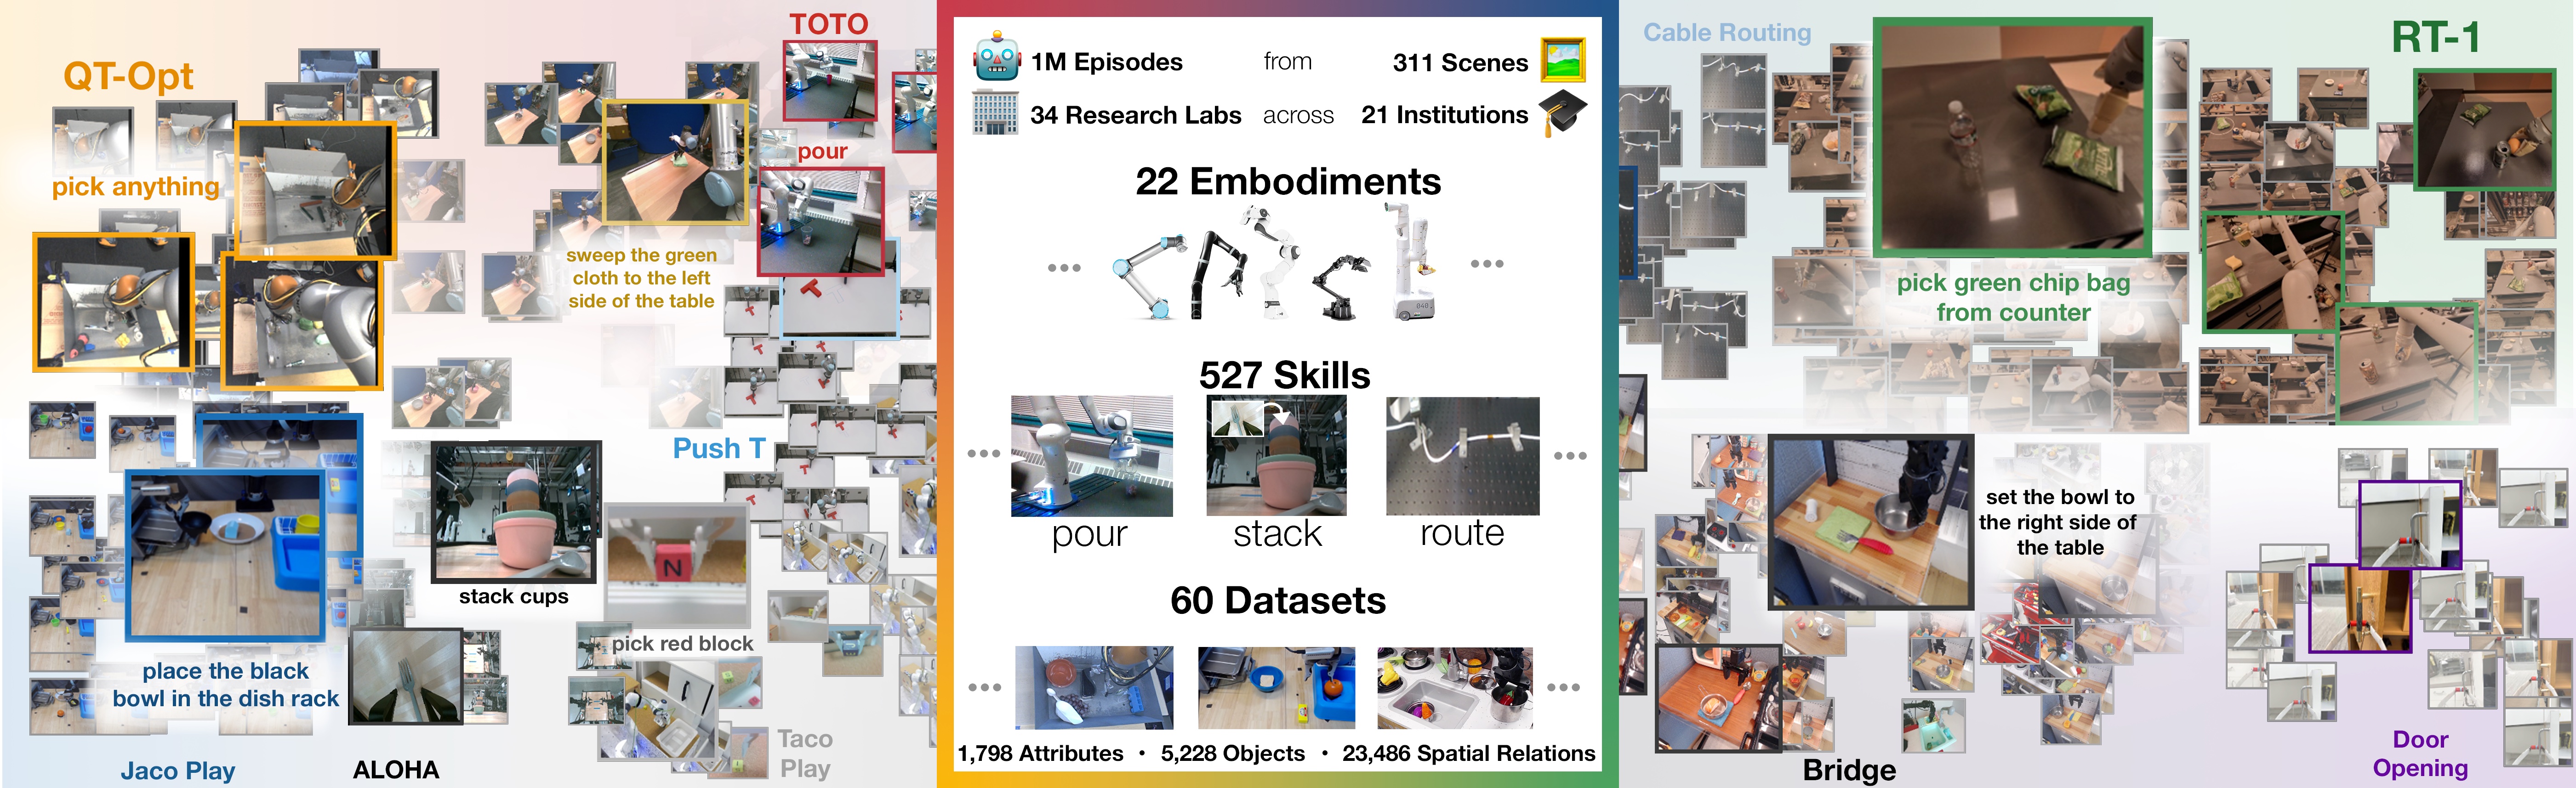
图 1:Open X-Embodiment 将不同机构、机器人、场景和技能组织成可共同训练的开放资源。来源:论文 Figure 1。
猫先生认为 ,这篇论文最重要的判断是:机器人领域缺的未必只是更大的模型,而是让不同实验室的数据能够被同一个模型"读懂"的共同接口。数据标准化本身就是具身智能基础模型的模型设计。
- 论文标题:Open X-Embodiment: Robotic Learning Datasets and RT-X Models
- 论文地址:https://arxiv.org/abs/2310.08864
- 论文 PDF:https://arxiv.org/pdf/2310.08864
- 项目主页:https://robotics-transformer-x.github.io/
- GitHub:https://github.com/google-deepmind/open_x_embodiment
- 论文版本:arXiv v9,2025-05-14
原文脉络
Introduction 从视觉和语言领域的预训练范式出发,提出机器人也需要跨本体训练;Related Work 将问题放在本体迁移、大规模机器人数据和语言条件策略的交叉处。Section III 介绍 Open X-Embodiment 数据仓库,Section IV 说明统一数据格式、RT-1-X/RT-2-X 架构和训练混合,Section V 按"域内性能---分布外泛化---设计消融"验证跨本体训练,最后讨论未覆盖的传感器、执行器和新机器人泛化问题。
1--2. Introduction 与 Related Work:机器人为什么需要 X-embodiment 数据
视觉模型和语言模型已经说明,大规模、多样化数据可以让通用预训练模型超过为单一任务优化的小模型。机器人却很难复制这条路线:交互数据昂贵,数据集通常只覆盖一种环境、一组物体或一种机器人;不同平台之间还存在摄像头、动作空间和控制接口的 embodiment gap。
作者把目标定义为 X-embodiment training:在多种机器人平台上收集数据,让策略从其他平台的经验中获得正迁移。这里的"X"不是要求模型立刻支持所有机器人,而是先把数据、动作表示和训练工具组织起来,使跨平台学习成为可实验的问题。
与专门设计 embodiment 映射、共享奖励或跨域表征的方法不同,Open X-Embodiment 采取较直接的路线:先把数据转成粗粒度共同格式,直接训练 RT-1 和 RT-2,观察一个模型能否同时吸收多种机器人经验。这样做的优点是工程路径清楚,缺点是统一格式不可避免地丢失一部分本体细节。
3. The Open X-Embodiment Repository:先把分散数据变成共同语料
3.1 数据规模与多样性
数据仓库包含超过 100 万条真实机器人轨迹,覆盖 22 种本体,从单臂机械臂、双臂系统到四足机器人;论文汇总了 60 个已有数据集。数据不只是"轨迹数量大",还覆盖不同场景、物体、动作和语言指令。数据分析显示,Franka 贡献了最多的视觉场景,xArm 和 Google Robot 贡献了较多轨迹;技能主体仍是抓取和放置,但长尾中包含擦拭、装配等动作,物体则覆盖食品、餐具和家电等家庭物品。
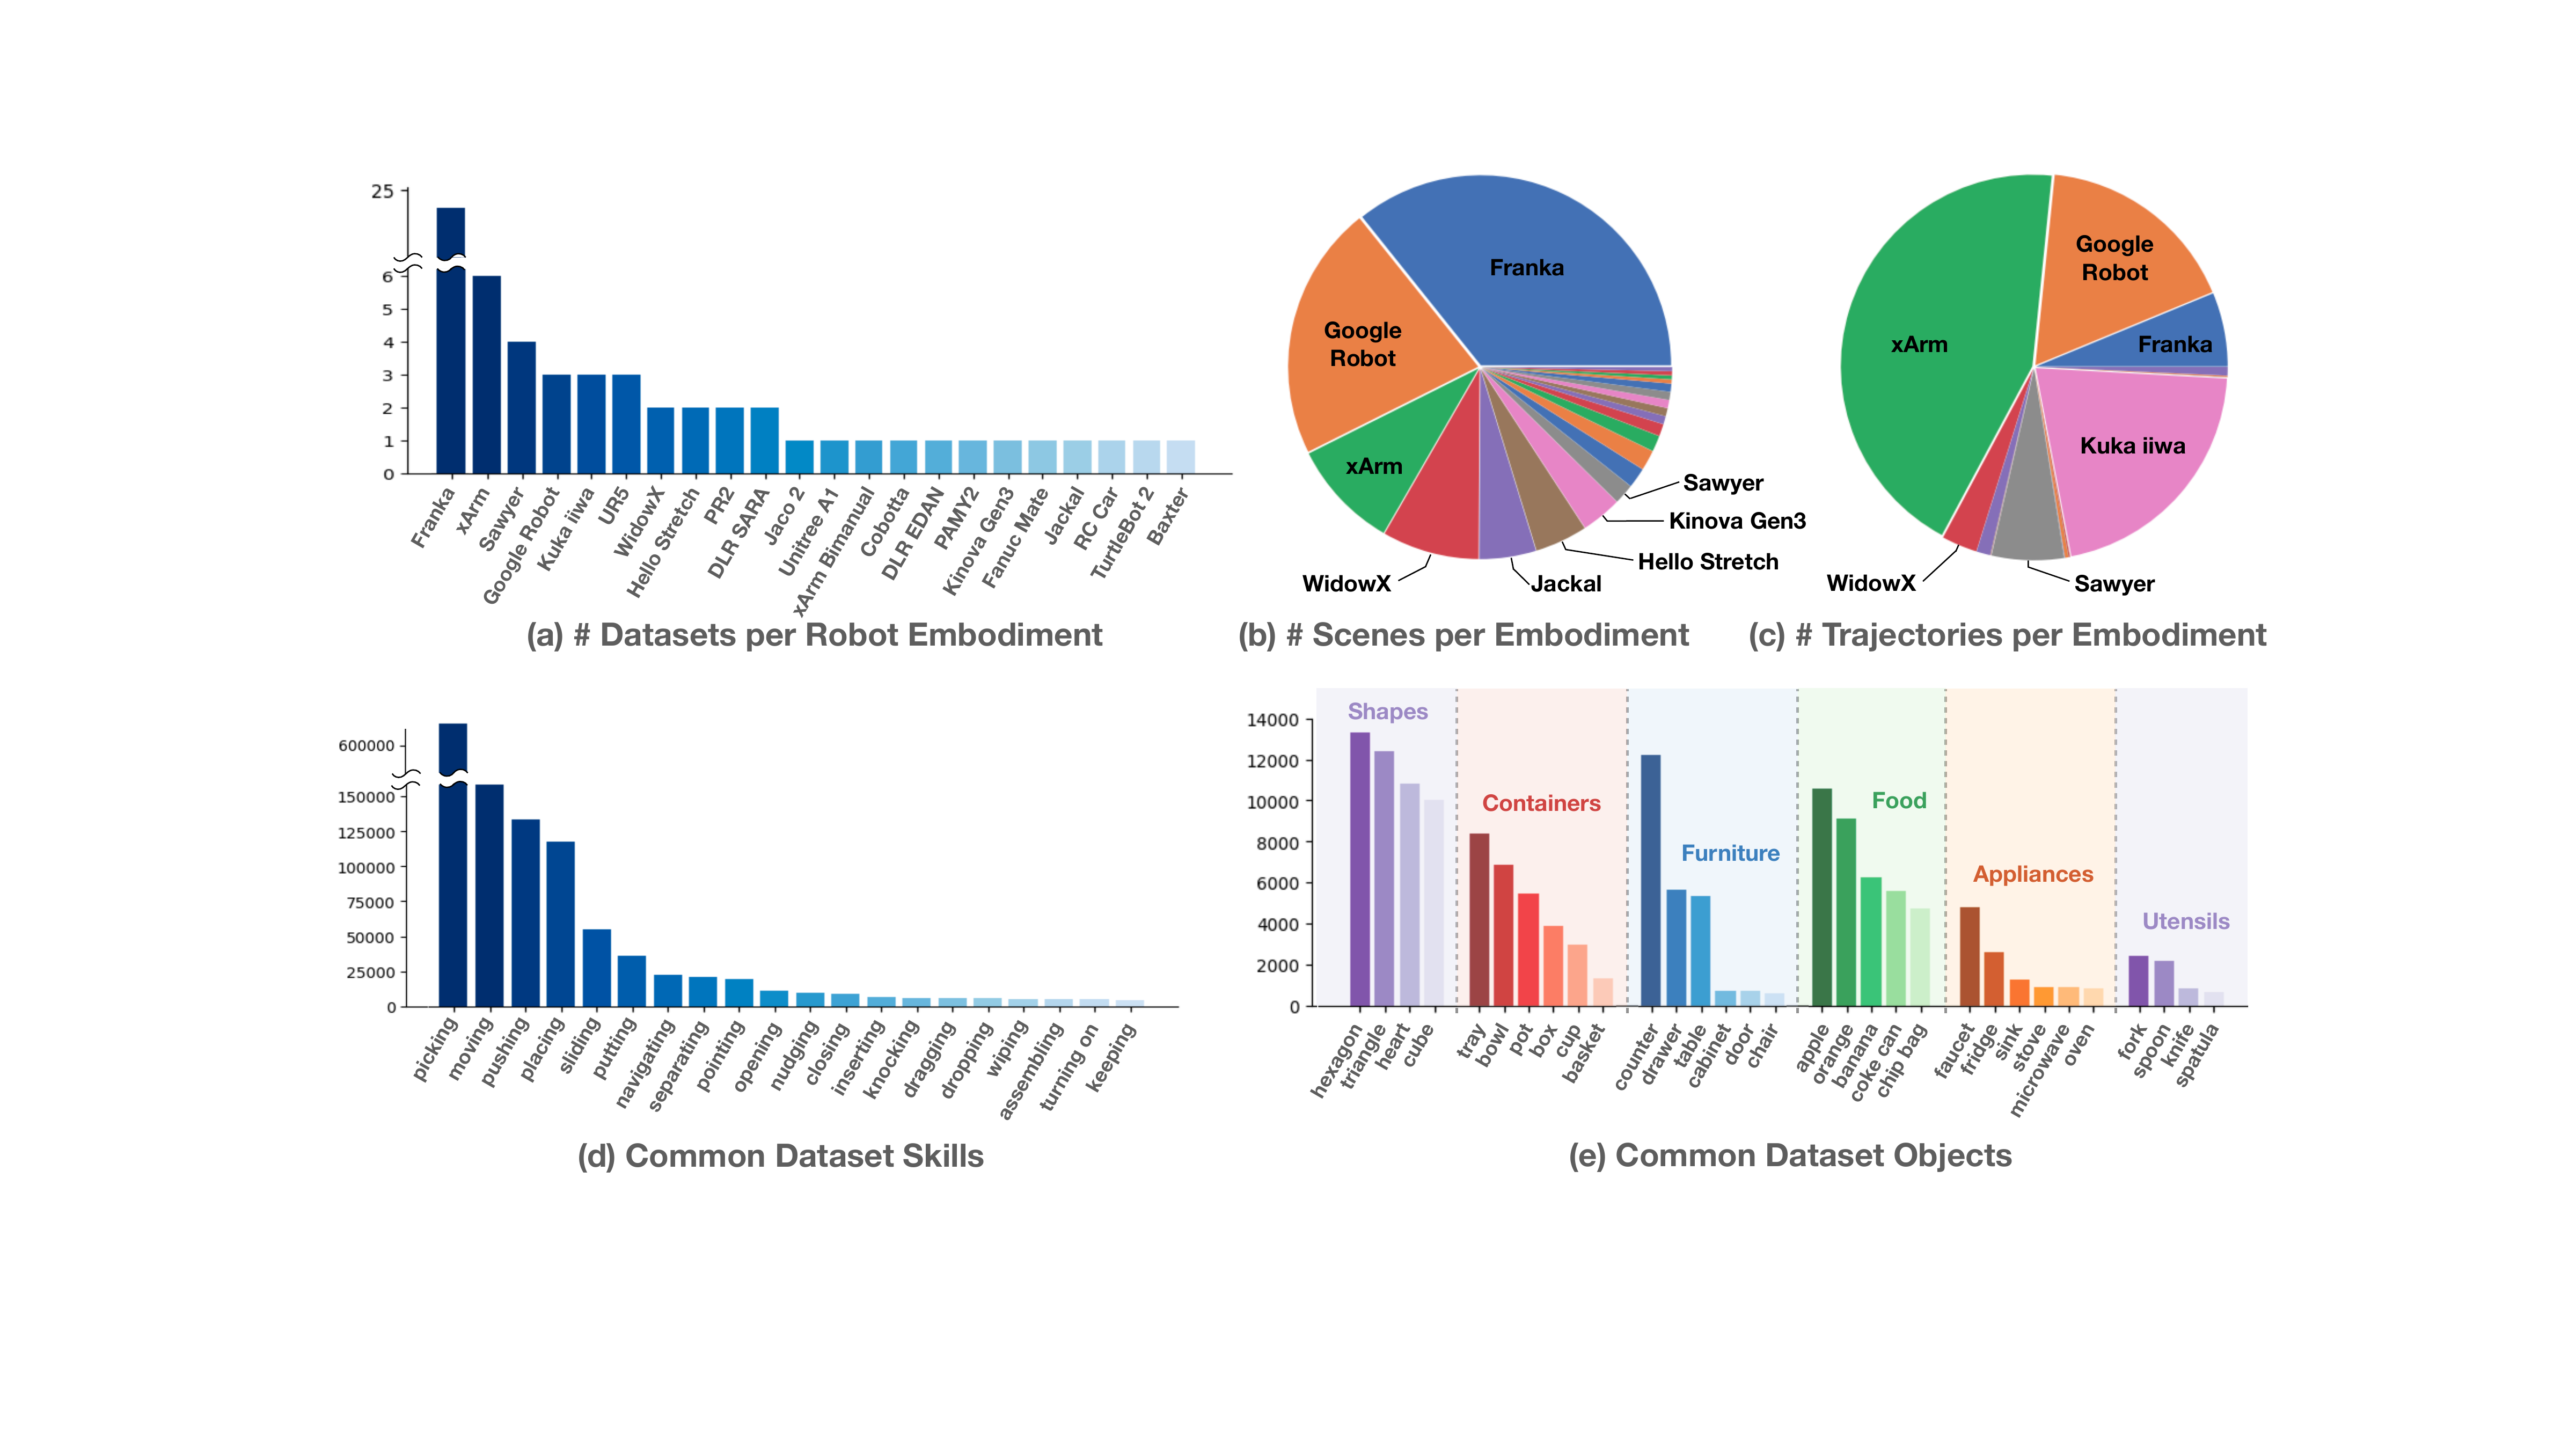
图 2:数据分析同时展示数据集数量、本体对应的视觉场景和轨迹规模,以及技能、物体的长尾分布。来源:论文 Figure 2。
3.2 共享格式不是完全同构
为了让 RT-X 读取来自不同机器人的样本,作者选择一个 canonical camera view,调整到统一分辨率,并把原始动作转换为 7 维末端执行器动作:
a = ( x , y , z , r o l l , p i t c h , y a w , g ) a=(x,y,z,\mathrm{roll},\mathrm{pitch},\mathrm{yaw},g) a=(x,y,z,roll,pitch,yaw,g)
其中 g g g 表示夹爪开合或相应速率。各数据集的动作先独立归一化,再离散到统一 token 或桶中;推理时,输出再根据目标机器人的接口反归一化。模型接收近期图像历史与语言指令,预测离散化动作。
这套方案统一的是"表达形状",不是完整物理含义:坐标系、绝对/相对动作语义和相机安装方式仍可能不同。它更像一个可训练的共同协议,而不是完整的机器人本体模型。
猫先生认为,Open X-Embodiment 的标准化做得很克制:它没有假设不同机器人真的共享同一个动作语义,只先把差异压缩到模型可以处理的范围。这个取舍让数据合并成为可能,同时也把"如何显式建模本体差异"留给了后续研究。
4. RT-X Design:同一份数据,两个容量与预训练路线
4.1 RT-1-X:机器人原生 Transformer
RT-1-X 基于 35M 参数的 RT-1。模型将最近 15 帧图像送入 ImageNet 预训练的 EfficientNet,语言指令通过 Universal Sentence Encoder 得到嵌入,再由 FiLM 层把语言条件注入视觉特征,最后交给 decoder-only Transformer 预测动作 token。它的优势是结构紧凑、推理可以在本地运行,适合机器人控制频率。
4.2 RT-2-X:把动作当作另一种语言
RT-2-X 建立在大规模 VLM 上。RT-2 原本把离散动作写成文本形式,例如一串代表位置和夹爪状态的数字 token;在此基础上,模型可以继续利用 Web 视觉语言预训练得到的物体、空间和语义知识。论文中的 RT-2-X 采用约 55B 的 PaLI-X 路线,将机器人数据与原始 VLM 数据大约按一比一共同微调。
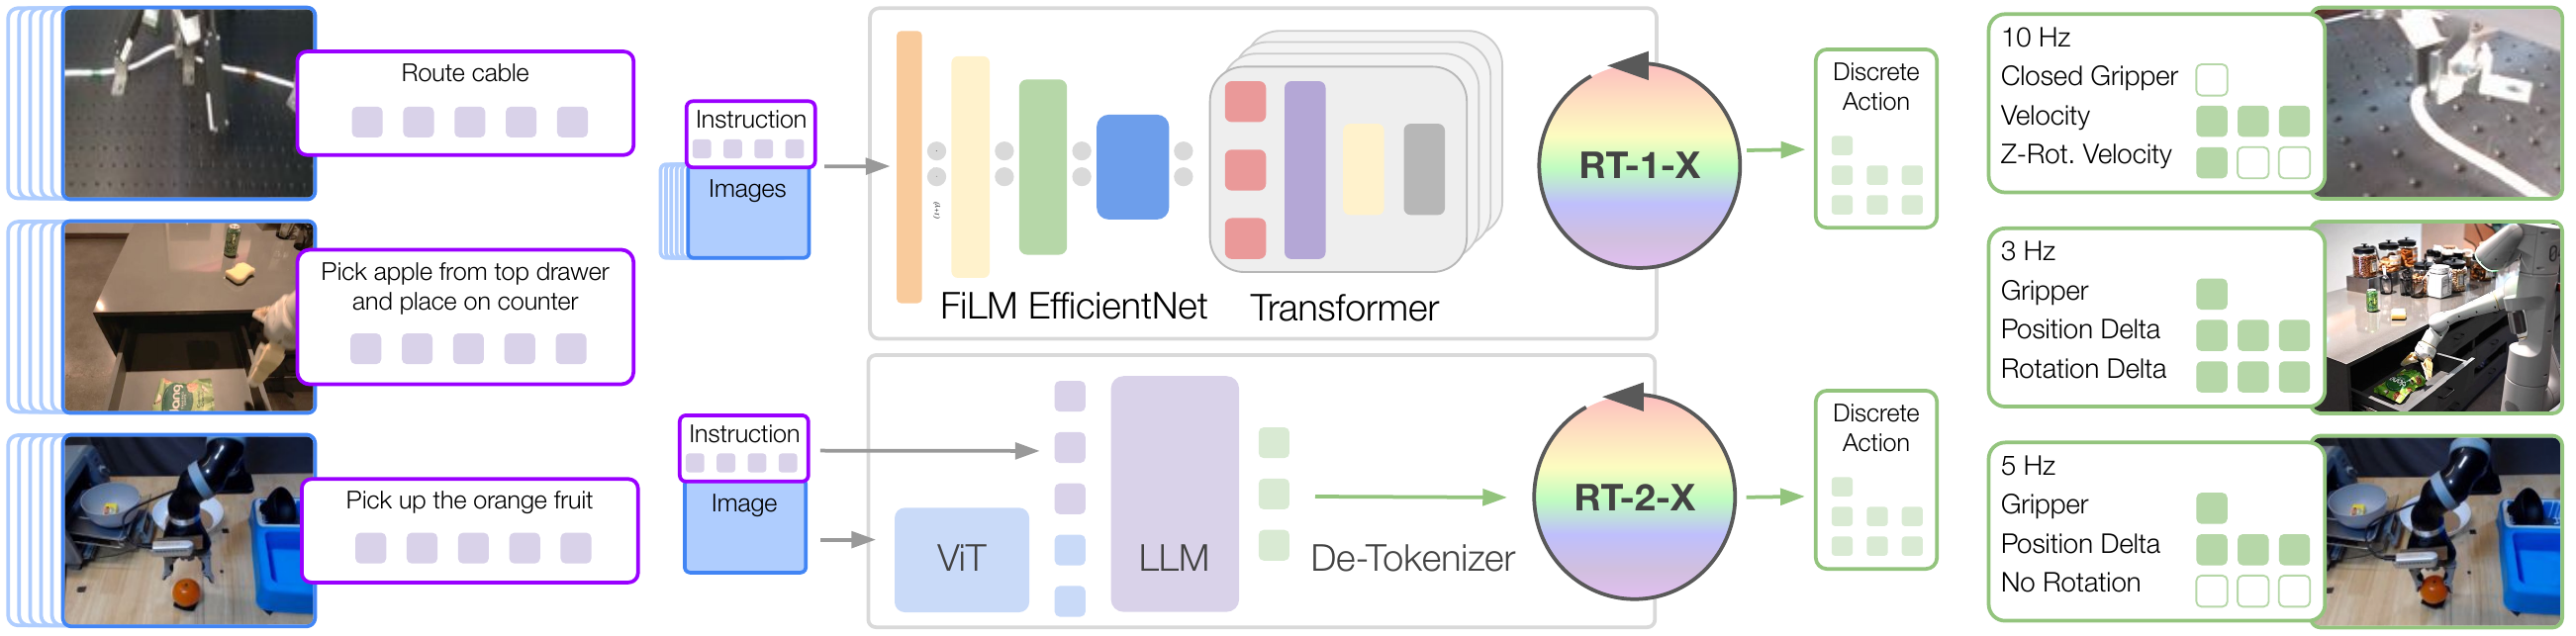
图 3:RT-1-X 用 FiLM-EfficientNet 与 Transformer 处理图像和指令;RT-2-X 用 VLM 骨干把离散动作作为语言 token 生成。来源:论文 Figure 3。
两种架构也构成实验变量:RT-1-X 测试小型机器人原生模型能否吸收异构数据,RT-2-X 测试大容量 Web 预训练模型能否把跨机器人经验转化为新技能。
4.3 训练目标与推理开销
两种模型都采用离散输出空间上的交叉熵。RT-1-X 在本地以约 3--10 Hz 运行,RT-2-X 通过云端服务查询。论文训练混合实际使用 9 种本体,而不是完整的 22 种;因此它证明的是"跨本体训练有效",不是"22 种本体全部共同训练后一定更好"。
5. Experimental Results:正迁移发生在哪里,又依赖什么
实验回答三个问题:多本体数据能否提升域内任务;能否带来未见任务和新技能;模型容量、Web 预训练、历史帧和数据组成各自起什么作用。评测在 6 台不同机器人上进行,共约 3,600 次试验。
5.1 域内性能:小数据领域收益最明显
在 Kitchen Manipulation、Cable Routing、NYU Door Opening、AUTOLab UR5 和 Robot Play 等小数据领域,RT-1-X 在 5 个数据集中的 4 个超过了各自数据集训练的 Original Method;论文 Figure 4 汇总的平均成功率比 Original Method 或单独训练的 RT-1 高约 50%。这说明大量其他机器人数据提供了可迁移的视觉、动作和语言模式。
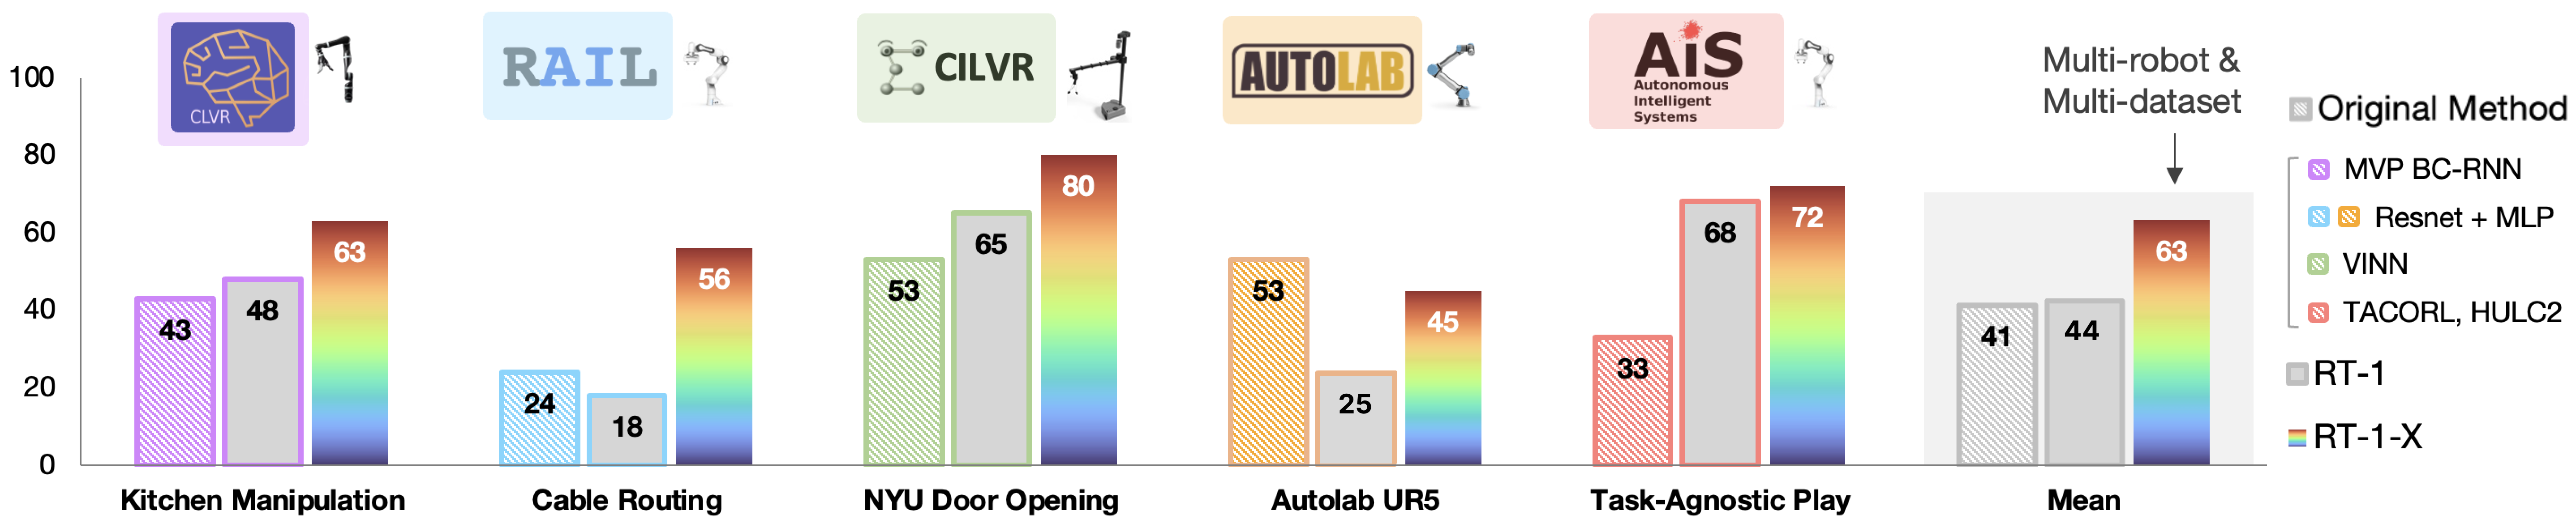
图 4:RT-1-X 与 Original Method、单域 RT-1 的平均成功率对比;相同 RT-1 架构下的提升主要来自跨本体共同训练。来源:论文 Figure 4。
在 Bridge 和 RT-1 这类本身已有大量轨迹的领域,RT-1-X 反而可能低于单域 RT-1,作者将其归因于模型容量不足导致的 underfitting。更大的 RT-2-X 在这些大数据场景中表现更强,说明异构数据规模化需要足够容量,单纯扩大数据并不能保证小模型受益。
5.2 分布外泛化:跨机器人数据带来新技能
RT-2-X 与 RT-2 在未见物体、背景和环境上的表现大致相当,原因是 RT-2 已经具备 Web 视觉语言预训练带来的泛化能力。更能体现 X-embodiment 价值的是 emergent skills 评测:在 Google Robot 上测试只出现在 Bridge 数据集、由 WidowX 机器人采集的技能。
RT-2-X 的 emergent skills 成功率为 75.8%,仅用 Google Robot 动作数据训练的 RT-2 为 27.3%,约提升 3 倍。去掉 Bridge 数据后,RT-2-X 降至 42.8%,说明提升并非只来自更大的训练混合,Bridge 中的跨机器人经验确实贡献了可追溯的技能迁移。
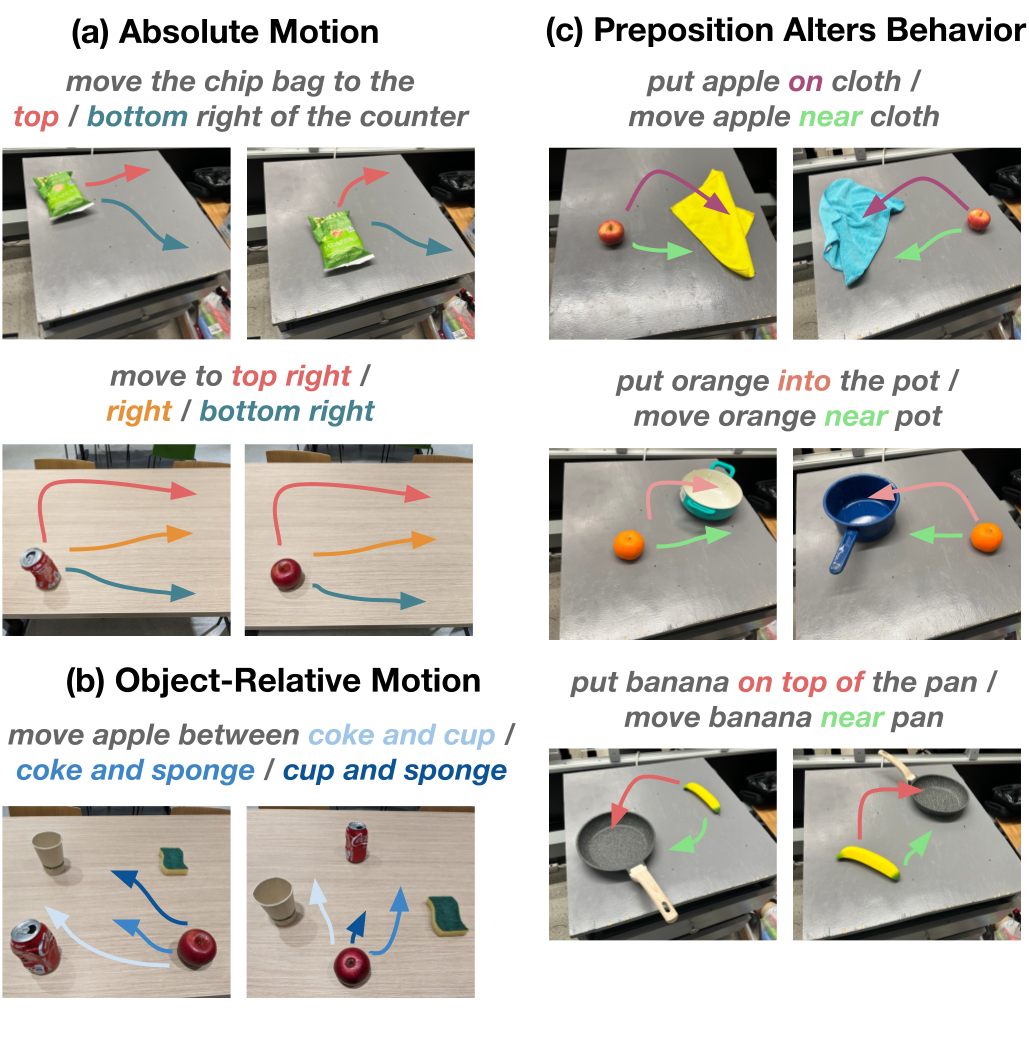
图 5:评测技能来自 Bridge 数据集,但不在 Google Robot 原始数据中,用于观察 WidowX 到 Google Robot 的跨本体迁移。来源:论文 Figure 5。
5.3 消融:容量、历史和 Web 预训练共同决定迁移上限
RT-2-X 55B 的 emergent skills 成功率为 75.8%,5B 版本在保留两帧历史时为 44.4%,说明模型容量对吸收异构机器人经验很关键。去掉历史图像后,5B 版本降到 14.5%;短时视觉历史帮助模型理解动作前后的状态变化,也缓解单帧观测的歧义。
Web 预训练同样不可替代:5B、两帧历史、从零训练的模型在 emergent skills 上为 0%,而使用 Web 预训练初始化、其余条件相近时为 48.7%。这组结果表明机器人数据提供动作 grounding,Web 数据提供物体和空间语义,二者共同构成 RT-2-X 的迁移能力。
猫先生认为 ,Open X-Embodiment 的实验没有把"数据越多越好"说成普遍规律。它给出了更具体的条件:小数据域受益于共享经验,大数据域需要更大模型,跨本体新技能还依赖来源数据、Web 预训练和时序历史。正迁移是数据、容量和表示共同作用的结果,不是简单的数据拼盘。
6. Discussion:一个开放数据基础设施的边界
Open X-Embodiment 提供统一机器人数据、数据工具和 RT-1-X checkpoint,把"跨本体机器人学习"变成可复用、比较和扩展的公共基线。
但论文的边界也很明确:实验没有充分覆盖传感和执行方式差异极大的机器人,也没有系统评估训练时完全未出现的新机器人;动作粗对齐会隐藏坐标系和动力学差异,RT-2-X 的云端推理也增加了部署成本。
总结:RT-X 证明的不是"统一一切",而是"共享经验可以工作"
Open X-Embodiment 用一个跨机构数据仓库和两个已有 Transformer 架构验证了 X-embodiment learning。数据层贡献是把 60 个数据集整理为 22 种机器人本体、527 项技能和 160,266 个任务的共同资源;模型层贡献是展示 RT-1-X 和 RT-2-X 可以从其他机器人经验中获得域内提升和新技能;实验层贡献是把正迁移拆解为数据规模、模型容量、Web 预训练和视觉历史的共同结果。
猫先生认为,这篇论文留给后续 VLA 和机器人基础模型最值得带走的一句话是:**跨本体泛化首先是数据组织问题,其次才是网络结构问题。**当数据协议、动作表示和评测任务能够被更多机构共同维护,模型规模化才有可能从单个实验室走向机器人生态。
参考资料
- Open X-Embodiment Collaboration,arXiv 论文页面
- Open X-Embodiment 团队,项目主页
- Open X-Embodiment 团队,论文 PDF
推荐阅读
► 技术资讯: 魔方 AI 新视界
► 项目应用:开源视界
► 技术专栏: 多模态大模型最新技术解读专栏 | AI 视频最新技术解读专栏 | 大模型基础入门系列专栏 | 视频内容理解技术专栏 | 从零走向 AGI 系列