个人电脑搭建AI-Qwen3-8B-学习记录
电脑配置
CPU:i7-11800H
内存:16*2=32G 3200
存储:1TSSD
显卡:RTX3060-6G
AI知识扫盲(因为我也不会)
LLM :Large Language Model
用的什么deepseek,豆包,千问,Kimi就剩LLM。
Token :大模型处理文本的最小单元。
一个中文,一个词,就剩1个token
- 输入:你的提示词、流量特征、RAG 检索出来的文档,都会切成 token 送入模型
- 输出:模型生成的每一句话,一个一个 token 吐出
- 限制:模型有上下文窗口(最大 token 上限),超过就会截断内容
- 显存消耗:token 越多,KV 缓存越大,显存占用越高,推理越慢
KV缓存(KV CAche)
简单理解为AI专用的RAM,但是用完就丢,可以理解为推算的草稿纸
特点:只存活在当前这一轮对话 / 任务,任务结束就清空,不会永久记忆
权重(Weights)
模型训练完成后保存的一长串数字,就是模型学到的全部知识。
- 存在模型文件(GGUF)里面,Ollama pull 下载的就是权重文件
- 推理时读取权重,完成计算;普通推理不会修改权重(微调才改权重)
RAG 检索增强生成
可以理解为外置的知识库,自己搭建维护的WIKI
Agent AI 智能体
如果说AI是大脑,agent就是他的手手脚脚,赋予他去调用AI的能力。
Skill
可以理解为是一个固定的模板,也就是固定提示词啥的,不用每次都一堆提示词。给AI-Agent的固定能力
Ollama
AI的专属管理器,不用他也可以,只是用了可以方便很多
上下文窗口 Context Window
模型一次性最多能处理的 Token 总数(输入 + 输出总和)。
比如 32k 上下文 = 最多 32768 个 token。超过上限,模型会截断丢掉最前面内容。上下文越长,KV 缓存越大,显存占用越高,推理越慢。
提示词 Prompt
发给大模型的文字指令。包含任务描述、规则、示例、背景资料(RAG 检索回来的内容)。
- 系统提示词 System Prompt:固定底层规则,定义角色、限制、输出格式(你给溯源 Agent 写的规则)
- 用户提示词 User Prompt:单次任务输入(你的流量特征、取证信息)
API 应用程序接口
程序之间通信的通道。脚本不用直接加载模型,发 http 请求给 Ollama 服务获取结果。云端模型(Grok/Claude)也是 API 调用
AIGC 生成式人工智能
AI 生成内容:文字、图片、音频、视频。LLM 只是 AIGC 其中文字分支,就是说AI生成的东西都叫AIGC,包括任何东西
模型多少B的解释
- 7B = 7 Billion = 70 亿参数
- 8B = 80 亿参数
- 14B = 140 亿参数
- 27B = 270 亿参数
- 70B = 700 亿参数
正常情况是越大越好,但是代价也是硬件成本越高
但
例:训练差的14B模型还不如效果比较好的7B模型
开始安装
根据自己电脑配置量力而行,可以去问AI
我这里选的是Qwen3.6的7B
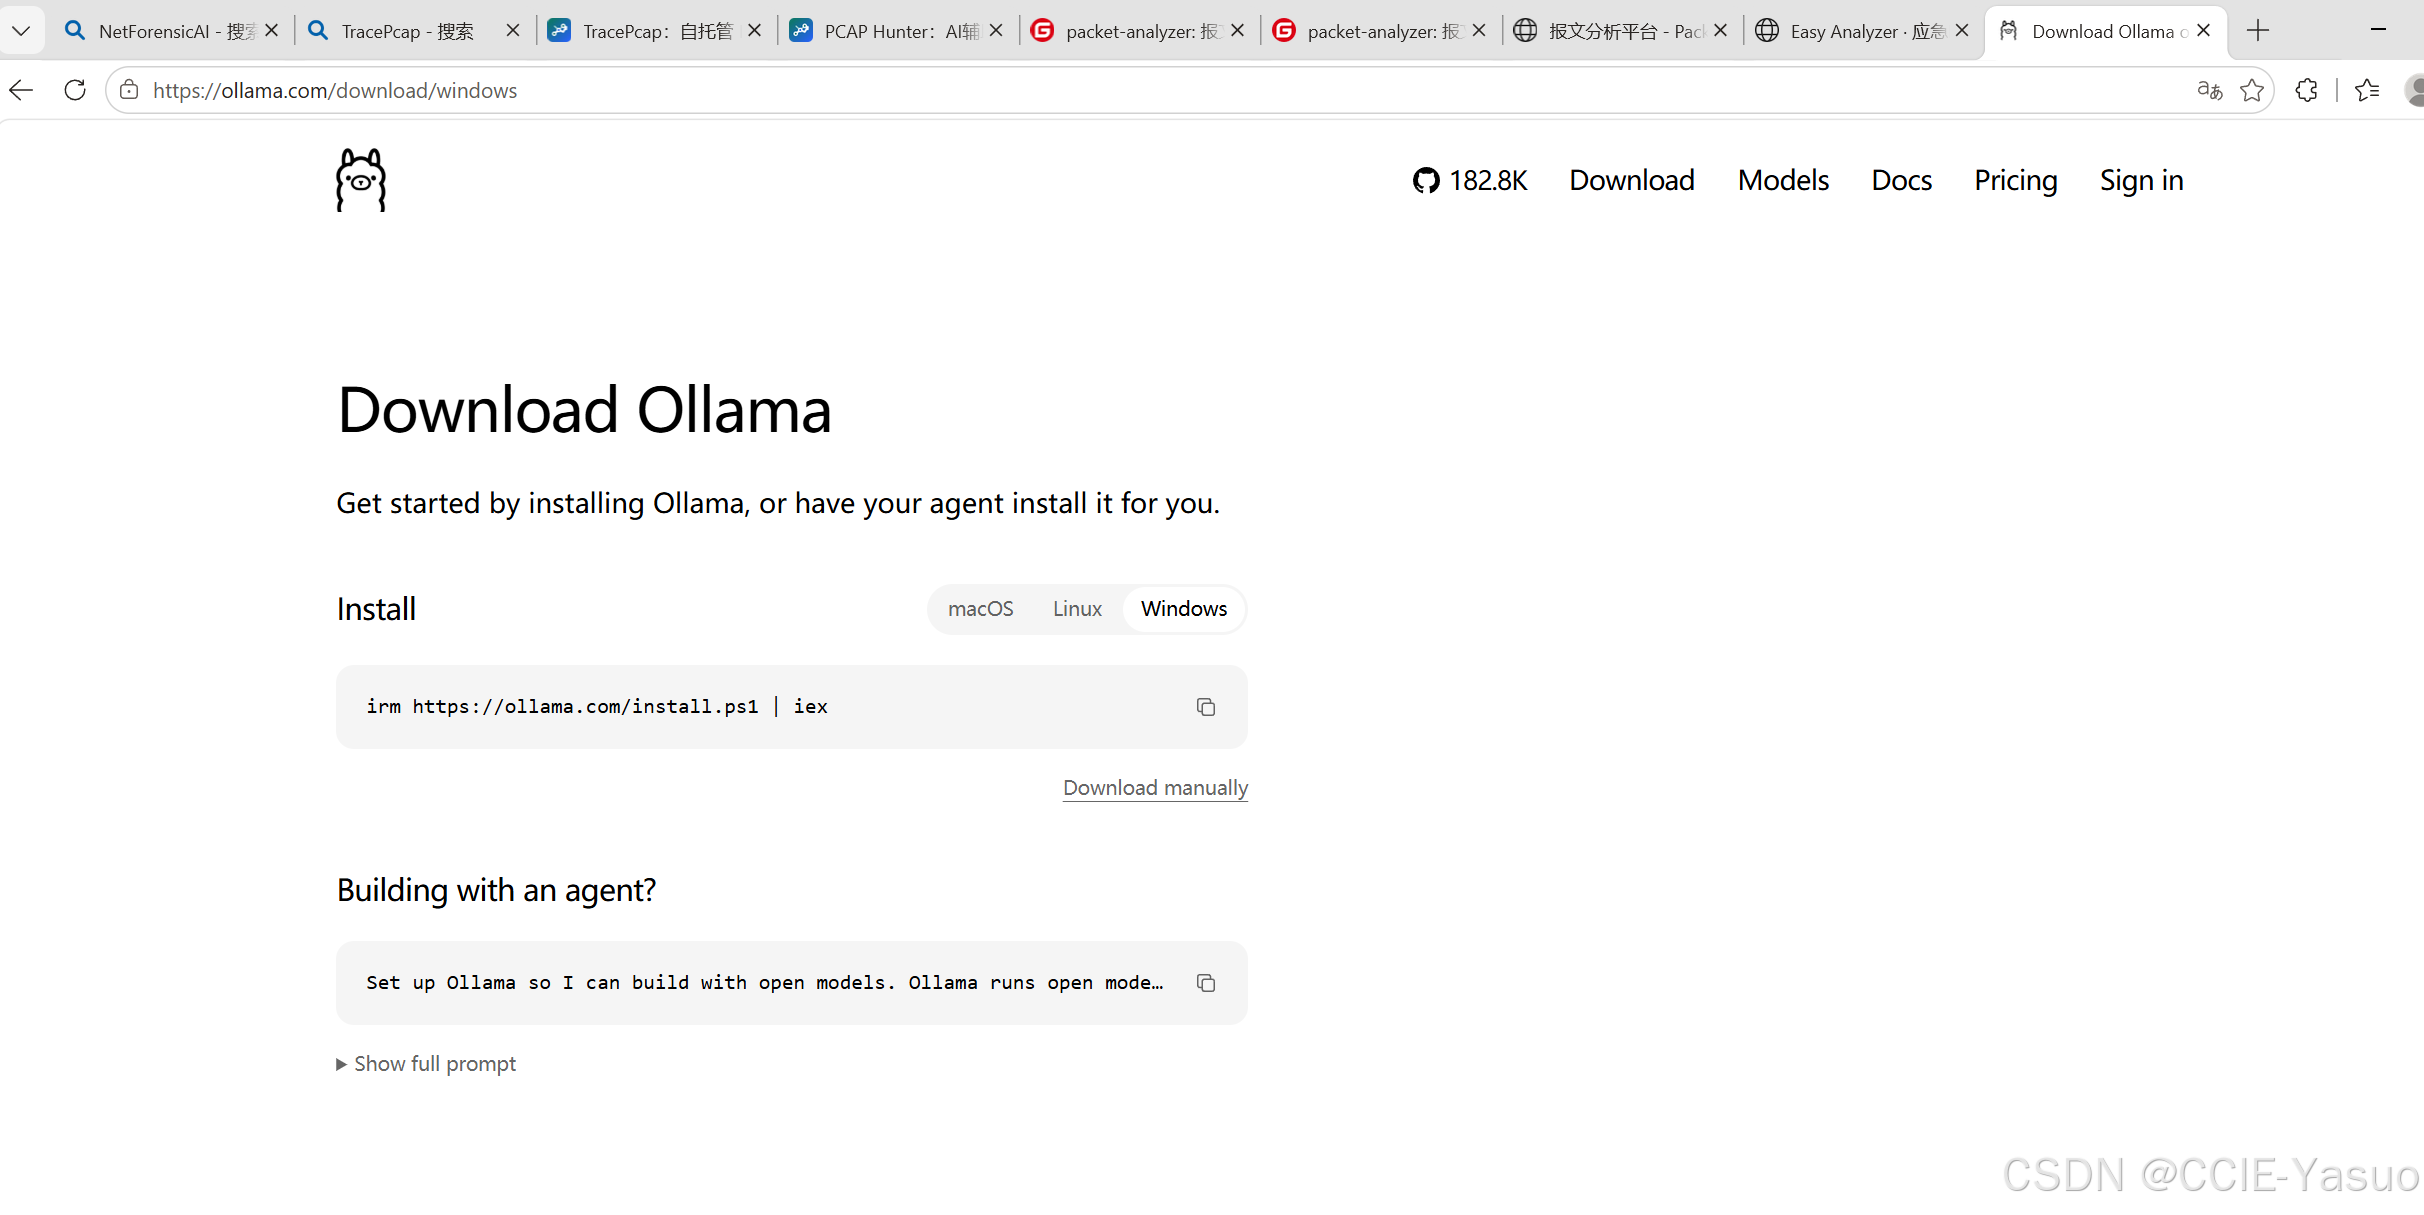
Ollama下载
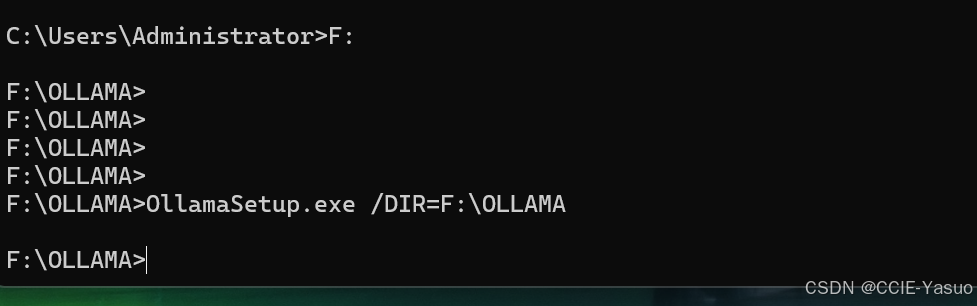
下载好之后默认安装是C盘的,可以手动用命令行修改路径,但是无论如何一定会有一些东西写入C盘
比如我要安装F盘就这样写,要其他盘符的就自己改
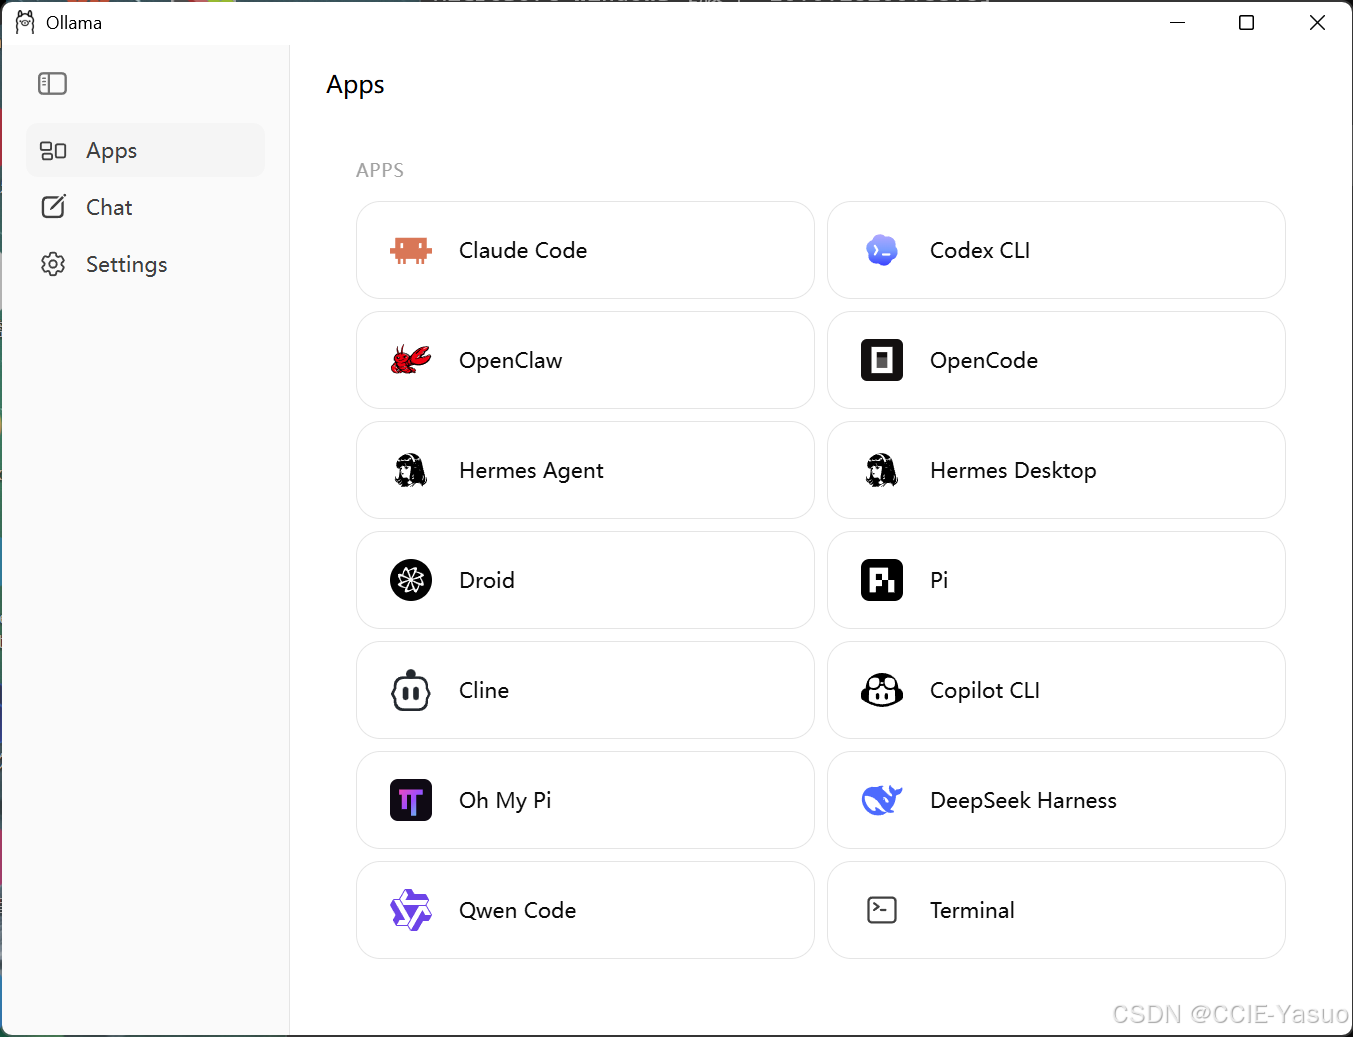
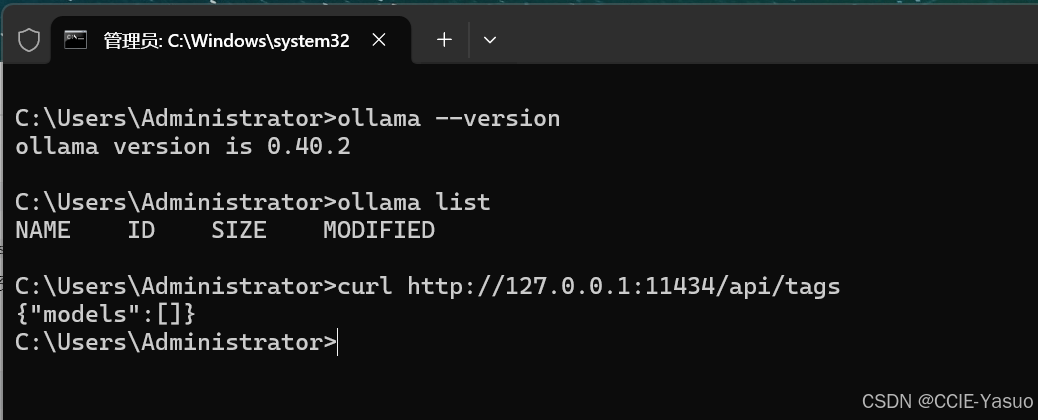
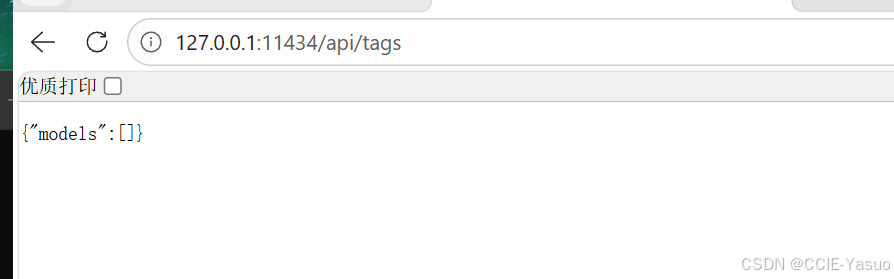
安装好之后是这样的,同时在CMD可以用命令去测试是否成功
第一个是看版本
第二个是看是否有安装本地大模型
有些旧版本可能会显示running,这个输出models也是一样的,是一个json
添加环境变量
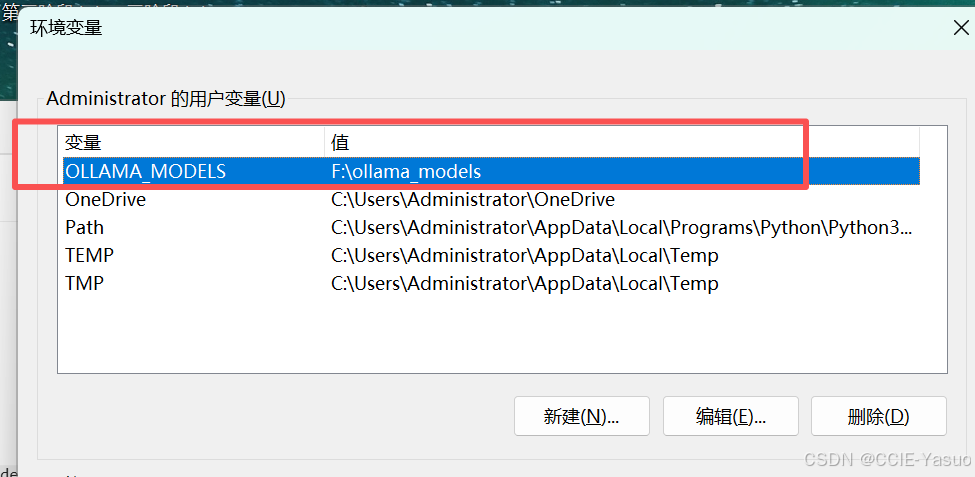
我是F盘,根据自己实际的来
好了之后开一个新的cmd去验证
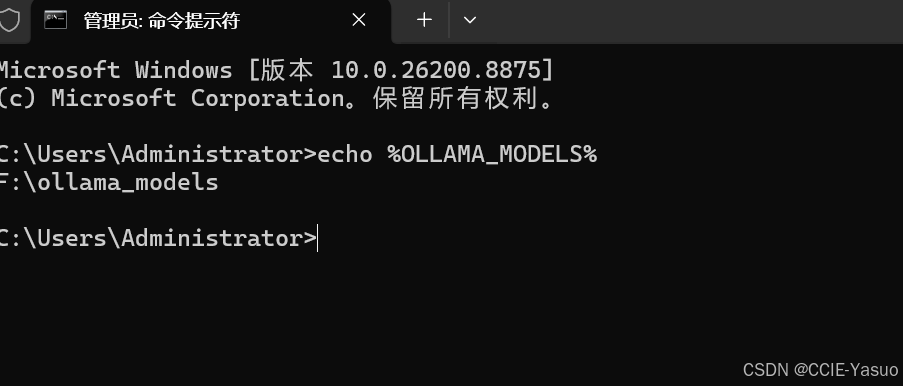
能找到你的盘符那就是对的
测试下载nomic-embed-text
专门给RAG用的
把一段文字(转换成一串很长的数字数组,叫向量 (vector) 。
原理:语义含义相近的文字,生成的向量在高维空间距离很近 。
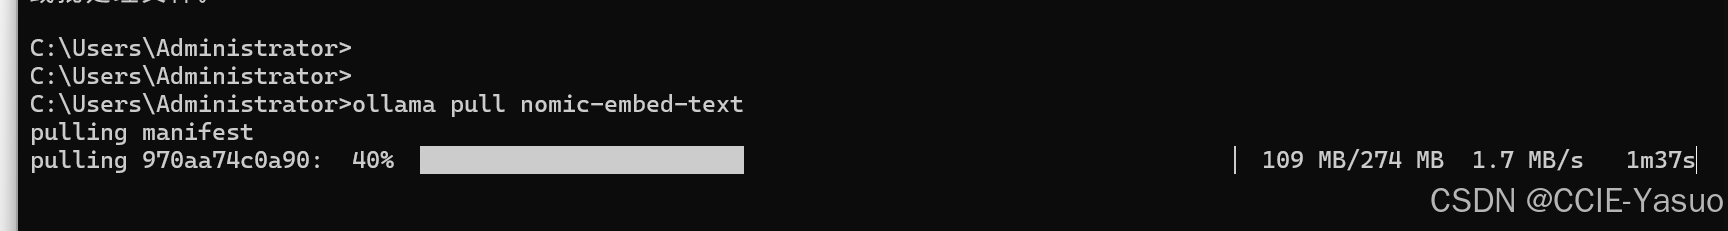 Embedding 模型只负责算相似度
下载完了之后看他是不是在你要的盘符
然后
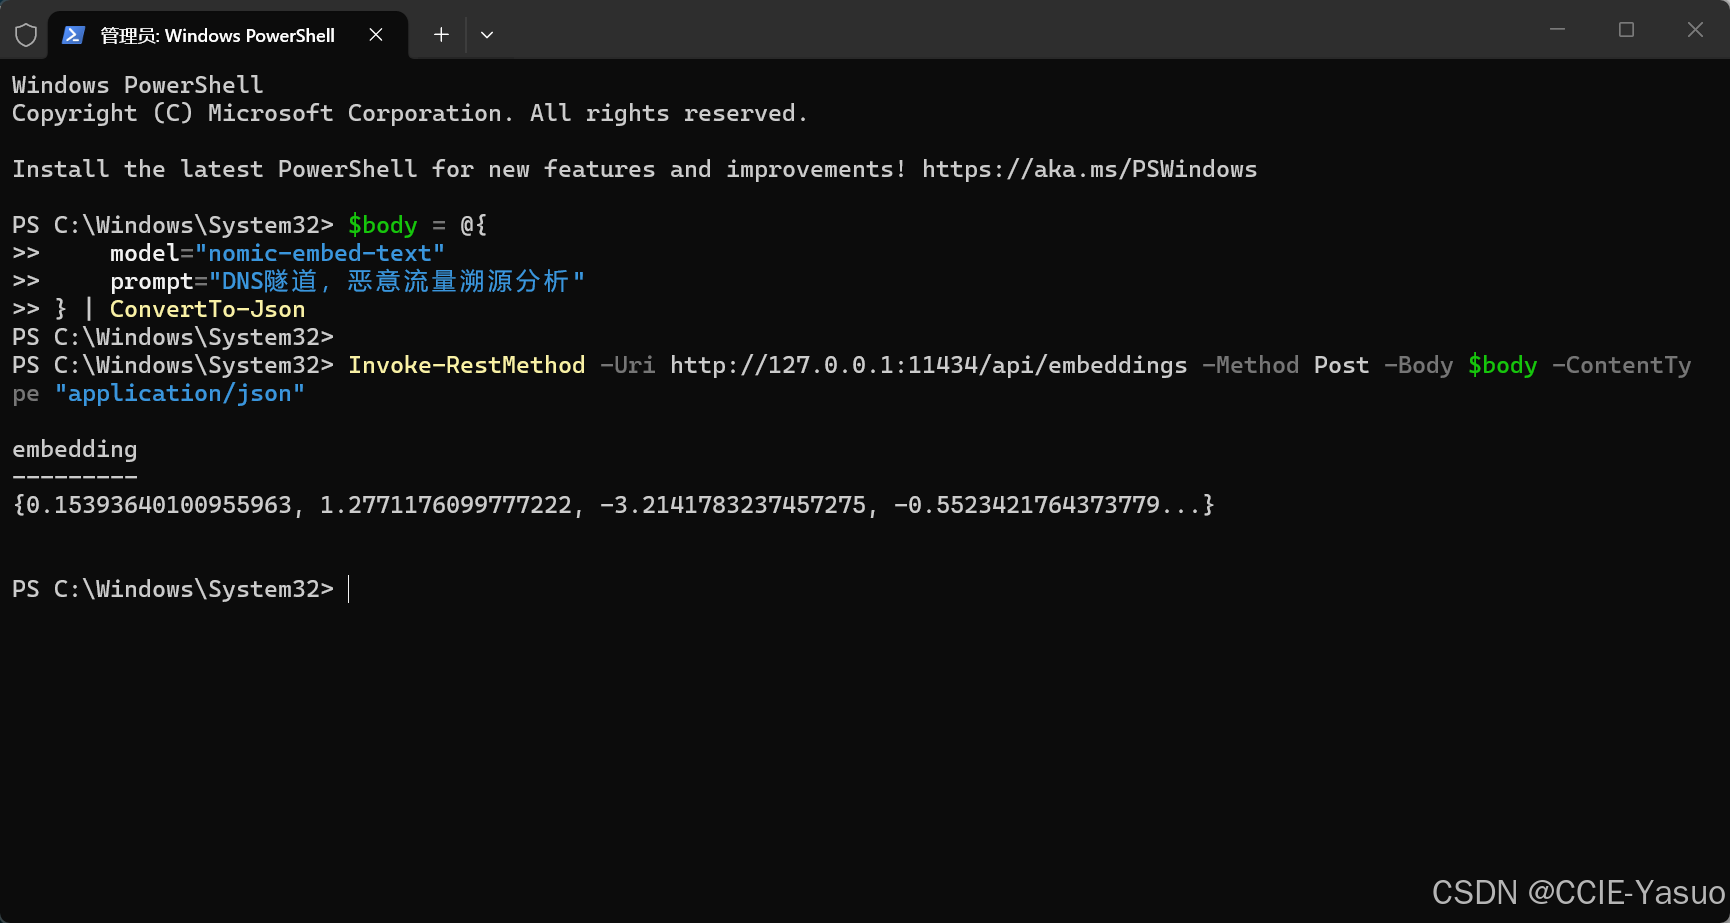
$body = @{
model="nomic-embed-text"
prompt="DNS隧道,恶意流量溯源分析"
} | ConvertTo-Json
Invoke-RestMethod -Uri http://127.0.0.1:11434/api/embeddings -Method Post -Body $body -ContentType "application/json"
已经成功返回embedding向量数组,说明:
- Ollama 服务正常监听 11434 端口
- nomic-embed-text 模型加载正常
- 嵌入向量 API 完全可用,RAG 的核心组件已经就绪
Download-AI
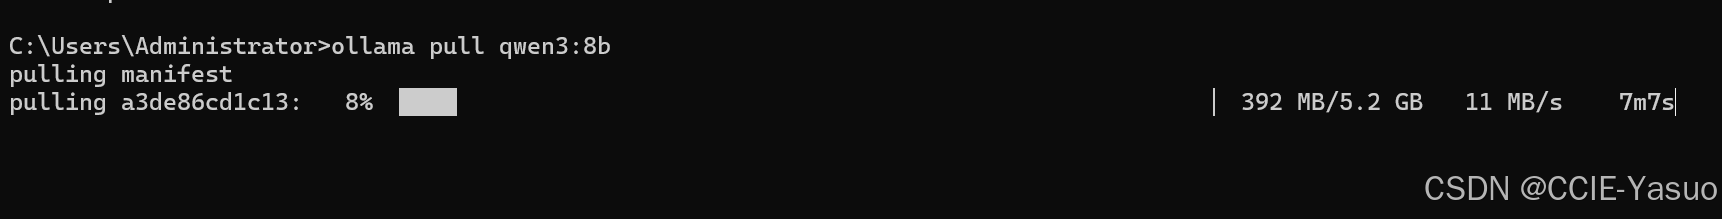
cmd
ollama pull qwen3:8b
我这里选的是千问的3的8B(下载还挺慢的可能得个半小时+)
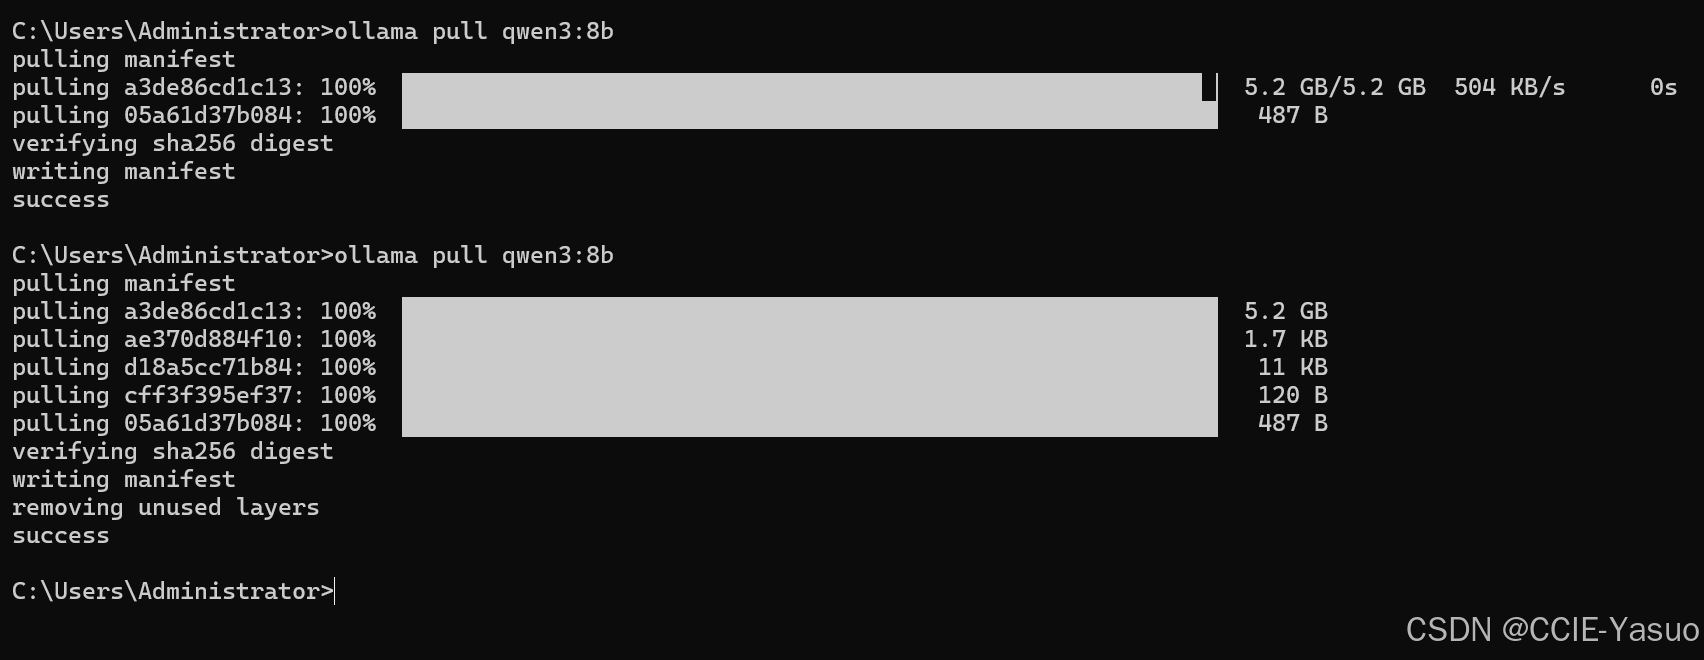
下载好了
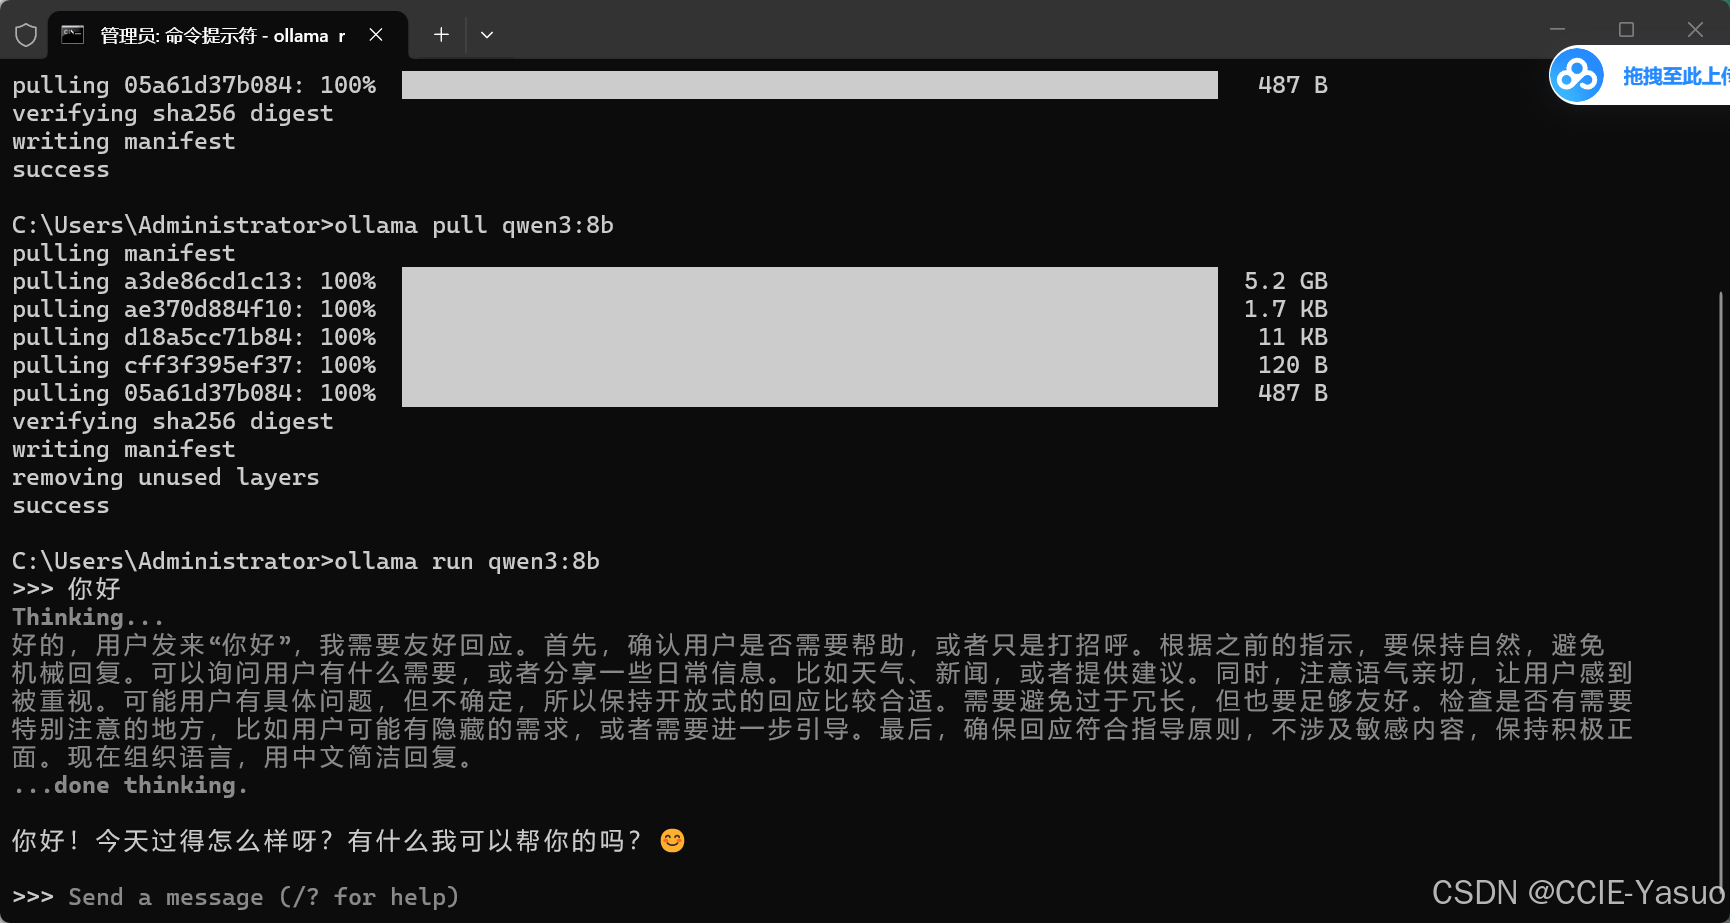
就已经可以用了
生成速度取决于显卡性能,风扇转是一定的了
然后打开会这样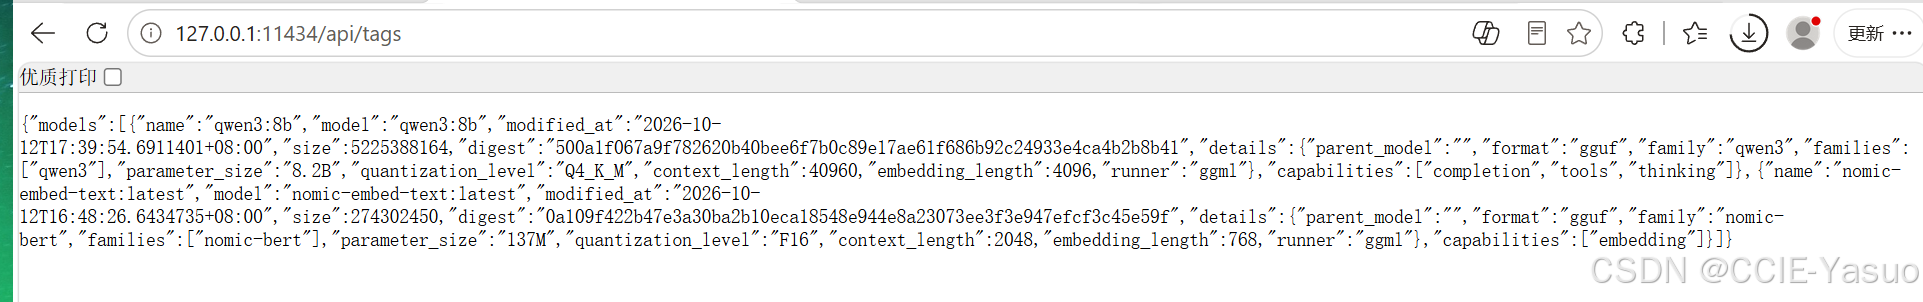
因为没有GUI图形化界面,所以可以去下一个
推荐原生的open-webui(可以用pip下载,也可以找exe)因为我的python版本高不支持,我就懒得降级了,直接下exe
https://github.com/open-webui/desktop
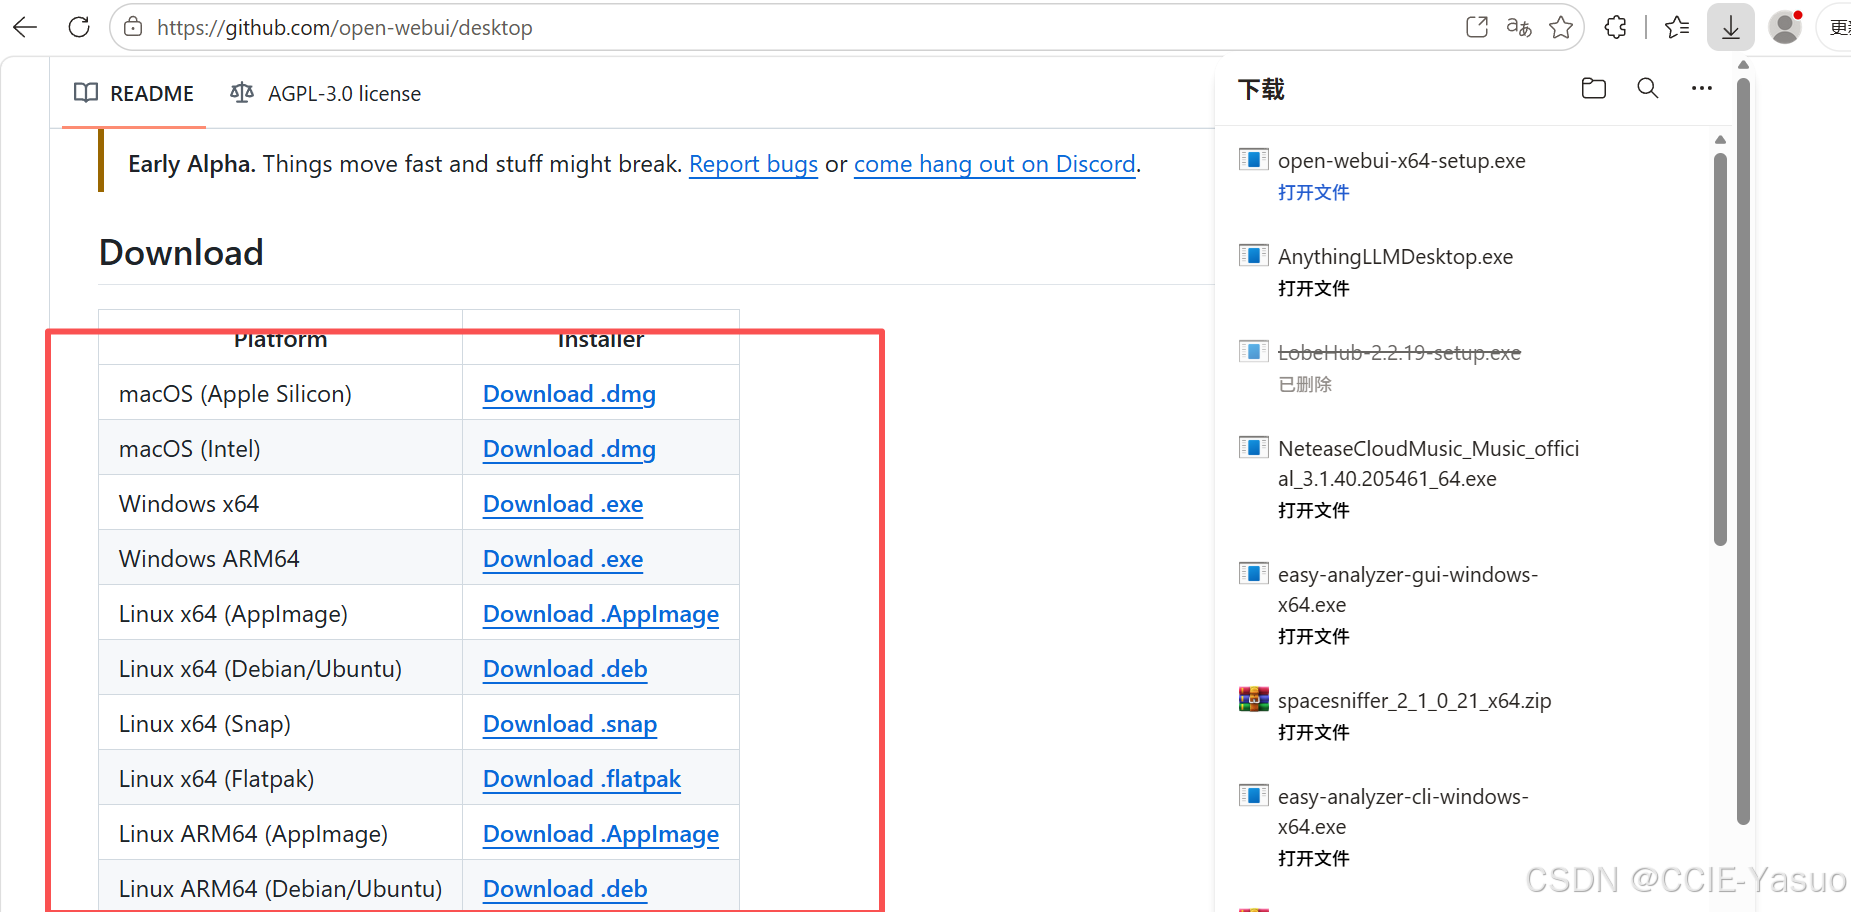
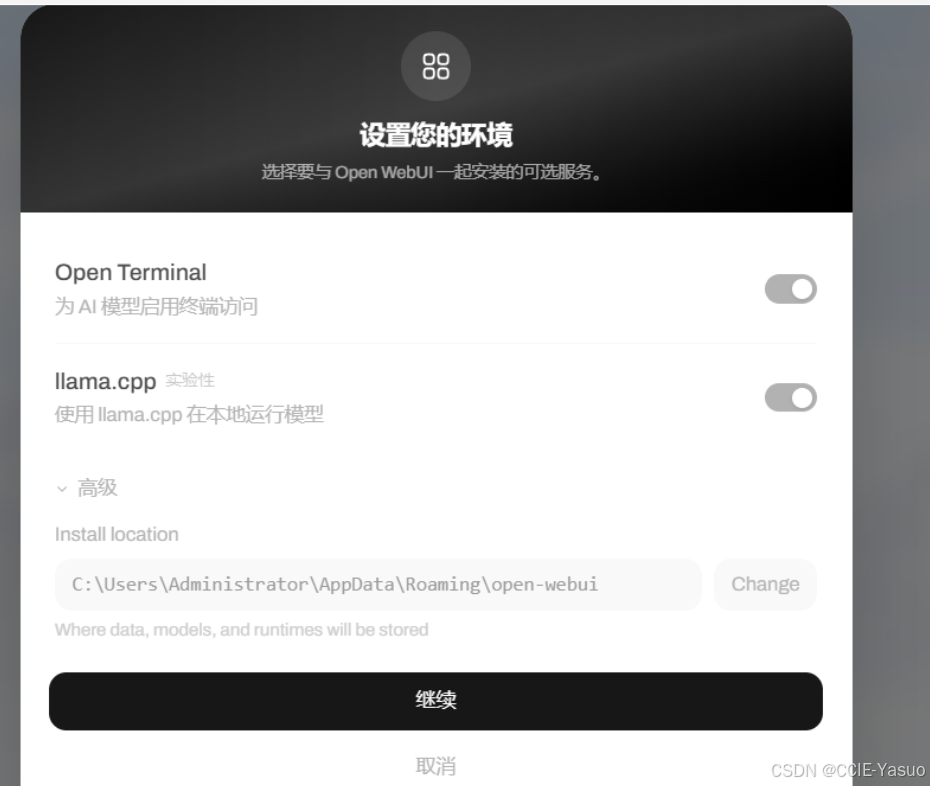
下载完之后这个啥都不用勾选,直接next就好了他会下载一些东西
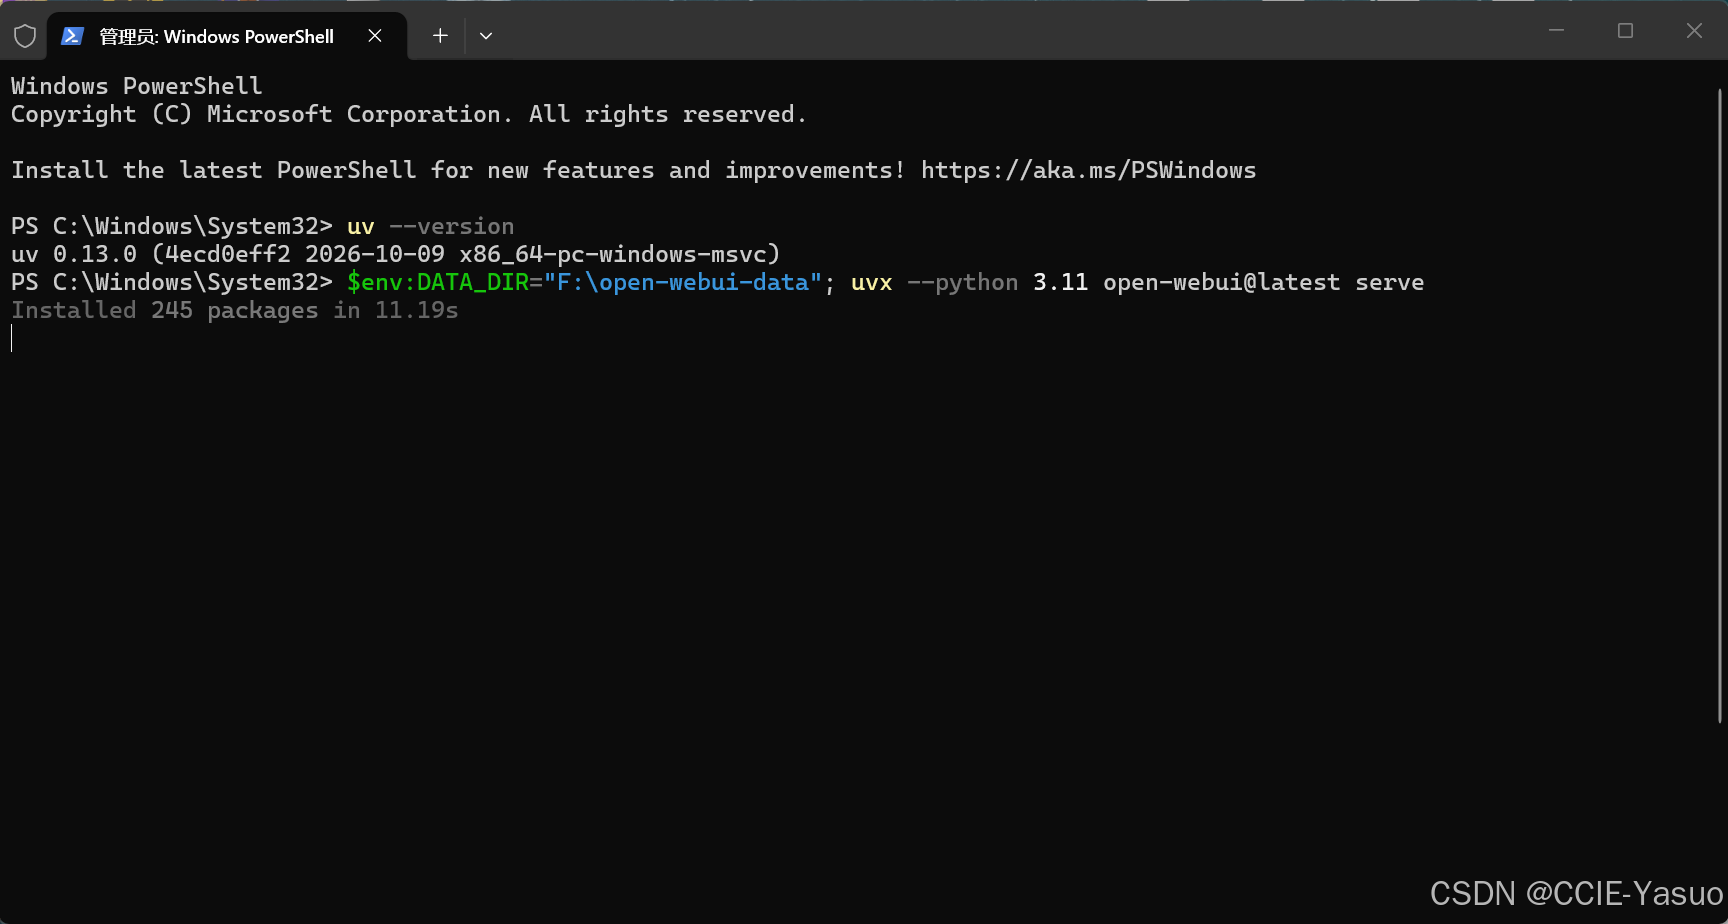
因为我的电脑python高,不想降级
所以用了uv去下载一个独立的python
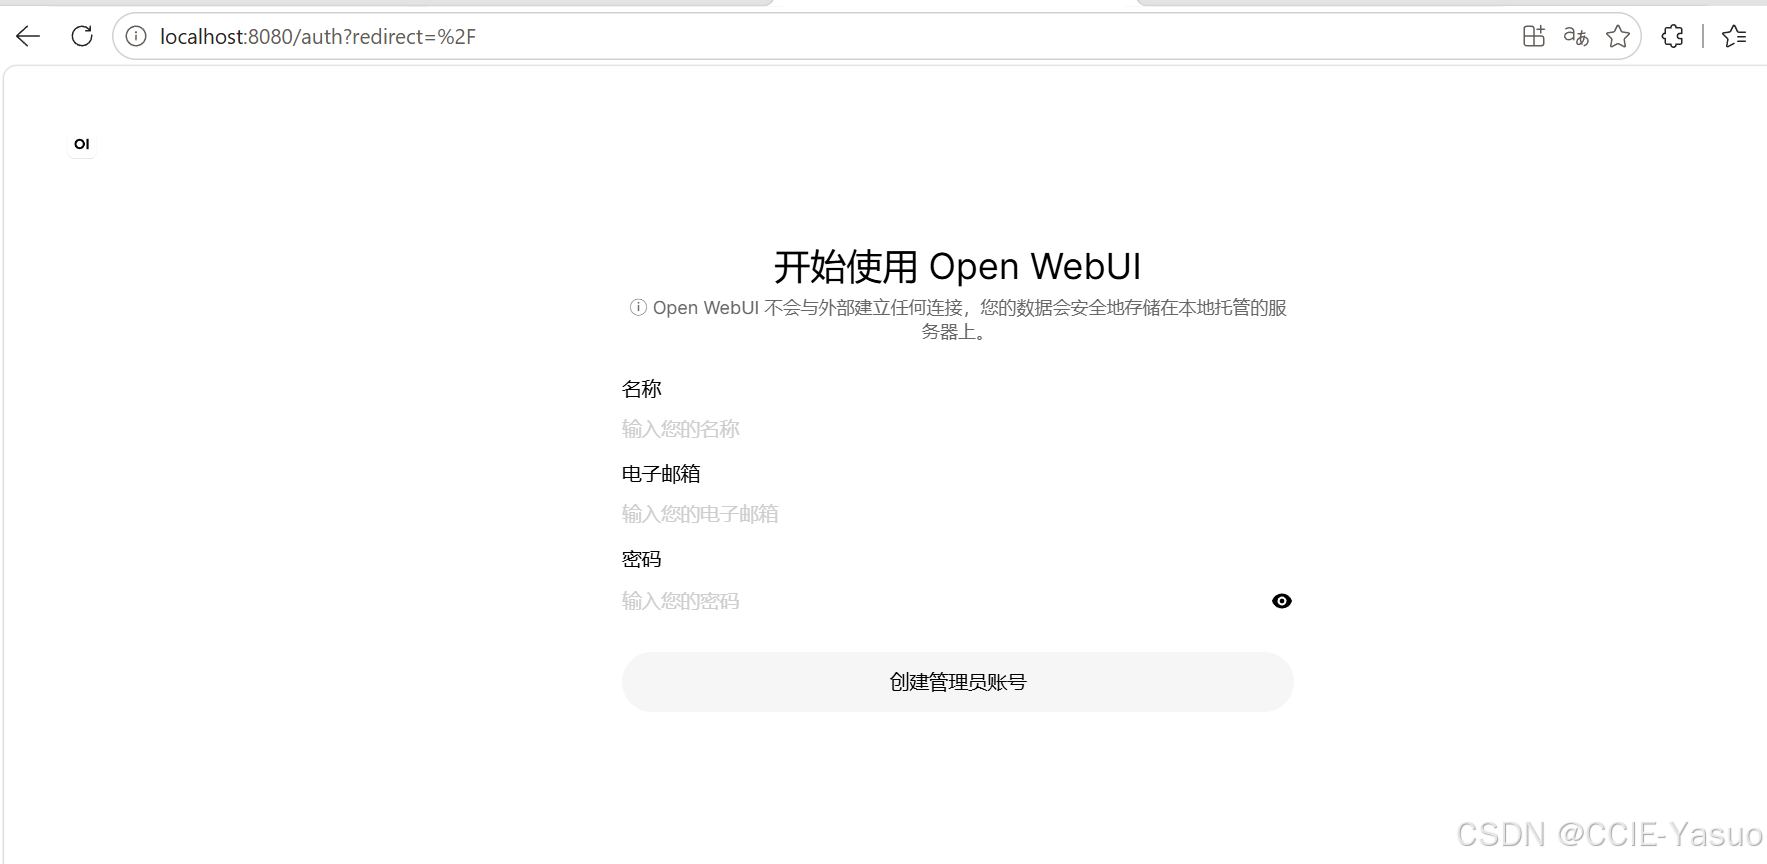
上面这个管理账号啥的自己随便弄,反正是在本地的不用管他。
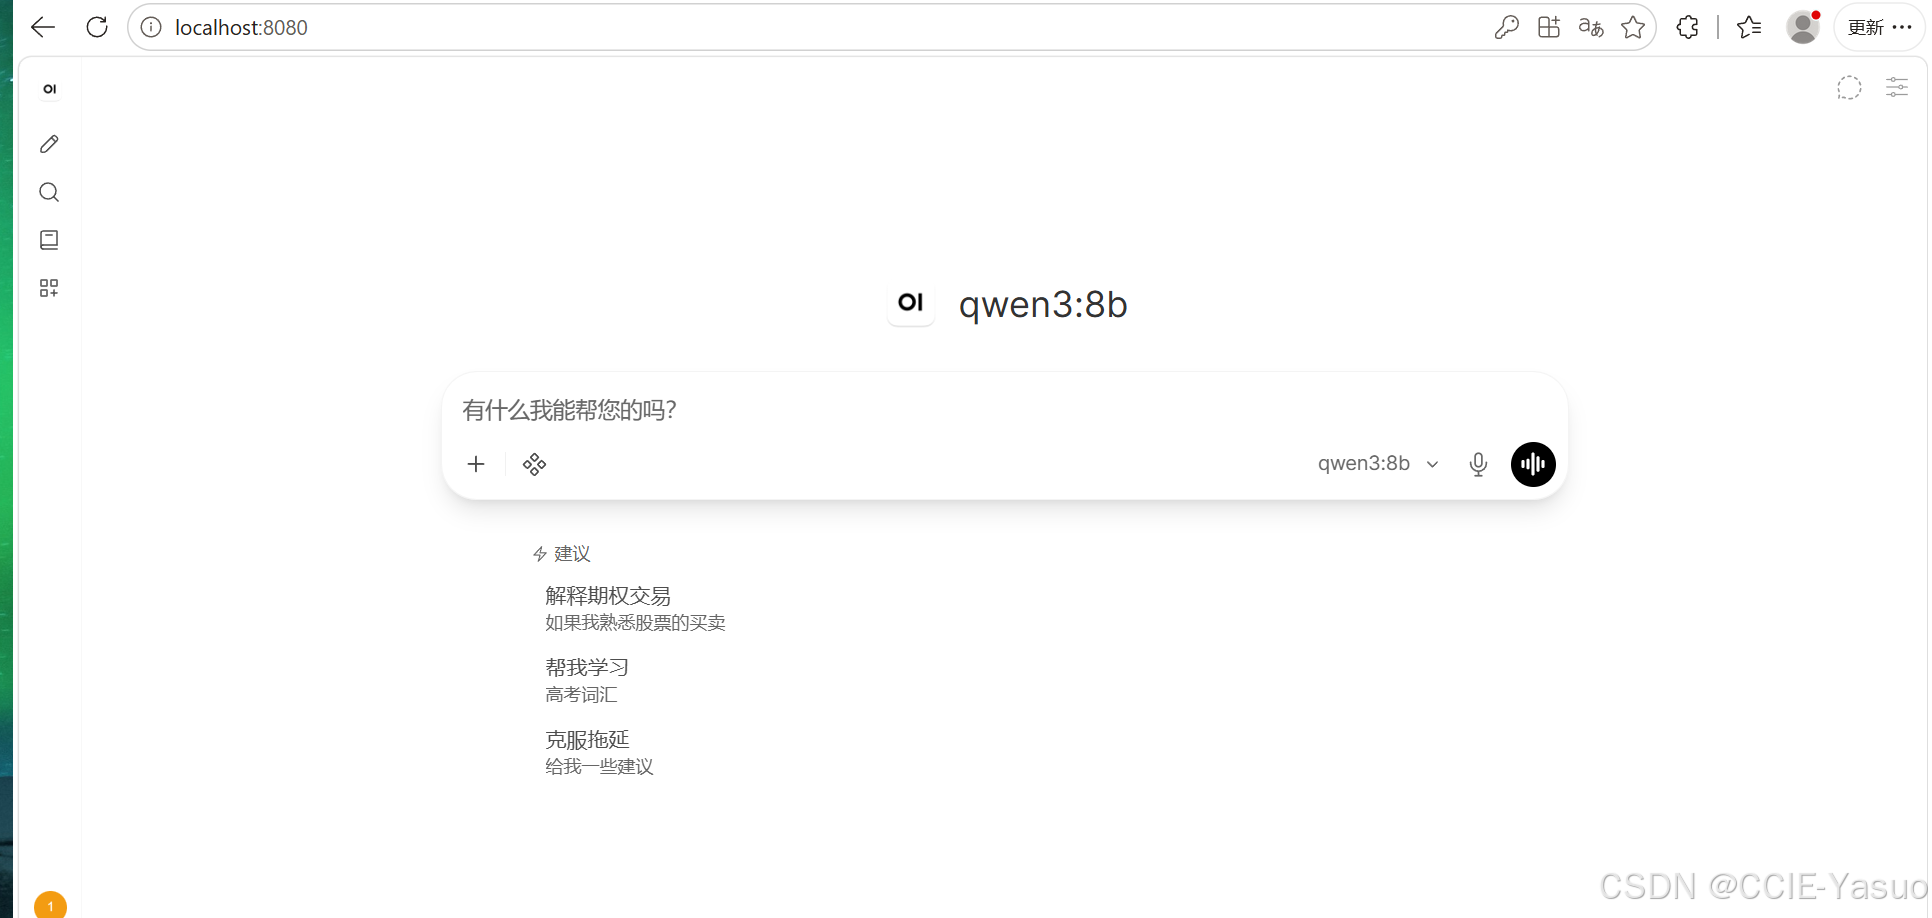
这样就出来了这个自己电脑上的千问了
然后以后每次开都要
假设现在关机了
然后重新要用的时候
cmd打开(不要关)
ollama serve 启动服务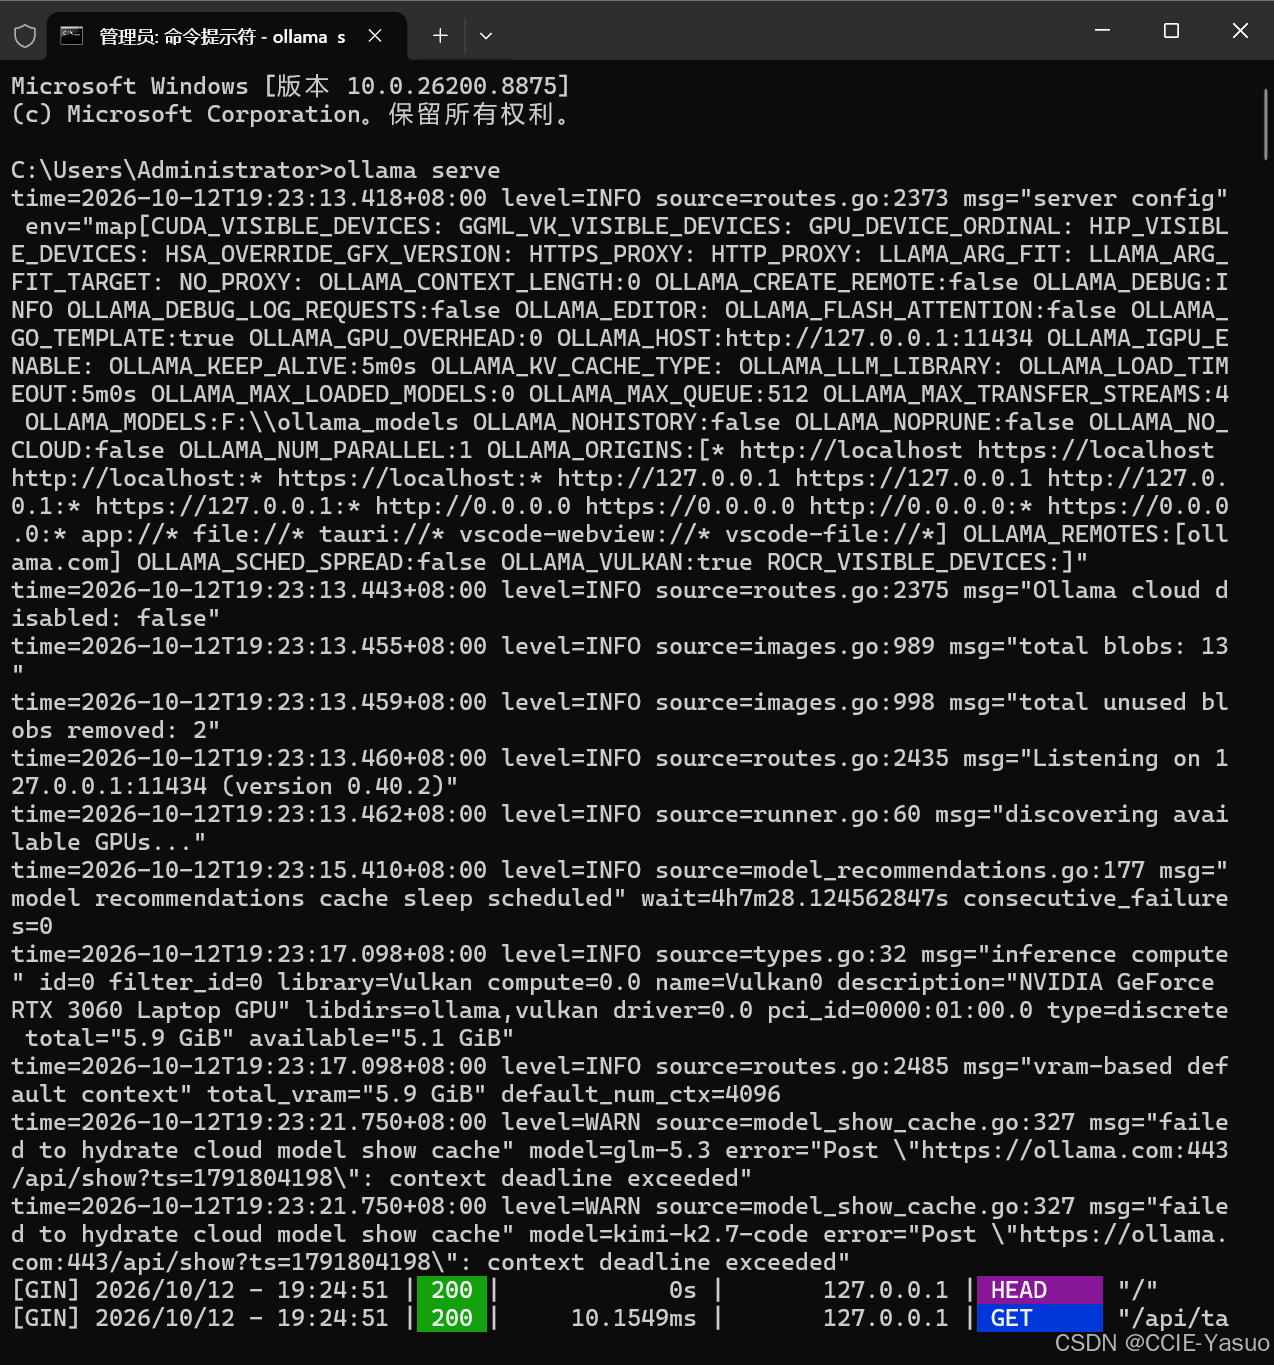
启动完之后可以通过ollama list去查看是否存活
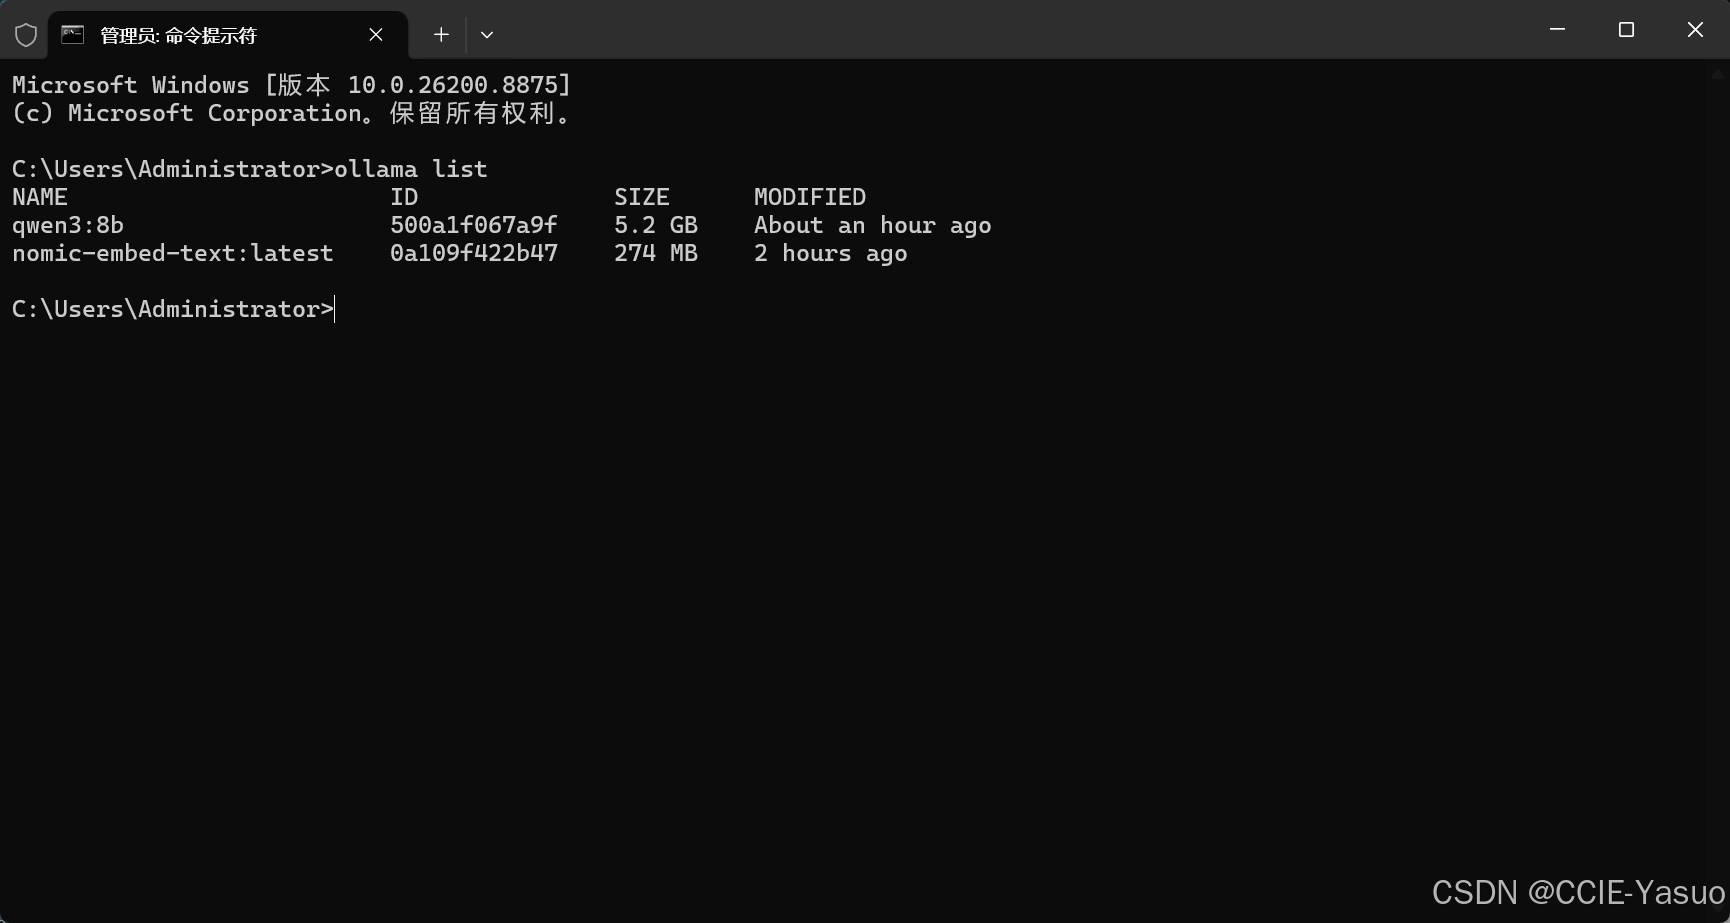
powershell(管理员执行,也不要关)
$env:DATA_DIR="F:\open-webui-data"; uvx --python 3.11 open-webui@latest serve
你的openwebui安装在哪就执行那,自己找路径
这个可能只有我能用到
因为我python环境是3.13,他最高只支持3.11所以我必须用一个独立的python去启动这个web界面,这个仅仅是web界面,如果不想用,直接用cmd的命令行或者任何一个工具,也是可以的。
然后浏览器
就可以打开了