从今天开始,我们就要正式翻开一个全新的篇章------【从零入门数据结构与算法】!
有诗云:"开天辟地头一篇,道轮沧海尽书言。"那么,我们就顺着这句诗,往下把数据结构与算法的知识点一个一个铺开。
数据结构与算法,从来不分家。像算法复杂度、顺序表和链表、栈和队列、二叉树、排序这些内容,乍一看,体量似乎没有C语言那么大,可实际上恰恰相反,这一块的内容,丰富得很!所以,大家一定要打起十二分的精神,认认真真地学。
前面提到的这些,还只是数据结构与算法这片汪洋里的冰山一角。当然,不是说它们简单,更不是说它们不重要,恰恰相反,它们一点都不简单,而且极其重要。就像闯关游戏,得由易到难,一步一步来。这些内容,都只是初阶的数据结构知识,却是往后一切大厦的根基。
运输大队长,懂的友友们都懂哈,他的文胆陈布雷,就是写出"如果战端一开,那就是地无分南北,人无分老幼,无论何人,皆有守土抗战之责任,皆应抱定牺牲一切之决心"的那位,曾说过一句话,和博主下面这句有异曲同工之妙:"大厦将构筑于沙丘之上。"正因如此,大家一定要认真学习数据结构与算法的内容,把基础打牢、夯实!
在C语言部分,我已经向大家说明了学习数据结构所需要的C语言基础:指针(一级、二级)、结构体、动态内存管理、递归(函数栈帧的创建与销毁)。这几个板块,如果大家有些陌生了,可以去C语言专栏重温一下。专栏链接,博主在每篇文章的目录下面都会附上,大家点击传送就好。
那么,废话不多说,我们就从算法复杂度开始,正式进入数据结构与算法的学习!希望我的博客对友友们有所帮助!我们共同进步!
目录
[1.1 什么是数据结构](#1.1 什么是数据结构)
[1.2 什么是算法](#1.2 什么是算法)
[1.3 为什么要学习数据结构与算法](#1.3 为什么要学习数据结构与算法)
[2.1 衡量算法好坏的核心指标:算法效率](#2.1 衡量算法好坏的核心指标:算法效率)
[2.2 复杂度的概念与意义](#2.2 复杂度的概念与意义)
[2.2.1 什么是复杂度](#2.2.1 什么是复杂度)
[2.2.2 为什么需要分析复杂度](#2.2.2 为什么需要分析复杂度)
[3.1 时间复杂度](#3.1 时间复杂度)
[3.1.1 时间复杂度的基本定义](#3.1.1 时间复杂度的基本定义)
[3.1.2 从T(N)函数到大O渐进表示法](#3.1.2 从T(N)函数到大O渐进表示法)
[3.1.3 时间复杂度计算实例](#3.1.3 时间复杂度计算实例)
[3.1.3.1 示例一 计算Func2的时间复杂度。](#3.1.3.1 示例一 计算Func2的时间复杂度。)
[3.1.3.2 示例二 计算Func3的时间复杂度。](#3.1.3.2 示例二 计算Func3的时间复杂度。)
[3.1.3.3 示例三 计算Func4的时间复杂度。](#3.1.3.3 示例三 计算Func4的时间复杂度。)
[3.1.3.4 示例四 计算strchr的时间复杂度。](#3.1.3.4 示例四 计算strchr的时间复杂度。)
[3.1.3.5 示例五 计算冒泡排序的时间复杂度。](#3.1.3.5 示例五 计算冒泡排序的时间复杂度。)
[3.1.3.6 示例六 计算Func5的时间复杂度。](#3.1.3.6 示例六 计算Func5的时间复杂度。)
[3.1.3.7 示例七 计算阶乘递归Fac的时间复杂度。](#3.1.3.7 示例七 计算阶乘递归Fac的时间复杂度。)
[3.2 空间复杂度](#3.2 空间复杂度)
[3.2.1 空间复杂度的基本定义](#3.2.1 空间复杂度的基本定义)
[3.2.2 通过实例掌握空间复杂度的计算](#3.2.2 通过实例掌握空间复杂度的计算)
[3.2.2.1 示例一:如何计算BubbleSort的空间复杂度?](#3.2.2.1 示例一:如何计算BubbleSort的空间复杂度?)
[3.2.2.2 示例二:如何计算阶乘递归函数Fac的空间复杂度?](#3.2.2.2 示例二:如何计算阶乘递归函数Fac的空间复杂度?)
一、先聊聊:数据结构与算法到底是什么
还没正式开讲之前,估计不少友友心里都犯过嘀咕:这俩玩意儿,凭什么非得捆在一块儿讲?别急,在扎进内容之前,我们先把它们各自的面目认清楚。
1.1 什么是数据结构
数据结构,英文叫Data Structure,说的是计算机存储、组织数据的那套方式,增、删、查、改,全归它管。更严谨一点:它是相互之间存在一种或多种特定关系的元素集合。
这世上没有哪一种数据结构能包打天下。哈希、树、图、线性表......各有各的脾气,各有各的用武之地。正因如此,我们才得一个一个地学,一个一个地啃。
1.2 什么是算法
算法,英文Algorithm,定义很干脆:一个良定义的计算过程,拿一个或一组值当输入,吐出一个或一组值当输出。说人话就是,把输入数据变成输出结果的那一串计算步骤。
比如我们在C语言里摸过的冒泡排序,干的活儿就是把一个无序数组,整成一个有序数组。
注意了,同一道算法题,思路往往不止一条。而具体怎么实现、哪条路更划算,就牵扯出本文的重头戏,复杂度。
1.3 为什么要学习数据结构与算法
它俩不分家,这是前提。
数据结构与算法这个板块,位置相当关键,承上启下。往上,接着C语言;往下,等初阶数据结构学扎实了,再往深处走,就是C++、操作系统、数据库这些硬骨头。根基不牢,后面全是空中楼阁。
再看这几年的风向,各大厂商对技术笔试的重视程度肉眼可见地往上蹿。以前笔试还分选择题和编程题,现在呢?深信服、美团、腾讯、科大讯飞......一票大厂的笔试,清一色全是编程题。代码能力,已经成了硬门槛。而想写出好代码,数据结构与算法就是绕不开的武器。笔试考算法,顺理成章。
面试也一样。大厂实习岗的面试官,尤其像腾讯,特别看重真实技术水平。项目问题问得细,水是水不过去的,让你介绍项目、现场手撕几道算法题、追问"为什么这个函数比malloc快"......这类问题,没点真功夫,当场就得卡壳。
总结一下:
数据结构与算法的学习,没有捷径。应该说,编程语言的学习本来就没有捷径,不然程序员怎么会掉头发呢?哈哈,这就是专业壁垒,也是竞争力。翘着二郎腿就能拿十几个大厂 offer?怎么可能,梦里才啥都有。
所以,给友友们两个学习的"秘诀":
第一,死磕代码。 敲一遍没感觉,太正常了。两遍、三遍、四遍......死磕,干就完了。
第二,画图,思考。 光思考不够。有的友友盯着一道算法题,光看,玩君子动口不动手那套(开个玩笑)。老话讲"不动笔不读书",画图。我在讲C语言的时候,尤其像一维数组、二维数组、指针这些,详解习题基本都要在旁边配张图。图一画,思路可能一下子就打开了。光在脑子里转,跟动手画出来,效果完全不一样。
二、如何衡量算法的好坏:从算法效率到复杂度
2.1 衡量算法好坏的核心指标:算法效率
力扣(LeetCode)上有这么一道题:轮转数组。链接放这儿了,感兴趣的友友可以自己去做一做。
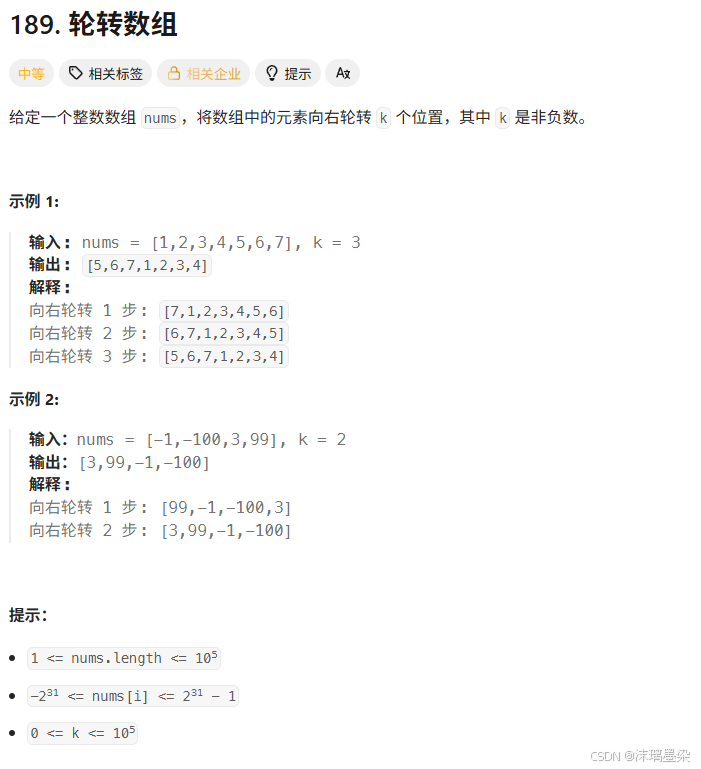
我们的思路是:循环k次,每次把数组元素整体向后移动一位。
轮转一次,所有元素往后挪一格,同时把最后一个位置的数据先存起来。这里用i表示当前位置,倒数第二位就是i-1。为什么偏偏盯住最后一位?因为如果从第一个位置开始动,轮转过程中它就会被后面的元素覆盖掉,数据当场丢失。
cpp
void rotate(int* nums, int numsSize, int k)
{
    while (k--)
    {
        int end = nums[numsSize - 1];
        for (int i = numsSize - 1; i > 0; i--)
        {
            nums[i] = nums[i - 1];
        }
        nums[0] = end;
    }
}
但问题来了:这段代码,执行能过,提交却过不了。
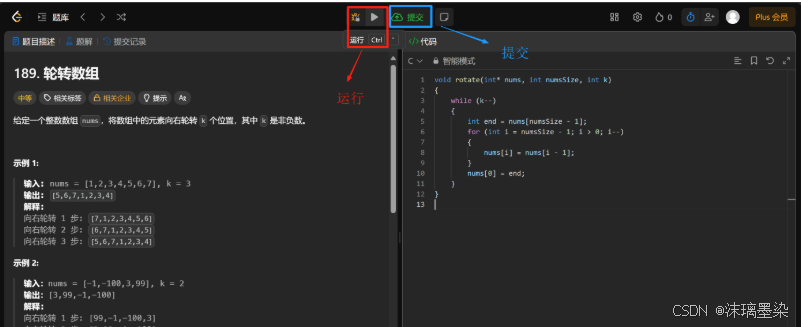
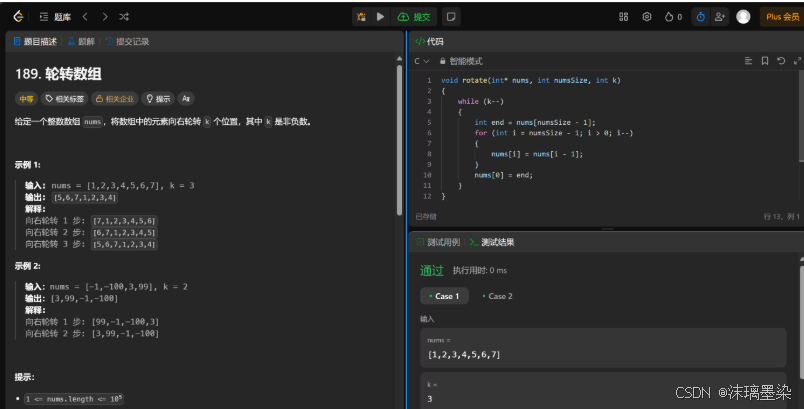
你有没有遇到过这种情况?本地跑几个测试用例,好好的,一点毛病没有。可一提交到平台,啪,超时。执行和提交,结果天差地别。
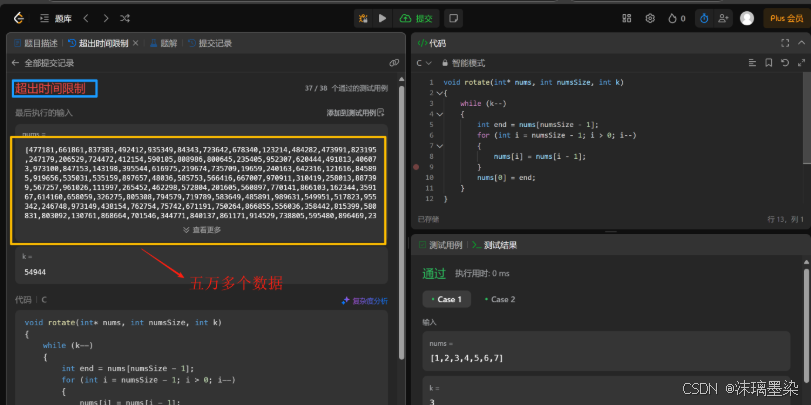
这是为啥?
因为执行只测那么几个用例,规模小,代码跑得动。提交呢?平台会拿海量数据、极端规模来考你,这时候算法的效率就藏不住了。
那怎么衡量一个算法的好坏?这就引出一个核心概念,复杂度。
算法的好与坏,不能靠感觉,也不能只看几个小用例跑不跑得动。得从复杂度上去分析。
2.2 复杂度的概念与意义
2.2.1 什么是复杂度
一个算法,写成可执行程序之后,跑起来是要吃资源的,时间要耗,内存要占。所以衡量一个算法的好坏,一般就从这两个维度下手:时间复杂度 和空间复杂度。
时间复杂度,看的是算法跑得快不快;空间复杂度,看的是算法运行时额外占了多少内存。早年间,那些"大块头"计算机的存储容量小得可怜,大家对空间复杂度自然斤斤计较。可这些年,计算机行业一路狂飙,存储容量早就今非昔比,空间复杂度也就不再是那个需要时时盯着的紧箍咒了。
所以,我们学复杂度的重点,就落在时间复杂度上。
2.2.2 为什么需要分析复杂度
重要性,从两个角度说。
一个是从学习编程本身出发。复杂度这东西,能让程序员心里有杆秤,知道代码为什么快、为什么慢,从而写出更高效的代码,把时间和空间都省在刀刃上。
另一个,从校招实习面试的考察也能看出来。比如腾讯C++后台开发实习的一面,就曾问过这么一道题:"快排、堆排、归并的时间复杂度分别是什么?快排最坏的情况(上界)是多少?怎么推导出来的?"这问题,没点复杂度功底,当场就得卡壳。
可见,复杂度无论是作为学习工具,还是作为校招考点,都是非常重要的。
三、复杂度分析:时间复杂度与空间复杂度
3.1 时间复杂度
3.1.1 时间复杂度的基本定义
在计算机科学里,算法的时间复杂度用一个函数式T(N)来表示。T(N)能定量地描述算法的运行时间。
既然时间复杂度是用来衡量程序的时间效率,那为什么不直接去测程序的运行时间呢?原因有三:
第一,程序运行时间跟编译环境、运行机器的配置都有关系。同一个算法程序,用老编译器编译和用新编译器编译,在同一台机器上跑,时间就不一样。
第二,同一个算法程序,放在低配置老机器上跑,和放在高配置新机器上跑,时间又不一样。
第三,运行时间只能在程序写好之后实际跑一遍才能测出来,做不到在写程序之前,就通过理论思想去计算评估。所以,直接测运行时间这条路,走不通。
那就换个思路。
程序的执行时间 = 二进制指令运行时间 × 执行次数(假设每条指令运行时间一定,是个常量)
这个T(N)函数式,算的就是程序的执行次数。
博主在C语言专栏里有一篇文章专门讲过编译链接。算法程序被编译后,生成二进制指令,程序执行,就是CPU执行这些编译好的指令。我们通过程序代码,或者说理论思想,计算出程序执行次数的函数式T(N)。假设每条指令执行时间基本一样,实际上有差别,只不过微乎其微,可以忽略不计------那么执行次数和运行时间就等比例正相关。于是,我们就可以脱离具体的编译运行环境,用执行次数来代表程序时间效率的好坏优劣。
用T(N)这个函数式去算两个算法,结果小的那个,效率更优。
比如:A程序T(N) = N²,B程序T(N) = N,那B算法的效率就要优于A算法。
3.1.2 从T(N)函数到大O渐进表示法
先来看个例子。要求:算一算Func1里++count这条语句,总共执行了多少次?
cpp
void Func1(int N)
{
    int count = 0;
    for (int i = 0; i < N; ++i)
    {
        for (int j = 0; j < N; ++j)
        {
            ++count;
        }
    }
    for (int k = 0; k < 2 * N; ++k)
    {
        ++count;
    }
    int M = 10;
    while (M--)
    {
        ++count;
    }
}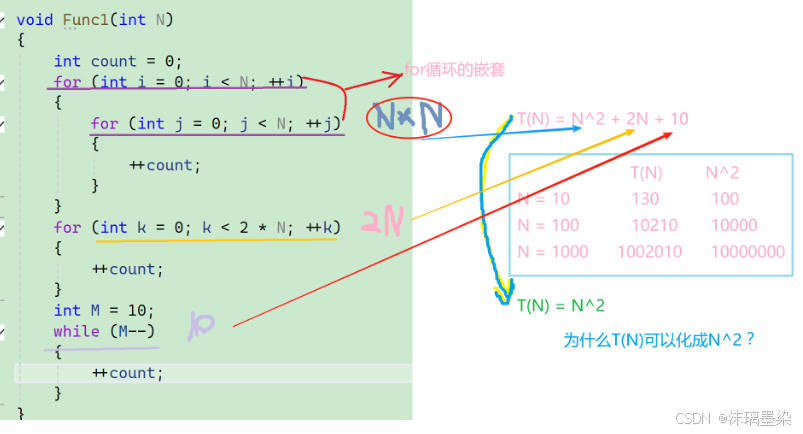
一层层拆开看。第一个双重循环,外层跑N次,内层也跑N次,++count被执行了N²次。第二个循环,2N次。最后那个while,M从10递减到0,跑10次。
所以总数是:
T(N) = N² + 2N + 10
可为什么最后只留下N²?
我们把不同N代进去对比一下。N小的时候,2N + 10还占点分量;可N 一旦大起来,比如100、1000,甚至更大,2N + 10对结果的影响就越来越微不足道了。真正起主导作用的,是N²这一项。就像一条大河,低阶项和常数项不过是河面上偶尔漂过的几片叶子,改变不了水流的走向。
再说了,实际计算时间复杂度时,我们也不会去抠精确的执行次数。精确次数算起来又麻烦,意义也不大,不同的一句代码,编译出来的指令条数本就不一样。我们真正关心的,是算法程序的增长量级:N不断变大时,T(N)的差别在哪里。低阶项、常数项,在N趋于无穷的过程中,影响越来越小,小到可以忽略。
所以,我们只需要抓住能代表增长量级的大概执行次数。这时候,就该请出大O渐进表示法了。
大O符号(Big O notation),是用来描述函数渐进行为的数学符号。推导大O阶,规则有三条:
-
只保留最高阶项,去掉低阶项。 N越来越大时,低阶项对结果的影响越来越小,N无穷大时,直接忽略不计。
-
最高阶项如果系数不是1,把系数也去掉。 N变大时,系数对结果的影响同样越来越小,无穷大时也可忽略。
-
如果T(N)里压根没有跟N相关的项,只剩常数,那就用常数1代替所有加法常数。
套上这三条规则,Func1的时间复杂度就出来了:O(N²)
3.1.3 时间复杂度计算实例
3.1.3.1 示例一 计算Func2的时间复杂度。
cpp
void Func2(int N)
{
    int count = 0;
    for (int k = 0; k < 2 * N; ++k)
    {
        ++count;
    }
    int M = 10;
    while (M--)
    {
        ++count;
    }
    printf("%d\n", count);
}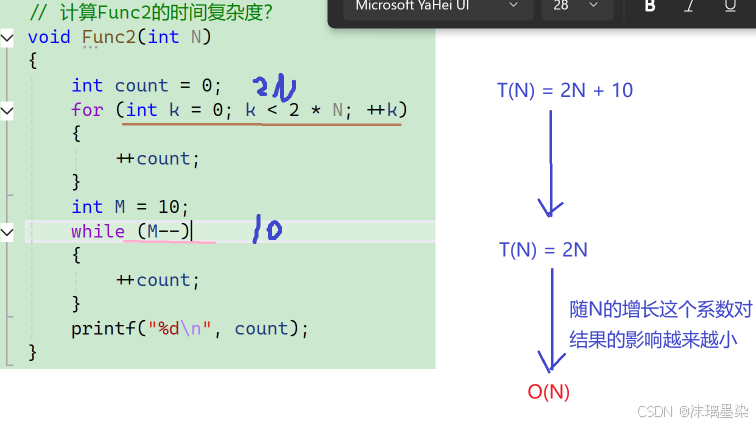
for循环执行2N次,while 循环执行10次。最高阶是N¹,根据大O阶规则第二条,系数2随着N增长对结果的影响越来越小,直接去掉。所以时间复杂度就是O(N)。
3.1.3.2 示例二 计算Func3的时间复杂度。
cpp
void Func3(int N, int M)
{
    int count = 0;
    for (int k = 0; k < M; ++k)
    {
        ++count;
    }
    for (int k = 0; k < N; ++k)
    {
        ++count;
    }
    printf("%d\n", count);
}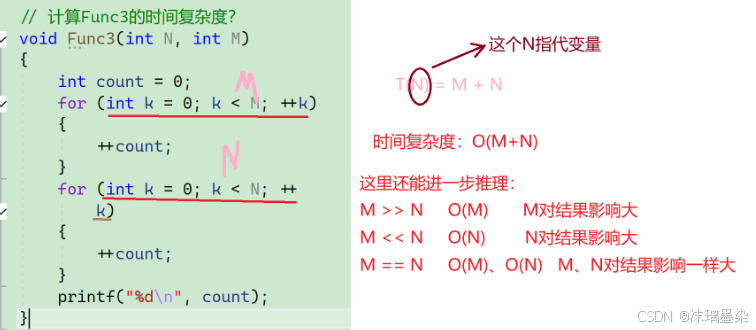
注意,T(N)函数式里的N,指的是变量,不是说非得叫N不可。
第一个循环跑M次,第二个循环跑N次,加起来是O(M + N)。这道题的结果其实还能进一步推理,过程已经画在图里了。
3.1.3.3 示例三 计算Func4的时间复杂度。
cpp
void Func4(int N)
{
    int count = 0;
    for (int k = 0; k < 100; ++k)
    {
        ++count;
    }
    printf("%d\n", count);
}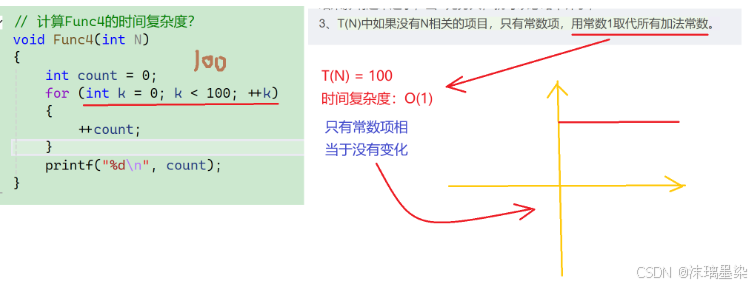
执行次数只有常数项,没有跟N相关的部分。按大O规则,用1取代所有常数项,所以是O(1)。
有朋友可能要问:这个常数项如果超级大呢?按规则用1取代,不会影响结果吗?
你的担忧没毛病。CPU算100次和算100000000000000次,时间确实差得远。但是(西卡西,聪明的友友都知道,但是后面才是重点),看我上图画的坐标轴,只有常数项,就相当于一条水平直线。时间复杂度不是用来算具体运行时间的,它是一个函数式。既然是函数式,它衡量的就是趋势。随着N怎么变,这条线都纹丝不动,所以用1取代所有常数项,没毛病。
3.1.3.4 示例四 计算strchr的时间复杂度。
cpp
const char* strchr(const char* str, int character)
{
    const char* p_begin = s;
    while (*p_begin != character)
    {
        if (*p_begin == '\0')
            return NULL;
        p_begin++;
    }
    return p_begin;
}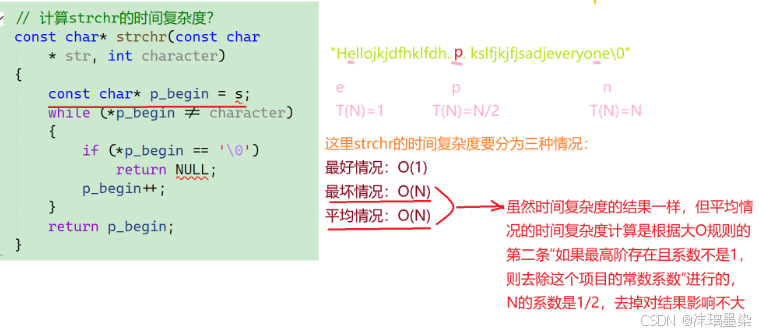
从这道题开始,一个新概念浮出水面:一些算法的时间复杂度,存在最好、最坏、平均三种情况。
-
最坏情况:任意输入规模下的最大运行次数,也就是上界。
-
最好情况:任意输入规模下的最小运行次数,也就是下界。
-
平均情况:任意输入规模下的期望运行次数。
大O渐进表示法,实际中一般关注的是算法的上界,也就是最坏运行情况。所以strchr的时间复杂度是O(N)。
3.1.3.5 示例五 计算冒泡排序的时间复杂度。
cpp
void BubbleSort(int* a, int n)
{
    assert(a);
    for (size_t end = n; end > 0; --end)
    {
        int exchange = 0;
        for (size_t i = 1; i < end; ++i)
        {
            if (a[i - 1] > a[i])
            {
                Swap(&a[i - 1], &a[i]);
                exchange = 1;
            }
        }
        if (exchange == 0)
            break;
    }
}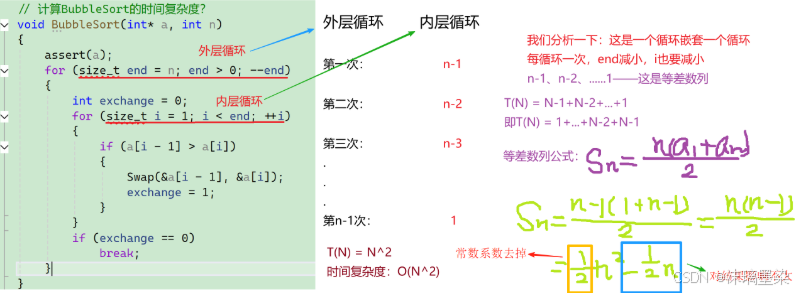
外层循环n次,内层循环次数从n-1 一路递减到1。总的执行次数是(n-1) + (n-2) + ... + 1,等差数列求和,最高阶项是n²,系数是1/2。按大O规则去掉系数,最终时间复杂度是O(N²)。
3.1.3.6 示例六 计算Func5的时间复杂度。
cpp
void func5(int n)
{
    int cnt = 1;
    while (cnt < n)
    {
        cnt *= 2;
    }
}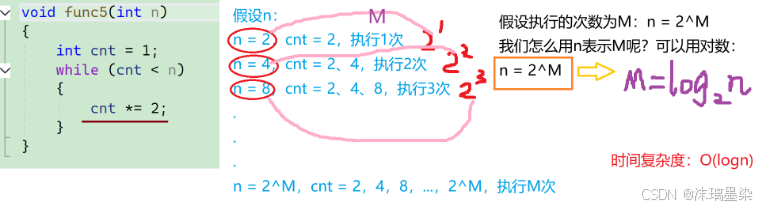
cnt从1开始,每次翻倍,1、2、4、8......直到不小于n。假设循环跑了x次,那么2^x = n,x = log₂n。所以时间复杂度是O(log N)。
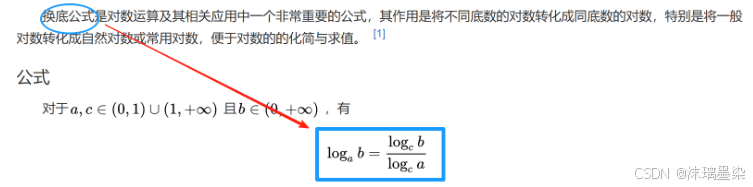
注意对数的三种表示。
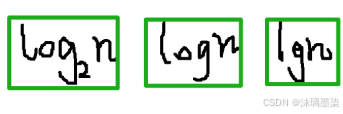
当n接近无穷大时,底数的大小对结果影响不大(换底公式摆在那儿),所以不管底数是多少,都可以省略不写,统一写成log n。博主建议就用log n。
3.1.3.7 示例七 计算阶乘递归Fac的时间复杂度。
cpp
long long Fac(size_t N)
{
    if (0 == N)
        return 1;
    return Fac(N - 1) * N;
}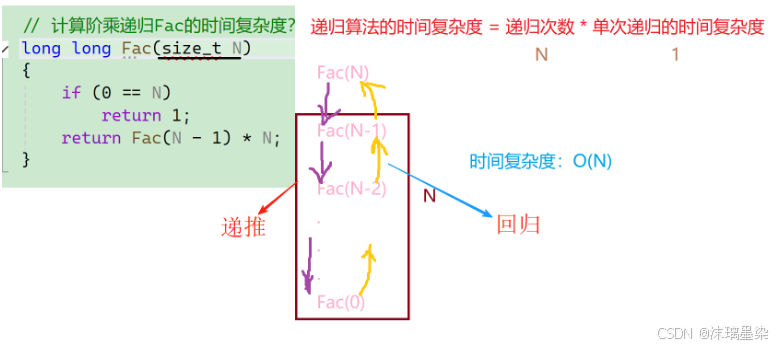
递归从Fac(N)一路往下,Fac(N-1)、Fac(N-2)......直到Fac(0),一共递归了N次。每次递归内部的操作为常数级,所以总执行次数是N次。时间复杂度是O(N)。
3.2 空间复杂度
空间复杂度,同样是一个数学表达式。它盯的是算法在运行过程中,因为自身需要而额外临时开辟出来的那部分空间,比如C语言动态内存管理里malloc、calloc、realloc搞出来的那些。
说白了,就是函数体内为了实现算法,额外向系统伸手要的那块地。
cpp
void func1(int n)
{
    // 函数体内因实现算法而需要额外开辟的空间
}
3.2.1 空间复杂度的基本定义
空间复杂度,不是去数程序到底占了多少字节。正常情况下,每个对象的大小差不了太多,数字节意义不大。所以,我们算空间复杂度,算的是变量的个数。
计算规则跟时间复杂度基本一个路子,同样用大O渐进表示法。
注意一点:函数运行时所需的栈空间,存储空间、局部变量、一些寄存器信息,在编译期间就已经定死了。因此,空间复杂度主要看的是函数在运行时显式申请的额外空间。
3.2.2 通过实例掌握空间复杂度的计算
空间复杂度和时间复杂度,计算规则差不多,只是把"执行次数"换成了"变量个数"。所以例子少举几个,意思到位就行。
3.2.2.1 示例一:如何计算BubbleSort的空间复杂度?
cpp
void BubbleSort(int* a, int n)
{
    assert(a);
    for (size_t end = n; end > 0; --end)
    {
        int exchange = 0;
        for (size_t i = 1; i < end; ++i)
        {
            if (a[i - 1] > a[i])
            {
                Swap(&a[i - 1], &a[i]);
                exchange = 1;
            }
        }
        if (exchange == 0)
            break;
    }
}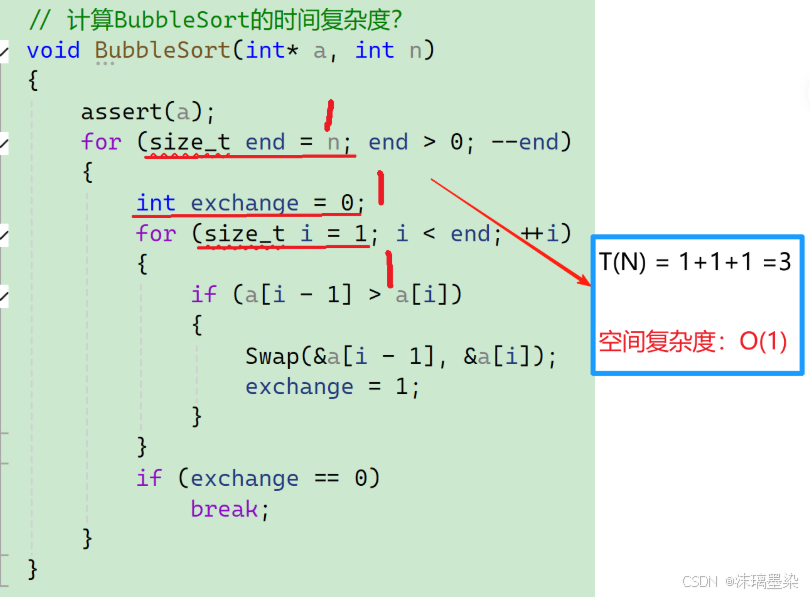
这次我们算的是空间复杂度。看下面划出来的部分end、exchange、i,这些就是算法额外申请的空间。它们都是有限个局部变量,属于常数个额外空间。
只有常数项,按大O规则,用常数1取代所有加法常数。所以BubbleSort的空间复杂度是O(1)。
3.2.2.2 示例二:如何计算阶乘递归函数Fac的空间复杂度?
cpp
long long Fac(size_t N)
{
    if (N == 0)
        return 1;
    return Fac(N - 1) * N;
}
递归的空间开销,不能只看单次调用,得看递归压了多少层栈帧。
Fac(N)一路往下递归,Fac(N-1)、Fac(N-2)......直到Fac(0),一共压了N+1层栈帧。每一层栈帧里,局部变量和寄存器信息都是常数级。层数随N线性增长,总空间开销自然也跟着线性增长。
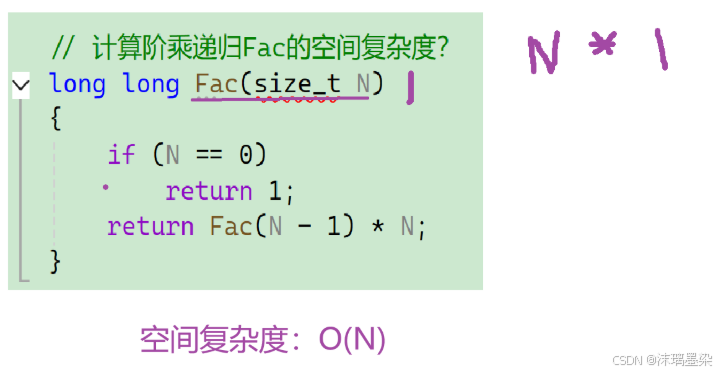
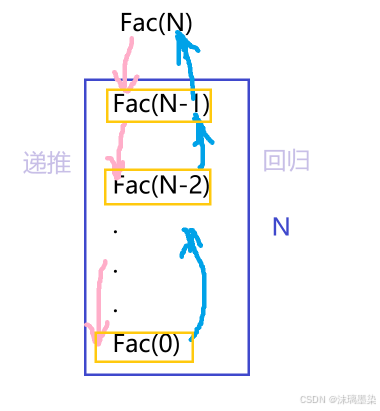
所以,阶乘递归Fac的空间复杂度是O(N)。
一句话总结:递归空间复杂度 = 递归深度 × 单次递归的空间复杂度。 阶乘这里就是N × 1,最终得到O(N)。
四、常见复杂度对比与分析
下面这张图,画的是各个函数随着n增大,函数值的变化情况。
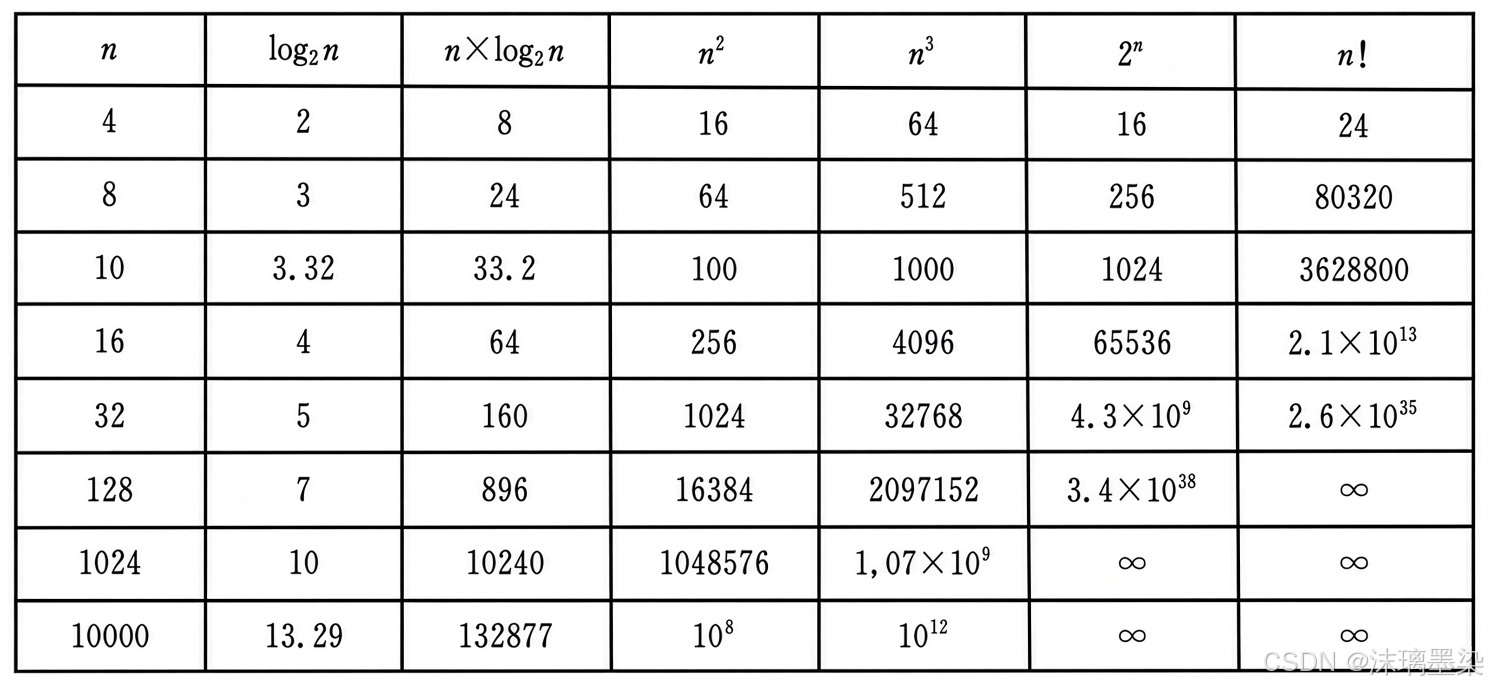
从图上能清楚看到:n一旦大起来,时间复杂度的增长速度就开始放飞自我。我们想要的,恰恰是让它长得慢一点、再慢一点。优化复杂度,本质上就是在优化代码。
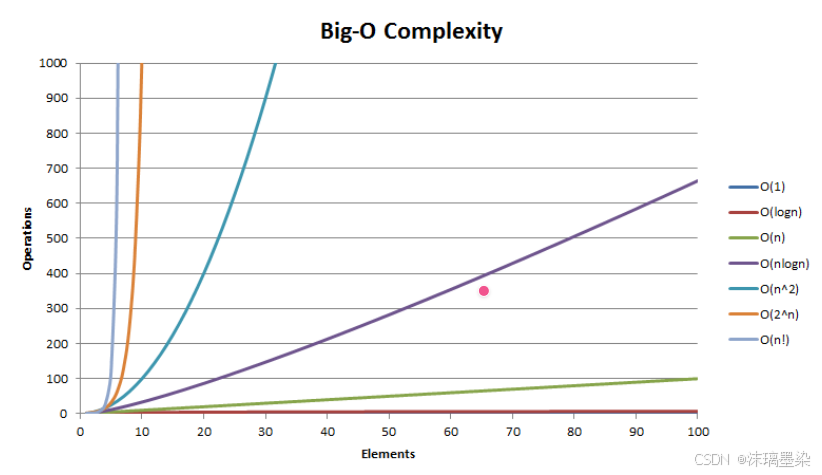
右侧那一列时间复杂度,从上往下看,变化幅度越来越夸张。尤其是O(n²),拐点一到,曲线陡得吓人,n稍微大一点,计算量就炸了。这也是为什么,写代码时要尽量避免O(n²)这种量级。
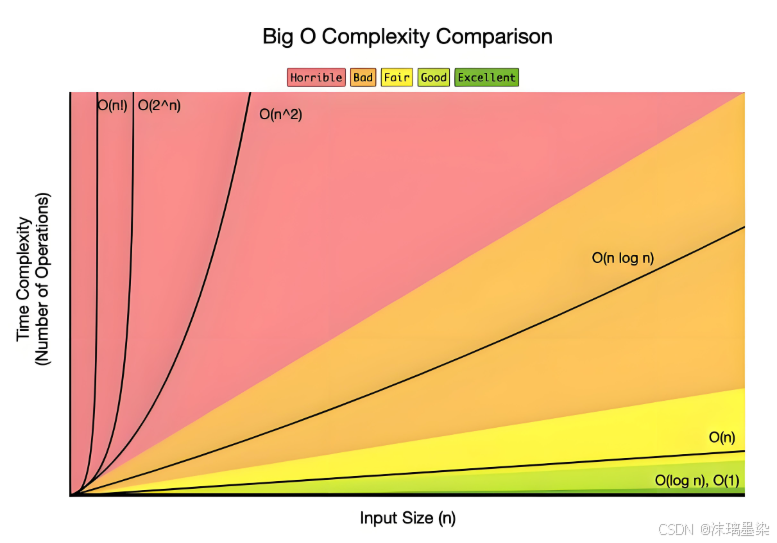
再看对比图,几个常见复杂度叠在一起,谁快谁慢,一目了然。
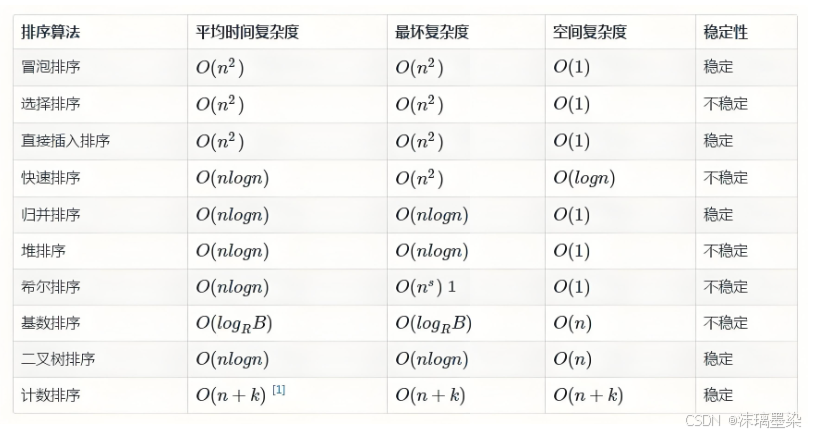
下面是各种排序算法的复杂度表格,留个印象,后面学排序时会反复用到。
五、算法题与复杂度
回到刚才那道力扣题------轮转数组。我们最初的思路是:循环k次,每次把数组元素整体向后挪一位。代码写出来了,运行也通过了,可一提交,啪,一句"超出时间限制"甩脸上。
现在学会了大O渐进表示法,回头算一下这个思路的时间复杂度:O(n²)。再对照复杂度那张表,O(n²)那条线陡得吓人。O(n²)是个不太体面的复杂度,我们希望它再小一点。思路一之所以翻车,根子就在这,时间复杂度太高,程序最终撞上了时间限制。
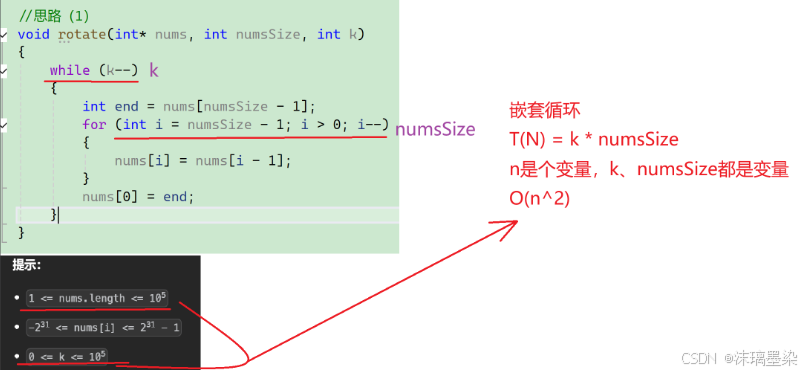
在琢磨新思路之前,先把思路一的时间、空间复杂度怎么算的理清楚。刚才说时间复杂度是O(n²),怎么来的?k和numsSize的范围都到10⁵,嵌套循环一乘,k × numsSize,也就是n × n,时间复杂度自然是O(n²)。空间复杂度呢?只多了一个变量,O(1)。
家人们,既然本质是让时间复杂度越小越好,有没有办法把时间复杂度的"价格"打下来?
有的兄弟,有的。我们可以把时间复杂度压到O(N),但代价是变量数增加,也就是空间复杂度会涨。说白了,这是一种"空间换时间"的平衡术,有点像端水大师。具体怎么做?
思路二:借一个临时数组。
创建一个临时数组tmp,大小跟原数组一样。把原数组轮转后的数据依次放进tmp,再把tmp里的内容整体倒回原数组。
cpp
// 思路(2)
void rotate(int* nums, int numsSize, int k)
{
    // 创建一个新数组 tmp
    int tmp[numsSize];
    // 遍历原数组,把轮转后的数据放进 tmp
    for (int i = 0; i < numsSize; i++)
    {
        tmp[(i + k) % numsSize] = nums[i];
    }
    // 把 tmp 中的数据导回 nums 数组
    for (int i = 0; i < numsSize; i++)
    {
        nums[i] = tmp[i];
    }
}
把图画出来(学数据结构,两件事:一是死磕代码,二是画图加思考)。
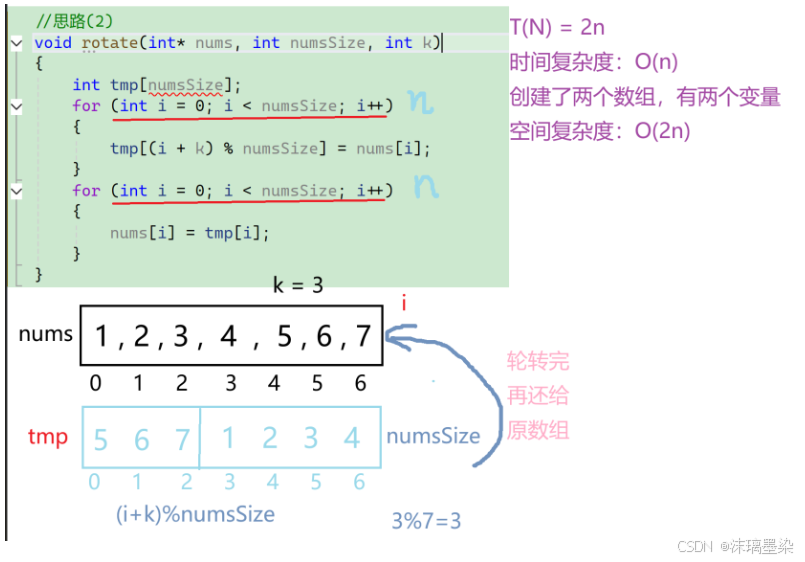
(i + k) % numsSize这个取余操作,妙就妙在不用反复循环挪动,一步到位把每个元素按到轮转后的正确位置上。
这个思路的结果,就是标准的"空间换时间"。时间复杂度如愿降下来了,可空间复杂度也跟着上去了。
代码是能圆满完成任务了,但我们可以再加大点难度,不用"空间换时间"那一套。也就是说,时间复杂度照样压到O(n),空间复杂度还死死守在O(1)。
怎么做?
思路三:三次逆置。
我们在C语言里讲过逆置。这里,三次逆置是不是也能实现轮转数组?
cpp
// 思路(3)
// 逆置
void my_reverse(int* nums, int left, int right)
{
    while (left < right)
    {
        // 交换
        int tmp = nums[left];
        nums[left] = nums[right];
        nums[right] = tmp;

        left++;
        right--;
    }
}

// numsSize = 1, k = 2
void rotate(int* nums, int numsSize, int k)
{
    k = k % numsSize;
    // 前 n-k 个数据逆置
    my_reverse(nums, 0, numsSize - k - 1);
    // 后 k 个数据逆置
    my_reverse(nums, numsSize - k, numsSize - 1);
    // 整体逆置
    my_reverse(nums, 0, numsSize - 1);
}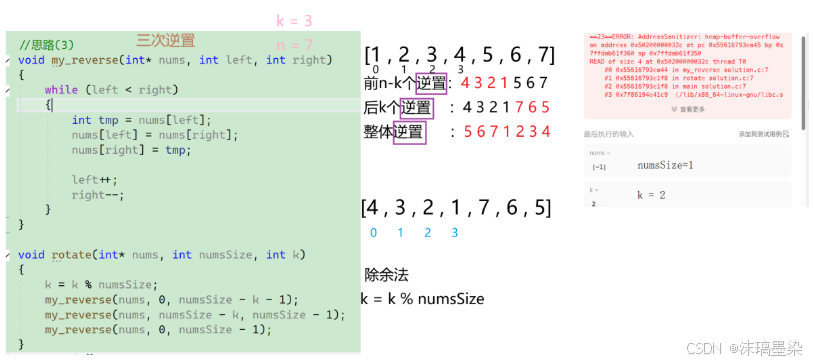
先逆置前n-k个,再逆置后k个,最后整体逆置。三步走完,轮转完成。
这样一来,时间复杂度的"价格"打下来了,空间复杂度也没涨,两边都满意,皆大欢喜。
轮转数组这一道题,能翻出这么多思路,恰恰印证了那句话算法的思路,从来不止一条。
到这里,数据结构与算法的第一篇,就正式收尾了。
这一路,我们从一道轮转数组题出发,亲眼看着一段"执行能过、提交超时"的代码,一步步引出复杂度。接着,大O渐进表示法登场,时间复杂度和空间复杂度被逐一拆开,最后又用三种思路把题目重新做了一遍:暴力轮转、空间换时间、三次逆置。同一道题,不同的解法,复杂度一对比,高下立判。
说到底,复杂度就是衡量算法好坏的那把尺子。它不能告诉你代码跑得有多快,但能告诉你,当数据规模涨起来时,这段代码会以什么样的姿态迎接挑战。心里有这把尺子,写代码之前就能估个八九不离十,而不是等提交超时了才拍大腿。
学习数据结构与算法,没有捷径。死磕代码,画图思考,这两条路,一步都省不了。
下一篇,我们正式进入线性表,从最基础的顺序表开始,一点点把数据结构的骨架搭起来。友友们,我们下篇见。
如果这篇文章对你有帮助,别忘了点赞、收藏、关注三连支持。你的每一次反馈,都是我继续硬核输出的最大动力。