**摘要:**本文从磁盘的物理结构出发,系统讲解了机械磁盘的扇区、磁道、柱面等基本概念,以及CHS与LBA两种寻址方式的原理与转换方法。在此基础上,文章引入文件系统,介绍了"块"与"分区"的概念,并深入剖析了块组内部构成,包括Data Blocks、Block Bitmap、inode、inode Bitmap、GDT和Super Block等核心结构。随后,文章探讨了路径解析、目录与文件名的关系,以及Linux路径缓存机制,最后介绍了挂载分区和软硬链接的原理与应用场景,帮助读者建立从硬件到文件系统的完整认知。
目录
[3.2.1inode table](#3.2.1inode table)
[3.2.2inode Bitmap](#3.2.2inode Bitmap)
[3.2.5Super Block](#3.2.5Super Block)
1.理解硬件
1.1理解磁盘
现如今的笔记本(电脑)已经不装磁盘了,而是装的是一个叫做SSD(固态硬盘),它没有纯机械结构,它都是纯电子的,SSD和这篇博客讲的文件系统有关联。因为企业里还用磁盘,所以我们需要了解磁盘。
为什么企业还要用磁盘?
因为磁盘便宜!如果使用现在的SSD的话那动辄400-500多,所以企业选磁盘!
传统磁盘叫做机械磁盘,它是我们计算机中唯一的一个机械设备,那么磁盘它根据冯诺依曼的体系结构中,它也称为外设。
因为磁盘还是一个机械结构还是一个外设,所以磁盘访问时速度往往会慢一些,因此,我们之前的软件为了等待磁盘读取完成有一个进程状态叫做D状态(深度睡眠状态),但是它慢是相当于CPU和内存的。
这种机械磁盘的容量往往是特别大的,价格也非常便宜,因此,备受互联网公司喜爱,企业会购买很多磁盘(几十上百万)来存储几年的所有数据!
磁盘怎么存放数据?
计算机只认识二进制,在内存里的数据它可能用电信号的有无来表示01,也可能用电信号的高低电平来表示01。因此,磁盘里存放的数据都是二进制的,但是二进制也是程序员加工处理后的结果,那么什么叫做二进制呢?
类似磁铁,磁铁有正负极,我们可以认为磁盘由无数个磁铁拼接而成,我们可以规定北极为1,南极为0,所以如果我们写1,那么就是把对应的磁铁南极变成北极,清零就是把磁铁从北极变成南极,因为磁盘上可以用磁头来修改磁盘上的数据,其实就是修改对应某个磁盘中某一个小元素的南北极朝向的问题!
磁盘的物理结构:
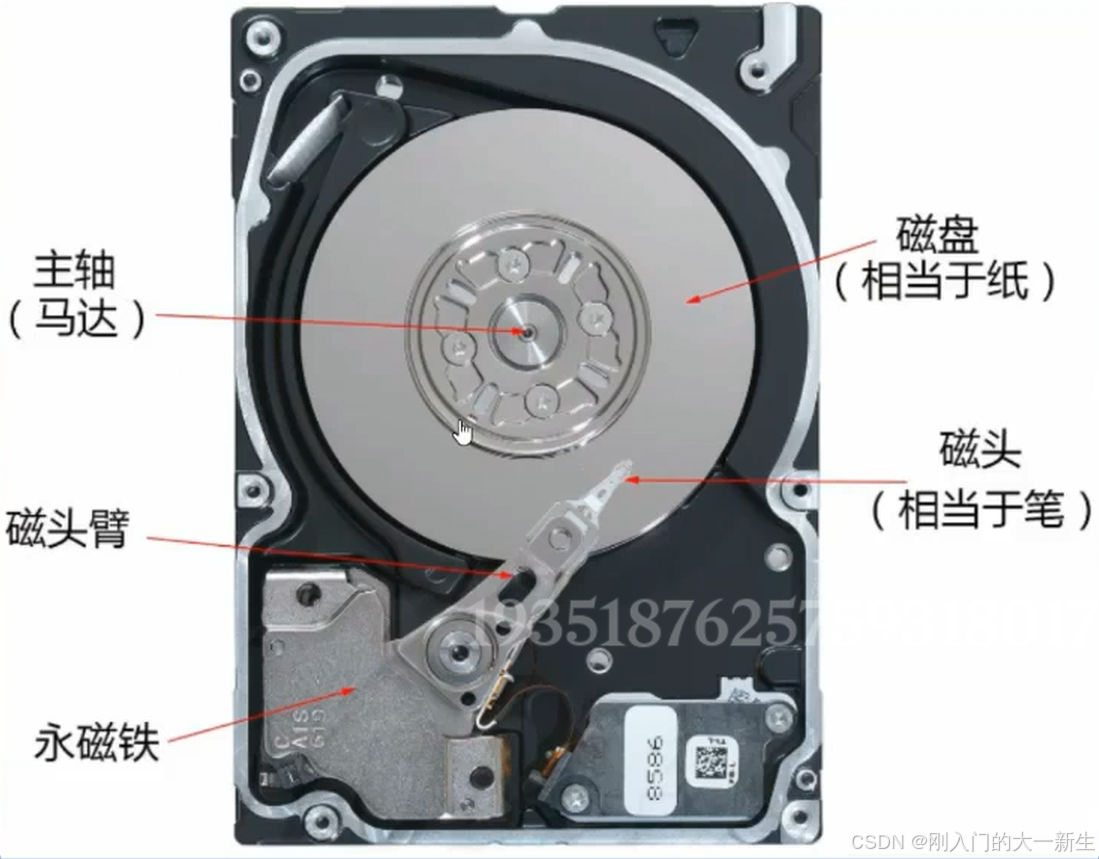
将来的主轴会高速的以一定方向的速度去旋转,磁头在磁盘旋转的时候做左右摆动(往靠近圆心和远离圆心的摆动),但是磁头并不会紧挨着盘面,因为会刮花盘面!
磁盘的存储结构:我们可以认为盘片是同心圆的结构:
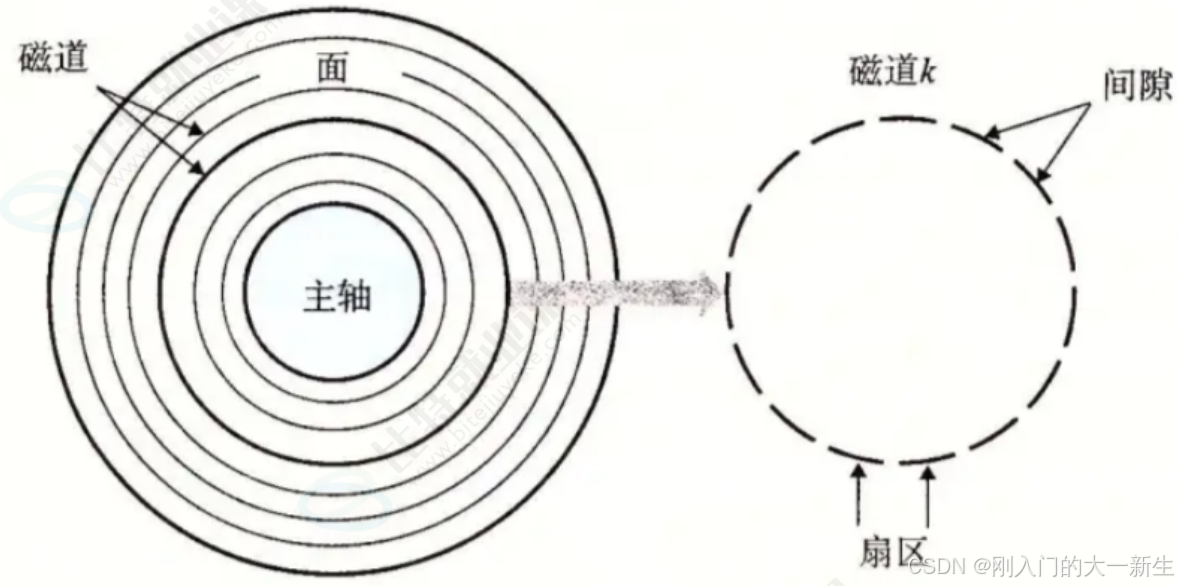
扇区是操作系统访问磁盘设备的基本单位(一般是512个字节),我们认为内部和外部磁道上面所拥有的扇区个数是一样的,这样方便我们进行对应的计算。
当然磁盘不只有一个盘面,如果平视来看磁盘有:
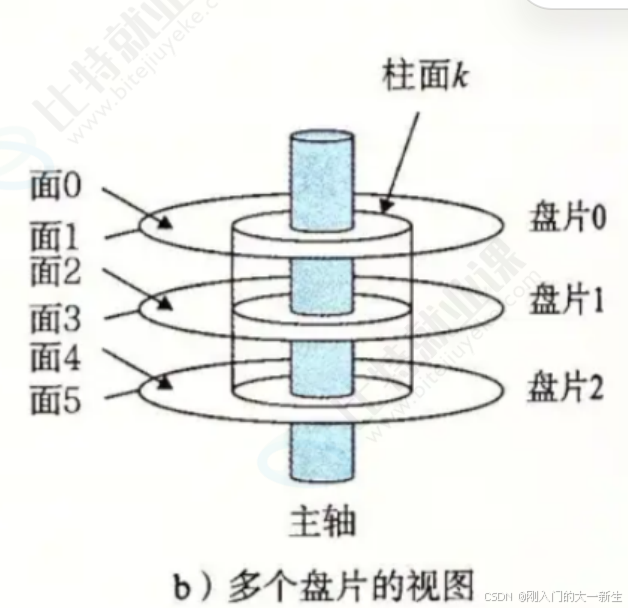
一个盘片也可以有两面(正反都有)。
此外,磁头和盘面也是一对一的(一个磁头对应一个盘片):
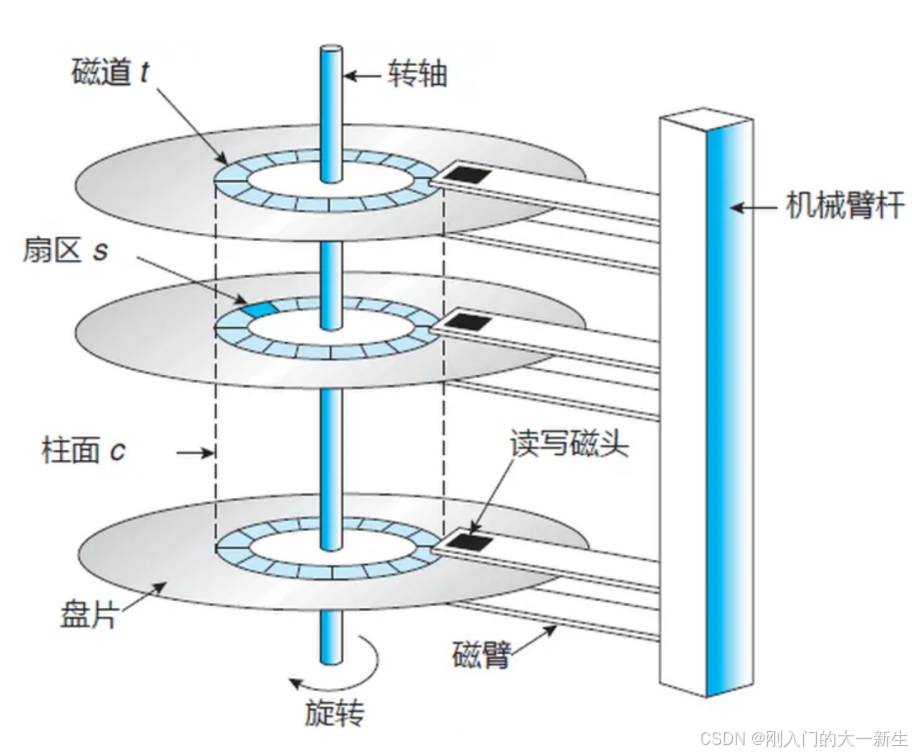
所有的磁头在访问盘片时,所有磁头共进退。
因此:磁头访问某一个位置时,所有的磁头都指向它对应的盘面的相同半径处 ,我们把半径相同的所有盘面叫做柱面(类似圆柱),柱面就是磁道,相同半径的磁道看做一个整体。
磁头:选择哪一面。
磁头摆动的本质:在定位哪一个磁道;盘面旋转的本质:确定了哪一个磁道(柱面),定位该磁道(柱面)的哪一个扇区。二者合起来的本质:对磁盘特定位置进行寻址。
因为磁盘访问的基本单位是扇区,那么如何在磁盘中定义一个扇区 ----- 拿一面来研究?
磁头都有编号(都是从0开始),盘面也有编号(因为磁头有编号,而盘面和磁头一一对应),磁道的编号也是从0开始的;扇区也有编号,它的编号从1开始。如何定位一个扇区呢?
①选择磁头;②选择磁道;③选择扇区。因此,我们要找到磁盘当中的任意一个扇区有三个要素:找磁头,找磁道,选择扇区!
我们把这种在机械磁盘中定位一个扇区的方法叫做:CHS地址定位方法(C:cylinder磁道,H:header磁头,S:sector扇区)虽然顺序我们是有点差别的,后面我们会讲解这种顺序的。因此,我们能找到任意多个扇区吗?
因此,我们要访问磁盘,只需要记录CHS就行,就可以从内存中拿到磁盘对应的数据块!
但是CHS这种寻址方式已经太老了,它要求操作系统做的事情太多了,虽然磁盘的物理结构决定了它必须以CHS的方式来寻址,但我们有更好的做法。
更深的理解:
扇区是从磁盘读出和写⼊信息的最⼩单位,通常⼤⼩为 512 字节。
磁头(head)数:每个盘⽚⼀般有上下两⾯,分别对应1个磁头,共2个磁头
磁道(track)数:磁道是从盘⽚外圈往内圈编号0磁道,1磁道...,靠近主轴的同⼼圆⽤于停靠磁
头,不存储数据
柱⾯(cylinder)数:磁道构成柱⾯,数量上等同于磁道个数
扇区(sector)数:每个磁道都被切分成很多扇形区域,每道的扇区数量相同
圆盘(platter)数:就是盘⽚的数量
磁盘容量=磁头数 × 磁道(柱⾯)数 × 每道扇区数 × 每扇区字节数
细节:传动臂上的磁头是共进退的(这点⽐较重要,后⾯会说明)
CHS寻址
对早期的磁盘⾮常有效,知道⽤哪个磁头,读取哪个柱⾯上的第⼏扇区就可以读到数据了。但是CHS模式⽀持的硬盘容量有限,因为系统⽤8bit来存储磁头地址,⽤10bit来存储柱⾯地址,⽤6bit来存储扇区地址,⽽⼀个扇区共有512Byte,这样使⽤CHS寻址⼀块硬盘最⼤容量为256 * 1024 * 63 * 512B = 8064 MB(1MB = 1048576B)(若按1MB=1000000B来算就是8.4GB)
1.2磁盘的逻辑结构
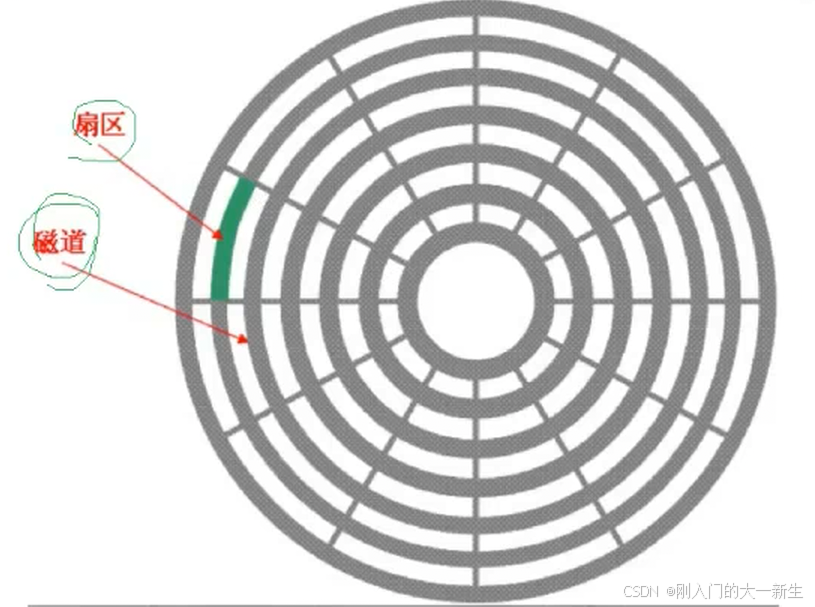
如果我们把这一个个同心圆拉成一条线,虽然它物理结构变了,但是它的存储结构还是不变的,因此,我们可以把整个磁面想象成线性结构。
虽然磁盘本质上是硬质的,但是我们可以把磁盘想象成卷起来的磁带,那么磁盘的存储结构类似于:

这样每一个扇区,就有了一个线性地址(数组下标),这种地址叫做LBA:
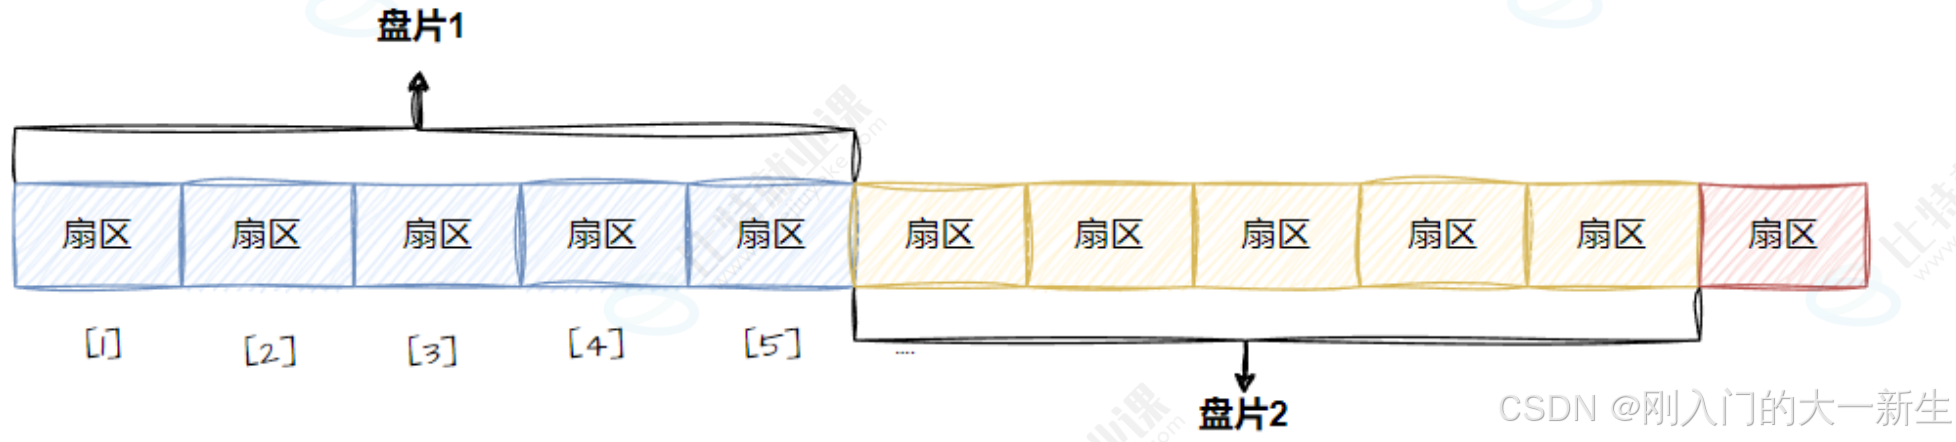
每一面的总量相等,且每一个盘片的扇区个数也都相等,因此,磁盘就是一个一维数组!!!
如何定位一个扇区?
我们只需要一个数组下标就能定义任意一个扇区了!
假设一个盘面有100个扇区,每个扇区有10个磁道,我们有一个下标123,如果我们把这个123转化成为CHS我们就能成功找到对应的扇区了!
123先除100得到对应的盘面,然后再除10就得到对应的扇区,类似的得到最终的CHS,因此就能找到对应的扇区了!因此,我们只需要知道LBA地址就能找到对应的数据!因此当代磁盘用的都是LBA地址。
我们理解展开的时候,是以一面为单位进行展开的,但是磁盘真实的展开,并不是以物理盘面的展开的,那么以什么单位展开的呢?
柱面!我们真实展开磁盘是以柱面的形式展开。
其实,我们把磁盘做逻辑抽象,并不是以盘面为单位的,它是以柱面为单位进行抽象的,如果有3片盘面那么就有6个磁道,将这6个磁道作为一组,柱面是一个逻辑上的概念,其实就是每一面上相同半径的磁道在逻辑上构成一个柱面:
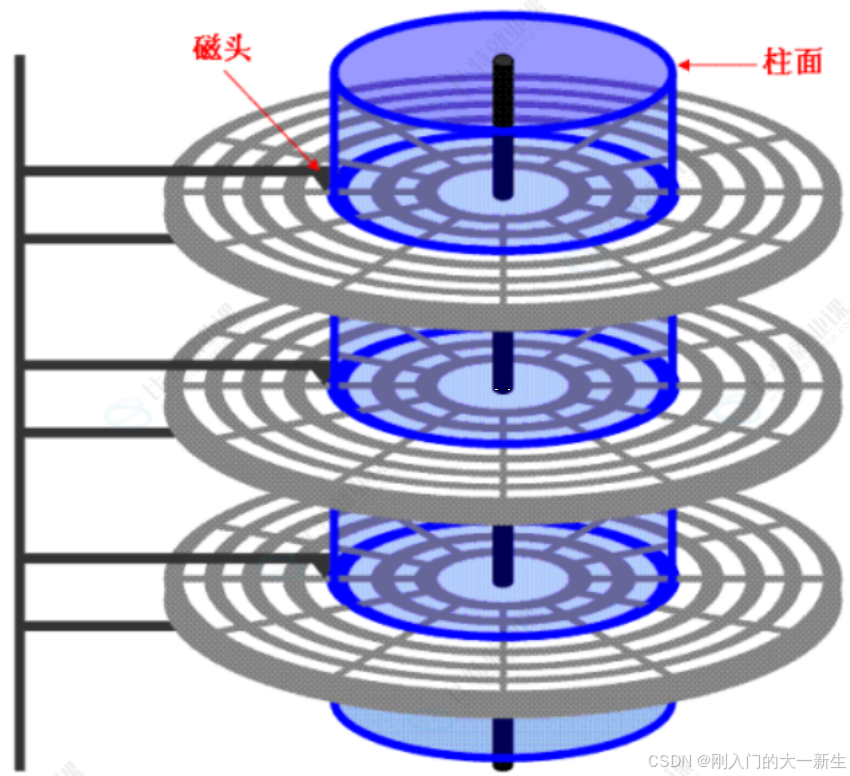
所以,磁盘真正的情况是:
磁道,某一盘面的某一个磁道展开: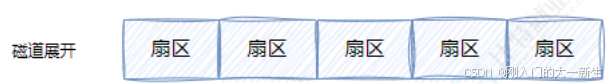
即磁道就是一个一维数组。
柱面:整个磁盘所有盘面的同一个磁道:
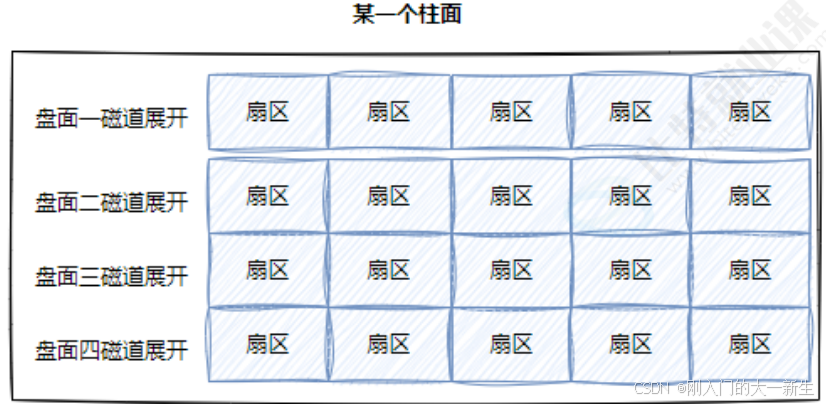
特点:柱面上的每个磁道,扇区个数是一样的,相当于一个二维数组!
相当于我们把一个圆柱纵向剪开就是一个柱面!
整个磁盘由多个不同的柱面构成:
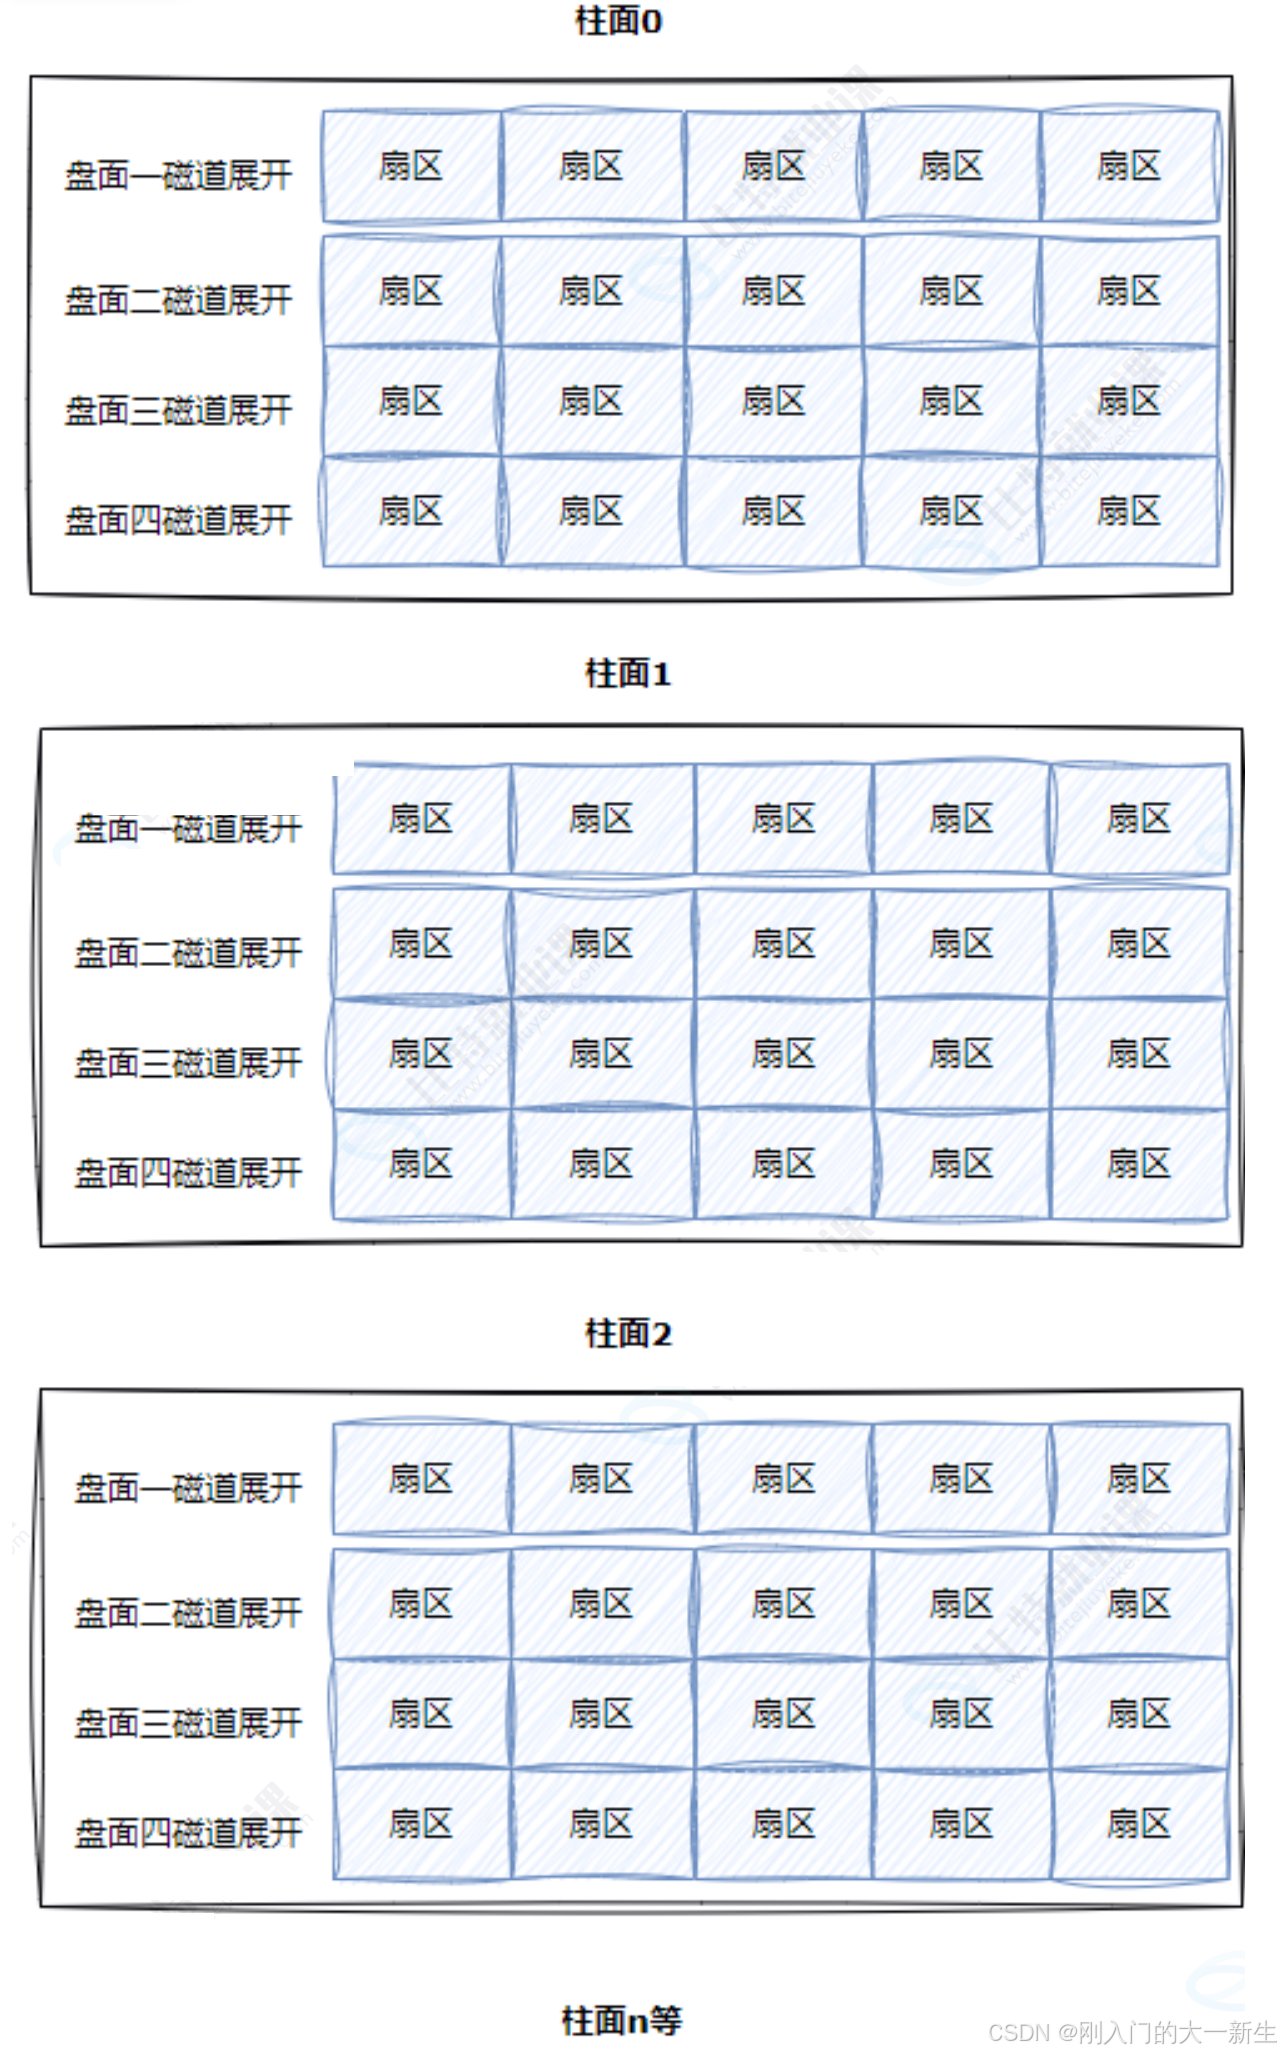
因此,整个磁盘就是一个多张二维的扇区数组表(三维数组)。即:
磁盘 ------------------> 三维数组
那么,如何定位磁盘上任意一个扇区?
因为柱面是由多个相同的盘面对应的磁道构成,所以我们可以把柱面称之为磁道。因此我们定位下标可以通过C、H、S来定位,C:定位柱面(磁道),H:定位磁头,S:定位扇区。即,我们可以通过sector arrayCHS来得到具体的扇区!C\H\S是三维数组下标的顺序!
我们看待三维数组时,本质上可以看做n个二维数组构成的三维数组,我们看待二维数组时,也可以看成由m个一维数组构成的!因此。三维数组就是由n*m个一维数组构成的!
我们可以把相同半径,但是不同的扇面的磁道称之为柱面,然后我们把多个柱面首尾相连(即把多个一维数组穿插在前面的一维数组后面)就变成了一维数组:
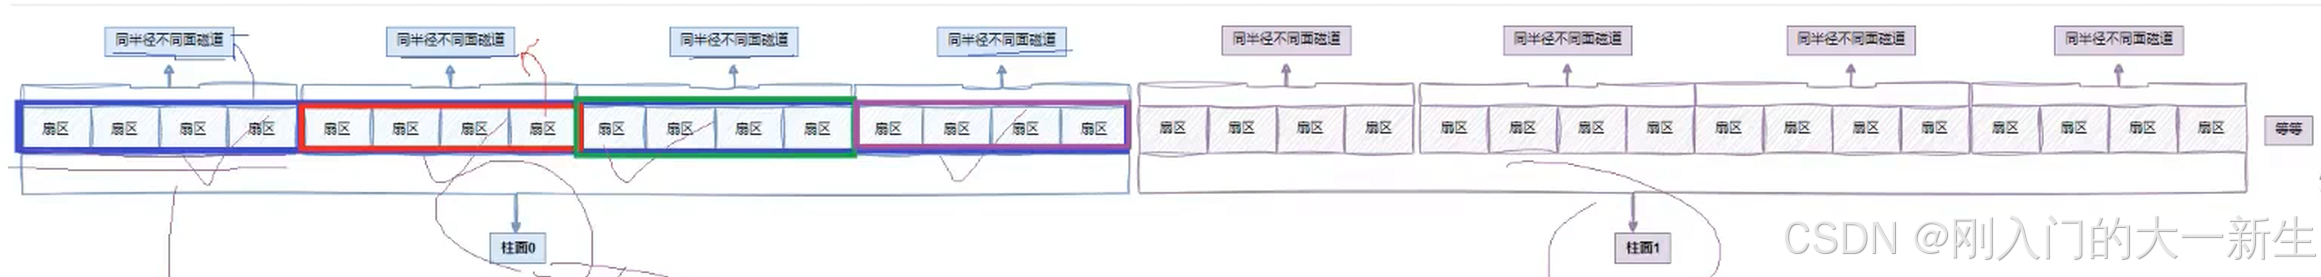
因此,我们可以把磁盘想象成一个线性结构,其中每一个扇区在该线性结构对应的地址叫做LBA地址,因此将来要把LBA地址转化成CHS地址本质是 :把一维数组的下标转化成三个数字!
因此,操作系统内,要使用扇区地址,只需要知道LBA地址即可!因为CHS地址和LBA地址可以互相转化!这种转化工作是由磁盘自己来做的!
在我看来,磁盘就是一个以sector为单位的一维数组!(sector:扇区)
1.3LBA&&CHS地址
CHS转成LBA:
①磁头数*每磁道扇区数 = 单个柱⾯的扇区总数;
②LBA = 柱⾯号C*单个柱⾯的扇区总数 + 磁头号H*每磁道扇区数 + 扇区号S - 1;
即:LBA = 柱⾯号C*(磁头数*每磁道扇区数) + 磁头号H*每磁道扇区数 + 扇区号S - 1
③扇区号通常是从1开始的,⽽在LBA中,地址是从0开始的;
④柱⾯和磁道都是从0开始编号的;
⑤总柱⾯,磁道个数,扇区总数等信息,在磁盘内部会⾃动维护,上层开机的时候,会获取到这些参数。
LBA转成CHS:
①柱⾯号C = LBA // (磁头数*每磁道扇区数)【就是单个柱⾯的扇区总数】;
②磁头号H = (LBA % (磁头数*每磁道扇区数)) // 每磁道扇区数;
③扇区号S = (LBA % 每磁道扇区数) + 1;【+1是因为扇区从1开始】
④"//": 表⽰除取整。
所以:从此往后,在磁盘使⽤者看来,根本就不关⼼CHS地址,⽽是直接使⽤LBA地址,磁盘内部⾃⼰转换。
从现在开始,磁盘就是⼀个 元素为扇区 的⼀维数组,数组的下标就是每⼀个扇区的LBA地址。OS使⽤磁盘,就可以⽤⼀个数字访问磁盘扇区了。
2.引入文件系统
2.1引入"块"概念
其实硬盘是典型的"块"设备,操作系统读取硬盘数据的时候,其实不会一个一个扇区地读取,这样效率太低,而是一次性连续读取多个扇区,即一次性读取一个"块"。
硬盘的每个分区都被划分成一个一个的"块",一个"块"的大小是由格式化的时候确定的,并且不可以更改,最常见的是4KB,即连续8个扇区组成一个"块","块"是文件存取的最小单位!
所以操作系统在看待磁盘时,就认为磁盘是一个块设备,每个块都有下标!
我们站在文件系统角度把磁盘当做block array,所以我们把磁盘叫做块设备。因此在操作系统内访问磁盘有两种方式:LBA和块号!
至此,我们完成了对磁盘的完整建模。磁盘:本质就是一个block array\[\];块设备!
但是磁盘太大了,直接管理的话会很麻烦,因此,我们可以对磁盘进行分区,如:一个磁盘区域200GB,另一个磁盘250GB,这个过程我们称作:分区。
2.2引入"分区"概念
如何理解分区?
我们可以定义一个结构体,然后定义两个变量:int start代表分区的开始,int end代表分区的结束。因为我们也可以把磁盘看做一个一维数组,所以划分区域时我们就很容易划分出来。如:在Linux中,磁盘可以划分成为C盘,D盘,E盘......,虽然我们只有一块物理盘,我们看到的C、D、E盘......本质是一块盘,只是一个盘做的分区罢了!
但是Linux的设备都是以文件的形式存在,那么是怎么分区的呢?
理解一下,操作系统是如何把数据写给磁盘的?
我们在介绍计算机的基本组成的时候有提到过:寄存器。我们曾经学到的寄存器都是在CPU上的。但是,外设内部,也有寄存器!磁盘里面除了盘片等,还有自己的控制电路。我们可以理解成磁盘当中会存在以下的几种寄存器,如:dir,addr,data。因此,磁盘可以和内存之间用I/O总线连接起来,因此它们就能够用总线调节起来。dir代表方向,是你想在磁盘里读还是磁盘里写,我们可以规定,如果往磁盘里写叫做1,往磁盘里读叫做0。addr就是我们之前讲的LBA,data就是对应的数据(磁盘里面的)。因此计算机访问磁盘就是通过向磁盘当中特定寄存器写入对应的控制和数据来完成对外设的控制。
因此,操作系统对外设的控制,是通过对设备内部的寄存器进行数据写入的!因此,如果操作系统想要读,会把dir设置成为0,并且把addr里面LBA地址转化成为CHS,然后找到对应的地址!
类似的,因为我们有虚拟地址空间,我们可以把各种硬件(外设)的寄存器地址放置到物理内存,然后未来我们申请的空间就能通过页表来指向对应的外设。但这些我们不考虑,我们只需要考虑:操作系统向外设对应的寄存器写入就行!
其实,操作系统和外设进行沟通的时候,外设也有寄存器,我们就可以通过对应的寄存器直接写入它的控制命令,写入地址,写入数据,然后它内部硬件电路自动对设备进行对应的访问。
因此,为什么外设(尤其是磁盘)比较慢?
因为它数据寄存器地址寄存器控制数量比较少,而且它内部还是机械设备,当我们在IO的时候,很多时候需要等待磁盘的就绪,这就是为什么我们进程在IO的时候,有时候进程会处于短暂的D状态!
只要我们把一个磁盘中的一个分区管理好,那么其他的分区的管理方式直接根据这个分区的管理方式进行复制粘贴即可。因此,问题是:如何管理其中的一个分区?
我们知道:分区的目的是为了减少我们解决问题的规模,那么分区的本质是什么?
磁盘在进行抽象之后,有一个一个的"块",因此所谓的分区就是定义出来我们当前在磁盘当中的start和end即可。对于一个操作系统,它一般把自己分区的信息写在它第一个块的第一个扇区的指定位置里面。那么它可以在内部 定义类似分区1start1,end1,分区2start2,end2......这个我们称之为分区表。
实际上,我们电脑里只有一个物理磁盘,C盘和D盘是Windows文件系统给我们模拟抽象出来的一个盘,其实C盘或D盘是一块物理磁盘对应的分区。如:C盘300GB。但是300GB也不小啊,怎么管理?
我们可以继续把这300GB分为一个个的子区域,我们把它叫做:分组。假设每一个小组为10GB,所以我们只需要把其中的一个小组管理好就能把所有的小组管理好了,因此我们就能把一个分区管理好了!!!
因此,我们要学习文件系统,我们第一件事就是如何把一个小组管理好。我们本来想要管理800GB,现在只需要管理10GB,这叫做:分治!
因此,我们现在需要把问题转化成了对"块组"如何被管理的即可!
共识:文件=文件内容+文件属性,其实不管是文件内容还是文件属性,都是数据,因此都需要存储好。
但是①Linux当中文件的属性和内容是分开存储的;②在文件系统中,和磁盘进行IO的基本单位数:4KB(512字节)!
3.块组内部构成
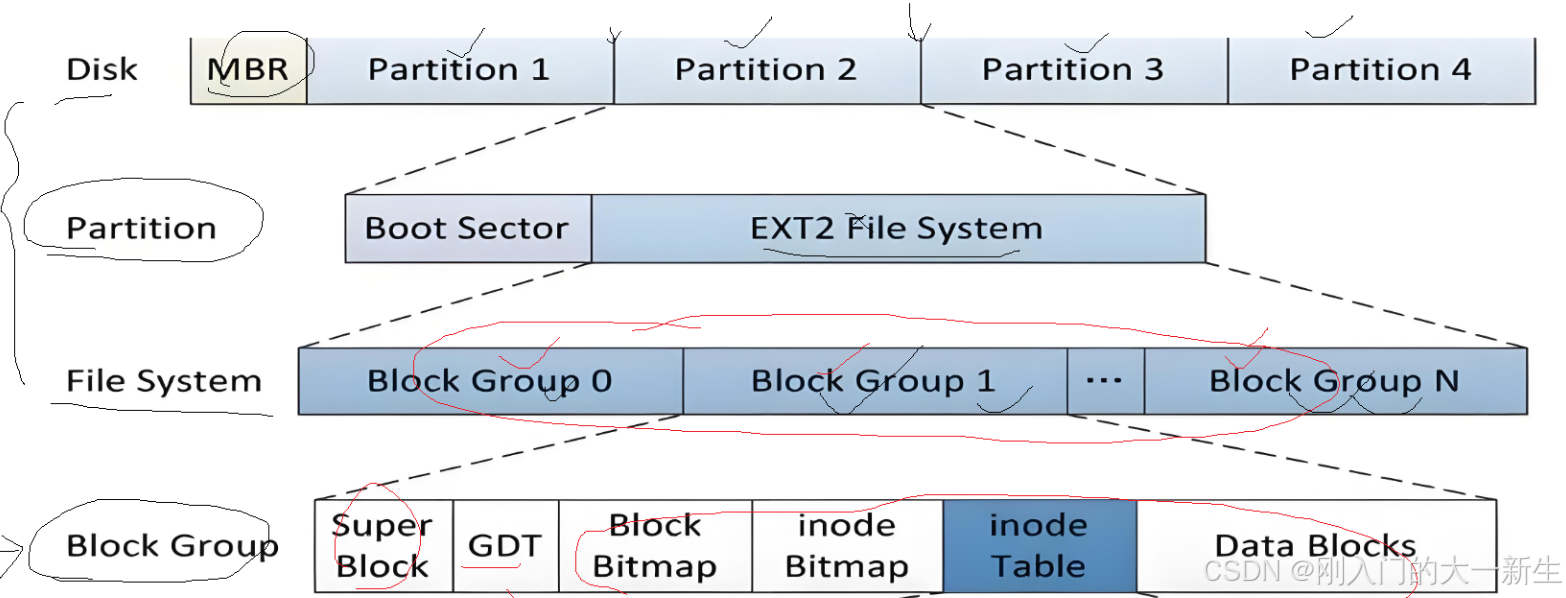
3.1文件内容的存放
Data Blocks:只保存 文件的内容,以4KB为单位,因此我们把它称为数据块区域。其实在我们的分组里面,绝大部分空间都是由Data Blocks来占据的,即它占取绝大部分的磁盘空间,Data Blocks里面保存的就是数据块,且每个数据块大小是固定的,数据块总量固定,单位也是固定的。
因此:每一个数据块都有唯一的编号!
那么哪些数据块被占用了,哪些数据块没有被占用,如何知道?
如:我们在一块数据块上有0101这样的数据,那么能不能代表这个数据块有数据?并不能,我们不能确定这个数据块有数据,因此我们有结构:Block Bitmap。
块位图(Block Bitmap)中记录着Data Block中哪个数据块已经被占用,哪些数据块没有被占用。
假设有100万个数据块,100万个数据块每个数据块用一个比特位来表示,100万个数据块就占1000000/8个字节(125000字节),由于一个块有4KB,因此就有bitmap就有31个块,因此,我们只需要31个块就能表示100 0000数据块的整个位图结构。
因此,bitmap比特位的位置表示对应哪一个数据块,比特位的内容(1/0)表示对应的数据块是否被占用。
那么文件的属性该怎么存放?
3.2文件属性的存放
Linux文件属性有哪些呢?
文件的属性有:文件名,权限、文件类型、拥有者、所属组......
在Linux文件属性,我们用struct inode来表示文件的属性!
例如下面对文件的描述结构体:
cpp
/*
* Structure of an inode on the disk
*/
struct ext2_inode
{
    __le16 i_mode; /* File mode */
    __le16 i_uid; /* Low 16 bits of Owner Uid */
    __le32 i_size; /* Size in bytes */
    __le32 i_atime; /* Access time */
    __le32 i_ctime; /* Creation time */
    __le32 i_mtime; /* Modification time */
    __le32 i_dtime; /* Deletion Time */
    __le16 i_gid; /* Low 16 bits of Group Id */
    __le16 i_links_count; /* Links count */
    __le32 i_blocks; /* Blocks count */
    __le32 i_flags; /* File flags */
    union
    {
        struct
        {
            __le32 l_i_reserved1;
        } linux1;
        struct
        {
        __le32 h_i_translator;
        } hurd1;
        struct
        {
            __le32 m_i_reserved1;
        } masix1;
    } osd1; /* OS dependent 1 */
    __le32 i_block[EXT2_N_BLOCKS];/* Pointers to blocks */
    __le32 i_generation; /* File version (for NFS) */
    __le32 i_file_acl; /* File ACL */
    __le32 i_dir_acl; /* Directory ACL */
    __le32 i_faddr; /* Fragment address */
    union
    {
        struct
        {
        __u8 l_i_frag; /* Fragment number */
        __u8 l_i_fsize; /* Fragment size */
        __u16 i_pad1;
        __le16 l_i_uid_high; /* these 2 fields */
        __le16 l_i_gid_high; /* were reserved2[0] */
        __u32 l_i_reserved2;
        } linux2;
        struct
        {
            __u8 h_i_frag; /* Fragment number */
            __u8 h_i_fsize; /* Fragment size */
            __le16 h_i_mode_high;
            __le16 h_i_uid_high;
            __le16 h_i_gid_high;
            __le32 h_i_author;
        } hurd2;
        struct
        {
            __u8 m_i_frag; /* Fragment number */
            __u8 m_i_fsize; /* Fragment size */
            __u16 m_pad1;
            __u32 m_i_reserved2[2];
        } masix2;
    } osd2; /* OS dependent 2 */
};
#define EXT2_NDIR_BLOCKS 12
#define EXT2_IND_BLOCK EXT2_NDIR_BLOCKS
#define EXT2_DIND_BLOCK (EXT2_IND_BLOCK + 1)
#define EXT2_TIND_BLOCK (EXT2_DIND_BLOCK + 1)
#define EXT2_N_BLOCKS (EXT2_TIND_BLOCK + 1)
//inode 的⼤⼩通常是 128 字节 或 256 字节
因为inode本质是一个结构体,就注定了它的大小是固定的,大小为sizeof(inode)(一般为128字节或256字节)!
我们每一个文件都有属性,所有文件的属性类型都是相同的,都有文件名/文件类型/权限,但是所有文件的属性的内容是不相同的。而任何一个文件总共需要多少种属性,全部都是一样的(即struct inode每个文件所含的成员变量的数量是固定的)!
因此,操作系统要读取文件,读取inode,一次依旧4KB读取,即我们可以读取4*1024=4096个字节,而inode是128字节(假设),那么就能一次读取4096/128=32个inode,因此操作系统可以一次性读取32组文件对应的inode!
一般而言,一个文件一个inode,一个文件可能对应0个或者多个data block!
为了标识文件的唯一性,所以每一个inode内部都必须包含一个inode->number!
在Linux中,有一个特殊的地方文件名不能,也不在inode中保存(我们的struct inode里并没有发现字符串)!
3.2.1inode table
inode结点表(Inode Table):单个inode会存放文件属性(文件大小,所有者,最近修改时间等等);当前分组所有inode属性的集合;inode编号以分区为单位,整体划分,不可跨区!
其中inode table是把该分组内的文件属性,其实就是多个inode的集合:
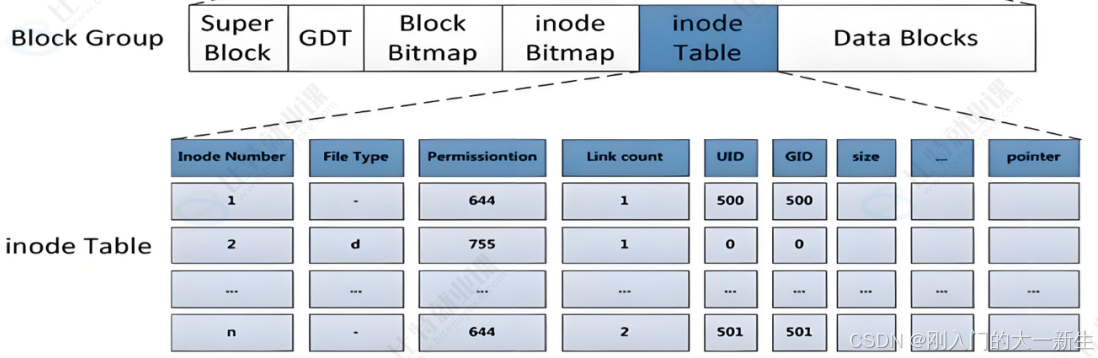
inode table也是一段以4KB为单位的,我们可以吧这个4KB的空间划分成一个一个的inode,我们把这个图横着看就是一个文件对应的所有inode属性,其中每一个inode都占128个字节,因此4KB就有32个inode。
当我们要新建文件时,内容默认是空的,新建文件应当是新建inode,因此,我们需要知道哪些inode被使用了就需要遍历这个inode table?但是底层上,所有的inode的属性都是0101,因此我们分辨不出来。
为了对当前所有的inode信息进行是否被使用的统计,所以需要:inode Bitmap!
3.2.2inode Bitmap
inode位图(inode Bitmap):每个比特位表示inode是否空闲可用。(和Block Bitmap一样的道理:比特位的位置代表第几个inode,比特位的内容(1/0)表示对应inode是否被占用!
3.2.3inode
那么如何看到这个inode呢?
输入:
bash
ls -l -i就能出现:
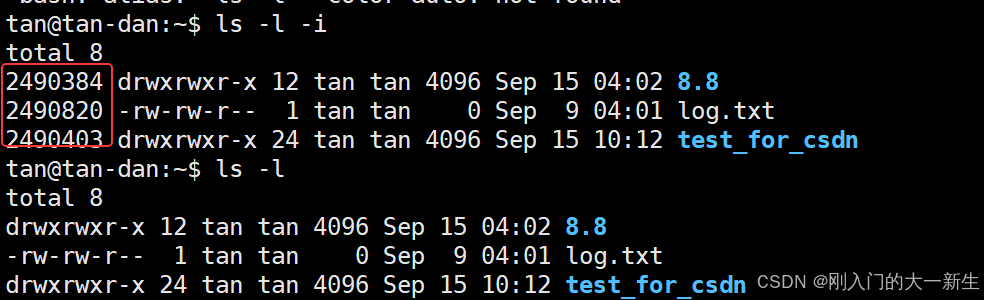
这些在文件权限前面的是inode编号。
其实在Linux中表示文件,我们最终是通过inode来找到对应的文件的!
将来我们可以先通过inode拿到文件的属性,但是如何找到文件的内容呢?
inode结构体里面其实是包含了一个对应block的映射关系表的,即一个文件有一个对应它占据数据块的表。那么这个表在哪里呢?
我们从刚刚的那个inode结构体找到:

该数组会保存对应的文件块号,此时属性和内容都有了!因此就能找到对应的inode属性,内部具有和数据块对应的关系,就能进一步找到文件的内容了!
3.2.4GDT
GDT(Group Descriptor Table),块描述符表,描述块组属性信息,整个分区分成多个块组,就对应有多少个块组描述符,每个块组描述符存储一个块组的描述信息,如在这个块组中从哪⾥开始是inode Table的开始,从哪⾥开始是Data Blocks的开始,空闲的inode和数据块还有多少个等等。块组描述符在每个块组的开头都有⼀份拷⻉。
我们并不知道文件的个数,数据块的个数,被占用的inode个数,被占用的数据块个数,因此,整个分组里面的数据块和inode使用情况就需要整体使用GDT来做一个整体描述与管理,因此GDT叫做块描述符表,描述块组信息。一个分区有很多个分组,其中整个分区有多少个块组就对应多少个块组描述符,即如果一个分区有30个分组,那就有30个GDT!
GDT具体的结构示例:
cpp
// 磁盘级blockgroup的数据结构
/*
* Structure of a blocks group descriptor
*/
struct ext2_group_desc
{
    __le32 bg_block_bitmap; /* Blocks bitmap block *///Block Bitmap占了多少块
    __le32 bg_inode_bitmap; /* Inodes bitmap */
    __le32 bg_inode_table; /* Inodes table block*///inode Table表占用的数据块个数
    __le16 bg_free_blocks_count; /* Free blocks count */
    __le16 bg_free_inodes_count; /* Free inodes count */
    __le16 bg_used_dirs_count; /* Directories count */
    __le16 bg_pad;
    __le32 bg_reserved[3];
};
由于结构是这样的:

因此,这些类似Block Bitmap这类的东西都是连续存储的,所以在文件系统里面就可以从GDT往后按照个数依次把这三个区域划分好,类似free_blocks_count代表有多少个空闲的block数据块等共同描述一个分组,因此这就是GDT。
3.2.5Super Block
超级块(Super Block),它存放⽂件系统本⾝的结构信息,描述整个分区的⽂件系统信息。记录的信息主要有:bolck 和 inode的总量,未使⽤的block和inode的数量,⼀个block和inode的⼤⼩,最近⼀次挂载的时间,最近⼀次写⼊数据的时间,最近⼀次检验磁盘的时间等其他⽂件系统的相关信息。如果Super Block的信息被破坏,可以说整个⽂件系统结构就被破坏了!
其结构为(上面为整个分区,下面为一个分组对应的细节):
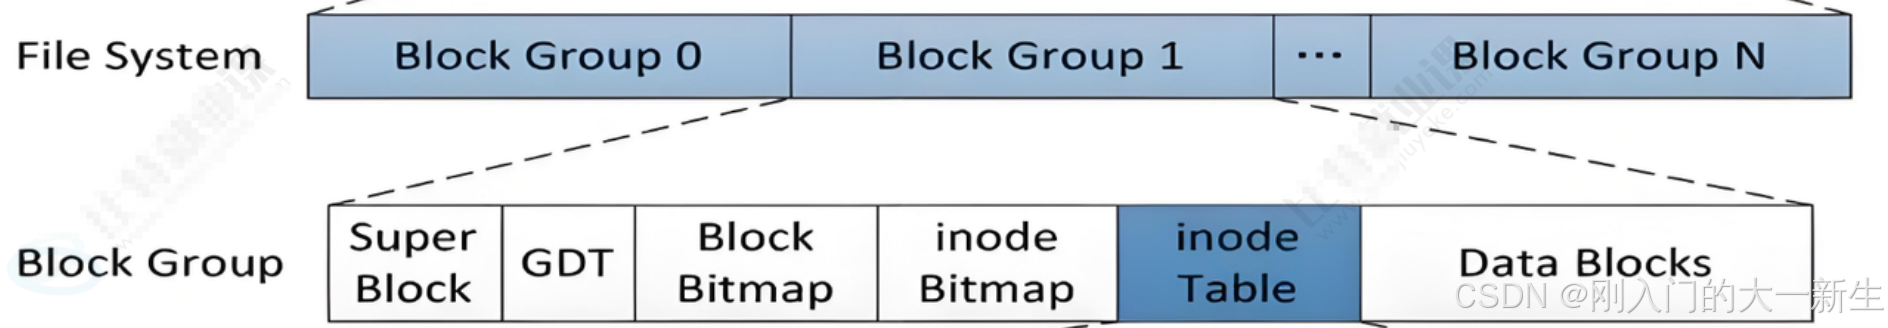
Block Group N即一个分组,而Super Block就描述的是对整个分区整体的管理信息,GDT管理一个组,Super Block管理所有的组!
4.路径解析
问题1:Super Block,既然是描述一个分区的所有分组的整体情况,那么Super Block为什么会在一个块组里中?即为什么不在文件系统的开头就有一个Super Block,却放在其中的一个块组里?这样不就更好管理整个分区吗?
因为Super Block不仅仅在一个组里,其他的组(Block Group)可能也有一个Super Block,即不一定每个组都有Super Block,但是几乎多个组会同时存在同样的Super Block。因为如果我们只存储在文件系统的开头,即这个Super Block就只有一份,那么如果存储这个Super Block的地方损坏了,那么整个文件系统就被破坏了,此时整个分区的所有内容我们都使用不了了!如果存放多个Super Block,即使有一个损坏了也能通过其他块组完好的Super Block恢复出来。
但是为什么GDT只有一份呢,因为GDT影响小,如果GDT丢失,也就只影响一个分组,没必要多存储几遍!
问题2:新建一个分区,Super Block,GDT一定是有效数据,但对应的Bitmap可能为0,即我们新建完一个分区后,要给特定分区写入管理信息,即写入 文件系统和分区分组相关的管理数据,文件数据可以暂时不要,这个工作我们叫做格式化!
如果我们要使用一块硬盘,我们需要做两件事情,1.分区;2.格式化(给当前分区写入文件系统)
问题3:访问一个文件,在分区内标识该文件的唯一性我们用inode编号。那么新建一个文件在干什么?删除一个文件在干什么?修改一个文件在干什么?查询一个文件在干什么?
新建文件是先在该块组查找inode Bitmap,从右向左找到一个为0的比特位(位图存储的),找到后我们就知道了我们在哪个比特位存储这个文件的,即知道了这个文件的inode,此时再把这个比特位由0变成1,然后我们通过偏移量来在指定的inode table申请一个inode空间了,因此我们就可以把inode属性写入进去,那么此时就新建完成了!
如果我们将来要往该文件写入4KB数据,这个文件的inode为1234,我们就可以拿着这个inode编号(1234)找到对应的文件inode,再查对应的Block Bitmap,申请一个数据块,然后我们在Block Bitmap里从右向左查找到0,然后找到对应的块号,把用户数据写入进来,然后再把块写入到inode Bitmap对应的数据映射关系里。
如果要删除一个文件,我们需要拿到inode编号,到Block Bitmap里去找,找到对应的inode Bitmap,找到之后我们需要找到inode的属性,找到之后我们要判断文件大小是否为0,如果不为0,就从inode属性当中内部会建立和数据块的映射关系,从对应的映射数组里找到对应的inode,此时我们就能找到对应的数组,数组里存放块号,拿着对应的块号在Data Blocks里面这个文件对应的数据块的块号只要把对应的比特位清零即可,只要清零这个文件对应的数据块就会被释放了,如果该文件已经被释放了或该文件为空,我们就可以直接拿着这个inode号在inode Bitmap中对应的位图由1改为0即可。即删除文件只需要把位图中对应的1改为0即可!(只改位图,只要设置数据无效,就可以了!)
如果我们在Windows下删除文件,在一些文件修复的软件上仍然能恢复,因为我们只是把文件的内容和属性设置为无效了,但当前的文件属性和内容还在,如果要恢复,直接拿着对应的inode号逆向操作即可完成操作!
要修改文件,我们可以修改文件的属性和文件的内容,我们只需要针对对应的类似清空写入,追加写入等制定对应的方案即可!
问题4:关于inode编号和data block编号。
inode是全分区统一分配的,不是只在分组内有效;inode不能跨区域,一个分区一个文件系统相互独立!
假设一个分区有100 000个inode,假设第一个分组的inode起始编号为0,第二个分组的inode起始编号为10000,因此,如果在不同的分区里有可能就存在相同的inode,但是在一个分区内绝对不存在相同的inode,因此inode是以分区为单位的!
问题5:我们从Linux学到现在都没有用过inode,而是用文件名,文件名没有在inode内部,应该在哪里?
5.目录与文件名
问题转化为如何看待目录文件?
Linux中目录是文件吗?
目录也是文件,目录文件=目录的内容+目录的属性(inode),那么目录的内容存放着什么?目录也要有对应的Data Block,即也要有数据块,只是目录里存放着文件名和inode映射关系!即文件名放在目录的内部保存!
为什么我们用的都是文件名?
因为潜在的是我们用的是指定目录的映射关系。
在文件系统中,从存储方式角度,存储普通文件和目录,有区别吗?
没有区别,只是在Linux文件系统中,区分文件的类型是通过inode当中的mode的标志位来区分对应的是目录还是普通文件,但是在文件系统里不区分是文件还是目录,因为存储方案是一样的!
因此,一个目录下文件名不能重复的原因是键值不能重复!
在指定目录下新建文件的本质:要把文件名和inode对应的映射关系写入到指定的Data Block里。
这就是为什么在当前目录下新建文件,需要该目录具有w权限了,因为最终我们需要把文件名按照字符串映射写入到文件内容里,写入到目录的data Block里。所以,读取一个文件的属性的话,需要当前目录具有r权限,因为如果没有r权限就不能访问该目录的数据块data block,这时就拿不到文件对应的inode和文件名的映射。r/w:对目录设置rw本质是约束用户,访问目录的data block!x权限:能不能进入这个目录,本质上是允许我们是否能打开这个目录。
如果我们在一个目录下新建文件,如果我们不打开这个目录的情况下(不切换到该目录下),此时就不能通过inode来访问对应的文件了,但是我们要打开一个目录,就要打开它的上级目录,最终我们就需要打开根目录,但是根目录我们是确定的。(即我们要打开一个文件,要打开包含它所在的目录,而它所在的目录也包含在它的上级目录,因此要打开它的上级目录......)为什么要打开上级目录?
因为上级目录里建立了目录文件名和inode的映射关系。
那么根目录的inode为什么呢?
输入指令:
bash
ls -lid /就能看到根目录的具体信息:
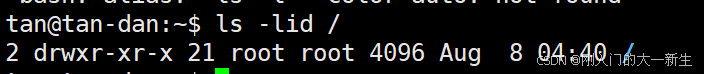
因此根目录是具体的一个inode,因此我们得出一个真相:要打开一个特定路径下的文件,如:file1,那么我们需要对file1所在的路径进行解析!因此要访问file1,需要把其所在路径的所有目录都打开! ----> 结论:我们打开Linux的任何文件时,必须从我们的指定路径,一般都是从根目录开始,要对指定文件所在的路径进行解析(依次打开路径下的每个目录的inode)! -----> 这就是为什么我们之前进行文件打开操作的open函数必须要有路径的原因!这就是为什么Linux下访问任何文件,都需要路径访问!这就是为什么进程PCB内部要包含cwd的根本原因!-----> 最终结论:这就是为什么Linux下,文件路径可以定位文件的根本原因! ----> Linux下访问任意文件,都必须带路径(无论是显式的还是隐式的)****!
6.路径缓存
问题5:当我们尝试对一个文件系统的属性进行增删查改的时候,都必须先把对应的文件系统的信息加载到内存当中。在内存中修改,写回对应的磁盘位置! ------> 文件系统的部分数据结构,未来在开机的时候,就直接加载到内核中了,然后在内核对数据做操作,做管理,然后刷新到磁盘对应的分区对应的分组! ------> 但是为什么我们在Linux命令行进行tree 目录的操作,能看到对应的树呢?
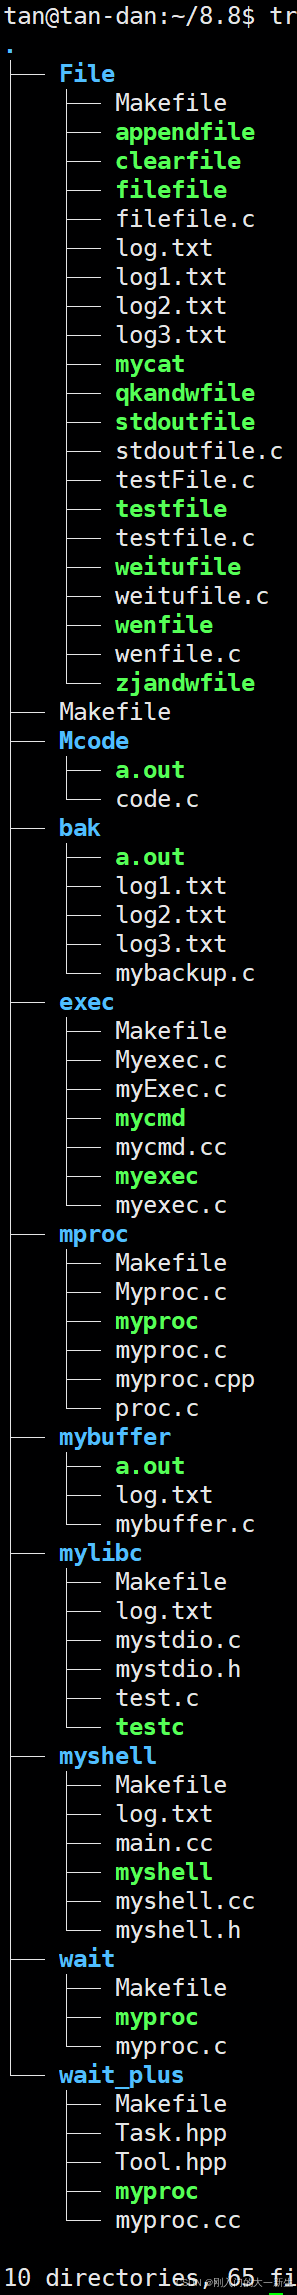
如果是这样的话,速度不应该很慢吗,为啥我们看到的还是比较快的?
Linux系统中,当用户访问指定路径下的文件(包括路上目录,最终的目标文件在内),Linux会在你进行路径解析的过程中,在内核中会形成目录树和路径缓存! -----> 目录结构是内存级的!
Linux中,在内核中维护树状路径结构的内核结构体叫做:struct dentry
cpp
struct dentry {
    atomic_t d_count;
    unsigned int d_flags; /* protected by d_lock */
    spinlock_t d_lock; /* per dentry lock */
    struct inode *d_inode; /* Where the name belongs to - NULL is
    * negative */
    /*
    * The next three fields are touched by __d_lookup. Place them here
    * so they all fit in a cache line.
    */
    struct hlist_node d_hash; /* lookup hash list */
    struct dentry *d_parent; /* parent directory */
    struct qstr d_name;
    struct list_head d_lru; /* LRU list */
    /*
    * d_child and d_rcu can share memory
    */
    union {
        struct list_head d_child; /* child of parent list */
        struct rcu_head d_rcu;
    } d_u;
    struct list_head d_subdirs; /* our children */
    struct list_head d_alias; /* inode alias list */
    unsigned long d_time; /* used by d_revalidate */
    struct dentry_operations *d_op;
    struct super_block *d_sb; /* The root of the dentry tree */
    void *d_fsdata; /* fs-specific data */
#ifdef CONFIG_PROFILING
    struct dcookie_struct *d_cookie; /* cookie, if any */
#endif
    int d_mounted;
    unsigned char d_iname[DNAME_INLINE_LEN_MIN]; /* small names */
};
从今天开始,进行路径解析的时候,只有第一次是慢的,后面的n次路径解析,优先从dentry树结构中进行解析!(即当我们第一次解析完后,后面解析要在根目录进行解析,此时就不需要在磁盘中查找了,直接从dentry树的根目录进行解析,发现根目录已经加载了,然后依次往后查找后面的路径。 ------> Linux的路径缓存!因此dentry既属于多叉树结构,又属于LRU链表!
注意:
①每个⽂件其实都要有对应的dentry结构,包括普通⽂件。这样所有被打开的⽂件,就可以在内存中形成整个树形结构
②整个树形节点也同时会⾪属于LRU(Least Recently Used,最近最少使⽤)结构中,进⾏节点淘汰
③整个树形节点也同时会⾪属于Hash,⽅便快速查找
④更重要的是,这个树形结构,整体构成了Linux的路径缓存结构,打开访问任何⽂件,都在先在这棵树下根据路径进⾏查找,找到就返回属性inode和内容,没找到就从磁盘加载路径,添加dentry结构,缓存新路径
问题:打开当前⼯作⽬录⽂件,查看当前⼯作⽬录⽂件的内容?当前⼯作⽬录不也是⽂件吗?我们访问当前⼯作⽬录不也是只知道当前⼯作⽬录的⽂件名吗?要访问它,不也得知道当前⼯作⽬录的inode吗?
答案1:所以也要打开:当前⼯作⽬录的上级⽬录,额....,上级⽬录不也是⽬录吗??不还是上⾯的问题吗?
答案2:所以类似"递归",需要把路径中所有的⽬录全部解析,出⼝是"/"根⽬录。
最终答案3:⽽实际上,任何⽂件,都有路径,访问⽬标⽂件,⽐如:
/home/whb/code/test/test/test.c
都要从根⽬录开始,依次打开每⼀个⽬录,根据⽬录名,依次访问每个⽬录下指定的⽬录,直到访问到test.c。这个过程叫做Linux路径解析。
既然group,inode,block(Data Block数据块)个数都是固定的,那么如果inode用完了,block没用完咋办(磁盘有空间,但是为什么不能创建文件了)?如果block用完了,inode没用完咋办?
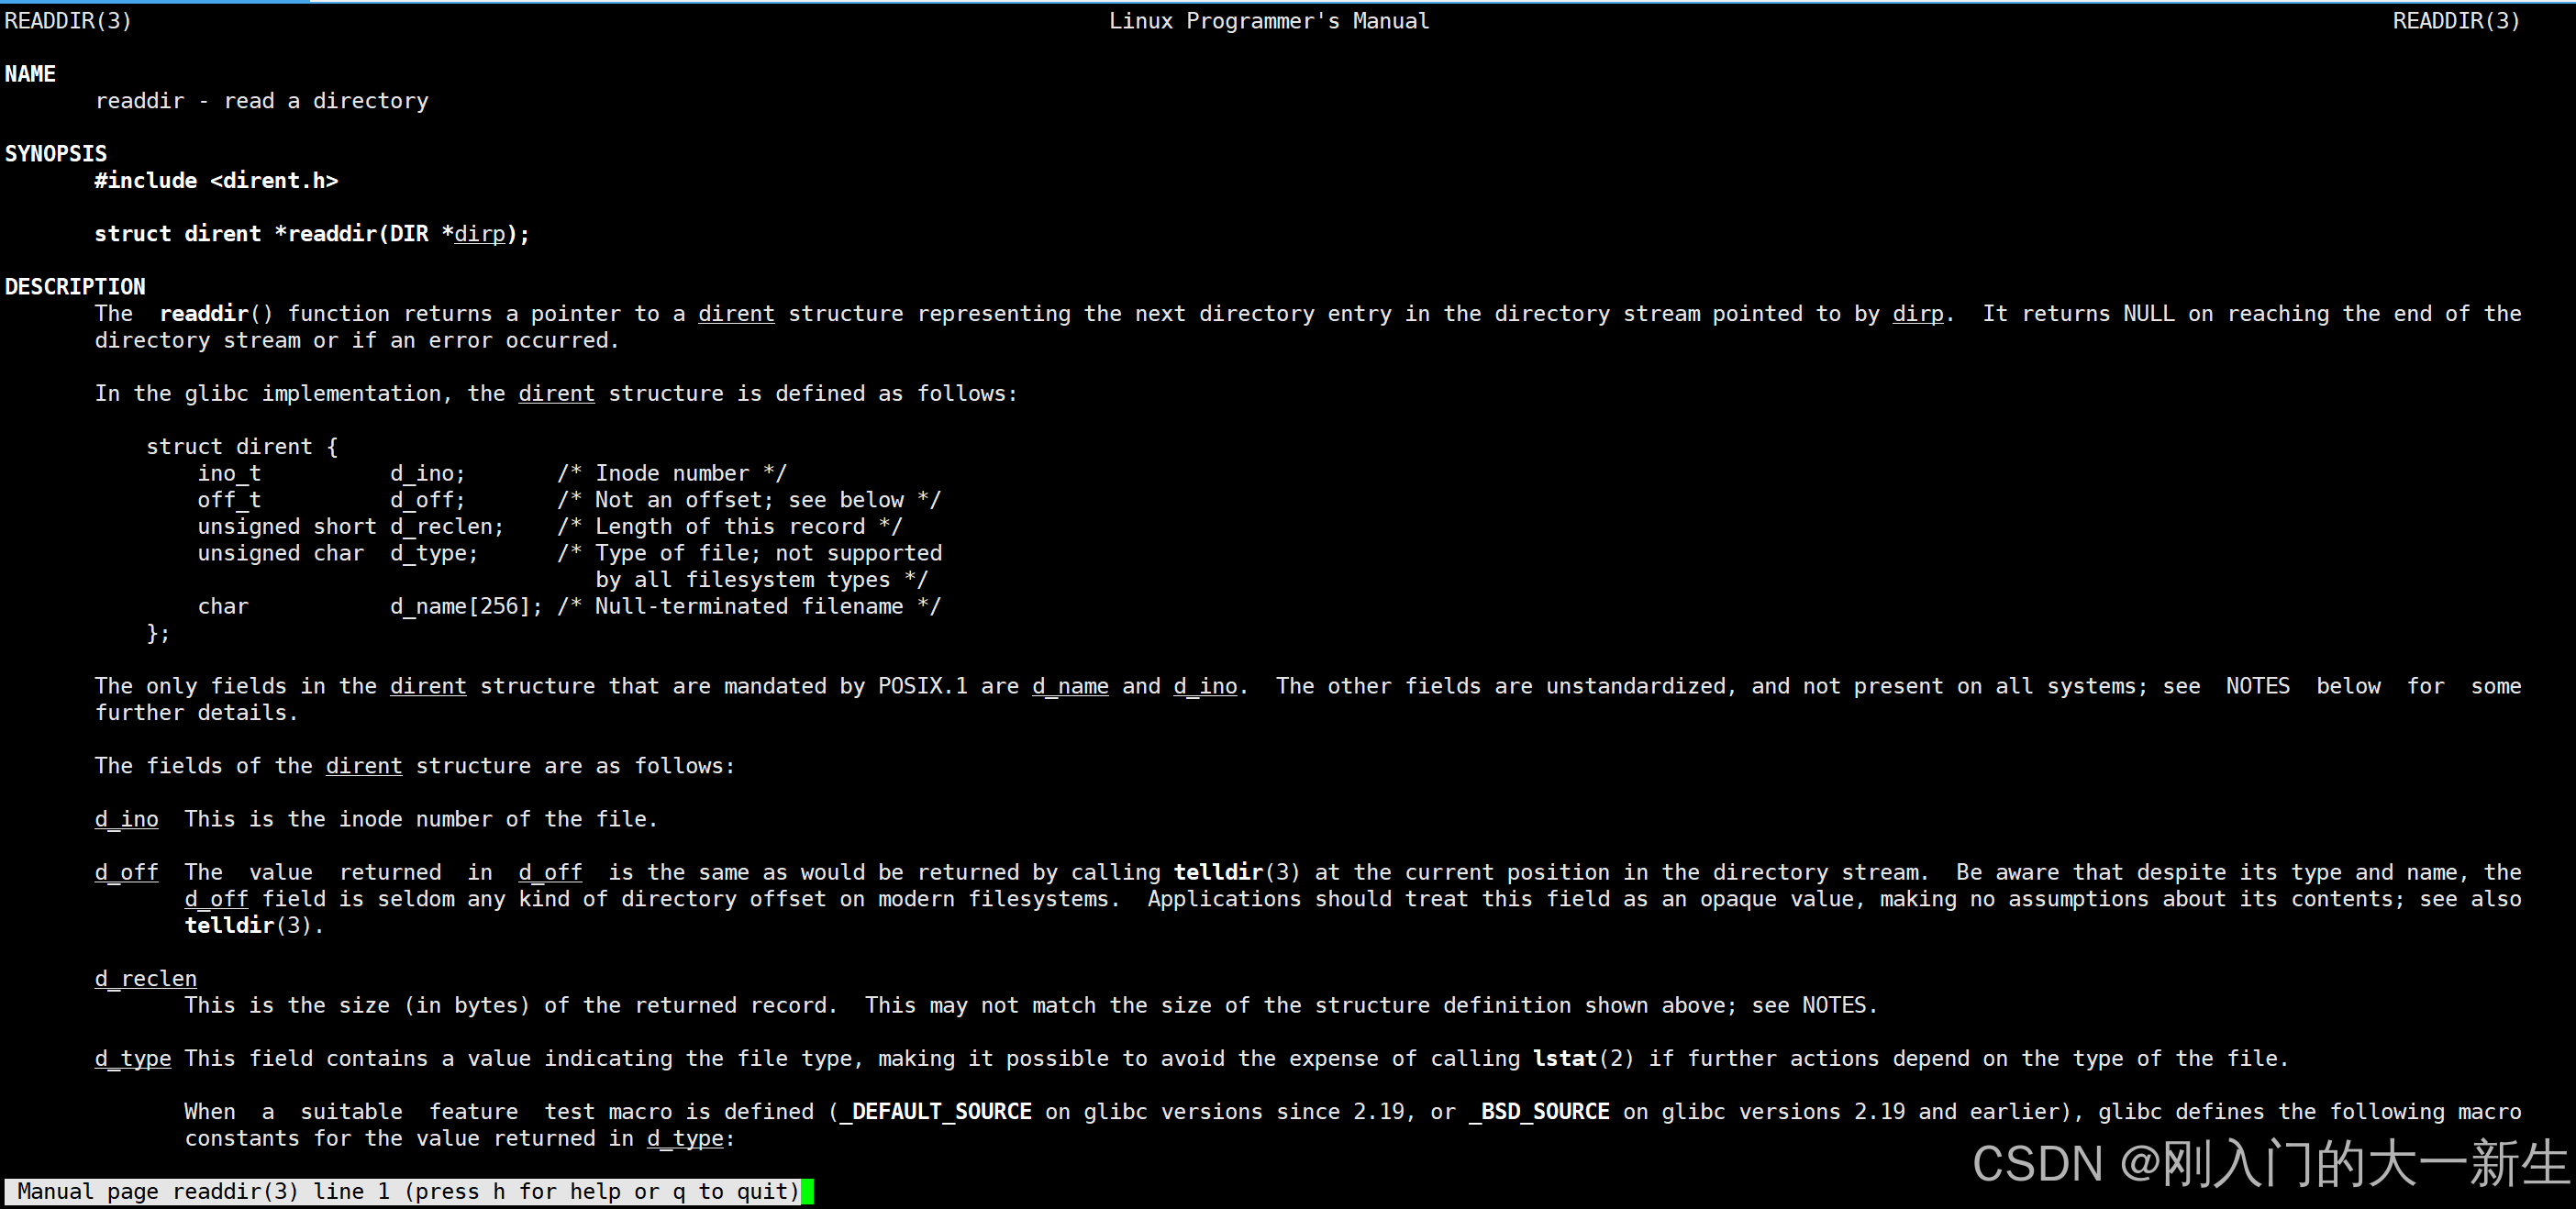
我们可以用readdir来读取目录信息:
7.挂载分区
我们知道每个分区的inode是唯一的,但是如果扩展到整个文件系统,那么文件系统有多个分区,假设有一个inode为100,分区1也有为100的inode,分区2也有为100的inode,系统怎么知道这个inode为100的是在哪个分区的呢?
在Linux下磁盘一般在/dev下,如果是云服务器就是/dev/vda:
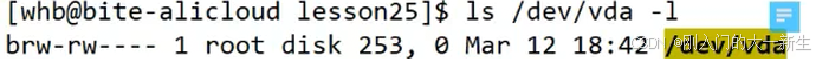
如果是在虚拟机下是/dev/sda:

云服务器也有可能不止一块盘,而是几块盘:
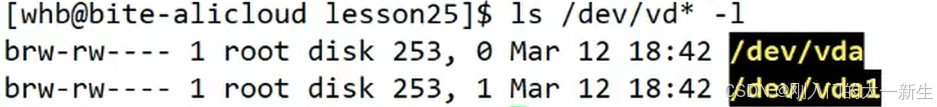
在虚拟机下也可能不止一块盘:
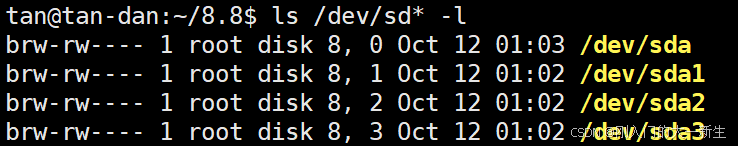
我们并不能直接使用这个物理盘,要使用就需要把这个物理盘进行分区格式化,而当前整个系统,磁盘只有一块,分区只有一块就是vda1;将来如果把磁盘分为两块就有vda2。即vda(数字)/sda(数字)这是我们磁盘当中的分区。但是这个分区并不能直接使用,它必须得被挂载才能被使用,即挂载分区!
一个分区,必须要分区格式化,才能具有使用的前提;一个分区,要真正被使用,必须要挂载到指定的目录才可以!
我们输入指令:
bash
df -h有:
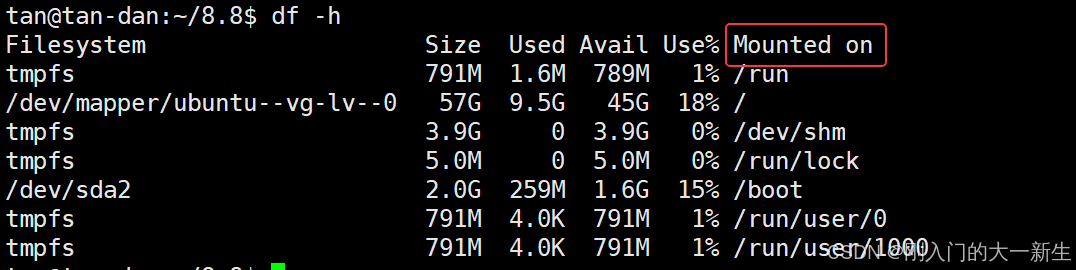
Mouted on:被挂载的路径,我们发现/dev/sda2被挂载到/boot路径下了,所以我们在/boot路径下进行的所有增删查改的操作,都在sda2这个分区下进行的!
我们要真正使用这个sda2的话要把它放到一个目录下的。
但是如果我们只有一个分区的情况下,是不需要进行跨分区操作的,所以我们可以模拟出一个分区出来,本质上一个分区是一段磁盘空间,我们只需要伪造出一段磁盘空间,把这段空间视为分区即可!因此我们需要使用dd命令来进行:
我们需要创建一个实验目录,并切换到该目录:
bash
mkdir -p ~/disk_test
cd ~/disk_test
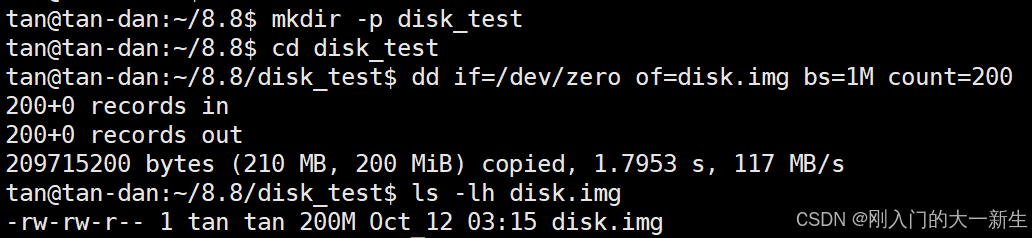
用dd创建一个200MB的全零文件,模拟一块磁盘:
bash
dd if=/dev/zero of=disk.img bs=1M count=200查看文件:
bash
ls -lh disk.img有:
把整个文件当做一个分区的步骤:
①直接格式化为ext4文件系统:
bash
sudo mkfs.ext4 -F disk.img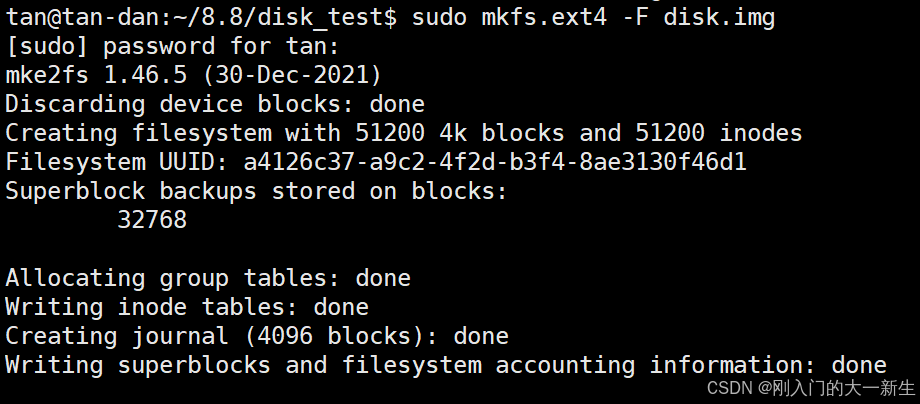
②创建挂载点并挂载:
bash
sudo mkdir -p /mnt/mydisk
bash
sudo mount -o loop disk.img /mnt/mydisk
③验证挂载:
bash
df -hT /mnt/mydisk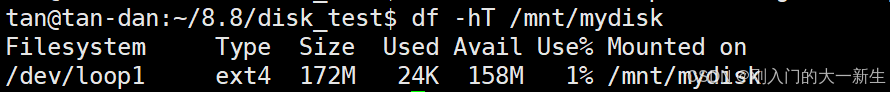
如果看到类似/dev/loop1这样的设备出现,并在Mounted on看到对应的路径代表已挂载。
bash
mount | grep mydisk
④测试读写:
bash
echo "Hello, Linux 分区实验!" | sudo tee /mnt/mydisk/hello.txt如果出现这样的界面代表成功:

或者后面输入这个指令:
bash
cat /mnt/mydisk/hello.txt有:
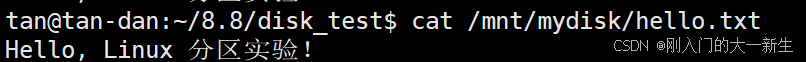
输入下面指令:
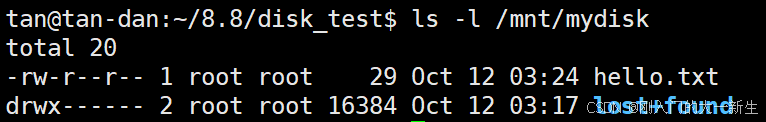
bash
ls -l /mnt/mydisk能看到:
⑤卸载并清理:
bash
sudo umount /mnt/mydisk
bash
rm disk.img 当然如果不想删除这个disk.img也行!
如果想要具体了解整个过程可以问AI大模型,寻求解释,因为这里并不是很重要,这里不做过多解释了!
回到最开始的问题,我们如何知道我访问的分区在哪里?
我们知道,访问文件的时候是带了路径的,如果你访问的路径以/开头,则为:
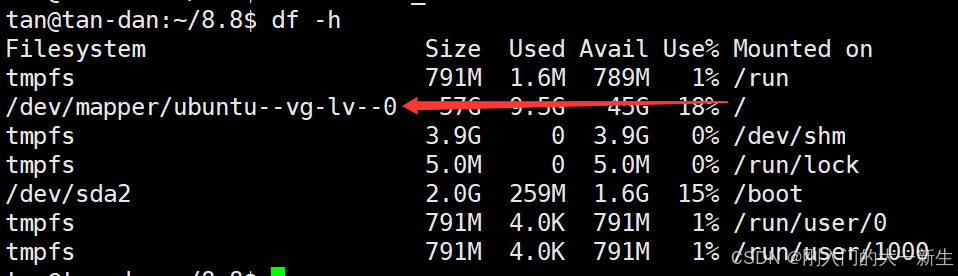
因此,以/开头的代表挂载的路径是根目录,因此我们访问的分区是这个分区!如果我们访问的是以/run/lock开头,那么访问的分区就是tmpfs分区,我们挂载的路径是有路径字符串的,以哪个字符串开头,匹配最接近的分区,如/run/lock虽然它匹配/,也匹配/run,但是有/run/lock,因此是访问的tmpfs!
结论:
①分区写⼊⽂件系统,⽆法直接使⽤,需要和指定的⽬录关联,进⾏挂载才能使⽤。
②所以,可以根据访问⽬标⽂件的"路径前缀"准确判断我在哪⼀个分区。
8.软硬链接
8.1软链接
我们使用:
bash
ln -s xxx.c xxx-soft就可以把xxx.c和xxx-soft用软链接起来(xxx.c已经存在,而xxx-soft并不存在),然后我们用ls -li查看结果:
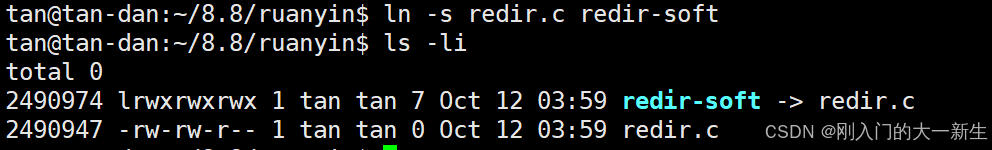
其中inode为2490977这个文件叫做软链接。
8.2硬链接
我们使用:
bash
ln redir.c redir-hard创建一个硬链接:
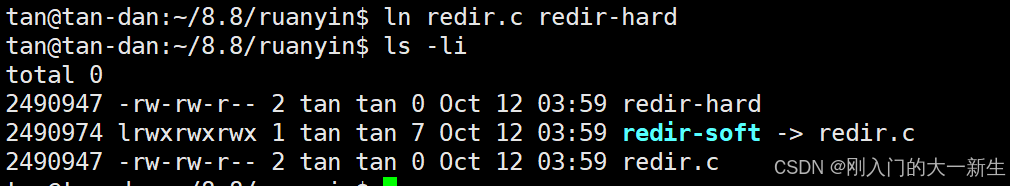
其中inode为249047的第一个为硬链接!
8.3软硬链接的区别
观察一下硬链接和原文件的区别:
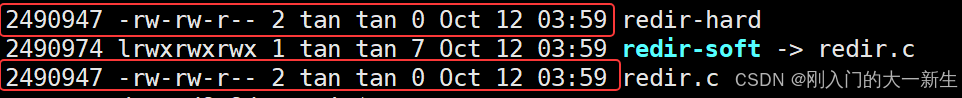
我们发现,除了文件名不一样外,其他的文件的所有信息都完全一样!
观察一下软连接和原文件的区别:

发现inode不一样,且连文件的属性也有很多区别!
因此结论:
软链接是一个独立的文件,因为它有独立的inode;硬链接不是一个独立的文件,因为它没有独立的inode。
那么软硬链接存在的意义是什么?
文件=属性+内容,软硬链接的内容该放什么?
软链接里面存放的内容是指向文件所处的路径字符串!软链接特别像Winodws中的快捷方式,Winodws快捷方式就类似我们不需要去C盘/D盘找到对应程序所在的目录,而只需要右键创建快捷方式即可:
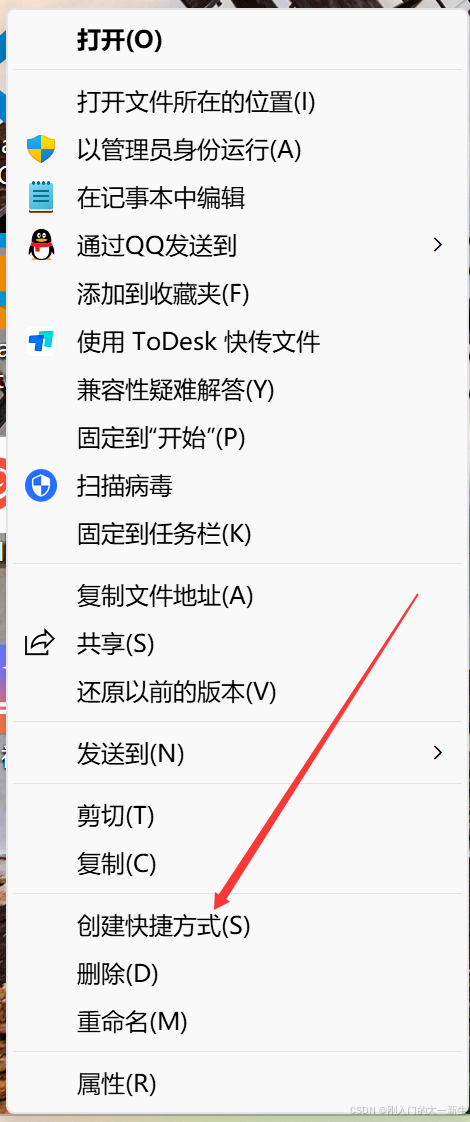
快捷方式存在的意义是:避免我们在一个比较深的路径下查找可执行程序,有这个快捷方式,我们可以快速找到对应的目标程序,快捷方式是一个独立的文件,它存放着目标文件所对应的路径:
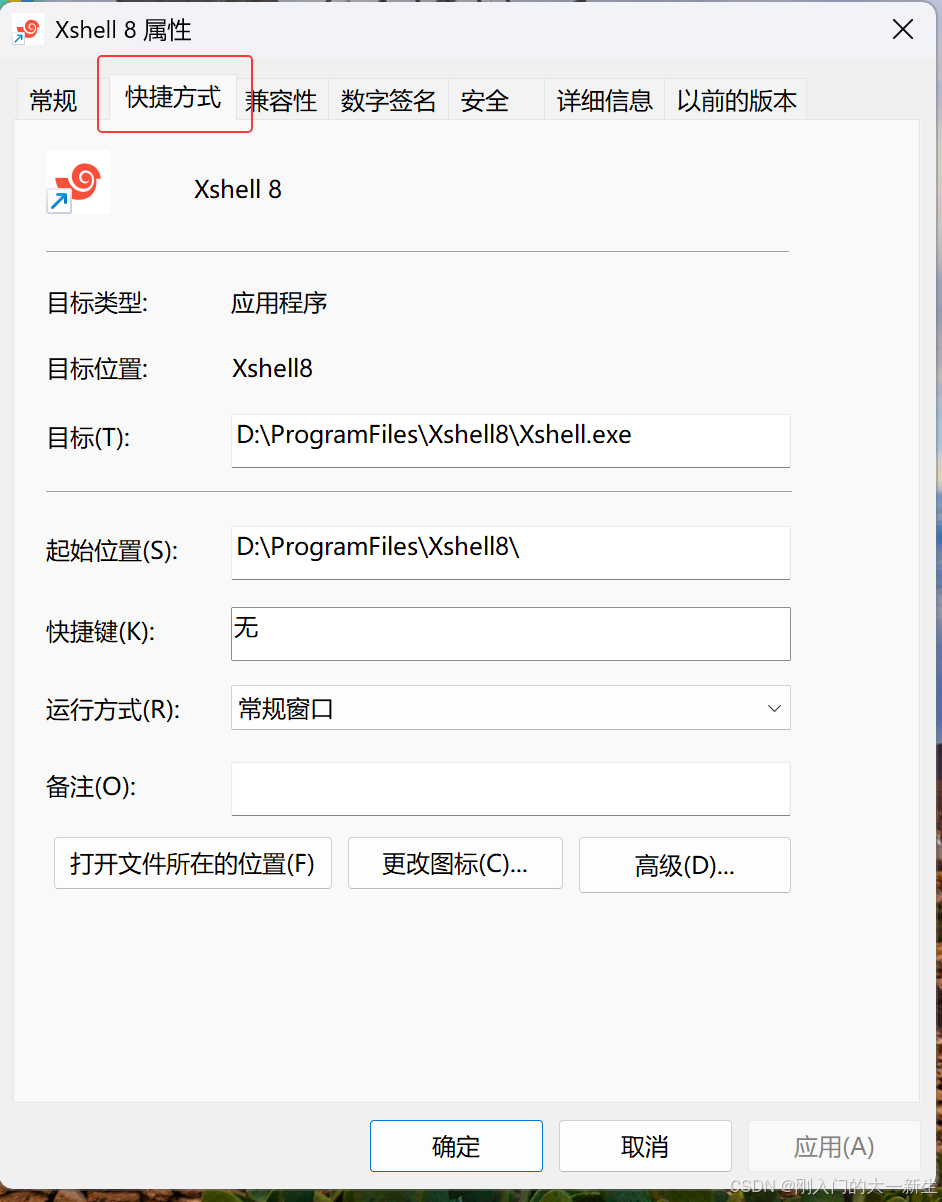
软链接的应用场景之一就是快捷方式!
在Linux下,如果我们执行程序必须带绝对路径,如:
bash
/usr/bin/ls这样的方式写得非常麻烦,所以我们一般可以建立一个软链接如:
bash
ln -s ./bin/redir run这样我们就可以使用./run来执行./bin/redir!
此外,如果后面redir被修改了,这个软链接也自动会匹配新的redir!
因此软链接还可以让用户无感知进行软件升级!
硬链接是什么,它在做什么事情?
本质是在指定目录下,建立新的文件名和目标inode的映射关系,并没有在系统层面创建新的文件!
硬链接的应用场景:
如果我们删除了redir.c,那么有:
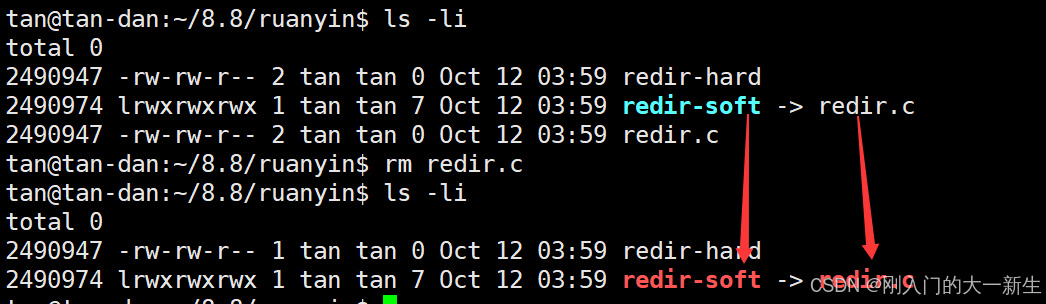
此时的redir-soft实际上是没有任何作用了,如果想要给它断开连接用一下命令:
bash
unlink redir-soft即可:
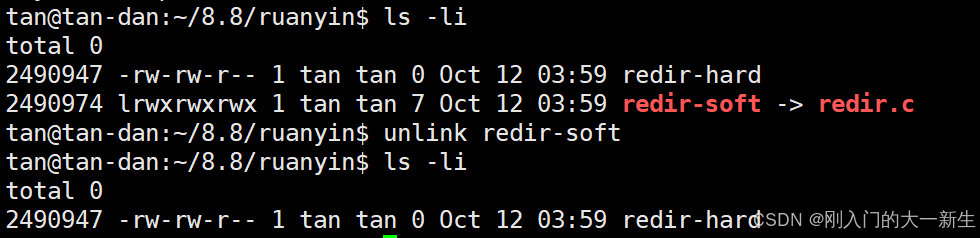
但是实际上这个redir.c并没有被删掉,因为inode还在,只要inode在,inode的属性就在,属性在,内容就在,因此,硬链接类似我们文件的重命名(或者复制文件的全部内容和属性),甚至我们可以把这个redir.c硬链接到其他目录(路径)下!
因此,硬链接可以对文件进行备份!(但是并不会多占用更多的空间)
我们观察之前的图片发现,我们创建硬链接之前有:
创建硬链接之后有:
哎,这个redir.c第三个文件的属性由1变成2了!
因此,我们平时在这一列:
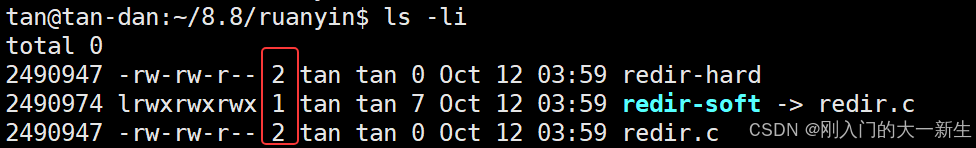
代表的是:硬链接数,硬链接本质是有几个文件名指向特定的inode!因此,我们删除redir.c的时候还有一个变化就是这个编号-1了:
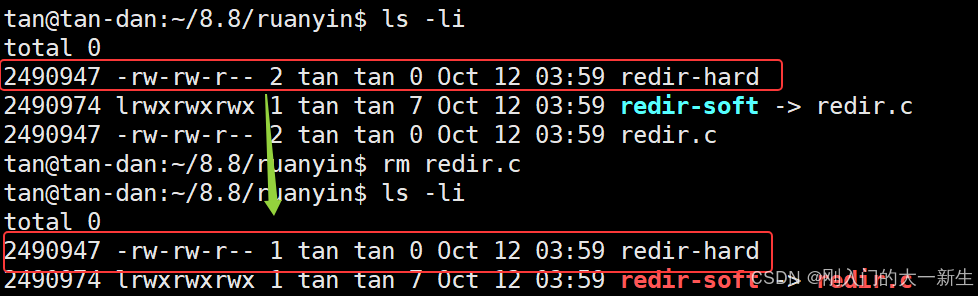
硬链接数是对特定属性的引用计数!
因此,我们删除文件时,并不是直接就删除了,而是先对引用计数--,然后判断是否为0,为0才删除,如果不为0删除了就不对了!(有其他文件也是和他一样的)因此,我们这样备份就可以防止我们不小心删除了一个文件,也没多大的关系!
我们观察一下文件和目录的引用计数:
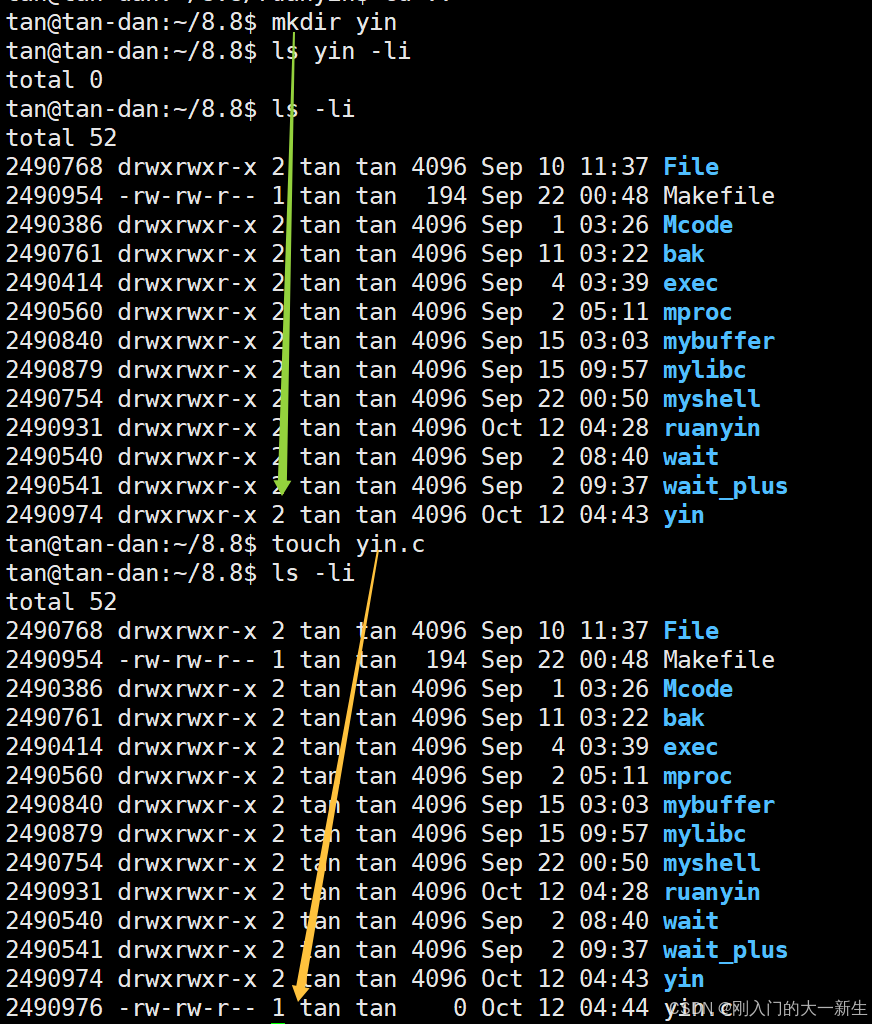
为什么文件的默认硬链接数是1,而目录的默认硬链接数是2?
因为普通文件对应的文件名和inode的映射关系只有一组文件名和一个inode,所以它的引用计数就是1。(空)目录是2,首先,自己的目录名字和inode是一组映射关系,但是在空目录里有一个目录叫做.,和dir本身的inode是一样的:
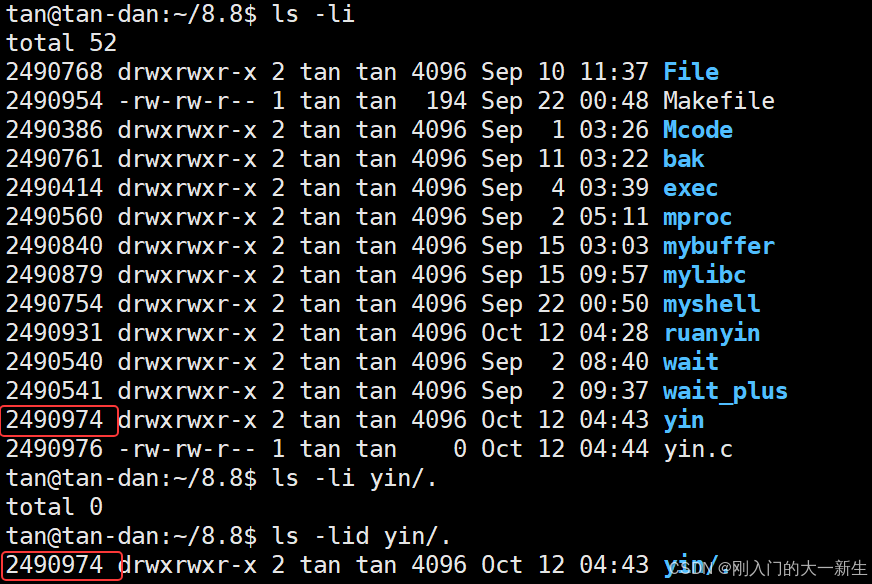
因此,我们用.表示当前目录,因为.和当前目录指向同一个inode,因此有2个目录名指向2490974即.和yin是一个硬链接!因此,一个空目录的默认硬链接数是2!
如果我们的目录里还存在一个子目录,如我在yin里再创建一个目录有:
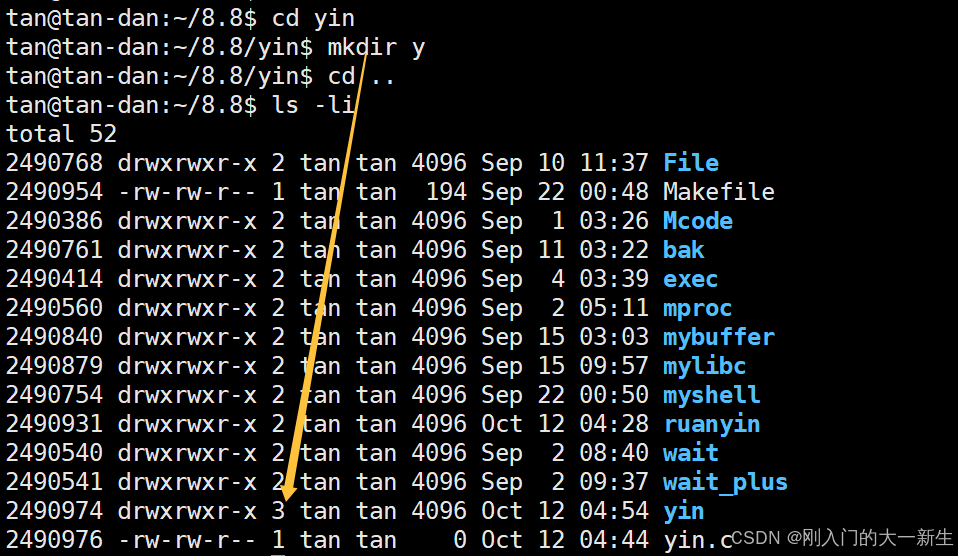
我们发现此时的引用计数变成了3,为什么?
因为在我们新创建的y目录下有一个..:

即yin/y/..就是第三个与2490974这个inode链接的文件!
因此,我们在统计硬链接数时还要加上.以及..,分情况讨论!
用户层面,不允许对目录设置硬链接,只允许对普通文件设置硬链接:

不能给目录设置硬链接的原因:如果我设置的硬链接在其他目录下,如:/home/tan/8.8/yin我设置硬链接为/home/tan,由于二者inode一样,那么当查找到/home/tan/8.8/yin时识别到的inode和/home/tan一样,就会回退到/home/tan继续查找,无限循环(路径的环路的问题)!
但是为什么系统设置了两个硬链接:.和..呢,我们却不能设置?
因为.和..是特殊的目录名称,在系统做对应的判断的时候,会对.和..进行特殊处理,跳过这个.和..!