🔥 星光编译者 · 个人主页
📚 学习专栏: 《C/C++ 成长笔记》 · 《Linux 实践手册》 · 《数据结构与算法》
🌄 向云端飞扬,编译属于自己的代码星河。
☕ 写在开篇
你好,这里是 星光编译者。
这里记录我在 C/C++、Linux、数据结构与算法 学习中遇到的真实问题、亲手验证过的代码,以及那些容易被忽略的实现细节。
比起简单罗列结论,我更愿意从问题出发,把一个知识点的来由讲清楚,把"为什么会这样"和"应该怎样解决"说明白,让每一次踩坑都沉淀成可以复用的经验。
如果这篇记录能帮你少绕一点路,或让某个模糊的地方忽然变得清晰,那么这次分享便有了意义。愿我们在一次次阅读、编译与调试中稳步向前,慢慢搭起属于自己的技术世界。
🔥 本文定位:承接上篇的协议栈与传输流程,根据《1 网络基础概念》PDF 第 19~26 页整理 Socket 编程预备知识,并补充字节序和 IPv4 地址初始化的完整示例。
💡 学习目标 :分清 IP、端口、PID 与 Socket;理解 TCP 字节流与 UDP 数据报;会使用
htons()、htonl()和inet_pton();能正确准备sockaddr_in。📌 代码约定 :正文代码采用 Linux/POSIX C11 接口,IPv4 示例使用
AF_INET。本篇完整代码只演示地址准备、字节观察与本地绑定,不实现聊天或回显服务;后续 UDP/TCP 博客再完成通信程序。
文章目录
- 一、网络通信为什么最终要交给应用
- 二、IP端口与PID各自标识什么
- 三、Socket地址对象与连接四元组
- 四、TCP与UDP的第一张对照表
- 五、网络字节序究竟在转换什么
- 六、四个转换函数与字节观察实验
- 七、sockaddr与sockaddr_in
- 八、正确初始化一个IPv4地址
- 九、Socket接口的职责与调用顺序
- 十、完整地址与本地绑定示例
- 十一、常见错误与排查清单
- 总结
一、网络通信为什么最终要交给应用
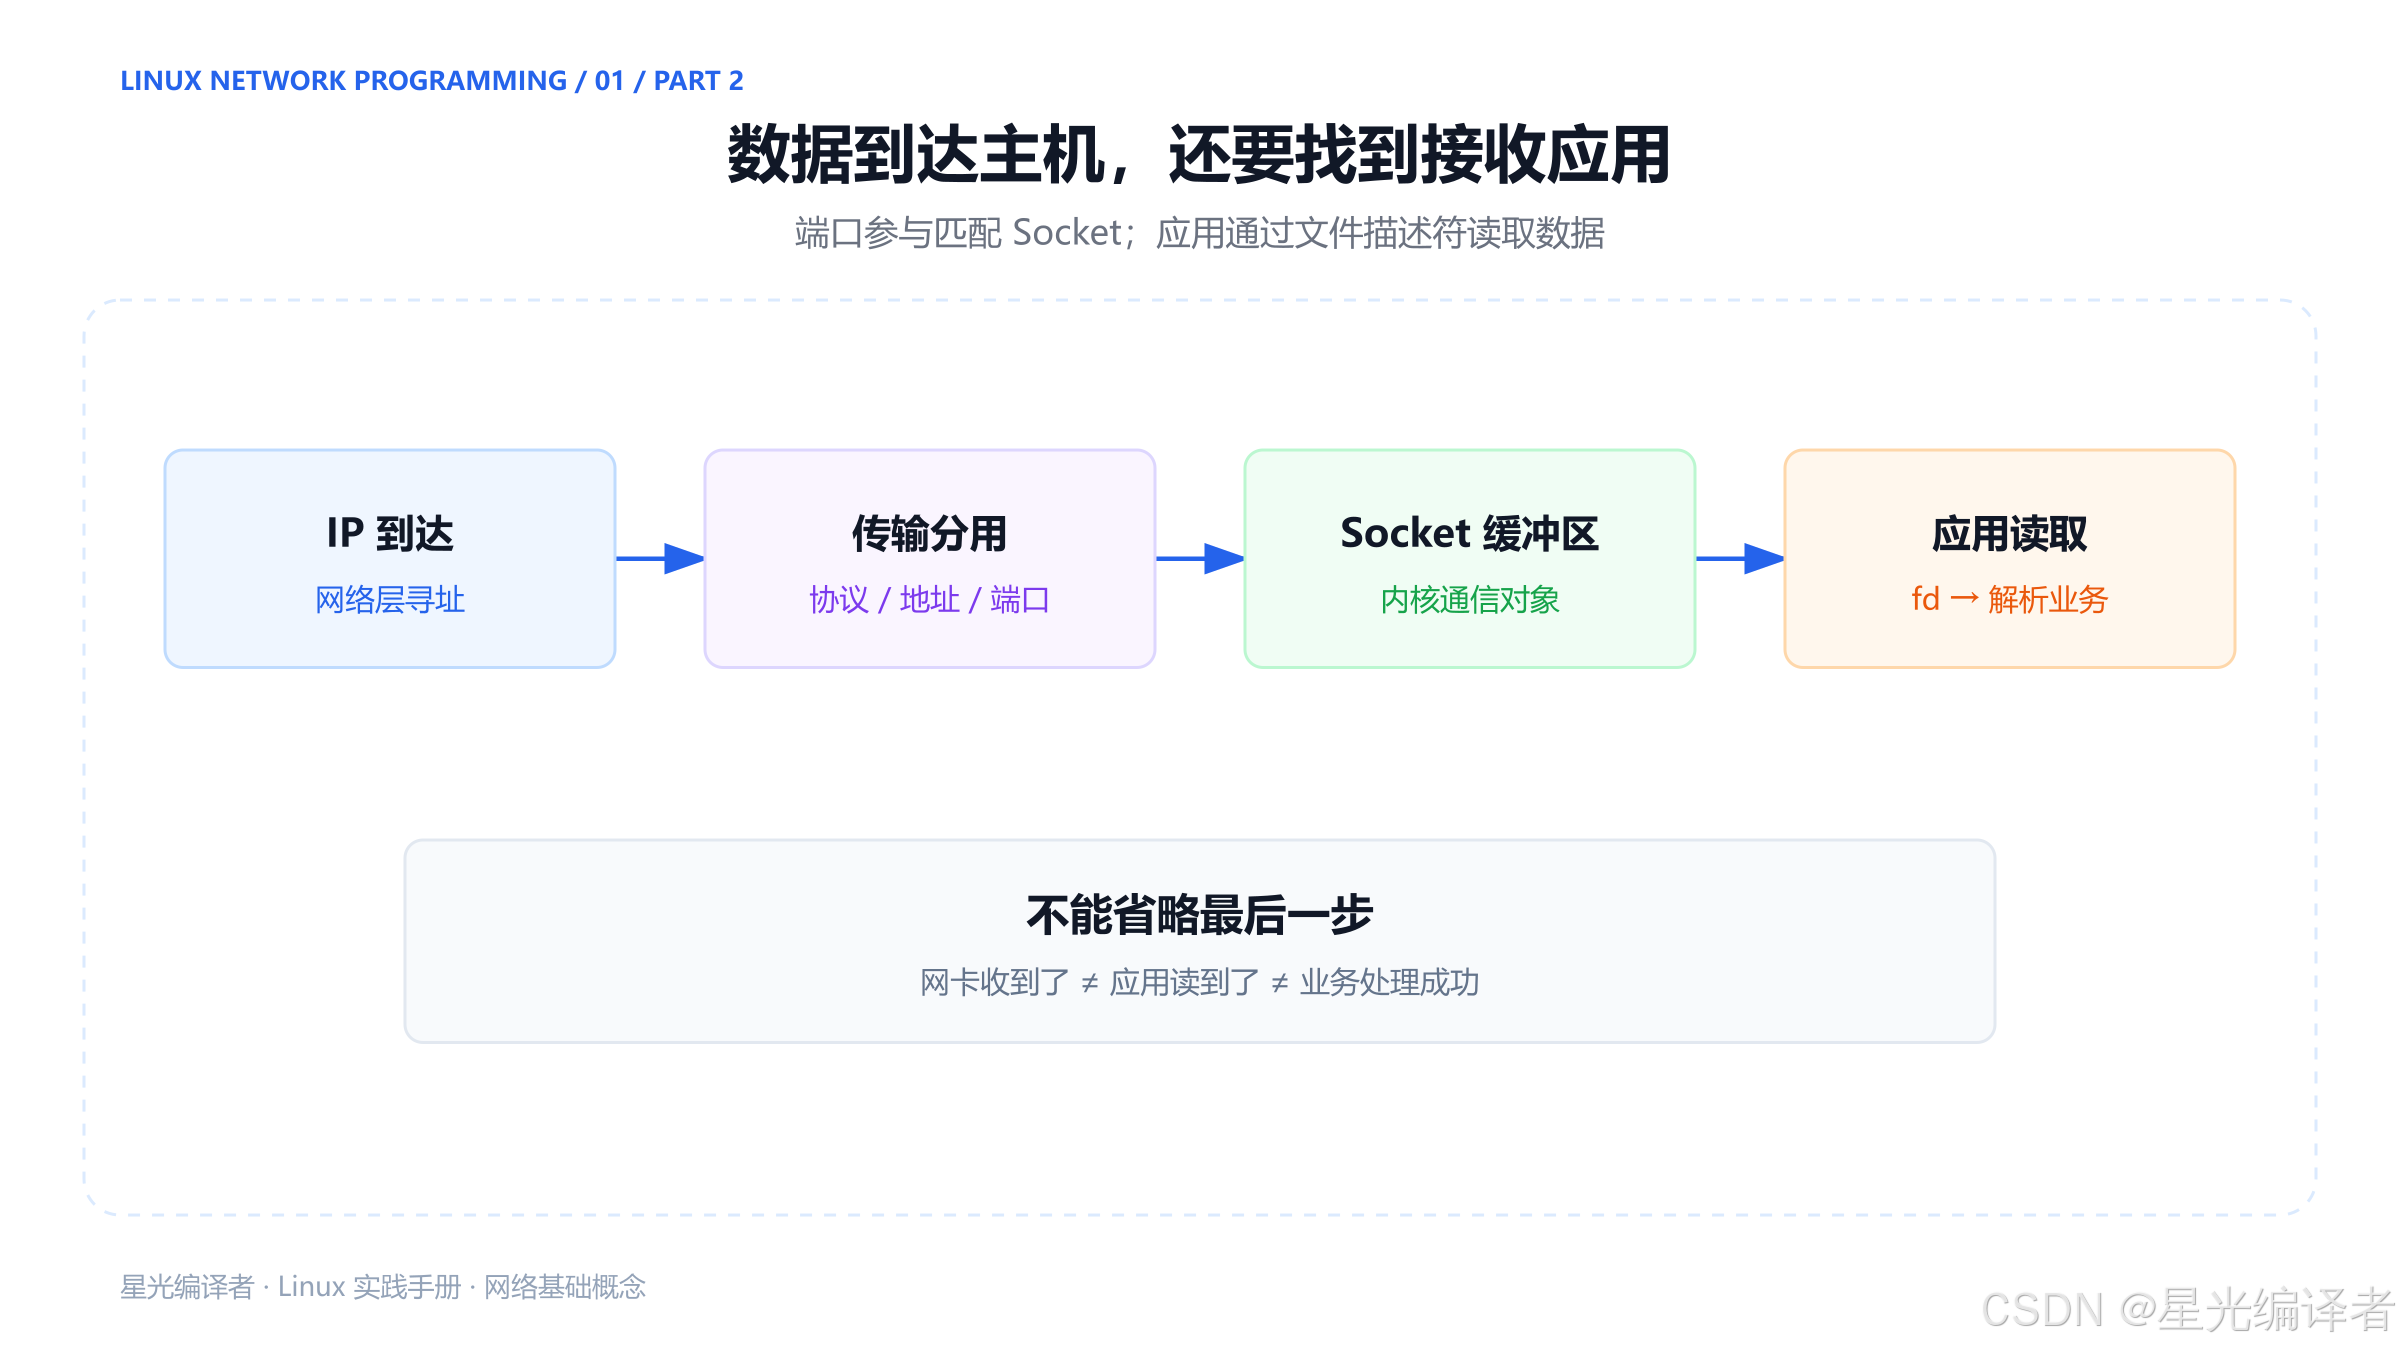
上篇已经说明,IP 包通过路由到达目的主机。但对用户而言,"到了这台电脑"还不足以完成任务。
聊天消息应交给聊天程序,远程登录数据应交给 SSH 服务,网页响应应交给浏览器。主机上可以同时存在很多进程,内核必须把网络数据送到正确的通信对象。
1.1 IP解决网络层寻址,端口参与传输层分用
在常见 IPv4 通信中,IP 地址用于网络层寻址;到达主机之后,TCP/UDP 的端口参与定位通信端点。
于是,一个常见 IPv4 端点可以写成:
text
192.168.10.8:8080但不要立刻把这个写法理解为"某个唯一 PID"。端口是传输协议中的编号,最终由内核将数据匹配到 Socket,再由持有这个 Socket 的应用读取。
1.2 网络通信与进程间通信的联系
用户通常通过运行中的应用交换数据,因此从应用角度看,网络通信是进程间通信的一种重要形式。
不过,协议栈中还存在并不由普通应用直接接收的控制报文。例如 ICMP 错误消息可能先被内核处理。我们接下来讨论的是典型 TCP/UDP 应用通信的路径。
沿着这一条链理解更稳妥:
text
网络到达与协议判断
    → 传输层端点匹配
    → 对应的 Socket 接收缓冲区
    → 应用读取并解释数据
二、IP端口与PID各自标识什么
这几个概念都能回答某种"是谁",但它们处在不同层次,不能互相代替。
2.1 IPv4与IPv6地址
IPv4 地址是 32 位,IPv6 地址是 128 位。IPv4 常见写法是四组十进制数,每组为 0~255:
text
192.168.10.8一个主机可以有多个网络接口和多个 IP 地址。私有地址也可能在不同隔离网络重复使用。因此在编程和排错时,需要把地址放在具体网络、接口和路由上下文中理解。
2.2 端口号是16位编号
TCP 和 UDP 的源端口、目的端口字段都是 16 位,可表示 0~65535。
常用端口分类为:
| 范围 | IANA 分类 | 入门理解 |
|---|---|---|
| 0~1023 | System Ports | 系统/知名端口范围 |
| 1024~49151 | User Ports | 用户/注册端口范围 |
| 49152~65535 | Dynamic / Private Ports | 动态/私有端口范围 |
以上分类来自 IANA 服务名与端口号登记表。这是登记分类,不等于操作系统必定从第三段分配临时端口。Linux 的临时端口范围是可配置的。
例如 HTTP 常用 TCP 80,HTTPS 常用 TCP 443,SSH 常用 TCP 22。服务也可以在其他端口运行;应用协议与某个端口之间是常见约定,而不是永远不能改变的绑定。
在绑定时填写端口 0,通常表示请求系统分配一个可用端口。分配完成后要用 getsockname() 查询实际结果,不能认为服务会一直在"端口 0"上等待通信。
2.3 PID为何不能直接代替端口
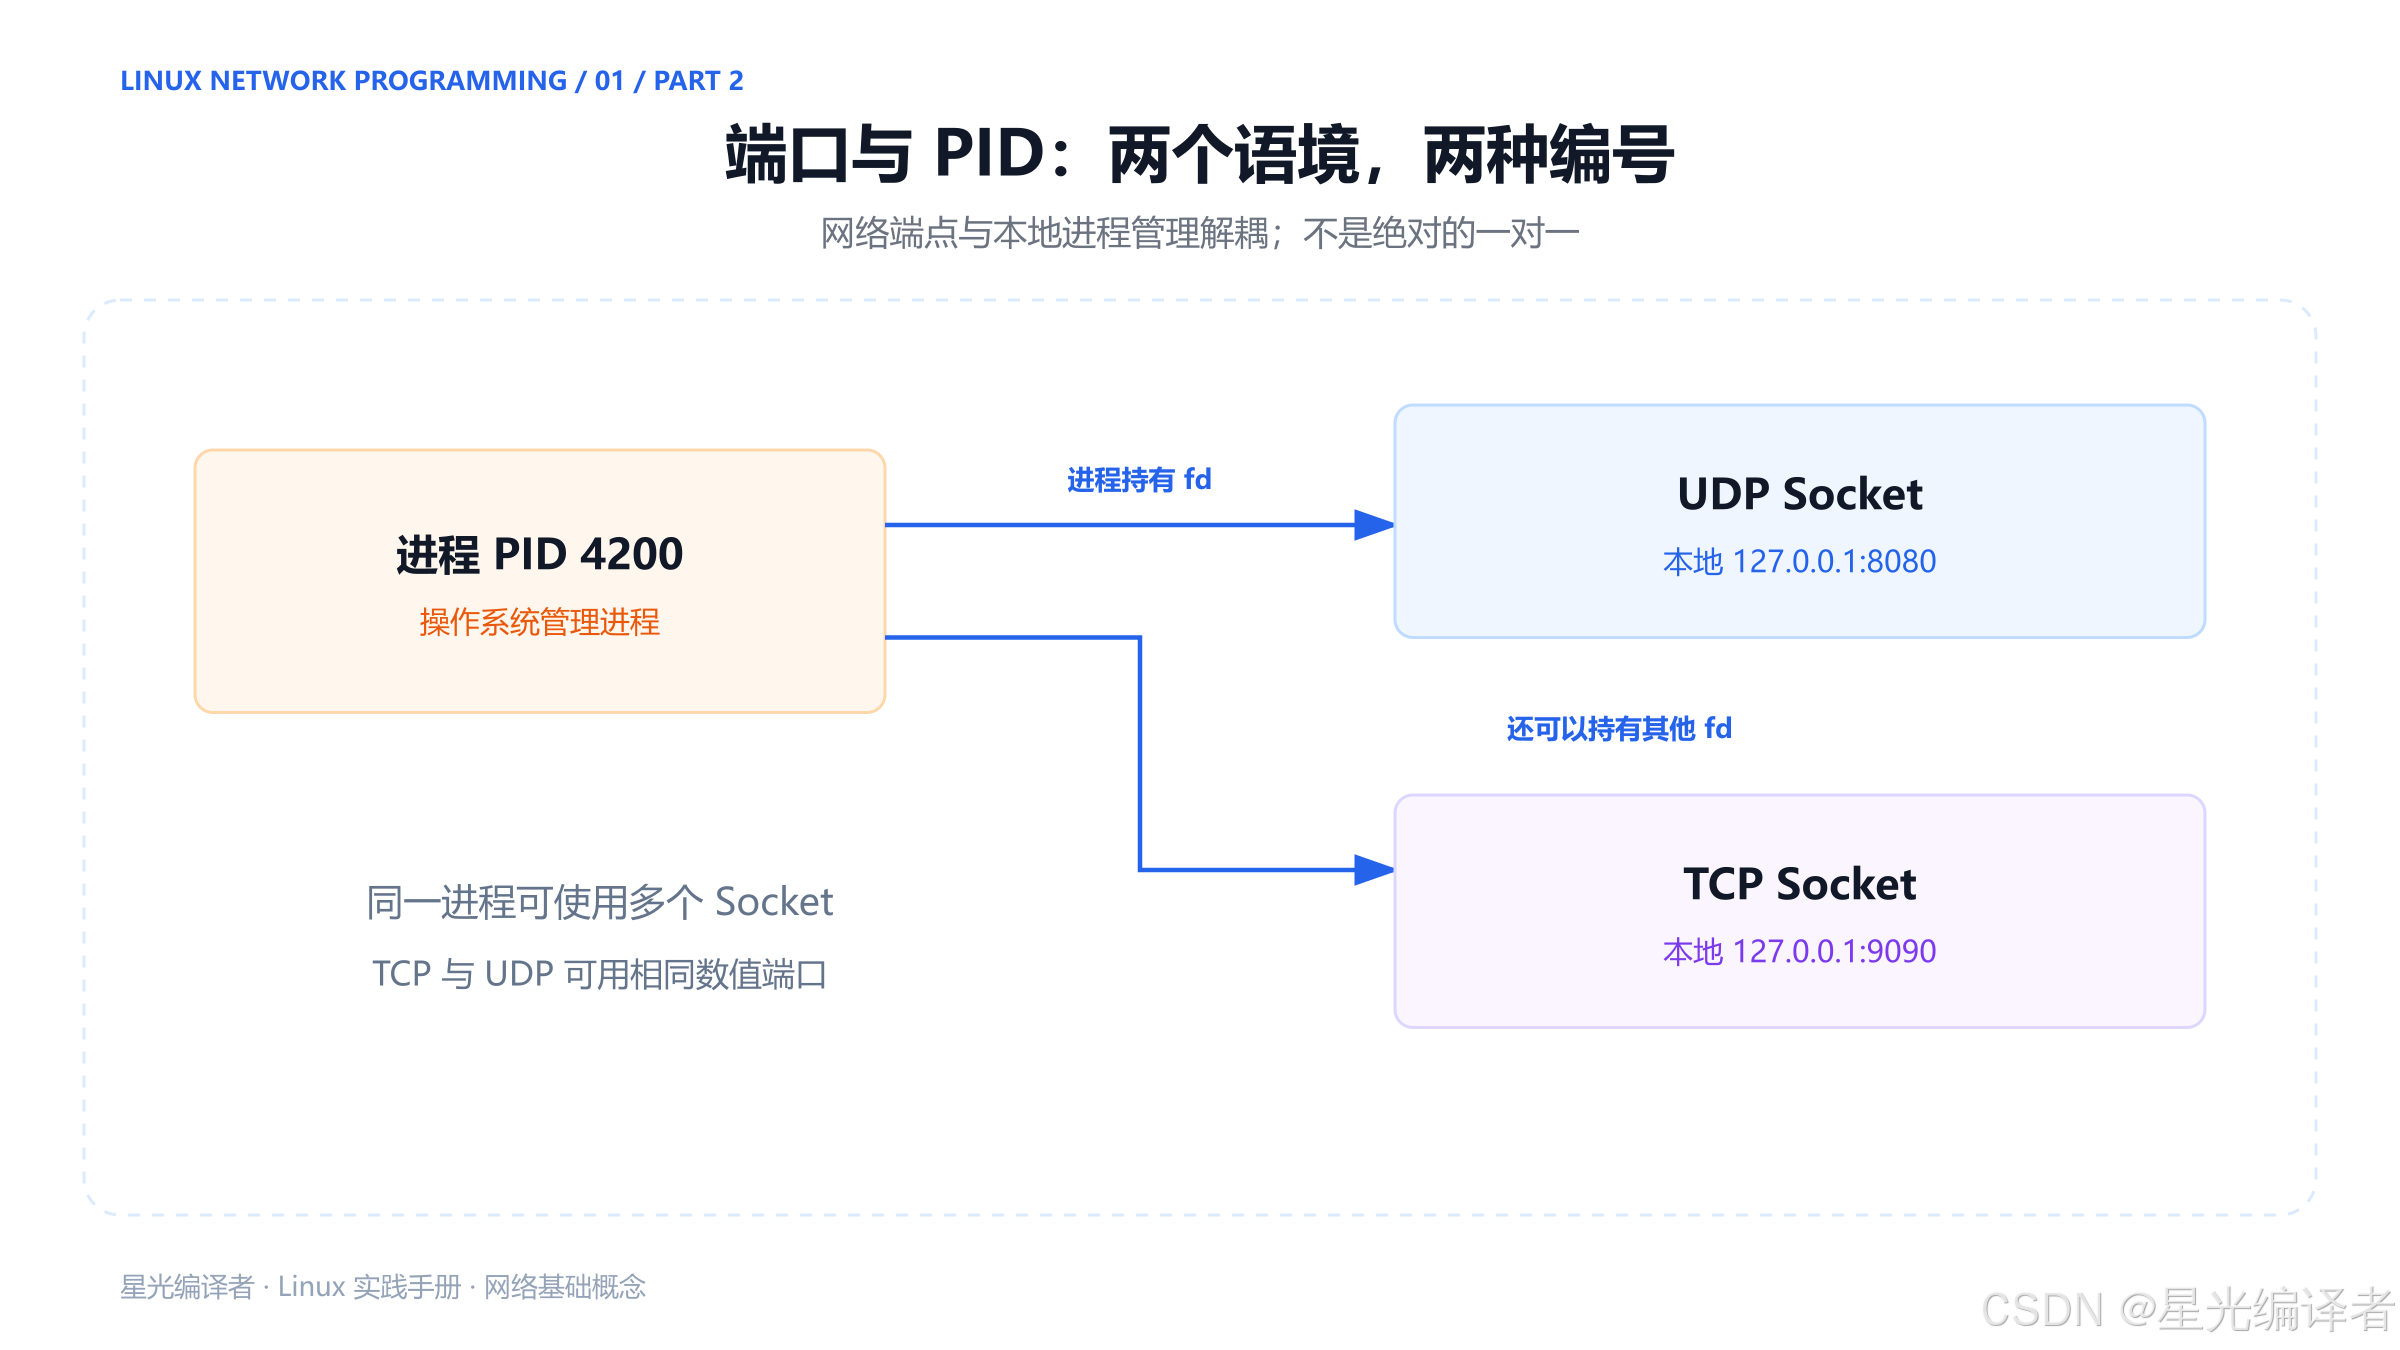
PID 是操作系统管理进程的编号。它用于进程调度、信号、资源管理等本地系统功能。
端口是通信协议和 Socket 寻址的一部分。客户端要知道的是服务端提供哪个通信端点,不必知道服务端进程启动后得到了哪个 PID。
| 概念 | 属于哪个语境 | 典型用途 |
|---|---|---|
| IP 地址 | 网络层寻址 | 决定包到达哪里 |
| 端口号 | TCP/UDP 等传输层 | 参与区分服务与通信端点 |
| PID | 操作系统进程管理 | 找到本地进程 |
| 文件描述符 fd | 进程内的资源引用 | 读写一个已打开的 Socket |
同一个数字可以在不同语境中重复。例如两个不同进程都可能拥有 fd 3,这不意味着它们引用同一个 Socket。
2.4 端口与进程不是绝对的一对一
PDF 用"一个端口对应一个进程"建立直觉,但把它当作严格规则会影响后面的服务器设计。
实际有多种情况:
- 一个进程可以创建多个 Socket,使用多个端口;
- TCP 和 UDP 可以分别使用同一个数值端口;
- 不同本地 IP 上,同一个数值端口的绑定是否冲突,要结合绑定地址判断;
fork()后多个进程可以继承同一个 Socket;- Linux 的
SO_REUSEPORT在满足条件时允许多个 Socket 绑定相同地址。
最后一项可查 socket(7) 的 SO_REUSEPORT 说明。因此,绑定冲突需要结合传输协议、本地地址、网络命名空间和复用规则理解,不能只比较一个端口数字。
初学代码先采用最简单的约定:一个服务器在指定本地地址和端口绑定一个 Socket,先把基本流程写清楚,后续再讨论复用和多进程服务。
三、Socket地址对象与连接四元组
Socket 常译作"套接字"。如果只把它记成 IP + Port,会漏掉代码里非常重要的一层。
3.1 区分Socket地址与Socket对象
Socket 地址 描述端点位置。例如 IPv4 的 sockaddr_in 包含地址族、IP 和端口。
Socket 对象是操作系统管理的通信对象,还包含类型、状态、缓冲区等信息。Linux 程序通过文件描述符引用它。
c
int fd = socket(AF_INET, SOCK_DGRAM, 0);调用成功后返回非负文件描述符,失败时返回 -1 并设置 errno。此时 fd 不是 IP,也不是端口;它是程序操作 Socket 的句柄。
socket() 刚创建对象时,并不表示应用已经明确绑定了一个服务地址。地址准备和 bind() 是后面的动作。
3.2 两个通信端点如何描述
考虑一个 TCP 客户端访问服务器:
text
客户端:192.168.10.8:53000
服务器:192.168.20.9:8080
对客户端发出的方向,可以列出四元组:
text
{源 IP,源端口,目的 IP,目的端口}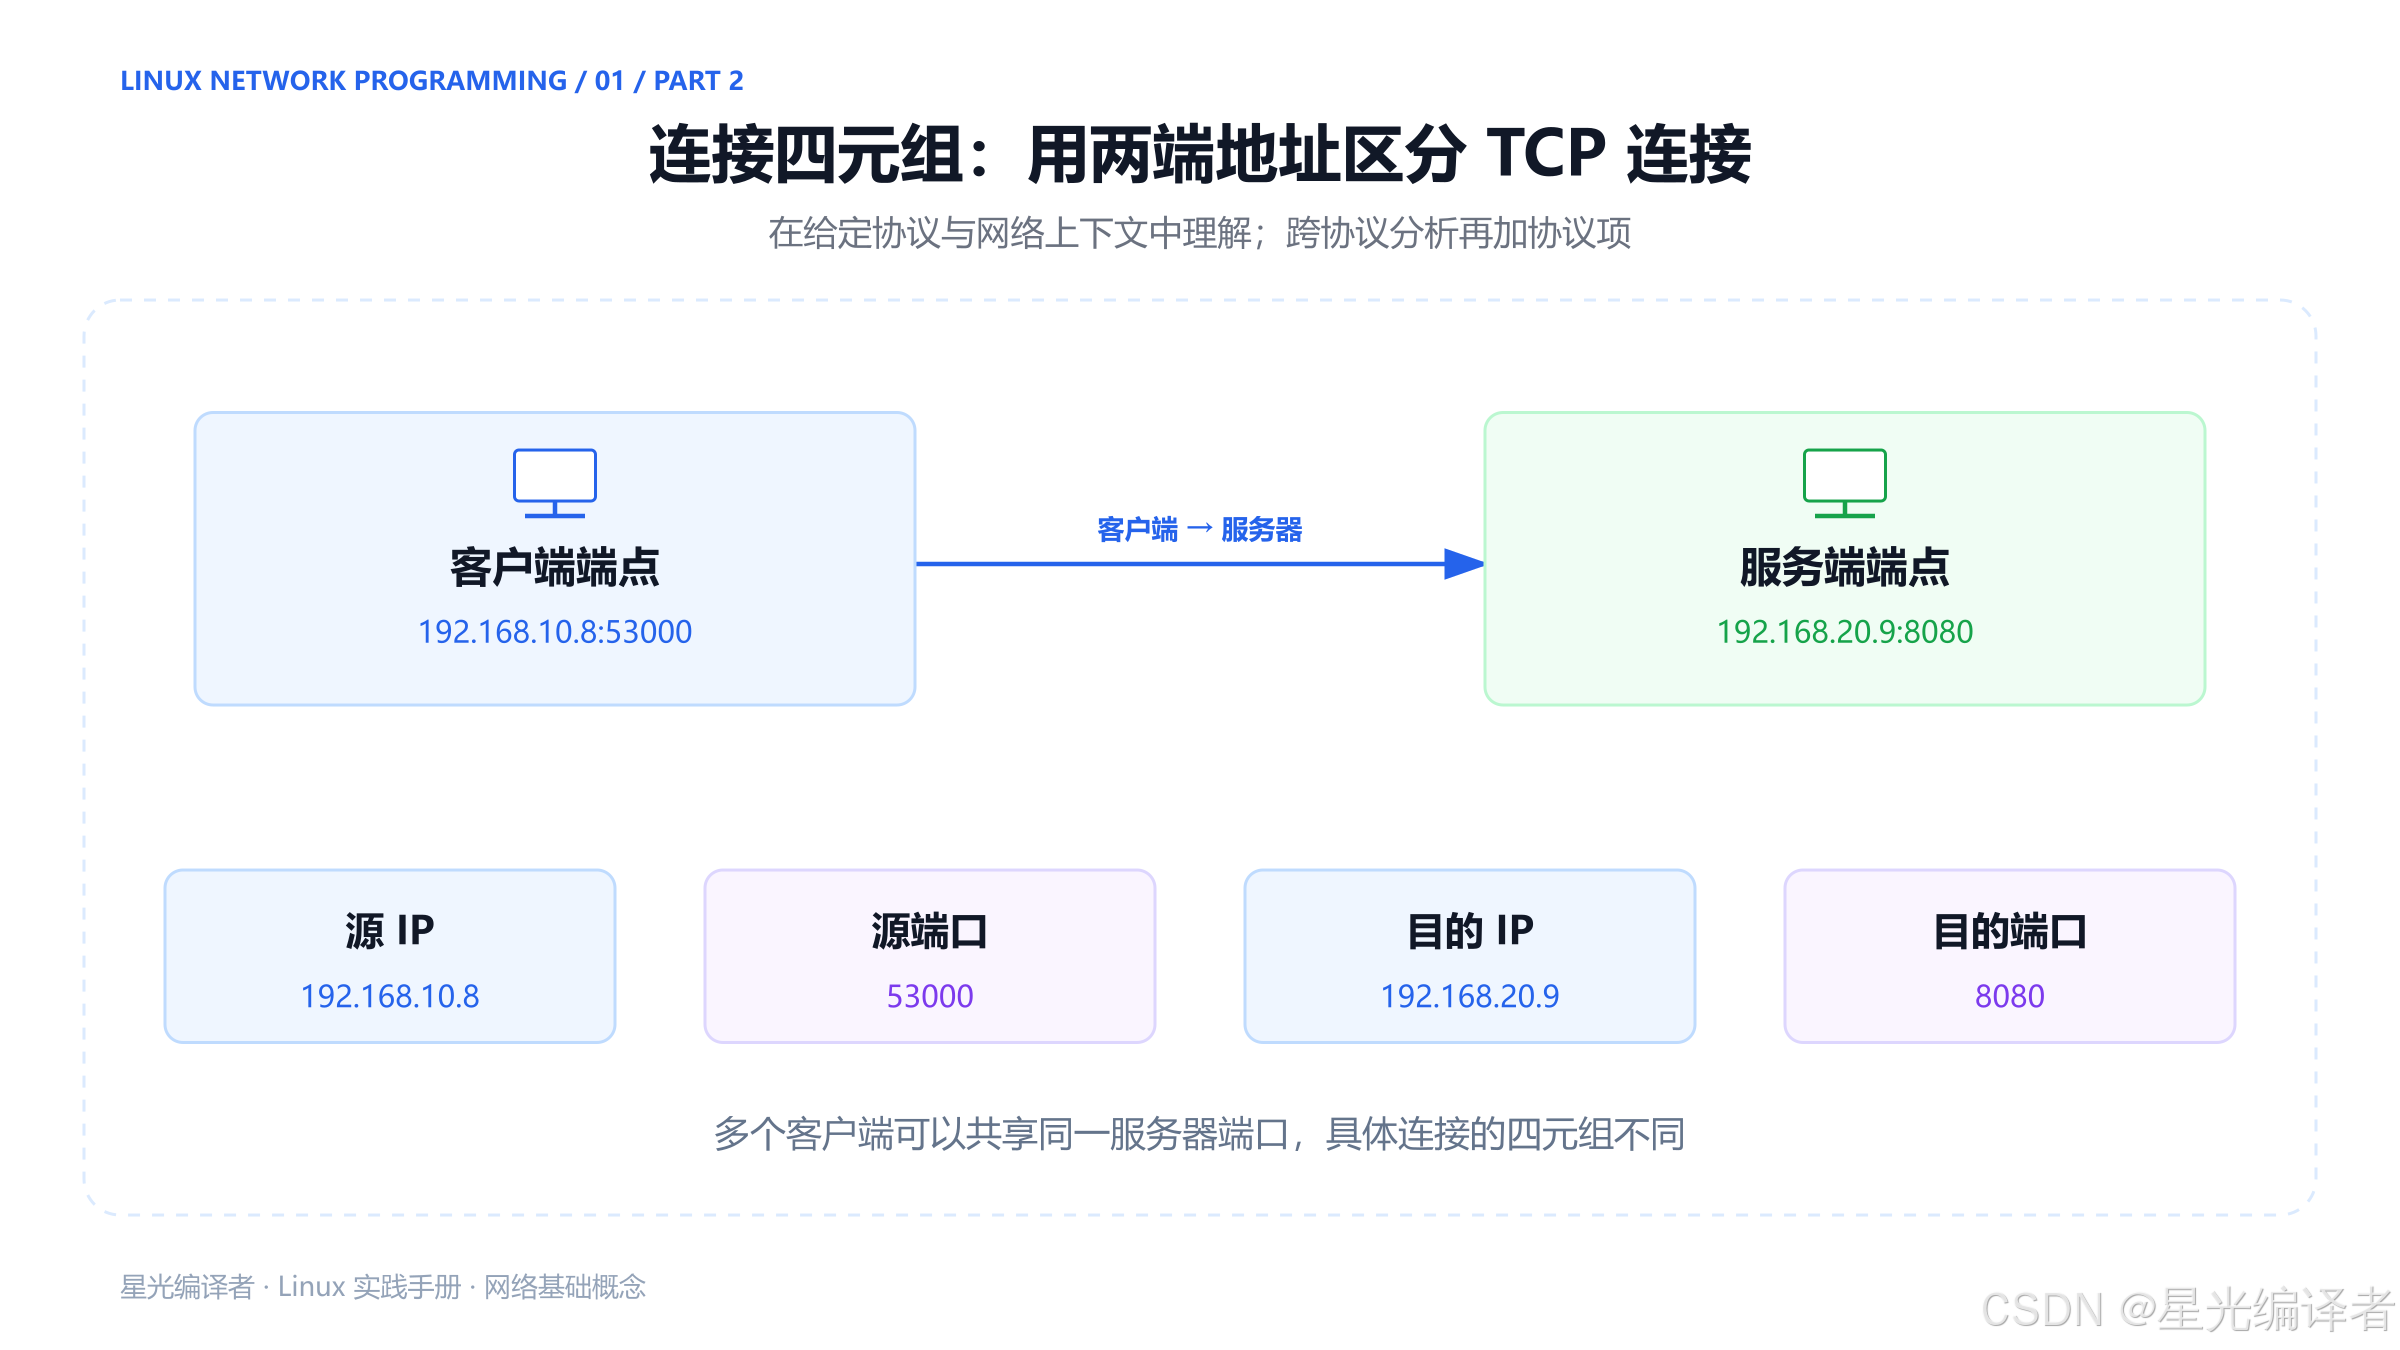
在给定协议和网络上下文中,TCP 连接通常用这四个地址信息区分。若同时讨论 TCP、UDP 等不同协议,则还要加入传输协议,形成常说的五元组。
3.3 服务器为什么能让很多客户端都连接同一个端口
假设服务器监听 192.168.20.9:8080,两个客户端分别从不同端点连接:
text
连接一:192.168.10.8:53000 → 192.168.20.9:8080
连接二:192.168.10.8:53001 → 192.168.20.9:8080
它们的服务器端口相同,但四元组不同。服务器通过监听 Socket 接收连接,再使用 accept() 返回的已连接 Socket 与各个客户端通信。
所以,一个 TCP 服务端口不会只能接待一个客户端。监听端口与一条具体连接的识别方式不能混为一谈。
3.4 Socket不只用于IPv4网络
Socket 接口还支持 IPv6、UNIX domain socket 等地址族。UNIX domain socket 可以用本地路径等信息描述地址,并不以 IPv4 地址和端口作为必需内容。
因此,"IP + Port"适合描述常见 IP 通信端点,不能作为 Socket 的完整定义。这也解释了后面 API 为什么接收通用的 sockaddr *。
四、TCP与UDP的第一张对照表
这部分先建立编程所需的基本认识。连接状态、拥塞控制、重传算法和报头细节,会在后面的专门文章里展开。
| 维度 | TCP | UDP |
|---|---|---|
| 所在层次 | 传输层 | 传输层 |
| 常见 Socket 类型 | SOCK_STREAM |
SOCK_DGRAM |
| 通信模型 | 有连接 | 无连接 |
| 接口交付特点 | 有序字节流 | 数据报 |
| 消息边界 | 不保留应用的发送边界 | 保留数据报边界 |
| 协议自带能力 | 确认、重传、流量与拥塞控制等 | 不提供 TCP 式可靠有序传输 |
4.1 TCP的"可靠"具体意味着什么
TCP 为连接提供可靠、有序的字节流。它通过序号、确认和重传等机制处理网络中常见的丢失和乱序问题。
但不能由此推断"调用 send() 成功,就说明对方业务已经处理完"。成功发送可能只是本地内核接受了这些字节,应用还可能稍后发现断线。
即使对方 TCP 收到了数据,对方应用也可能还没读取,更没有完成数据库写入。若业务要求确认结果,应在应用协议中定义响应或确认消息。
4.2 TCP为什么需要应用层自己划分消息
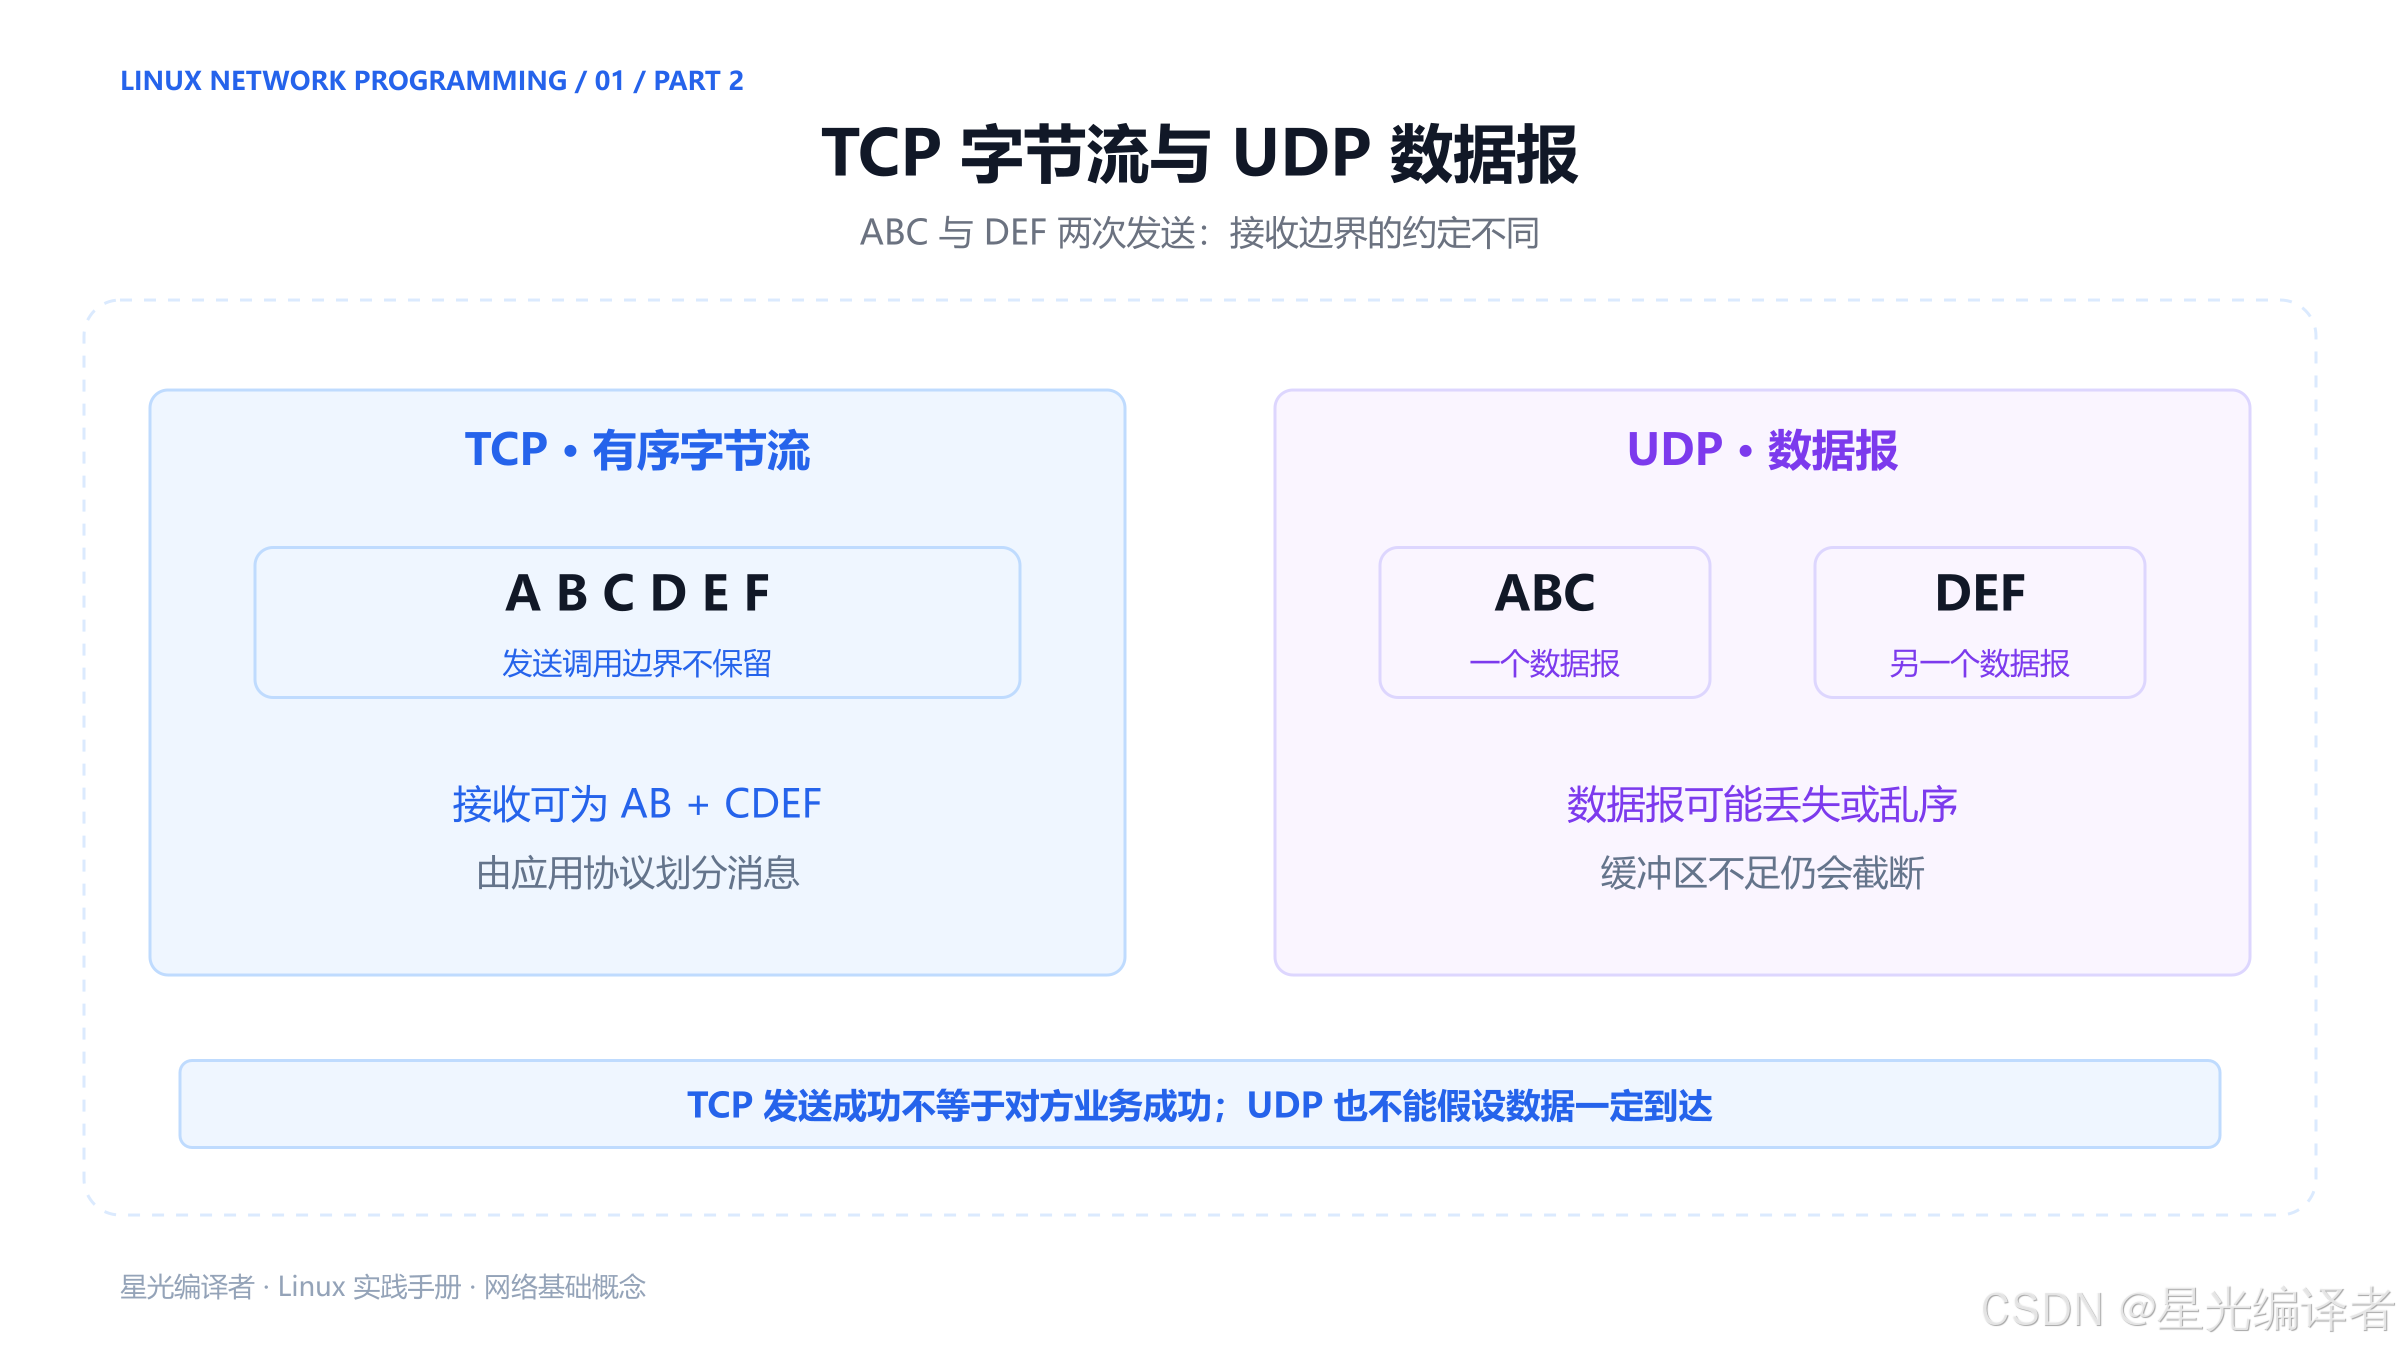
客户端依次发送两段数据:
text
第一次:ABC
第二次:DEF
接收方可能一次读到 ABCDEF,也可能先读到 AB,再读到 CDEF。TCP 保证字节顺序,但不会为应用保留这两次调用的分界线。
因此接收程序要根据应用协议识别消息,例如使用固定长度、长度字段、分隔符等方案。不能把"一次 recv()"直接当成"一条业务消息"。
4.3 UDP的"不可靠"不等于不能用
UDP 本身不保证数据报一定到达,也不保证按发送顺序到达,更不自动为应用补齐丢失的数据报。
但它保留数据报边界,接口简单,应用可以按照需求自行处理超时、序号和重试。选型取决于业务,而不是把"可靠"看作所有场景中的唯一标准。
收到一个数据报时,接收缓冲区仍要足够大。若缓冲区不足,数据报可能被截断,剩余内容不能像 TCP 字节流那样等着下一次继续读取。
4.4 无连接UDP为什么也能调用connect
对 UDP Socket 调用 connect(),通常是设置默认对端,并限制接收来源等,并不建立 TCP 那样的握手连接。
所以,不能仅根据源码出现 connect(),就判断应用一定用了 TCP。应结合地址族、Socket 类型和协议一起看。
五、网络字节序究竟在转换什么
现在考虑一个更直接的问题:同一个整数,在不同计算机内存里可能采用不同的字节排列,怎么保证对方解释一致?
5.1 先把数值与字节排列分开
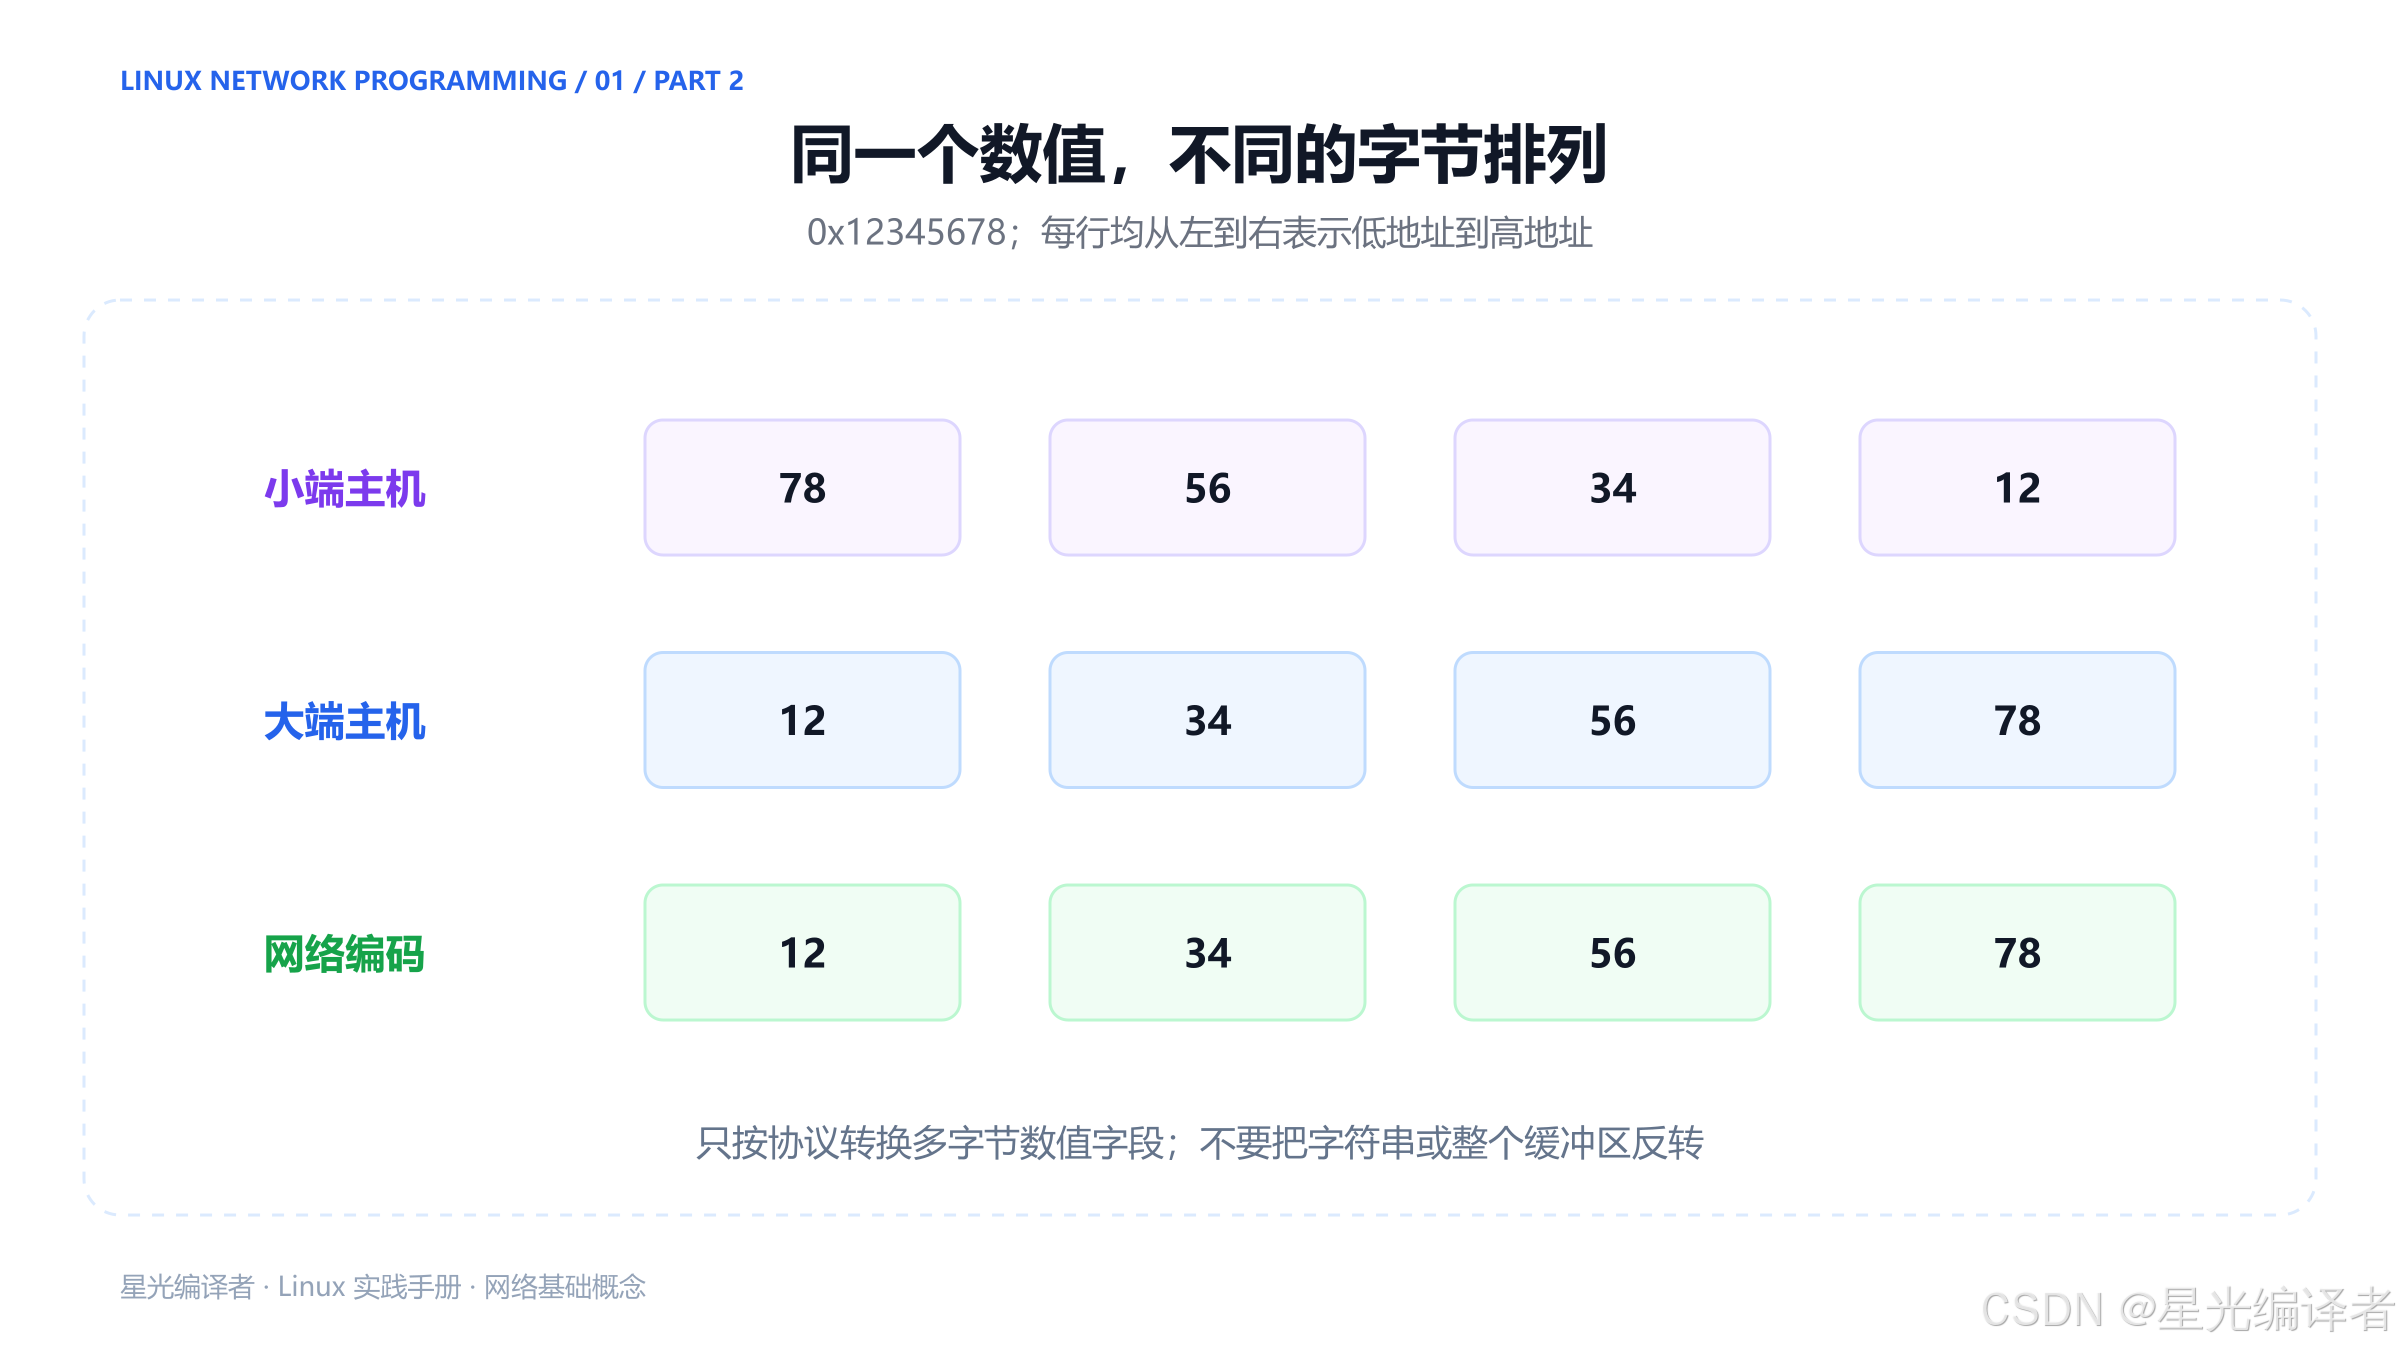
整数 0x12345678 的数值是确定的,但它在内存中由四个字节表示时,排列可能不同:
| 内存地址从低到高 | 第 1 字节 | 第 2 字节 | 第 3 字节 | 第 4 字节 |
|---|---|---|---|---|
| 大端序 | 12 |
34 |
56 |
78 |
| 小端序 | 78 |
56 |
34 |
12 |
这里所有字节值均为十六进制。大端是高有效字节放在低地址,小端则是低有效字节放在低地址。
5.2 线上的关键事实是字节先后顺序
网络并不传递发送方的内存地址,它传递的是按顺序排列的字节。接收方必须知道如何把这些字节还原成字段。
常见 TCP/IP 协议的多字节整数采用网络字节序,即大端序。若字段表示 0x12345678,按这个约定编码后就是:
text
12 34 56 78本地内存是大端还是小端,不应该成为对端理解协议的前提。双方都先按规范编码,再按规范解码。
5.3 不是所有网络数据都要"转成大端"
PDF 的"所有发送到网络上的数据都必须大端"需要加上范围:字节序主要涉及协议规定的多字节数值字段。
如果发送 ASCII 文本 hello,每个字符已经是一个字节,原有顺序就是文本内容。不能因为网络字节序是大端,就把整个字符串倒过来。
类似地:
- UTF-8 文本要遵守 UTF-8 编码规则;
- 图片、音频等要遵守对应文件或业务格式;
- 自定义二进制协议要明确规定各个数值字段的表示;
- 某些应用协议可以约定小端整数,但双方必须遵守同一格式。
字节序转换不是把整个缓冲区翻转,而是按字段完成表示转换。
5.4 操作系统会不会自动转换业务正文
TCP/UDP 协议栈会生成它们自己的标准首部,但不会替应用理解并转换每个自定义整数。
例如你把一个本地 uint32_t 的内存直接传给发送函数,Socket 并不知道这四个字节表示"人数""价格"还是普通二进制内容。它把这些字节当作业务载荷处理。
因此,应用层协议中的整数要由应用主动编码。sin_port 等 Socket 地址字段则按 API 要求填写网络字节序。
六、四个转换函数与字节观察实验
Linux 可以使用 <arpa/inet.h> 提供的转换函数:
c
#include <arpa/inet.h>

uint16_t htons(uint16_t hostshort);
uint32_t htonl(uint32_t hostlong);
uint16_t ntohs(uint16_t netshort);
uint32_t ntohl(uint32_t netlong);
6.1 函数名怎样记
| 函数 | 方向 | 字段宽度 |
|---|---|---|
htons |
host → network | 16 位 |
htonl |
host → network | 32 位 |
ntohs |
network → host | 16 位 |
ntohl |
network → host | 32 位 |
h 是 host,n 是 network,to 表示方向,s 与 l 对应这些 API 的历史命名。
要特别注意:这里 l 对应的是 32 位,不是"当前平台 sizeof(long) 有多少位就转换多少位"。Linux LP64 环境下,C 的 long 可以是 64 位,这些函数的参数和返回类型仍然如原型所示。参见 byteorder(3)。
6.2 通常不要自己判断机器大小端后再决定是否调用
下面这种写法更合适:
c
uint16_t port = 8080;
uint16_t network_port = htons(port);
uint16_t restored_port = ntohs(network_port);
在大端主机上,转换可能保持字节不变;在小端主机上,转换会调整字节排列。调用者不需要为每种机器写分支。
转换函数不会改变原变量,它们返回转换结果。只调用 htons(port); 而不使用返回值,port 本身不会因此变为网络序。
6.3 用unsigned char观察字节
下面的完整程序保存为 code/byte_order_demo.c:
c
#include <arpa/inet.h>
#include <inttypes.h>
#include <stdint.h>
#include <stdio.h>
#include <string.h>

static void print_bytes(const char *label, const void *data, size_t len)
{
    const unsigned char *bytes = data;
    printf("%-12s", label);
    for (size_t i = 0; i < len; ++i)
        printf(" %02X", (unsigned int)bytes[i]);
    putchar('\n');
}

int main(void)
{
    const uint32_t host_value = UINT32_C(0x12345678);
    const uint32_t network_value = htonl(host_value);
    unsigned char wire[sizeof network_value];

    memcpy(wire, &network_value, sizeof wire);
    print_bytes("host bytes:", &host_value, sizeof host_value);
    print_bytes("wire bytes:", wire, sizeof wire);

    uint32_t received_value;
    memcpy(&received_value, wire, sizeof received_value);
    printf("decoded: 0x%08" PRIX32 "\n", ntohl(received_value));
    return 0;
}
Linux 编译和运行方式:
bash
gcc -std=c11 -Wall -Wextra -Wpedantic byte_order_demo.c -o byte_order_demo
./byte_order_demo
在常见小端 Linux 主机上,预期输出为:
text
host bytes:  78 56 34 12
wire bytes:  12 34 56 78
decoded: 0x12345678
在大端主机上,第一行也会是 12 34 56 78。无论主机字节序如何,后两行应符合上述网络格式和还原结果。
6.4 为什么使用memcpy,而不是强转缓冲区
不要为了方便就这样读取:
c
/* 不建议这样解析任意字节缓冲区 */
uint32_t value = *(const uint32_t *)buffer;
buffer 的位置可能未按 uint32_t 对齐,这种访问也可能违反类型别名规则。先用 memcpy() 复制到正确类型的局部变量,再做字节序转换,是更稳妥的做法。
应用协议还需要先检查缓冲区是否有足够的字节。安全的表示转换不能替代边界检查。
6.5 8080为什么在线上表示为1F 90
十进制 8080 等于十六进制 0x1F90。使用 htons(8080) 后,观察这两个字节应得到:
text
1F 90在小端机器上,如果把转换后的结果当作本地整数打印,可能看到一个"交换后"的数值。理解转换应观察内存中的字节排列,而不是期待转换前后用 %u 打印的数字始终相同。
七、sockaddr与sockaddr_in
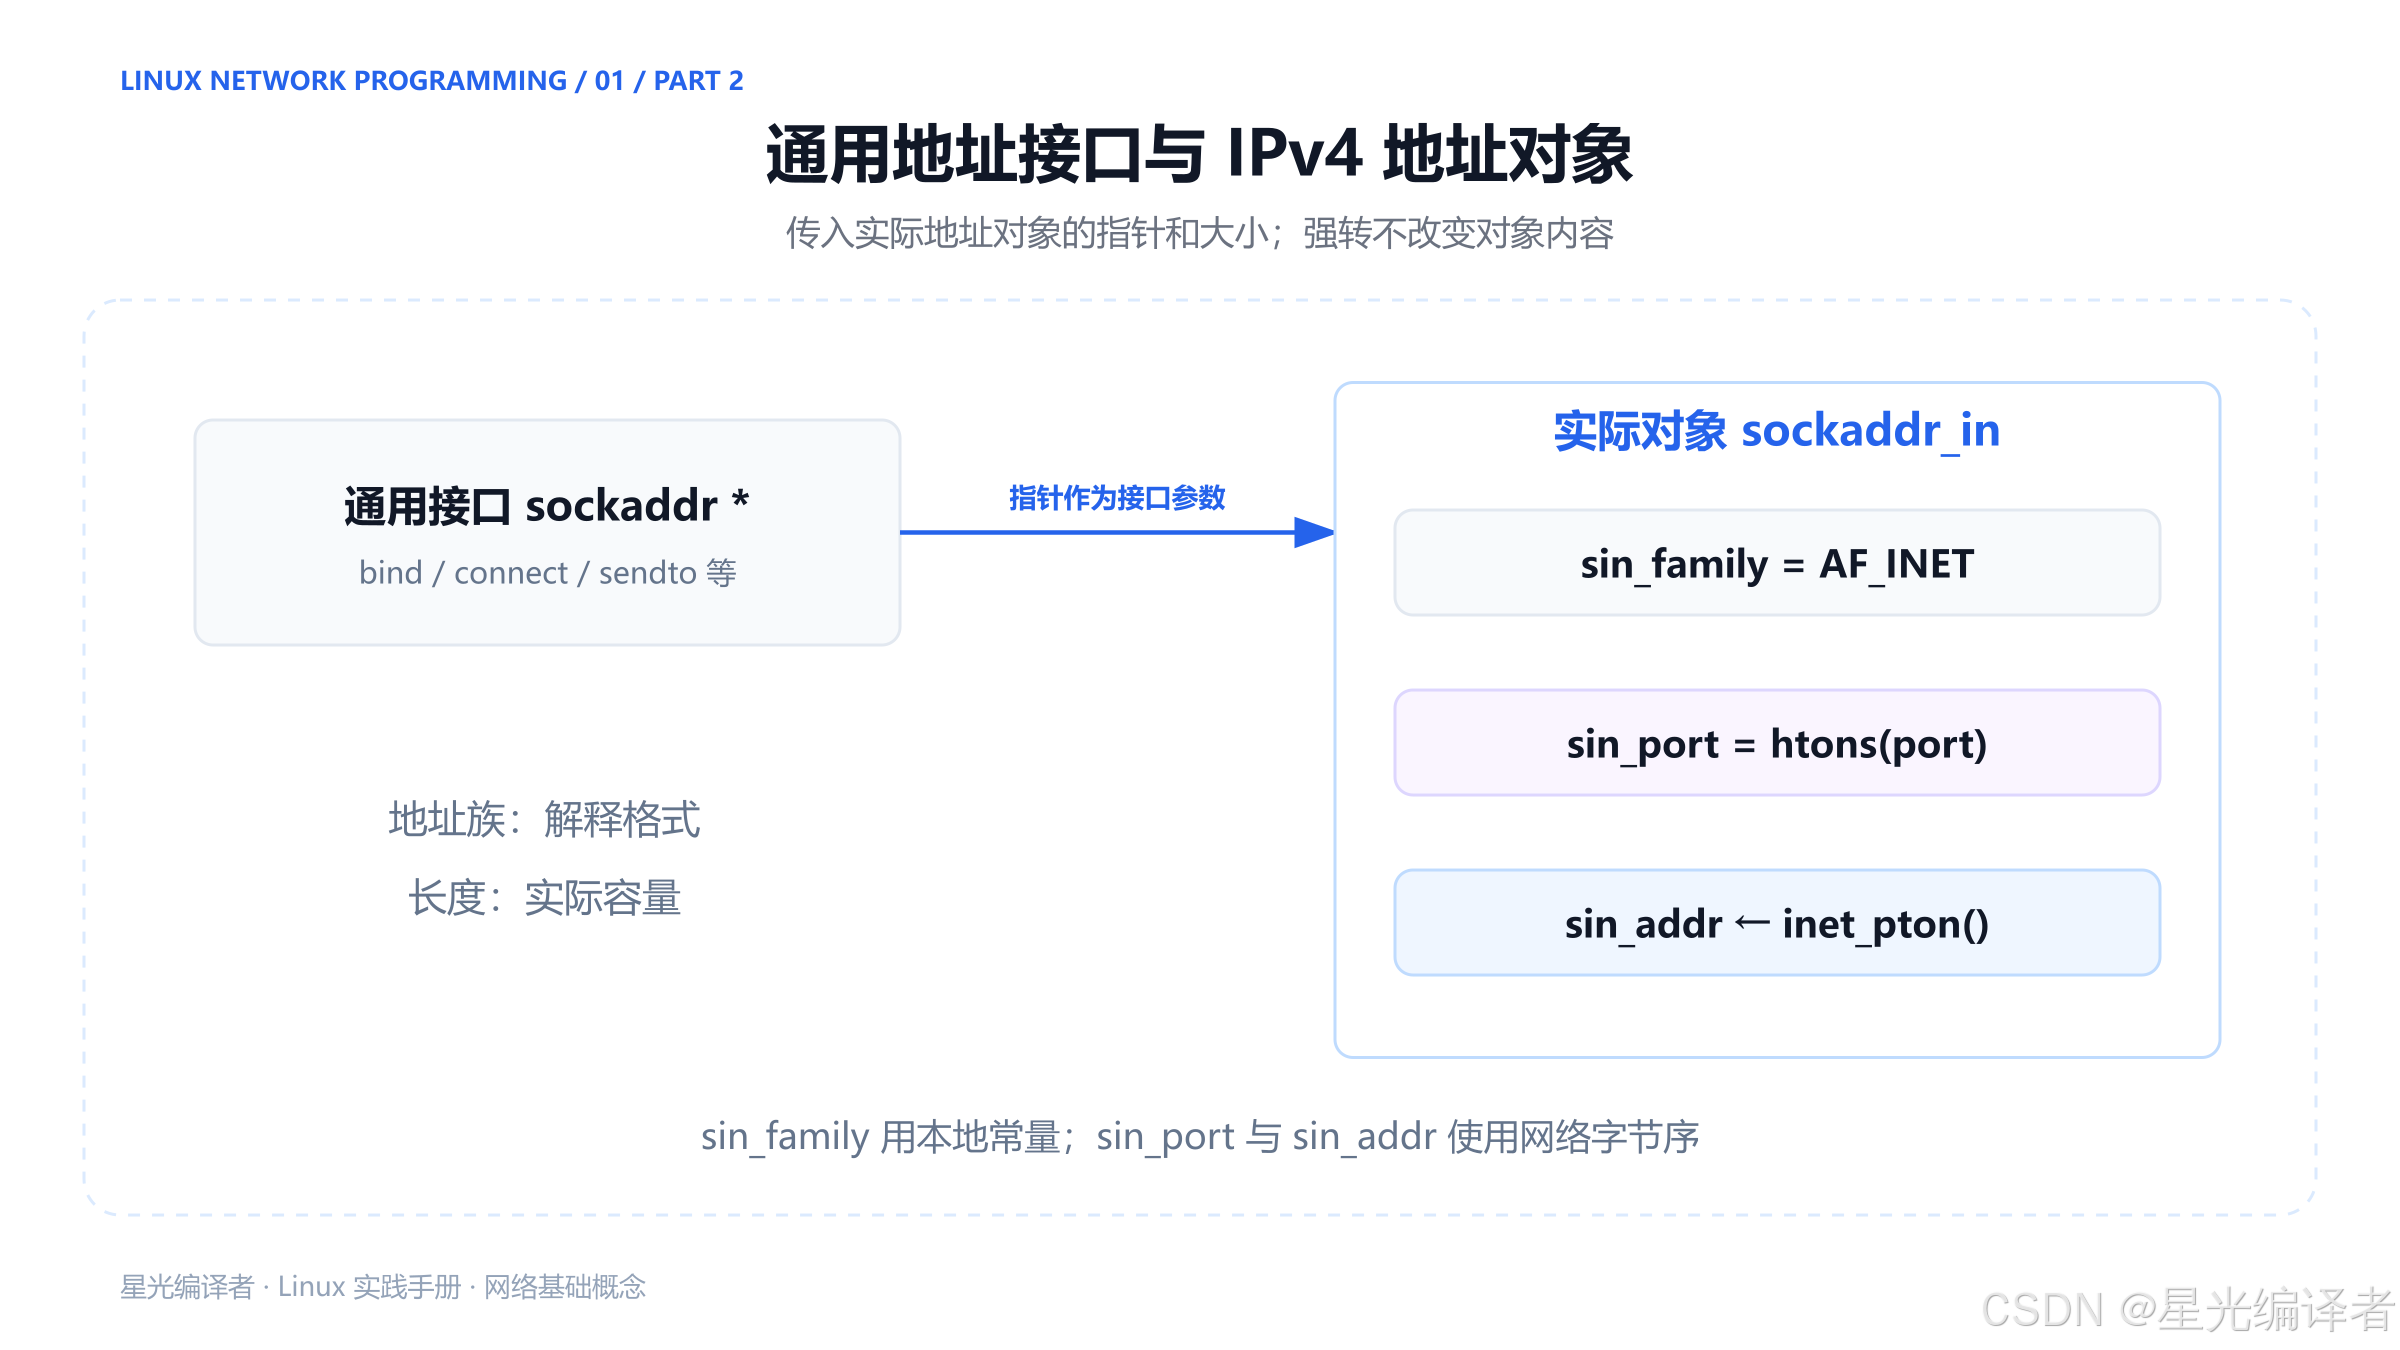
Socket 接口需要支持不同地址族,因此不能要求所有地址都长成"IPv4 + 端口"。
7.1 sockaddr是API使用的通用地址类型
例如 bind() 的接口是:
c
int bind(int sockfd, const struct sockaddr *addr, socklen_t addrlen);它可以用于不同地址族。地址族字段让系统知道传入地址如何解释,长度参数说明实际对象大小。
使用 IPv4 时,我们构造 struct sockaddr_in;使用 IPv6 时构造 struct sockaddr_in6。不要把 IPv4 地址的文本字符串直接写进通用结构的 sa_data。
7.2 sockaddr_in主要有哪些字段
关键字段可概括为:
c
struct sockaddr_in
{
    sa_family_t    sin_family; /* AF_INET */
    in_port_t      sin_port;   /* 16 位端口,网络字节序 */
    struct in_addr sin_addr;   /* IPv4 地址,网络字节序 */
    /* 实现还可能包含填充等成员,以系统头文件为准 */
};

struct in_addr
{
    in_addr_t s_addr;          /* 32 位 IPv4 地址 */
};
这是用来说明成员含义的结构摘录,不要在自己的程序里重新定义系统结构。真实定义来自 <netinet/in.h>。
Linux 常见布局包括填充成员,但写程序不应依赖"地址类型一定占两字节,整个结构一定是我背下来的大小"。正确方式是用系统头文件和 sizeof。
7.3 这三个字段的填写规则不同
| 字段 | 设置方法 | 字节序要求 |
|---|---|---|
sin_family |
AF_INET |
本地 API 的地址族标记,不用 htons() |
sin_port |
htons(port) |
网络字节序 |
sin_addr |
inet_pton() 或适当的数值转换 |
网络字节序 |
sin_port 与 sin_addr 的要求可查 sockaddr_in(3type)。不能看到"网络地址结构",就把其中每个字段都做一次 hton*()。
7.4 为什么调用时要转换成sockaddr指针
c
struct sockaddr_in local;
/* 初始化 local */

if (bind(fd, (const struct sockaddr *)&local, sizeof local) == -1)
{
    perror("bind");
}强转改变的是传给通用接口的指针类型,不会把整个对象改造成另一个结构,也不会自动转换字节序。
sizeof local 仍是实际 IPv4 地址对象的大小。地址族、对象内容和长度必须彼此匹配。
八、正确初始化一个IPv4地址
先把一个地址对象准备正确,再调用通信接口,可以避免不少一运行就报错的问题。
8.1 先初始化对象,再分别设置字段
c
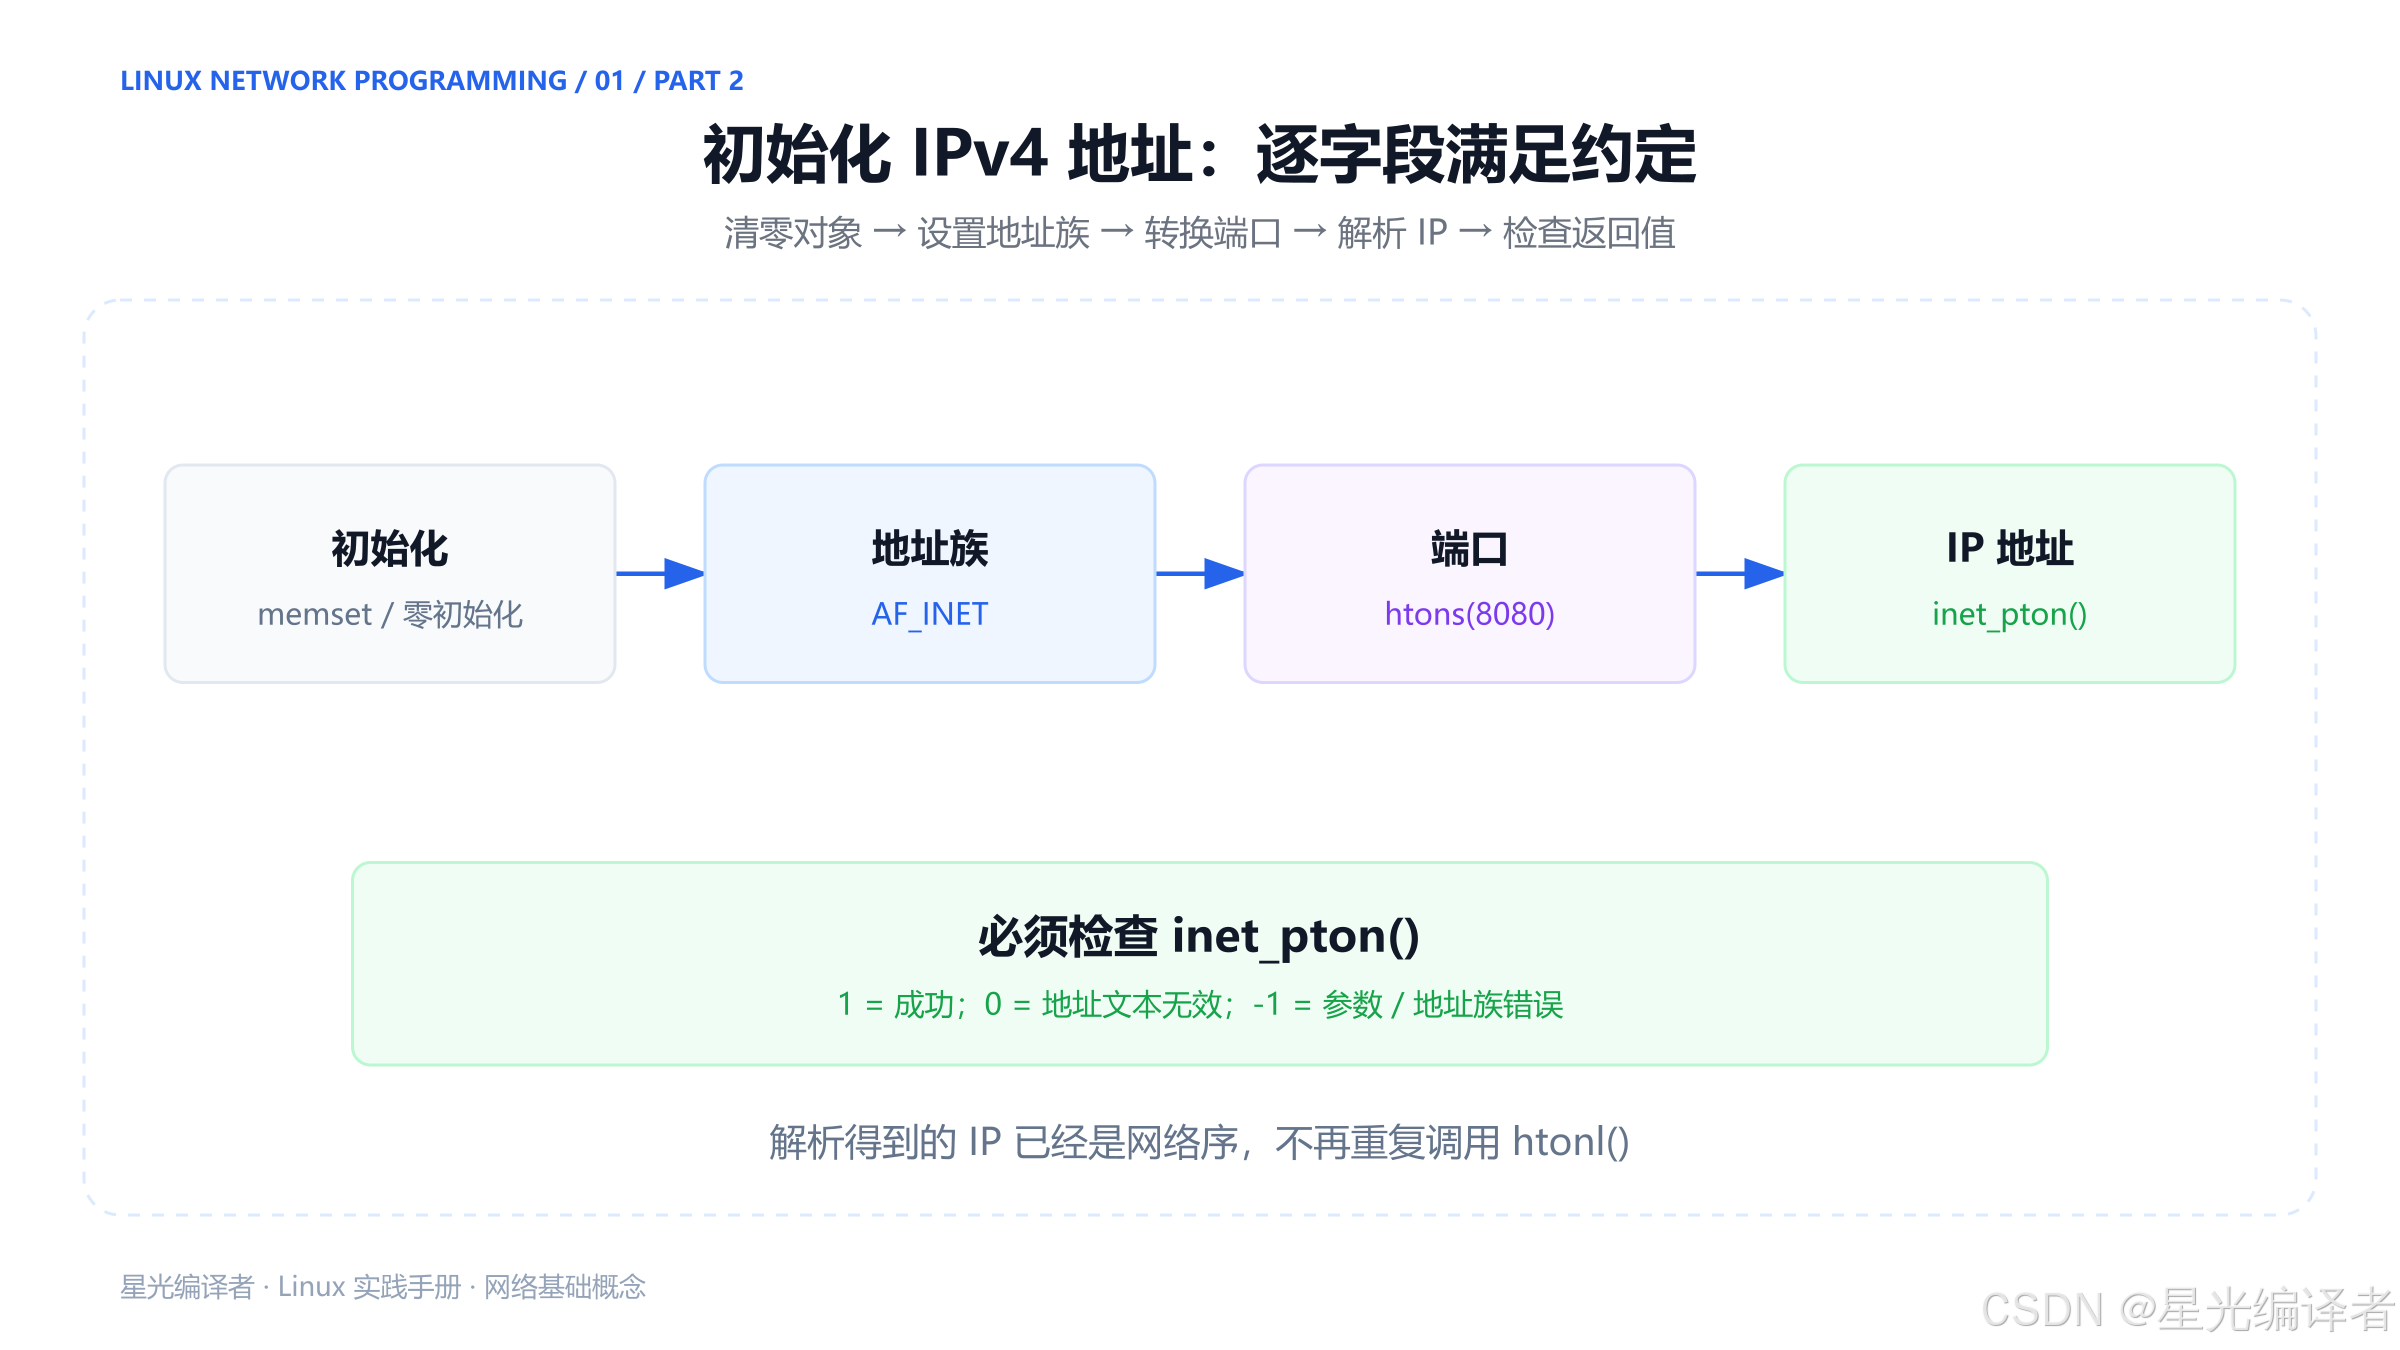
struct sockaddr_in peer;
memset(&peer, 0, sizeof peer);

peer.sin_family = AF_INET;
peer.sin_port = htons(8080);

int rc = inet_pton(AF_INET, "192.168.20.9", &peer.sin_addr);
if (rc != 1)
{
    /* rc == 0:地址文本无效;rc == -1:地址族等参数错误 */
}
这里清零是常见的初始化写法,避免对象中留下未明确设置的内容。然后每个字段按其规则填写。
8.2 inet_pton解决文本与二进制地址转换
"192.168.20.9" 是给人阅读的字符串,而 sin_addr 保存二进制 IPv4 地址。
inet_pton() 将地址文本解析到目标对象,返回:
1:成功;0:文本不符合地址格式;-1:参数中的地址族等不被支持,并设置errno。
成功时,它写出的地址已经是网络字节序,不要接着再对 sin_addr.s_addr 调用 htonl()。这点在 inet_pton(3)中有明确说明。
rc == 0 时,不应直接用 perror() 当作地址格式错误说明,因为它并不代表此次调用设置了相应 errno。应自己输出"无效地址文本"。
8.3 接收展示地址时,做相反方向的转换
c
char text[INET_ADDRSTRLEN];
if (inet_ntop(AF_INET, &peer.sin_addr, text, sizeof text) == NULL)
{
    perror("inet_ntop");
}
else
{
    printf("%s:%u\n", text, (unsigned int)ntohs(peer.sin_port));
}
IP 用 inet_ntop() 从二进制转成可阅读文本;端口用 ntohs() 还原为本地主机数值后再打印。
不要试图用 ntohl() 代替 IP 文本格式化,它只返回整数,并不生成点分十进制字符串。
8.4 两个常见特殊地址
**127.0.0.1**是常用 IPv4 回环地址,可让本机程序通过协议栈进行通信。只绑定回环地址的服务,通常不会通过外部网络接口被访问到。
**0.0.0.0**在本地绑定中常表示 INADDR_ANY,即不限定某个具体本地 IPv4 接口地址。它不是让客户端拿去连接的远程服务器地址。
绑定任意本地地址常写成:
c
local.sin_addr.s_addr = htonl(INADDR_ANY);INADDR_ANY 的值为零,转换后还是零,但统一的数值初始化写法有利于理解。若使用 inet_pton() 解析文本地址,则遵守"已经是网络序,不重复转换"的规则。
绑定地址应属于本机,或者是该 API 支持的通配地址。把远方服务器的 IP 交给本机 bind(),并不会让本机成为那台服务器。
九、Socket接口的职责与调用顺序
PDF 列出了 socket()、bind()、listen()、accept()、connect()。现在把它们放回具体流程。
9.1 先记职责,不急着背完整程序
| 接口 | 主要用途 | 初学者要注意 |
|---|---|---|
socket() |
创建通信对象 | 成功返回 fd,失败返回 -1 |
bind() |
关联本地地址 | 参数是本地地址 |
listen() |
让流式 Socket 等待连接 | 常用于 TCP 服务端 |
accept() |
取出已建立连接 | 返回新的已连接 fd |
connect() |
设置/连接对端 | TCP 建立连接,UDP 语义不同 |
send() / recv() |
已指定对端的收发 | TCP 可能只处理部分字节 |
sendto() / recvfrom() |
带地址的数据报收发 | 常用于 UDP |
close() |
关闭文件描述符 | 不再需要时释放本地引用 |
返回值有不同意义。例如 accept() 返回文件描述符,接收函数返回字节数,不能统一认为"非零都是成功"。后续每个接口都要按其定义处理。
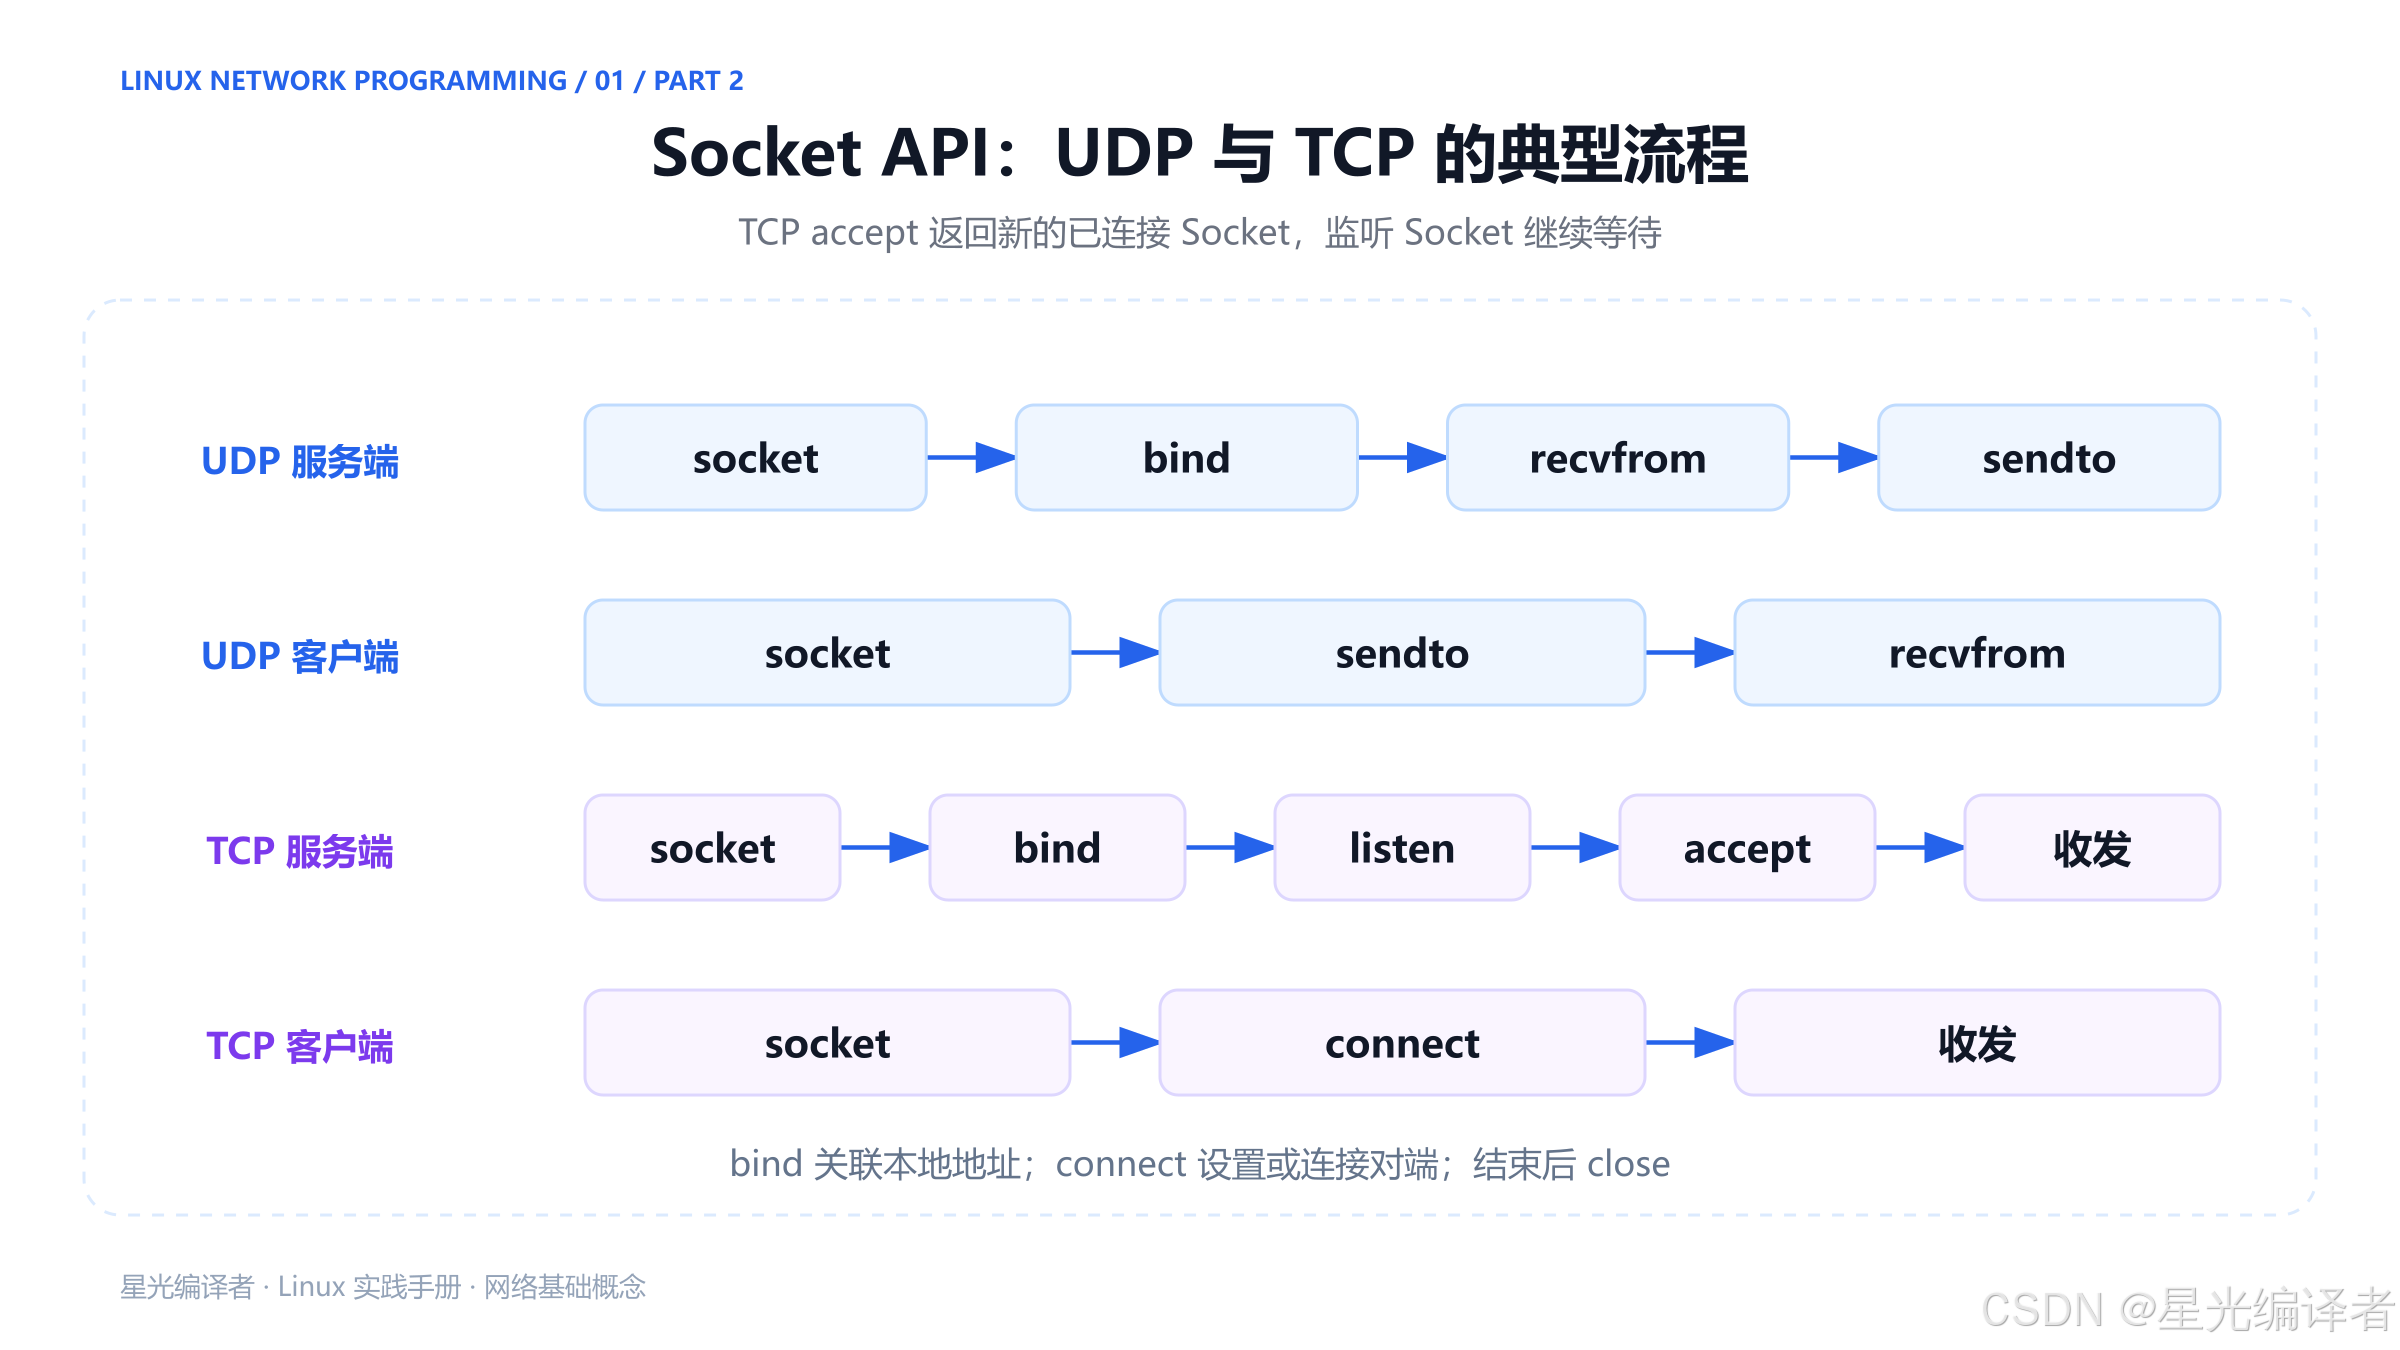
9.2 UDP服务端与客户端的典型路径
text
UDP 服务端:socket → bind → recvfrom / sendto → close
UDP 客户端:socket → sendto / recvfrom → close
客户端不显式调用 bind() 时,内核通常会在需要时分配本地地址信息和临时端口。若业务要求固定本地端口,也可以主动绑定。
UDP 的基本收发不使用 TCP 的 listen() 与 accept()。它没有"先接受一条 TCP 连接,再拿到连接 fd"的过程。
9.3 TCP服务端与客户端的典型路径
text
TCP 服务端:socket → bind → listen → accept → 收发 → close
TCP 客户端:socket → connect → 收发 → close
这里服务器存在两个不同对象:
- 监听 Socket:等待新连接;
- 已连接 Socket :由
accept()返回,用于和特定客户端通信。
关闭一条已连接 Socket 不代表关闭监听 Socket;服务器仍可以继续接受其他客户端。
9.4 创建IPv4 TCP与UDP Socket
c
int tcp_fd = socket(AF_INET, SOCK_STREAM, 0);
int udp_fd = socket(AF_INET, SOCK_DGRAM, 0);
在这个常见 IPv4 场景中,第三个参数填 0 表示让系统为地址族和类型选择默认协议。也可以使用相应协议常量明确指定。
如果调用失败,不要继续对 -1 执行 bind() 或 connect()。先检查错误,再决定退出、重试或回收资源。
9.5 先分清本地地址与对端地址
这是初学 Socket 最值得反复检查的地方:
text
bind(fd, local, ...)     :这个 Socket 在本机用什么地址
connect(fd, peer, ...)   :这个 Socket 要联系哪个对端
服务器通常绑定自己的服务地址;客户端连接服务器的地址。虽然它们都用 sockaddr_in 表示,但变量承担的角色完全不同。
十、完整地址与本地绑定示例
下面把地址转换、对象创建、绑定、查询实际地址和资源释放放在一个程序里。源码同时保存在 code/ipv4_address_demo.c。
这个例子绑定回环地址和端口 0,由系统选择可用端口;它没有发送数据,也不会持续等待客户端。这样能把观察重点放在地址结构和 API 参数上。
10.1 完整源码
c
#include <arpa/inet.h>
#include <netinet/in.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/socket.h>
#include <unistd.h>

static int make_ipv4_address(struct sockaddr_in *addr,
                             const char *ip, unsigned short port)
{
    memset(addr, 0, sizeof *addr);
    addr->sin_family = AF_INET;
    addr->sin_port = htons(port);

    int rc = inet_pton(AF_INET, ip, &addr->sin_addr);
    if (rc == 1)
        return 0;
    if (rc == 0)
        fprintf(stderr, "Invalid IPv4 address: %s\n", ip);
    else
        perror("inet_pton");
    return -1;
}

static int show_ipv4_address(const char *label,
                             const struct sockaddr_in *addr)
{
    char text[INET_ADDRSTRLEN];
    if (inet_ntop(AF_INET, &addr->sin_addr, text, sizeof text) == NULL)
    {
        perror("inet_ntop");
        return -1;
    }
    printf("%s%s:%u\n", label, text,
           (unsigned int)ntohs(addr->sin_port));
    return 0;
}

int main(int argc, char **argv)
{
    if (argc > 2)
    {
        fprintf(stderr, "Usage: %s [peer-ipv4]\n", argv[0]);
        return EXIT_FAILURE;
    }

    const char *peer_ip = argc == 2 ? argv[1] : "192.168.20.9";
    struct sockaddr_in peer;
    if (make_ipv4_address(&peer, peer_ip, 8080) == -1)
        return EXIT_FAILURE;
    if (show_ipv4_address("Prepared peer: ", &peer) == -1)
        return EXIT_FAILURE;

    struct sockaddr_in local;
    if (make_ipv4_address(&local, "127.0.0.1", 0) == -1)
        return EXIT_FAILURE;

    int fd = socket(AF_INET, SOCK_DGRAM, 0);
    if (fd == -1)
    {
        perror("socket");
        return EXIT_FAILURE;
    }

    int status = EXIT_FAILURE;
    if (bind(fd, (const struct sockaddr *)&local, sizeof local) == -1)
    {
        perror("bind");
        goto cleanup;
    }

    struct sockaddr_in actual;
    memset(&actual, 0, sizeof actual);
    socklen_t actual_len = sizeof actual;
    if (getsockname(fd, (struct sockaddr *)&actual, &actual_len) == -1)
    {
        perror("getsockname");
        goto cleanup;
    }

    if (show_ipv4_address("Bound local: ", &actual) == -1)
        goto cleanup;
    status = EXIT_SUCCESS;

cleanup:
    if (close(fd) == -1)
    {
        perror("close");
        status = EXIT_FAILURE;
    }
    return status;
}
10.2 编译与预期输出
进入 code 目录后,在 Linux 上运行:
bash
gcc -std=c11 -Wall -Wextra -Wpedantic ipv4_address_demo.c -o ipv4_address_demo
./ipv4_address_demo
预期输出形式为:
text
Prepared peer: 192.168.20.9:8080
Bound local: 127.0.0.1:实际分配的端口
第一行只是准备并展示一个对端地址,没有尝试连接它;第二行是系统实际完成的本地绑定。临时端口由当前系统选择,不应在示例中写死。
可以验证错误文本路径:
bash
./ipv4_address_demo 999.1.1.1预期报告无效 IPv4 地址并以失败状态退出。地址无效时,程序不会继续创建和绑定 Socket。
验证说明:本次制作环境为 Windows,未运行这些 Linux C 程序。这里给出可供 Linux 环境复现的源码与预期现象;字节转换和地址往返规则已用本地等价实验核对,不能把等价实验当作 Linux 编译运行记录。
10.3 getsockname的长度参数为什么要先初始化
actual_len 是输入输出参数:调用前告诉系统缓冲区容量,调用后接收实际地址长度。因此必须先写:
c
socklen_t actual_len = sizeof actual;这个模式也会出现在 accept()、recvfrom() 等获取地址的接口中。不要使用未初始化的长度变量,否则系统不知道你允许它写入多少内容。
10.4 用只读命令观察系统的真实状态
在后续运行持续工作的服务端时,可以使用:
bash
# Linux 当前临时端口范围
cat /proc/sys/net/ipv4/ip_local_port_range

# 查看 TCP 监听与 UDP Socket
ss -ltn
ss -lun

# 查看 TCP 连接;进程信息可能需要相应权限
ss -tnp
本篇的绑定示例会立即关闭 Socket,所以程序退出后通常无法再在 ss 中看到它。观察监听和连接应配合后续持续运行的服务器示例。
十一、常见错误与排查清单
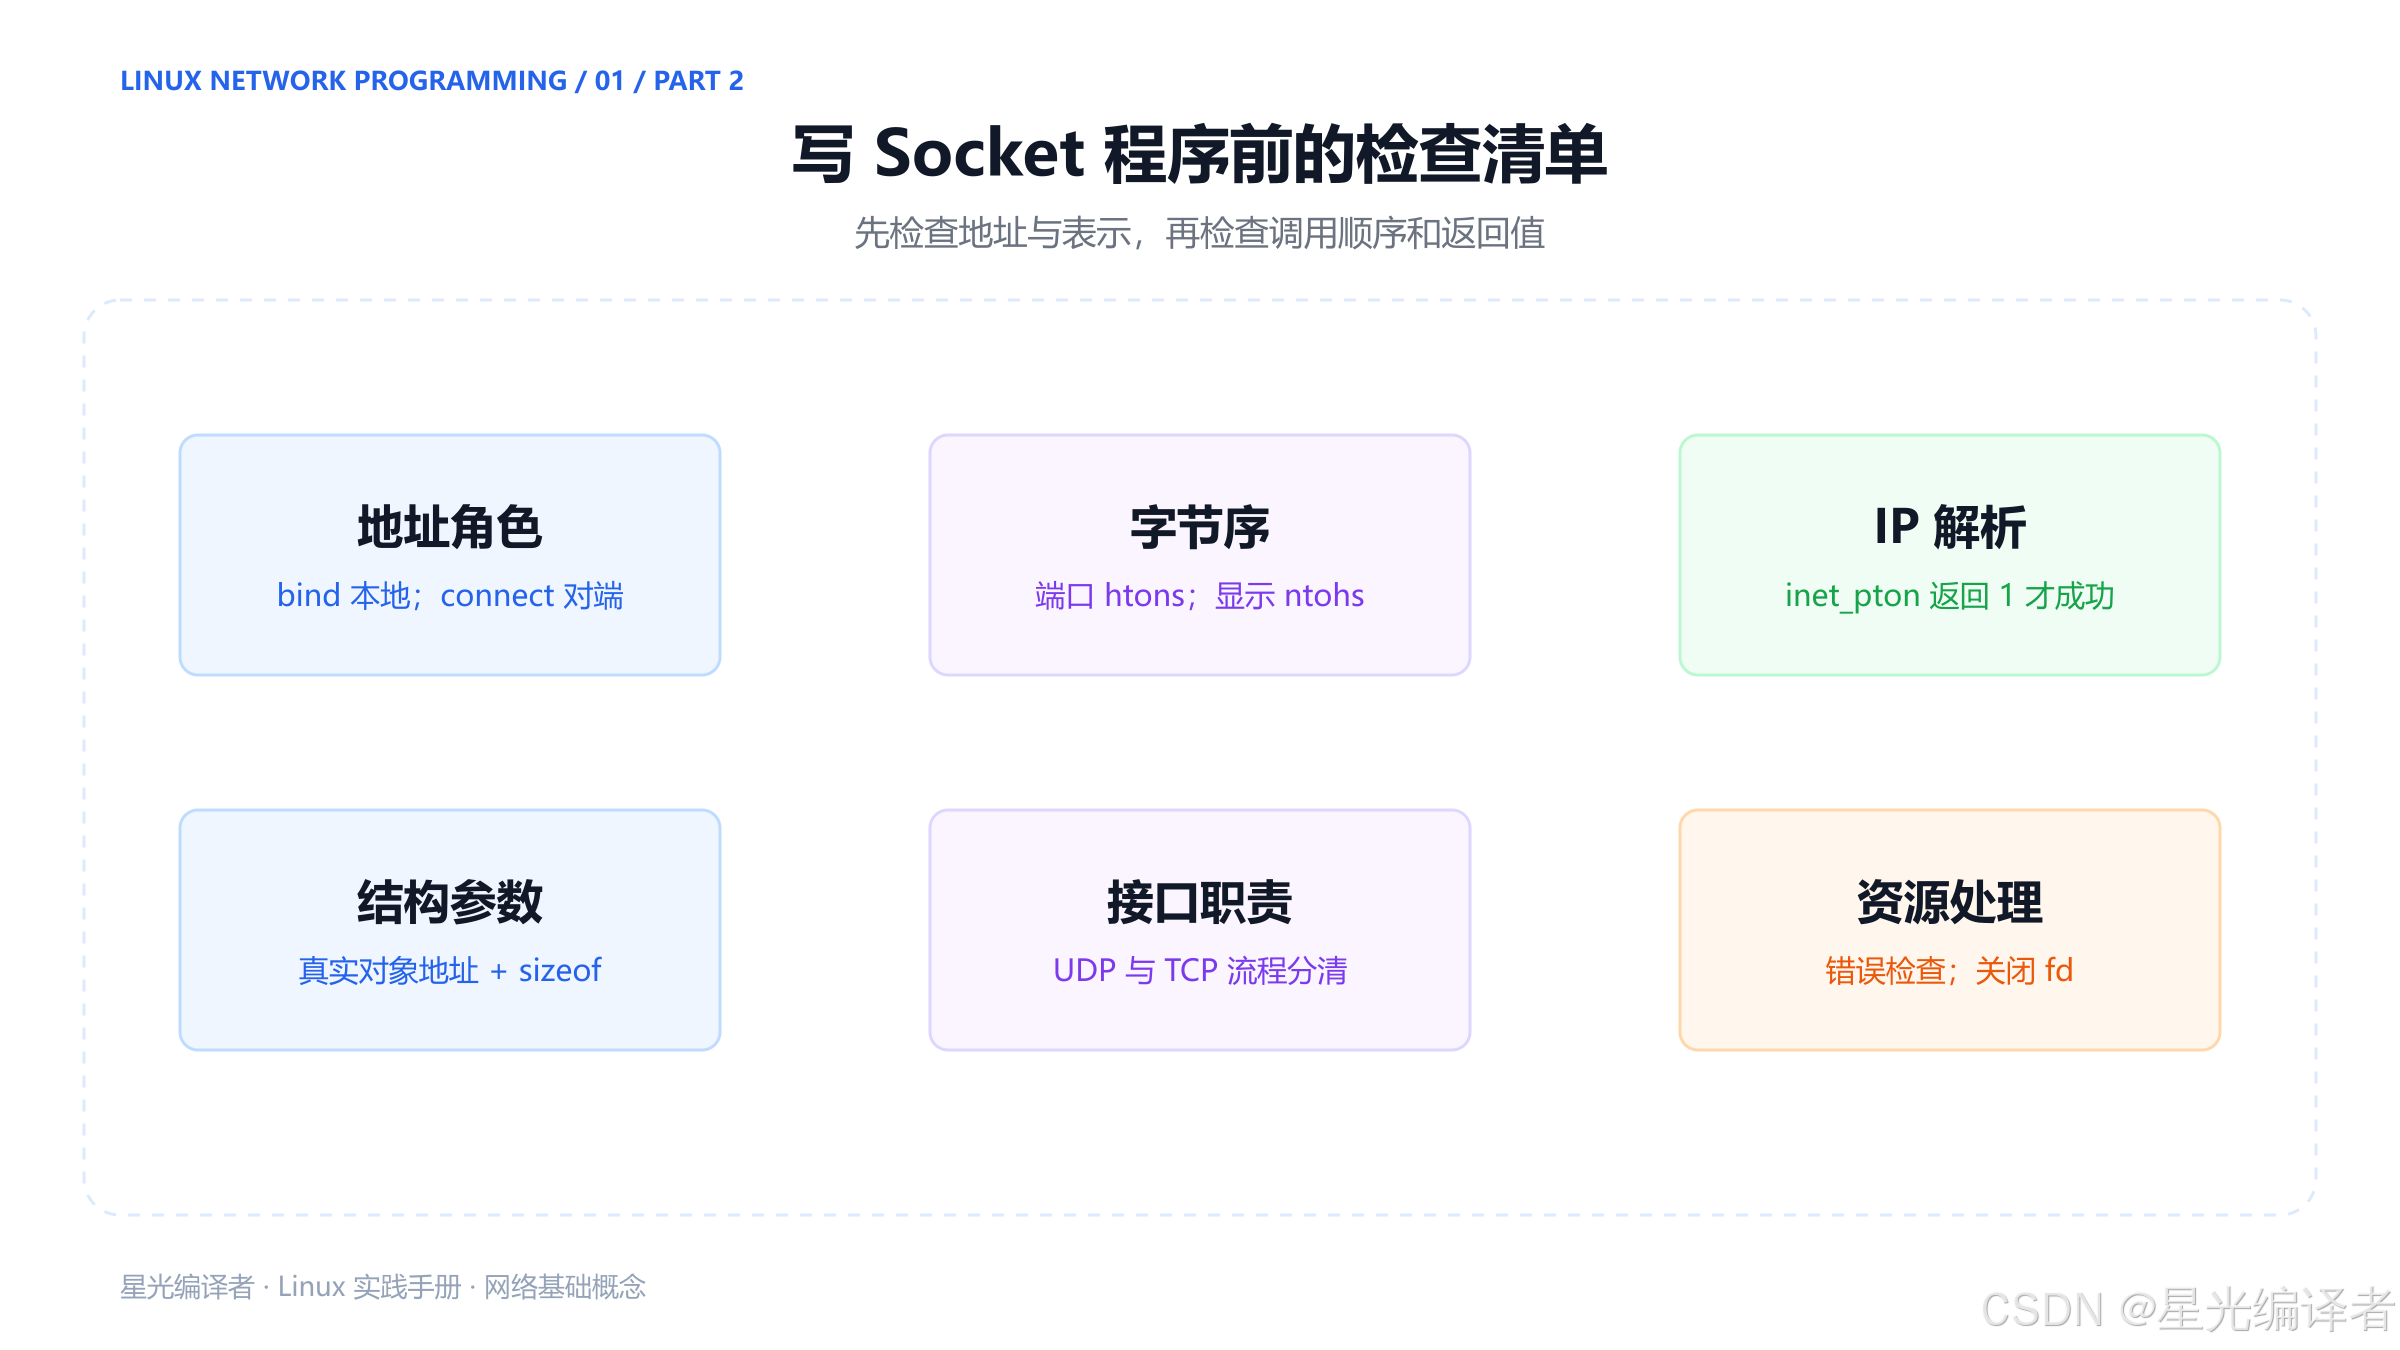
11.1 字节序相关错误
| 错误写法或想法 | 问题 | 正确方向 |
|---|---|---|
sin_port = 8080 |
没有满足网络字节序要求 | sin_port = htons(8080) |
htons(port); |
返回值被丢弃 | 把返回值赋给目标字段 |
sin_family = htons(AF_INET) |
地址族不是网络字段 | 直接赋值 AF_INET |
inet_pton() 后再 htonl() |
重复转换已是网络序的地址 | 直接使用解析结果 |
| 对整个字符串反转 | 字符串不是单个多字节整数 | 按文本编码传递 |
htonl() 处理 64 位数据 |
该接口只转换 32 位 | 使用协议明确的 64 位编码方案 |
| 直接强转任意字节缓冲区 | 可能有对齐和别名问题 | 检查长度,再 memcpy() |
11.2 地址与接口相关错误
只看到EADDRINUSE就认定"某个进程占了端口"
地址已使用可能与绑定地址、协议、复用选项和连接状态有关。先查看真实 Socket 状态与代码设置,不要只根据端口数字下结论。
把远方服务器IP交给本机bind
bind() 关联本地地址,connect() 才描述对端。检查变量到底代表 local 还是 peer。
认为accept返回的fd就是原监听fd
accept() 成功时返回新的已连接 Socket 文件描述符。监听对象仍然负责接收后续连接。
把网络序端口直接打印给用户
展示之前使用 ntohs()。如果日志里端口与配置不一致,先检查是否漏了还原。
忽略inet_pton的返回值
无效地址文本不能继续当作正确地址使用。区分返回 0 与返回 -1,分别处理格式错误和系统错误。
11.3 用六个问题进行自测
- TCP 与 UDP 都使用数值端口 8080,一定冲突吗? 不一定,它们属于不同传输协议。
- 创建 Socket 成功后,返回值等于服务端口吗? 不是,返回的是文件描述符。
- 服务器监听 8080,能否同时处理多个客户端? 可以,具体 TCP 连接通过不同端点组合区分。
- TCP 两次发送一定对应两次接收吗? 不一定,应用要自行识别消息边界。
inet_pton()成功后还要手动改成网络序吗? 不需要,它已按接口要求输出网络序地址。- 绑定端口 0 以后怎样知道真实端口? 调用
getsockname(),再用ntohs()读取端口值。
总结
准备写 Socket 程序时,先把五组关系理顺:
- IP 地址与端口:网络层寻址与传输层端点识别;
- 端口与 PID:网络通信编号与本地进程管理编号;
- Socket 地址与对象:端点描述与内核通信对象;
- TCP 与 UDP:字节流与数据报接口的不同约定;
- 本地表示与线上表示:多字节字段必须按协议规定编码。
然后把这些认识落到一段可检查的初始化流程里:
text
明确地址角色
    → 初始化 sockaddr_in
    → 设置 AF_INET
    → htons 转换端口
    → inet_pton 解析 IP
    → 检查返回值
    → 把真实对象地址与大小交给 API
    → 使用完关闭 Socket
这条流程看起来基础,却决定了后面 UDP 和 TCP 程序能否正确起步。下一份 PDF 将进入 Socket 编程 UDP,把这些字段和函数真正组合成客户端与服务器。