ICML 2026
ICML 2026 |1D-Fusion :从二维网格到一维 Token,重构多模态图像融合的共享表示
FROM 2D GRIDS TO 1D TOKENS
01
- 一句话总结
QUICK TAKE · 核心速览
这篇论文针对二维共享特征容易混合全局外观 与局部细节 的问题,引入冻结的一维图像 tokenizer,并用选择性 Token 编辑 (Selective Token Editing ,STE)调节少量关键位置。在红外---可见光与医学图像融合基准上,该方法兼顾了全局外观 一致性和局部结构保真度,并在四个数据集的多数指标上取得最佳或次优结果。
#多模态信息融合(javascript:😉#图像融合(javascript:😉#ICML2026(javascript:😉#浙江大学(javascript:😉
02
- 论文信息
PAPER INFO · 论文档案
题目:From 2D Grids to 1D Tokens: Reforming Shared Representations for Multimodal Image Fusion|从二维网格到一维 Token:重构多模态图像融合的共享表示
**发表:**ICML 2026
**作者:**Yuchen Xian1,2,Yunqiu Xu3,Yang He4,5,Yi Yang1,2,*
**单位:**1浙江大学 ReLER、脑机智能全国重点实验室;2浙江大学人工智能学院;3新加坡国立大学;4新加坡科技研究局计算与未来智能研究中心(CFAR);5新加坡科技研究局高性能计算研究院(IHPC)
**代码:**https://zju-xyc.github.io/1D-Fusion-Project-Page/
**下载:**https://arxiv.org/pdf/2606.12303
03
- 论文摘要
ABSTRACT · 研究概览
目前多模态图像融合一般是在二维特征网格里建立共享表示,可以捕捉到局部结构,但是要把亮度、对比度以及感知色调这样的全局因素分摊到很多的空间位置上,就会导致外观和细节混在一起。本文用冻结的一维tokenizer作为紧凑的全局外观载体,并且保留了二维分支来恢复边缘和纹理,然后用STE稀疏编辑少量对外观敏感的token来改善融合的效果,而不需要增加复杂的损失函数。
04
- 主要创新
HIGHLIGHTS · 核心亮点
创新点 1:重新设计共享表示载体
论文不再把二维网格作为唯一的融合共享信息的方式,而用紧凑的一维Token来表示非局部的基本外观,并且使得全局亮度、对比度以及色调可以集中地进行调整。
创新点 2:一维全局接口与二维细节通路协同
冻结的预训练 TiTok 为一维表示,Token-to-Map接口将其适配为二维特征图;二维融合骨干继续完成纹理、边缘以及空间结构的任务,以此来防止高度压缩的 Token 分支单独恢复所有的高频细节。
创新点 3:稀疏的选择性 Token 编辑
STE 先用Gumbel-Softmax来探测外观敏感的位置,然后只学习一些 token 以及通道偏移。在 TiTok-32 的配置下,位置 12 和 18、通道集6,7,8最稳定,可以用来补充锐化和背景平滑的效果。
05
- 方法详解
METHOD · 方法拆解
5.1 问题定义与整体框架
输入是对齐的可见光图和红外图,输出是融合图。作者认为二维共享特征会使低维、非空间的基础外观以及高频局部细节 一起传播到空间网格上,从而使得全局调节成为一个不稳定的高度维度协调问题。所以该框架把"全局基础外观"交给一维Token,把"局部细节"保留在二维路径里,并用重建预热和跨模态融合两个训练阶段来完成。
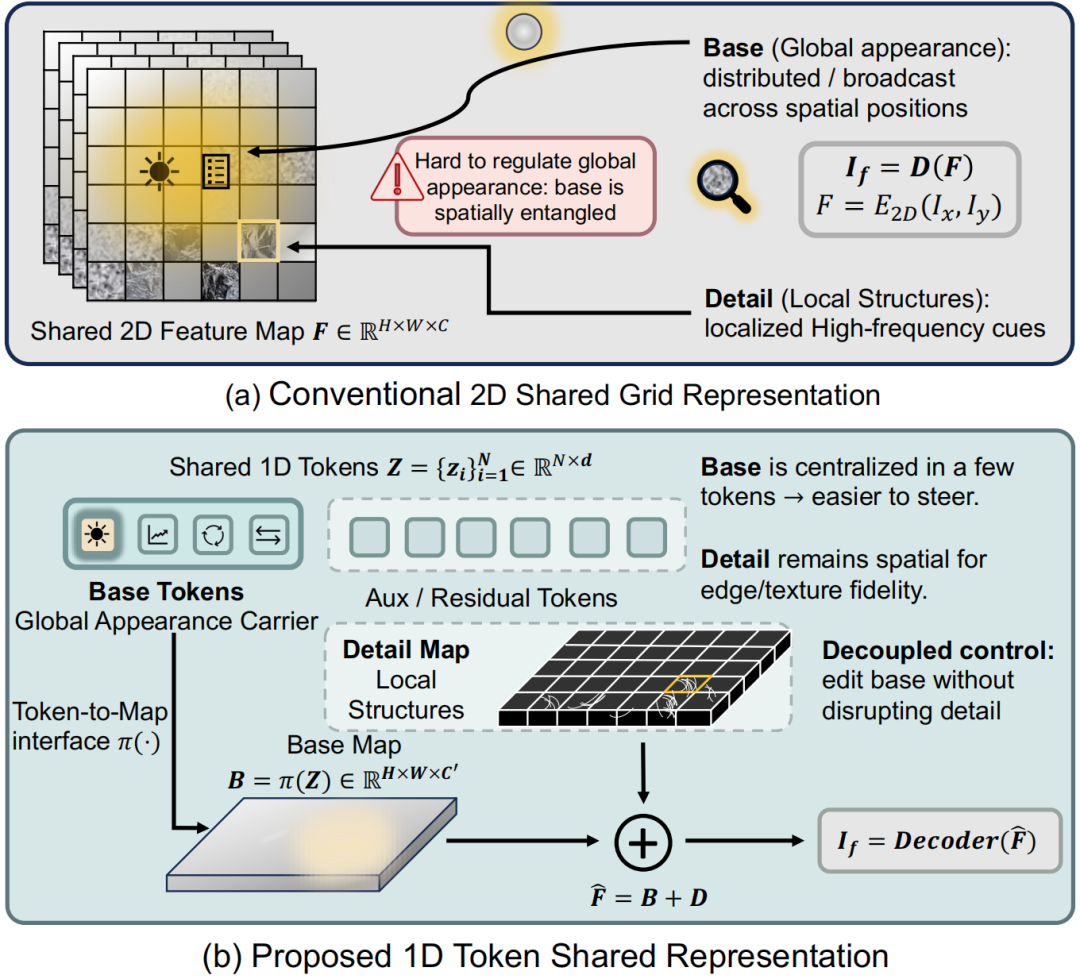
**图 1:**二维网格和一维Token在基础外观-局部细节解耦方面存在的不同之处:前者把全局的因素分散到各个空间的位置上,而后者则用一个紧凑的Token来表示基本的外观,并且把这个基本外观同二维的细节图结合起来。
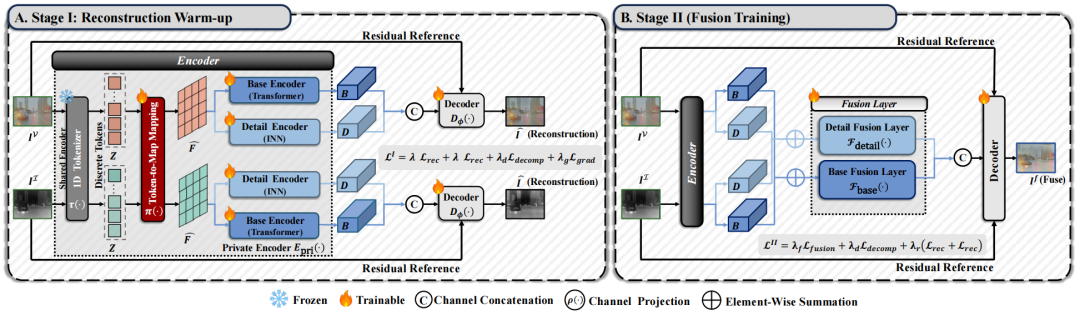
**图 2:**两阶段训练框架,在第一阶段中对每个模态进行重构,并且使基础部分和细节部分保持稳定;第二阶段使用基础和细节融合模块来实现跨模态融合以及残差解码。
5.2 一维 Token与选择性编辑
冻结的tokenizerτ(·)先将模态m∈V,I的图像转化为一维序列:
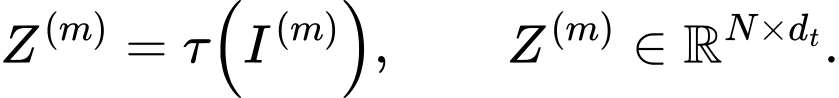
其中,N表示 token 的数量,dt表示 token 的维度;本文取N=32和dt=12。该序列属于全局外观接口,并非单独负责图像重建的主干。
STE 使用Gumbel-Softmax来学习候选位置,并且只对其中一部分进行偏移:
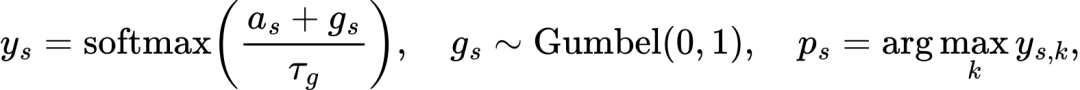
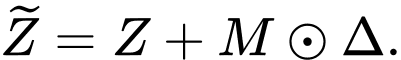
as为第s个编辑槽的选择器logits,τg为温度参数,ps为被选择的位置;二值掩码M只对指定的位置和通道起作用,Δ是可学习的偏移量。
**公式解读:**模型不会对所有的token都做修改,而是先在数据里找出一些敏感的位置,然后对其进行局部的修改,在较小的可训练成本下改变整体的样子,并且不会影响到主体的意义以及二维细节通道。
5.3 Token-to-Map与基础/细节分解
一维Token用接口π(·)映射成二维的操作载体之后再被私有的编码器分解开来并且各自融合在一起:
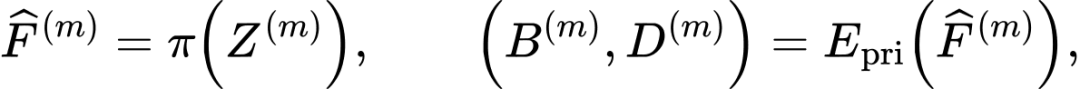

F̂(m)是由Token诱导出的二维特征图,B(m)为低频且全局一致的基础外观,D(m)为高频局部结构,而Bf和Df则是两个子空间合并之后的结果。映射模块首先把维度从12提升到64,得到一个32×32的粗特征图,在经过三次阶段性的上采样之后被恢复成了256×256,并且每一层都会加入用7×7、5×5以及3×3卷积抽取出来的细节信息。
一维空间用来表示外貌,二维空间用来表现局部结构;分开之后再合并,并且在解码的时候要考虑到基础外貌和纹理残差在同一网格中产生的影响。
最后用的是残差重建:
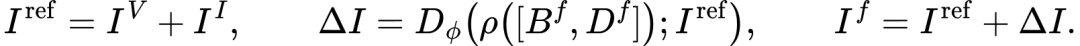
ρ(·)为通道投影算子、D\phi(·)为解码器、Δ I为需要被预测出来的互补残差。因此可以使得解码器只对必要的地方进行修改而不会重新构建整个图像。
5.4 损失函数与两阶段训练
第一阶段用结构相似性和像素级别的ℓ2重构损失,并且加入了基础/细节分解正则:
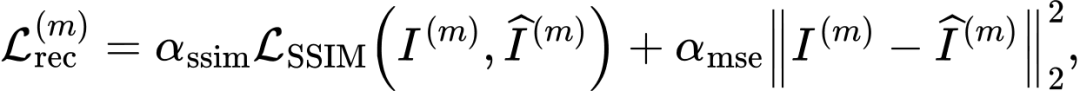
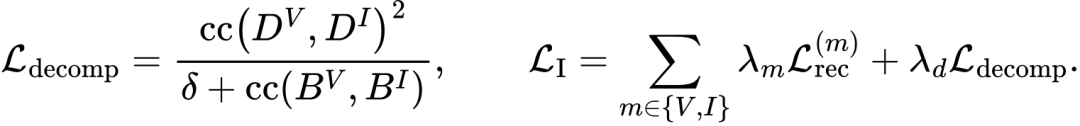
第二阶段用输入强度的最大值I\max和梯度的最大值G\max来监督融合结果:
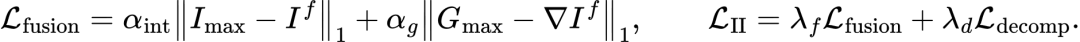
cc(·,·)为相关系数,δ为数值稳定性常数;ℒdecomp促使两个模态的细节不同,而使基本外观趋于一致;ℒfusion则保证融合图像具有较强的原始强度和梯度。
**公式解读:**第一阶段使分解与重构保持稳定,第二阶段才进行跨模态融合;整个训练过程中保持tokenizer不变动,防止一维共享空间出现偏移。
**一句话理解该方法:**用一维的token来控制整体的外观,用二维的分支来保护局部的细节,然后用稀疏编辑和分解式的融合把两者结合起来。
06
- 实验结果
EXPERIMENTS · 实验验证
6.1 实验设置
MSRS 上有1083对图像用于红外---可见光融合训练,并在 RoadScene 的50对图像上验证,测试集包括 M3FD(202对)、RoadScene(152对)和 TNO(30对)。医学图像融合用 Harvard 数据集上的200/50/55对图像进行训练、验证和测试。所有图片都统一缩放到256×256大小。第一阶段训练 40 个周期,第二阶段训练 80 个周期。使用 Adam 作为优化器,初始学习率为1 × 10⁻⁴,每隔 20 个周期就将学习率降到原来的一半,并且最低不能低于1 × 10⁻⁶。训练过程中采用混合精度以及最大范数为 0.01 的梯度裁剪技术。论文中提到的损失权值如下:第一阶段λ1= λ2= 1, λd= 2, λg= 5;第二阶段λf= 1, λd= 2, λr= 0.5。论文没有提到所用的训练硬件。
评价指标有信息熵(EN)、标准差(SD)、差异相关性之和(SCD)、边缘强度(EI)、空间频率(SF)、平均梯度(AG)以及结构相似性(SSIM),比较的方法有九种:CDDFuse、DDFM、LRRNet、Text-IF、TC-MoA、EMMA、SAGE、DCEvo 和 Text-DiFuse。
6.2 定量与定性结果
在表 1 的16组数据集---指标组合中,本文方法,有 15 组达到了最好的或者次好的效果,其中有 13 组是最佳的。M3FD 在 EN、SD、SCD、SSIM 方面分别为 7.19、47.35、1.85、1.49;TNO 在 EN、SD、SCD、SSIM 方面分别为 7.34、50.97、1.82、1.42;RoadScene 的 SCD 和 SSIM 分别为 1.82 和 1.45;Harvard 的 SCD 和 SSIM 分别为 1.76 和 1.45,但是 Harvard 的 EN 并不是最好的。
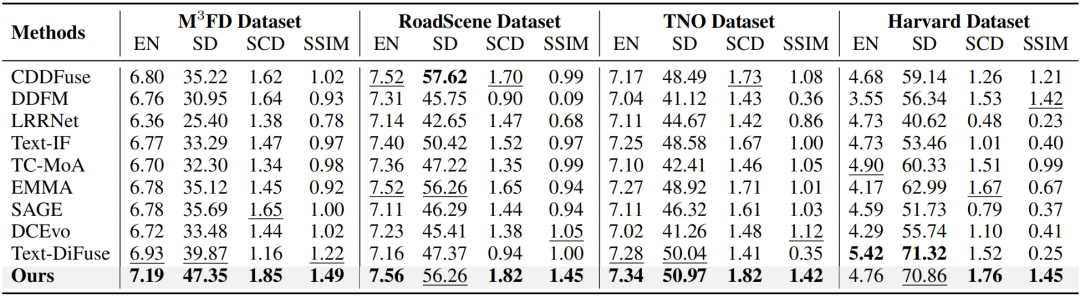
**表 1:**M3FD、RoadScene、TNO 和 Harvard 四个数据集上的融合指标定量比较,粗体和下划线分别表示最佳与次优结果。
图3表示此法于暗路情况下保有车体轮廓、于RoadScene下抑制过曝、于TNO下重现人物及景物纹理、于医学影像中维持较一致的整体外观。
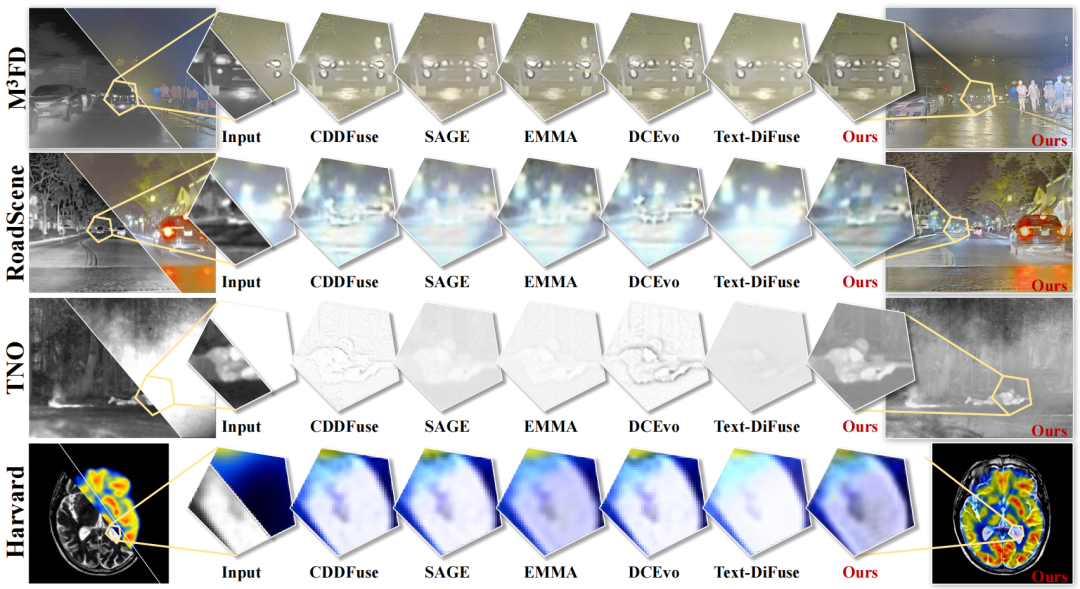
**图 3:**M3FD、RoadScene、TNO和Harvard四者之间全局亮度一致性和局部轮廓清晰度的定性对比。
6.3 下游任务结果
本文使用 YOLOv8s对M3FD做目标检测,并用YOLOv8s的mAP50:95来衡量;用SegFormer-B1对FMB做语义分割,并用SegFormer-B1的mIoU来衡量。本文的方法的mAP50:95=0.360,比次优的Text-IF的0.353要好;mIoU=0.692,和SAGE并列第一,说明融合后的结果既保住了目标边界又保存了局部结构以及全局上下文。
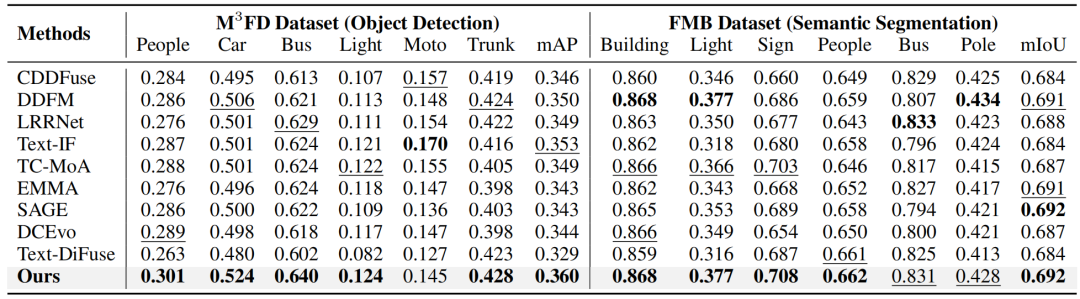
**表 2:**M3FD 目标检测和FMB语义分割的量化的对比。
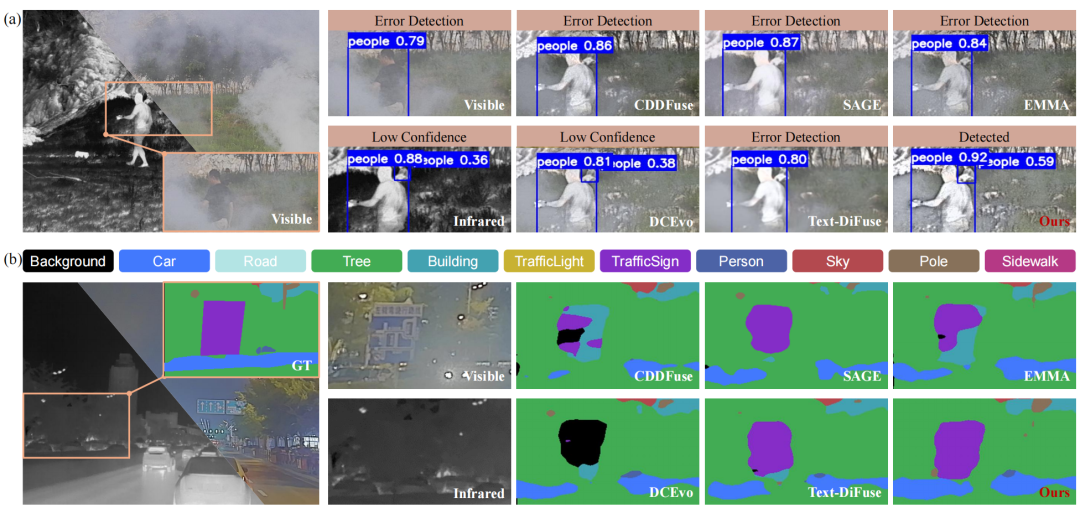
**图 4:**烟雾场景下目标检测和夜晚场景下语义分割的可视化对比。
6.4 消融实验与进一步分析
表3中无编辑基线下的EI/SF/AG/SSIM值为34.39、7.90、2.94、1.37;加入编辑位置12和18之后变为37.42、8.63、3.21、1.42。表4显示,在32个词比64个词或者128个词表现更好,说明更加紧凑的表示方式使得全局因素更加集中。表7进一步证明了两个编辑槽可以获得最好的EN/SD/SCD/SSIM值,即7.19、47.35、1.85、1.49,再增加槽位并不会带来好处。
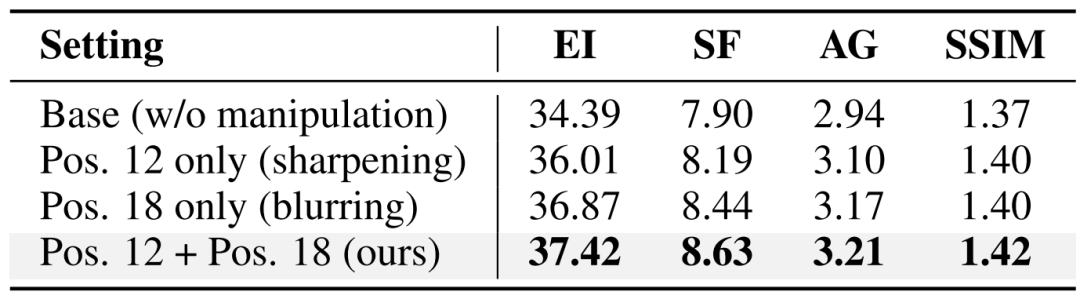
**表 3:**当位置为12和18的时候联合编辑的效果最好。
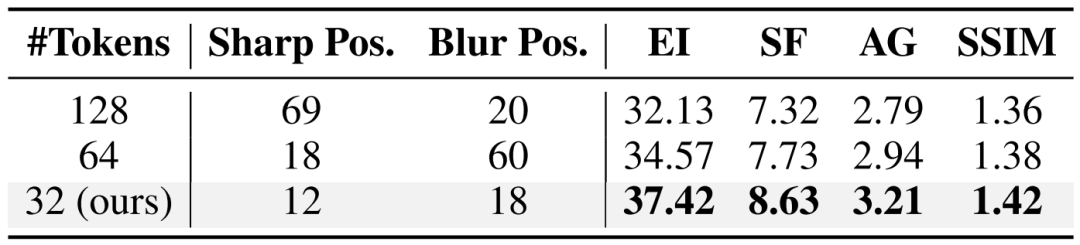
**表 4:**潜在的token数量消融,在32个token配置下全局语义更加集中。
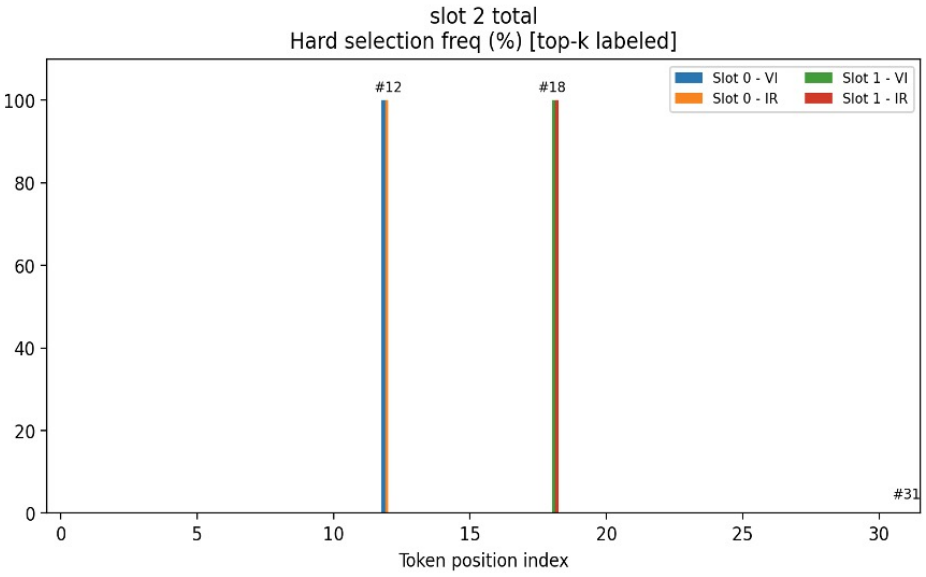
**图 5:**在有两个槽的情况下,Gumbel-Softmax选择器进行硬选择的概率;其中一个是稳定的选中位置12,另一个是稳定的选中位置18。
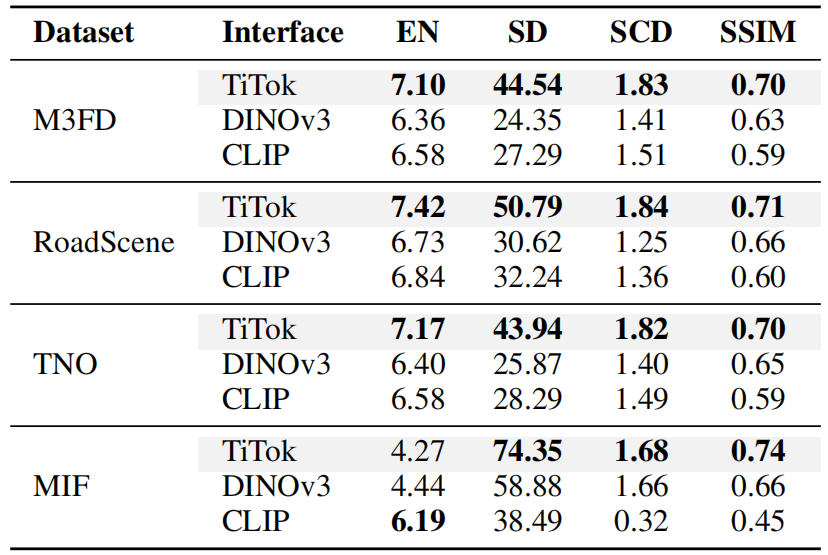
**表 6:**TiTok、DINOv3 和 CLIP 用作表示接口时的比较;TiTok 在四个数据集上的整体表现更强。
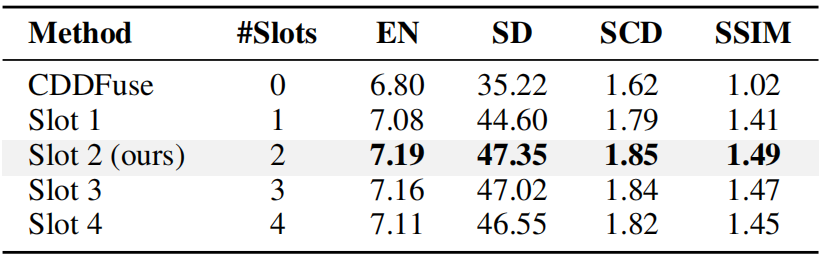
表 7:M3FD上Gumbel-Softmaxtoken位置选择槽位预算消融的结果,在两个槽位中得到最好的效果。
6.5 模型复杂度
本文的可训练参数量为1.325M,在表 5 中表示为1.3M;FLOPs、延迟以及显存分别是304.5G、124.3ms和2.78GB。尽管如此,冻结 tokenizer 仍然会带来一定的推理开销:比 CDDFuse、EMMA 和 DCEvo 慢一些,但是要比 Text-DiFuse 快很多(后者需要2736.2ms),而且 SSIM 更好。
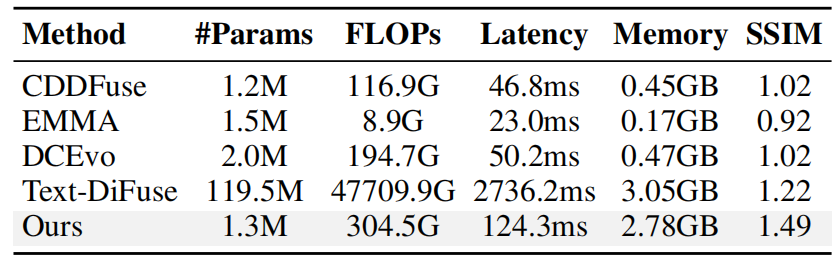
**表 5:**与代表性方法的效率比较,其中参数量指可训练参数。
07
- 总结与展望
TAKEAWAY · 总结回顾
本工作重点不是用一维的Token去替代所有的二维特征,而是要重新分配责任:用紧凑的Token来管理全局外观,用二维路径来恢复局部结构。实验结果表明,在多种数据融合、下游检测和分割的任务上该表示方法可以得到稳定的收益;但是它也带来了冻结tokenizer带来的额外FLOPs、延迟以及显存占用的问题,并且STE的具体位置取决于tokenizer的配置,在迁移的时候还需要重新选择。
一句话总结:****1D-Fusion 最重要的贡献就是把全局外观 无法在二维网格里集中控制的问题交给了少量的一维Token来处理,并且还保留了二维融合对于局部细节的好处。
往期推荐