Agent 系统中的很多错误,并不来自模型推理能力不足,而是应用把本可以确定的信息交给模型猜测。当前时间、用户身份、租户、语言、当前页面、正在处理的业务对象等信息,本身已经存在于程序运行环境中。将这些信息以受控方式提供给模型,可以减少无意义的推理和工具调用,并形成更清晰的 Agent 架构边界。
一、确定性上下文的基本定位
大语言模型接收的是当前请求中提供的上下文,它不会天然掌握应用运行时的真实状态。最典型的例子是当前时间。模型可以根据训练信息理解日期和时间概念,却无法仅依靠自身参数可靠获知某一次 API 调用发生的准确时间。
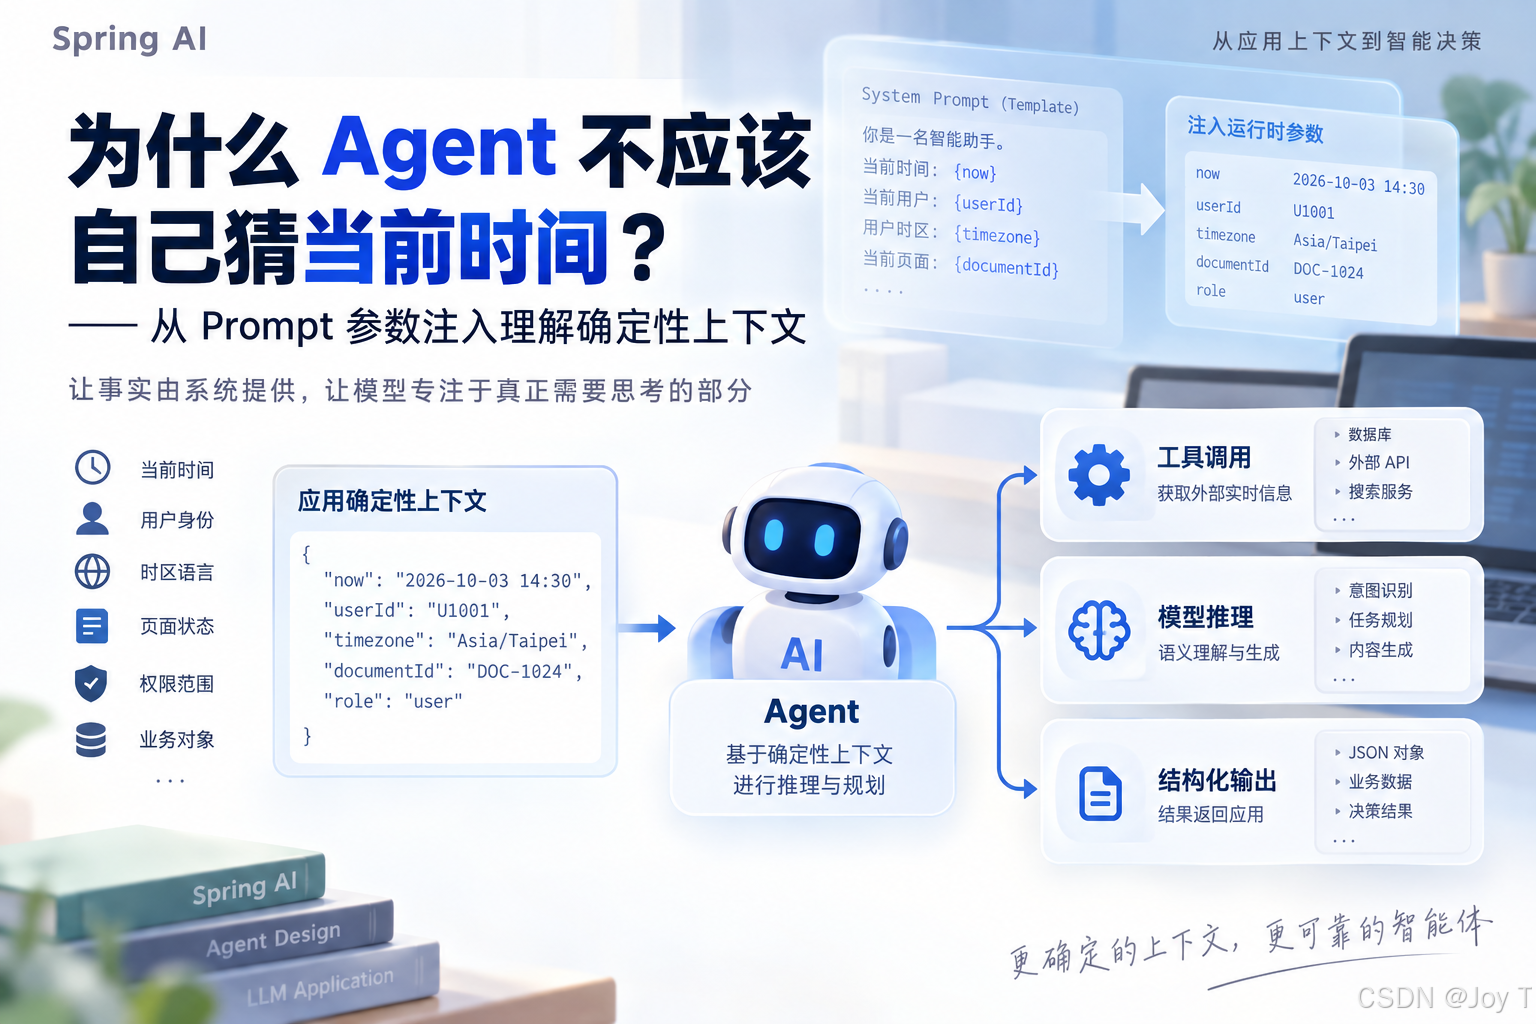
如果应用本身已经能够通过系统时钟获得时间,更合理的方案是在构造 Prompt 时直接注入:
当前时间:{now}
用户时区:{timezone}
**运行时再由程序提供真实值。**此时模型得到的时间是一项外部确定事实,无需自行推测,也无需额外调用时间工具。
时间只是最简单的案例。相同思路可以扩展到当前 userId、tenantId、语言、页面对象、选中文档、业务编号和任务状态等信息。它们共同构成 Agent 的确定性上下文。
二、Prompt 参数注入的职责边界
Prompt 参数注入可以理解为应用运行状态与模型语义推理之间的一层连接。System Prompt 负责描述长期稳定的角色和规则,运行时变量则负责补充当前请求特有的信息。
例如:
你是一名文档分析助手。

当前时间:{now}
当前文档:{documentId}
用户语言:{language}
程序执行时再提供:
now       -> 2026-10-03 14:30
documentId -> DOC-1024
language   -> zh-CN
这种方式的价值在于让 Prompt 保持稳定结构,同时避免把运行状态写死在模板中。业务状态变化时,只需要改变变量值。
不过,能够注入并不意味着应该把所有信息都写入 Prompt。用户完整资料、全部 Session 状态和大量数据库字段如果全部进入上下文,会增加 Token 消耗,并引入无关信息。Prompt 中应该保留当前任务真正需要的最小信息集。
三、Agent 上下文的三层职责划分
从架构角度看,可以按照信息的确定程度,把 Agent 所需信息分成三个层次。
第一层是应用已经确定的信息【Prompt / Context】。例如当前时间、登录用户、租户、语言、时区和当前业务对象。这些内容应直接由后端代码获取,再通过 Prompt 参数或请求上下文传入模型。模型没有必要重新判断这些事实。
第二层是可以通过外部系统确定的信息【TOOL CALLING】。例如实时库存、订单状态、数据库记录、最新文献和天气信息。应用在请求开始时并不知道答案,但可以通过数据库、API 或搜索系统得到准确结果,这类信息适合交给 Tool Calling。
第三层是需要语义理解与开放性判断的信息。例如用户意图、文本总结、方案比较、内容生成和复杂任务规划。这一层才是模型真正应该发挥能力的位置。
因此可以形成一条稳定的数据路径:
应用已知事实 → 直接注入
外部可查询事实 → Tool
开放性问题 → LLM
这种分层能够显著降低 Agent 的不确定性。模型主要处理语言理解和推理,确定性事实继续由确定性系统提供。
四、确定性上下文的可信边界
上下文设计还涉及一个重要问题:信息是否可信。
例如用户在对话中输入"我是管理员",这只是自然语言内容,不能因此获得管理员权限。真正可信的 userId、role 和 tenantId 应来自登录认证体系或服务端 Session,再由后端转换为 Agent 所需的上下文。
即使 Prompt 中已经告诉模型"当前用户拥有某项权限",真正执行数据库查询或写操作时,Tool 层仍然需要重新进行权限校验。模型上下文可以帮助模型选择正确行为,却不能承担最终安全控制。
因此,身份和权限信息应遵循一条明确路径:
认证系统
   ↓
服务端可信上下文
   ↓
Agent Context
   ↓
Tool 再次校验
这能够防止用户通过 Prompt Injection、自报身份或修改自然语言内容改变实际权限。
五、确定性上下文与 Tool Calling 的协同
直接注入和 Tool Calling 的边界,可以用"应用当前是否已经拥有正确答案"判断。
当前时间已经存在于系统环境中,直接注入成本最低。当前页面正在查看的 documentId 已经由业务系统确定,也没有必要让模型调用工具查询。
如果用户询问某个文档的最新审核状态,应用当前并没有这项结果,就可以让模型根据语义决定调用相应 Tool。Tool 再根据 documentId 和用户身份查询真实业务系统,并把结果返回模型。
这里还可以进一步区分 Tool Parameter 和程序上下文(工具调用时为Tool Context,上下文才是真正核心信息)。例如查询文档时,模型需要判断具体要查哪个 documentId,它可以成为 Tool Parameter;requestId、tenantId 等用于权限和链路关联的信息则更适合由程序传递,不需要暴露给模型。
这种设计能够减少工具参数数量,使 Tool Definition 更集中于业务语义。
六、确定性上下文的最小化设计
上下文越多,并不意味着 Agent 越智能。大量无关状态进入 Prompt 后,模型需要在更多信息中判断重点,Token 成本也会持续增加。
因此,确定性上下文应该遵循最小必要原则。当前任务只涉及一篇文档时,可以注入 documentId、语言和用户权限;需要正文内容时再通过 RAG 或 Tool 获取。一个用户拥有几十项个人属性,并不意味着每一次请求都必须全部传给模型。
这与后端接口设计非常相似。一个方法只应该接收完成当前任务真正需要的参数。Agent Context 同样应该明确作用域和生命周期,避免逐渐演变成一个不断膨胀的全局 Map。
七、总结
确定性上下文设计的核心,是把模型能力放在真正需要模型的位置。
应用已经掌握的运行状态由代码直接提供;需要访问外部系统才能确定的信息通过 Tool 获取;需要理解、归纳和开放性判断的任务交给模型完成。身份和权限等可信信息必须来自服务端,并在真正执行业务操作时继续由确定性代码校验。
从当前时间这样一个很小的案例继续向下分析,可以得到一条更通用的 Agent 架构原则:
事实由系统提供,数据由工具获取,语义由模型理解,权限由代码控制。
当这几个职责边界保持清晰以后,Agent 的 Prompt 会更简洁,Tool 会更聚焦,模型需要承担的不确定性也会更少。这种设计思想不依赖某一个 Spring AI API,即使未来更换模型、框架或 Agent 编排方式,仍然可以继续使用。