无训练视频检索
不做参数更新
用事件链的方式来理解查询
通过协同校准来找到时间的界限
不经过训练就可以进行视频时刻检索:SCAC使事件链、边界校准和协同工作相结合
IEEE TIP 2026 · Video Corpus Moment Retrieval · Training-Free
一句话读懂: SCAC 将 VCMR 两个难点的问题拆分成事件链、语义对齐和协同校准三个步骤,并且在整个过程中不进行任何参数更新。
论文 Training-Free Video Corpus Moment Retrieval via Synergistic Collaboration and Adaptive Calibration
作者 Jialong Zhao, Huafeng Li, Yafei Zhang, Wen Wang*, Changchun Hua
DOI https://ieeexplore.ieee.org/document/11658824
单位 昆明理工大学;云南大学;燕山大学
代码 https://github.com/cyanlll/SCAC
/1
VCMR为什么要进行training-free训练?
ANNOTATION AND GENERALIZATION
Video Corpus Moment Retrieval(VCMR)要求模型从大规模视频库首先找到和自然语言查询最相关的一段视频,在该视频中确定具体的起始时间和结束时间。它包含了跨模态检索以及时刻定位这两个层面。
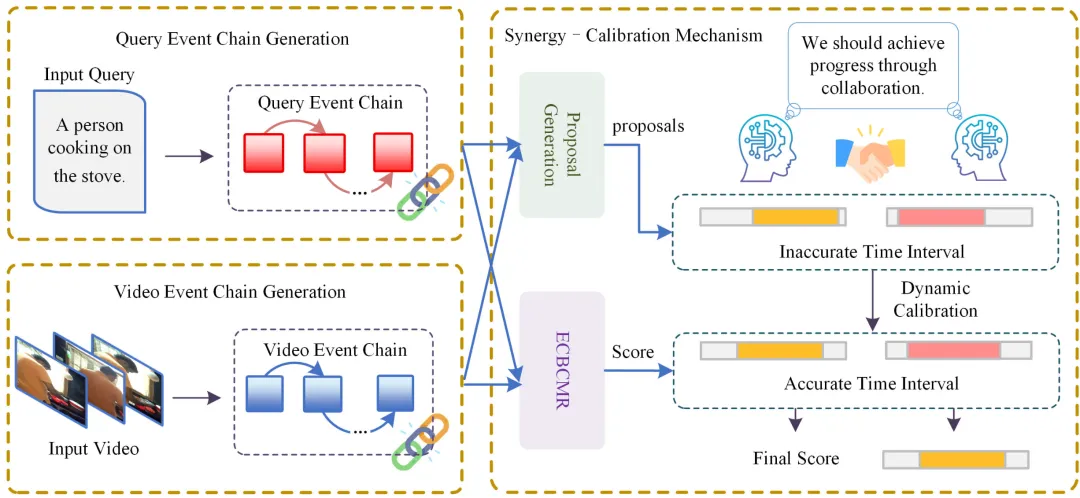
目前的强监督/弱监督的方法一般都依靠大量的视频-文本配对或者片段级别的标注。即使在固定的benchmark上表现良好,在迁移到开放域或者长视频的时候仍然会受到标注成本、数据分布以及训练开销的影响。
SCAC 的目标就非常清楚了:不进行训练和更新参数,只用预训练LLM/VLM的语义能力来完成从查询解析、视频语义组织、跨模态检索到边界细化的整个闭环过程。
/2
把文本、视频都转化成"事件链"
EVENT CHAIN
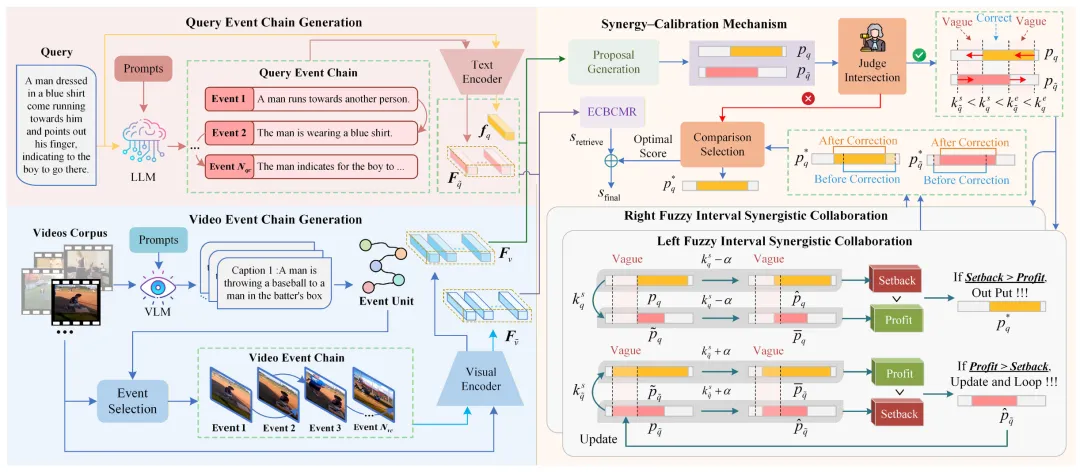
查询端,QECG(Query Event Chain Generation)用LLaMA 3.1-8B把复杂的自然语言查询分解为按照语义顺序排列的事件:
{q₁, q₂, ..., qNqc} = LLM(P, Q)
P 是用来产生事件链的提示词。
视频端,VECG(Video Event Chain Generation)利用字幕分段和关键帧聚合,把视频切分成语义相对连贯的事件单元,然后使用BLIP视觉编码器得到视频事件表示。因此,原来的查询和视频就不再是只存在一个"句向量对一个视频向量"的关系之中了,而是在同一个空间里进行事件级别的结构对齐。
/3
均值判断"整体上是不是这样",方差判断"是否有局部虚高"
MEAN-VARIANCE SCORE
SCAC 的Event-Chain-Based Cross-Modal Retrieval会先对原始query和视频事件进行最大相似度计算,然后对每一个query event和video event进行匹配。最后的关键点是得分并不是简单的算平均分,而是在于引入了事件匹配方差惩罚:
sretrieve = sq + E(Sq̃) − D(Sq̃)
E(·)表示事件级别的匹配均值,D(·)表示其方差。
如果一个候选视频只在少数几个事件上出现异常高的相似度,而其他事件的支持不够,则该事件得分会有很大的波动,方差项就会把这类"局部碰巧匹配"的情况压制下去。该设计将全局一致性的表现形式明确地体现在了检索评分中。
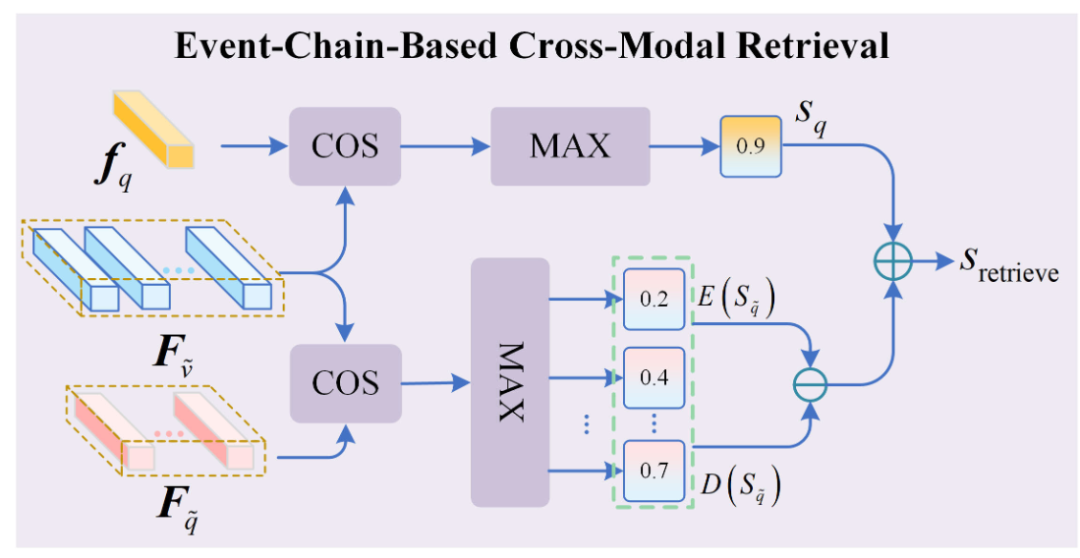
事件链跨模态检索和候选proposal生成。
/4
SCM:两个候选区间互相"讨价还价",把边界推到更加合理的地步
SYNERGY CALIBRATION
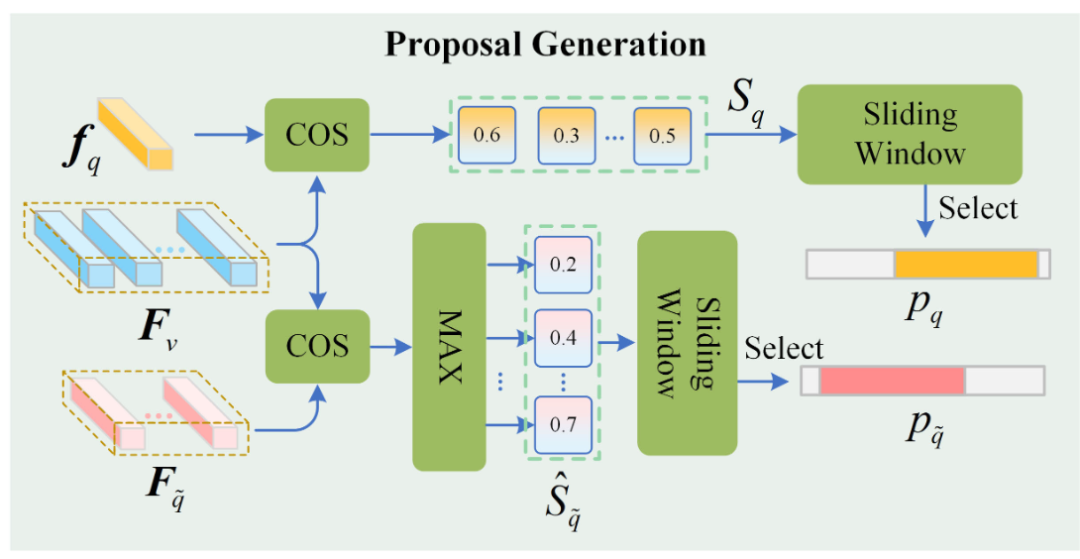
经过检索之后,SCAC 会从原始查询和查询事件链中分别得到候选提案。如果两个区间存在交集的话,Synergy-Calibration Mechanism(SCM)就会被激活并开始进行协同边界校准。
论文将交集看作是可能正确的区间,把两边不一致的部分看作fuzzy interval。在调整边界的时候,并没有用到梯度,而是一次性的调整所带来的效果来比较,从而确定出最合适的调整方式。
Setback= g(pq, Sq) − g(p̂q, Sq)
Profit= g(p̃q, Ŝq̃) − g(p̄q, Ŝq̃)
当Profit 大于 Setback时,则接受调整继续迭代;反之停止。本质上就是一种没有参数的闭环边界搜索:两个语义来源互相提供约束,使候选区间逐渐逼近最优的时间边界。
/5
实验:training-free 并不是"能跑就行",而已经接近或者超过了监督的方法
RESULTS
在ActivityNet-Captions的SVMR定位中,SCAC的R@1(IoU=0.3/0.5/0.7)可以达到45.18/26.28/13.18;相比于training-free的RefCap(M),分别提高了7.85、4.39和2.21个百分点。
在 Charades-STA 上达到59.41/42.61/21.94,相对于RefCap(M),提升8.74、9.49和5.62个百分点;在 DiDeMo 中得到39.20/23.80/10.89,相应的提高幅度为11.51、9.35 和 4.29 个百分点。
论文中提到,在一个重要的R@1检索指标上,SCAC比全监督SQuiDNet高出了0.3个百分点。说明结构化事件链、动态校准等不是仅仅依靠"大模型语义能力",而是提高了检索和定位的协同效果。
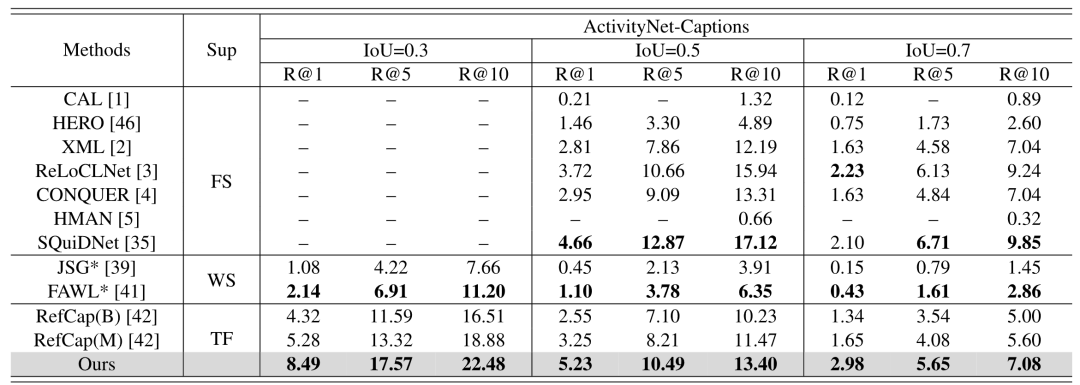
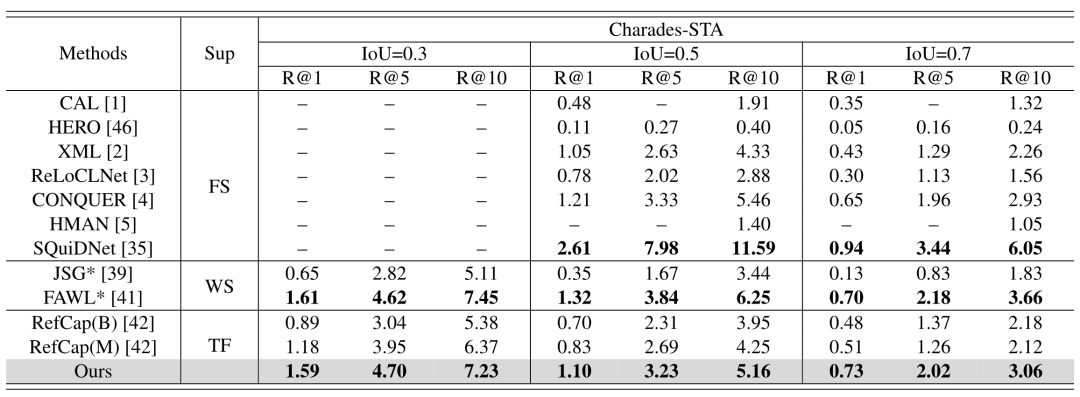
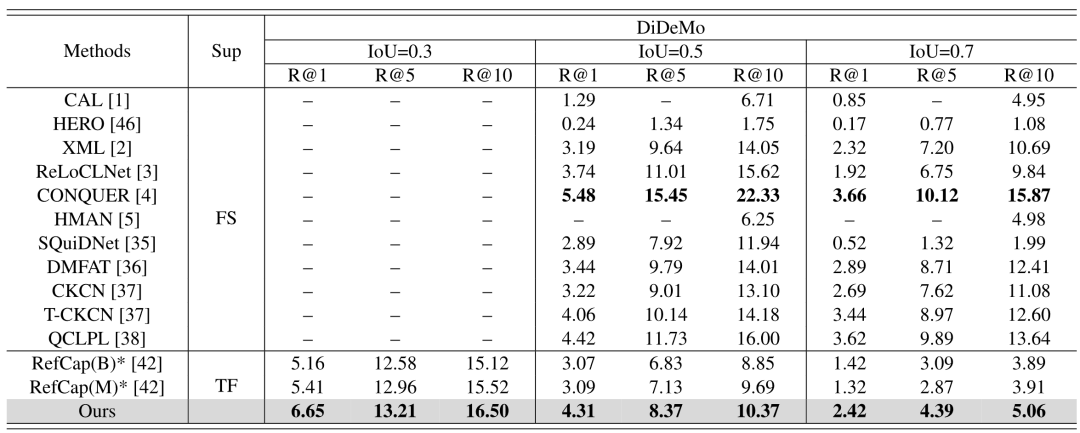
ActivityNet-Captions、Charades-STA、DiDeMo 上的 SVMR 定位结果。
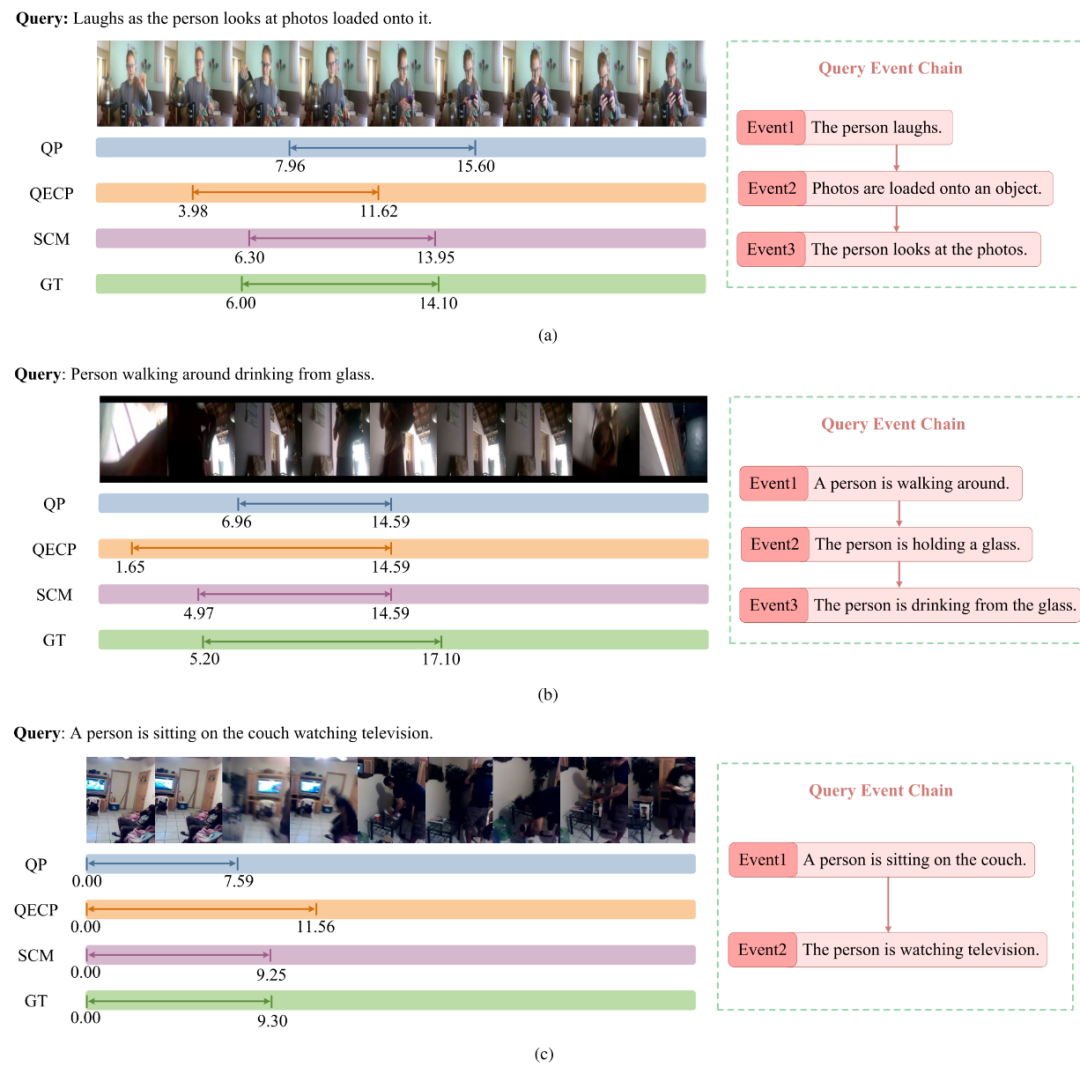
SCM输出可视化:QP、QECP经过校准之后会更加接近GT区间。
/6
思考与展望
第一,SCAC 虽然"不训练",但是并不等于"低成本":它依赖于大型预训练 LLM/VLM,所以在资源受限环境下部署的成本仍然存在。
第二,论文也明确表示,在目前的情况下复杂的事件之间存在时间上的依赖关系以及层级结构建模仍不充分。事件链把查询由一句话变成了一个有序的事件序列,但是更长跨度的因果/层级关系还没有被系统所利用。
因此这篇工作的真正值得进一步研究的方向是把training-free VCMR从"事件拆解+相似度+搜索"的基础上继续推进到结构化时序推理,同时减少大模型调用的成本。
往期推荐
--- END ---