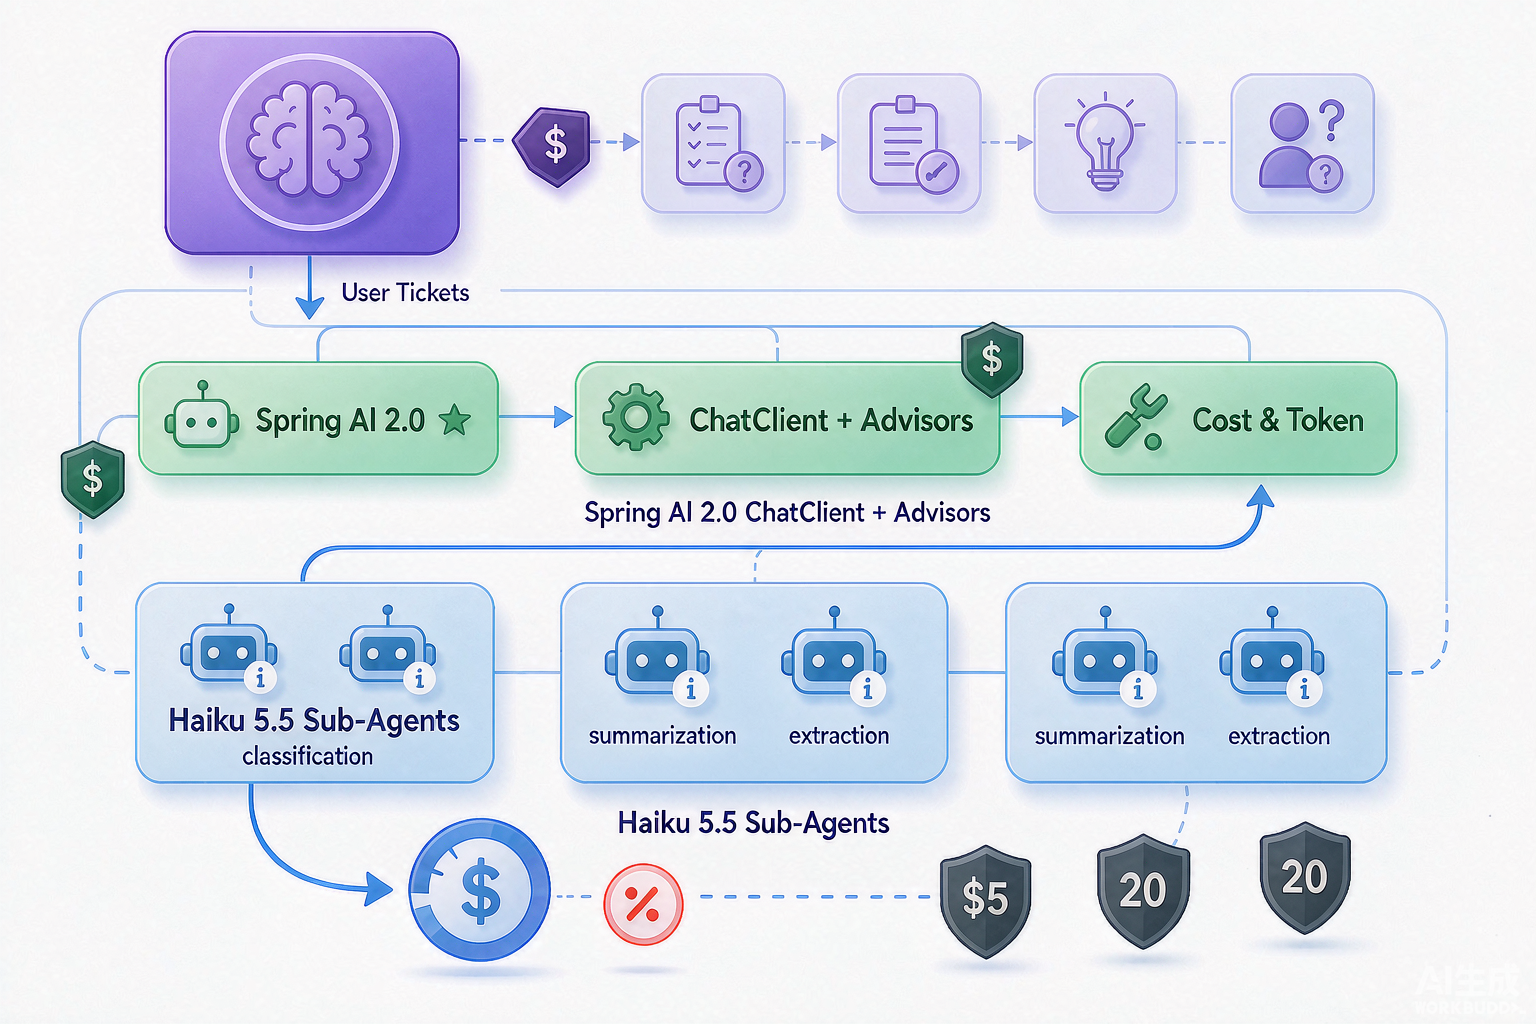
2026 年 10 月 7 日,Anthropic 正式发布 Claude Haiku 5.5------被称为"迄今最便宜、最快、最强的小模型"。 input 价格从 Haiku 4.5 的 1/百万 token 砍到 0.1/百万 token(10 万 token 以内),降幅达 90% ;context window 从 20 万 token 膨胀到 100 万 token ;更关键的是,它首次在 Haiku 级别引入了 adjustable effort 五级档位和 computer/browser use 工具能力。对于每天需要处理数万次模型调用的 Java 后端系统来说,这意味着子 Agent 层的成本结构被彻底重写。
但便宜不等于好用。Haiku 5.5 的 tokenizer 变了、thinking 机制变了、采样参数限制变了,直接把老代码里的 temperature=0.7 扔进去会收获一个 400 错误。本文从 Spring AI 2.0 Anthropic 模块源码出发,围绕一个完整的"智能工单分类与路由系统"实战项目,拆解 Haiku 5.5 的企业级落地全链路:从子智能体分工架构、成本熔断策略,到百万上下文的内存与连接池治理。
一、Haiku 5.5 核心特性:为什么它是 Java 后端的"子 Agent 专用引擎"
1.1 定价结构:成本不是低,是可预测的分层
Haiku 5.5 的定价设计非常"工程友好"------它按 prompt 长度分了两档:
| 档位 | 输入价格 | 输出价格 | 适用场景 |
|---|---|---|---|
| ≤ 100K token | $0.10 / 百万 | $0.50 / 百万 | 90% 的历史请求在此区间 |
| > 100K token | $0.50 / 百万 | $2.50 / 百万 | 长文档、代码库分析 |
Anthropic 明确说约 90% 的 Haiku 历史请求在 10 万 token 以内。对于工单分类、摘要提取、意图识别这类"输入几百到几千 token、输出几十到几百 token"的高频任务,单次调用成本已经低到可以忽略不计。配合 cache read $0.01/百万 token, warm 会话的成本几乎为零。
但注意一个隐藏成本:Haiku 5.5 使用了与 Claude 4.7+ 相同的新 tokenizer ,同样的文本比 Haiku 4.5 多计约 30% 的 token。这意味着你之前在 Haiku 4.5 上跑通的 max_tokens=500 预算,在 5.5 上可能不够用了。
1.2 Adjustable Effort:五级档位,让成本和质量可量化权衡
Haiku 5.5 是首个支持 effort 参数的小模型,五级档位从 low 到 max,默认 medium:
java
// Spring AI 2.0 中通过 AnthropicChatOptions 配置
AnthropicChatOptions options = AnthropicChatOptions.builder()
    .model("claude-haiku-5-5")
    .effort(AnthropicChatOptions.Effort.LOW)  // 或 MEDIUM, HIGH, XHIGH, MAX
    .maxTokens(1024)
    .build();
在 Anthropic 的内部测试中,从 low 切到 medium 会让 early stopping 减少约一半,但输出 token 数翻倍。对于工单分类这种"只需要一个标签"的任务,low 档位足够;而对于需要多步推理的异常根因分析,high 或 xhigh 才够用。核心原则:让便宜的任务更便宜,让复杂的任务有退路。
1.3 1M Context + 128K Output:单窗口吞下整个代码库
100 万 token 的上下文窗口,大约相当于 55.5 万个英文单词。在 Java 后端场景中,这意味着:
-
单次调用可以吞下 整个中型代码库的源码 (约 10-20 万行)做分析
-
单次调用可以处理 数百条工单历史记录 做模式识别
-
128K 的输出上限,足够生成一份完整的技术方案文档
但 1M context 也是一把双刃剑------如果你的系统不做输入截断和分层检索,用户 paste 进来一份 80 万 token 的日志文件,账单会让你怀疑人生。
1.4 Computer & Browser Use:小模型也能操作桌面和浏览器
Haiku 5.5 支持 computer_toolset_20260801 和 browser_toolset_20260801,在 OSWorld 2.1 离线子集上拿到 72.4% 的分数,碾压 GPT-6 Luna 的 48.9%。虽然距离 Sonnet 5.5 的 83.9% 还有差距,但考虑到 Haiku 的成本只有 Sonnet 的约 1/50,它在"高并发自动化测试"、"批量网页信息抓取"等场景中的性价比是无敌的。
注意 :Haiku 4.5 的
computer_20250124工具在 5.5 上已被computer_toolset_20260801取代,直接换 model ID 不修改工具定义会 400。
二、Spring AI 2.0 Anthropic 模块源码级拆解
Spring AI 2.0(2026 年 6 月 GA)对 Anthropic 模块做了一次彻底的重构:从自研 RestClient 迁移到 Anthropic 官方 Java SDK (com.anthropic:anthropic-java)。这个变化对 Haiku 5.5 的接入有直接影响。
2.1 AnthropicChatModel:从 new 到 Builder
Spring AI 1.x 时代,AnthropicChatModel 的构造方式是直接 new:
java
// 1.x ------ 已废弃
AnthropicApi anthropicApi = new AnthropicApi(apiKey);
AnthropicChatModel chatModel = new AnthropicChatModel(anthropicApi, options);
2.0 改为 Builder 模式,底层委托给官方 SDK:
java
// 2.0 ------ 推荐方式
AnthropicChatModel chatModel = AnthropicChatModel.builder()
    .apiKey(apiKey)
    .defaultOptions(AnthropicChatOptions.builder()
        .model("claude-haiku-5-5")
        .maxTokens(4096)  // 官方 SDK 默认值从 1.x 的 500 变为 4096
        .build())
.build();源码里,AnthropicChatModel.builder() 内部调用的是 AnthropicChatModel.Builder,它在 build() 时会通过 AnthropicClientFactory 创建官方 SDK 的 AnthropicClient 实例。这意味着:
-
HTTP 连接池、重试逻辑、SSL 配置全部交给官方 SDK 管理
-
Spring AI 只负责 Prompt/Response 的语义转换
-
官方 SDK 的新特性(如 Haiku 5.5 的 effort 参数)理论上可以快速跟进
2.2 AnthropicChatOptions:Haiku 5.5 的专属配置项
Spring AI 2.0 的 AnthropicChatOptions 是 Haiku 5.5 特性的直接映射层。关键字段:
java
public class AnthropicChatOptions implements ChatOptions {
    private String model;                    // "claude-haiku-5-5"
    private Integer maxTokens;               // 默认 4096(注意不是 500!)
    private Effort effort;                   // LOW, MEDIUM, HIGH, XHIGH, MAX
    private ThinkingType thinking;           // 自适应 thinking 配置
    private List<ToolDefinition> tools;      // computer/browser use 工具定义
    private Boolean enableCache;             // prompt cache 开关
    // ...
}
一个关键变化 :Haiku 5.5 的 maxTokens 默认是 4096 ,而 1.x 时代是 500。如果你从 Haiku 4.5 迁移过来,原来靠"默认值 500"做成本控制的代码,在 2.0 上会默默膨胀到 4096,账单直接翻 8 倍。生产环境务必显式设置 maxTokens。
2.3 ToolCallingAdvisor:Haiku 5.5 的 tool use 循环
Spring AI 2.0 把工具调用循环从 ChatModel 内部上移到 ToolCallingAdvisor,这是 2.0 最大的架构变革。对于 Haiku 5.5 的 computer/browser use 场景,这意味着:
java
ChatClient chatClient = ChatClient.builder(chatModel)
    .defaultAdvisors(new ToolCallingAdvisor())  // 工具调用由 Advisor 负责循环
    .build();

String result = chatClient.prompt()
    .user("打开浏览器,搜索最新的 Spring Boot 4.1 发布说明")
    .tools(new BrowserUseTool())  // 自定义 browser use 工具
    .call()
    .content();
ToolCallingAdvisor 的源码实现是一个 do-while 循环 :每次调用模型 → 检查 response 是否包含 tool_use → 执行工具 → 把结果塞回 prompt → 再次调用 → 直到拿到最终文本回答。Haiku 5.5 作为子 Agent 时,这个循环通常只需要 1-2 轮(分类/提取任务),而 Sonnet 5.5 处理复杂任务时可能需要 3-5 轮。控制循环轮数 = 控制成本。
2.4 Streaming 与 Thinking Block 的处理
Haiku 5.5 的 adaptive thinking 默认开启,thinking tokens 会计入 maxTokens。Spring AI 2.0 在 AnthropicChatModel.toChatResponse() 中,如果遇到 ThinkingBlock,会将其转换为 Generation,reasoning text 存入 message metadata 的 "thinking" 键下:
java
// AnthropicChatModel.java 关键逻辑(概念还原)
if (block instanceof ThinkingBlock thinkingBlock) {
    return new Generation(
        new AssistantMessage(thinkingBlock.thinking()),
        Map.of("thinking", thinkingBlock.thinking())
    );
}
默认情况下 thinking block 的 thinking 字段为空(只有 signature),需要设置 thinking.display = "summarized" 才能看到内容。流式模式下,thinking block 可能在第一个 content block 之前出现,前端渲染时必须按 type 字段选择,不能按位置硬编码。
三、实战项目:智能工单分类与路由系统
我们围绕一个真实的客服工单场景,构建"Haiku 5.5 子 Agent + Sonnet 5.5 主 Agent"的分层架构。
3.1 系统架构与 Agent 分工
用户工单输入
    │
    ▼
┌─────────────────┐     ┌─────────────────┐     ┌─────────────────┐
│  IntentionAgent │────▶│ SummaryAgent    │────▶│ ExtractAgent    │
│  (Haiku 5.5 LOW)│     │ (Haiku 5.5 MED) │     │ (Haiku 5.5 MED) │
│  意图分类        │     │ 内容摘要        │     │ 实体提取        │
└─────────────────┘     └─────────────────┘     └─────────────────┘
    │                           │                       │
    ▼                           ▼                       ▼
  分类标签                    摘要文本                实体JSON
    │                           │                       │
    └──────────┬────────────────┴───────────────────────┘
               │
               ▼
    ┌─────────────────┐
    │ DecisionAgent   │
    │ (Sonnet 5.5 HIGH)│
    │ 复杂决策/根因分析 │
    └─────────────────┘
               │
               ▼
           路由结果
设计原则 :
-
Haiku 5.5 负责"模式化"任务 :分类、摘要、实体提取------输入输出结构固定,effort 可调
-
Sonnet 5.5 负责"推理型"任务 :异常根因分析、跨工单关联、需要多步推理的决策
-
成本比:Haiku 子 Agent 单次约 0.0001,Sonnet 主 Agent 单次约 0.005,相差 50 倍
3.2 核心代码:分层 Agent 配置
java
@Configuration
public class TicketAgentConfig {

    // ===== Haiku 5.5 低成本子 Agent =====
    @Bean
    public ChatModel haikuChatModel() {
        return AnthropicChatModel.builder()
            .apiKey(System.getenv("ANTHROPIC_API_KEY"))
            .defaultOptions(AnthropicChatOptions.builder()
                .model("claude-haiku-5-5")
                .maxTokens(256)  // 分类任务输出很短,严格限制
                .effort(AnthropicChatOptions.Effort.LOW)
                .build())
            .build();
    }

    @Bean
    public ChatClient haikuClient(ChatModel haikuChatModel) {
        return ChatClient.builder(haikuChatModel)
            .defaultAdvisors(new ToolCallingAdvisor())
            .build();
    }

    // ===== Sonnet 5.5 高精度主 Agent =====
    @Bean
    public ChatModel sonnetChatModel() {
        return AnthropicChatModel.builder()
            .apiKey(System.getenv("ANTHROPIC_API_KEY"))
            .defaultOptions(AnthropicChatOptions.builder()
                .model("claude-sonnet-5-5")
                .maxTokens(4096)
                .effort(AnthropicChatOptions.Effort.HIGH)
                .build())
            .build();
    }

    @Bean
    public ChatClient sonnetClient(ChatModel sonnetChatModel) {
        return ChatClient.builder(sonnetChatModel)
            .defaultAdvisors(
                new ToolCallingAdvisor(),
                new MessageChatMemoryAdvisor(new InMemoryChatMemory())
            )
            .build();
    }
}
3.3 IntentionAgent:工单意图分类
java
@Ai.Service
public interface IntentionAgent {

    @SystemMessage("""
        你是一个工单分类专家。请将用户工单分类到以下类别之一:
        BUG, FEATURE_REQUEST, BILLING, ACCOUNT_ISSUE, GENERAL_INQUIRY
        只返回分类标签,不要解释。
        """)
    @UserMessage("工单内容:{{content}}")
    TicketCategory classify(@V("content") String content);
}

// 使用
@Component
public class TicketRouter {
    @Autowired private IntentionAgent intentionAgent;
    @Autowired private SummaryAgent summaryAgent;
    @Autowired private ExtractAgent extractAgent;
    @Autowired private DecisionAgent decisionAgent;

    public RoutingResult route(Ticket ticket) {
        // Step 1: Haiku LOW 做分类(约 50-100 token 输入,1-5 token 输出)
        TicketCategory category = intentionAgent.classify(ticket.getContent());

        // Step 2: Haiku MEDIUM 做摘要(约 500 token 输入,100 token 输出)
        String summary = summaryAgent.summarize(ticket.getContent());

        // Step 3: Haiku MEDIUM 做实体提取(约 500 token 输入,50 token 输出)
        TicketEntities entities = extractAgent.extract(ticket.getContent());

        // Step 4: 只有复杂工单才走 Sonnet HIGH
        if (category == TicketCategory.BUG && entities.getSeverity() == Severity.CRITICAL) {
            return decisionAgent.analyze(ticket, summary, entities);
        }

        return new RoutingResult(category, summary, entities, null);
    }
}
3.4 成本熔断与监控 Advisor
java
@Component
public class CostGuardAdvisor implements CallAdvisor {

    private final MeterRegistry meterRegistry;
    private final double dailyBudgetUsd;

    @Override
    public AdvisedResponse aroundCall(AdvisedRequest request, CallChain chain) {
        // 检查当日预算
        double spentToday = meterRegistry.counter("anthropic.cost.daily").count();
        if (spentToday > dailyBudgetUsd) {
            throw new CostBudgetExceededException("当日 API 预算已耗尽: $" + spentToday);
        }

        long startTime = System.currentTimeMillis();
        AdvisedResponse response = chain.nextCall(request);
        long duration = System.currentTimeMillis() - startTime;

        // 记录 token 消耗和成本
        TokenUsage usage = response.response().getMetadata().getTokenUsage();
        if (usage != null) {
            double cost = estimateCost(usage, request.modelOptions());
            meterRegistry.counter("anthropic.cost.daily").increment(cost);
            meterRegistry.timer("anthropic.latency").record(duration, TimeUnit.MILLISECONDS);
            meterRegistry.counter("anthropic.tokens.input").increment(usage.promptTokens());
            meterRegistry.counter("anthropic.tokens.output").increment(usage.generationTokens());
        }

        return response;
    }

    private double estimateCost(TokenUsage usage, ChatOptions options) {
        // Haiku 5.5: $0.10/百万 input, $0.50/百万 output (≤100K)
        long inputTokens = usage.promptTokens();
        long outputTokens = usage.generationTokens();
        boolean isHaiku = options.getModel() != null && options.getModel().contains("haiku");

        if (isHaiku && inputTokens <= 100_000) {
            return (inputTokens * 0.10 + outputTokens * 0.50) / 1_000_000;
        } else if (isHaiku) {
            return (inputTokens * 0.50 + outputTokens * 2.50) / 1_000_000;
        }
        // Sonnet 5.5 定价...
        return 0.0;
    }
}
3.5 百万上下文的安全使用模式
对于需要处理长文档的场景(如附件日志分析),Haiku 5.5 的 1M context 不是让你无脑塞满,而是配合 分层检索 使用:
java
@Service
public class LongDocumentProcessor {

    @Autowired private ChatClient haikuClient;

    public String analyzeLargeLog(String logContent) {
        // 安全策略:超过 50 万 token 先做分段摘要
        int tokenCount = estimateTokens(logContent);
        if (tokenCount > 500_000) {
            List<String> chunks = splitIntoChunks(logContent, 100_000);  // 每段约 10 万 token
            List<String> summaries = chunks.parallelStream()
                .map(chunk -> haikuClient.prompt()
                    .user("请摘要以下日志片段的关键错误和异常模式:\n" + chunk)
                    .call()
                    .content())
                .toList();
            // 用摘要拼接后的文本做最终分析
            String combinedSummary = String.join("\n---\n", summaries);
            return haikuClient.prompt()
                .user("基于以下日志摘要,给出根因分析和修复建议:\n" + combinedSummary)
                .call()
                .content();
        }
        return haikuClient.prompt()
            .user("分析以下日志:\n" + logContent)
            .call()
            .content();
    }
}
四、生产踩坑清单:从 Haiku 4.5 迁移到 5.5 的八个致命陷阱
踩坑 1:temperature/top_p/top_k 必须完全省略
Haiku 5.5 拒绝任何非默认采样参数。以下代码会直接 400:
java
// ❌ 错误:Haiku 5.5 会返回 400
AnthropicChatOptions.builder()
    .model("claude-haiku-5-5")
    .temperature(0.7)  // 致命!必须省略
    .build();

// ✅ 正确:完全省略采样参数
AnthropicChatOptions.builder()
    .model("claude-haiku-5-5")
    .maxTokens(1024)
    .effort(AnthropicChatOptions.Effort.MEDIUM)
.build();原因:Haiku 5.5 的 adaptive thinking 机制与显式采样不兼容。Anthropic 的迁移文档明确说 "omit temperature, top_p, and top_k entirely"。
踩坑 2:thinking tokens 吃掉 maxTokens 预算
Haiku 5.5 默认开启 adaptive thinking,thinking tokens 计入 maxTokens 。如果你设置 maxTokens=256 做分类,可能发现返回的内容被截断------因为前面 100+ token 被 thinking 占用了。
解决方案:给 thinking 预留 20-30% 的 token 预算,或显式关闭 thinking(仅对 medium 及以下 effort 有效):
java
AnthropicChatOptions.builder()
    .model("claude-haiku-5-5")
    .maxTokens(512)  // 预留 thinking 空间
    .thinking(ThinkingConfig.builder().enabled(false).build())  // medium 及以下可关闭
    .build();
踩坑 3:新 tokenizer 导致成本估算全面失效
Haiku 5.5 的 tokenizer 与 Haiku 4.5 不同,同一段文本的 token 数增加约 30%。如果你用 Haiku 4.5 的历史数据做成本预测,实际账单会高出 30%。
解决方案 :上线前用新 tokenizer 重新校准所有预算模型。Spring AI 2.0 的 TokenUsage 会返回实际 token 数,建议采集至少 1000 条请求做新的成本模型拟合。
踩坑 4:effort 切换导致 prompt cache 失效
Anthropic 的 prompt cache 是按 "prompt 内容 + 模型参数" 做键的。切换 effort 档位会改变 cache key,导致整个对话的 cache 失效。在多轮对话场景中,如果前后两轮的 effort 不一致,第二轮会全额计费。
解决方案:为同一会话固定 effort 档位,或通过配置中心按任务类型绑定 effort,避免运行时动态切换。
踩坑 5:computer/browser use 工具的系统 token 开销
当 tool_choice 设为 auto 或 none 时,Haiku 5.5 会自动注入 286 个系统 prompt token ;当设为 any 或指定工具时,增加到 406 个 token。对于高频短请求,这笔固定开销可能占总成本的 20-30%。
解决方案 :如果任务明确不需要工具,显式设置 tool_choice = ToolChoiceMode.NONE 以节省 120 个 token。
踩坑 6:1M context 的内存与连接池压力
100 万 token 的上下文,按 UTF-8 估算约 4MB 文本。如果并发 100 个请求同时处理长文档,内存峰值可能达到 400MB+ 纯文本。更隐蔽的是 HTTP 连接池问题------官方 SDK 的默认连接超时可能不足以传输 4MB 的 payload。
解决方案 :
-
设置足够的
okhttp.readTimeout(建议 60 秒以上) -
长文档任务使用独立线程池隔离
-
启用 GZIP 压缩传输
踩坑 7:assistant prefill 被彻底禁用
Haiku 5.5 不支持 assistant prefill(即使 thinking 关闭也会 400)。如果你之前用 prefill 技巧做结构化输出引导,需要改用 Spring AI 2.0 的原生 structured output:
java
// ❌ 已废弃:Haiku 5.5 返回 400
chatClient.prompt()
    .user("分类以下工单")
    .messages(new AssistantMessage("{"))  // prefill 被禁用
    .call()
    .content();

// ✅ 正确:使用 structured output
chatClient.prompt()
    .user("分类以下工单")
    .call(new BeanOutputConverter<>(TicketCategory.class));
踩坑 8:Spring AI 2.0 maxTokens 默认值从 500 变为 4096
这是最隐蔽的账单杀手。Spring AI 2.0 的 AnthropicChatOptions 默认 maxTokens=4096(官方 SDK 默认值),而 1.x 是 500。如果你从 1.x 迁移过来,忘记显式设置 maxTokens,Haiku 5.5 单次调用可能输出数千 token,成本直接爆炸。
解决方案 :所有生产环境的 AnthropicChatOptions 必须显式设置 maxTokens,并在代码审查中作为强制检查项。
五、总结:Java 后端做 AI,成本控制是第二条护城河
Claude Haiku 5.5 的发布,标志着大模型应用从"炫技"进入"精打细算"的时代。对于 Java 后端工程师来说,这不是"换模型 ID"那么简单,而是一整套分层 Agent 架构、成本熔断、并发治理的工程化能力。
Haiku 5.5 不是 Sonnet 5.5 的替代品,而是子 Agent 层的专用引擎。让它做分类、摘要、提取、浏览器自动化;让 Sonnet 做根因分析、复杂决策、代码生成。配合 Spring AI 2.0 的 ChatClient + Advisor 链,Java 团队完全可以在不转 Python 的前提下,构建出成本可控、并发可扩展的企业级 AI Agent 系统。
工程化能力,才是 Java 工程师在 AI 时代的真正护城河。