ESP32 唤醒词标称 98%,为什么还要自己做验收?
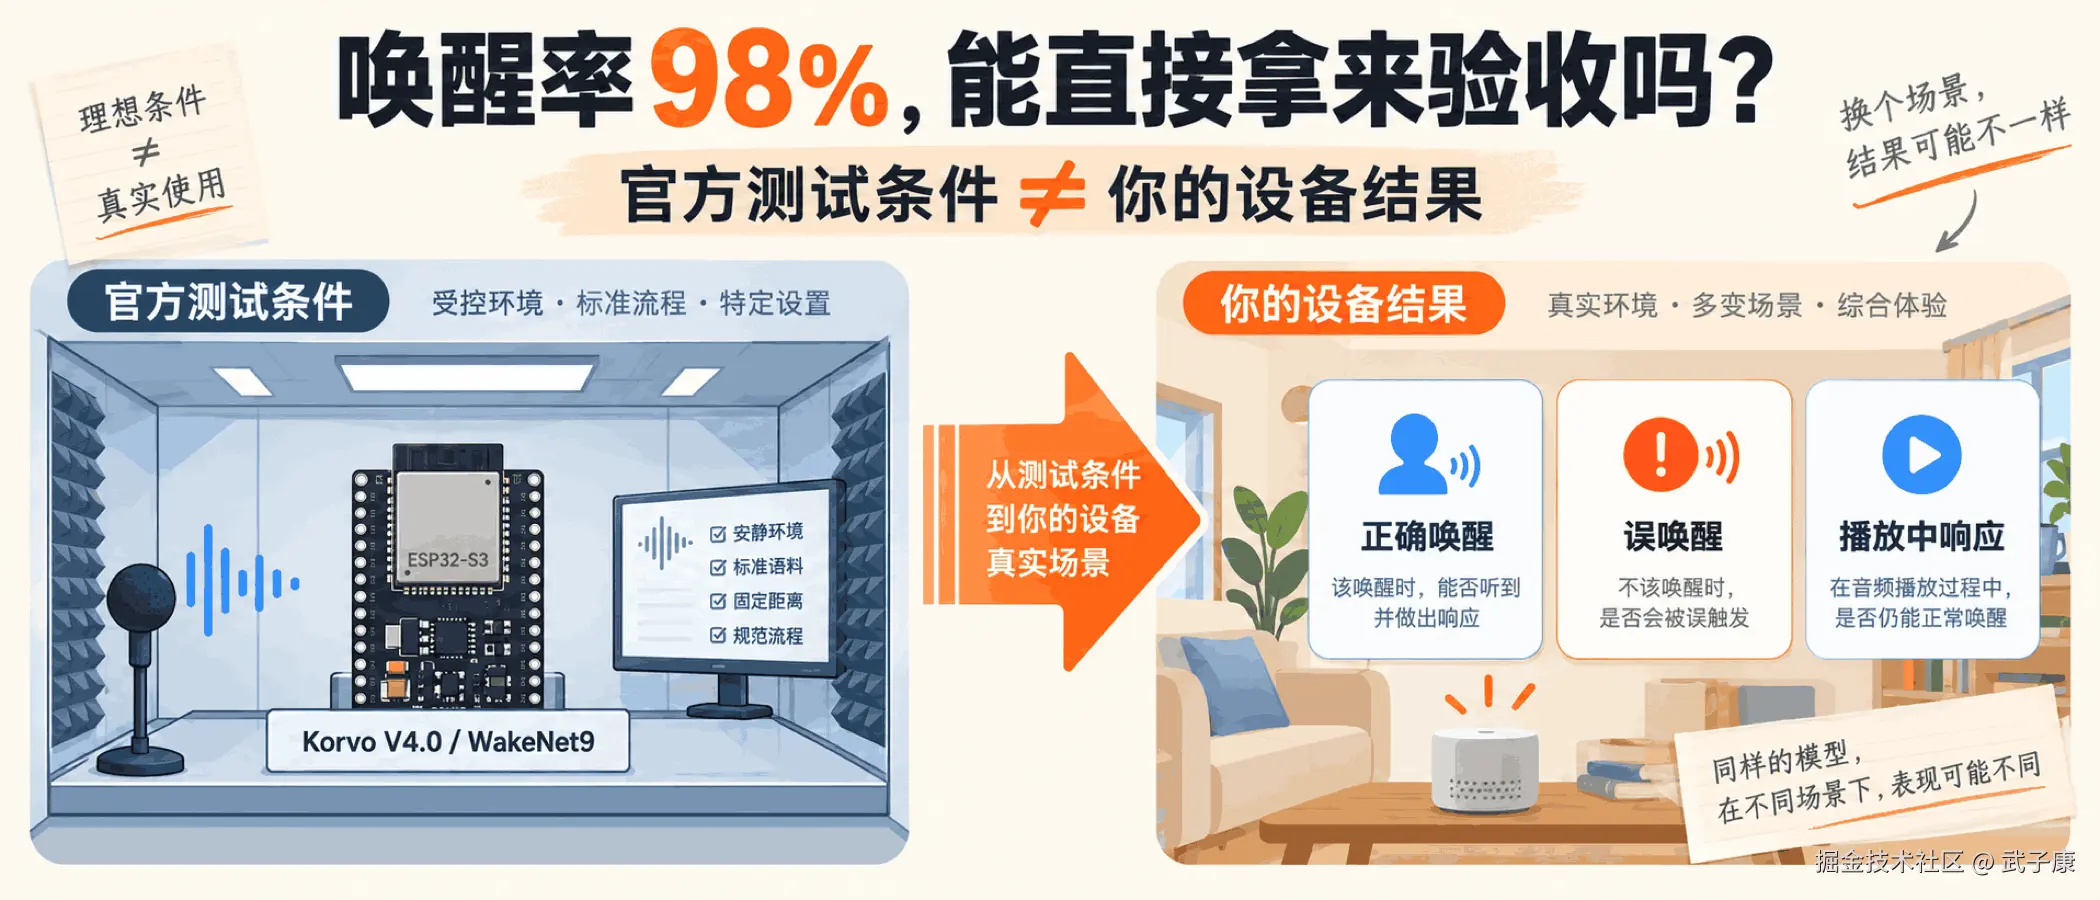
给 ESP32-S3 语音设备做验收时,很容易从官方资料里抄一个唤醒率。乐鑫的 WakeNet Benchmark 在安静条件下列出 1 米和 3 米均为 98%。但你的产品换了外壳、麦克风位置、唤醒词或播放状态后,这个百分比还能直接当合格线吗?
先看表格脚注:那组结果基于 ESP32-S3-Korvo V4.0 开发板和 WakeNet9(Alexa)模型。官方结果是参考边界,不是任意 ESP32-S3 产品的现场结果。本文给出一张待执行的验收表,区分正确唤醒、误唤醒和播放中响应;没有实体板卡实测,也不填写自家产品的虚构通过率。
98% 具体属于哪次测试
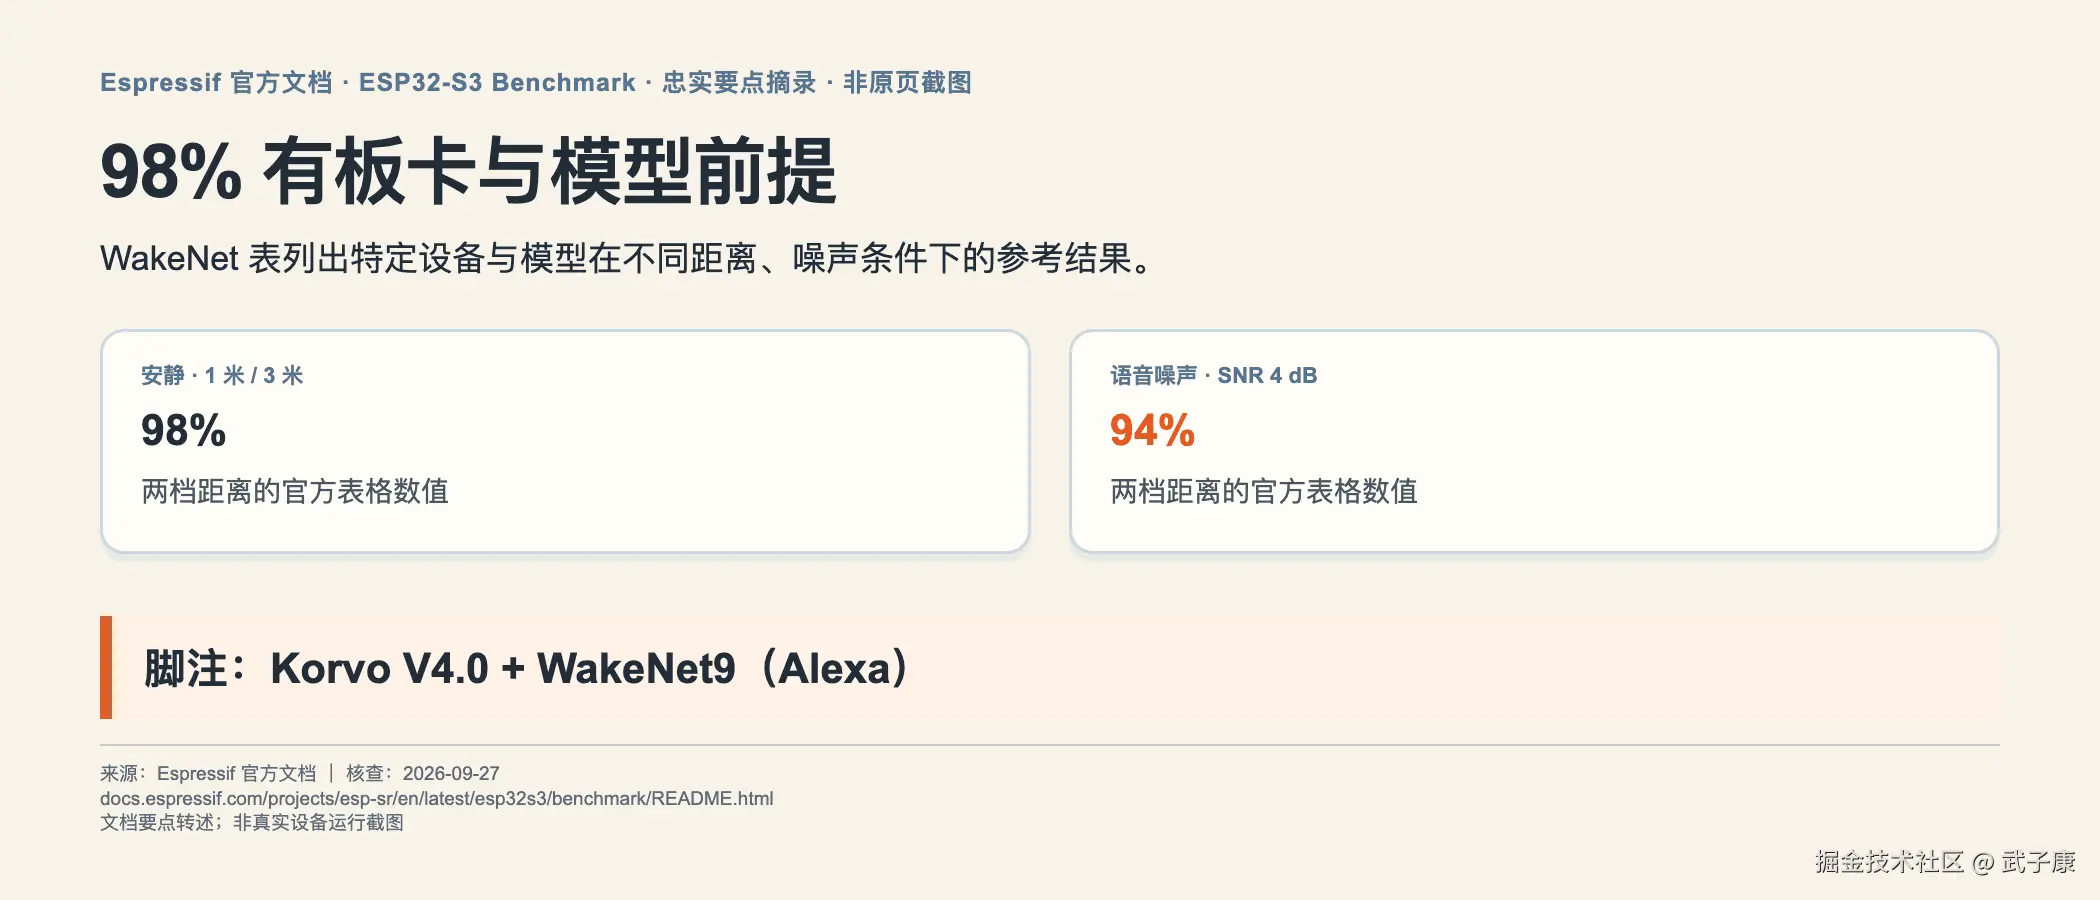
同一张官方 Benchmark 表,1 米和 3 米安静条件均列出 98%;语音噪声、SNR 4 dB 条件下两档距离均列出 94%。这不是"唤醒词在所有房间都能达到 98%"。开发板、模型、唤醒词、距离和噪声条件都属于结果的一部分。外壳开孔、麦克风指向、增益、固件版本与播放链路改变后,应重新测自己的设备。
另一个容易混淆的地方是:乐鑫的测试方法与结果页面也有百分比,但它单独描述测试房间、声源摆位与案例条件。不能从两页挑各自最高数字,拼成一次"官方综合测试"。读公开表时,先把设备/模型、声学条件、目标指标抄在数字旁边;缺一项就不要移植成产品承诺。
数字旁边的条件,决定它能回答多大的问题
引用公开结果时,将板卡、模型和条件写在数字旁边;产品验收对象是实际交付的设备组合。芯片型号相同不能替代输入一致,模型系列相同也不能替代唤醒词与配置一致。
假设同一开发板换了产品外壳,麦克风从正面改到侧面,测试人员仍站在设备正前方。与公开表之间已经多出结构和摆位差异。这时观察到较低唤醒比例,既不能证明公开数字不可信,也不能自动归因于新模型。需要先保存本机输入录音与配置,再安排一次只改变摆位或结构的对照。这里是假设案例,没有声学测量数据,因而不推断开孔到底造成了多少损失。
反方向也要谨慎:本机在少量安静样本上全中,不代表已经超过官方结果。你的样本可能只有一个熟悉设备的说话人,发音可能被反复练习,测试场景也可能更容易。没有相同样本与条件,两个比例就不是可直接排序的竞赛成绩。公开 Benchmark 可以帮助发现应该覆盖的维度,但不能替产品验收提供缺失的分母和失败样本。
三项指标,三种分母
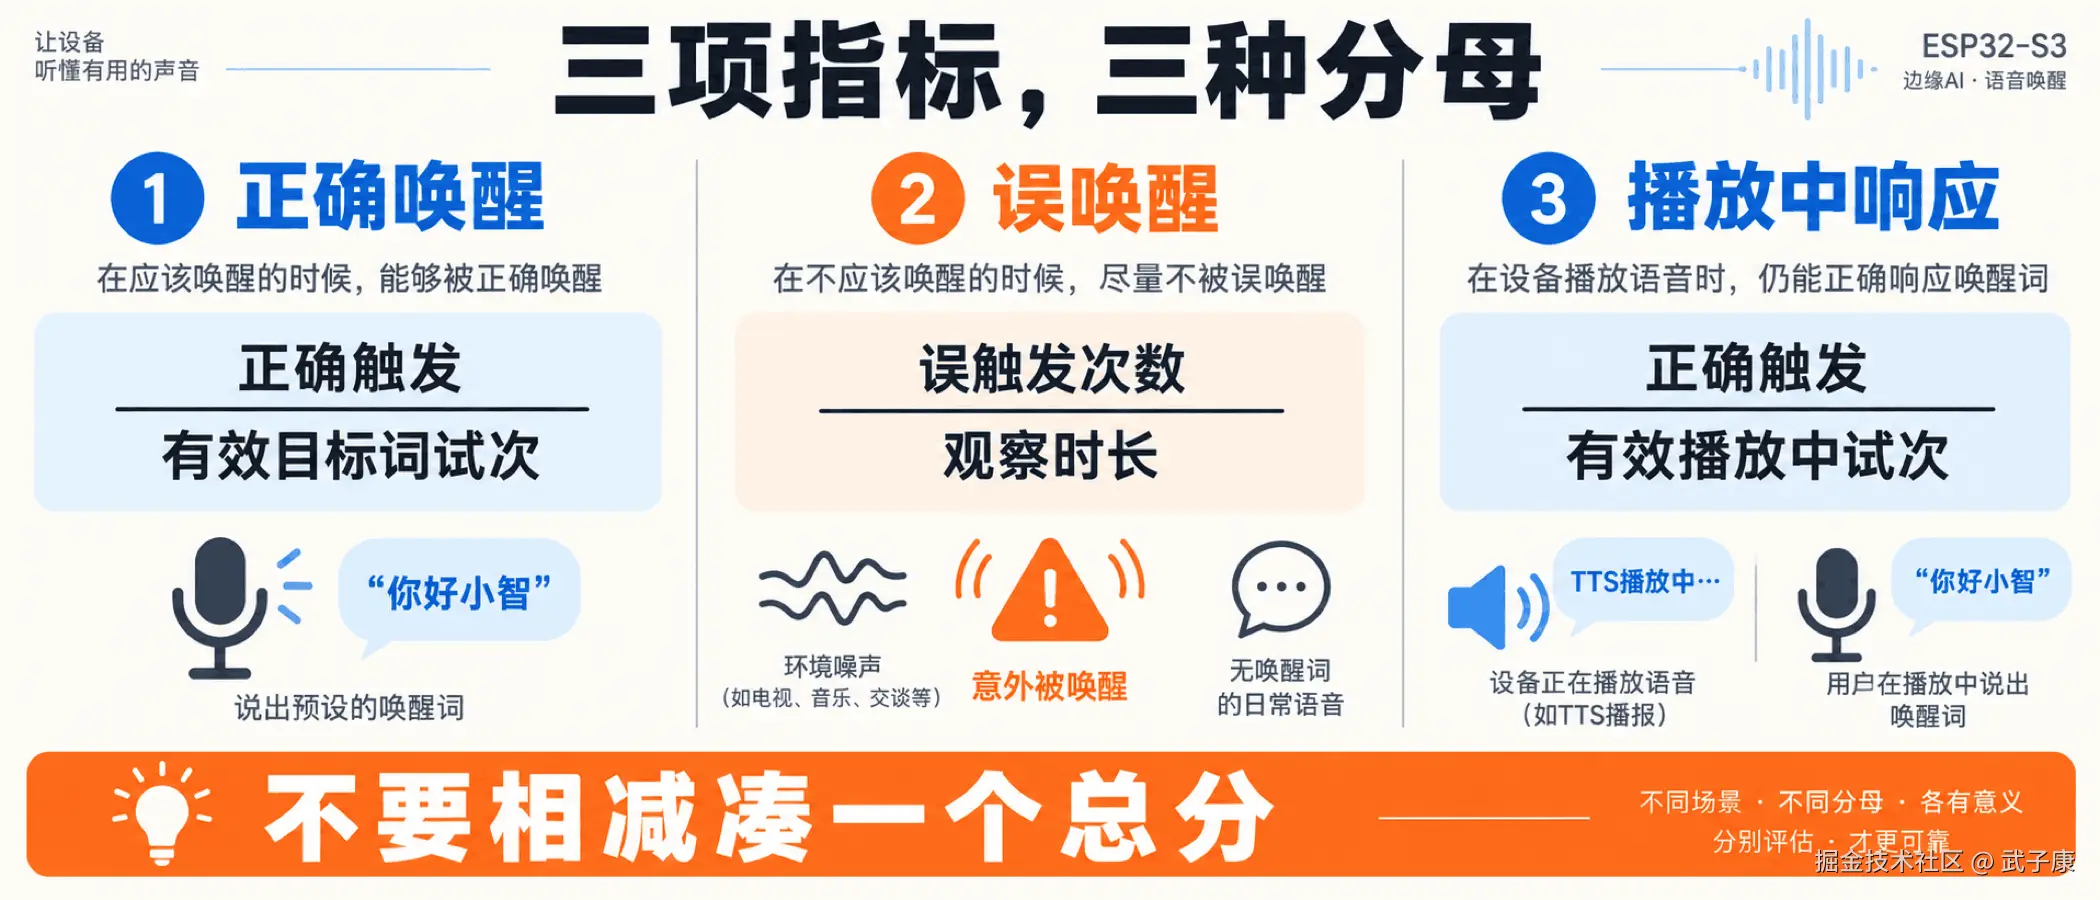
测试方法页面把目标词正确触发、非目标词误触发,以及音乐或 TTS 播放时的响应分开。它们解决的是不同问题,不能相减凑一个总分。
| 要回答的问题 | 建议报告口径 | 必须留下什么 |
|---|---|---|
| 说了目标词,设备醒了吗 | 正确触发试次 / 有效目标词试次 | 说话人、距离、音量、漏唤醒录音 |
| 没说目标词,设备会乱醒吗 | 观察时长内的误触发次数,附非目标语音场景 | 触发前录音、噪声或播放状态 |
| 设备播报时还能被唤醒吗 | 播放中正确触发试次 / 有效播放中试次 | 播放参考、麦克风输入、事件时间 |
这里的"观察时长内次数"是本文建议的产品报告口径,不冒称官方给出了统一的误唤醒频率标准。样本数和时长同样重要:十次全中与一千次测试后的比例,不应只写一个百分比。播放中测试要另列,因为设备自己的声音可能进入麦克风;这一项对带 AEC、需要播报时唤醒的产品尤其关键。它不等于上一篇 AEC 文章的播放参考排障,本篇只负责给 WakeNet 验收保留独立场景和分母。
一次触发事件,先判断它属于哪一格
假设设备播报时,用户说出目标唤醒词并成功唤醒。这次属于播放中的有效目标词试次。若设备仅仅因为自己的播报而唤醒,则属于没有目标词的误触发事件。两种情况都出现"WakeNet 触发",但产品体验和统计含义完全不同。必须通过目标词是否实际出现、播放状态和输入留样来分类,不能仅用事件日志汇总所有成功。
再假设用户连续说了三遍目标词,设备第三遍才响应。若计划里每遍都是独立试次,就应按预先约定的规则记录前两遍的结果;若计划里整段重复呼叫算一个交互,则应记录从第一次呼叫到响应的过程。两种口径都可以服务不同产品问题,但不能测试完之后才挑一个更好看的分母。试次的开始、结束和允许重复次数,应该在验收前说明。
误触发也要记录暴露条件。十分钟静默观察和十分钟播放新闻,不是在覆盖相同风险;二者都没有误触发,不能合并成"各种环境都不会乱醒"。报告中保留各自时长、内容和播放状态,才能解释没有观察到事件的范围。没有事件是一次有限观察结果,不是事件概率等于零。团队可以按真实使用方式加长观察或增加内容,但本文不为所有产品规定固定小时数。
缺失试次不能在统计时悄悄消失
测试中可能发生录音损坏、事件日志中断、播放设备未按计划启动。它们需要单列为无效或待判定,并注明原因。如果这些试次恰好都是失败,直接从分母里删除会让结果看起来更好;如果保留为有效又无法知道目标词有没有播出,比例也失去解释。应在实验计划里约定哪些证据构成有效试次,并保留全部排除记录,允许复查。
下面的小脚本直接输出命中、有效试次、漏检与无效试次,另算背景观察中的误触发频率。比较配置时仍需相同输入条件,并逐个标记改善和退化的样本;显示更多小数位不能弥补小分母。
先用构造标注验证计数,再换成设备留样
将下面代码保存为 wake_denominators.py,使用 Python 3.10 或更新版本运行 python3 wake_denominators.py。不需要板卡、音频、模型文件或安装依赖。它计算人工标注记录的分母和背景频率,没有运行 WakeNet,没有测 ESP32 唤醒准确率。输入中的 quiet、playback、事件次数与背景秒数全部为构造值,用来暴露统计口径错误。
Trial 只代表已经确认目标词出现的一次试次,triggers 是按预先定义的响应窗口归属到该试次的事件数。一次试次有两个事件也只算一次命中,多出的事件单列 extra_triggers,不能把 3 个试次的 3 次触发就写成 100%:构造 quiet 数据里,一次漏检、一次单触发、一次双触发,正确口径是 2/3。重复事件可能影响用户体验,但不改变"该试次至少正确触发一次"的预定问题。
Background 则代表人工确认没有目标词、日志完整且互不重叠的一段观察。它不进入目标词分母,只统计误触发次数和有效秒数。这里的 FA/hour 是次数乘 3600 再除以暴露秒数;它是事件频率,不是误触发概率,也不能与目标命中百分比相减。如果一次事件经确认与另一段重复,须在标注层按原事件身份去重;脚本的 id 检查只避免同一条记录重复入表,不替代声学事件去重。
invalid_reason 非空时,记录留在输入中,但目标试次不进入有效分母,背景记录也不贡献时长或事件。排除必须来自事先约定的证据缺失标准:例如音频损坏、事件日志断档、播放未启动。零触发本身不是排除理由;q2、p2 都以有效漏检保留。真实接入时还要审查无效原因,不能让人工标注成为删除失败样本的开关。
python
"""Constructed annotations only; never invokes WakeNet or reads a microphone."""
from dataclasses import dataclass


@dataclass(frozen=True)
class Trial:
    id: str
    scene: str
    triggers: int
    invalid_reason: str = ""


@dataclass(frozen=True)
class Background:
    id: str
    scene: str
    seconds: int
    triggers: int
    invalid_reason: str = ""


def summarize(trials, backgrounds):
    totals, seen = {}, set()
    for row in [*trials, *backgrounds]:
        if row.id in seen or not row.id or not row.scene:
            raise ValueError("missing or duplicate identity")
        seen.add(row.id)
        if type(row.triggers) is not int or row.triggers < 0:
            raise ValueError("trigger count must be a nonnegative integer")
        s = totals.setdefault(row.scene, dict(valid=0, hits=0, extra=0,
                              invalid_trials=0, seconds=0, false_alarms=0,
                              invalid_backgrounds=0))
        if isinstance(row, Trial):
            if row.invalid_reason:
                s["invalid_trials"] += 1
            else:
                s["valid"] += 1
                s["hits"] += int(row.triggers > 0)
                s["extra"] += max(row.triggers - 1, 0)
        else:
            if row.invalid_reason:
                s["invalid_backgrounds"] += 1
            elif type(row.seconds) is not int or row.seconds <= 0:
                raise ValueError("valid background requires positive seconds")
            else:
                s["seconds"] += row.seconds
                s["false_alarms"] += row.triggers
    return totals


def main():
    # shortcut: target/absence labels and event-window assignments are trusted;
    # audit recordings and annotation rules before using real device records.
    trials = [Trial("q1", "quiet", 1), Trial("q2", "quiet", 0),
              Trial("q3", "quiet", 2), Trial("q4", "quiet", 0, "audio missing"),
              Trial("p1", "playback", 1), Trial("p2", "playback", 0),
              Trial("p3", "playback", 0, "playback did not start")]
    backgrounds = [Background("b1", "quiet", 3600, 1),
                   Background("b2", "playback", 1800, 2),
                   Background("b3", "playback", 300, 0, "event log gap")]
    result = summarize(trials, backgrounds)
    q, p = result["quiet"], result["playback"]
    assert (q["hits"], q["valid"], q["extra"], q["invalid_trials"]) == (2, 3, 1, 1)
    assert (p["hits"], p["valid"], p["seconds"], p["false_alarms"]) == (1, 2, 1800, 2)
    assert p["invalid_backgrounds"] == 1
    assert summarize([], []) == {}
    assert summarize([Trial("empty", "empty", 0, "audio missing")], [])["empty"]["valid"] == 0
    for bad_trials, bad_backgrounds in [
        ([Trial("dup", "quiet", 1), Trial("dup", "quiet", 0)], []),
        ([Trial("negative", "quiet", -1)], []),
        ([], [Background("zero", "quiet", 0, 1)]),
    ]:
        try:
            summarize(bad_trials, bad_backgrounds)
        except ValueError:
            continue
        raise AssertionError("invalid input was accepted")
    for scene, s in sorted(result.items()):
        rate = f'{s["hits"] / s["valid"]:.2%}' if s["valid"] else "n/a"
        fa = f'{s["false_alarms"] * 3600 / s["seconds"]:.2f}' if s["seconds"] else "n/a"
        print(f'CONSTRUCTED {scene}: hits={s["hits"]}/{s["valid"]} ({rate}), '
              f'misses={s["valid"] - s["hits"]}, extra_triggers={s["extra"]}, '
              f'invalid_trials={s["invalid_trials"]}')
        print(f'CONSTRUCTED {scene}: false_alarms={s["false_alarms"]}, '
              f'background_seconds={s["seconds"]}, FA/hour={fa}, '
              f'invalid_backgrounds={s["invalid_backgrounds"]}')
    print("PASS count, exclusions, duplicates, empty and invalid-input checks")


if __name__ == "__main__":
    main()
本次在 Python 3.11.6、macOS arm64 环境执行,退出码为 0;实际标准输出如下。CONSTRUCTED 前缀标明这是计数例,不是设备性能测试报告。
text
CONSTRUCTED playback: hits=1/2 (50.00%), misses=1, extra_triggers=0, invalid_trials=1
CONSTRUCTED playback: false_alarms=2, background_seconds=1800, FA/hour=4.00, invalid_backgrounds=1
CONSTRUCTED quiet: hits=2/3 (66.67%), misses=1, extra_triggers=1, invalid_trials=1
CONSTRUCTED quiet: false_alarms=1, background_seconds=3600, FA/hour=1.00, invalid_backgrounds=0
PASS count, exclusions, duplicates, empty and invalid-input checks
quiet 输出 2 个命中、3 个有效目标试次和 1 个漏检;另有 1 个无效试次,因此原计划目标试次共 4 个。双触发作为 1 次额外事件单列,既未增加命中数,也没有隐藏重复响应。playback 的有效目标试次另算为 1/2,不能借 quiet 的命中改善播放场景数字。脚本中的百分比只演示除法和显示精度,不对任何设备给出通过判定。
背景 quiet 为 3600 秒内 1 次误触发,即 1 次/小时;playback 为 1800 秒内 2 次,即 4 次/小时。另有 300 秒播放背景日志断档,被记录为无效背景,没有偷偷把观察时长扩成 2100 秒来稀释频率。若两段完整、同场景且互不重叠的观察合并,先累计事件与秒数再计算频率,不能对不同时长的每小时数直接取算术平均。
自检同时覆盖空输入、全无效目标试次、重复记录 ID、负事件数和零背景时长。空分母只能报告 n/a,不能输出 0% 或 100%;重复 ID 与不合法计数会被拒绝。构造输入并没有验证目标词标签、窗口归属和观察时长真实性,这些前提必须回到录音、事件时间与测试日志人工核对。脚本也不提供置信区间、跨说话人加权、跨配置比较或产品统一合格线。
使用真实记录前,先把板卡、模型、配置 SHA 和场景定义冻结,再将目标试次与连续无目标背景分别标注。不同固件、不同唤醒词或不同播放内容不应仅因 scene 名称相同就合并;这个例子只处理一个冻结配置,每个场景内部假定条件一致。保留输入原记录和排除原因,输出才可以追溯;此时本地算术检查仍只是报告工具正确性的证据,真实性能结论来自现场样本而非脚本自检。
先固定声学条件,再比较模型或阈值
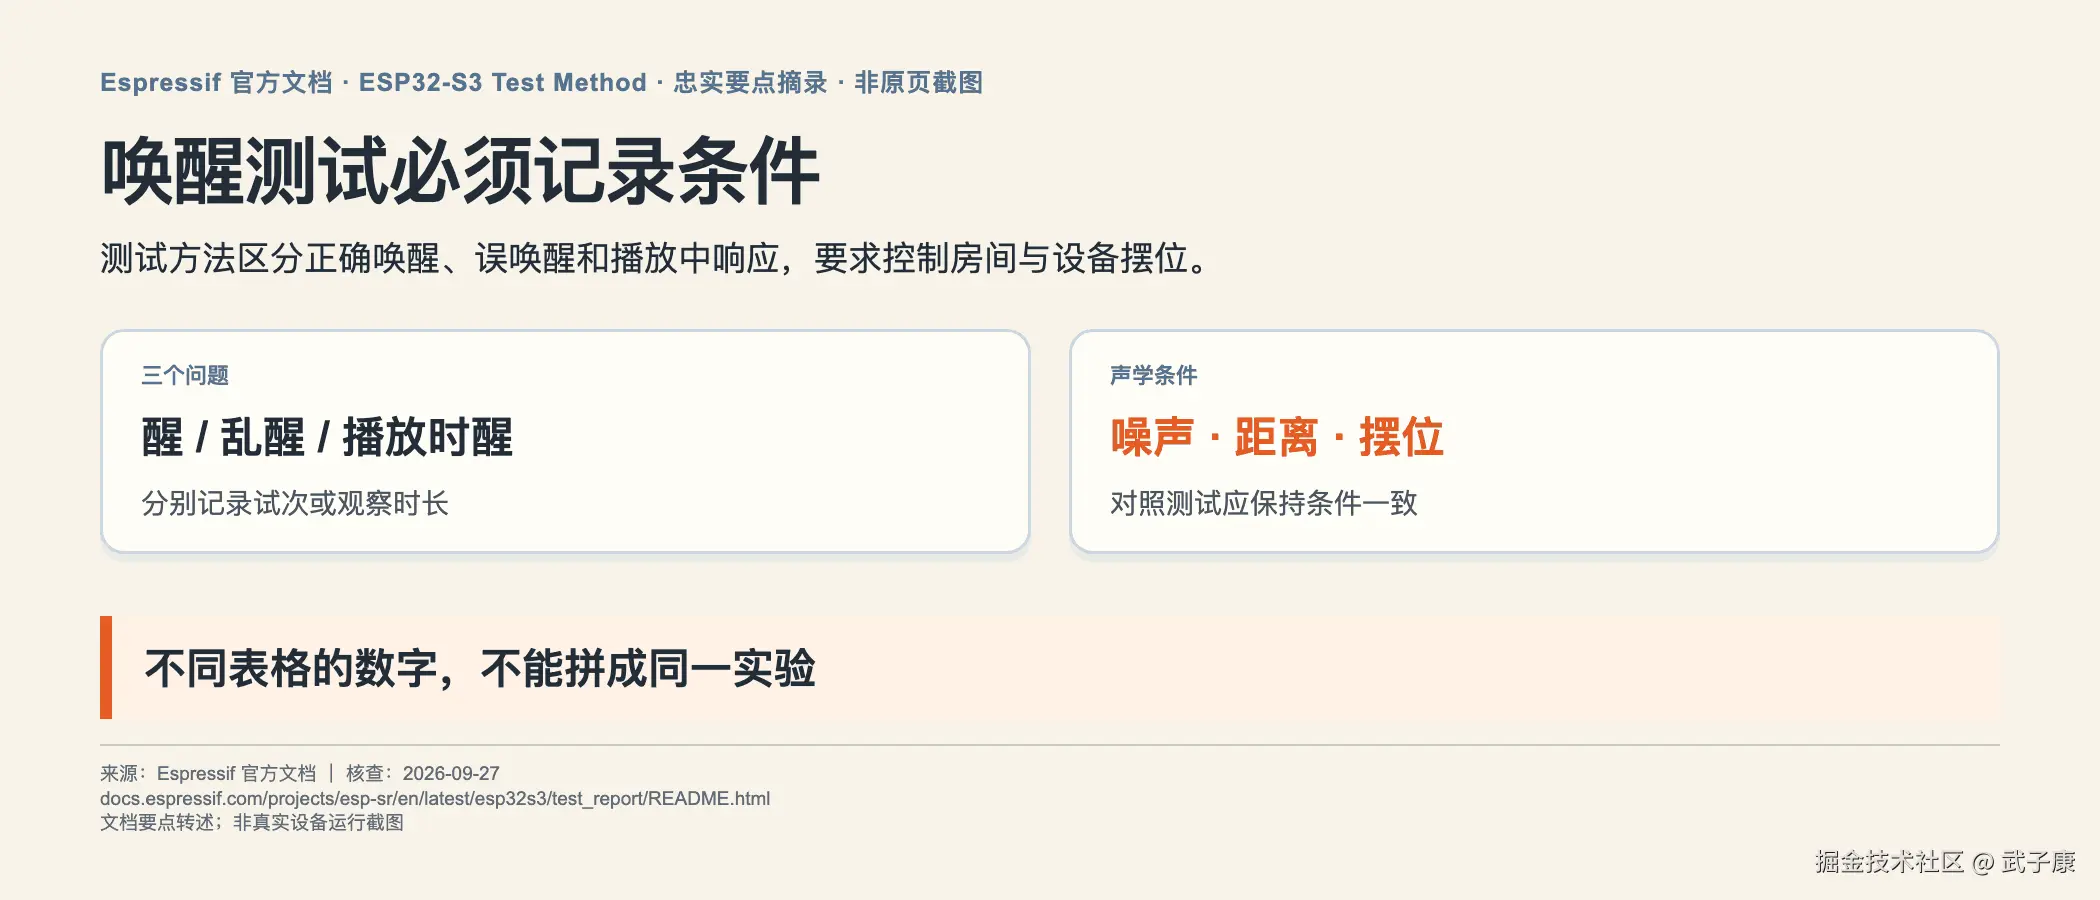
官方测试方法要求控制房间、背景噪声、混响以及设备和声源摆位;它建议根据产品场景安排白噪声、人声、音乐、新闻等类型与不同声压、SNR。若两次测试换了房间或摆位,却只比较唤醒率,差异无法归因于模型设置。没有声学测量条件时,也要如实标记"未量化",不能把主观的"安静房间"说成官方测试环境。
WakeNet 模型说明还指出:连续流中的若干帧识别结果会被平滑,平滑值超过设定阈值才触发;检测结果通过 AFE fetch 返回。因此一次"没亮灯"不够定位:先确认输入音频与模型启用状态,再查 AFE 是否给出唤醒事件,最后查应用是否消费了事件。降低阈值可能减少漏唤醒,也可能增加误唤醒;这是基于触发机制的工程推导,需要用同一批输入、同一声学条件同时测两项,本文没有测过任何具体阈值。
同一段声音回放与真人呼叫,各有用途
固定录音回放适合做配置之间的对照:每次尽量给设备相同的内容,让开发者观察阈值、模型或应用状态改变之后的响应。但是回放声源不等于真人,扬声器和房间共同影响最终麦克风输入,不能把回放通过直接写成所有用户通过。真人呼叫更接近真实使用,输入差异又更大。可以将两类结果分表保存,用回放帮助定位,用真人样本检查交互覆盖。
对照中最重要的是实际进入设备的声音。音源文件不变,设备位置、播放音量或外壳位置变了,麦克风端输入仍会变化。若没有仪器测量声压与混响,可以记录相对位置、播放设置和设备摆放,并明确未量化。这样的记录虽然不满足某套专业声学实验条件,仍比只写"同一个房间"更容易重现;同时它不能冒充官方测试房间的复现证据。
假设调整阈值后,安静场景漏唤醒变少,新闻播放时误触发变多。这是产品取舍的信号,不是简单的通过或不通过。床头设备可能特别在意夜间无故回应,车间终端可能更在意工人叫了没有响应。验收表应分别展示变化,由产品负责人按场景代价决定是否接受,而不能把两类错误相抵后只交一个总分。本文没有目标产品的业务约束,因此不替团队选择阈值。
先排除事件交接故障,再用阈值解释模型
"设备没响应"可能包含多层:输入没有进入 AFE、WakeNet 处于禁用状态、AFE 未给事件、应用未消费事件、应用消费后 UI 或业务没有执行。一个可复查的轮次至少记录输入留样、检测事件和业务响应。若 AFE 已经给出唤醒而业务没有响应,这次首先是事件交接问题,调低模型阈值无法修复丢失的业务通知。
唤醒后暂时禁用检测的产品还应测试恢复路径。上轮结束、用户取消、服务超时之后,检测是否重新进入预期状态?若只测刚开机的首次呼叫,可能完全覆盖不到后续轮次。这个检查属于应用状态设计,不是本文声称 WakeNet 有恢复缺陷。通过事件和状态记录确认每轮检测窗口,能够把连续使用中的漏响应与纯声学漏检测分开。
一张可以真正执行的本机验收表
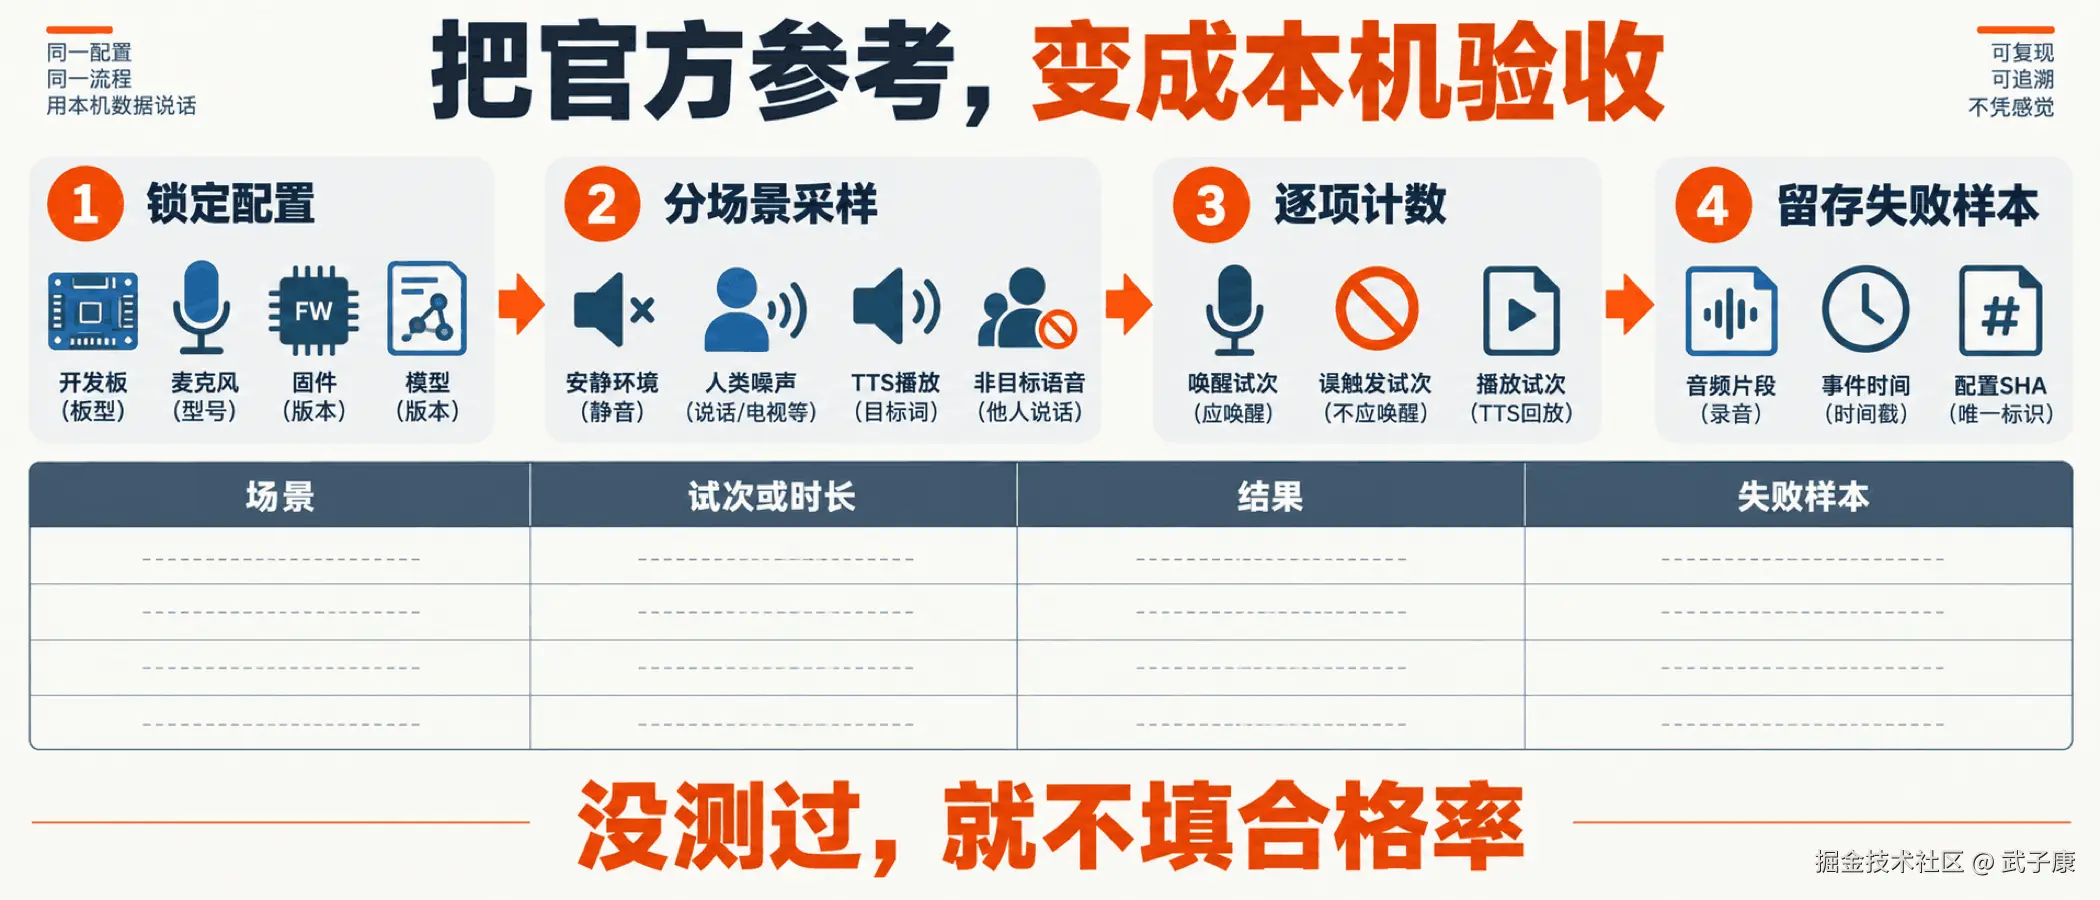
测试前,先冻结板型、麦克风与外壳、固件 SHA、ESP-SR/WakeNet 模型、唤醒词和 AFE 配置。之后按产品用途建立至少四类场景:安静近/远场、有人说话的噪声、设备播放 TTS 或音乐、长时间没有人说目标唤醒词。每格记录距离、声压或 SNR、声源和设备摆位、试次或观察时长;每个失败样本保存输入音频、AFE 事件时间与当次配置。更换麦克风位置或模型版本后,新结果另起一行,不能接着累加旧分母。
这份表只给记录方法,不替产品定义统一合格线。床头设备、车间终端和持续播报的设备,对漏唤醒与误唤醒的代价不同;团队应先决定各场景能接受多少失败、观察多久,再按固定流程测试。若产品还要求"唤醒后立刻说命令",应另测首句完整性,不把 VAD 缓存或 ASR 错误混进 WakeNet 的唤醒次数。
最终汇报要分两层写:官方表报告了特定板卡与模型在其条件下的参考结果;你的验收结论,只能来自你自己的设备、场景、分母和失败样本。本文依据 2026-09-27 核查、2026-10-13 复核的乐鑫公开文档提出测试设计,没有运行 ESP32-S3、WakeNet 或声学实验。
从产品场景倒推样本,而不是从最高分倒推场景
先描述设备被如何使用:放在哪里、用户从哪些方向说话、是否经常播放声音、是否连续联网工作。然后把这些描述转换成可观察场景。桌面设备可以覆盖坐姿和站姿的距离变化;带屏设备可以覆盖用户面对屏幕或转头说话;播放设备可以覆盖不同播报内容。这里举的是场景设计思路,不给这些场景赋予不存在的成功率。
说话人也需要变化。只使用研发人员自己的声音,会把熟悉唤醒词和使用方式的优势留在样本里。可以按实际用户范围邀请不同音量、语速和口音的说话人,并对每位参与者使用相同提示。若只是内部小样本探索,报告就写小样本探索,不把它称为用户总体评估。样本覆盖范围直接限制结论范围,这个限制比一个看起来精确的比例更值得保留。
验收前写清业务响应的判定窗口。目标词出现后,多久内的事件算此次响应?迟来的事件如何归属下一轮?设备正在工作时再次被叫是否应该响应?没有这些约定,同一录音可能被不同测试人员判为不同结果。窗口值要由产品交互需求与实现能力共同决定,本文只要求明确它,不设置一个脱离场景的通用毫秒数。
失败留样要能引导下一次修改
每个漏唤醒样本应留下目标词输入和状态证据。若声音在采集端已明显不完整,优先检查硬件或采集;若输入完整且检测窗口正确,再比较模型与阈值;若事件已出现而业务无动作,则移交应用交接排障。误唤醒样本则保存触发前内容和播放状态,判断触发来自非目标说话、环境声音还是自播内容。这些分类把失败转为下一步任务,避免所有问题最后都落在"模型再调一下"。
修改后保留原失败样本,做定向回归,同时复查可能受影响的反向指标。例如为减少漏唤醒降低阈值,就需要重看非目标内容;为抑制播放误触发加强处理,就需要重看播放中目标词响应。只回放已经成功的样本会让验收失去发现退化的能力。若输入链路发生变化,旧回放与新真人测试应各自保留标签,不能把它们混成一次相同条件实验。
结论绑定具体板型、外壳、模型、配置和样本;未覆盖的方位、播放内容与长期观察时长列为待测。按每格结果决定哪些配置暂时冻结、哪些场景继续改善,不把总体百分比替代尚无证据的风险。
复测还有一个容易忽略的约束:测试者已经知道失败内容后,可能不自觉地放慢语速、靠近设备或提高音量。若修复前后换了说法,就难以区分是实现改善还是输入变容易。回归时保持原留样,并将新采集的真人样本另列。对无法精确重放的自然说话,可以明确记录它属于补充观察,不与原始对照合并。
团队协作时,可以让一人组织输入,另一人依据录音与事件判断结果,先固定判定规则,再看配置名称。这不是要求复杂评测平台,而是减少知道哪个配置较新之后产生的主观偏好。如果人工判断仍有争议,就保留原始证据与争议原因,重新测试该样本。把争议直接记成成功,只会使后续交付阶段难以解释同一种现场投诉。
若产品有多个唤醒词,也应按词分别记录。某个容易发音的词表现较好,不能替另一个短词通过验收;聚合结果可以用于概览,逐词记录仍是定位依据。各项场景最终都对应实际用户行为,让每个百分比有明确对象,才有资格进入产品交付文档。