文章目录
- [1 -> 引言](#1 -> 引言)
- [2 -> 先区分规则、事实和历史记录](#2 -> 先区分规则、事实和历史记录)
- [3 -> Skill 的描述,其实承担了路由工作](#3 -> Skill 的描述,其实承担了路由工作)
- [4 -> 一个最小的按需加载实验](#4 -> 一个最小的按需加载实验)
- [5 -> 精简前后,究竟应该比较什么](#5 -> 精简前后,究竟应该比较什么)
- [6 -> 上下文也需要维护生命周期](#6 -> 上下文也需要维护生命周期)
1 -> 引言
刚开始使用编程助手时,项目里的规则通常很短:遵循现有风格,修改后运行测试,不要动无关文件。遇到一次问题,就补上一条要求;又出现一次遗漏,再加一段说明。几个月后,规则文件已经像一本内部手册,旁边还挂着几十个 Skill 和大量历史文档。
这时会出现一个令人困惑的现象:准备的资料更多了,AI 却未必更好用。改一个显示文案,也要先读架构、部署和数据库说明;处理简单查询,却被引导进入完整迁移流程。有时它还会引用早已失效的约定,因为旧规则一直没有移除。
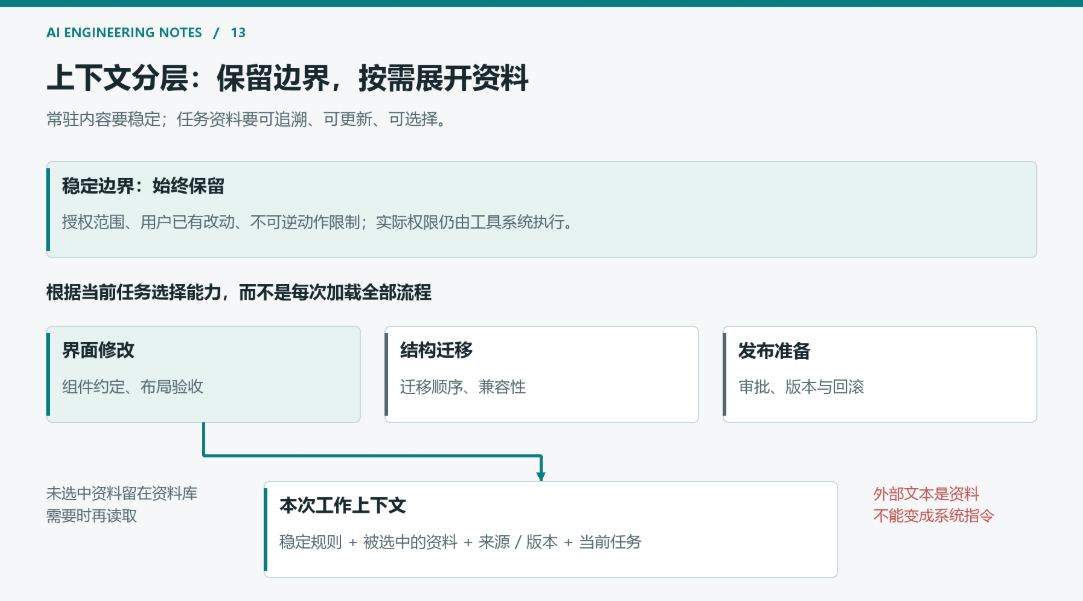
问题通常不在于文档多,而在于系统没有分清:什么必须一直生效,什么只在特定任务出现时加载,什么已经不能继续作为事实依据。上下文管理的目标,是在恰当的时候提供恰当的信息,同时让授权、来源和版本保持清楚。
2 -> 先区分规则、事实和历史记录
把所有内容都塞进同一份文件,最直接的后果是不同性质的信息混在一起。"不得上传客户数据"是行为边界;"服务监听 8080 端口"是可能变更的项目事实;"上周尝试过某种方案"是历史记录。三者的有效期、可信来源和冲突处理方式都不同。
长期规则适合简短、稳定,并与权限系统一致。项目事实最好能够追溯到配置或代码,不要仅靠一段人工维护的说明。历史记录值得保存,但不应该自动变成下一次任务的执行指令。
例如,过去某次为了排查问题临时关闭缓存,这条记录可以帮助理解当时的分析,却不能说明今后的每次任务都需要关闭缓存。把"当时做过"误当成"以后必须做",是上下文逐渐变重的常见来源。
对于业务结论也一样。一次客户访谈中的偏好,不能直接升级成全部客户的共同需求。将记录标注为"观察""假设""已确认决策",比把它们全部整理成语气确定的知识条目更有帮助。
一个简单分类就能显著降低混淆:
| 内容 | 适合放在哪里 | 维护重点 |
|---|---|---|
| 授权边界、不可逆动作限制 | 稳定规则与工具权限配置 | 不因追求速度而删除 |
| 目录结构、运行命令 | 项目入口文档 | 与当前代码核对 |
| 迁移、发布等专门流程 | 对应 Skill 或流程文档 | 明确触发条件 |
| 某次任务的目标和约束 | 当前任务说明 | 本次任务结束后归档 |
| 失败案例、讨论过程 | 可检索的历史记录 | 保留日期和适用背景 |
这不是规定所有项目都必须拥有五套系统。小项目可以只有几个文件,关键是内容的身份和作用要清晰。
3 -> Skill 的描述,其实承担了路由工作
OpenAI 在 2026 年 9 月的上下文与 Skill 指南中,讨论了描述过长和触发范围过宽的问题。一条"涉及数据库时使用"的说明,可能把查询解释、字段命名和迁移上线都送进同一条复杂流程。
更合适的描述应该告诉系统:这个能力处理什么,以及什么时候不需要它。例如,"创建数据库迁移并评估回滚步骤"比"处理所有数据库相关工作"更容易限定范围。
这种设计背后是按需展开:先让模型知道有哪些能力,再在任务匹配时读取具体步骤,必要时继续访问参考资料。官方的 Skills 说明介绍了由说明文件和配套资源组织可复用工作流的方式。实际路径与加载机制应以当前工具文档为准,不同客户端不能简单照搬。
需要注意,路由描述并不是安全控制。把"涉及生产环境先询问"写进 Markdown,有助于表达意图,但不能取代数据库只读账户、沙箱、网络限制和审批接口。真正的权限要由工具和系统执行,不能只靠模型每次自觉记住。
描述也需要负例。如果一个 Skill 适用于修改数据库结构,就应该明确普通 SQL 解释不一定需要它。只有正例没有负例的规则,很容易随着任务类型增加而不断扩大适用范围。
4 -> 一个最小的按需加载实验
下面用三个小型文档模拟项目上下文。它不实现真实的 Skill 自动发现,也不通过关键词猜测任务类型,而是让调用方显式声明本次需要哪类资料。这样可以把实验限定在一个问题上:加载哪些内容,由谁决定,缺失时如何失败。
示例使用 Python 3.10 及以上版本和标准库,只在内存中工作。输出的字符数只是可读规模,不是 Token 数,更不是模型成本实测。
python
from dataclasses import dataclass


@dataclass(frozen=True)
class Source:
    name: str
    revision: str
    body: str


BASE = Source(
    "boundaries", "r1",
    "Preserve user changes. Do not publish or delete production data."
)
DOCS = {
    "ui": Source("ui", "r2", "Use existing UI components and verify layout."),
    "schema": Source(
        "schema", "r3",
        "Check migration order, compatibility and rollback limits."
    ),
    "release": Source(
        "release", "r4",
        "Verify release approval, artifact version and rollback evidence."
    ),
}


def build_context(required, expected_revisions):
    selected = [BASE]
    for name in sorted(set(required)):
        if name not in DOCS:
            raise ValueError(f"missing context: {name}")
        source = DOCS[name]
        if expected_revisions.get(name) != source.revision:
            raise ValueError(f"revision mismatch: {name}")
        selected.append(source)
    return "\n\n".join(
        f"[{s.name}@{s.revision}]\n{s.body}" for s in selected
    )


all_docs = build_context(DOCS.keys(), {
    name: source.revision for name, source in DOCS.items()
})
ui_only = build_context(["ui"], {"ui": "r2"})
assert "[schema@" not in ui_only
assert "[boundaries@r1]" in ui_only

try:
    build_context(["schema"], {"schema": "r2"})
except ValueError as exc:
    print("blocked:", exc)
else:
    raise AssertionError("stale revision should be blocked")

print("all-doc characters:", len(all_docs))
print("task-context characters:", len(ui_only))
print(ui_only)
这里演示了三个小原则:稳定边界始终存在;专门资料只在声明需要时加载;版本不匹配时不能装作已经拿到了正确背景。
实际项目可以让模型辅助判断需要哪些资料,但加载记录仍应保留。排查一次错误时,知道"模型看过什么版本、没有看过什么",比猜测它为什么误解更有用。
这段代码不会检查文档里的提示注入,也不会解决真实的权限隔离。外部网页、用户上传文件和工具返回内容应作为资料处理,不能因为被放进上下文,就获得修改系统规则的权力。
5 -> 精简前后,究竟应该比较什么
如果只比较提示词长度,实验很容易得到一个没有意义的结论:删得越多,字符越少。但我们真正关心的是任务是否被正确完成,以及为了完成任务付出了多少人力和资源。
可以准备一组固定任务,包含简单文案修改、普通代码修复、数据库结构变更和发布准备。每个任务都先写验收条件,再分别使用原配置和精简配置执行。保持模型版本、工具权限和运行环境一致,避免把其他变化误当成上下文优化的结果。
至少记录四类结果:任务通过率、人工澄清次数、耗时与实际计费量、遗漏边界的次数。对于高风险动作,越权行为应单独统计,不能被更快的完成速度抵消。
每种配置最好重复运行多次。模型输出存在波动,一次成功不能证明新配置更可靠。还应检查失败样本:精简版可能在简单任务上更快,却在跨模块变更中漏掉关键约定。
因此,优化不是一场"尽可能删除"的比赛。有些资料需要缩短,有些需要更准确的触发条件,还有些应该保留原文,只在必要时读取。对实际 Token 数的测量,应使用对应模型的计数工具或请求用量;不能用中文字符数除以某个固定常数当成准确账单。
具体精简时,可以先做一次规则审计,而不是立刻删除。把每条要求关联到它曾经防止的错误,再观察它是否仍在适用。如果一条规则只是某次临时环境故障的补丁,就应转成带条件的故障说明;如果它描述的是稳定的授权边界,则应该保留。
例如,"每次修改都必须运行完整构建"可能来自一次漏掉资源文件的事故。后续更准确的规则可以区分文档修改、局部函数调整和打包配置变更,再为不同改动安排验证范围。这里的目标不是少做检查,而是让检查与风险相匹配,并保留影响公共行为时扩大验证的条件。
又如,一个 Skill 的适用描述同时包含"任何问题都要调用"和"只有部署时调用",模型需要在矛盾指令之间猜测。应由维护者先消除冲突,不能期待模型每次自行推断哪句话才代表真正意图。类似矛盾越多,额外 Token 消耗只是表面,反复澄清和任务中断才是更直接的成本。
对精简后的配置,可以采用渐进替换:先用于低风险任务,观察新的失败类型,再逐步扩大。保留旧配置与改动理由,出现退化时能够准确定位到哪条规则变化。没有对照版本,团队很容易陷入"最近好像变笨了"的主观讨论,而无法区分模型变化、资料过期和配置修改带来的影响。
6 -> 上下文也需要维护生命周期
资料长期不更新,比资料少更危险。错误背景会让模型沿着一条看起来合理的路线工作,直到交付时才暴露问题。
一个可持续的方法,是为关键文档标注负责人、适用范围和最后核对时间。修改架构、运行命令或发布方式时,同步更新相关入口。发现某段历史说明已经过时,可以归档并加上失效原因,而不是让新旧版本继续并列出现。
决策记录值得保留"为什么"。仅保存最后选择的方案,下一次讨论时又会重新探索已经排除的路线;同时保存当时的约束与反例,模型才有机会判断旧结论现在是否仍成立。
但"值得记录"不代表"所有原始内容都应该无限期保存"。涉及客户信息、内部凭证和敏感沟通时,应遵守最小必要原则,明确访问范围和保存期限。知识库不是绕过权限的通道。
上下文质量最终体现为一种具体体验:做简单任务时不会被无关流程拖住,做复杂任务时又能找到真正需要的背景。文档数量和提示词长度都只是表象,能否正确选择、核对和使用资料,才决定这些文字是否有价值。
感谢各位大佬支持!!!
互三啦!!!