SpringBoot3+Vue3 企业 AI 工作流:Tinyflow 画布、LLM 节点与在线试跑怎么落地
🌐 文档地址 :https://ruoyioffice.com
👇👇👇 文章底部获取源码和演示地址 👇👇👇
💬 :17156169080(获取产品咨询)
很多 AI 工作流演示止步于"把几个方块连起来"。真正进入企业系统后,还要回答:画布怎样保存、模型密钥放在哪里、开始节点参数怎样校验、后端如何执行、谁能试跑、运行失败如何审计,以及这条流程能不能稳定提供给业务系统调用。
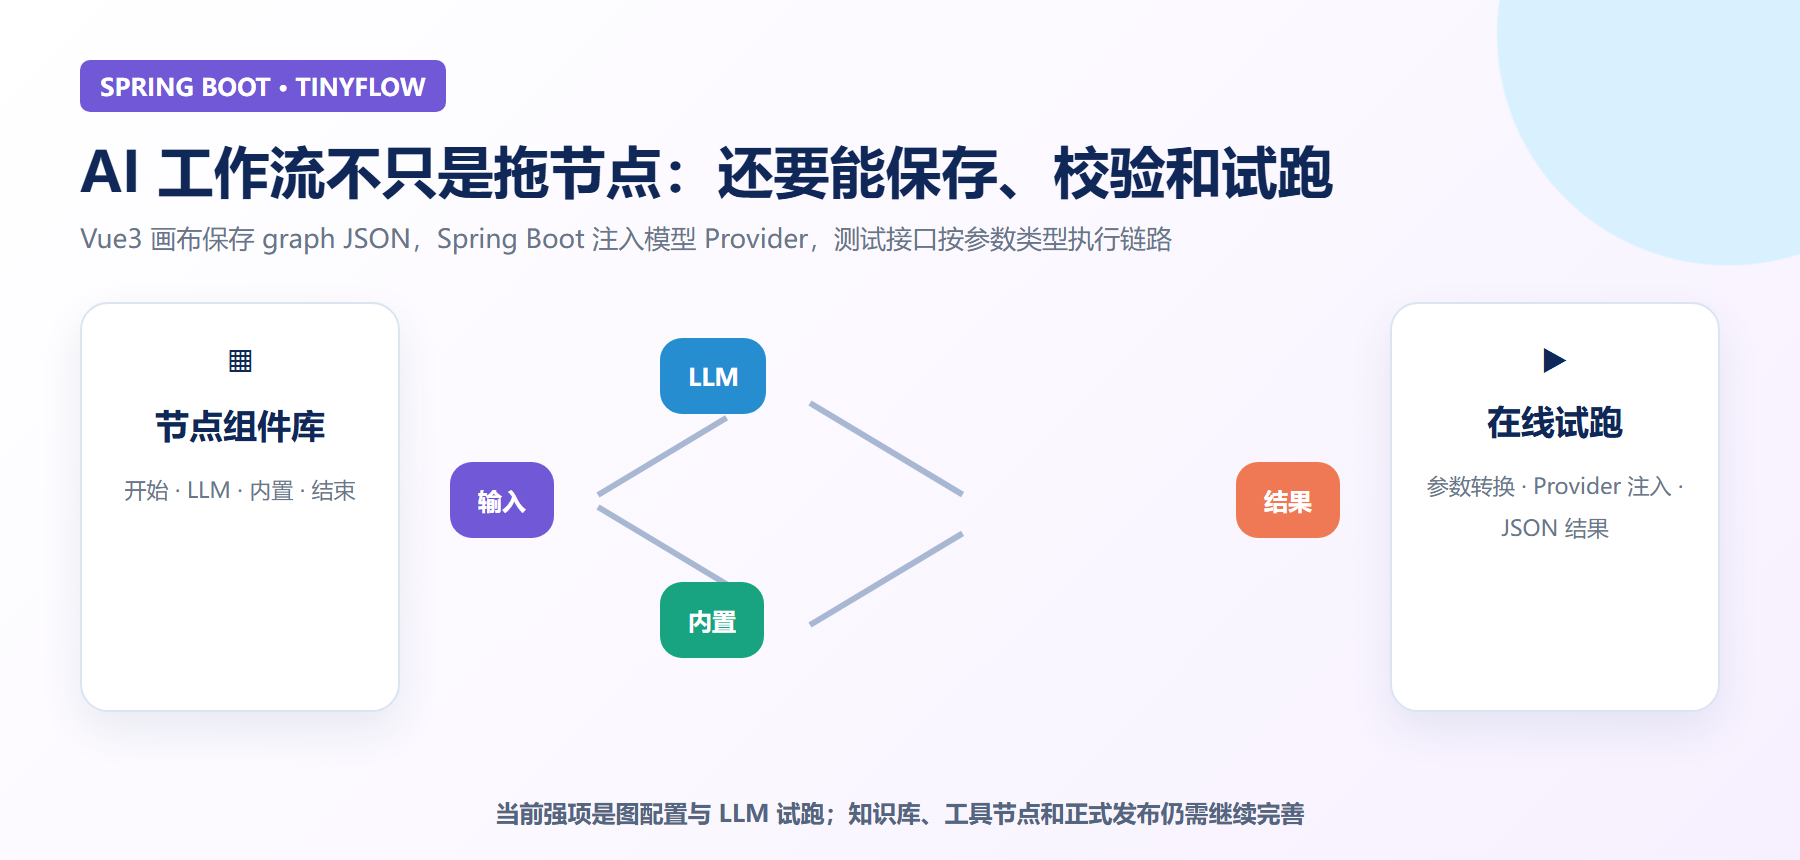
▲ 当前链路完成了图配置、LLM Provider 注入与在线试跑;知识库、工具和正式发布仍需继续闭环
引言:拖拽画布只是 AI 工作流最表面的一层
把一次大模型调用写在 Controller 里并不难:
- 接收 Prompt;
- 调用模型;
- 返回文本。
但企业场景很快会要求更多能力:
- 输入不止一个字符串,而是订单、客户、语言、金额等结构化参数;
- 一个任务需要先提取、再判断、最后生成;
- 业务人员希望调整 Prompt,而不是每次找研发改代码;
- 不同流程选择不同模型;
- 测试时要看到输入和结果;
- 正式运行要有版本、权限、超时、重试与审计。
这时,工作流的本质就不再是"几个节点",而是一个可保存的图模型 + 可执行的运行时 + 可治理的发布体系。
本文基于现有实现,重点拆解已经落地的前两部分:
- Vue3 + Tinyflow 负责编辑和序列化图;
- Spring Boot + Tinyflow Core 负责解析并执行;
- 模型中心负责根据
modelId注入 LLM Provider; - 测试抽屉负责收集参数并展示结果。
同时也会明确哪些能力尚未闭环,避免把"可试跑的工作流编辑器"夸大成完整 Agent 平台。
一、产品入口为什么分成"基本信息"和"工作流设计"
工作流创建页使用两步结构。
第一步维护:
- 工作流名称;
- 唯一编码;
- 状态;
- 备注。
第二步维护 Tinyflow 图,包括节点、连线、参数和节点配置。
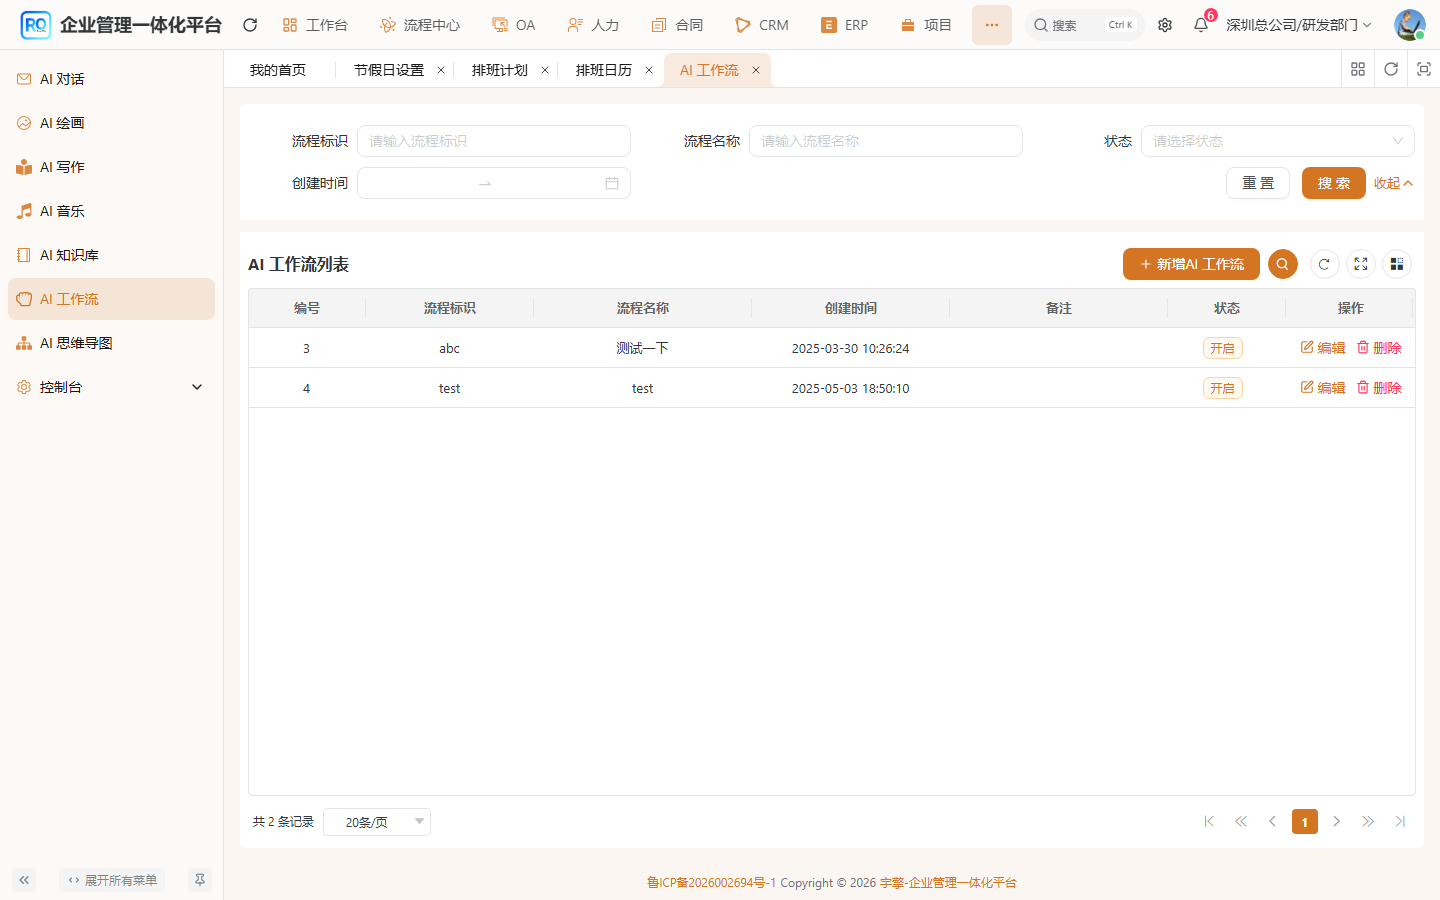
▲ 列表负责工作流资产管理,画布不应同时承担搜索、分页和权限配置
这种拆分看似普通,实际解决了一个关键问题:业务身份和执行图不是同一件事。
工作流名称和编码用于检索、授权、未来 API 调用与版本识别;graph 则是某个时点的执行定义。把全部数据只存在前端画布对象里,后续就无法按编码调用,也无法做版本迁移。
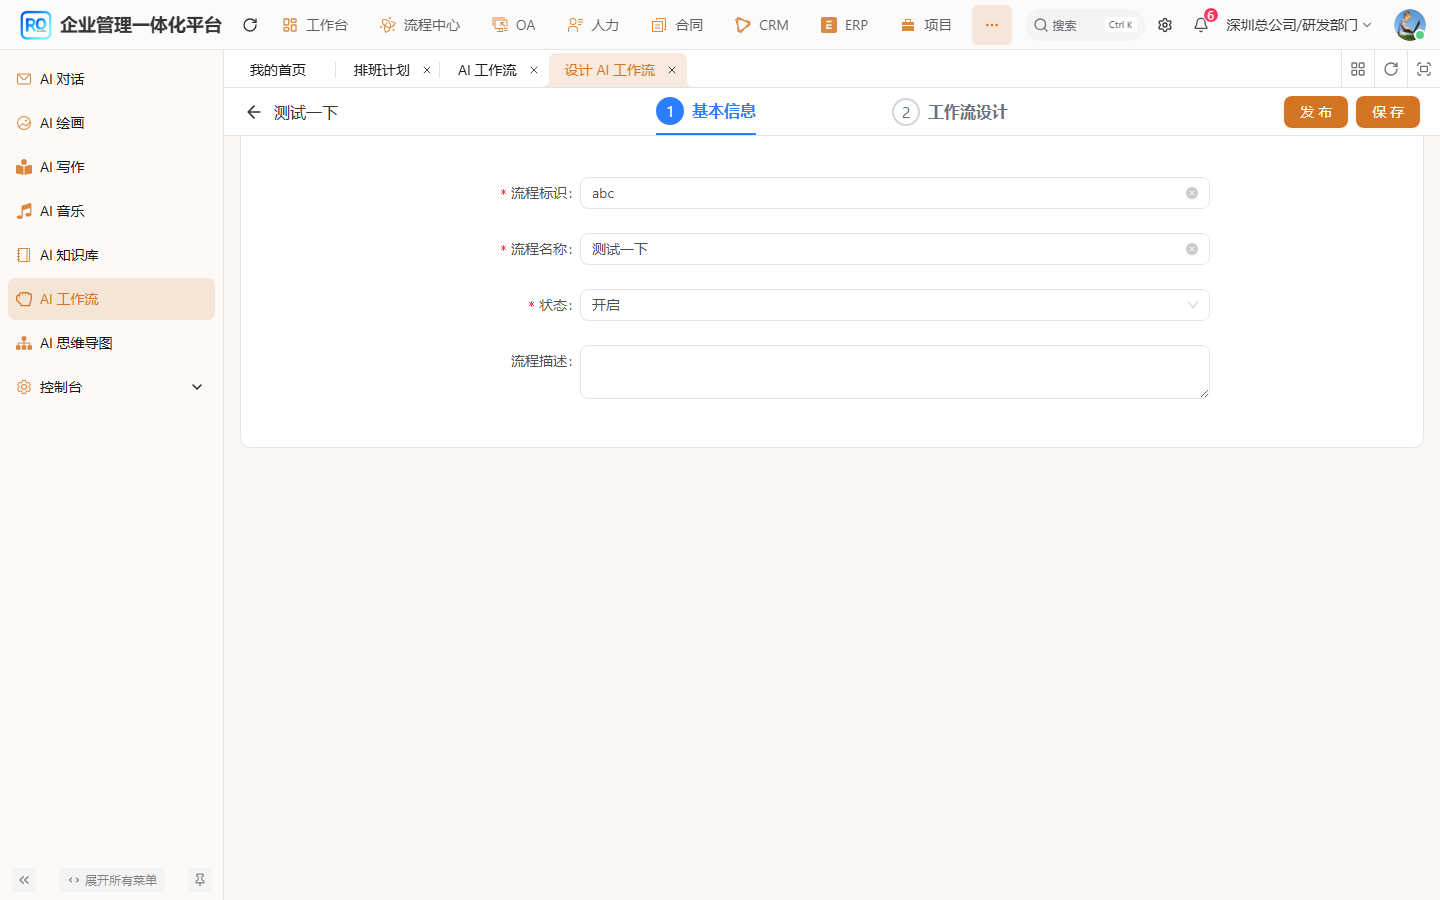
▲ 基本信息先定义可治理的工作流资产,第二步再进入节点画布
二、画布不是数据库表,而是一份 graph JSON
前端通过 @tinyflow-ai/vue 封装的 Tinyflow 组件进行设计。
保存时,从组件读取完整图数据,再序列化成字符串:
typescript
const data = {
  ...formData.value,
  graph: JSON.stringify(workflowData.value),
};

await (actionType.value === 'update'
  ? updateWorkflow(data)
  : createWorkflow(data));
后端 ai_workflow 表保存:
name:工作流名称;code:工作流标识;graph:完整图 JSON;status:启用或禁用;remark:说明;- 审计字段和
tenant_id。
为什么不把节点拆成 workflow_node、连线拆成 workflow_edge?
对设计器来说,图的字段会频繁演进。不同节点可能拥有完全不同的配置结构。先用 JSON 保存有几个优势:
- 前后端能完整往返,不必每增加一种节点就改多张表;
- 可以直接把画布数据交给 Tinyflow Core;
- 导入、复制、版本快照更容易;
- 节点 UI 配置不会污染业务主表。
代价也很明确:
- 数据库难以直接查询"哪些流程使用了某个模型";
- 节点字段无法依靠关系数据库约束;
- 图结构升级需要迁移器;
- 保存前必须做更严格的结构校验。
因此,JSON 不是偷懒,而是一种适合编辑器定义的存储方式;生产化后仍需要索引表或解析任务补足治理能力。
三、Tinyflow 画布在前端承担哪些职责
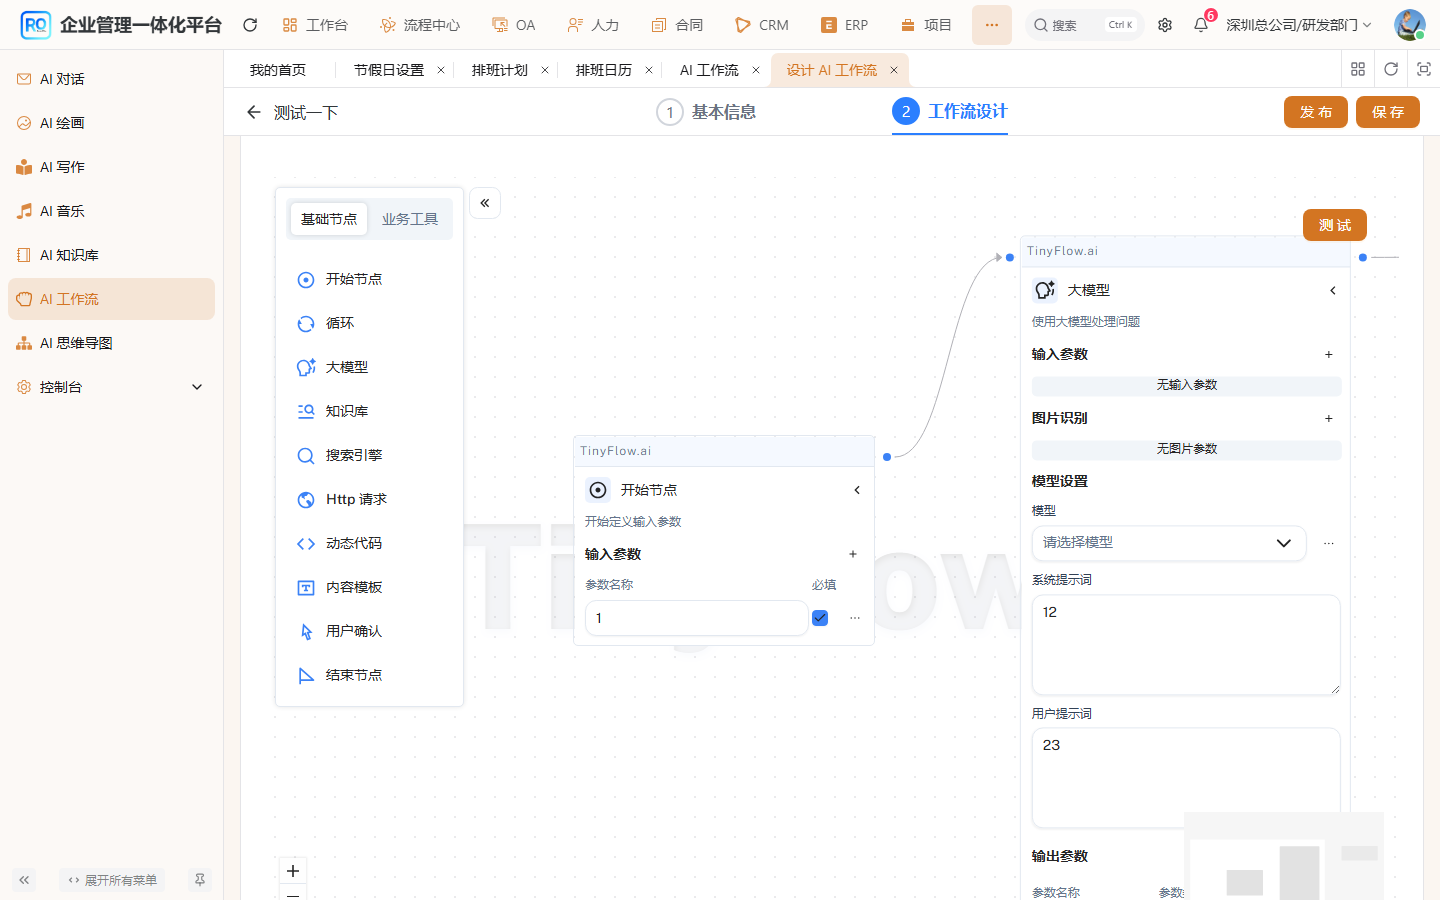
▲ 设计器把流程结构保存在 graph 中,聊天模型下拉来自平台模型中心
前端当前主要完成四件事。
1. 装载已有图
编辑工作流时,接口返回字符串 graph,页面解析为对象后注入设计器:
typescript
formData.value = await getWorkflow(workflowId.value);
workflowData.value = JSON.parse(formData.value.graph);
这意味着非法 JSON 会直接影响编辑页加载。更成熟的实现应在保存和读取时都增加 Schema 版本与异常提示。
2. 给 LLM 节点提供模型选项
页面读取聊天模型简表,把模型 ID 和名称交给 Tinyflow:
typescript
const models = await getModelSimpleList(AiModelTypeEnum.CHAT);
llmProvider.value = {
  llm: () =>
    models.map(({ id, name }) => ({
      value: id,
      label: name,
    })),
  knowledge: () => [],
  internal: () => [],
};
这里已经清楚暴露了当前边界:
- LLM 模型有真实数据源;
- 知识库 Provider 仍返回空数组;
- 内置工具 Provider 仍返回空数组。
所以本文标题只强调 LLM 节点,不把知识库检索和工具调用写成现成能力。
3. 校验画布存在
进入下一步或保存时,页面至少确认设计器实例和数据存在,并读取最新图。
这还是较轻的校验。生产级校验还应覆盖:
- 只能有一个开始节点;
- 必须存在结束节点;
- 必填节点配置不能为空;
- 连线不能形成不允许的环;
- 所有节点都必须可从开始节点到达;
- 输出变量引用必须存在。
4. 提供测试入口
测试按钮打开抽屉,从开始节点读取参数定义,自动补齐必填参数,让用户输入后直接运行当前画布。
这一步很重要:它允许用户在保存前验证图,而不是把半成品配置先发布到业务环境。
四、开始节点参数怎样从字符串变成运行变量
浏览器表单输入天然是字符串,但工作流变量可能是:
String;Number;Boolean;Array;Object。
测试抽屉会根据开始节点定义转换:
typescript
switch (dataType) {
  case 'Number':
    return Number(value);
  case 'Boolean':
    if (value.toLowerCase() === 'true') return true;
    if (value.toLowerCase() === 'false') return false;
    throw new Error('必须为 true/false');
  case 'Array':
  case 'Object':
    return JSON.parse(value);
  default:
    return String(value);
}
如果不做这一步,条件节点拿到 "100" 和 100 时可能出现完全不同的判断结果;字符串 "false" 在 JavaScript 中又是一个真值,风险更大。
当前转换在前端完成,体验上可以及时提示格式错误。更稳妥的生产方案还要在后端按同一份参数 Schema 再校验一次,因为调用者可以绕过前端直接请求接口。
五、后端怎样把 graph JSON 变成执行链
在线试跑接口支持两种输入:
- 传
graph:直接执行当前画布; - 传
id:从数据库加载已保存工作流。
请求校验要求二者至少有一个:
java
@AssertTrue(message = "工作流或模型,必须传递一个")
public boolean isGraphValid() {
    return id != null || StrUtil.isNotEmpty(graph);
}
执行过程可以拆成四步。
第一步:确定图来源
java
String graph = testReqVO.getGraph() != null
        ? testReqVO.getGraph()
        : validateWorkflowExists(testReqVO.getId()).getGraph();
第二步:构造 Tinyflow
后端解析 nodes,并用完整 JSON 创建 Tinyflow 实例。
第三步:为 LLM 节点注入模型 Provider
遇到 llmNode 时,读取节点内的 llmId,再从模型中心获取模型、密钥配置和平台类型。
第四步:执行并返回结果
java
Map<String, Object> variables = testReqVO.getParams();
return tinyflow.toChain().executeForResult(variables);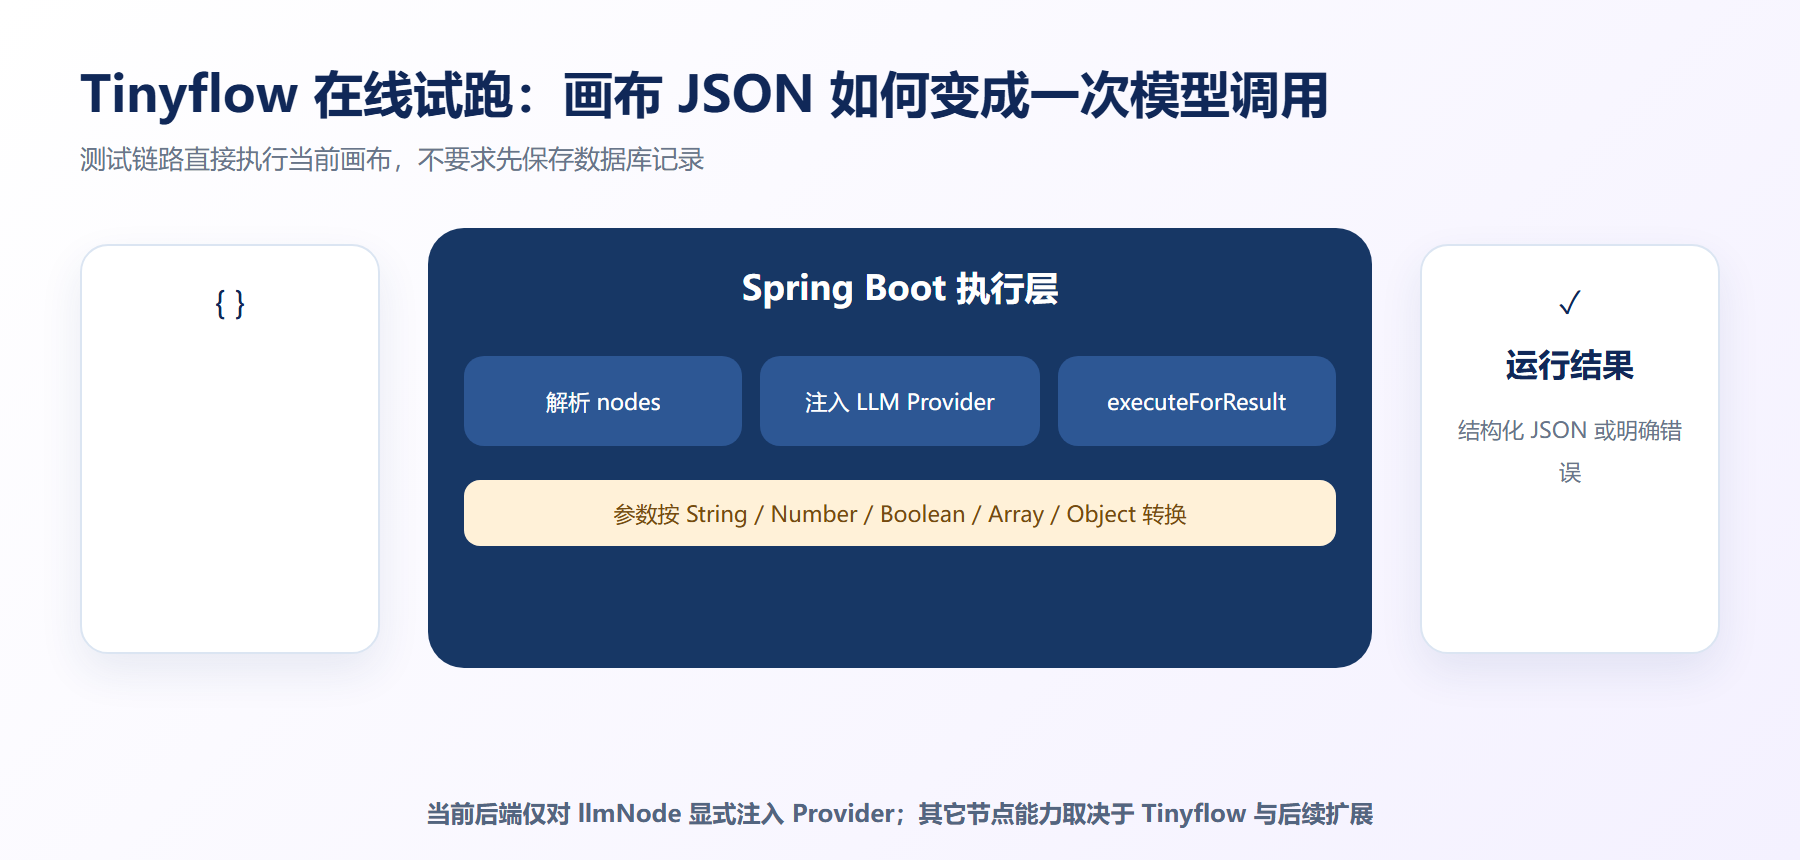
▲ 浏览器提交 graph 与结构化参数,后端解析节点、注入 Provider,再执行链并返回结果
六、模型密钥为什么不能直接保存在 graph 里
LLM 节点只保存 modelId,不保存 API Key。
后端通过模型中心继续找到:
- 模型记录;
- 关联密钥记录;
- 平台类型;
- 模型名称和服务地址。
当前 Tinyflow Provider 显式支持:
- 通义千问;
- Ollama。
java
switch (platform) {
    case TONG_YI:
        tinyflow.setLlmProvider(id -> new QwenLlm(qwenConfig));
        break;
    case OLLAMA:
        tinyflow.setLlmProvider(id -> new OllamaLlm(ollamaConfig));
        break;
}
把密钥从图中拿掉有三个好处:
- 导出 graph 时不会泄露凭据;
- 密钥轮换不要求逐个修改工作流;
- 模型访问可以统一受平台权限和租户边界约束。
但这里还不能声称"任意 Spring AI 模型都能在工作流里运行"。平台模型中心支持的供应商范围更广,不等于 Tinyflow 适配层已经逐一支持。文章与产品页都应该按执行适配器的真实 switch 说明。
更准确地说,平台的对话、RAG 等能力主要使用 Spring AI ChatModel 体系,而工作流试跑当前使用 Tinyflow + agents-flex 的 QwenLlm / OllamaLlm Provider。这是两条运行链,不应因为共用模型中心就写成"工作流节点统一走 Spring AI"。
七、在线试跑为什么应该是独立权限
测试接口使用 ai:workflow:test 权限,和创建、更新、删除分开。
这不是多写一个权限码,而是因为"能编辑图"和"能消耗模型额度"不是同一类风险。
在线运行可能:
- 消耗付费 Token;
- 把测试数据发往外部模型;
- 触发耗时调用;
- 暴露模型返回内容;
- 在未来调用内部工具。
因此,企业平台至少要区分:
- 查看工作流;
- 编辑工作流;
- 试跑工作流;
- 发布工作流;
- 调用生产版本;
- 查看运行日志。
当前 Controller 已对创建、更新、删除和测试增加 @PreAuthorize,但工作流详情与分页接口还没有显式绑定 ai:workflow:query。菜单权限不能替代接口鉴权,继续完善时应把查询权限落实到服务端;试跑参数也会直接进入模型链路,需要补充敏感字段脱敏、内容审计和额度控制。
当前错误展示主要返回"运行失败,请检查参数和网络连接"。继续完善时应在不泄露密钥和内部堆栈的前提下,给出节点编号、节点名称和错误阶段。
八、多租户和数据边界怎样理解
ai_workflow 表包含 tenant_id,平台 MyBatis 租户插件会为常规查询、更新和唯一性校验注入租户条件。
这意味着:
- A 租户看不到 B 租户的工作流;
- 相同工作流编码可以按租户独立管理;
- 通过 ID 加载时仍受租户条件约束。
Java DO 继承 BaseDO,但不能只看继承关系判断租户能力。该项目的租户插件会根据表字段和忽略规则工作,事实判断必须同时核对表结构、拦截器和跨租户测试。
模型 ID 的归属也必须验证。工作流属于当前租户,不代表 graph 中填入的任意 modelId 都天然安全。后端调用 validateModel 时应确保模型查询同样经过租户隔离,不能只相信前端下拉列表。
九、当前实现最需要诚实说明的五个边界
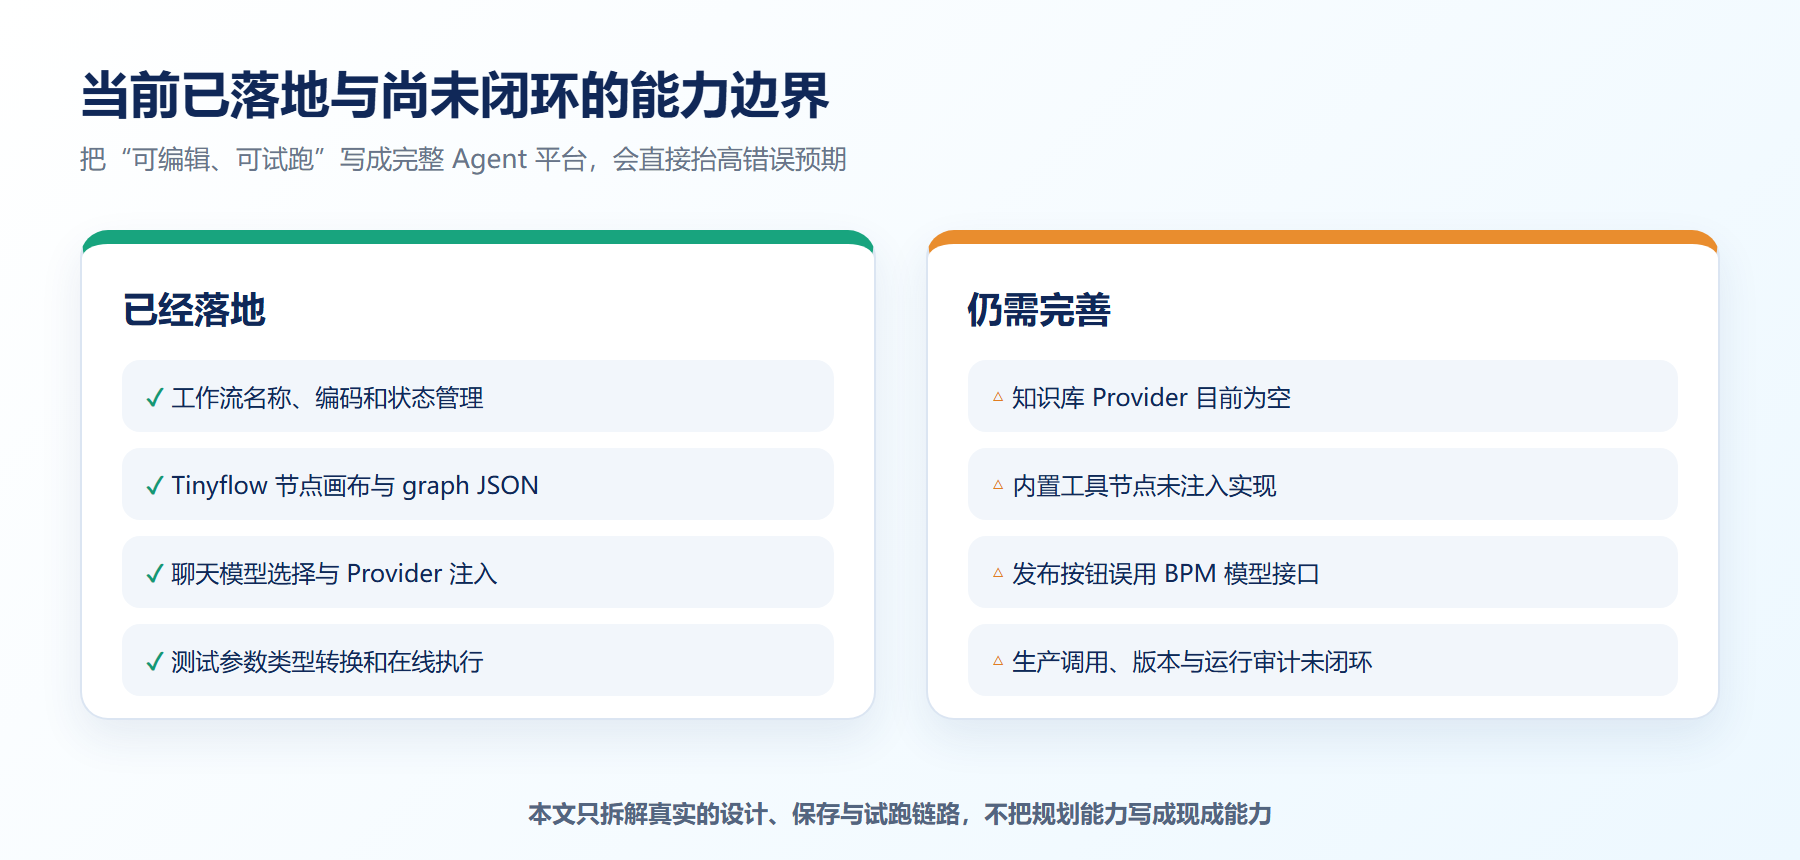
▲ 可设计、可保存、可试跑不等于已经具备版本发布、生产调用和 Agent 治理
1. "发布"按钮当前误用了 BPM 模型接口
工作流编辑页的发布逻辑调用了 BPM 的 createModel、updateModel 和 deployModel,数据结构也直接复用了表单数据。
这不是 AI 工作流真正的发布实现。现阶段可靠链路是"保存 + 测试",不能把页面上的发布按钮当成可交付的生产发布能力。
正确方向应是:
- 为 AI 工作流建立自己的版本表;
- 保存不可变 graph 快照;
- 发布时校验节点与模型;
- 生成生产版本号;
- 运行请求绑定明确版本;
- 支持停用和回滚。
2. 多个 LLM 节点可能被最后一次 Provider 设置覆盖
解析代码遍历所有 llmNode,每次调用 setLlmProvider。当前 Provider 回调并没有根据节点传入的 ID 返回不同模型,而是固定返回本次配置。
如果一条图里配置多个不同模型,最终执行是否正确需要专项验证。代码注释也明确提示了这一问题。
因此,更准确的表述是"支持选择并执行 LLM 节点",不是"已经支持一条链多模型协同"。
3. 知识库和内置工具尚未接入
前端 Provider 返回空列表,后端对 internalNode 也没有注入实现。RAG 检索、数据库查询、HTTP 工具、审批动作等还不能仅凭画布节点完成。
4. 缺少生产调用入口
当前只有管理端测试接口,没有看到按工作流编码调用已发布版本的业务 API,也没有服务间调用契约。
业务模块如果直接把 graph 传给测试接口,会绕过版本和发布治理,不应作为正式集成方式。
5. 缺少运行实例与节点审计
当前接口同步返回最终结果,没有持久化:
- 运行编号;
- 使用版本;
- 输入摘要;
- 每个节点开始、结束时间;
- Token 用量;
- 错误节点;
- 重试次数;
- 最终输出;
- 调用用户与业务单据。
没有这些数据,线上出现慢调用或结果异常时很难定位。
十、从"可试跑"走向生产 Agent 平台还需要什么
1. 工作流版本
保存是草稿,发布是不可变版本。运行实例必须记录版本号,不能总是读取最新 graph。
2. 节点注册中心
每种节点应声明:
- 节点类型;
- 配置 Schema;
- 输入输出 Schema;
- 前端配置组件;
- 后端执行器;
- 所需权限;
- 超时与重试策略。
新增知识库或 HTTP 工具时,通过注册扩展,不在一个大 switch 中无限堆分支。
3. 运行上下文
运行上下文除了业务变量,还应携带:
- tenantId;
- userId;
- workflowCode 和 version;
- traceId;
- 业务来源;
- 超时截止时间;
- 可调用工具白名单。
4. 模型路由
模型 Provider 不应只有全局单例覆盖。每个 LLM 节点要按自己的 modelId 获取模型,同时限制并发、Token、温度和最大输出。
5. 工具安全
一旦允许工作流调用数据库、HTTP 或企业业务服务,必须增加:
- 工具白名单;
- 参数 Schema;
- 服务端鉴权;
- 敏感字段脱敏;
- 幂等键;
- 人工确认节点;
- 调用审计。
"让模型决定调用什么"不能等价于"让模型拥有管理员权限"。
6. 异步与可恢复执行
长流程不能一直占用 HTTP 请求线程。需要运行实例、节点状态、消息队列或任务调度,支持暂停、重试、取消和断点恢复。
十一、建议怎样测试 AI 工作流
场景一:开始参数类型
分别测试字符串、数字、布尔、数组和对象,错误 JSON 必须在运行前被拦截。
场景二:graph 与 ID 两种入口
未保存画布传 graph 应可试跑;已保存工作流传 ID 应加载数据库版本。两者结果应一致。
场景三:模型失效
禁用模型、删除密钥或配置错误地址时,接口应返回可定位错误,不能只留下后端空指针。
场景四:跨租户访问
A 租户不能读取或执行 B 租户的工作流和模型。
场景五:多个 LLM 节点
给两个节点选择不同模型,验证实际请求是否分别命中目标模型。如果不能,应在保存阶段禁止这种配置,而不是静默使用最后一个 Provider。
场景六:并发和超时
同一工作流并发试跑时,Provider 配置不能互相污染;模型超时后需要及时释放请求资源。
场景七:禁用状态
管理端试跑是否允许禁用工作流要有明确规则;未来生产调用必须拒绝禁用版本。
常见问题(FAQ)
Tinyflow 和 Flowable 是同一类工作流吗?
不是。Flowable 面向人参与的业务审批和 BPMN 状态;Tinyflow 面向 AI 节点与数据处理链。二者可以联动,但不能用 AI 画布替代审批引擎。
graph JSON 为什么不直接拆成节点表?
图结构变化快,JSON 更利于设计器完整往返。生产治理可以额外建立节点索引或发布快照,不必一开始就把所有节点字段关系化。
当前能接知识库吗?
平台本身有知识库能力,但当前工作流编辑器的 knowledge Provider 为空,本文所述链路尚未把知识库节点闭环。
当前能在一个工作流里选择多个不同模型吗?
界面可以选择模型,但后端 Provider 设置方式可能被后一个 LLM 节点覆盖。多模型链路需要专项修正和验证后才能承诺。
工作流状态为禁用后,测试接口会拒绝吗?
当前传 graph 可直接测试,传 ID 的执行路径也没有显式检查状态。生产调用入口需要补上状态和发布版本校验。
能直接给业务系统调用吗?
当前可靠入口是管理端测试接口,不是正式业务 API。生产化需要按编码和版本调用、鉴权、限流与运行日志。
结语
企业 AI 工作流真正的分水岭,不在画布能否拖动,而在图能否被稳定保存、参数能否被严格解释、模型凭据能否安全注入、运行结果能否追踪。
当前实现已经把 Vue3 Tinyflow 画布、graph JSON、模型中心和在线试跑串成了一条可理解的技术链,同时也暴露出很有价值的下一步:知识库和工具注册、独立发布版本、多模型路由、生产调用与运行审计。
先把"设计、保存、试跑"做真实,再逐步建设 Agent 治理,比一开始宣称"全能智能体平台"更可靠。
如果这篇对你有用,点个「在看」或收藏。
🌐 演示地址 :https://ruoyioffice.com/web
📦 GitHub 源码 :https://github.com/yuqing2026/ruoyi-office
📦 Gitee 源码 :https://gitee.com/yqzy1688/ruoyi-office
💬 微信:17156169080(获取产品咨询)
打开演示地址直接查看系统。