本篇目标:
讲解图的基本概念、邻接矩阵以及图的遍历。
一. 图的基本概念
1. 什么是图?
图是一种描述对象以及对象之间关系的数据结构 ,通常写成:G=(V,E)
其中:
cpp
- V 是顶点集合,Vertex Set。
- E 是边集合,Edge Set。
例如 ,用顶点表示城市,用边表示城市之间的道路:
V = {A, B, C, D}
E = {(A,B), (A,C), (B,D)}
这里的 A、B、C、D 是顶点,城市之间的道路是边。
图与树的关系是:树是一种特殊的图。树一定连通并且没有环;普通图则可能存在环,也可能不连通,两个顶点之间还可能存在多条不同的路径。
2. 无向图
如果边没有方向,这样的图称为无向图 。无向边通常写成:(A,B)
它表示 A 和 B 之间可以双向通行。在无向图中:(A,B)=(B,A)
二者是同一条边,不能计算成两条边。
如图所示:
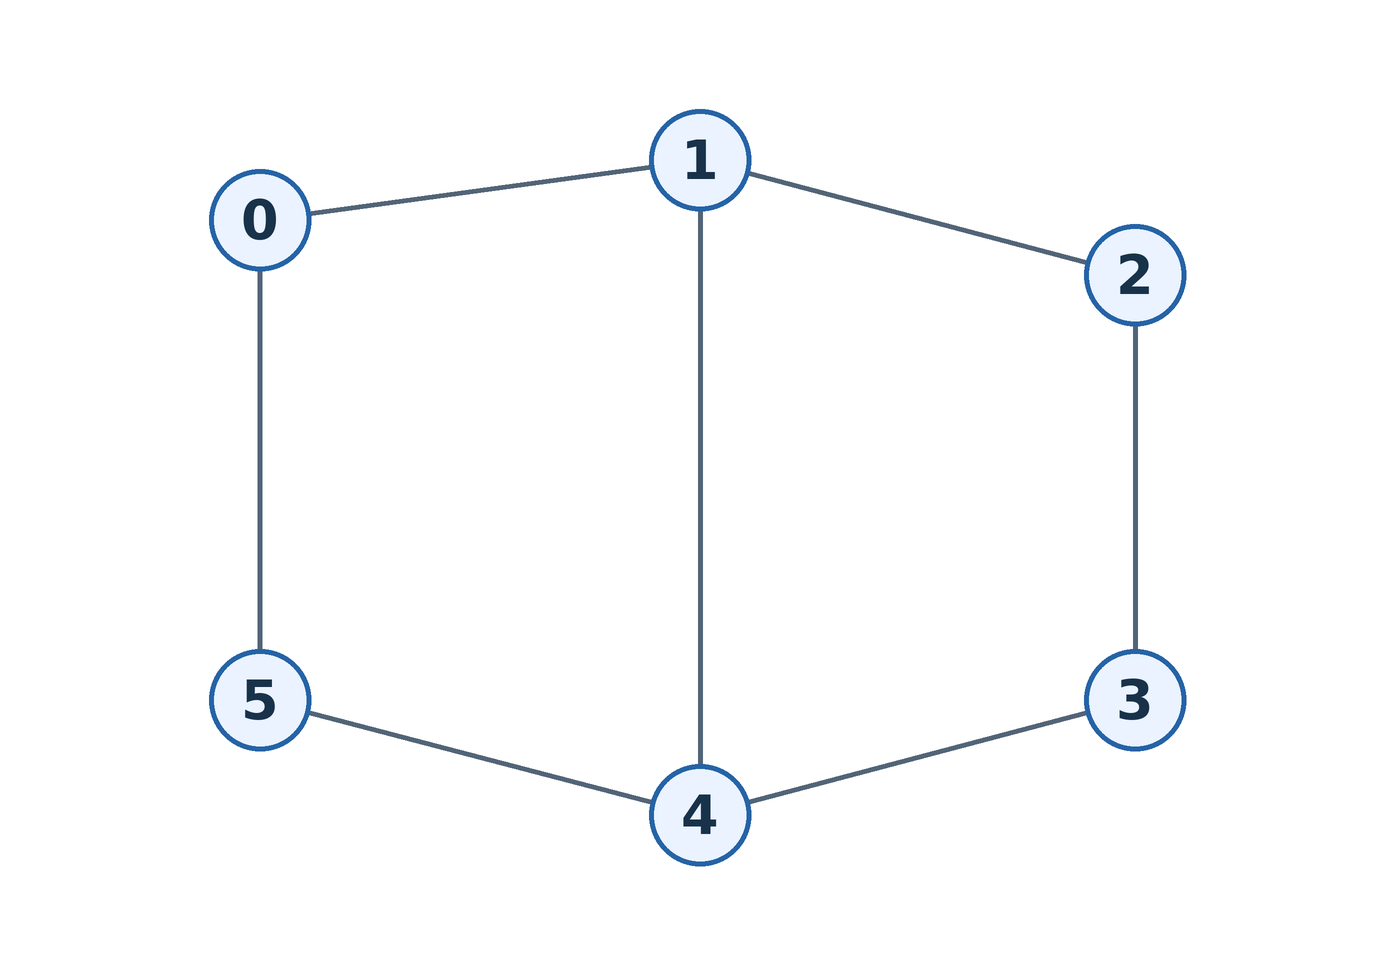
为了在程序中方便处理,有时会分别记录 A 到 B 和 B 到 A 两个方向的信息,但这只是存储方式。一条无向边在数学意义上仍然是一条边。
3. 有向图
如果边具有明确方向,这样的图称为有向图。有向边通常写成:<x,y>
也可以直观地写成:A → B
它只表示可以从 A 直接到达 B,不能说明可以从 B 直接到达 A。
如图所示:
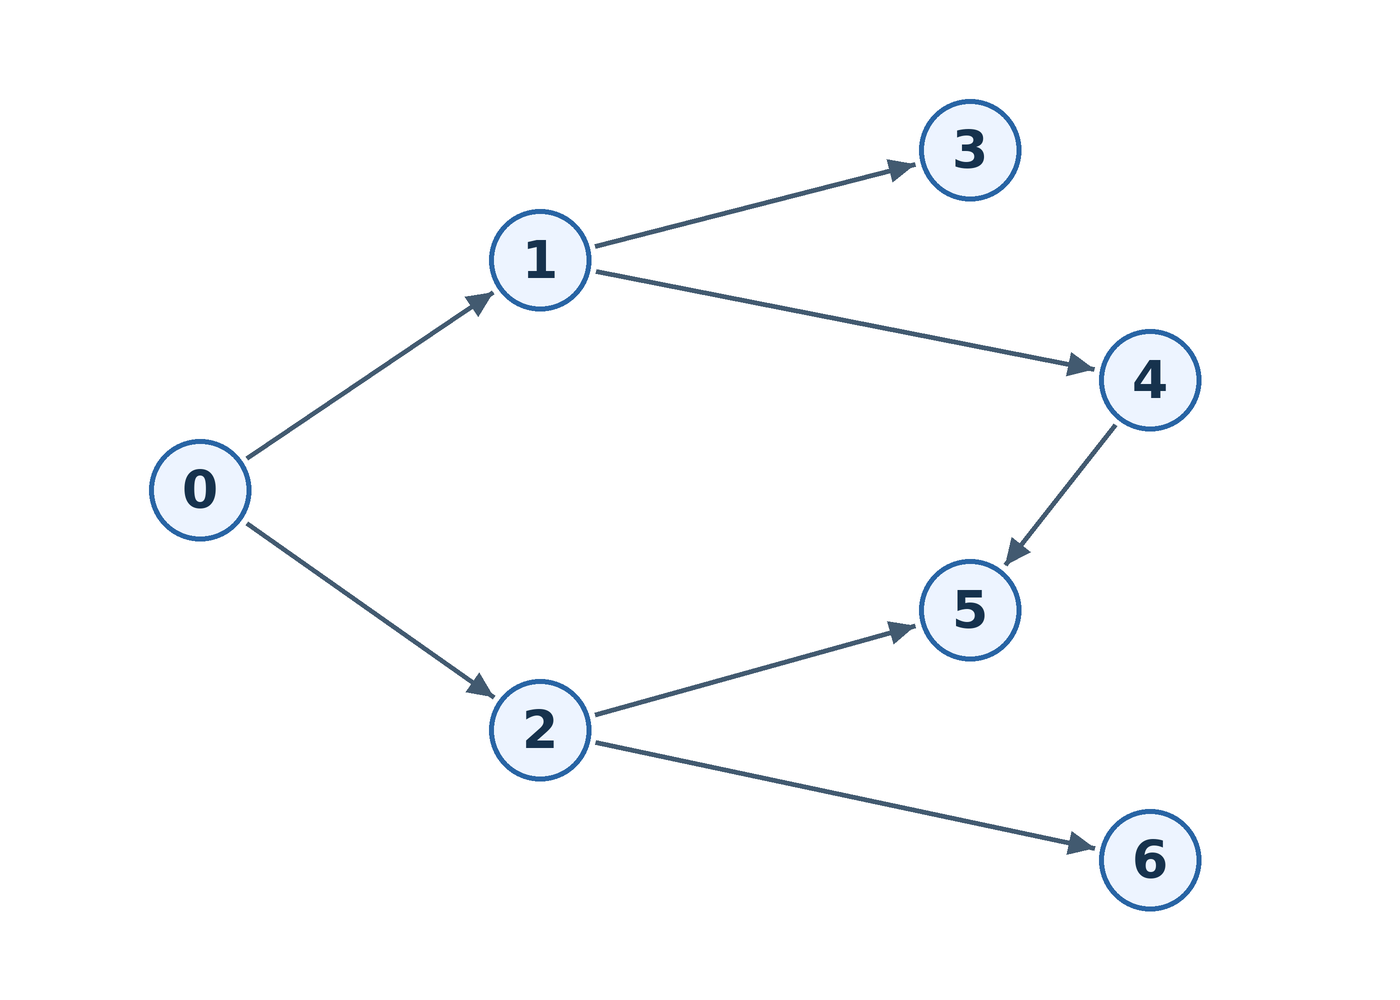
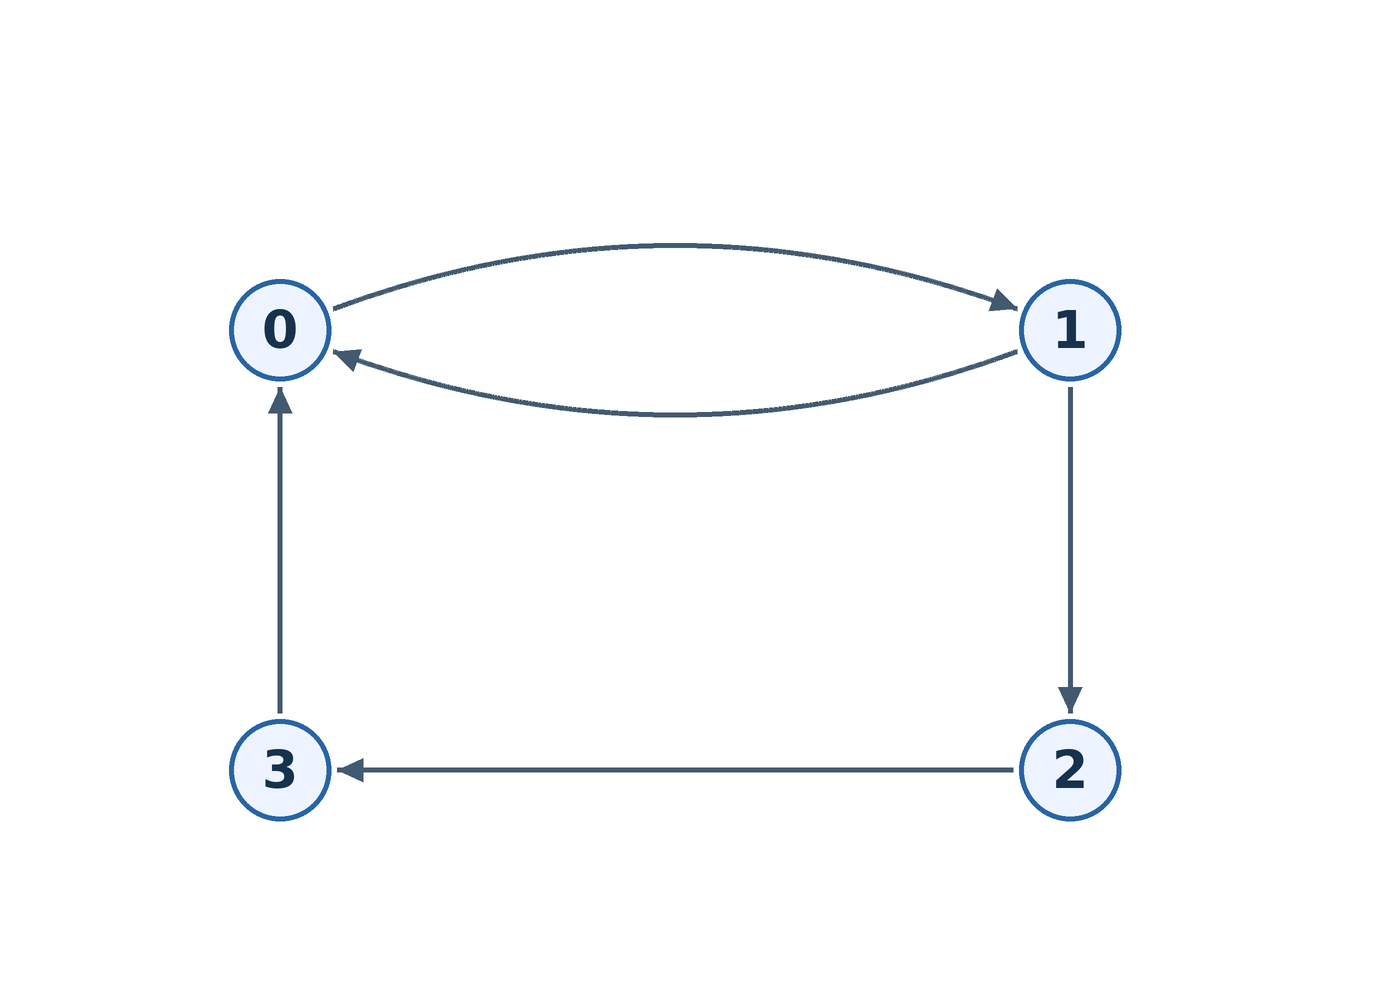
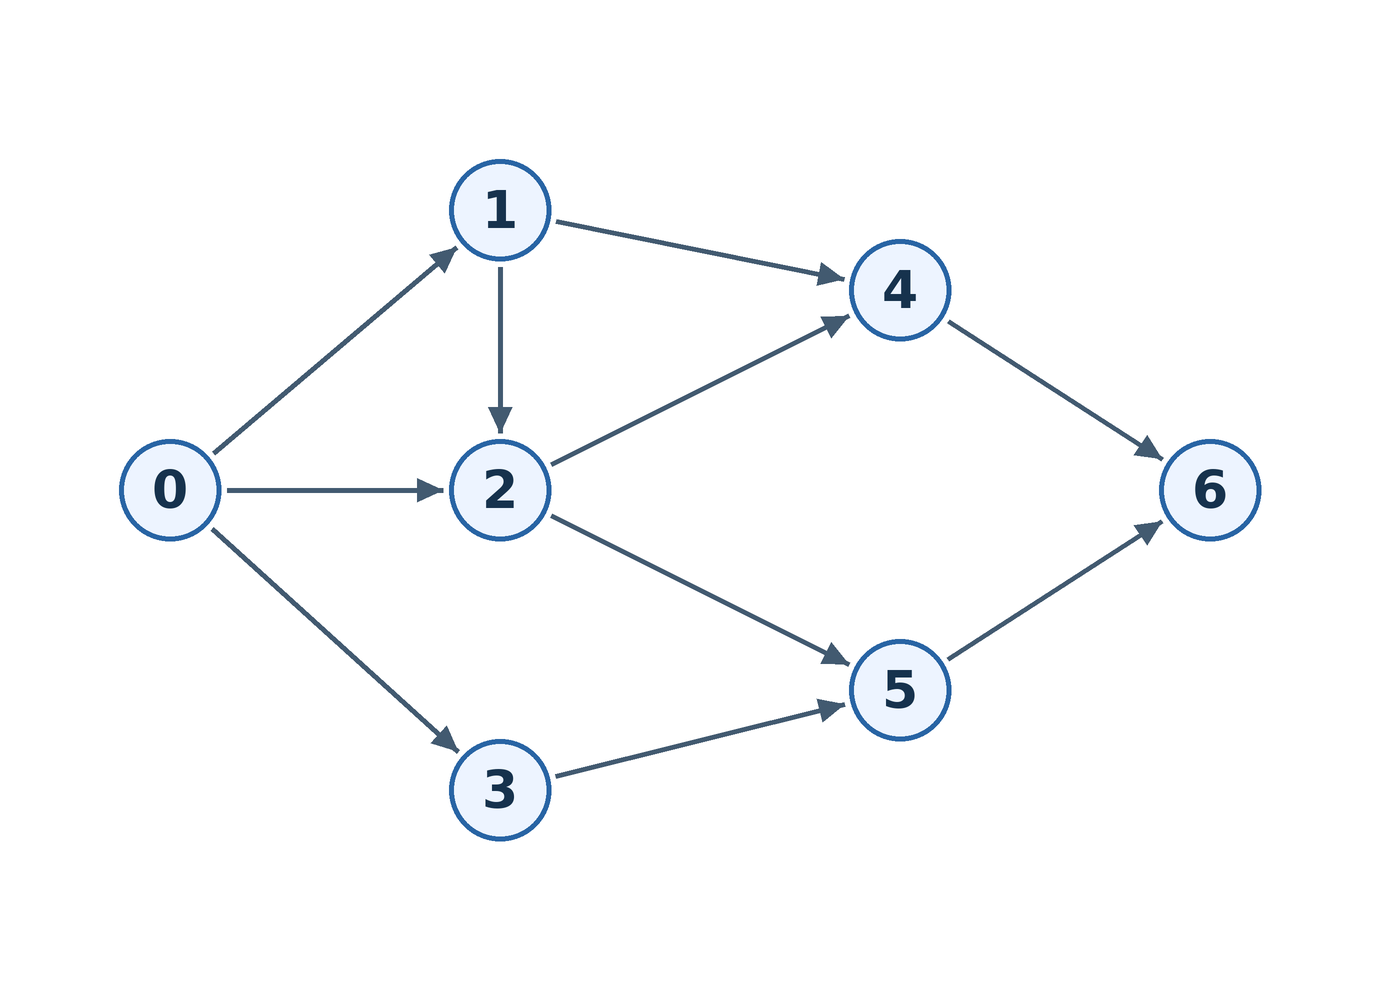
有向边也称为弧。起点 A 称为弧尾,终点 B 称为弧头。
4. 带权图
如果边上带有数值,这个数值称为边的权值。带有权值的图称为带权图,也常称为网。
例如:
cpp
    5
A ------------ B
权值 5 可以表示距离、费用、时间、网络延迟或其他代价。算法究竟让权值表示什么,要根据具体问题决定。
如图所示:
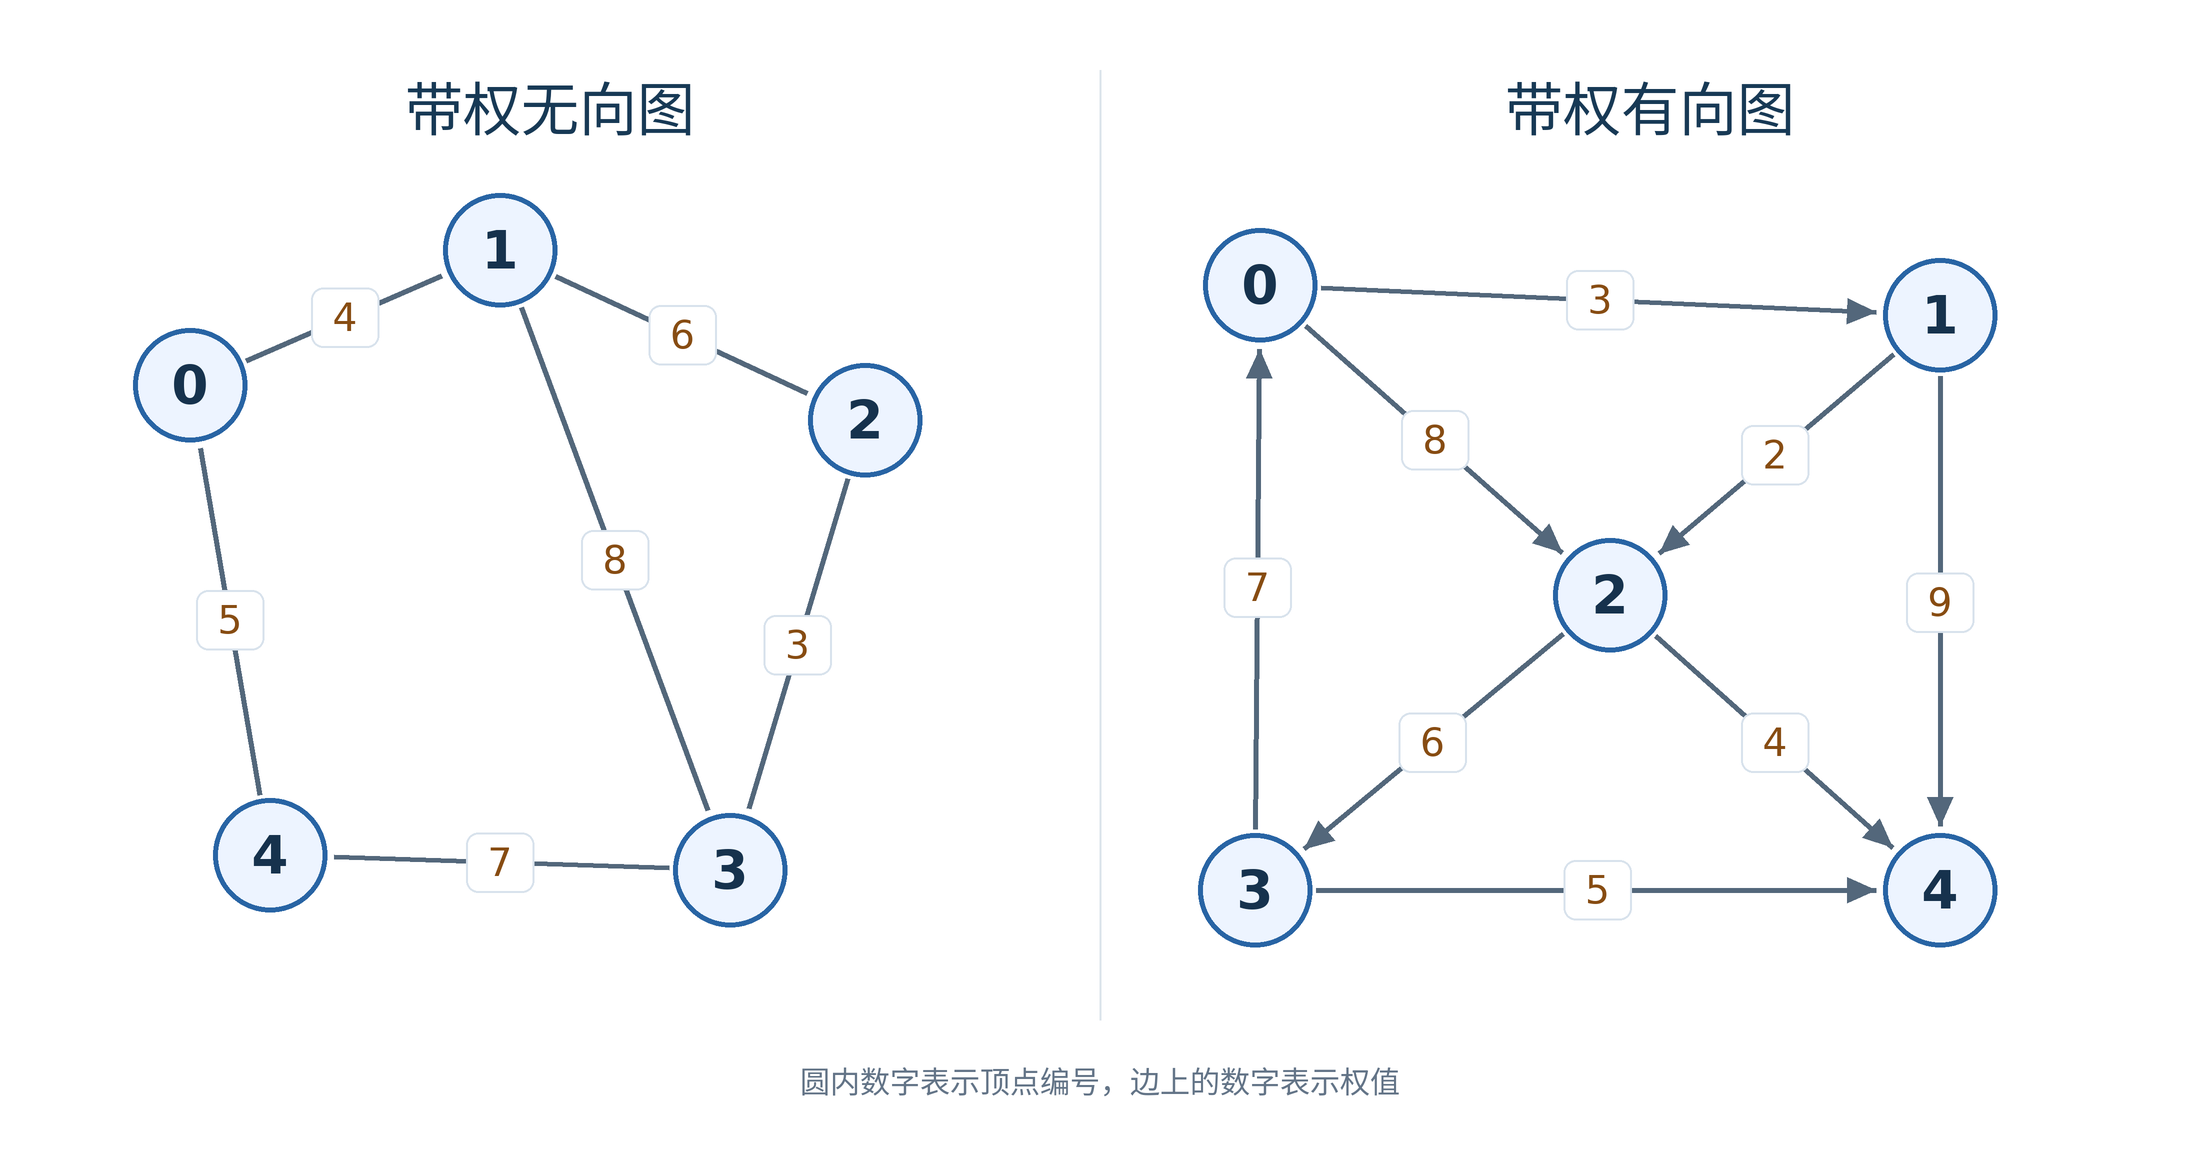
不带权图中的每条边,可以看成权值都为 1。因此,无权图中一条路径的长度通常就是路径所包含的边数。
5. 重边和自环
自环是指一条边的起点和终点是同一个顶点,例如:A → A
重边是指两个顶点之间存在多条相同方向或相同端点的边。
如果一个图既没有自环,也没有重边,通常称为简单图。完全图的边数公式通常默认讨论简单图。
6. 完全图
6.1. 无向完全图
一个有 n 个顶点的无向图,如果任意两个不同顶点之间都有一条边,就称为无向完全图。
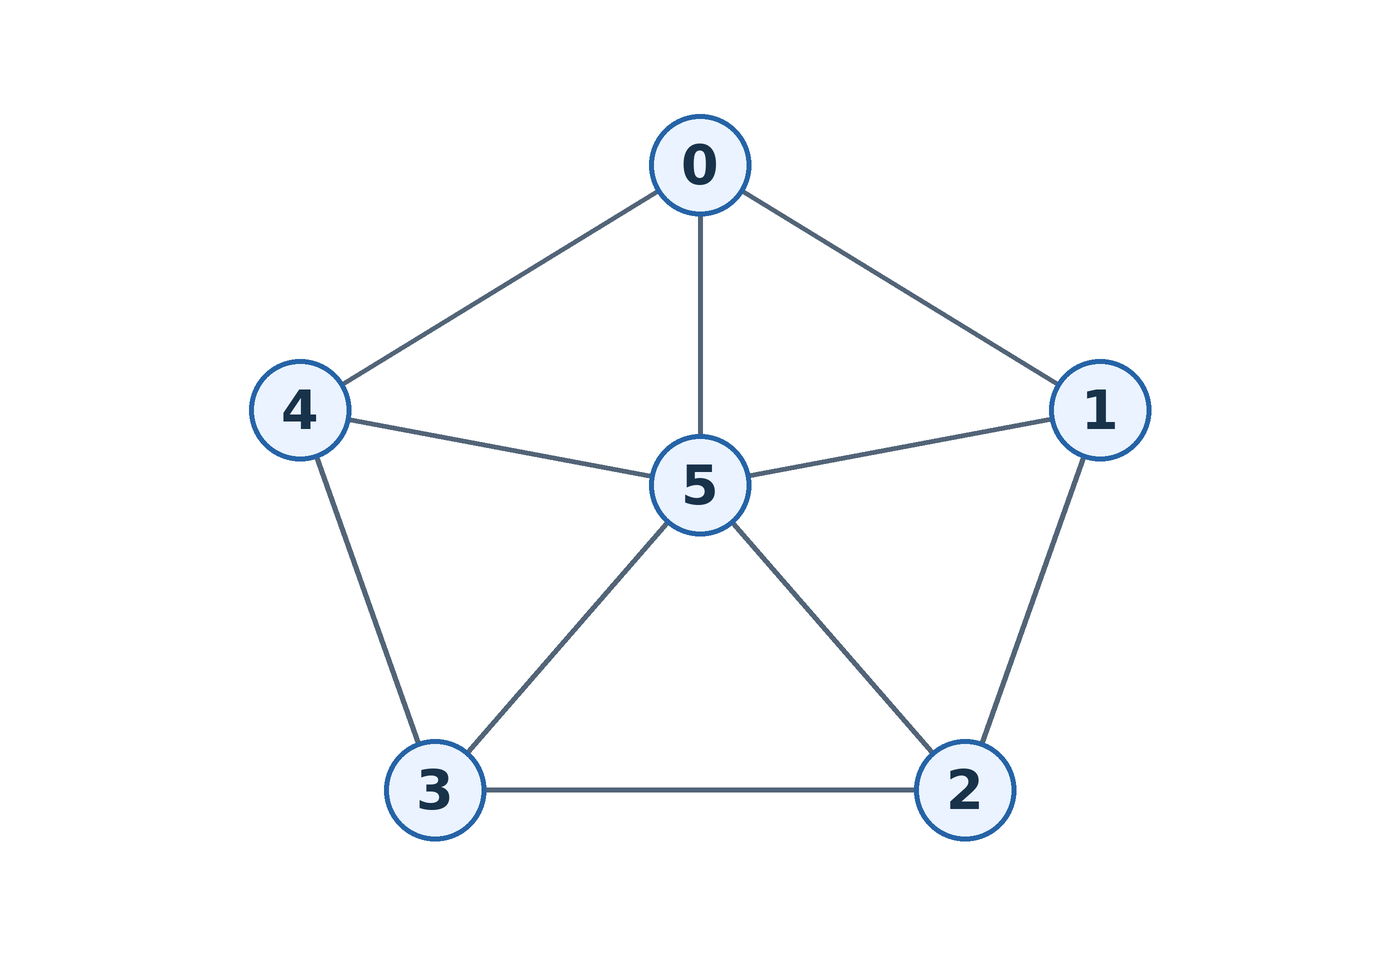
如图所示: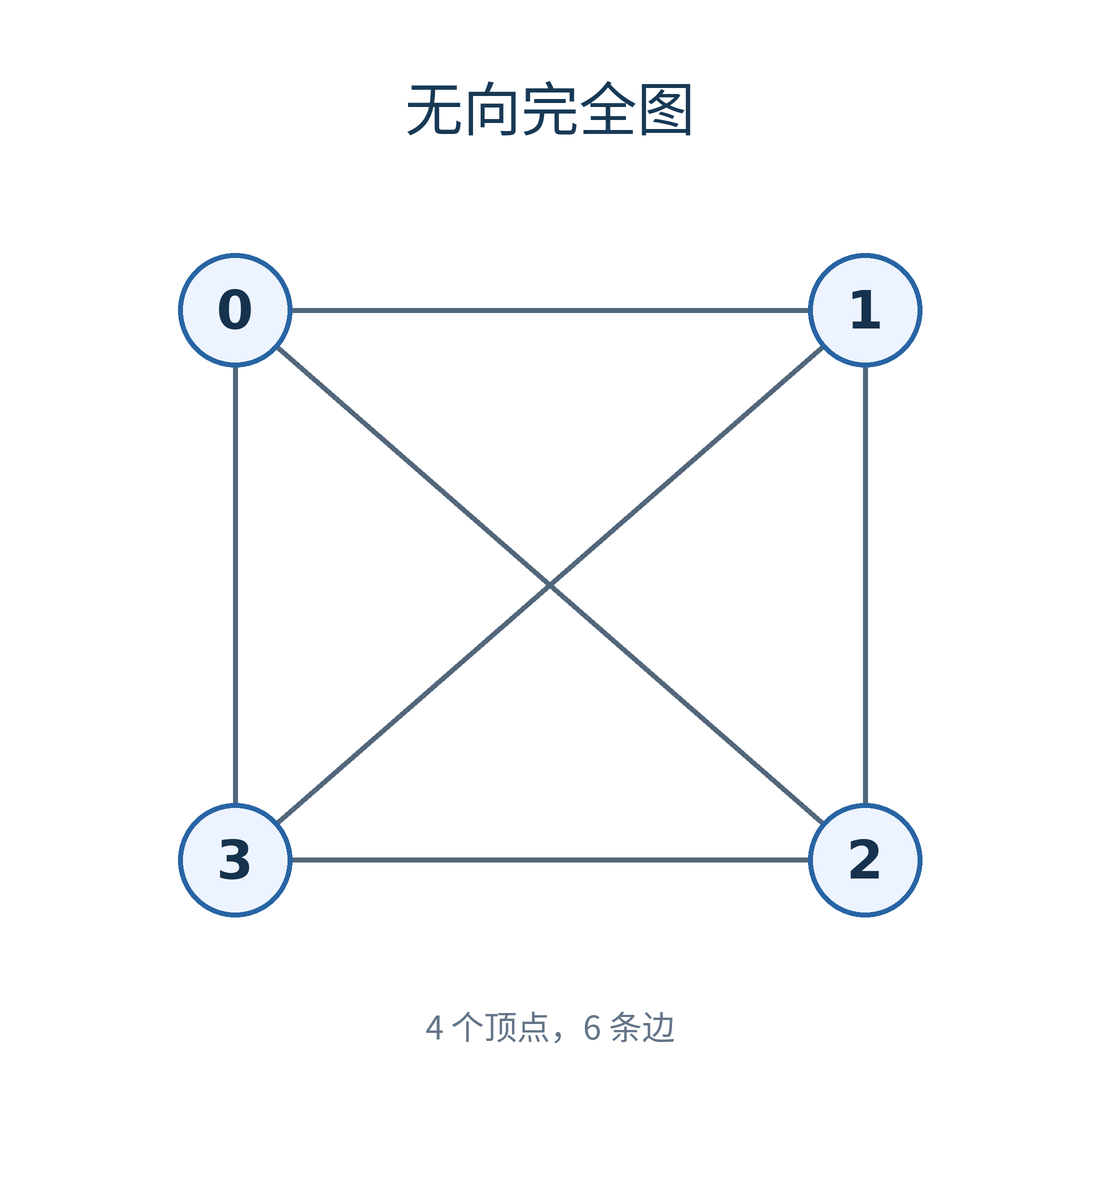
它的边数为:n * (n-1)/2条边
原因是每个顶点都可以和其他 n-1 个顶点相连,先得到 n*(n-1);但是每条无向边会从两个端点各计算一次,所以还要除以 2。
例如,4 个顶点的无向完全图有:4*3条边。
6.2. 有向完全图
如果任意两个不同顶点之间,两个方向的有向边都存在,那么这个图称为有向完全图。
如图所示:
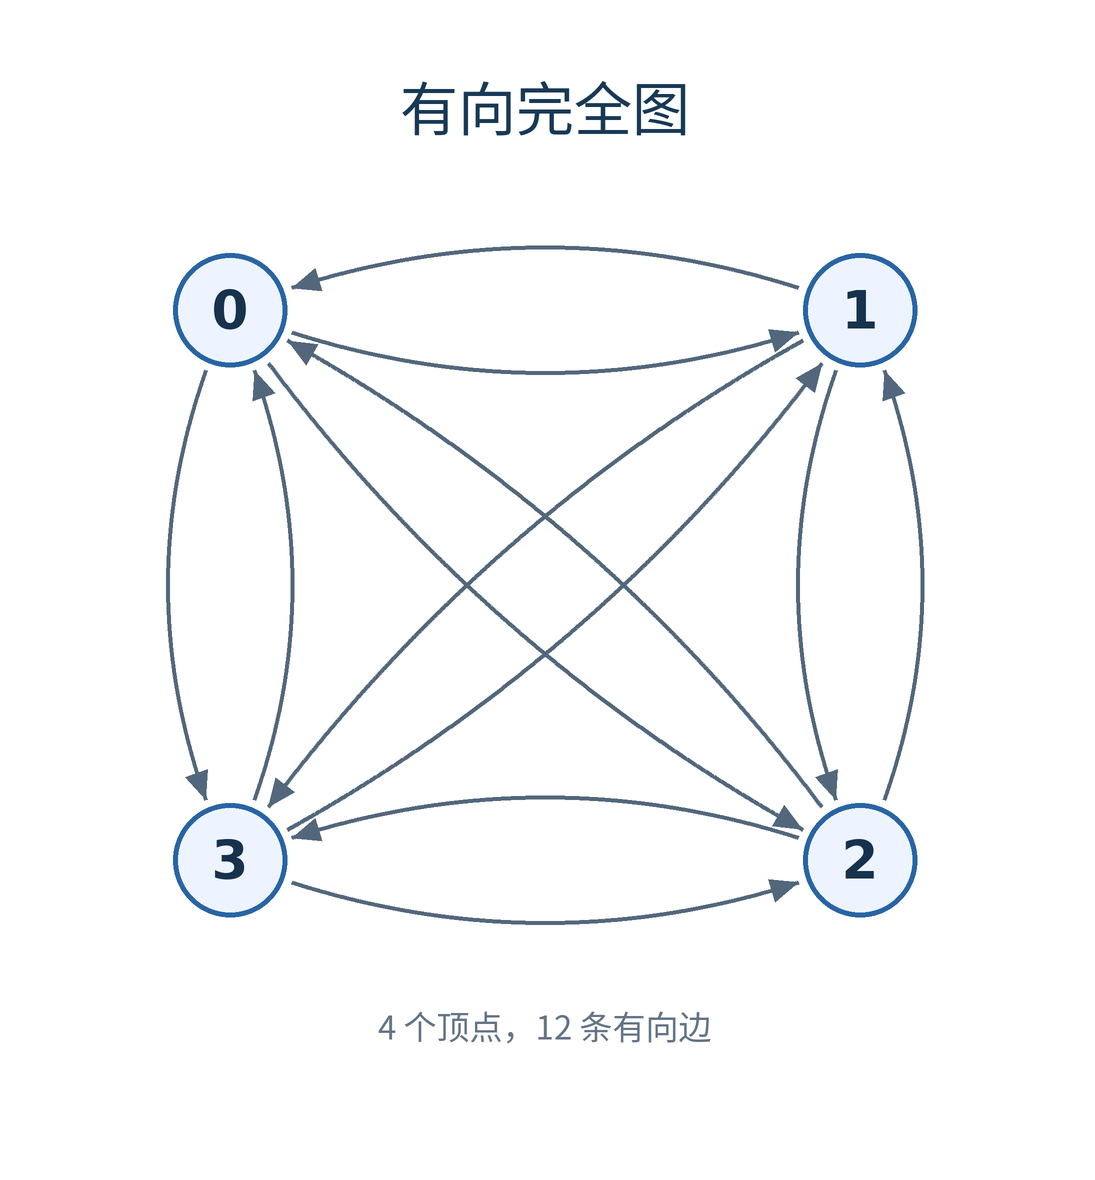
它的边数为:n(n-1)条边
例如,A 和 B 之间同时存在 A→B 与 B→A。4 个顶点的有向完全图共有:4*3=12条有向边。
7. 邻接顶点
在无向图中,如果存在边 (A,B),那么 A 和 B 互为邻接顶点,这条边依附于 A 和 B。
在有向图中,如果存在 A→B,那么可以说:
-
A 邻接到 B。
-
B 邻接自 A。
-
B 是 A 的出边邻接点。
-
A 是 B 的入边邻接点。
有向图中的邻接关系不一定具有对称性。A 邻接到 B,并不能说明 B 也邻接到 A。
8. 顶点的度
8.1 无向图的度
在无向图中,边没有方向,因此不需要区分入度和出度。与顶点 v 相关联的边数,称为该顶点的度,记作 deg(v)。
例如,与顶点 A 相连的边有 (A,B)、(A,C)、(A,D),那么 A 的度就是:
deg(A) = 3
对于整个无向图,每条边的两个端点都会各贡献一个度。因此,将所有顶点的度相加,每条边都会被统计两次,得到:
所有顶点的度之和 = 2 × |E|
其中,|E| 表示图中边的总数。如果图中允许出现自环,那么一条自环对所在顶点的度贡献为 2,上面的结论仍然成立。
如图所示:
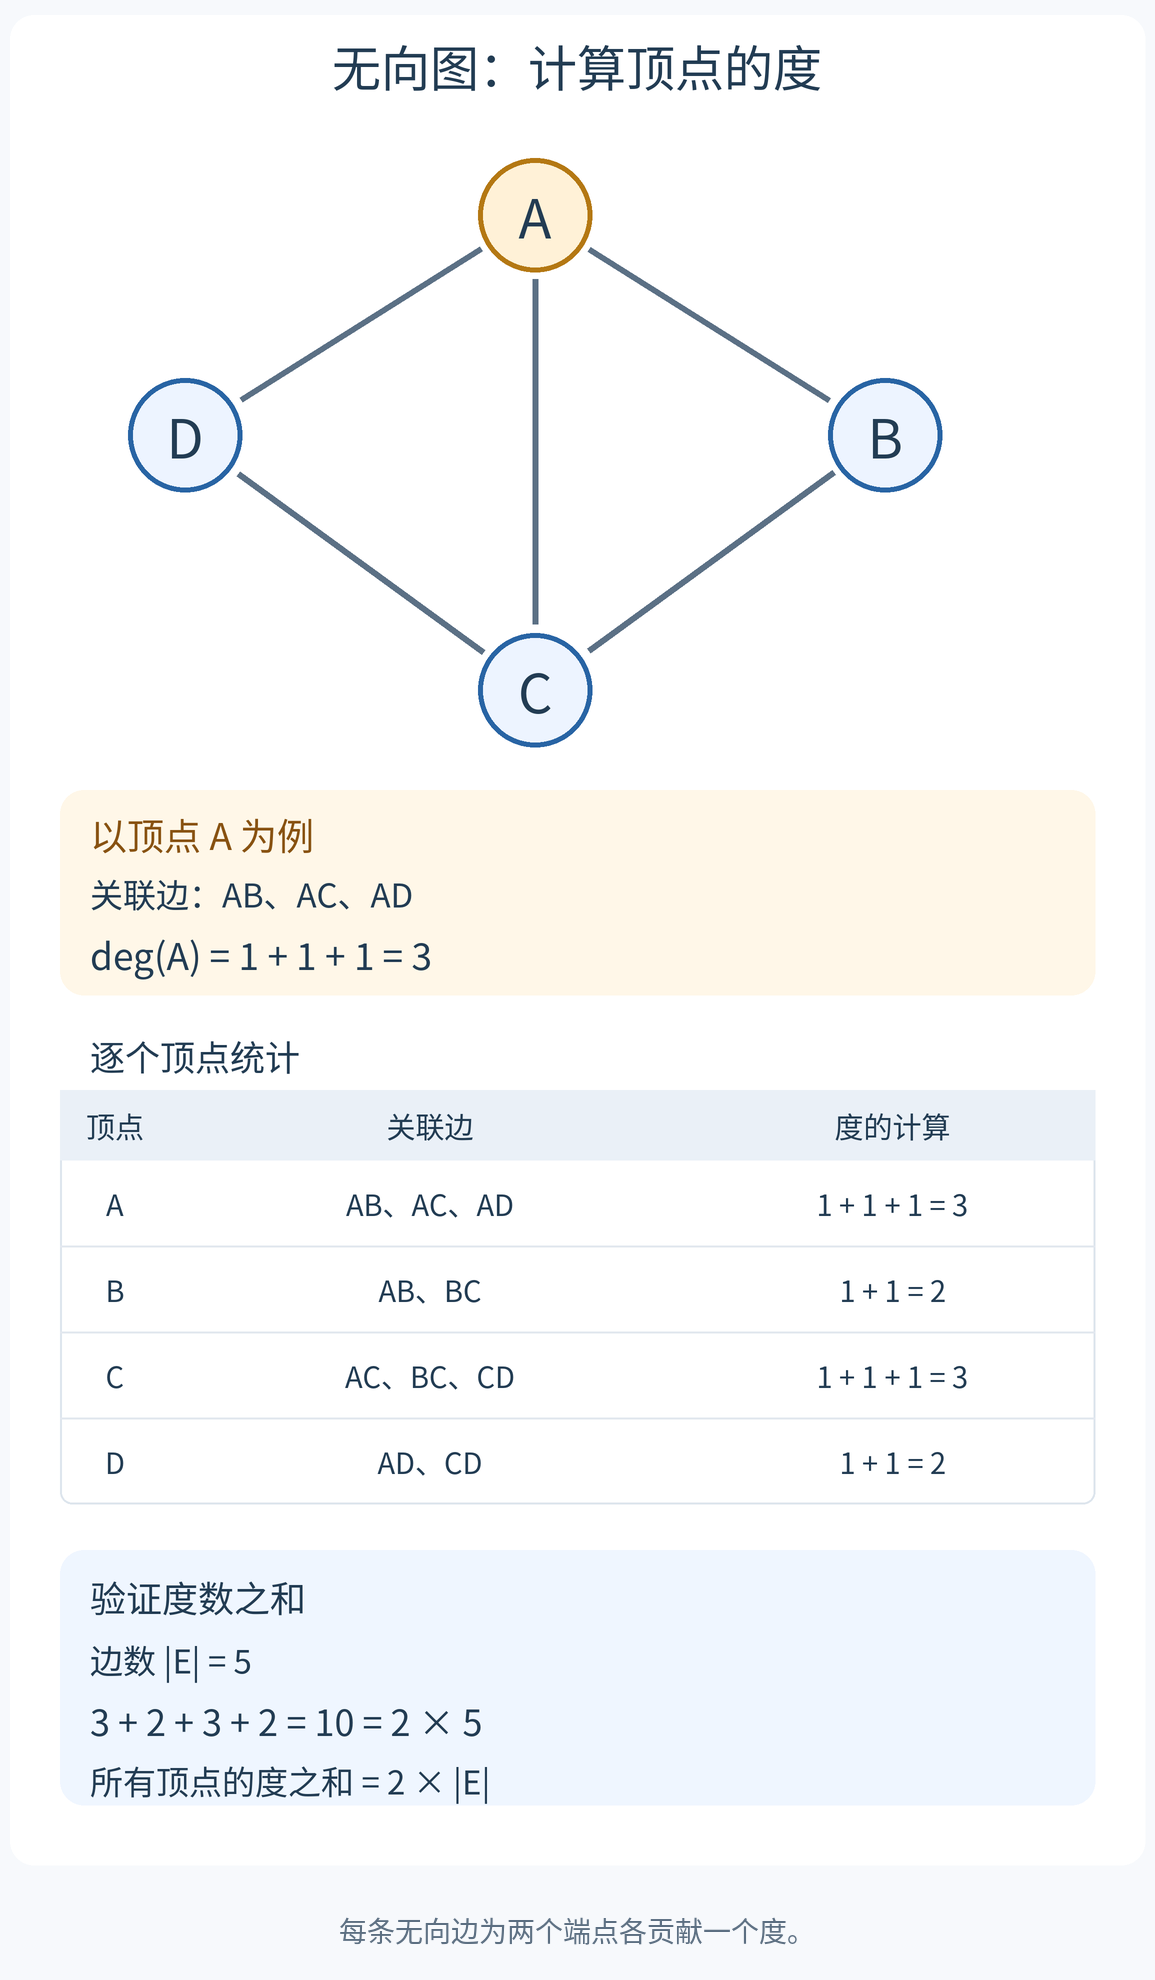
所有顶点的度数之和等于边数的两倍。因为每条无向边有两个端点,会对总度数贡献 2。因此,无向图的所有顶点度数之和一定是偶数。
无向图本身不区分入度和出度,直接讨论顶点的度即可。
8.2 有向图的入度和出度
对于有向边 A→B:
-
A 的出度 增加 1。
-
B 的入度增加 1。
在有向图中,每条边都有明确的方向,因此顶点的度需要区分为入度 和出度。
入度 :以顶点 v 为终点的边数,记作 indeg(v)。通俗地说,就是有多少条边指向这个顶点。
出度 :以顶点 v 为起点的边数,记作 outdeg(v)。也就是有多少条边从这个顶点出发。
顶点 v 的总度数等于它的入度与出度之和:
deg(v) = indeg(v) + outdeg(v)。
如图所示:
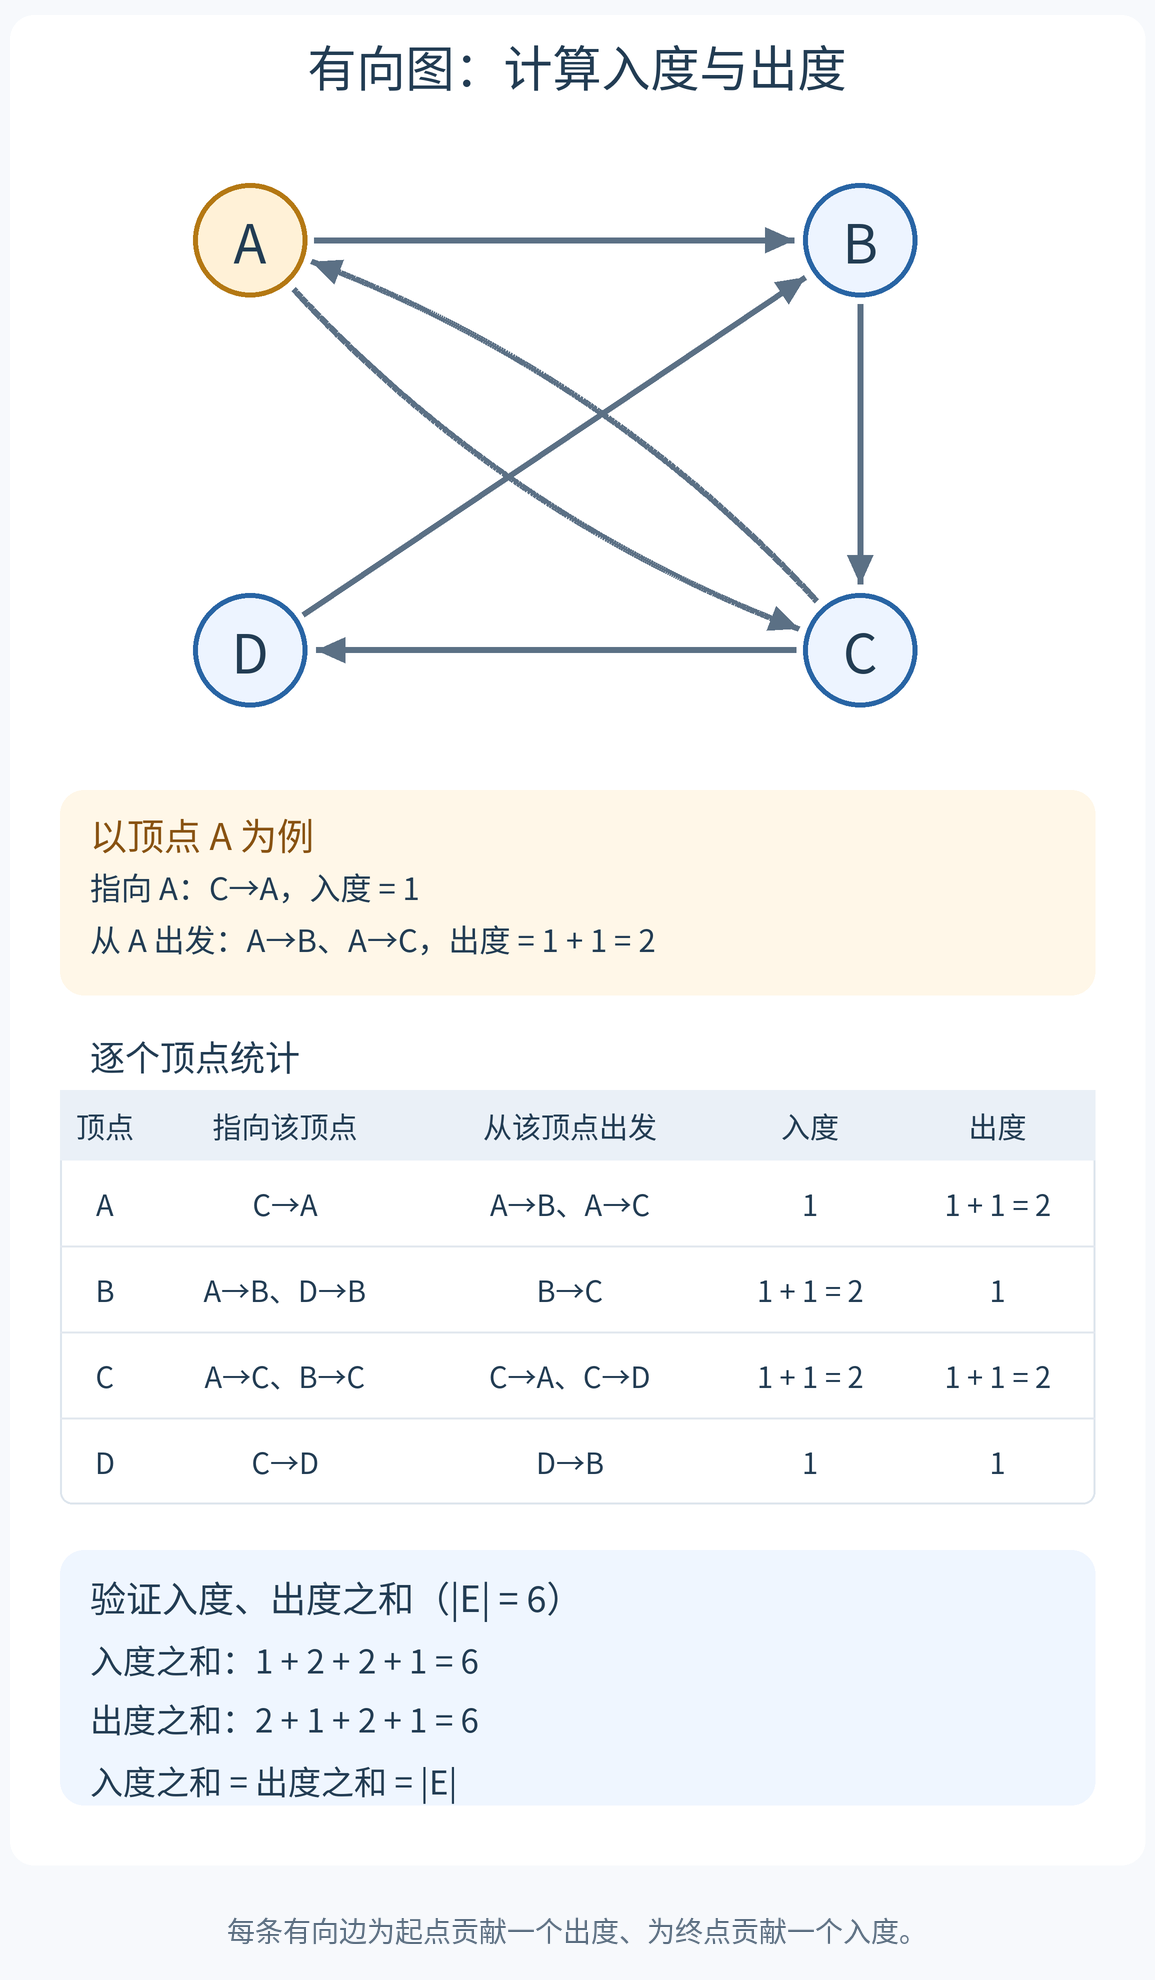
对于整个有向图,每条边都会给起点贡献一个出度,同时给终点贡献一个入度。因此,将所有顶点的入度相加,或者将所有顶点的出度相加,得到的结果都等于图中边的总数:
所有顶点的入度之和 = |E|
所有顶点的出度之和 = |E|
其中,|E| 表示图中边的总数。
因为每条有向边恰好为某个顶点贡献一个出度,同时为另一个顶点贡献一个入度。
9. 路径和路径长度
如果能够沿着图中的一系列边从顶点 A 到达顶点 D,那么经过的顶点序列就构成一条从 A 到 D 的路径。
例如:
A → B → C → D
对应的顶点序列是 A、B、C、D。
在有向图中必须按照箭头方向行走;在无向图中可以沿边的任意方向行走。
对于无权图,路径长度等于路径包含的边数。上面的路径经过 3 条边,所以路径长度是 3,而不是 4。
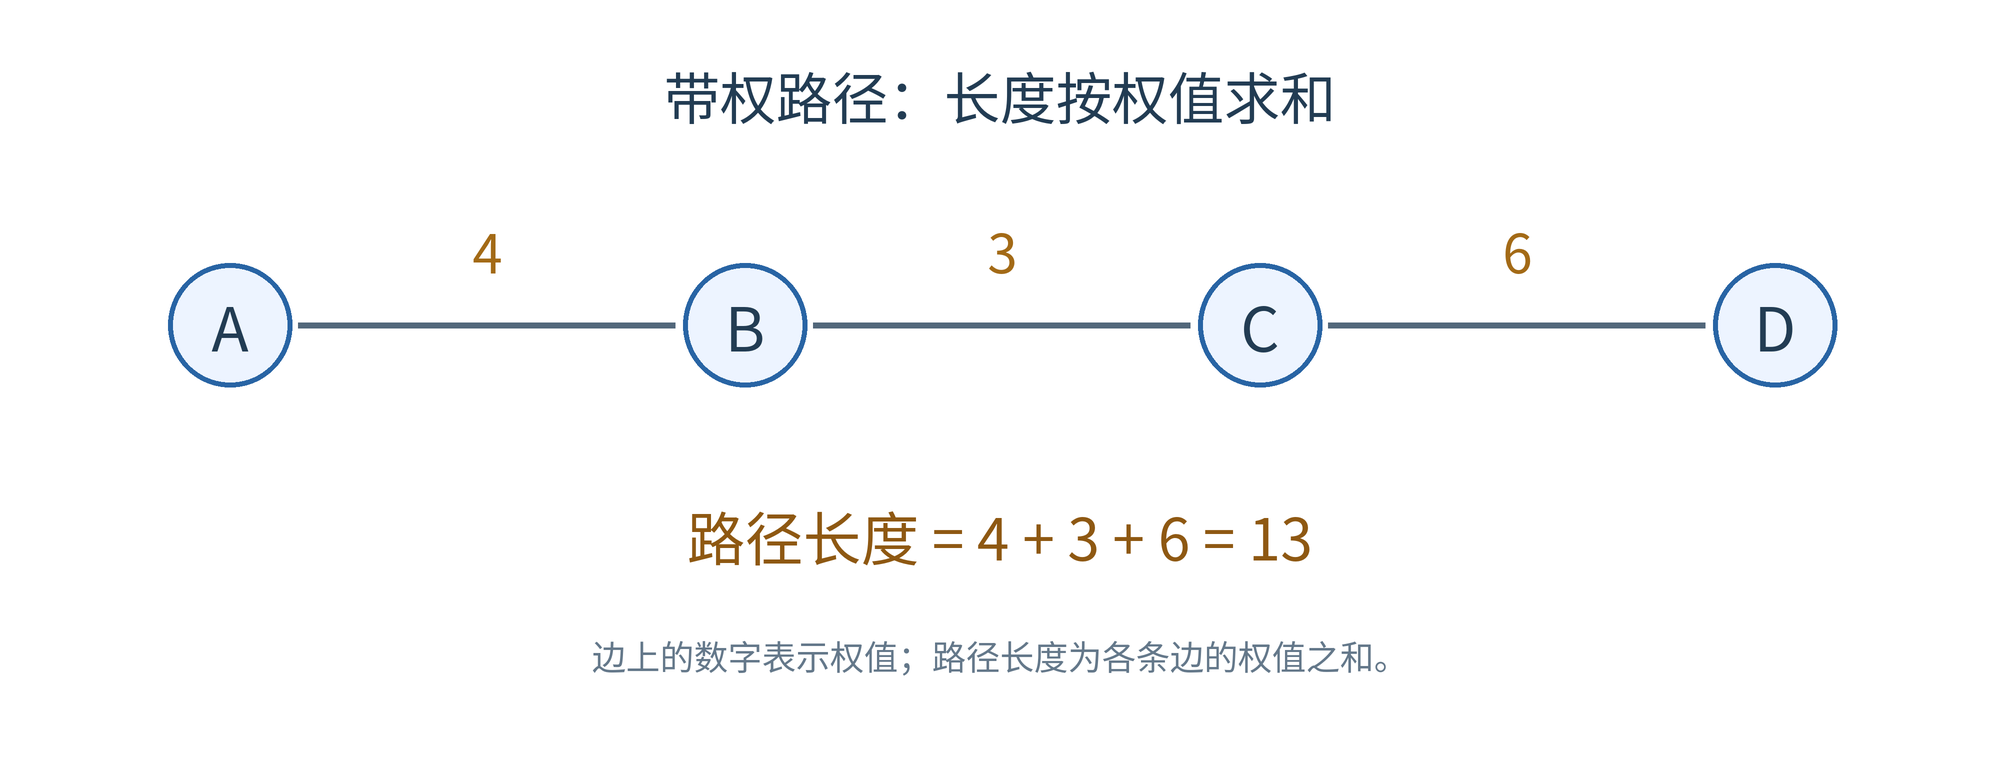
对于带权图,路径长度通常等于路径上所有边权值的总和。例如:
cpp
    4      3      6
A ------------ B ------------ C ------------ D
路径长度为:4+3+6=13
如图所示:
10. 简单路径和回路
如果路径中的顶点不重复,这条路径称为简单路径。
例如:
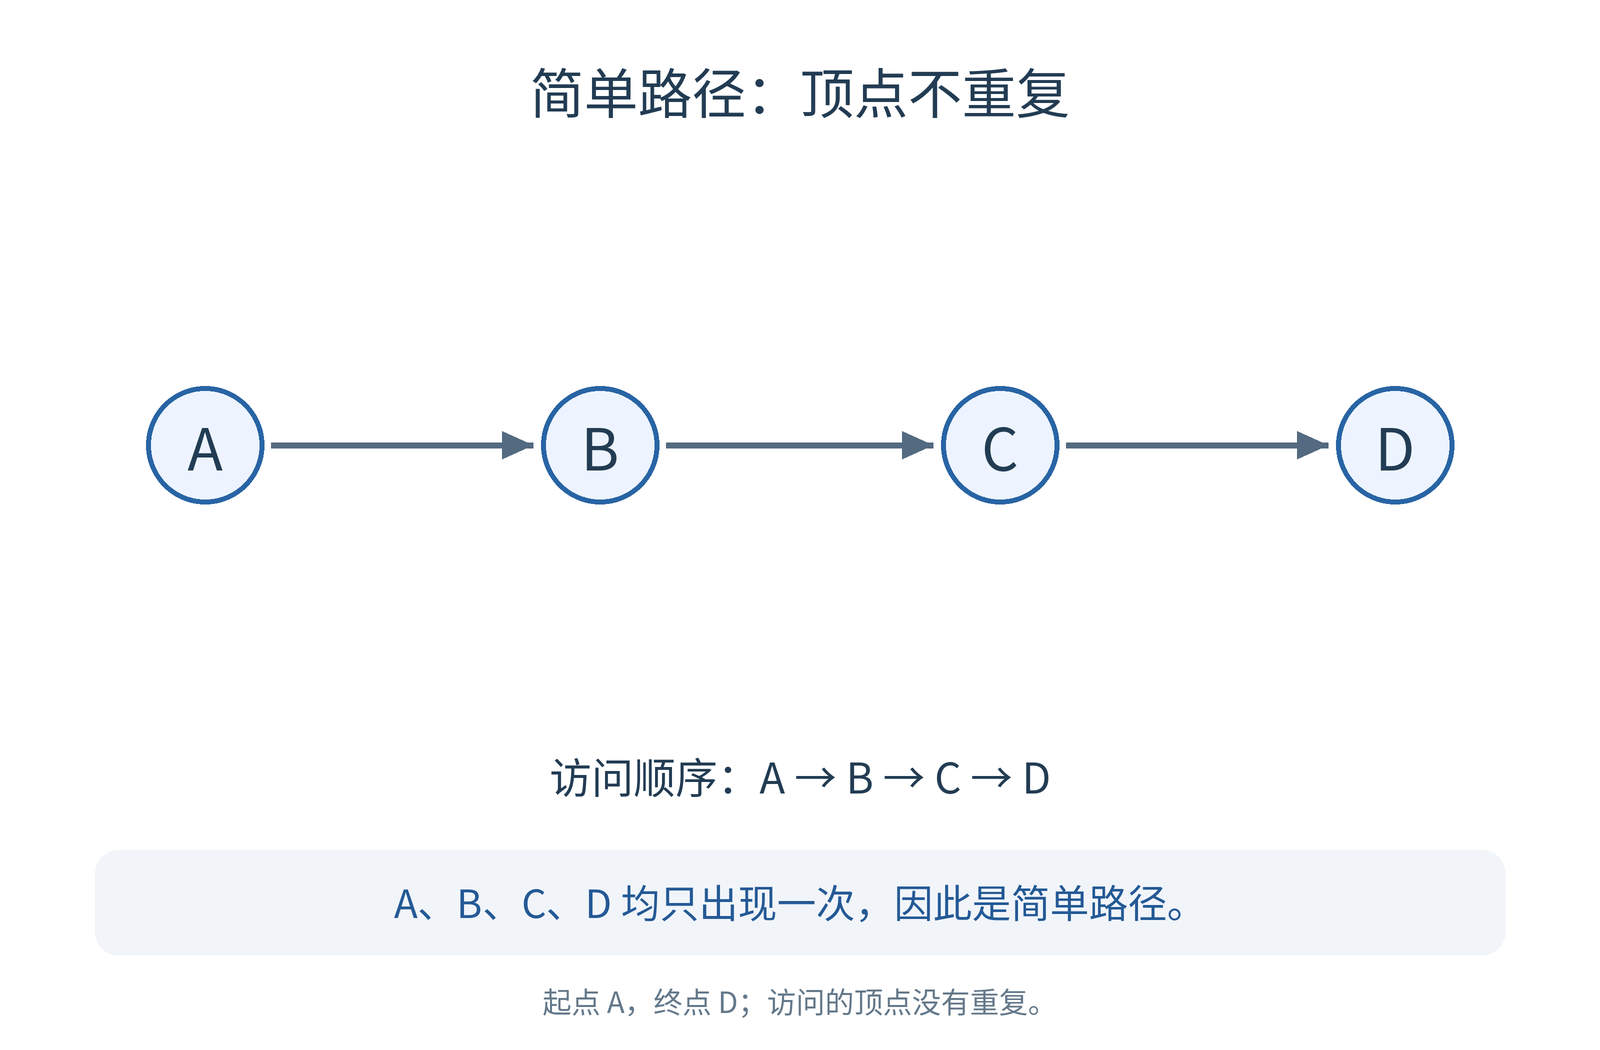
如果路径中出现重复顶点,例如 A→B→C→B→D,那么它不是简单路径。
例如: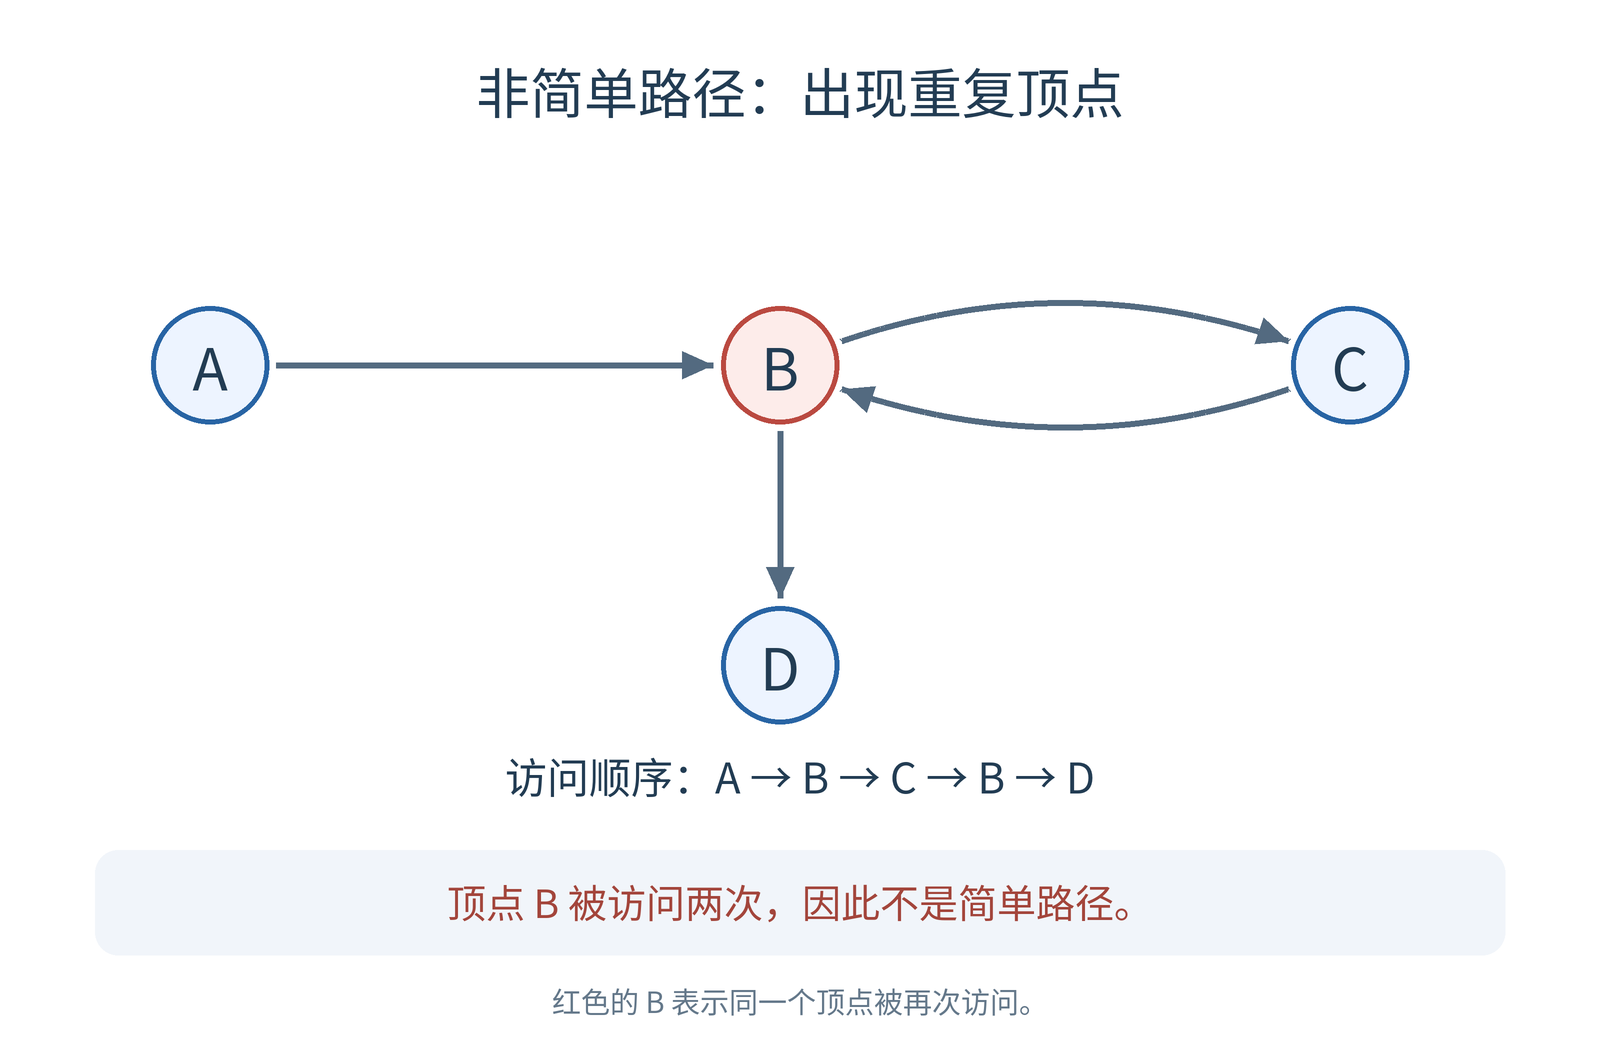
如果一条路径的起点和终点相同,这条路径称为回路或环。
例如:
A → B → C → A
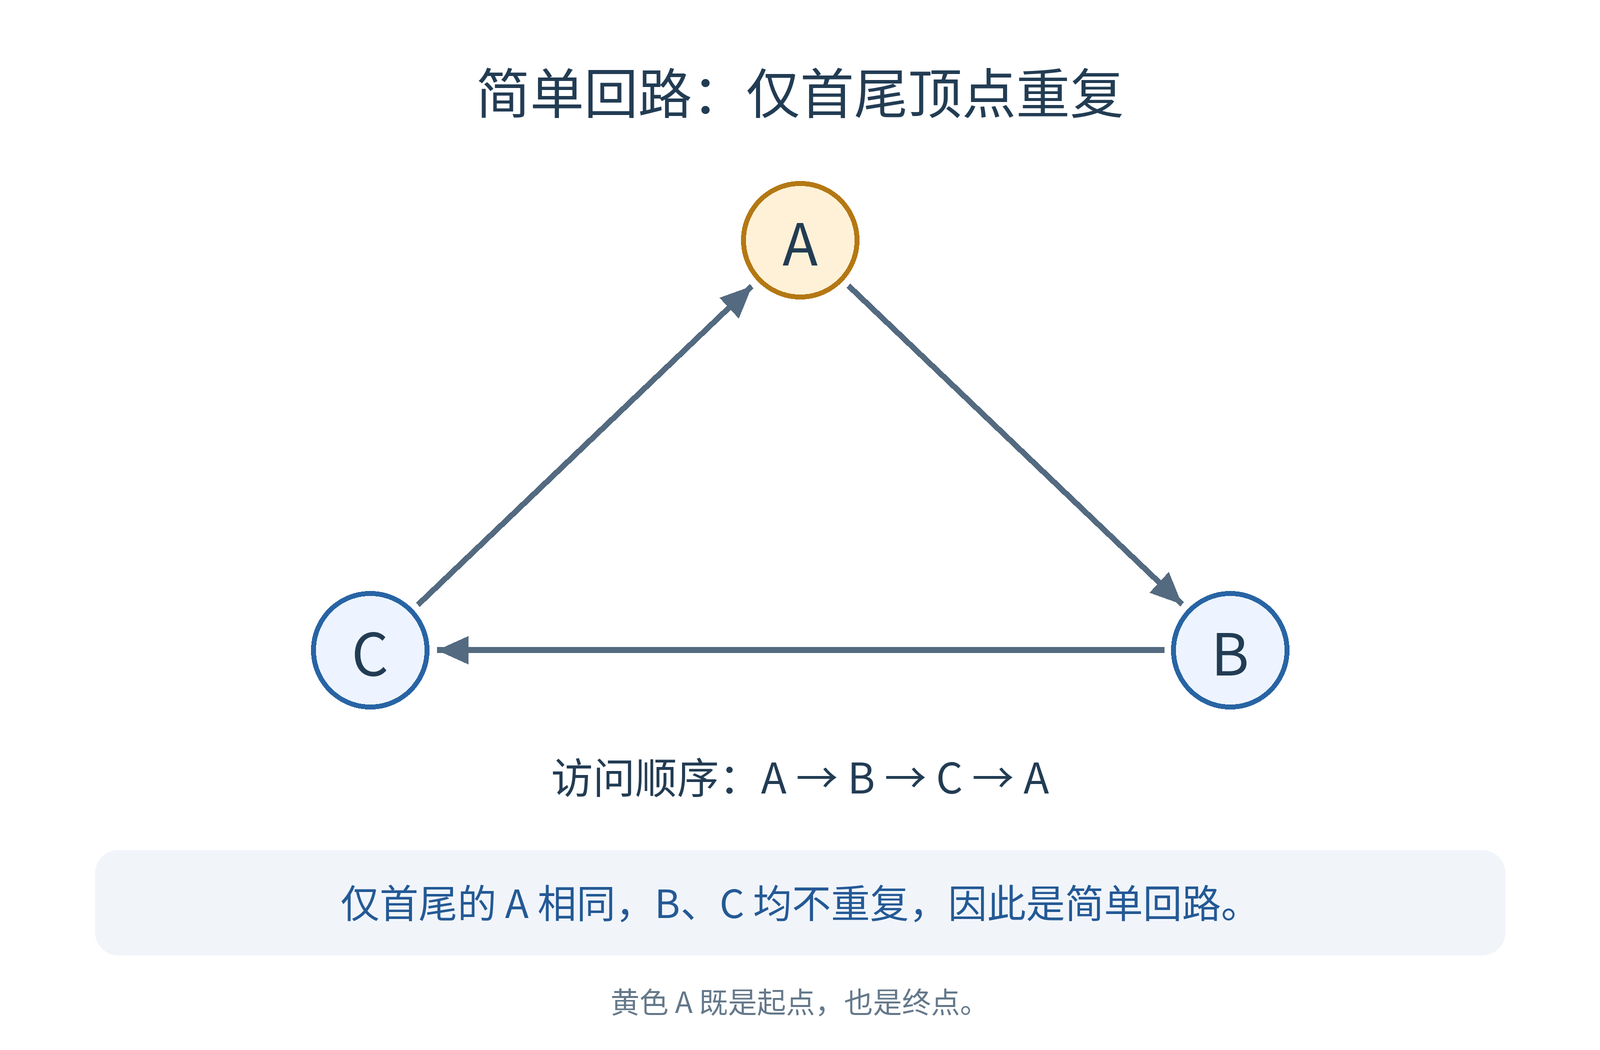
如果除首尾顶点相同外,其他顶点都不重复,那么它称为简单回路。也就是说,简单回路允许起点在最后再次出现,但不允许中间顶点重复。
非简单回路例如:
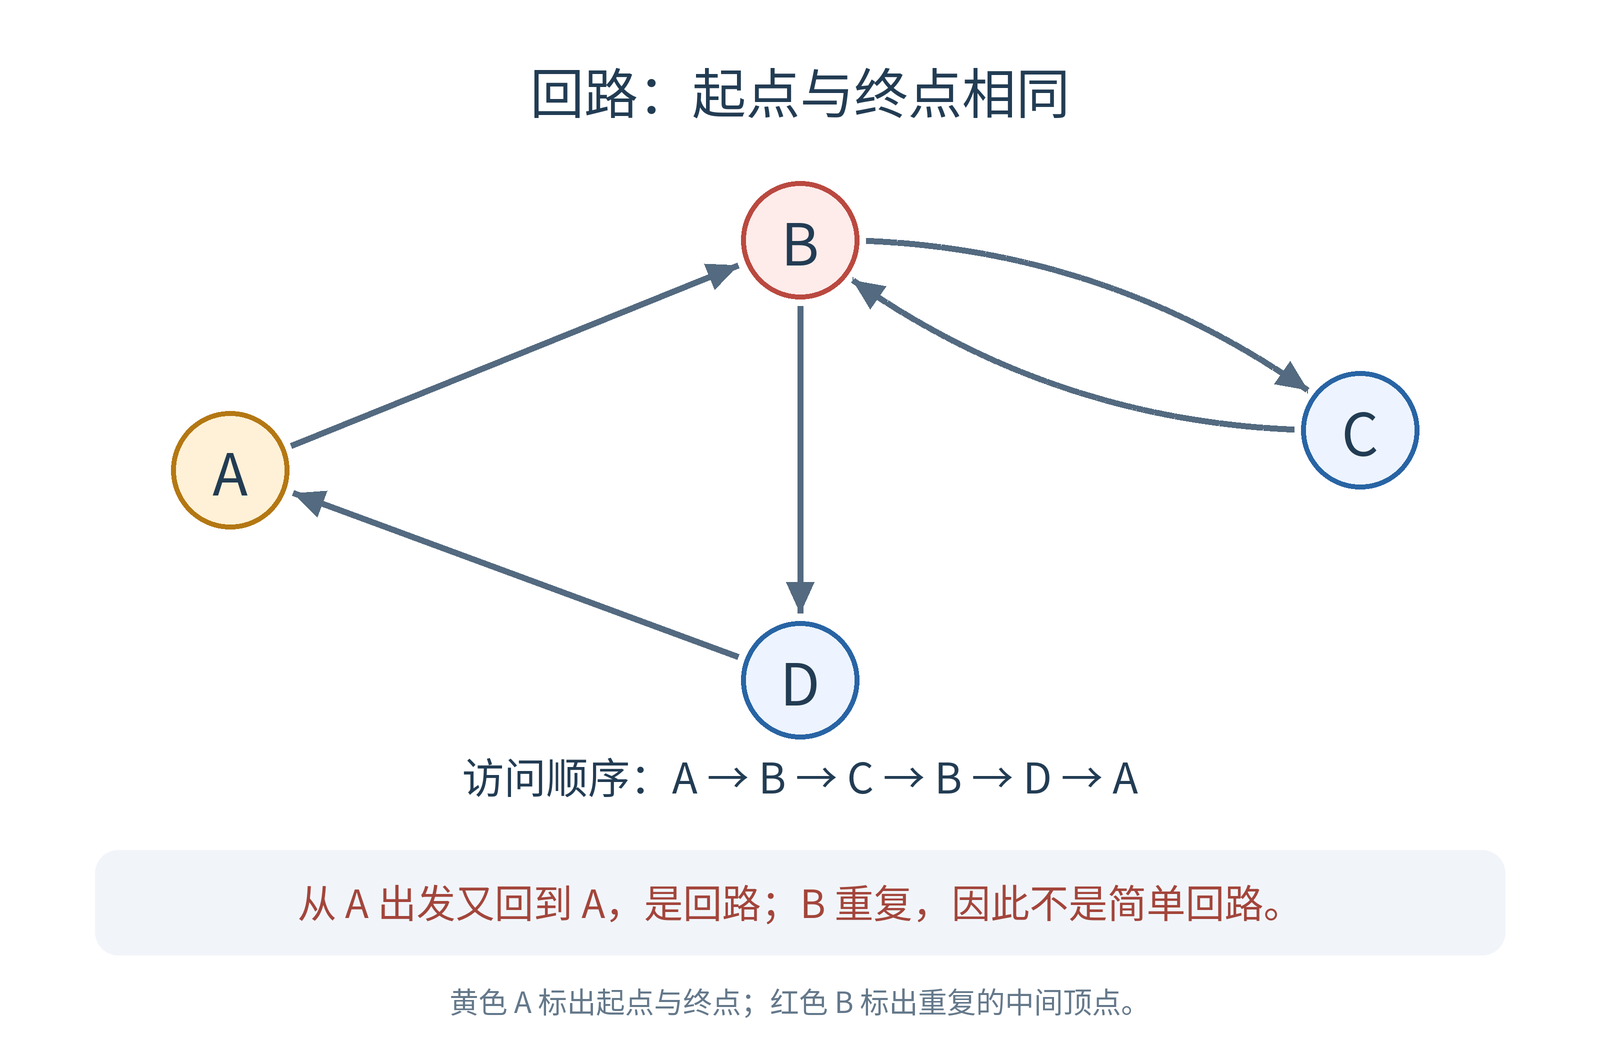
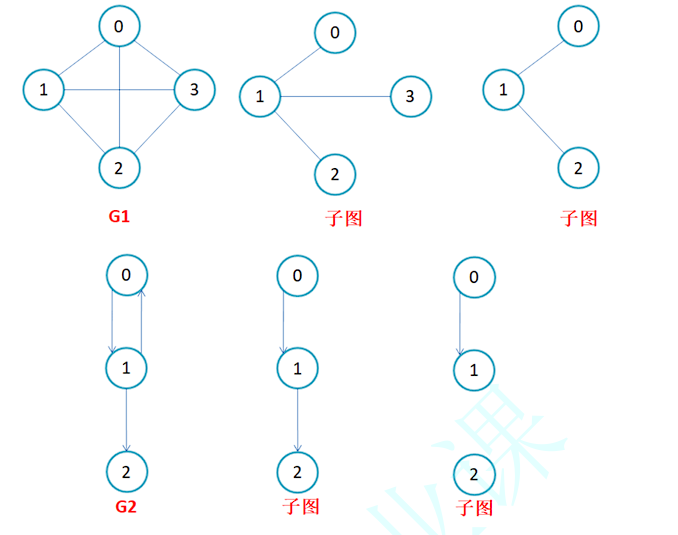
11. 子图
设原图为 G = (V, E),另一个图为 G₁ = (V₁, E₁)。如果满足以下条件,那么 G₁ 就是 G 的子图:
-
V₁ ⊆ V:G₁ 中的所有顶点都来自原图 G。
-
E₁ ⊆ E:G₁ 中的所有边都来自原图 G。
-
E₁ 中每条边的两个端点都属于 V₁:选取一条边时,也必须保留它连接的两个顶点。
可以将子图理解为:从原图中选取部分或全部顶点和边,组成一个新的图。
这里需要区分"子集"和"属于"两个概念:
v ∈ V 表示顶点 v 是集合 V 中的一个元素。
V₁ ⊆ V 表示集合 V₁ 是集合 V 的子集,即 V₁ 中的每个元素都在 V 中。
因此,描述两个顶点集合或两个边集合之间的包含关系时,应使用 ⊆ ,而不是 ∈。另外,⊆ 允许两个集合相等,所以原图本身也是它的子图。
但是通过概念来理解过于抽象了,还是通过图来理解吧!
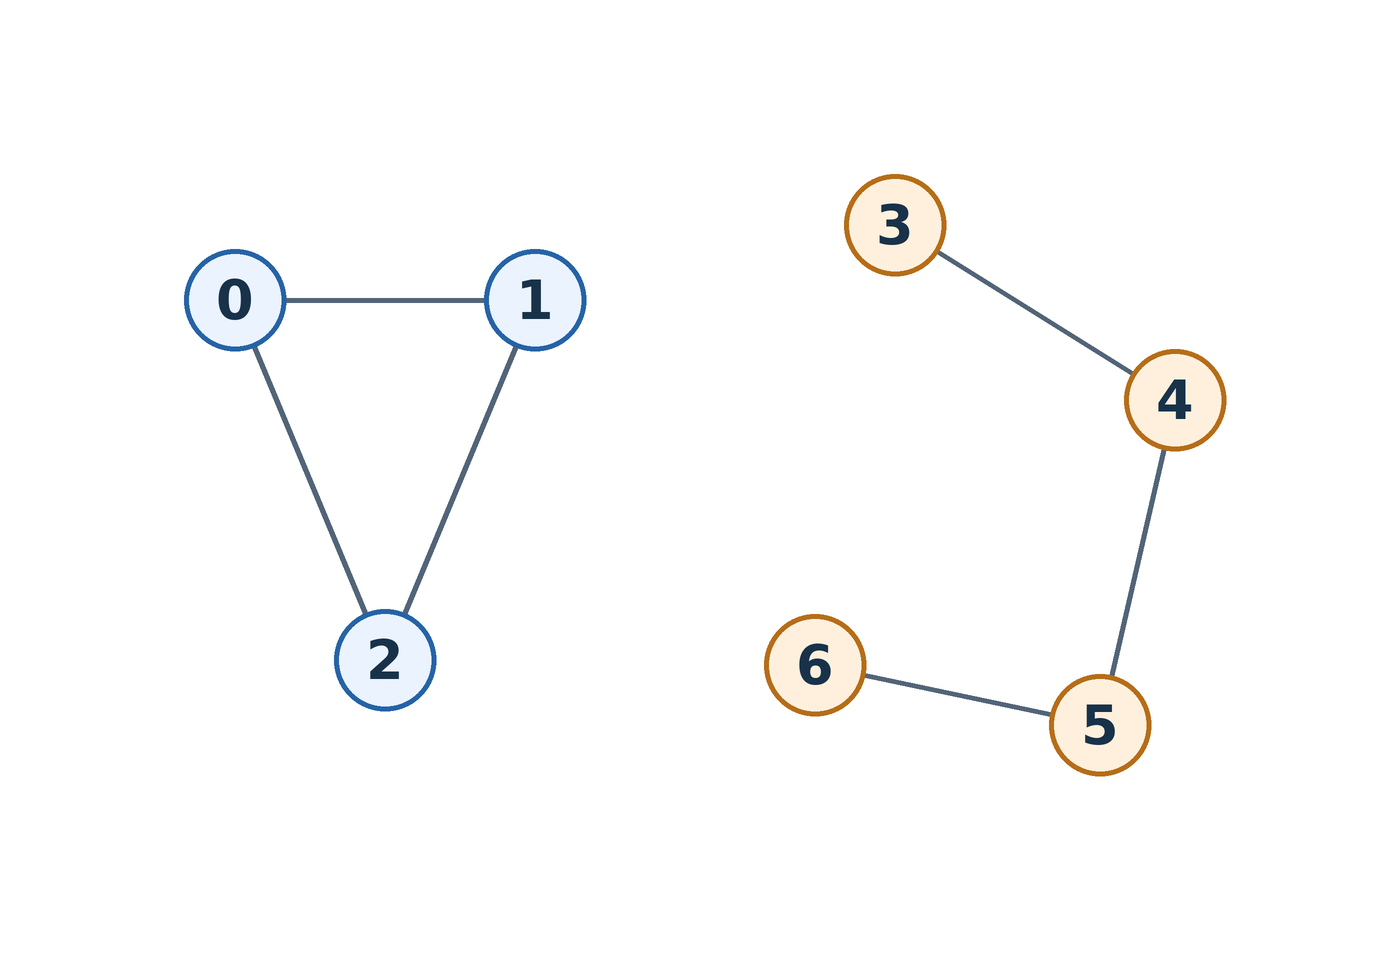
如图:
12. 连通图和连通分量
在无向图中,如果顶点 A 与顶点 B 之间存在路径,就称 A 和 B 连通。
如果任意两个顶点之间都存在路径,那么这个无向图称为连通图。如果图不是连通图,可以把它分成若干个连通分量。
连通分量是极大的连通子图。"极大"表示已经不能再加入原图中的其他顶点,同时仍保持为当前连通子图。
13. 强连通图
强连通是有向图中的概念。
对于有向图中的任意两个顶点 A 和 B,如果既存在从 A 到 B 的路径,也存在从 B 到 A 的路径,那么 A 和 B 是强连通的。
例如:
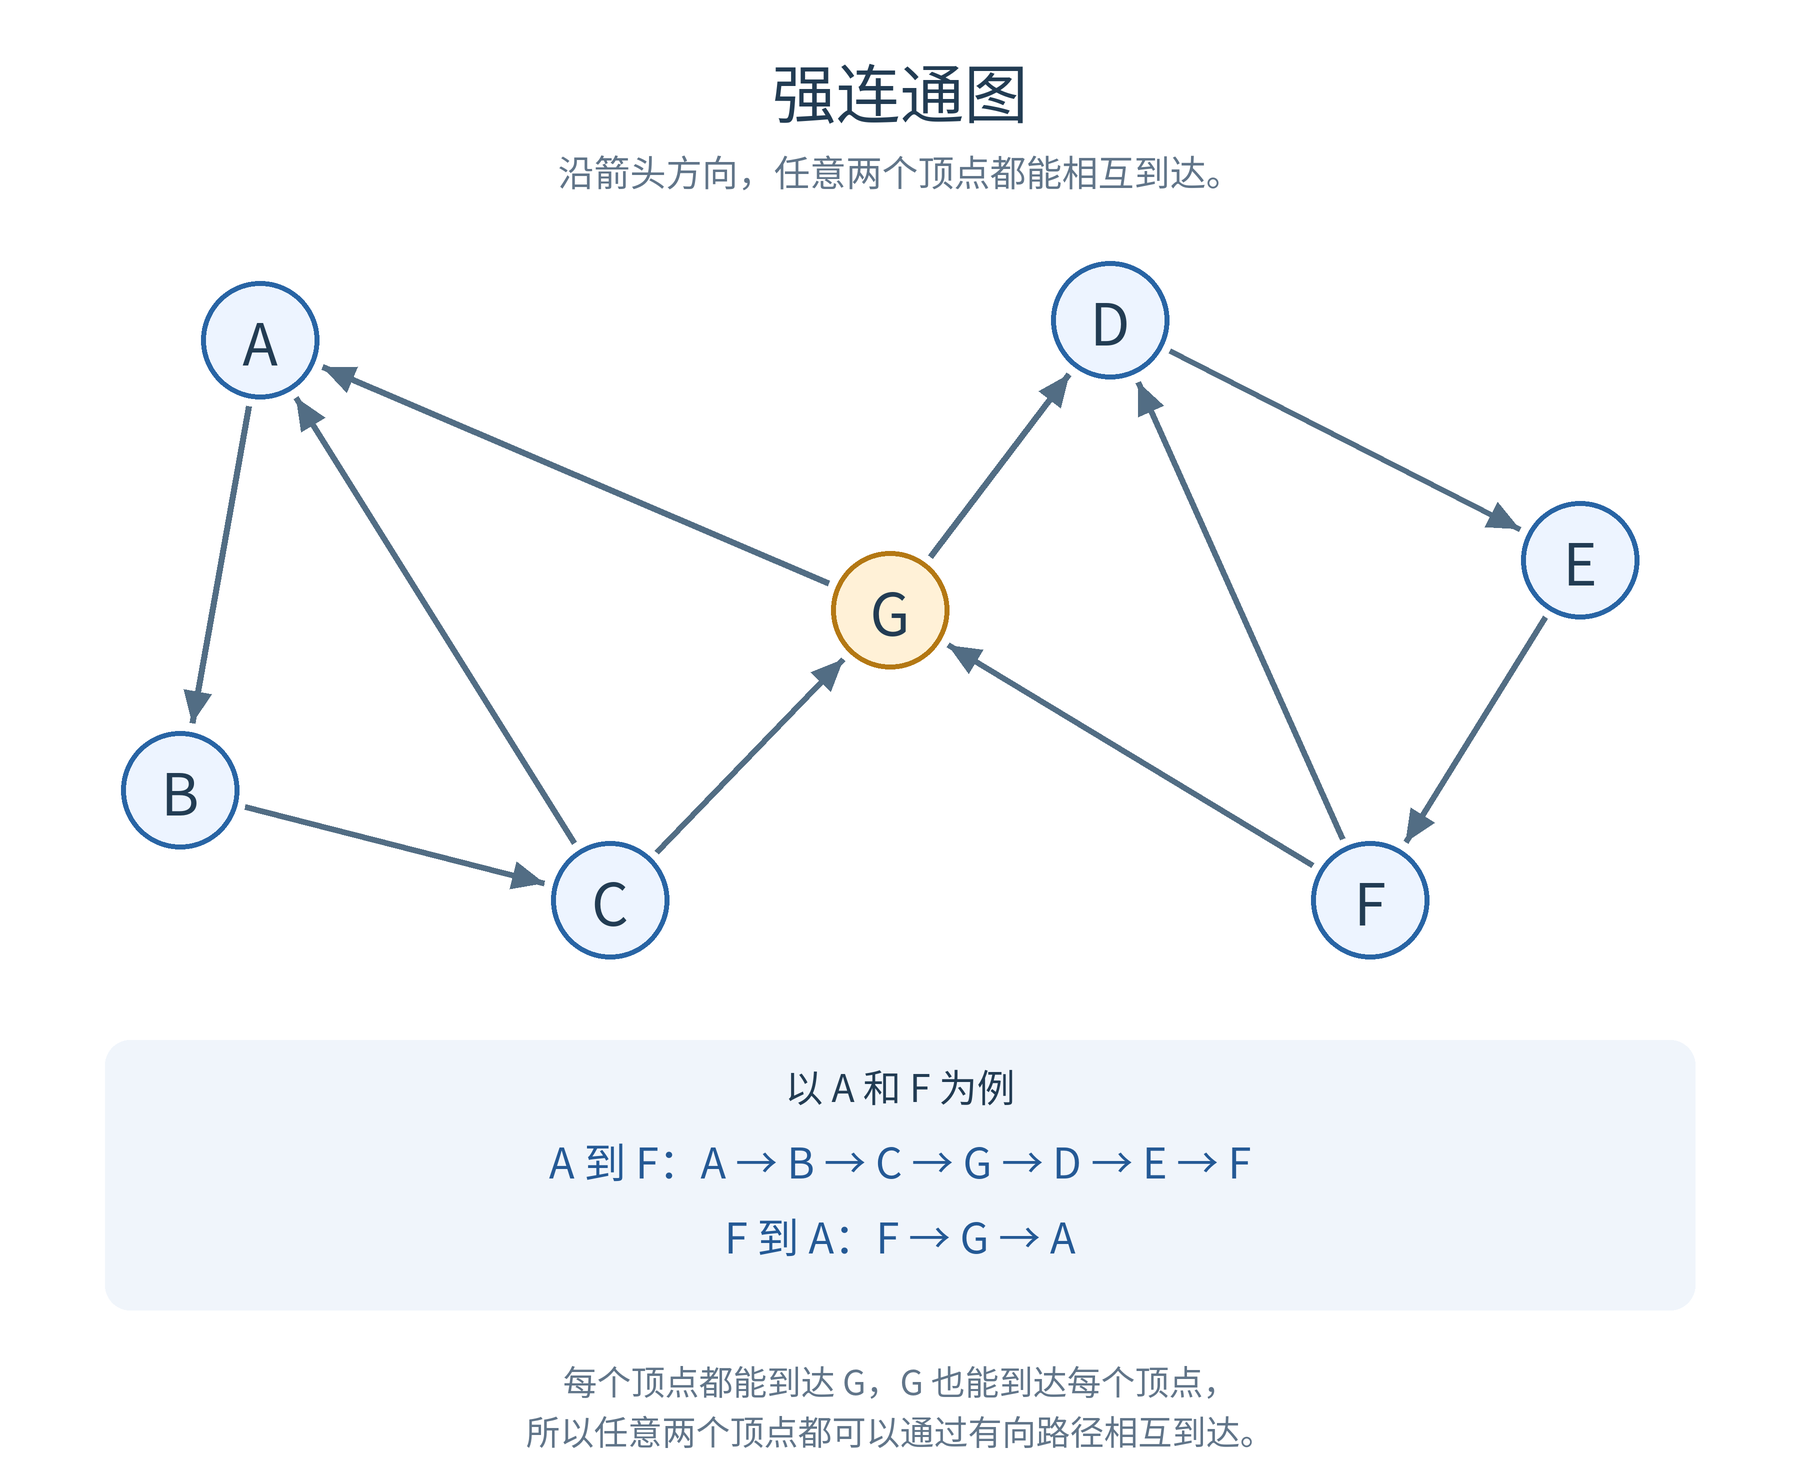
如果图中任意两个顶点都强连通,那么这个图称为强连通图。
A → B → C
忽略方向后,这三个顶点是连通的;但这个有向图不是强连通图,因为 C 无法返回 A。
14. 树与生成树
树可以理解为一个连通且无环的无向图。如果一棵树有 n 个顶点,那么它一定有 n − 1 条边。
不过,反过来不能只根据边数判断一个图是不是树。一个具有 n 个顶点、n − 1 条边的无向图,还需要满足"连通"或"无环"中的任意一个条件,才能确定它是一棵树。
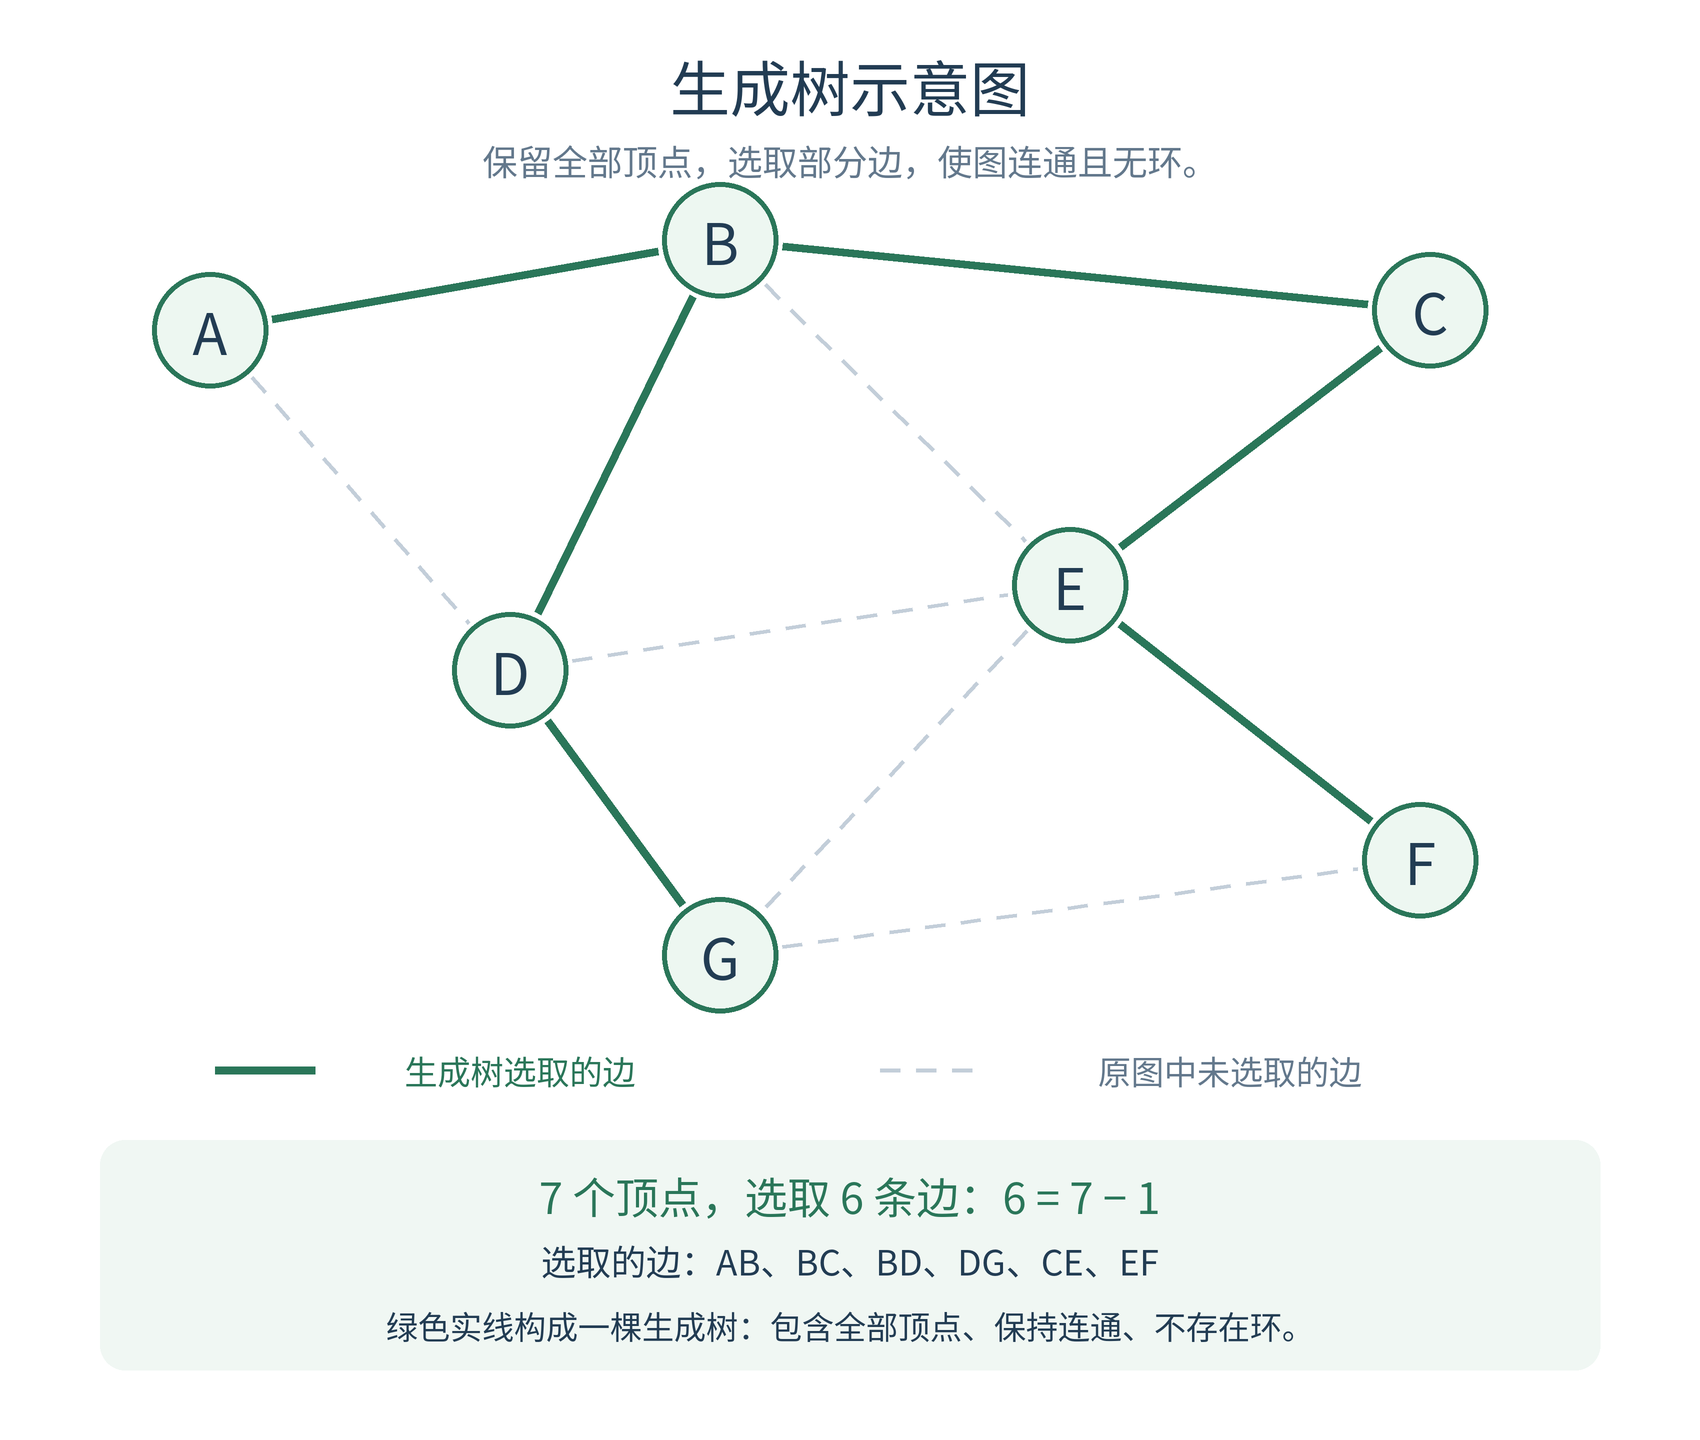
对于一个连通无向图,如果保留原图的全部顶点,并从原图中选取部分边,使得到的子图仍然连通且不存在环,那么这个子图就称为原图的一棵生成树。
可以将生成树理解为:用尽可能少的边,将原图中的所有顶点连接起来。
如图所示:
生成树具有以下性质:
-
顶点全部保留:原图有 n 个顶点,生成树也有 n 个顶点,并且恰好有 n − 1 条边。
-
路径唯一:任意两个顶点之间恰好存在一条简单路径。
-
不能再删边:删除任意一条边,都会使生成树不再连通。
-
不能再加边:在现有顶点之间加入任意一条原来没有的边,都会形成环。
-
生成树不一定唯一:同一个连通无向图可能存在多棵不同的生成树。
二. 图的邻接矩阵存储
1. 基本思想
图需要保存两类信息:顶点以及顶点之间的边关系。
假设图有 n 个顶点,可以先使用一维数组保存顶点 ,再使用一个 n*n 的二维矩阵保存边:
cpp
vector<V> _vertexs;
vector<vector<W>> _matrix;
其中 matrixij 表示编号为 i 的顶点和编号为 j 的顶点之间是否存在边和表示这条边的权值。
2. 无权无向图的邻接矩阵
无权图只需要记录两个顶点之间是否存在边,因此通常规定:
-
matrixij = 1:顶点 i 与顶点 j 之间存在边。
-
matrixij = 0:顶点 i 与顶点 j 之间不存在边。
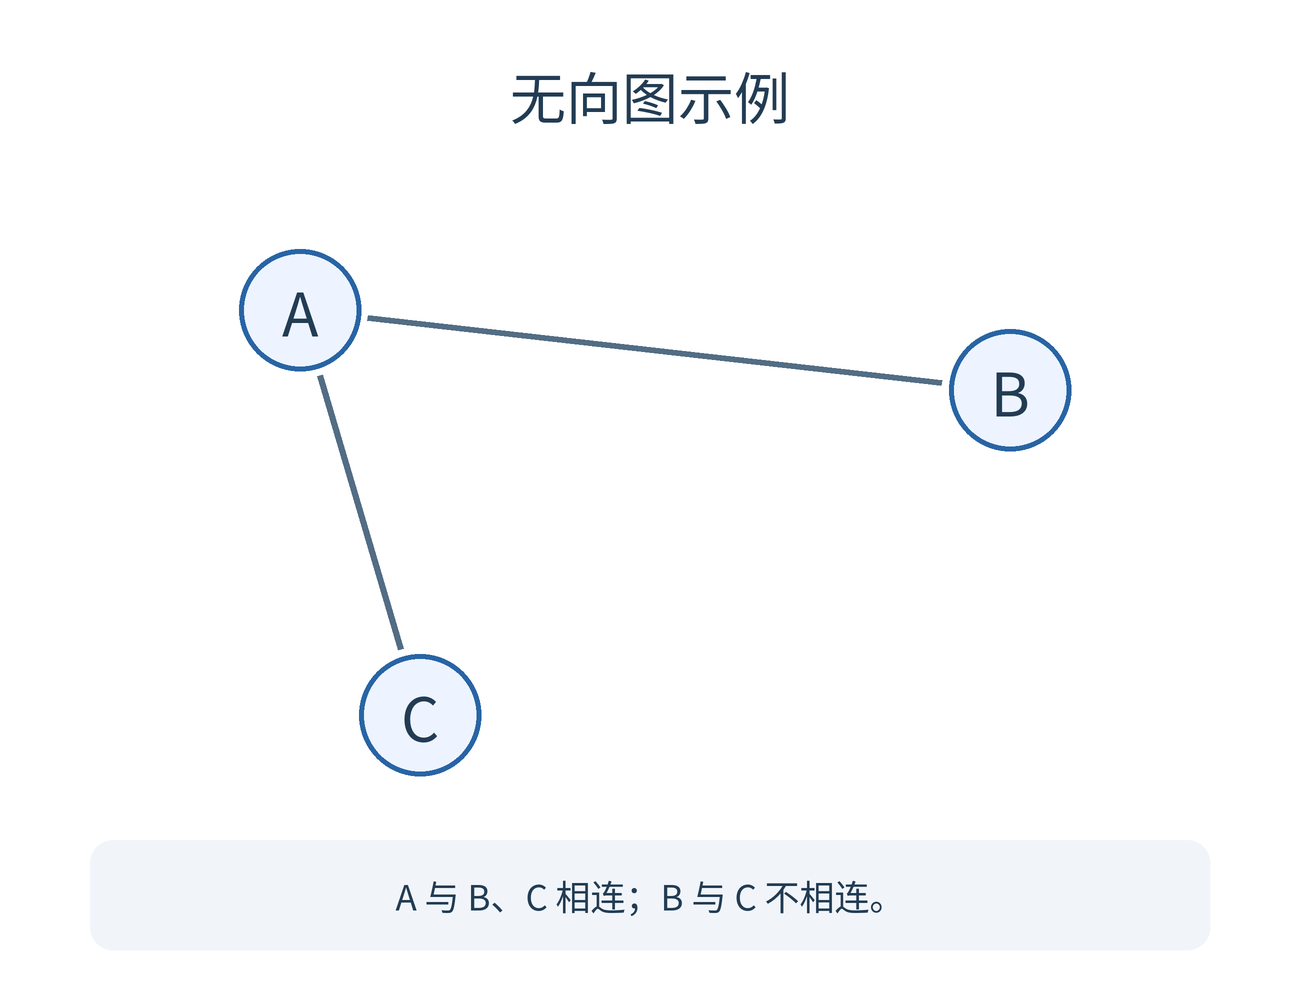
例如,一个无向图有 A、B、C 三个顶点,其中 A 与 B 相连,A 与 C 相连,B 与 C 不相连。
如图:
按照 A、B、C 的顺序建立邻接矩阵:
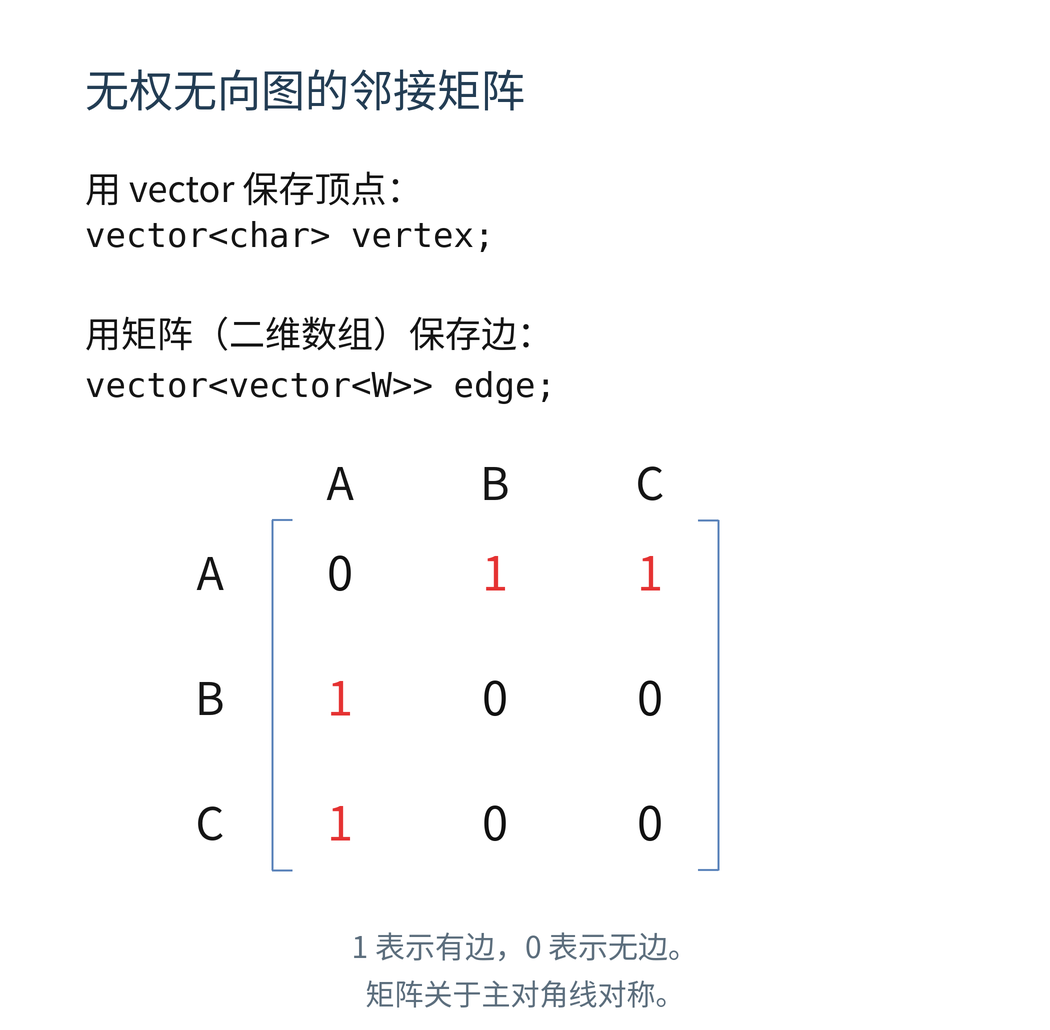
在无向图中,如果 A 与 B 相连,那么 B 与 A 也相连,所以:
matrixij = matrixji
因此,无向图的邻接矩阵关于主对角线对称。如果图中没有自环,主对角线上的元素都是 0。
对于不含自环的简单无向图,第 i 行中每个 1 都对应一条与顶点 i 相连的边,因此:
第 i 行元素之和 = 顶点 i 的度
由于矩阵对称,第 i 列元素之和也等于顶点 i 的度。
例如,A 所在行的元素之和为 0 + 1 + 1 = 2,因此 deg(A) = 2。
3. 无权有向图的邻接矩阵
在有向图中,matrixij 表示是否存在一条从顶点 i 指向顶点 j 的边:
-
matrixij = 1:存在 i → j。
-
matrixij = 0:不存在 i → j。
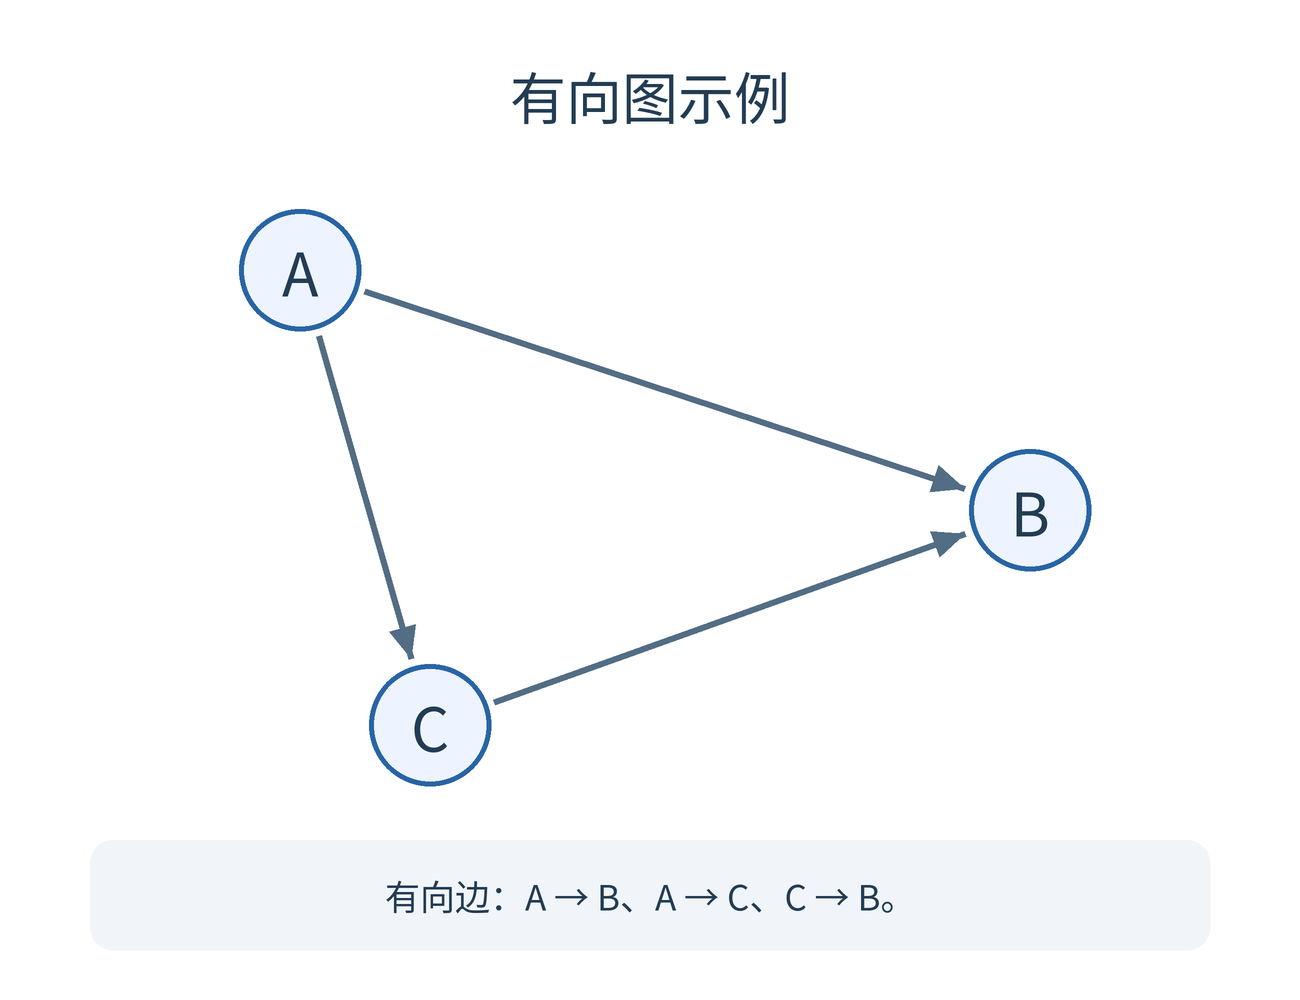
例如,图中有三条有向边:A → B、A → C、C → B。
如图:
按照 A、B、C 的顺序建立邻接矩阵:
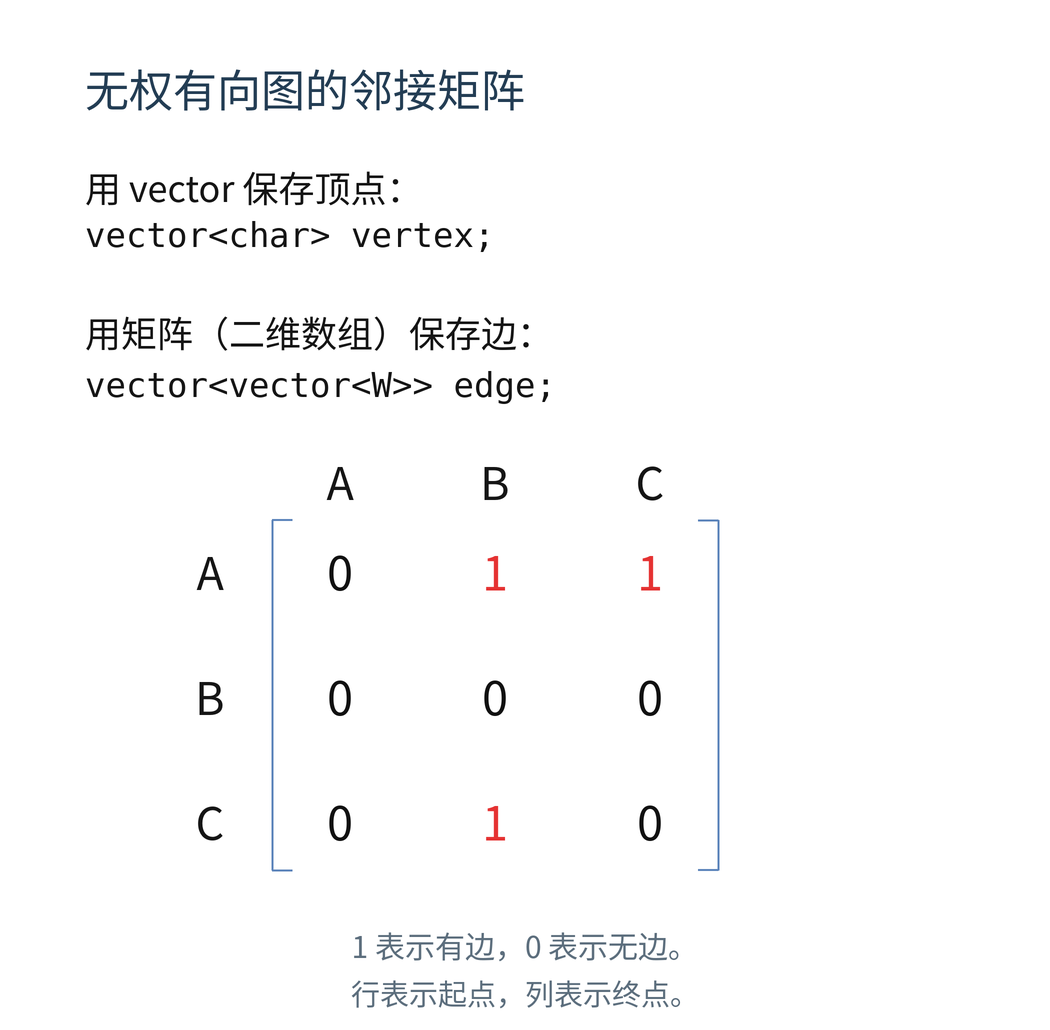
有向边具有方向,存在 i → j,并不代表一定存在 j → i,因此有向图的邻接矩阵一般不对称。
对于简单有向图:
-
第 i 行元素之和表示顶点 i 的出度,因为这一行记录的是"从 i 出发,能够直接到达哪些顶点"。
-
第 i 列元素之和表示顶点 i 的入度,因为这一列记录的是"哪些顶点能够直接到达 i"。
例如,A 所在行的元素之和为 2,因此 outdeg(A) = 2;B 所在列的元素之和为 2,因此 indeg(B) = 2。
4. 带权图的邻接矩阵
带权图不仅需要记录边是否存在,还需要保存边的权值。
如果顶点 i 到顶点 j 存在边,就令:
matrixij = 这条边的权值
如果不存在边,通常使用特殊值 INF 表示,例如:
cpp
const int INF = INT_MAX;这里不宜直接用 0 表示"不存在边",因为图中可能存在权值为 0 的合法边。
需要注意,带权邻接矩阵的行、列元素之和不能直接用来计算度数。计算度数时,应统计实际存在的边,而不是累加权值。
另外,在计算 distu + weight 时,应先确认 distu 不是 INF、对应的边确实存在,并保证相加结果不会溢出。
5. 顶点值和下标的映射
实际程序中的顶点可能是字符、字符串或其他类型,而矩阵下标必须是整数。因此可以同时维护:
vector<V> _vertexs; // 顶点集合
map<V, int> _indexMap; // 顶点映射下标
vector<vector<W>> _matrix; // 邻接矩阵
它们的作用分别是:
cpp
- _vertexs[i]:根据下标 i 找到真正的顶点值。
- _indexMap[v]:根据顶点值 v 找到矩阵下标。
- _matrix[i][j]:保存两个顶点之间的边信息。
例如:
A → 0
B → 1
C → 2
查询 A 到 C 的边时,实际访问 matrix02。
所以大致框架为:
cpp
#pragma once

#include <iostream>
#include <vector>
#include <string>
#include <map>
#include <queue>

namespace Matrix
{
	using namespace std;
	template<class V,class W,W MAX_W=INT_MAX,bool Direction=false>
	class Graph
	{
	public:
        //默认构造函数
		Graph() = default;
	private:
		vector<V> _vertexs;			// 顶点集合
		map<V, int> _indexMap;		// 顶点映射下标
		vector<vector<W>> _matrix;  // 邻接矩阵
	};
}注意:Direction的作用是为了确认这个图是否有向?
6. 初始化矩阵
对于带权图,可以把矩阵初始化为 MAX_W,表示默认不存在边:
cpp
_matrix.resize(n);
for (size_t i = 0; i < n; i++)
{
	_matrix[i].resize(n, MAX_W);
}
对于顶点的初始化和映射哈希的初始化,我们需要通过外部来初始化,所以总体的初始化如下:
cpp
Graph(const V* v, size_t n)
{
	//注意reserve是开辟空间的,但是不开辟size()的大小,而resize是开辟size()的大小的
	_vertexs.resize(n);
	for (size_t i = 0; i < n; i++)
	{
		_vertexs[i] = v[i];
		_indexMap[v[i]] = i;
	}

	_matrix.resize(n);
	for (size_t i = 0; i < n; i++)
	{
		_matrix[i].resize(n, MAX_W);
	}
}
7. 添加边
对于添加边的操作,我们是通过顶点来寻找下标,那么这个下标我们是map来寻找的。
所以我们先写个寻找下标的操作:
cpp
size_t GetVertexIndex(const V& v)
{
	auto it = _indexMap.find(v);
	if (it != _indexMap.end())
	{
		return it->second;
	}
	else
	{
		throw invalid_argument("顶点不存在");
		return -1;
	}
}然后接下来就是通过寻找两个顶点的操作,来添加边,但是要注意判断是否有向,代码如下:
cpp
void _AddEdge(size_t srci, size_t dsti,const W& w)
{
	_matrix[srci][dsti] = w;
	if (Direction == false)
	{
		_matrix[dsti][srci] = w;
	}
}
void AddEdge(const V& src, const V& dst,const W& w)
{
	size_t srci = GetVertexIndex(src);
	size_t dsti = GetVertexIndex(dst);

	_AddEdge(srci, dsti, w);
}
8. 邻接矩阵的优缺点
<1>.优点
-
判断两个顶点之间是否存在边非常快。
-
添加、删除或修改边比较直观。
-
无向图的矩阵具有对称性,便于检查。
-
适合顶点不太多但边很多的稠密图。
-
很多算法可以直接在矩阵上实现,结构清晰。
<2>.缺点
邻接矩阵需要保存一个完整的二维数组,因此它的空间复杂度为 O(V²),其中 V 表示顶点数量。即使图中只有几条边,也需要为所有顶点对保留对应的存储位置。
例如,一个图有 10 万个顶点,邻接矩阵就需要:
100000 × 100000 = 100 亿个元素
如果每个元素占用 4 字节,仅矩阵数据就需要约 40 GB 的内存,开销非常大。因此,邻接矩阵不适合存储顶点很多、边很少的稀疏图。
此外,查找某个顶点的全部邻接点时,需要扫描该顶点对应的一整行,逐个判断是否存在边。因此,这个操作的时间复杂度为 O(V),即使该顶点实际只连接了少数几个顶点,也需要检查整行。
- 打印边时的注意事项
对于无向图,同一条边会在矩阵中出现两次:matrixij 和 matrixji。打印时可以只处理 i < j 的位置,避免重复输出。
对于有向图不能使用 i < j 过滤,因为两个方向表示不同的边,并且i > j 的位置也可能存在合法边。有向图应检查矩阵中的所有有效位置。
代码如下:
cpp
void Print()
{
	size_t n = _vertexs.size();
	for (size_t i = 0; i < n; i++)
	{
		cout << i << "->" << _vertexs[i] << endl;
	}
	cout << endl;
	cout << "  ";
	for (size_t i = 0; i < n; i++)		cout << i << " ";
	cout << endl;
	for (size_t i = 0; i < n; i++)
	{
		cout << i<<" ";
		for (size_t j = 0; j < n; j++)
		{
			if (_matrix[i][j] == MAX_W)
			{
				cout << "*" << " ";
			}
			else
			{
				cout << _matrix[i][j] << " ";
			}
		}
		cout << endl;
	}
}
三. 图的遍历
1. 什么是图的遍历
图的遍历是从某个顶点出发,按照一定规则访问图中的顶点,并对顶点执行输出、统计、查找等操作。
图的两种基本遍历方式是:
-
广度优先搜索 BFS 。
-
深度优先搜索 DFS。
图和树的重要区别是,图中可能存在环。同一个顶点还可能被多个顶点指向。因此不能仅靠"向下访问"来避免重复,必须额外记录顶点是否已经访问。
cpp
vector<bool> visited(n, false);顶点第一次被发现后,将对应位置设置为 `true`。后续再遇到它时直接跳过。
2. 广度优先搜索 BFS
2.1.核心思想
BFS 的访问方式像水波一样,从起点向外一层一层扩散:
<1>. 先访问起点。
<2>. 再访问与起点直接相邻的所有顶点。
<3>. 再访问与起点相距两条边的顶点。
<4>. 然后继续访问更远的层次。
BFS 使用队列,因为队列先进先出的特点能够保证先发现的顶点先展开。
2.2. BFS 的基本过程
以起点 A 为例:
<1>. 将 A 标记为已访问,并让 A 入队。
<2>. 当队列不为空时,取出队头顶点。
<3>. 访问队头顶点的所有邻接点。
<4>. 对每个尚未访问的邻接点,立即标记并让它入队。
<5>. 重复以上过程,直到队列为空。
关键规则是:顶点入队时就要标记为已访问,不能等到出队时才标记。否则,同一个顶点可能被多个顶点同时发现,从而重复进入队列。
2.3. BFS 示例
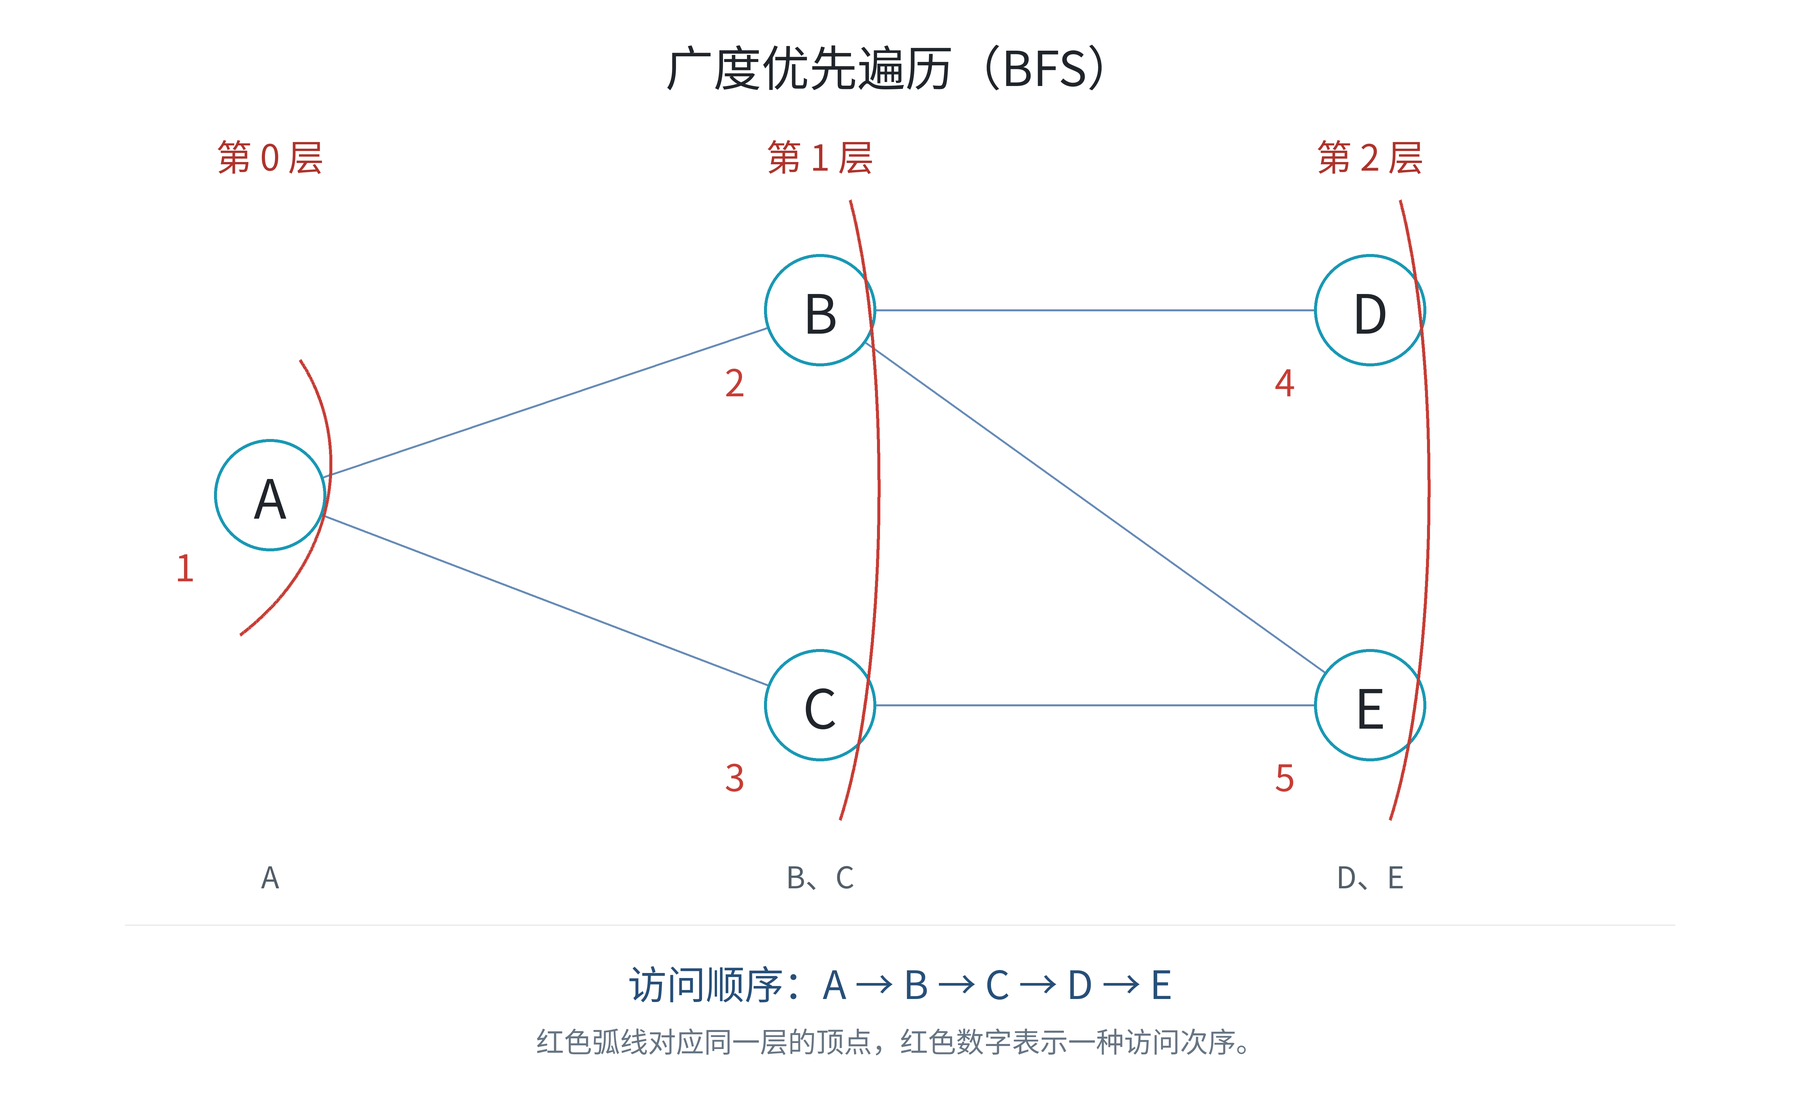
从 A 开始进行 BFS,先访问第 0 层的 A,再访问第 1 层的 B、C,最后访问第 2 层的 D、E。本例的一种访问顺序是:A、B、C、D、E。
邻接点的检查顺序可能改变同一层内的访问顺序,但 BFS 始终按照"一层一层"的方式遍历。
过程如图所示:
4. 邻接矩阵版本的 BFS
cpp
void BFS(const V& src)
{
	size_t srci = GetVertexIndex(src);
	size_t n = _vertexs.size();
	queue<int> q;
	vector<bool> visited(n, false);
	q.push(srci);
	visited[srci] = true;

	while (!q.empty())
	{
		size_t sz = q.size();
		for (size_t i = 0; i < sz; i++)
		{
			size_t front = q.front();
			q.pop();
			cout << front << "->" << _vertexs[front] << " ";
			for (size_t j = 0; j < n; j++)
			{
				if (_matrix[front][j] != MAX_W && !visited[j])
				{
					q.push(j);
					visited[j] = true;
				}
			}
			cout << endl;
		}
	}
}
3. 深度优先搜索 DFS
3.1. 核心思想
DFS 的思想是沿着一条道路尽可能深入,直到当前顶点没有尚未访问的邻接点,再回退到上一个分叉位置,继续尝试其他道路。
DFS 可以使用递归,也可以显式使用栈。递归实现本质上利用了函数调用栈。
3.2. DFS 的基本过程
对当前顶点 current:
<1>. 把 current 标记为已访问。
<2>. 对 current 执行访问操作。
<3>. 依次检查它的邻接点。
<4>. 遇到尚未访问的邻接点,就从该邻接点继续 DFS。
<5>. 如果没有可继续访问的邻接点,就返回上一层。
3.3. DFS 示例
仍使用下面的图:
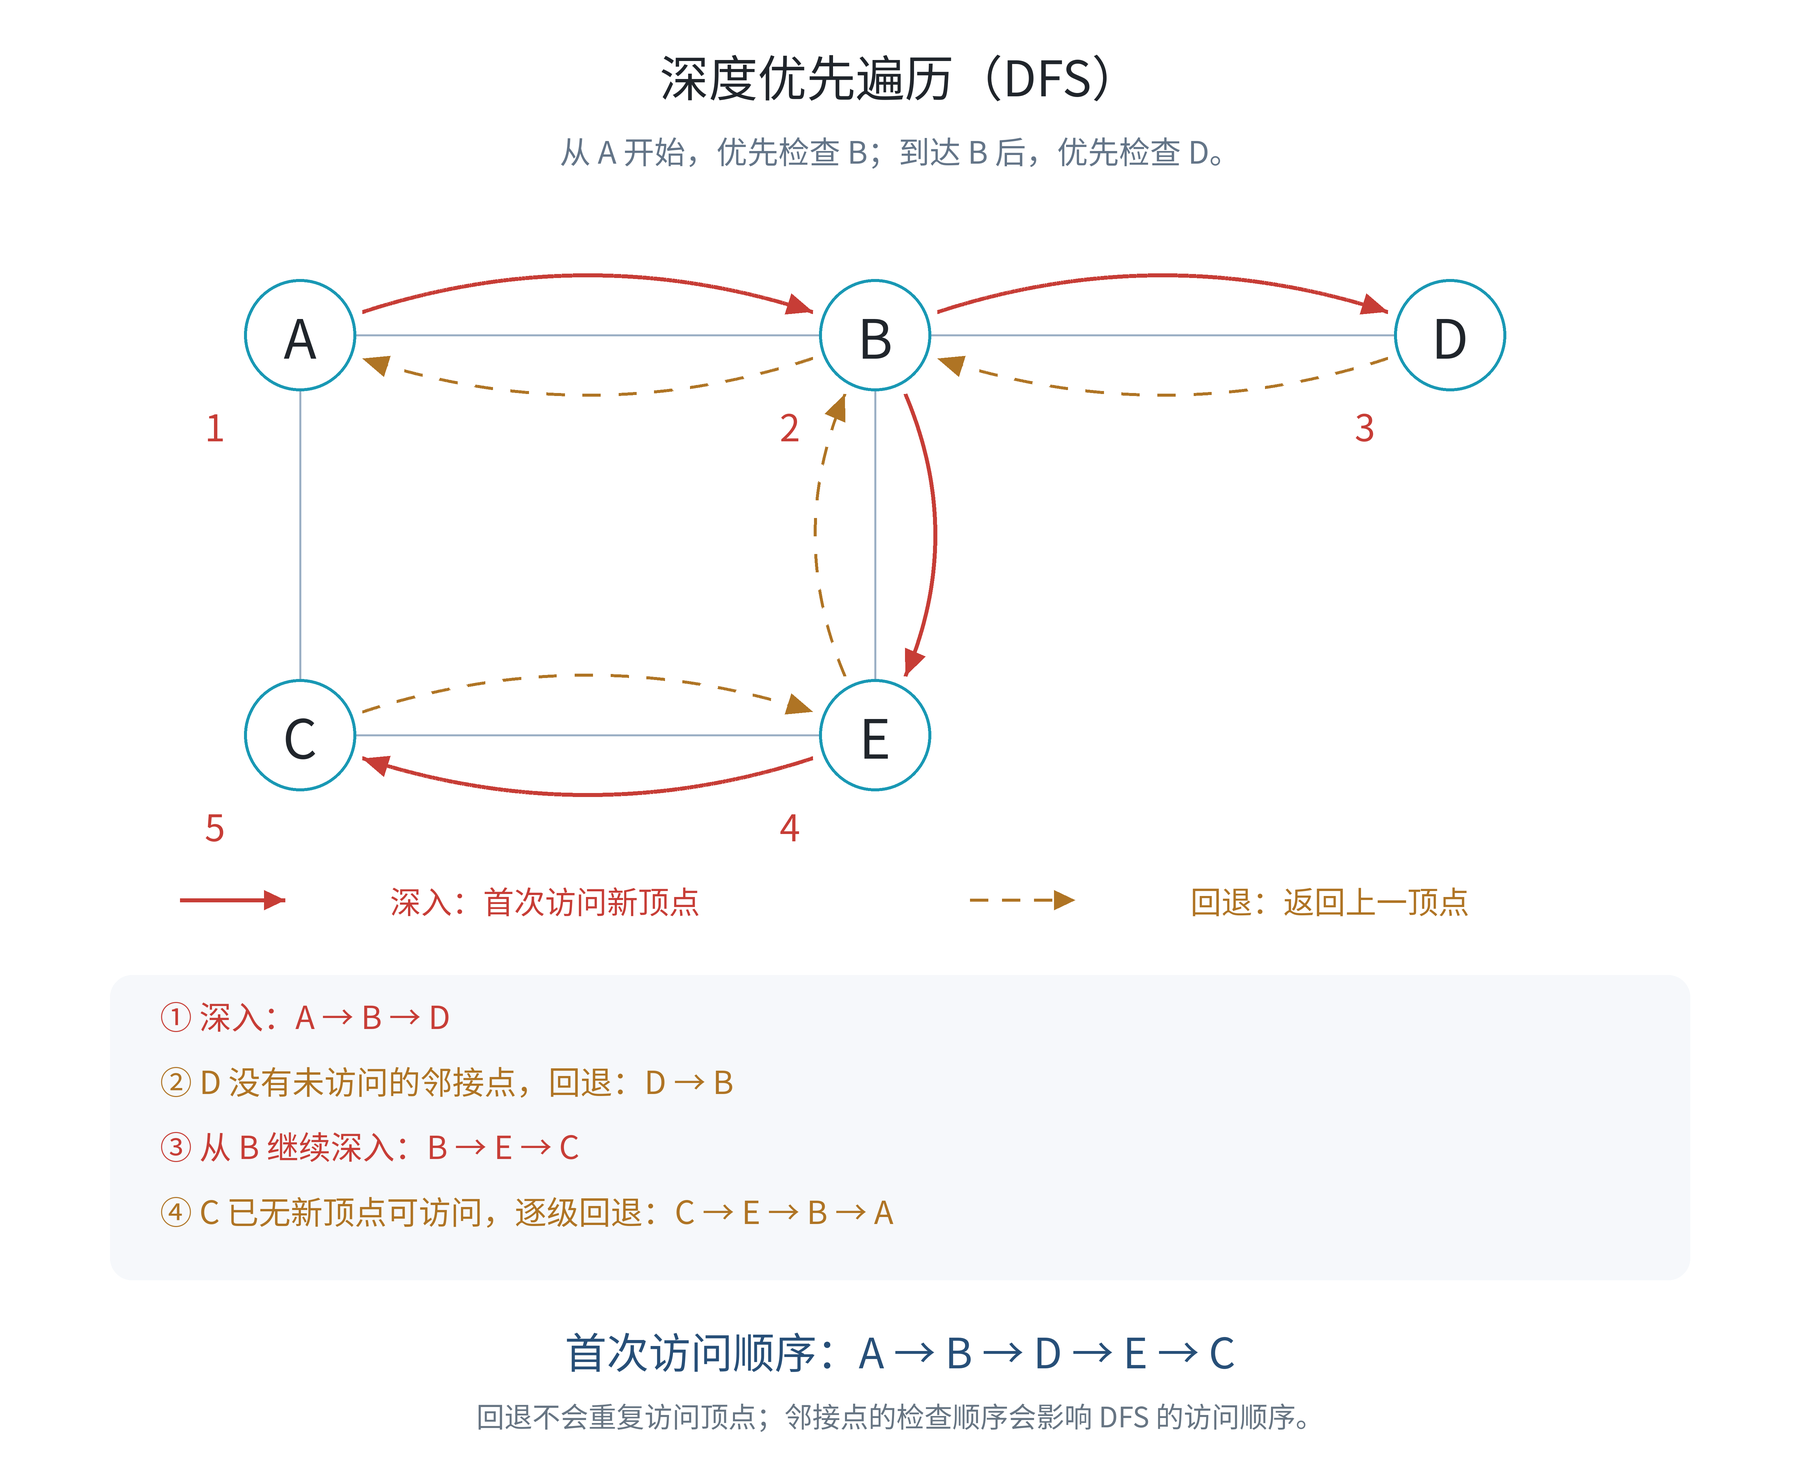
从 A 开始,假设优先检查 B:A → B → D
D 没有新的邻接点,于是回退到 B,再尝试 E;从 E 还可以继续到 C。一个可能的 DFS 顺序是:
A B D E C。
DFS 顺序同样受顶点编号和邻接点检查顺序影响,但"深入后回退"的基本规律不变。
3.4. 邻接矩阵版本的递归 DFS
cpp
void _DFS(size_t srci, vector<bool>& visited)
{
	cout << srci <<"->"<< _vertexs[srci] << endl;
	visited[srci] = true;
	size_t n = _vertexs.size();
	for (size_t i = 0; i < n; i++)
	{
		if (_matrix[srci][i] != MAX_W && !visited[i])
		{
			_DFS(i, visited);
		}
	}
}
void DFS(const V& src)
{
	size_t srci = GetVertexIndex(src);
	vector<bool> visited(_vertexs.size(), false);

	_DFS(srci, visited);
}
责递归遍历一个连通分量。visited 必须使用引用传递,这样所有递归层操作的是同一份访问记录。如果按值传递,每一层都会复制数组,访问状态就无法正确共享。
但是如果这个**不是个连通图呢?**那么就要遍历一下visited数组了,需要在外层继续检查:
cpp
void DFSAll()
{
    vector<bool> visited(_vertexs.size(), false);

    for (size_t i = 0; i < _vertexs.size(); ++i)
    {
        if (!visited[i])
        {
            _DFS(i, visited);
        }
    }
}
每调用一次 _DFS,就会遍历一个新的连通分量。
总结:本篇从图的基本概念出发,介绍了顶点、边、路径、连通性与生成树,并使用 C++ 实现了邻接矩阵的存储方式。邻接矩阵能够方便地判断两个顶点之间是否存在边,但需要 O(V²) 的空间,更适合规模较小或边较多的图。遍历方面,BFS 借助队列逐层访问,DFS 借助递归或栈深入探索并回退,两者都需要记录访问状态,避免重复访问。掌握这些内容,就为后续学习最短路径、最小生成树等图算法打下了基础。