目录
- 开头
- [一.DML(Data Manipulation(操作) Language)------ CURD](#一.DML(Data Manipulation(操作) Language)—— CURD)
-
- [1. Create(新增) : insert 数据插入](#1. Create(新增) : insert 数据插入)
-
- (1)两种插入形式
-
- [a. 单行全列插入](#a. 单行全列插入)
- [b. 多行指定列插入](#b. 多行指定列插入)
- (2)插入冲突的两种解决方案
-
- [a.on duplicate key update](#a.on duplicate key update)
- [b. replace into](#b. replace into)
- [2.Retrieve (检索):SELECT 数据查询](#2.Retrieve (检索):SELECT 数据查询)
- 3.Update (更新)
- 4.Delete(删除)
-
- [(1)delete 删除](#(1)delete 删除)
- [(2)truncate 截断表](#(2)truncate 截断表)
- 5.插入查询结果
- [6. 聚合统计](#6. 聚合统计)
- [7. group by 分组查询](#7. group by 分组查询)
-
- (1)简单分组
- [(2)having : 分组后过滤](#(2)having : 分组后过滤)
- [8. SQL执行顺序 (重要)](#8. SQL执行顺序 (重要))
- [二. 内置函数](#二. 内置函数)
-
- [1. 日期时间函数](#1. 日期时间函数)
-
- (1)获取当前时间类
-
- [a. current_date()](#a. current_date())
- b.current_time()
- [c. now() / current_timestamp()](#c. now() / current_timestamp())
- (2)日期提取与计算
-
- a.date(datetime)
- [b.date_add(date,interval 值 单位)](#b.date_add(date,interval 值 单位))
- [c. date_sub(date,interval 值 单位)](#c. date_sub(date,interval 值 单位))
- d.datediff(date1,date2)
- 2.字符串函数
-
-
- [a.concat(str1,str2,....) :字符串拼接](#a.concat(str1,str2,....) :字符串拼接)
- [b.length(str) :所占字节](#b.length(str) :所占字节)
- c.substring(str,起始位置,长度):字符串截取
- d.instr(str,子串):查询子串
- e.replace(str,旧子串,新子串):替换子串
- [f. ucase / lcase 大小写替换](#f. ucase / lcase 大小写替换)
- [g.left / right :截取](#g.left / right :截取)
- h.空格处理
- i.charset(str)
-
- 3.数学函数
- 4.其他常用函数
- [三. 复合查询](#三. 复合查询)
-
- 1.多表查询
- 2.自连接
- 3.子查询(嵌套查询)
-
- (1)多行子查询
- (2)多行子查询
-
- a.in:等于其中任意一个
- [b.all :比所有都...](#b.all :比所有都...)
- c.any:比任意一个...
- (3)多列子查询
- [(4)from 子句中的子查询(派生表)](#(4)from 子句中的子查询(派生表))
- 4.合并查询
- 结尾
- 往期回顾
开头
Ok了,上一期我们认识了什么是MySQL,学习了相关的DDL操作、数据类型、表的约束。下面我们趁热打铁,接着学习DML,内置函数、复合查询。
这部分是 MySQL 最核心的数据操作与查询能力,也是实际开发中使用频率最高的内容
一.DML(Data Manipulation(操作) Language)------ CURD
1. Create(新增) : insert 数据插入
用于向数据表中新增数据行,支持单行、批量、冲突处理等多种形式
基本语法
INSERT [INTO] 表名 [(列名1, 列名2, ...)]
VALUES (值列表1), (值列表2), ...
核心规则:
- 列名可省略,省略时,默认按表定义的列顺序匹配所有列------全列插入
- 值列表的数量、顺序、数据类型必须与指定列一一对应。
- 未指定的列,会自动填充默认值(无默认值则填充 NULL)
(1)两种插入形式
下面用这个作为例子:
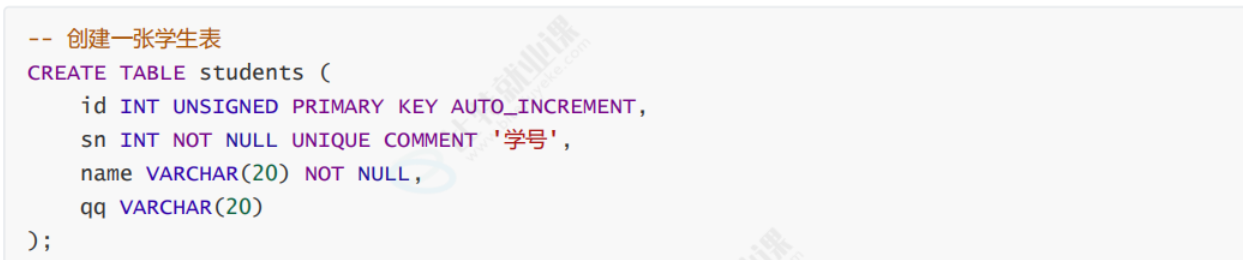
a. 单行全列插入
不指定列名,按表的列顺序给所有列赋值。
-- 示例:向 students 表插入完整的一行
INSERT INTO students VALUES (100, 10000, '唐三藏', NULL);
注意:自增主键可以手动赋值,也可以填 NULL 让系统自动生成
b. 多行指定列插入
指定要插入的列,一次插入多行数据,是生产环境推荐的批量写入方式,性能远高于逐条插入。
-- 示例:只插入 id、sn、name 三列,一次插入两行
INSERT INTO students (id, sn, name) VALUES
(102, 20001, '曹孟德'),
(103, 20002, '孙仲谋');
(2)插入冲突的两种解决方案
当插入数据的主键或唯一键与表中已有数据重复时,普通 INSERT 会直接报错。针对冲突场景,有两种成熟的处理方案:
a.on duplicate key update
冲突时不报错,转而更新指定字段的值。
-- 主键冲突时,更新 sn 和 name 字段
INSERT INTO students (id, sn, name) VALUES (100, 10010, '唐大师')
ON DUPLICATE KEY UPDATE sn = 10010, name = '唐大师';
执行结果通过 ROW_COUNT() 判断:
- 1:无冲突,数据成功插入
- 2:有冲突,数据已更新
- 0:有冲突,但更新后的值和原值完全相同
b. replace into
冲突时先删除原行,再插入新行,相当于「删除 + 插入」的原子操作
REPLACE INTO students (sn, name) VALUES (20001, '曹阿瞒');执行结果:
- 1:无冲突,直接插入
- 2:有冲突,删除旧行 + 插入新行
注意:REPLACE 会触发删除触发器,且自增主键会重新生成,生产环境需谨慎使用。
2.Retrieve (检索):SELECT 数据查询
查询是 SQL 中最核心、最常用的操作,完整语法结构:
SELECT [DISTINCT] 列/表达式
FROM 表名
[WHERE 条件]
[GROUP BY 分组]
[HAVING 分组过滤]
[ORDER BY 排序]
[LIMIT 分页]
下面从「列控制 → 行筛选 → 排序 → 分页」逐层讲解。
(1)查询列的控制
下面以这个表作为例子:
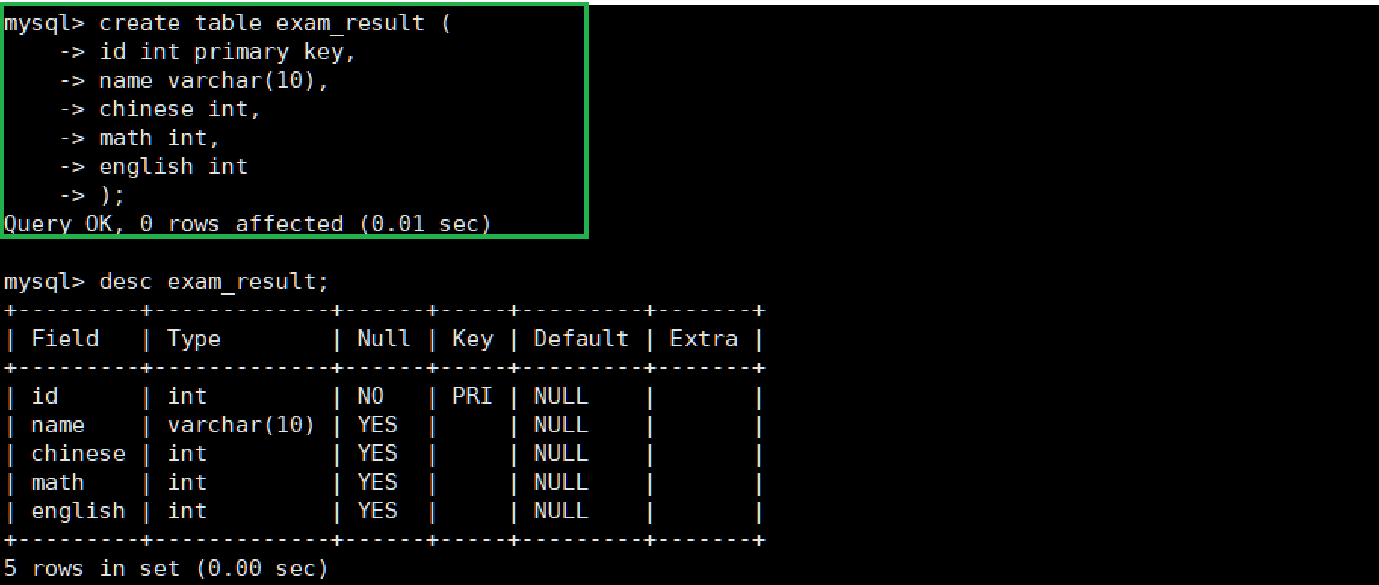
往里面插入了一些数据:
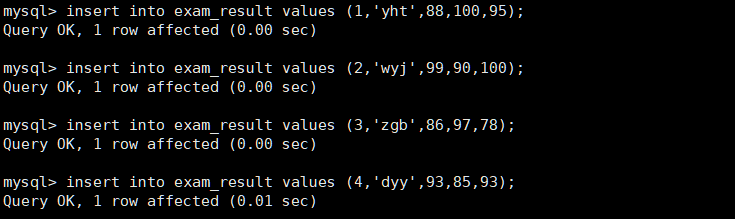
a.全列查询
SELECT * FROM exam_result;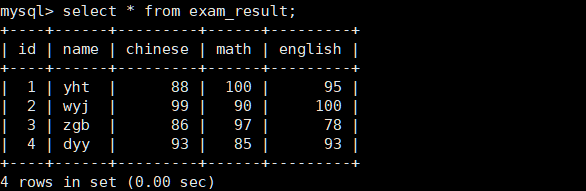
⚠️ 生产环境禁止使用 *:
- 查询列越多,数据传输量越大,性能差
- 可能导致索引失效
- 表结构变更时,查询结果不稳定
b.指定列查询
自定义返回的列与顺序
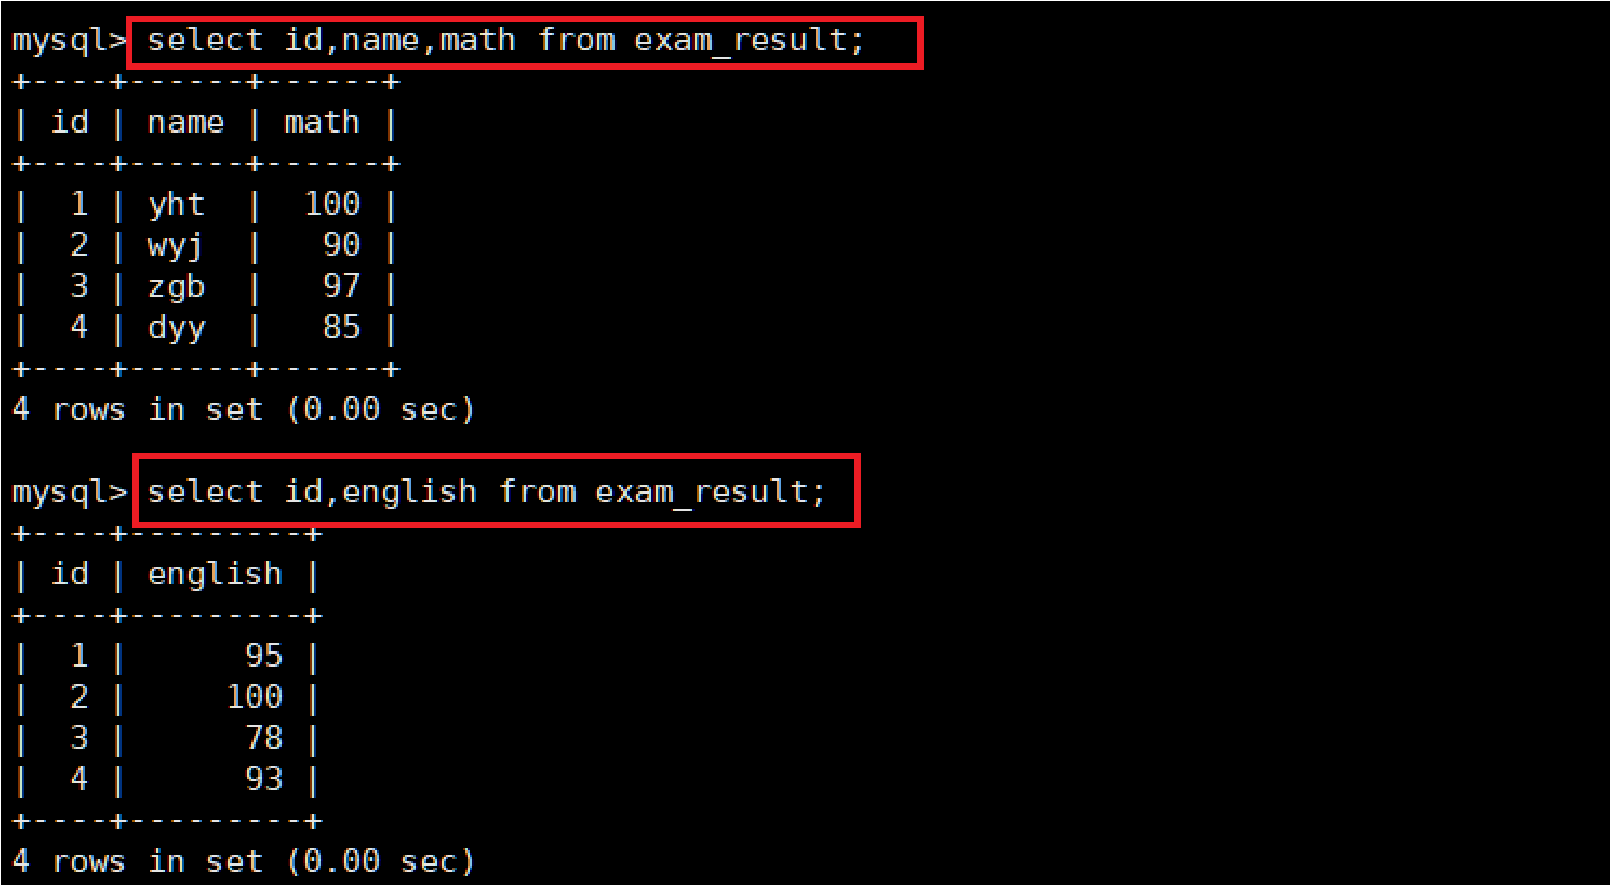
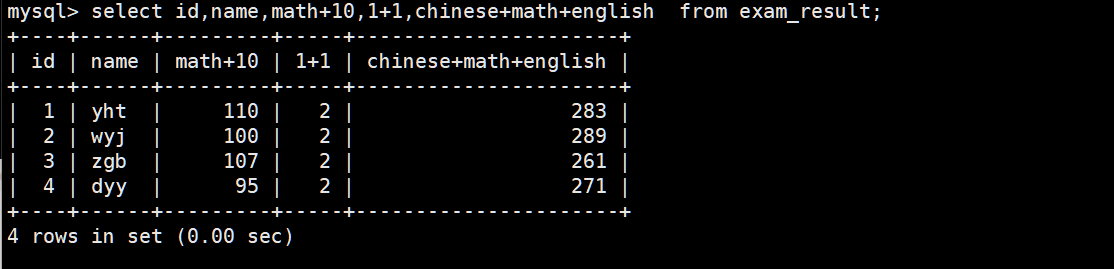
c.表达式查询
支持常量、单字段运算、多字段组合运算
d.别名 (AS)
给查询结果的列起别名,AS关键字可以省略:
SELECT id, name, chinese + math + english 总分 FROM exam_result;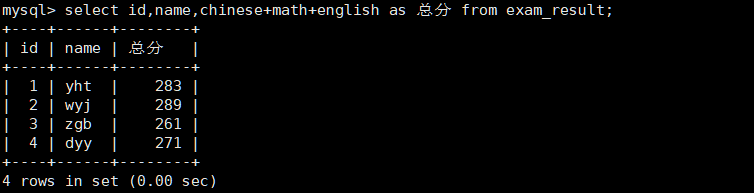
e.结果去重(distinct)
去除查询结果中完全重复的行:
SELECT DISTINCT math FROM exam_result;(2)where 条件:过滤行
WHERE 是行级过滤,只有满足条件的行才会进入后续查询。
a.比较运算符
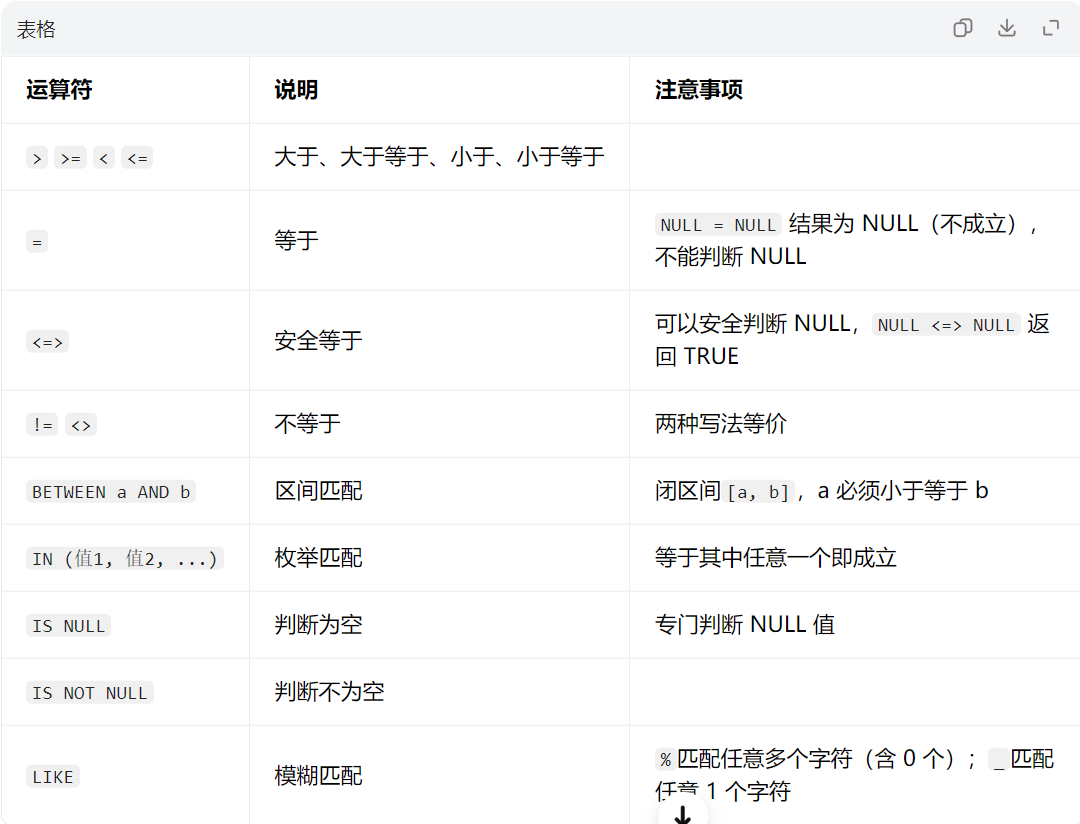
🔴 重点:NULL 的比较
普通=无法判断 NULL,WHERE qq = NULL查不到任何数据;判断空值必须用IS NULL。
<=>是 MySQL 特有的安全等于,可以同时判断普通值和 NULL
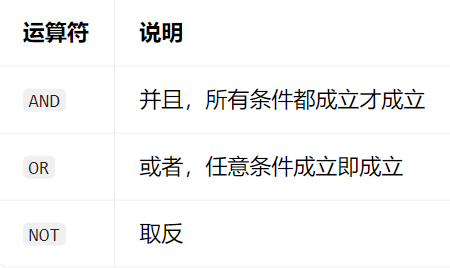
b.逻辑运算符
下面以这个为例,出几个题来看看
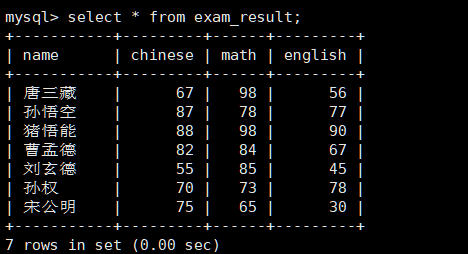
-
英语不及格的同学及英语成绩
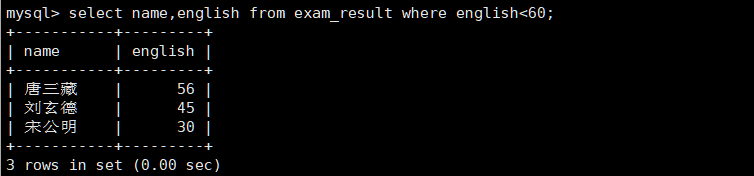
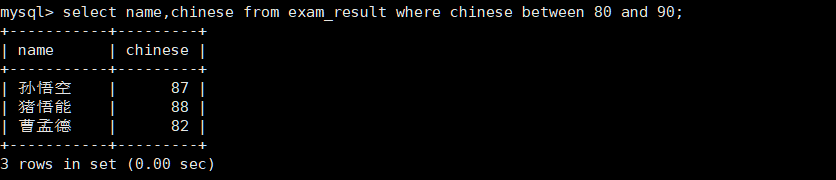
-
语文成绩在 80, 90 分的同学及语文成绩
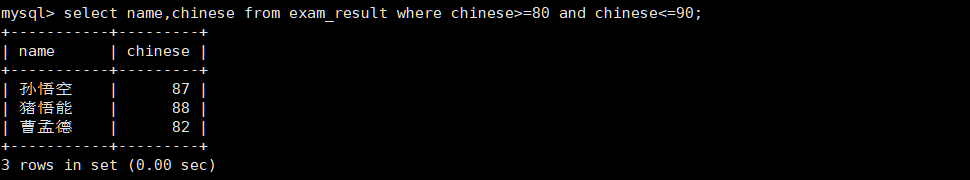
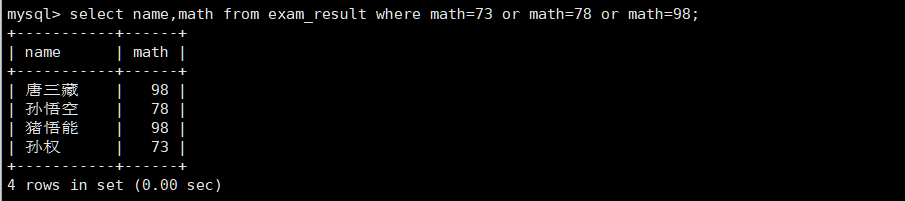
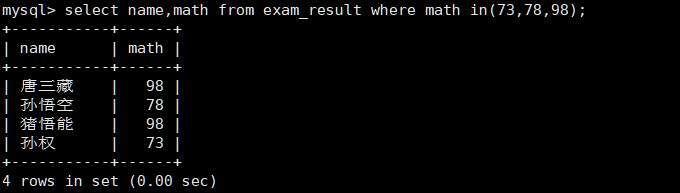
-
数学成绩是 78 或者 73 或者 98 的同学及数学成绩
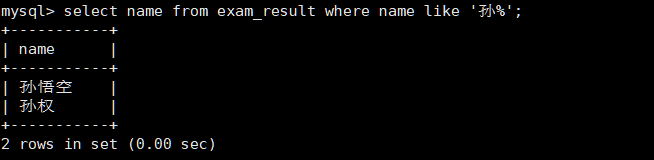
-
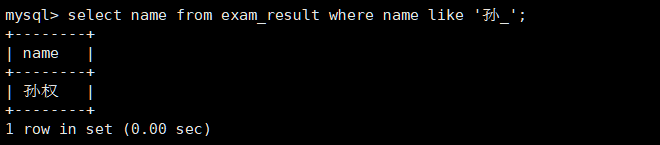
姓孙的同学及孙某同学
姓孙的:% 匹配任意多个(包括 0 个)任意字符
孙某同学:_ 匹配严格的一个字符
-
总分在 200 分以下的同学
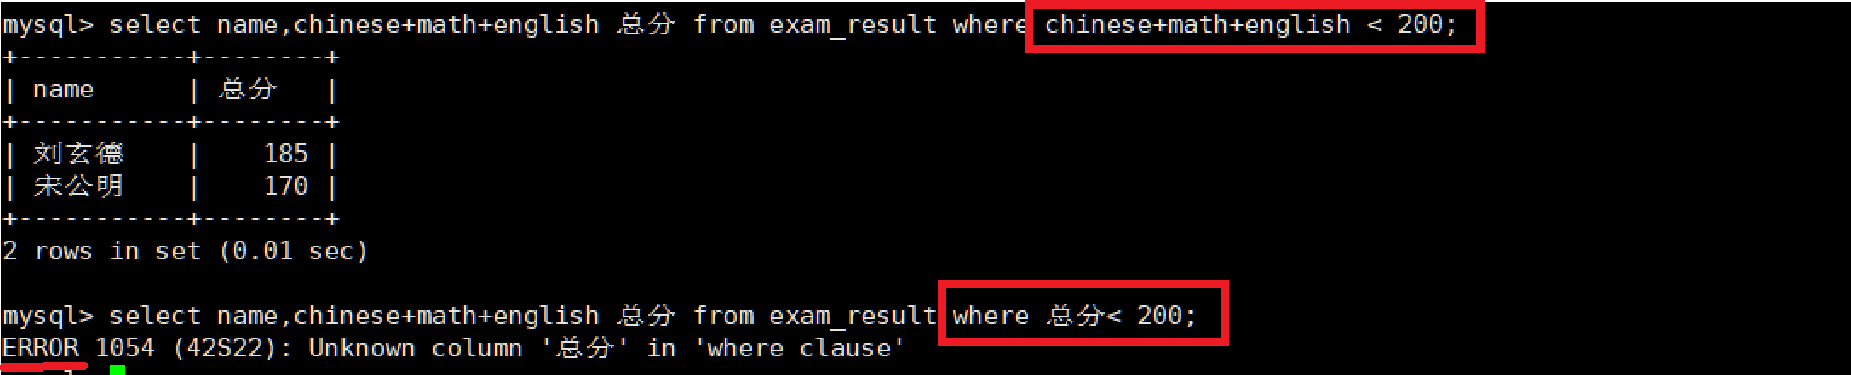
别名不能用在 WHERE 条件中
-
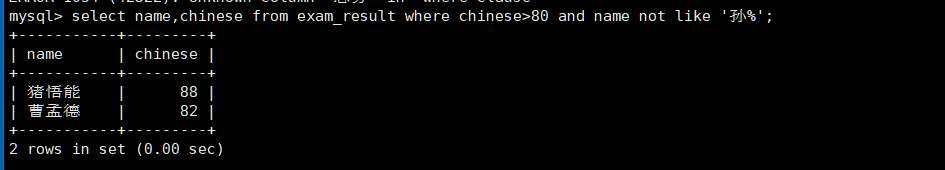
语文成绩 > 80 并且不姓孙的同学
(3)ORDER BY:结果排序
ORDER BY 列1 [ASC|DESC], 列2 [ASC|DESC], ...ASC:升序(从小到大),默认值DESC:降序(从大到小)- 多字段排序:按书写顺序优先级,先按第一列排,相同再按第二列排
特点与注意事项
-
NULL 的排序:NULL 视为比任何值都小,升序时排在最前面,降序时排在最后面
-
支持按表达式、别名排序
-
不加 ORDER BY 的查询,返回顺序是不确定的,永远不要依赖默认顺序
-
查询同学及总分,由高到低
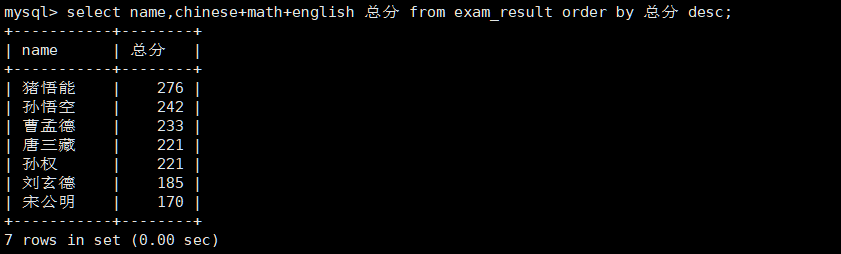
ORDER BY 子句中可以使用列别名
-
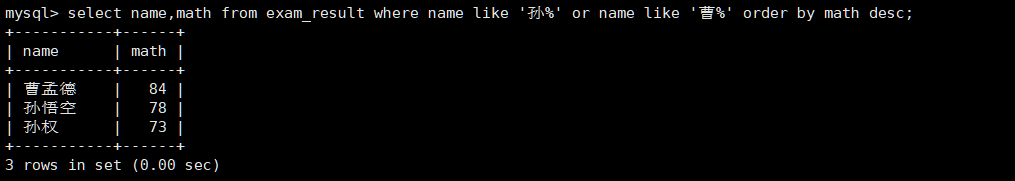
查询姓孙的同学或者姓曹的同学数学成绩,结果按数学成绩由高到低显示
(4) limit:分页筛选
-- 取前n条
LIMIT n

-- 从位置s开始,取n条(s从0开始计数)
LIMIT s, n

-- 更清晰的写法(推荐)
LIMIT n OFFSET s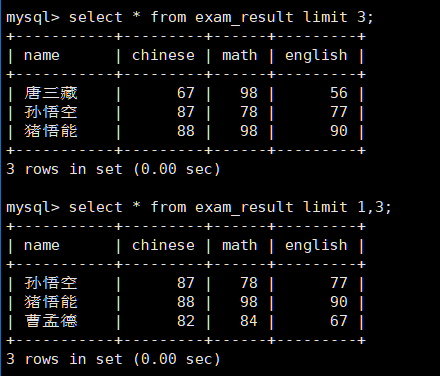
3.Update (更新)
UPDATE 表名
SET 列1 = 值1, 列2 = 值2, ...
[WHERE 条件]
[ORDER BY 排序]
[LIMIT 数量];
要点说明
- 可以更新单列或多列,逗号分隔
- 更新值可以是固定值,也可以是基于原值的表达式(如
math = math + 30) - 没有 WHERE 条件会更新整张表,生产环境必须慎用
- MySQL 不支持
math += 30这种简写,必须写完整的math = math + 30
-
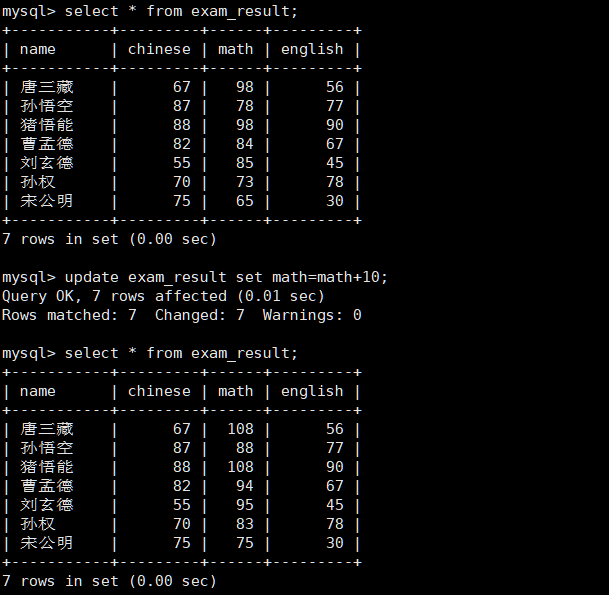
将全部人的数学成绩加10分
-
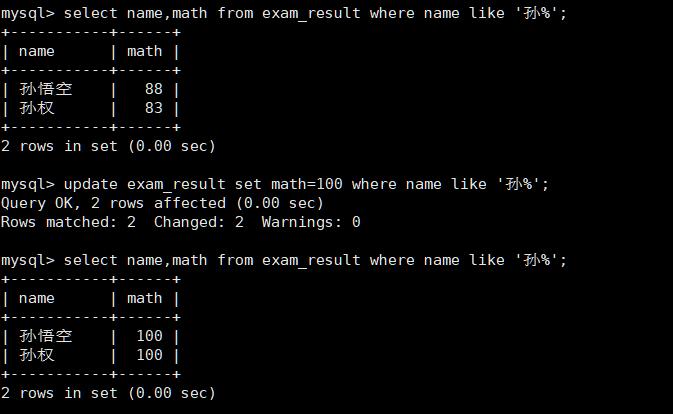
将姓孙同学的数学成绩变更为 100 分
-
** 将总成绩倒数前三的 3 位同学的数学成绩加上 30 分**

4.Delete(删除)
(1)delete 删除
DELETE FROM 表名
[WHERE 条件]
[ORDER BY 排序]
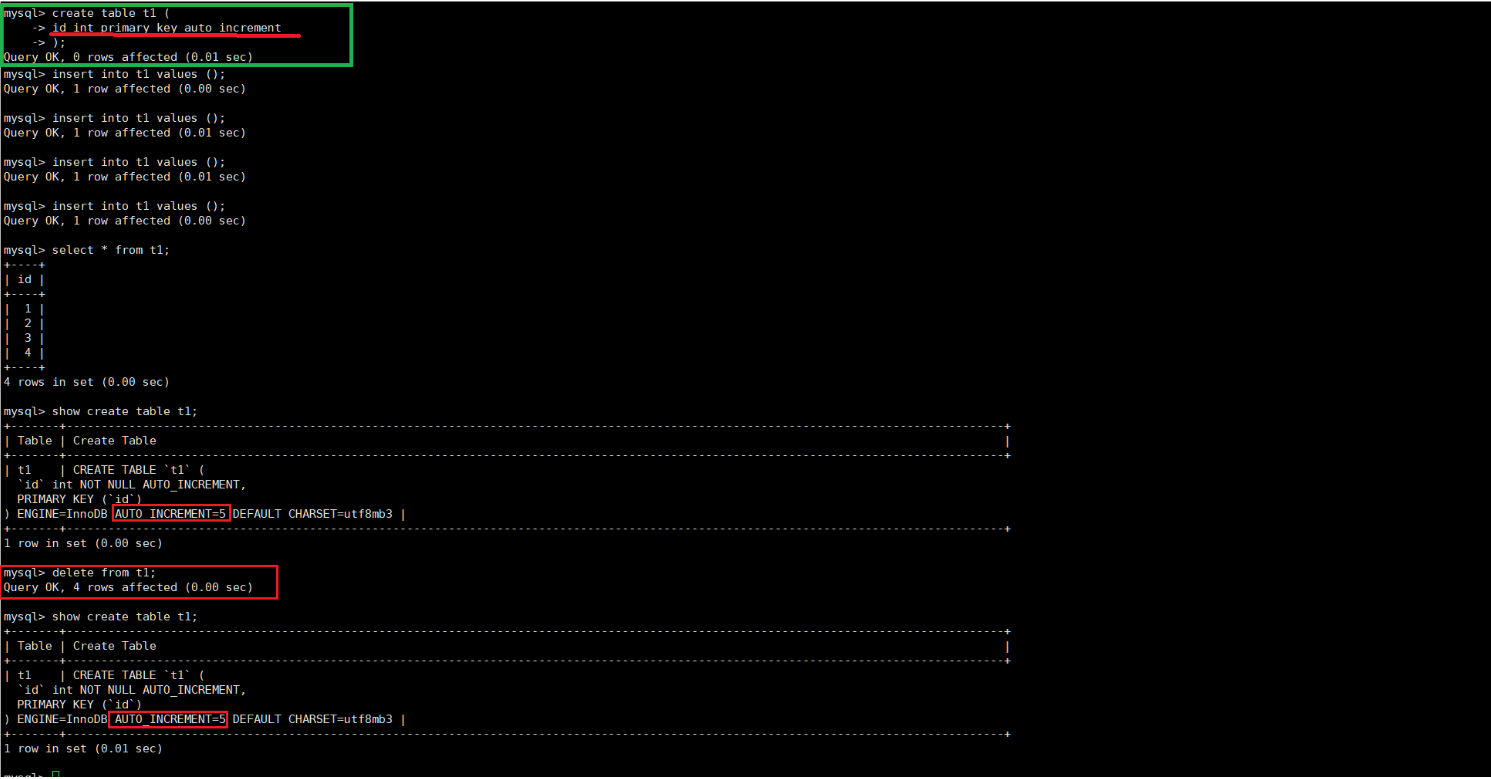
[LIMIT 数量];- 按条件删除指定行,没有 WHERE 则删除全表数据
- 属于 DML 语句,走事务,可以回滚
- 删除后不会重置自增计数器,后续插入的自增 ID 继续递增
(2)truncate 截断表
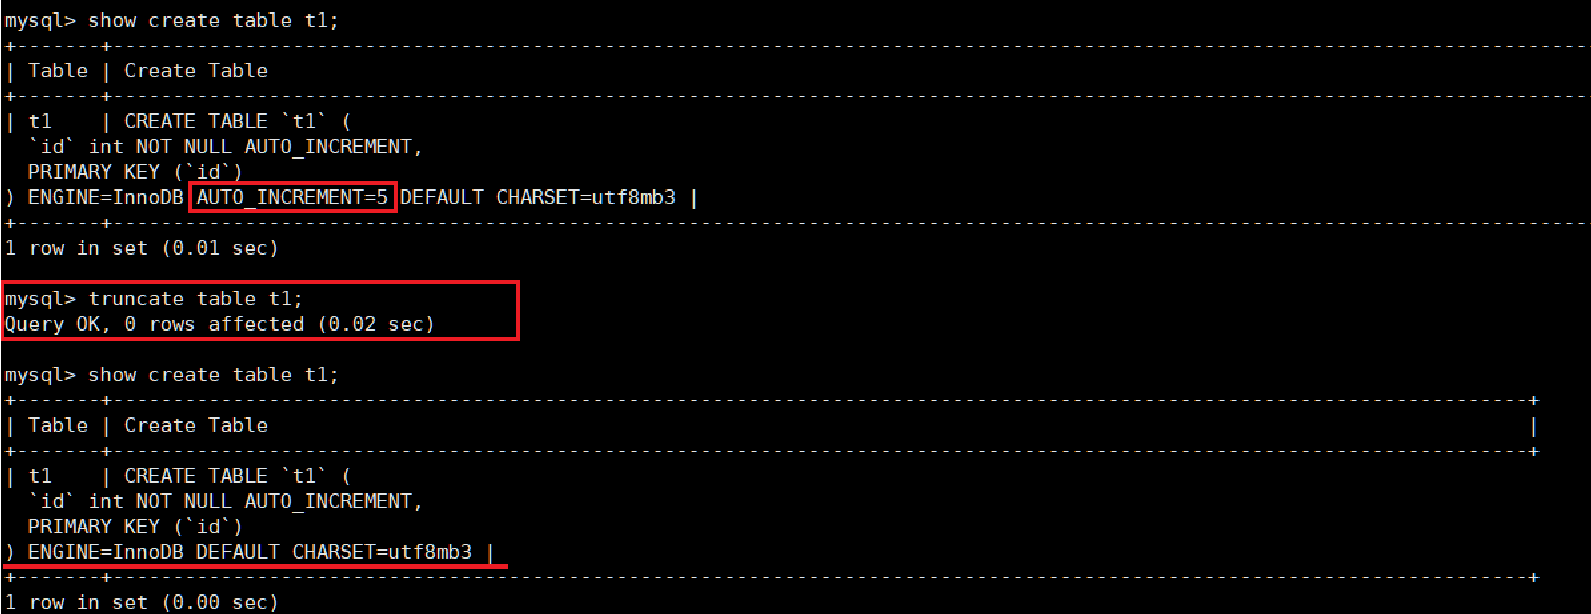
TRUNCATE [TABLE] 表名;- 只能整表操作,不能按条件删除部分数据
- 本质是直接重建表,不是逐行删除,速度远快于 DELETE
- 属于 DDL 语句,不走事务,数据不可回滚
- 会重置自增计数器,自增 ID 从 1 重新开始
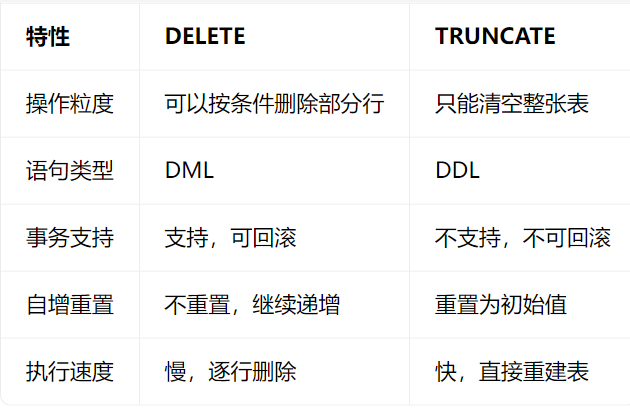
DELETE vs TRUNCATE 核心对比
5.插入查询结果
可以将 SELECT 查询的结果直接插入到另一张表中:
INSERT INTO 目标表 [(列1, 列2, ...)] SELECT ... FROM 源表;经典场景:表数据去重
-- 1. 创建一张结构相同的空表
CREATE TABLE no_duplicate_table LIKE duplicate_table;

-- 2. 将去重后的数据插入新表
INSERT INTO no_duplicate_table SELECT DISTINCT * FROM duplicate_table;

-- 3. 原子重命名,完成替换
RENAME TABLE duplicate_table TO old_duplicate_table,
no_duplicate_table TO duplicate_table;
6. 聚合统计
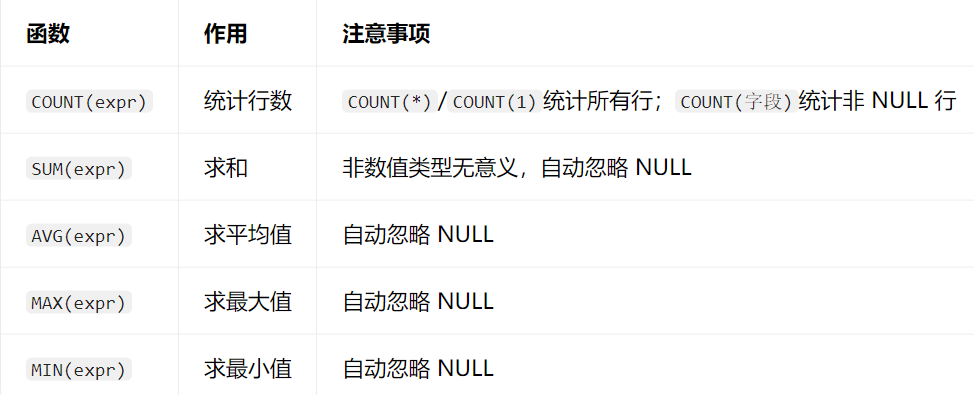
聚合函数对一组行进行统计计算,最终返回一个结果
都可以搭配
DISTINCT进行去重统计,如COUNT(DISTINCT math)
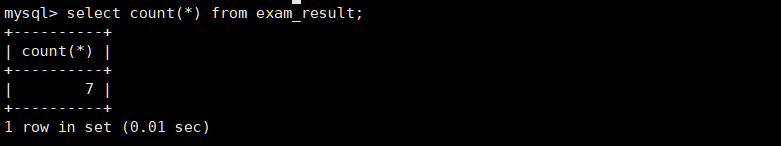
-
统计班级共有多少同学
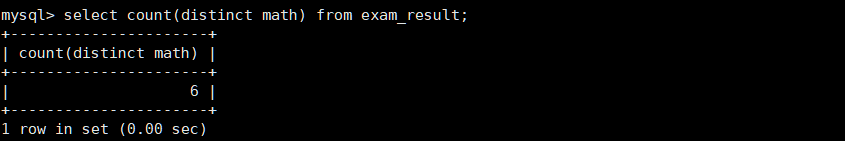
-
统计本次考试的数学成绩分数个数
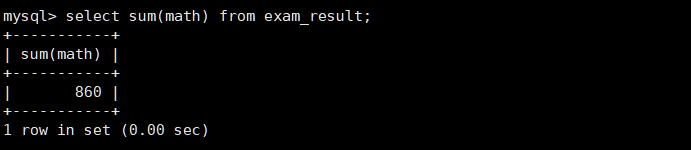
-
统计数学成绩总分
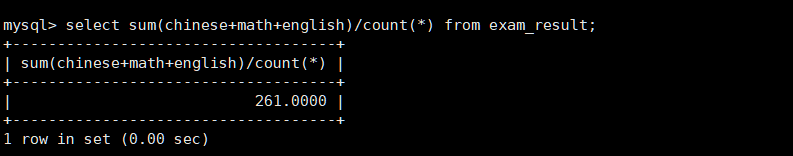
-
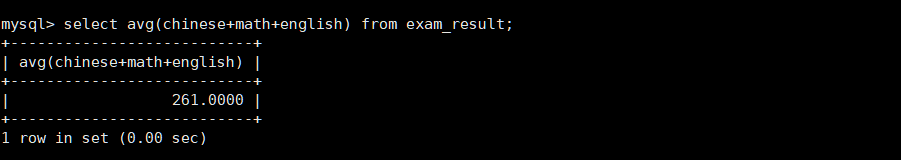
统计平均总分
-
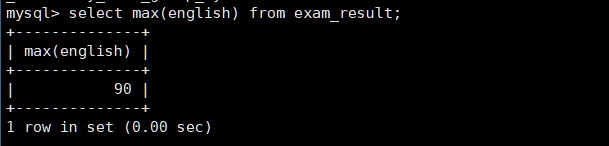
返回英语最高分
-
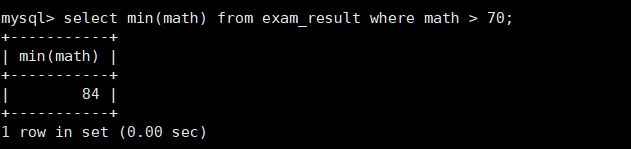
返回 > 70 分以上的数学最低分
7. group by 分组查询
按指定列的值将数据分组,每组单独计算聚合结果。
SELECT 分组列, 聚合函数...
FROM 表名
[WHERE 条件]
GROUP BY 分组列1, 分组列2, ...
[HAVING 分组后条件];
(1)简单分组
-- 每个部门的平均工资、最高工资
SELECT deptno, AVG(sal), MAX(sal) FROM EMP GROUP BY deptno;

-- 每个部门、每个岗位的平均工资
SELECT deptno, job, AVG(sal), MIN(sal) FROM EMP GROUP BY deptno, job;
(2)having : 分组后过滤
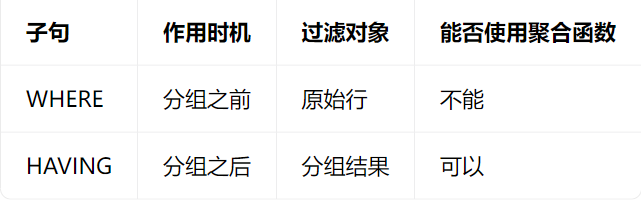
HAVING用于对分组后的结果进行过滤,必须配合GROUP BY使用
示例:
-- 显示平均工资低于2000的部门和平均工资
SELECT deptno, AVG(sal) avg_sal
FROM EMP
GROUP BY deptno
HAVING avg_sal < 2000;
WHERE vs HAVING 核心区别
8. SQL执行顺序 (重要)
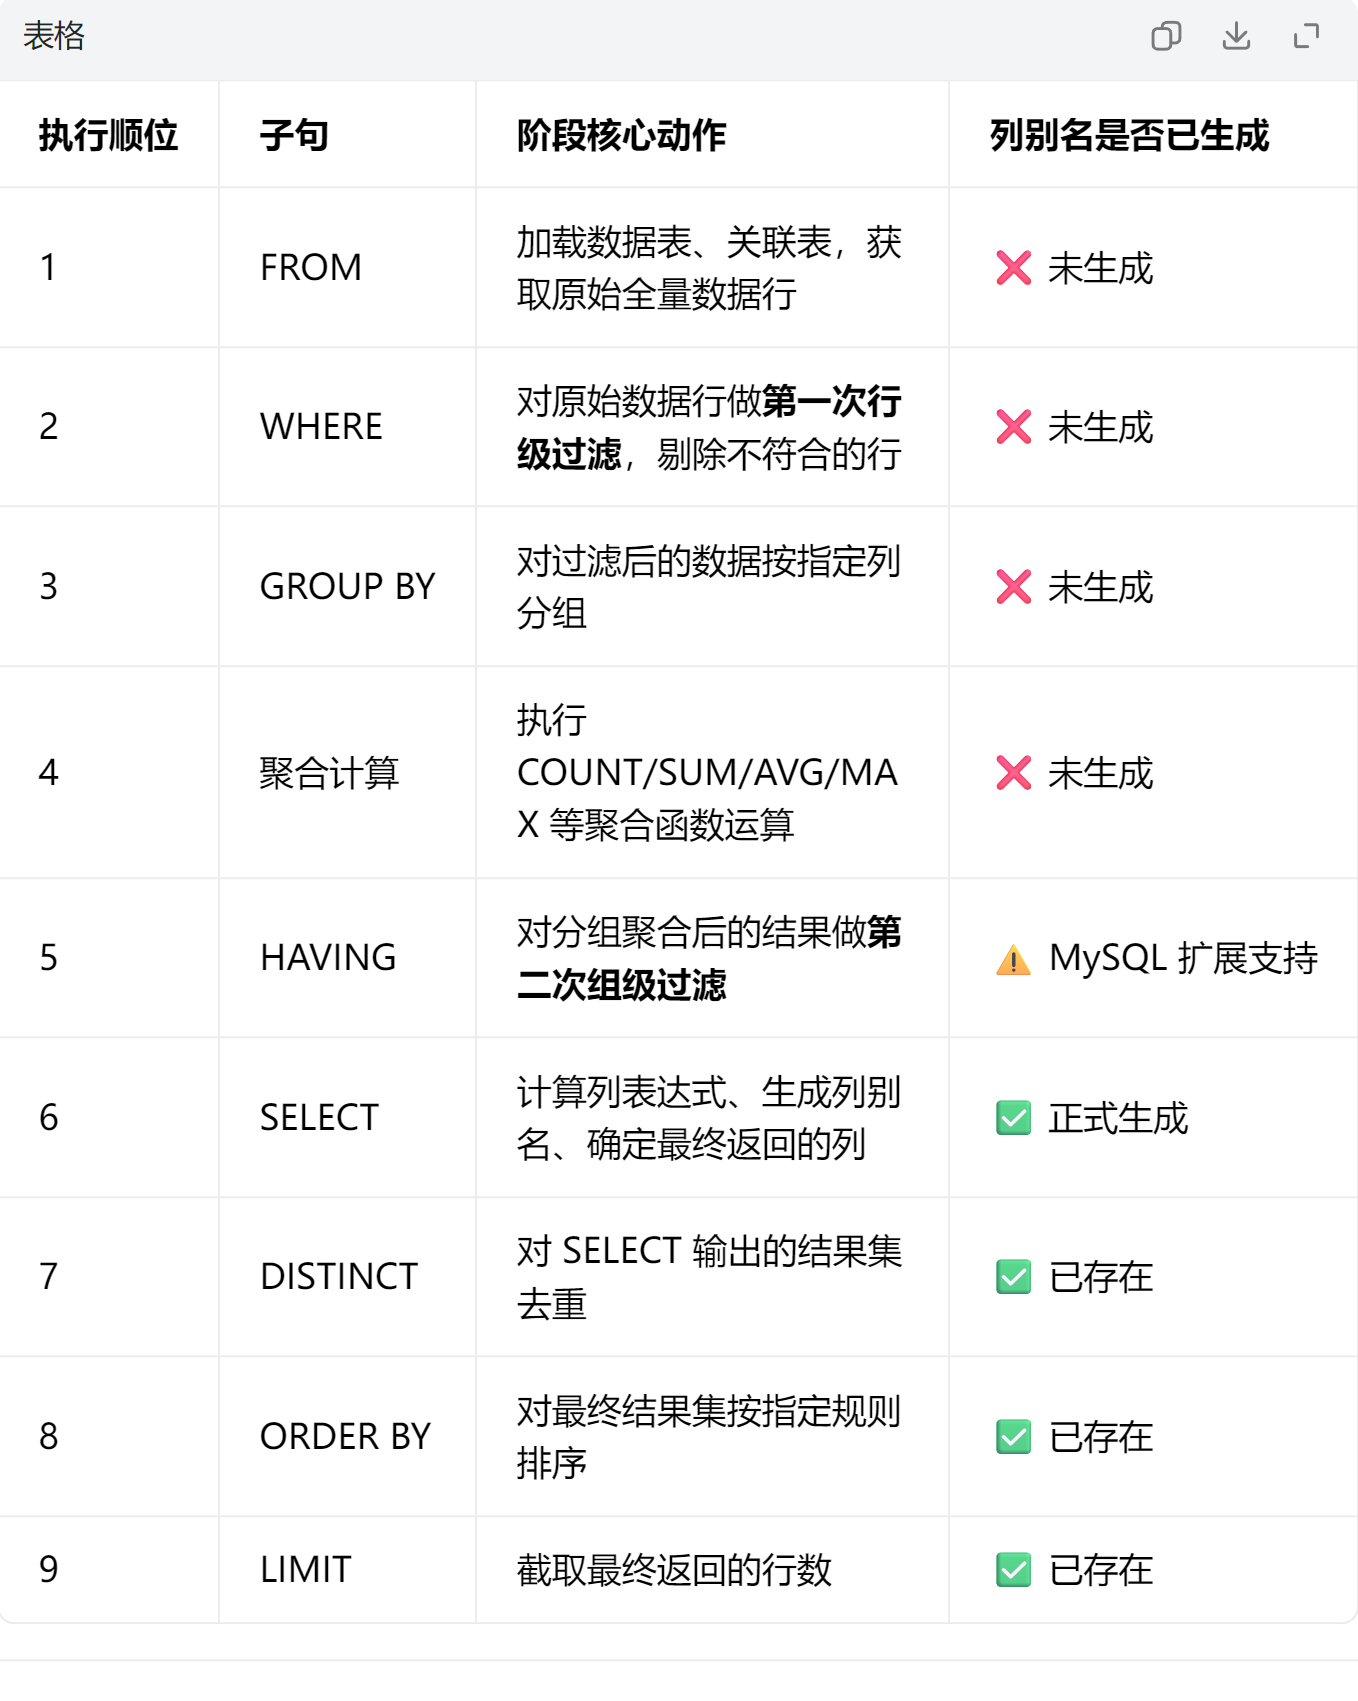
可以把 SQL 查询想象成「工厂加工产品」:
- FROM:把原材料(原始数据)运到车间
- WHERE:质检筛选,挑出合格的原材料
- GROUP BY + 聚合:把原材料分组加工成半成品
- HAVING:对半成品做质检筛选
- SELECT:给成品贴标签、印产品名(生成别名)
- ORDER BY:按标签上的产品名给成品排序
- LIMIT:装箱,只取前 N 件
二. 内置函数
1. 日期时间函数
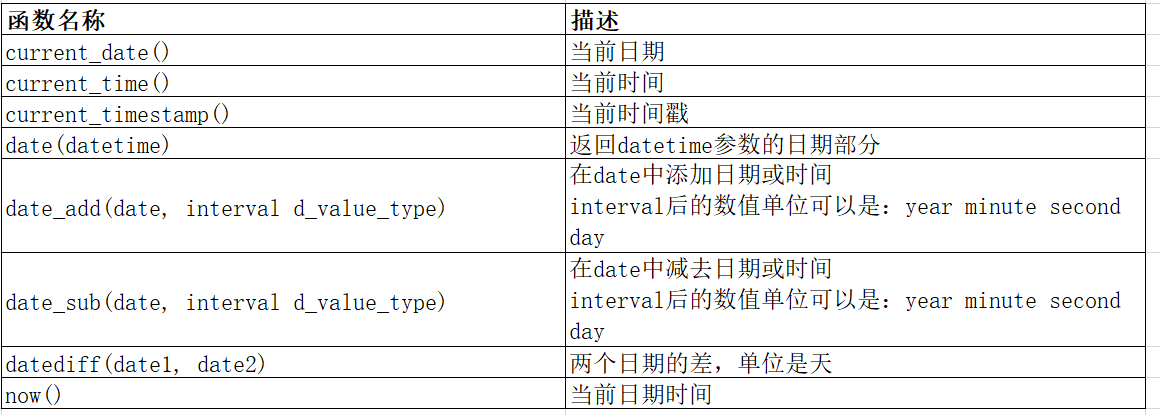
日期函数是业务中使用频率最高的一类函数,用于处理时间的获取、计算、提取等操作,是按时间统计、时间范围判断的核心工具
(1)获取当前时间类
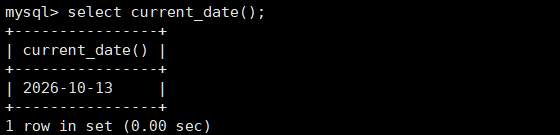
a. current_date()
- 功能 :获取当前系统的日期,格式为
YYYY-MM-DD - 语法 :
CURRENT_DATE() - 示例:
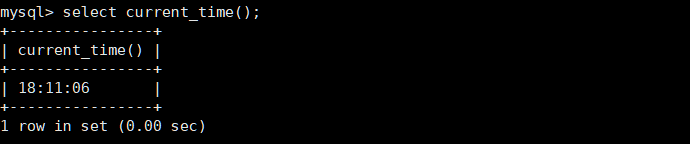
b.current_time()
- 功能 :获取当前系统的日期,格式为
YYYY-MM-DD - 语法 :
CURRENT_DATE() - 示例:
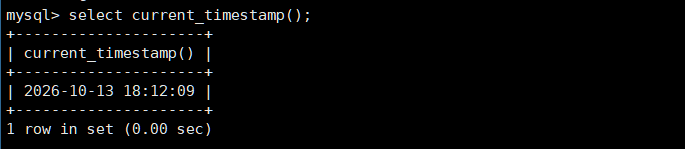
c. now() / current_timestamp()
- 功能 :获取当前系统的完整日期 + 时间,格式为
YYYY-MM-DD HH:MM:SS - 说明:二者功能完全等价,是同义词
- 示例 :
(2)日期提取与计算
a.date(datetime)
- 功能:从 datetime 类型的值中提取日期部分,丢弃时分秒
- 典型场景:按天统计数据、列表只展示日期不展示时间
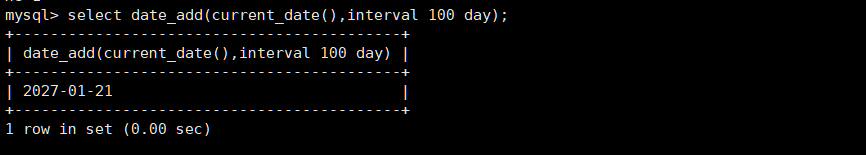
b.date_add(date,interval 值 单位)
- 功能:在指定日期 / 时间的基础上,增加指定的时间量
- 支持单位 :
year(年)、month(月)、day(天)、hour(时)、minute(分)、second(秒) - 示例
c. date_sub(date,interval 值 单位)
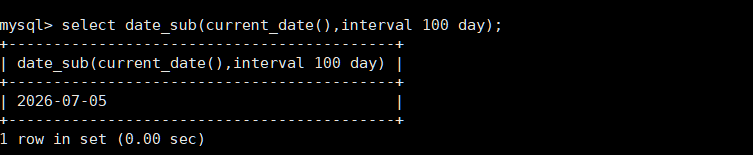
- 功能:在指定日期 / 时间的基础上,减去指定的时间量,用法和 DATE_ADD 完全对称
- 示例 :
d.datediff(date1,date2)
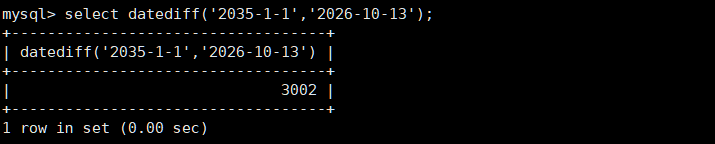
- 功能 :计算两个日期之间相差的天数,结果为
date1 - date2 - 注意:只计算日期部分的差值,忽略时分秒;结果可正可负
- 示例 :
2.字符串函数
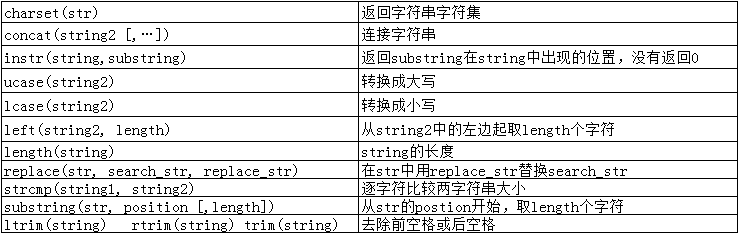
a.concat(str1,str2,...) :字符串拼接
-
功能:按顺序拼接多个字符串,合并为一个完整字符串
-
易错点 :任意一个参数为 NULL,最终拼接结果就为 NULL,使用时注意做空值处理
-
示例:
-- 格式化输出学生成绩信息
SELECT CONCAT(name, '的语文是', chinese, '分,数学是', math, '分') AS '分数'
FROM exam_result;
b.length(str) :所占字节
- 功能 :返回字符串的字节长度,不是字符个数
- 关键说明 :
- 单字节字符(英文、数字、符号):1 个字符占 1 字节
- 多字节字符(中文):占用字节数由字符集决定,utf8 编码下 1 个中文占 3 字节
注意:如果需要获取字符个数,使用CHAR_LENGTH()函数,不要和 LENGTH 混淆
c.substring(str,起始位置,长度):字符串截取
- 功能:从字符串的指定位置开始,截取指定长度的子串
- 易错点 :MySQL 中字符串位置从 1 开始计数,不是编程常见的 0
- 省略长度参数时,会直接截取到字符串末尾
d.instr(str,子串):查询子串
- 功能:查找子串在原字符串中第一次出现的位置
- 返回值:找到返回对应位置(从 1 开始);找不到返回 0
e.replace(str,旧子串,新子串):替换子串
-
功能:将字符串中所有匹配的旧子串,全部替换为新子串
-
示例:
-- 将员工姓名中所有的'S'替换成'上海'
SELECT REPLACE(ename, 'S', '上海'), ename FROM EMP;
f. ucase / lcase 大小写替换
UCASE(str)/UPPER(str):将字符串全部转为大写LCASE(str)/LOWER(str):将字符串全部转为小写
g.left / right :截取
left(str, 长度):从字符串最左侧开始,截取指定长度的子串right(str, 长度):从字符串最右侧开始,截取指定长度的子串
h.空格处理
ltrimstr):去除字符串左侧的空格rtrim(str):去除字符串右侧的空格trim(str):去除字符串首尾两侧的所有空格
i.charset(str)
功能:返回字符串使用的字符集
3.数学函数
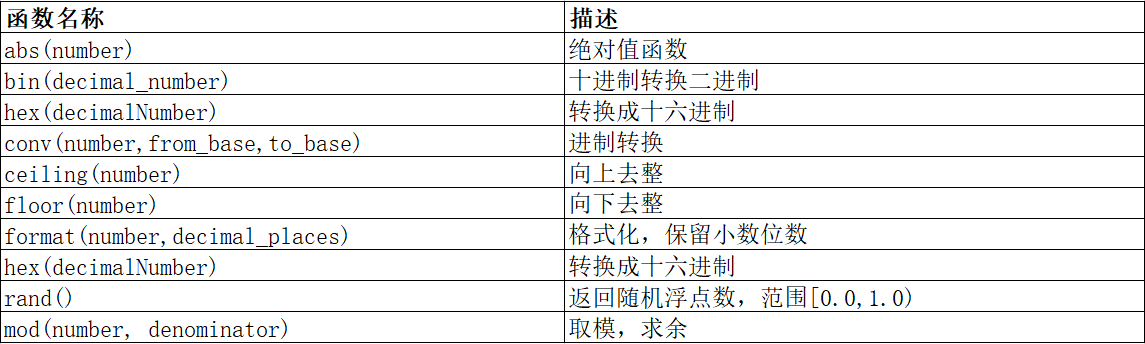
- ceiling 与 floor 的区别
- 正数场景:CEILING 向前进 1,FLOOR 直接舍弃小数
- 负数场景:
CEILING(-23.7) = -23,FLOOR(-23.7) = -24,注意取整方向
- format 函数注意点
- 不仅会四舍五入,还会自动添加千分位分隔符,返回结果为字符串类型
- rand 扩展用法
- 生成 0~100 的随机整数:
FLOOR(RAND() * 100) - 生成 m~n 之间的随机数:
m + RAND() * (n - m)
- 生成 0~100 的随机整数:
4.其他常用函数
a.ifnull(val1,val2)
-
功能:空值处理函数。如果 val1 为 NULL,返回 val2;否则返回 val1 本身
-
地位:开发中最高频的函数之一,用于避免 NULL 值参与运算导致结果异常
-
示例:
SELECT IFNULL('abc', '123'); -- 结果:abc
SELECT IFNULL(NULL, '123'); -- 结果:123
b.md5(str)
-
功能:对字符串进行 MD5 摘要运算,返回一个 32 位的十六进制字符串
-
使用场景:常用于密码加密、数据一致性校验
-
示例:
SELECT MD5('admin');
-- 返回结果:21232f297a57a5a743894a0e4a801fc3
c.password(str)
- 功能:MySQL 自带的专属密码加密函数,是 MySQL 内部用户账号使用的加密算法
- 注意:这是 MySQL 专属的加密方式,不要用于业务系统的用户密码加密
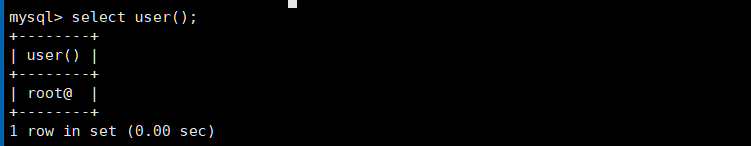
d.user()
功能 :返回当前登录 MySQL 的用户名和主机地址
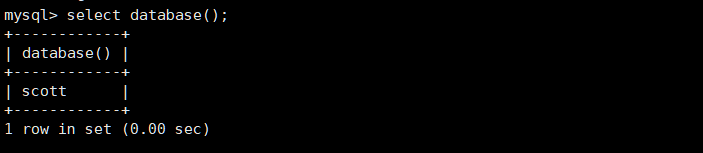
e.databse()
功能 :返回当前正在使用的数据库名
三. 复合查询
单表查询只能处理单一数据表的数据,但实际业务中数据往往分散在多张关联表中,这时就需要用到复合查询。
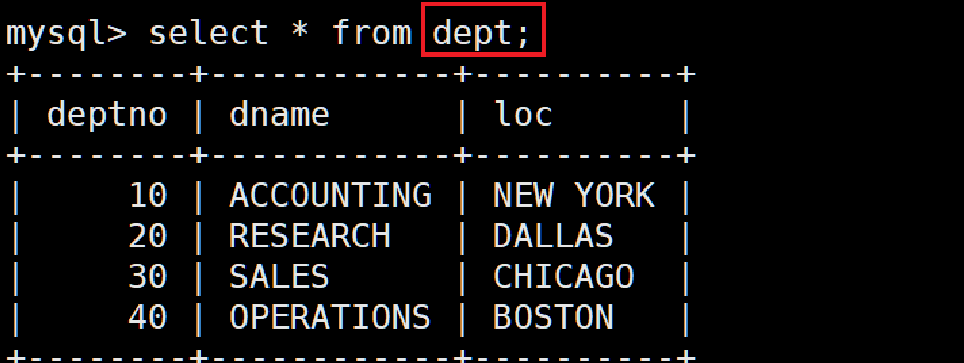
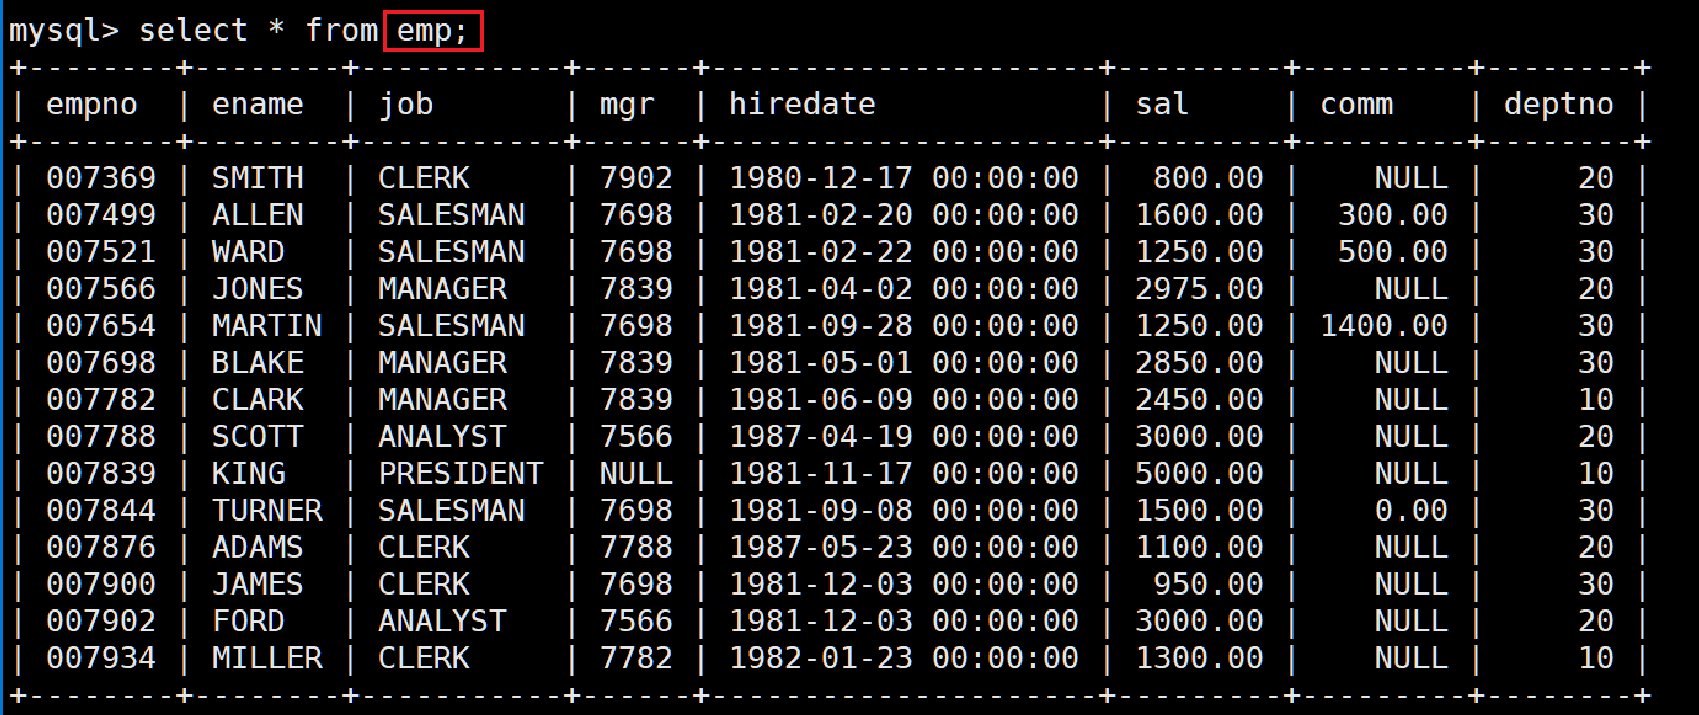
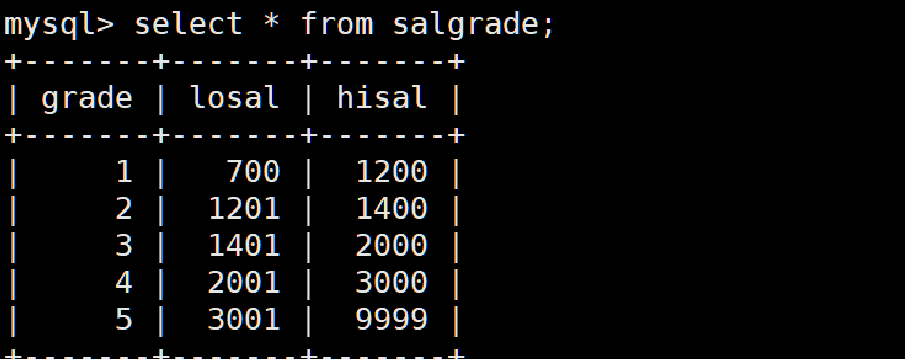
下面给出一个具体的例子,下面都会围绕这个例子来学习后面的内容:
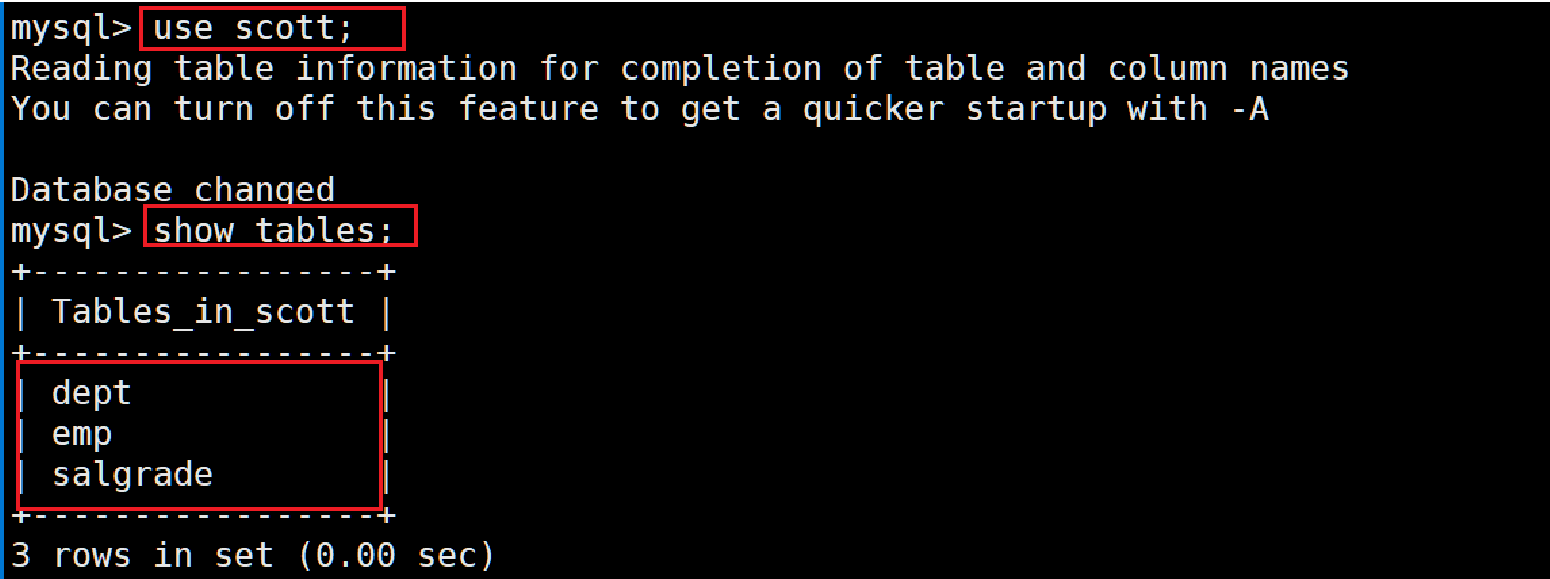
构建了一个数据库scott,里面放了三张表
dept:部门编号,部门名,工作地点
emp:员工编号,员工名,职位,主管编号,入职时间,薪资,奖金,部门编号
salgrade:薪资等级,最低,最高
1.多表查询
(1)笛卡尔积:多表查询的底层本质
当 FROM 后面跟多张表,且不加任何连接条件时,会产生笛卡尔积:第一张表的每一行,都会和第二张表的所有行组合一次,最终结果行数 = 表 1 行数 × 表 2 行数
其实就是一种穷举:
如下图,部分结果:
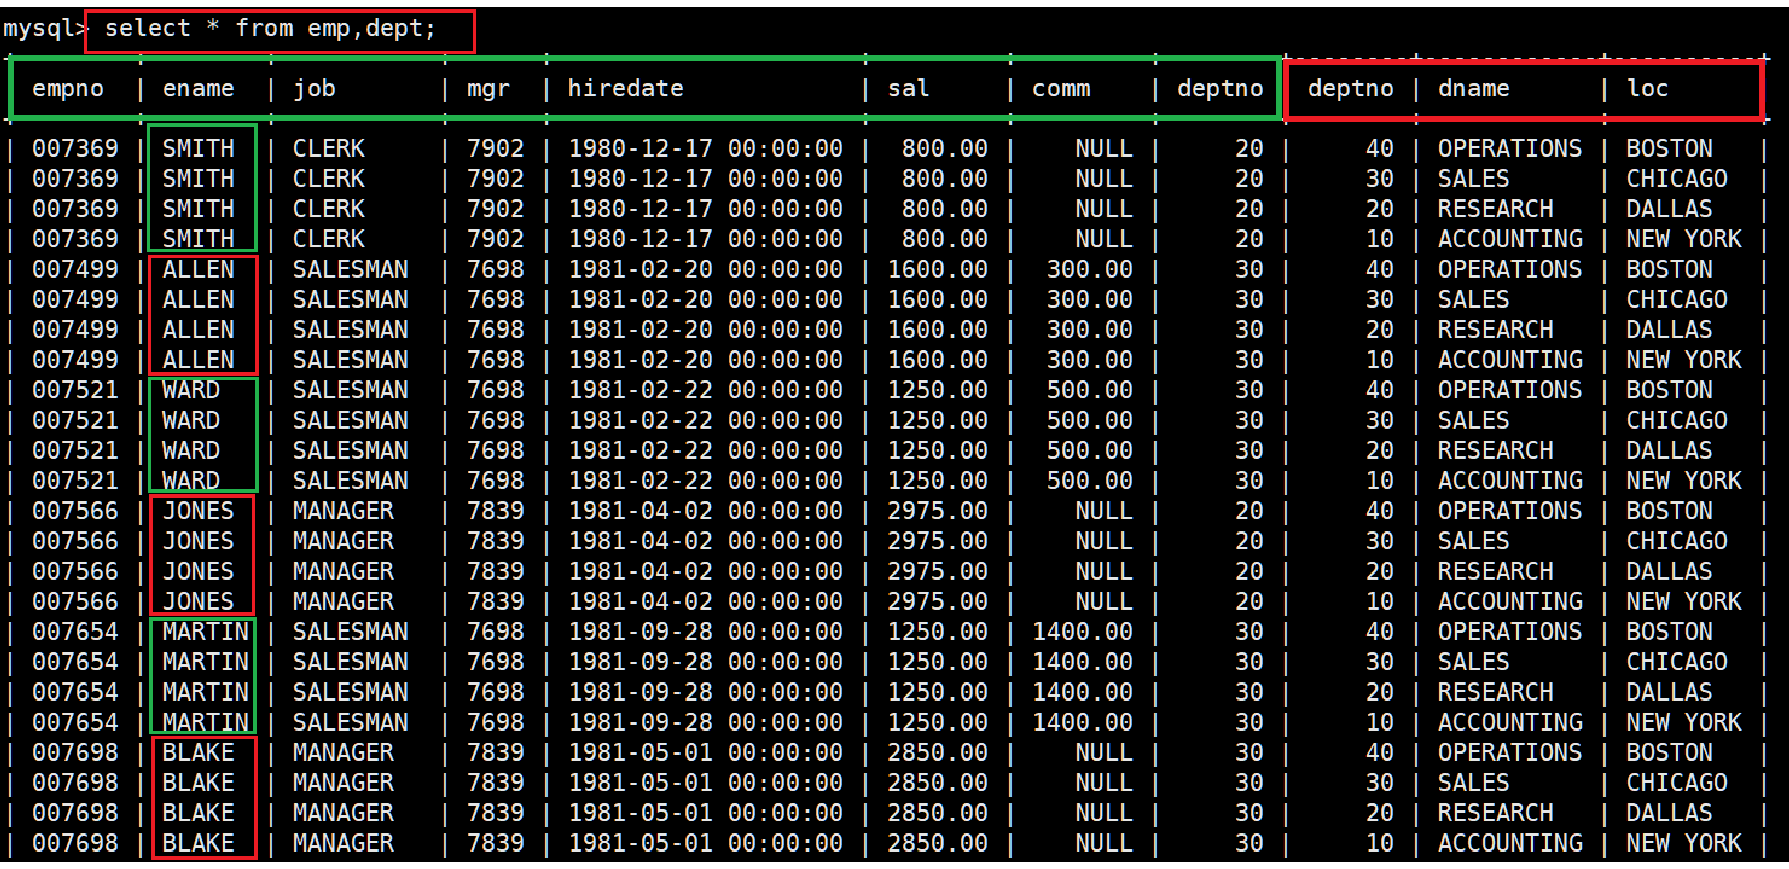
所有多表查询都必须加连接条件,用来过滤掉笛卡尔积中的无效组合,只保留关联匹配的行
(2)等值连接(内连接)
通过两张表的关联字段值相等来匹配数据,是最常用的多表查询方式
语法格式
SELECT 列名...
FROM 表1, 表2
WHERE 表1.关联列 = 表2.关联列
[AND 其他过滤条件];-
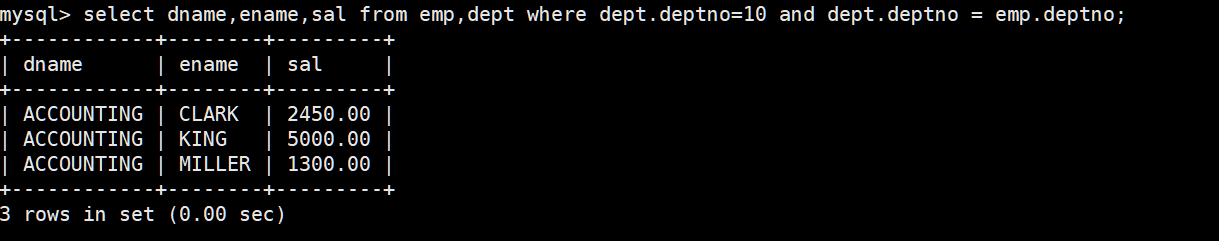
显示部门号为10的部门名,员工名和工资
-
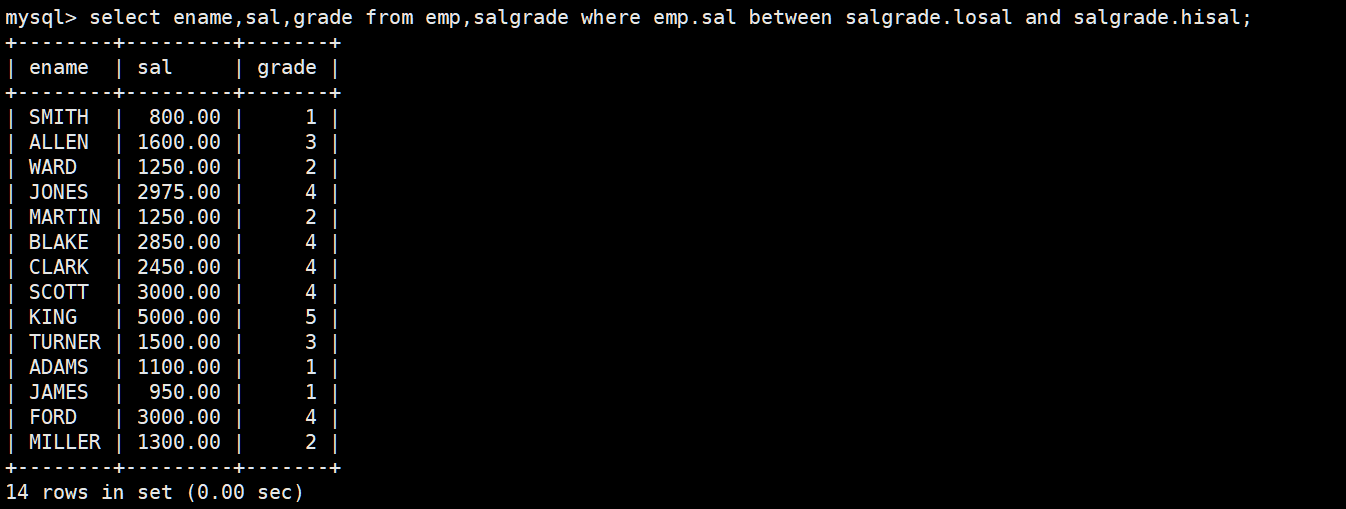
显示各个员工的姓名,工资,及工资级别
(3)表别名的使用
当查询涉及多张表时,推荐给表起别名,简化书写,同时避免同名字段冲突。
-
规则:
表名 别名,之后所有字段都可以用别名.列名引用 -
注意:一旦给表起了别名,就不能再用原表名引用字段
-- 用别名简化写法
SELECT e.ename, e.sal, d.dname
FROM EMP e, DEPT d
WHERE e.deptno = d.deptno;
2.自连接
自连接就是一张表自己和自己连接查询,本质还是多表连接,只不过两张表是同一张表的不同角色副本
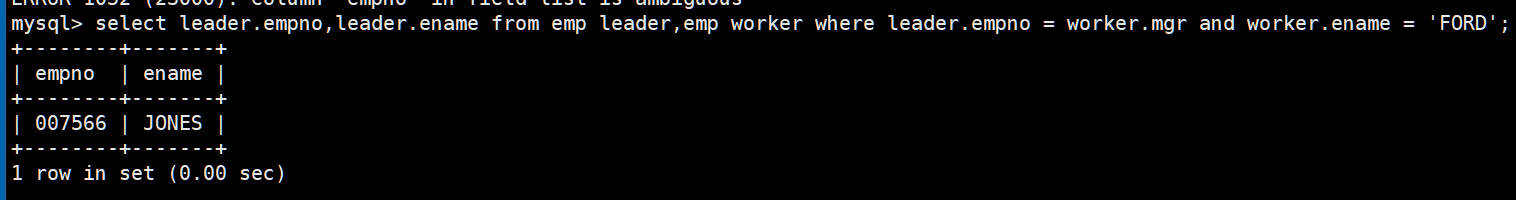
作用:用于查询表内自身存在层级关系 的数据,最典型的就是员工 - 上级关系:EMP 表中每个员工有mgr字段(上级编号),而上级本身也是员工,也在 EMP 表中
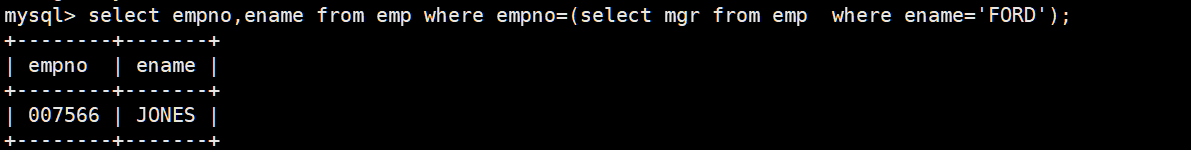
显示员工FORD的上级领导的编号和姓名
- 使用子查询
- 使用多表查询(自连接)
3.子查询(嵌套查询)
子查询是指嵌入在其他 SQL 语句中的 SELECT 语句,也叫嵌套查询。外层的查询叫主查询,内层的查询叫子查询
- 执行顺序:通常先执行子查询,得到结果后再执行主查询
- 子查询可以出现在 WHERE、FROM、SELECT、HAVING 等子句中
(1)多行子查询
- 返回结果:一行一列(单个值)
- 搭配运算符 :
=、>、<、>=、<=、!=等比较运算符
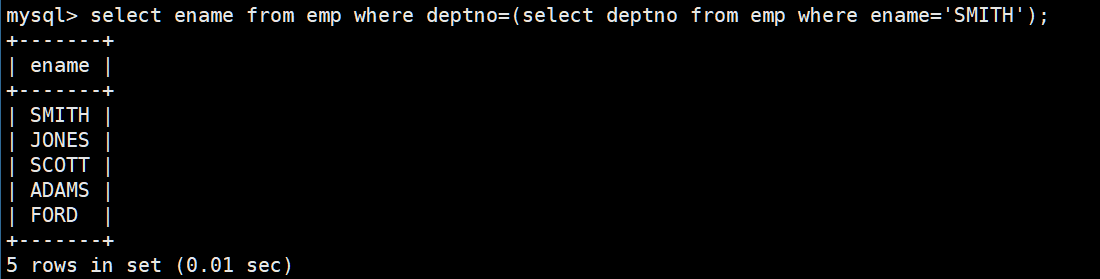
显示SMITH同一部门的员工
(2)多行子查询
- 返回结果:多行一列(多个值的集合)
- 搭配运算符 :
IN、ALL、ANY
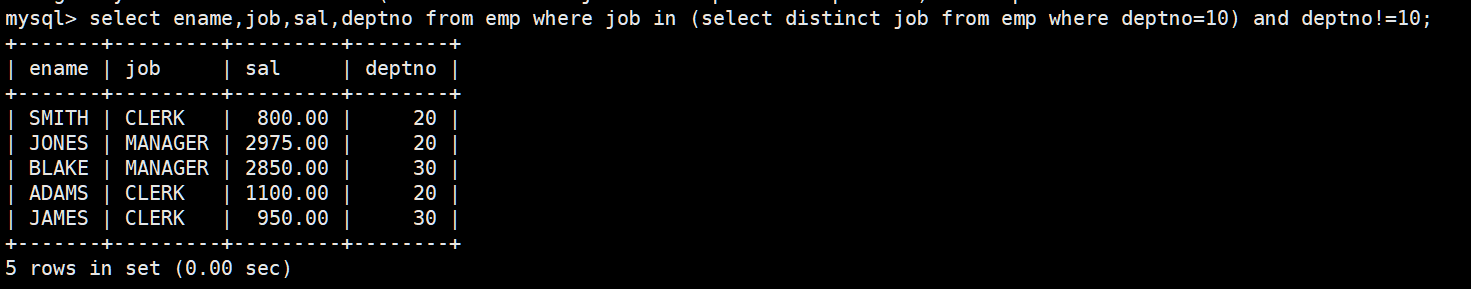
a.in:等于其中任意一个
查询和10号部门的工作岗位相同的雇员的名字,岗位,工资,部门号,但是不包含10自
己的
b.all :比所有都...
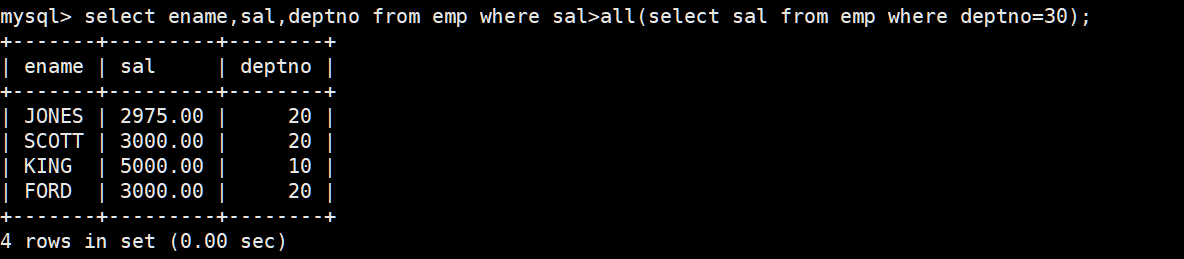
判断字段值要大于 / 小于子查询结果中的每一个值。
> ALL(...)= 大于最大值< ALL(...)= 小于最小值
显示工资比部门30的所有员工的工资高的员工的姓名、工资和部门号
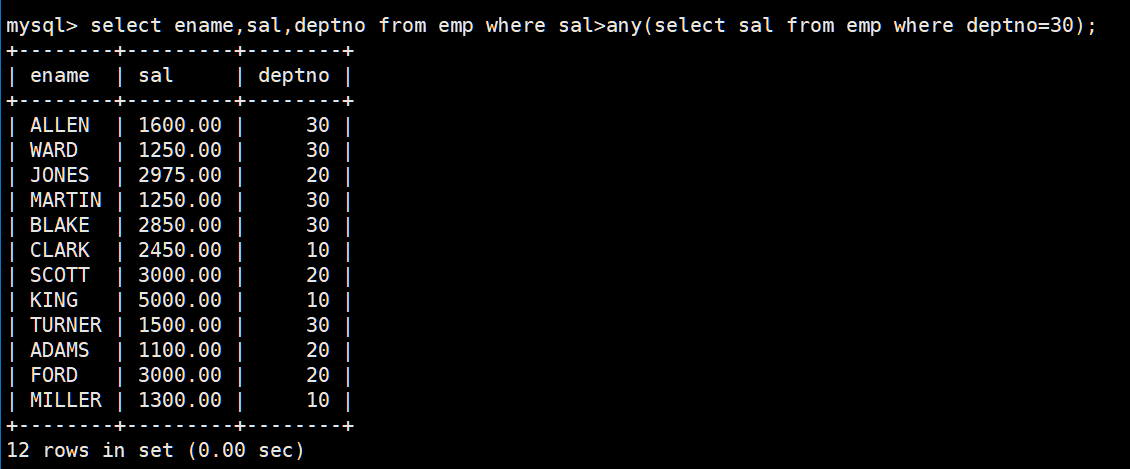
c.any:比任意一个...
判断字段值只要大于 / 小于子查询结果中的任意一个值即可。
> ANY(...)= 大于最小值< ANY(...)= 小于最大值
显示工资比部门30的任意员工的工资高的员工的姓名、工资和部门号(包含自己部门
的员工)
(3)多列子查询
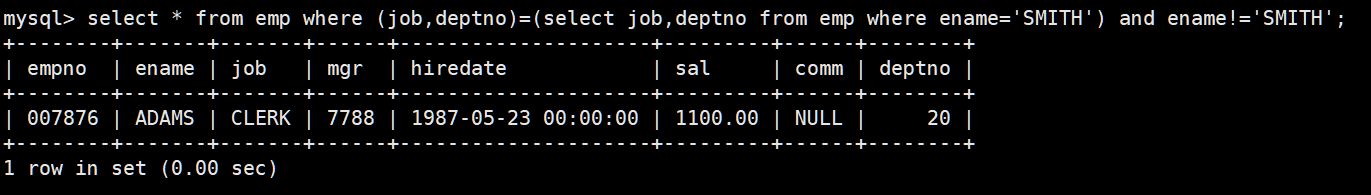
- 返回结果:一行多列
- 语法特点:主查询的比较条件必须用括号包裹多个列,列的顺序、数量、类型必须和子查询完全一致
查询和 SMITH 的部门、岗位都完全相同的所有雇员(不含 SMITH 本人)
(4)from 子句中的子查询(派生表)
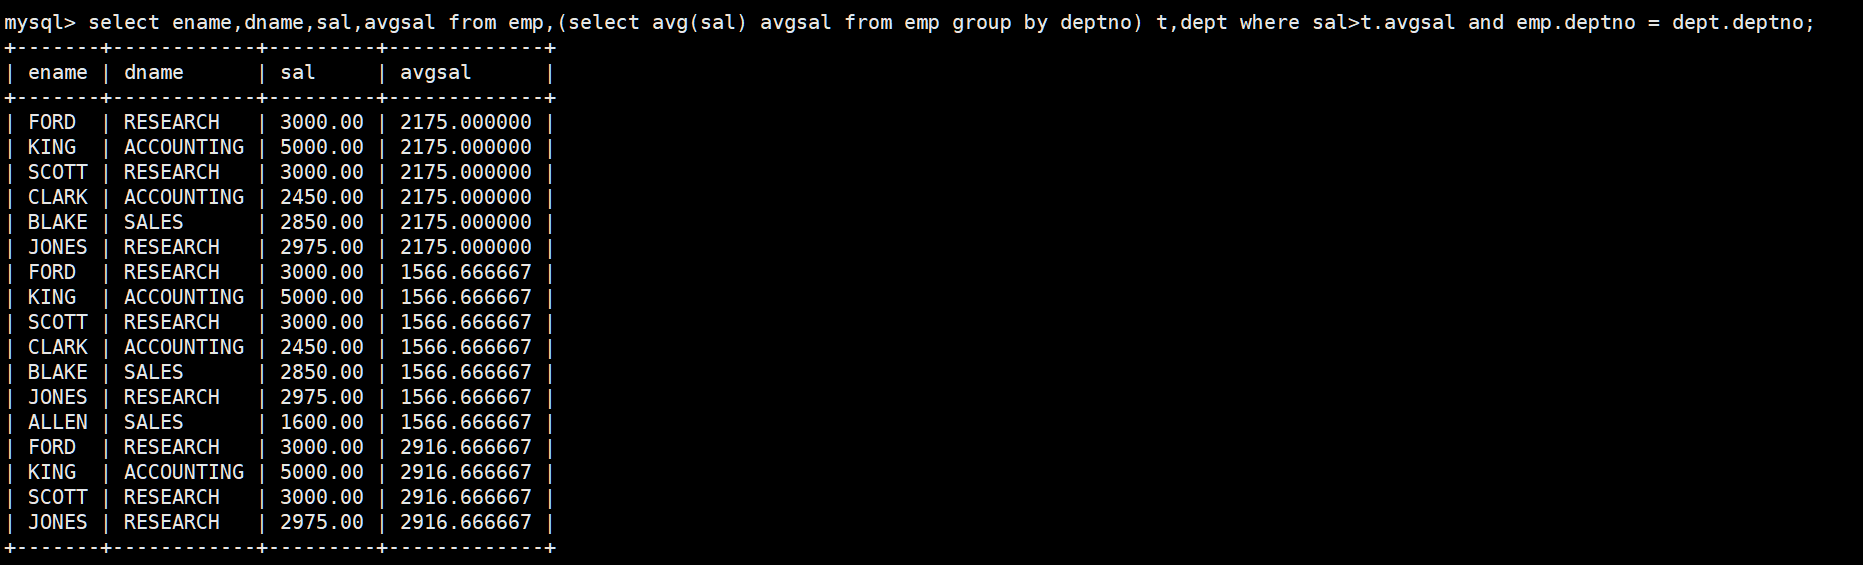
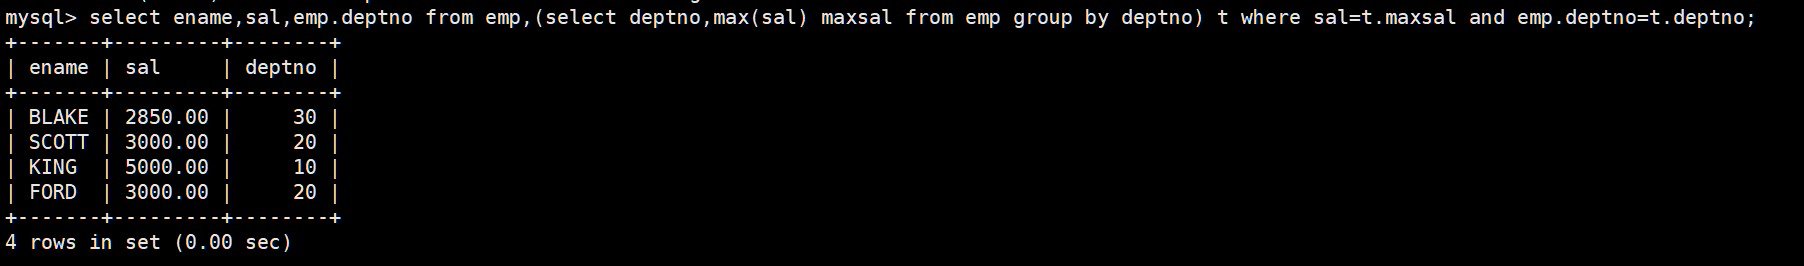
- 特点 :子查询出现在 FROM 子句中,将查询结果当作一张临时表来使用
- 强制要求:必须给子查询的结果起别名,否则主查询无法引用
- 适用场景:把聚合计算的结果作为中间表,再和其他表关联查询
-
显示每个高于自己部门平均工资的员工的姓名、部门、工资、平均工资
-
查找每个部门工资最高的人的姓名、工资、部门、最高工资
-
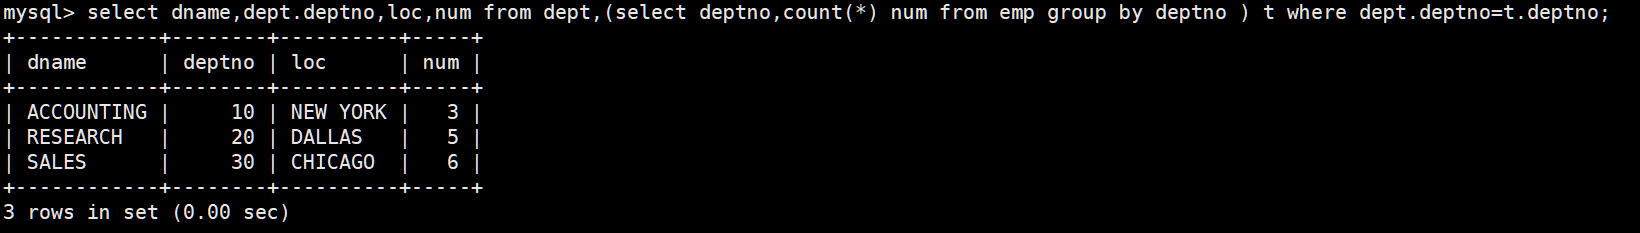
显示每个部门的信息(部门名,编号,地址)和人员数量
4.合并查询
将多个 SELECT 语句的查询结果,纵向拼接成一个结果集。和连接不同:连接是横向加列,合并是纵向加行。
多个 SELECT 语句的结果必须满足:
- 列数相同
- 对应列的数据类型兼容
- 最终结果的列名,以第一个 SELECT 语句的列名为准
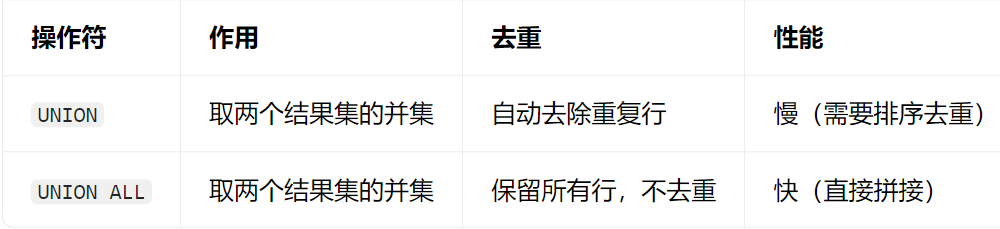
union 和 union all 的区别
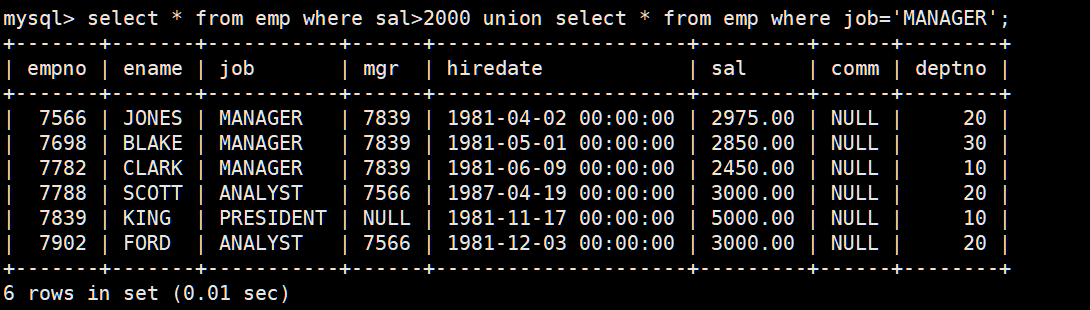
将工资大于2500或职位是MANAGER的人找出来
结尾
这一期对于MySQL的学习就到这里了,希望对你的学习有所帮助。感谢你的点赞、关注。我主页里有更好康的呦!