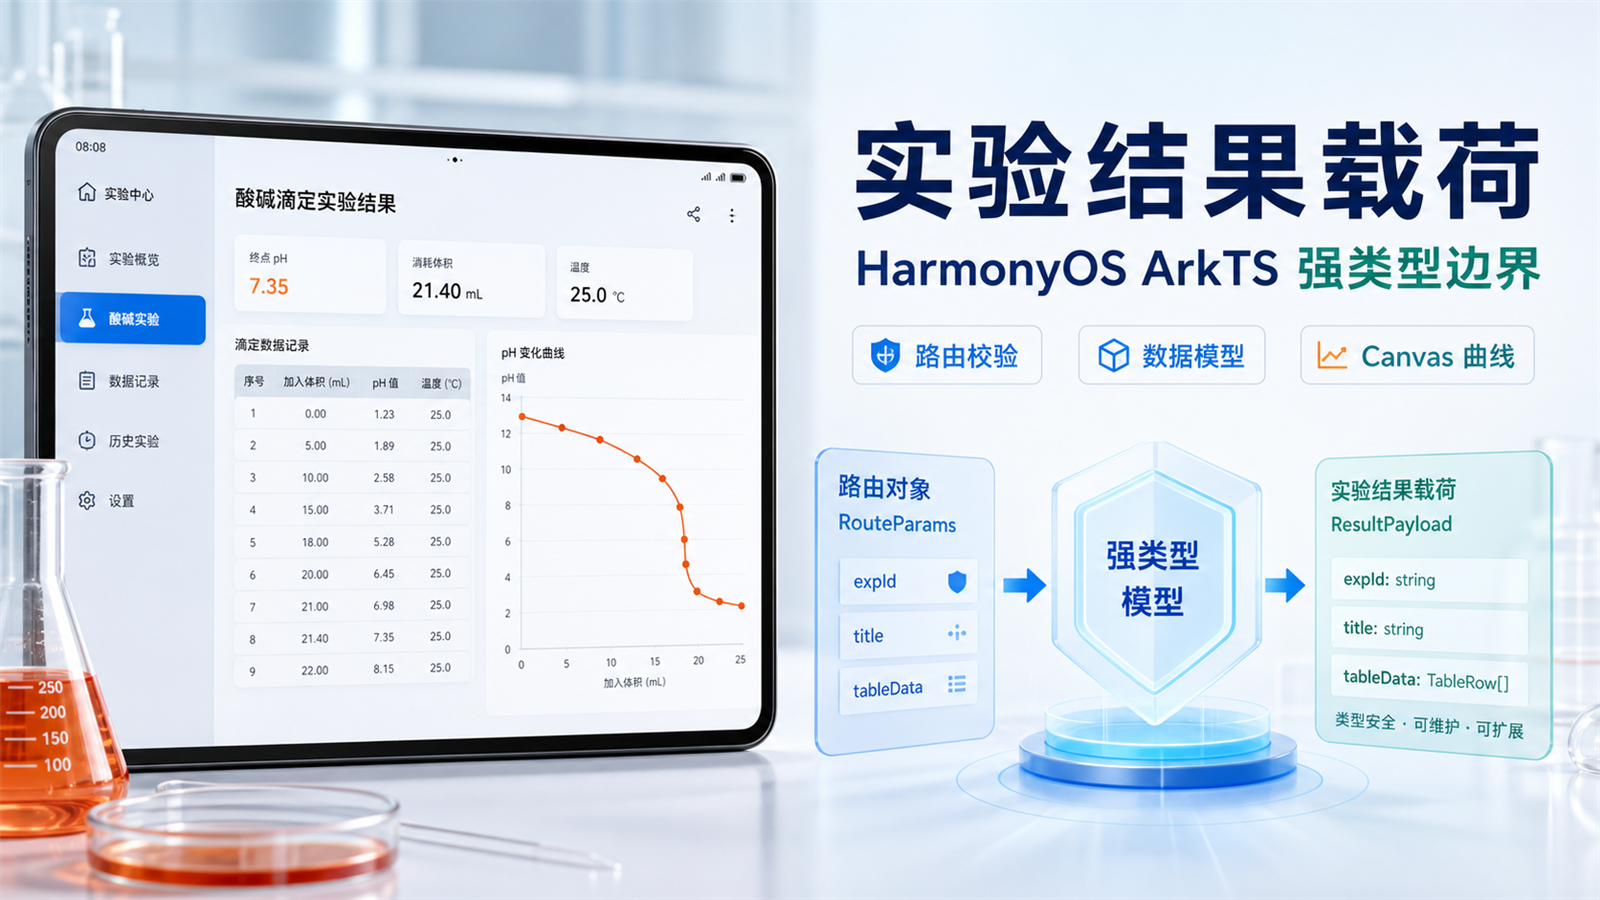
一个实验页面把曲线画出来,并不等于结果链路可靠。真正容易出错的地方,往往发生在"模拟结束"到"结果页展示"之间:上一个页面通过 router 传来一个普通对象,结果页直接把它断言成业务类型;表格把每行数据写成 number[],但没有人保证数组一定有三列;Canvas 又根据最后一行数据推导坐标范围,恰好遇到下降曲线时,前面的点就可能被画到可视区域之外。
本文基于 化学实验室 1.0.5 的真实 ArkTS 源码,复核 ExperimentResultPayload.ets 与 ExperimentResultPage.ets。文章不会只给一个"把 any 换成 interface"的表面答案,而是把路由输入、运行时校验、页面状态、表格适配、Canvas 坐标和报告跳转串成一条可验证的结果契约。
本文唯一复核标记:
CHEM-LAB-ONE12-RESULT-PAYLOAD-20260729
源码复核发现两个核心风险:
tableData: number[][]只能约束"它是二维数字数组",无法表达每一列分别是时间、pH 和反应进度。drawChart()使用最后一行的第二列作为纵轴最大值。默认数据的 pH 从7.00下降到0.50,最后值反而最小,前面的 pH 点会超出按1.2计算出的纵轴范围。
解决目标很明确:路由参数先当作不可信输入,只有经过规范化的强类型载荷才能进入页面状态;表格和曲线只消费同一组数据点,不再各自猜测列含义。
一、本文对应的工程环境
| 项目 | 实际值 | 本文关注点 |
|---|---|---|
| 应用 | 化学实验室 | 离线实验模拟、结果、报告与分享 |
| 应用版本 | 1.0.5 / versionCode 1000005 | AppScope/app.json5 当前声明 |
| HarmonyOS SDK | 6.0.2(22) | ArkTS / ArkUI Stage Model |
| 结果模型 | ExperimentResultPayload.ets |
路由与页面共同使用的载荷 |
| 结果页面 | ExperimentResultPage.ets |
表格、Canvas、保存、分享与报告 |
| 输入来源 | router.getParams() |
运行时对象,不能只靠类型断言 |
| 数据形态 | number[][] |
列含义不明确、缺少行级校验 |
本文是对现有源码的静态复核与改造设计,没有把示例代码冒充为已经合入工程的构建结果。文末会把"源码中已存在的行为"和"建议改造后的验证项"分开列出,便于读者复查。
二、先画清楚结果载荷的完整生命周期
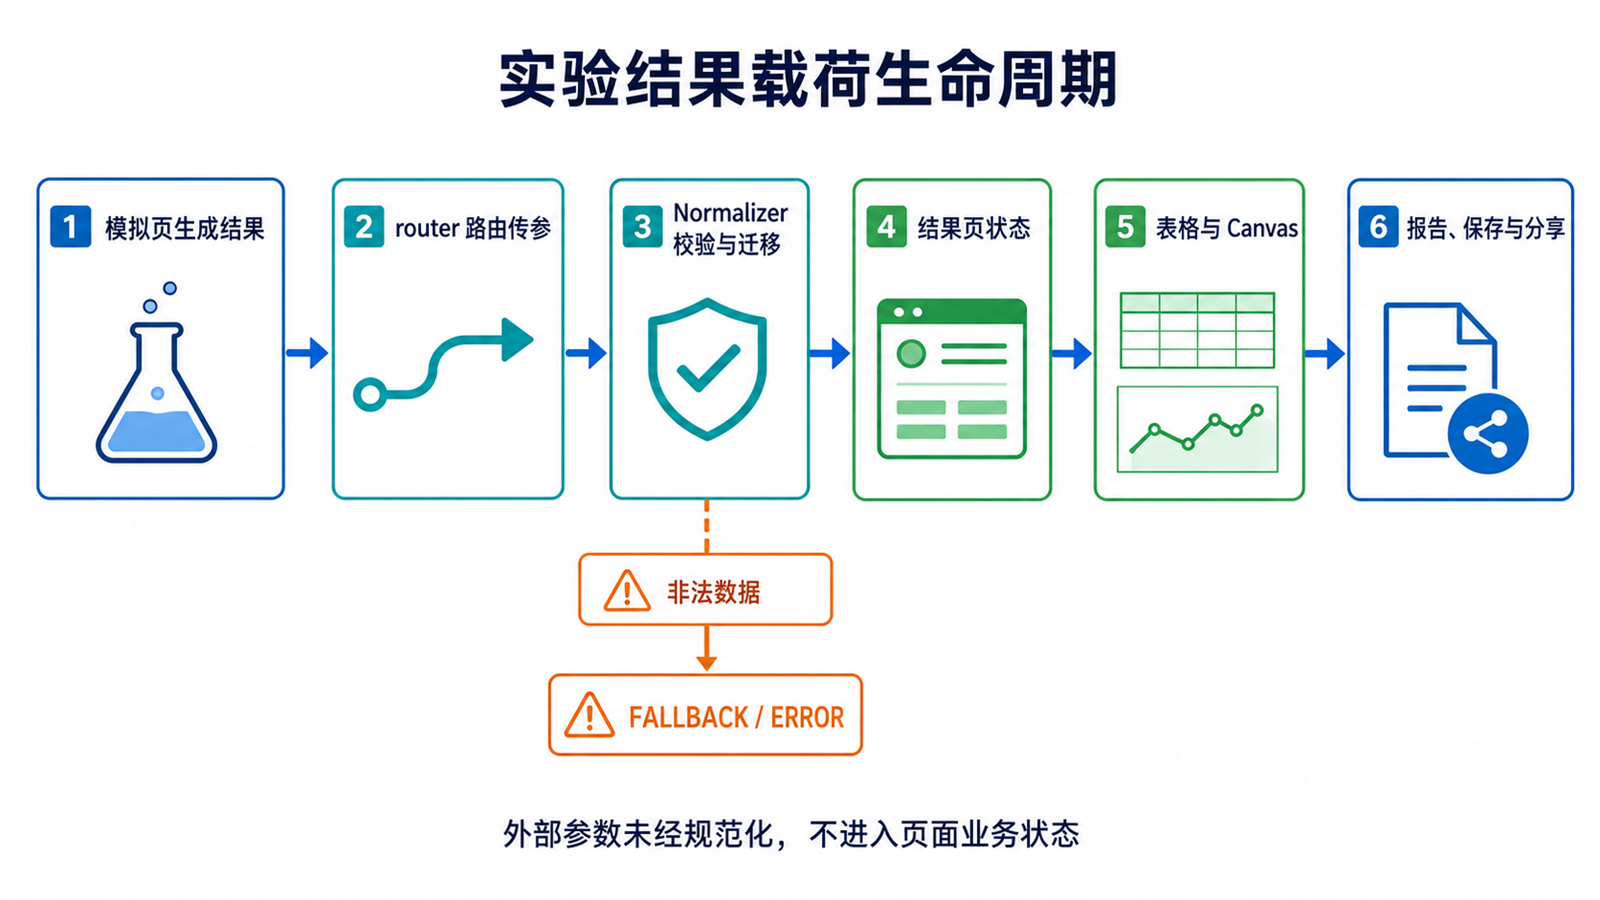
结果对象并不只服务于一个页面。当前链路至少经过六个节点:模拟页生成数据、路由传参、结果页接收、表格或曲线展示、生成报告、分享文本。任何一个节点对字段理解不同,都会产生"页面没有崩溃,但结果错了"的隐性问题。
现有结果模型很简洁:
ts
export interface ExperimentResultPayload {
  expId: string
  title: string
  category: string
  paramSummary: string
  conclusion: string
  tableData: number[][]
}
这份接口解决了字段命名统一,但还没有解决两个运行时问题。
第一,TypeScript/ArkTS 接口不会自动校验 router.getParams()。下面的断言只告诉编译器"请相信我",不会检查真实对象:
ts
const params = router.getParams() as ExperimentResultPayload | undefined第二,number[][] 没有列契约。[0.5, 5.8, 12] 表示时间、pH、进度,[5.8, 0.5, 12] 在类型系统里同样合法。代码能编译,曲线也能画,但语义已经交换。
因此结果链路需要一个明确规则:类型负责表达结构,Normalizer 负责运行时防线,页面只保存规范化后的值。
三、二维数组为什么是结果模型中的薄弱点
当前页面在三个位置直接使用数组下标:
ts
const t = this.tableData[i][0]
const v = this.tableData[i][1]

Text(row[0].toFixed(2))
Text(row[1].toFixed(2))
Text(row[2].toFixed(2))
这意味着"0 是时间、1 是 pH、2 是反应进度"只存在于开发者记忆里。只要上游少传一列,row[2] 就会变成 undefined,随后调用 toFixed() 产生运行时异常;如果上游把列顺序传错,页面甚至不会报错。
更适合这个场景的是命名数据点:
ts
export interface ExperimentDataPoint {
  timeMinute: number
  phValue: number
  progressPercent: number
}

export interface ExperimentResultPayloadV2 {
  schemaVersion: number
  expId: string
  title: string
  category: string
  paramSummary: string
  conclusion: string
  points: ExperimentDataPoint[]
}
增加 schemaVersion 不是为了"架构看起来高级",而是给未来迁移留入口。假设后续要加入温度、颜色或电导率,旧结果可以按版本转换,而不是让页面猜当前数组到底有几列。
命名字段还带来三个直接收益:
- 表格读取
point.phValue,列含义在代码里可见。 - Canvas 读取同一对象,不再复制下标规则。
- 测试可以构造缺少字段或越界值,验证规范化策略。
四、路由参数必须从 unknown 开始收敛
结果页当前只检查 title 和非空 tableData:
ts
aboutToAppear(): void {
  const params = router.getParams() as ExperimentResultPayload | undefined
  if (params && params.title && params.tableData && params.tableData.length > 0) {
    this.result = params
    this.tableData = params.tableData
  }
}
这段代码无法阻止以下输入进入页面:
ts
const malformed = {
  title: '酸碱中和',
  tableData: [[0, 7], [1, Number.NaN, 50]]
}
它有标题、也有非空数组,因此会通过现有判断;但第一行缺少进度,第二行包含 NaN,表格和曲线都会得到不可预测结果。
边界层应该先把参数视为 unknown,再逐层判断。为了保持 ArkTS 严格类型,可以使用窄接口与显式函数,而不是在页面里散落可选链:
ts
interface RawResultPayload {
  schemaVersion?: number
  expId?: string
  title?: string
  category?: string
  paramSummary?: string
  conclusion?: string
  tableData?: number[][]
}

function isFiniteNumber(value: number): boolean {
  return Number.isFinite(value)
}

function isLegacyRow(row: number[]): boolean {
  return row.length >= 3
    && isFiniteNumber(row[0])
    && isFiniteNumber(row[1])
    && isFiniteNumber(row[2])
}
在 ArkTS 工程中,router.getParams() 的具体静态类型要以当前 SDK 定义为准。重点不是执着于写出某个复杂通用类型守卫,而是把"外部对象未经校验不能写入 @State"设为边界原则。
五、用 Normalizer 同时承担校验与旧数据迁移
如果直接把现有模型改成 points,模拟页、结果页、报告页和分享工具都要同步调整,风险较大。更稳的方式是先增加一个规范化函数:它接收旧二维数组,输出命名数据点,并对范围做统一处理。
ts
export function normalizeLegacyRows(rows: number[][]): ExperimentDataPoint[] {
  const result: ExperimentDataPoint[] = []
  for (let index = 0; index < rows.length; index++) {
    const row = rows[index]
    if (!isLegacyRow(row)) {
      continue
    }
    result.push({
      timeMinute: Math.max(0, row[0]),
      phValue: Math.max(0, Math.min(14, row[1])),
      progressPercent: Math.max(0, Math.min(100, row[2]))
    })
  }
  return result
}
这里的处理策略必须写清楚,不能偷偷修数据:
- 少于三列、包含
NaN或无穷值的行直接丢弃。 - 时间不允许小于 0。
- pH 限制在常用展示范围
0..14。 - 反应进度限制在
0..100。
如果所有行都被过滤,就不应该继续展示一张"看似正常"的默认曲线,而应进入明确错误或降级状态:
ts
export interface NormalizeResult {
  payload: ExperimentResultPayloadV2
  usedFallback: boolean
  warnings: string[]
}
usedFallback 让页面能够显示"结果参数异常,已展示示例数据",而不是把示例数据伪装成用户刚完成的实验结果。
六、默认结果只能做显式降级,不能掩盖上游错误
项目中的 defaultExperimentResultPayload() 很有价值:它保证结果页在无参数预览、设计调试或异常恢复时仍能打开。但默认值如果静默生效,会带来业务误导。
当前页面初始化时已经写入默认结果:
ts
@State result: ExperimentResultPayload = defaultExperimentResultPayload()
@State tableData: number[][] = defaultExperimentResultPayload().tableData
若路由参数不合法,页面什么也不提示,用户看到的仍是"酸碱中和反应"。更稳的页面状态应区分四类:
ts
export enum ResultLoadState {
  LOADING = 'loading',
  CONTENT = 'content',
  FALLBACK = 'fallback',
  ERROR = 'error'
}
页面加载流程可以写成:
ts
private loadResult(): void {
  const raw = router.getParams()
  const normalized = ResultPayloadNormalizer.normalize(raw)
  this.result = normalized.payload
  this.points = normalized.payload.points
  this.loadState = normalized.usedFallback
    ? ResultLoadState.FALLBACK
    : ResultLoadState.CONTENT
  this.warnings = normalized.warnings
}
当进入 FALLBACK 时,顶部显示一条可关闭但不会自动消失的提示;当进入 ERROR 时,提供返回实验页和重试入口。这样默认数据仍然发挥兜底作用,又不会冒充真实实验。
七、修复曲线纵轴范围取值错误
这是本次源码复核中最值得优先修复的逻辑问题。当前实现如下:
ts
const maxT = this.tableData[this.tableData.length - 1][0]
const maxV = this.tableData[this.tableData.length - 1][1]
const tRange = Math.max(maxT, 1) * 1.1
const vRange = Math.max(maxV, 1) * 1.2
默认数据的第一行 pH 是 7.00,最后一行 pH 是 0.50。由此计算得到 vRange = 1.2,第一行的纵坐标是:
text
y = padT + plotH - (7.0 / 1.2) * plotH这个值会远小于 padT,也就是被画到绘图区上方。问题根源不是 Canvas,而是把"最后一个值"误当成"最大值"。
正确做法是扫描全量数据,并同时处理空集、相同值和非有限数:
ts
interface ChartRange {
  maxTime: number
  maxValue: number
}

private resolveChartRange(points: ExperimentDataPoint[]): ChartRange {
  let maxTime = 1
  let maxValue = 1
  for (let index = 0; index < points.length; index++) {
    const point = points[index]
    if (point.timeMinute > maxTime) {
      maxTime = point.timeMinute
    }
    if (point.phValue > maxValue) {
      maxValue = point.phValue
    }
  }
  return {
    maxTime: maxTime * 1.1,
    maxValue: maxValue * 1.2
  }
}
对 pH 场景还可以固定纵轴为 0..14,这样不同实验之间具有可比较性;如果同一个结果页未来也展示温度或电导率,就应根据指标类型选择范围策略,而不是统一取第二列。
八、表格与 Canvas 必须消费同一份数据点
当模型改成 ExperimentDataPoint[] 后,表格不再依赖下标:
ts
ForEach(this.points, (point: ExperimentDataPoint) => {
  ListItem() {
    Row() {
      Text(point.timeMinute.toFixed(2))
        .layoutWeight(1)
        .textAlign(TextAlign.Center)
      Text(point.phValue.toFixed(2))
        .layoutWeight(1)
        .textAlign(TextAlign.Center)
      Text(point.progressPercent.toFixed(2))
        .layoutWeight(1)
        .textAlign(TextAlign.Center)
    }
  }
})
Canvas 使用同一个 point:
ts
for (let index = 0; index < this.points.length; index++) {
  const point = this.points[index]
  const x = padL + (point.timeMinute / range.maxTime) * plotW
  const y = padT + plotH - (point.phValue / range.maxValue) * plotH
  if (index === 0) {
    ctx.moveTo(x, y)
  } else {
    ctx.lineTo(x, y)
  }
}
这不是单纯把 [0] 改成字段名。真正的收益是"表格、曲线、分享、报告"围绕一个领域对象工作。当字段含义变化时,编译错误会把所有受影响位置暴露出来,而不是让错误数据继续运行。
九、页面切换与 Canvas 重绘要有明确触发点
当前页面默认 activeTab = 1,Canvas 在 onReady() 中记录宽高并绘制。如果用户先看数据表格,再切回曲线,组件可能重新构建;但数据变化、窗口尺寸变化或主题变化时,仅依赖一次 onReady() 不够清晰。
可以把切换动作收口到方法:
ts
private switchTab(nextTab: number): void {
  if (this.activeTab === nextTab) return
  this.activeTab = nextTab
  if (nextTab === 1) {
    setTimeout(() => {
      this.drawChart()
    }, 0)
  }
}
不过是否允许在当前 ArkTS 版本直接采用该调度方式,应以项目 SDK 和实际构建结果为准。更重要的是定义重绘条件:
- Canvas 首次 ready 后绘制。
points更新后绘制。- 从表格切回曲线后绘制。
- 窗口尺寸变化后重新计算
chartW与chartH。 - 深浅色切换后使用新主题颜色重绘。
把这些条件写入测试清单,比在多个点击回调里重复调用 drawChart() 更容易维护。
十、保存、报告与分享要保留结果身份
当前 saveResult() 调用 buildRecord() 时只传入实验 ID、标题、分类和参数摘要:
ts
const record: StoredExperimentRecord = buildRecord(
  this.result.expId,
  this.result.title,
  this.result.category,
  this.result.paramSummary
)
这适合作为"做过一次实验"的轻量记录,但它不等价于保存完整结果。如果产品文案写"保存数据",用户可能合理期待以后能恢复曲线和结论。
因此需要先明确两类数据:
| 类型 | 目的 | 建议字段 |
|---|---|---|
| 实验历史摘要 | 列表、统计、最近学习 | expId、title、category、paramSummary、createdAt |
| 实验结果快照 | 恢复表格、曲线与报告 | schemaVersion、points、conclusion、参数、createdAt |
如果当前只保存摘要,按钮名称可以改成"保存到实验记录";如果要支持恢复,就需要增加结果快照模型、持久化版本和迁移策略。
报告跳转当前直接复用 this.result:
ts
router.pushUrl({
  url: 'views/experiment/ExperimentReportPage',
  params: this.result
})
这正是统一载荷的价值:结果页与报告页不需要重新拼装字段。但前提是 this.result 已经经过规范化,而不是未经校验的原始路由对象。
十一、强类型边界的推荐目录结构
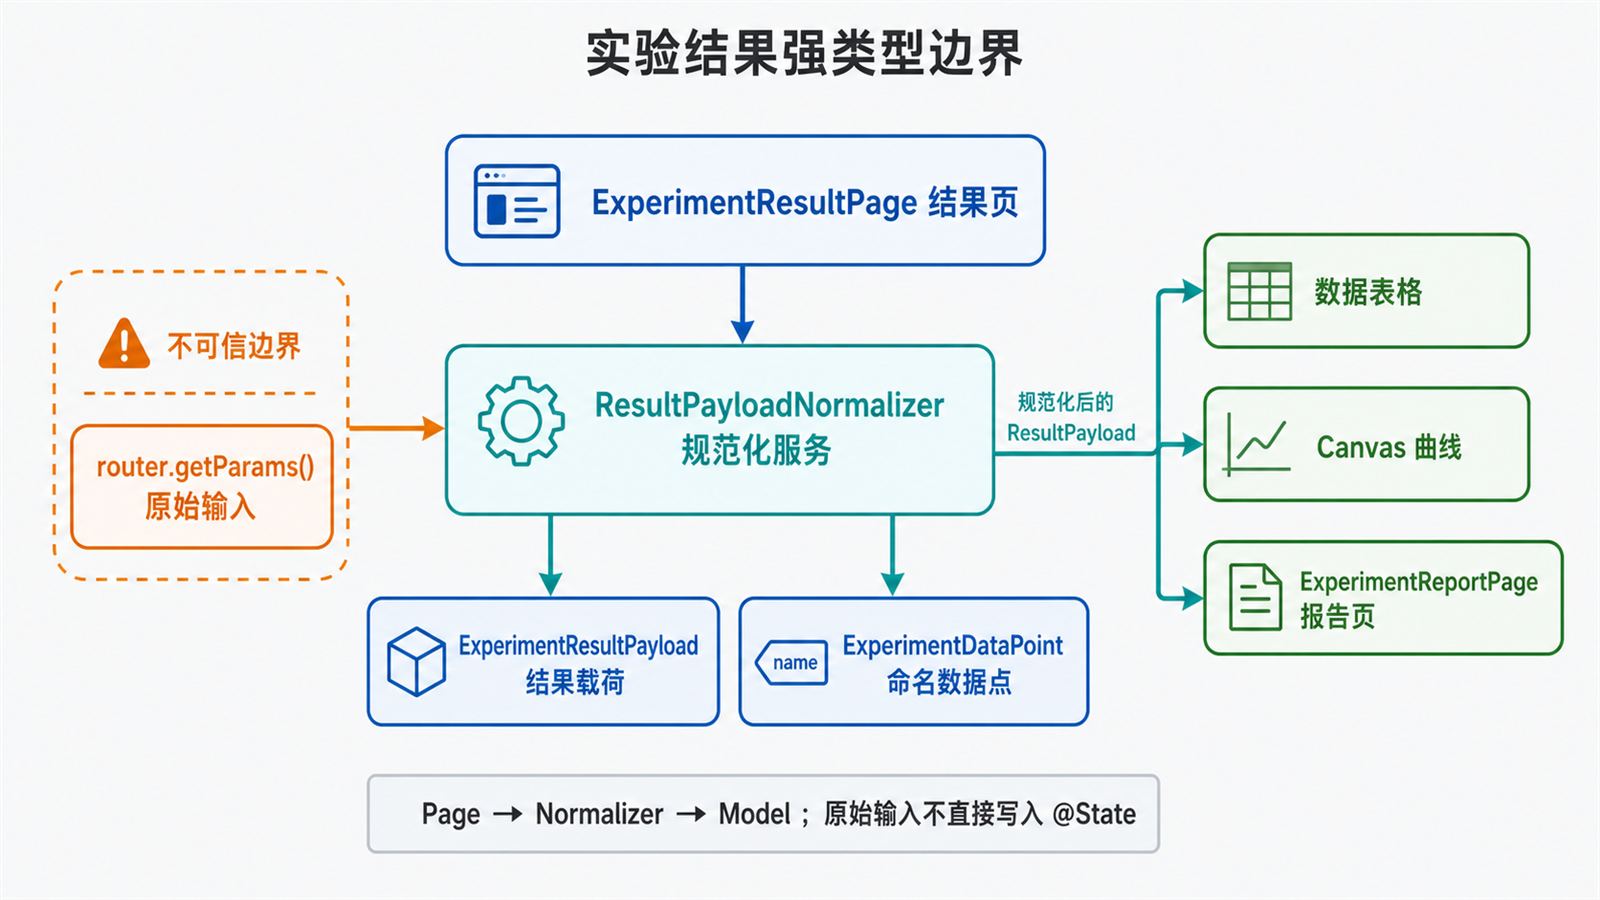
不必为了一个模型引入庞大框架,保持三层边界就够了:
text
model/
  ExperimentResultPayload.ets   # 领域类型、schemaVersion
  ExperimentDataPoint.ets       # 命名数据点

service/
  ResultPayloadNormalizer.ets   # 路由输入校验、旧格式迁移、告警

views/experiment/
  ExperimentResultPage.ets      # 页面状态、表格和 Canvas
  ExperimentReportPage.ets      # 报告展示
依赖方向是 Page -> Normalizer -> Model。模型不依赖页面,Normalizer 不负责绘制,页面不再解析数组列。这个结构足以支持单元测试,也不会把项目改造成抽象层过多的"架构样板"。
十二、按边界用例验证,不只验证正常数据
建议把验证分为载荷、表格、曲线和交互四组:
| 编号 | 输入或操作 | 预期结果 | 主要风险 |
|---|---|---|---|
| R-01 | 合法 7 行酸碱数据 | 表格 7 行,曲线全部在绘图区 | 基本路径 |
| R-02 | 第一行 pH 7,最后一行 pH 0.5 | 纵轴按全量最大值或 14 计算 | 当前可复现缺陷 |
| R-03 | 某行只有两列 | 过滤该行并记录 warning | toFixed 异常 |
| R-04 | 某行包含 NaN |
不进入页面数据点 | Canvas 非有限坐标 |
| R-05 | pH 为 18 | 规范化到 14 或拒绝载荷 | 数值越界 |
| R-06 | 进度为 -5 | 规范化到 0 或拒绝载荷 | 业务范围 |
| R-07 | 路由参数为空 | 显示明确降级提示 | 默认数据冒充结果 |
| R-08 | 快速重复点击保存 | 只执行一次持久化 | 重复记录 |
| R-09 | 分享面板不可用 | Toast 提示且按钮恢复 | 异常状态 |
| R-10 | 表格切换曲线 | Canvas 使用同一 points 重绘 | 状态不同步 |
当前源码已经通过 isSaving 与 isSharing 防止重复操作,这是值得保留的实现:
ts
if (this.isSaving) return
this.isSaving = true
try {
  // save
} catch (_) {
  // visible failure state
}
this.isSaving = false
进一步可用 finally 保证状态恢复,避免未来在 try 中增加提前返回后漏掉复位:
ts
this.isSaving = true
try {
  await saveSnapshot(this.result)
} catch (error) {
  this.showToast('保存失败,请重试')
} finally {
  this.isSaving = false
}
十三、改造顺序与回滚边界
为了控制影响范围,建议按以下顺序实施:
- 先修
drawChart()的最大值扫描,这是低风险且可独立验证的真实缺陷。 - 增加
ExperimentDataPoint与旧数组转换函数,暂时保留原tableData字段。 - 让结果页内部统一使用
points,表格和 Canvas 不再访问数组下标。 - 增加路由参数规范化与
FALLBACK提示。 - 再让模拟页直接生成 V2 载荷。
- 最后迁移报告、分享与结果快照存储。
每一步都可以保留旧入口,出现问题时回到上一阶段,不需要一次性修改所有页面。迁移完成后再删除 tableData,避免长期维护双数据源。
十四、提交前复查清单
-
router.getParams()的结果没有未经校验直接写入@State。 - 每个数据点都有命名字段,不再依赖
[0]、[1]、[2]。 - 时间、pH、进度都检查有限值和业务范围。
- 曲线范围扫描全量数据,不使用最后一行冒充最大值。
- 默认数据出现时有明确降级提示。
- 表格、Canvas、报告和分享消费同一份规范化载荷。
- 保存按钮文案与真实保存内容一致。
- 重复点击、分享失败、空数据都有可见反馈。
- 窗口尺寸与主题变化后曲线能够重绘。
- 旧载荷迁移有
schemaVersion或等价版本边界。
十五、源码事实与建议实现的边界
为了避免把设计建议写成"项目已经完成的能力",这里对全文结论做一次归档。读者可以直接打开文首列出的两个 ArkTS 文件逐项复核。
| 类别 | 当前源码可直接确认 | 本文提出但尚未声称已合入 |
|---|---|---|
| 结果模型 | ExperimentResultPayload 使用 number[][] 保存表格数据 |
ExperimentDataPoint[]、schemaVersion 与 V2 载荷 |
| 路由接收 | router.getParams() 后通过类型断言和少量字段判断写入状态 |
以不可信输入为起点的 Normalizer、warning 与错误态 |
| 默认值 | 页面初始化即使用 defaultExperimentResultPayload() |
FALLBACK 状态和"正在展示示例数据"的显式提示 |
| 曲线范围 | maxV 读取最后一行第二列;默认 pH 数据由 7.00 降至 0.50 |
扫描全量最大值,或为 pH 使用固定 0..14 量程 |
| 表格与曲线 | 两者都消费 tableData,但依赖数组下标解释列语义 |
两者统一消费带命名字段的数据点 |
| 防重复操作 | 已有 isSaving 与 isSharing 按钮状态 |
使用 finally 进一步保证异常路径复位 |
| 后续页面 | 报告页通过路由继续接收 this.result |
仅允许规范化后的结果继续传递和持久化 |
本文给出的代码用于说明可落地的改造方法,但没有声称这些建议已经完成工程编译、真机运行或 AGC 上架验证。实际实施时应按第十三节分阶段修改,并在每个阶段重新构建和回归。
总结
实验结果链路的可靠性,不取决于接口文件里有没有 interface,而取决于运行时对象是否经过校验、列语义是否被类型表达、所有展示是否消费同一份数据,以及异常时页面有没有诚实反馈。
对化学实验室当前实现,最先应该修的是曲线范围:默认 pH 数据下降,最后值并不是最大值。随后把 number[][] 收敛为 ExperimentDataPoint[],再通过 Normalizer 隔离路由参数与页面状态。完成这三步后,表格、Canvas、报告和分享才能真正共享一份可预测、可迁移、可测试的实验结果载荷。
AI 辅助声明:本文由 AI 辅助完成源码梳理、结构校对与配图设计,技术结论均以文中列出的本地 ArkTS 源码为依据,并由作者复核后发布。