做 AI 训练的人几乎都遇到过这种场景:几百个 Pod 同时拉起,数据集还没加载完,元数据服务先被打满了。日志里看是 Mount 慢,根子上却是存储栈和工作负载形态不匹配。
常规的「挂一块云盘」思路在这里不够用:顺序大带宽扛得住,海量小文件和并发元数据操作扛不住;而 CSI 官方文档讲的是通用场景,很少回答「训练任务该选哪种存储、怎么编排数据」这类问题。
本文分享一套可直接落地的方案:CSI 演进脉络拆解 + 并行文件系统选型表 + 数据预热编排与排错清单,三段组合覆盖 AI 存储架构设计。
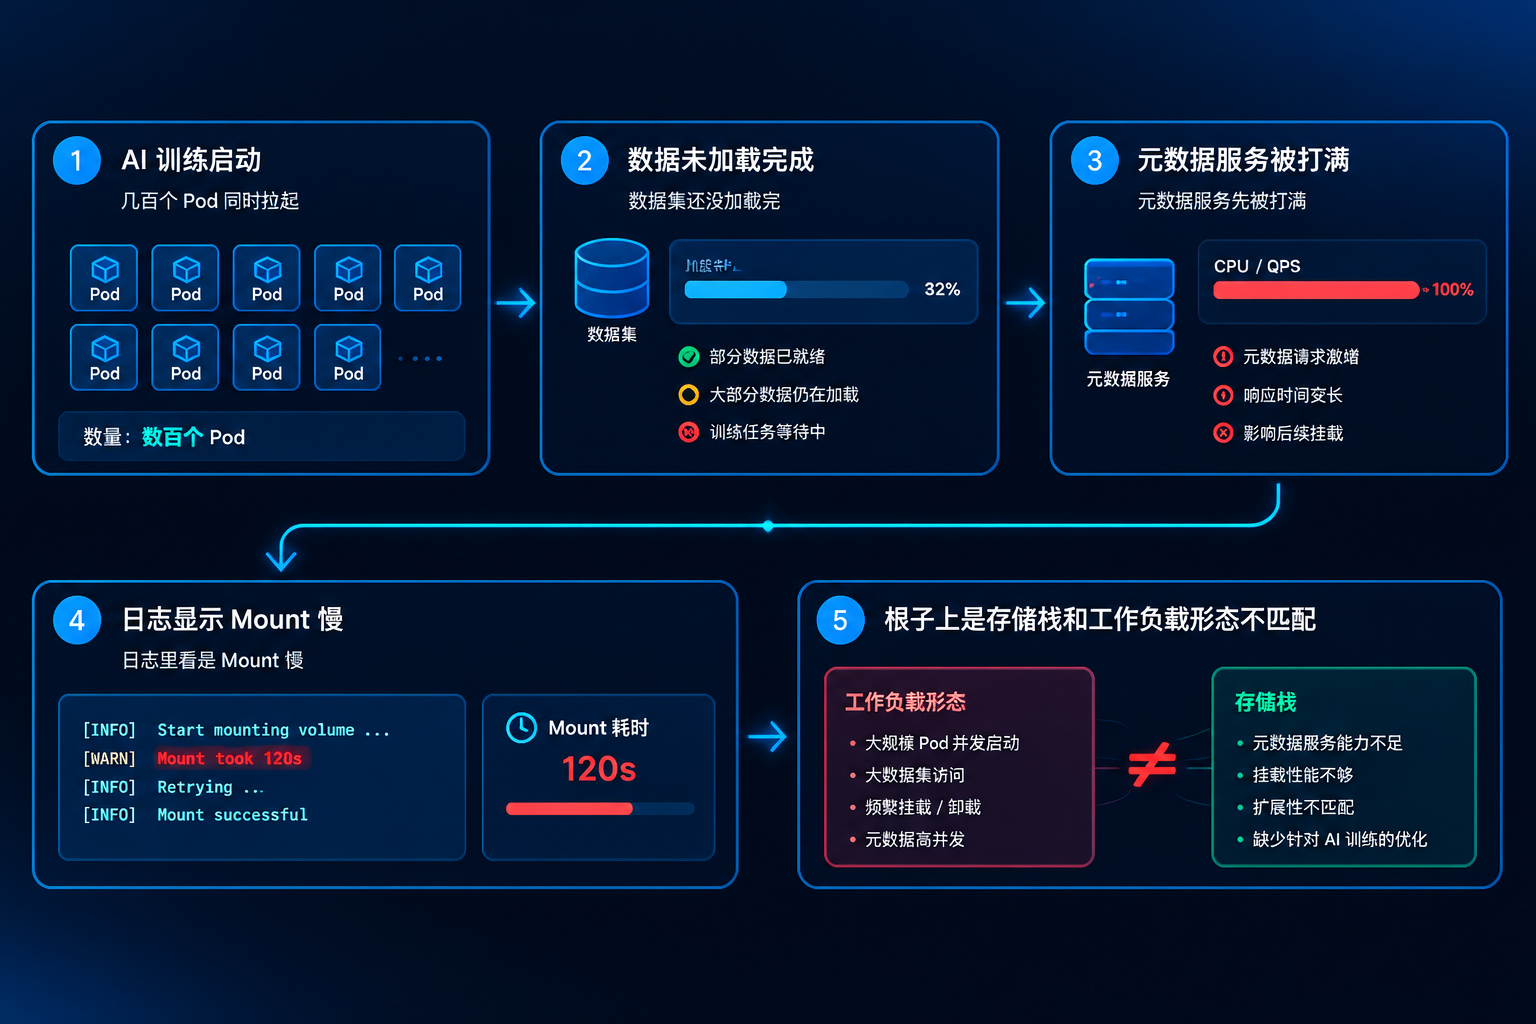
一、痛点定位:AI 负载把存储打在哪一环
先把问题定位准确,才能决定改哪一层:
- 小文件风暴 :ImageNet 级数据集动辄百万文件,每个 epoch 的
readdir会把元数据库打成热点。 - 启动期抖动:训练作业是「同时启动、同时拉数据」,突发带宽是稳态的 10 倍以上。
- 读放大:DataLoader 多 worker 随机读小块,顺序带宽再高也用不满。
- 弹性缺位:云盘扩容要重启 Pod,checkpoint 写入窗口期最容易出事。
核心结论: AI 存储问题的本质是元数据与并发读,不是带宽总量。
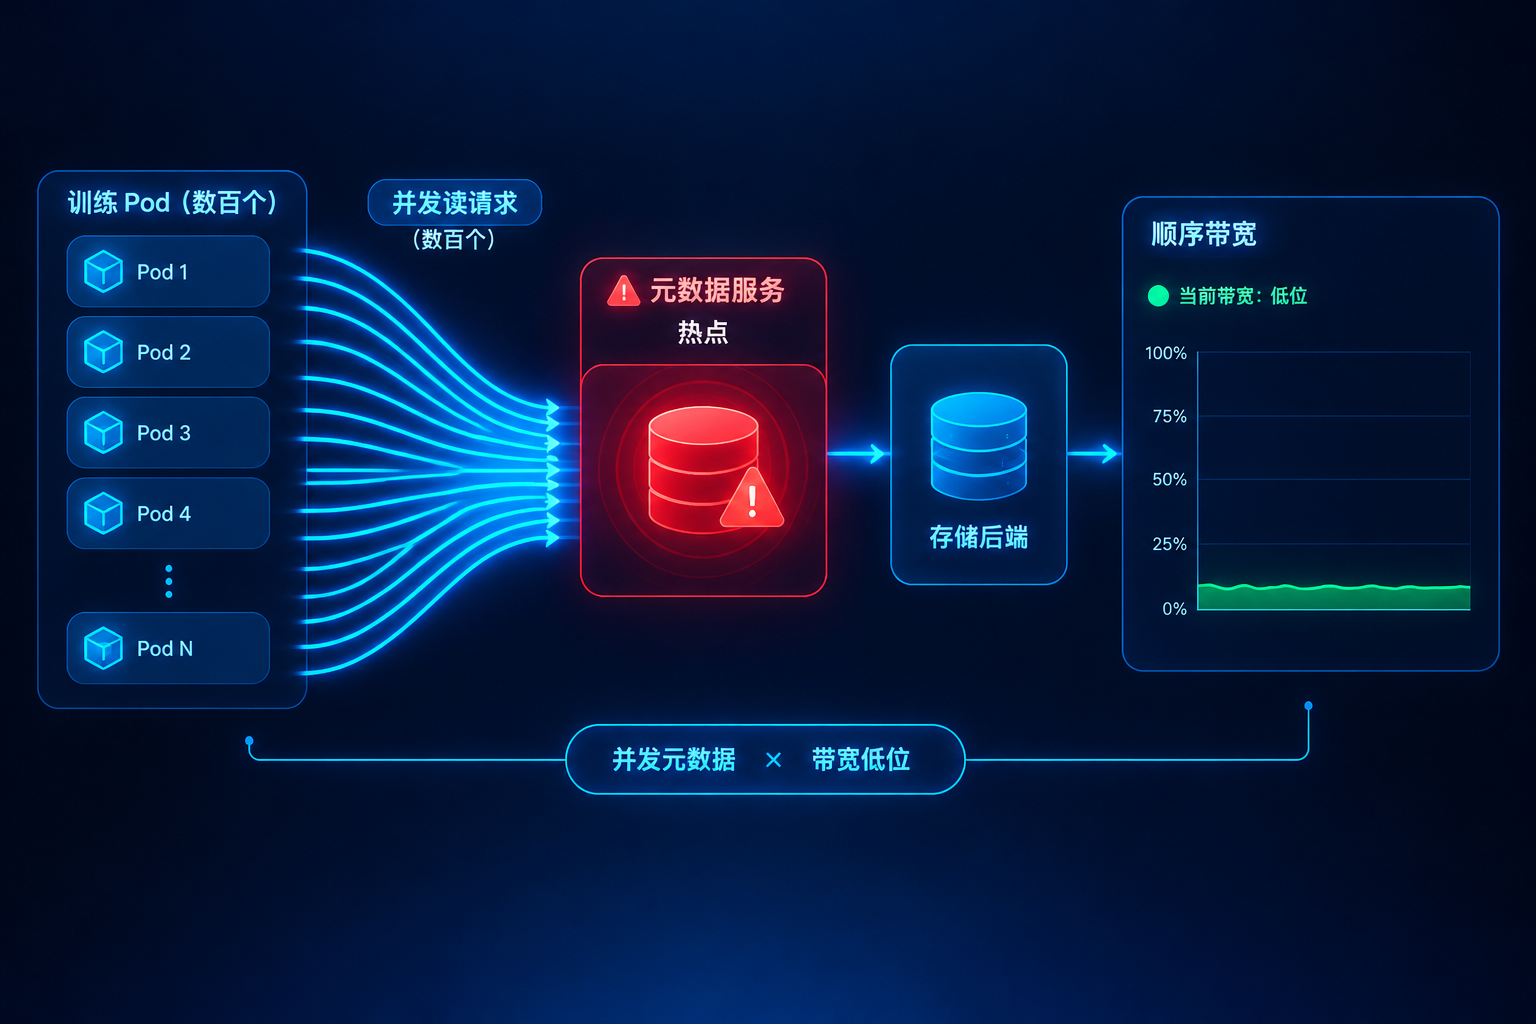
二、演进脉络:CSI 从外挂走向标准接口
CSI 的三段演进,决定了今天能做到什么:
- FlexVolume 时代:存储插件以可执行文件形式下发到每个节点,容器运行时耦合紧,凭据管理混乱。
- CSI 定版 :gRPC 接口统一了
NodeStage、NodePublish、ControllerPublish等语义,存储厂商一次开发全平台通用。 - Sidecar 拆分 :
external-provisioner、external-attacher、external-resizer拆成独立组件,K8s 核心不再关心厂商细节。 - 近期方向 :VolumeAttributesClass 让参数可动态下发,group controller 支持卷组级快照,服务多 Pod 并发挂载。
核心结论: 接口标准化之后,选型的自由度从「能不能接」变成了「参数怎么调」。
三、职责边界:Controller 与 Node 插件各管什么
排障前必须分清故障面,两者的分工如下:
| 组件 | 运行位置 | 负责动作 | 典型故障表现 |
|---|---|---|---|
| Controller 插件 | 集群级 Deployment | 建卷、删卷、扩卷、挂接 | PVC 卡 Pending |
| Node 插件 | 每节点 DaemonSet | 格式化、Mount、卷统计 | Pod 卡 ContainerCreating |
| external-provisioner | 集群级 | 监听 PVC 触发建卷 | StorageClass 无响应 |
| kubelet | 每节点 | 驱动挂载生命周期 | 事件报 MountVolume failed |
对应关系可以这样记:
PVC → external-provisioner → Controller 插件建卷 → attacher 挂接 → Node 插件 Mount → kubelet 启容器
核心结论: Pending 查 Controller 侧,ContainerCreating 查 Node 侧,先分层再看日志。
四、动态供给:StorageClass 参数怎样定才不踩坑
下面这段 YAML 定义一个面向训练数据集的 StorageClass,适配 Kubernetes 1.27+ 与主流 CSI 驱动:
yaml
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: ai-dataset-fast
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  iops: "6000"
  throughput: "750"
  encrypted: "true"
reclaimPolicy: Retain
allowVolumeExpansion: true
volumeBindingMode: WaitForFirstConsumer
mountOptions:
- noatime关键点:WaitForFirstConsumer 延迟到调度时建卷,保证数据与计算同可用区;Retain 保护数据集不被误删。
- 绑定模式 :训练数据集用
Immediate也没问题,写入型 PVC 务必WaitForFirstConsumer。 - 扩容开关 :
allowVolumeExpansion忘开,后期补数据只能重建 PVC。
五、快照链路:Checkpoint 与数据集克隆怎么做
快照是 AI 场景的刚需,训练中断续跑、实验分支都靠它:
bash
# 创建快照并克隆出新 PVC,供另一组实验并行使用
kubectl apply -f - <<'EOF'
apiVersion: snapshot.storage.k8s.io/v1
kind: VolumeSnapshot
metadata:
  name: dataset-epoch10
spec:
  volumeSnapshotClassName: csi-snapclass
  source:
    persistentVolumeClaimName: ai-dataset
EOF
核心结论: 用快照做「数据集版本」,比复制目录快一个数量级。
| 场景 | 推荐手段 | 耗时特征 |
|---|---|---|
| 训练续跑 | 秒级增量快照恢复 | 分钟内 |
| 实验分支 | 快照克隆新 PVC | 克隆瞬间完成 |
| 跨集群迁移 | 对象存储导出再导入 | 依赖带宽 |
| 归档冷数据 | 快照转归档存储 | 按天计 |
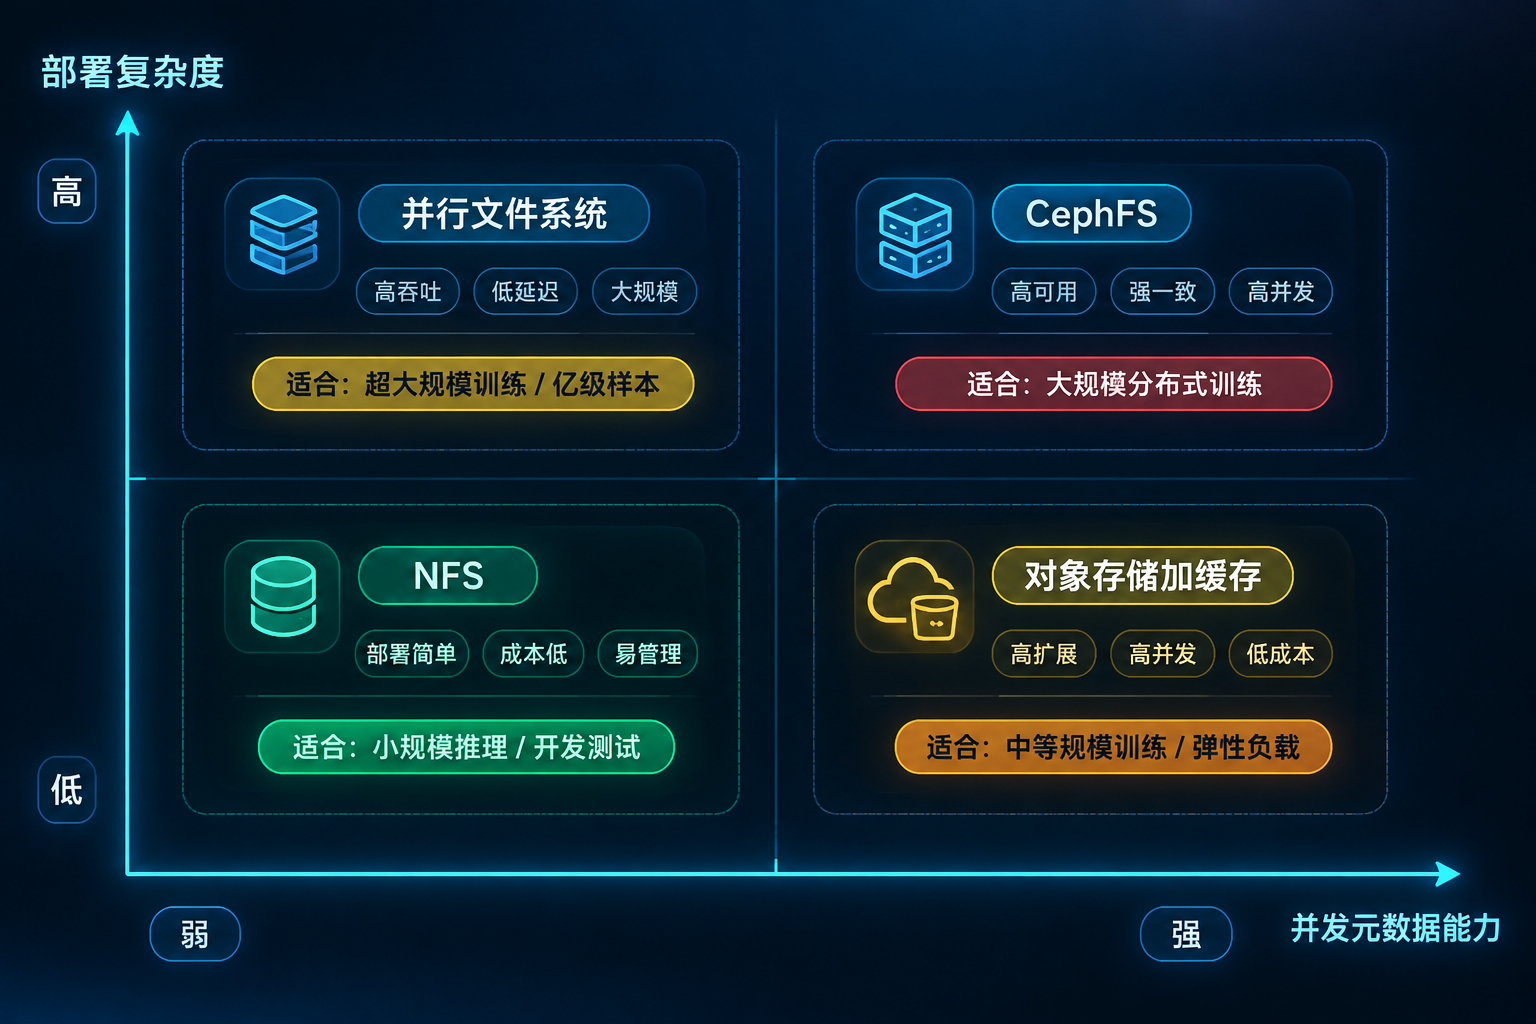
六、文件系统选型:三种并行方案横向对比
选型先看工作负载画像,再看运维成本:
| 方案 | 并发元数据 | 部署复杂度 | 适合阶段 |
|---|---|---|---|
| CephFS | 强 | 高(需独立集群) | 千级 Pod 规模 |
| Lustre/HPFS 类 | 极强 | 中(专用存储节点) | 百卡以上训练 |
| NFS | 弱 | 极低 | 小团队起步 |
| 对象存储 + 缓存 | 中(靠缓存) | 中 | 冷数据与推理 |
三条硬性判断标准:
- 文件数阈值:数据集超 500 万小文件,直接排除 NFS。
- 单流带宽:Checkpoint 写入要 1 GB/s 以上,需并行文件系统。
- 多 Pod 共享:同一数据集被多训练任务读,必须支持并发挂载。
核心结论: 小团队先 NFS 起步,但要在架构上预留迁移到并行文件系统的挂载点。
七、数据编排:用 Dataset CRD 自动预热缓存
让数据在训练启动前就位,这一段是落地关键:
yaml
apiVersion: data.kubeflow.org/v1alpha1
kind: Dataset
metadata:
  name: imagenet-mirror
spec:
  source:
    http:
      url: https://mirror.example.com/imagenet.tar
  mounts:
    - mountPath: /data/imagenet
      nodeAffinity:
        required:
          nodeSelectorTerms:
            - matchExpressions:
                - key: workload.example.com/gpu-pool
                  operator: Exists
核心结论: 节点亲和 + 挂载点绑定 让数据只在 GPU 池节点预热,避免全集群重复拉取。
- 失败兜底 :预热失败要让 Job 进入
Pending而非跑空数据,靠 initContainer 校验路径。 - 增量更新:对象存储改用基于 ETag 的增量同步,避免每次全量下载。
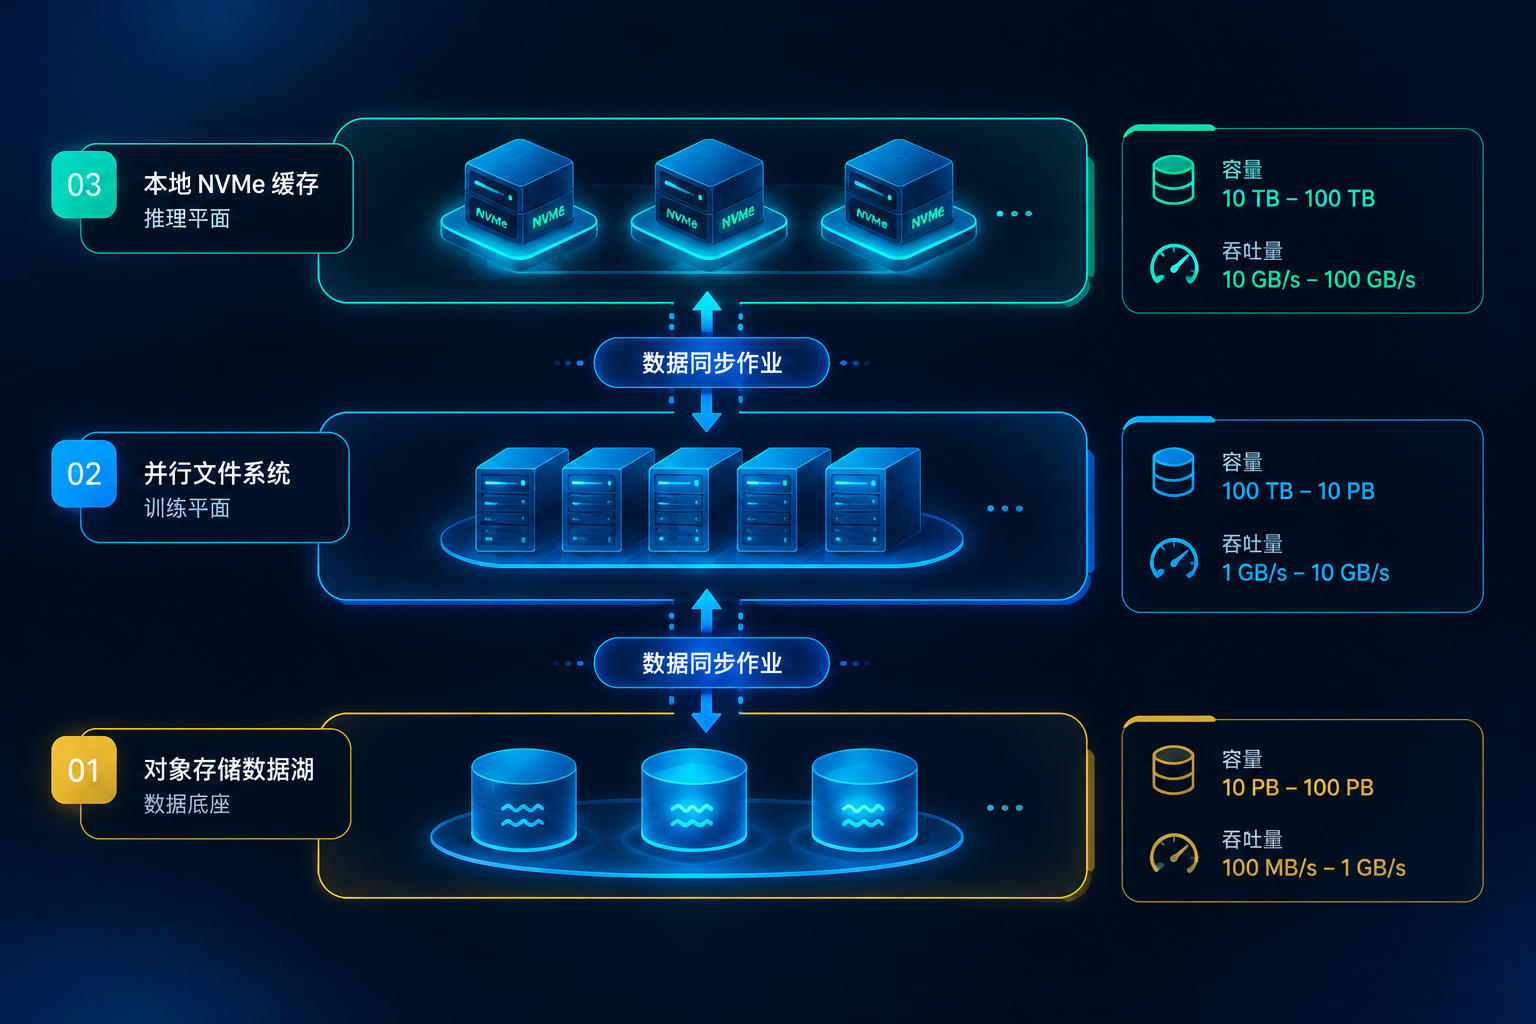
八、架构总览:训练、推理、数据湖三平面拆分
整体架构按读写特征分层,比「一套存储打天下」稳得多:
- 训练平面:并行文件系统承载数据集与 checkpoint,高吞吐、高并发、允许较高成本。
- 推理平面:只读模型仓 + 本地 NVMe 缓存,启动快、命中率高,容量需求固定。
- 数据湖平面:对象存储保存原始数据与标注,冷热分层,成本最低。
链路关系一句话说清:
原始数据 → 对象存储 → 加工后数据集 → 并行文件系统 → 训练 Pod → checkpoint 回写
核心结论: 三平面之间用「导出/同步作业」解耦,任何一层扩容都不牵连其他层。
九、可观测与排错:故障定位的最短路径
先看四类高频故障的对应动作:
| 现象 | 排查点 | 处置动作 |
|---|---|---|
PVC 永久 Pending |
provisioner 日志 | 核对 provisioner 名与凭据 |
Pod ContainerCreating |
node 插件日志 | 检查驱动 DaemonSet 是否就绪 |
| Mount 超时 | CSI 节点日志 + dmesg |
核对内核模块与网络可达 |
| 读写变慢 | csi_metrics + 文件系统指标 |
定位元数据热点或缓存失效 |
下面这段命令用于快速拉齐 CSI 全链路状态,适配任意 Kubernetes 集群:
bash
# 查看 CSI 组件健康与事件,一次定位卡在哪一层
kubectl -n kube-system get pods -l app=csi-driver -o wide
kubectl get events -A --field-selector reason=ProvisioningFailed
kubectl -n kube-system logs -l app=external-provisioner --tail=100
强信号优先 → 事件与日志分层 → 最后才翻驱动源码
核心结论: 排障顺序错了,会把 Node 侧问题查成 Controller 侧问题,白费半天。
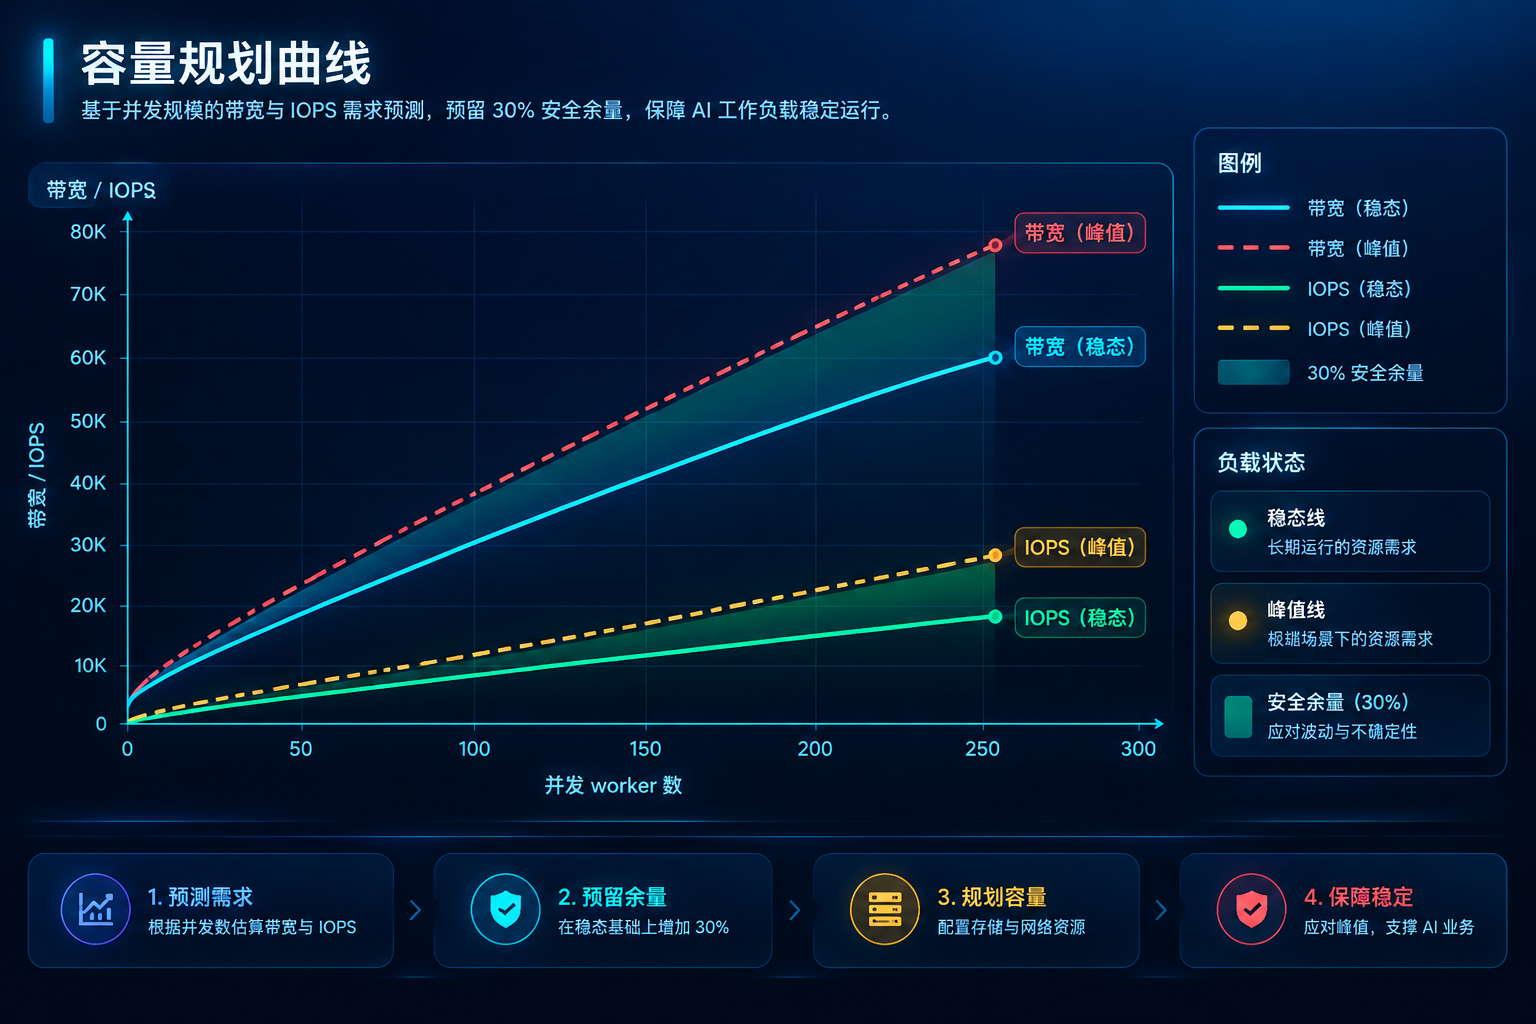
十、容量与成本:按吞吐换算倒推存储规格
规格不能拍脑袋,要从训练作业的读写需求倒推:
- 稳态读带宽 = batch size × 单样本字节 ÷ 数据加载秒数,再乘以副本数。
- 峰值写带宽 = checkpoint 大小 ÷ 允许的保存窗口,窗口 30 秒就要求 3 倍余量。
- IOPS 预算 = 同时运行的 DataLoader worker 数 × 每 worker 并发请求数。
下面的脚本按上述公式给出存储规格建议,适配 bash 5.x:
bash
#!/usr/bin/env bash
# 输入样本大小与并发 worker,输出所需带宽与 IOPS 量级
read -p "单样本字节(默认262144): " sz; sz=${sz:-262144}
read -p "并发 worker(默认64): " w; w=${w:-64}
read -p "epoch 时间(默认1800s): " t; t=${t:-1800}
awk -v s=$sz -v w=$w -v t=$t 'BEGIN{
  printf "稳态读带宽约 %.1f MB/s\n", s*1.1*w/t*1024/1048576*60;
  printf "IOPS 建议不低于 %d\n", w*40;
}'
核心结论: 留 30% 余量应对启动突发与 checkpoint 叠加峰值。
结语
CSI 的演进把存储从「厂商私有插件」推成了「标准接口 + 可插拔 sidecar」,这意味着瓶颈已经不在接入层,而在参数调优与架构分层。面向 AI 工作负载,真正的分水岭是能不能按读写特征拆出训练、推理、数据湖三个平面,并用数据编排把预热、同步、回写串成闭环。
落地时建议按「先定位元数据瓶颈 → 再选文件系统 → 后接编排与观测」的顺序推进,每一步都能独立验证,出问题也容易回退。
存储架构的价值不在于堆性能,而在于让算力永远不为等数据而空转。