💡 一句话总结:蚂蚁广见团队的 PolyOCR 想让 OCR 模型不只是「把字抄下来」,而是识别、定位、解析、抽取、理解、推理一把抓:6000 万实例按六大能力维度组织训练,后训练用 CGPO------先量出「教师在这个样本上到底比学生强多少、强得是否稳定」,再决定蒸馏开多重。OCRBench v2.1 英文榜 80.42 拿下第一,内部 KIE 甚至压过 GPT-5.6-Sol,还顺手把 OCRBench v2 的标注修了一遍。
导语:OCR 的尽头是「以文本为中心的视觉智能」
做 OCR 的朋友应该有感觉:这两年榜单刷得飞起,但刷榜的模型大多是「偏科生」------解析模型(MinerU、PaddleOCR-VL 这类)把 PDF 还原得炉火纯青,可你让它数一数图里有几个文字实例、或者对着图表做步推理,它就露怯;通用 VLM(Qwen3-VL、Gemini 这些)什么都懂一点,但细粒度认字、空间定位、密集文档抽取又不如专科生。
蚂蚁这篇报告给这个局面一个相当有野心的回应:PolyOCR------不是一个模型,而是一个家族(2B/9B 通用版 + 2.7B 多语言专精版),目标把 OCR 从「纯文本转写」扩成「文本中心的视觉智能」:识别、定位、文档解析、信息抽取、视觉文本理解、OCR 推理六大能力,全部塞进一个统一的指令跟随生成框架。想知道细节?资源在这:
想自己动手试?
- 📄 论文:arXiv 2609.37712
这篇论文到底想解决什么问题?
统一 OCR 基础模型有两个拦路虎,一个在数据,一个在训练。
数据侧:现有 OCR 数据集几乎都是按单一任务、单一领域、单一语言建的,拼起来覆盖碎片化、配比失衡------空间锚定的双语翻译、模板化 KIE、中文文档表格解析、场景文本定位、OCR 推理这些能力,要么没数据,要么标注贵到离谱。
训练侧更有意思:不同任务的学习难度、输出结构、优化目标天差地别------识别要逐字精确,定位要空间落点,抽取要格式严格,推理要语义理解。多任务混训时强势任务会淹没弱势任务,正迁移和任务干扰还会同时存在。更微妙的是 RL 阶段的一个死角,论文举了个特别生动的例子:
一张 1000 字符的金融单据,模型把金额 18,650 抄成了 18,850------就错这一个字符。8 个 rollout 的编辑相似度奖励全都是 0.999,一模一样。GRPO 的组内相对优势全是零:这个组对「纠正这个数字」贡献的梯度是零。
数字错了,奖励却看不出错------这叫等价奖励退化 。转写任务里错一个字可能就是业务上的致命错,但 page 级奖励对它钝感。解药是有的:在线蒸馏(OPD) ------让老师站在学生自己生成的路径上逐 token 给监督,「到这一位该是 6 不是 8」,信息密度完全不同。但直接加蒸馏又引入新问题:老师也可能 favor 1850 那个错误数字;更麻烦的是,等学生后来自己改对了、老师还在犯糊涂时,固定权重的蒸馏会拖着学生不让进步。
怎么让老师的监督「在该在的时候、以该有的力度」出现?这就是 CGPO 要回答的。
它的思路是什么?
📚 第一步:6000 万实例的「能力账本」
数据引擎两手抓:一手全谱收集(公开数据集 + 内部资源,按六大能力维度归账),一手定向补缺------对稀缺能力做可控合成和模型辅助标注:规则式计数合成直接继承已验证标注的精确答案(不引入模型标签噪声);复杂推理数据用 DeepSeek-V4-Pro 基于已验证的 OCR 标注生成问答与思维链,再过任务一致性校验。所有管线共享三重质控:多模型一致性验证(分歧送人工)、结构感知验证(坐标/HTML/表格与渲染图对得上)、源头验证(翻译和推理链不得脱离源证据)。
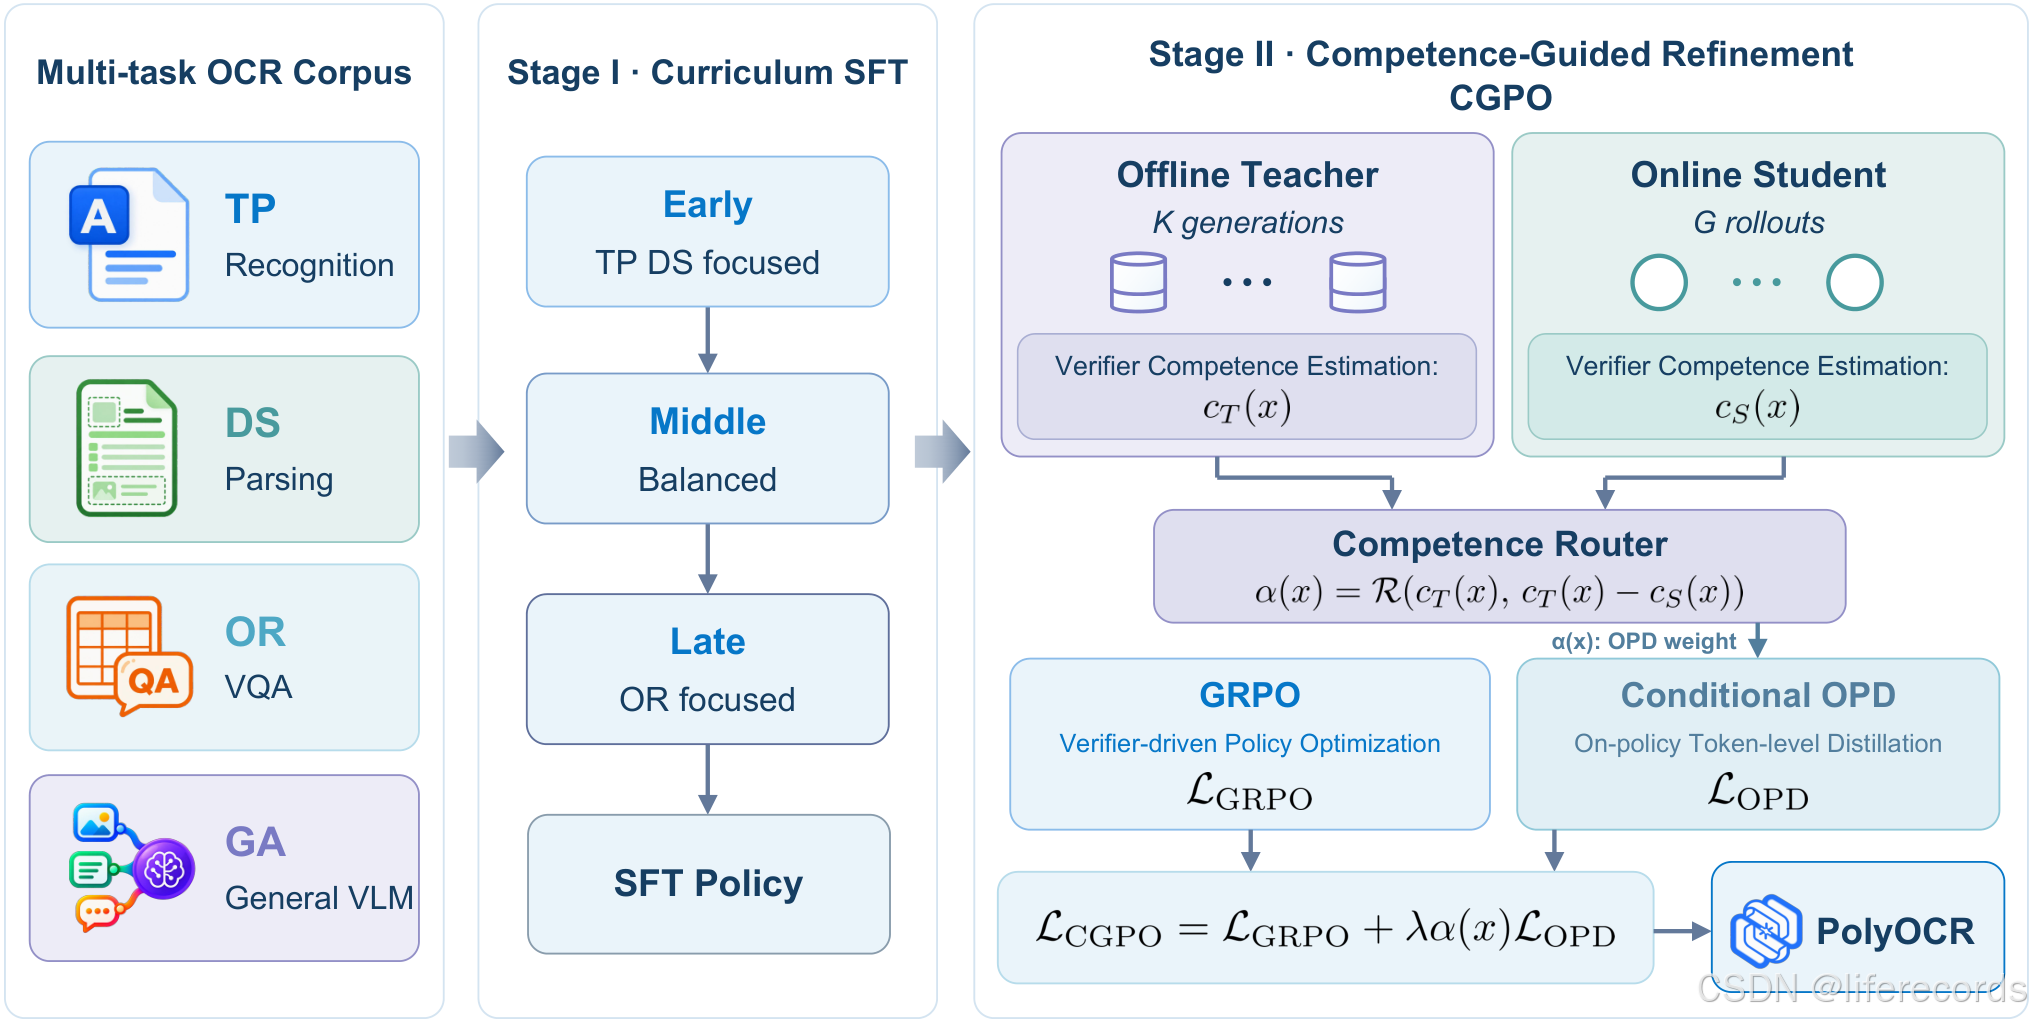
6000 万 SFT 实例按四组配比:文本感知 32.5%、文档结构 30%、OCR 理解推理 22.5%、通用多模态 15%,再按三相课程推进------推理类占比从早期 10% 一路加到后期 35%,先练认字,再练动脑。
🎯 第二步:CGPO------给蒸馏装一个「能力路由器」
训练分两阶段:SFT 打底之后,进入 CGPO(Competence-Guided Policy Optimization)。它的骨架是 GRPO(一直在线),叠加一个样本级路由的在线蒸馏,路由逻辑分三步:
- 量出双方能力:教师在每个样本上离线采样 8 次、按任务验证器打分取均值,得到教师能力分 c_T(x),训练前算好缓存(验证器按任务映射:文本用编辑相似度、定位用 IoU、公式用 CDM、表格用 TEDS、KIE 用字段 F1、开放问答用 LLM 裁判);学生能力分 c_S(x) 用训练中的 8 个 rollout 在线估计。两者相减就是能力差 Δ(x)。
- 校准,别裸用估计值:8 次采样的均值毕竟有噪声,直接比大小不可靠。作者在校准集上用 A/B 独立划分拟合两个单调映射:一个从 c_T 预测「教师的真实质量」,一个从 Δ 预测「教师稳定赢过学生的概率」(平局算半分)。这一步纯离线推理,不训练任何东西。
- 按路由系数开蒸馏 :α(x) = 教师质量 × max(2×胜率 − 1, 0)。读一下这个式子的脾气:胜率不到一半,蒸馏直接归零;教师只是「矮子里拔将军」赢过更差的学生(质量分低),权重也会被压住。最终损失 = GRPO + λ·α(x)·OPD。
训练动态验证了设计意图:路由系数的平滑值随训练一路下降,后期归零的决策越来越频繁------教师自己逐渐「下岗」,把优化权交还给验证器。这就是标题里「competence-guided」的含义:蒸馏权重跟着师生能力边界走,而不是跟着训练步数走。
🧭 第三步:顺手把考场修了------OCRBench v2.1
作者还审计了 OCRBench v2:部分参考标注有噪声、部分任务的计分方式与任务语义错位(公式、文档解析、翻译、推理这几类尤甚)。v2.1 做了人工核验的标注修正 + 按任务对齐的计分调整,任务覆盖不变------但要记住:旧 v2 的分数和新 v2.1 不可直接对比。
效果到底怎么样?
主战报(PolyOCR-9B):
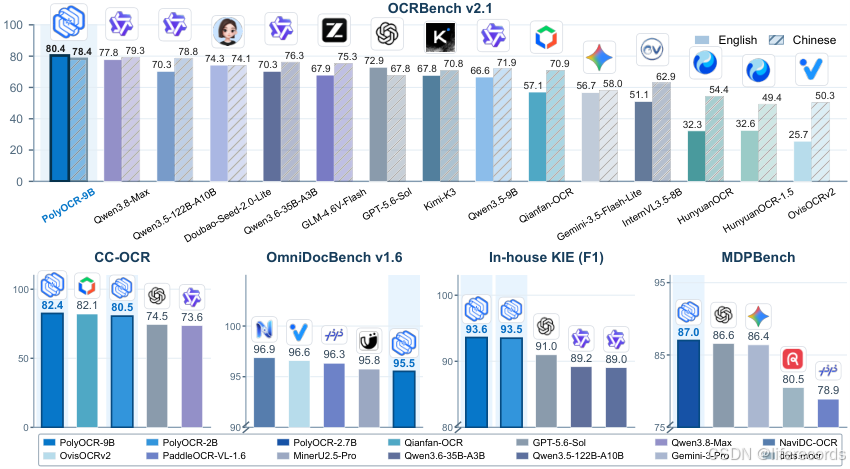
- OCRBench v2.1:英文 80.42 / 中文 78.37 ,英文全场第一,压过 GPT-5.6-Sol(72.92)和 Qwen3.8-Max(77.75);HunyuanOCR-1.5 这种专用模型在 v2.1 上只有 32.63------旧 OCR 专精模型在「理解+推理」维度被拉开得很难看。2B 版拿到 72.33,已经摸到 GPT-5.6-Sol 的门槛。
- CC-OCR:82.43 全场第一,其中文档解析 71.71、KIE 94.02 两个单项都是第一。
- 内部 KIE 基准(学信网证明/身份证/录取通知书/护照):Overall 93.60%,超过 GPT-5.6-Sol 的 90.98%------2B 版 93.49% 也几乎打平。
- MDPBench 多语言:2.7B 专精版 Overall 87.0%,超 GPT-5.6-Sol 0.4 个点、Gemini-3-Pro 0.6 个点,17 个语言组里 6 个第一、12 个前二。
- OmniDocBench v1.6(文档解析):整页直推 91.57;外挂 PP-DocLayoutV3 版面检测后 95.52(公式 CDM 91.71→96.30)------但这个数字仍低于 OvisOCR2(96.58)、TeleOCR(96.87)这些解析专精模型。
CGPO 本身的消融很能说明问题(同 SFT 起点,CC-OCR 分数):SFT 79.46 → 加 GRPO 81.72 → 加固定权重 OPD 82.18 → 换余弦衰减 82.32(但 OmniDocBench 反而掉到 90.12)→ CGPO 82.43,且三榜全面最高。按样本路由,赢过按步数调度。
能拿来做什么?
- 证件/票据结构化场景:KIE 93.60% 的成绩单(学信网、身份证、录取通知、护照)对国内证件类业务几乎是量身定做的参考。
- 多语言文档管线:2.7B 专精版 21 个语言/文字组的成绩,对出海业务的文档解析是个现成的选型参考。
- RL+蒸馏联训的调度范式:CGPO 的「验证器打分估能力 → 离线校准 → 样本级路由」三段式,和最近同期的 GAD-RL(按组奖励门控+衰减)思路同源但路由粒度更细------正在做后训练的团队可以直接把这两篇对着抄作业。
泼冷水时间
- 自修订的榜自己第一:OCRBench v2.1 的标注修正与计分调整都是本文做的,动机(噪声、计分错位)说得通,但「在自己修订的考场拿第一」这个循环需要第三方复核来闭环,目前没有。
- 文档解析深水区仍是专精模型的天下:OmniDocBench 整页直推 91.57、pipeline 95.52,距解析专精的第一梯队还有约 1 个点的差距------「六边形」意味着没有一条边是最长的。
- 内部基准占比高:KIE 是 in-house 四类证件,MDPBench 部分对照模型未评测(表中「--」),横向比较的完备度有限。
- CGPO 的隐性成本:教师要在全部训练样本上离线采样 8 次 + 构建校准集,教师还是 122B 级模型------省下的蒸馏浪费,换成的是前期的推理账单。
- 报告未附代码/权重发布链接,想复现只能等。
理性看待
PolyOCR-Venus 值得记住的有两件事。一是它把「OCR 基础模型」的能力边界从「转写 + 解析」正式扩到了「理解 + 推理」,并用六大维度的数据账本证明了这条路在 2B-9B 规模上走得通------OCRBench v2.1 上通用大模型和 OCR 专精模型的分数断层,被这个统一配方填平了大半。二是 CGPO 的路由思想:教师监督的价值不是常数,它取决于「教师此时此地是否真的比学生强、赢得是否稳定」------把这个判断做成校准过的概率再开蒸馏,比拍一个衰减曲线优雅得多。
统一的代价依然存在:最深的解析榜上它还不是第一。但方向已经清楚了------OCR 的竞争正在从「谁抄得准」转向「谁看得懂」,这一篇是很好的注脚。
(数据与结论均来自论文原文,解读部分为作者观点,欢迎交流。)