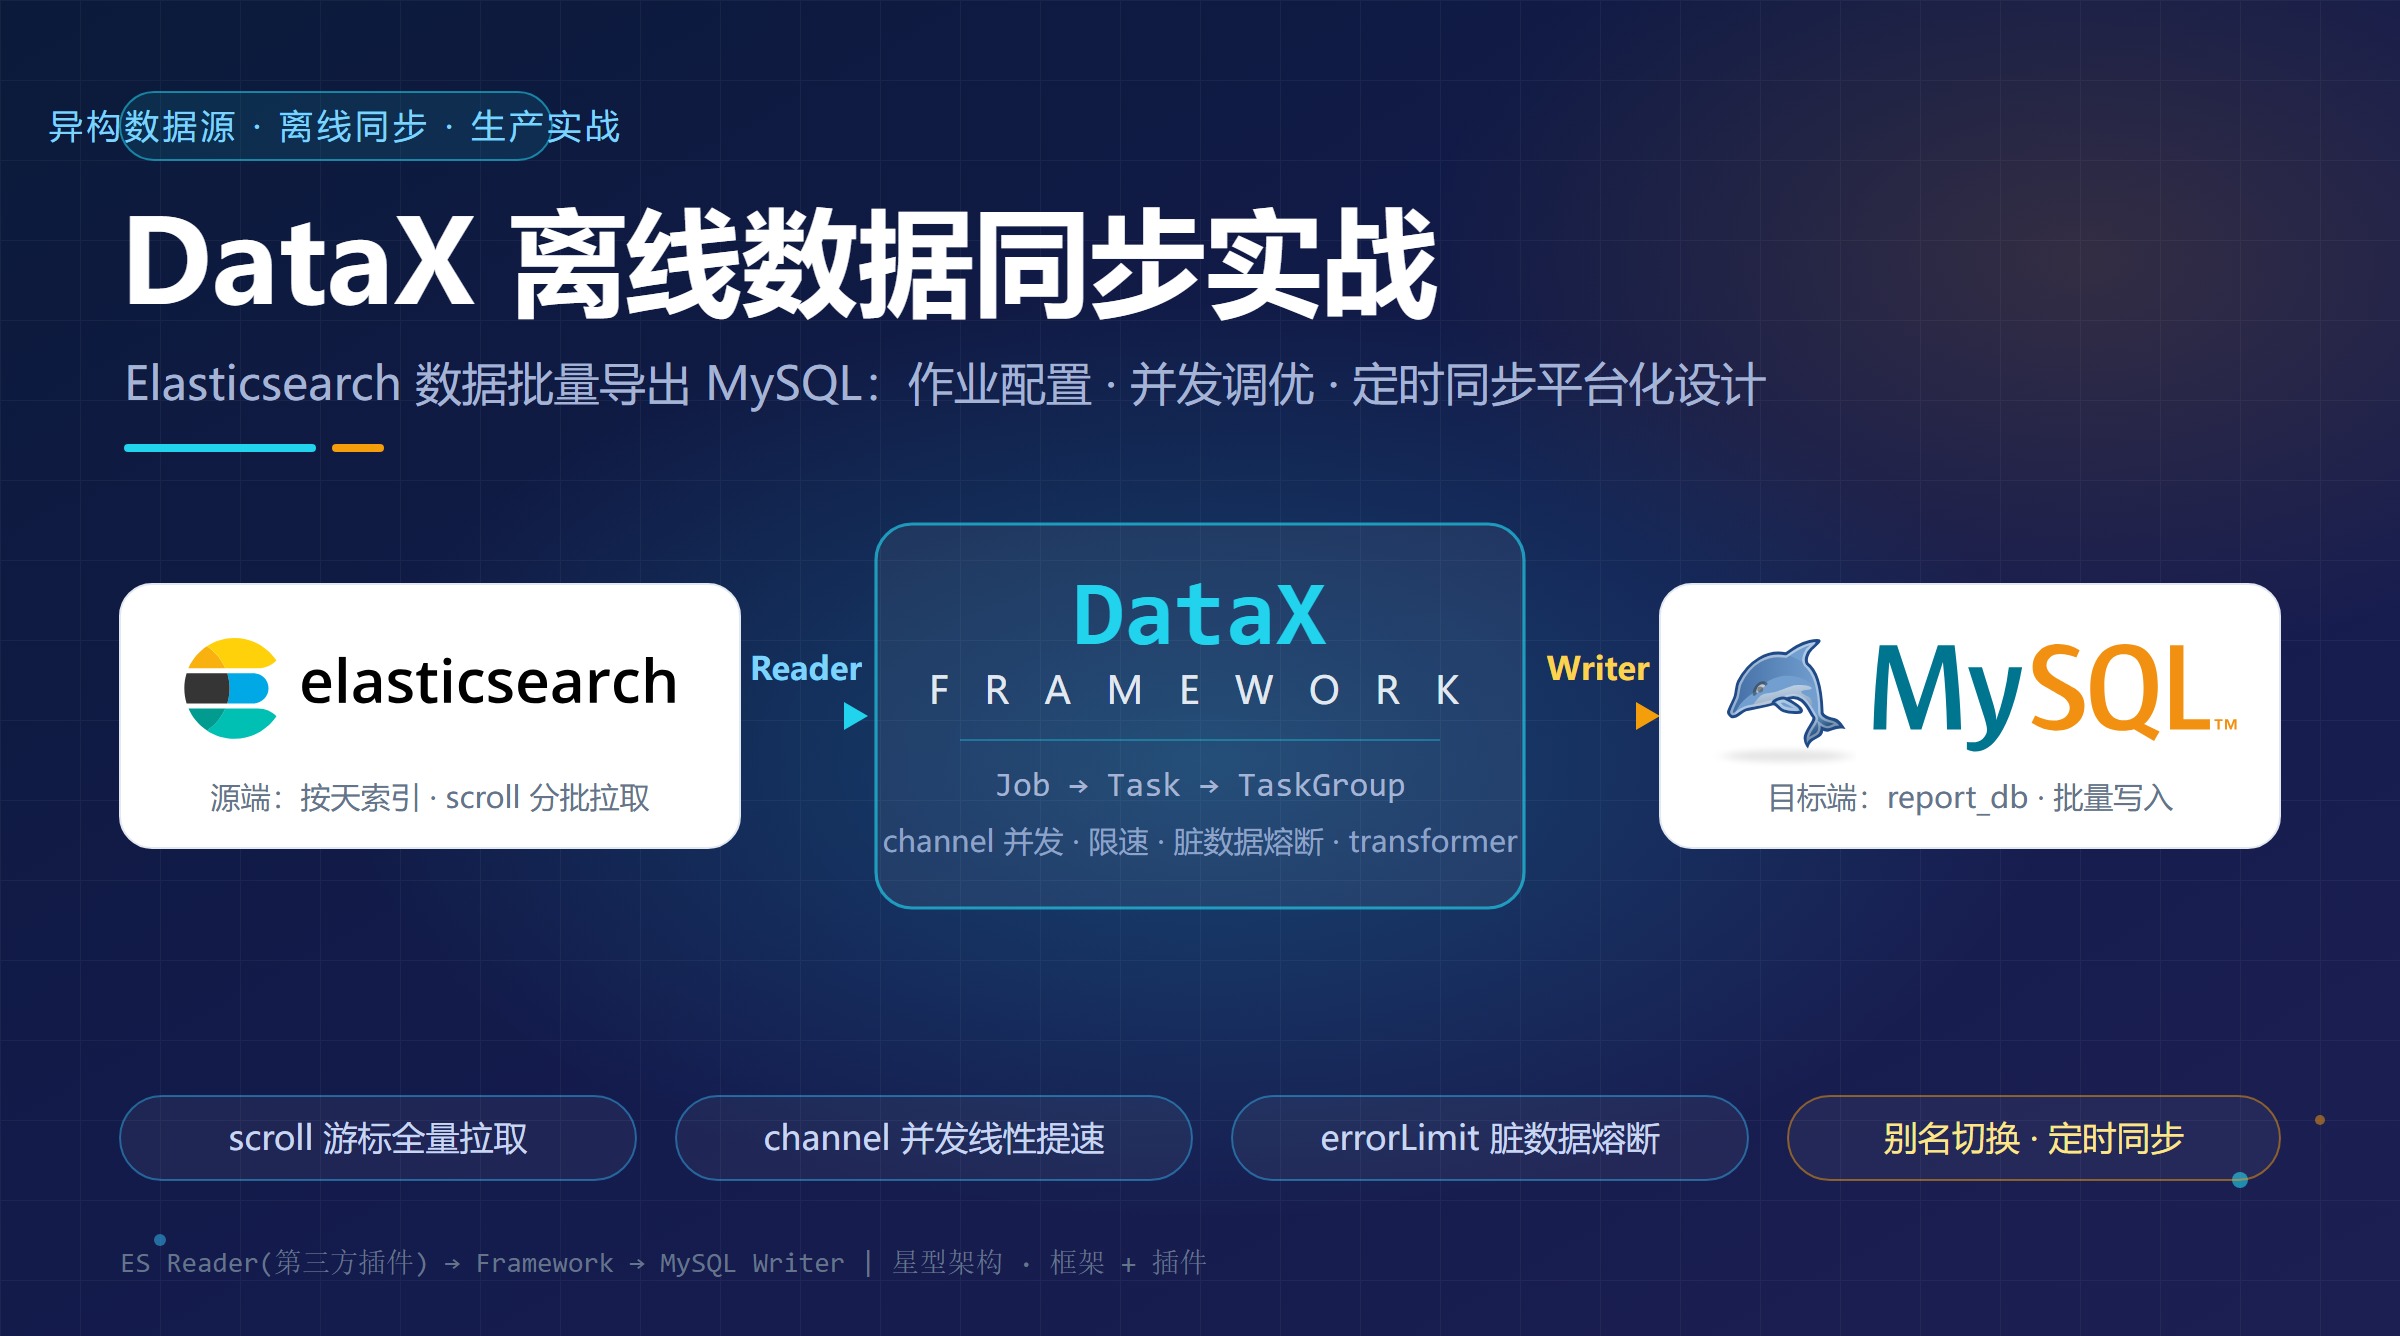
前言:实时 CDC 之外,另一半的同步需求是"离线"的
我之前写过一篇《Flink CDC 实战:MySQL 数据实时同步到 ClickHouse》,讲的是 binlog 级别的实时 同步。但同步需求里还有另外一半:离线批量搬运------每天凌晨把昨天的数据归档到关系库做报表、按需补取历史数据、或者做一次性的存量迁移。这类场景不追求秒级延迟,拼的是吞吐量、运行稳定和可运维性。
我们平台的真实需求就很典型:监控指标数据按天落在 Elasticsearch 里(ES 侧的索引规划可以看我这篇《Elasticsearch 日增 30TB 日志架构实战》),而业务侧的报表和二次加工在 MySQL 上。每天要把前一天的指标数据整批搬到 MySQL,偶尔还要一次性补取前 N 天。最后选型落地用了阿里开源的 DataX。
这篇文章把整个过程整理出来:DataX 的架构与调度模型、一份生产上真实使用的 ES→MySQL 作业配置、并发与限速调优,以及最关键的一步------把一次性的命令行作业包装成"定时同步任务"的平台化设计。文中所有 IP、账号、索引名、表名均已脱敏替换。
一、为什么选 DataX:星型架构 + 框架插件化
DataX 是阿里开源的异构数据源离线同步工具。它和 Flume、Logstash 这类实时采集管道的定位不同:不做实时增量采集,专注把一批数据从 A 源整批搬到 B 源,支持关系型数据库(MySQL、Oracle)、HDFS、Hive、HBase、Elasticsearch、FTP 等主流数据源之间的互相同步。
它解决的核心痛点是链路爆炸 。传统点对点同步,N 种数据源两两互备就是一张网:每条链路都要单独开发一套读取和写入逻辑,单独维护。DataX 把网状结构换成星型结构:每种数据源只需要实现一次"接入框架"的适配,任意两端组合成一个同步作业。
实现上采用框架 + 插件的设计:
   Elasticsearch(源)                      MySQL(目标)
  ┌────────────────────┐                 ┌──────────────────┐
  │  metric_host-      │   Reader 插件    │    Writer 插件     │
  │  20250906          │───────┐  ┌──────│  mysqlwriter      │
  └────────────────────┘       ▼  ▼      └──────────────────┘
                        ┌───────────────────┐
                        │    Framework      │
                        │  数据传输通道/缓冲   │
                        │  并发/转换/限速/重试 │
└───────────────────┘- Reader 插件:负责从源端采集数据,把数据发送给 Framework;
- Writer 插件:不断从 Framework 取数据,批量写入目的端;
- Framework:连接 Reader 和 Writer 的传输通道,统一处理缓冲、并发、数据转换、限速、重试这些所有作业共性的技术问题。
这个分层带来的直接好处:接入一种新数据源 = 只写一个新插件,核心框架不动;而限速、脏数据控制、并发调度这些能力,所有插件组合天然共享,配一次就懂全部。
二、5 分钟上手:安装与作业配置骨架
环境要求只有两项:JDK 1.8+ 和 Python 2/3(启动器用)。安装就是解压:
bash
tar -zxf datax.tar.gz -C /opt/moduleDataX 的作业是一个 JSON 文件,结构就三层------job 包着 content(读什么写什么)和 setting(怎么跑):
json
{
  "job": {
    "content": [
      {
        "reader": {},
        "writer": {}
      }
    ],
    "setting": {
      "speed": {
        "channel": 1,
        "byte": 1024
      },
      "errorLimit": {
        "record": 10,
        "percentage": 0.05
      }
    }
  }
}content是作业核心,放 Reader 和 Writer 插件配置(content可以是多组,一组就是一个读写对);speed.channel是并发通道数,byte/record可选,做总量限速;errorLimit是脏数据熔断:脏数据超过 10 条、或占比达到 0.05%,作业直接报错退出。
把这份骨架记住,后面所有复杂作业都是往这个壳里填肉。
三、实战:把 ES 指标数据整批导出到 MySQL
3.1 场景与插件准备
源端是按天生成的索引 metric_host-20250906,每条文档六个字段:主机 ID、采集任务 ID、指标名、时间、指标值、所属组件。目标是 MySQL 库 report_db 里的报表表。
有个前置坑要先说:DataX 官方插件列表里没有 Elasticsearch Reader (官方带了 ES writer,读插件没有)。社区有成熟的开源实现,把项目 clone 下来 mvn package,产物目录放到 datax/plugin/reader/ 下即可被框架识别。插件机制这里就体现出价值了------没有官方插件,自己补一个,框架能力照用。
3.2 完整作业配置
json
{
  "job": {
    "content": [
      {
        "reader": {
          "name": "elasticsearchreader",
          "parameter": {
            "endpoint": "http://192.168.10.21:9200",
            "accessId": "elastic",
            "accessKey": "<你的密码>",
            "index": "metric_host-20250906",
            "type": "_doc",
            "searchType": "dfs_query_then_fetch",
            "headers": {},
            "scroll": "3m",
            "search": [
              {
                "query": { "match_all": {} },
                "size": 10000
              }
            ],
            "table": {
              "column": [
                { "name": "host_id",     "alias": "HOST_ID" },
                { "name": "task_id",     "alias": "TASK_ID" },
                { "name": "metric_name", "alias": "METRIC_NAME" },
                { "name": "event_time",  "alias": "EVENT_TIME" },
                { "name": "value" },
                { "name": "component" }
              ]
            }
          }
        },
        "writer": {
          "name": "mysqlwriter",
          "parameter": {
            "column": ["HOST_ID", "TASK_ID", "METRIC_NAME", "EVENT_TIME", "VALUE", "COMPONENT"],
            "connection": [
              {
                "jdbcUrl": "jdbc:mysql://192.168.10.22:3306/report_db?useUnicode=true&characterEncoding=UTF-8&serverTimezone=Asia/Shanghai",
                "table": ["perf_metric_data"]
              }
            ],
            "username": "root",
            "password": "<你的密码>",
            "writeMode": "insert",
            "batchSize": 10000
          }
        }
      }
    ],
    "setting": {
      "speed": { "channel": 5 },
      "errorLimit": { "record": 0, "percentage": 0.01 }
    }
  }
}
几个关键参数值得展开:
scroll: "3m":ES 游标上下文的存活时间。DataX 分批拉取全量数据靠的是 scroll 快照,如果单批处理慢(Writer 写入抖动),快照过期会直接失败,导出大索引时适当调大;search.size: 10000:每批拉取的文档数,配合 scroll 翻页;column的name/alias:ES 字段名到 MySQL 列名的映射就配在 Reader 侧,Writer 只认 alias 后的列名。不写alias的字段(如value、component)按原名透传------字段映射不写一行代码,全靠这段配置;writeMode:insert是纯追加,replace/update会走REPLACE INTO/ON DUPLICATE KEY UPDATE,幂等重跑时选后两者(后面第七节会用到);batchSize:Writer 每批提交的行数,10000 是吞吐和事务大小的平衡点。
3.3 目标表
sql
CREATE TABLE IF NOT EXISTS perf_metric_data (
  HOST_ID     VARCHAR(64)  NOT NULL COMMENT '主机ID',
  TASK_ID     VARCHAR(64)  DEFAULT NULL COMMENT '采集任务ID',
  METRIC_NAME VARCHAR(128) DEFAULT NULL COMMENT '指标名',
  EVENT_TIME  DATETIME     DEFAULT NULL COMMENT '指标时间',
  VALUE       DOUBLE       DEFAULT NULL COMMENT '指标值',
  COMPONENT   VARCHAR(64)  DEFAULT NULL COMMENT '所属组件',
  PRIMARY KEY (HOST_ID, EVENT_TIME, METRIC_NAME)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='性能指标数据(从ES按天同步)';主键的选择有意为之:(HOST_ID, EVENT_TIME, METRIC_NAME) 唯一定位一条指标记录,这样 writeMode 切到 replace 后,同一天的数据重复跑也不会产生重复行。
3.4 执行
bash
./bin/datax.py ./job/es_to_mysql.json作业结束时 DataX 会打印一段总账(不同集群数值差异很大,看结构就行):
任务启动时刻    : 2025-09-07 00:10:12
任务结束时刻    : 2025-09-07 00:14:43
任务总计耗时    :                  271s
任务平均流量    :            3.42MB/s
记录写入速度    :          11230rec/s
读出记录总数    :             3046210
读写失败总数    :                    0
运行中的日志也远比想象中丰富:总传输速度、Reader/Writer 各自的速率、进程 CPU、JVM 内存和 GC 情况都会周期性输出,排查"到底慢在读还是写在"基本不用加任何监控。
另外记住一个对平台化很关键的细节:datax.py 执行成功返回 0,失败非 0,靠退出码就能判定作业结果。
四、核心调度模型:Job → Task → TaskGroup
单次能跑满多核,靠的是 DataX 的单机多线程调度模型,三个概念:
-
Job :一个 JSON 配置对应一个 Job,负责整作业的生命周期管理,最重要的是把作业切分成多个 Task;
-
Task:同步作业的最小单元,由 Job 根据源端切分策略拆出来(比如 mysqlreader 按主键范围切、HDFS reader 按文件切),每个 Task 负责一部分数据,互相独立,可并行;
-
TaskGroup :Scheduler 模块把切出来的 Task 重新组合成若干 TaskGroup,每个 TaskGroup 以固定并发跑完分到的 Task,默认单个任务组并发是 5------也就是
channel配置的直接体现。Job(1个作业)
├── 切分策略 ──▶ Task1 Task2 Task3 Task4 ...
│ 重新编组
▼
TaskGroup(并发 = channel 数)
这套模型的实际含义:只要源端和目的端性能给足,作业速度基本随 channel 并发数线性增长,官方的定位是单作业可以打满网卡。这也是它敢说"性能强悍"的底气------并发扩展不是靠多机,而是单进程内多线程。
五、调优三板斧:并发、限速、脏数据
5.1 并发与限速:三层速度控制
json
"speed": {
  "channel": 5,
  "byte": 1048576,
  "record": 10000
}channel:全局并发通道数,最直接的提速旋钮;record/byte:全局记录数/字节限速,保护源端或目的端不被打挂时用。
还有一个更细的粒度在 conf/core.json 里:core.transport.channel.speed.record 和 core.transport.channel.speed.byte 控制的是单个 channel 的限速。作业级配的是"这台机器总共跑多快",core 级配的是"每个通道各自跑多快",两者是乘法关系,精细限流时两个都要看。
5.2 JVM 堆内存:大数据量导出必调
DataX 默认 JVM 堆不大,千万级记录导出时 GC 压力上来,速度会肉眼可见地掉,甚至直接 OOM。加大堆一条命令:
bash
python datax/bin/datax.py --jvm="-Xms4G -Xmx4G" ./job/es_to_mysql.json经验值:导出千万行级别起步 -Xmx4G,同时把 Xms 设成一样大,避免运行期堆扩张抖动。(JVM 参数怎么跟着数据量走,可以参考我这篇《大数据平台容量规划实战》的估算思路。)
5.3 脏数据熔断
json
"errorLimit": { "record": 10, "percentage": 0.05 }含义:脏数据(类型转换失败、约束冲突等写不进去的行)累计超过 10 条、或占比超过 0.05%,作业报错终止。注意熔断阈值是"或"的关系,先触发的先生效。归档类作业建议 record: 0 零容忍,及时发现数据质量问题。
5.4 transformer:同步过程中顺手做转换
很多时候源字段不能直接落库------手机号要脱敏、编码要截取、要统一摘要。DataX 内置 transformer 机制,在 Reader 和 Writer 之间做行级转换,不用提前在源端加工:
json
"transformer": [
  {
    "name": "dx_substr",
    "parameter": { "columnIndex": 5, "paras": ["1", "3"] }
  },
  {
    "name": "dx_replace",
    "parameter": { "columnIndex": 4, "paras": ["3", "4", "****"] }
  },
  {
    "name": "dx_digest",
    "parameter": { "columnIndex": 3, "paras": ["md5", "toLowerCase"] }
  },
  {
    "name": "dx_groovy",
    "parameter": {
      "code": "// 自定义 groovy 逻辑",
      "extraPackage": ["import somePackage1;"]
    }
  }
]
dx_substr 截取、dx_replace 替换、dx_digest 摘要(md5/sha1)、dx_groovy 兜底写任意 Groovy 逻辑,columnIndex 按列的序号(从 0 起)定位。字段映射 + transformer 组合,常规的清洗需求基本不用写程序。
六、从一次性作业到平台化:定时同步功能设计
到这里,手工执行一次导出已经没问题了。但真实需求是两条线:
- 每天定时同步前一天的索引数据;
- 一次性补取前 N 天的历史数据(天数不固定)。
直接用命令行跑,有四个缺口:配置文件怎么到目标服务器(下发 )、谁来每天触发(调度 )、跑挂了谁知道(监控 )、重跑时数据会不会重复(幂等)。我们的做法是把 DataX 包装成数据平台里的一个"离线同步"功能,设计拆成九个模块:
| 模块 | 职责 |
|---|---|
| 数据源管理 | 维护源/目标数据源的地址、账号、密码,复用平台已有的数据源配置 |
| 模型/映射管理 | 维护字段映射关系,支持 DataX 转换函数和自定义 Groovy |
| 同步配置 | 选择源表/索引、目标表、映射模板、查询条件,组装成 DataX JSON |
| 同步工具配置 | DataX 安装目录、所在主机(执行代理 IP) |
| 作业执行 | 配置文件下发 + 调用代理接口启动作业 |
| 定时任务 | 一次性任务 / 周期任务(quartz 表达式) |
| 作业监控 | 执行状态、结果、日志(从执行代理接口拉取) |
| 重跑/补跑 | 失败或漏跑后重新执行,处理已写入数据 |
| 索引别名管理 | 每天定时把"昨天"别名指向新索引 |
其中执行代理只要求四类 HTTP 接口:登录换 token、文件下发、异步执行作业、查询执行日志------一个能远程执行命令的 agent 都能满足。
6.1 配置表与运行表
同步任务的元数据落四张表。同步配置表,一个任务一行,把上面的 JSON 里所有可变项都收进来:
sql
CREATE TABLE IF NOT EXISTS datasync_conf (
  ID                  VARCHAR(60)  NOT NULL COMMENT '主键',
  TASK_NAME           VARCHAR(60)  DEFAULT NULL COMMENT '任务名称',
  TASK_DESC           VARCHAR(1000) DEFAULT NULL COMMENT '任务描述',
  DATA_SOURCE_TYPE    VARCHAR(60)  DEFAULT NULL COMMENT '数据来源类型',
  DATA_SOURCE_ID      VARCHAR(60)  DEFAULT NULL COMMENT '数据来源ID(关联数据源管理)',
  DATA_SOURCE_TABLE   VARCHAR(60)  DEFAULT NULL COMMENT '数据来源表/索引',
  DATA_SOURCE_FILTER  TEXT         DEFAULT NULL COMMENT '数据来源过滤条件',
  DATA_TARGET_TYPE    VARCHAR(60)  DEFAULT NULL COMMENT '数据去向类型',
  DATA_TARGET_ID      VARCHAR(60)  DEFAULT NULL COMMENT '数据去向ID',
  DATA_TARGET_TABLE   VARCHAR(60)  DEFAULT NULL COMMENT '数据去向表',
  FIELD_MAPPING_ID    VARCHAR(60)  DEFAULT NULL COMMENT '字段映射ID(关联映射管理)',
  ERROR_LIMIT_RECORD  VARCHAR(20)  DEFAULT NULL COMMENT '脏数据最大条数',
  ERROR_LIMIT_PERCENT VARCHAR(20)  DEFAULT NULL COMMENT '脏数据最大比例',
  SYNC_SPEED_CONTROL  VARCHAR(1)   DEFAULT NULL COMMENT '是否限制同步速率',
  SYNC_SPEED_BYTE     VARCHAR(10)  DEFAULT NULL COMMENT '最大同步速率',
  SYNC_CHANNEL        VARCHAR(10)  DEFAULT NULL COMMENT '最大并发数',
  JOB_ID              VARCHAR(60)  DEFAULT NULL COMMENT '调度任务作业ID',
  TASK_TYPE           VARCHAR(10)  DEFAULT NULL COMMENT '任务类型 quick/quartz,立即/定时',
  TASK_CRON           VARCHAR(60)  DEFAULT NULL COMMENT '定时任务表达式',
  TASK_STATUS         VARCHAR(10)  DEFAULT 'init' COMMENT '任务状态 init/run/finish',
  START_TIME          TIMESTAMP    NULL DEFAULT NULL COMMENT '启动时间',
  PRIMARY KEY (ID)
) COMMENT='数据同步任务配置表';同步运行表,每次执行插一行实例记录:
sql
CREATE TABLE IF NOT EXISTS datasync_run (
  ID         VARCHAR(60) NOT NULL COMMENT '主键',
  JOB_ID     VARCHAR(60) DEFAULT NULL COMMENT '调度任务作业ID',
  CONF_ID    VARCHAR(60) DEFAULT NULL COMMENT '同步配置ID',
  START_TIME DATETIME    DEFAULT NULL COMMENT '开始时间',
  END_TIME   DATETIME    DEFAULT NULL COMMENT '结束时间',
  STATUS     VARCHAR(10) DEFAULT NULL COMMENT '运行状态',
  RESULT     VARCHAR(10) DEFAULT NULL COMMENT '运行结果',
  MESSAGE    TEXT        DEFAULT NULL COMMENT '运行日志',
  PRIMARY KEY (ID)
) COMMENT='数据同步作业运行实例表';再往下是两级作业执行记录,作业运行表记平台侧视角:
sql
CREATE TABLE IF NOT EXISTS job_run (
  id            VARCHAR(64)  NOT NULL COMMENT '主键',
  user_id       VARCHAR(255) NULL COMMENT '执行用户',
  task_id       VARCHAR(64)  NULL COMMENT '任务id',
  model_type    VARCHAR(64)  NULL COMMENT '模块类型',
  status        VARCHAR(255) NULL COMMENT '状态 init/run/willFinish/finish',
  success       INT          NULL COMMENT '执行成功:0:是,1:否',
  job_run_id    VARCHAR(64)  NULL COMMENT '调度平台任务运行id',
  create_time   DATETIME     NULL COMMENT '创建时间',
  start_time    DATETIME     NULL COMMENT '开始时间',
  finished_time DATETIME     NULL COMMENT '结束时间',
  out_put       LONGTEXT     NULL COMMENT '脚本输出',
  PRIMARY KEY (id)
) COMMENT='作业运行实例表';
作业日志明细表 按步骤记录执行过程,EVENT_DATE 精确到每一步的时间点,重跑排障时能还原完整时序:
sql
CREATE TABLE IF NOT EXISTS job_log_detail (
  ID             VARCHAR(64)  NOT NULL COMMENT '主键',
  JOB_RUN_ID     VARCHAR(36)  NOT NULL COMMENT '作业流水号',
  EXEC_IP        VARCHAR(60)  NOT NULL COMMENT '执行机IP',
  RESULT_SEQ_NUM INT          NOT NULL COMMENT '输出结果顺序号',
  TASK_ID        VARCHAR(36)  DEFAULT NULL COMMENT '任务id',
  MSG_TYPE       VARCHAR(2)   DEFAULT NULL COMMENT '消息类型',
  JOB_STATUS     VARCHAR(2)   DEFAULT NULL COMMENT '任务状态:0准备 1执行 2结束',
  IS_SUCCESS     VARCHAR(2)   DEFAULT NULL COMMENT '是否成功:1成功 0失败',
  LOG_LEVEL      VARCHAR(10)  DEFAULT NULL COMMENT '日志等级',
  EVENT_DATE     TIMESTAMP    DEFAULT NULL COMMENT '该步骤执行的具体时间点',
  IS_STORED      CHAR(1)      DEFAULT '0' COMMENT '保存状态:0未保存 1已保存',
  MESSAGE        LONGTEXT     DEFAULT NULL COMMENT '从消息队列取得的结果信息',
  RESULT_INFO    LONGTEXT     DEFAULT NULL COMMENT '接口返回信息',
  CONSTRAINT PK_JOB_LOG_DETAIL PRIMARY KEY (ID)
) COMMENT='作业运行日志明细表';
6.2 执行流程
一次定时同步的完整时序:
定时触发(或手动)
   ▼
扫描 datasync_conf 中 TASK_STATUS = init 的任务
   ▼
取任务详情 + 字段映射 ──▶ 组装 DataX JSON
   ▼
调执行代理接口:下发配置文件到 DataX 的 job 目录
   ▼
登录换 token ──▶ 调用"异步执行作业"接口启动
   ▼
轮询作业状态,拉取执行日志
   ▼
回写 datasync_run(状态/结果/输出)
组装 JSON 时有个小技巧:目标端是 MySQL 时,前端要给用户选表,直接查 information_schema 就能拿到当前库的表清单,不用额外维护:
sql
SELECT TABLE_NAME FROM information_schema.TABLES WHERE TABLE_SCHEMA = (SELECT database());6.3 索引别名:让任务配置"永远不用改"
按天索引的源端有个麻烦:今天叫 metric_host-20250906,明天就叫 metric_host-20250907,难道每天改一遍任务配置?
用 ES 的别名 机制绕开:给索引起一个固定别名,比如 metric_host-yesterday,每天凌晨(同步任务启动前)用一个定时小任务把别名原子地切到前一天的索引上,再删掉过期的旧别名。DataX 作业配置里永远写 metric_host-yesterday,一份配置跑每天,零修改:
json
POST /_aliases
{
  "actions": [
    { "remove": { "index": "metric_host-20250905", "alias": "metric_host-yesterday" } },
    { "add":    { "index": "metric_host-20250906", "alias": "metric_host-yesterday" } }
  ]
}
6.4 重跑与补跑
作业失败或漏跑后要重跑,两件事必须想清楚:
- 已写入的数据怎么办 :DataX 作业中断时,失败前的那部分数据已经写进目标端了,不会回滚 。所以重跑前要么把目标表当天的数据按条件删掉,要么建表时就把主键设计好、
writeMode用replace让重复行覆盖写入(3.3 节的主键就是为这个准备的); - 补取历史数据 :补跑前 N 天时索引名不是"昨天",需要临时调整作业配置里的索引名,或给任务加个"数据日期"参数。DataX 支持启动时传动态参数:
datax.py -p "-Dindex=metric_host-20250801" job.json,JSON 里用${index}占位,补跑场景直接换参数就行------但注意参数只支持简单字符串,字段映射这类复杂 JSON 结构没法通过参数传。
七、踩坑与 FAQ
- 脏数据超限报错后,已写入的数据回滚了吗? 没有。中断或失败时可能已有一部分数据进入目标端,重跑要么先删已写入数据,要么用
replace/update写入模式做幂等覆盖。 - 作业能传动态参数吗? 能传简单字符串参数(
-p "-Dxxx=yyy",配置里${xxx}引用),索引名、表名这类适合参数化;字段列表这类复杂 JSON 数组结构不支持。 - 怎么判断作业成功? 退出码:成功返回 0,失败非 0。平台化场景靠它判定,别去解析日志文本。
- 导出大索引时 scroll 过期报错 :
scroll是快照存活时间,导出慢就调大(5m、10m),同时确认 Writer 没有拖后腿(看运行日志里两端各自的速率)。 - 导出速度上不去 :先加
channel;还不够就检查是不是触发了限速配置(speed.byte/record和 core.json 的单通道限速),最后加 JVM 堆(--jvm="-Xms4G -Xmx4G"),GC 频繁时会明显拖慢。 - 时区问题 :MySQL 连接串的
serverTimezone要和数据的实际时区一致,不然时间字段会整体偏移,对账时第一件事就是抽查一条时间数据。
结语
DataX 的定位非常克制:只做离线搬运,把并发、限速、脏数据、转换这些共性能力做扎实。配合"配置表 + 执行代理 + 别名切换 + 幂等重跑"这一层薄薄的平台化封装,它就能稳定支撑每天定时的归档同步和随时补数。和实时 CDC 是一对互补的工具:要秒级一致用 Flink CDC,要批量搬运用 DataX,两者覆盖了数据同步的绝大多数场景。
你的离线同步现在用的什么方案------DataX、Sqoop,还是 SeaTunnel / DataWorks?迁移千万级数据时踩过哪些坑?欢迎在评论区交流。
相关阅读:《Flink CDC 实战:MySQL 数据实时同步到 ClickHouse》《Elasticsearch 日增 30TB 日志架构实战》《大数据平台容量规划实战》