02|Agent 架构全景图
Agent 工程实战系列 · 设计篇 ·
一、问题场景:50 行代码跑通之后,需求接踵而至
01 篇的最小 Agent 跑起来了。紧接着,需求一个接一个提出来:
- "能不能记住用户上次说过什么?"
- "它别乱退款,超过 200 元必须人工确认。"
- "我怎么知道这周的版本比上周更好,还是更差?"
- "昨天有个回复错了,能不能查到它当时是怎么想的?"
多数团队的做法是一个问题补一个补丁。三个月后,agent.py 膨胀到三千行:提示词、重试、日志、权限判断、记忆读写全缠在同一个循环里。症状很典型:改一处坏三处,没人能说清"这段逻辑应该放哪",出了问题不知道该找谁。
解决办法不是更小心地写,而是先有一张架构地图:把 Agent 拆成职责清晰的模块,每个模块知道自己管什么、不管什么。这就是本篇要画的全景图,后面 26 篇都会在这张图上找到自己的位置。
二、核心概念:八大模块一张图
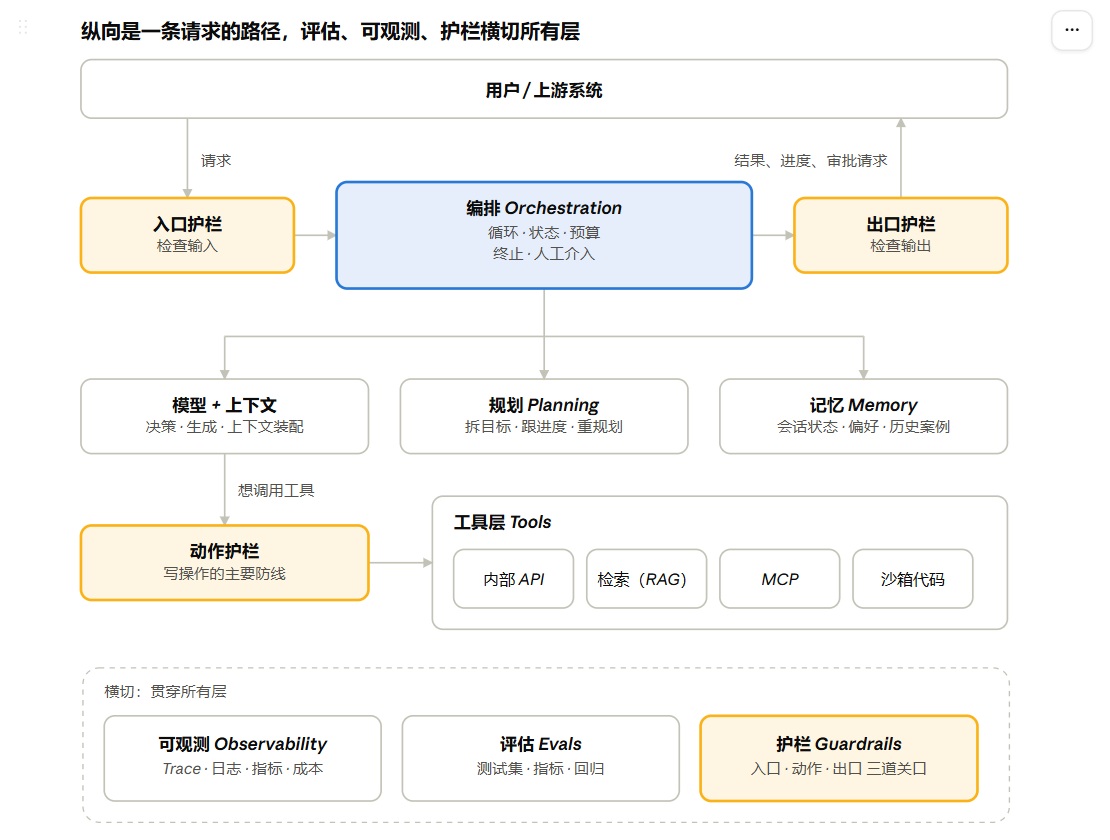
2.1 参考架构图
这张图的重要三点:
- 纵向是一条请求的路径:从用户进来,经编排驱动,由模型决策,通过工具落地,再回到用户。
- 护栏有三道关口:入口(输入)、动作(工具调用前)、出口(输出)。写操作的风险主要靠中间这一道。
- 评估、可观测、护栏是横切的:它们不属于某一层,而是要在每一层留出接入点。后补成本最高。
2.2 用公司来类比
| 模块 | 公司里的对应物 |
|---|---|
| 模型 + 上下文 | 员工的大脑,加上他此刻手边的资料 |
| 工具 | 业务系统和对应的操作权限 |
| 记忆 | 笔记本和档案柜 |
| 规划 | 项目计划表 |
| 编排 | 项目经理和流程制度 |
| 护栏 | 合规与内控 |
| 评估 | 绩效考核 |
| 可观测 | 监控录像和工单系统 |
2.3 输出 ①:模块职责与边界表
"边界"一列比"职责"更重要,大多数架构问题都出在模块越界。
| 模块 | 核心职责 | 边界:不归它管 |
|---|---|---|
| 模型 + 上下文 | 理解意图,决定下一步(调用哪个工具或直接回答),生成内容;装配提示词、历史、检索结果 | 不负责执行动作,不保存长期状态,不承担权限判断 |
| 工具 | 把外部能力封装成可调用、可校验、可审计的动作 | 不做业务决策;不信任模型传来的参数,一律校验 |
| 记忆 | 跨轮、跨会话保存和取回信息(会话状态、用户偏好、历史案例) | 不决定"做什么";不能无限堆进上下文 |
| 规划 | 把目标拆成步骤,跟踪进度,偏离时重规划 | 不执行动作;简单任务可以没有它 |
| 编排 | 驱动循环与流程:状态流转、预算、超时、终止、重试、人工介入点 | 不理解语义,不写业务提示词 |
| 护栏 | 在输入、动作、输出三个关口拦截、改写或升级 | 不替代最小权限,不是唯一防线 |
| 评估 | 用测试集和指标判断"好不好、改没改坏" | 不在线上主流程里阻塞请求;不等于线上监控 |
| 可观测 | 记录每次运行的过程:Trace、日志、指标、成本 | 只记录不判断,也不能影响主流程运行 |
2.4 这些模块在 SupportPilot 里长什么样
| 模块 | SupportPilot 中的落地 | 详见 |
|---|---|---|
| 模型 + 上下文 | 客服角色提示词;订单与政策片段按需装配 | 05、12 |
| 工具 | get_order、get_logistics、create_reship(需审批) |
06、13、14 |
| 记忆 | 本次工单状态;用户历史工单摘要 | 07、16 |
| 规划 | 包裹丢失:查订单 → 查物流 → 判定异常 → 给出建议 | 08、15 |
| 编排 | 步数与时间上限、审批中断、checkpoint | 08、11、15 |
| 护栏 | 订单号格式校验;补发和退款需确认;输出脱敏 | 23、24、26 |
| 评估 | 100 条历史工单做回归测试 | 18 |
| 可观测 | 每次工单一条 Trace;成本与延迟看板 | 19 |
2.5 其他篇目在图中的位置
- RAG(09、16):既是工具层里的一个"检索工具",也是记忆里的知识库。
- MCP(14):工具层接入外部能力的协议。
- 多 Agent(10、17):在编排之上再加一层编排,相当于把整张图复制多份,由编排者调度。
- 人机协同(11):编排里的中断点,加上出口处的交互设计。
- 安全(22--27):横切的护栏、权限与审计,贯穿所有层。
- 性能与成本(20) 、部署(21):前者跨模块优化,后者是整张图外面的运行环境。
三、一次请求如何流过这些模块
用户说:"我的包裹好像丢了,订单 A1001。"
| 步 | 发生了什么 | 涉及模块 |
|---|---|---|
| 1 | 检查输入长度,识别订单号格式,过滤明显恶意内容 | 入口护栏 |
| 2 | 创建本次运行,设置预算(最多 8 步、60 秒),加载状态 | 编排 |
| 3 | 取出该用户最近的工单摘要 | 记忆 |
| 4 | 装配提示词 + 摘要 + 用户消息,模型决定先调用 get_order |
模型 + 上下文 |
| 5 | 校验参数;只读工具直接放行并执行 | 动作护栏、工具 |
| 6 | 结果回到上下文,模型决定再查物流,进入下一轮循环 | 编排、模型、工具 |
| 7 | 发现物流停滞超过 5 天,判定异常,更新子目标进度 | 规划 |
| 8 | 需要补发,属于写操作,触发人工审批中断,保存 checkpoint | 动作护栏、编排 |
| 9 | 审批通过后执行补发,输出脱敏,回复用户 | 工具、出口护栏 |
全程,可观测记录每一步的 Trace;评估则在上线前,用历史工单回放这条链路,验证没有改坏。
注意第 8 步:模型提出的是"建议补发",决定能不能执行的,是动作护栏和人工审批,不是模型自己。 这是后面所有安全设计的基础。
四、设计取舍
4.1 三条分层原则
- 决策与执行分离。 模型负责提议,代码负责校验与执行。模型的输出是"建议",不是"命令"。
- 控制流归编排,语义归模型。 预算、终止、审批这些必须保证的事,写在代码里,不要写在提示词里指望模型自觉。
- 横切关注点独立。 护栏、可观测、评估做成可插拔的拦截点,不要散落在业务代码里。
4.2 模块按复杂度逐级实现
八个模块不是一开始就要全上。按风险和复杂度分档:
| 档位 | 典型场景 | 需要的模块 |
|---|---|---|
| L1 原型 | 内部小工具、01 篇的 50 行 | 模型、工具、最简编排、日志 |
| L2 面向用户的单 Agent | 对外客服问答 | 加:会话记忆、基础护栏、小测试集、结构化 Trace |
| L3 有写操作、涉及资金或隐私 | 退款、补发、改订单 | 加:动作分级、人工审批、完整审计、权限隔离、红队测试 |
| L4 多 Agent 或长流程 | 跨系统的复杂工单 | 加:规划、checkpoint、跨 Agent 协议、成本治理 |
模块可以暂时空缺,但要"心中有数":在设计文档里写清楚为什么现在不需要。评估和可观测,我们建议 L2 以上都不要省略。
4.3 常见做法与后果
| 做法 | 后果 |
|---|---|
| 所有逻辑塞进一个超长 System Prompt | 改一句崩一片,无法单独测试 |
| 把"退款不得超过 200 元"写在提示词里 | 模型可能违反。应该在工具层或动作护栏里校验 |
| 用 print 代替 Trace | 出错后无法还原当时的上下文和决策 |
| 最后才补评估 | 没有基线,无法判断每次改动是变好还是变坏 |
不同框架在这张图上覆盖的面不同:有的主要提供编排,有的把循环、护栏、追踪一起打包。选型时用这张图逐项核对,看它覆盖哪几块、哪几块要自己补。具体方法在第 12 篇。
五、动手实现:把 01 篇的代码按模块分层
本篇不新增功能,只做一件事:把 01 篇的代码按模块拆开,给每个模块留出位置和接口。这是 SupportPilot 后续所有篇目的脚手架。
supportpilot/
├── agent/
│   ├── orchestrator.py   # 编排:循环、预算、终止、审批中断
│   ├── model.py          # 模型调用与上下文装配
│   ├── tools/            # 工具层:每个工具一个文件 + 注册表
│   │   ├── registry.py
│   │   └── order.py
│   ├── memory.py         # 记忆(先放接口)
│   ├── planner.py        # 规划(先留空)
│   ├── guardrails.py     # 入口 / 动作 / 出口三个拦截点
│   └── tracing.py        # 可观测:记录每一步
├── evals/                # 评估:测试集与脚本
│   └── cases.jsonl
├── tests/
└── README.md
核心是编排文件,它只管流程,不管业务语义。下面是骨架,用来展示模块之间的调用关系,各函数的完整实现在后续篇目补齐:
python
# agent/orchestrator.py:只管流程,不懂业务语义
import time
from dataclasses import dataclass
from . import guardrails, tracing
from .model import call_model, text_of, tool_calls
from .tools.registry import execute, schemas
from .memory import load_context, save_context

@dataclass
class Budget:
    max_steps: int = 8
    max_seconds: int = 60

def run(user_msg: str, user_id: str, budget: Budget = Budget()) -> str:
    trace = tracing.start(user_id)
    ok, reason = guardrails.check_input(user_msg)                    # 入口护栏
    if not ok:
        return trace.finish(f'无法处理:{reason}')
    messages = load_context(user_id) + [{'role': 'user', 'content': user_msg}]
    deadline = time.time() + budget.max_seconds

    for step in range(budget.max_steps):
        if time.time() > deadline:
            break
        msg = call_model(messages, tools=schemas(), trace=trace)     # 模型 + 上下文
        messages.append(msg)                                         # 整条消息原样放回
        calls = tool_calls(msg)
        if not calls:                                                # 模型认为可以收尾
            save_context(user_id, messages)
            return trace.finish(guardrails.check_output(text_of(msg)))    # 出口护栏

        for c in calls:
            verdict = guardrails.check_action(c)                     # 动作护栏
            if verdict == 'need_approval':
                return trace.finish('已提交人工审批') #第 11、15 篇:保存 checkpoint 并中断
            messages.append(execute(c, allowed=(verdict == 'allow'), trace=trace))   # 工具层
    return trace.finish('达到预算上限,已转人工处理')
对照 01 篇,有四处变化:
- 预算从一个常量变成
Budget,增加了时间上限。 - 工具调用前多了一道
check_action,被拒绝的动作不会被执行,而是把"不被允许"作为结果回传给模型。 - 输入、输出各加了一道护栏。
- 每一步都带着
trace,为第 19 篇的回放留好了接入点。
其余文件先放接口和空实现,例如 guardrails.py 的三个函数默认全部放行,tracing.py 先打印日志。接口稳定了,后面逐篇往里填内容,不需要再改编排。
六、踩坑清单:典型失败模式
| 失败模式 | 现象 | 预防(对应篇目) |
|---|---|---|
| 大范围循环 | 一个文件几千行,改一处坏三处 | 按本篇模块拆分,编排只管流程(12) |
| 模块越界 | 工具里写提示词,提示词里写权限 | 对照职责表的"边界"列做评审(03、06) |
| 过早抽象 | 一上来搭全套八大模块,原型迟迟跑不起来 | 按档位逐级点亮,空缺要写理由(03) |
| 护栏只在入口 | 输入过滤做了,写操作却没有动作护栏 | 三道关口都要有(23、24) |
| 评估与可观测空缺 | 出了问题只能靠猜,改动无法验证 | L2 起就要建,别等上线后补(18、19) |
| 把多 Agent 当架构起点 | 还没跑通单 Agent 就拆成五个角色 | 先单 Agent,有证据再拆(04、10) |
七、重点与自测
本篇重点
- 参考架构图(2.1 节):贴在项目 Wiki 上,评审时对着它提问。
- 模块职责与边界表(2.3 节):写设计文档和做代码评审时的依据。
- 项目骨架(第五节):可以直接作为 SupportPilot 的起始目录。
- 练习:给你手头的一个项目填下面这张"模块点亮表",找出缺失和越界。
| 模块 | 已有 / 缺失 / 有意缺席 | 现在放在哪个文件 | 越界问题 |
|---|---|---|---|
| 模型 + 上下文 | |||
| 工具 | |||
| 记忆 | |||
| 规划 | |||
| 编排 | |||
| 护栏 | |||
| 评估 | |||
| 可观测 |
自测 5 题
- "退款金额不得超过 200 元"这条规则,应该放在哪里?
- 想知道改了提示词之后,Agent 是变好了还是变坏了,应该靠哪个模块?
- 用户反馈昨天有一次回复是错的,怎么定位当时发生了什么?
- 一个固定 5 步、每步调用一次模型的流程,需要"规划"模块吗?
- "最多执行 8 步"这条限制,写在系统提示词里和写在编排里,有什么区别?
参考答案
- 放在工具层或动作护栏,由代码校验。提示词只做引导,不能当作保证。
- 评估模块,用固定测试集做前后对比。可观测记录的是单次运行,回答不了"整体变好还是变坏"。
- 靠可观测的 Trace 回放(第 19 篇),还原当时的上下文、工具调用和每一步决策。
- 不需要。规划用于运行时动态拆解目标;固定流程由编排里的流程定义承担。
- 写在提示词里,模型有概率不遵守;写在编排里,由代码强制执行。控制流归编排。
八、下一篇预告
03|从业务需求到 Agent 设计 :架构图回答的是"有哪些部件",设计文档要回答的是"做什么、做到什么程度、出错了怎么办"。下一篇我们学习任务拆解、成功标准、自治级别、ROI 估算,以及"失败模式先行"和状态机设计,并设计一份Agent 设计文档模板,填好 SupportPilot 版。