🔥承渊政道: 个人主页
❄️个人专栏: 《C语言基础语法知识》 《数据结构与算法》 《C++知识内容》 《Linux系统与网络知识》 《算法刷题指南》 《测评文章活动推广》 《大模型语言路线学习》 《MySQL数据库学习》 《Python知识内容》 《cpolar知识学习》
✨逆境不吐心中苦,顺境不忘来时路!✨ 🎬 博主简介:
在Linux网络编程中,完成TCP Socket通信只是第一步.随着程序功能逐渐复杂,一个关键问题随之而来:数据能够正常收发,但通信双方如何识别完整消息,并准确理解其中的内容? 由于TCP面向字节流,不负责划分应用层消息边界,因此需要通过应用层自定义协议 约定数据格式,并利用序列化与反序列化 实现程序数据与网络字节流之间的转换.然而,一个完整的网络服务不仅要解决数据通信问题,还需要考虑进程之间的组织关系以及服务如何稳定运行 .例如,父子进程如何管理?孤儿进程与僵尸进程是如何产生的?普通程序又该如何脱离终端,成为长期在后台运行的守护进程?本文将以 "应用层协议设计 → 手写序列化与反序列化 → 进程间关系 → 守护进程" 为主线,从网络数据的组织与解析入手,逐步深入 Linux进程管理与后台服务运行机制,帮助大家建立从网络通信、协议解析到服务管理的完整知识体系,为后续学习高性能网络服务器、进程管理及后台服务开发打下扎实基础.
目录
一、应⽤层⾃定义协议与序列化
核心思想:应用层自定义协议解决"如何组织和识别网络消息",序列化解决"如何将业务数据转换成可传输的字节".
两者通常配合使用,是实现TCP长连接通信、RPC、即时聊天、游戏服务器和物联网通信的基础.
1.什么是应用层自定义协议?
TCP 提供可靠的字节流传输,但不负责区分一条条业务消息.
例如,客户端连续发送:
Hello
World
服务端可能一次收到 HelloWorld,也可能分多次收到 He、lloW、orld.
这就是通常所说的 TCP 粘包、拆包问题,本质上是TCP不保留应用层消息边界.
因此,需要自行制定协议,让接收方知道一条消息从哪里开始、在哪里结束.
2.自定义协议的典型结构
常见方案是"固定长度消息头 + 可变长度消息体".
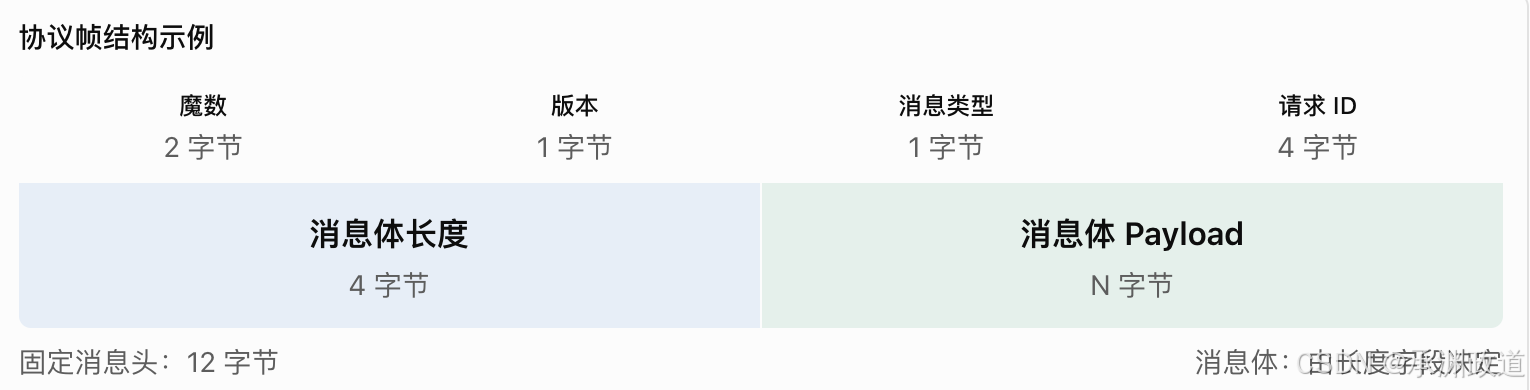
各字段作用:
| 字段 | 作用 |
|---|---|
| Magic | 识别协议格式 |
| Version | 支持协议升级 |
| Type | 区分登录、心跳、业务请求等 |
| Request ID | 匹配请求和响应 |
| Body Length | 告诉接收方需要读取多少字节 |
| Payload | 存放序列化后的业务数据 |
例如,消息体是:
{"userId":1001,"action":"login"}整个发送过程为:
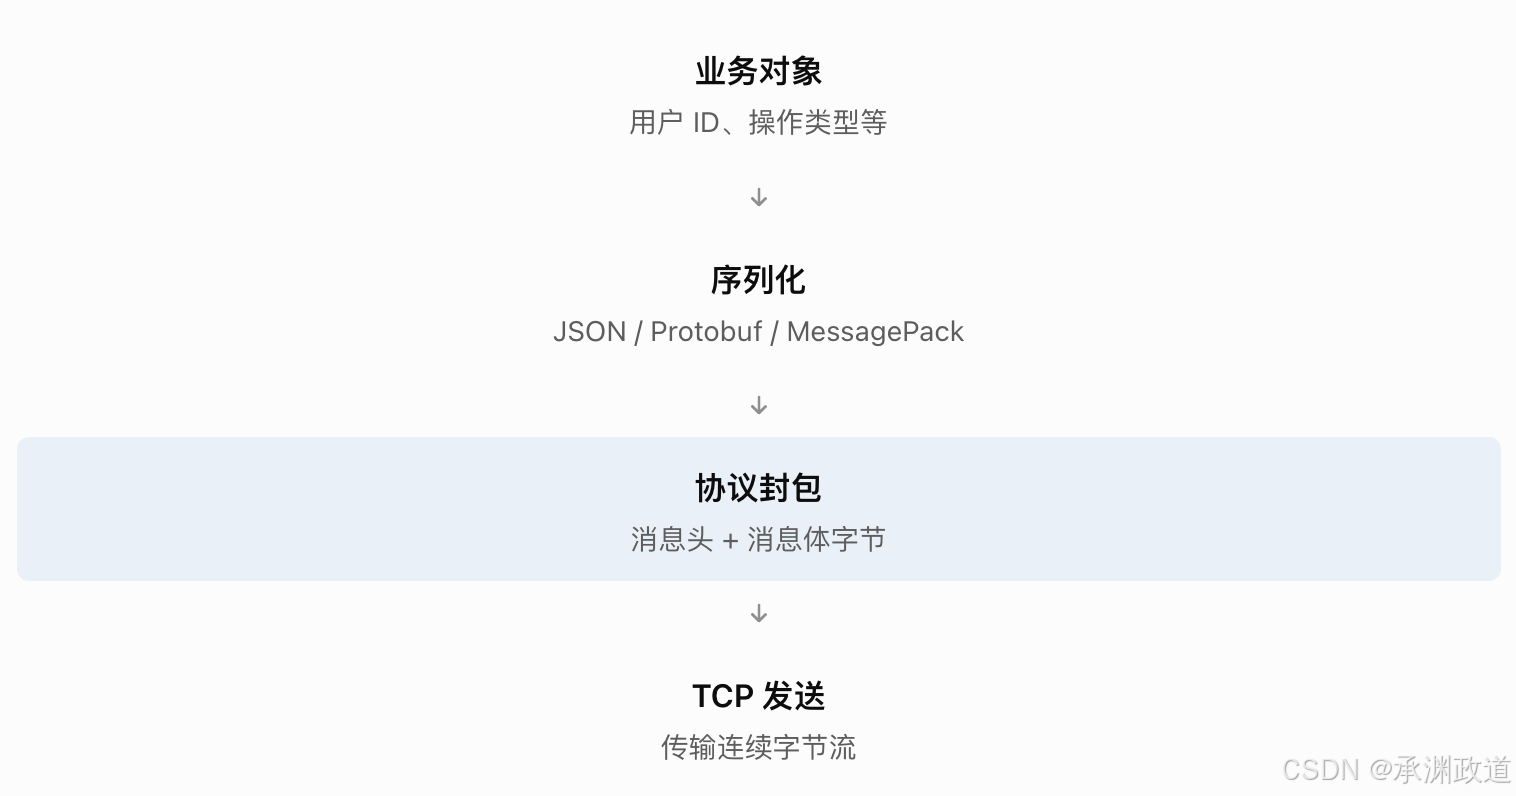
接收方则反向执行:接收字节 → 解析消息头 → 按长度提取消息体 → 反序列化 → 处理业务.
3.什么是序列化与反序列化?
序列化(Serialization):将内存中的对象转换为字节数据.
反序列化(Deserialization):将接收到的字节数据恢复成程序能够使用的数据结构.
常见序列化方案:
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| JSON | 可读性强、跨语言、易调试 | 数据体积较大、解析开销相对较高 | Web API、调试 |
| Protobuf | 体积小、性能好、支持 Schema | 需要定义 .proto 文件 |
RPC、微服务 |
| MessagePack | 紧凑、支持多种数据类型 | 不便直接阅读 | 二进制通信 |
| 自定义二进制 | 字段布局可控、可以很紧凑 | 开发维护成本高、兼容性复杂 | 特殊性能或设备协议 |
一般建议:简单项目选择JSON,追求传输效率和跨语言接口规范时优先考虑Protobuf.
4.使用Python实现协议封包
下面用JSON作为消息体编码,使用 Python 的 struct 构造固定长度消息头.
python
import json
import struct

MAGIC = 0xCAFE
HEADER_FORMAT = "!HBBII"
HEADER_SIZE = struct.calcsize(HEADER_FORMAT)

def encode_message(msg_type, request_id, data):
    # 1. 序列化业务数据
    body = json.dumps(
        data, separators=(",", ":")
    ).encode("utf-8")

    # 2. 构建 12 字节消息头
    header = struct.pack(
        HEADER_FORMAT,
        MAGIC,        # 2 字节
        1,            # 协议版本:1 字节
        msg_type,     # 消息类型:1 字节
        request_id,   # 请求 ID:4 字节
        len(body)     # 消息体长度:4 字节
    )

    return header + body

packet = encode_message(
    msg_type=1,
    request_id=100,
    data={"action": "login", "userId": 1001}
)

print(packet.hex())
!HBBII 中,! 表示网络字节序(大端序),H 表示2字节无符号整数,B 表示1字节无符号整数,I 表示4字节无符号整数.
实际TCP接收端必须先累计够12字节消息头,再根据 Body Length 读取完整消息体,不能假设一次 recv() 就得到完整消息.
1.1应⽤层
应用层是计算机网络中最接近用户和应用程序的一层,主要负责定义应用程序之间如何通信.
在OSI七层网络模型中,应用层位于第七层,也是最高层.
1.应用层在网络中的位置
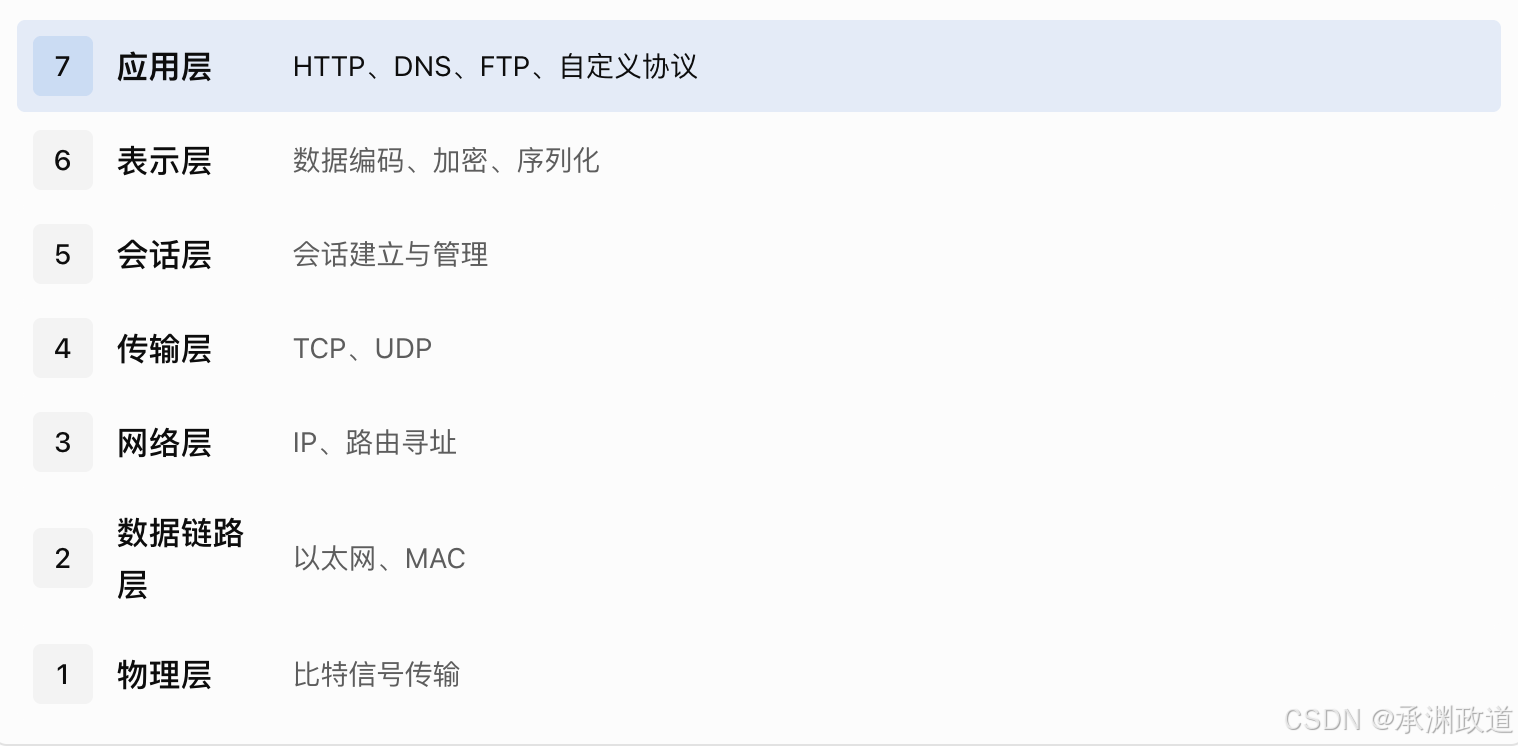
注意:实际TCP/IP 协议体系通常将 OSI 的应用层、表示层和会话层功能统一归入应用层.
2.应用层的主要作用
- 定义通信规则:规定请求和响应的格式.
- 组织业务数据:如登录请求、聊天消息、文件上传.
- 解析消息含义:识别消息类型、参数和业务操作.
- 处理应用逻辑:根据消息内容执行对应功能.
常见应用层协议:
| 协议 | 主要用途 |
|---|---|
| HTTP / HTTPS | 网页访问、API 通信 |
| DNS | 域名解析 |
| FTP | 文件传输 |
| SMTP | 邮件发送 |
| WebSocket | 双向实时通信 |
| MQTT | 物联网消息通信 |
2.应用层与传输层的区别
假设客户端发送登录请求:
{
  "username": "admin",
  "password": "123456"
}
应用层负责: 定义登录请求的格式、字段含义,以及服务端如何响应.
传输层负责: 使用TCP或UDP在网络中传输数据.
例如:
客户端应用程序
      ↓
应用层:构造登录请求
      ↓
序列化:转换成字节数据
      ↓
传输层:TCP 发送
      ↓
网络层:IP 寻址
      ↓
服务端接收并逐层处理
4.应用层为什么需要自定义协议?
TCP 只负责传输字节流,并不知道传输的是登录、聊天还是支付消息.
因此,可以在应用层制定通信规则,例如:
+------------+------------+---------------+
| 消息类型   | 数据长度   | 消息内容      |
+------------+------------+---------------+
| 1 字节     | 4 字节     | N 字节        |
+------------+------------+---------------+
这样服务端就能知道消息是什么类型、有多长,以及如何解析.
这种设计就是应用层自定义协议.
总结:
- 应用层:定义通信规则和业务语义.
- 传输层:负责端到端数据传输.
- 序列化:将业务对象转换成适合传输的字节数据.
- 自定义协议:规定字节如何组成消息,以及消息代表什么.
学习网络编程时,重点理解:应用层决定传什么、怎么解释;传输层负责把数据传过去.
①再谈"协议"
协议的本质,是通信双方提前约定好数据的格式和含义,让接收方能够正确理解发送方的数据.
1.为什么需要协议?
假设客户端通过 Socket 向服务器发送:
1001 张三 20服务器收到这些数据后,会遇到几个问题:
1001是用户ID,还是商品编号?张三是用户名,还是收件人?20是年龄,还是价格?- 每个字段之间如何分隔?
如果没有提前约定,服务器无法准确理解数据.
因此,通信双方需要制定一套规则,这套规则就是协议.
2.协议是怎么工作的?
例如,客户端和服务器约定:
第一个字段:用户 ID
第二个字段:用户名
第三个字段:年龄
字段之间用 | 分隔
客户端发送:
1001|张三|20服务器就能按照约定解析:
用户 ID = 1001
用户名  = 张三
年龄    = 20
这就是最简单的应用层自定义协议.
3.协议和序列化有什么关系?
实际开发中,通常使用JSON等序列化格式表示结构化数据.
例如:
{
  "userId": 1001,
  "name": "张三",
  "age": 20
}
完整通信过程:
客户端
  │
  ▼
业务对象
  │
  ▼
序列化(JSON → UTF-8 字节)
  │
  ▼
Socket 发送
  │
  ▼
网络传输
  │
  ▼
Socket 接收
  │
  ▼
反序列化(字节 → JSON → 业务对象)
  │
  ▼
服务器处理业务
其中:
- 协议:约定有哪些字段、字段的含义、消息格式以及如何处理消息.
- 序列化:将结构化数据转换成可传输的字节.
- 反序列化:将收到的字节转换成程序能够使用的数据.
4.有两个地方需要准确理解
- Socket 并不是只能发送字符串.
Socket 实际传输的是字节数据(bytes),字符串需要经过编码才能发送.
- 协议不仅仅是结构化数据.
协议还可以规定消息边界、消息类型、请求响应规则以及错误处理等.
例如 TCP 是字节流协议,因此应用层通常还需要约定消息长度,才能正确区分每一条消息.
一句话理解:协议负责让双方知道"数据应该长什么样、代表什么意思",序列化负责把这些数据变成可以在网络上传输的字节.
②网络版计算器
假设我们要实现一个网络版加法计算器:
客户端发送两个数字,服务器完成加法运算,再把计算结果返回客户端.
例如:
客户端发送:1+2
服务器返回:3
方案一:直接使用字符串约定通信协议
核心思想:客户端和服务器约定好字符串的格式,服务器按照这个格式解析数据.
1.约定请求格式
- 客户端发送形如
"1+2"的字符串. - 字符串由两个整数和一个运算符组成.
- 运算符只能是
+. - 两个数字之间不允许出现空格.
- 为简化实现,暂时只支持非负整数.
- 服务器按照约定解析字符串,提取两个操作数.
例如:
"123+456"
    │
    ▼
按照 '+' 分割
    │
    ├── 第一个操作数:123
    │
    ├── 运算符:+
    │
    └── 第二个操作数:456
    │
    ▼
计算:123 + 456
    │
    ▼
结果:579
2.约定响应格式
- 计算成功:返回结果字符串,例如
"579". - 请求格式错误:返回
"ERR:FORMAT". - 计算结果超出约定整数范围:返回
"ERR:OVERFLOW".
如果使用TCP,还需要约定消息边界.例如,每条请求和响应都以换行符 \n 结束.
3.方案一的优缺点
优点: 实现简单、容易理解,适合初学网络编程.
缺点: 格式比较固定,服务器需要手动解析字符串.当业务需要支持更多字段、运算符或复杂类型时,解析逻辑会越来越复杂.
方案二:通过结构体和序列化进行通信
核心思想:先定义结构体表示业务数据,再通过序列化和反序列化完成网络传输.
1.定义请求结构体
例如,使用 C++:
struct Request
{
    int x;      // 第一个操作数
    int y;      // 第二个操作数
    char op;    // 运算符
};
客户端要计算 1+2,就可以创建一个请求对象:
Request req;
req.x = 1;
req.y = 2;
req.op = '+';
2.定义响应结构体
服务器计算完成后,也需要把结果返回给客户端.
struct Response
{
    int result;  // 计算结果
    int code;    // 状态码
};
例如,规定:
code = 0:计算成功。code = 1:运算符不支持。code = 2:计算出错。
3.序列化与反序列化
结构体是程序内部的数据结构,不能直接假设把它的内存字节发出去,对方就能正确识别.
因此,客户端可以使用 JSON 格式进行序列化:
{
  "x": 1,
  "y": 2,
  "op": "+"
}
再编码成字节数据,通过Socket发送.
服务器接收完整消息后,按照相同规则进行反序列化,恢复出Request对象.
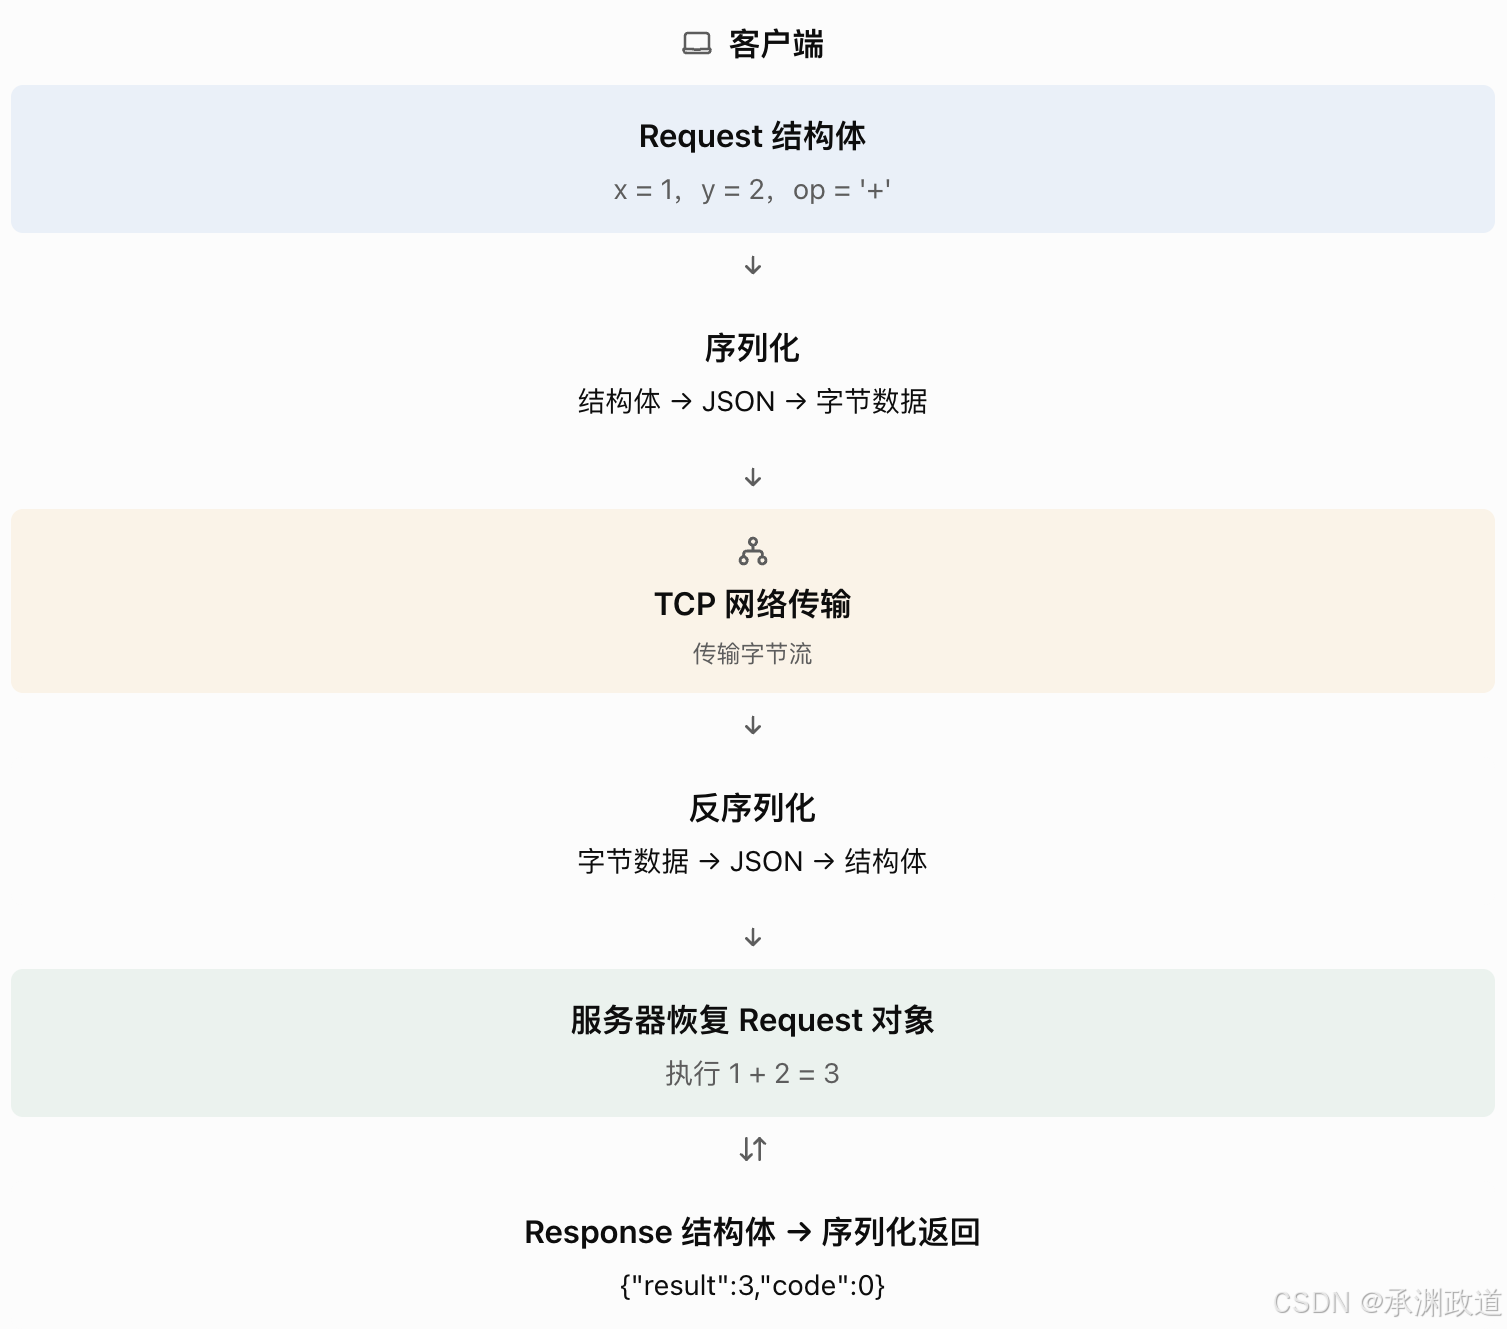
客户端收到响应后,进行反序列化,就能得到:
Response resp;
resp.result = 3;
resp.code = 0;
实际使用TCP时,方案二同样需要定义消息边界,例如采用长度前缀或约定单行JSON.
4.方案二的优缺点
优点: 数据结构清晰,字段容易扩展,适合复杂业务,也更方便代码维护.
缺点: 需要编写或使用序列化、反序列化代码,并确保通信双方使用兼容的数据格式.
方案一与方案二的区别
| 对比维度 | 方案一:直接约定字符串 | 方案二:结构体 + 序列化 |
|---|---|---|
| 数据组织 | 1+2 |
Request 结构体 |
| 数据解析 | 手动分割字符串 | 反序列化成对象 |
| 字段扩展 | 相对困难 | 相对容易 |
| 实现复杂度 | 简单 | 略高 |
| 适用场景 | 简单计算、学习网络编程 | 复杂业务、实际项目 |
需要特别理解的一点
方案一其实也可以看作一种简单的自定义序列化方案.
因为它同样完成了:
两个整数 + 一个运算符
          ↓
按照约定格式编码
          ↓
       "1+2"
          ↓
       网络传输
          ↓
按照约定格式解析
          ↓
还原出两个整数和运算符
方案二的不同之处在于,它把数据组织成明确的结构体,并采用统一的序列化格式进行编码和解析.
总结:方案一直接约定字符串格式;方案二先定义结构化数据,再通过序列化进行网络传输.两种方案本质上都依赖通信双方提前约定好的应用层协议.
③序列化和反序列化
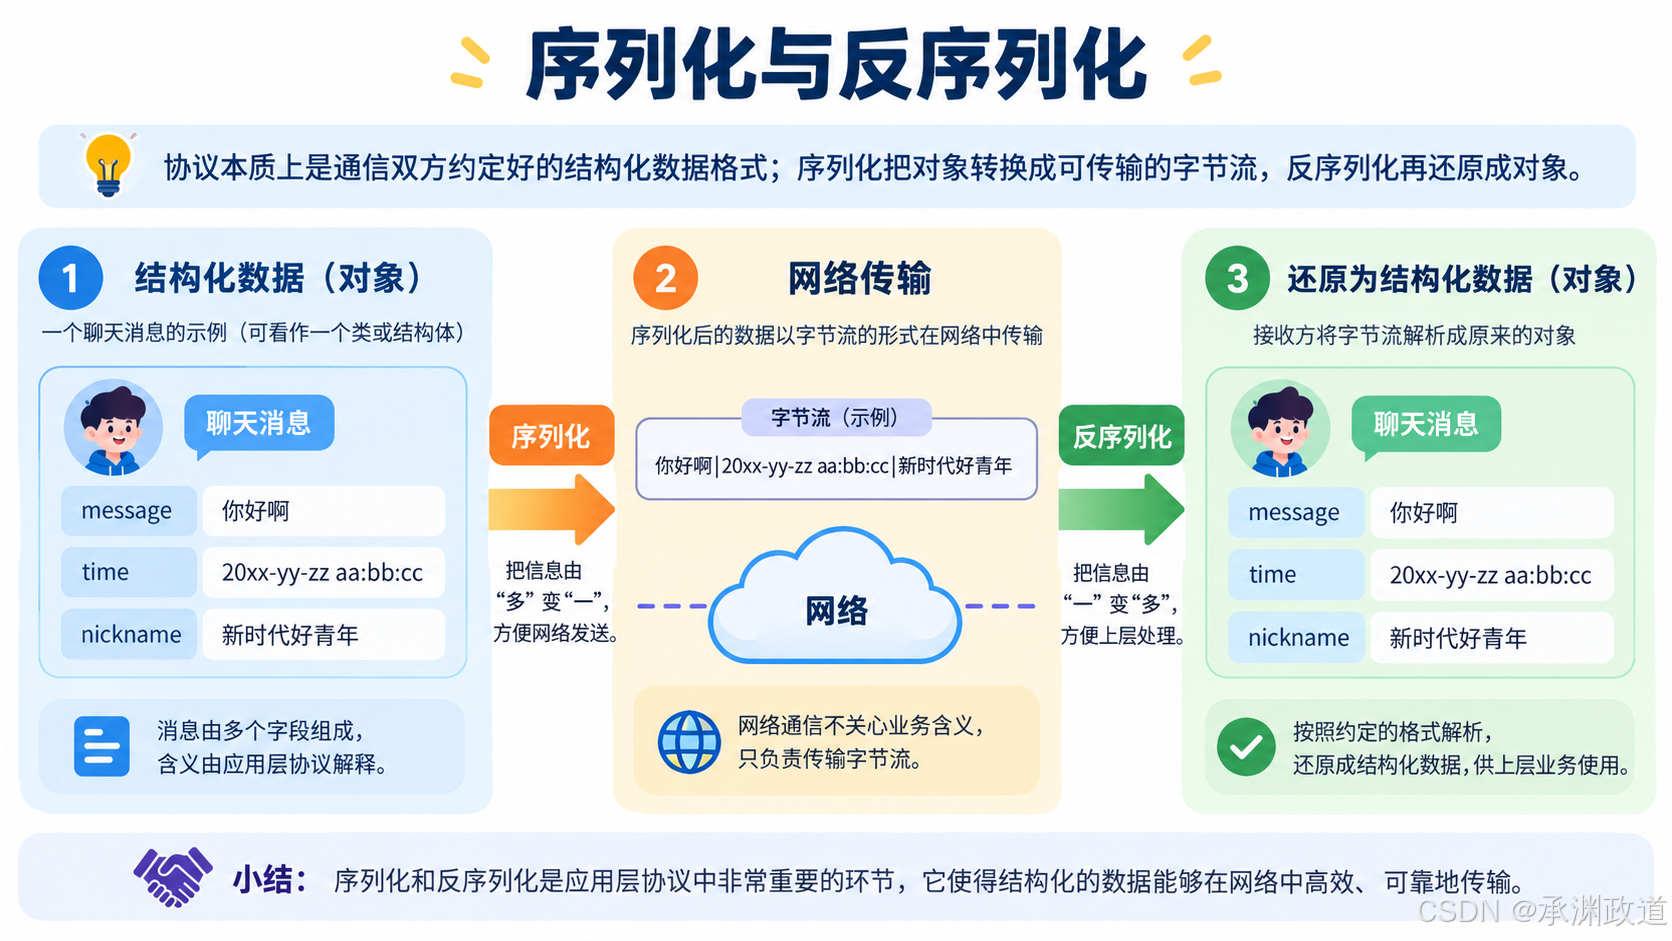
⽆论我们采⽤⽅案⼀,还是⽅案⼆,还是其他的⽅案,只要保证,⼀端发送时构造的数据,在另⼀端能够正确的进⾏解析,就是ok的.这种约定,就是应⽤层协议.但是,为了让我们深刻理解协议,我们打算⾃定义实现⼀下协议的过程.
- 我们采⽤⽅案2,我们也要体现协议定制的细节.
- 我们要引⼊序列化和反序列化,只不过我们直接采⽤现成的⽅案 -- jsoncpp库.
- 我们要对socket进⾏字节流的读取处理.
1.2重新理解read、write、recv、send和tcp为什么⽀持全双⼯
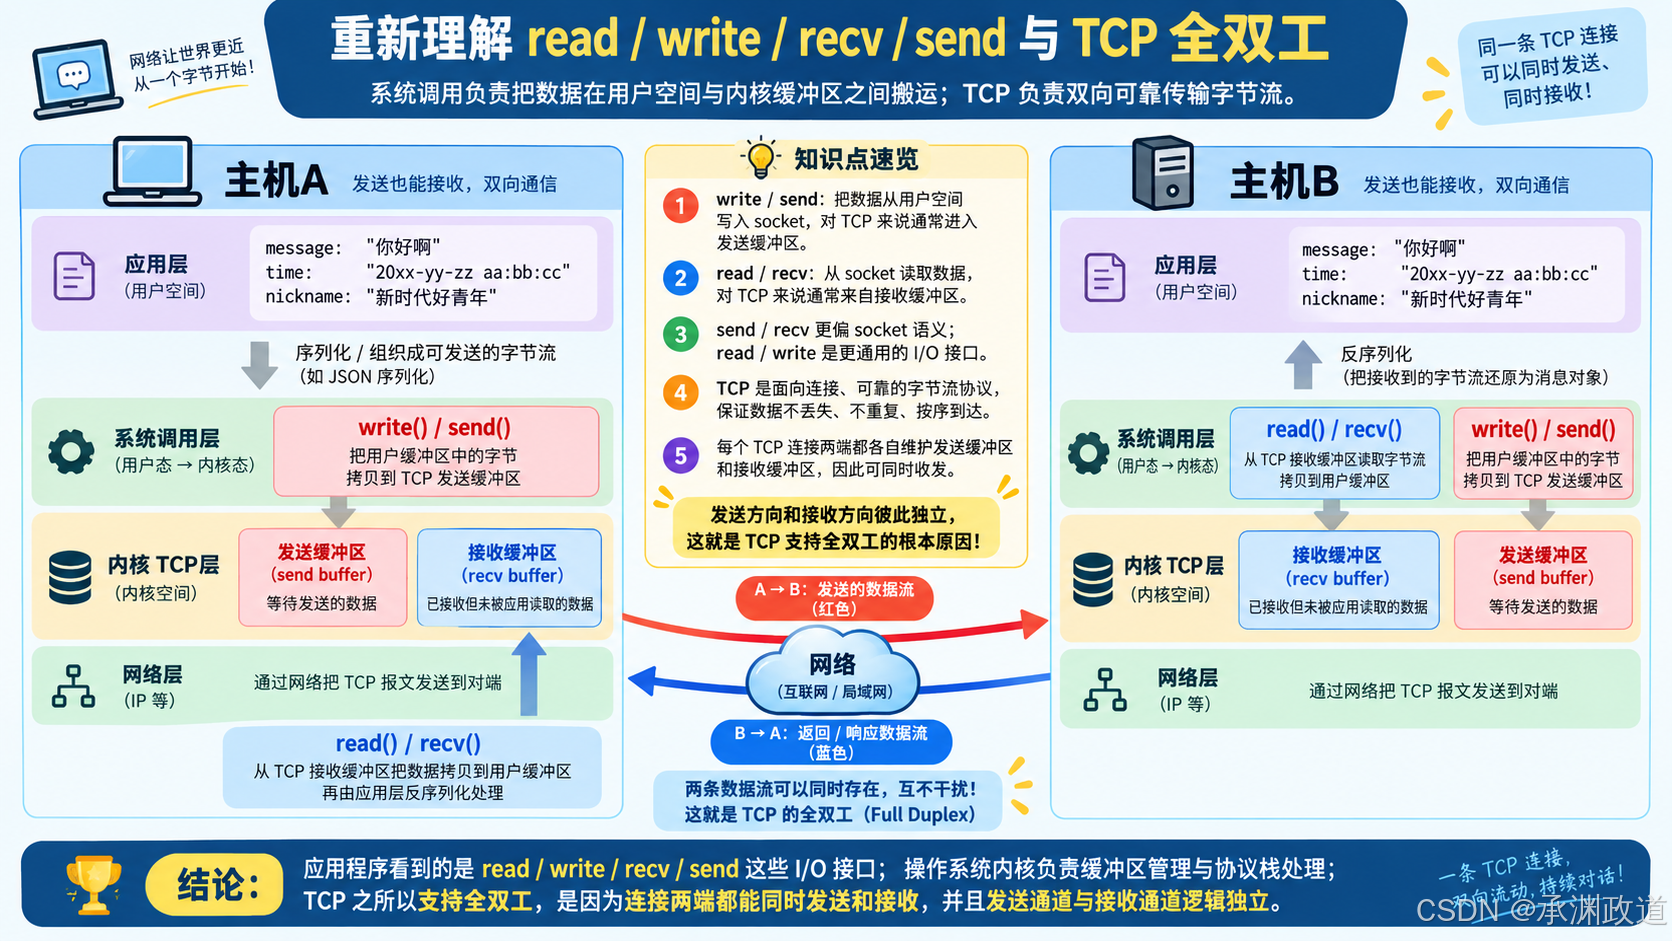
1.重新理解 read、write、recv、send 与TCP全双工
核心结论:write/send 负责把应用程序的数据交给操作系统,read/recv 负责从操作系统中取出接收到的数据.TCP支持全双工,是因为通信双方都可以同时发送和接收数据.
理解这张图,需要先掌握三个概念:用户空间、内核缓冲区、TCP 全双工通信.
2.先理解Socket发送和接收数据的过程
假设主机 A 和主机 B 已经建立了一条 TCP 连接.
主机 A 想给主机 B 发送一句话:
"你好啊"1.主机 A:发送数据
主机 A 使用 write() 或 send() 发送数据。
例如:
char buffer[] = "你好啊";

write(sockfd, buffer, strlen(buffer));
这里需要注意:
调用write,并不意味着数据已经直接发送到了主机B.
通常情况下,数据会先从应用程序的用户空间复制到操作系统内核中的TCP发送缓冲区.
整个过程:
主机 A

用户空间
┌────────────────────┐
│ buffer = "你好啊"   │
└────────────────────┘
          │
          │ write() / send()
          ▼
内核空间
┌────────────────────┐
│ TCP 发送缓冲区      │
│ "你好啊"            │
└────────────────────┘
          │
          │ TCP 协议栈处理
          ▼
网络因此,write() 或 send() 成功返回,通常意味着数据已经被操作系统接受,并不代表主机B已经收到,更不代表主机B的应用程序已经读取.
TCP协议栈随后负责发送、确认、必要时重传等工作.
2.主机 B:接收数据
当主机 A 发送的数据到达主机B后,并不是直接进入主机B的应用程序.
而是先由主机B的操作系统TCP协议栈处理,然后把有效数据放入TCP接收缓冲区.
主机 B

        网络
          │
          ▼
内核空间
┌────────────────────┐
│ TCP 接收缓冲区      │
│ "你好啊"            │
└────────────────────┘
          │
          │ read() / recv()
          ▼
用户空间
┌────────────────────┐
│ buffer = "你好啊"   │
└────────────────────┘
          │
          ▼
应用程序处理数据
主机B可以调用:
char buffer[1024];

ssize_t n = read(sockfd, buffer, sizeof(buffer));这时,read() 会从TCP接收缓冲区读取可用数据,并复制到应用程序提供的 buffer 中.
需要注意,read() 不保证一次读到一条完整消息.它返回的是实际读取的字节数,应用层还需要根据协议解析数据.
3.read、write、recv、send 到底有什么区别?
这四个函数可以分成两组:
| 函数 | 作用 | 数据方向 |
|---|---|---|
write() |
向文件描述符写入数据 | 用户空间 → 内核 |
send() |
向 Socket 发送数据 | 用户空间 → 内核 |
read() |
从文件描述符读取数据 | 内核 → 用户空间 |
recv() |
从 Socket 接收数据 | 内核 → 用户空间 |
对于TCP Socket:
write和send
write(sockfd, buffer, len);

send(sockfd, buffer, len, 0);
通常都可以用于发送数据.
read和recv
read(sockfd, buffer, len);

recv(sockfd, buffer, len, 0);
通常都可以用于接收数据.
主要区别是:
read/write是通用 I/O 系统调用,既可以操作文件,也可以操作Socket等文件描述符.recv/send专门面向Socket,提供额外的flags参数,用来控制部分收发行为.
在常见 Linux TCP Socket 场景中,send(..., 0) 和 write(...) 的基本发送效果相同,recv(..., 0) 和 read(...) 的基本接收效果也相同.
4.为什么 TCP 支持全双工?
首先,需要理解什么是全双工.
全双工(Full Duplex):通信双方可以在同一条连接上同时发送和接收数据.
想象两个人打电话.
A 说话的时候,B 也可以说话;A 能听到 B 的声音,B 也能听到 A 的声音.
TCP 的通信方式也是类似的.
1.每台主机都有发送缓冲区和接收缓冲区
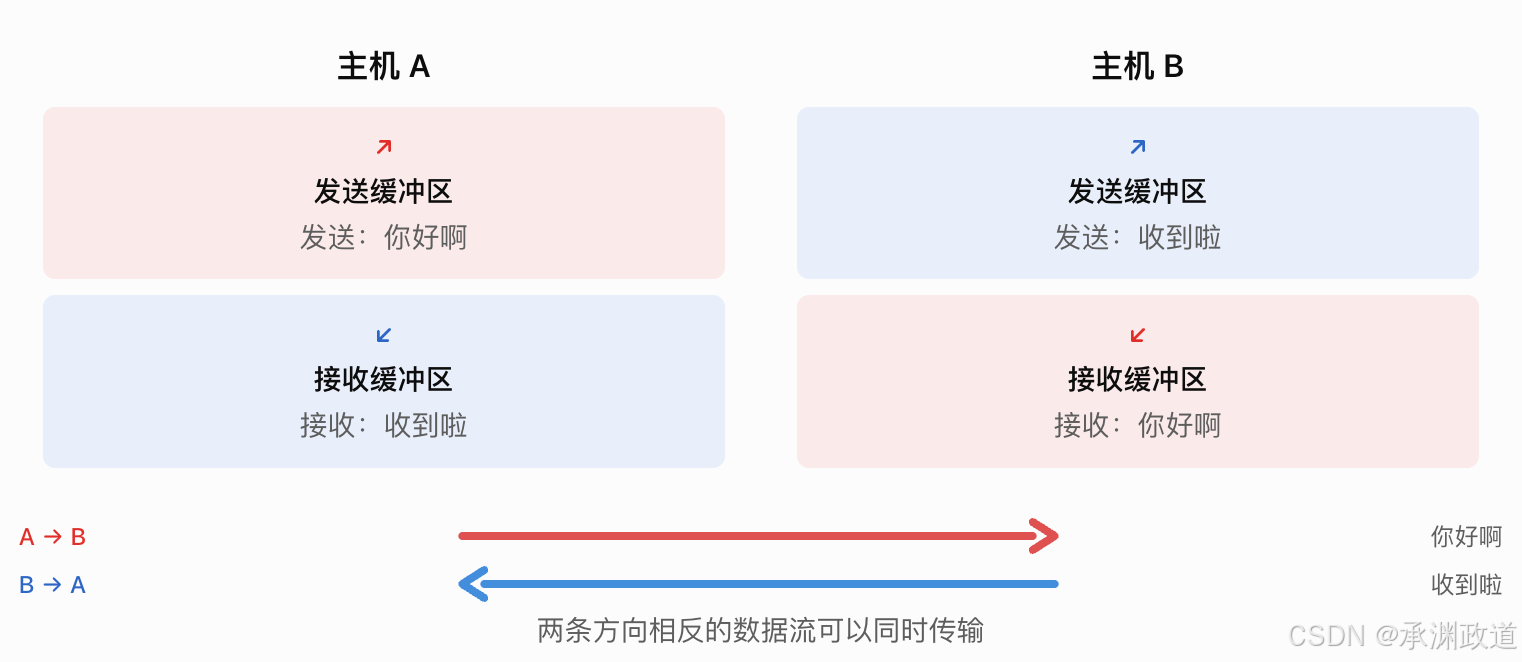
也就是说:
当主机 A 正在调用 write() 发送数据时,它仍然可以调用 read() 接收主机 B 发送过来的数据.
同样,主机B正在向A发送数据时,也可以同时接收来自 A 的数据.
2.TCP 为什么能够做到这一点?
关键在于:
一条 TCP 连接包含两个逻辑上独立的字节流方向.
- A → B:A 的发送方向,对应 B 的接收方向.
- B → A:B 的发送方向,对应 A 的接收方向.
TCP为两个方向分别维护相关的发送、接收状态和序列号空间.
每个连接端点通常也都有独立的发送缓冲区和接收缓冲区.
因此,发送和接收可以并行进行,不需要等待一个方向传输结束后,另一个方向才能开始.
不过,两个方向仍然可能共享网络带宽、CPU 等资源,所以全双工不意味着两边永远互不影响.
5.再思考一个问题:read 和 write 会相互阻塞吗?
假设主机 A 开启两个线程:
// 线程 1:发送数据
write(sockfd, send_buffer, send_len);

// 线程 2:接收数据
read(sockfd, recv_buffer, recv_capacity);
由于TCP支持全双工,这两个线程可以在同一个TCP Socket上分别进行发送和接收.
例如:
- 线程 1 正在发送
"你好啊". - 线程 2 正在等待接收
"收到啦".
即使线程2因为没有数据可读而阻塞,也不代表线程1不能发送.
需要区分:TCP支持全双工,不代表read和write永远不会阻塞.
比如:
read()在阻塞模式下,没有可读数据时可能等待.write()在阻塞模式下,发送缓冲区空间不足时可能等待.
这属于系统调用的阻塞行为,并不改变 TCP 的全双工特性.
6.最终总结
记住下面这四句话,就能理解这张图:
第一,发送数据: write/send 通常先将用户空间的数据复制到内核的 TCP 发送缓冲区,再由 TCP 协议栈负责传输.
第二,接收数据: 网络数据先进入内核 TCP 接收缓冲区,再通过 read/recv 复制到用户空间.
第三,TCP 全双工: 每个连接端点都能同时发送和接收数据,两个方向的字节流逻辑上独立.
第四,Socket 的作用: 为应用程序提供网络通信接口,使程序不需要直接操作底层 TCP 报文.
最重要的一句话:
write/send 是应用程序把数据交给内核,read/recv 是应用程序从内核取数据;TCP全双工意味着同一条连接可以同时进行双向通信.
1.3开始实现C++网络版计算器项目
cpp
//Calculator.hpp
#pragma once

#include "Protocol.hpp"
#include <iostream>
#include <string>

class Calculator
{
public:
    Response Execute(const Request &req)
    {
        Response resp;
        switch (req._oper)
        {
        case '+':
            resp._result = req._data_x + req._data_y;
            break;
        case '-':
            resp._result = req._data_x - req._data_y;
            break;
        case '*':
            resp._result = req._data_x * req._data_y;
            break;
        case '/':
        {
            if (req._data_y == 0)
                resp._code = 1; // div error
            else
                resp._result = req._data_x / req._data_y;
        }
        break;
        case '%':
        {
            if (req._data_y == 0)
                resp._code = 2; // mod error
            else
                resp._result = req._data_x % req._data_y;
        }
        break;
        default:
            resp._code = 3; // 非法操作
            break;
        }
        return resp;
    }
};
cpp
//InetAddr.hpp
#pragma once

#include <iostream>
#include <string>
#include <strings.h>
#include <sys/socket.h>
#include <netinet/in.h>
#include <arpa/inet.h>

#define CONV(address) ((struct sockaddr *)address)

// 对客户端进行先描述
class InetAddr
{
public:
    InetAddr()
    {
    }
    InetAddr(const struct sockaddr_in &address) : _address(address), _len(sizeof(address))
    {
        // _ip = inet_ntoa(_address.sin_addr);
        char ipstr[32];
        inet_ntop(AF_INET, &(_address.sin_addr), ipstr, sizeof(ipstr));
        _ip = ipstr;
        _port = ntohs(_address.sin_port);
    }
    InetAddr(uint16_t port, const std::string &ip = "0.0.0.0") : _ip(ip), _port(port)
    {
        bzero(&_address, sizeof(_address));
        _address.sin_family = AF_INET;
        _address.sin_port = htons(_port); // h->n
        //_address.sin_addr.s_addr = inet_addr(_ip.c_str()); // 1. 字符串ip->4字节IP 2. hton
        inet_pton(AF_INET, ip.c_str(), &(_address.sin_addr));
        _len = sizeof(_address);
    }
    bool operator==(const InetAddr &addr)
    {
        return (this->_ip == addr._ip) && (this->_port == addr._port);
    }
    void operator=(struct sockaddr_in &addr)
    {
        _address = addr;
        char ipstr[32];
        inet_ntop(AF_INET, &(_address.sin_addr), ipstr, sizeof(ipstr));
        _ip = ipstr;
        _port = ntohs(_address.sin_port);
    }
    std::string ToString()
    {
        return "[" + _ip + ":" + std::to_string(_port) + "]";
    }

    struct sockaddr *NetAddress()
    {
        return CONV(&_address);
    }
    socklen_t Len()
    {
        return _len;
    }
    ~InetAddr()
    {
    }

private:
    // net address
    struct sockaddr_in _address;
    socklen_t _len;
    // host address
    std::string _ip;
    uint16_t _port;
};
cpp
//Logger.hpp
#ifndef __LOGGER_HPP
#define __LOGGER_HPP
#include <iostream>
#include <cstdio>
#include <string>
#include <memory>
#include <sstream>
#include <ctime>
#include <sys/time.h>
#include <unistd.h>
#include <filesystem> // C++17
#include <fstream>
#include "Mutex.hpp"
namespace NS_LOG_MODULE
{
enum class LogLevel
{
INFO,
WARNING,
ERROR,
FATAL,
DEBUG
};
std::string LogLevel2Message(LogLevel level)
{
switch (level)
{
case LogLevel::INFO:
return "INFO";
case LogLevel::WARNING:
return "WARNING";
case LogLevel::ERROR:
return "ERROR";
case LogLevel::FATAL:
return "FATAL";
case LogLevel::DEBUG:
return "DEBUG";
default:
return "UNKNOWN";
}
}
// 1. 时间戳 2. 日期+时间
std::string GetCurrentTime()
{
struct timeval current_time;
int n = gettimeofday(¤t_time, nullptr);
(void)n;
// current_time.tv_sec; current_time.tv_usec;
struct tm struct_time;
localtime_r(&(current_time.tv_sec), &struct_time); // r: 可重入函数
char timestr[128];
snprintf(timestr, sizeof(timestr), "%04d-%02d-%02d %02d:%02d:%02d.%ld",
struct_time.tm_year + 1900,
struct_time.tm_mon + 1,
struct_time.tm_mday,
struct_time.tm_hour,
struct_time.tm_min,
struct_time.tm_sec,
current_time.tv_usec);
return timestr;
}
// 输出角度 -- 刷新策略
// 1. 显示器打印
// 2. 文件写入
// 策略模式,策略接口
class LogStrategy
{
public:
virtual ~LogStrategy() = default;
virtual void SyncLog(const std::string &message) = 0;
};
// 控制台日志刷新策略, 日志将来要向显示器打印
class ConsoleStrategy : public LogStrategy
{
public:
void SyncLog(const std::string &message) override
{
LockGuard lockguard(_mutex);
std::cerr << message << std::endl; // ??
}
~ConsoleStrategy()
{
}
private:
Mutex _mutex;
};
const std::string defaultpath = "./log";
const std::string defaultfilename = "log.txt";
// 文件策略
class FileLogStrategy : public LogStrategy
{
public:
FileLogStrategy(const std::string &path = defaultpath, const std::string &name = defaultfilename)
: _logpath(path),
_logfilename(name)
{
LockGuard lockguard(_mutex);
if (std::filesystem::exists(_logpath))
return;
try
{
std::filesystem::create_directories(_logpath);
}
catch (const std::filesystem::filesystem_error &e)
{
std::cerr << e.what() << '\n';
}
}
void SyncLog(const std::string &message) override
{
{
LockGuard lockguard(_mutex);
if (!_logpath.empty() && _logpath.back() != '/')
{
_logpath += "/";
}
std::string targetlog = _logpath + _logfilename; // "./log/log.txt"
std::ofstream out(targetlog, std::ios::app); // 追加方式写入
if (!out.is_open())
{
std::cerr << "open " << targetlog << "failed" << std::endl;
return;
}
out << message << "\n";
out.close();
}
}
~FileLogStrategy()
{
}
private:
std::string _logpath;
std::string _logfilename;
Mutex _mutex;
};
// 交给大家
// const std::string defaultfilename = "log.info";
// const std::string defaultfilename = "log.warning";
// const std::string defaultfilename = "log.fatal";
// const std::string defaultfilename = "log.error";
// const std::string defaultfilename = "log.debug";
// 文件策略&&分日志等级来进行保存
// class FileLogLevelStrategy : public LogStrategy
// {
// public:
// private:
// };
// 日志类:
// 1. 日志的生成
// 2. 根据不同的策略,进行刷新
class Logger
{
// 日志的生成:
// 构建日志字符串
public:
Logger()
{
UseConsoleStrategy();
}
void UseConsoleStrategy()
{
_strategy = std::make_unique<ConsoleStrategy>();
}
void UseFileStrategy()
{
_strategy = std::make_unique<FileLogStrategy>();
}
// 内部类, 标识一条完整的日志信息
// 一条完整的日志信息 = 做半部分固定部分 + 右半部分不固定部分
// LogMessage RAII风格的方式,进行刷新
class LogMessage
{
public:
LogMessage(LogLevel level, std::string &filename, int line, Logger &logger)
: _level(level),
_curr_time(GetCurrentTime()),
_pid(getpid()),
_filename(filename),
_line(line),
_logger(logger)
{
// 先构建出来左半部分
std::stringstream ss;
ss << "[" << _curr_time << "] "
<< "[" << LogLevel2Message(_level) << "] "
<< "[" << _pid << "] "
<< "[" << _filename << "] "
<< "[" << _line << "] "
<< " - ";
_loginfo = ss.str();
}
template <typename T>
LogMessage &operator<<(const T &info)
{
std::stringstream ss;
ss << info;
_loginfo += ss.str();
return *this; // 返回当前LogMessage对象,方便下次继续进行<<
}
~LogMessage()
{
if (_logger._strategy)
{
_logger._strategy->SyncLog(_loginfo);
}
}
private:
LogLevel _level;
std::string _curr_time;
pid_t _pid;
std::string _filename;
int _line;
std::string _loginfo; // 一条完整的日志信息
// 一个引用,引用外部的Logger类对象
Logger &_logger; // 方便我们后续进行策略式刷新
};
// 这里已经不是内部类了
// 故意采用拷贝LogMessage
LogMessage operator()(LogLevel level, std::string filename, int line)
{
return LogMessage(level, filename, line, *this);
}
~Logger()
{
}
private:
std::unique_ptr<LogStrategy> _strategy; // 刷新策略
};
// 日志对象,全局使用
Logger logger;
#define ENABLE_CONSOLE_LOG_STRATEGY() logger.UseConsoleStrategy();
#define ENABLE_FILE_LOG_STRATEGY() logger.UseFileStrategy();
#define LOG(level) logger(level, __FILE__, __LINE__)
}
#endif
cpp
//Makefile
.PHONY:all
all:netcal_server netcal_client

netcal_server:NetCalServer.cc
	g++ -o $@ $^ -std=c++17 -ljsoncpp

netcal_client:NetCalClient.cc
	g++ -o $@ $^ -std=c++17 -ljsoncpp

.PHONY:clean
clean:
	rm -f netcal_server netcal_client
cpp
//Mutex.hpp
#pragma once

#include <iostream>
#include <pthread.h>

class Mutex
{
public:
    Mutex()
    {
        pthread_mutex_init(&_lock, nullptr);
    }
    void Lock()
    {
        pthread_mutex_lock(&_lock);
    }
    pthread_mutex_t *Ptr()
    {
        return &_lock;
    }
    void Unlock()
    {
        pthread_mutex_unlock(&_lock);
    }
    ~Mutex()
    {
        pthread_mutex_destroy(&_lock);
    }
private:
    pthread_mutex_t _lock;
};

class LockGuard // RAII风格代码
{
public:
    LockGuard(Mutex &lock):_lockref(lock)
    {
        _lockref.Lock();
    }
    ~LockGuard()
    {
        _lockref.Unlock();
    }
private:
    Mutex &_lockref;
};
cpp
//NetCalClient.cc
#include <iostream>
#include <string>
#include <memory>
#include "InetAddr.hpp"
#include "Socket.hpp"
#include "Protocol.hpp"

using namespace NS_SOCKET_MODULE;

static void Usage(const std::string &proc)
{
    std::cout << "Usage:\n\t" << proc << " server_ip server_port" << std::endl;
}

static void HanlderResponse(Response &resp)
{
    std::cout << "result: " << resp._result << "[" << resp._code << "]" << std::endl;
}

// ./netcal_client 目标IP 目标主机端口
int main(int argc, char *argv[])
{
    if (argc != 3)
    {
        Usage(argv[0]);
        exit(1);
    }
    std::string server_ip = argv[1];
    uint16_t server_port = std::stoi(argv[2]);

    std::unique_ptr<Socket> socket = std::make_unique<TcpSocket>();
    socket->BuildTcpClientSockMethod();

    InetAddr serveraddress(server_port, server_ip);
    bool n = socket->Connect(serveraddress);
    if (!n)
    {
        std::cerr << "connect error: " << serveraddress.ToString() << std::endl;
        exit(2);
    }
    Protocol procotol(HanlderResponse);
    std::string inbuffer;
    while (true)
    {
        int cnt = 3;
        std::string outbuffer;
        while (cnt--)
        {
            // 0. 获取数据
            int x, y;
            char oper;
            std::cout << "Enter Your x: ";
            std::cin >> x;
            std::cout << "Enter Your y: ";
            std::cin >> y;
            std::cout << "Enter Your oper: ";
            std::cin >> oper;

            // 1. 定义请求对象
            Request req(x, y, oper);

            // 2. 序列化
            std::string req_json;
            req.Serialize(&req_json);

            // 3. 封装报头
            std::string send_req_string = procotol.Packet(req_json);
            outbuffer += send_req_string;
        }
        std::cout << "\n" << outbuffer << std::endl;

        // 4. 发送
        socket->Send(outbuffer);

        // 5. 接收
        socket->Recv(&inbuffer);

        // 6. 解析
        procotol.ParseResponse(inbuffer);
    }

    // Protocol procotol(HanlderResponse);
    // std::string inbuffer;
    // while (true)
    // {
    //     // 0. 获取数据
    //     int x, y;
    //     char oper;
    //     std::cout << "Enter Your x: ";
    //     std::cin >> x;
    //     std::cout << "Enter Your y: ";
    //     std::cin >> y;
    //     std::cout << "Enter Your oper: ";
    //     std::cin >> oper;

    //     // 1. 定义请求对象
    //     Request req(x, y, oper);

    //     // 2. 序列化
    //     std::string req_json;
    //     req.Serialize(&req_json);

    //     // 3. 封装报头
    //     std::string send_req_string = procotol.Packet(req_json);

    //     // 4. 发送
    //     socket->Send(send_req_string);

    //     // 5. 接收
    //     socket->Recv(&inbuffer);

    //     // 6. 解析
    //     procotol.ParseResponse(inbuffer);
    // }

    socket->Close();
    // sock
    return 0;
}
cpp
//NetCalServer.cc
#include "TcpServer.hpp"
#include "Protocol.hpp"
#include "Calculator.hpp"
#include <memory>


static void Usage(const std::string &proc)
{
    std::cout << "Usage:\n\t" << proc << " port" << std::endl;
}

int main(int argc, char *argv[])
{
    if (argc != 2)
    {
        Usage(argv[0]);
        exit(1);
    }
    uint16_t port = std::stoi(argv[1]);
    // 1. 定义计算机
    std::unique_ptr<Calculator> cal = std::make_unique<Calculator>();

    // 2. 定义协议对象
    std::unique_ptr<Protocol> protocol = std::make_unique<Protocol>(
        [&cal](Request &req)->Response{
            return cal->Execute(req);
        }
    );

    // 3. 定义网络对象
    std::unique_ptr<TcpServer> tsvr = std::make_unique<TcpServer>(
        [&protocol](std::string &inbuffer)->std::string{
            return protocol->ParseRequest(inbuffer);
        }, port
    );

    // 4. 启动
    tsvr->Loop();

    return 0;
}
cpp
//Protocol.hpp
#pragma once

// 自定义协议部分
#include <iostream>
#include <string>
#include <jsoncpp/json/json.h>
#include <functional>
#include "Logger.hpp"

using namespace NS_LOG_MODULE;

// 1. 自己做 - 不建议的!
// 2. 用别人的 - json protobuf xml

// 请求报文
class Request
{
public:
    Request() : _data_x(0), _data_y(0), _oper(0)
    {
    }
    Request(int x, int y, char oper) : _data_x(x), _data_y(y), _oper(oper)
    {
    }
    bool Serialize(std::string *out)
    {
        // 结构化 -> "_data_x _oper _data_y"
        Json::Value root;
        root["left"] = _data_x;
        root["right"] = _data_y;
        root["oper"] = _oper;

        Json::FastWriter writer;
        *out = writer.write(root);
        return true;
    }
    bool Deserialize(std::string &in) // "_data_x _oper _data_y"
    {
        // "_data_x _oper _data_y" -> 结构化
        Json::Value root;
        Json::Reader reader;
        bool parsesuccess = reader.parse(in, root);
        if (!parsesuccess)
            return false;

        _data_x = root["left"].asInt();
        _data_y = root["right"].asInt();
        _oper = root["oper"].asInt();
        return true;
    }
    ~Request()
    {
    }
    // get set

public:
    // 10 20 '-' -> 10 - 20 = ?
    // _data_x _oper _data_y
    int _data_x;
    int _data_y;
    char _oper; // '+' '-' '/' '*' '%'
};

// 应答报文
class Response
{
public:
    Response() : _result(0), _code(0)
    {
    }
    Response(int result, int code) : _result(result), _code(code)
    {
    }
    bool Serialize(std::string *out)
    {
        Json::Value root;
        root["result"] = _result;
        root["code"] = _code;

        Json::FastWriter writer;
        *out = writer.write(root);
        return true;
    }
    bool Deserialize(std::string &in)
    {
        Json::Value root;
        Json::Reader reader;
        bool parsesuccess = reader.parse(in, root);
        if (!parsesuccess)
            return false;

        _result = root["result"].asInt();
        _code = root["code"].asInt();
        return true;
    }
    ~Response()
    {
    }

public:
    int _result; // 结果
    int _code;   // 状态码
};

const std::string gsep = "\r\n";

using HandlerRequest_t = std::function<Response(Request &)>;
using HandlerResponse_t = std::function<void (Response &)>;

class Protocol
{
public:
    Protocol(HandlerRequest_t handler) : _version("1.0"), _handler_request(handler)
    {
    }
    Protocol(HandlerResponse_t handler_response):_version("1.0"), _handler_response(handler_response)
    {
    }
    // {"left": 10, "right": 20, oper: '+'}
    // len\r\n{"left": 10, "right": 20, oper: '+'}\r\n
    std::string Packet(const std::string &json_string)
    {
        return std::to_string(json_string.size()) + gsep + json_string + gsep;
    }
    // len\r\n{"left": 10, "right": 20, oper: '+'}\r\n
    // len\r\n{"left": 10, "right": 20, oper: '+'}\r\nlen\r\n{"left": 10, "right": 20, oper: '+'}\r\n
    // len\r\n{"left": 10, "right": 20, oper: '+'}\r\nlen\r\n{"left": 10,
    // len\r\n{"left": 10, "right": 20, o
    // le
    // ret > 0: no error, json_string != NULL
    // ret == 0: no error, json_string == NULL
    // ret < 0 : error.
    int Unpack(std::string &packet, std::string *json_string)
    {
        if (packet.empty())
            return 0;
        if (json_string == nullptr)
            return -1;

        // 分析报文
        auto pos = packet.find(gsep);
        if (pos == std::string::npos)
            return 0;
        std::string lenstr = packet.substr(0, pos);

        // lenstr 合法性判断,lenstr -> 123 345

        int len = std::stoi(lenstr);
        int total = lenstr.size() + len + 2 * gsep.size();
        if (packet.size() < total)
            return 0;
        // 提取报文
        *json_string = packet.substr(pos + gsep.size(), len);
        packet.erase(0, total);
        return 1;
    }
    // 如果读到半个报文,什么都不做
    // 如果读到一个报文+,循环处理,把所有合法的报文都进行统一处理
    std::string ParseRequest(std::string &inbuffer)
    {
        std::string result;
        while (true)
        {
            std::string json_string;
            // 1. 解包
            int n = Unpack(inbuffer, &json_string);
            if (n < 0)
            {
                LOG(LogLevel::DEBUG) << "no way !!";
                return std::string();
            }
            if (n == 0)
            {
                LOG(LogLevel::INFO) << inbuffer << " parse done";
                return result;
            }
            LOG(LogLevel::DEBUG) << "json_string:\n" << json_string;
            LOG(LogLevel::DEBUG) << "unpack done, inbuffer:\n" << inbuffer;
            // 2. 反序列化
            // 得到一个完整的报文jsonstring
            Request req;
            if (!req.Deserialize(json_string))
                return std::string();

            // 3. 业务计算
            Response resp;
            if (_handler_request)
                resp = _handler_request(req);

            // 4. 应答序列化
            std::string resp_json_string;
            resp.Serialize(&resp_json_string);

            // 5. 添加报头
            result += Packet(resp_json_string);
        }
    }
    std::string ParseResponse(std::string &inbuffer)
    {
        while (true)
        {
            std::string json_string;
            // 1. 解包
            int n = Unpack(inbuffer, &json_string);
            if (n < 0)
            {
                LOG(LogLevel::DEBUG) << "no way !!";
                return std::string();
            }
            if (n == 0)
            {
                LOG(LogLevel::INFO) << inbuffer << " parse done";
                return std::string();
            }
            // 2. 反序列化
            // 得到一个完整的报文jsonstring
            Response resp;
            if (!resp.Deserialize(json_string))
                return std::string();

            // 3. 回调处理
            if (_handler_response)
                _handler_response(resp);
        }
    }

    ~Protocol()
    {
    }

private:
    std::string _version;
    HandlerRequest_t _handler_request;
    HandlerResponse_t _handler_response;
};
cpp
//Socket.hpp
#pragma once

#include <iostream>
#include <unistd.h>
#include <cstdlib>
#include <arpa/inet.h>
#include <netinet/in.h>
#include <sys/socket.h>
#include "Logger.hpp"
#include "InetAddr.hpp"

namespace NS_SOCKET_MODULE
{
    using namespace NS_LOG_MODULE;

    static const int gbacklog = 16;

    enum
    {
        OK = 0,
        SOCKET_ERR,
        BIND_ERR,
        LISTEN_ERR
    };

    // 模版方法模式!
    class Socket
    {
    public:
        ~Socket()
        {
        }

    protected:
        virtual void CreateSocketOrDie() = 0;
        virtual void BindSocketOrDie(uint16_t port) = 0;
        virtual void ListenSocketOrDie() = 0;
        // virtual ssize_t Recv() = 0;
        // virtual void Send() = 0;
    public:
        virtual std::shared_ptr<Socket> Accepter(InetAddr &addr) = 0;
        virtual int Sockfd() = 0;
        virtual int Recv(std::string *out) = 0;
        virtual int Send(const std::string &in) = 0;
        virtual void Close() = 0;
        virtual bool Connect(InetAddr &addr) = 0;
    public:
        void BuildTcpSocketMethod(uint16_t port) // 模版方法
        {
            CreateSocketOrDie();
            BindSocketOrDie(port);
            ListenSocketOrDie();
        }
        void BuildTcpClientSockMethod()
        {
            CreateSocketOrDie();
        }
        // void BuildUdpSocketMethod()
        // {
        //     CreateSocketOrDie();
        //     BindSocketOrDie();
        // }
    };

    class TcpSocket : public Socket
    {
    public:
        TcpSocket() : _sockfd(0)
        {
        }
        TcpSocket(int sockfd): _sockfd(sockfd)
        {}
        void CreateSocketOrDie() override
        {
            _sockfd = socket(AF_INET, SOCK_STREAM, 0);
            if (_sockfd < 0)
            {
                LOG(LogLevel::FATAL) << "create socket error";
                exit(SOCKET_ERR);
            }
        }
        void BindSocketOrDie(uint16_t port) override
        {
            InetAddr addr(port);
            if (bind(_sockfd, addr.NetAddress(), addr.Len()) != 0)
            {
                LOG(LogLevel::FATAL) << "bind socket error";
                exit(BIND_ERR);
            }
        }
        void ListenSocketOrDie() override
        {
            if (listen(_sockfd, gbacklog) != 0)
            {
                LOG(LogLevel::FATAL) << "listen socket error";
                exit(LISTEN_ERR);
            }
        }
        std::shared_ptr<Socket> Accepter(InetAddr &clientaddr) override
        {
            struct sockaddr_in addr;
            socklen_t len = sizeof(addr);
            int sockfd = accept(_sockfd, CONV(&addr), &len);
            if(sockfd < 0)
            {
                LOG(LogLevel::WARNING) << "accept error";
                return nullptr;
            }
            clientaddr = addr;
            return std::make_shared<TcpSocket>(sockfd);
        }
        int Sockfd() override
        {
            return _sockfd;
        }

        int Recv(std::string *out) override
        {
            char inbuffer[1024];
            ssize_t n = recv(_sockfd, inbuffer, sizeof(inbuffer)-1, 0);
            if(n > 0)
            {
                inbuffer[n] = 0;
                *out += inbuffer; // 追加写入的
            }
            return n;
        }

        int Send(const std::string &in) override
        {
            return send(_sockfd, in.c_str(), in.size(), 0);
        }
        void Close() override
        {
            if(_sockfd>=0)
            {
                close(_sockfd);
                _sockfd = -1;
            }
        }
        bool Connect(InetAddr &addr) override
        {
            int n = connect(_sockfd, addr.NetAddress(), addr.Len());
            if(n < 0)
                return false;
            else
                return true;
        }

        ~TcpSocket() {}

    private:
        int _sockfd;
    };

    // class UdpSocket: public Socket
    // {

    // };

} // namespace name
cpp
//TcpServer.hpp
#include "Logger.hpp"
#include "InetAddr.hpp"
#include "Socket.hpp"
#include <memory>
#include <unistd.h>
#include <signal.h>
#include <functional>

static uint16_t gport = 8080;

using namespace NS_SOCKET_MODULE;

using Handler_t = std::function<std::string(std::string&)>;

class TcpServer
{
public:
    TcpServer(Handler_t handler, uint16_t port = gport)
    : _port(port),
     _listensock(std::make_unique<TcpSocket>()),
     _handler(handler)
    {
        _listensock->BuildTcpSocketMethod(_port); // 使用创建listensockfd的模版方法!
        LOG(LogLevel::INFO) << "create listen socket success: " << _listensock->Sockfd();
    }
    void Loop()
    {
        signal(SIGCHLD, SIG_IGN);
        while (true)
        {
            InetAddr clientaddr;
            auto sockfd = _listensock->Accepter(clientaddr);
            if (!sockfd)
                continue;
            LOG(LogLevel::DEBUG) << "get a new link, socket address: " << clientaddr.ToString() << " sockfd: " << sockfd->Sockfd();

            if (fork() == 0)
            {
                // child
                service(sockfd, clientaddr);
                sockfd->Close();
                exit(0);
            }
        }
    }
    ~TcpServer()
    {
    }

private:
    void service(std::shared_ptr<Socket> sockfd, InetAddr &clientaddr)
    {
        std::string inbuffer, outbuffer;
        while (true)
        {
            outbuffer.clear();

            int n = sockfd->Recv(&inbuffer);
            if(n <= 0)
            {
                LOG(LogLevel::WARNING) << "recv: client quit, " << clientaddr.ToString();
                break;
            }

            LOG(LogLevel::DEBUG) << "inbuffer:\n" << inbuffer;

            if(_handler)
                outbuffer += _handler(inbuffer);

            if(outbuffer.empty())
                continue;

            LOG(LogLevel::DEBUG) << "outbuffer:\n" << outbuffer;
            n = sockfd->Send(outbuffer);
            if(n < 0)
            {
                LOG(LogLevel::WARNING) << "send: client quit, " << clientaddr.ToString();
                break;
            }
        }
    }

private:
    uint16_t _port;
    std::unique_ptr<Socket> _listensock;
    Handler_t _handler;
};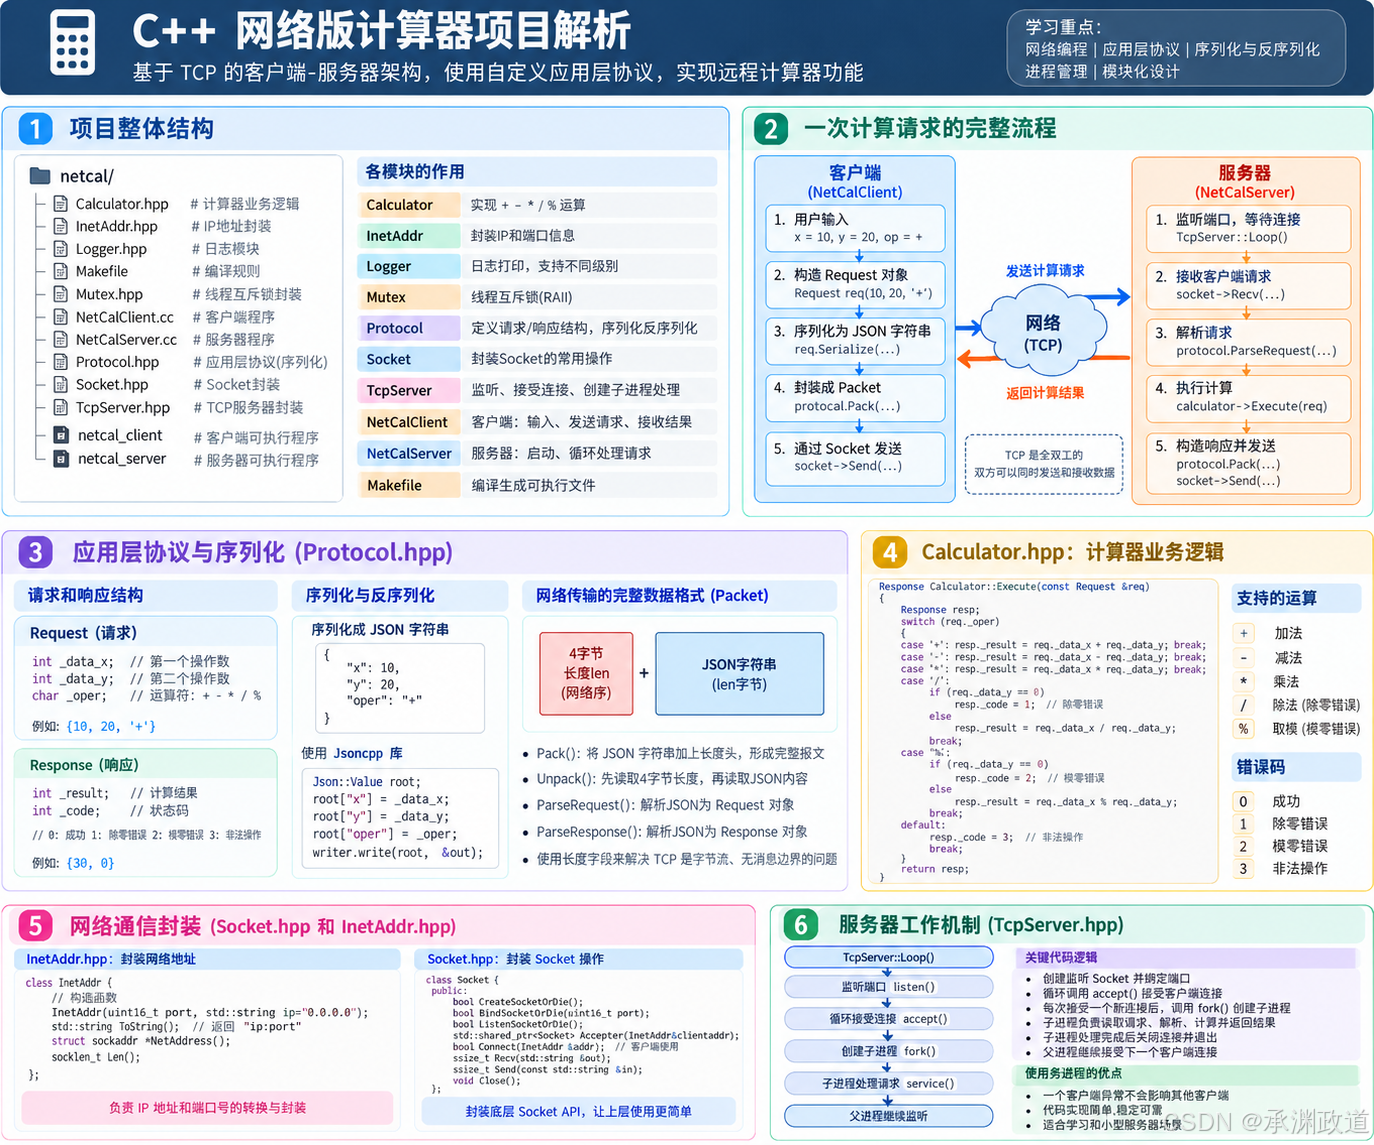
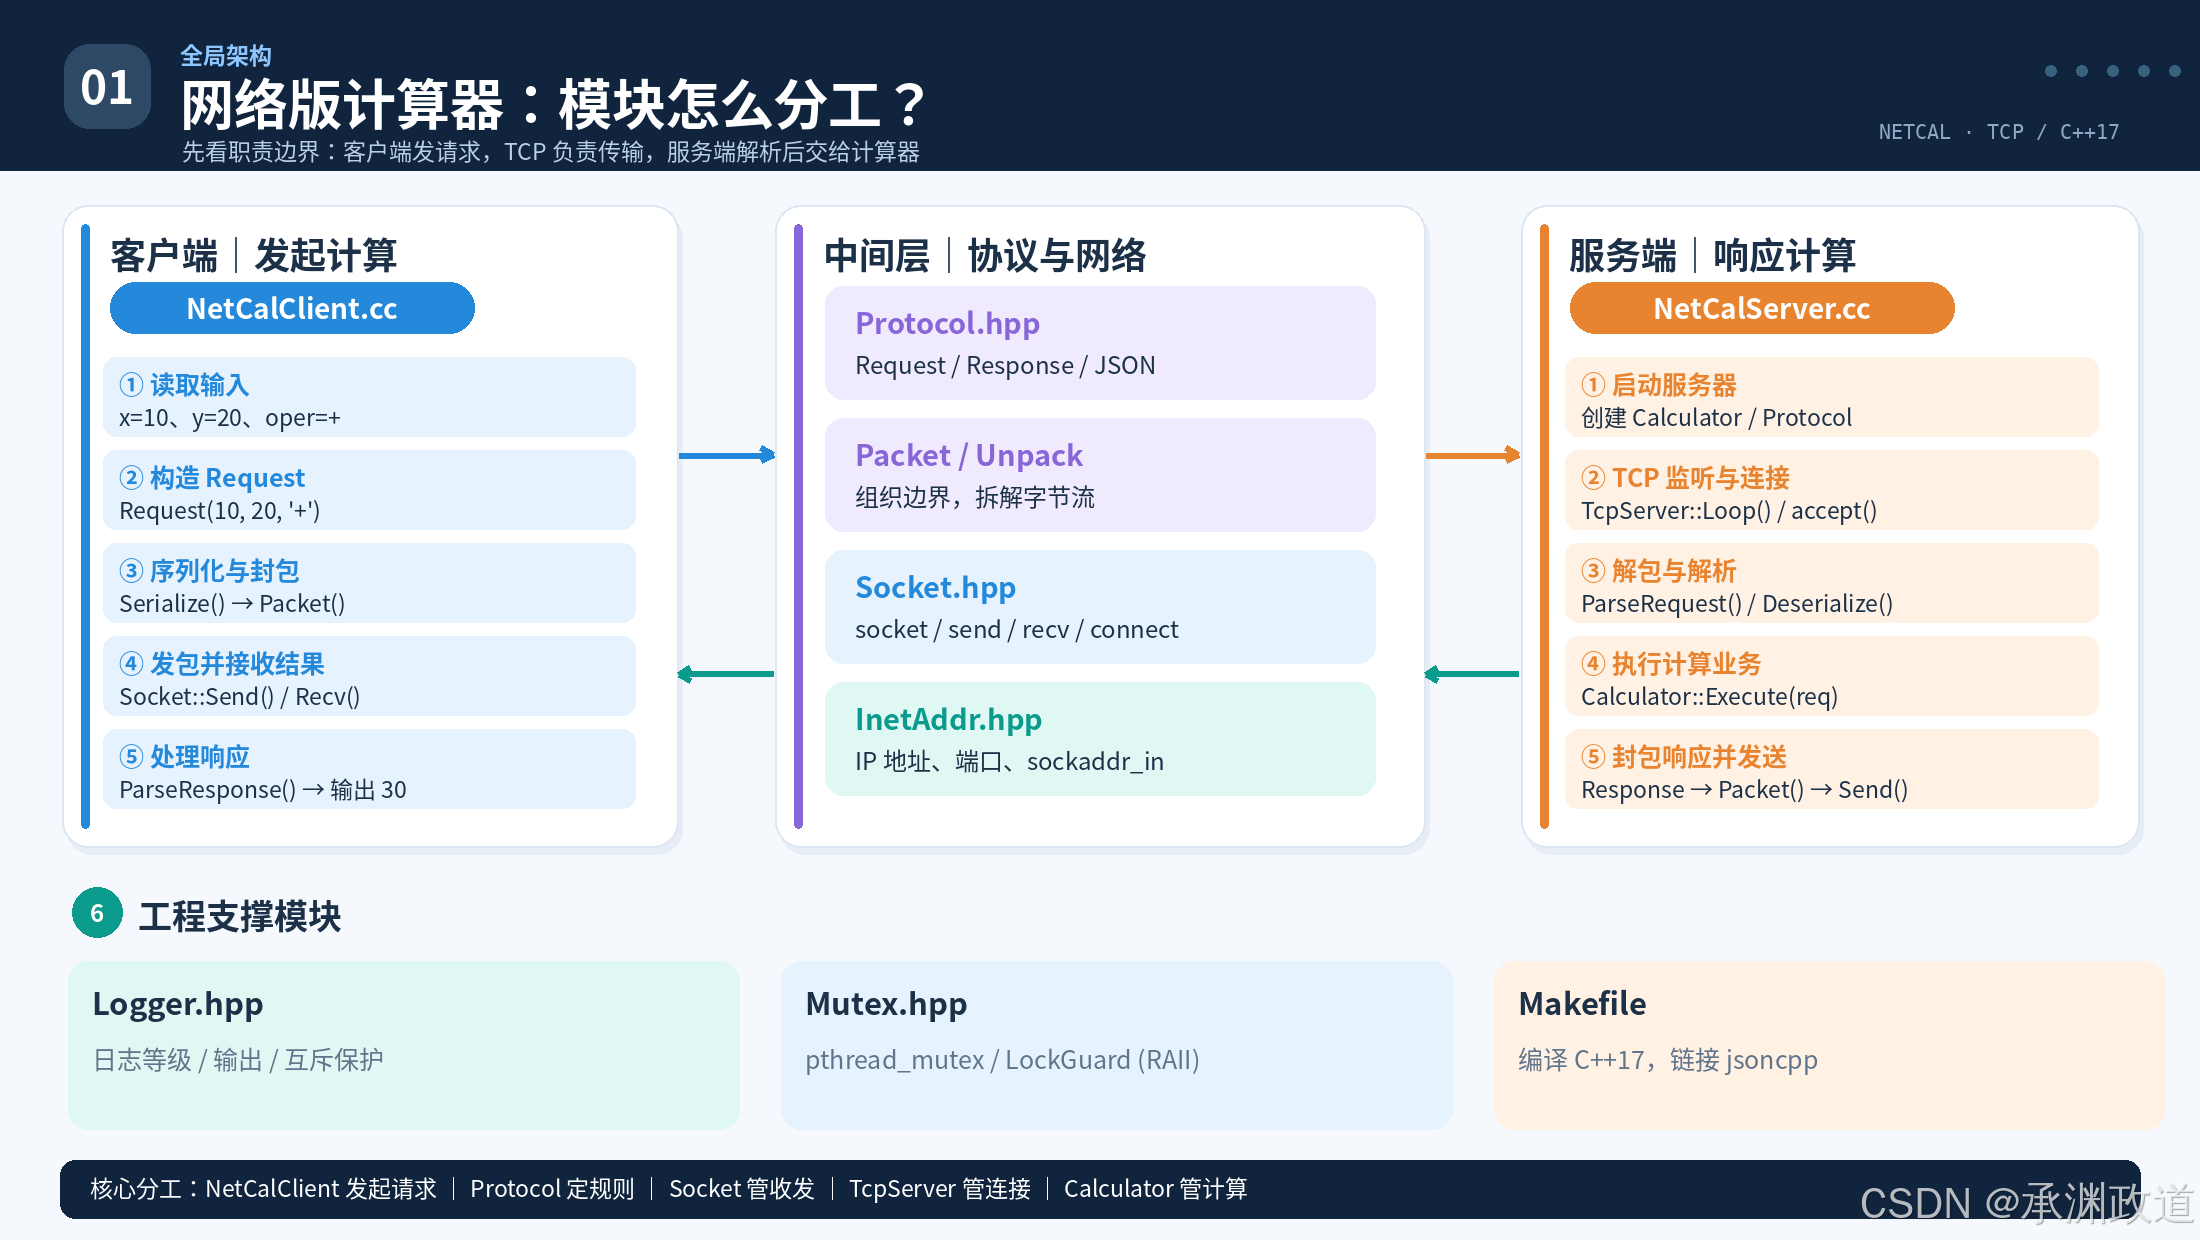
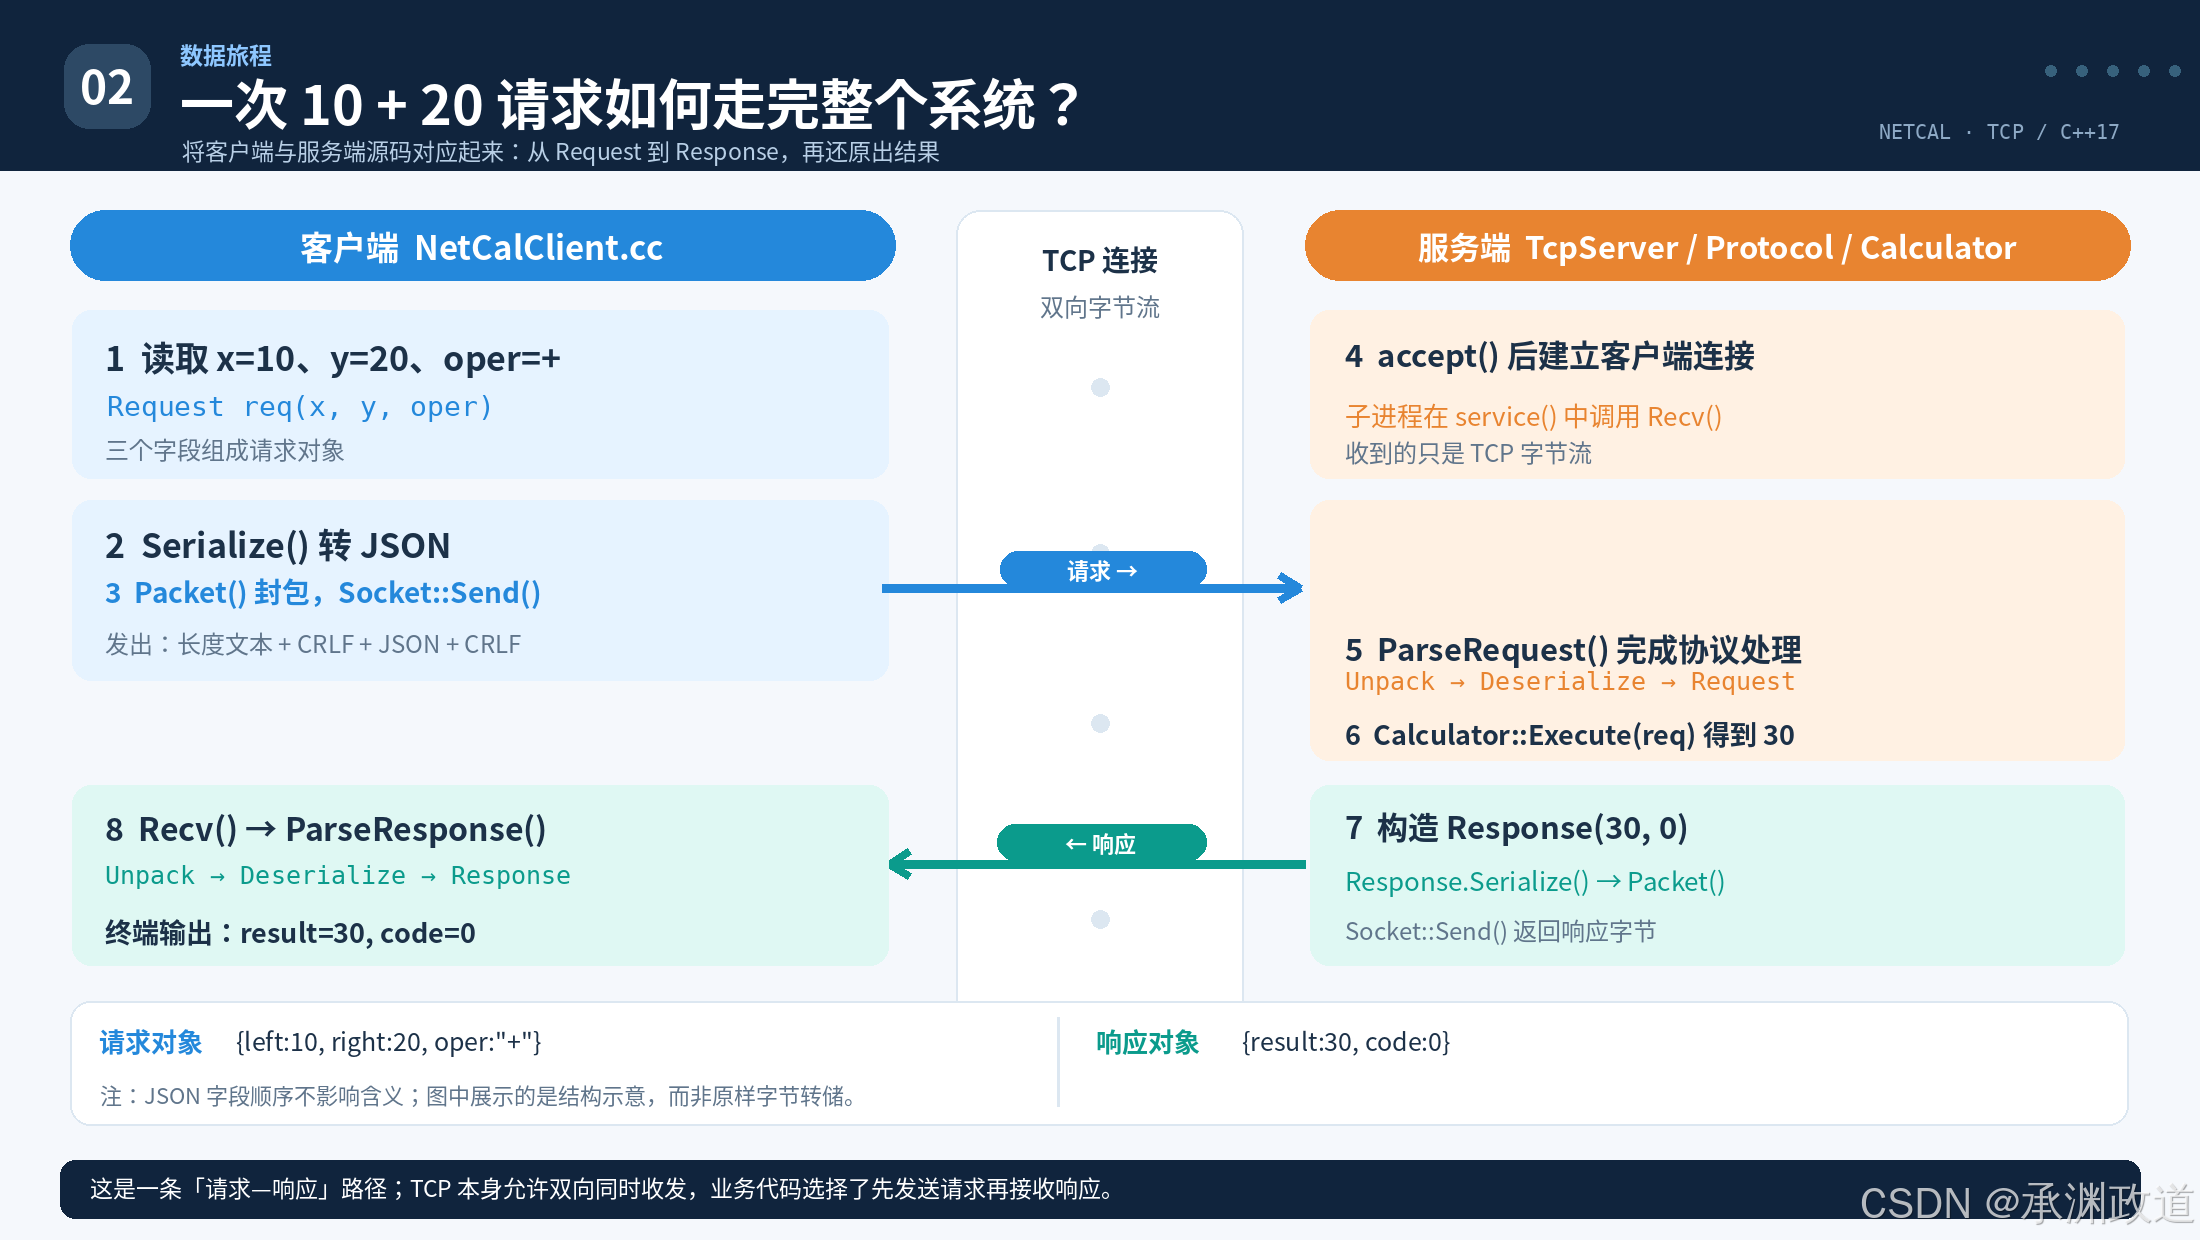
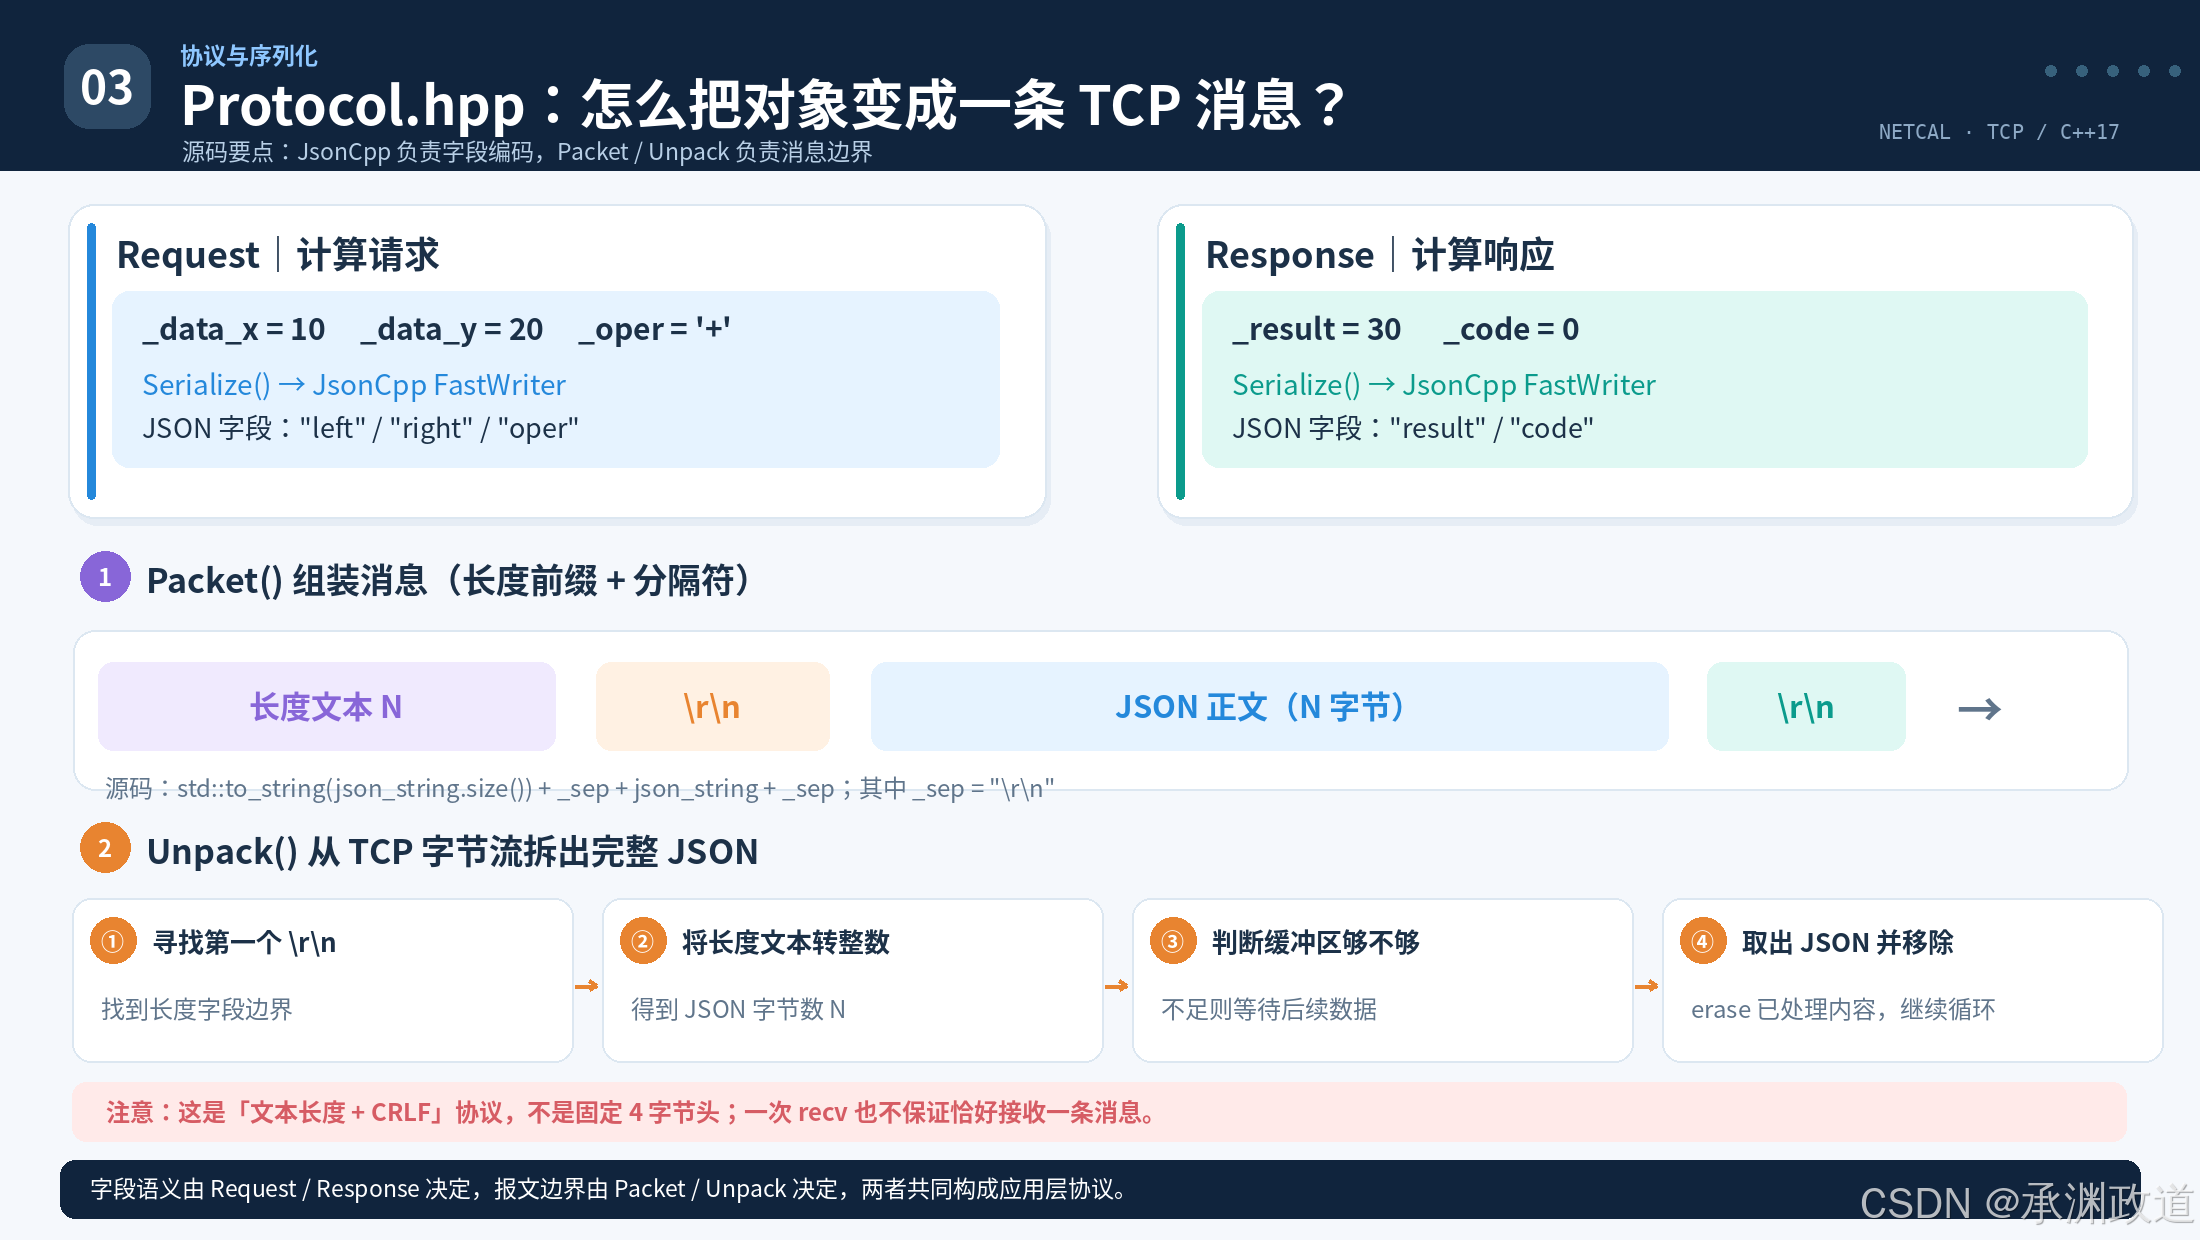
这个项目本质上是在实现一个基于 TCP 的远程计算器.
客户端负责输入数据,服务器负责计算,双方使用自定义应用层协议进行通信.
例如:
客户端:我要计算 10 + 20
              ↓
       通过 TCP 发送请求
              ↓
服务器:收到请求,计算 10 + 20 = 30
              ↓
       通过 TCP 返回结果
              ↓
客户端:显示 result = 30
理解这套代码,关键是搞清楚四件事:模块如何分工、数据如何传输、协议如何解析,以及服务器如何处理多个客户端.
项目整体架构
整个项目可以分成四个部分:
| 部分 | 对应文件 | 负责什么 |
|---|---|---|
| 客户端 | NetCalClient.cc |
输入数据、发送请求、显示结果 |
| 网络通信 | Socket.hpp、InetAddr.hpp |
建立 TCP 连接、收发数据 |
| 应用层协议 | Protocol.hpp |
序列化、封包、解包、反序列化 |
| 服务端 | NetCalServer.cc、TcpServer.hpp、Calculator.hpp |
接收连接、解析请求、执行计算 |
此外,Logger.hpp 负责日志,Mutex.hpp 负责互斥锁封装,Makefile 负责编译项目.
为什么要分成这些模块?
假设我们把所有代码都写在一个文件中,那么这个文件既要管理TCP连接,又要负责JSON解析,还要计算加减乘除.
代码会非常复杂.
现在将其拆开:
Socket.hpp不需要知道发送的是计算请求还是聊天消息,只负责网络通信.Protocol.hpp不需要知道具体怎么做加减乘除,只负责把字节数据解析成请求对象.Calculator.hpp不需要知道 TCP 怎么建立连接,只负责计算.
这就是软件开发中的模块化设计和职责分离.
一次计算请求的完整过程
假设我们在客户端输入:
x = 10
y = 20
oper = +
第一步:客户端构造 Request 对象
对应 NetCalClient.cc:
Request req(x, y, oper);此时程序内部有一个对象:
Request
├── _data_x = 10
├── _data_y = 20
└── _oper   = '+'
这个对象保存在客户端进程的内存中.
但是服务器是另一个进程,甚至可能运行在另一台机器上,无法直接读取客户端内存中的这个对象.
因此必须把它转换成能够通过网络传输的数据.
第二步:序列化
std::string req_json;
req.Serialize(&req_json);
在 Protocol.hpp 中,Request::Serialize() 使用 JsonCpp 将对象转换成 JSON 字符串.
例如:
{"left":10,"right":20,"oper":"+"}注意:C++ 对象内部使用 _data_x、_data_y、_oper,而 JSON 协议使用的是 left、right、oper.
这说明对象的内部成员名称和网络协议字段名称可以不同.
第三步:封包并发送
std::string packet = protocol.Packet(req_json);
socket->Send(packet);
Packet() 会给 JSON 数据添加长度信息和分隔符.
Send() 则通过底层 send() 系统调用,将数据交给内核TCP发送缓冲区.
随后,TCP 协议栈负责通过网络发送数据.
第四步:服务端接收数据
服务器在 TcpServer.hpp 中调用:
sockfd->Recv(&inbuffer);这里收到的是字节流,并不是直接得到 Request 对象.
因此服务器还需要解析协议.
第五步:服务器解析并执行计算
服务器调用:
_handler(inbuffer);这个 _handler 最终关联到:
protocol->ParseRequest(inbuffer);其内部执行过程是:
接收到的字节流
       ↓
Unpack():提取完整消息
       ↓
Deserialize():还原 Request
       ↓
Calculator::Execute(req)
       ↓
计算 10 + 20 = 30
       ↓
生成 Response 对象其中,Calculator::Execute() 使用 switch 判断运算符,执行加减乘除或取模运算.
第六步:服务器返回结果
计算完成后生成响应:
Response
├── _result = 30
└── _code   = 0
其中 code = 0 表示成功.
服务器再次执行:
Response 对象
      ↓
Serialize()
      ↓
Packet()
      ↓
Send()
      ↓
TCP 网络
客户端接收到响应后,通过 ParseResponse() 解析,最终输出:
result: 30 [0]这里的 [0] 就是状态码.
Protocol.hpp 为什么是这个项目的核心?
这是整个项目最值得深入理解的文件.
因为它同时解决两个不同的问题:
第一个问题:如何表示业务数据?
通过 Request 和 Response 的序列化规则实现.
第二个问题:如何从 TCP 字节流中识别完整消息?
通过 Packet() 和 Unpack() 实现.
1.先理解 Packet() 的作用
代码采用的是:
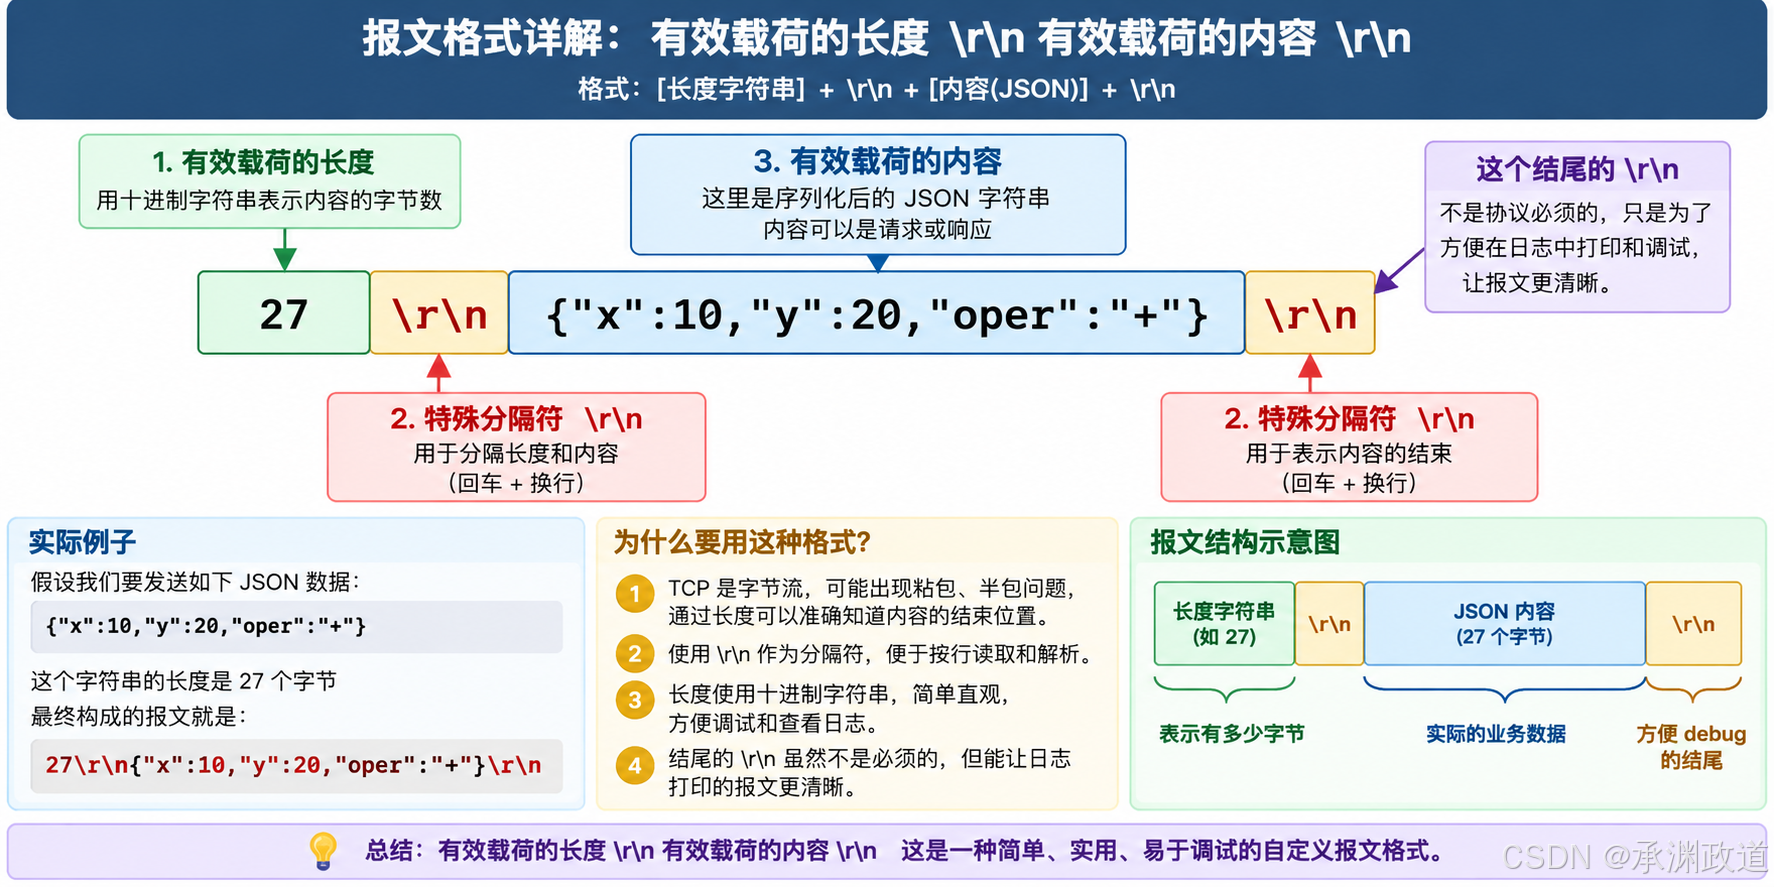
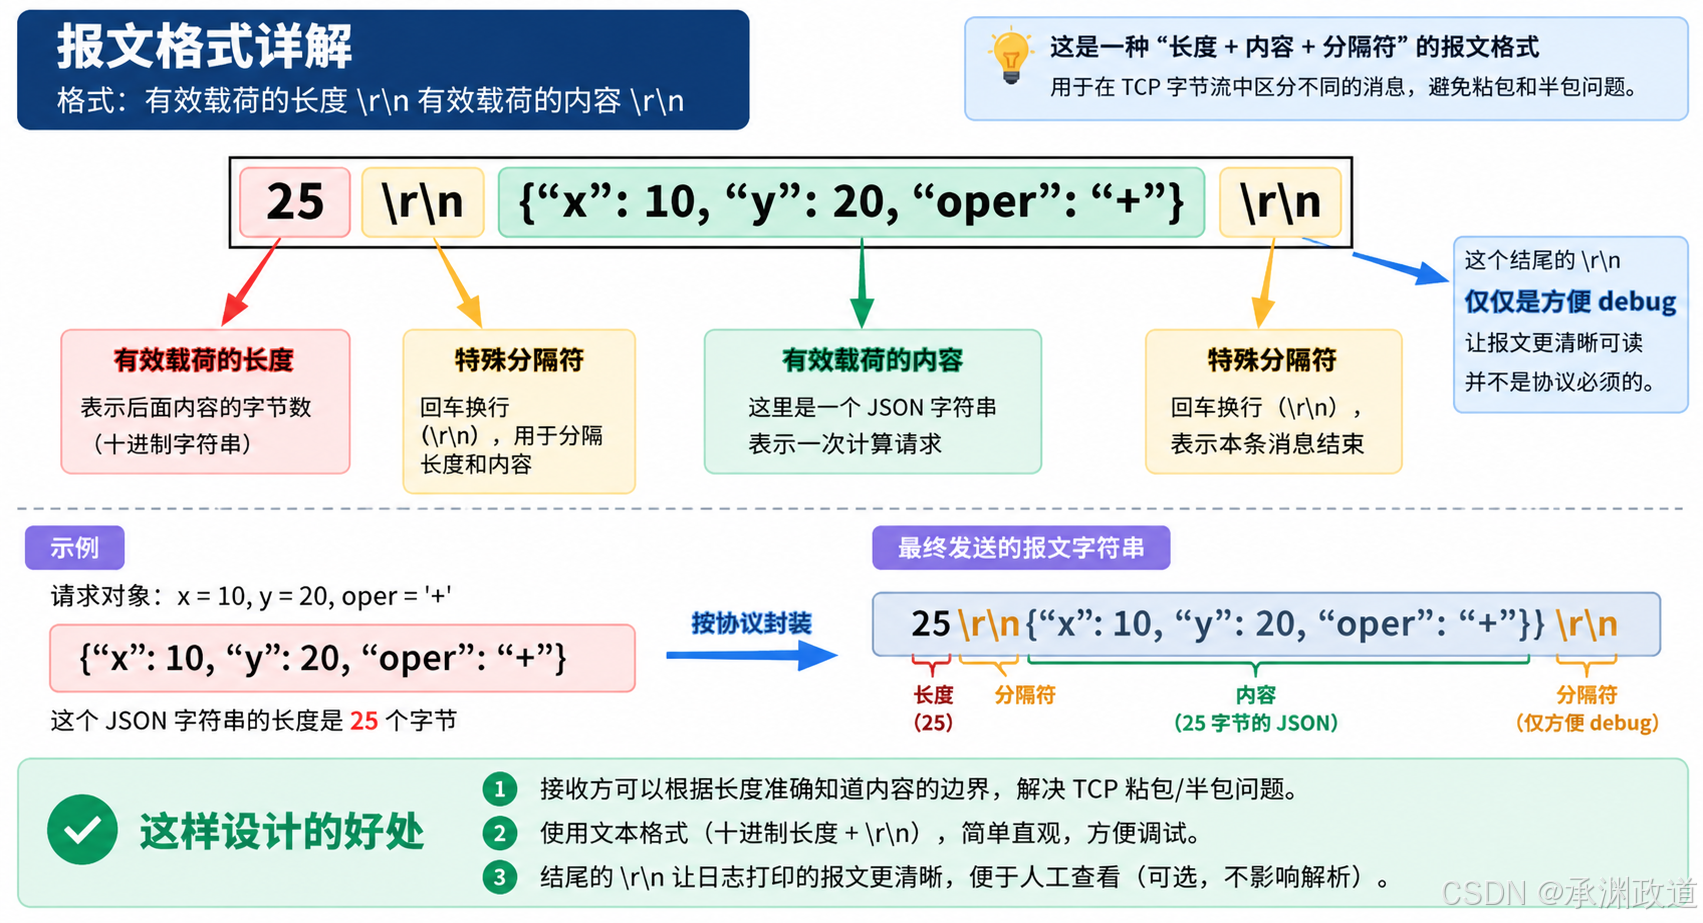
消息长度\r\nJSON正文\r\n这里的消息长度不是固定4字节整数,而是十进制数字组成的文本.
例如,假设某条 JSON 消息有N个字节:
N\r\nJSON数据\r\nN 表示 JSON 正文的实际字节数,由代码计算,而不是接收方自行猜测.
为什么要添加长度?
因为TCP是字节流协议,不保证每次 recv() 都恰好接收到一条完整消息.
假设客户端连续发送三条消息:
请求1 + 请求2 + 请求3服务器可能一次收到三条完整请求,也可能只收到第一条请求的一部分.
这就是通常说的粘包和半包现象.
2.Unpack() 的作用
Unpack() 的职责就是按照之前约定的报文格式,提取完整消息.
它大致执行以下过程:
接收缓冲区
      ↓
寻找第一个 \r\n
      ↓
读取前面的长度字段 N
      ↓
检查缓冲区是否有完整报文
      ↓
如果不完整,等待更多数据
      ↓
如果完整,提取 N 字节 JSON
      ↓
从缓冲区移除已处理报文
这就解决了消息边界问题.
3.ParseRequest() 的作用
ParseRequest() 比 Unpack() 更进一步.
它不仅要提取消息,还要执行具体的业务处理:
Unpack()
   ↓
Request::Deserialize()
   ↓
Calculator::Execute()
   ↓
Response::Serialize()
   ↓
Packet()
   ↓
返回响应报文
尤其要注意,你的 ParseRequest() 内部使用循环,可以连续处理缓冲区中已经收到的多条完整请求.
实际上,NetCalClient.cc 中就有一个 cnt = 3 的循环,会先构造三条计算请求,再组合到一个发送缓冲区中发送.
这正好体现了:一次 send() 可以包含多条应用层消息,一次 recv() 也不一定收到完整的一条消息.
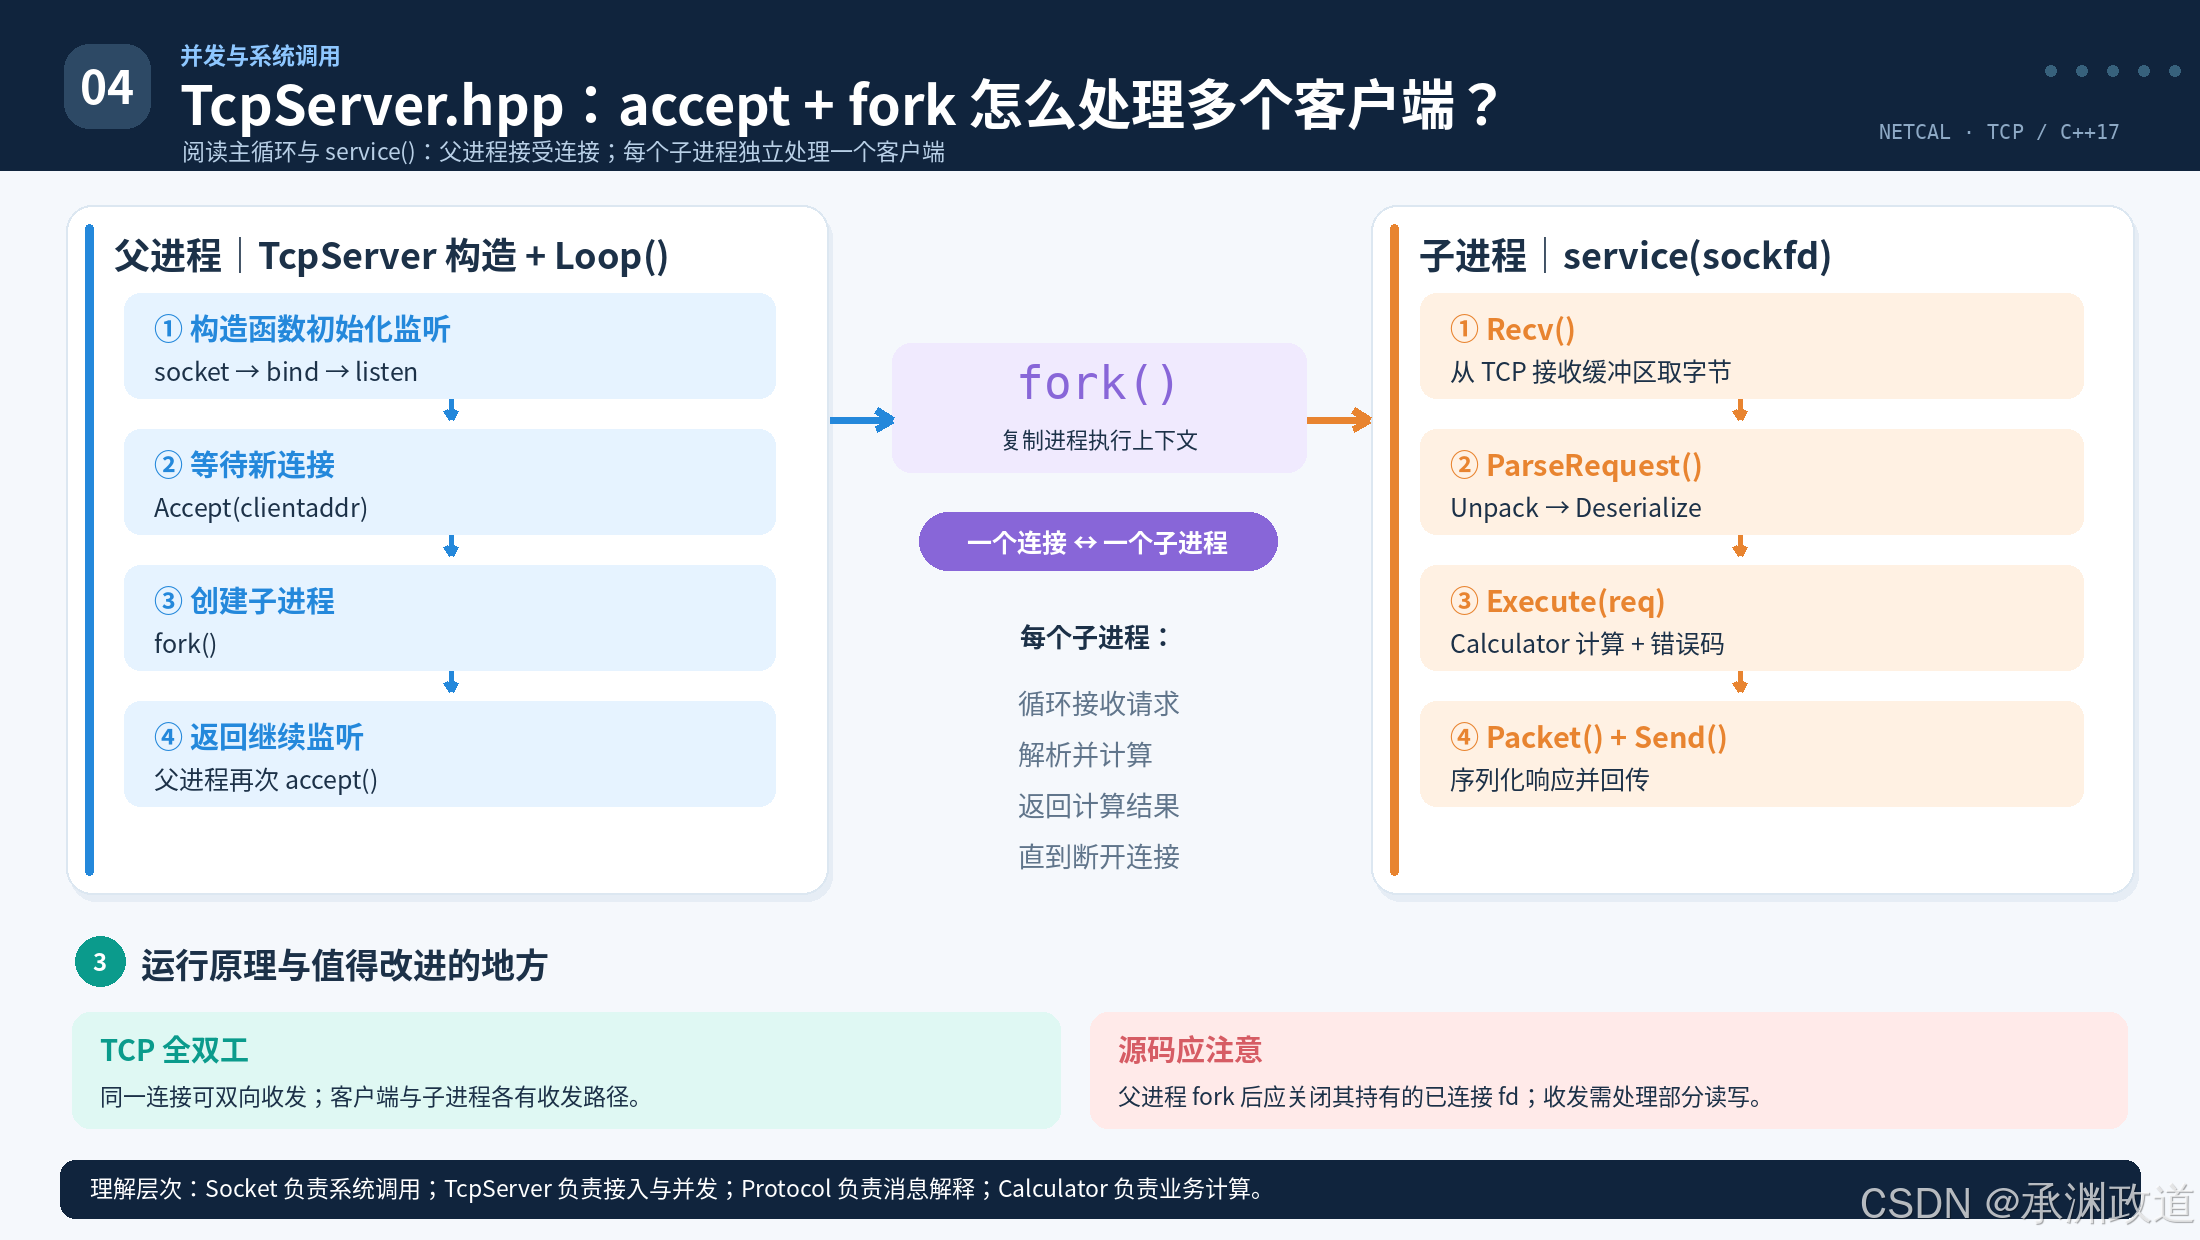
TcpServer.hpp 与 fork() 多进程
这个部分主要解决:
当多个客户端同时连接服务器时,服务器应该如何处理?
1.服务器首先启动监听
在 NetCalServer.cc 中,程序创建计算器对象、协议对象和TCP服务器对象.
随后执行:
tsvr->Loop();进入服务器的主循环.
底层依次使用:
socket()
   ↓
bind()
   ↓
listen()
   ↓
accept()
这里:
socket()创建 Socket.bind()绑定服务器 IP 和端口.listen()让 Socket 进入监听状态.accept()接受新的客户端连接.
2.为什么需要 fork()?
假设现在有三个客户端:
客户端 A ───┐
客户端 B ───┼──→ TCP 服务器
客户端 C ───┘
如果服务器在接受客户端 A 后,一直在当前进程中处理它的请求,就可能无法及时接受B、C的连接.
因此,你的服务器采用 fork() 创建子进程.
if (fork() == 0)
{
    service(sockfd, clientaddr);
    sockfd->Close();
    exit(0);
}
fork() 会创建一个子进程.
父进程继续执行 accept(),接收新的连接.
子进程则执行 service(),专门处理当前客户端.
可以理解为:
              服务器父进程
                   │
               accept()
                   │
           客户端 A 连接
                   │
                fork()
              ┌────┴────┐
              ▼         ▼
          父进程      子进程 A
              │         │
        继续 accept   处理客户端 A
              │
           客户端 B
              │
            fork()
           ┌──┴────┐
           ▼       ▼
         父进程   子进程 B
           │       │
       继续监听   处理客户端 B
这样,不同子进程就可以并发处理不同客户端.
3.service() 在做什么?
service() 中有一个循环,核心流程是:
Recv()
  ↓
读取客户端数据
  ↓
_handler(inbuffer)
  ↓
协议解析 + 执行计算 + 组织响应
  ↓
Send(outbuffer)
  ↓
等待下一次请求
这里最重要的是 _handler.
它的类型定义为:
using Handler_t =
    std::function<std::string(std::string&)>;
也就是说:
服务器并不需要知道 _handler 内部一定是计算器.
只需要知道:给它一段请求数据,它就会返回一段响应数据.
至于如何计算,由传入的回调函数决定.
这种设计也叫做回调机制,使TCP服务器框架与具体业务逻辑分离.
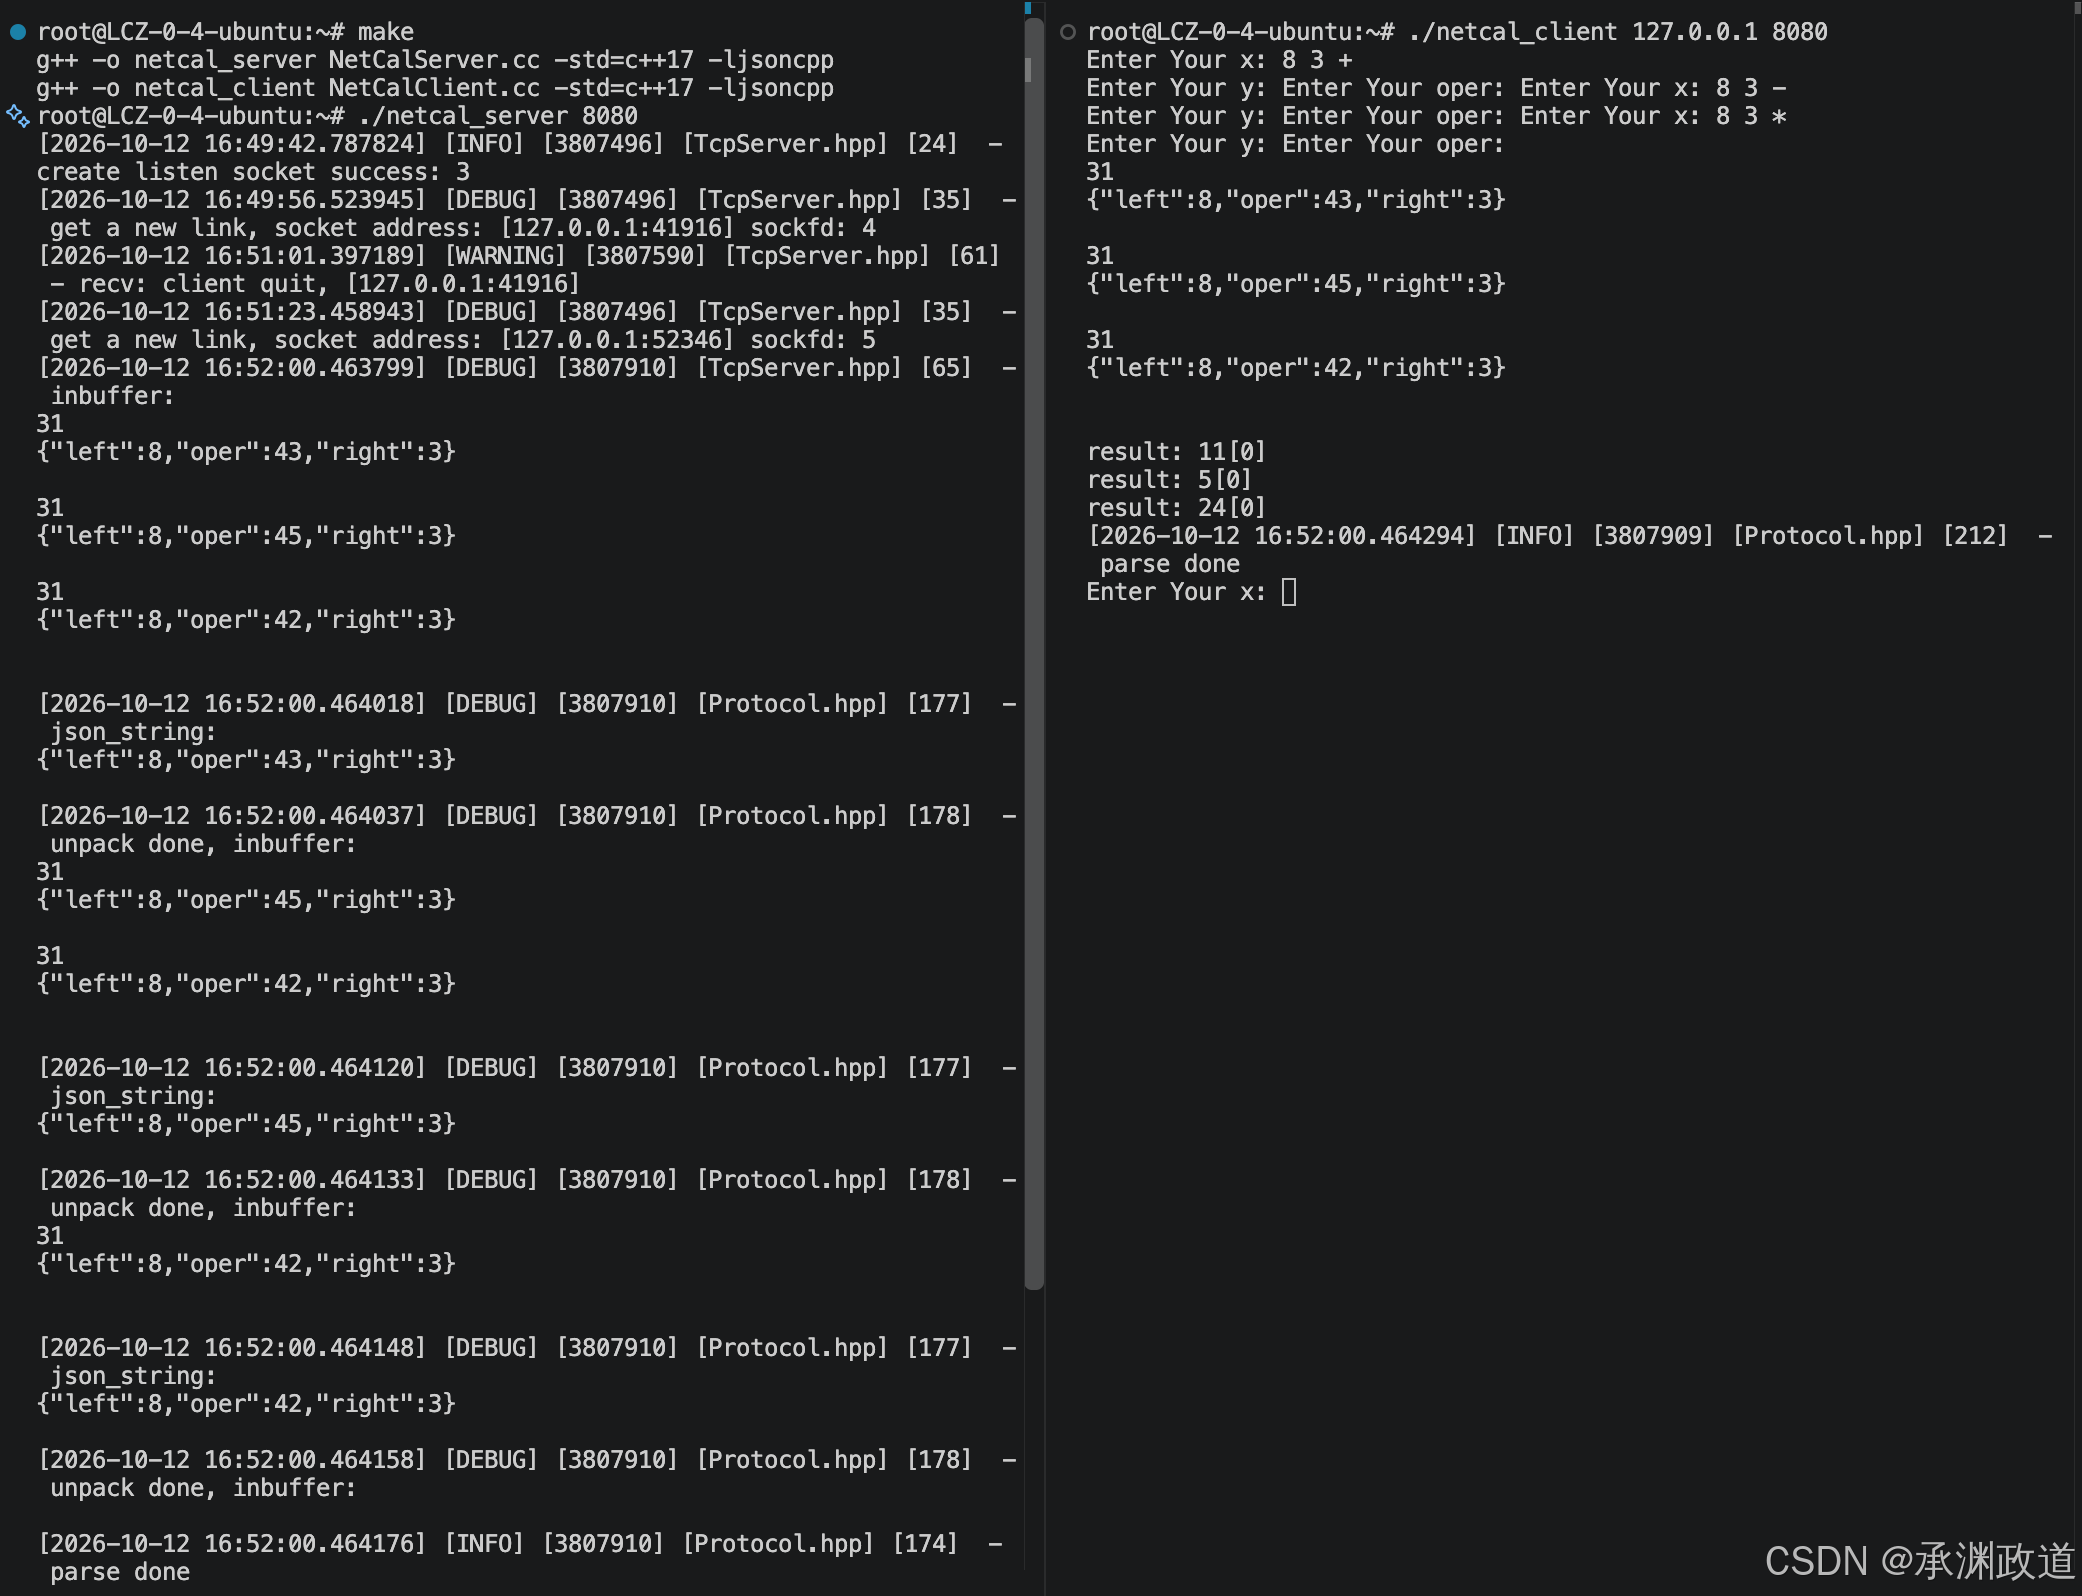
期望的报⽂格式:
测试运行结果:
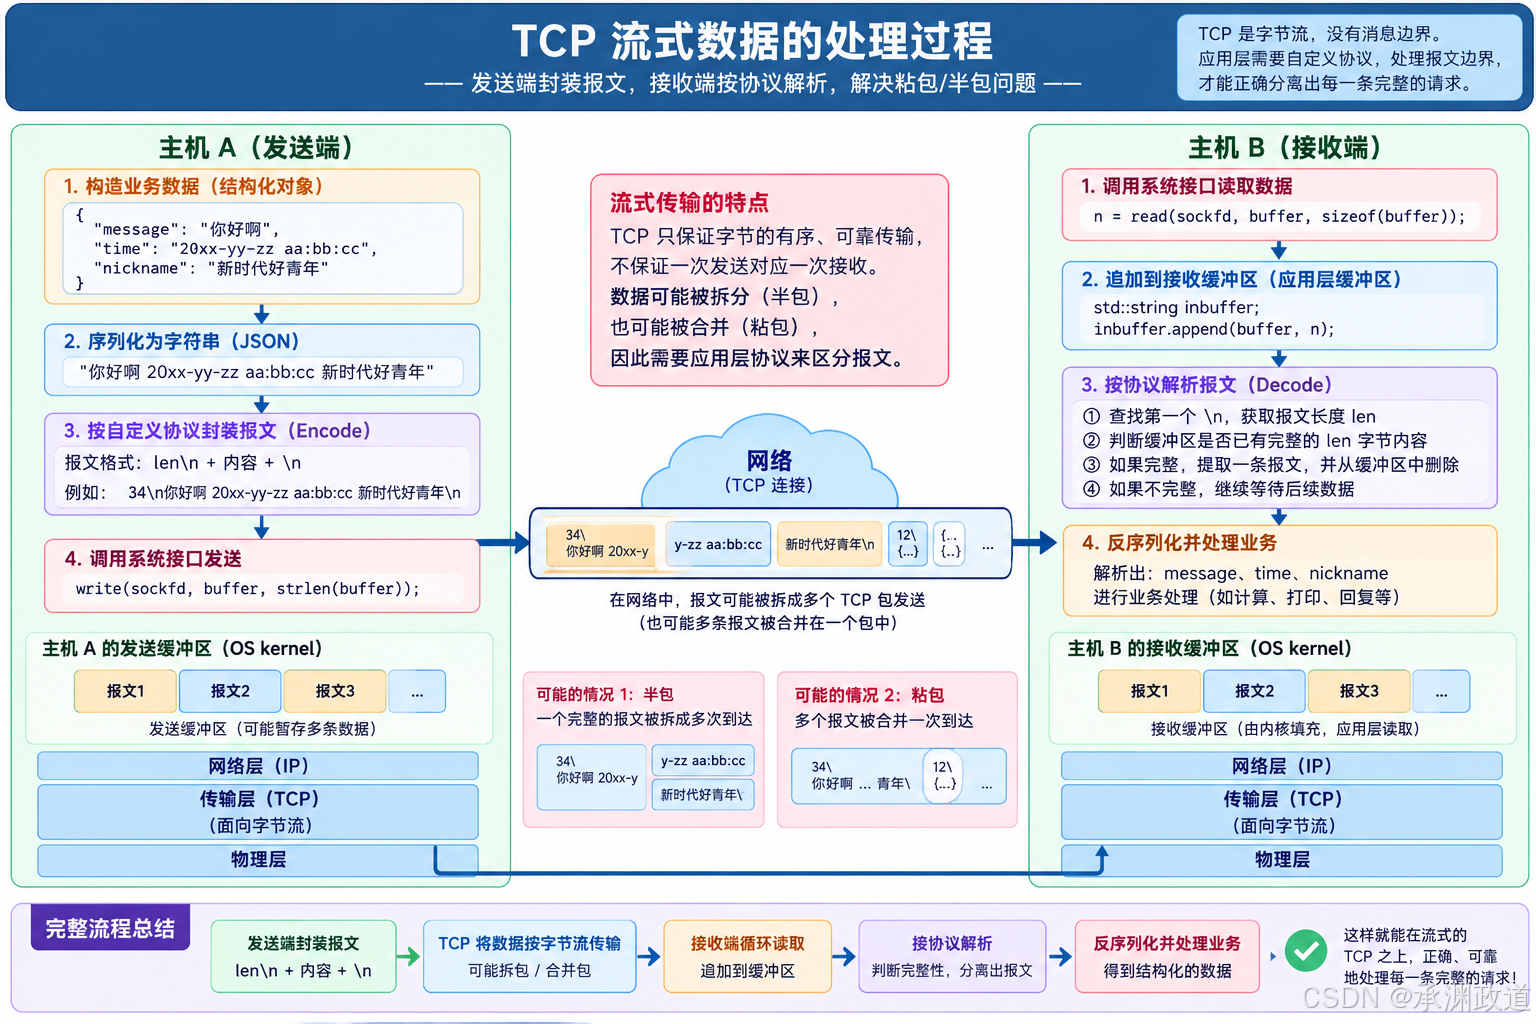
1.4关于流式数据的处理
1.如何保证每次读取都能读完请求缓冲区的所有内容?
无法保证.
因为TCP是面向字节流的,一次 recv() 不一定能读取到所有数据,可能只读取一部分,也可能读取多条请求的数据.
解决方法: 使用循环读取,将每次收到的数据追加到应用层缓冲区,直到获得完整请求.
2.如何保证读取到的是一个完整的请求?
通过应用层自定义协议来判断.
例如,你的项目采用:
有效载荷长度\r\n有效载荷内容\r\n接收方按照协议解析:
- 先找到第一个
\r\n,获取有效载荷长度 N. - 判断缓冲区是否包含完整的 N 字节载荷及末尾分隔符.
- 如果数据不完整,就继续
recv(). - 如果数据完整,就提取一条请求,剩余数据留在缓冲区等待解析.
总结:TCP不保证一次读取就是一条完整消息;我们通过循环接收、缓冲区管理和应用层协议解决TCP粘包、半包问题.
1.5Jsoncpp
Jsoncpp是⼀个⽤于处理JSON数据的C++库.它提供了将 JSON 数据序列化为字符串以及从字符串反序列化为C++数据结构的功能.Jsoncpp是开源的,⼴泛⽤于各种需要处理JSON数据的 C++ 项⽬中.
特性
- 简单易⽤:Jsoncpp 提供了直观的API,使得处理JSON数据变得简单.
- ⾼性能:Jsoncpp 的性能经过优化,能够⾼效地处理⼤量JSON数据.
- 全⾯⽀持:⽀持 JSON 标准中的所有数据类型,包括对象、数组、字符串、数字、布尔值和null.
- 错误处理:在解析JSON数据时,Jsoncpp提供了详细的错误信息和位置,⽅便开发者调试.当使⽤Jsoncpp库进⾏JSON的序列化和反序列化时,确实存在不同的做法和⼯具类可供选择.以下是对Jsoncpp中序列化和反序列化操作的详细介绍.
安装
bash
ubuntu:sudo apt-get install libjsoncpp-dev
Centos: sudo yum install jsoncpp-devel
序列化
序列化指的是将数据结构或对象转换为⼀种格式,以便在⽹络上传输或存储到⽂件中.Jsoncpp提供了多种⽅式进⾏序列化:
1.使⽤ Json::Value的toStyledString⽅法:
优点:将 Json::Value 对象直接转换为格式化的JSON字符串.
示例:
cpp
#include <iostream>
#include <string>
#include <jsoncpp/json/json.h>
int main()
{
Json::Value root;
root["name"] = "joe";
root["sex"] = "男";
std::string s = root.toStyledString();
std::cout << s << std::endl;
return 0;
}
2.使⽤ Json::StreamWriter :
优点:提供了更多的定制选项,如缩进、换⾏符等.
示例:
cpp
#include <iostream>
#include <string>
#include <sstream>
#include <memory>
#include <jsoncpp/json/json.h>
int main()
{
Json::Value root;
root["name"] = "joe";
root["sex"] = "男";
Json::StreamWriterBuilder wbuilder; // StreamWriter的⼯⼚
std::unique_ptr<Json::StreamWriter>
writer(wbuilder.newStreamWriter());
std::stringstream ss;
writer->write(root, &ss);
std::cout << ss.str() << std::endl;
return 0;
}
3.使⽤ Json::FastWriter :
优点:⽐ StyledWriter 更快,因为它不添加额外的空格和换⾏符.
示例:
cpp
#include <iostream>
#include <string>
#include <sstream>
#include <memory>
#include <jsoncpp/json/json.h>
int main()
{
Json::Value root;
root["name"] = "joe";
root["sex"] = "男";
Json::FastWriter writer;
std::string s = writer.write(root);
std::cout << s << std::endl;
return 0;
}

#include <iostream>
#include <string>
#include <sstream>
#include <memory>
#include <jsoncpp/json/json.h>
int main()
{
Json::Value root;
root["name"] = "joe";
root["sex"] = "男";
// Json::FastWriter writer;
Json::StyledWriter writer;
std::string s = writer.write(root);
std::cout << s << std::endl;
return 0;
}
反序列化
反序列化指的是将序列化后的数据重新转换为原来的数据结构或对象.Jsoncpp提供了以下⽅法进⾏反序列化:
1.使⽤Json::Reader :
优点:提供详细的错误信息和位置,⽅便调试.
示例:
cpp
#include <iostream>
#include <string>
#include <jsoncpp/json/json.h>
int main() {
// JSON 字符串
std::string json_string = "{\"name\":\"张三\", \"age\":30,
\"city\":\"北京\"}";
// 解析 JSON 字符串
Json::Reader reader;
Json::Value root;
// 从字符串中读取 JSON 数据
bool parsingSuccessful = reader.parse(json_string, root);
if (!parsingSuccessful) {
// 解析失败,输出错误信息
std::cout << "Failed to parse JSON: " <<
reader.getFormattedErrorMessages() << std::endl;
return 1;
}
// 访问 JSON 数据
std::string name = root["name"].asString();
int age = root["age"].asInt();
std::string city = root["city"].asString();
// 输出结果
std::cout << "Name: " << name << std::endl;
std::cout << "Age: " << age << std::endl;
std::cout << "City: " << city << std::endl;
return 0;
}
2.使⽤ Json::CharReader 的派⽣类(不推荐了,上⾯的⾜够了)
在某些情况下,你可能需要更精细地控制解析过程,可以直接使⽤ Json::CharReader 的派
⽣类.但通常情况下,使⽤ Json::parseFromStream或Json::Reader的parse⽅法就⾜够了.
总结:toStyledString 、 StreamWriter和FastWriter提供了不同的序列化选项,你可以根据具体需求选择使⽤.
1.6Json::Value
1.什么是 Json::Value?
Json::Value 是 JsonCpp 库提供的一个类,用来在C++程序中表示和操作JSON数据.
简单理解:它相当于一个容器,可以存储JSON对象、数组、字符串、数字等数据.
例如,我们的网络计算器需要传输:
{
  "left": 10,
  "right": 20,
  "oper": "+"
}
在C++中,可以使用 Json::Value 构造这个JSON对象.
2.Json::Value 怎么使用?
#include <jsoncpp/json/json.h>

Json::Value root;

// 添加数据
root["left"] = 10;
root["right"] = 20;
root["oper"] = "+";
这段代码相当于创建了一个 JSON 对象:
        Json::Value root
                │
       ┌────────┼────────┐
       ▼        ▼        ▼
     left     right     oper
       │        │        │
       10       20       "+"
这里:
root是一个Json::Value对象.root["left"]表示访问或设置left字段.root["right"]表示访问或设置right字段.root["oper"]表示访问或设置oper字段.
3.Json::Value 与序列化有什么关系?
在网络计算器项目中:
Json::Value root;

root["left"] = _data_x;
root["right"] = _data_y;
root["oper"] = std::string(1, _oper);

Json::FastWriter writer;

std::string json_string = writer.write(root);
整个过程:
C++ Request 对象
    │
    │ _data_x = 10
    │ _data_y = 20
    │ _oper = '+'
    ▼
Json::Value root
    │
    │ root["left"] = 10
    │ root["right"] = 20
    │ root["oper"] = "+"
    ▼
Json::FastWriter
    │
    │ 序列化
    ▼
JSON 字符串
{"left":10,"right":20,"oper":"+"}
    │
    ▼
应用层协议封包
    │
    ▼
TCP 网络发送
这里有两个关键概念:
Json::Value: 用来组织和保存 JSON 数据.
Json::FastWriter: 将 Json::Value 转换成 JSON 字符串,也就是进行序列化.
注意:FastWriter 默认会在输出末尾添加换行符,实际封包长度需要根据生成的字符串计算.
4.反序列化时 Json::Value 又有什么作用?
服务器收到JSON字符串后,可以进行反序列化:
std::string json_string =
    R"({"left":10,"right":20,"oper":"+"})";

Json::Value root;
Json::Reader reader;

// 将 JSON 字符串解析到 root
if (reader.parse(json_string, root))
{
    int x = root["left"].asInt();
    int y = root["right"].asInt();
    std::string op = root["oper"].asString();
}
其中:
reader.parse():把 JSON 字符串解析成Json::Value.asInt():获取整数.asString():获取字符串.
实际项目中还应检查字段是否存在、类型是否正确.
5.重点区分这三个概念
| 类型 | 作用 |
|---|---|
Json::Value |
在内存中表示 JSON 数据 |
Json::FastWriter |
将 JSON 数据序列化为字符串 |
Json::Reader |
将 JSON 字符串解析成 JSON 数据 |
FastWriter 和 Reader 是 JsonCpp 较早的接口,在新代码中也可以使用 StreamWriterBuilder、CharReaderBuilder 等接口.
一句话总结:Json::Value 就是C++程序中存储和操作JSON数据的对象,配合 Writer 和 Reader,可以完成网络通信中的序列化与反序列化.
二、⼿写序列化与反序列化
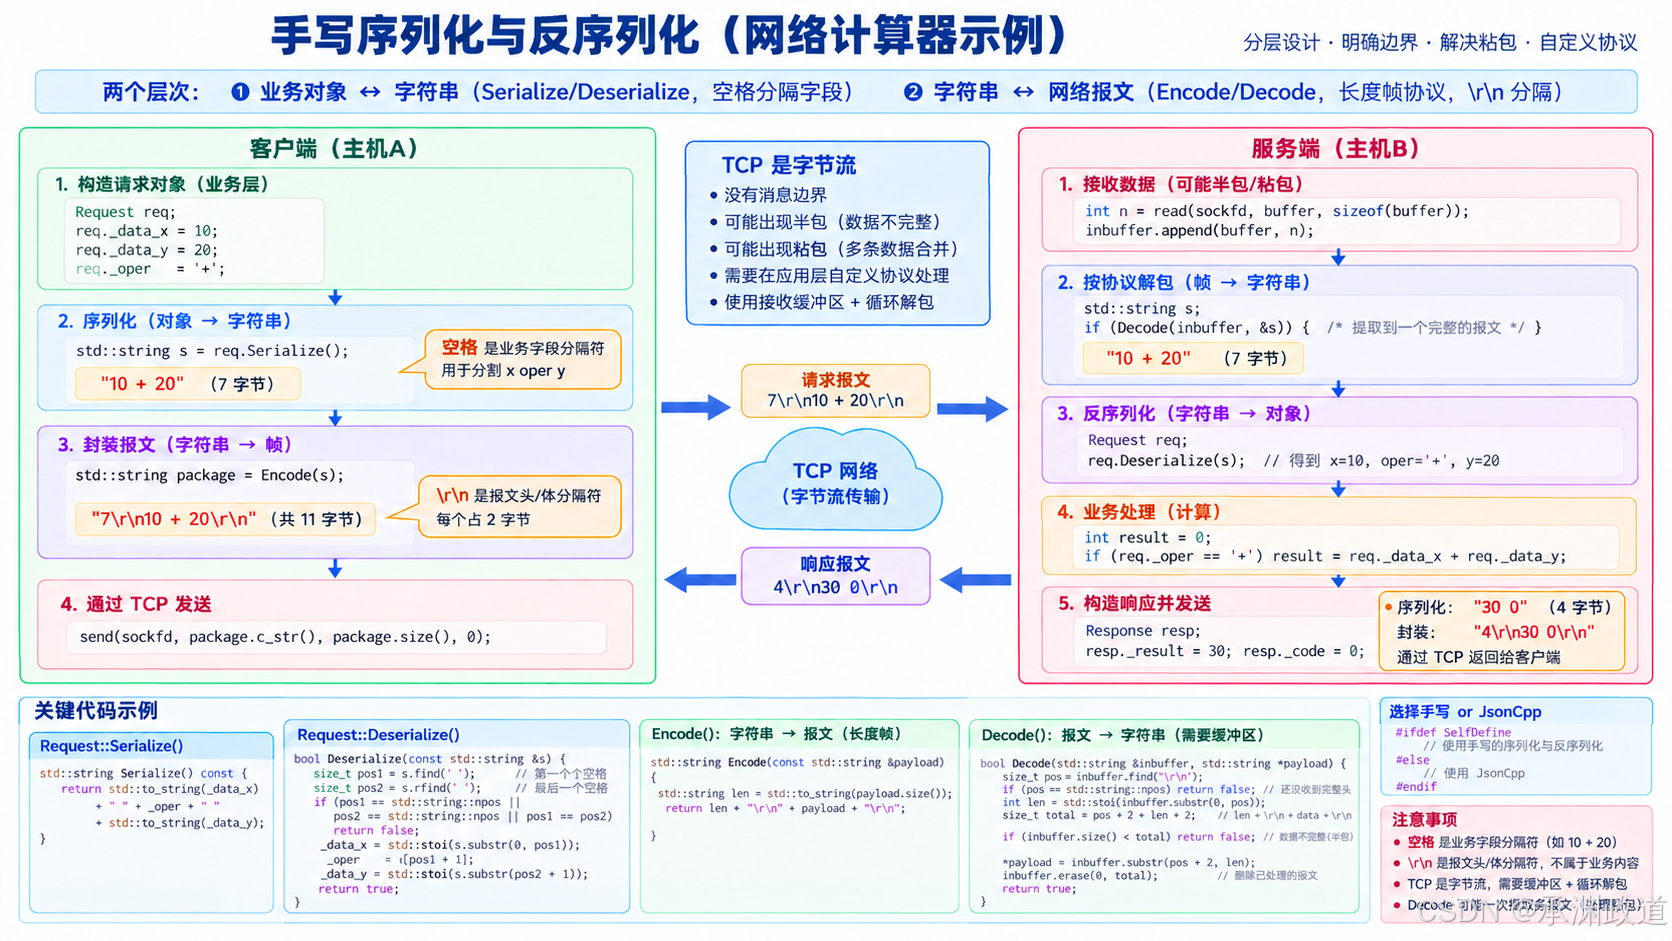
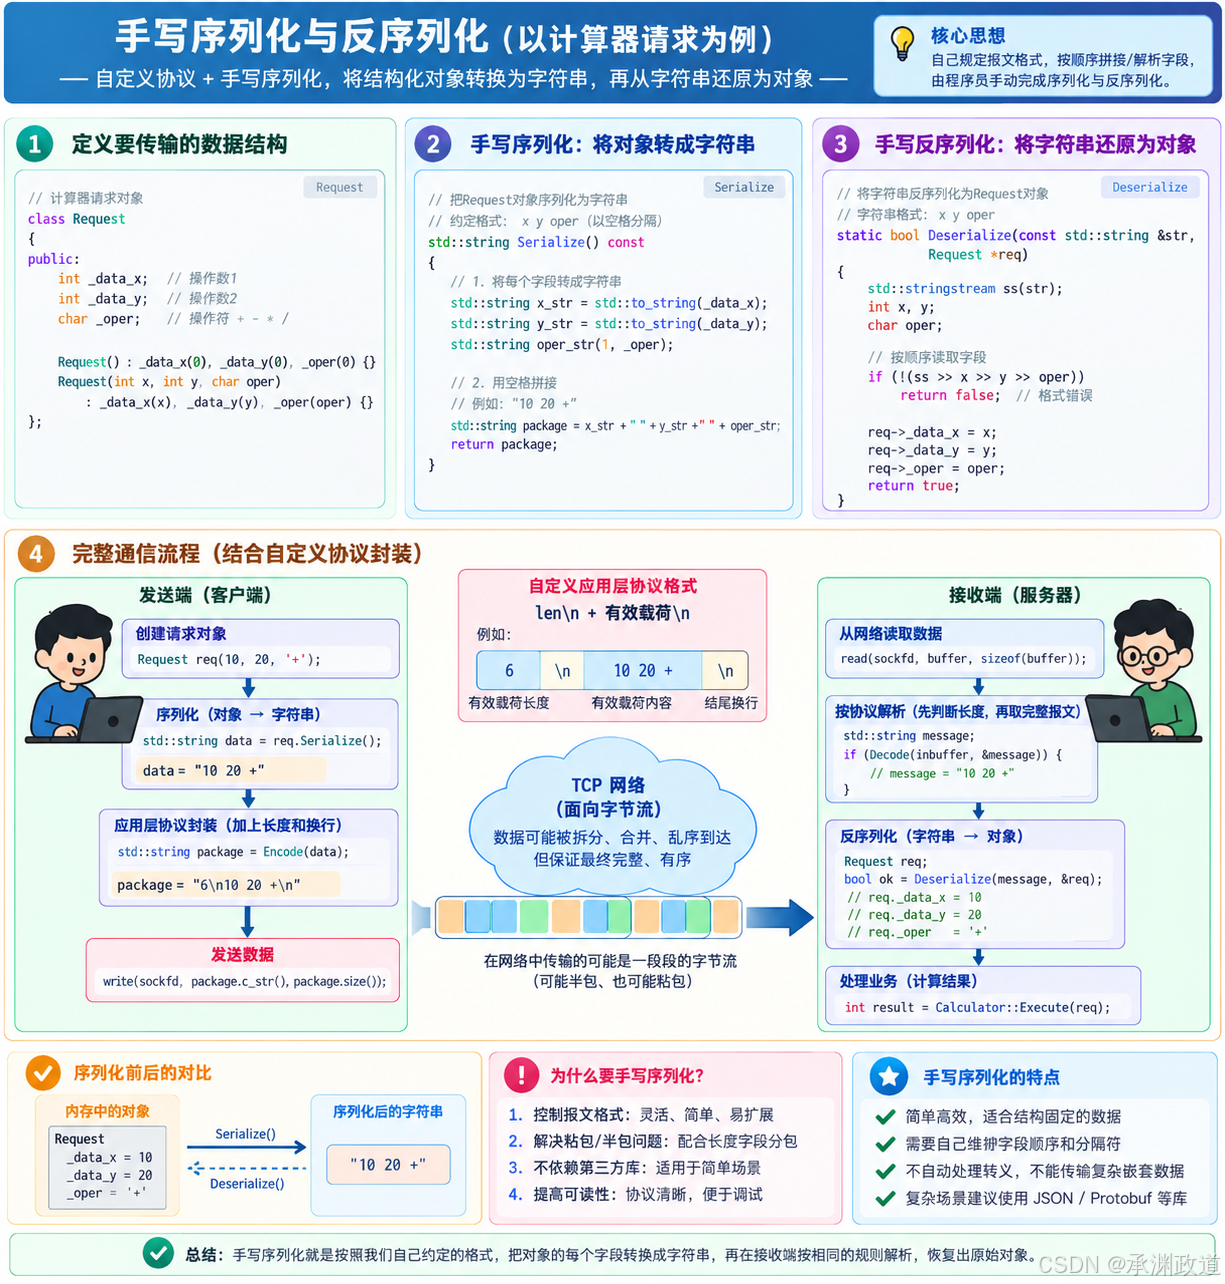
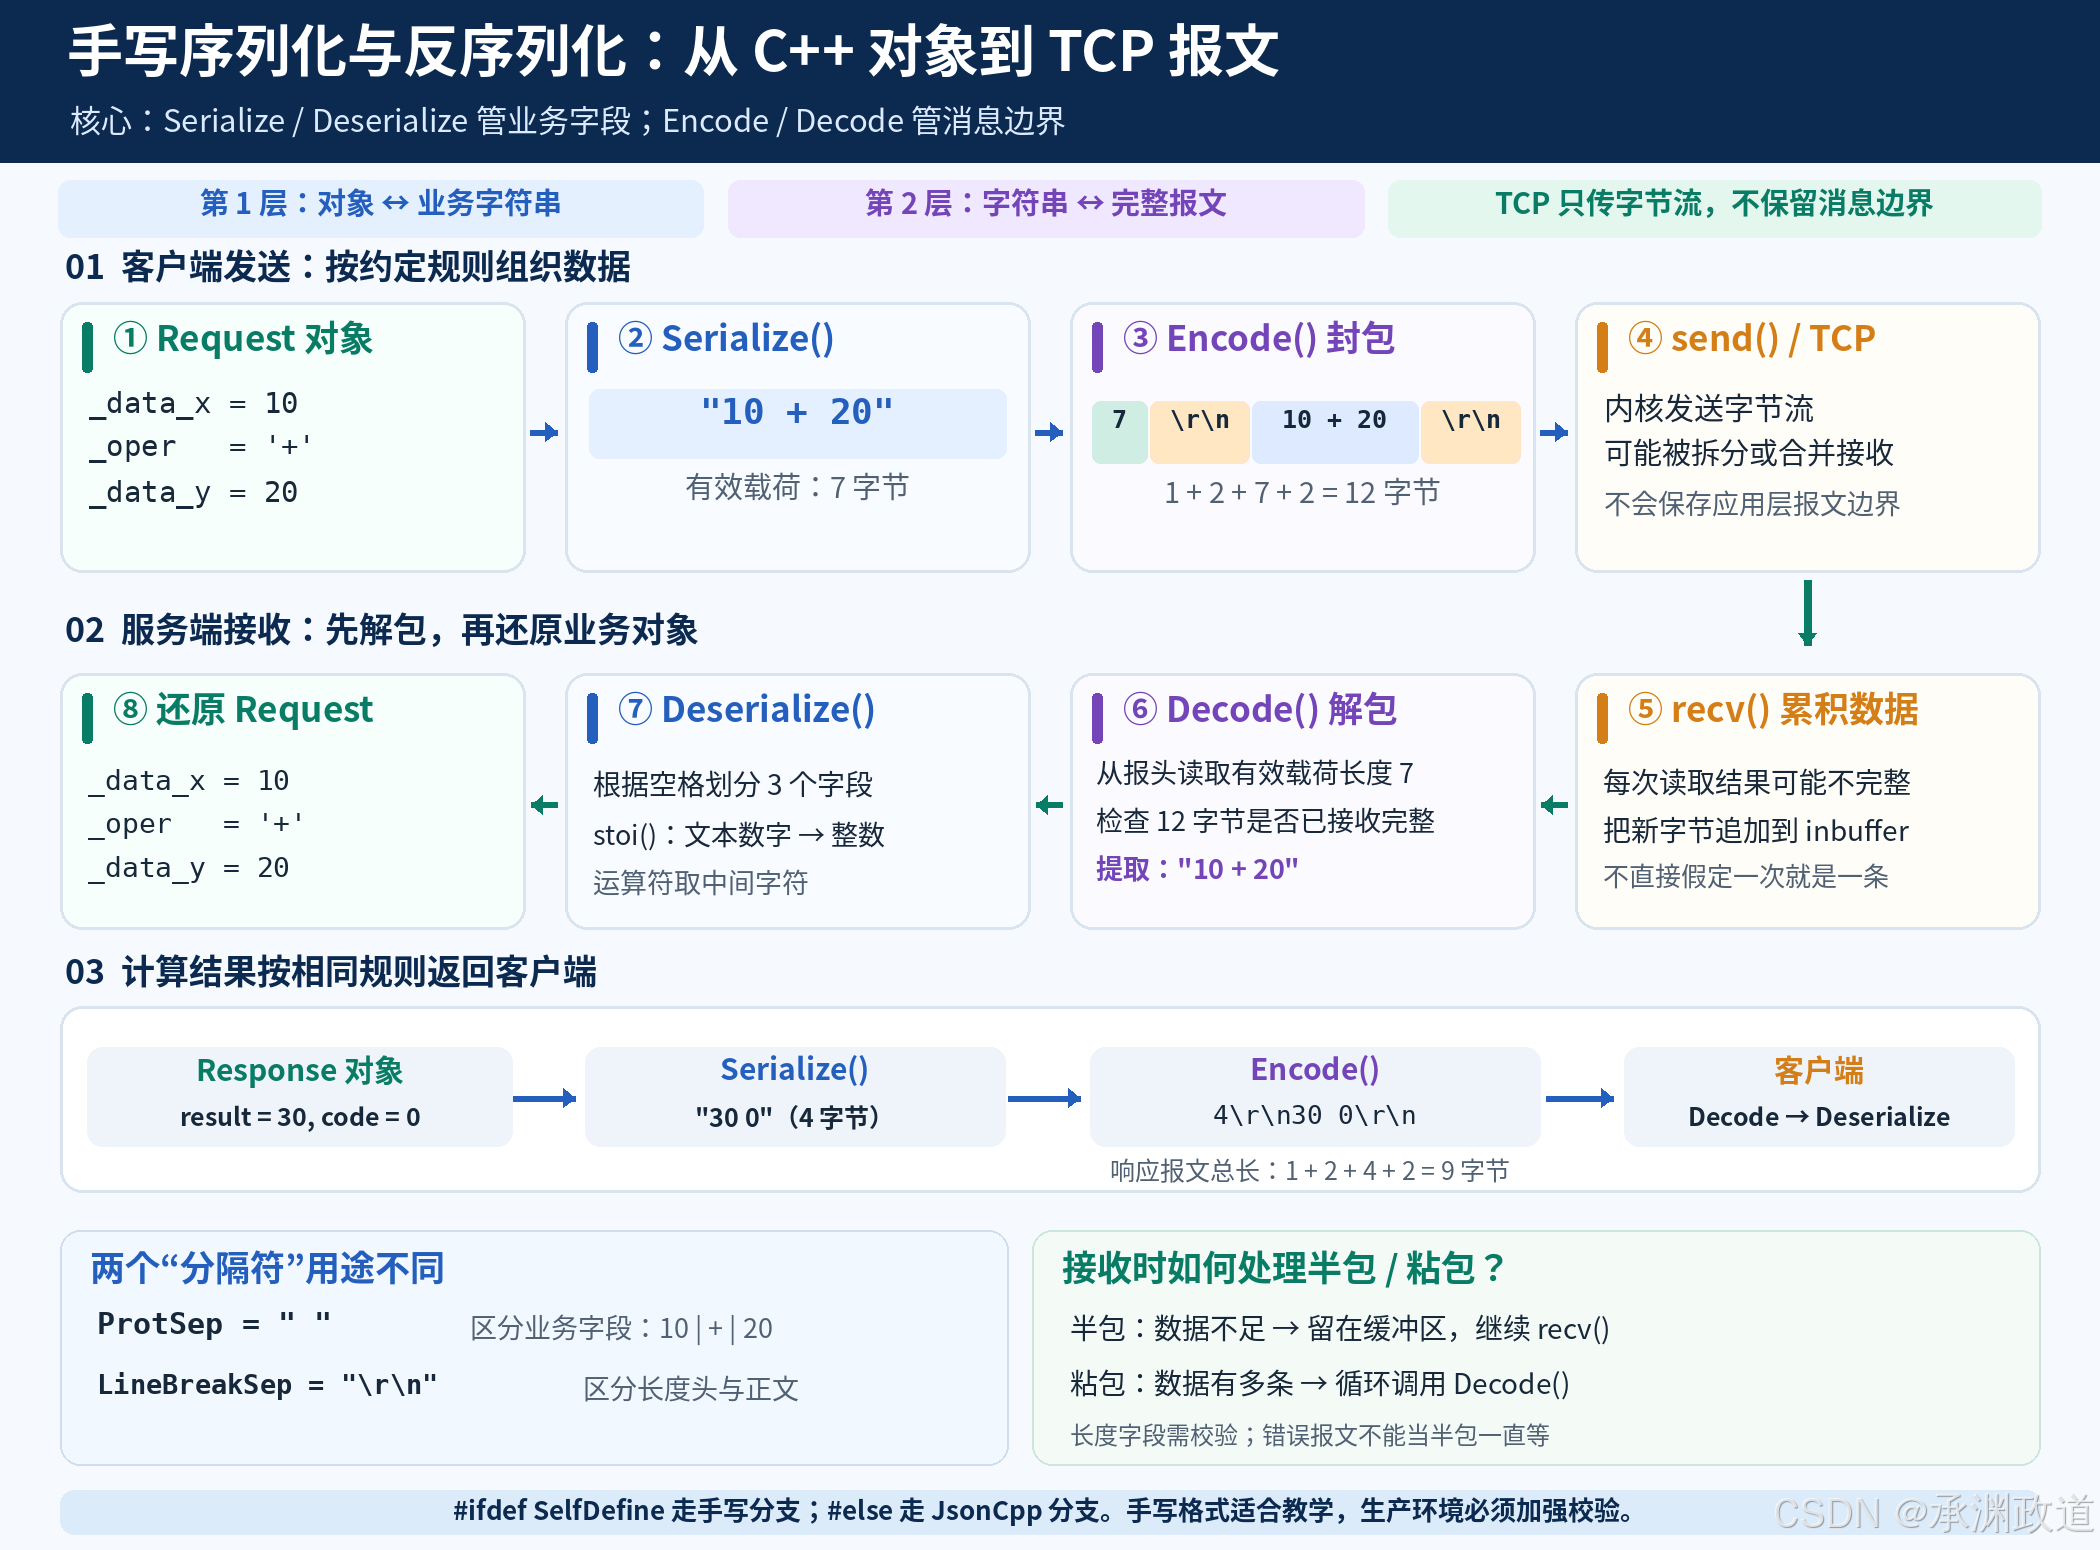
Protocol.hpp(协议实现)
cpp
#pragma once

#include <iostream>
#include <string>
#include <memory>
#include <sstream>
#include <limits>

// 业务字段分隔符
const std::string ProtSep = " ";

// 报文分隔符
const std::string LineBreakSep = "\r\n";

// 最大允许的有效载荷长度
const size_t MaxMessageSize = 1024 * 1024;

// ================================
// 1. 封包
// 格式:len\r\nmessage\r\n
// ================================

std::string Encode(const std::string &message)
{
    std::string len = std::to_string(message.size());

    std::string package =
        len + LineBreakSep + message + LineBreakSep;

    return package;
}

// ================================
// 2. 解包
// 从接收缓冲区提取一条完整消息
// ================================

bool Decode(std::string &package, std::string *message)
{
    if (message == nullptr)
        return false;

    // 1. 寻找第一个分隔符
    auto pos = package.find(LineBreakSep);

    if (pos == std::string::npos)
        return false;

    // 2. 提取长度字符串
    std::string lens = package.substr(0, pos);

    if (lens.empty())
        return false;

    // 3. 将长度转换成整数
    size_t messagelen = 0;

    try
    {
        size_t used = 0;
        messagelen = std::stoull(lens, &used);

        if (used != lens.size())
            return false;

        if (messagelen > MaxMessageSize)
            return false;
    }
    catch (...)
    {
        return false;
    }

    // 4. 计算完整报文长度
    size_t headerlen = pos + LineBreakSep.size();

    size_t total =
        headerlen + messagelen + LineBreakSep.size();

    // 5. 判断是否收到完整报文
    if (package.size() < total)
        return false;

    // 6. 验证结尾分隔符
    if (package.compare(
            headerlen + messagelen,
            LineBreakSep.size(),
            LineBreakSep) != 0)
    {
        return false;
    }

    // 7. 提取有效载荷
    *message = package.substr(headerlen, messagelen);

    // 8. 删除已经解析的报文
    package.erase(0, total);

    return true;
}

// ================================
// 3. Request 请求类
// ================================

class Request
{
public:
    int _data_x;
    int _data_y;
    char _oper;

public:
    Request()
        : _data_x(0), _data_y(0), _oper('+')
    {
    }

    Request(int x, int y, char oper)
        : _data_x(x), _data_y(y), _oper(oper)
    {
    }

    // ----------------------------
    // 手写序列化
    // 对象 -> 字符串
    // 例如:10 + 20
    // ----------------------------

    bool Serialize(std::string *out)
    {
        if (out == nullptr)
            return false;

        *out =
            std::to_string(_data_x) +
            ProtSep +
            _oper +
            ProtSep +
            std::to_string(_data_y);

        return true;
    }

    // ----------------------------
    // 手写反序列化
    // 字符串 -> 对象
    // ----------------------------

    bool Deserialize(const std::string &in)
    {
        std::istringstream iss(in);

        int x = 0;
        int y = 0;
        char oper = 0;
        std::string extra;

        // 按顺序提取三个字段
        if (!(iss >> x >> oper >> y))
            return false;

        // 不允许出现多余字段
        if (iss >> extra)
            return false;

        _data_x = x;
        _data_y = y;
        _oper = oper;

        return true;
    }

    void Debug()
    {
        std::cout
            << "x = " << _data_x
            << ", y = " << _data_y
            << ", oper = " << _oper
            << std::endl;
    }
};

// ================================
// 4. Response 响应类
// ================================

class Response
{
public:
    int _result;
    int _code;

public:
    Response()
        : _result(0), _code(0)
    {
    }

    Response(int result, int code)
        : _result(result), _code(code)
    {
    }

    // ----------------------------
    // 序列化
    // 例如:30 0
    // ----------------------------

    bool Serialize(std::string *out)
    {
        if (out == nullptr)
            return false;

        *out =
            std::to_string(_result) +
            ProtSep +
            std::to_string(_code);

        return true;
    }

    // ----------------------------
    // 反序列化
    // ----------------------------

    bool Deserialize(const std::string &in)
    {
        std::istringstream iss(in);

        int result = 0;
        int code = 0;
        std::string extra;

        if (!(iss >> result >> code))
            return false;

        if (iss >> extra)
            return false;

        _result = result;
        _code = code;

        return true;
    }
};

// ================================
// 5. Factory 对象工厂
// ================================

class Factory
{
public:
    static std::shared_ptr<Request> BuildRequest()
    {
        return std::make_shared<Request>();
    }

    static std::shared_ptr<Request> BuildRequest(
        int x, int y, char oper)
    {
        return std::make_shared<Request>(x, y, oper);
    }

    static std::shared_ptr<Response> BuildResponse()
    {
        return std::make_shared<Response>();
    }

    static std::shared_ptr<Response> BuildResponse(
        int result, int code)
    {
        return std::make_shared<Response>(result, code);
    }
};
main.cpp(测试程序)
cpp
#include <iostream>
#include "Protocol.hpp"

int main()
{
    // =========================
    // 一、客户端
    // =========================

    // 1. 创建请求对象
    Request req(10, 20, '+');

    // 2. 序列化
    std::string message;
    req.Serialize(&message);

    std::cout << "序列化结果: "
              << message << std::endl;

    // 3. 封包
    std::string package = Encode(message);

    std::cout << "封包后: "
              << package << std::endl;

    // =========================
    // 二、服务器
    // =========================

    // 模拟 TCP 接收缓冲区
    std::string inbuffer = package;

    // 4. 解包
    std::string recv_message;

    if (!Decode(inbuffer, &recv_message))
    {
        std::cerr << "解包失败!" << std::endl;
        return 1;
    }

    // 5. 反序列化
    Request server_req;

    if (!server_req.Deserialize(recv_message))
    {
        std::cerr << "反序列化失败!" << std::endl;
        return 1;
    }

    server_req.Debug();

    // 6. 执行计算
    int result = 0;
    int code = 0;

    switch (server_req._oper)
    {
    case '+':
        result = server_req._data_x
               + server_req._data_y;
        break;

    case '-':
        result = server_req._data_x
               - server_req._data_y;
        break;

    case '*':
        result = server_req._data_x
               * server_req._data_y;
        break;

    case '/':
        if (server_req._data_y == 0)
        {
            code = 1;
        }
        else
        {
            result = server_req._data_x
                   / server_req._data_y;
        }
        break;

    default:
        code = 2;
        break;
    }

    // 7. 创建响应对象
    Response resp(result, code);

    // 8. 响应序列化
    std::string resp_message;
    resp.Serialize(&resp_message);

    // 9. 响应封包
    std::string resp_package = Encode(resp_message);

    // =========================
    // 三、客户端接收响应
    // =========================

    std::string client_buffer = resp_package;
    std::string result_message;

    if (!Decode(client_buffer, &result_message))
    {
        std::cerr << "响应解包失败!" << std::endl;
        return 1;
    }

    Response client_resp;

    if (!client_resp.Deserialize(result_message))
    {
        std::cerr << "响应反序列化失败!" << std::endl;
        return 1;
    }

    std::cout << "计算结果: "
              << client_resp._result << std::endl;

    std::cout << "状态码: "
              << client_resp._code << std::endl;

    return 0;
}
三、进程间关系与守护进程
核心理解:Linux 不仅要管理单个进程,还要管理进程之间的关系.守护进程则是一种脱离终端、长期在后台运行的服务进程.
3.1进程组
①什么是进程组
进程组就是Linux将一个或多个进程组织在一起,方便统一管理的一种机制.
你可以把它理解成一个班级:
- 进程:班级里的学生.
- 进程组:整个班级.
- 进程组组长:班长.
- PGID:班级编号.
Linux可以向整个进程组发送信号,而不用一个进程一个进程地操作.
进程组是怎么组织的?
假设Linux中存在三个进程:
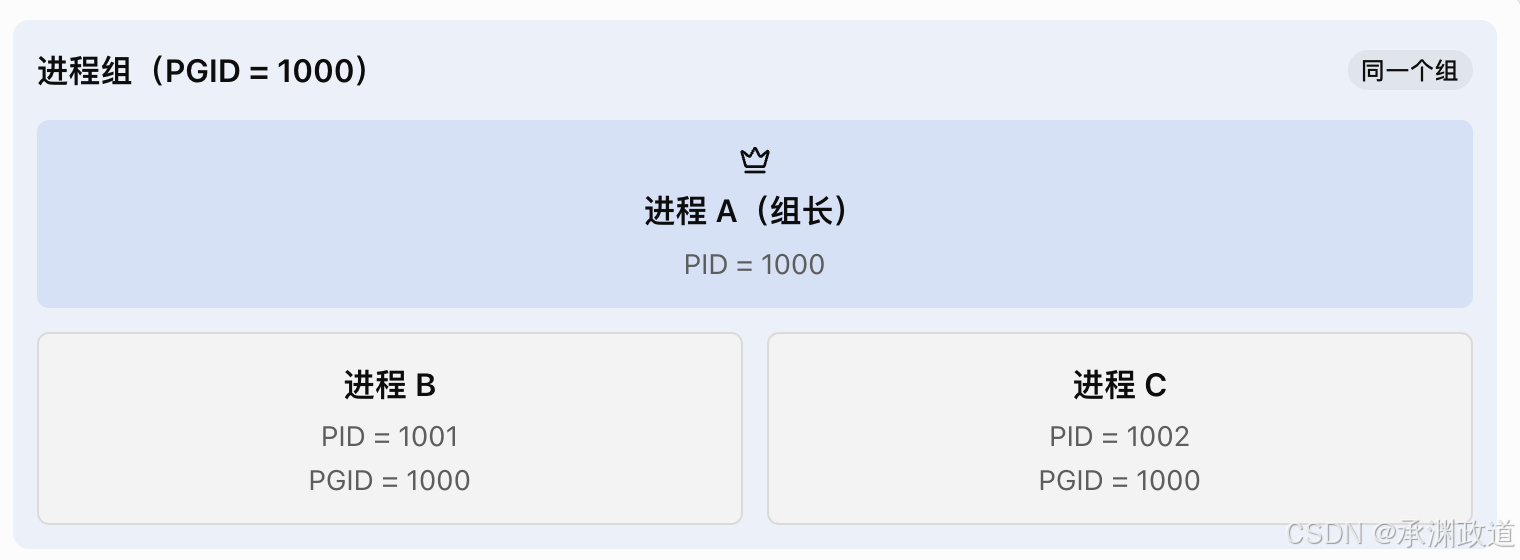
注意:
- 每个进程都有自己的PID.
- 同一进程组中的进程具有相同的PGID.
- 进程组组长的PID等于该组的PGID.
- 组长退出后,进程组不一定立即消失.
为什么需要进程组?
最典型的场景就是Linux管道命令.
例如:
cat file.txt | grep hello | wc -lShell 通常会创建三个进程:
cat → grep → wc并把它们放在同一个进程组中.
如果用户按下 Ctrl+C:
终端会向当前前台进程组发送SIGINT信号,而不是只向某一个进程发送.
这样,cat、grep 和 wc 通常都能够一起终止.
这就是进程组的重要作用:方便统一进行信号管理和作业控制.
进程组与父子进程有什么区别?
| 对比 | 父子进程 | 进程组 |
|---|---|---|
| 关系 | 进程创建关系 | 进程组织关系 |
| 标识 | PID、PPID | PGID |
| 相关函数 | fork() |
setpgid() |
| 主要作用 | 创建和管理子进程 | 统一管理进程组 |
例如:
pid_t id = fork();默认情况下,子进程会继承父进程的PGID,因此父子进程通常属于同一个进程组.
但父子进程不一定始终属于同一进程组,可以通过 setpgid() 在符合条件时调整.
如何查看进程组?
Linux 提供两个重要接口:
getpgrp();     // 获取当前进程的 PGID
getpgid(pid);  // 获取指定进程的 PGID
可以通过下面的命令查看:
ps -o pid,ppid,pgid,sid,comm -p $$各字段含义:
PID:进程ID.PPID:父进程ID.PGID:进程组ID.SID:会话ID.
一句话总结:进程组就是把多个进程归为一组,让Linux能够统一管理它们,特别是统一发送信号.
还要记住一个层级关系:
会话(Session)
    │
    ├── 进程组 A
    │     ├── 进程 1
    │     └── 进程 2
    │
    └── 进程组 B
          ├── 进程 3
          └── 进程 4
一个会话可以包含多个进程组,而一个进程组可以包含多个进程.
**
②组⻓进程
什么是组长进程(Process Group Leader)?
组长进程就是一个进程组中,PID等于PGID的那个进程.
- PID:进程自身的ID.
- PGID:进程所属进程组的ID.
- 组长进程:PID=PGID的进程.
举个例子:
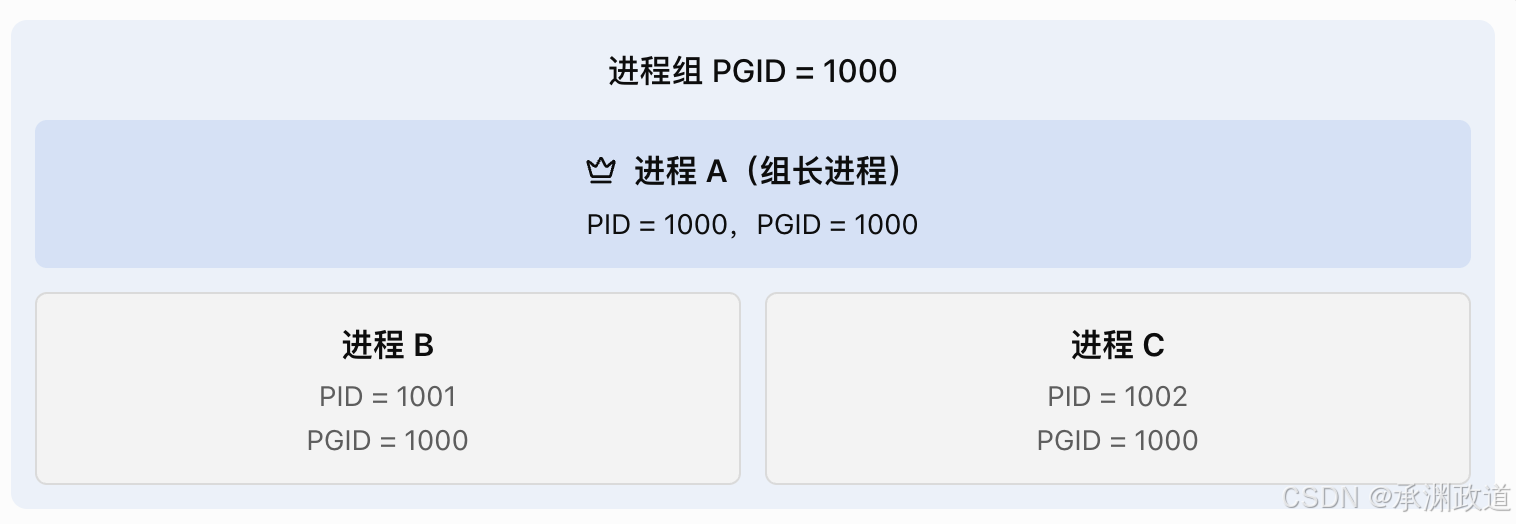
因为进程A的PID == PGID,所以进程A是组长进程.
组长进程有什么作用?
组长进程主要具有以下特点:
- 标识进程组:组长的PID被用作整个进程组的PGID.
- 组织进程:其他进程可以加入这个进程组.
- 不负责管理所有组员:组长并不天然拥有管理其他成员的特殊权限,进程组成员也不一定是它的子进程.
特别注意:
组长进程退出,并不意味着整个进程组退出.
例如:
进程组 PGID = 1000
    │
    ├── 进程 A(PID 1000)→ 退出
    ├── 进程 B(PID 1001)→ 继续运行
    └── 进程 C(PID 1002)→ 继续运行
此时进程组仍然存在,PGID仍然是1000.
如何创建组长进程?
Linux 可以使用 setpgid() 设置进程组.
#include <iostream>
#include <unistd.h>

int main()
{
    // 创建新的进程组
    if (setpgid(0, 0) == -1)
    {
        perror("setpgid");
        return 1;
    }

    std::cout << "PID: " << getpid() << std::endl;
    std::cout << "PGID: " << getpgrp() << std::endl;

    return 0;
}
其中:
setpgid(0, 0);表示把当前进程放入一个以自身 PID 为 PGID 的进程组中,使其成为组长进程.
注意,该操作需要满足系统限制,例如会话首进程不能通过 setpgid() 改变进程组.
组长进程和父进程有什么区别?
| 对比 | 组长进程 | 父进程 |
|---|---|---|
| 判断标准 | PID = PGID | 创建了子进程 |
| 形成方式 | setpgid() 等 |
fork() |
| 主要意义 | 标识一个进程组 | 表示进程创建关系 |
| 退出后 | 进程组可能继续存在 | 子进程可能成为孤儿进程 |
为什么学习守护进程需要理解组长进程?
因为 Linux 的 setsid() 有一个重要限制:
进程组组长不能调用 setsid() 成功创建新会话.
因此,传统守护进程创建过程中通常先调用 fork():
原始进程(可能是组长)
          │
          ▼
        fork()
          │
          ▼
子进程(不是进程组组长)
          │
          ▼
        setsid()
          │
          ▼
创建新会话 + 新进程组
          │
          ▼
子进程成为新会话首进程
同时也是新进程组组长
这就是为什么创建守护进程时,经常需要先执行一次 fork(),再调用 setsid().
一句话总结:组长进程就是 PID 等于 PGID 的进程,它是进程组的标识,但不意味着它控制整个进程组.
3.2会话
①什么是会话
刚刚我们谈到了进程组的概念,那么会话⼜是什么呢?会话其实和进程组息息相关,会话可以看成是⼀个或多个进程组的集合,⼀个会话可以包含多个进程组.每⼀个会话也有⼀个会话ID(SID)
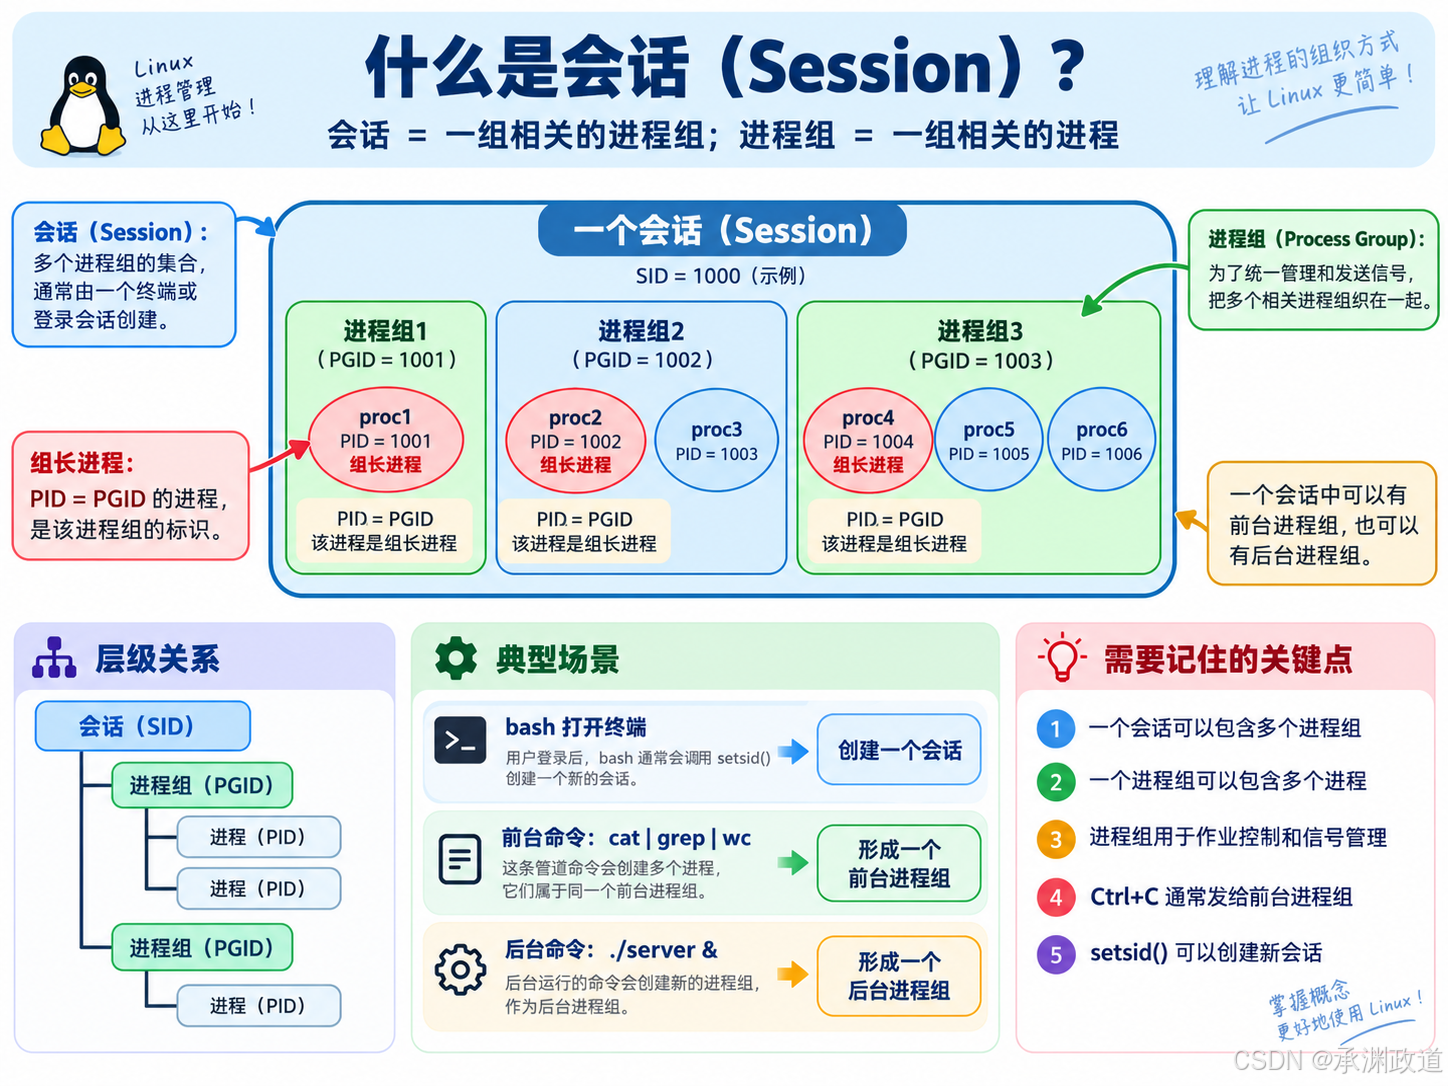
通常我们都是使⽤管道将⼏个进程编成⼀个进程组.如上图的进程组2和进程组3可能是由下列命令形成的:
bash
[node@localhost code]$ proc2 | proc3 &
[node@localhost code]$ proc4 | proc5 | proc6 &
# &表示将进程组放在后台执⾏
我们举⼀个例⼦观察⼀下这个现象:
bash
# ⽤管道和sleep组成⼀个进程组放在后台运⾏
[node@localhost code]$ sleep 100 | sleep 200 | sleep 300 &
# 查看ps命令打出来的列描述信息
[node@localhost code]$ ps axj | head -n1
# 过滤sleep相关的进程信息
[node@localhost code]$ ps axj | grep sleep | grep -v grep
# a选项表⽰不仅列当前⽤⼾的进程,也列出所有其他⽤⼾的进程
# x选项表⽰不仅列有控制终端的进程,也列出所有⽆控制终端的进程
# j选项表⽰列出与作业控制相关的信息, 作业控制后续会讲
# grep的-v选项表⽰反向过滤, 即不过滤带有grep字段相关的进程

# 结果如下
PPID PID PGID SID TTY TPGID STAT UID TIME COMMAND
2806 4223 4223 2780 pts/2 4229 S 1000 0:00 sleep 100
2806 4224 4223 2780 pts/2 4229 S 1000 0:00 sleep 200
2806 4225 4223 2780 pts/2 4229 S 1000 0:00 sleep 300
从上述结果来看3个进程对应的PGID相同,即属于同⼀个进程组.
②如何创建会话
可以调⽤setseid函数来创建⼀个会话,前提是调⽤进程不能是⼀个进程组的组⻓.
cpp
#include <unistd.h>
/*
*功能:创建会话
*返回值:创建成功返回SID, 失败返回-1
*/
pid_t setsid(void);
该接⼝调⽤之后会发⽣:
- 调⽤进程会变成新会话的会话⾸进程.此时,新会话中只有唯⼀的⼀个进程.
- 调⽤进程会变成进程组组⻓.新进程组ID就是当前调⽤进程ID.
- 该进程没有控制终端.如果在调⽤setsid之前该进程存在控制终端,则调⽤之后会切断联系.
需要注意的是: 这个接⼝如果调⽤进程原来是进程组组⻓,则会报错,为了避免这种情况,我们通常的使⽤⽅法是先调⽤fork创建⼦进程,⽗进程终⽌,⼦进程继续执⾏,因为⼦进程会继承⽗进程的进程组ID,⽽进程ID则是新分配的,就不会出现错误的情况.
③会话ID(SID)
什么是会话ID(SID)?
SID(Session ID)是Linux中用于唯一标识一个会话的编号.
一个会话可以包含多个进程组,一个进程组又可以包含多个进程.
可以理解为:
- PID:进程的编号.
- PGID:进程组的编号.
- SID:会话的编号.
SID、PGID、PID 之间的关系
假设Linux中有一个会话,SID = 1000.
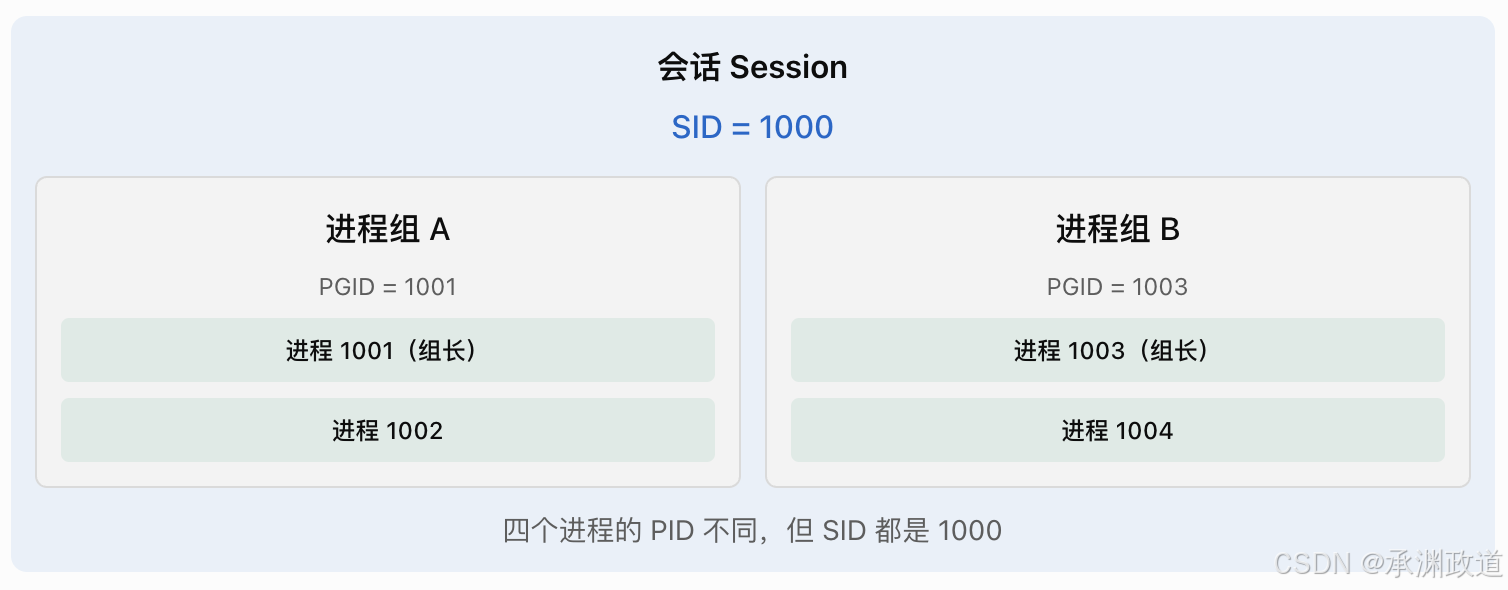
这个例子说明:
- 同一个会话中的所有进程具有相同的 SID.
- 不同进程组可以有不同的 PGID.
- 每个进程都有自己的 PID.
会话 ID 是怎么产生的?
Linux 可以通过 setsid() 创建一个新会话.
pid_t sid = setsid();假设当前进程:
PID  = 2000
PGID = 1000
SID  = 1000
调用 setsid() 成功后:
PID  = 2000
PGID = 2000
SID  = 2000
这是因为 setsid() 会使当前进程:
- 成为新会话的会话首进程(Session Leader).
- 成为新进程组的组长.
- 脱离原来的控制终端.
注意:进程组组长不能成功调用 setsid().所以创建传统守护进程时,通常先调用 fork(),让非进程组组长的子进程调用 setsid().
如何查看SID?
可以使用 Linux 命令:
ps -o pid,ppid,pgid,sid,comm -p $$也可以使用 C++:
cpp
#include <iostream>
#include <unistd.h>

int main()
{
    std::cout << "PID: " << getpid() << '\n';
    std::cout << "PGID: " << getpgrp() << '\n';
    std::cout << "SID: " << getsid(0) << '\n';

    return 0;
}
其中 getsid(0) 用于获取当前进程所属会话的SID.
总结:
记住下面三个等式:
- 进程组组长:
PID == PGID - 会话首进程:
PID == SID - 成功调用 setsid() 后:
PID == PGID == SID
不过,普通进程不一定满足这些等式.
一句话理解:SID 表示进程属于哪个会话,PGID表示进程属于哪个进程组,PID表示这个进程是谁.
3.3控制终端
先说⼀下什么是控制终端?
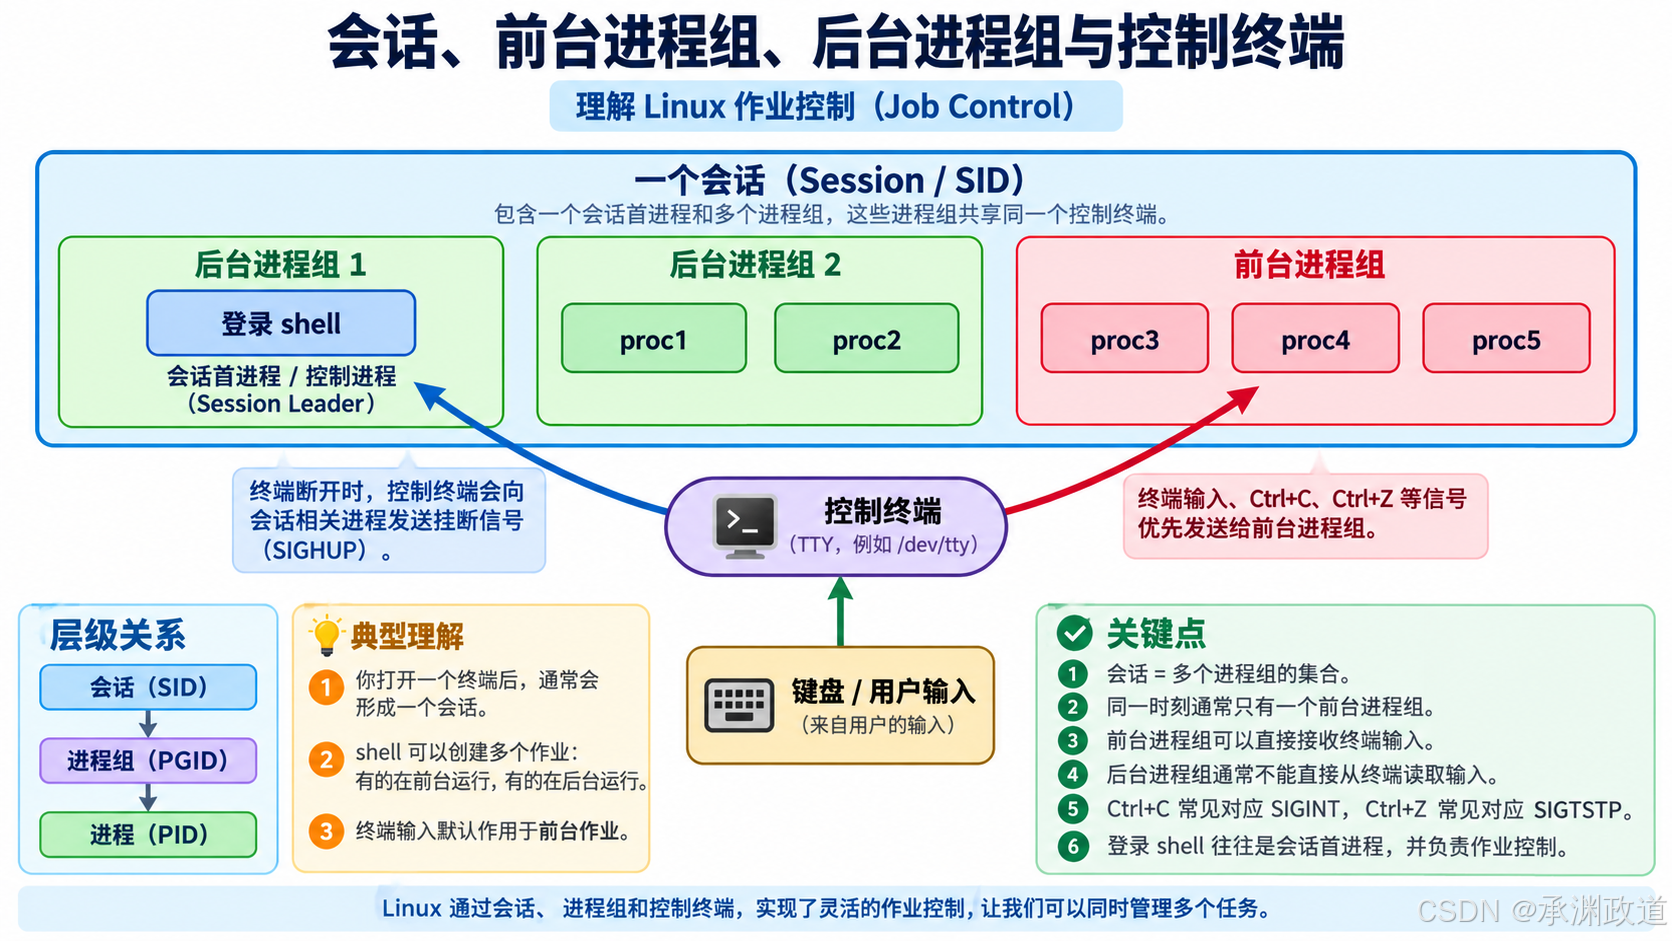
在UNIX系统中,⽤户通过终端登录系统后得到⼀个Shell进程,这个终端成为Shell进程的控制终端.控制终端是保存在PCB中的信息,我们知道fork进程会复制PCB中的信息,因此由Shell进程启动的其它进程的控制终端也是这个终端.默认情况下没有重定向,每个进程的标准输⼊、标准输出和标准错误都指向控制终端,进程从标准输⼊读也就是读⽤户的键盘输⼊,进程往标准输出或标准错误输出写也就是输出到显示器上.另外会话、进程组以及控制终端还有⼀些其他的关系,我们在下边详细介绍⼀下:
- ⼀个会话可以有⼀个控制终端,通常会话⾸进程打开⼀个终端(终端设备或伪终端设备)后,该终端就成为该会话的控制终端.
- 建⽴与控制终端连接的会话⾸进程被称为控制进程.
- ⼀个会话中的⼏个进程组可被分成⼀个前台进程组以及⼀个或者多个后台进程组.
- 如果⼀个会话有⼀个控制终端,则它有⼀个前台进程组,会话中的其他进程组则为后台进程组.
- ⽆论何时进⼊终端的中断键(ctrl+c)或退出键(ctrl+),就会将中断信号发送给前台进程组的所有进程.
- 如果终端接⼝检测到调制解调器(或⽹络)已经断开,则将挂断信号发送给控制进程(会话⾸进程).
3.4作业控制
①什么是作业和作业控制?
1.什么是作业(Job)?
作业是Shell为了管理用户执行的命令而引入的概念.一个作业可以包含一个或多个进程.
例如,在 Linux 终端执行:
ls -l这条命令通常只创建一个进程,因此可以看作一个作业.
再比如:
cat file.txt | grep hello | wc -l这条管道命令通常会创建三个进程:
          一个作业(Job)
                 │
          一个进程组(PGID)
                 │
       ┌─────────┼─────────┐
       │         │         │
      cat       grep       wc
       │         │         │
     进程1     进程2     进程3
虽然有三个进程,但Shell将它们作为一个作业进行管理.
在支持作业控制的Shell中,一个作业通常对应一个进程组.
2.什么是作业控制(Job Control)?
作业控制就是 Shell 对作业进行管理的机制,可以让作业在前台和后台之间切换,以及暂停、恢复和终止作业.
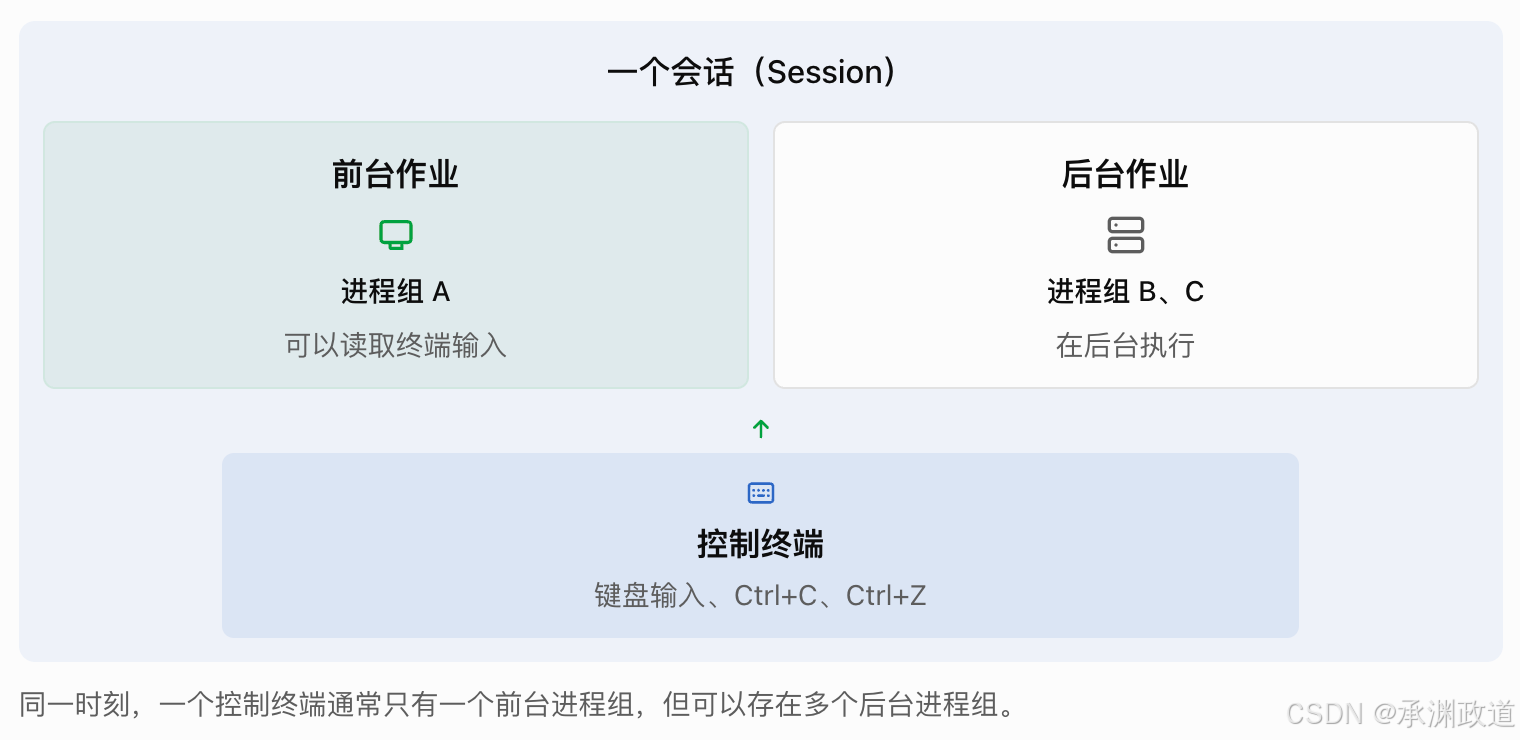
前台作业(Foreground Job)
例如:
sleep 100此时 sleep 在前台执行,终端等待它结束.
如果按下 Ctrl+C,终端通常会向前台进程组发送 SIGINT 信号,导致 sleep 终止.
后台作业(Background Job)
例如:
sleep 100 &这里的 & 表示将作业放到后台运行.
此时:
sleep继续执行.- Shell 可以继续接受新的命令.
- 后台作业通常不能直接从控制终端读取输入.
前台和后台的关系
如何进行作业控制?
假设执行:
sleep 100此时程序在前台运行.
第一步:按下 Ctrl+Z
向前台进程组发送 SIGTSTP 信号,通常会使作业暂停.
第二步:查看作业
jobs可能看到:
[1]+ Stopped sleep 100这里的 [1] 是 Shell 分配的作业编号,不是PID.
第三步:让作业在后台继续运行
bg %1第四步:重新切换到前台
fg %1第五步:按 Ctrl+C
通常会终止当前前台作业.
常用命令总结:
| 命令 | 功能 |
|---|---|
jobs |
查看当前 Shell 管理的作业 |
Ctrl+Z |
暂停前台作业 |
bg %1 |
将作业 1 放到后台继续执行 |
fg %1 |
将作业 1 切换到前台 |
Ctrl+C |
向前台进程组发送 SIGINT |
command & |
在后台启动作业 |
作业、进程组、会话之间的关系
这三个概念有紧密联系,但并不完全相同.
| 概念 | 主要作用 |
|---|---|
| 进程 | 程序执行的基本单位 |
| 进程组 | 将多个进程组织起来,方便统一发送信号 |
| 作业 | Shell 管理命令执行的单位 |
| 会话 | 管理一个或多个进程组 |
| 作业控制 | Shell 对作业进行前后台切换、暂停和恢复等操作 |
特别注意:作业是 Shell 的管理概念,进程组则是 Linux 内核提供的机制.Shell通常利用进程组、会话和终端信号实现作业控制.
一句话总结:
- 作业: 用户提交给 Shell 执行的一个任务,可以包含多个进程.
- 作业控制: Shell管理这些任务的运行状态,包括前台、后台、暂停和恢复.
②作业号
作业号是Shell为每个作业分配的编号,用来方便用户管理前台和后台作业.
例如,在Linux终端执行:
sleep 100 &
sleep 200 &
然后执行:
jobs可能得到:
[1]-  Running    sleep 100 &
[2]+  Running    sleep 200 &
其中:
[1]:第一个作业的作业号.[2]:第二个作业的作业号.+:当前作业(默认优先操作的作业).-:前一个作业.
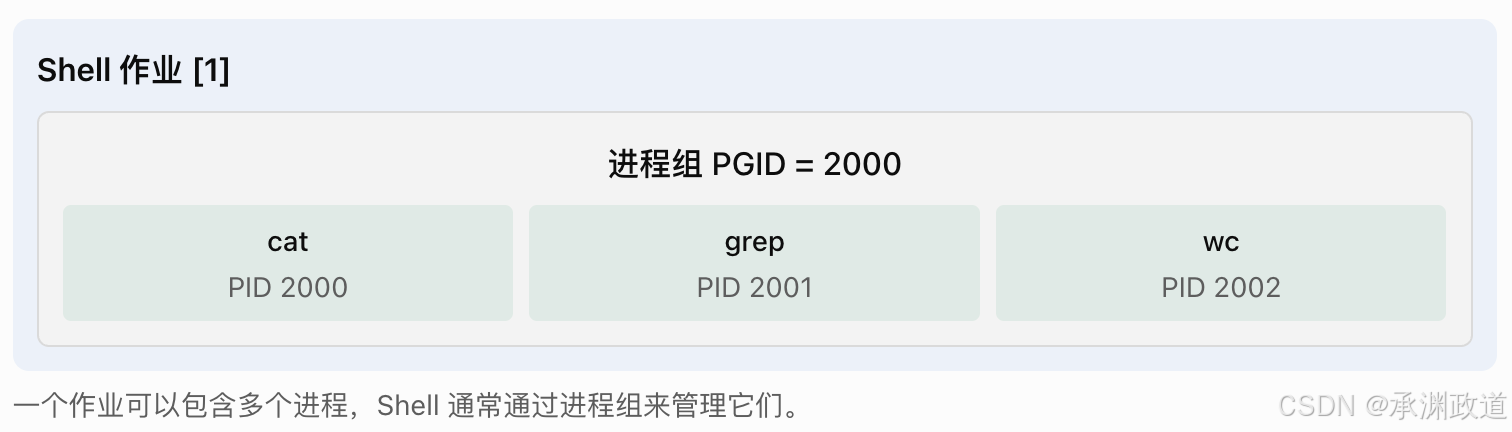
作业号与PID、PGID的区别
| 概念 | 含义 | 管理者 |
|---|---|---|
| 作业号(Job ID) | 标识 Shell 管理的一个作业 | Shell |
| PID | 标识一个进程 | Linux 内核 |
| PGID | 标识一个进程组 | Linux 内核 |
| SID | 标识一个会话 | Linux 内核 |
例如:
如何通过作业号控制作业?
假设作业号为 [1]:
fg %1       # 将作业1切换到前台

bg %1       # 在后台恢复作业1

kill %1     # 向作业1发送终止信号

jobs -l     # 查看作业及相关PID
这里的 %1 表示作业号为1的作业,而不是PID为1的进程.
作业号的特点
- 作业号由 Shell 分配,并不是 Linux 内核中的全局进程编号.
- 不同 Shell 可以同时存在作业号为
[1]的作业. - 作业结束后,原来的作业号可以被重新使用.
- 一个作业可能包含多个进程,但通常只有一个作业号.
一句话总结:作业号是Shell给作业分配的管理编号,而PID是内核给进程分配的编号.
例如,fg %1 操作的是作业1,而 kill 2000 默认操作的是PID为2000的进程.
③作业状态
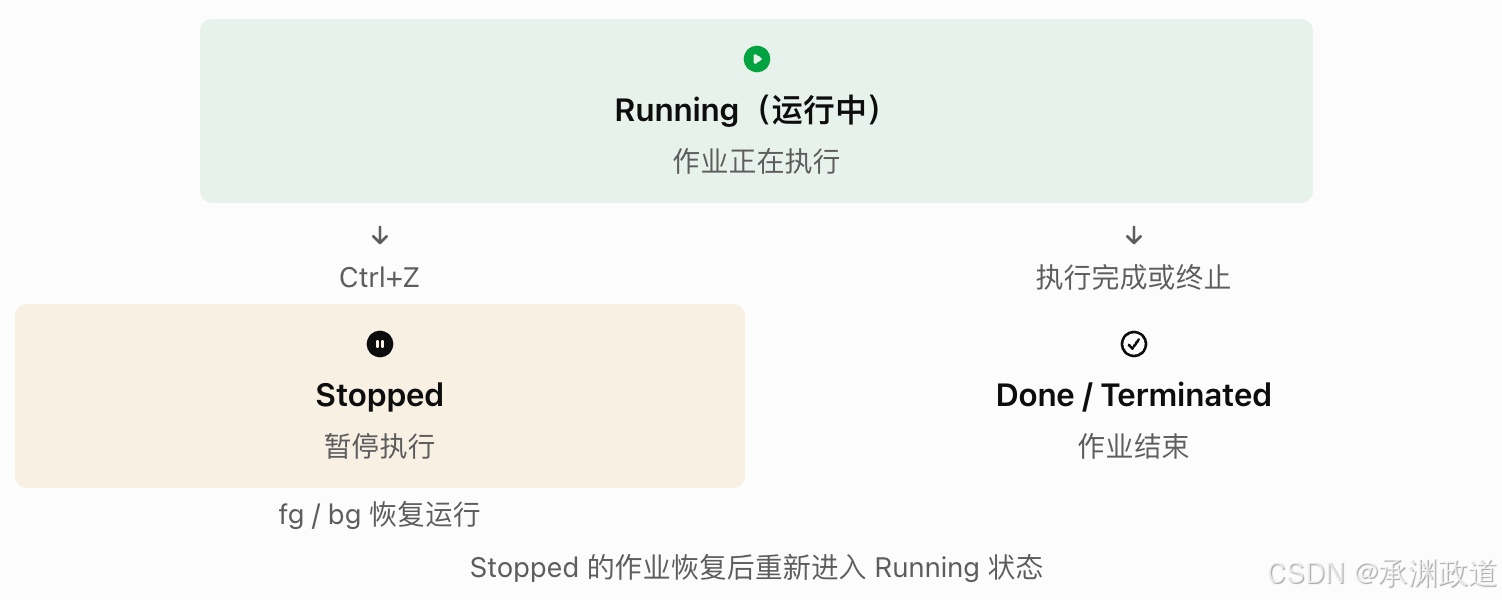
作业状态表示Shell管理的作业当前处于什么运行状态,例如正在运行、已经暂停或已经结束.
在Linux中,可以使用 jobs 命令查看作业状态.
1.常见的作业状态
| 作业状态 | 英文 | 含义 |
|---|---|---|
| 运行中 | Running | 作业正在运行或等待 CPU 调度 |
| 已停止 | Stopped | 作业被信号暂停,暂时不执行 |
| 已完成 | Done | 作业正常执行结束 |
| 已终止 | Terminated | 作业因信号而终止 |
注意:这里的 Running、Stopped 等是Shell视角的作业状态,不完全等同于Linux内核中的进程状态.
2.作业状态如何变化?
3.通过命令观察作业状态
-
创建一个后台作业
sleep 100 &
执行 jobs,可能看到:
[1]+ Running sleep 100 &表示作业1正在后台运行.
-
暂停作业
kill -STOP %1
再次执行 jobs:
[1]+ Stopped sleep 100表示作业1已经暂停.
-
恢复作业
bg %1
作业恢复在后台运行,状态变成 Running.
-
结束作业
kill %1
Shell 随后可能显示:
[1]+ Terminated sleep 100作业被终止,之后会从Shell的作业列表中移除.
4.作业状态与前后台的区别
这里特别容易混淆:
前台、后台描述作业与控制终端的关系;Running、Stopped描述作业是否正在运行.
例如:
| 作业 | 前台/后台 | 状态 |
|---|---|---|
sleep 100 |
前台 | Running |
sleep 100 & |
后台 | Running |
Ctrl+Z 暂停后的作业 |
已停止 | Stopped |
bg %1 恢复后的作业 |
后台 | Running |
因此,后台作业不等于暂停的作业.后台作业可以一直运行,只是不占用终端的前台位置.
5.作业状态与信号的关系
| 操作 | 信号 | 效果 |
|---|---|---|
Ctrl+C |
SIGINT | 通常终止前台作业 |
Ctrl+Z |
SIGTSTP | 通常暂停前台作业 |
kill -STOP %1 |
SIGSTOP | 强制停止作业 |
fg %1 |
SIGCONT(若已停止) | 恢复作业并切换前台 |
bg %1 |
SIGCONT(若已停止) | 恢复作业并放到后台 |
Ctrl+C 和 Ctrl+Z 的信号通常由控制终端发送给整个前台进程组,而不是单个进程.
总结:
- Running:作业正在运行。
- Stopped:作业被暂停,可以恢复。
- Done:作业正常结束。
- Terminated:作业被信号终止。
最需要记住的是:Shell 通过作业状态、进程组和信号,实现作业的暂停、恢复、前后台切换与终止.
④作业的挂起与切回
作业的挂起与切回,就是通过Shell控制一个作业暂停执行、恢复运行,以及在前台和后台之间切换.
主要涉及三个操作:
Ctrl+Z:挂起(暂停)前台作业.bg:让挂起的作业在后台继续运行.fg:将作业切换到前台,若已暂停则恢复运行.
1.什么是作业挂起?
假设在 Linux 终端执行:
sleep 100此时 sleep 是一个前台作业.
如果按下:
Ctrl + Z终端会向前台进程组发送 SIGTSTP 信号,通常使其中的进程暂停运行.
Shell 可能显示:
[1]+ Stopped sleep 100这表示:
[1]:作业号为 1.Stopped:作业已暂停.sleep 100:对应的命令.
注意:挂起不是终止.进程仍然存在,只是暂时停止执行,可以继续恢复.
2.作业如何切回前台和后台?
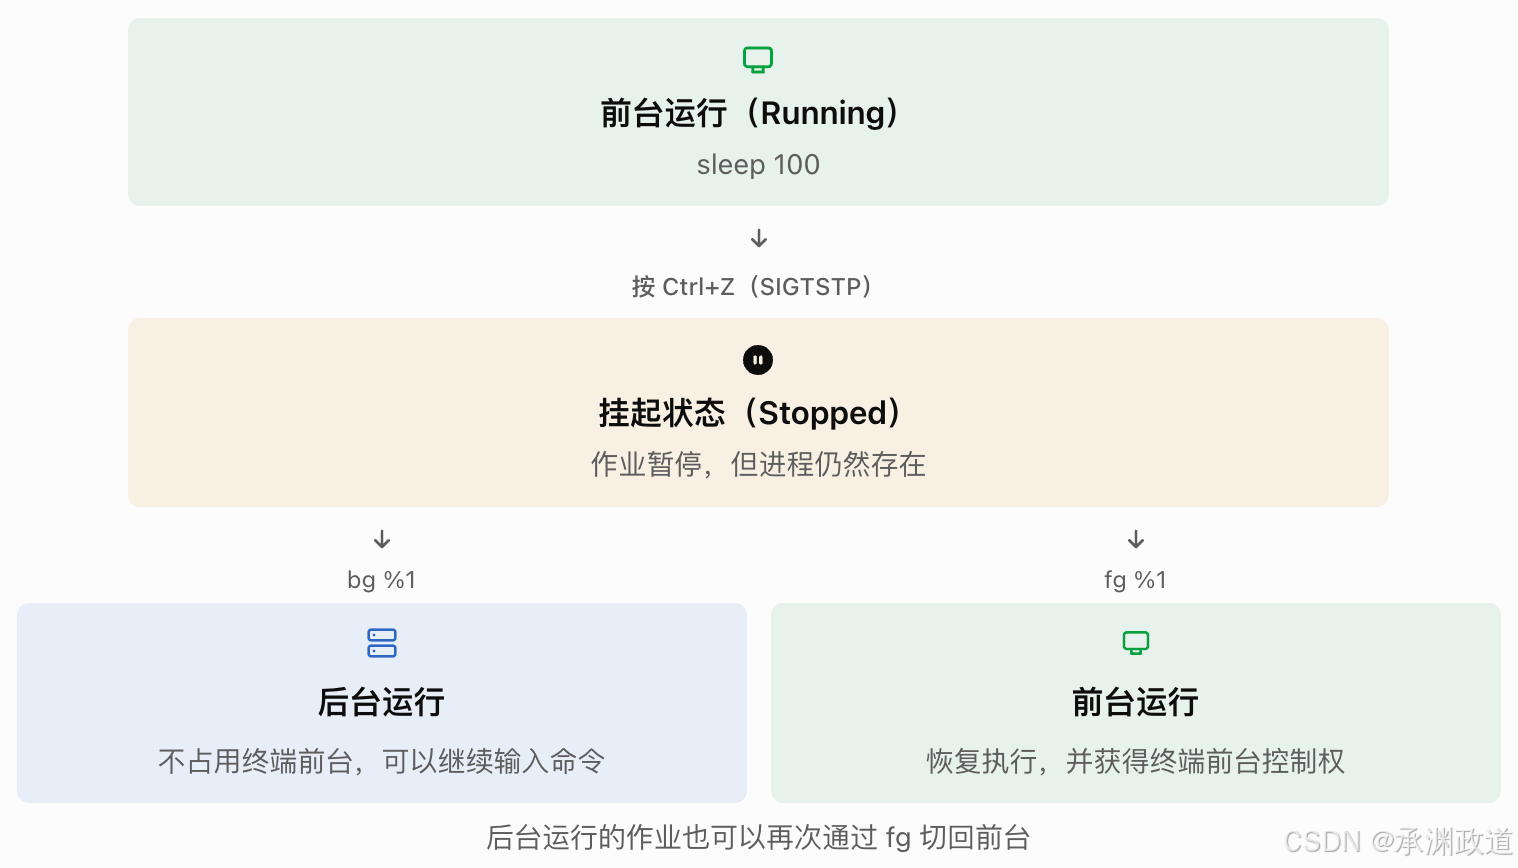
3.实际操作演示
第一步:启动前台作业
sleep 100第二步:按 Ctrl+Z,挂起作业
^Z
[1]+  Stopped    sleep 100
第三步:查看作业
jobs第四步:恢复到后台执行
bg %1Shell 可能显示:
[1]+ sleep 100 &此时 sleep 已经恢复运行,但处于后台.
第五步:切回前台
fg %1现在 sleep 重新成为前台作业.
第六步:按 Ctrl+C 终止作业
Ctrl+C 通常会使前台进程组收到 SIGINT 信号,从而终止程序.
4.底层原理:Shell 如何实现挂起与切回?
| 操作 | 底层机制 | 作用 |
|---|---|---|
Ctrl+Z |
SIGTSTP | 暂停前台作业 |
bg %1 |
SIGCONT | 恢复挂起的作业,在后台运行 |
fg %1 |
前台进程组切换、必要时 SIGCONT | 切回前台并恢复执行 |
Ctrl+C |
SIGINT | 通常终止前台作业 |
其中,fg 不只是发送 SIGCONT,Shell还需要通过 tcsetpgrp() 等机制,将控制终端的前台进程组切换为目标作业的进程组.
5.容易混淆的地方
挂起(Stopped)和后台运行(Background Running)不是一回事.
- 挂起: 程序暂停执行,不继续完成任务.
- 后台运行: 程序仍然执行,只是不占用终端的前台位置.
- 切回前台: 将作业重新设为终端的前台作业,必要时恢复执行.
例如:
sleep 100 &这条命令会直接在后台启动作业,它没有经过挂起过程.
一句话总结:Ctrl+Z 负责暂停,bg 负责在后台恢复,fg 负责切回前台.
Shell 通过作业号、进程组、信号和控制终端配合,实现作业的挂起、恢复及前后台切换.
⑤查看后台执⾏或挂起的作业
在Linux,可以使用 jobs 命令查看当前Shell管理的后台作业和挂起作业.
1.基本使用
jobs例如,先启动两个后台作业:
sleep 100 &
sleep 200 &
执行:
jobs可能得到:
[1]-  Running    sleep 100 &
[2]+  Running    sleep 200 &
各部分含义:
| 内容 | 含义 |
|---|---|
[1]、[2] |
作业号(Job ID) |
+ |
当前作业,默认优先操作 |
- |
前一个作业 |
Running |
正在运行 |
Stopped |
已挂起,暂停执行 |
sleep 100 |
作业对应的命令 |
2.jobs 的常用选项
| 命令 | 作用 |
|---|---|
jobs |
查看所有作业 |
jobs -l |
同时显示作业对应的 PID |
jobs -r |
只查看正在运行的作业 |
jobs -s |
只查看已挂起的作业 |
jobs -p |
只显示作业对应的进程组组长 PID |
3.如何操作这些作业?
假设:
[1]-  Stopped    sleep 100
[2]+  Running    sleep 200 &
可以执行:
bg %1       # 让作业1在后台恢复运行
fg %2       # 将作业2切换到前台
kill %1     # 向作业1发送终止信号
4.需要特别注意
jobs 只能查看当前Shell管理的作业,不能查看系统中所有后台进程.
例如,在终端A中启动的作业,通常无法通过终端B中的 jobs 查看.
如果想查看系统中的进程,可以使用:
ps aux或者:
ps -ef这些命令查看的是进程信息,而不是Shell的作业列表.
总结:
jobs:查看当前 Shell 的所有作业.jobs -r:查看正在运行的作业.jobs -s:查看挂起的作业.jobs -l:查看作业及其PID.
记住:jobs 管理的是Shell作业,ps 查看的是系统进程.
⑥作业控制相关的信号
作业控制的本质,就是Shell利用信号(Signal)和进程组,实现作业的暂停、恢复、终止以及前后台切换.
例如:
- 按下
Ctrl+C:通常终止前台作业. - 按下
Ctrl+Z:通常暂停前台作业. - 执行
bg %1:让挂起的作业在后台恢复运行. - 执行
fg %1:将作业切回前台,必要时恢复执行.
1.作业控制常见的信号
| 信号 | 作用 | 典型场景 |
|---|---|---|
SIGINT |
中断进程 | Ctrl+C |
SIGQUIT |
请求退出进程,默认产生核心转储 | Ctrl+\ |
SIGTSTP |
请求暂停进程 | Ctrl+Z |
SIGSTOP |
强制停止进程 | kill -STOP PID |
SIGCONT |
恢复被停止的进程 | bg、fg |
SIGTTIN |
后台进程组尝试读取控制终端时,通常被停止 | 后台读取终端 |
SIGTTOU |
后台进程组执行受限制的终端写入或控制操作时,通常被停止 | 后台操作终端 |
SIGCHLD |
子进程状态发生变化时通知父进程 | Shell 管理子进程 |
SIGHUP |
终端挂断等场景下发送 | 终端断开 |
2.Ctrl+C、Ctrl+Z 是怎么工作的?
假设你执行:
cat file.txt | grep hello | wc -lShell 将三个进程组织成一个前台进程组.
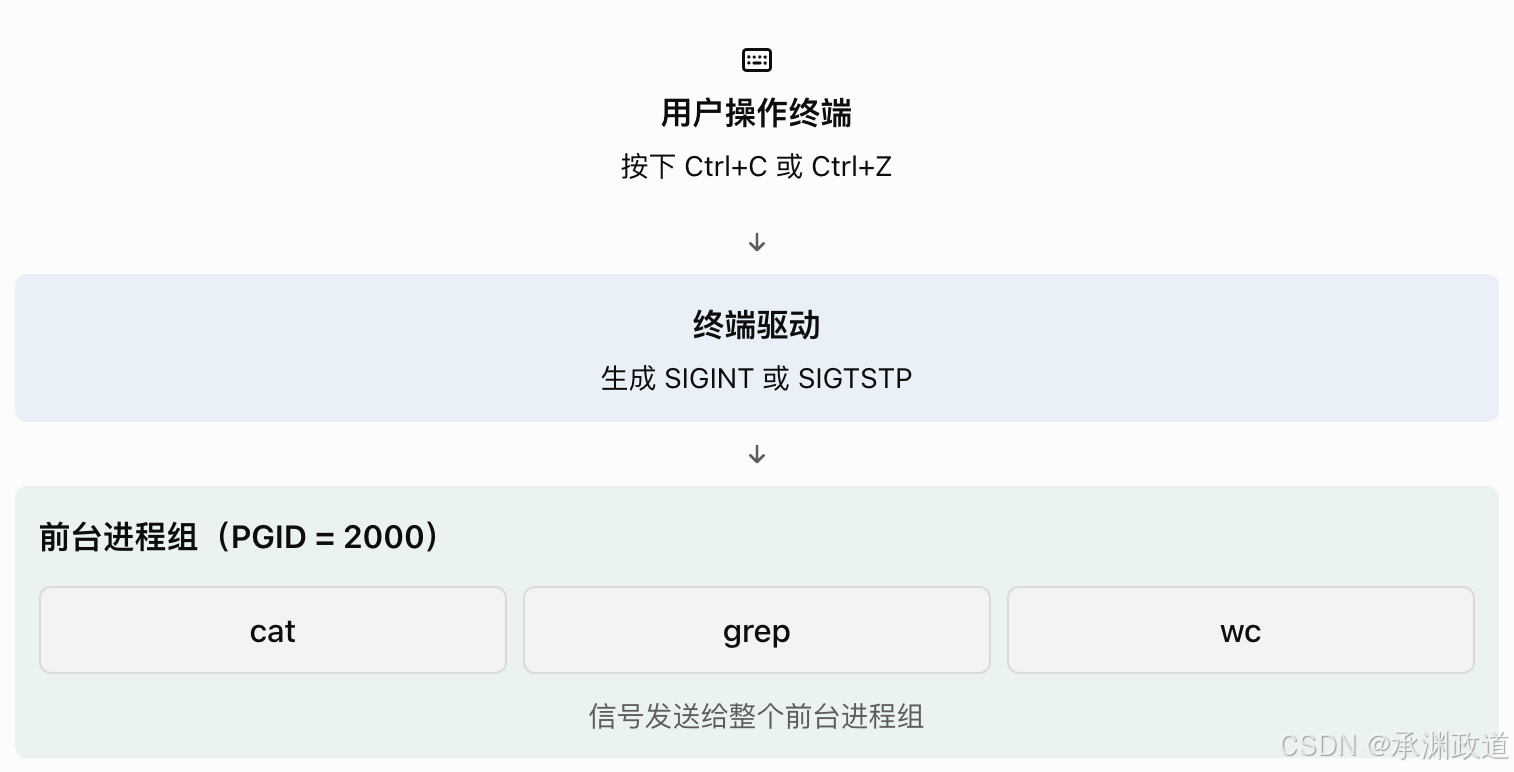
关键点:Ctrl+C 和 Ctrl+Z 产生的终端信号,默认发送给整个前台进程组,而不是仅发送给某一个进程.
3.SIGTSTP、SIGSTOP、SIGCONT 的区别
这三个信号最容易混淆.
-
SIGTSTP:请求暂停
sleep 100
按下 Ctrl+Z,终端通常发送 SIGTSTP,使作业暂停.
SIGTSTP 可以被进程捕获、忽略或阻塞.
-
SIGSTOP:强制暂停
kill -STOP 1234
SIGSTOP 不能被捕获、忽略或阻塞,因此能强制停止目标进程.
-
SIGCONT:恢复执行
kill -CONT 1234
让被停止的进程继续运.
注意:SIGCONT 只负责恢复执行,不负责把作业切换到终端前台.
4.SIGTTIN 和 SIGTTOU:控制后台作业访问终端
假设:
cat &cat 在后台执行,却尝试从控制终端读取输入.
此时终端驱动通常会向它所在的后台进程组发送 SIGTTIN,导致进程组停止.
而 SIGTTOU 主要与后台进程组写入或操作控制终端有关.普通后台输出通常是允许的;启用终端的 TOSTOP 设置后,后台写入也可能触发 SIGTTOU.
这两个信号帮助 Shell 维持前台与后台作业之间的终端访问规则.
5.SIGCHLD:Shell 如何知道作业状态变化?
假设 Shell 创建了一个子进程:
pid_t pid = fork();子进程退出、被停止或恢复运行时,在符合条件的情况下,内核会向父进程发送 SIGCHLD.
Shell 可以结合:
waitpid(pid, &status, WUNTRACED | WCONTINUED);获取子进程的状态变化,从而维护 jobs 所显示的作业状态.
这就是为什么Shell能显示:
[1]+ Stopped sleep 100或者:
[1]+ Done sleep 1006.作业控制的完整流程
启动前台作业
      │
      ▼
Running(运行中)
      │
      │ Ctrl+Z → SIGTSTP
      ▼
Stopped(已停止)
      │
      ├── bg %1
      │     │
      │     └── SIGCONT → 后台运行
      │
      └── fg %1
            │
            └── 切换前台 + SIGCONT
                       │
                       ▼
                   前台运行
                       │
                       │ Ctrl+C → SIGINT
                       ▼
通常终止其中,fg 切换前台还涉及 tcsetpgrp(),并不是只发送一个信号.
3.5守护进程
cpp
//Daemon.hpp
#pragma once

#include <iostream>
#include <cstdlib>
#include <signal.h>
#include <unistd.h>
#include <fcntl.h>
#include <sys/types.h>
#include <sys/stat.h>

const char *root = "/";
const char *dev_null = "/dev/null";

void Daemon(bool ischdir, bool isclose)
{
    // 1. 忽略可能引起程序异常退出的信号
    signal(SIGCHLD, SIG_IGN);
    signal(SIGPIPE, SIG_IGN);

    // 2. 让自己不要成为组长
    if (fork() > 0)
        exit(0);

    // 3. 设置让自己成为一个新的会话
    // 后面的代码其实是子进程在走
    setsid();

    // 4. 每一个进程都有自己的 CWD
    // 是否将当前进程的 CWD 更改成为 / 根目录
    if (ischdir)
        chdir(root);

    // 5. 已经变成守护进程啦
    // 不需要和用户的输入、输出、错误进行关联了
    if (isclose)
    {
        close(0);
        close(1);
        close(2);
    }
    else
    {
        // 这里一般建议就用这种
        int fd = open(dev_null, O_RDWR);

        if (fd > 0)
        {
            dup2(fd, 0);
            dup2(fd, 1);
            dup2(fd, 2);
            close(fd);
        }
    }
}
3.6如何将服务守护进程化
核心思路:在 TCP 服务器启动时调用 Daemon(),让服务器脱离控制终端,在后台持续运行.
结合编写的 Daemon.hpp 和网络计算器项目,可以分成三个部分理解.
一、守护进程化的实现流程
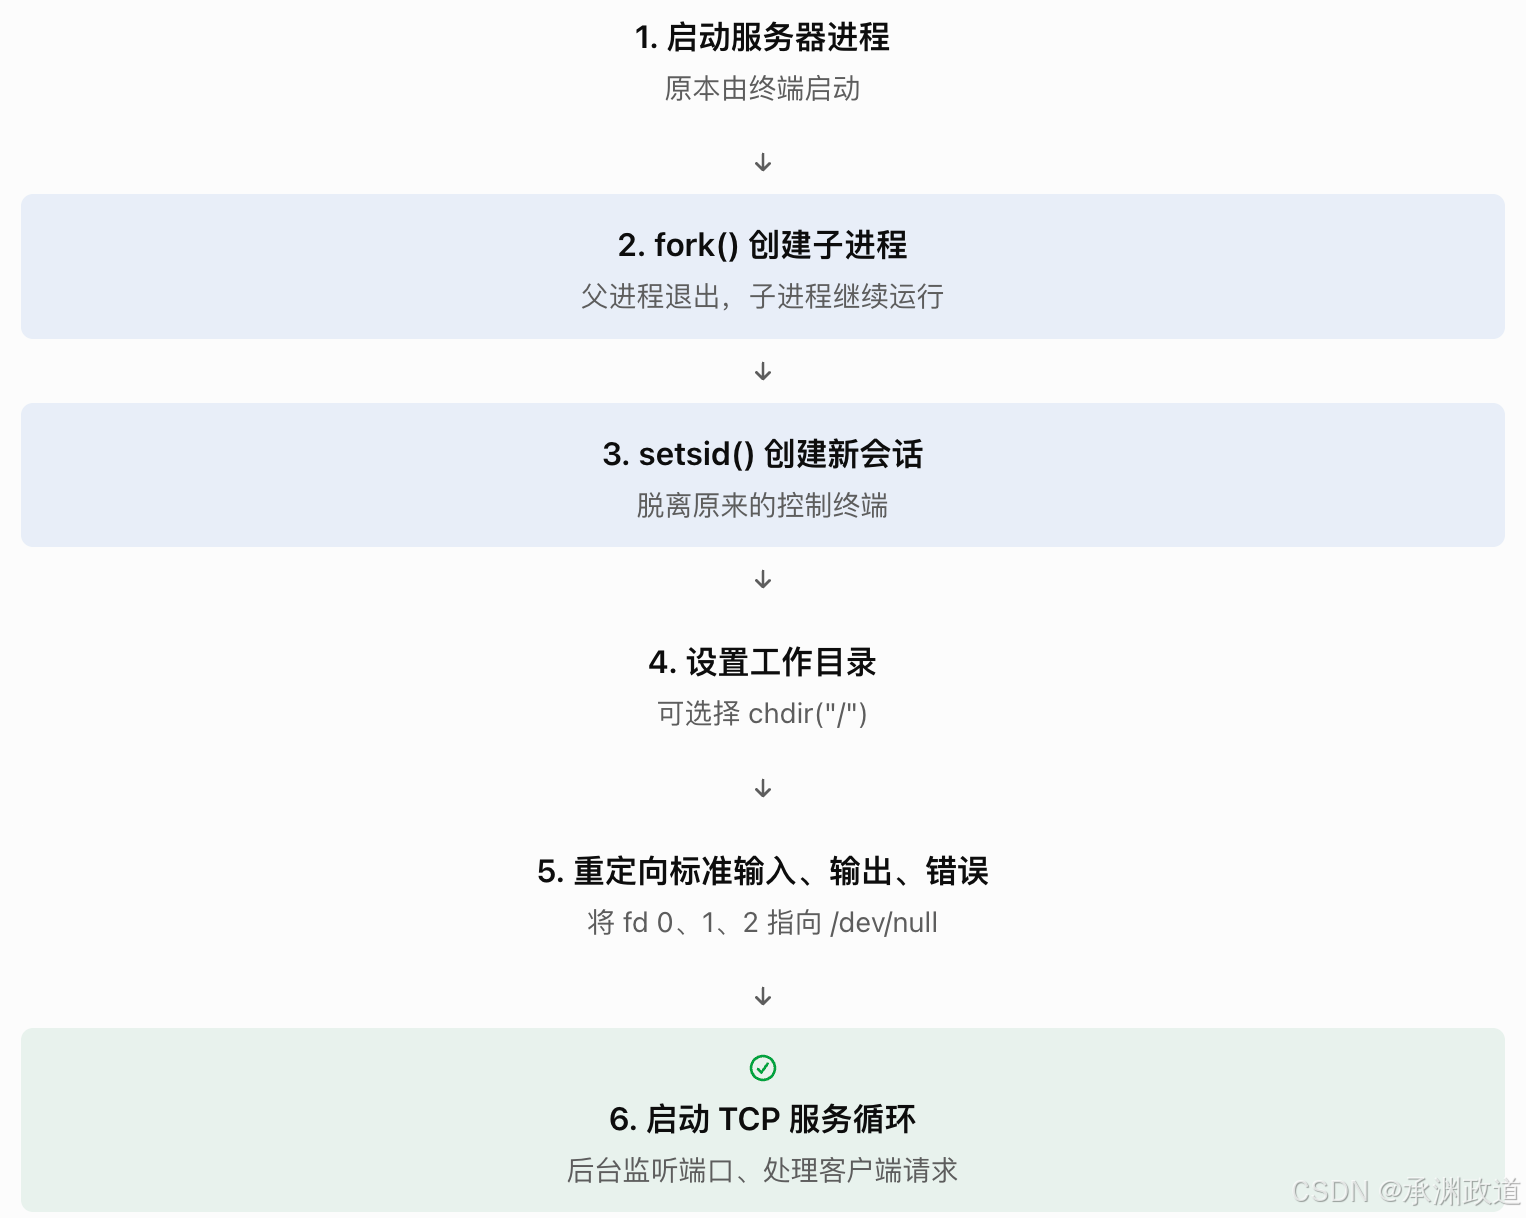 二、如何应用到你的网络计算器项目?
前面已经实现了 Daemon.hpp,因此只需要在 NetCalServer.cc 中调用.
假设原来的服务器主逻辑为:
cpp
// 创建 TCP 服务器
// 初始化服务器

tsvr->Loop();
修改后:
cpp
#include "Daemon.hpp"

// ... 原来的头文件和初始化逻辑

int main(int argc, char *argv[])
{
    // 1. 进行命令行参数检查

    // 2. 守护进程化
    Daemon(true, false);

    // 3. 创建并初始化 TCP 服务器
    // 保留原有服务器初始化代码

    // 4. 进入服务器循环
    tsvr->Loop();

    return 0;
}这里展示的是调用位置,tsvr 仍然需要按照原项目代码创建和初始化.
Daemon(true, false) 代表什么?
根据之前的实现:
cpp
Daemon(true, false);第一个参数 true:
cpp
if (ischdir)
    chdir("/");
将当前工作目录修改为根目录 /.
第二个参数 false:
cpp
int fd = open("/dev/null", O_RDWR);

dup2(fd, 0);
dup2(fd, 1);
dup2(fd, 2);
让标准输入、标准输出和标准错误都指向 /dev/null.
因此,之后的 std::cout 不会像以前那样显示在启动终端上.
注意:原先的代码使用 if (fd > 0),应修改成 if (fd >= 0) 并检查 dup2() 是否成功.
三、为什么要在服务器启动时调用 Daemon()?
假设原来执行:
bash
./netcal_server 8080服务器以前台方式运行,终端通常被它占用.
现在调用 Daemon() 后:
终端 Shell
    │
    ▼
./netcal_server
    │
    ▼
  fork()
    │
    ├── 父进程退出
    │
    └── 子进程继续运行
              │
              ▼
           setsid()
              │
              ▼
        脱离控制终端
              │
              ▼
       TCP 服务器继续工作
              │
              ▼
      accept() 等待客户端
              │
              ▼
        处理网络请求
此时 Shell 可以继续接受命令,服务器仍然能够在后台提供TCP服务.
如果是准备正式部署 Linux TCP 服务器,更推荐交给 systemd 管理.它可以负责后台运行、日志收集、故障重启,此时服务器通常不需要自行调用 Daemon().
最终总结:将你的网络计算器服务守护进程化,关键就是在进入 TCP 服务循环之前执行:
Daemon(true, false);这样,服务器进程就能在脱离控制终端后继续运行,持续执行 accept() 接收客户端连接.
记住:守护进程化解决的是服务器如何脱离终端持续运行;fork() 处理客户端解决的是服务器如何并发提供服务.这是两个不同的问题.
🚀真正的勇者不是流泪的人,而是含泪奔跑的人!
敬请期待下一篇文章内容
每日心灵鸡汤: 自渡者,天助之!
救自己千千万万次,天助自助者!低落时学会自我鼓励,不任由情绪沉沦,遇到难题主动钻研,不等别人来拉一把.考试失利及时复盘,重新拾起前行勇气;摒弃拖延与懒惰,主动把握每寸光阴,不坐等好运降临,依靠努力慢慢变强.听见质疑不自我动摇,守住心中目标,学会及时停止内耗,把精力放回学习.一次次自我救赎,终会跨过重重关卡.坚持自救与深耕,时光不负不懈之人.