《Agentic Design Patterns》第 19 章导读:评估与监控
本文是对开源书籍《Agentic Design Patterns》第 19 章的解读与导读,内容忠实呈现原文,并附个人思考。
原书在线阅读:https://adp.xindoo.xyz/ | 翻译项目代码仓库:https://github.com/xindoo/agentic-design-patterns
前面我们聊了怎么让智能体更聪明------规划、推理、协作、工具使用......但有一个灵魂拷问:你怎么知道你的智能体表现好不好?
传统软件有单元测试、集成测试、性能测试------输入什么、输出什么,清清楚楚。但 AI 智能体不一样:它是概率性的、非确定性的,同一个问题每次回答可能都不一样。它还会调用工具、跟环境交互,行为轨迹千变万化。
第 19 章讲的就是评估和监控------怎么系统地衡量智能体的性能、监控目标进展、检测操作异常。
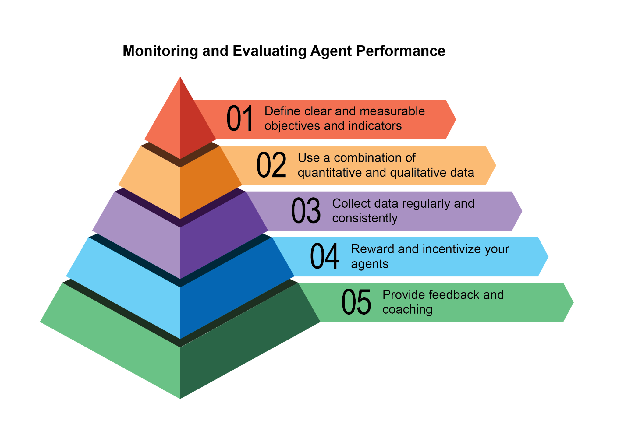
一、为什么评估和监控这么难?
先想一下:你怎么评估一个客服聊天机器人的好坏?
传统思路:写一堆测试用例,输入问题,检查输出------但输出是自然语言啊!"请问怎么退款?"和"我要退货退款"表达的是同一个意思,但字符串完全不一样。精确匹配根本行不通。
而且智能体不只是"回答问题",它还会:
- 调用工具(查订单、改地址、退款项)
- 多轮对话(用户说不清,智能体得追问)
- 处理异常(订单不存在怎么办?)
- 跟其他系统交互
这就导致传统的软件测试方法完全不够用。我们需要全新的评估体系。
书中列举了 7 个典型应用场景:
| 场景 | 说明 |
|---|---|
| 实时性能跟踪 | 持续监控生产环境中智能体的准确性、延迟、资源消耗 |
| A/B 测试 | 并行比较不同版本/策略的性能,找出最优方案 |
| 合规与安全审计 | 自动生成审计报告,跟踪道德准则、监管要求的遵守情况 |
| 企业系统治理 | AI"合约"------为 AI 委派的任务编纂目标、规则和控制机制 |
| 漂移检测 | 监控输出质量是否随时间退化(数据分布变化、环境变化) |
| 异常检测 | 识别异常或意外操作,可能表明错误、攻击或涌现的不良行为 |
| 学习进度评估 | 跟踪学习型智能体的学习曲线、技能改进、泛化能力 |
二、基础评估指标
1. 响应准确性评估
最基础的评估是检查智能体输出的正确性。但"正确性"怎么衡量?
一个最简单的版本是精确匹配:
python
def evaluate_response_accuracy(agent_output: str, expected_output: str) -> float:
    """计算智能体响应的简单准确度分数。"""
    return 1.0 if agent_output.strip().lower() == expected_output.strip().lower() else 0.0
但这个方法问题很大------"法国首都是巴黎"和"巴黎是法国的首都"意思完全一样,但字符串不匹配,就会被判 0 分。
真实场景中需要更高级的指标:
- 字符串相似度:Levenshtein 距离、Jaccard 相似度
- 关键词分析:检查关键词的存在/缺失
- 语义相似度:用嵌入模型计算余弦相似度
- LLM-as-a-Judge:让另一个 LLM 来评估细微的正确性和有用性
- RAG 特定指标:忠实性(答案是否基于检索到的上下文)、相关性
2. 延迟监控
响应速度直接影响用户体验。特别是在实时或交互式环境中,延迟过高会严重损害用户体验。
实际应用中,延迟数据不能只打印到控制台,需要记录到持久存储:
- 结构化日志文件(JSON 格式)
- 时间序列数据库(InfluxDB、Prometheus)
- 数据仓库(Snowflake、BigQuery、PostgreSQL)
- 可观测性平台(Datadog、Splunk、Grafana Cloud)
3. Token 使用量跟踪
LLM 驱动的智能体,成本主要来自 token 消耗。输入输出 token 越多,账单越贵。
python
class LLMInteractionMonitor:
    def __init__(self):
        self.total_input_tokens = 0
        self.total_output_tokens = 0

    def record_interaction(self, prompt: str, response: str):
        # 实际场景用 LLM API 的 token 计数器或 tokenizer
        input_tokens = len(prompt.split())
        output_tokens = len(response.split())
        self.total_input_tokens += input_tokens
        self.total_output_tokens += output_tokens
跟踪 token 使用量有两个好处:
- 成本管理:知道钱花在哪了,优化资源分配
- 改进提示词:识别提示词工程或响应生成中的优化空间
三、LLM-as-a-Judge:用 AI 评估 AI
"有用性"、"质量"这些主观品质,用客观指标很难衡量。这时候就有了一个巧妙的思路:让一个 LLM 来评估另一个 LLM 的输出。
这就是 LLM-as-a-Judge 方法。它的优势是:
- 一致:同样的标准,不会今天松明天紧
- 高效:可以大规模并行评估
- 可扩展:想加多少评估维度就加多少
书中给了一个法律调查问题质量评估的完整示例,用 Gemini 模型当法官,从五个维度打分:
| 评估维度 | 说明 |
|---|---|
| 清晰性和精确性 | 问题是否模糊、歧义、令人困惑 |
| 中立性和偏见 | 是否有引导性或有偏见的语言 |
| 相关性和焦点 | 是否与调查目标直接相关 |
| 完整性 | 是否提供了回答所需的足够上下文 |
| 受众适当性 | 术语难度是否适合目标受众 |
每个维度 1-5 分,最后输出 JSON 格式的结构化结果:整体分数、理由、详细反馈、关注点、建议行动。
python
class LLMJudgeForLegalSurvey:
    """使用生成式 AI 模型评估法律调查问题的类。"""
    def __init__(self, model_name='gemini-1.5-flash-latest', temperature=0.2):
        self.model = genai.GenerativeModel(model_name)
        self.temperature = temperature

    def judge_survey_question(self, survey_question: str) -> Optional[dict]:
        full_prompt = self._generate_prompt(survey_question)
        response = self.model.generate_content(
            full_prompt,
            generation_config=genai.types.GenerationConfig(
                temperature=self.temperature,
                response_mime_type="application/json"
            )
        )
        return json.loads(response.text)
当然,LLM-as-a-Judge 也不是完美的------它受限于"法官"LLM 自身的能力,可能忽略中间步骤,也可能有自己的偏见。
三种评估方法对比:
| 评估方法 | 优势 | 劣势 |
|---|---|---|
| 人工评估 | 能捕捉细微行为、考虑主观因素 | 难以扩展、昂贵、耗时 |
| LLM-as-a-Judge | 一致、高效、可扩展 | 可能忽略中间步骤、受 LLM 能力限制 |
| 自动化指标 | 可扩展、高效、客观 | 在捕获完整能力方面可能有局限 |
四、智能体轨迹评估
评估智能体不能只看最终输出,还要看它是怎么走到那里的 ------也就是它的轨迹(trajectory)。
轨迹就是智能体达到目标所采取的步骤序列。评估轨迹可以检查:
- 决策质量好不好
- 推理过程对不对
- 工具有没有用对
- 效率高不高
比如一个处理客户产品查询的智能体,理想轨迹应该是:
- 确定用户意图
- 使用数据库搜索工具
- 审查结果
- 生成报告
把智能体的实际操作和理想轨迹对比,就能发现错误和低效率。
对比方法有很多种:
| 方法 | 说明 | 严格程度 |
|---|---|---|
| 精确匹配 | 要求与理想序列完全一致 | 最高 |
| 按序匹配 | 正确操作按顺序,允许有额外步骤 | 中等 |
| 任意顺序匹配 | 正确操作以任何顺序,允许额外步骤 | 较低 |
| 精确度 | 测量预测操作的相关性 | 灵活 |
| 召回率 | 测量捕获了多少基本操作 | 灵活 |
| 单工具使用 | 检查特定操作是否发生 | 最低 |
选哪种方法取决于场景------高风险场景可能要求精确匹配,灵活场景用按序或任意顺序就行。
测试文件 vs 评估集文件
ADK(Google 的 Agent Development Kit)提供了两种评估文件格式:
- 测试文件:单个简单的智能体交互,JSON 格式,适合单元测试,快速执行
- 评估集文件:多个可能很长的会话,适合模拟复杂多轮对话和集成测试
每个测试/评估包含多个"回合",每个回合包括:用户查询、预期的工具使用、中间智能体响应、最终响应。
五、多智能体评估:评估"团队表现"
评估多智能体系统就像评估团队项目------不只要看每个人干得怎么样,还要看整个团队配合得好不好。
四个关键问题:
-
智能体是否有效合作?
比如"航班预订智能体"成功订完票后,有没有正确把日期和目的地传给"酒店预订智能体"?传错了酒店就订错了时间。
-
它们是否制定了好计划并坚持执行?
计划是先订航班再订酒店,如果"酒店智能体"在航班确认前就尝试订房,那就是偏离计划了。还要检查智能体会不会卡住------比如无休止地搜"完美"的租车,永远不进入下一步。
-
是否为正确的任务选择了正确的智能体?
用户问天气,系统应该用专门的"天气智能体"(提供实时数据),而不是"通用知识智能体"(只给"夏天通常很温暖"这种废话)。
-
添加更多智能体是否真的提高了性能?
加了个"餐厅预订智能体",是让整体旅行规划更好更高效了?还是造成冲突、拖慢系统?如果是后者,说明可扩展性有问题。
六、从智能体到高级承包商
书中提出了一个很有意思的演进方向:从简单的 AI 智能体,演进为高级"承包商"(Contractor)。
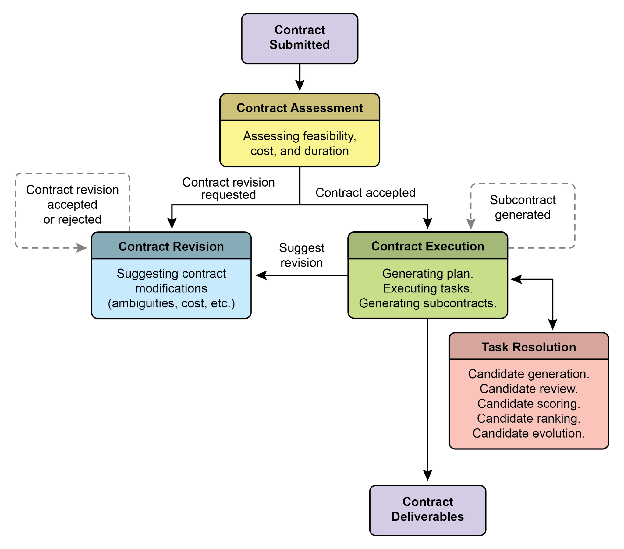
当今的 AI 智能体靠简短模糊的指令运行------做 demo 还行,放到生产环境就很脆弱,因为歧义会导致失败。
"承包商"模型通过建立用户和 AI 之间严格的正式化关系来解决这个问题------就像人类世界的法律服务协议一样,明确定义、双方同意。
四个关键支柱:
1. 正式化合约
不是简单的提示词,而是详细的规范,作为任务的唯一真实来源。
比如财务分析任务的合约不会只说"分析上个季度的销售",而是会要求:
- 一份 20 页的 PDF 报告
- 分析 2025 年第一季度欧洲市场销售
- 包含五个特定的数据可视化
- 与 2024 年第一季度的比较分析
- 基于提供的供应链中断数据集的风险评估
明确到可交付成果、精确规格、可接受的数据源、工作范围、预期成本和完成时间------结果客观可验证。
2. 动态协商和反馈生命周期
合约不是静态命令,而是对话的开始。承包商智能体可以分析初始条款并进行协商。
比如合约要求使用智能体无法访问的专有数据库,它可以返回反馈:"指定的 XYZ 数据库不可访问。请提供凭据或批准使用替代公共数据库,这可能会略微改变数据的粒度。"
协商阶段还允许智能体标记歧义或潜在风险------在执行开始之前解决误解,防止代价高昂的失败。
3. 以质量为中心的迭代执行
承包商优先考虑正确性和质量,而不是低延迟。它基于自我验证和纠正的原则运作。
比如代码生成合约,智能体不会只是写代码;它会:
- 生成多个算法方法
- 根据合约定义的单元测试编译和运行它们
- 对性能、安全性、可读性等指标评分
- 只提交通过所有验证标准的版本
4. 通过子合约的层次化分解
复杂度很高的任务,主承包商智能体充当项目经理,把大目标分解成更小的子任务------通过生成新的正式"子合约"。
比如"构建电商移动应用"的主合约,可以分解为:
- 设计 UI/UX
- 开发用户身份验证模块
- 创建产品数据库架构
- 集成支付网关
每个子合约都是完整独立的,有自己的可交付成果和规格,可以分配给其他专门的智能体。
这个承包商模型的思路非常值得深思。它本质上是把软件工程中的"需求规格说明书"、"合同管理"、"项目分解"等成熟实践,引入到 AI 智能体的交互中。对于高风险、高价值的任务,这可能是未来的方向。
七、Google ADK 的评估支持
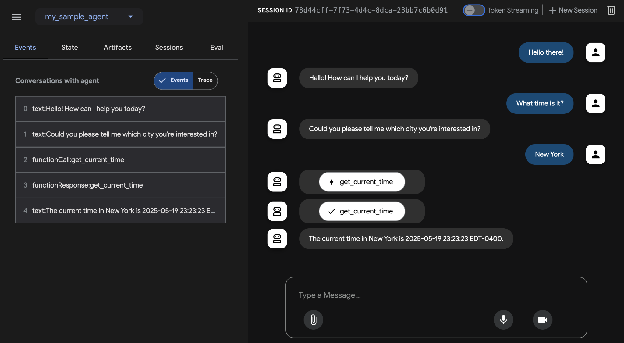
Google 的 ADK(Agent Development Kit)提供了三种评估方式:
- 基于 Web 的 UI(
adk web):交互式评估和数据集生成,可视化地创建会话并保存到评估集 - pytest 编程集成 :通过
AgentEvaluator.evaluate调用,整合到测试管道中,适合 CI/CD - 命令行界面(
adk eval):自动化评估,适合定期构建和验证流程
八、速览:评估和监控设计模式
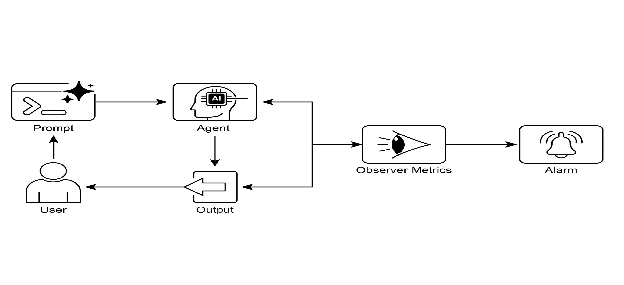
| 维度 | 说明 |
|---|---|
| 问题背景 | Agentic 系统在复杂动态环境中运行,性能可能随时间退化。概率性和非确定性意味着传统软件测试不足以确保可靠性 |
| 解决方案 | 标准化评估和监控框架------定义明确指标(准确性、延迟、token 使用)、分析智能体轨迹、采用 LLM-as-a-Judge、建立反馈循环 |
| 实践建议 | 生产环境部署、A/B 测试比较、合规审计、漂移检测、评估复杂行为(轨迹 + 主观质量)时使用 |
九、关键要点总结
- 超越传统测试:评估智能体需要在真实环境中持续测量其有效性、效率和合规性
- 基础指标三件套:响应准确性、延迟监控、token 使用跟踪------每个智能体系统都得有
- 轨迹评估很重要:不只要看结果,还要看过程------把实际操作和理想路径对比,发现错误和低效率
- LLM-as-a-Judge 是利器:主观品质(有用性、质量)的评估,让 AI 来评 AI,一致且可扩展
- 多智能体要看协作:团队表现不等于个体表现之和,要检查合作质量、计划执行、角色匹配、可扩展性
- 承包商模型是未来方向:从简单提示词到正式合约,协商、分解、自我验证------让 AI 从不可预测的工具变成可问责的系统
我的思考
这一章让我感触最深的是**"从智能体到承包商"**这个概念。
现在很多人做 AI 应用,思路还是"写个好提示词就行"。但真要上生产,你会发现:歧义、边界情况、可靠性、可审计性......全是问题。承包商模型提出的四个支柱------正式合约、协商反馈、迭代执行、层次分解------其实就是把人类社会中已经验证过的"工程项目管理"方法论,移植到 AI 系统中来。
另外,LLM-as-a-Judge 也是一个非常实用的技术。以前评估 AI 输出质量只能靠人,贵且慢。现在用 AI 评 AI,虽然不是 100% 准确,但胜在快、便宜、一致,可以作为第一道筛选关卡。
当然,评估和监控是个大学问------数据漂移怎么检测?异常行为怎么发现?多智能体的协作效率怎么量化?这些问题都还在探索中。但至少,我们已经有了一个框架和起点。
下一章我们聊第 20 章------优先级排序。当智能体面临一堆任务、目标冲突、资源有限时,该先做什么?后做什么?敬请关注!