GPT-4 系列退役在即:一套可回滚的模型迁移验收法
OpenAI 在 2026 年 10 月 14 日公布:指定的 GPT-4o、GPT-4o mini、GPT-4.1 与 GPT-4.1 mini 快照将在 2027 年 1 月 14 日停止服务,微调版本也跟随基础模型采用同一时间表,官方推荐替代为 gpt-6-luna。
三个月看起来不短,但生产迁移最容易踩的坑,是把它理解成一次字符串替换:
diff
- model: "gpt-4.1-2025-04-14"
+ model: "gpt-6-luna"
真正变化的可能还有推理参数、接口行为、工具调用、结构化输出、延迟分布、缓存命中和失败重试。更稳妥的目标不是"请求成功",而是"业务门禁通过,而且能快速回滚"。
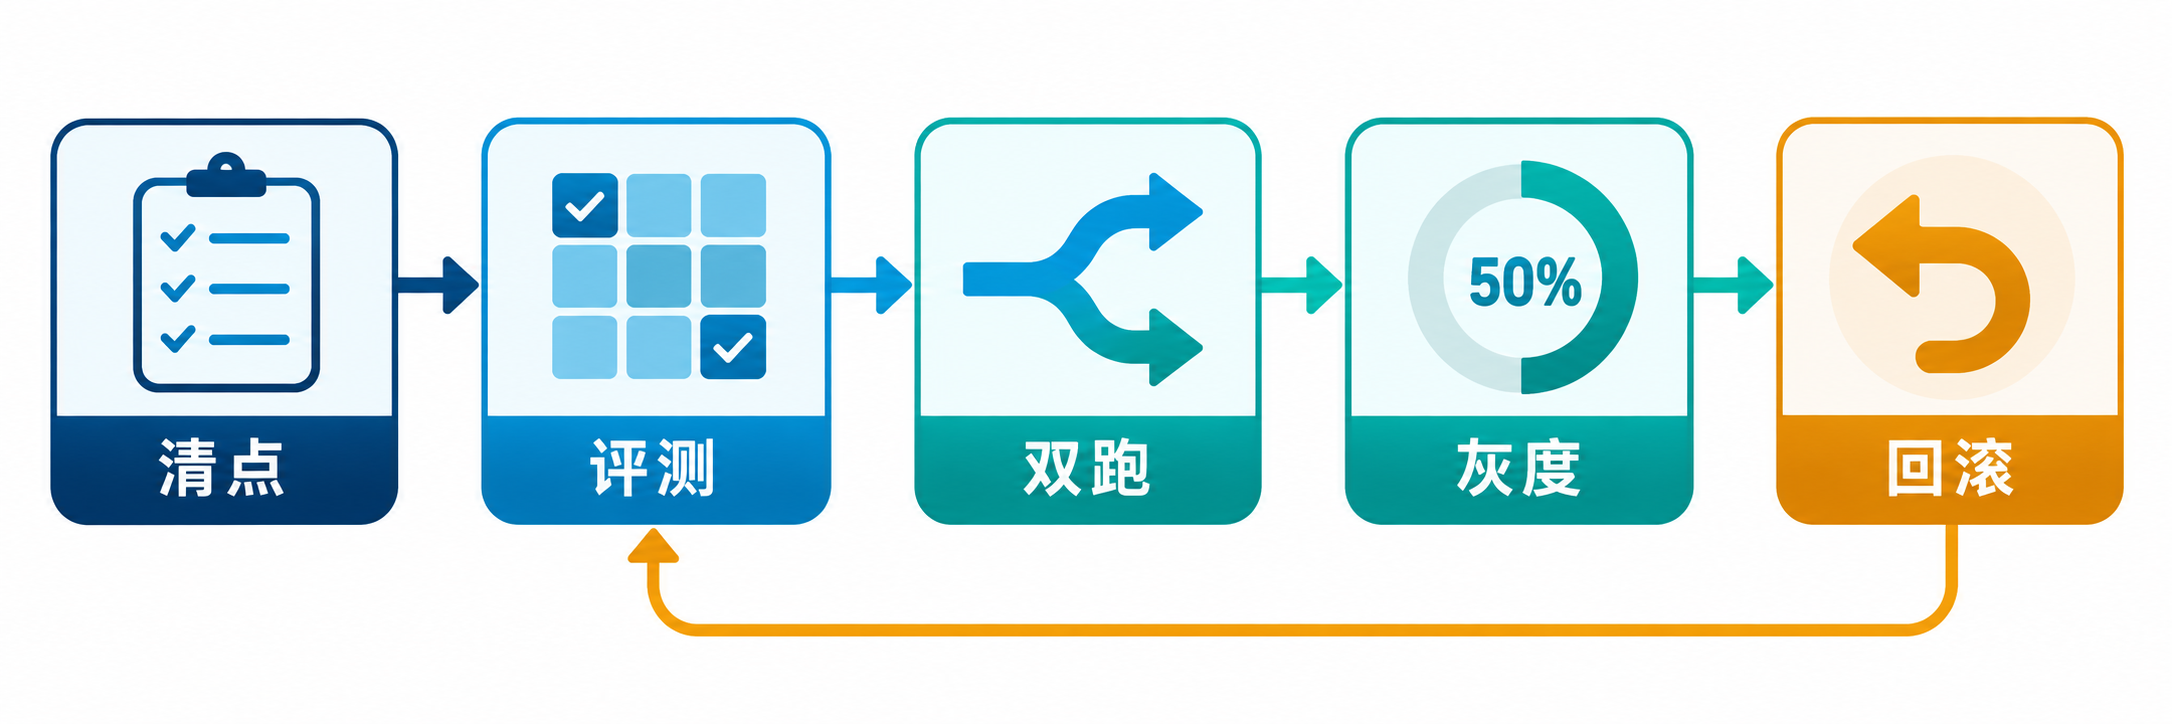
第一步:按请求类型清点,而不是按项目清点
同一项目里,摘要、分类、代码生成和带工具的 Agent 风险完全不同。建议把迁移台账拆到"可观测的请求类型":
| 字段 | 示例 |
|---|---|
| 场景 | 工单分类 |
| 当前模型 | gpt-4o-mini-2024-07-18 |
| 接口 | Responses / Chat Completions |
| 输出契约 | JSON Schema v3 |
| 工具与副作用 | 查询库存;无写操作 |
| 核心指标 | 分类准确率、P95 延迟、单次成本 |
| 回滚开关 | MODEL_ROUTE=ticket-v2 |
还要单列微调模型、硬编码模型名、备用路由、批处理任务和离线脚本。只查主服务配置,往往会漏掉定时任务与故障降级路径。
第二步:建立能算分的黄金评测集
不要只准备"正常问题"。一个可用的最小集合至少包含三类:
- 正常样本:覆盖主流输入和主要业务意图;
- 边界样本:长输入、空字段、多语言、歧义表达、超时工具;
- 失败样本:越权请求、无答案问题、工具异常、非法结构。
每个样本都要有可判断的通过条件。文本生成可用规则与人工抽检结合;结构化任务优先使用 schema 合法率、字段准确率和拒答一致性。官方提示词指南也强调:每次发布提示词时运行测试和评测用例。
一个简单的评测记录可以长这样:
json
{
  "case_id": "ticket-refund-017",
  "expected": {"intent": "refund", "needs_human": false},
  "gates": {
    "schema_valid": true,
    "intent_match": true,
    "tool_calls_max": 1,
    "latency_ms_max": 1800
  }
}
第三步:双跑,但隔离所有副作用
双跑不是把同一条"退款""发信"或"改库"操作执行两遍。正确做法是让旧链路继续承接真实流量,新链路进入影子模式:
- 复制输入与必要上下文;
- 写工具统一替换为 mock、dry-run 或只读适配器;
- 分别记录输出、工具计划、token、延迟与错误;
- 用同一评测器生成差异报告。
比较时不要只看平均值。至少观察 P50/P95/P99 延迟、结构合法率、关键任务成功率、工具调用次数、重试率与单位请求成本。少量长尾失败常常会被平均分掩盖。
第四步:把灰度门禁写成配置
灰度可以按 1%→5%→20%→50%→100% 推进,但百分比不是重点,门禁才是。
yaml
route: ticket-classifier-v2
candidate_model: gpt-6-luna
stages: [1, 5, 20, 50, 100]
promote_when:
  schema_valid_rate: ">= 99.9%"
  task_success_delta: ">= -0.3%"
  p95_latency_delta: "<= 15%"
rollback_when:
  critical_error_count: ">= 1"
  tool_side_effect_mismatch: ">= 1"
阈值应按业务风险设定,不能照抄示例。支付、医疗或权限变更等高风险链路,需要更严格的样本和人工复核。
第五步:回滚要覆盖整条链路
只回滚模型名通常不够。迁移中如果同时调整了提示词、工具 schema、输出解析器或缓存键,旧模型可能已经无法适配新契约。
建议把以下内容作为同一个发布单元版本化:
- 模型与接口;
- system/developer 提示词;
- reasoning 与文本输出参数;
- 工具定义及顺序;
- JSON Schema 和解析器;
- 缓存键与缓存策略;
- 评测集版本和监控门禁。
回滚演练至少做一次:人为触发候选链路失败,确认流量能切回、告警能到达、影子任务能停止、未完成副作用不会重复执行。
一个容易忽略的接口差异
GPT-6 Luna 官方模型页注明:Responses API 支持内置工具与函数调用;如果使用 Chat Completions 做函数调用,需要将 reasoning_effort 设为 none。因此,迁移前必须检查现有调用路径,不能只替换模型 ID 后沿用全部参数。
完成标准
模型迁移完成,不是"新模型能返回内容",而是满足四件事:
- 退役范围内的线上、离线与微调依赖全部清零;
- 黄金评测集和线上门禁连续通过;
- 双跑差异已经解释,副作用经过隔离验证;
- 回滚开关经过演练,值班人员知道何时触发。
把迁移当成一次可观测、可暂停、可回退的生产变更,才不会把官方时间表变成最后一周的紧急替换。
参考资料
- OpenAI API Deprecations:https://developers.openai.com/api/docs/deprecations
- OpenAI Models:https://developers.openai.com/api/docs/models
- GPT-6 Luna:https://developers.openai.com/api/docs/models/gpt-6-luna
- OpenAI Prompting:https://developers.openai.com/api/docs/guides/prompting