作者:王日宇(霁谦)StarRocks Committer;阿里云技术专家
在实时湖仓中,Apache Paimon 负责管理持续变化的湖上数据,StarRocks 则通过 Paimon Catalog,为这些数据提供报表、交互式分析和跨源关联能力。数据仍然保存在湖上,用户可以继续使用熟悉的 SQL 完成查询。
但查询 Paimon 表并不只是读取 Parquet 或 ORC 文件。以主键表为例,同一条记录的多个版本可能分散在不同文件中,查询引擎还需要根据 Paimon 的表格式语义完成版本合并、删除处理等工作。过去,这类任务通常需要 StarRocks 通过 JNI 调用 Paimon Java SDK 完成。
随着数据规模、表宽和查询并发增加,跨语言调用、数据转换以及湖上数据合并带来的开销会更加明显。用户不仅希望持续变化的主键表和宽表聚合能够查得更快,也希望查询变慢时,能够更清楚地判断时间与内存消耗发生在哪个环节。
为此,StarRocks 接入 Paimon C++,让更多 Paimon 查询可以通过原生执行路径完成。在保持 Paimon 表格式语义和现有 SQL 使用方式不变的同时,它减少了 Java 与 C++ 之间的交互,并进一步复用 StarRocks 的缓存、内存管理和 Query Profile 能力。
本文将介绍 Paimon C++ 在 StarRocks 查询链路中的作用、不同 Reader 的选择方式,以及如何结合实际查询评估原生读取带来的性能收益。
一、Paimon C++ 是什么,为什么要引入它
让 C++ 引擎直接理解 Paimon 表
Paimon C++,也称 paimon-cpp,是 Apache Paimon 的 C++ 实现,为原生计算引擎提供访问 Paimon 表的能力。对 StarRocks 用户而言,它是查询引擎内部的一个组件,不需要单独部署服务,也不改变已有的 SQL 查询方式。
与直接读取 Parquet、ORC 文件不同,查询 Paimon 表还需要理解快照、主键合并和数据删除等表格式语义。
例如,一笔订单先后经历"待支付""已支付""已完成"几个状态,相关记录可能分布在不同的数据文件中。查询时,读取组件需要根据 Paimon 的合并规则处理不同版本和删除信息,才能还原用户应当看到的结果。仅仅读取各个数据文件,并不足以完成这类查询。
StarRocks 已有的文件 Reader 擅长直接读取 Parquet、ORC 数据;Paimon C++ 则进一步处理需要理解 Paimon 表格式语义的读取任务。由此,更多查询可以直接进入 StarRocks 的原生执行路径,并与后续的过滤、关联和聚合计算衔接。
原生执行路径带来什么
-
更低的读取开销。 StarRocks 的执行引擎以 C++ 进行向量化计算。通过 Paimon C++ 读取数据,可以减少 Java 与 C++ 之间的调用和数据转换,使读取、合并与后续计算衔接得更紧密。短查询、宽表扫描和主键表合并,是值得重点评估的场景。
-
让更多任务原生执行。 Paimon C++ 能够处理主键合并、删除向量等表格式语义,使原生读取覆盖更多无法简单转换为文件直读的任务。用户仍然查询同一张 Paimon 表,由底层读取组件保证查询结果符合 Paimon 的表规则。
-
更统一的资源管理与观测。 原生接入可以复用 StarRocks 的 I/O 与数据缓存,减少对远程存储的重复访问。相关内存分配和读取指标也可以纳入 StarRocks 的内存管理与 Query Profile,帮助用户判断瓶颈发生在数据读取、版本合并还是后续计算。
二、StarRocks 如何通过 Paimon C++ 查询湖上数据
一次查询的整体过程
从执行链路看,一次查询可以概括为查询规划、并行读取和数据计算三个阶段。
用户提交 SQL 后,StarRocks FE 根据 Paimon 的表结构、快照和文件信息,确定需要读取的数据范围,并将读取任务分发给执行节点。对于由 Paimon C++ Reader 处理的任务,执行节点会按照 Paimon 的表格式语义读取数据,完成所需的主键版本合并和删除处理,再将数据交给 StarRocks 执行过滤、关联和聚合等计算,最终返回查询结果。
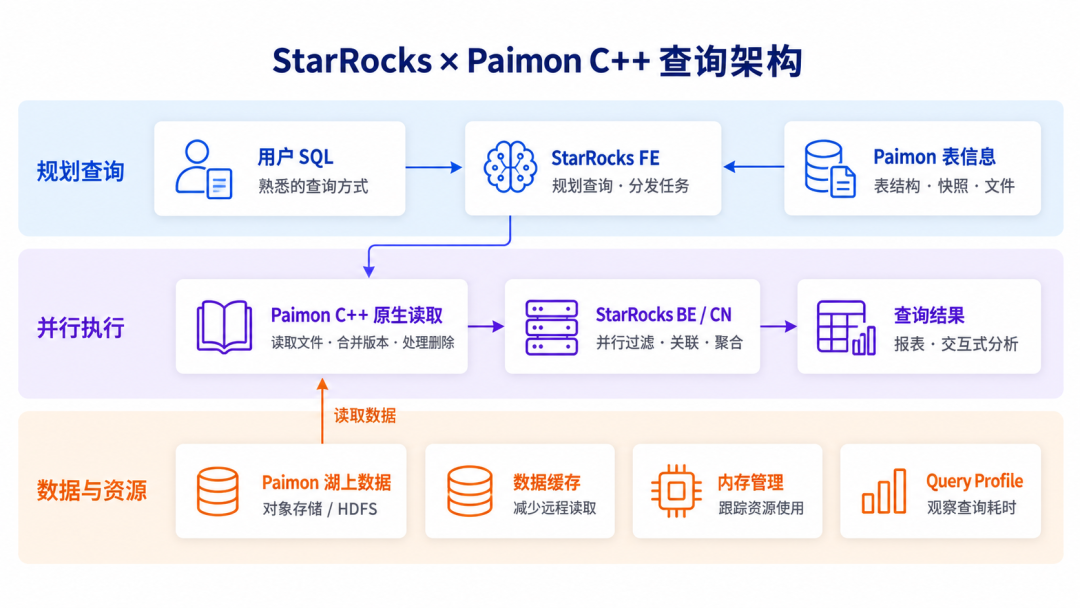
(图 1:Paimon C++ 负责原生读取,StarRocks 负责查询规划与并行计算,数据仍保存在 Paimon 中。)
在这条链路中,Paimon C++ 的读取过程可以复用 StarRocks 的缓存和内存管理能力:缓存用于减少对远程存储的重复访问,内存管理负责跟踪查询资源消耗,Query Profile 则记录各执行阶段的耗时和关键指标。用户无需建立新的监控与调优方式,仍可沿用 StarRocks 现有的查询分析习惯。
三种 Reader 分别负责什么
查询 Paimon 表时,StarRocks 可以通过三类 Reader 执行读取任务。它们适用的任务和执行路径有所不同。
-
**StarRocks 文件 Reader:直接读取 Parquet、ORC。**当一项读取任务可以安全地转换为文件扫描时,StarRocks 可以直接使用自身的文件 Reader。这类任务常见于追加表,也可能出现在满足文件直读条件的主键表中。因此,Reader 的选择不能只根据表是否包含主键来判断。
-
Paimon C++ Reader:原生处理 Paimon 表语义。 对于需要在读取阶段完成主键版本合并、删除处理等操作的任务,Paimon C++ Reader 可以按照 Paimon 的规则组织和读取数据。它也能够读取支持范围内的其他 Paimon 数据,将更多原本依赖 Java SDK 的工作纳入 StarRocks 的原生执行路径。
-
JNI Reader:通过 Paimon Java SDK 读取。 对于系统表等仍需通过 Java 路径处理的特殊任务,StarRocks 会继续使用 JNI Reader。用户也可以显式指定这条路径,用于兼容性排查或与原生读取进行性能对照。
三种 Reader 如何选择
具体使用哪一种 Reader,取决于两个因素:用户设置的读取模式,以及当前读取任务能够由哪类 Reader 处理。
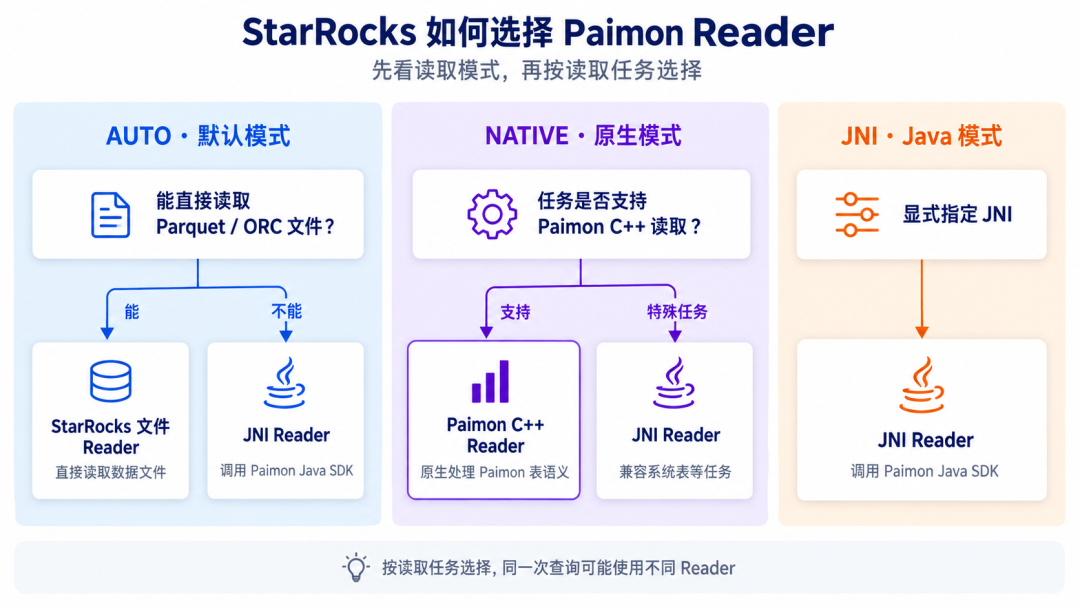
(图 2:默认模式优先尝试文件直读,原生模式对支持的任务使用 Paimon C++,Java 模式指定 JNI。)
在本文使用的 paimon_reader_mode 配置方式下:
-
AUTO:默认模式。 对能够直接读取 Parquet、ORC 文件的任务,优先使用 StarRocks 文件 Reader;其余任务保留 JNI 读取路径。 -
NATIVE:启用 Paimon C++ 原生读取。 支持的普通表读取任务由 Paimon C++ Reader 处理;系统表等特殊任务仍可能使用 JNI Reader。 -
JNI:指定使用 Java SDK 。 所有适用的 Paimon 数据读取任务通过 JNI Reader 执行,可用于兼容性排查以及与原生读取路径进行性能对照。
Reader 的选择发生在具体的读取任务上。当一条 SQL 包含多个扫描任务时,不同任务可能使用不同的 Reader。需要注意的是,AUTO 模式不会自动启用 Paimon C++。评估原生读取的性能收益时,应显式设置为 NATIVE,并结合执行信息确认查询实际使用的读取路径。
三、如何使用 Paimon C++ 的读取能力
建立 Paimon Catalog
Paimon C++ 不改变湖表的接入方式。用户仍然通过 Paimon Catalog 访问数据。以 Hive Metastore 和 HDFS 存储为例,创建 Catalog 的方式如下:
CREATE EXTERNAL CATALOG paimon_lake
PROPERTIES (
    "type" = "paimon",
    "paimon.catalog.type" = "rest",
    "uri" = "https://cn-hangzhou-vpc.dlf.aliyuncs.com",
    "paimon.catalog.warehouse" = "<dlf_catalog_name>",
    "token.provider" = "dlf"
);其中,paimon.catalog.warehouse 用于指定 DLF Catalog,uri 和 dlf.region需要根据 DLF 实例所在地域进行配置。
启用原生读取,执行原有 SQL
以下示例通过 paimon_reader_mode 选择 Paimon C++ Reader(该参数在 v4.2 的文档中引入)。使用前,需要确认当前 StarRocks 版本及执行节点已经支持该功能。
首先查看当前集群是否提供该参数:
SHOW VARIABLES LIKE 'paimon_reader_mode';随后,在当前会话中选择 NATIVE 模式,并开启 Query Profile:
SET paimon_force_jni_reader = false;
SET paimon_reader_mode = 'NATIVE';
SET enable_profile = true;其中,paimon_force_jni_reader 是优先级更高的强制开关。如果该参数为 true,查询仍会通过 JNI Reader 执行。因此,在评估 Paimon C++ Reader 前,需要先将其设置为 false。
完成配置后,用户可以直接执行原有 SQL。例如,统计指定日期内已支付订单的总金额:
SELECT
    order_date,
    SUM(amount) AS paid_amount
FROM paimon_lake.sales.orders
WHERE order_date = '2026-09-01'
  AND order_status = 'PAID'
GROUP BY order_date;
启用 Paimon C++ Reader 不需要重写 SQL,也不改变上层应用的查询逻辑。对于已经通过 Paimon Catalog 访问湖表的业务,变化主要发生在底层数据读取路径。
结合实际查询评估效果
建议选择主键表查询、宽表聚合和常用过滤查询,在数据快照、SQL 和集群资源配置一致的条件下,对比 NATIVE 与 JNI 模式的查询结果和执行耗时。测试时还应保持缓存条件一致,或分别进行冷缓存与热缓存测试,避免将缓存预热带来的变化误认为 Paimon C++ Reader 的收益。
除了查询总耗时,还应结合 Query Profile 和 Reader 诊断信息,确认实际使用的读取路径,并关注扫描数据量、远程读取、缓存命中和内存使用等指标。如果主要耗时发生在 Join、聚合等后续计算阶段,更换 Reader 对端到端查询耗时的改善可能相对有限。
测试完成后,可以将当前会话恢复为默认读取模式:
SET paimon_reader_mode = 'AUTO';四、性能表现与后续规划
性能测试结果:
以下测试比较了 Paimon C++ Reader 与 JNI Reader,环境为单个 BE、8 核 CPU、32 GB 内存。
以下测试在单个 BE、8 核 CPU 和 32 GB 内存的环境中进行,对比了 Paimon C++ Reader 与 JNI Reader 在不同查询场景下的执行耗时。
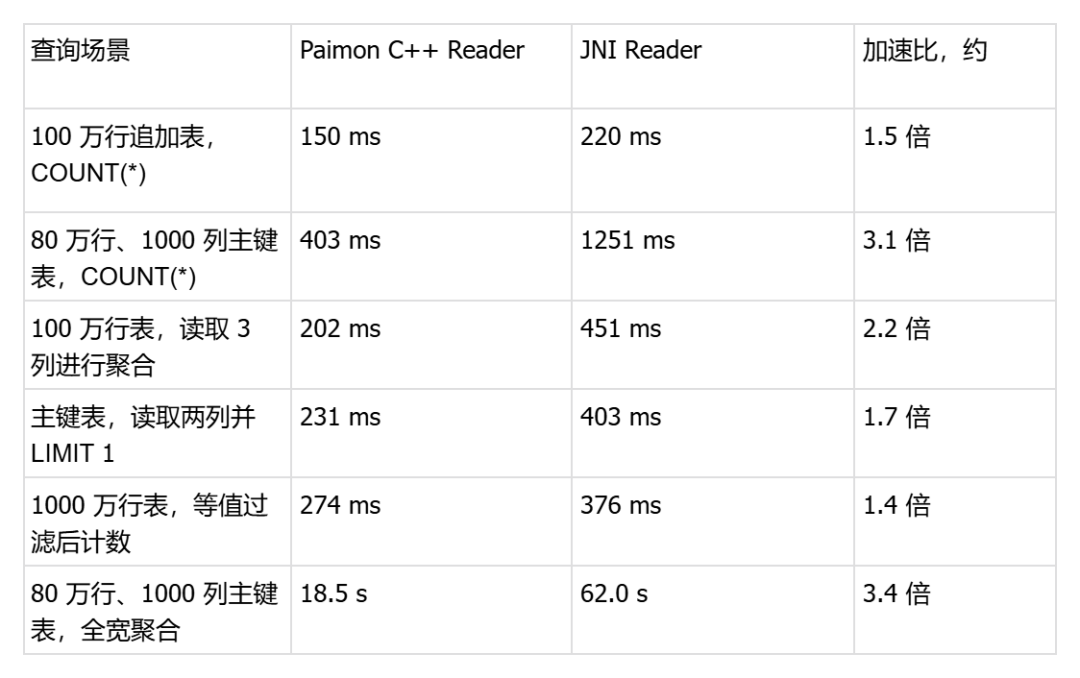
在上述测试环境和查询场景中,Paimon C++ Reader 相比 JNI Reader 实现了约 1.4~3.4 倍的查询加速。其中,主键表计数耗时由 1,251 ms 降至 403 ms,千列宽表的全宽聚合耗时由 62.0 秒降至 18.5 秒,原生读取路径在主键合并和宽表处理场景中的优势更加明显。
后续规划:覆盖更多湖上查询场景
围绕原生读取,后续演进从三个方向展开。
-
扩大原生读取覆盖。 持续完善不同表类型、数据类型和表结构演进场景下的读取能力,让更多查询能够通过原生路径完成,并保持与 Paimon 表格式的兼容。
-
进一步降低查询开销。 围绕元数据准备、远程 I/O、数据合并和列式数据转换继续优化,同时完善缓存利用和查询指标,让性能提升更容易被观察和验证。
-
探索多模态与索引加速。 随着 Paimon 对 BLOB、全局索引、向量和全文检索能力的扩展,StarRocks 可以进一步探索把过滤和检索条件下推到湖上索引,减少需要读取的数据,为更多分析与检索场景提供统一的 SQL 入口。相关能力将随版本逐步推进。
相关代码已合入 StarRocks Main 分支,将随下一版本正式发布。后续文章也将结合版本进展,进一步介绍不同能力的使用方式与适用场景。