文章目录
- [Nginx 配置 Readiness Probe(就绪探针)](#Nginx 配置 Readiness Probe(就绪探针))
-
- [第一步:为 Nginx 添加 HTTP 就绪探针](#第一步:为 Nginx 添加 HTTP 就绪探针)
- 第二步:检查探针和滚动更新
- [第三步 给 Nginx 添加 Liveness Probe](#第三步 给 Nginx 添加 Liveness Probe)
下一步先练习 Liveness Probe(存活探针)和 Readiness Probe(就绪探针),暂时不急着部署 Ingress。
- Liveness Probe:判断容器是否需要重启。
- Readiness Probe:判断容器是否已经可以接收流量。
- Startup Probe:给启动较慢的应用预留初始化时间,避免过早触发其他探针。
这三个概念在 DevOps 面试中非常常见,也能帮助你解释为什么容器处于 Running 状态却不一定能正常对外提供服务。
我们下一步可以给现有 Nginx Deployment 配置 HTTP 就绪探针,验证 Pod 的 Ready 状态如何影响 Service 的后端流量。操作前先保存当前 Deployment 配置,便于随时恢复:
bash
sudo k3s kubectl get deployment nginx -n nginx-lab -o yaml \
  > ~/nginx-deployment-before-probes.yaml
cat nginx-deployment-before-probes.yaml
yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  annotations:
    deployment.kubernetes.io/revision: "2"
  creationTimestamp: "2026-10-14T06:37:23Z"
  generation: 2
  labels:
    app: nginx
  name: nginx
  namespace: nginx-lab
  resourceVersion: "10134"
  uid: 194c1d63-613d-4ba4-9abd-8c452a4cc597
spec:
  progressDeadlineSeconds: 600
  replicas: 2
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: nginx
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - image: m.daocloud.io/docker.io/library/nginx:stable
        imagePullPolicy: IfNotPresent
        name: nginx
        resources: {}
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
status:
  availableReplicas: 2
  conditions:
  - lastTransitionTime: "2026-10-14T06:47:50Z"
    lastUpdateTime: "2026-10-14T06:56:22Z"
    message: ReplicaSet "nginx-68bfbd8bb7" has successfully progressed.
    reason: NewReplicaSetAvailable
    status: "True"
    type: Progressing
  - lastTransitionTime: "2026-10-14T08:18:41Z"
    lastUpdateTime: "2026-10-14T08:18:41Z"
    message: Deployment has minimum availability.
    reason: MinimumReplicasAvailable
    status: "True"
    type: Available
  observedGeneration: 2
  readyReplicas: 2
  replicas: 2
  terminatingReplicas: 0
  updatedReplicas: 2
Nginx 配置 Readiness Probe(就绪探针)
第一步:为 Nginx 添加 HTTP 就绪探针
bash
sudo k3s kubectl patch deployment nginx -n nginx-lab \
  --type=strategic \
  -p '{
    "spec": {
      "template": {
        "spec": {
          "containers": [{
            "name": "nginx",
            "readinessProbe": {
              "httpGet": {
                "path": "/",
                "port": 80
              },
              "initialDelaySeconds": 5,
              "periodSeconds": 5,
              "timeoutSeconds": 2,
              "failureThreshold": 3
            }
          }]
        }
      }
    }
  }'
这条命令会修改 Deployment 的 Pod 模板,因此 Kubernetes 会触发一次滚动更新,逐步替换原来的两个 Pod。它不会修改宿主机端口,也不会改动你的博客和 Jenkins。
| 参数 | 含义 |
|---|---|
| path: / | 请求 Nginx 首页 |
| port: 80 | 检查容器的 80 端口 |
| initialDelaySeconds: 5 | 容器启动约 5 秒后开始检查 |
| periodSeconds: 5 | 每隔 5 秒检查一次 |
| timeoutSeconds: 2 | 单次检查最多等待 2 秒 |
| failureThreshold: 3 | 连续失败 3 次后,判定为未就绪 |
第二步:检查探针和滚动更新
bash
# 等待 Deployment 更新完成
sudo k3s kubectl rollout status deployment/nginx \
  -n nginx-lab --timeout=120s

# 查看 Pod 就绪状态
sudo k3s kubectl get pods -n nginx-lab

# 查看探针配置
sudo k3s kubectl describe deployment nginx -n nginx-lab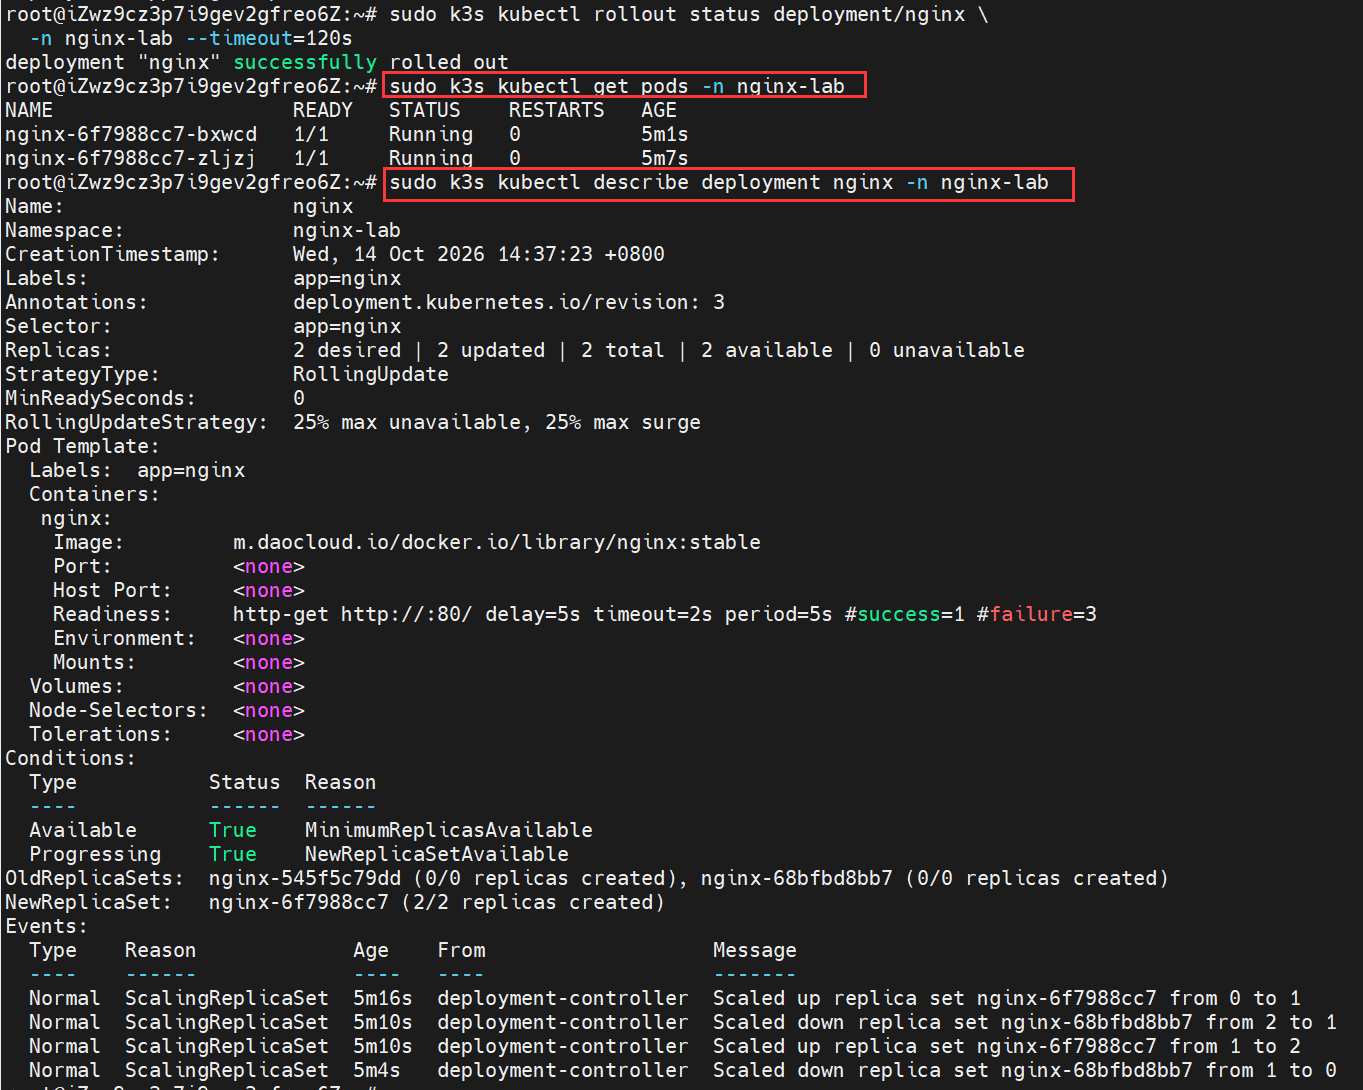
第三步 给 Nginx 添加 Liveness Probe
先给现有 Deployment 增加存活探针。它和已有的 Readiness Probe 可以同时工作,不会因为配置 Liveness 就立即重启容器。
bash
sudo k3s kubectl patch deployment nginx -n nginx-lab \
  --type=strategic \
  -p '{
    "spec": {
      "template": {
        "spec": {
          "containers": [{
            "name": "nginx",
            "livenessProbe": {
              "httpGet": {
                "path": "/",
                "port": 80
              },
              "initialDelaySeconds": 10,
              "periodSeconds": 5,
              "timeoutSeconds": 2,
              "failureThreshold": 3
            }
          }]
        }
      }
    }
  }'
参数含义:
| 参数 | 含义 |
|---|---|
| httpGet.path: / | 通过 HTTP 请求 Nginx 首页 |
| initialDelaySeconds: 10 | 容器启动后先等待 10 秒 |
| periodSeconds: 5 | 每 5 秒检查一次 |
| timeoutSeconds: 2 | 单次检查最多等待 2 秒 |
| failureThreshold: 3 | 连续失败 3 次后触发重启 |
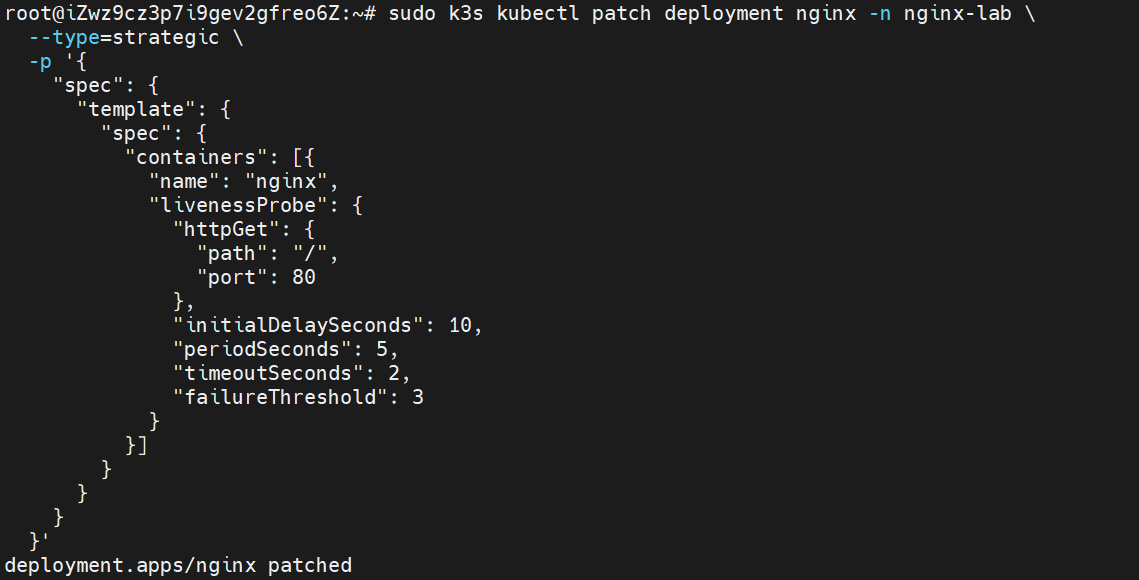
deployment.apps/nginx patched说明Liveness Probe 的配置修改已被 Kubernetes 接受。接下来确认滚动更新成功,并检查两个探针是否都生效。
执行下面三条命令:
bash
# 1. 等待滚动更新完成
sudo k3s kubectl rollout status deployment/nginx \
  -n nginx-lab --timeout=120s

# 2. 查看 Pod 状态和重启次数
sudo k3s kubectl get pods -n nginx-lab

# 3. 检查两个探针的配置
sudo k3s kubectl describe deployment nginx -n nginx-lab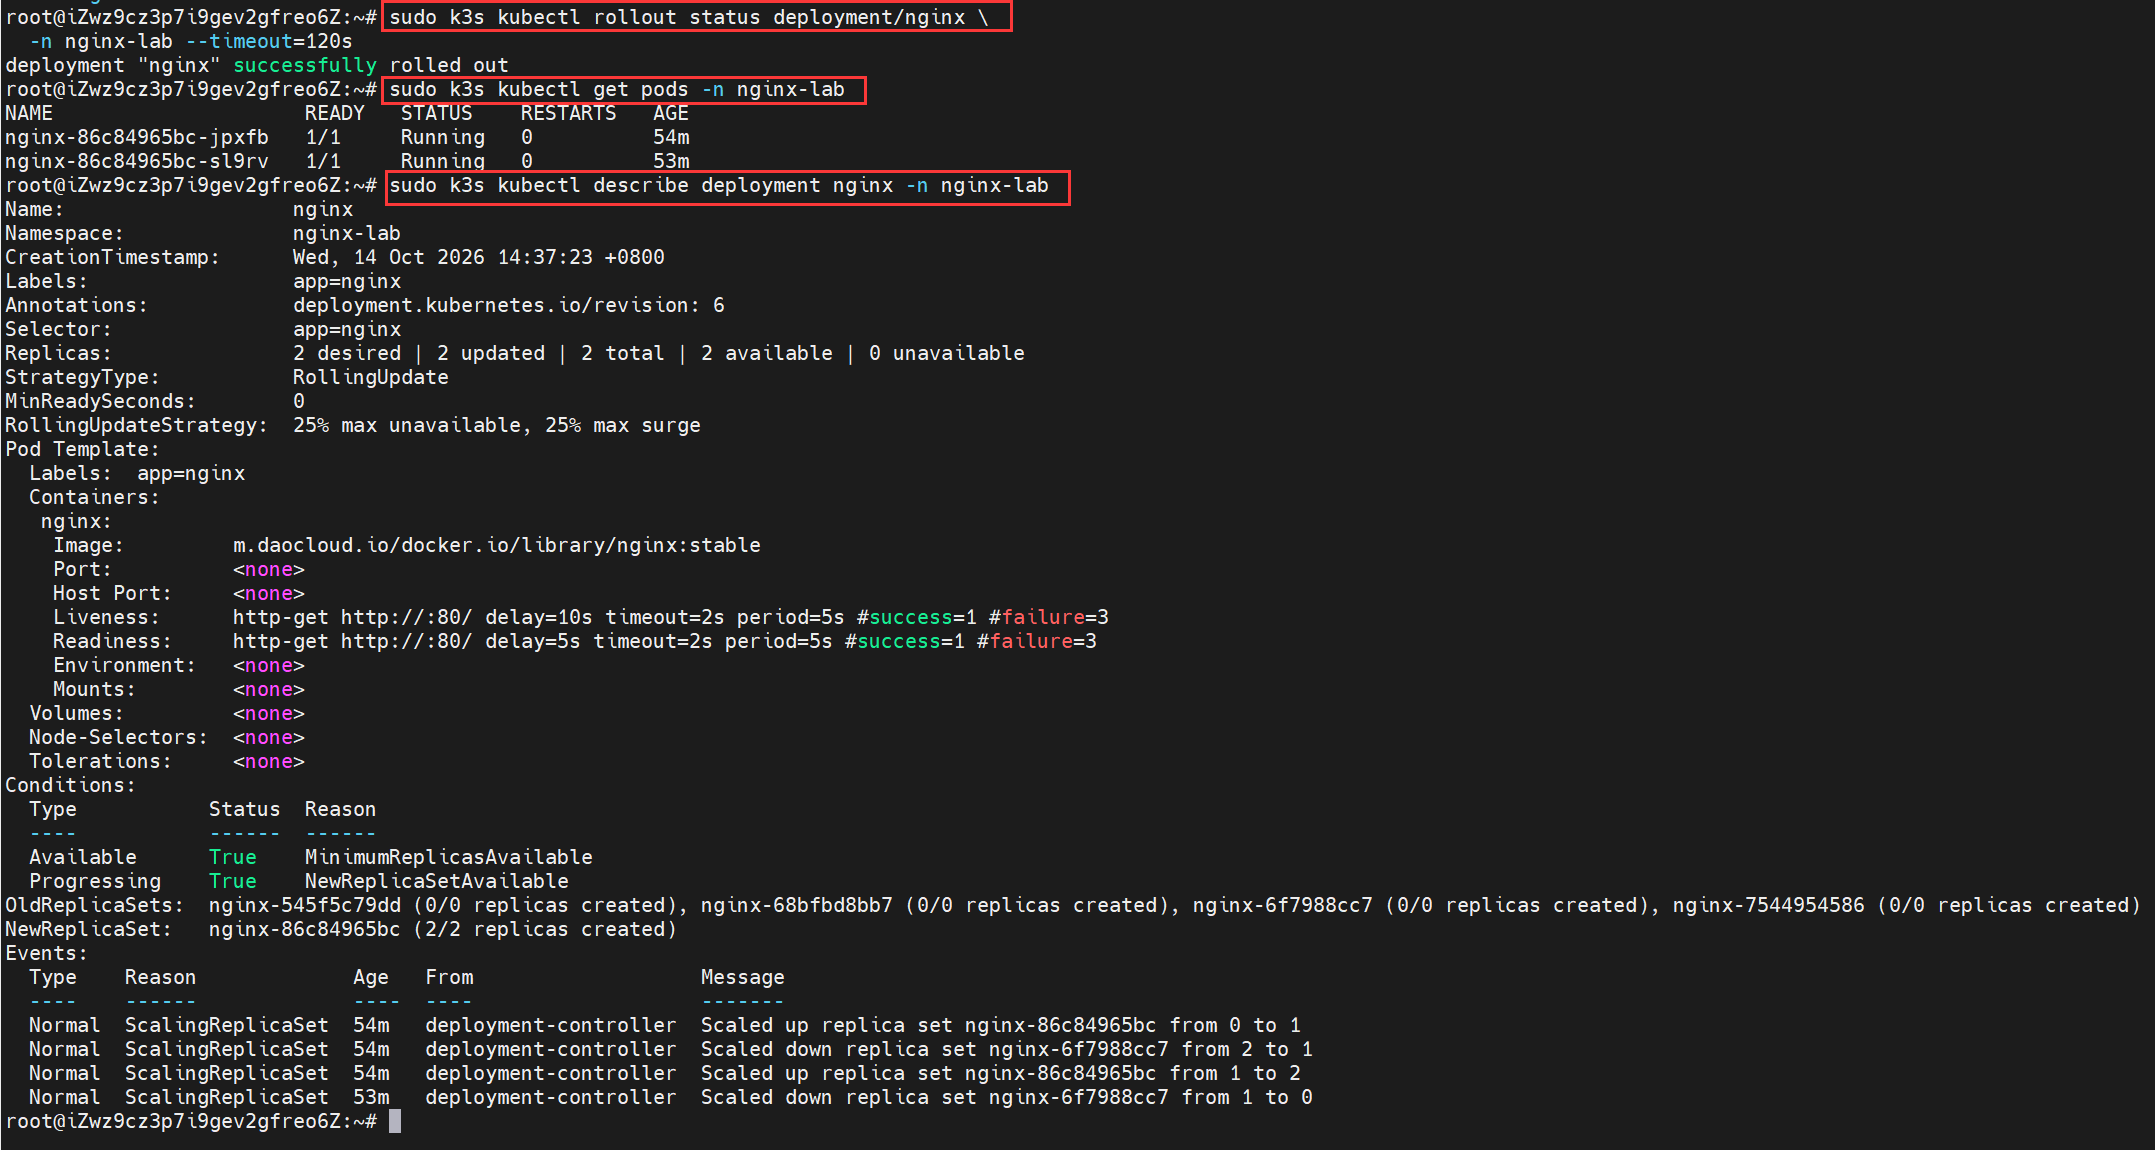
第一步:生成实验 Pod 配置
bash
cat > ~/nginx-liveness-lab.yaml <<'EOF'
apiVersion: v1
kind: Pod
metadata:
  name: nginx-liveness-lab
  namespace: nginx-lab
spec:
  restartPolicy: Always
  containers:
    - name: nginx
      image: m.daocloud.io/docker.io/library/nginx:stable
      command:
        - nginx
        - -g
        - daemon off;
      ports:
        - containerPort: 80
      livenessProbe:
        httpGet:
          path: /healthz-missing
          port: 80
        initialDelaySeconds: 5
        periodSeconds: 5
        timeoutSeconds: 2
        failureThreshold: 3
EOF
这份配置的关键点:
- restartPolicy: Always:容器退出后,Kubernetes 会尝试重新启动它。
- livenessProbe:访问一个不存在的 URL,预期返回 HTTP 404。
- failureThreshold: 3:连续三次检查失败后,触发容器重启。
第二步:检查 YAML 是否正确
执行:
bash
sudo k3s kubectl apply \
  --dry-run=client \
  -f ~/nginx-liveness-lab.yaml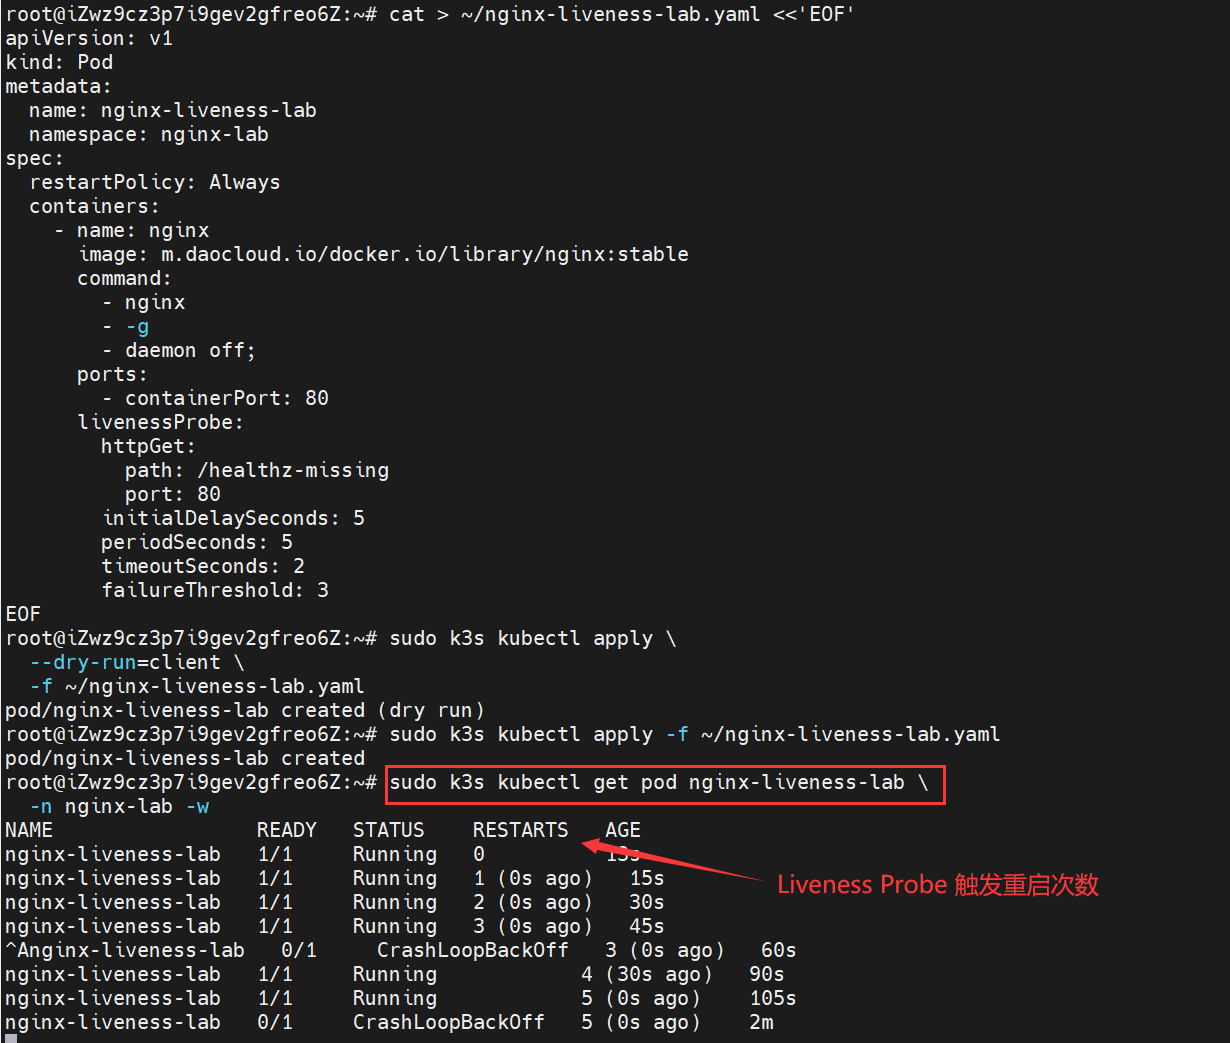
面试中可以这样总结
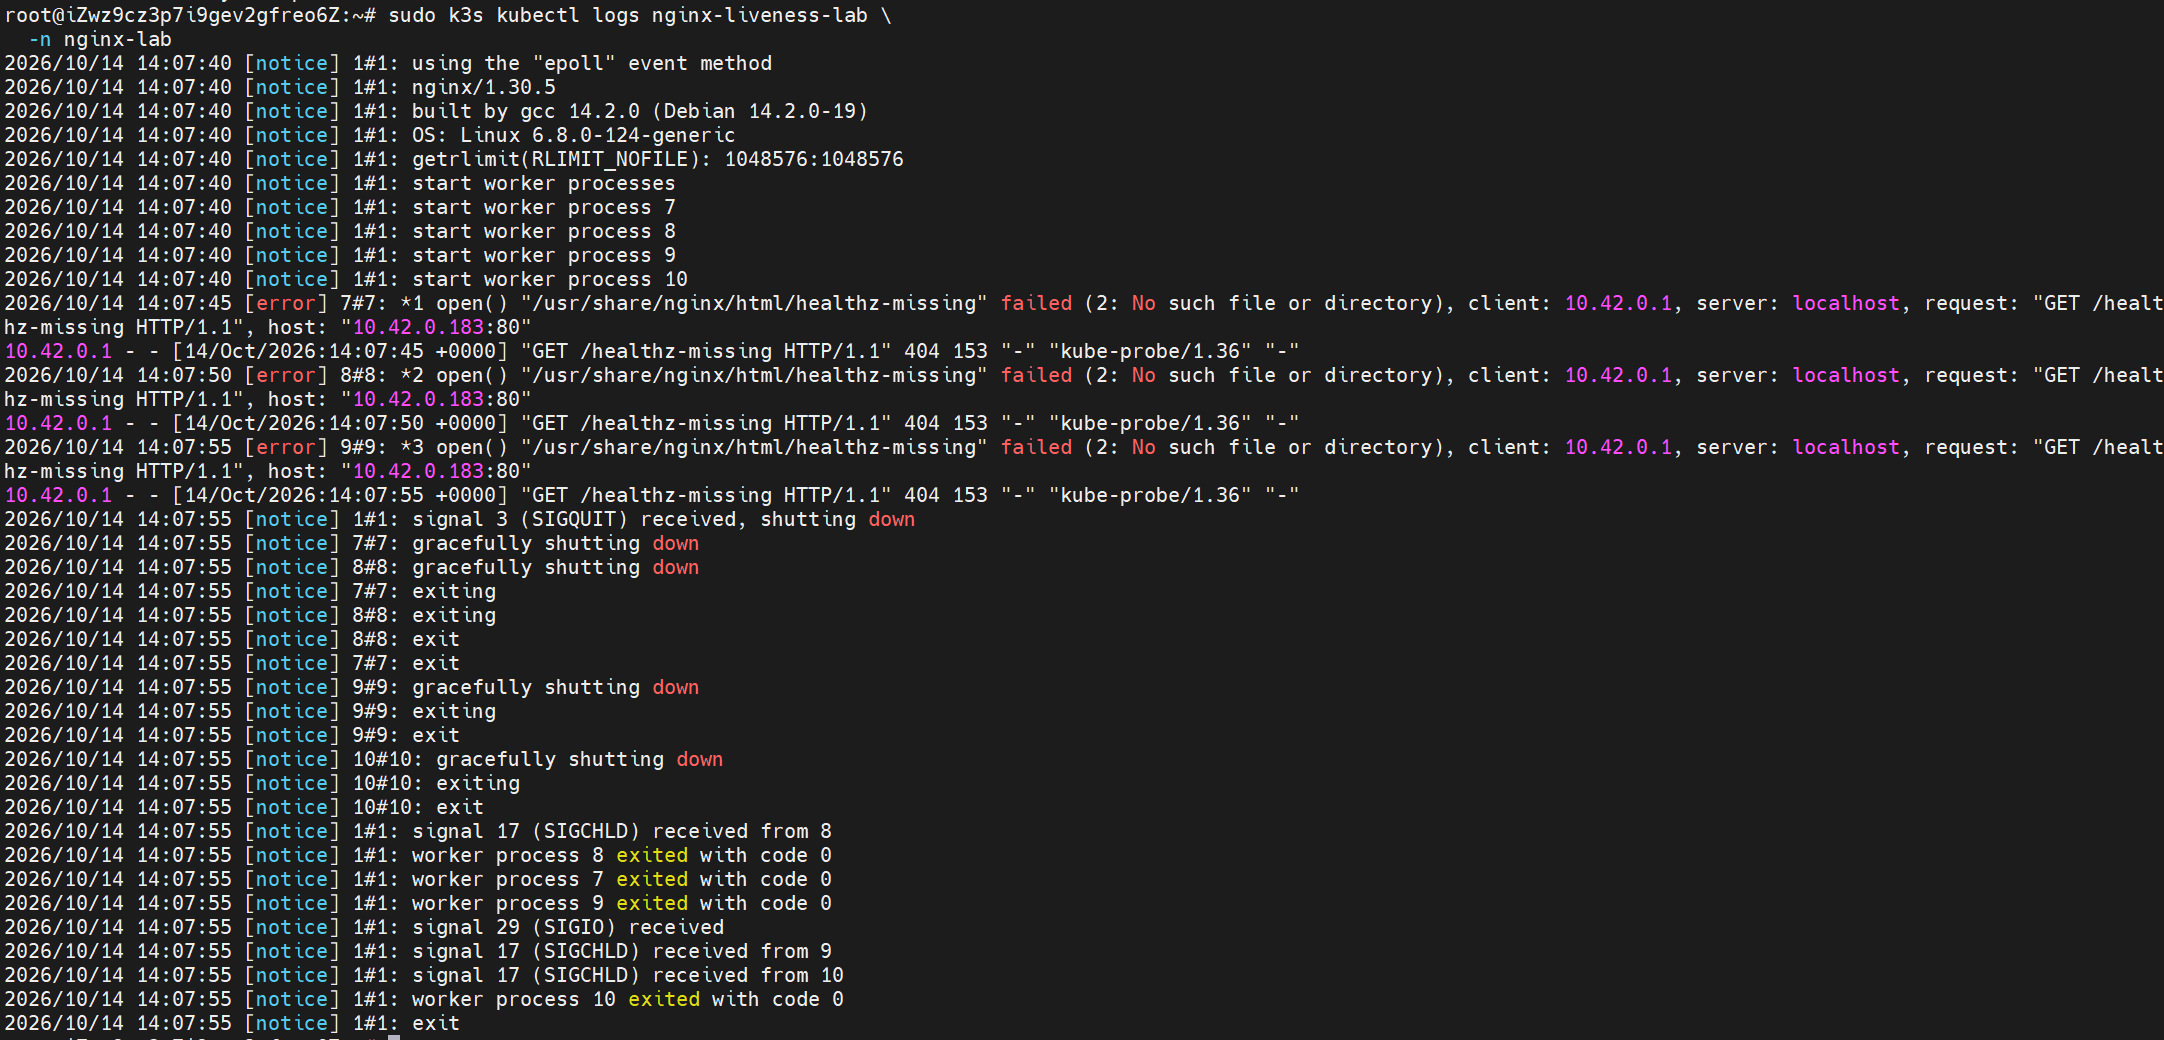
我在 K3s 中创建了一个独立的 Nginx 实验 Pod,并配置 Liveness Probe 检查一个不存在的 HTTP 路径。通过 kubectl get pod 观察到重启次数持续增加,最终进入 CrashLoopBackOff。查看容器日志后发现,Kubernetes 探针连续请求 /healthz-missing 并收到 404,随后 Nginx 收到 SIGQUIT 开始退出。结合 Pod Events 可以确认探针失败触发了容器重启。
这个实验说明,容器进程最初能够正常启动,并不代表健康检查一定能通过;Liveness Probe 配置错误本身也可能导致持续重启。因此在生产环境中,探针路径必须与应用真实的健康检查接口匹配,并合理设置延迟、间隔和失败阈值。
这就是一段完整的 Kubernetes 故障排查案例:发现异常 → 查状态 → 看日志 → 查事件 → 定位原因 → 修复或清理。