上一篇(02)把订阅握手做到了订阅成功率 99.89%@10% 丢包 ,但订阅成功只是"通道打通"。本篇把"事件通知"从一句
OnChange拆成三本可算的账 。同一份固定种子(20261012)、20 万报文 的三类丢包序列:Bernoulli(iid, 2%) 实测 2.043%、Gilbert-Elliott 稳态解析 3.558%(实测 3.814%)、拥塞切换解析 14.10%(实测 13.19%) ,解析与蒙特卡洛最大偏差 7.19%。开销账:20 路信号、每路 2 Hz 变化率下,纯事件通知只要 40 pps / 36.5 kbit/s,而 10 ms 周期通知要 2000 pps / 1824 kbit/s------带宽差 50 倍,有效报文占比 2% vs 100% 。时效账用 Age of Information 量化:周期通知 AoI = T(2−q)/(2q),丢包对 AoI 的放大系数恒为 (1+p)/(1−p),与周期无关;2%/5%/10% 丢包分别放大 4.08%/10.53%/22.22% 。纯事件通知在 2% 通知丢包下 AoI = 26.51 ms ,与"周期 50 ms"的 26.02 ms 几乎相同,但带宽只要它的 1/10。风暴账:无排队损失系统在 offered load a=0.9、并行服务台 K=2 时事件溢出率 17.57% ,K=5 降到 0.20%。检测账:"连续丢 G 个"做突发判据,G=2 对突发丢包检出覆盖率 93.93%、对随机丢包误报率 2.13%、检测时延 20 ms;G=3 覆盖率 88.34%、误报率降到 0.03% 。放大账:1% 单帧丢包下,64 KB 消息分 41 片后消息级丢包从 1% 放大到 33.77%(33.8 倍) 。结论:事件"丢的是什么"不是单个丢包率能回答的------必须同时看丢包的时间结构(突发还是散点)、时效(AoI 而不是丢包率)、以及溢出与分片带来的非线性放大。
1. 订阅成功之后:事件语义的三本账
上一篇(02)算完订阅握手,结论是"重传 3 次能把 10% 丢包下的订阅成功率从 81.6% 拉到 99.89%"。但那只回答了一个问题:通道建没建起来。建起来之后,真正决定功能体验的是另外三件事:
- 丢包的时间结构 。同样是 2% 丢包,随机散点和"每次连丢 5 个"对上层是完全不同的世界:前者被最后值缓冲(latest-value buffer)抹平,后者会让"至少一次"语义彻底失效。丢包率是一个标量,丢包语义是一个序列------这是本篇的第一个论点。
- 时效而不是速率。周期通知 20 ms 一帧,不代表上层看到的"最新值"就只有 20 ms 旧。丢包会把"最新值的年龄"从 T/2 抬高到 T(2−q)/(2q)。这篇用 Age of Information(AoI)把这件事变成一条可算的曲线,而不是"配个周期拍脑袋"。
- 放大 。事件风暴会让发送侧缓冲溢出(丢包),SOME/IP-TP 分片会让消息级丢包随分片数非线性上升。1% 的单帧丢包,在 64 KB 消息上会变成 33.8% 的消息级失败------这个非线性是很多"链路明明只有 1% 丢包,功能却经常不可用"投诉的真正来源。
1.1 接收端的三种交付语义
在进入实验之前,先把"接收端拿到事件之后怎么办"讲清楚,因为同一份丢包序列,落在不同交付语义上,后果完全不同:
- 至多一次(at-most-once) :收到就用,丢帧不补。纯 UDP 的 OnChange 就是这种。丢包表现为"状态更新永久缺失"------如果丢的那一帧恰好是"最后一次变化",接收端会永远停在旧值上,直到下一次变化才恢复。这在"变化稀疏"的信号上最危险:一个 5 分钟才变一次的信号,丢一帧可能意味着 5 分钟的错值。
- 至少一次(at-least-once):带序列号的可靠事件,允许重复、不允许丢失,靠重传/ACK 补齐。它把乱序和重复变成接收端必须处理的新问题:同一个序列号来了两次,业务逻辑必须幂等;序列号跳号则触发缺口检测(第 6 节)。
- 最后值(progress / latest-value) :接收端只关心"当前最新值",维护一个 latest-value buffer,旧帧到达直接覆盖。这是车载事件通知里最常用也最抗丢包 的语义:只要"下一次变化"最终能到,丢中间的过渡值往往无害。但它的前提是"变化会持续发生";对长稳态信号,"永远不再变"就等于"永远拿不到最新值",这也是第 4 节里"事件必须配长周期兜底"的另一半原因。
三种语义不是互斥的:同一个 Eventgroup 里,状态类信号用最后值 + 兜底周期,诊断/统计类事件用至少一次(带序列号 + 缺口检测)------本篇后面每一节都对应其中一个开关。
本专栏路线图(每篇都带可复现实验):
| 篇 | 主题 | 核心产出 |
|---|---|---|
| 01 | 报文字节级解析 + 四通道开销账 + 发现时延 | 编解码器、开销表、SD 蒙特卡洛 |
| 02 | SOME/IP-SD 状态机与事件订阅 | 三态状态机、订阅重传账、下线检测与上电风暴 |
| 03(本篇) | 事件通知与丢包语义 | 三类丢包模型、AoI 时效账、事件风暴溢出、缺口检测阈值、分片放大 |
| 04 | SOME/IP-TP 分片与大数据 | >1412 B 的分片账与重组超时(本篇只算"放大") |
| 05 | UDP 还是 TCP:连接管理与超时体系 | 半开连接、心跳、会话恢复 |
| 06 | 服务矩阵从 Excel 到 ARXML/SD 文件 | 工具链打通与代码生成 |
| 07 | Wireshark 抓包调试实战 | 解码器配置、10 类典型故障包 |
| 08 | 量产问题集:丢包/风暴/上电时延 | 真实故障复盘与门禁值 |
表1 本篇实验的全部参数(写在 exp03.py 的 CFG 里,改一个数即可复跑)
| 参数 | 取值 | 含义与依据 |
|---|---|---|
| 随机种子 | 20261012 | 固定种子,全文数字可复现 |
| 丢包序列长度 N | 200000 | 三种模型在同一份种子上各自生成 |
| AoI 仿真槽数 | 400000 / 档 | 周期通知 AoI 的时间平均 |
| 队列仿真到达数 | 40000 / 档 | M/M/K/K 阻塞概率 |
| Bernoulli 丢包率 p | 2% | 独立同分布基准 |
| GE 转移概率 (a, b) | 0.004 / 0.10 | G→B 0.4%、B→G 10%,瞬时 Bad 态占比 π_B=3.846% |
| GE 态内丢包 (p_G, p_B) | 0.1% / 90% | Good 态几乎不丢,Bad 态几乎全丢 |
| 拥塞链 (q_a, q_b) | 0.002 / 0.002 | 畅通↔拥塞平均各持续 500 个报文 |
| 拥塞态内丢包 (p_lo, p_hi) | 0.2% / 28% | 拥塞占比 π_C=50% |
| 信号数 × 变化率 | 20 路 × 2 Hz | 聚合变化率 λ=40 /s |
| 载荷 / 线上头 | 32 B / 82 B | 每报文线上 114 B(含 14 ETH+4 FCS+8 前导+12 IFG+20 IP+8 UDP+16 SOME/IP) |
| 周期候选 T | 10/20/50/100/200 ms | cyclic 通知 |
| AoI 丢包档 p | 0 / 2% / 5% / 10% | 周期通知对照 |
| offered load a | 0.7 / 0.9 / 1.2 Erlang | 事件风暴强度 |
| 并行服务台 K | 1 / 2 / 5 / 10 / 20 | 发送侧并行能力 |
| 缺口阈值 G | 1 ~ 6 | 连续丢包判据 |
| TP 载荷档 | 512 B ~ 64 KB | 分片净荷 1623 B(1631−8 B TP 头) |
| TP 单帧丢包 | 1% | 与 iid 模型交叉复算 |
2. 三类丢包模型:Bernoulli、Gilbert-Elliott 与拥塞切换
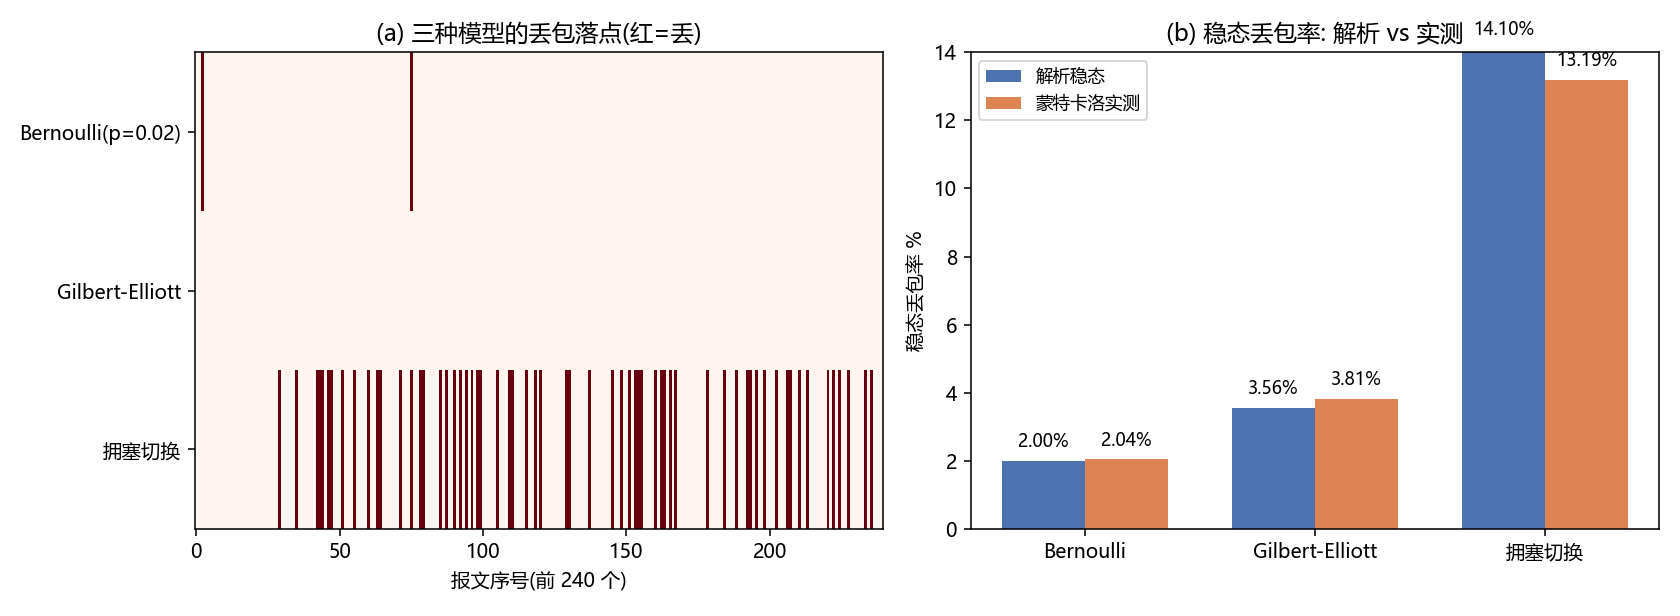
要谈"丢包语义",先得能把丢包生成出来。工程上用三类模型就够了,各对应一种真实现象:
- Bernoulli(iid) :每个报文独立以 p 概率丢失。对应"物理层随机误码、干扰底噪"这类无记忆损伤。它是最乐观的模型------因为它没有记忆,下一帧永远有机会。
- Gilbert-Elliott(GE) :链路在两态间马尔可夫切换,Good 态几乎不丢、Bad 态几乎全丢。对应"短时干扰、遮蔽、EMC 事件、温漂"------损伤有惯性,坏起来会连着坏一串。
- 拥塞切换 :拥塞态里交换/端侧队列溢出,概率性丢弃。对应"事件风暴打满发送队列"这一类自己把自己打崩的丢包,和第 5 节直接联动。
三类模型的稳态丢包率都有闭式解。对 GE,设 G→B 概率 a、B→G 概率 b,则 Bad 态占比
\\pi_B=\\frac{a}{a+b},\\qquad p_{\\mathrm{GE}}=\\pi_B p_B+(1-\\pi_B)p_G
对拥塞链同理,\(\pi_C=q_a/(q_a+q_b)\)、\(p_{c}=\pi_C p_{hi}+(1-\pi_C)p_{lo}\)(下标 c 表示拥塞态)。
表2 三类模型的稳态丢包率:解析 vs 蒙特卡洛(N=200000)
| 模型 | 解析稳态 | 蒙特卡洛实测 | 相对偏差 | 平均丢包游程 | 游程个数 |
|---|---|---|---|---|---|
| Bernoulli(iid, p=2%) | 2.0000% | 2.0430% | +2.15% | 1.0215 | 4000 |
| Gilbert-Elliott | 3.5577% | 3.8135% | +7.19% | 4.7848 | 1594 |
| 拥塞切换 | 14.1000% | 13.1875% | −6.47% | --- | --- |
这张表里最值得讲的不是"解析和仿真对得上",而是它们对不上 7% ,以及平均游程从 1.02 跳到 4.78 这两件事:
- Bernoulli 的实测只偏 2.15%,GE 偏了 7.19% ------这是估计量方差的问题。GE 的丢包是强自相关的:一次 Bad 态能连丢十几帧,这十几帧在统计上是一个样本而不是十几个 。有效样本量被压缩到原来的 1/5 左右,于是同样 N=200000,GE 的抽样误差大得多。工程含义很直接:用"丢包率"评估 GE 类链路时,采集时长要比想象的长 5 倍以上,否则每一次抽测的结果都在抖。
- 平均游程 1.02 → 4.78 :在同样的"丢包率量级"下,GE 的连续丢包长度是 iid 的 4.7 倍(且解析上 Bad 态驻留期望是 1/b=10 帧,游程被"Bad 态内 10% 不丢"切成 4.78)。这才是"丢包语义"的物理载体:一个 4.78 帧的缺口,对"至少一次"语义就是灾难,对"最后值缓冲"却可能完全无害。
还有一个容易被忽略的一致性检查:GE 稳态丢包解析值 3.5577% 是遍历平均 。仿真从 Good 态起步,在 20 万帧的尺度上应当收敛到它;实测 3.8135% 略高,既包含估计量方差,也提示"短窗内的瞬时丢包率"与"长期平均"本来就不同。做验收门禁时,必须规定统计窗口:本篇建议单次统计窗口不少于 10 万个报文,或不少于 10 个 Bad 态平均驻留周期。
怎么在现场判断遇到了哪一类? 三个可落地的观测手段:①在端侧统计"连续丢包长度的分布",若游程长度几乎恒为 1(iid),就把资源投在"防单帧丢失"(冗余帧 / 最后值缓冲);若出现大量长度 ≥3 的游程(GE),优先排查 EMC / 线束 / 连接器与 PHY 参数,而不是加协议层重传------物理层的突发损伤,协议层的线性补偿永远追不上。②对比"同一链路上不同速率、不同方向的丢包率",若只有某一方向突发,通常指向链路自协商 / 双工失配而非误码。③检查丢包是否与某个周期性任务相关(比如某一帧发出后 2 ms 必丢),这类"锁相"现象几乎一定是端侧调度 / 队列配置问题。
3. 通知模式开销账:cyclic、event 与"周期+事件"混合
SOME/IP 的事件/字段通知有三种落地形态,配置表里就是那三个开关:周期发送(cyclic)、变化发送(OnChange)、以及两者叠加。
表3 通知模式开销账(20 路信号,每路 2 Hz 变化,每报文线上 114 B)
| 模式 | 报文率 pps | 线上带宽 kbit/s | 携带真实变化的报文占比 |
|---|---|---|---|
| cyclic T=10 ms | 2000 | 1824.0 | 2.00% |
| cyclic T=20 ms | 1000 | 912.0 | 4.00% |
| cyclic T=50 ms | 400 | 364.8 | 10.00% |
| cyclic T=100 ms | 200 | 182.4 | 20.00% |
| cyclic T=200 ms | 100 | 91.2 | 40.00% |
| event(纯 OnChange) | 40 | 36.5 | 100.00% |
| cyclic 100 ms + event | 240 | 218.9 | 16.67% |
三条读法:
- 周期通知的带宽与周期成反比、与"有效报文占比"也成反比 。T=10 ms 时 98% 的报文在传"和上一帧一样的值"------这是拿 50 倍带宽换"确定性",值不值取决于业务:安全相关的周期信号要的是"每一帧都可预期",那就该用周期;而"车门状态、空调设定"这类变化稀疏的信号,周期发就是纯浪费。
- 纯事件最省,但把风险全押在链路可靠性上 。40 pps / 36.5 kbit/s 是周期 10 ms 的 1/50,但它对丢包零冗余------丢一帧就是丢一次状态更新,而且没有任何"下一帧会补上"的兜底。
- "周期 + 事件"叠加不是免费保险 。cyclic 100 ms + event 的带宽(218.9 kbit/s)反而比"纯周期 100 ms"(182.4)更高,有效报文占比掉到 16.67%,而这些多出来的周期报文很可能和事件报文重复汇报同一个值 。下面第 8 节会证明:这个组合在"带宽---时效"平面上被纯事件完全支配。
这里必须补一个容易被忽略的坑:事件模式的"变化"定义决定了它到底是 40 pps 还是 4000 pps 。如果按"浮点最低位变化"判定 OnChange,一个带抖动的传感器每秒能触发几百次事件------所以在工程上,事件模式的实现里一定要带 min-cycle(最小发送间隔)与 debounce(死区/迟滞),否则"省带宽"会瞬间变成"事件风暴",直接接上第 5 节的溢出账。
min-cycle 与 debounce 的定量经验值 :以本篇 20 路 × 2 Hz 的场景为例,若某路信号带 ±1 LSB 抖动、采样率 100 Hz,那么"逐位比较"的 OnChange 每秒能触发上百次事件,聚合后事件率会从 40 /s 涨到 2000+ /s------正好等于把纯事件模式的带宽优势(36.5 kbit/s)吃回周期 10 ms 的水平(1824 kbit/s) 。两条工程约定:min-cycle 取"业务可感知的最快变化周期"的一半(本篇 2 Hz → 建议 200~250 ms);debounce 死区取传感器量化噪声的 3~5 倍标准差。这两个参数如果不写进配置规范,事件模式在实车上会自发退化成"高带宽周期模式"。
4. Age of Information:比丢包率更贴业务的时效指标
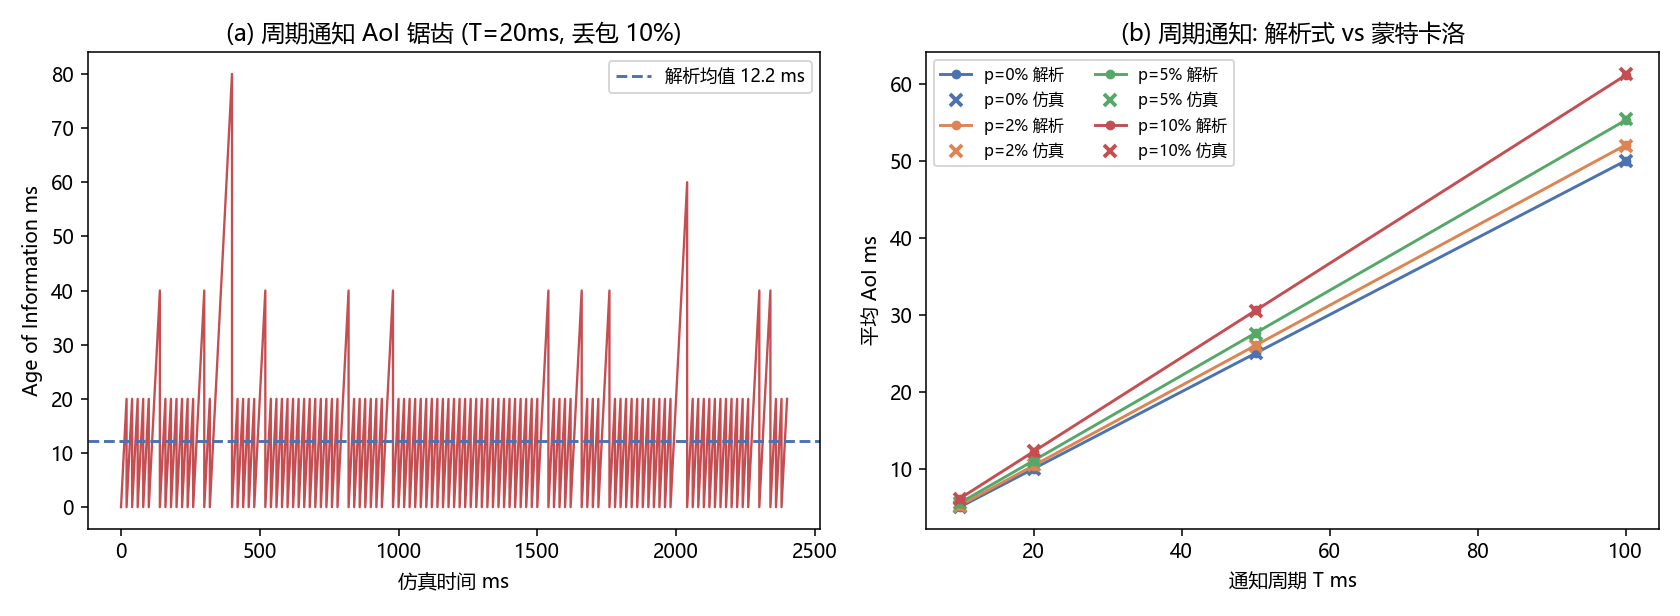
丢包率回答不了"我的最新值有多旧"。回答这件事的指标叫 Age of Information(AoI):在任意时刻 t,接收端手上那份数据的年龄 = t − 该数据在发送端被生成/采样 的时刻。它同时对"周期太长"和"丢包"敏感,是把两者放进同一个坐标轴的正确工具。
周期通知的 AoI 有闭式解。 设周期 T、单帧投递成功率 q=1−p。接收端只有在"这一帧成功"时才刷新,所以相邻两次成功刷新的间隔是几何分布的帧数 G~Geom(q),对应时间 X=G·T。AoI 是锯齿波(每次刷新掉到 0,然后线性增长),对更新过程有:
E\[X\]=\\frac{T}{q},\\quad E\[X\^2\]=\\frac{T\^2(2-q)}{q\^2},\\qquad E\[\\mathrm{AoI}\]=\\frac{E\[X\^2\]}{2E\[X\]}=\\frac{T(2-q)}{2q}
无丢包(q=1)时退化为熟悉的 T/2 ;有丢包时被放大。关键结论:放大系数与 T 无关:
R_{\\mathrm{AoI}}=\\frac{T(2-q)/(2q)}{T/2}=\\frac{2-q}{q}=\\frac{1+p}{1-p}
式中 R_{\\mathrm{AoI}} 即"丢包对平均 AoI 的放大系数"(下标 AoI 标明它作用于时效指标):
表4 周期通知平均 AoI(单位 ms,每格"解析 / 蒙特卡洛",N=400000 槽)
| T \ 丢包率 | p=0% | p=2% | p=5% | p=10% |
|---|---|---|---|---|
| 10 ms | 5.000 / 5.000 | 5.204 / 5.203 | 5.526 / 5.527 | 6.111 / 6.121 |
| 20 ms | 10.000 / 10.000 | 10.408 / 10.417 | 11.053 / 11.054 | 12.222 / 12.224 |
| 50 ms | 25.000 / 25.000 | 26.020 / 26.012 | 27.632 / 27.640 | 30.556 / 30.546 |
| 100 ms | 50.000 / 50.000 | 52.041 / 52.061 | 55.263 / 55.178 | 61.111 / 60.994 |
解析与仿真最大偏差 0.19% (T=100 ms、p=10%),说明"独立丢包 + 几何更新"这个模型完全够用,以后评估周期与丢包对时效的影响,直接算解析式就行。
表5 事件驱动通知的 AoI(λ=40 /s,通知丢包 p=2%,单向时延 d=1 ms)
| 项 | 数值 |
|---|---|
| 解析式 \(1000/(\lambda q)+d\) | 26.510 ms |
| 蒙特卡洛(泊松到达 + 稀疏化) | 25.963 ms |
| 相对偏差 | 2.11% |
| 对照:cyclic T=20 ms / p=2% | 10.408 ms(但带宽 912 vs 36.5 kbit/s) |
| 对照:cyclic T=50 ms / p=2% | 26.020 ms(带宽 364.8 vs 36.5 kbit/s,整整 10 倍) |
把表4、表5 并排读,能得到本篇最实用的一条配置结论:
在"20 路信号、2 Hz 变化率、2% 通知丢包"这个场景里,纯事件通知用 36.5 kbit/s 拿到 26.51 ms 的 AoI,而周期通知要花 364.8 kbit/s 才能拿到同样水平的 26.02 ms。也就是说,事件通知在这个工作点上比周期通知省了约 90% 的带宽。
但不能就此宣布"事件永远更好" ------事件通知的 AoI 分布是重尾的:变化间隔服从指数分布,总有"很久没变"的长间隔,AoI 就会长成那个间隔。周期通知的 AoI 有硬上界(约 T)。所以正确的分工是:安全相关、需要"最坏情况可预期"的信号用周期;状态类、变化稀疏的信号用事件 + 兜底周期(超时无变化时补一帧) 。这个"兜底周期"就是很多量产配置里那行看似多余的 cyclic fallback,它不是冗余,它是给 AoI 设上界的那根保险绳。
5. 事件风暴与有限缓冲:Erlang-B 的溢出代价
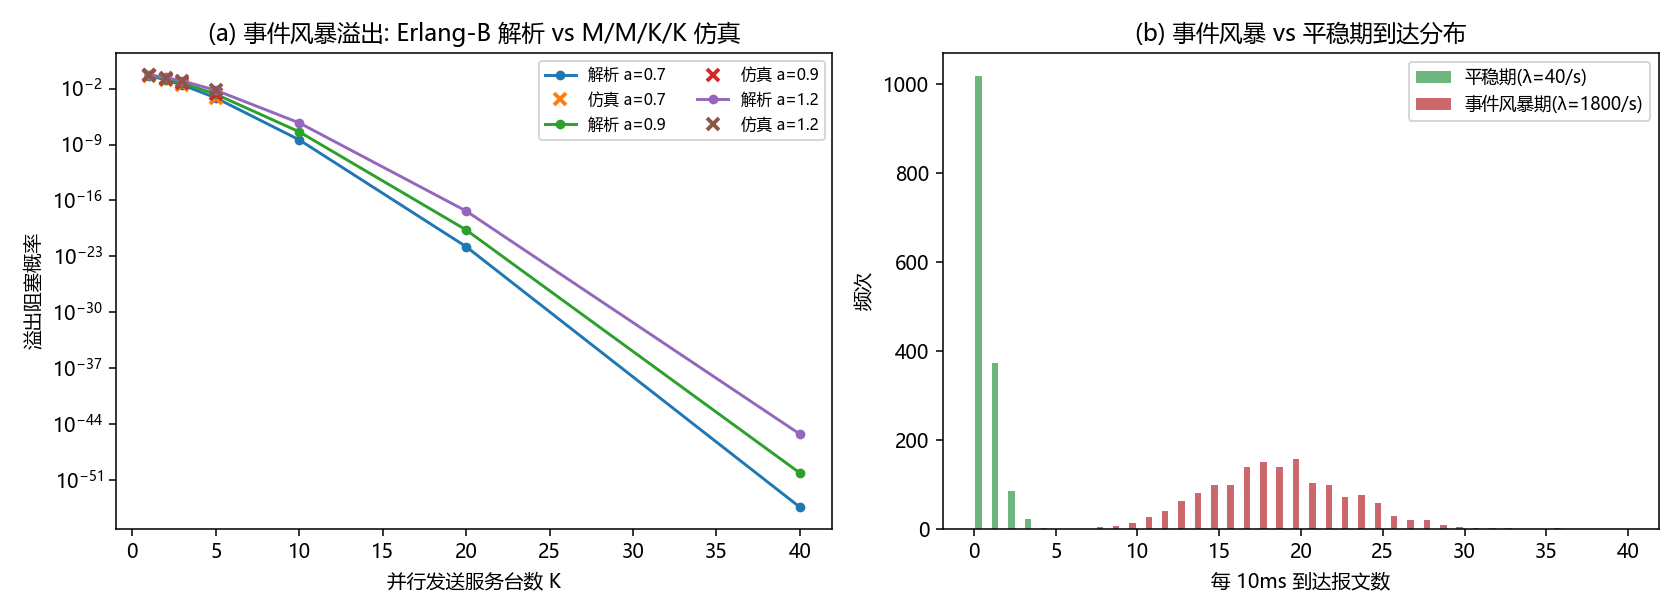
事件模式的"省带宽"有一个前提:发送侧永远接得住。真实情况是发送侧有有限的处理/发送能力(并行服务台),当事件率超过能力,多出来的事件只能被丢------而且丢的往往是"最新的那个",于是 AoI 反而恶化。
把发送侧建成无排队的损失系统 M/M/K/K:到达率 a(Erlang,即负载)、K 个并行服务台、每个服务率归一化为 1。当所有 K 个服务台都在忙时,新到达的事件被直接丢弃。其阻塞概率有 Erlang-B 闭式解:
B(a,K)=\\frac{a\^K/K!}{\\sum_{k=0}\^{K}a\^k/k!},\\qquad \\frac{1}{B(a,K)}=1+\\frac{K}{a}\\cdot\\frac{1}{B(a,K-1)}
表6 事件风暴溢出概率:Erlang-B 解析 vs M/M/K/K 仿真(每格"解析 / 仿真")
| offered load a | K=1 | K=2 | K=5 | K=10 | K=20 |
|---|---|---|---|---|---|
| 0.7 Erlang | 41.18% / 41.41% | 12.60% / 12.99% | 0.070% / 0.085% | 0 / 0 | 0 / 0 |
| 0.9 Erlang | 47.37% / 47.71% | 17.57% / 17.56% | 0.200% / 0.255% | 0 / 0 | 0 / 0 |
| 1.2 Erlang | 54.55% / 54.73% | 24.66% / 24.19% | 0.625% / 0.650% | 0 / 0 | 0 / 0 |
三条结论,每条都能直接改配置:
- 负载不到 1、K 只有 2 的时候,溢出率已经到了 12.6%~24.7% 。"平均利用率 90% 看着很健康"是个危险的错觉------溢出概率对 K 极度敏感,而对平均负载相对不敏感。这与排队论直觉一致:损失系统的瓶颈从来不是"平均够不够",而是"峰到的时候有几个台子"。
- K 是最便宜的旋钮 。a=0.9 时 K 从 2 加到 5,溢出率从 17.57% 掉到 0.20%(87 倍);再补到 10 就已经到 0。把事件发送从"单队列单线程"改成"多路并行/多核分摊",比调任何超时参数都立竿见影。
- 事件风暴的"到达分布"和稳态完全是两回事 。图右把"平稳期 λ=40 /s"和"风暴期 λ=1800 /s"在 10 ms 窗口内的到达数画在一起:平稳期 93% 的窗口是 0~1 个到达,而风暴期均值 18 个、尾部到 30+。做缓冲/并行度预算必须按风暴期的最坏窗口配,按稳态配出来的系统一遇风暴必崩。
顺带一个自查方法:如果现场出现"事件时有时无、且集中在一段时间",先在发送侧统计"单位时间事件数 vs 事件丢弃数"。若丢弃数非 0,再好的接收端逻辑也救不回来------问题在发送侧并行度,不在 SD,也不在订阅。
6. 序号缺口检测:阈值 G 的检出率、误报率与时延三角
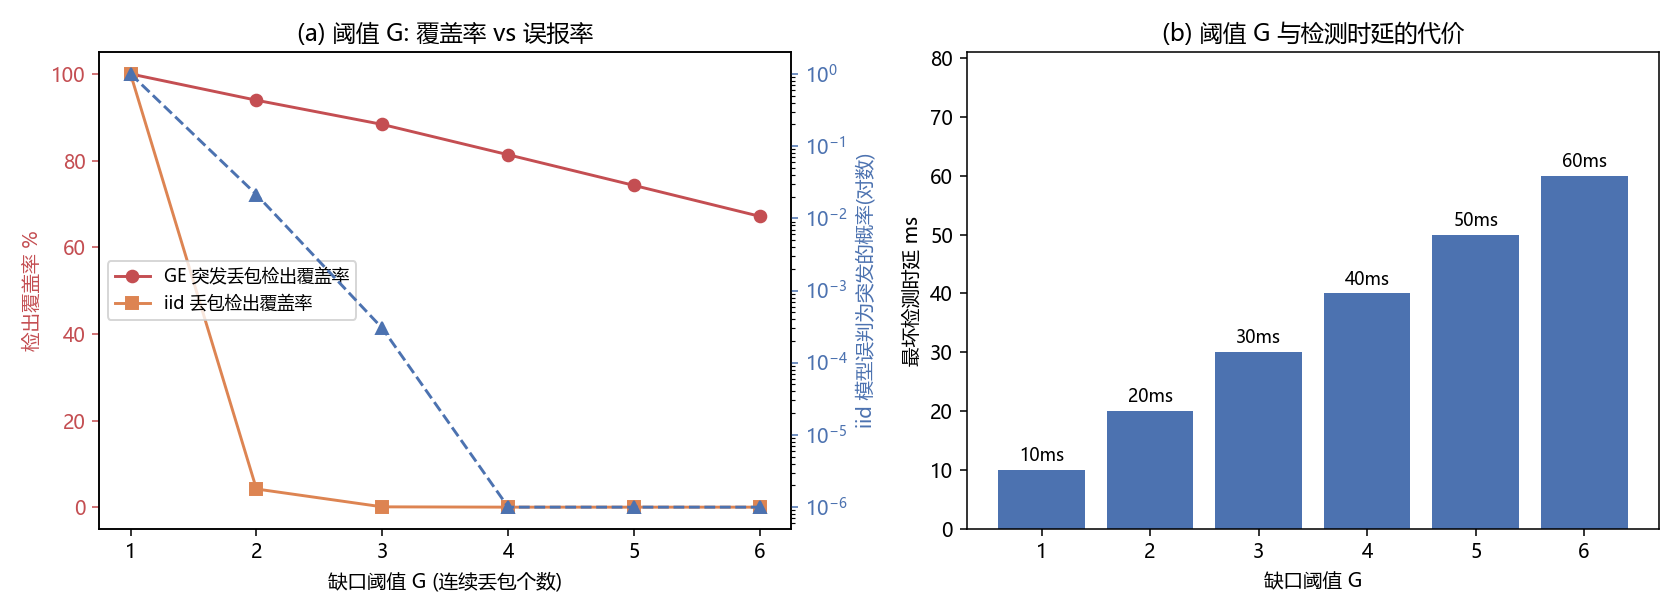
SOME/IP 的每个事件通知都带序列号 。接收端看到序列号跳号,就知道中间丢了帧。这条信息有两个用途:一是让"至少一次"语义的接收端知道该不该重同步;二是判断链路是"随机散点丢包"还是"进入了突发损伤",后者的处置完全不同(前者继续跑,后者要降级/切备用通道)。
判据很简单:维护一个"连续丢包计数",当连续丢包数 ≥ 阈值 G 时,判为突发。G 越大越不容易误报,但检出也越晚、越可能漏掉短突发。
表7 缺口检测阈值 G 的三角权衡(GE 突发丢包 vs iid 随机丢包)
| 阈值 G | 突发检出覆盖率(GE) | iid 误判为突发 | iid 检出覆盖率 | 最坏检测时延 |
|---|---|---|---|---|
| 1 | 100.00% | 100.00% | 100.00% | 10 ms |
| 2 | 93.93% | 2.13% | 4.19% | 20 ms |
| 3 | 88.34% | 0.03% | 0.07% | 30 ms |
| 4 | 81.34% | 0.00% | 0.00% | 40 ms |
| 5 | 74.26% | 0.00% | 0.00% | 50 ms |
| 6 | 67.12% | 0.00% | 0.00% | 60 ms |
读法(以及为什么这张表能直接用):
- G=1 等于没有判据。任何一次丢包都被判成"突发",误报率 100%------这解释了为什么"只统计丢包率就报警"的监控一定会被淹没:随机 2% 丢包下,每 50 帧就报一次。
- G=2 是检出率的甜蜜点 :93.93% 的突发丢包帧落在"连续 ≥2"的游程里,而 iid 随机丢包只有 2.13% 的游程会被误判成突发。用一个整数计数器就能把"突发"和"散点"以 44:1 的对比度分开------这就是 GE 与 iid 在"游程长度"这个特征上的可分性(平均游程 4.78 vs 1.02)。
- G 从 2 升到 3,误报率从 2.13% 掉到 0.03%(71 倍),代价是检出覆盖率掉 5.6 个点、时延从 20 ms 涨到 30 ms 。这是一个典型的"三选二":检出率高 / 误报低 / 响应快,三者不可能同时最优。量产建议:G=2 用于"触发降级"(宁可误报也不漏报),G=3 用于"触发告警/记录"(宁可漏报也不刷屏)------同一份数据,两个阈值,两个用途。
- 时延就是 G×周期 。如果通知周期是 10 ms,那么 G=3 意味着"最早也要 30 ms 之后才确认突发"。这条约束会把周期和检测阈值绑死 :要 20 ms 内检测到,要么 G≤2,要么把周期压到 5 ms(带宽翻倍)。"检测要多快"和"多久发一帧"从来不是两个独立参数。
这一步同时也是上一篇预告别里那句"序列号回绕时客户端如何区分旧包和新包 "的落点:序列号是 16 位会回绕的,实现里必须用模 2^16 的差值判断"往前跳了多少",且要把"跳号差值大于某个界(比如 32768)"当成接收端重启/重同步 而不是"一次丢了 3 万帧"。缺口检测的判据只能建立在"有序 + 有界"两个前提上,否则一次回绕就能把统计量打爆。
再加一层迟滞,把"抖动"彻底挡掉 :实测里 G=2 与 G=3 的差异说明,单阈值检测在边界上会反复横跳------一段刚过阈值的突发结束后,计数器归零,紧接着的一个随机丢包又可能重新触发状态切换。工程做法是给状态机加不对称迟滞 :进入"突发"用 G=2(快),退出"突发"要求"连续 M 个周期无丢包"(慢,M 取 5~10)。这样一次真实的短暂突发只会产生一次告警,而不是"进入---退出---再进入"的告警风暴。告警风暴的代价被严重低估:它会让运维直接关掉这条告警,于是真正的故障也一起被关掉了。
7. 丢包放大:从单帧到消息级(SOME/IP-TP 视角)
TP 分片是第 04 篇的主题,但它在丢包语义 里必须提前露一次面,因为它制造了一类典型的非线性:一条消息被切成 n 片,只要丢任意一片,整条消息就失败。于是单帧丢包率 p 会被放大成消息级丢包率:
p_{m}=1-(1-p)\^{n},\\qquad n=\\left\\lceil \\frac{P}{1623\\,\\mathrm{B}}\\right\\rceil
式中 p_{m} 为消息级丢包率、P 为单条消息的载荷字节数、n 为分片数(单分片净荷 1623 B)。
表8 分片数对消息级丢包率的放大(p=1%,每档 20 万次蒙特卡洛)
| 载荷 | 分片数 n | 消息级丢包(解析) | 消息级丢包(实测) | 放大倍数 |
|---|---|---|---|---|
| 512 B | 1 | 1.000% | 1.005% | 1.00× |
| 2 KB | 2 | 1.990% | 1.985% | 1.99× |
| 8 KB | 6 | 5.852% | 5.875% | 5.85× |
| 32 KB | 21 | 19.027% | 18.931% | 19.03× |
| 64 KB | 41 | 33.772% | 33.798% | 33.77× |
用本篇 iid 模型实测的 2.043% 丢包率复算一遍同一张表 (直接代入 \(1-(1-p)^n\),把小片丢包换成本篇的散点模型):512 B → 2.04% 、2 KB → 4.04% 、8 KB → 11.65% 、32 KB → 35.17% 、64 KB → 57.10% 。也就是说,单帧 2% 的散点丢包,在 64 KB 消息上会变成 57.1% 的消息级失败------一半以上的大消息收不全。
三条工程结论:
- "链路 1% 丢包"和"功能可用"之间没有直接关系 。1% 对 512 B 消息是 1%,对 64 KB 消息是 33.8%;报"丢包率 1%,链路正常"之前,必须换算到业务消息级。
- TP 必须有 ARQ 或分片级兜底 。纯 UDP 的 SOME/IP-TP 一旦丢了任意一片,整条消息只能等重组超时后重传整条------而重传又带来新的 33.8% 失败概率,于是"大消息发送"变成一个几何分布问题:期望尝试次数 \(1/(1-p_{m})\)。这是 04 篇会展开算的账。
- 分片数与丢包放大近似线性(小 p 时) 。因为 \(1-(1-p)^n \approx np\)。把一条大消息拆成两条小消息、或提高分片净荷利用率,都能直接砍掉放大倍数------这是比换协议栈便宜得多的优化。
8. 带宽---AoI 帕累托:通知模式怎么选
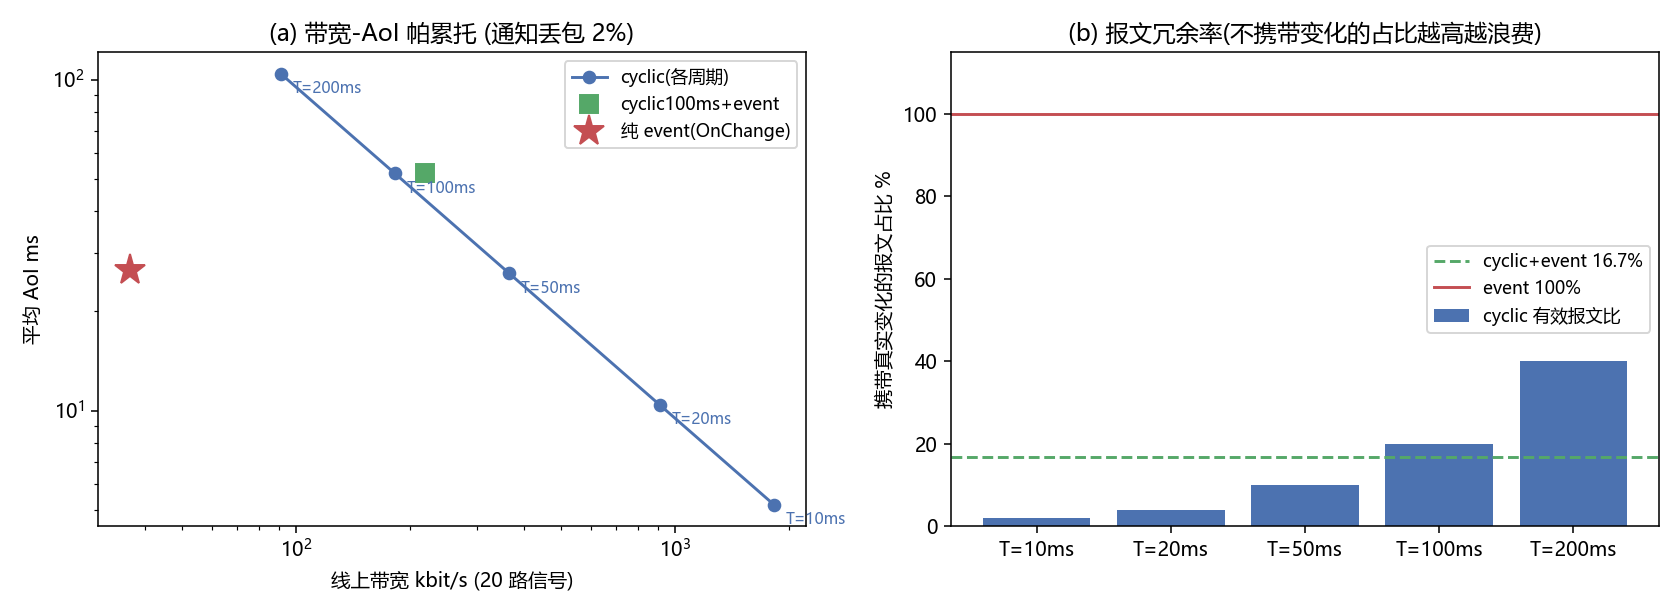
把第 3 节的带宽和第 4 节的 AoI 放到同一张图上,就得到通知模式的帕累托前沿。工作点(20 路信号、2 Hz、2% 通知丢包):
表9 各通知模式在"带宽---时效"平面上的坐标(取 p=2%)
| 模式 | 带宽 kbit/s | 平均 AoI ms | 是否被支配 |
|---|---|---|---|
| cyclic T=10 ms | 1824.0 | 5.204 | 前沿(最快但最贵) |
| cyclic T=20 ms | 912.0 | 10.408 | 前沿 |
| cyclic T=50 ms | 364.8 | 26.020 | 被纯事件支配 |
| cyclic T=100 ms | 182.4 | 52.041 | 前沿(最省的周期档) |
| cyclic T=200 ms | 91.2 | 104.08 | 前沿(极省) |
| 纯事件 | 36.5 | 26.510 | 前沿(最省) |
| cyclic 100 ms + event | 218.9 | 52.041 | 被纯事件完全支配 |
图上能一眼看出两件事:
- 纯事件(36.5 kbit/s, 26.51 ms)把"cyclic 50 ms"(364.8 kbit/s, 26.02 ms)整个盖住了 :带宽只有它的 1/10,AoI 只差 0.5 ms。同样地,它把"cyclic 100 ms + event"(218.9 kbit/s, 52.04 ms)完全支配------后者带宽更高、时效更差,双输 。所以那条"既配周期又配事件"的常见配置,在本篇的工作点上没有任何存在理由 ;它之所以在工程里存在,是因为它想买的是"事件不可靠时的兜底",而不是带宽效率------要兜底就应该显式把兜底周期配长(比如 1 s),而不是配成 100 ms 这种"半吊子冗余"。
- "冗余率"是这套权衡的另一种读法 。右边那张图里,cyclic T=10 ms 只有 2% 的报文携带真实变化,纯事件是 100%。报文冗余率越高,同样的 AoI 就要花越多的带宽,这不是实现问题,是模式本身的性质。
把选择讲成一句可执行的话:
- 要最坏情况可预期(安全相关、控制回路)→ 周期,按"允许多旧"定 T;
- 要带宽效率(状态、诊断、舒适件)→ 事件 + 长周期兜底(兜底周期按业务容忍上限定,通常 500 ms~1 s,而不是 100 ms);
- 绝不要用"短周期 + 事件"做所谓的高可靠------它在本篇的工作点上双输,真正的可靠性来自第 5 节的发送侧并行度与第 7 节的消息级兜底,而不是多发冗余帧。
9. 落地检查单:上车前 12 问
表10 本篇沉淀的工程检查单(带实测参考值)
| # | 检查项 | 通过判据 | 本篇参考值 |
|---|---|---|---|
| 1 | 丢包评估区分"散点/突发" | 至少统计游程长度分布 | iid 游程 1.02 vs GE 4.78 |
| 2 | 丢包率统计窗口足够长 | ≥10 万报文 或 ≥10 个 Bad 驻留 | GE 短窗偏差可达 7.19% |
| 3 | 事件模式配了 min-cycle / debounce | 事件率有上界 | 未配则 2 Hz/路 可放大成风暴 |
| 4 | 发送侧并行度 K 按风暴期配 | 风暴期溢出率 <0.5% | a=0.9: K=2→17.57%,K=5→0.20% |
| 5 | 用 AoI 而非丢包率定周期 | 有"可接受年龄"指标 | AoI 放大系数 (1+p)/(1−p) |
| 6 | 周期 T 按最坏 AoI 反推 | T(2−q)/(2q) ≤ 预算 | T=100ms,p=10% → 61.1 ms |
| 7 | 事件模式有周期兜底 | 兜底周期 = 业务容忍上限 | 建议 500ms~1s,勿用 100ms 冗余帧 |
| 8 | 缺口检测阈值分级 | 降级用 G=2,告警用 G=3 | G=2: 93.9%/2.13% G=3: 88.3%/0.03% |
| 9 | 检测时延预算与周期联动 | G×周期 ≤ 检测预算 | G=3,T=10ms → 30ms |
| 10 | 序列号回绕有界判断 | 差值按模 2^16,超界判重同步 | 避免一次回绕打爆统计量 |
| 11 | 大消息按消息级失败率评估 | \(1-(1-p)^n\) 换算到业务级 | 2% 单帧 / 64KB → 57.1% |
| 12 | 大消息配 ARQ 或分片兜底 | 有重传且重传也有预算 | 期望尝试 \(1/(1-p_{m})\) |
10. 方法论:三条可迁移的结论
- 标量指标会掩盖结构 。同样的 2% 丢包,iid 与 GE 的功能后果差了整整一个量级;同样的 1% 单帧丢包,64 KB 消息上是 33.8%。任何"一个数字就能说明问题"的说法,先怀疑它是平均出来的。工程上要多存一维:丢包要存游程分布,大消息要存消息级失败率。
- 时效指标要选对 :丢包率、报文率、带宽都只是中间量 ,业务真正感受到的是 AoI(最新值的年龄)和消息级失败率。本篇把这两条都算成了闭式,可以直接拿去写需求:"最新车速的年龄 ≤ X ms"比"周期 ≤ 10 ms、丢包 ≤ 1%"更接近功能安全想要的东西。
- 非线性处才是预算的着力点 。带宽和 AoI 是对数/线性可换的平滑地带(调周期就行),而溢出概率(对 K 的指数敏感)和分片放大(对 n 的近似线性) 都是非线性区。把优化力气花在非线性上:加一个并行服务台能换 87 倍的溢出率,而把周期从 20 ms 调到 10 ms 只换来 2 倍的 AoI。
11. 本篇的可复现性
- 环境:Python 3.12 + matplotlib 3.10,单文件
exp03.py,随机种子 20261012,一次运行约 8 秒。 - 规模:三类丢包序列各 20 万报文;AoI 仿真 400000 槽/档;队列 M/M/K/K 每档 40000 次到达;TP 每档 20 万次蒙特卡洛。
- 图表:5 张图全部由脚本直接生成(丢包模型 / AoI / 事件风暴溢出 / 缺口检测 / 带宽-AoI 帕累托),
rcParams中文字体 Microsoft YaHei,保存 dpi=140,无手工绘制。 - 关键模型(解析式,可手工验算):
python
import math
# 三类模型的稳态丢包率
piB = 0.004 / (0.004 + 0.10)          # 0.03846  <- GE Bad 态占比
p_ge = piB * 0.90 + (1 - piB) * 0.001 # 0.03558   <- 表2 解析值 3.558%
p_cong = 0.5 * 0.28 + 0.5 * 0.002     # 0.14100   <- 表2 解析值 14.10%

# 周期通知 AoI: E[AoI] = T(2-q)/(2q),  q = 1-p
def aoi_cyclic(T, p):
    q = 1 - p
    return T * (2 - q) / (2 * q)
aoi_cyclic(20, 0.02)     # 10.408 ms <- 表4
(1 + 0.10) / (1 - 0.10)  # 1.2222    <- AoI 放大系数 (1+p)/(1-p)

# 事件驱动 AoI: 1000/(λq) + d
1000 / (40 * 0.98) + 1.0 # 26.510 ms <- 表5

# Erlang-B 溢出
def erlang_b(a, K):
    inv = 1.0
    for k in range(1, K + 1):
        inv = 1.0 + inv * k / a
    return 1.0 / inv
erlang_b(0.9, 2)         # 0.17570   <- 表6
erlang_b(0.9, 5)         # 0.00200   <- 表6

# TP 分片放大: 1-(1-p)^n
for P in (512, 2048, 8192, 32768, 65536):
    n = math.ceil(P / 1623)
    print(P, n, round((1 - (1 - 0.02043) ** n) * 100, 2))
# 512 1 2.04 / 2048 2 4.04 / 8192 6 11.65 / 32768 21 35.17 / 65536 41 57.1- 全部中间结果已落盘
exp03_out.json,表2~表8 的每一个数字都能在其中找到对应字段(A_loss/B_mode/C_aoi/D_queue/E_gap/F_tp)。
12. 下篇预告
04. SOME/IP-TP 分片与大数据传输:本篇只算了"分片把丢包放大 n 倍"这一半的账。下篇把另一半补齐------1412/1631 B 的边界到底怎么来的、分片头 8 字节如何吃掉有效载荷、重组超时该配多长(和分片数、链路 RTT、重传次数联立)、以及"丢一片重传整条"与"分片级 ARQ"两套方案的期望时延和成功率对比。同样是一份固定种子、可复跑的单文件实验,把"大消息到底怎么发才不崩"量化成表和图。