**摘要:**本文介绍 LangGraph 的安装与核心概念,重点讲解 State(状态)、Node(节点)、Edge(边)和 Graph(流程图)四大组件,并通过一个完整的 Python 代码示例演示如何定义状态结构、创建节点、设置入口与边,最终编译并运行一个带状态管理的 Agent 工作流(StateGraph)。
内容参考于:图灵AI大模型全栈
在安装LangChain的时候它会给我们把langgraph安装好,但是还是最好执行一下LangGraph的安装命令
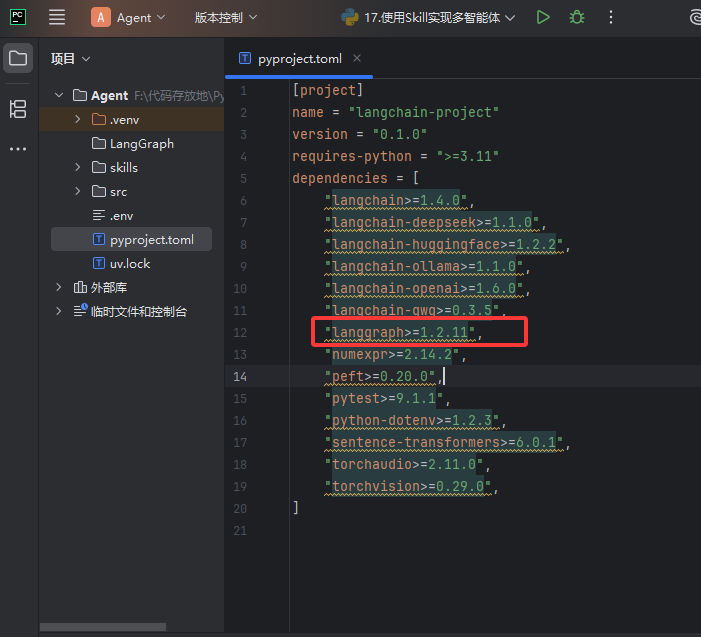
uv add langgraph执行一下上方的命令可以让uv锁定LangGraph的版本,如下图红框锁定LangGraph的版本
LangGraph基础概念
序号 核心概念 ① State(状态) 用来保存整个工作流在工作的时候的上下文 ② Node(节点) 节点就是我们写的函数,比如调用工具的函数是一个节点、调用大模型是一个节点、调用某个函数是一个节点 ③ Edge(边/跳转) 用来控制流程的走向,比如执行完查询订单节点后该去哪,都是通过边来决定的 ④ Graph(流程图) 用来把State、Node、Edge全部整合起来,从而形成一张图,这就是LangGraph的主要结构
流程图:
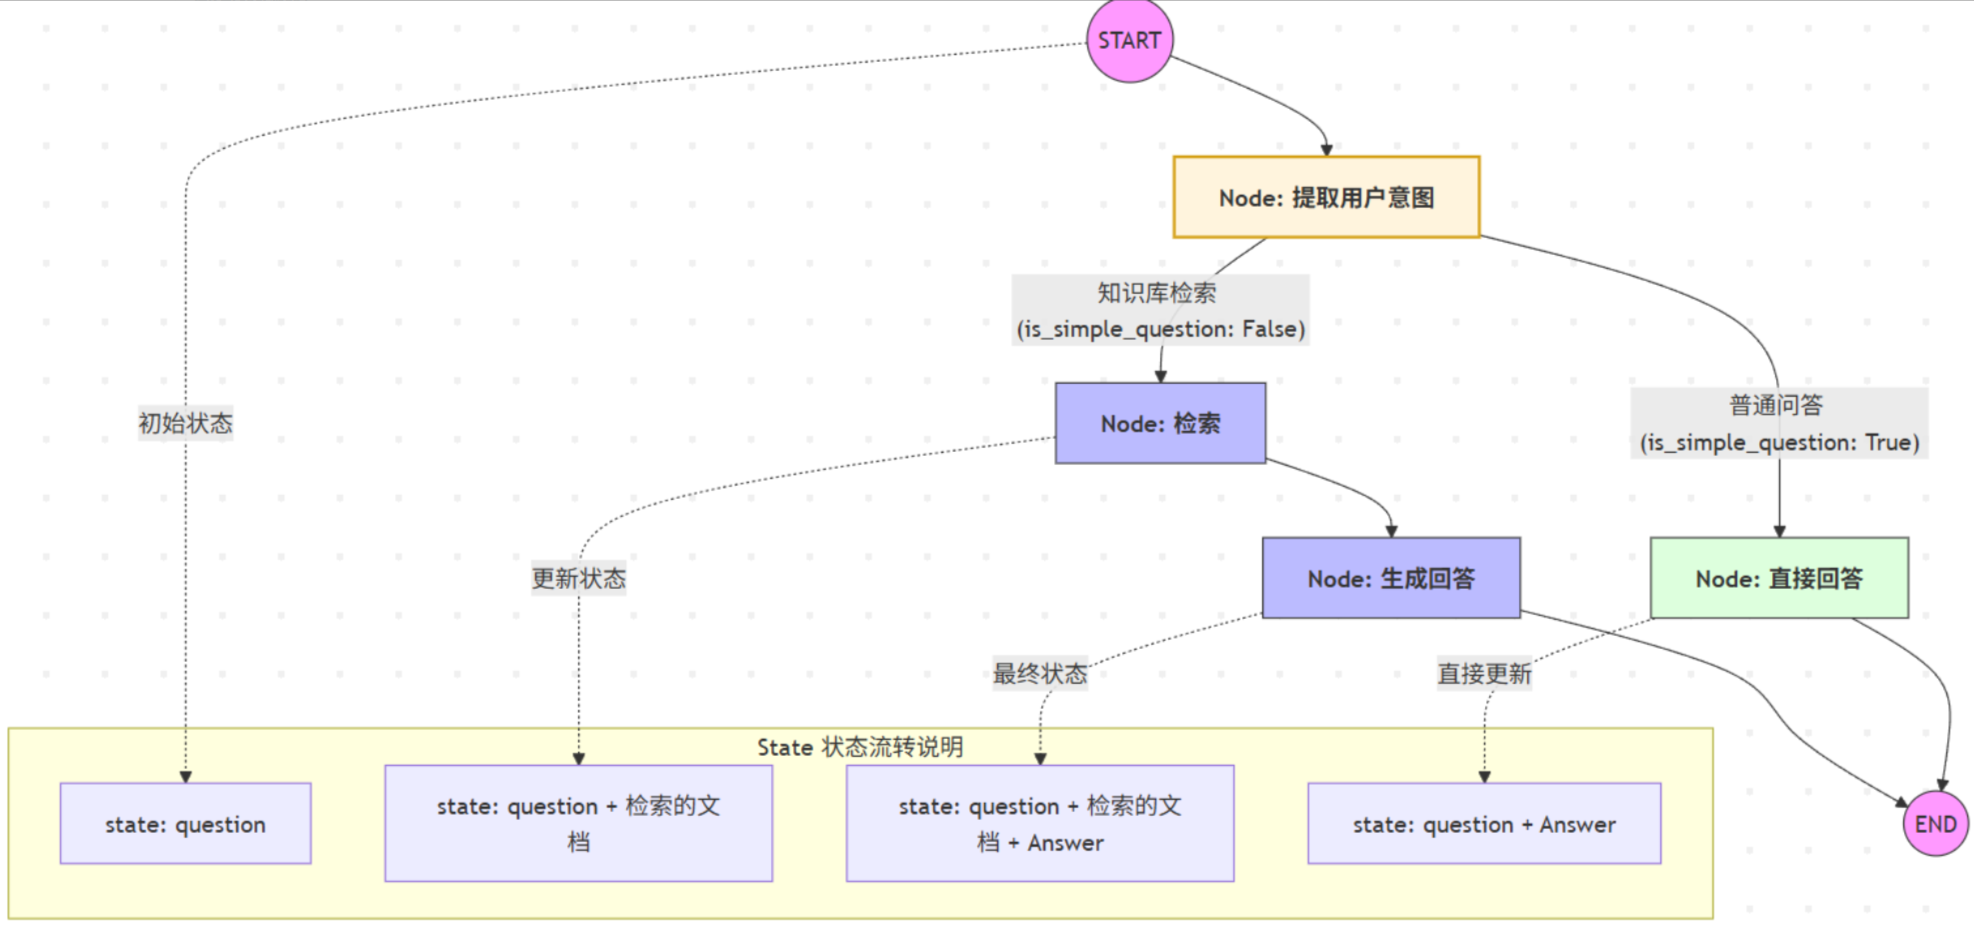
它用来把Agent的工作流程建模成一个图表,State、Node、Edge为建模的组件,LangGraph强大的地方是State的管理
现有如下步骤:
它现在的流程时Start启动Agent
然后就初始化State
然后提取用户的意图
如果普通问题就直接回答问题,回答完后把内容写到State中
如果需要知识库(RAG)检索,就去检索知识库,检索完把内容更新到State然后生成回答,生成完后写到State中
经过上方的步骤后就把State、Node、Edge整合起来了,然后就形成了一个流程图,这种流程图叫做StateGraph(带状态管理的流程图)
StateGraph(状态图)说明
在LangGraph中它不仅仅是流程的控制,它特别强调在每个节点执行前和执行后都要可以访问和修改状态,节点是否跳转都可以依据状态的内容来判断,它就像我们家里的电一样,在我们的电器中流动,所以它被称为状态图(StateGraph),而不是流程图
代码说明
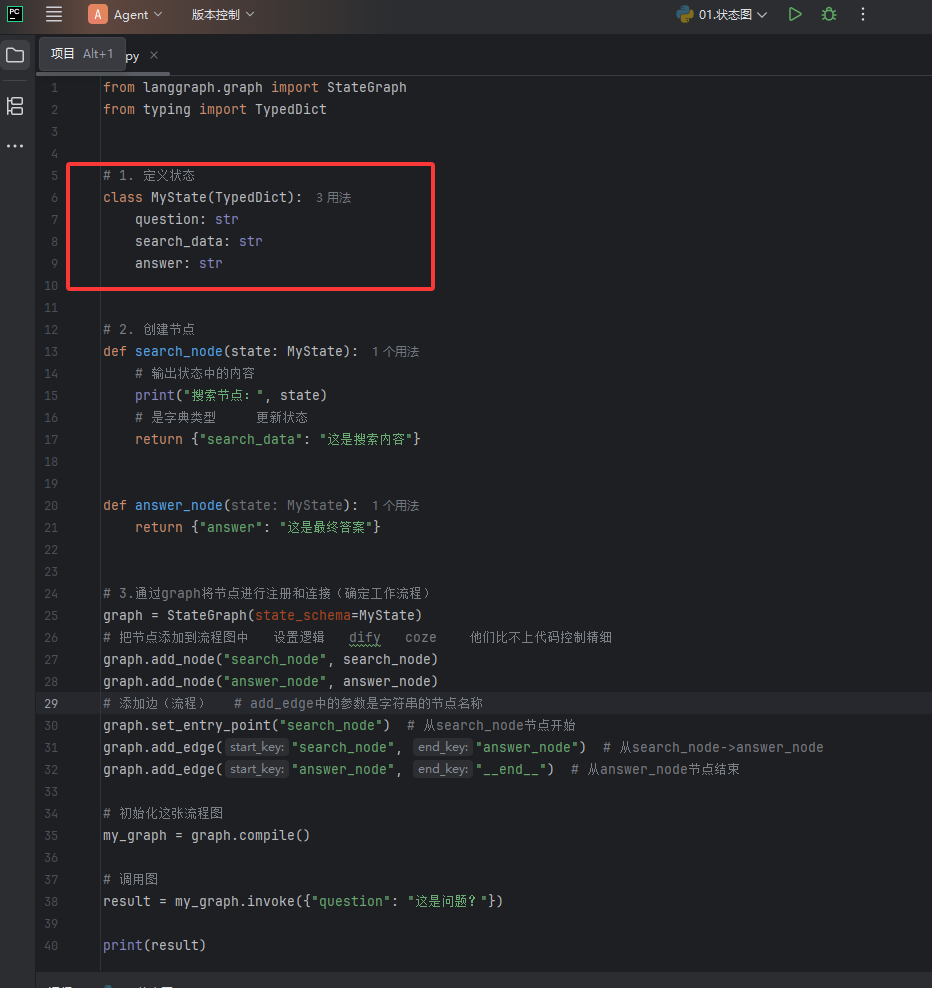
下图红框创建自定义的State,MyState 继承自 TypedDict,用来让MyState 变成带类型约束的字典
创建两个节点
创建LangGraph的状态图并设置状态
把节点添加到状态图中
下图红框的内容就是用来给下图蓝框的节点函数起一个别名,可以随意写,一般与函数名一致,如果下图红框位置不写默认是函数名
设置状态图的入口,就是进入状图后第一个执行的节点
设置节点的走向,也就是边(Edge)
下图红框的代码表示search_node1节点执行完后,下一步执行answer_node节点
下图红框的代码表示answer_node节点执行完后,下一步执行 end 节点, end 节点是LangGraph内置的状态图执行结束节点
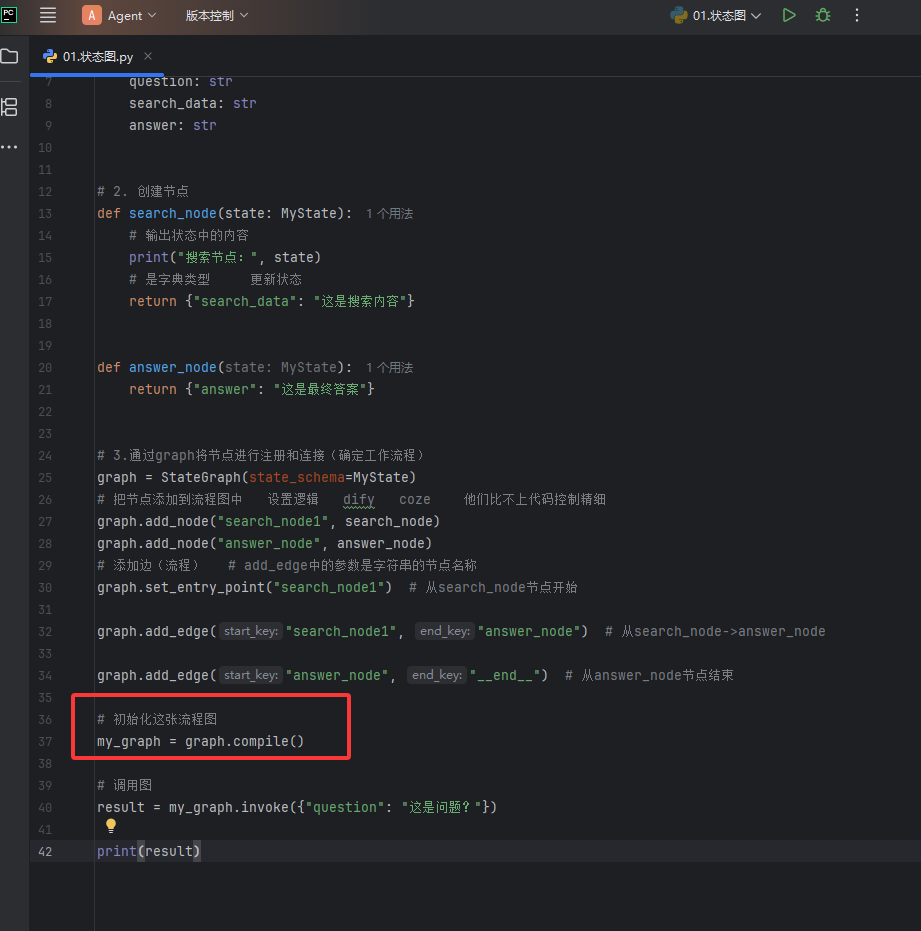
上方把状态图中的节点、边、状态都设置好,下方时初始化状态图
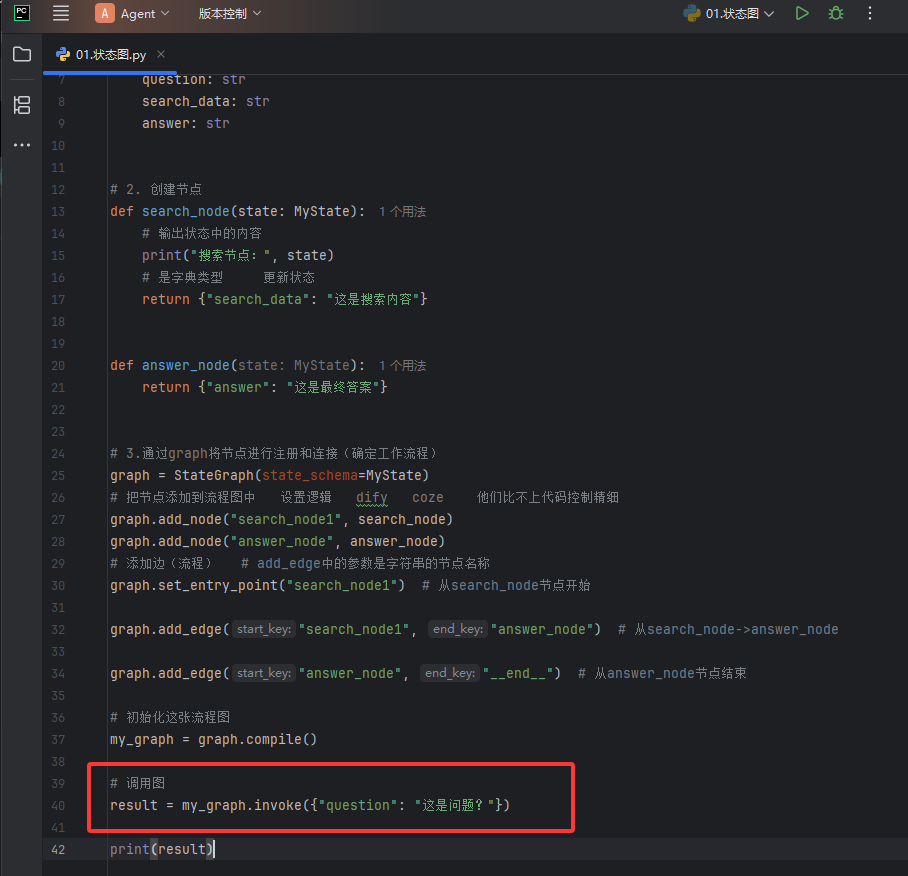
执行状态图
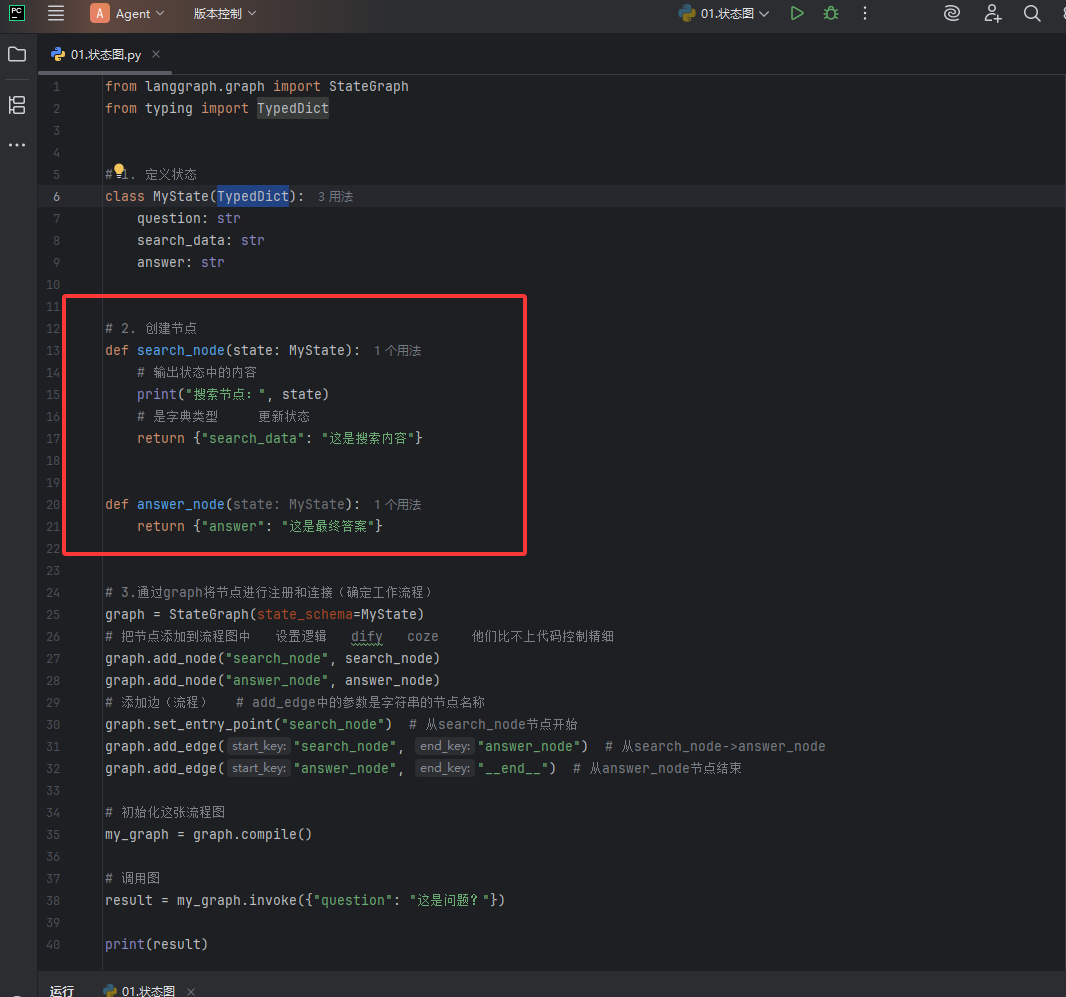
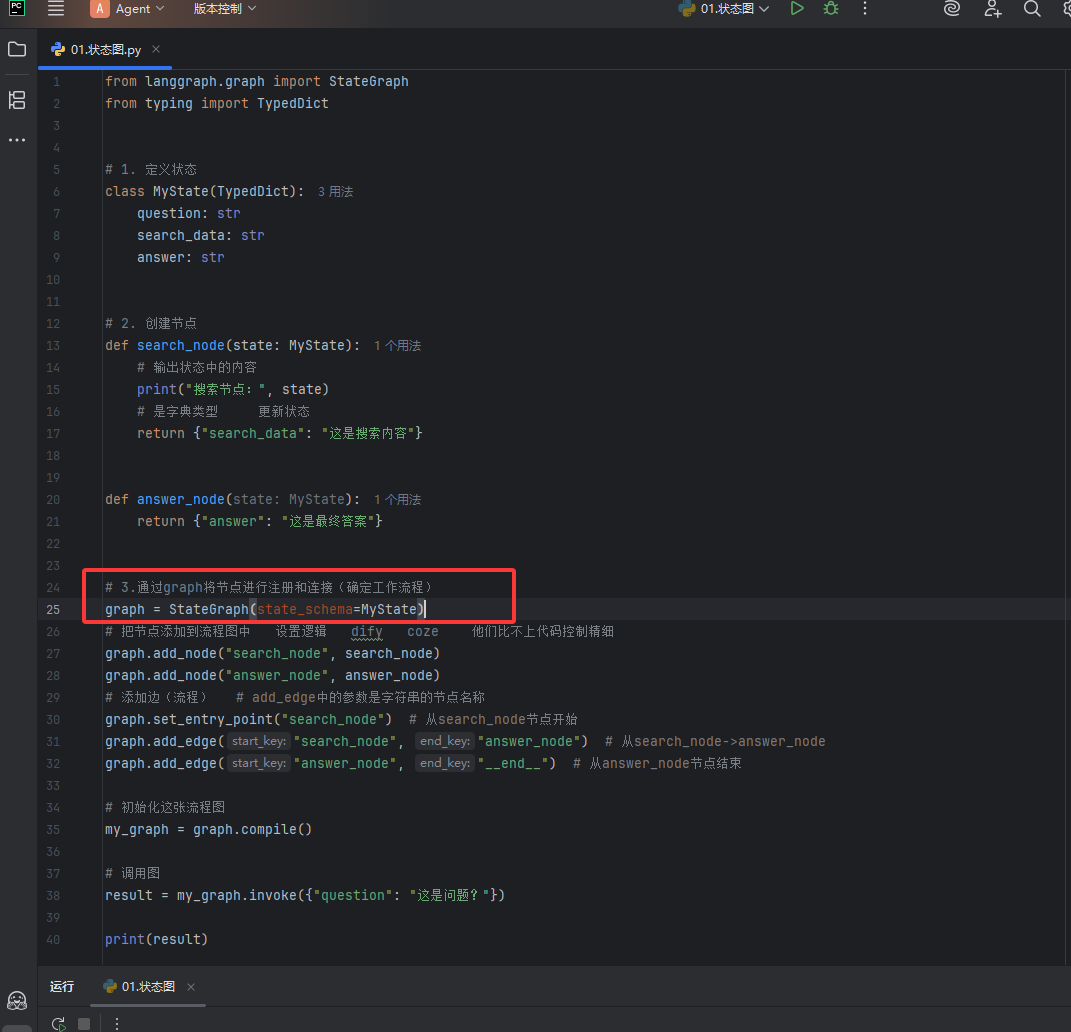
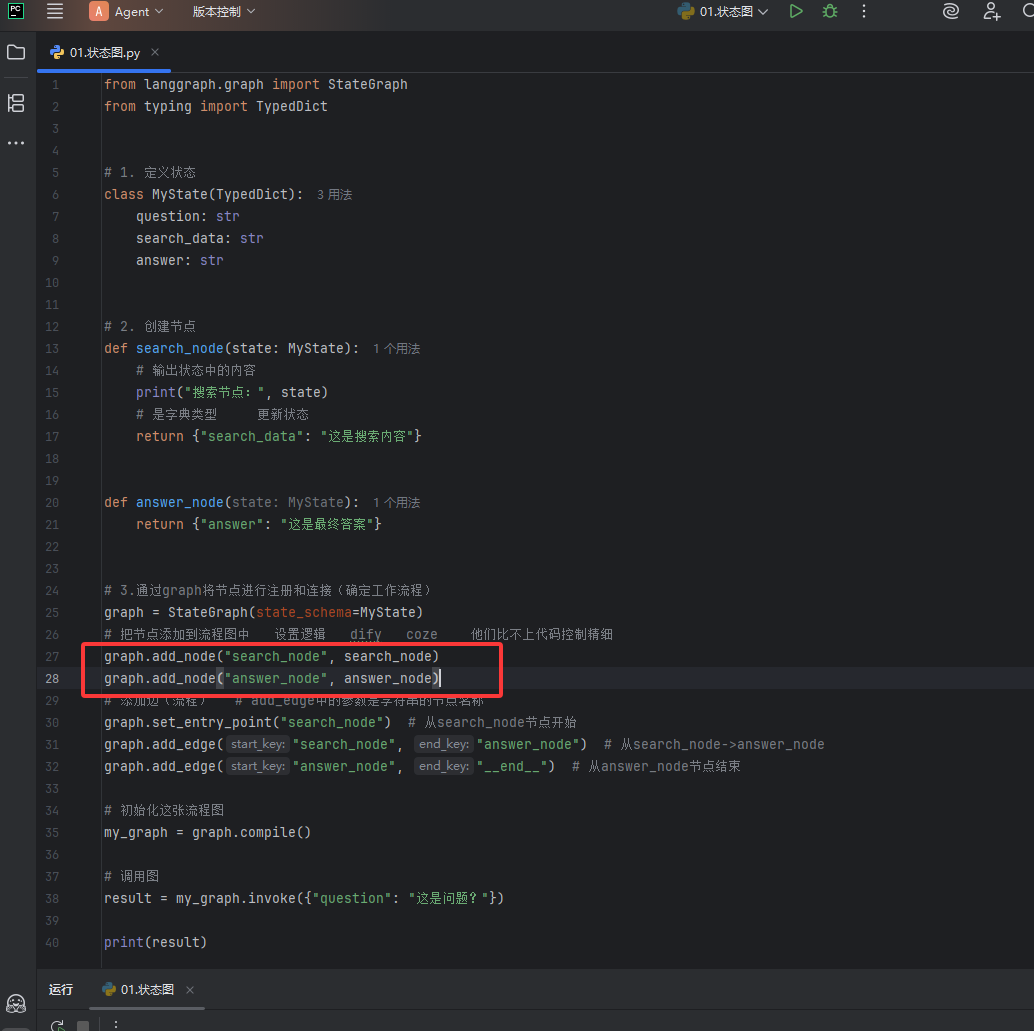
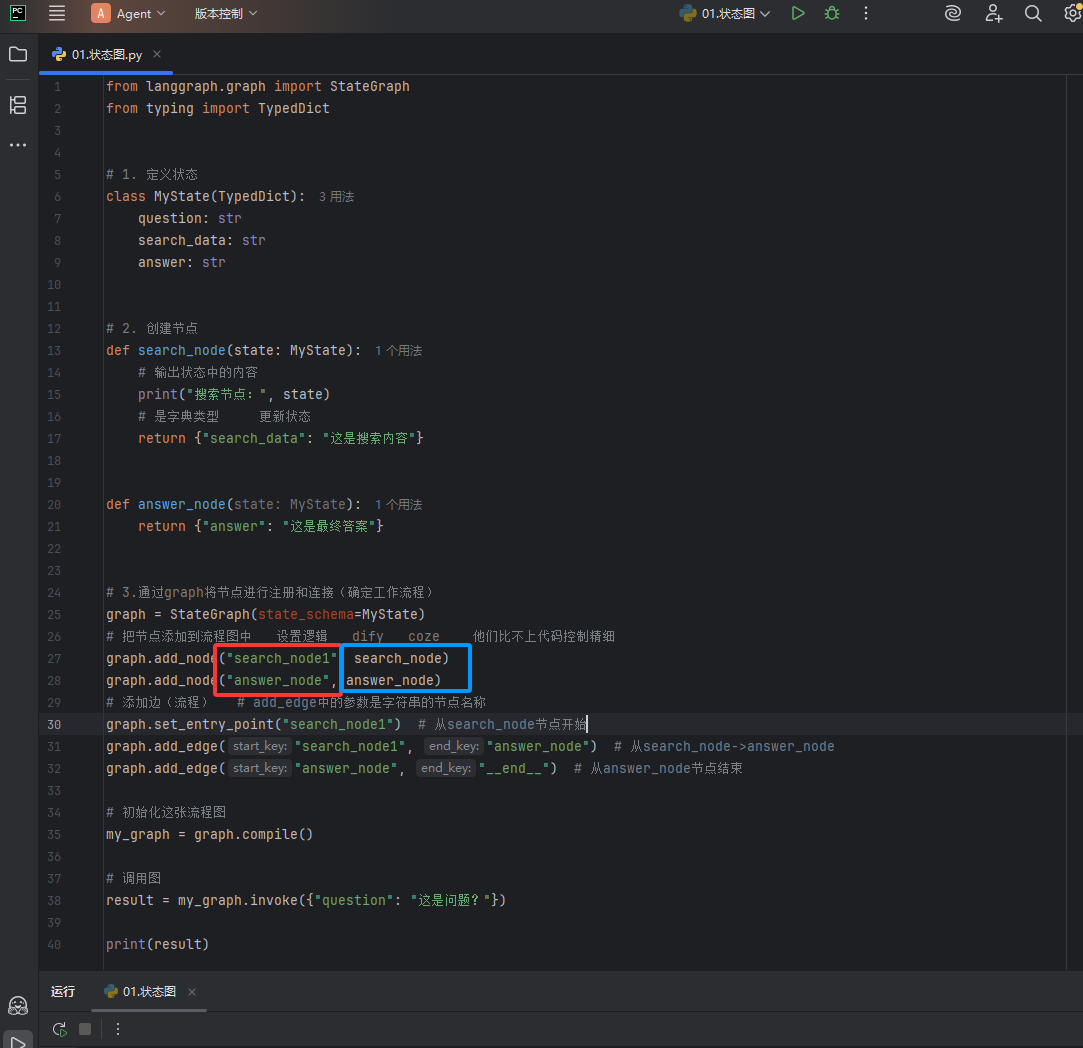
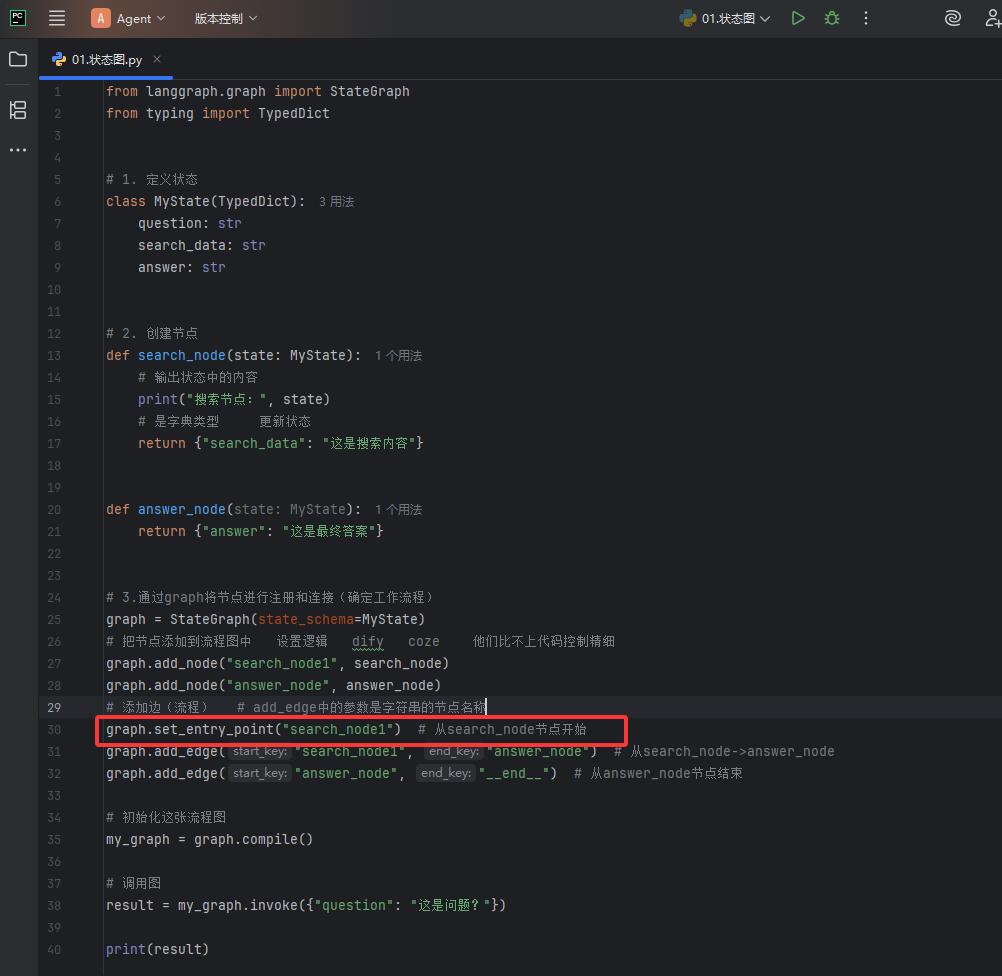
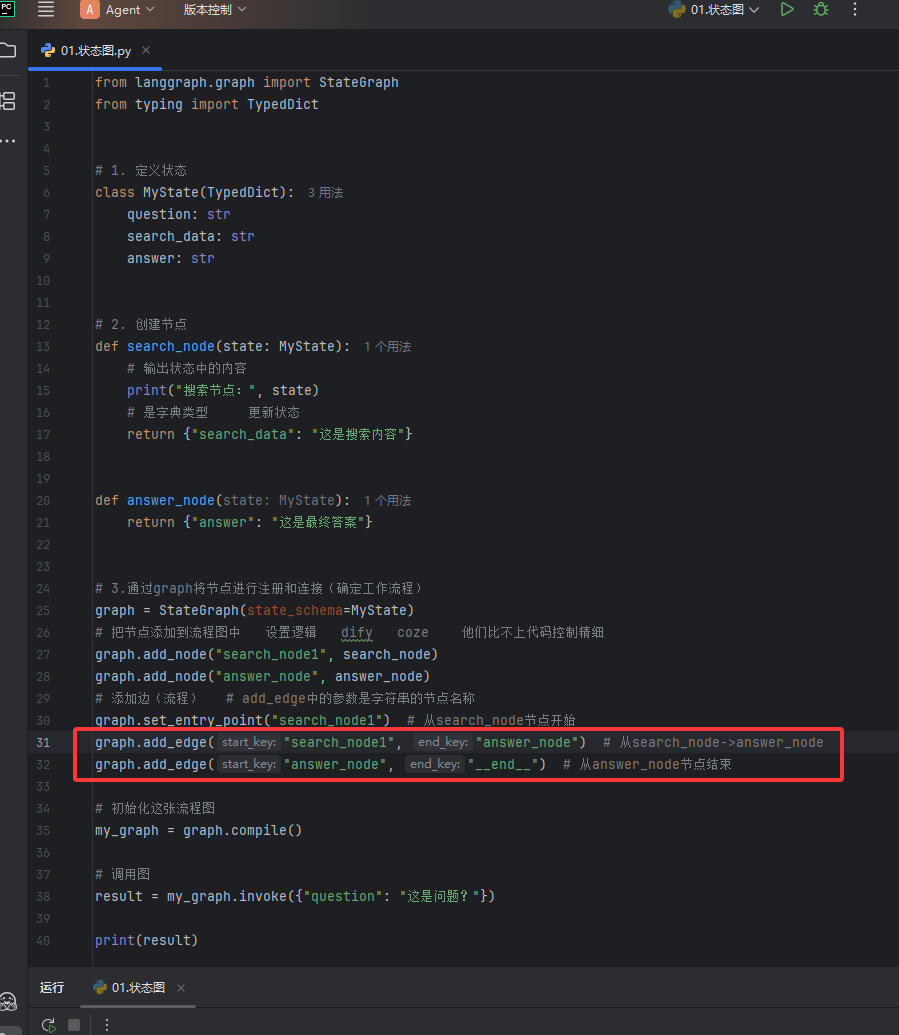
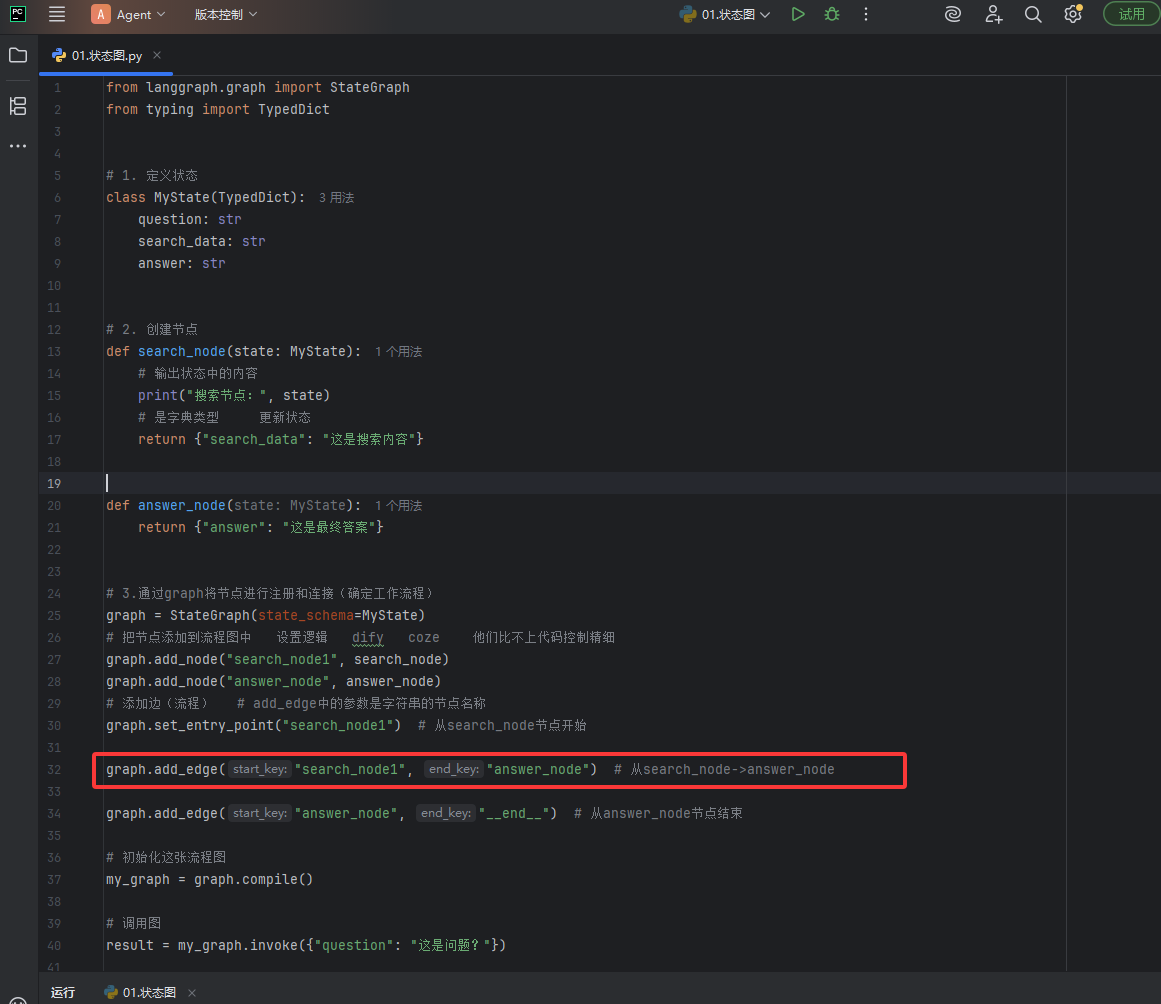
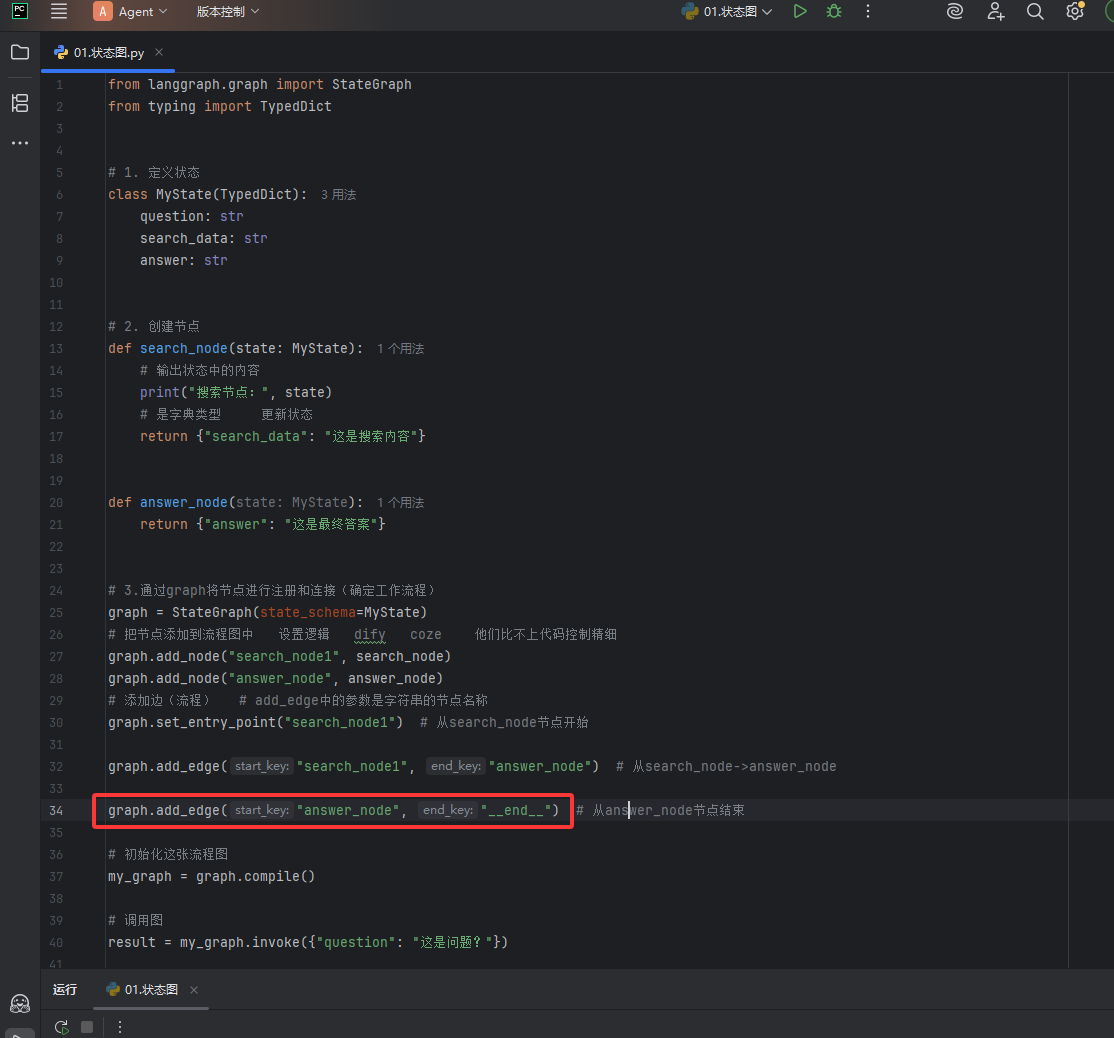
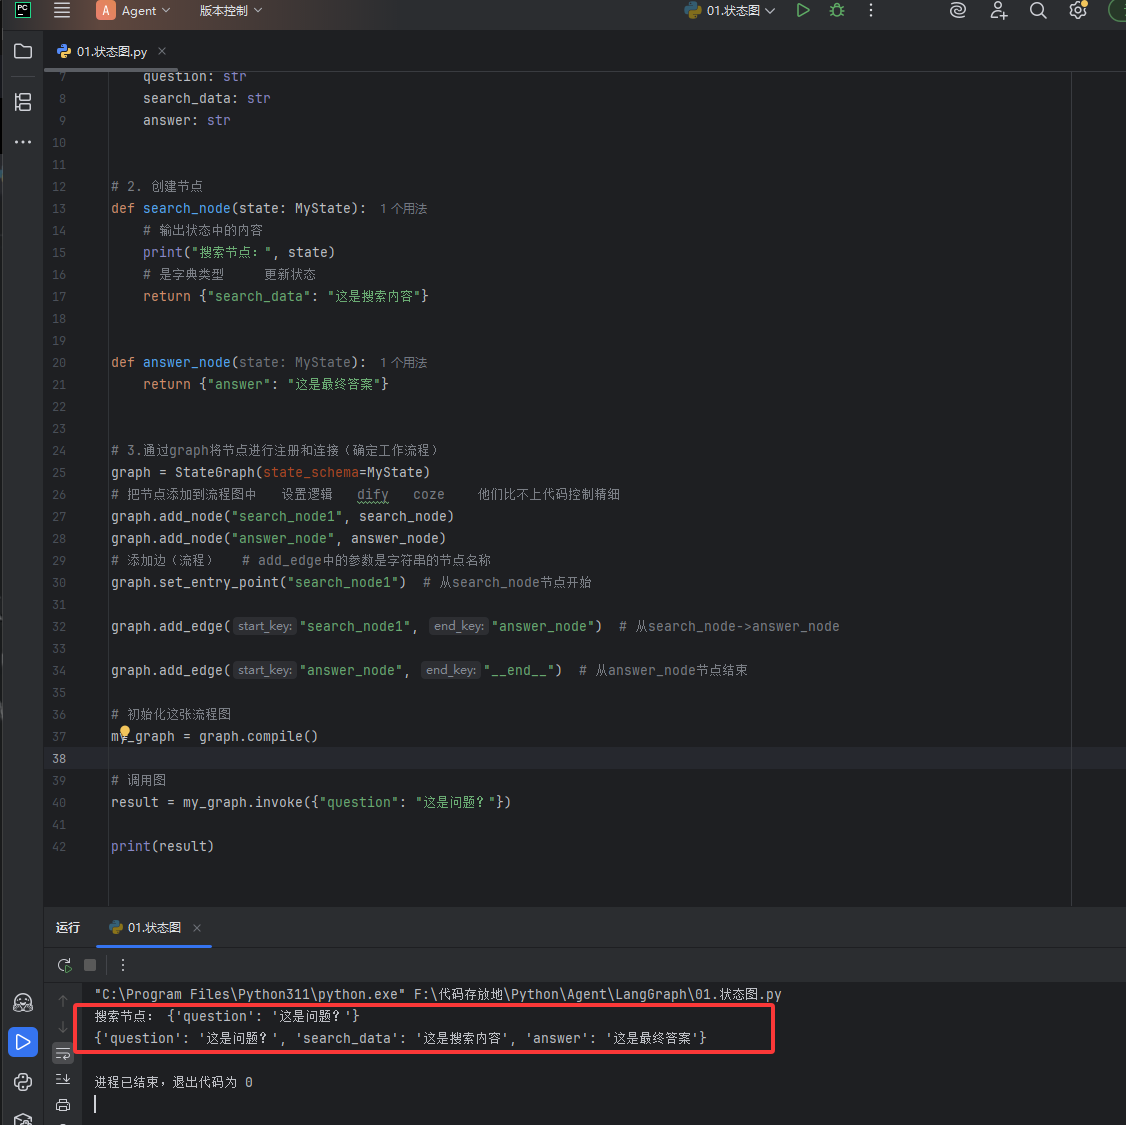
效果图:
代码
python
# 导入 LangGraph 核心类 StateGraph
# 作用:用于构建基于状态的有向工作流图,是 LangGraph 的核心流程容器
from langgraph.graph import StateGraph
导入 typing 模块的 TypedDict
作用:定义结构化字典类型,为状态数据提供类型约束和代码提示
from typing import TypedDict
===================== 1. 定义全局状态结构 =====================
MyState 继承自 TypedDict,本质是带类型约束的字典
作用:定义整个工作流共享的数据结构,所有节点的输入输出都遵循该结构
class MyState(TypedDict):
# question 字段:字符串类型
# 作用:存储用户输入的原始问题,是整个工作流的输入数据源
question: str
# search_data 字段:字符串类型
# 作用:存储搜索节点执行后产出的中间结果数据
search_data: str
# answer 字段:字符串类型
# 作用:存储回答节点生成的最终结果,是工作流的输出数据
answer: str
===================== 2. 定义工作流节点函数 =====================
节点函数通用规则:
- 输入参数:固定接收 1 个参数,即当前完整的状态字典
- 返回值:仅返回需要新增/修改的状态字段,LangGraph 会自动合并到全局状态
搜索节点:模拟执行搜索逻辑,产出搜索数据
参数 state: MyState:当前工作流的完整状态对象
作用:节点通过 state 读取历史数据,比如可读取 state["question"] 作为搜索关键词
def search_node(state: MyState):
# 打印当前状态,用于调试观察节点执行时的数据
print("搜索节点:", state)
# 返回需要更新的状态字段
# 这里只更新 search_data,question 字段会自动保留在全局状态中
return {"search_data": "这是搜索内容"}
回答节点:基于搜索结果生成最终答案
参数 state: MyState:当前完整状态,此时已包含 question + search_data
作用:基于前面节点产出的中间数据,生成最终回答
def answer_node(state: MyState):
# 返回需要更新的状态字段,新增 answer 字段
return {"answer": "这是最终答案"}
===================== 3. 构建工作流图 =====================
初始化 StateGraph 实例
参数 state_schema:指定状态的结构 schema,传入我们定义的 MyState 类
作用:约束整个工作流的数据格式,校验节点返回值的合法性,确保节点间数据传递一致
graph = StateGraph(state_schema=MyState)
向图中注册节点
相比 Dify、Coze 等低代码平台,纯代码方式对流程和逻辑的控制粒度更精细
参数1:"search_node" ------ 节点唯一ID(字符串)
作用:作为节点的标识,后续添加边、设置入口都通过这个ID引用节点
参数2:search_node ------ 节点执行函数
作用:工作流运行到该节点时,会调用这个函数执行具体逻辑
graph.add_node("search_node", search_node)
graph.add_node("answer_node", answer_node)
设置工作流的入口点
参数:"search_node" ------ 入口节点的ID
作用:指定工作流启动后第一个执行的节点,是整个流程的起点
graph.set_entry_point("search_node")
添加有向边,定义节点间的执行流向
参数1:"search_node" ------ 边的起点节点ID
参数2:"answer_node" ------ 边的终点节点ID
作用:当起点节点执行完成后,工作流自动流向终点节点继续执行
graph.add_edge("search_node", "answer_node")
添加指向结束节点的边
参数2:"end" ------ LangGraph 内置的特殊终止节点(固定写法)
作用:标记工作流的终点,到达此节点后工作流停止运行,并返回最终状态
graph.add_edge("answer_node", "end")
===================== 4. 编译并运行工作流 =====================
编译图结构
无参数调用时使用默认配置
作用:校验图结构的合法性(如是否有入口、是否存在无效节点引用等),
将定义好的图结构转换为可执行的运行时对象
my_graph = graph.compile()
启动并执行工作流
参数:{"question": "这是问题?"} ------ 初始状态字典
作用:作为工作流的初始输入数据,会传递给入口节点作为输入状态
返回值:工作流执行完成后的最终完整状态字典,包含所有字段的最终值
result = my_graph.invoke({"question": "这是问题?"})
打印最终结果
print(result)