做汽车软件研发的团队,今年大概率都收到了主机厂类似的一条通知:新车型定点,供应商必须通过 ASPICE 3 级评估。
难点不在"能不能把事做完",而在 3 级往后要看"能不能把事做稳、做可重复"------评估机构会顺着追溯链一路追:这条需求是谁提的、谁设计的、哪条测试验证了它、变更时有没有留下证据。任何一段断链,整条链都可能被判不达标。
但现实里,很多团队还在用 5 份 Excel 维护"需求-设计-测试"追溯矩阵,每次评估前两周全员熬夜手工拼证据。车型并行 10 条以上需求线、基线变更频繁时,靠人工维护追溯矩阵的做法会先于评估崩掉。
这正是 高远Himee-ALM(基于飞书项目的应用生命周期管理方案) 要解决的问题:把 AI 智能体长进研发链路,让人做判断、让智能体做执行与核对。
一、为什么"再买个工具"解决不了
市面上多数 AI 工具是"外挂式"的:数据分散在多个系统,AI 结论需人工二次搬运,流程不感知 AI,结论游离在主链路之外。只有挂在统一研发数据底座上的智能体,才能串起需求、追溯、合规这条主链。
|------|-----------------------|---------------------|
| 对比维度 | 外挂式 AI | 内嵌式智能体(高远Himee-ALM) |
| 数据位置 | 数据分散在多系统,AI 结论需人工二次搬运 | 智能体直接读写统一底座数据 |
| 流程感知 | 流程不感知 AI,结论游离在主链路之外 | 结论回流到工作项、评审节点和追溯链路 |
| 协同方式 | 人把数据喂给 AI,再把结论抄回来 | 人和智能体在同一套流程上协同 |
| 能力边界 | 单点的效率工具 | 按岗位角色承担多步连续任务 |
高远Himee-ALM 建在飞书项目之上,由北京高远华信科技开发、依托飞书项目运行,不是飞书项目自带的标准功能。多智能体集群挂在这个底座上,按岗位角色承担多步连续任务,结论回流到工作项和追溯链路。
二、核心能力拆解(附调用范式)
下方代码为基于飞书项目开放平台 + Himee 智能体能力的示意调用范式,实际接口路径与鉴权以高远Himee-ALM 官方文档为准,切勿直接用于生产。
2.1 多格式需求导入与高精度解析
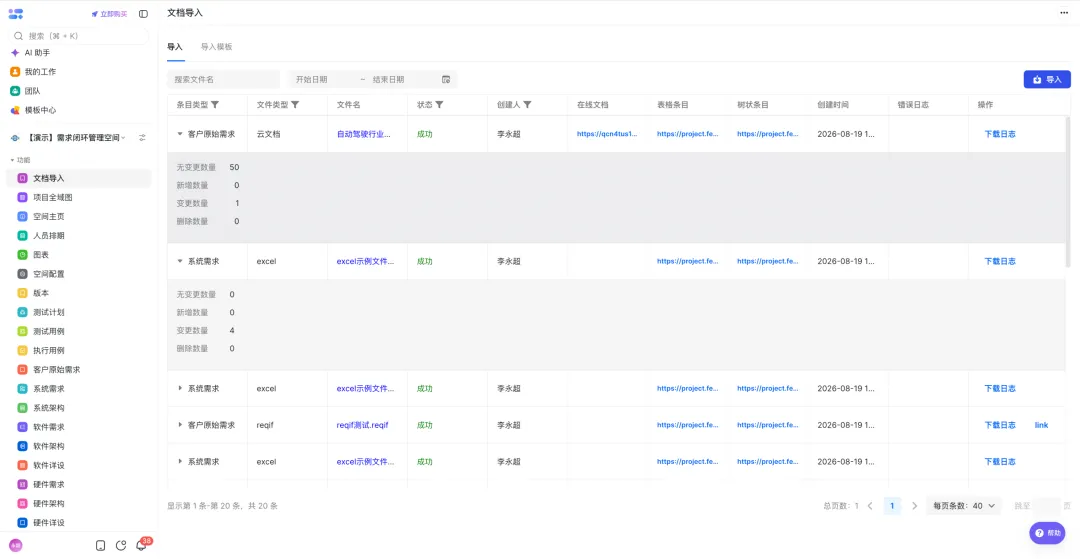 支持 PDF / Word / Excel / ReqIF / 飞书云文档一键导入,难点在还原原始大纲层级。6000 页、约 9000 条需求的文档,AI 解析约 3 小时、准确度约 96%,原本要需求工程师 2 个月手工拆解。
```python
# 需求文档高精度解析:导入 PDF 并触发 Himee 解析智能体
import requests

FEISHU_APP_ID = "your_app_id"
FEISHU_APP_SECRET = "your_app_secret"
HIEMEE_BASE = "https://api.example.com/himee/v1"  # 示例占位域名,实际以官方文档为准

def get_tenant_token(app_id, app_secret):
    r = requests.post(
        "https://open.feishu.cn/open-apis/auth/v3/tenant_access_token/internal",
        json={"app_id": app_id, "app_secret": app_secret},
    )
    return r.json()["tenant_access_token"]

def parse_requirement_doc(token, file_key, precision="high"):
    # 上传文档到飞书项目空间
    upload = requests.post(
        "https://open.feishu.cn/open-apis/drive/v1/files/upload_all",
        headers={"Authorization": f"Bearer {token}"},
        files={"file": open(file_key, "rb")},
    )
    file_token = upload.json()["data"]["file_token"]
    # 触发 Himee 解析智能体:还原大纲层级 + 自动切片
    resp = requests.post(
        f"{HIEMEE_BASE}/requirements/parse",
        headers={"Authorization": f"Bearer {token}"},
        json={"file_token": file_token, "precision": precision, "keep_outline": True},
    )
    # 返回:解析耗时、条目数、准确度
    return resp.json()
    # 示例返回: {"cost_min": 180, "item_count": 9000, "accuracy": 0.96}
```
2.2 双向追溯完整性检查(核心)
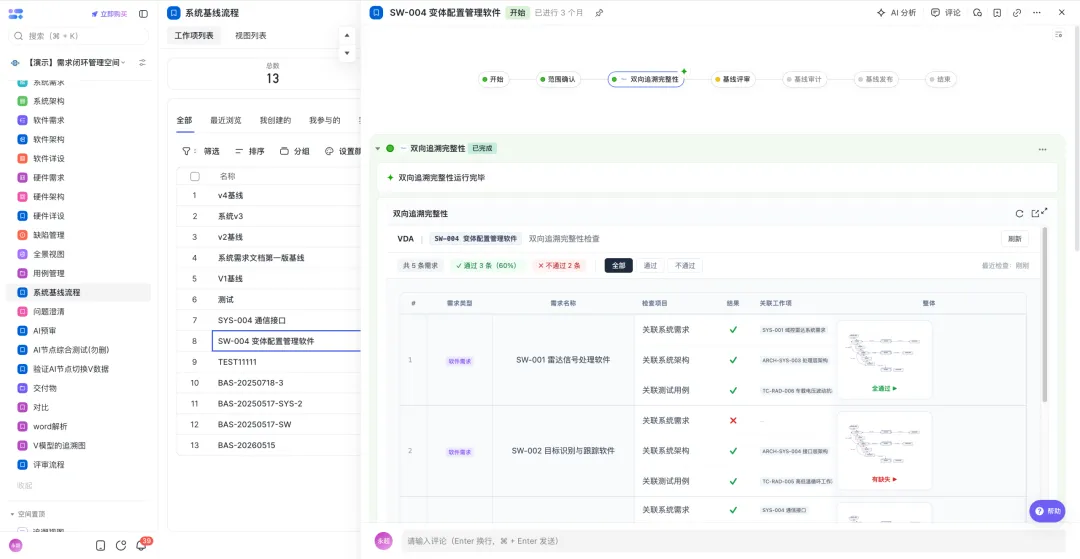 系统自动遍历当前条目的追溯是否完整,识别断链、错链、单向链与信息不一致,输出带责任对象的修复建议。原本 2-3 周人工核对,压到数分钟。
```sql
-- 追溯完整性检查:找出"需求存在但下游测试缺失"的断链
SELECT
    r.item_id      AS requirement_id,
    r.item_name    AS requirement_name,
    COUNT(t.item_id) AS downstream_test_count
FROM requirements r
LEFT JOIN trace_links tl ON tl.upstream_id = r.item_id
                        AND tl.link_type   = 'verify'
LEFT JOIN test_cases  t  ON t.item_id      = tl.downstream_id
WHERE r.project_id = 'PROJECT_X'
GROUP BY r.item_id, r.item_name
HAVING downstream_test_count = 0;   -- 断链:需求无任何验证用例
```
2.3 多层级追溯展示(V-Model)
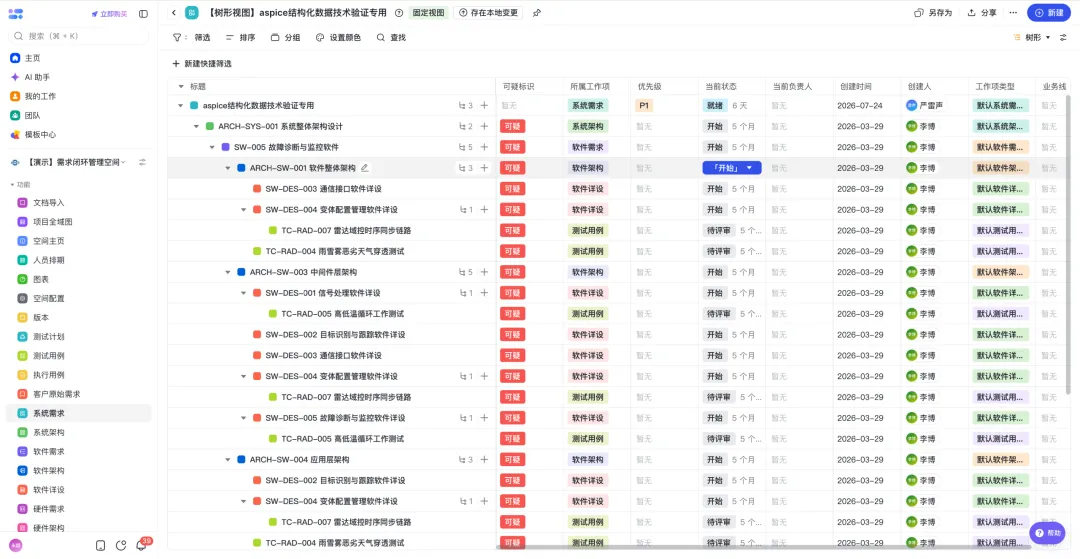 按 V 模型树形层级展示追溯关系,文档树支持筛选、排序、分组、搜索,并可切换表格、看板、甘特等显示方式。
```bash
# 获取某需求条目的上下游追溯图(V-Model 视图)
curl -X GET 'https://api.example.com/himee/v1/trace/graph?item_id=REQ-1024&view=vmodel' \
  -H 'Authorization: Bearer <tenant_token>' \
  -H 'Content-Type: application/json'
# 返回树形结构:上游干系人需求 -> 系统需求 -> 软件需求 -> 架构 -> 测试
```
2.4 版本与基线管理
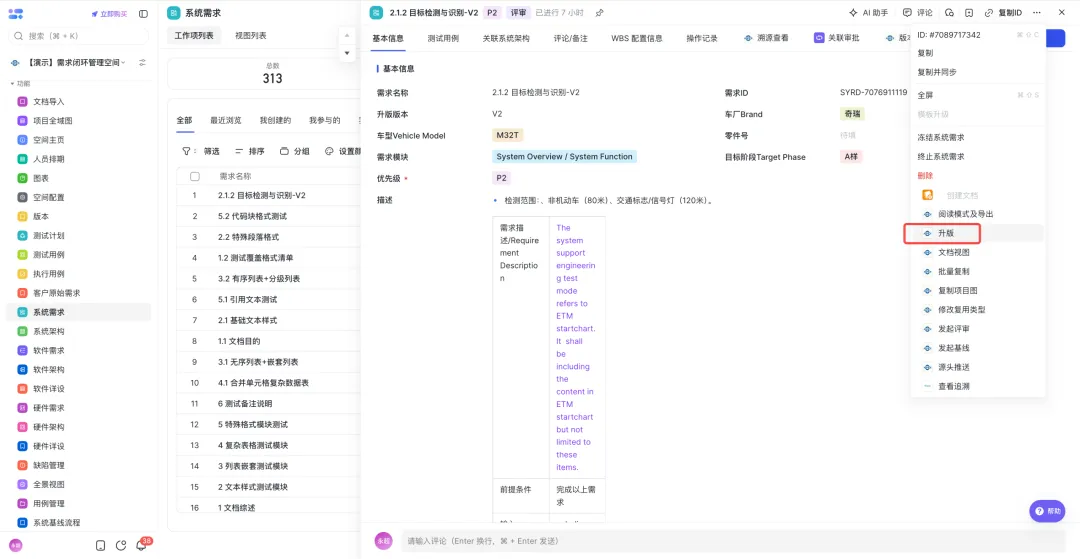 单条目 / 多条目升版、发布、版本对比;发起基线、基线升版替换、追加基线,并支持基线条目与字段级差异对比。
```python
# 发起基线并对比字段级差异
import requests

def create_baseline(token, project_id, items):
    resp = requests.post(
        "https://api.example.com/himee/v1/baselines",
        headers={"Authorization": f"Bearer {token}"},
        json={"project_id": project_id, "items": items, "name": "ASPICE_L3_Baseline_v1"},
    )
    baseline_id = resp.json()["baseline_id"]
    # 字段级差异对比
    diff = requests.get(
        f"https://api.example.com/himee/v1/baselines/{baseline_id}/diff",
        headers={"Authorization": f"Bearer {token}"},
        params={"compare_with": "previous"},
    )
    return diff.json()   # 返回条目级 + 字段级差异清单
```
2.5 批量复制与跨项目复用
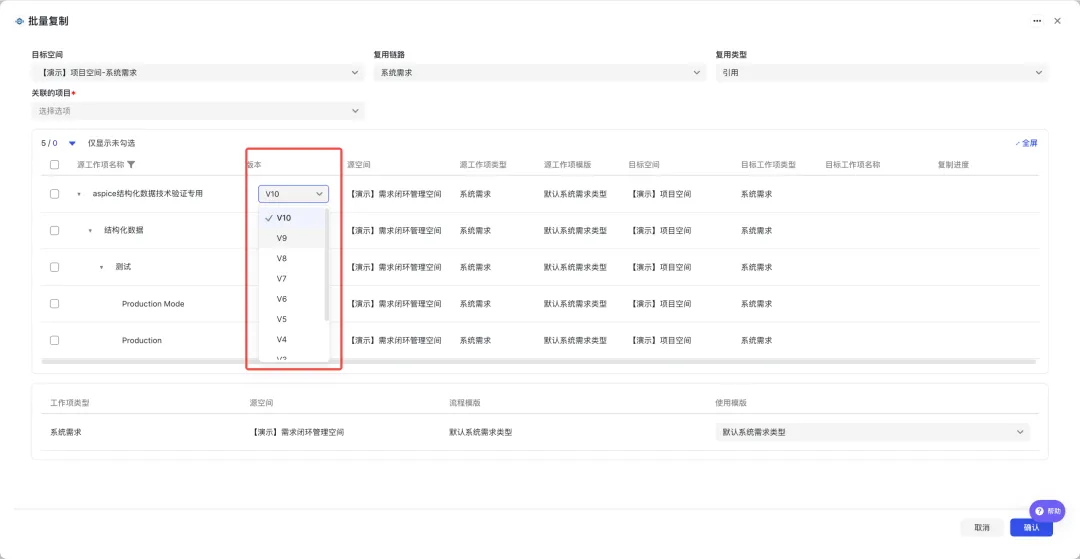 把某项目下的追溯链路批量复制或引用到另一个项目,可选历史版本,并配置工作项映射、字段匹配、状态匹配------即"一次建模、多项目复用"。
```bash
# 把项目 A 的追溯链路批量复制到项目 B(新车型承接已验证需求)
curl -X POST 'https://api.example.com/himee/v1/trace/copy' \
  -H 'Authorization: Bearer <tenant_token>' \
  -H 'Content-Type: application/json' \
  -d '{
        "source_project": "PROJECT_A",
        "target_project": "PROJECT_B",
        "mode": "reference",
        "field_mapping": {"req_status": "status", "owner": "assignee"}
      }'
# 返回:复制链路数、映射失败条目、需人工确认清单
```
2.6 可疑链路查询
系统对异常追溯关系(如循环引用、孤立节点)输出可疑链路,供审核员重点核查。
```json
{
  "suspect_links": [
    {
      "type": "cycle",
      "nodes": ["REQ-1024", "DES-077", "REQ-1024"],
      "reason": "需求与下游设计形成循环引用"
    },
    {
      "type": "orphan",
      "node": "TEST-331",
      "reason": "测试用例无任何上游需求关联"
    }
  ]
}
```
三、八大能力全景
高远Himee-ALM 覆盖从需求进入到追溯合规的完整链路,八个模块串成"需求导入---结构化编辑---多层级追溯---完整性检查---版本基线---评审复用"一条不断链的主轴。
|------------------|------------------|----------------------------------------|
| 能力模块 | 解决的核心痛点 | 量化收益 |
| 多格式需求导入与高精度解析 | 几千页 PDF 还原大纲层级难 | 6000 页/9000 条,约 3 小时、准确度 96%(原 2 个月手工) |
| 文档视图与在线编辑 | 需求散落多系统、编辑追溯分离 | 编辑与追溯同一界面完成 |
| 多层级追溯展示(V-Model) | 跨工具追溯不可视 | 树形/表格/看板/甘特多视图切换 |
| 追溯图链路与上下游查看 | 单条需求追溯关系不透明 | 任意条目上下游一键可视化 |
| 双向追溯完整性检查 | 人工核对遗漏率高、评估前临时拼凑 | 2-3 周 → 数分钟 |
| 版本与基线管理 | 变更无迹可循 | 条目级 + 字段级差异对比 |
| 评审管理与自动关联 | 线上线下追溯两张网 | 客户线下追溯导入后自动关联 |
| 批量复制与跨项目复用 | 同功能多车型反复建项 | 一次建模、多项目复用 |
四、企业三本账
- 研发周期更短:需求解析从 2 个月压到数小时,双向追溯检查从数周压到数分钟,跨项目批量复制让已验证链路一次建模、多处复用,事务性搬运大幅减少。
- 合规举证更省:ASPICE、ISO 26262、ISO 21434 的证据不再临时拼凑,审核一键出报告,2-3 天压到数小时。
- 车型资产更厚:需求库、追溯矩阵、基线版本在底座内持续沉淀,下一代车型可直接复用上一代已验证的条目与链路。
五、落地节奏
方案建在飞书项目之上,已在用飞书项目的团队不用换平台,从一条车型研发线切入即可。典型部署 4-6 周:前两周梳理主链路与标准条款、做配置化;中间接入需求解析与双向追溯检查跑通一条真实项目;后段再把版本基线、评审与批量复制接进来。
已在用 Polarion 或 Jira 的团队,通常先做双轨并行,把追溯与合规检查能力先接进去验证效果,再考虑逐步迁移。
一个常被验证的提醒:流程没理顺之前别急着上智能体。先上工具再补流程,结果只是把混乱自动化了一遍。高远Himee-ALM 坚持"流程先行",正是为了避开这个坑。
常见问题
Q1:Himee-ALM 和正在用的飞书项目是什么关系?
它就装在飞书项目里。飞书项目负责需求、缺陷、项目的基础管理,Himee-ALM 在上面加了一层,把汽车软件研发的合规要求、追溯关系和 AI 能力接进来,不是飞书项目自带的标准功能。
Q2:数分钟出追溯检查、数小时出合规报告的数字真实吗?
是客户项目里的实测结果,不是 demo 数据。具体客户名称与规模因保密约定不披露。
Q3:已经在用 Polarion 或 Jira 的团队能直接用吗?
Himee-ALM 依托飞书项目运行,最适合已在用飞书项目、需要补齐合规与追溯能力的团队;已有重资产投入的,通常先做双轨并行、逐步迁移。
Q4:AI 给的审核结论能直接用于 ASPICE 评估吗?
AI 逐条查证据并给结论、每条附依据,但最终判定与签字仍由审核员完成。定位是把核对做完,把判断权留给人。
Q5:智能体和插件、工作项复制有什么区别?
插件和工作项是"工具",承担某一项功能;AI 智能体是"数字化员工",能按岗位角色承担多步连续任务------从检索、拆解、对比、校验到回流工作项。
如果你也在做 ASPICE 合规、追溯矩阵或需求解析,想看更贴合你项目规模的配置样例,可以在评论区留言 Himee,我把对应版本的调用与配置清单整理发你。
关键词:高远Himee-ALM、ASPICE、汽车软件研发、应用生命周期管理、需求双向追溯、ISO 26262、智能体、飞书项目、研发效能、高远科技