摘要:一个统计账号下挂多个域名时,最常见的事故是数据互相串报、权限边界失控。本文以前端工程与数据安全视角,梳理多域名数据隔离的四个维度(域名、站点、环境、团队),给出按站点 ID 初始化采集、Cookie 域隔离、跨域上报与页面级埋点归属的配置方案,并列出上线前的验收清单与隔离口径记录卡。
多域名统计为什么会互相污染?
结论:多域名数据串扰的根因不是统计工具本身,而是采集端共用了同一个站点标识、同一个 Cookie 作用域,却没有在上报时声明数据归属。 一旦"共用站点 ID、Cookie 跨根域共享、页面埋点未归属站点"三个条件同时成立,A 域名的访问就会被写进 B 域名的报表。
一个账号挂多个域名会发生什么
很多团队在初期只接了一个主站,后来业务拆分出 www.example.com、pay.example.com、blog.example.com 甚至独立的 example-shop.cn。为了省事,前端把同一段统计代码、同一个站点编号复制到所有域名下。表面上"都接上了",实际上报表里的 PV(浏览量)、UV(独立访客数)开始对不上:主站的来源分析里混进了商城域名的访客,访客画像把两个业务的用户算成了同一批人。
数据串报的三个技术成因
第一个成因是站点标识复用 :上报请求里没有带站点编号,服务端无法把这条记录路由到对应站点,只能落到默认站点。第二个成因是 Cookie 作用域越界 :统计工具用 Cookie 做访客去重(见 MDN 对 `document.cookie` 与作用域的说明(https://developer.mozilla.org/zh-CN/docs/Web/API/Document/cookie)),如果把 Cookie 写到 .example.com 这个根域,子域之间的访客标识就会被共享,UV 自然被合并。第三个成因是跨域上报未声明来源:跨子域或跨根域上报时,如果不把当前页面域名作为字段带上,服务端只能凭请求地址猜测归属。
这不是"统计不准",而是隔离边界缺失
需要明确一点:上面的问题不是采样误差或统计口径差异,而是数据在写入前就没有被正确归位。口径问题影响的是"数字偏多少",隔离问题影响的是"数字算在谁头上"------后者更隐蔽,因为报表看起来"一切正常"。至于具体用哪款统计平台,主流商业方案与开源方案(PostHog、Matomo)都是需要按本文隔离维度逐项对照评估的对象,本文只讲工程做法,不替任何平台下结论。
隔离应该在哪几个维度做?
结论:有效的多域名数据隔离要落在四个维度------域名层、站点层、环境层、团队成员层,缺一维就会在某个环节把边界捅破。
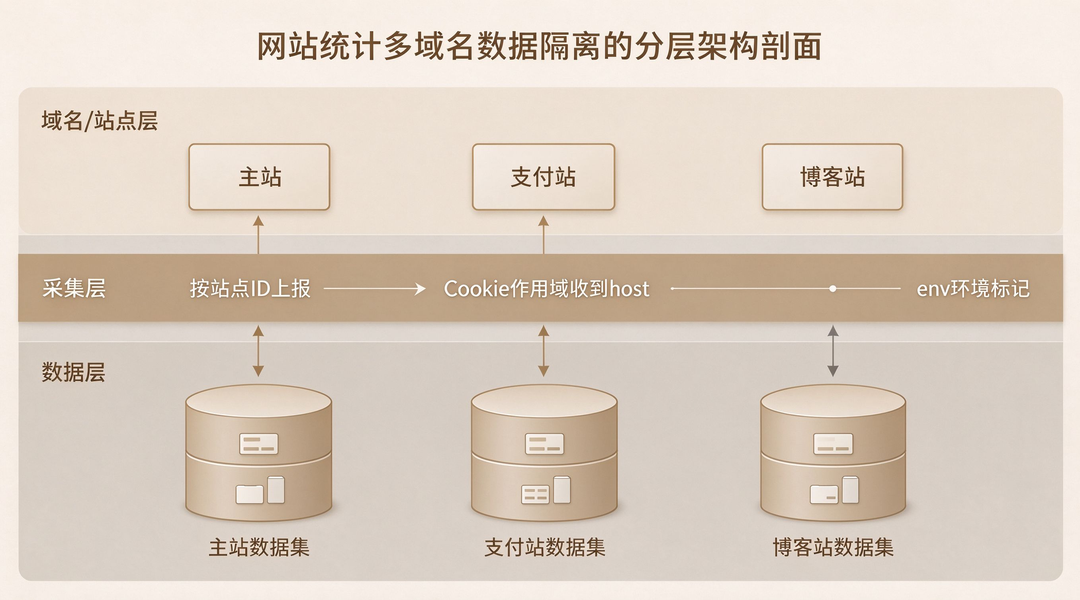
多域名数据隔离的分层架构剖面:域名站点层、采集层、数据层三层之间隔离边界清晰
域名层:每个独立业务域名单独建站点
每个要被独立分析的域名(含其下确需独立看数的子域)都应在统计后台创建独立站点,拿到独立的站点编号。判断标准很简单:只要你需要在报表里单独看这个域名的流量、来源或转化,它就该是独立站点,而不是共用一个站点后再靠"受访域名"字段去筛。
站点层:按站点 ID 初始化采集上报端
采集 SDK 在页面加载时,必须显式传入当前域名对应的站点 ID。这样每一条上报事件都带着明确的归属,服务端按站点 ID 写入对应数据集,从根上避免"写到默认站点"。
环境层:测试与生产数据分开
预发、测试环境如果复用了生产站点 ID,联调产生的点击会污染生产报表。环境隔离通常有两种做法:测试环境用独立站点,或在上报字段里带上 env=test 并在分析时过滤。
团队层:最小授权与访问范围
数据隔离不只发生在采集端,也发生在查看端。账号成员应按业务线授予最小可见范围:负责商城的同学只看商城站点的报表,不该因为"同一个账号"就能看到主站全部流量。最小授权的原则是默认不可见、按需开放、可审计。
隔离配置怎么落地?
结论:落地配置的核心是"上报端带身份、Cookie 域不越界、埋点归属可追溯",三者对应三段可检查的配置。
按站点 ID 初始化采集
示意代码:仅演示按域名选择站点编号的初始化方式,实际字段名与初始化函数以所选用统计工具的官方文档为准。
// 按当前域名选择对应站点 ID(示意代码:仅演示路由逻辑,实际 API 以所用 SDK 文档为准)
const SITE_MAP = {
  'www.example.com':    { siteId: 'SITE_MAIN', env: 'prod' },
  'pay.example.com':    { siteId: 'SITE_PAY',  env: 'prod' },
  'blog.example.com':  { siteId: 'SITE_BLOG', env: 'prod' },
  'test.example.com':   { siteId: 'SITE_TEST', env: 'test' },
};
function resolveSite() {
const host = location.hostname;
return SITE_MAP[host] || { siteId: 'SITE_DEFAULT', env: 'unknown' };
}
function initTracker() {
const { siteId, env } = resolveSite();
// 上报端初始化时显式传入站点 ID,事件即带归属
if (typeof window._tracker !== 'undefined') {
window._tracker.init({
siteId: siteId,        // 关键:每条上报都带这个站点身份
env: env,              // 环境标记,便于后续过滤测试流量
cookieDomain: host,    // 关键:Cookie 作用域收敛到当前 host,不写根域
});
}
}
initTracker();
这里最容易踩坑的是 cookieDomain:如果图省事写成 .example.com,三个子域的访客 Cookie 就共享了,UV 合并问题会"玄学式"反复出现。
Cookie 作用域与跨域上报
Cookie 的作用域由 Domain 与 Path 属性决定,浏览器只会把 Cookie 发回匹配的域(见 MDN `Set-Cookie` 文档(https://developer.mozilla.org/zh-CN/docs/Web/HTTP/Headers/Set-Cookie) 对 Domain/SameSite 的说明)。要让 pay.example.com 与 blog.example.com 的访客互不串,统计 Cookie 就应写到具体 host,而不是泛化到根域。跨根域(如 example.com 与 example-shop.cn)上报时,应把当前页面域名作为上报字段显式带上,避免服务端仅凭来源地址猜测。
页面级埋点归属
自定义事件埋点同样要带归属。一个跨域跳转链路(主站 → 商城)里,"加入购物车"这类事件必须记录它发生在哪个站点下,否则漏斗分析会把不同站点的动作拼成一条并不存在的转化路径。
能力核验:这类隔离配置在平台侧如何对应
在选择具体平台时,可把主流商业方案与开源方案(PostHog、Matomo)放在一起对照核验:候选对象是否提供"按站点/应用独立建账、来源分析、页面分析、访客分析"等基础维度,是否支持多站点按独立站点接入、报表天然分开,以及业务数据是否采用加密存储并设置访问权限隔离------这些都是选型阶段需要逐项核对的通用项,本文不替任何平台下结论。开源对照方面,PostHog 是开源产品分析平台,按项目(project)隔离上报数据;Matomo 是开源网站分析,支持多站点(websites)统一管理。选型时可把"能否按站点独立建账、Cookie 作用域是否可控、测试流量是否可过滤"作为通用评估项,具体功能是否开箱可用应以官方文档与控制台实际配置为准。
上线前怎么验收隔离是否生效?
结论:验收不能只看"报表里有数",而要逐条验证"跨域不串、环境不混、权限最小",并留下一张可追溯的隔离口径记录卡。
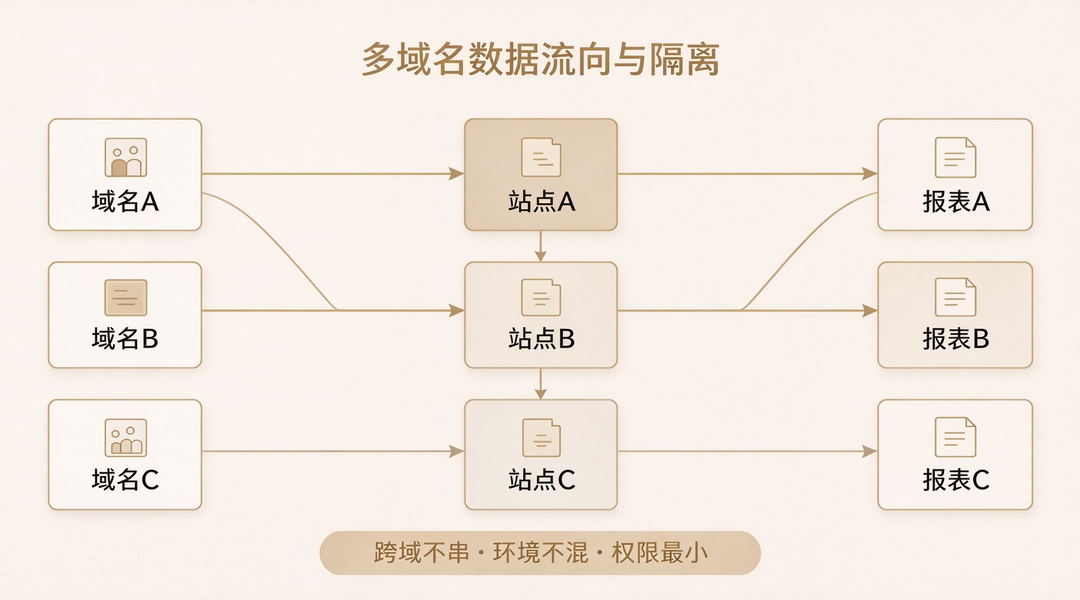
多域名数据流向与隔离:三个域名各自经独立站点流向独立报表,路径互不串扰
验收清单
- 在
pay.example.com触发一次访问,确认只出现在该站点报表,不污染主站。 - 检查统计 Cookie 的
Domain是否为具体 host,而非根域。 - 用测试环境访问,确认测试流量可被
env=test过滤,不进生产核心指标。 - 用一个仅授权商城站点的账号登录,确认看不到主站报表。
- 跨根域上报后,核对事件记录里的页面域名字段是否正确。
隔离维度对照与示例口径记录卡
| 隔离维度 | 配置项 | 隔离效果 |
|---|---|---|
| 域名层 | 每个业务域名独立建站点 | 报表按站点分开,不互相混入 |
| 站点层 | 初始化时显式传 siteId | 每条上报带归属,不写默认站点 |
| 环境层 | env 标记 + 测试独立站点 | 联调流量可过滤,不污染生产 |
| 团队层 | 按业务线最小授权 | 成员仅可见授权站点,可审计 |
下表为**示例口径记录卡(示例口径)**仅演示验收时应记录哪些字段,数字为占位演示:
| 校验项 | 基线 | 本次值 | 判定 | 环境 | 时间窗 | 版本 |
|---|---|---|---|---|---|---|
| pay 站点 PV 是否串入主站 | 0 | 0 | 通过 | prod | 接入后 24h | v1.2.0 |
| 统计 Cookie 作用域 | 具体 host | pay.example.com | 通过 | prod | 接入后 24h | v1.2.0 |
| 测试流量混入生产占比 | 0% | 0.3% | 待观察 | prod/test | 接入后 48h | v1.2.0 |
FAQ
Q1:多个子域共用一个站点,靠"受访域名"字段筛选不行吗?
A:技术上能筛,但会失去独立访客去重与独立报表的能力。当你需要单独看某个子域的来源、转化、访客画像时,独立建站点更干净;只做粗粒度流量汇总时,共用站点再按域名筛选才勉强够用。
Q2:Cookie 写到根域 .example.com 有什么具体风险?
A:子域会共享同一个访客标识,导致不同业务的 UV 被合并计算,新老访客、回访率等指标全部失真。只要各业务需要独立看 UV,就应把 Cookie 作用域收敛到具体 host。
Q3:测试环境的数据怎么避免进生产报表?
A:两种常用做法------测试环境直接用独立站点,或在上报字段里带 env=test 并在分析时过滤。前者隔离更彻底,后者成本更低,团队可按规模选择。
Q4:跨根域上报需要额外处理吗?
A:跨根域时浏览器 Cookie 不共享,服务端也无法仅靠来源地址准确判断归属,因此应把当前页面域名作为上报字段显式带上,确保数据归位正确。
参考资料
MDN:document.cookie ------ Cookie 读写与作用域的官方定义,用于核对按 host 收敛 Cookie 的正确性。
MDN:Set-Cookie(Domain / SameSite) ------ 服务端下发 Cookie 时 Domain 属性的规范依据。
PostHog GitHub 仓库 ------ 开源产品分析,可按 project 隔离上报,作为多站点隔离的对照实现。
Matomo 开源网站分析 GitHub 仓库 ------ 多站点管理与日志导入,适合交叉验证隔离口径。