先问一个做文档解析的同行都会遇到的问题:你的解析模型用强化学习(RL)做后训练,反馈信号是什么?
大概率是一个页面级总分。模型对着一张整页图片生成一篇 Markdown------正文、LaTeX 公式、HTML 表格混排------评测器对照标注答案打一个 0 到 100 的分,GRPO 这类组相对优化算法(Group Relative Policy Optimization,采样一组答案后按组内排名算优劣)拿着这个分数去更新参数。听起来顺理成章。
但 Qwen 团队在 arXiv 2610.21979 里指出了这笔账的漏洞:总分是笔糊涂账。两份总分几乎一样的解析结果,一份公式抄对了却漏掉一张表格,另一份补全了表格却把公式毁了------在页面级分数里,这两个错误互相抵消,模型收到的反馈是「俩都还行」。该往哪个方向学?没人告诉它。
💡 一句话总结:P2TPO(Page-to-Token Policy Optimization)把整页解析的 RL 反馈从「一页一个平均分」改成「按文档结构记账」:先对齐参考元素逐块比较采样结果,用 UAP 把「整块缺失」和「全员同样不完美」变成明确的负反馈,再用 SCR 在块内把功过挪到对与错的 token 头上。六个基准 13 个评测集全部超过 GRPO/GSPO/GDPO/RDPO,OmniDocBench 上比最强基线高 0.74 分,元素漏检率从 1.09% 压到 0.95%。
📄 论文 :P2TPO: Structure-Aligned Page-to-Token Credit Assignment for Full-Page Document Parsing(arXiv 2610.21979)
糊涂账是怎么记亏的
论文开篇给了一组很扎心的示意。同一个页面采样四份输出,页面得分 0.85、0.85、0.84、0.85------几乎无法区分;但逐块看完全是两个故事:R2 的表格整块缺失、R4 的正文块缺失,各自的公式块也各有对错(数字为示意,非实测)。正文里的例子更直白:一份解析公式抄对了却漏掉一张表格,另一份补全了表格却把公式毁了。GRPO 的做法是给每份输出里的所有 token 发同一个优势系数(advantage,衡量「这次采样比平均水平好多少」的信号),于是正确公式和缺失表格拿到同样的分数,掩盖也就在所难免。
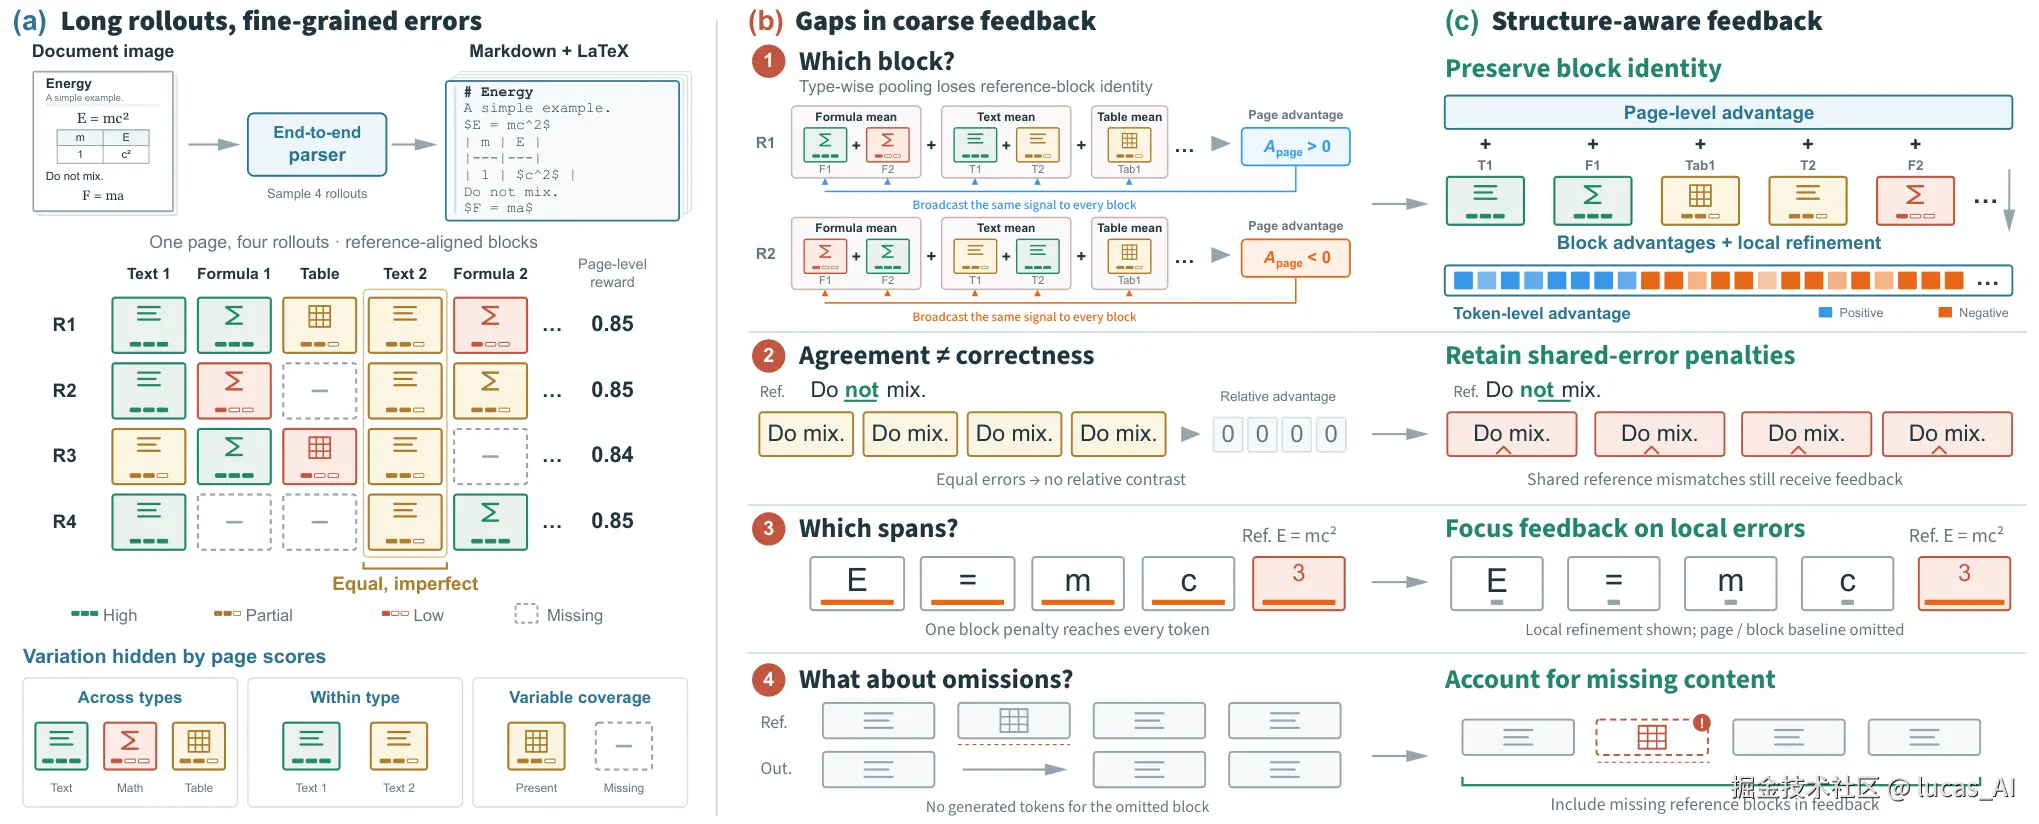
拆开看,这笔糊涂账有三个层次的问题,论文的表述非常工整:
- 身份丢失:页面级聚合把「第 3 张表」和「第 5 张表」混成一锅粥,同类型的不同元素之间的质量差异被直接抹掉;
- 比较不完备:整块漏掉的元素没有生成内容,没地方挂反馈;更隐蔽的是,如果 8 份采样全都把某个元素做得一样烂,「组内中心化」(按组内均值扣减)会让它的信号恰好为零------明明全员都不及格,反馈却是「无可奉告」;
- 位置不精确:就算知道某个块比平均好,块内是哪几句错了、哪几句对了,粗粒度反馈也分不出来。
三个问题递进:先得知道「谁和谁比」,再保证「比得全」,最后落实「差在哪」。P2TPO 的整个设计就是对着这三条来的。
🛠️ 思路:按文档结构重记一本账
P2TPO 不动生成方式,也不动页面级反馈的「大盘」,只在「每个 token 拿到多少学习信号」这个环节做文章。整条流水线分三步,环环对应上面三个问题。
第一步:参考元素对齐(P2BPO 底座)。 把模型的预测和标注参考都解析成有序的文本、公式、表格块,用内容级序列对齐把它们配对------允许插入和删除,但保持阅读顺序。配好对之后,每个参考元素在自己的「匹配组」内独立归一化打分:这个元素在你的 8 份采样里,谁做得好、谁做得差,分开记账。这样同类型的第 3 张表和第 5 张表身份不同,前面的元素被漏掉也不会让后面的错位。
第二步:UAP 补全两组无信号情形。 Unified Anchor Pricing(统一锚定定价)把每个参考元素的比较结果补全:匹配到的拿块分数,缺失的记 0 分,一起进组内比较。而对于组内离散度可忽略(8 份输出的分数几乎相同)的情形,它不再做中心化,而是改成对着满分天花板计价:给全班发一个 -λ × (满分 − 平均分) 的负系数------全员同样不完美的平局和整块缺失的组,都拿到明确指出「离满分还差多少」的负反馈,满分类平局则为零。
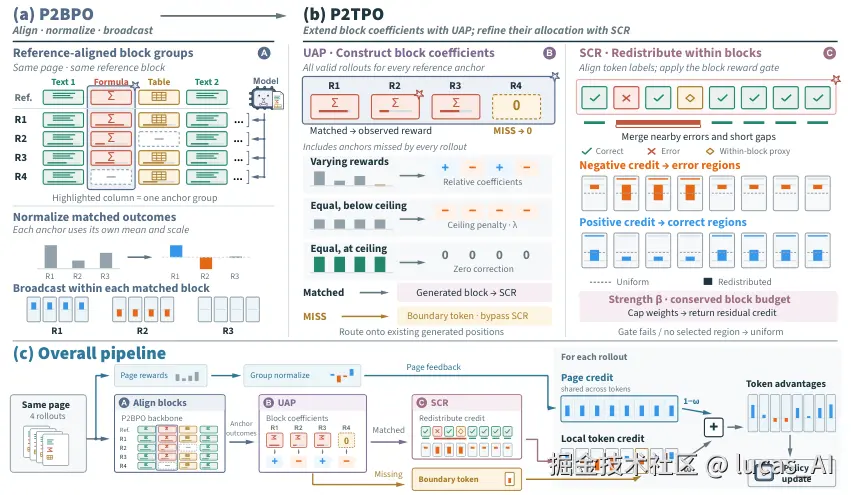
第三步:SCR 把功过挪到对的位置。 Span Credit Redistribution(片段信用重分配)处理最后一步:对一个「整体分数高但有小伤」的匹配块(默认文本、公式、表格块的准入门槛都是 0.8 分),用编辑对齐生成掩码------插入和替换的位置标为错误,被漏掉的参考内容就近映射到生成位置------然后把块级系数按掩码重新分配:负系数集中砸向错误 token,正系数集中给到正确 token。关键约束是预算守恒:重排前后,这个块发出学习信号的总账不变,符号也不变,只是「怎么分」变了。缺失整块的反馈则绕过 SCR,由边界路由直接挂到已生成的边界 token 上。
最后,局部信号和原来的页面级信号按权重合成(默认局部占 ω=0.2),每个 token 拿到自己那份「总账 + 明细账」,进常规的裁剪策略更新。生成时的整页自回归上下文一概不动。
这里值得停下来自问一句:把反馈算得这么细,会不会只是在梯度里掺了更花哨的噪声?论文用一组漂亮的消融正面回答了这个问题,见下一节。
📈 效果:全胜,但要拆开看赢在哪儿
实验设置先交代清楚:Qwen3.5-2B 模型,700K 页数据做监督微调(SFT)打底,然后各方法共享检查点、共享 100 次更新的 RL 预算(每次 128 个页面提示、每提示采样 8 份),五个随机种子报均值和标准差。对比对象是 GRPO、GSPO、GDPO、RDPO 四个「整条输出一个系数」的方法,评测覆盖六个基准 13 个评测集------从数字原生文档、扫描件到真实拍摄照片都有。
主结果一句话:13 个评测集,P2TPO 全部超过四个基线里的最强者。 OmniDocBench v1.6 从 RL 前的 92.17 涨到 93.12±0.23,比最强基线 GSPO 高 0.74 分;外部 12 个评测集的优势从 +0.19(DocPTBench Dewarp)到 +1.56(FinixDocBench)不等,其中 PureDocBench 的真实拍摄场景 +1.44、数字原生 +1.14。整体量级不大------底子越好,最后一公里越贵------但「无一落后」这个全胜格局本身比单点数字更有说服力。
更有信息量的是归因拆解。增益的大头来自「按参考元素比较」这个底座本身:只加 P2BPO、不加另外两个组件,就已经在 13 个评测集里的 12 个上超过最强基线(PureDocBench Clean +0.72、FinixDocBench +0.67)。这说明「总分抹平块间对比」确实是主要矛盾。
SCR 与 UAP 是共生关系,这个发现很点睛 :有 UAP 时加 SCR,11 个评测集提升;没有 UAP 时加 SCR,只有 2 个。直觉是------SCR 负责把钱发到对的位置,但前提是 UAP 先把每笔钱算对、算全。反馈没校准之前就精细选址,等于在糊涂账上做精细会计。反过来的「选址消融」更硬核:保持每块系数值和选中 token 数完全不变、只把位置随机打乱,性能立刻掉下去------对齐选址 12 个评测集胜过随机放置。收益来自「放对位置」,而不是「加了非均匀权重」这种廉价的解释。
落到解析质量本身(OmniDocBench 分项):公式 CDM 从 0.9340 升到 0.9446,表格 TEDS 从 0.8765 升到 0.8833,阅读顺序编辑距离从 0.0475 降到 0.0423;最值得关注的是漏检------整元素漏检率从 1.09% 降到 0.95%,块内漏字率从 6.72% 降到 5.53%。漏检正是 UAP 那条「天花板计价」负反馈的直接靶区。
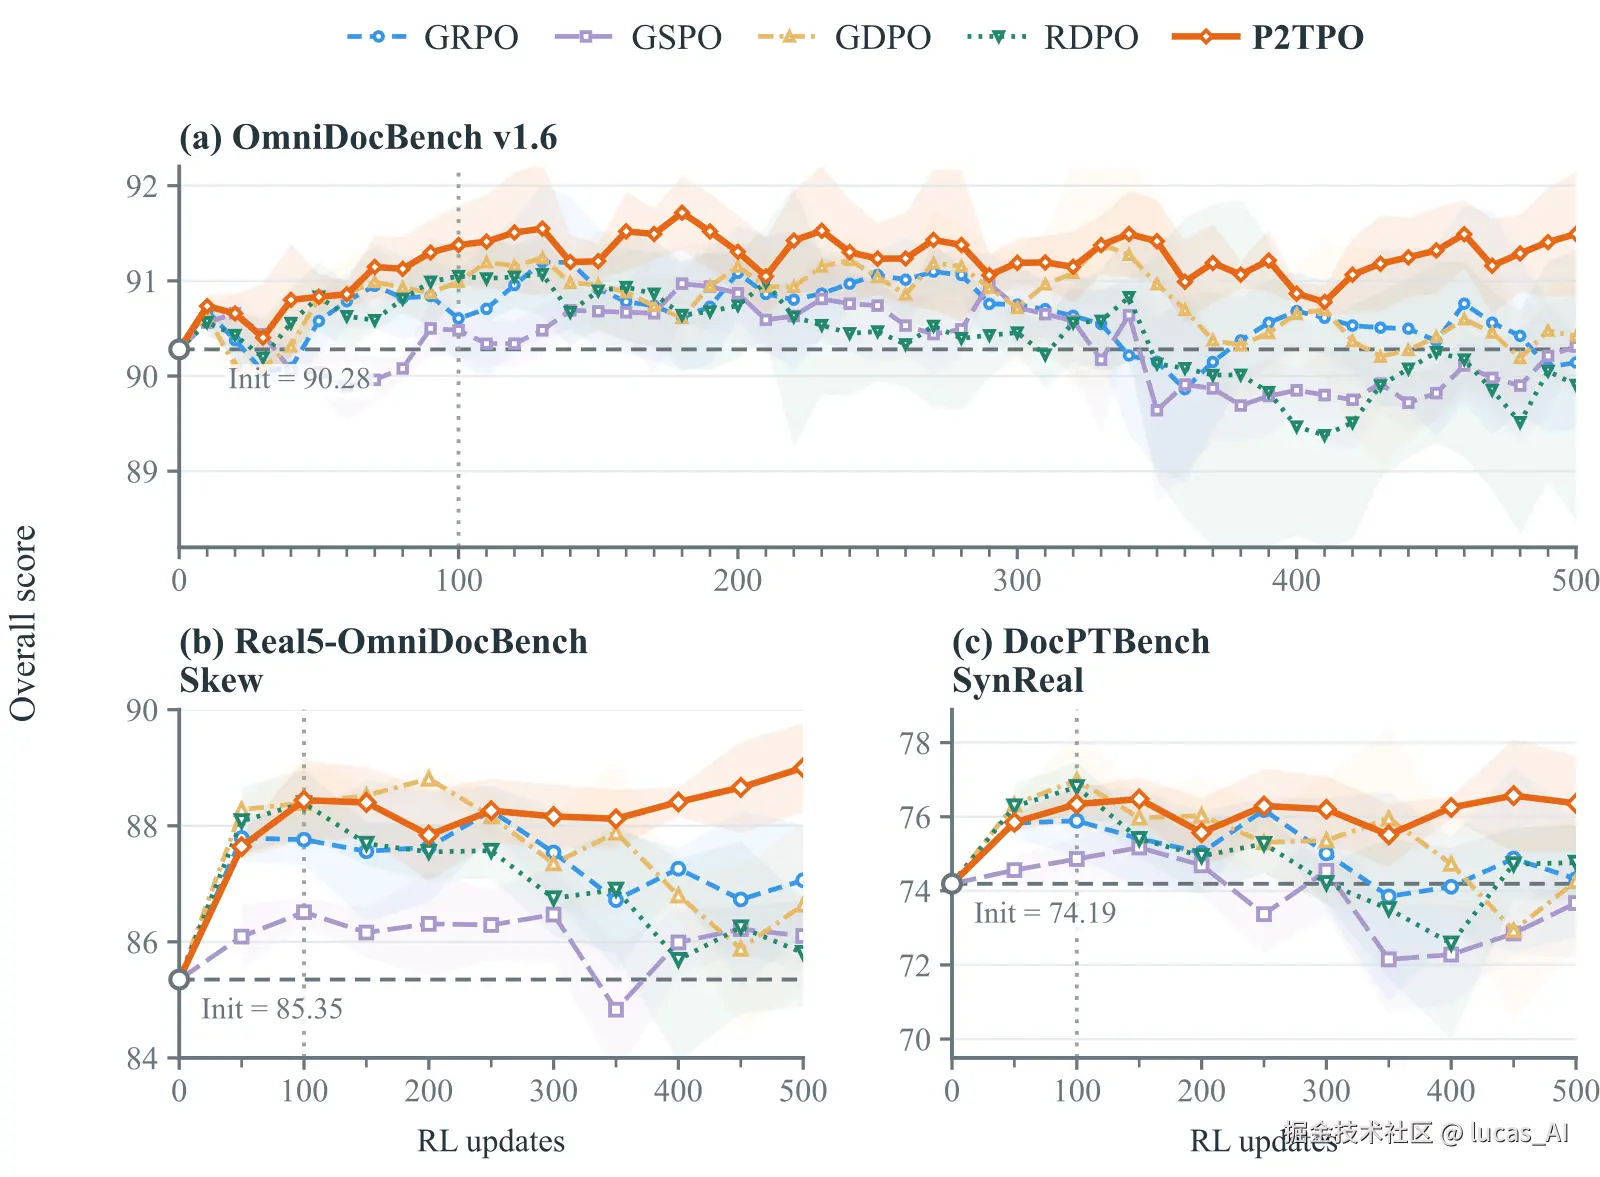
长跑和泛化两条腿也都站住了。 500 次更新的延长训练里,P2TPO 在全部 13 个评测集保持均值第一,对最强基线的优势最宽拉到 +1.94(Real5 倾斜场景)------收益随训练变厚,不是早期红利。换初始化(50K 页 SFT)、换规模(Qwen3.5-4B)、换骨干(Qwen3-VL-2B-Instruct)三种设置下,39 组对比里 37 组均值最高。超参数也皮实:λ、β、ω 三个旋钮单因素扫一遍,任何评测集的波动不超过 1.1 分。
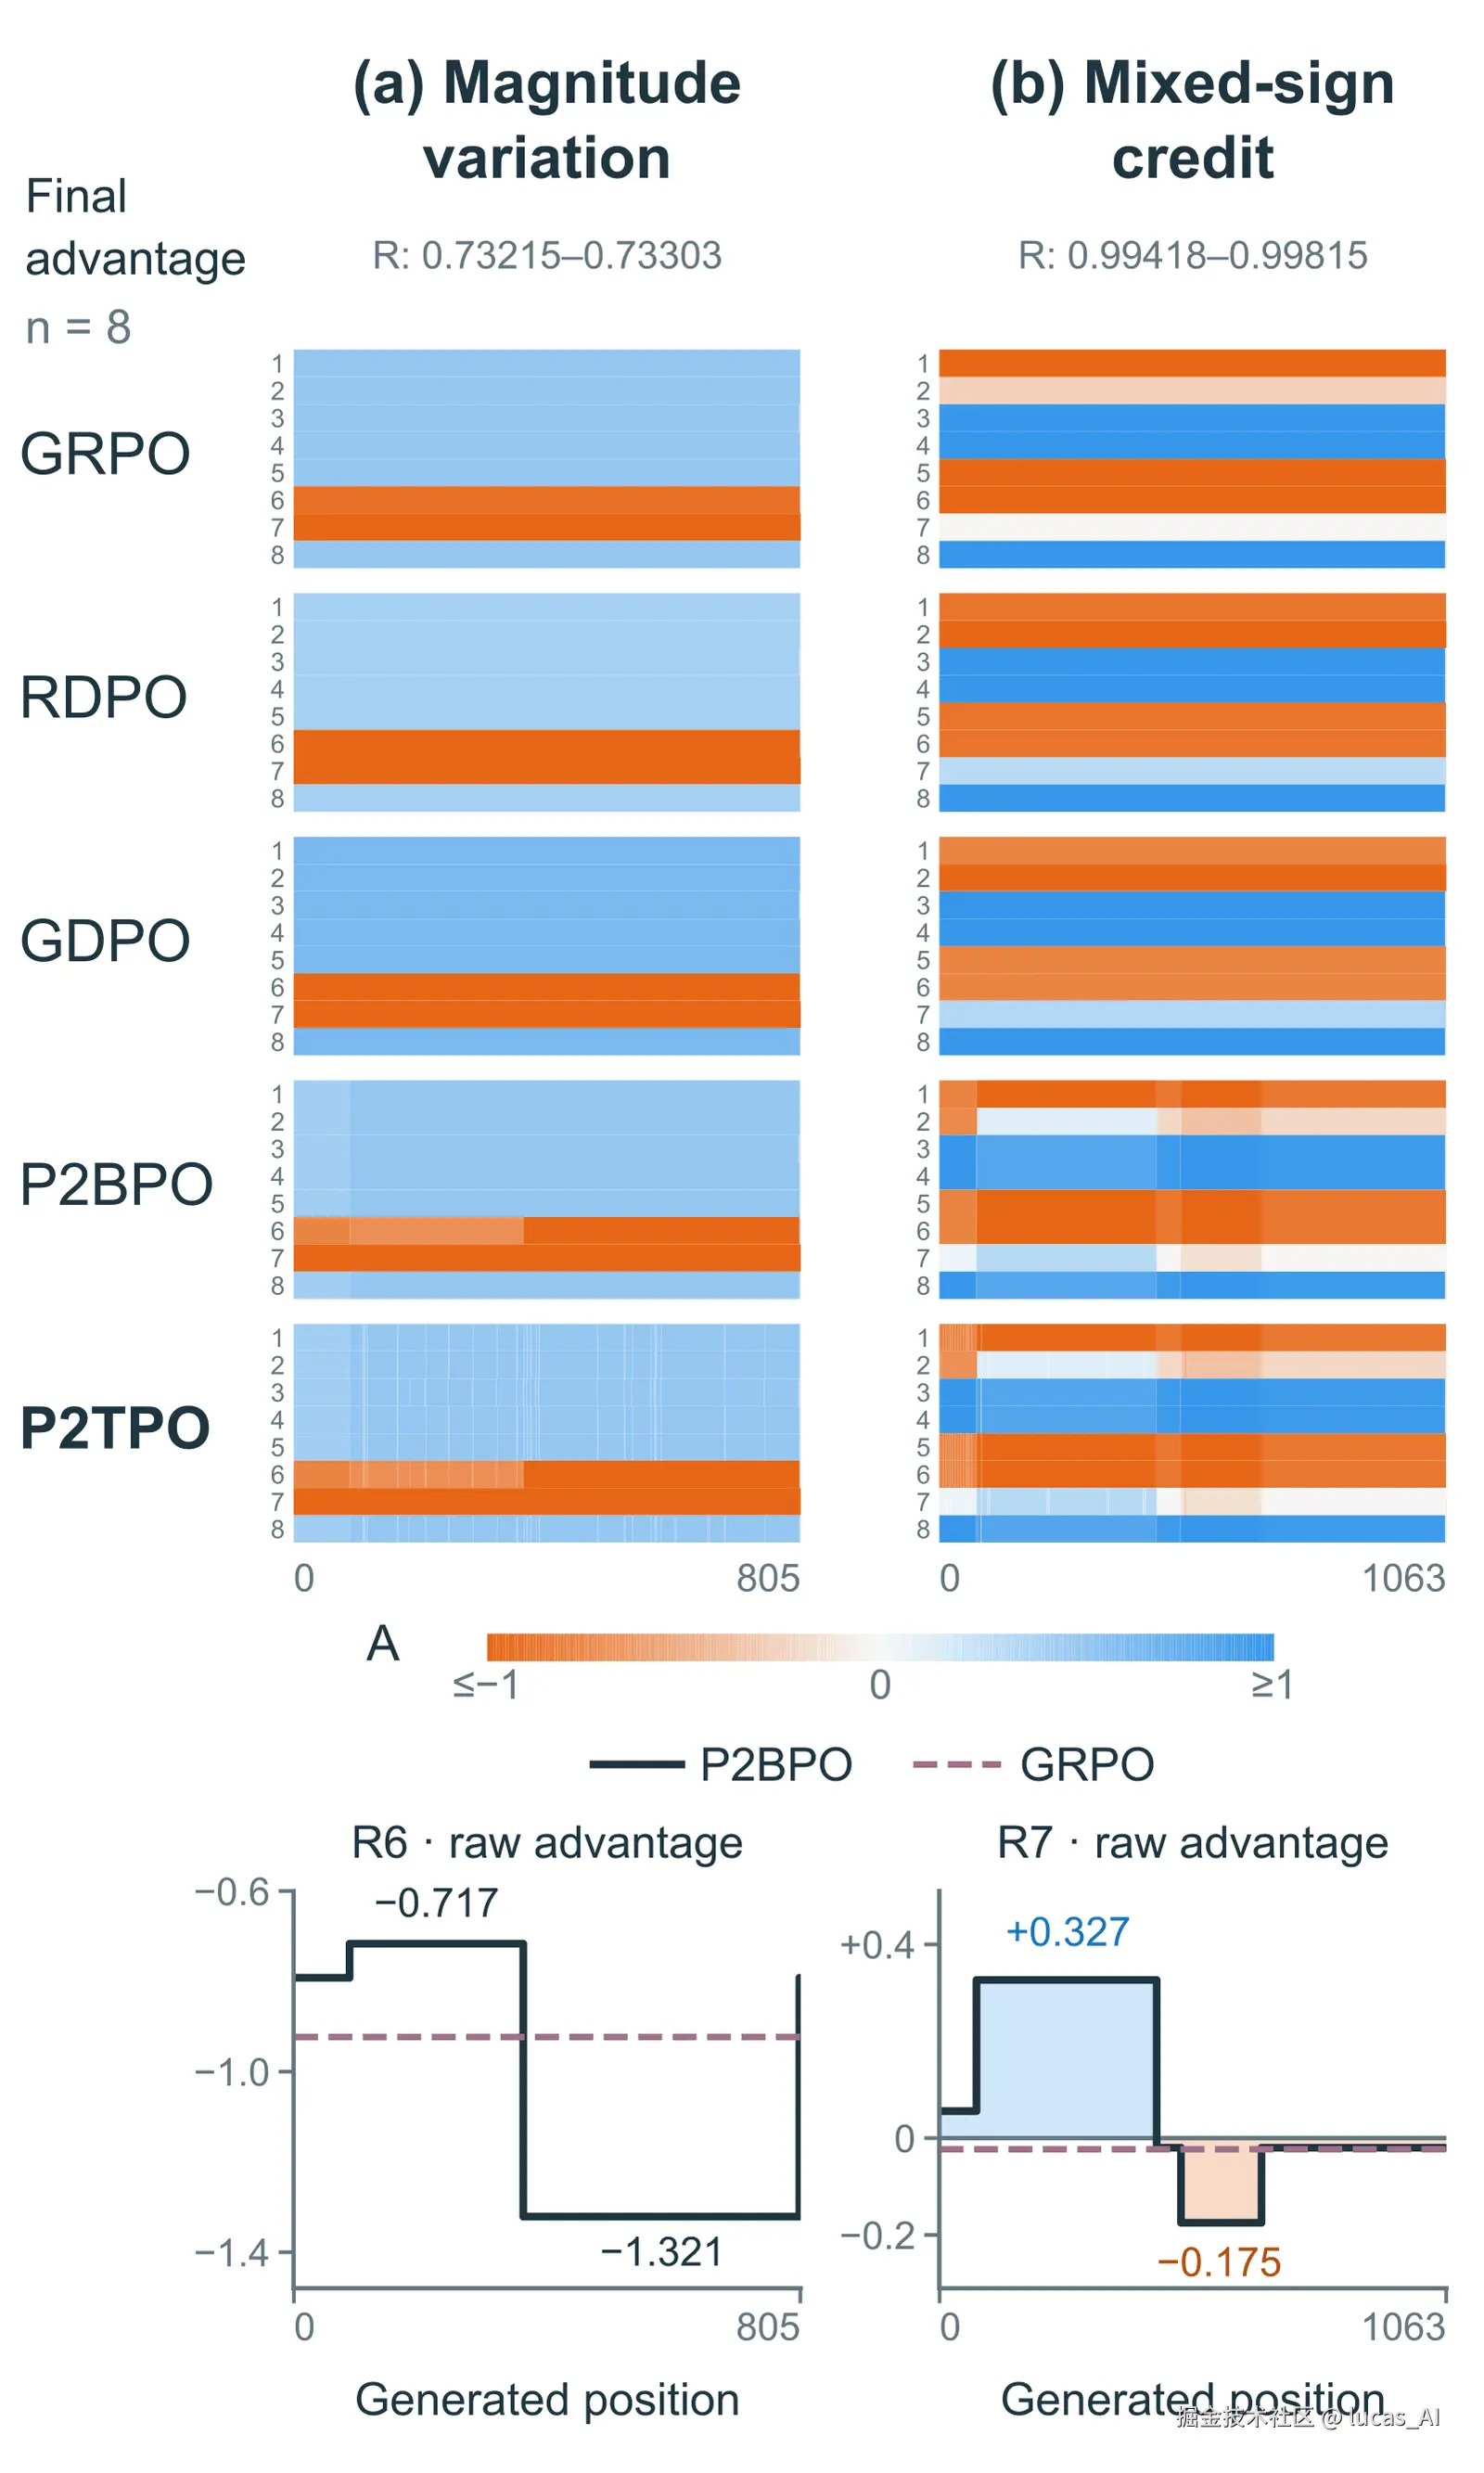
案例:粗账本到底会养出什么毛病
附录里的定性案例比表格数字更形象。挑一个临床文献页:页面上两条 Kaplan-Meier 生存曲线图注之间,夹着一个小节标题和一段统计描述。GRPO 训出的模型直接把这段跳过去了------文本编辑距离 0.4780,阅读顺序编辑距离 0.5;同一位置,P2TPO 训出的模型完整保留,两个距离都是 0。
双栏杂志页漏小标题、化学文献漏「Measurements」小节外加把上标排成纯文本------三个案例的错误清一色是「局部缺失」型。这不奇怪:整块漏掉的元素在旧账本里是最没存在感的,没有生成内容、没有局部分数,页面总分里它只贡献一个隐形的扣分项,和所有其他错误混在一起。UAP 把它变成显式的负反馈,SCR 再把「漏了」这个功过精确挂到边界 token 上,等于给模型立了一块「此处曾有空缺」的警示牌。
如果你正在训自己的解析模型,想抄这份作业,有几条实操要点:方法全程依赖高质量参考标注------对齐和打分都对着 ground truth 做,标注噪声会被直接吃进反馈里;默认超参数 (λ, β, ω) = (0.1, 0.5, 0.2) 直接用即可,敏感性扫描显示很稳;SCR 只对高分块生效(0.8 门槛),所以你的块级打分函数得先能分辨「基本对」和「基本错」。
🧊 泼冷水时间
第一,赢面虽全,单点幅度偏窄。多数评测集的均值差在 0.3 到 1.5 分之间,而五种子的标准差普遍有 0.2 到 0.9------不少评测集上的差距撑不起「统计显著」四个字,论文自己也只做了描述性比较,没报显著性检验。全胜格局可信,逐点优势要按评测集查证。
第二,它治不了标注的病。整个方法假设你有干净的参考文档和稳定的序列化约定;论文在 Limitations 里明说,标注噪声、重复文本、合法的替代写法都会污染元素匹配和 token 标签。没有高质量标注的团队,这套精细记账的收益要先过一道折扣。
第三,元素类型覆盖还窄。实验只评测文本、公式、表格三类,代码块、图片、跨页表格这些真实文档里的硬骨头没有作为独立类型验证;SCR 的编辑掩码以 token 级编辑为基础,对复杂版式是否还能「放对位置」,目前是外推。
第四,这是我的推测,论文没展开:元素级对齐和逐块打分本身有工程成本,每次更新都要对 128×8 份输出做序列对齐和编辑计算,相比 GRPO 一分钱不花的「组内排名」,训练管线的复杂度实打实上去了------论文报了硬件配置但没报相对开销(uncertain)。
💡 理性看待
把视野拉远一点,P2TPO 属于 RL 后训练里「把反馈的账算细」这条路线------agent 领域的 GiGPO 在分步记账,表格解析方向的 CSPO 在按属性路由,P2TPO 把同样的手术做到了整页文档的结构粒度上。它的三个组件各自简单:逐元素归一化是老手艺,天花板计价是一行公式,块内重排守着预算不越界------组合起来却精确地堵住了「身份、完备性、位置」三个漏洞。
对做文档解析、做 RL 反馈设计的人,这篇论文最值得带走的不是那 0.74 分,而是一个记账原则:反馈信号的粒度,应当与错误的粒度对齐。整页模型犯的是块级、token 级的错,却收着页面级的奖惩------账本记粗了,模型学到的就永远是和稀泥。至于「多细才算对」,P2TPO 的消融已经给出半句答案:先把账算对(UAP),再谈把钱发准(SCR);顺序反了,精细化只是噪声。