◆ 博主名称: QuZhengRong
AI俘虏,样式苦手
⭐️ Agent专栏: Agent
⭐️ LuckReport专栏: LuckReport
⭐️ SpringBoot专栏: SpringBoot
目录
- [一、什么是 KV Cache](#一、什么是 KV Cache)
- [二、KV Cache 的作用](#二、KV Cache 的作用)
- 三、多轮对话中的复用
- 四、延迟与计费
- 五、上下文编排策略
- [六、LuckReport 项目推荐](#六、LuckReport 项目推荐)

原生无状态大模型 API 本身没有会话记忆,每一次独立请求都是一次全新推理,对话时必须在本轮请求里完整带上 system prompt、工具描述和历史对话消息,模型读完这一整段上下文,再输出本轮回复。
随着上下文增加,推理计算量、耗时与调用成本都会随之走高。而那些固定不变的前置内容(system prompt、工具描述)之所以能够免于重复计算,底层依靠的正是 KV Cache。厂商文档里提到的 Prompt Cache、输入上下文缓存,大多都建立在这套机制之上。本文会讲清楚 KV Cache 的原理、工作流程,以及它对推理延迟、计费账单的影响。
一、什么是 KV Cache
模型是按 Token 串行输出内容的。每生成一个新 Token,注意力机制都需要参考它之前所有的上下文信息。
单次推理请求通常分为两个阶段:
- Prefill(预填充阶段):模型一次性对全部输入上下文执行完整计算,生成每一层注意力所需的 Key、Value,并产出回复的第一个 Token。
- Decode(解码阶段):后续每一步仅新增一个最新 Token,用该位置的 Query 去查询已经算好的历史 Key、Value,再迭代生成下一个 Token。
Decode 阶段高度依赖前置位置的 K、V。如果不做存储缓存,每产出一个新 Token,都要重新对整条历史序列完整计算;序列越长,计算开销和延迟就越高。
标准自注意力计算公式为:
A t t e n t i o n ( Q , K , V ) = s o f t m a x ( Q K T d k ) V Attention(Q, K, V) = softmax\left(\frac{Q K^{T}}{\sqrt{d_k}}\right) V Attention(Q,K,V)=softmax(dk QKT)V
其中 Q 是当前位置的查询向量,K 是历史位置的键向量,V 是历史位置的值向量。
Q 和所有历史 K 做点积,算出当前 token 和每一段历史的相似度;经过 softmax 归一化之后,得到一组总和为 1 的注意力权重,代表模型给每条历史信息分配多大的采信比例。
再用这一组权重,分别乘上对应位置的 V 向量,然后全部相加合并成一个向量,这个合并后的向量就是注意力层的输出。
KV Cache 的作用很明确:把已经计算完成的 Key、Value,按模型层、序列位置存入推理显存,后续解码步骤直接读取复用。
上下文序列越长,KV Cache 的体积就越大,显存占用随之上升。像 GQA 这类结构,本质是通过减少 K/V 头的数量压缩缓存大小,底层思路依旧是复用已计算结果,避免重复运算。
二、KV Cache 的作用
如果没有 KV Cache,重复计算会集中在两大场景:
- 单轮生成内部:Decode 每迭代一步,可见的上下文序列都会变长。倘若每一步都重新计算历史序列的 K、V,GPU 算力会大量消耗在重复运算上,输出文本越长,速度越慢。
- 多轮对话之间:后续请求里的 System Prompt、历史对话,往往和上一轮存在大量重叠前缀。每次都把整段上下文完整跑一遍 Prefill,重合内容就等于重复计算;不仅浪费算力,在不支持缓存计费的接口下,这部分前缀还会再次按全量输入 Token 收费。
归根到底,KV Cache 的目标很简单:已经算好的注意力中间状态,不要再重复计算。一方面降低算力开销、压低延迟;另一方面,在厂商支持前缀缓存计价的 API 中,还能直接减少这部分上下文的调用成本。
三、多轮对话中的复用
同一会话中,System Prompt 加上已有对话历史,会形成一段固定前缀。后续轮次只要保留这段前缀不变,服务端就可以复用上一轮已经生成好的 KV Cache,仅对新增内容执行计算。
text
多轮对话第 1 轮: [system][user_1]               → 全量 Prefill,写入 KV,再 Decode
多轮对话第 2 轮: [system][user_1][asst_1][user_2]
                  |← 可复用前缀 →|← 新增片段 →|
一旦前缀发生改动,旧缓存就无法复用,必须基于新序列重新走一遍 Prefill。开发里高频踩坑场景包括:修改 System Prompt、删减中间历史、变更工具定义的字段或顺序、切换模型。
四、延迟与计费
KV Cache 让推理免于重复的注意力运算,降低 Decode 阶段开销;如果前缀可以复用,Prefill 的工作量也会缩减,首包响应和续写速度都会得到改善。它的代价是显存占用更大,序列越长,缓存体积就越大。
计费层面要单独区分。云厂商推出的 Prompt Cache、输入前缀缓存,本质是在定价规则上承认「该前缀已在服务端完成处理」:缓存命中时,这部分输入 Token 按优惠价格结算;部分平台还会对首次写入缓存收取一笔更高的写入费用。各家策略差异很大,以官方文档为准。
方便对照记忆:
| 场景 | 收益 |
|---|---|
| 自建推理服务 | 降低算力开销、减少延迟;以显存占用为代价承载长上下文 |
| 稳定多轮会话 | 规避重复的 Prefill 计算 |
| 开启前缀缓存的商用 API | 缓存命中后,节省对应前缀的输入 Token 费用 |
如今推理引擎基本都内置 KV Cache,但 API 侧的计价折扣有附加约束:前缀需要保持稳定、达到厂商要求的最小长度,同时在缓存 TTL 有效期内。
五、上下文编排策略
在搭建多轮会话和 Agent 时,想要降低 token 费用,就要保证前缀 Token 序列不变。我们可以通过调整上下文排布,主动满足这个条件
- 稳定内容前置:System Prompt、工具 Schema、基础人设这类很少变动的内容放在最前面。不要频繁微调措辞,也不要随意调整工具字段的顺序。
- 可变内容后置:工具返回结果、RAG 检索片段、用户本轮新输入放在序列尾部。它们会增加当轮上下文长度,但不会破坏靠前的可缓存前缀。
自建部署场景下,重点关注推理引擎是否支持按会话持有 KV 缓存、显存资源是否充足;如果是调用公有 API,则需要对照厂商规则:缓存开关、最小前缀长度、命中判定逻辑,再校验每一轮生成的前置 Token 序列是否保持一致。
六、LuckReport 项目推荐
导航:LuckReport专栏
1、项目简介
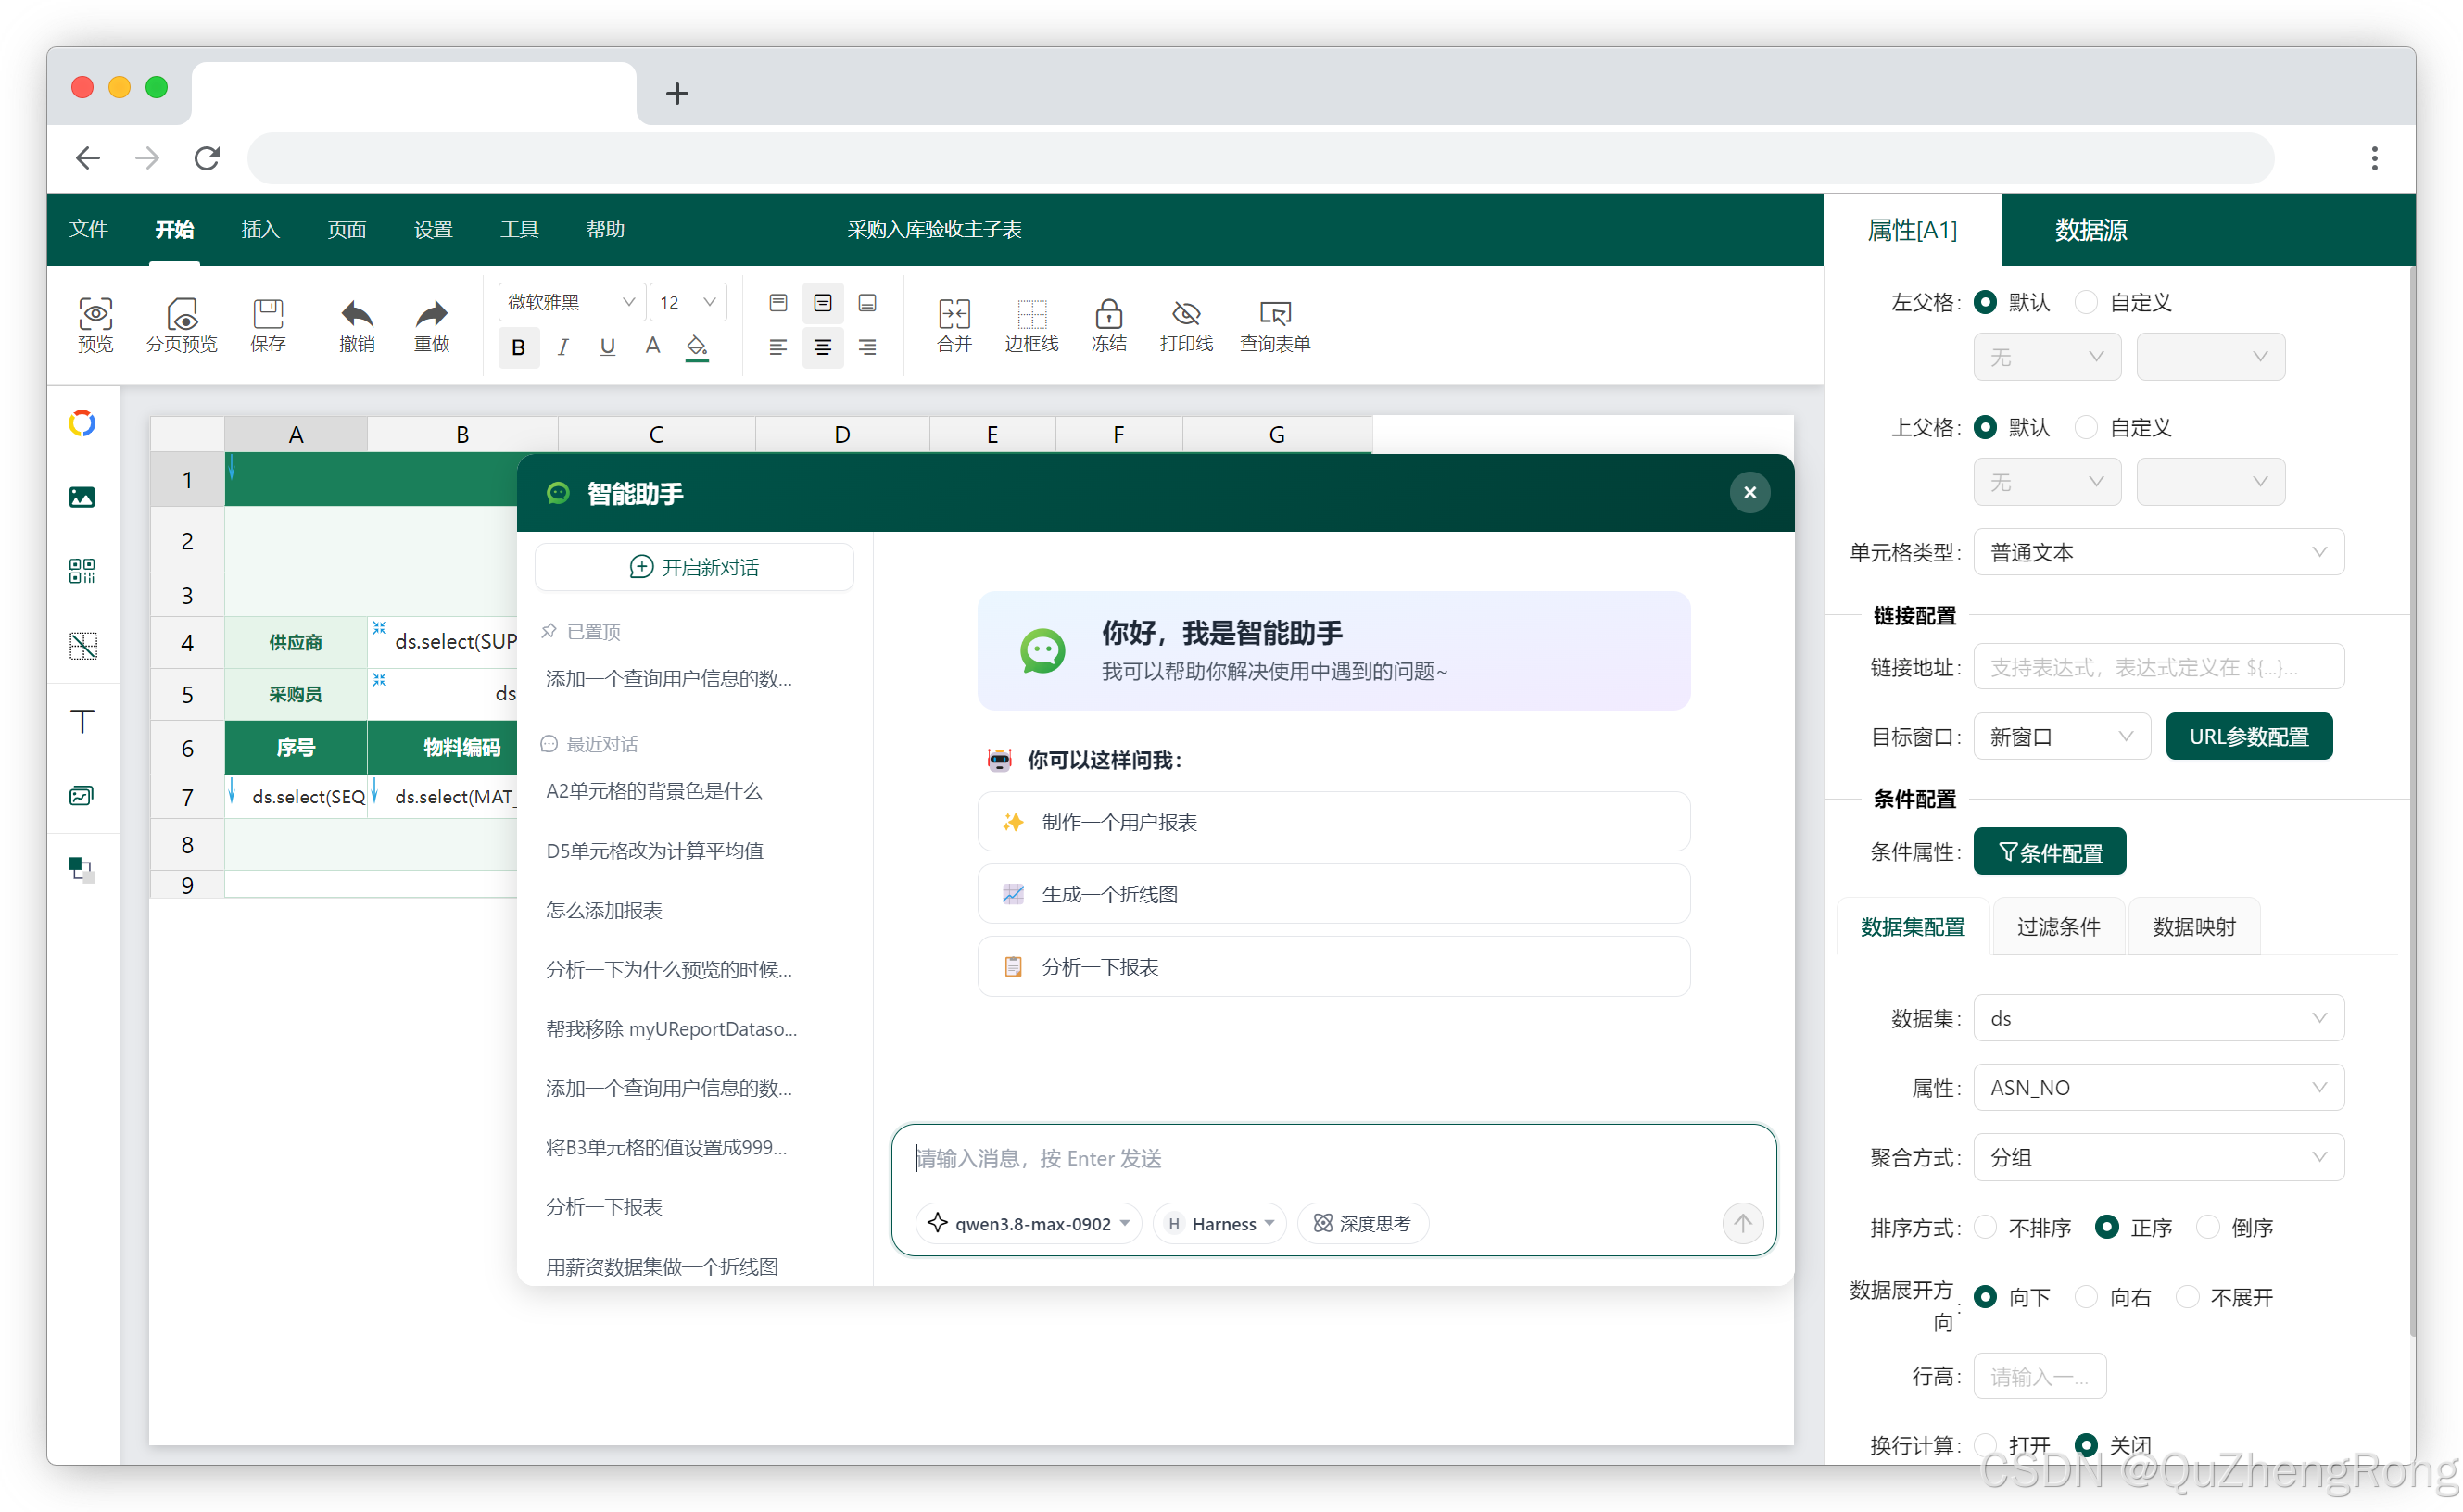
Luck-Report 是一款面向中国式复杂报表的开源报表引擎。基于单元格迭代,可在浏览器中完成交叉表、分组表、主从表等复杂版式的设计、预览与导出。
Luck-Report 内置 AI 智能助手 ,可结合大模型配置与知识库,用自然语言完成制表、改表与答疑。后端基于 Spring Boot,支持独立部署。项目由开源 UReport2 重构而来,在保留中国式报表能力的基础上,补齐现代化架构与 AI 辅助能力。
本仓库为报表引擎后端源码,基于 Apache-2.0 开源,可免费商用。