一句话:VoxCPM 2 是 OpenBMB 开源的语音模型,代码和权重都是 Apache-2.0,可以商用。VoiceStudio 是一个开源的本地配音桌面应用,可以把 VoxCPM 2 装成它的一个引擎,提供声音库、转写和本地 API。两者配合,在自己电脑上就能做出接近真人的中文旁白,不按字数付费,稿子和录音也不用上传。
本文要点
- 先科普:配音为什么难;"预设音色、声音设计、声音克隆"三种玩法各适合什么;两个项目截至 2026 年 10 月 30 日的状态。
- 再实战 :两条路线。
- 路线 A:VoiceStudio 图形界面加 VoxCPM 2 引擎,零代码。
- 路线 B:Mac 上直接用 mlx-audio 跑 VoxCPM 2,适合批量生产,也是我们一直在用的方式。
- 最值钱的部分:参考音频怎么洗、长稿怎么分段、多音字和英文词怎么处理、怎么质检。
- 弯路清单:一个月里踩过的 15 个坑,每个都有症状、原因和解法。
- 实测数据:Apple M3 Max 上的速度和内存、参考音频清理前后的对比、多音字的小样本实验。
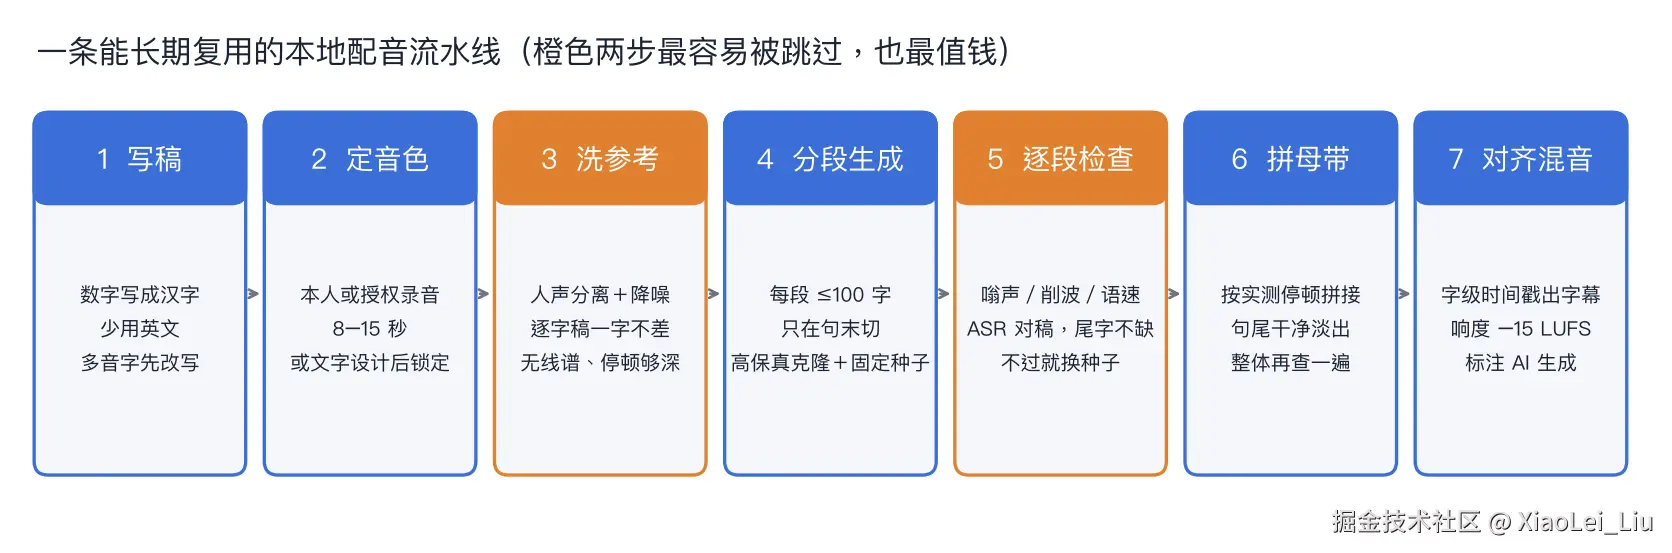
为什么写这篇
做视频的朋友,几乎都在配音上吃过苦头:
- 自己录:要安静的房间,要好麦克风,录完还得剪口误。改一个字,整段重录。
- 用免费的在线 TTS:一听就是机器,语调平,停顿怪,观众三秒就划走。
- 花钱买会员、按字数付费:贵,好听的音色还撞衫。你的稿子还要上传到平台,音色也不属于你。
- 找人配:更贵,周期更长,改稿还得再等。
我们在做开源项目 sweety-handdraw-video(AI 手绘口播视频)的过程中,几乎把这些坑全踩了一遍。后来定型的方案就是 VoiceStudio + VoxCPM 2。
手绘项目 2.0 发布时,我们提了一句"高度拟人化的配音靠的是这个组合",之后很多人来问怎么做。
准确地说,这两个在我们这里一直是分开跑的:
- 先用 VoiceStudio:当时配的是 Qwen3-TTS 引擎,手绘项目 1.0 的配音和语音转写都靠它。
- VoxCPM 2 后来加入:在 Mac 上用 mlx-audio 单独跑,成了主力旁白,造就了独一无二的逼真配音。
现在 VoiceStudio 已经能把 VoxCPM 2 装成自己的一个引擎,下面我会把这两条线都讲一遍。
第一部分:科普------先把概念理清,少走一半弯路
1. AI 配音的三种玩法
| 玩法 | 怎么用 | 优点 | 缺点 | 适合 |
|---|---|---|---|---|
| 预设音色 | 从列表里挑一个现成的声音 | 最简单 | 撞衫;音色不归你;情绪难调 | 偶尔用、对音色没要求 |
| 声音设计(Voice Design) | 用一句话描述你想要的声音,例如"中年男声,低沉有磁性,适合知识解说" | 不需要任何录音,凭空造出新声音 | 每次生成都像换了一个人 | 找方向、给虚构角色定声线 |
| 声音克隆(Voice Cloning) | 给一段参考录音,让模型用这个音色读新稿 | 音色稳定、可复用 | 参考录音质量决定一切;必须有使用授权 | 长期栏目、系列视频 |
我们最后的做法是两种组合起来:先用"声音设计"找到喜欢的声音,挑一条最好的作参考,以后全部用"克隆"。这样既不用找真人授权,音色又稳定。后面会细讲。
2. VoxCPM 2:现在最值得用的开源中文语音模型之一
VoxCPM 是 OpenBMB 开源的语音生成模型。VoxCPM 2 在 2026 年 4 月 6 日发布 2.0.0。截至本文,最新的 Python 包是 2.0.3 ,2026 年 5 月 11 日发布,加了 --device 参数,流式解码也更快了。
| 项目 | 内容 |
|---|---|
| 规模 | 约 20 亿参数,基于 MiniCPM-4,训练语音超过 200 万小时 |
| 输出 | 48 kHz,录音棚级采样率 |
| 语言 | 30 种语言,不用指定语言标签 |
| 中文方言 | 9 种:四川话、粤语、吴语、东北话、河南话、陕西话、山东话、天津话、闽南话 |
| 许可 | 代码和权重都是 Apache-2.0,官方写明可免费商用 |
| 硬件 | 官方参考显存约 8 GB;RTX 4090 上实时率约 0.30,即生成 10 秒音频约 3 秒 |
| Mac | 支持 Apple Silicon(MPS);社区的 MLX 移植更省内存,8-bit 权重约 3.2 GB |
它最让我们惊喜的是三种生成模式,也是后面所有操作的基础:
| 模式 | 需要什么 | 效果 | 什么时候用 |
|---|---|---|---|
| 声音设计 | 一句声音描述,不要录音 | 每次是不同的人 | 找声线 |
| 可控克隆(Controllable Cloning) | 参考录音,不用逐字稿;可以加括号指令,例如"(语速稍慢,语气温和)" | 保留音色,能调语气 | 需要情绪变化 |
| 高保真克隆(官方 README 叫 Ultimate Cloning,文档叫 Hi-Fi Cloning) | 参考录音 + 一字不差的逐字稿 | 音色最像,连说话习惯都延续 | 长期主力旁白 |
新手注意 :高保真克隆模式下,括号里的语气指令会被忽略。想要"同一个声音,换种语气",应该用可控克隆,而不是在高保真模式里拼命写指令。
在 Seed-TTS-eval 上的成绩如下(这是 OpenBMB 自己发布的表,未经第三方核验):
| 模型 | 中文 CER(越低越好) | 中文相似度 SIM(越高越好) |
|---|---|---|
| VoxCPM 2 | 0.97 | 79.5 |
| IndexTTS2 | 1.03 | 76.5 |
| Qwen3-TTS | 1.22 | 77.0 |
| CosyVoice2 | 1.38 | 75.7 |
| F5-TTS | 1.53 | 76.0 |
来源:VoxCPM README · Performance。
3. VoiceStudio
VoiceStudio 是开源的本地配音桌面应用,自称"开源、全本地的 ElevenLabs 替代品",有中文 README。
它的定位是工作台加引擎管理器,自己不绑定某一个模型:
- 多引擎:默认引擎是 OmniVoice,还可以装 VoxCPM 2、CosyVoice 3、IndexTTS、MOSS-TTS、GPT-SoVITS、MLX-Audio 等。
- 声音库:参考录音、逐字稿、种子都存成"声音档案",下次直接选。
- 配套工具 :语音转写(Whisper)、人声分离、视频配音、有声书和长文(支持
[pause 0.5s]停顿标记)、发音词典。 - 本地 API :默认端口 3900 ,有 OpenAI 兼容的
/v1/audio/speech和/v1/audio/transcriptions,还有 MCP 接口,可以接 Claude Code、Codex 这类 Agent。
最新版本是 0.5.7,2026 年 10 月 26 日发布,有几处要注意:
- 许可确认 :没有明确商用许可的模型,包括默认引擎 OmniVoice,要先在应用里接受一次许可,否则 API 和 MCP 调用会失败。
- 新安装包和界面:新增纯 CPU 版本,界面重新设计。
- 付费功能:远程和 GPU 共享这类功能移到了付费的 Pro 版。
4. 为什么是 VoiceStudio + VoxCPM 2的组合?
一个很多人没注意到的事实:VoiceStudio 应用本身是 AGPL-3.0,但它的默认引擎 OmniVoice 的模型权重是 CC-BY-NC(非商业) (模型卡)。
如果你做的是带货、接广告、知识付费这类商业内容,默认引擎在许可上就不合适。VoxCPM 2 的权重是 Apache-2.0,商用没有这个顾虑,中文和方言能力也强。
所以分工是:
- VoiceStudio 负责好用:界面、声音库、转写、配音工作台、本地 API。
- VoxCPM 2 负责好听和能商用。
提醒:模型许可允许商用,不等于你可以克隆任何人的声音。声音授权是另一回事,见文末"合规"部分。
第二部分:我们的心路历程
在讲操作之前,先讲我们怎么一步步走到现在的方案。
阶段一:工具大杂烩
最早每个项目各用各的:Edge TTS、Piper、Kokoro、Qwen3-TTS 的两个版本、Whisper.cpp、单独装的 MLX Audio......每个都能用,没有一个好用:
- 有的中文生硬;
- 有的只有几个预设音色;
- 有的能克隆,但需要单独的环境。
2026 年 10 月初我们下决心清理,卸掉这些独立工具和重复模型,腾出了约 13 GB 磁盘,配音统一收口到 VoiceStudio。
教训:先选一个统一入口。 工具越多,环境越乱,你会把时间花在这次用的是哪个上。
阶段二:情绪调不出来
收口后,我们先用 VoiceStudio 加 Qwen3-TTS 的克隆模式给绘本配音:妈妈和孩子两个角色,各自先用"声音设计"生成参考,再克隆。
问题来了:妈妈的台词需要温柔、着急、开心几种情绪,可不管指令写得多细,出来都一个调。
我们翻了源码才发现:当时 VoiceStudio 里跑的 Qwen3-TTS 克隆分支是 mlx-audio 的实现,它接收了情绪指令,却根本没有把指令传给模型。
教训:情绪不出来时,先确认你用的模式和引擎到底支不支持情绪指令。别急着改提示词。 这也是我们后来转向 VoxCPM 2 的原因之一:它的"可控克隆"明确支持用指令调语气。
阶段三:VoxCPM 2 上手,音色惊艳
我们在 Mac 上用 mlx-audio 跑 VoxCPM 2 的 8-bit 版本。我们没有把它装进 VoiceStudio,而是单独建了一个 Python 环境直接跑。第一次克隆出来的男声,音色质感比之前所有方案都好。我们当时偷懒,把整篇稿子一次性生成,47 秒一口气读完。
成片听下来,背景里一直有若有若无的嗡声。我们一开始以为是模型的问题,还试着调参数。
阶段四:调优
做了频谱分析才找到根因:我们那段 7 秒的参考录音,是从一段带背景音乐的旁白里直接截的。
- 配乐残留:频谱上有 106、593、891 Hz 三条持续的"线"。
- 停顿不安静:停顿处的音量只比说话低 17.8 dB,正常的干声应该低 25 dB 以上。
- 轻微削波:录音有轻微的破音。
模型把配乐当成了"这个人声音的一部分",一起克隆了进来,而且越长的段落放得越大。
修法:回到原始录音,挑一段 14.9 秒、在句末结束的完整段落,先用 HTDemucs 做人声分离,再用 DeepFilterNet3 降噪。结果持续线谱消失,停顿比语音低 33.5 dB,语音识别的字错误率(CER)0.035。
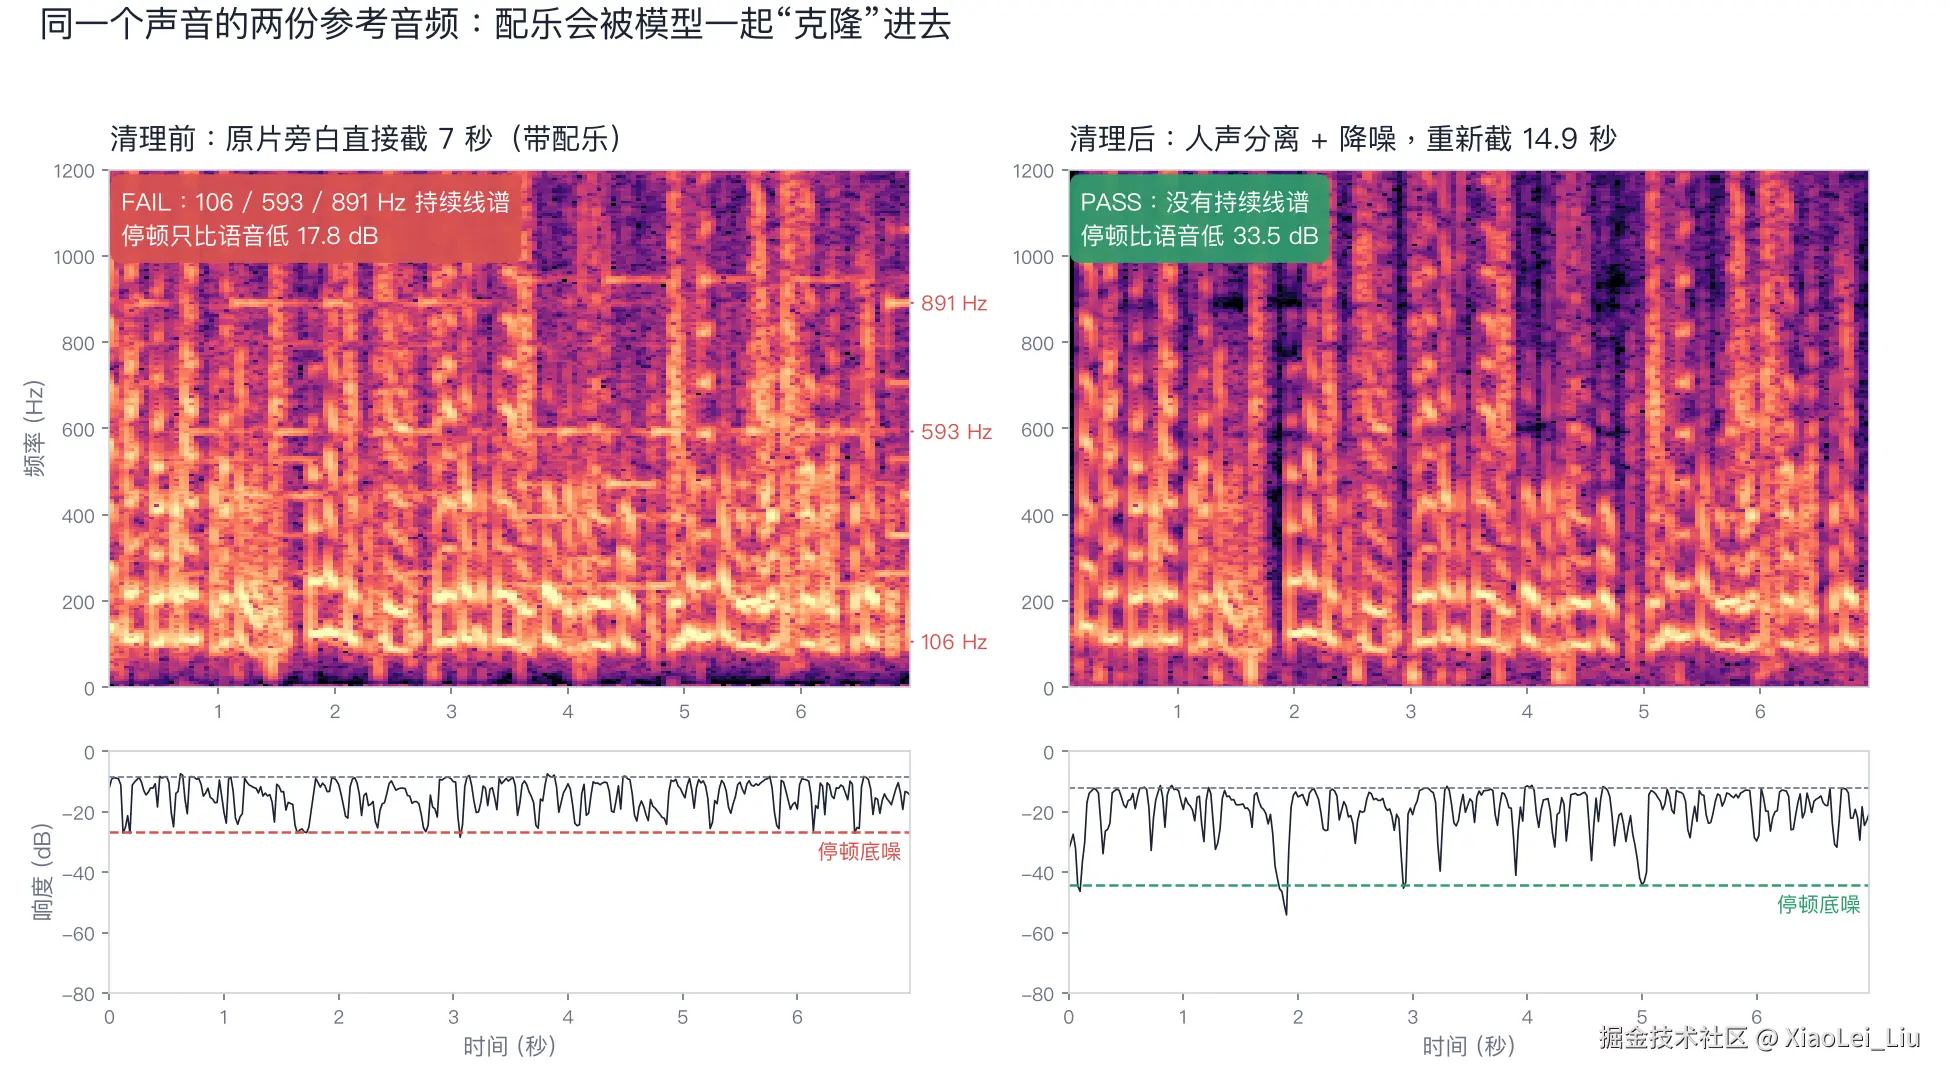
上图左边是清理前,能看到几条贯穿全程的横线,那就是配乐,停顿处也一直"不安静"。右边是清理后,横线没了,停顿深深地沉下去。
另一款女声也经历了同样的清理。重新生成后,我们的反馈原话是:"音色接近,杂音也消失了 ",全篇试听后"全篇也通过,作为主力女声"。
参考音频的质量,决定了克隆的上限。
阶段五:长稿的玄学
接下来做的片子越来越长,从一两分钟到十一分钟。新问题一个接一个,后面会逐条列,这里先挑几个印象深的:
- 整篇一次生成:越读越快,偶尔出现嗡声,甚至停不下来。官方也承认长文本不稳定,建议分段。
- 句尾被吃字:有一句"多试几遍",成片里"遍"没了。原因是我们裁句尾静音的算法,把"遍"字开口前那几十毫秒的闭塞(发 b 音前嘴唇闭住的那一下)当成了句子结束。
- 英文单词听不懂:bug、Thorsten 这类词,同一句话换了 8 个种子,一次都没读对。
- 机器质检误报:男声念一长串列举时,音高会在 120 Hz 附近稳住好几秒,被我们的嗡声检测当成了"杂音"。同一句话 8 个种子,7 个被误判。
每个问题我们都把规则写进了流程里,后面几节就是这些规则。
阶段六:克隆自己的声音
我们也试过克隆自己。从一段会议录音里截出本人主讲的 9 秒,降噪后门禁通过,识别字错误率为 0,技术上无可挑剔。
但放进正式的知识解说片,自己听着就是不对味:日常说话的声音,不等于适合做旁白的声音。最后我们的分工是:
- 个人口播、自媒体:用自己的声音。
- 正式解说片:用一款更有"播音感"的男声。
教训:技术合格不等于适合。 选声音时,用你要发布的那类内容试听,别只用一句"你好,欢迎来到我的频道"。
阶段七:多音字
最近一次给一段家庭羽毛球视频配解说,21 句旁白里,ASR 质检揪出了这些读错的:
| 应读 | 实际读成(ASR 听写) |
|---|---|
| 夜场 | 夜长 |
| 小将(jiàng) | 小江(jiāng) |
| 一气呵成 | 仪器合成 |
| 一拍 | 一排 |
| 十几拍 | 实际拍 |
我们的处理:
- 换种子重生成;
- 实在不行就改写说法,比如把"夜场羽毛球"开场改成别的说法;
- 最后只剩"十几拍"一句:ASR 仍听写成"实际拍"。两者只差声调,ASR 判声调本身就不可靠,所以留给人耳确认,其余全部过关。
后面"多音字"一节,有我们专门做的小实验。
第三部分:实战路线 A ------ VoiceStudio + VoxCPM 2(零代码)
适合绝大多数人:不想碰命令行,想要一个"打开就能用"的配音软件。
第 0 步:先确认你的电脑够不够
| 你的电脑 | 能不能跑 | 建议 |
|---|---|---|
| Apple Silicon Mac(M1 及以后),16 GB 内存起 | 可以 | 内存越大越从容;我们的 M3 Max 36 GB 很宽裕 |
| Intel Mac | VoxCPM 2 引擎不支持一键安装 | 用在线体验,或换设备 |
| Windows / Linux + NVIDIA 显卡(8 GB 显存起) | 可以,速度最快 | 官方首推 CUDA |
| 只有 CPU | 能跑,但很慢 | 0.5.7 起提供纯 CPU 版,适合偶尔用 |
磁盘:VoxCPM 2 引擎有自己独立的 Python 环境。0.5.6 安装时会先检查是否有约 10 GB 可用空间,首次生成还会下载约 5 GB 模型。建议至少留出 20 GB 空间。
第 1 步:安装 VoiceStudio
macOS 或 Linux,打开"终端",粘贴:
bash
curl -fsSL https://voicestudio.sh/install | shWindows,打开 PowerShell:
powershell
irm https://voicestudio.sh/install.ps1 | iex也可以去 Releases 页面下载安装包:Mac 用 DMG,Windows 用 .exe。Windows 安装包没有签名,SmartScreen 会弹警告,确认来源是官方 GitHub 再继续。
不会用终端?VoiceStudio 官方提供了"让 Agent 帮你装"的提示词。把下面这段贴给 Claude Code 或 Codex:
textInstall the VoiceStudio Electron app on this device and verify it works, following https://github.com/debpalash/VoiceStudio/blob/main/docs/install/agent.md
第 2 步:国内网络先配镜像
首次使用要从 Hugging Face 下载模型,国内网络常常很慢或连不上。VoiceStudio 的设置里有 Hugging Face 镜像 选项,可以切到 hf-mirror.com,它自带连通性测试。先把这个配好,再装引擎,能省掉一大半"下载卡住"的问题。
第 3 步:安装 VoxCPM 2 引擎
按官方文档:模型目录(Model Catalogue)→ VoxCPM2 → 安装(Install)。它会装进一个独立的 Python 环境,不影响其他引擎。
- 安装好后,第一次生成时才会下载模型权重,第一次会慢一些,耐心等。
- 0.5.7 起,默认引擎 OmniVoice 等非商用模型要先接受许可才能调用。VoxCPM 2 是 Apache-2.0,不受这个限制。
Mac 用户注意 :VoiceStudio 里还有一个"MLX-Audio"引擎,也列出了 VoxCPM 2。但按 VoiceStudio 自己的文档,经这个引擎调用时参考音频会被忽略,输出也降到 24 kHz 。要做克隆,请选上面那个专门的 VoxCPM2 引擎。来源:VoiceStudio mlx-audio 文档。
第 4 步:准备参考音频(最重要,单独成节)
请先跳到下面的"第五部分:参考音频------决定成败的一小时"把参考录音准备好,再回来继续。
第 5 步:建一个"声音档案"
在"声音克隆"页面添加参考录音,填写逐字稿,也就是参考录音里说的每一个字,一字不差,标点照录。保存成一个声音档案,起个好记的名字,比如"栏目男声-v1"。
VoiceStudio 处理 VoxCPM 2 参考音频的规则,弄清楚能少踩坑:
- 它会自动裁掉参考首尾的静音,然后最多保留前 30 秒;
- 如果因为超过 30 秒被截断,它会丢掉逐字稿,退回普通克隆,因为截断后的音频和逐字稿对不上了。
所以:参考音频控制在 8--15 秒,不要超过 30 秒。
来源:VoiceStudio VoxCPM2 引擎文档,以及 0.5.6 源码。
第 6 步:三种模式在 VoiceStudio 里怎么"触发"
VoiceStudio 不让你直接选模式,而是根据你填了什么自动决定(我们读了 0.5.6 的源码确认):
| 你填了什么 | 实际用的模式 |
|---|---|
| 选了声音档案(有参考 + 逐字稿),风格(Style)留空 | 高保真克隆:音色最像 |
| 选了声音档案,填了风格,比如"语速稍慢,语气温和" | 可控克隆:保留音色、调语气,逐字稿不用 |
| 不选声音档案,只写声音描述 | 声音设计:每次是新的人 |
参数建议,都是官方默认,先别动:
- 引导强度(guidance)2.0:调低更自然但可能跑稿,调高更贴稿但难句容易出杂音。
- 步数(steps)10:官方推荐 4--30,越大细节越好、越慢。我们的主力男声用 16。
第 7 步:生成、试听、对稿
生成后,用 VoiceStudio 自带的转写功能把音频转回文字,和稿子对一遍:
- 有没有漏字、多字?
- 结尾的最后一个字在不在?
- 人名、数字、多音字对不对?
不对就换个种子重新生成这一段。注意,转写只能发现明显问题,最终一定要用耳朵听一遍。
第 8 步:长稿不要一次贴整篇
不管哪个模型,长文本都容易越读越快、出杂音。正确做法是分段生成,规则见第六部分。
VoiceStudio 的"有声书 / 长文"功能支持 [pause 0.5s] 这样的停顿标记,还有发音词典,可以统一纠正某个词的读法,见第七部分。
第 9 步(进阶):用本地 API 批量生成
VoiceStudio 开着时,本机 3900 端口提供 OpenAI 兼容接口。参数名以 0.5.6 的接口说明为准:
bash
# 列出你的声音档案,拿到 voice 的 ID
curl -s http://127.0.0.1:3900/v1/audio/voices

# 用 VoxCPM 2 引擎、指定声音档案生成一段旁白
curl -s http://127.0.0.1:3900/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{
    "model": "voxcpm2",
    "voice": "<你的声音档案ID>",
    "input": "今天我们用十分钟,讲清楚一个问题。",
    "response_format": "wav",
    "seed": 2026,
    "num_step": 10,
    "guidance_scale": 2.0
  }' \
-o part-001.wavseed很重要:同一个种子、同样的参数,结果可以复现。哪段不满意就只换那段的种子。- 格式 :
response_format默认是 mp3,做视频建议用 wav。 - 接入 Agent :VoiceStudio 也提供 MCP(
http://127.0.0.1:3900/mcp),可以让 Claude Code、Codex 直接调用它配音。
第四部分:实战路线 B ------ Mac 上直接跑 VoxCPM 2
适合想批量生产、想把配音接进自己流程的人。我们的手绘视频项目就是这么做的:每段旁白自动生成、自动质检、不过关自动换种子重来,最后拼成完整的旁白母带。
1. 安装
bash
python3 -m venv ~/voxcpm2-mlx
source ~/voxcpm2-mlx/bin/activate
pip install -U mlx-audio soundfile mlx-whisper

# 国内网络可先设镜像
export HF_ENDPOINT=https://hf-mirror.commlx-audio(MIT 许可)从 0.4.4 开始支持 VoxCPM 2,截至本文最新是 0.6.3。我们的生产环境是 0.5.8,下面的代码在 0.5.8 上验证过;新版参数名如有变化,以官方说明为准。
权重有三档:
| 权重 | 大小 | 说明 |
|---|---|---|
| bf16 | 约 5.0 GB | |
| 8-bit | 约 3.2 GB | 我们用的 ;mlx-community/VoxCPM2-8bit |
| 4-bit | 约 2.3 GB |
2. 高保真克隆一段旁白
python
import mlx.core as mx
import numpy as np
import soundfile as sf
from mlx_audio.tts.utils import load

model = load("mlx-community/VoxCPM2-8bit")          # 首次会下载约 3.2 GB
ref = "reference.wav"                                # 洗干净的参考,8--15 秒
ref_text = open("reference.txt", encoding="utf-8").read().strip()   # 一字不差的逐字稿

text = "今天我们用十分钟,把这个问题从头讲清楚。"
mx.random.seed(2026)                                 # 固定种子,结果可复现
chunks = list(model.generate(
    text=text,
    ref_audio=ref, prompt_audio=ref, prompt_text=ref_text,   # 三项都给 = 高保真克隆
    inference_timesteps=10, cfg_value=2.0,
    max_tokens=len(text) * 6 + 10,                   # 官方"文本长度×6+10"的上限,防止停不下来
))
audio = np.concatenate([np.asarray(c.audio) for c in chunks])
sf.write("part-001.wav", audio, chunks[0].sample_rate)   # 48 kHz
另外两种模式的写法:
- 可控克隆 :只给
ref_audio,再加instruct="语速稍慢,语气温和"。 - 声音设计 :不给参考,只给
instruct="中年男声,低沉有磁性,沉稳,适合知识解说"。
3. 生成完立刻"对稿"
python
import mlx_whisper
r = mlx_whisper.transcribe("part-001.wav",
                           path_or_hf_repo="mlx-community/whisper-large-v3-turbo",
                           language="zh")
print(r["text"])
把识别结果和原稿逐字比对,算字错误率:
- 超过 0.15 ,或结尾少了字:这一段作废,换种子重来。
- 自动重试最多 3 次,还不行就改写这句。
4. 实测速度和内存
条件:Apple M3 Max、36 GB 内存,VoxCPM2-8bit,步数 10。
| 模式 | 生成 7 秒左右的音频耗时 | 实时率 | 内存峰值 |
|---|---|---|---|
| 高保真克隆 | 7.0 秒(音频 6.9 秒) | ≈1.0 | ≈6.3 GB |
| 可控克隆 | 11.3 秒(音频 7.2 秒) | ≈1.6 | ≈6.2 GB |
首次加载模型约 19 秒。
换算一下:我们的主力男声语速约 6.6 字/秒 ,一部 4581 字的稿子,成片旁白约 708 秒(11 分 48 秒)。
别开两个进程并行:我们试过两个生成进程同时跑,总耗时反而更长,还有一次因为内存吃紧被系统杀掉。单进程按顺序跑最稳。
第五部分:参考音频
这是全文最值钱的一节。克隆的质量 80% 由参考决定。
1. 参考音频的标准
| 要求 | 我们的标准 | 为什么 |
|---|---|---|
| 时长 | 8--15 秒(官方说 5--30 秒都行) | 太短抓不准音色;超过 30 秒在 VoiceStudio 里会被截断 |
| 内容 | 一个人、连续、自然地说话 | 有人插话、有笑声,都会被学进去 |
| 结尾 | 在句末结束,后面留 0.5--1 秒静音 | 句中截断,模型会延续那半句的状态,开头容易冒杂音 |
| 背景 | 没有音乐、没有空调和风扇声 | 底噪和配乐会被克隆,长段里还会放大 |
| 音量 | 峰值在 −3 dBFS 左右,不能破音 | 削波会变成"沙沙"的质感 |
| 逐字稿 | 一字不差,标点照录 | 不一致是"开头有杂音、漏读、读出参考里残字"的头号原因 |
2. 声音从哪来?三个合规来源
- 自己录:手机放在安静的衣柜边,离嘴 20 厘米,用平时讲解的语气读一段 15 秒的话。
- 获得授权的他人录音:一定要有明确授权,最好是书面的。
- 用"声音设计"造一个 :这是我们最推荐的做法,既不涉及任何真人,又能得到稳定音色:
- 写声音描述,官方建议的写法是"身份 + 质感 + 场景"三段,例如:"中年男声,低沉浑厚、有磁性,沉稳有力,适合知识与故事解说"。
- 同一个描述生成 4 次,换不同种子。
- 挑一条最干净、最像你想要的,作为参考。
- 以后全部用克隆模式,音色就固定下来了。
声音描述里只写声音特征,不要写"像某某主播""某平台某音色",也不要用别家 TTS 的输出当参考。
3. 参考脏了怎么洗
如果你的录音带了配乐或底噪:
图形界面:VoiceStudio 自带人声分离和音频清理功能,把录音先过一遍。
命令行:我们的做法是两步,先分离人声,再降噪。
bash
# 1) 截出 8--15 秒、句末结束的一段(单声道、48 kHz)
ffmpeg -ss 31.6 -to 46.0 -i source.wav -ac 1 -ar 48000 cut.wav

# 2) 人声分离(Demucs,MIT 许可),只保留人声
pip install demucs
demucs --two-stems=vocals cut.wav        # 结果在 separated/htdemucs/cut/vocals.wav

# 3) 降噪(DeepFilterNet)
pip install deepfilternet
deepFilter separated/htdemucs/cut/vocals.wav -o cleaned/
洗完怎么判断干不干净?
- 最简单 :用 Audacity 之类的软件打开,切到频谱图。如果看到贯穿全程的横线,就是还有配乐或电流声。
- 再戴耳机听停顿处:停顿应该是"死寂"的,而不是"有一层东西"。
- 我们的量化门禁 :
- 停顿要比说话低 25 dB 以上,干净的参考能到 −30 dB 以下;
- 不能有持续的单频线;
- 不能削波。
VoxCPM 2 本身也有
denoise参数,但它只处理参考音频,而且走 16 kHz 管线,官方说会"轻微改变音色"。参考本来就干净的话,保持关闭。
第六部分:长稿生产------分段、停顿、句尾
1. 分段规则
| 规则 | 说明 |
|---|---|
| 每段 不超过约 100 字 | 太长会越读越快、出嗡声、停不下来 |
| 只在句末切(。!?...) | 句中切开,语调会断 |
| 太短的句子并入下一段 | 少于 8 个字的单句声音偏弱;官方训练时最短约 1 秒 |
| 每段单独质检、单独重做 | 只返工出问题的那一段 |
| 每段记录文字、种子、参数 | 以后改稿时,没改的段直接复用 |
2. 段与段之间留多长停顿
拼接时插入纯静音。下面这组是我们在已验收的成片、以及真人长篇解说上实测的:
| 衔接位置 | 停顿(秒) |
|---|---|
| 逗号处拆开的长句 | 0.20 |
| 同一段落内的句子 | 0.30 |
| 段落之间 | 0.40 |
| 换页 / 换章节 | 0.60(真人解说句末停顿的中位数) |
3. 句尾怎么处理
模型说完一句后,偶尔会"多出一点声音",比如一口气、半个杂音。我们的处理:
- 从最后一个字的末尾往后找,第一段持续 30 毫秒、低于 −40 dB 的静音,就是句子真正的结尾。
- 别从字的开头找:b、t、g 这类声母开口前,嘴唇或舌头会闭住几十毫秒,那段静音不是句尾。我们的"多试几遍"丢了"遍"字,就是这个原因。
- 结尾后保留 0.12 秒余音,再用至少 50 毫秒的淡出收尾。
- 裁完再识别一次:确认最后一个字还在。
4. 混音
- 旁白整体响度做到 −15 LUFS 左右(短视频平台常用的范围)。
- 背景音乐在说话时压低。
- 整体峰值不超过 −1.5 dBTP。
第七部分:多音字、英文和数字------中文配音的三块硬骨头
1. 多音字:我们做了个小实验
官方给的方法是在文本里写带声调数字的拼音 ,比如 {ni3}{hao3},同时把 normalize 关掉(用法指南)。
社区里还有一个土办法:同音字替换。口播稿里把容易读错的字,换成读音唯一的同音字,字幕仍然用原文。VoiceStudio 的发音词典支持按词替换写法,可以把这件事自动化。
我们在自己的环境里各试了 5 个种子。环境是 mlx-audio 0.5.8、8-bit、高保真克隆,结果用 Whisper 判读:
| 写法 | "小将"读对 | "一气呵成"读对 |
|---|---|---|
| 原文照写 | 1/5 | 4/5 |
拼音标注 小{jiang4}、一气{he1}成 |
0/5 | 3/5 |
同音字替换 小匠、一气喝成 |
3/5 | 5/5 |
几点说明:
- 样本很小,只是 5 个种子,结论仅供参考。
- MLX 移植版不一定完整支持官方的拼音标注。用官方 PyTorch 版本的朋友,可以优先试拼音标注。
- ASR 判声调本身不可靠。"夜场 / 夜长"这种只差声调的词,Whisper 在两种写法下都给出过两种结果,我们没法据此判断,所以没列进表里。最后一定要人耳确认。
我们现在的实际做法:
- 写稿时就避开:容易读错的词,能换说法就换。
- 换不掉的,用同音字替换,并在字幕里保留原文。
- 逐段 ASR 对稿,读错就换种子,最多 3 次。
- 仍不行,改写这句。
- 最后人耳通听一遍。
2. 英文词:尽量少用
中文语音模型读中文里夹的英文,经常"中文识别能过,英文耳朵听不懂"。我们实测了主力男声(VoxCPM2-8bit 克隆):
- bug、Thorsten:同一句话 8 个种子,一次都没听出原词。
- git、Amp:部分种子能听出。
- AI、Agent、token:大多能听出。
所以我们定了规矩:
- 常用词有中文说法就用中文,比如 bug 写成"问题"。
- 人名用通行的中文译名,画面上可以保留英文。
- 必须保留的英文,生成后单独切出来,用英文识别再听一遍,听不出就换种子,最多 6 次。
3. 数字、日期、单位:写成汉字
官方的 normalize 参数可以处理数字读法,但 MLX 移植版没有。最稳的办法是在口播稿里直接写成你想读的样子:
- "2026 年"写成"二零二六年";
- "1024"先决定读"一零二四"还是"一千零二十四";
- "2.0.3"写成"二点零点三"。
第八部分:我们踩过的 15 个坑(速查表)
| # | 坑 | 症状 | 根因 | 解法 |
|---|---|---|---|---|
| 1 | 工具装了一堆 | 环境乱、磁盘满、不知道这次用的哪个 | 没有统一入口 | 收口到 VoiceStudio,其他卸掉(我们腾出约 13 GB) |
| 2 | 克隆后情绪调不出 | 指令写得再细也一个调 | 当时用的克隆分支根本没把指令传给模型 | 确认引擎和模式支持指令;VoxCPM 2 用可控克隆 |
| 3 | 高保真模式写了语气指令 | 写了也没反应 | 高保真克隆会忽略括号指令 | 要调语气,用可控克隆 |
| 4 | 逐字稿不准 | 开头有杂音、漏读、冒出参考里的字 | 参考音频和逐字稿对不上 | 用 ASR 转写后人工逐字核对,标点照录 |
| 5 | 参考带配乐 | 成片一直有嗡声 | 配乐被当成音色的一部分克隆 | 人声分离 + 降噪 + 频谱检查 |
| 6 | 参考太短、句中截断 | 音色不稳,开头怪 | 7 秒且没在句末结束 | 8--15 秒,句末结束,尾部留静音 |
| 7 | 整篇一次生成 | 越读越快、嗡声、停不下来 | 长文本本身不稳定 | 每段 ≤100 字,只在句末切 |
| 8 | 声音设计每次换人 | 第二段和第一段不像同一个人 | 设计模式本就有随机性 | 设计后挑一条锁成参考,之后全用克隆 |
| 9 | 句尾被吃字 | "多试几遍"丢了"遍" | 把声母前的闭塞静音当成句尾 | 从字尾往后找静音,裁完再识别一次 |
| 10 | 机器质检误报 | 正常男声被判"嗡声" | 列举时音高稳定,看起来像一条线 | 看停顿里线还在不在:嗡声在,音高不在 |
| 11 | 英文读不清 | 中文识别能过,英文耳朵听不懂 | 中文模型对英文发音有限 | 少用英文,用中文说法或译名 |
| 12 | 多音字、声调读错 | 小将→小江,一气呵成→仪器合成 | 模型对上下文读音判断不稳 | 避开、同音字替换、换种子、人耳终审 |
| 13 | 数字乱读 | 版本号、年份读法奇怪 | MLX 版没有数字规范化 | 稿子里写成汉字 |
| 14 | 并行反而更慢 | 两个进程比一个还慢,还被系统杀 | 显存和内存争用 | 单进程按顺序跑 |
| 15 | 只看许可证"开源"就商用 | 默认引擎其实不能商用 | OmniVoice 权重是 CC-BY-NC | 商用选 VoxCPM 2(Apache-2.0),并核对每个模型的许可 |
还有一条不算坑,算心得:克隆自己的声音,技术上满分,不一定适合正式内容。 选声音要用真实内容试听。
第九部分:最终效果
- 音色:两款主力声音(一男一女)参考清理后,嗡声、底噪消失。女声重新生成后的试听反馈是"音色接近,杂音也消失了",整篇通过。
- 稳定:同一个参考加固定种子,结果可复现。11 分钟长片全程是同一个"人"。
- 质检 :
- 每段都过"嗡声 / 停顿 / 削波 / 语速"的信号门禁和 ASR 对稿,结尾一个字都不能少;
- 不过关自动换种子;
- 最近一部片子 21 句旁白,经过换种子和一处改写,20 句通过机器对稿,剩下 1 句只差声调,留给人耳确认。
- 速度:M3 Max 上高保真克隆(步数 10)接近实时,生成 1 分钟旁白约 1 分钟。
- 成本 :除了电脑和电费,没有按字数、按月的费用;稿子和录音不离开本机。
- 成片:我们用这套流程交付了多部手绘口播视频,比如《用一天,重启你的人生》《错话,该不该翻译?》,最长一部约 11 分钟。
机器质检只能发现明显故障,不能代替听感。每部片子最后一定要完整听一遍。
第十部分:合规------这条比技术更重要
- 只克隆本人或获得授权的声音。 VoxCPM 2 官方明确禁止冒充、诈骗和虚假信息。不要克隆明星、主播、平台音色,也不要用别家 TTS 的输出当参考。
- 发布时标注 AI 生成。 按《人工智能生成合成内容标识办法》,在平台上发布 AI 合成的语音内容,应当主动声明。各平台一般都有"AI 生成"标签,勾上即可。
- 分清三种许可:应用的许可(VoiceStudio 是 AGPL-3.0)、模型的许可(VoxCPM 2 是 Apache-2.0,OmniVoice 是 CC-BY-NC)、声音本身的授权。三者各管各的。
- 我们自己的做法:两款"逼真"声音的原始参考只放在本机个人声音库,不随开源包分发。开源包里附带的是 4 款纯靠文字描述设计出来的合成声音,不涉及任何真人。
常见问题
Q:没有好显卡、也没有 Apple Silicon Mac,能用吗?
能用,但慢:VoiceStudio 0.5.7 有纯 CPU 版本。偶尔做几十秒配音,也可以先用 VoxCPM 官方的在线体验页。注意,在线体验时稿子和录音会上传到远端。
Q:参考音频用 MP3 可以吗?
官方支持 WAV、FLAC、MP3。但要洗参考的话,建议转成 WAV 处理,别只改文件后缀。
Q:我想要四川话、粤语怎么办?
VoxCPM 2 支持 9 种中文方言,但正文要写成方言用词 ,用普通话的写法效果会差。例如粤语:(广东话,中年男性)伙計,唔該一個A餐...。
Q:同一个声音,能不能让它开心一点、严肃一点?
用可控克隆:在 VoiceStudio 里填风格,或在代码里加 instruct。高保真克隆不吃指令。
Q:长期用,怎么让音色更稳?
两条:
- 永远用同一份洗干净的参考,加固定种子;
- 需要更高一致性,可以用官方的 LoRA 微调。官方说 5--10 分钟的录音就够起步,我们还没用到这一步。
Q:官方说长文本出杂音可以把 cfg 调到 1.5,为什么我调了没效果?
如果你用的是 MLX 移植版,它强制 cfg 不低于 2.0,调低不会生效。我们的解法是分段。
写在最后
回头看,我们花时间最多的地方不是"选哪个模型",而是三件朴素的事:
- 把参考音频洗干净;
- 把长稿切成短段,一段一段地检查;
- 在写稿时就避开多音字、英文和数字的坑。
模型会越来越强,这三件事却一直有用。希望这篇能帮你少走我们走过的弯路。
如果你在实践中遇到新的坑,欢迎留言交流。也欢迎试试我们的开源项目 sweety-handdraw-video,它已经把本文的整条配音流水线内置了。
参考资料(核对日期 2026-10-30)
- VoxCPM:GitHub · Releases · 模型卡 · 用法指南 · 声音设计食谱 · FAQ · 在线体验
- VoiceStudio:GitHub · v0.5.7 发布说明 · 中文 README · VoxCPM2 引擎文档 · mlx-audio 引擎文档
- mlx-audio:GitHub · VoxCPM2 说明 · 8-bit 权重
- OmniVoice 模型许可:k2-fsa/OmniVoice