前言
上篇文章中,笔者拆解了 DeepSeek Harness 的插件机制,认识了它的插件底座 Cordis,厘清了插件、Bundle、Profile 的生命周期概念,并通过一个带 Tool 注册的插件,走通了"插件加载 → 服务注入 → 工具注册 → 模型调用"的完整链路。
简单来说,DeepSeek Harness 的插件机制可以归纳为两件事:
- Cordis 负责插件加载与生命周期管理;
- 每个插件通过
apply(ctx)向共享上下文挂载逻辑。
不过,掌握这些基础知识后,真正动手写插件时,大家马上又会遇到两个绕不开的问题:
- 如果多个插件要复用同一段逻辑,该怎么写?难道每个插件都要复制一份吗?
- 如何在插件中注册钩子函数,以便在特定流程中执行额外逻辑?
这两个开发问题正好对应 DeepSeek Harness 插件体系中的两条扩展线:服务 与事件监听。前者负责"提供能力",后者负责"插入行为"。本篇文章就来详细讲清楚这两个扩展概念,大家一起来学习吧~
一、服务:不同插件之间的"共享能力"
1.1 为什么会出现服务?
用一句话概括服务就是挂载在上下文 ctx 上的具名能力(如 ctx.myService)。其他插件只需通过 inject: ['myService'] 声明所需服务,就能直接使用该能力,不需要 import 提供方的代码。
那为什么会出现服务呢?原因很简单:逻辑复用 。假设大家写了两个工具:工具 A 做"总结会话",工具 B 也做"总结会话",只是参数略有不同。按照上篇文章介绍的工具编写思路,大家很可能写出两份几乎一样的逻辑。哪天摘要规则要改,就得改两处。
而使用服务的基本思路是:把逻辑本身做成一个服务,工具只做薄壳 。服务实现 summarize(sessionId),工具 A 和工具 B 都只负责把模型传来的参数转发给 ctx.myService.summarize(...),逻辑只有一份,工具只是入口。
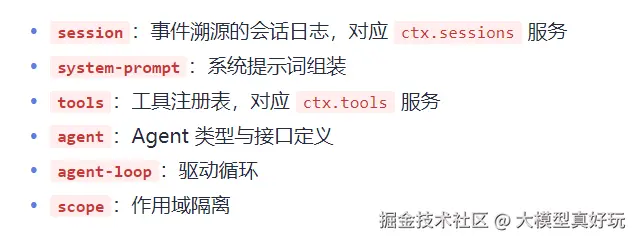
其实DeepSeek Harness 官方也为服务和工具划清了边界:工具给模型用,服务给同进程的插件和工具用 。工具是"单次执行"的入口,服务则可以暴露任意方法。大家还记得 DeepSeek Harness 源码中的 /packages/core 包含 6 个核心服务吗?其他各种插件都可以利用这些服务提供的方法实现各种各样的功能。
1.2 定义服务的最小样板
理解服务的设计理念和基本概念后,下面从实际代码出发,看看如何编写一个服务。一个最小化的服务样板如下:
typescript
import { Context, Service } from '@deepseek-ai/cordis'

declare module '@deepseek-ai/cordis' {
  interface Context {
    myService: MyService   // 让 ctx.myService 有类型
  }
}

export class MyService extends Service {
  static inject = ['sessions']  // 服务自己也可以依赖别的服务

  constructor(ctx: Context) {
    super(ctx, 'myService')     // 注册名称,其他插件按这个名找
  }

  async summarize(sessionId: string): Promise<string> {
    return '...'                // 真实逻辑:读会话、调 llm、返回摘要
  }
}

export async function apply(ctx: Context) {
  await ctx.plugin(MyService)
}
上述代码采用类模式编写了一个服务,其中几个关键点值得注意:
super(ctx, 'myService')构造函数表示将myService注册为一个服务。构造函数执行完,ctx.myService就已经挂载完成,其他插件可以按名称取用。async summarize(sessionId: string):这是服务定义的方法,其他注入该服务的插件可以直接调用。Service子类本身也是插件,所以仍然需要定义apply方法,并通过ctx.plugin(MyService)挂载插件。这和基本的插件加载方式完全一致。
定义好这个服务之后,其他插件就可以使用该服务的方法了。在 DeepSeek Harness 体系中,使用服务不需要 import MyService这个类,只需要在inject里声明即可:
typescript
export const inject = ['myService']

export function apply(ctx: Context) {
  // 能走到这里,说明 myService 已经就绪
  ctx.myService.summarize('some-session-id')
}
DeepSeek Harness 底层的 Cordis 会保证:在 inject 里列出的服务全部就绪之前,apply 方法不会执行。插件的加载顺序并不重要,真正决定启动顺序的是插件之间的依赖关系。如果运行期间 myService 的提供方被卸载,依赖它的插件会自动被dispose,等到服务重新出现时再加载,因此不会出现"插件还在跑,但服务已经被卸载"的悬空调用。看到这里,大家对DeepSeek Harness插件体系的理解是不是更上一层楼了?
1.3 将服务变成可调用对象
如果设计的一个服务本质上只有"一个动作",而不是"一组方法"的集合,那么可以使用服务的生命周期钩子[Service.invoke]来定义。这样就能使用ctx.myService(...),而不是ctx.myService.method(...)来实现功能。举个例子:
typescript
export class Logger extends Service {
  get [Service.invoke]() {
    return (msg: string) => this.log(msg)
  }
  log(msg: string) { /* ... */ }
}按如上方式定义服务后,使用ctx.logger('hello')就相当于调用ctx.logger.log('hello')。Harness 内置的ctx.logger()就是这种形态。
除了[Service.invoke]这个特殊的服务生命周期钩子,服务还有[Service.init]、[Service.check]等各种生命周期钩子,这里笔者不再详解,大家具体可参阅 DeepSeek Harness 服务 文档。
1.4 实战代码案例:总结会话服务+依赖服务工具
上面笔者讲的是骨架,下面落到一个具体场景,让大家看清"服务做逻辑、工具做薄壳"的设计意义。
假设要给 DeepSeek Harness 加一个能力:把一段会话总结成摘要。需求有两个入口:模型可以主动调用一个工具来总结;另外还想要一个"归档"工具,生成更详细的摘要并写入文件。未来还可能有一个"会话空闲时自动生成摘要"的后台行为。
如果按照"工具即逻辑"的写法,大家会写出两份几乎一样的代码:读会话历史、拼 Prompt、调 LLM、返回。归档工具除了重复类似逻辑,还要再多一段写文件操作。当摘要规则需要修改时,大家就得修改多个工具的实现。这正是典型的"需要抽取公共服务"的信号。下面就来实现一下。
第一步:创建开发目录
在源码仓库~/deepseek-harness 根目录下创建开发目录scratch-plugin,在开发目录中创建src目录用来编写源码,同时创建一个cordis.yml文件作为覆盖层挂载,启动时用--patch指向它。
第二步:编写服务插件summary-service.ts
新建scratch-plugin/src/summary-service.ts,继承Service编写SummaryService服务,提供总结能力,同时SummaryService也依赖ctx.sessions和ctx.llm等服务提供的能力:
typescript
// scratch-plugin/src/summary-service.ts
import { Service } from '@deepseek-ai/cordis'
import type { Context } from '@deepseek-ai/cordis'
import { BlockAssembler, createUserMessage } from '@deepseek-ai/dsh-llm'
import type { ContentBlock, GenerateOptions, Message } from '@deepseek-ai/dsh-llm'
import { SessionId } from '@deepseek-ai/dsh-session'
declare module '@deepseek-ai/cordis' {
  interface Context {
    summaryService: SummaryService
  }
}

export interface SummaryOptions {
  maxLength?: number
  style?: 'brief' | 'detailed'
  forceRefresh?: boolean
}

/** Hard cap on transcript characters sent to the summarizer. */
const MAX_TRANSCRIPT_CHARS = 24_000
/** Per-message cap so one huge tool dump cannot crowd out the rest. */
const MAX_MESSAGE_CHARS = 2_000

/** Join the text blocks of one message; other block kinds are not transcript text. */
function messageText(blocks: readonly ContentBlock[]): string {
  const parts: string[] = []
  for (const block of blocks) {
    if (block.type === 'text') parts.push(block.text)
  }
  return parts.join('\n').trim()
}

/** Clamp one string to a character budget. */
function clamp(text: string, limit: number): string {
  return text.length <= limit ? text : `${text.slice(0, limit)}...`
}

/** Render a derived history as a role-prefixed transcript, keeping the newest tail on overflow. */
function renderTranscript(history: readonly Message[]): string {
  const lines: string[] = []
  for (const message of history) {
    const text = messageText(message.content)
    if (text.length === 0) continue
    lines.push(`${message.role.toUpperCase()}: ${clamp(text, MAX_MESSAGE_CHARS)}`)
  }
  const joined = lines.join('\n\n')
  if (joined.length <= MAX_TRANSCRIPT_CHARS) return joined
  // Keep the tail: the latest turns describe the current state of the work.
  return `...\n${joined.slice(joined.length - MAX_TRANSCRIPT_CHARS)}`
}

/** Turn a terminal finish reason into an auxiliary-call failure. */
function finishError(finish: { kind: string; failure?: { message?: string; code?: string } }): Error | undefined {
  switch (finish.kind) {
    case 'stop':
      return undefined
    case 'error':
    case 'aborted': {
      const error = new Error(finish.failure?.message ?? '摘要模型调用失败')
      if (finish.failure?.code !== undefined) (error as Error & { code?: string }).code = finish.failure.code
      return error
    }
    case 'max-tokens':
      return new Error('摘要输出达到 maxTokens 上限,请调大 max_length')
    default:
      return new Error(`摘要模型返回了不支持的结束原因 "${finish.kind}"`)
  }
}

export class SummaryService extends Service {
  static inject = ['sessions', 'llm']
  private cache = new Map<string, string>()

  constructor(ctx: Context) {
    super(ctx, 'summaryService')
  }

  async summarize(sessionId: string, options: SummaryOptions = {}): Promise<string> {
    const { maxLength = 200, style = 'brief', forceRefresh = false } = options
    const cacheKey = `${sessionId}:${style}:${maxLength}`
    if (!forceRefresh && this.cache.has(cacheKey)) {
      return this.cache.get(cacheKey)!
    }

    // `sessions.get()` takes a branded id and may miss.
    const session = this.ctx.sessions.get(SessionId(sessionId))
    if (session === undefined) throw new Error(`summary: 找不到会话 ${sessionId}`)

    // The session log already records the exact route its turns ran on, so the
    // summarizer reuses it instead of needing provider/model configuration.
    const header = session.requestHeader()
    const provider = header?.config.provider
    const model = header?.config.model
    if (provider === undefined || model === undefined) {
      throw new Error(`summary: 会话 ${sessionId} 还没有 request/header,无法确定 provider/model`)
    }

    const transcript = renderTranscript(session.deriveMessages())
    if (transcript.length === 0) throw new Error(`summary: 会话 ${sessionId} 没有可总结的文本消息`)

    const system = style === 'brief'
      ? `用不超过 ${maxLength} 字的中文总结下面这段 AI 编码助手会话:概括用户的诉求、已完成的工作、得到的结论和尚未解决的问题。只输出摘要正文。`
      : '详细总结下面这段 AI 编码助手会话,用中文分节写出:会话目标、按轮次的关键动作与工具调用、发现的问题与根因、当前状态、未完成事项。只输出摘要正文。'
    const maxTokens = style === 'brief'
      ? Math.min(4_096, Math.max(512, maxLength * 6))
      : 4_096

    const messages: Message[] = [createUserMessage({
      content: [{ type: 'text', text: transcript }],
      source: { kind: 'plugin', plugin: 'scratch-plugin/summary-service' },
    })]
    const request: GenerateOptions = {
      provider,
      model,
      messages,
      system,
      maxTokens,
      sessionId: session.id,
    }

    // `ctx.llm` is streaming-only: assemble it instead of expecting `complete()`.
    const assembler = new BlockAssembler()
    for await (const chunk of this.ctx.llm.stream(request)) assembler.push(chunk)

    const finish = assembler.finish
    const summary = assembler.blocks()
      .filter((block): block is Extract<ContentBlock, { type: 'text' }> => block.type === 'text')
      .map(block => block.text)
      .join('\n')
      .trim()

    if (finish.kind !== 'stop' && finish.kind !== 'max-tokens') {
      throw finishError(finish) ?? new Error('summary: 摘要模型调用失败')
    }
    if (summary.length === 0) {
      throw finishError(finish) ?? new Error('summary: 摘要模型没有产出文本')
    }

    this.cache.set(cacheKey, summary)
    return summary
  }

  invalidate(sessionId: string) {
    for (const key of this.cache.keys()) {
      if (key.startsWith(`${sessionId}:`)) this.cache.delete(key)
    }
  }
}

export async function apply(ctx: Context) {
  await ctx.plugin(SummaryService)
}
static inject = ['sessions', 'llm']意味着SummaryService会等这两个内置服务就绪后再启动。super(ctx, 'summaryService')执行完,ctx.summaryService就已挂载到插件树上,其他插件可以通过inject: ['summaryService']取用。
第三步:编写工具summary-tools.ts
新建scratch-plugin/src/summary-tools.ts,把快速总结和详细归档两个工具放在同一个文件里。工具只做参数翻译和转发,不包含摘要逻辑,摘要逻辑全部依赖SummaryService服务:
typescript
// scratch-plugin/src/summary-tools.ts
import { writeFile } from 'node:fs/promises'
import type { Context } from '@deepseek-ai/cordis'
import { defineTool } from '@deepseek-ai/dsh-tools'

export const name = 'summary-tools'
export const inject = ['summaryService', 'tools']

export function apply(ctx: Context) {
  // 工具一:快速总结
  ctx.tools.register(defineTool({
    name: 'summarize_session',
    description: '总结指定会话的内容',
    parameters: {
      session_id: { type: 'string', required: true, description: '要总结的会话 ID' },
      max_length: { type: 'number', description: '摘要最大字数,默认 200' },
    },
    output: {
      schema: { type: 'string' },
      render: (_args, value) => [{ type: 'text', text: value }],
    },
    async execute(args) {
      const summary = await ctx.summaryService.summarize(args.session_id, {
        maxLength: args.max_length,
      })
      return summary
    },
  }))

  // 工具二:详细归档摘要
  ctx.tools.register(defineTool({
    name: 'archive_session',
    description: '生成会话的详细归档摘要并保存到文件',
    parameters: {
      session_id: { type: 'string', required: true },
      output_path: { type: 'string', required: true, description: '归档文件的写入路径' },
    },
    output: {
      schema: { type: 'string' },
      render: (_args, value) => [{ type: 'text', text: value }],
    },
    async execute(args) {
      const summary = await ctx.summaryService.summarize(args.session_id, {
        style: 'detailed',
        forceRefresh: true,
      })
      // `node:fs/promises` rather than a `ctx.fs` service: this plugin injects none.
      await writeFile(args.output_path, `${summary}\n`, 'utf8')
      return `归档摘要已写入 ${args.output_path}`
    },
  }))
}
inject: ['summaryService', 'tools'] 保证这个工具插件在SummaryService服务和工具运行时都就绪后才执行。defineTool负责类型推断和字段校验,execute返回的字符串会被render包成工具结果卡片,这个和上篇文章讲解的内容一致。
第四步:编写cordis.yml配置文件
编写配置文件scratch-plugin/cordis.yml:
yaml
- insert:
    - id: summary-service
      name: '/home/sandui/deepseek-harness/scratch-plugin/src/summary-service.ts'
    - id: summary-tools
      name: '/home/sandui/deepseek-harness/scratch-plugin/src/summary-tools.ts'
第五步:启动并验证服务
-
在
~/deepseek-harness目录下执行pnpm dsh web --patch ./scratch-plugin/cordis.yml。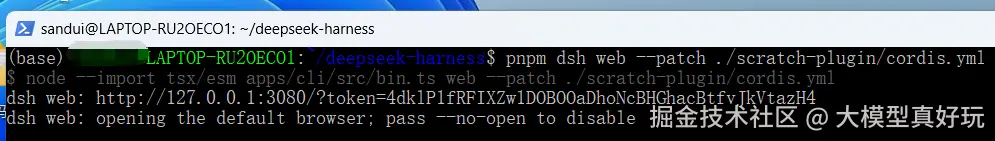
-
在Web UI里新建会话聊几句,拿到session id。
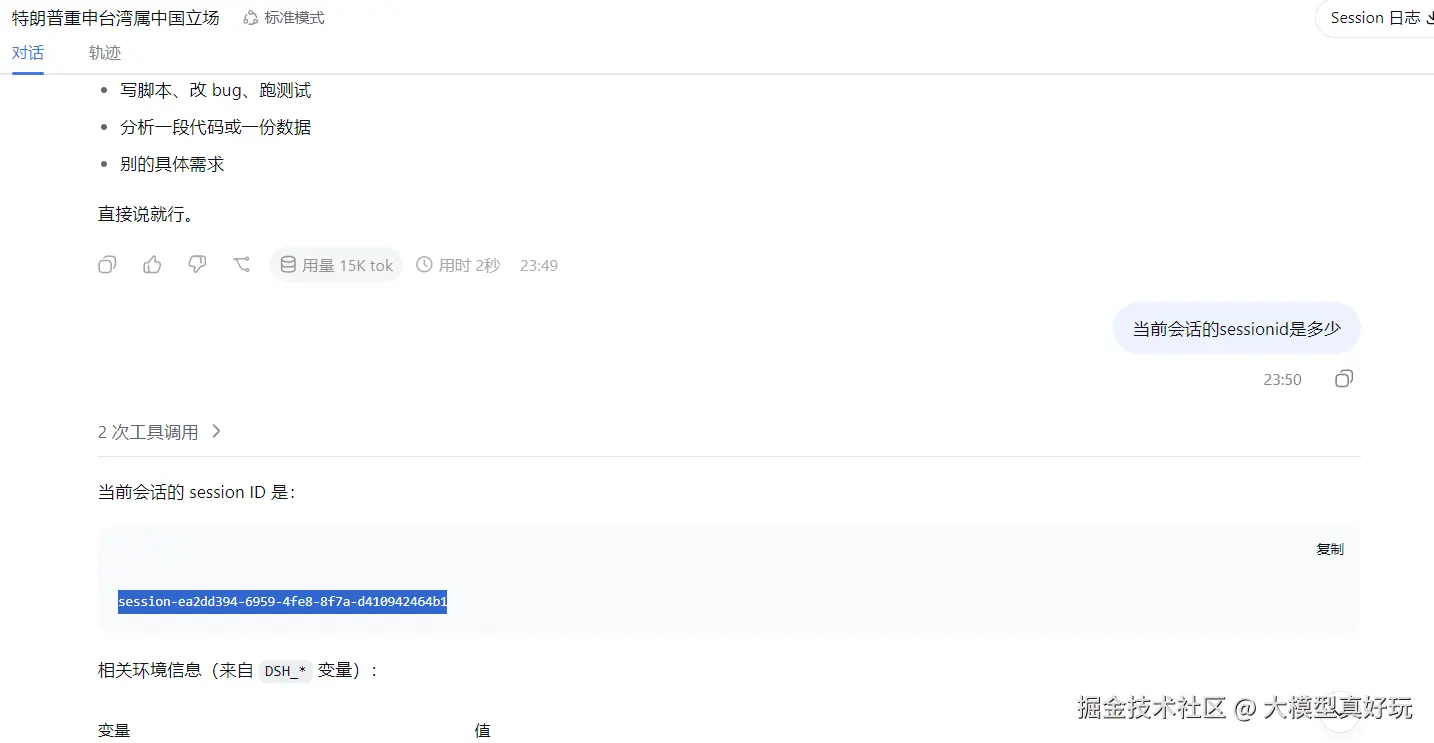
-
对模型说"请调用工具总结我的
<session id>会话内容",可以看到智能体调用了刚刚编写的summarize_session和archive_session两个工具。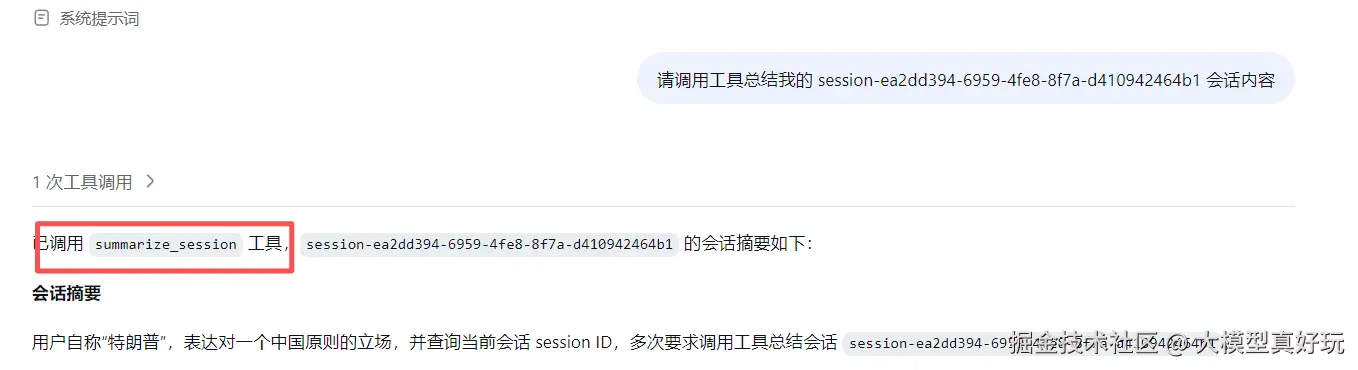
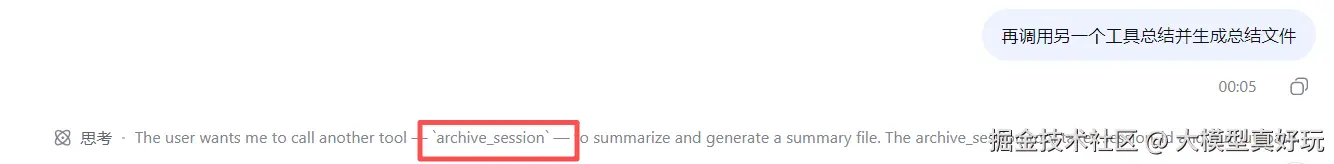
通过以上代码,相信大家已经理解了DeepSeek Harness服务的设计理念:不同工具和插件共享同一份逻辑,这正是服务的真正意义。
二、事件监听:在执行流程中挂钩子
如果大家看过笔者 LangChain DeepAgents 系列中的 LangChain1.0速通指南(三)------LangChain1.0 create_agent api 高阶功能,可能会感叹其中间件钩子设计得非常巧妙。DeepSeek Harness 同样提供了大量钩子:通过 ctx.on(event, handler),插件可以挂到会话、工具、Agent 的生命周期上去定制一些行为。
2.1 事件监听的基本形态
下面通过 session/created 和 tools/post-execute 的示例代码来理解事件监听的基本形态。
typescript
import { Context } from '@deepseek-ai/cordis'

export const name = 'event-watcher'

export function apply(ctx: Context) {
  // session/created钩子,在会话创建的时候执行, 只观察,不干涉
  ctx.on('session/created', (session) => {
    console.log('New session:', session.id)
  })

  // 门禁:执行前拦截
  ctx.on('tools/pre-execute', async (execution, next) => {
    if (execution.name === 'forbidden_tool') {
      return { kind: 'deny', reason: 'This tool is forbidden by policy' }
    }
    return next()   // 放行给后续监听器
  })

  // 改写:执行后加工结果
  ctx.on('tools/post-execute', async (execution, result, next) => {
    const decision = await next()
    // 检查 result,附加信息,或者修改 decision
    return decision
  })
}
通过 ctx.on 指定具体钩子,再传入一个处理函数,就能在钩子触发时执行操作。ctx.on安装的处理函数还有一个很好的性质:插件卸载时自动清理 。大家不需要手动 off,Cordis 会把注册当作"可逆的副作用"来管理,非常方便。
2.2 事件的分发模式
DeepSeek Harness底层定义了多种可监听事件,下面简单列出一些:
| 作用域 | 事件 |
|---|---|
| agent 生命周期 | agent/created /disposed /status /session-start;waterfall 的 /pre-step /request /request-error;/turn-stopping、agent/inbox/* |
| 会话 | session/created /disposed /event /flush |
| 工具流水线 | tools/pre-execute execute post-execute、tools/code-dispatch-log、tools/result |
| 跨域 | fs/edit-intent fs/write-intent、llm/stream、approval/request、goal/changed、settings/document-updated、credentials/reference-updated、commands/change |
需要注意的是,不同事件的分派模式并不相同,这意味着 ctx.on(event, handler) 中 handler 的处理逻辑也会不同。DeepSeek Harness 主要有以下五种分派模式:
| 模式 | 是否 await | 监听器怎么跑 | 有返回值? | 典型场景 |
|---|---|---|---|---|
emit |
否 | 按注册顺序,只观察 | 否 | agent/error 日志 |
waterfall |
否 | 链式,通过 next() 往下传 |
是 | tools/pre-execute 门禁 |
parallel |
是 | 全部并行,等最慢的 | 否 | session/flush |
serial |
是 | 按顺序串行,等上一个完成 | 是 | 某些 agent 顺序步骤 |
bail |
否 | 按顺序,第一个有效返回值就停 | 是 | 短路决策 |
其中最需要注意的是waterfall模式。它的语义是"环绕中间件",如果你了解 LangChain 的中间件机制,理解起来会简单一些,它就像笔者在 LangChain不支持AgentSkills?那就从0到1实现一个! 中介绍的 wrap_model 等中间件类别。它的处理器参数是 (...args, next),next() 负责把控制权放行给下游处理逻辑。如果处理器实现过程中不调用 next(),就会直接短路,不再执行后续处理链。这就是前端开发常说的"洋葱模型":next() 执行完成后,结果会返回当前层,还可以对结果进行包装处理。之所以叫洋葱模型,是因为处理器像一层皮,next() 是往里剥,返回值是往外包。没有设计模式概念的同学理解起来可能会绕一些,但日常最常用的两个事件钩子tools/pre-execute(工具执行前执行)和 tools/post-execute(工具执行后改写结果)------都是 waterfall 模式。下面是一个简单示例:
typescript
ctx.on('tools/pre-execute', async (execution, next) => {
  // 下游(包括默认的 allow 逻辑)的结果会从这里回来
  const downstream = await next()

  // 你可以在放行之前"包一层":比如记录耗时、附加审计信息
  return downstream
})
2.3 实战代码案例:工具调用护栏插件
上面的理论知识还是有一点难理解。笔者的风格一直是:模式讲完,还得落到一个真实形态,才看得清怎么用。
一般的 Harness 工程都会加一个护栏,通常做两件事:
- 执行前拦截 :模型要调高风险工具(比如
shell_execute且命令里带rm -rf)时,直接拒绝,不让它跑; - 执行后脱敏:任何工具返回的内容里如果混进了 API key、邮箱、手机号,打码后再交给模型。
这两件事都是"挂到别人的流程上",不需要改任何现有工具的代码,这正是事件监听的典型用法。
第一步:pre-execute 门禁:决策型处理器,可以短路
typescript
// guardrail.ts
export const name = 'guardrail'

const DANGEROUS_PATTERNS = [/rm\s+-rf\s+\//, /mkfs\./, /dd\s+if=/]

export function apply(ctx: Context) {
  ctx.on('tools/pre-execute', async (execution, next) => {
    // 决策型监听器:命中规则就直接短路,不调 next()
    if (execution.name === 'shell_execute') {
      const command: string = execution.args.command ?? ''
      if (DANGEROUS_PATTERNS.some(p => p.test(command))) {
        return { kind: 'deny', reason: `Blocked dangerous command: ${command}` }
      }
    }
    // 没命中,放行给下游(包括默认的 allow 逻辑)
    return next()
  })
}这里最关键的一行是return next()。tools/pre-execute是waterfall模式:处理器 handler 函数只是洋葱的一层,next() 把控制权交给下游,下游的决策(allow 或后续监听器的 deny)通过返回值回到处理器中。决策型处理器在拥有决策权时短路,是设计意图 ;但务必注意:如果大家只是想看一眼、不打算改变决策,却忘了next(),就会把后面所有监听器和默认逻辑全部误杀。这是 waterfall 里最常见的 bug。
第二步:post-execute 改写:在结果返回模型之前加工
typescript
const SECRET_PATTERNS: Array<[RegExp, string]> = [
  [/sk-[A-Za-z0-9]{20,}/g, 'sk-***REDACTED***'],
  [/[\w.+-]+@[\w-]+\.[\w.]+/g, '***@***.***'],
  [/1[3-9]\d{9}/g, '1**********'],
]

function redact(text: string): string {
  return SECRET_PATTERNS.reduce((acc, [re, mask]) => acc.replace(re, mask), text)
}

export function apply(ctx: Context) {
  ctx.on('tools/post-execute', async (execution, result, next) => {
    // 先让下游(默认的结果组装逻辑)跑完,拿到最终决策
    const decision = await next()

    // 只改"成功返回"的内容;deny 等决策原样放行
    if (decision.kind === 'allow' && typeof decision.content === 'string') {
      return { ...decision, content: redact(decision.content) }
    }
    return decision
  })
}这是waterfall的"环绕"写法:await next() 先剥到最里层,拿到下游的返回值,再在往外返回的路上做加工。改写型处理器的逻辑实现一般都是这样:先 next(),再包装 。注意decision.kind === 'allow'这个判断:如果上游某个门禁已经deny了,你不需要也不应该去脱敏一个不存在的结果。
看到这里,大家对事件监听的理解应该就比较清楚了。更多事件用法可以参考 dsh 事件机制 文档。
以上就是本篇文章的全部内容。本期完整源代码可关注笔者的同名微信公众号 大模型真好玩 ,私信 dsh插件 即可获得。
三、总结
这篇文章把插件体系中"服务"和"事件"两条扩展线梳理清楚了:
- 服务负责"提供能力" :把可复用逻辑抽成服务,让逻辑只有一份,状态也有合法的承载容器;工具只做参数翻译和转发的薄壳。
- 事件监听负责"插入行为" :通过钩子观察、拦截、改写或短路执行流程。绝大多数"行为扩展"的入口都是
ctx.on,而不是去改别人的代码。
到这里,插件机制从加载、生命周期,到服务与事件的基本原理就告一段落了。接下来笔者会转向实战,分享自己在日常工作中使用DeepSeek Harness的具体用法,帮大家真正把智能体用起来,服务于自己的工作与生活。
如果大家觉得有收获,欢迎点赞、收藏,关注我的专栏《DeepSeek Harness 从入门到进阶》,后续更新不错过。下篇见!更多精彩内容,如果大家感兴趣,欢迎关注笔者的掘金账号与专栏,也可关注笔者的同名微信公众号大模型真好玩,每期分享涉及的代码均可在公众号私信。