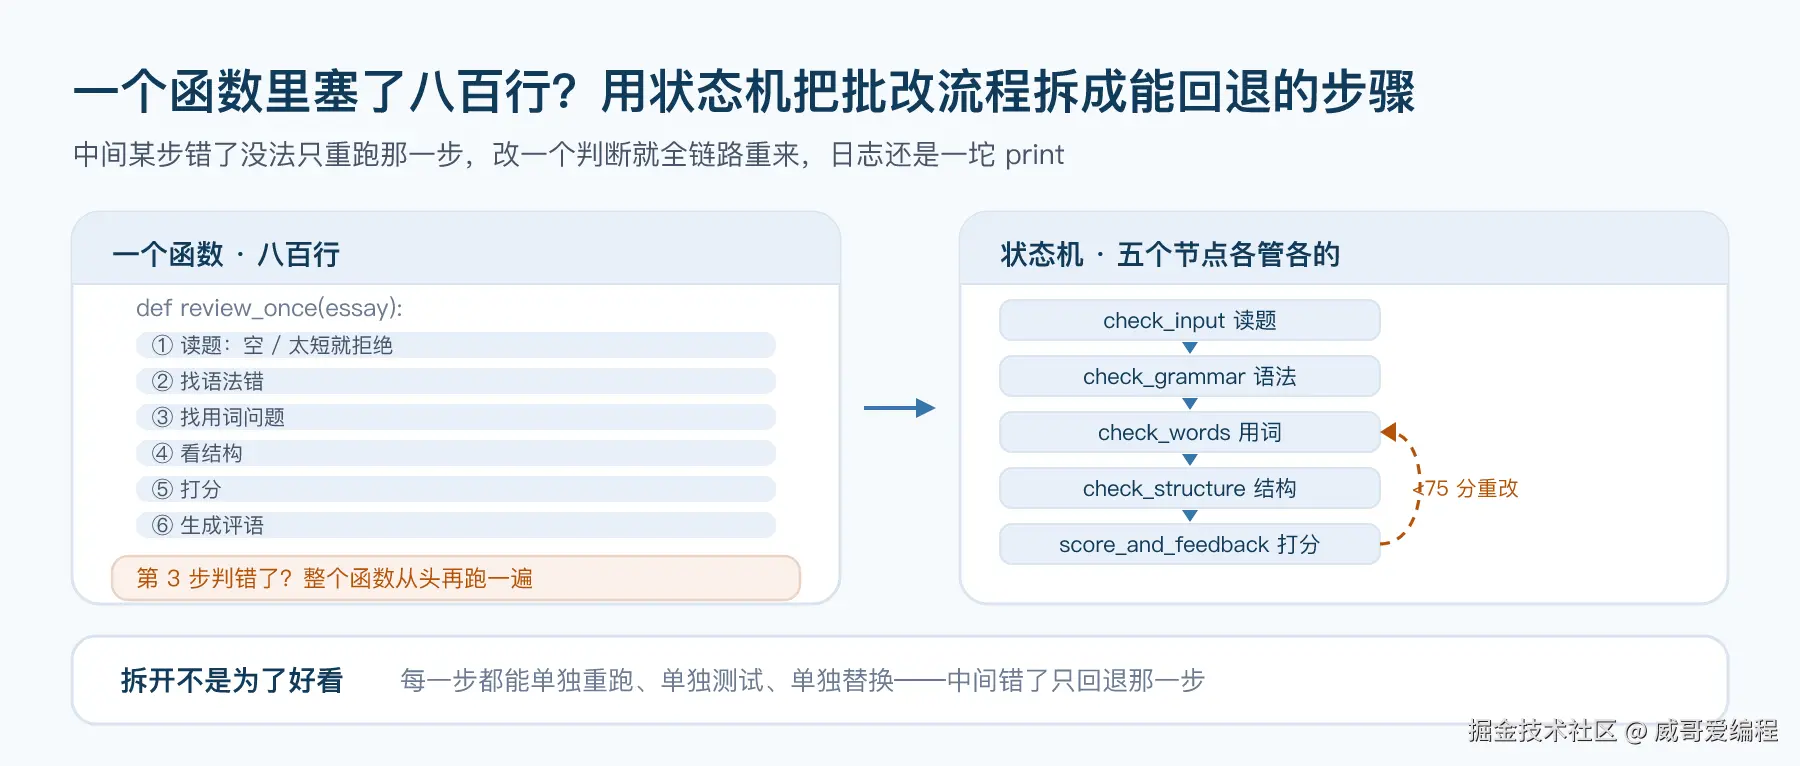
上周启明英语的助教"小E"上线了作文批改,第一天就出了两单事故。
一单是打分接口超时。批改流程是"读题 → 找语法错 → 找用词问题 → 看结构 → 打分 → 生成评语",前四步都跑完了,卡在打分上。负责这版的学员在电话里跟我说的原话是:"没办法,只能整个函数再跑一遍,前面四步的 token 就当白花了。"
另一单更冤:产品说用词检查的判断要改一行,他改完不敢直接上线------因为那行判断埋在一个八百行的 review_once() 函数中间,旁边就是打分逻辑和评语拼接,他没法只验证"用词"这一步,只能把全部历史作文喂进去跑全链路回归,跑了一下午。
我看了那个函数。六步逻辑、三层循环嵌套、十七个中间变量、二十几条 print。它不是不能跑,而是每一步的结果都装在局部变量里,出了问题既不能回退到那一步,也不能单独重跑那一步。
这一篇做的事就一件:把这条流水线交给状态机。你会看到同一个批改流程怎么拆成五个节点、怎么接上一条"分数不够就回炉重改"的循环、怎么保证循环不会失控烧钱、以及怎么在跑到一半时停下再接着跑。
一、先扫盲:流程图和状态机差在哪
多数人画过流程图,但没用过状态机,两者很容易混。
流程图是给人看的,状态机是给程序走的。 流程图画完就贴在墙上;状态机在运行时真的持有"我现在处于哪个状态",并且每走一步都在改这个状态。差别在需求变化时爆发:产品说"打分低于 75 就回炉重改",在函数里这意味着再嵌一层 while、再判断几个标志位、中间变量作用域互相纠缠;在状态机里这就是加一条边------从"打分"节点拉一条线回"查用词"节点,完事。
LangGraph 把状态机拆成三件套,术语必须先记住:
| 概念 | 是什么 | 在本篇里 |
|---|---|---|
| State | 图中流动的那份数据,所有节点共享读写 | EssayState:作文、两份问题清单、点评、分数、评语、次数 |
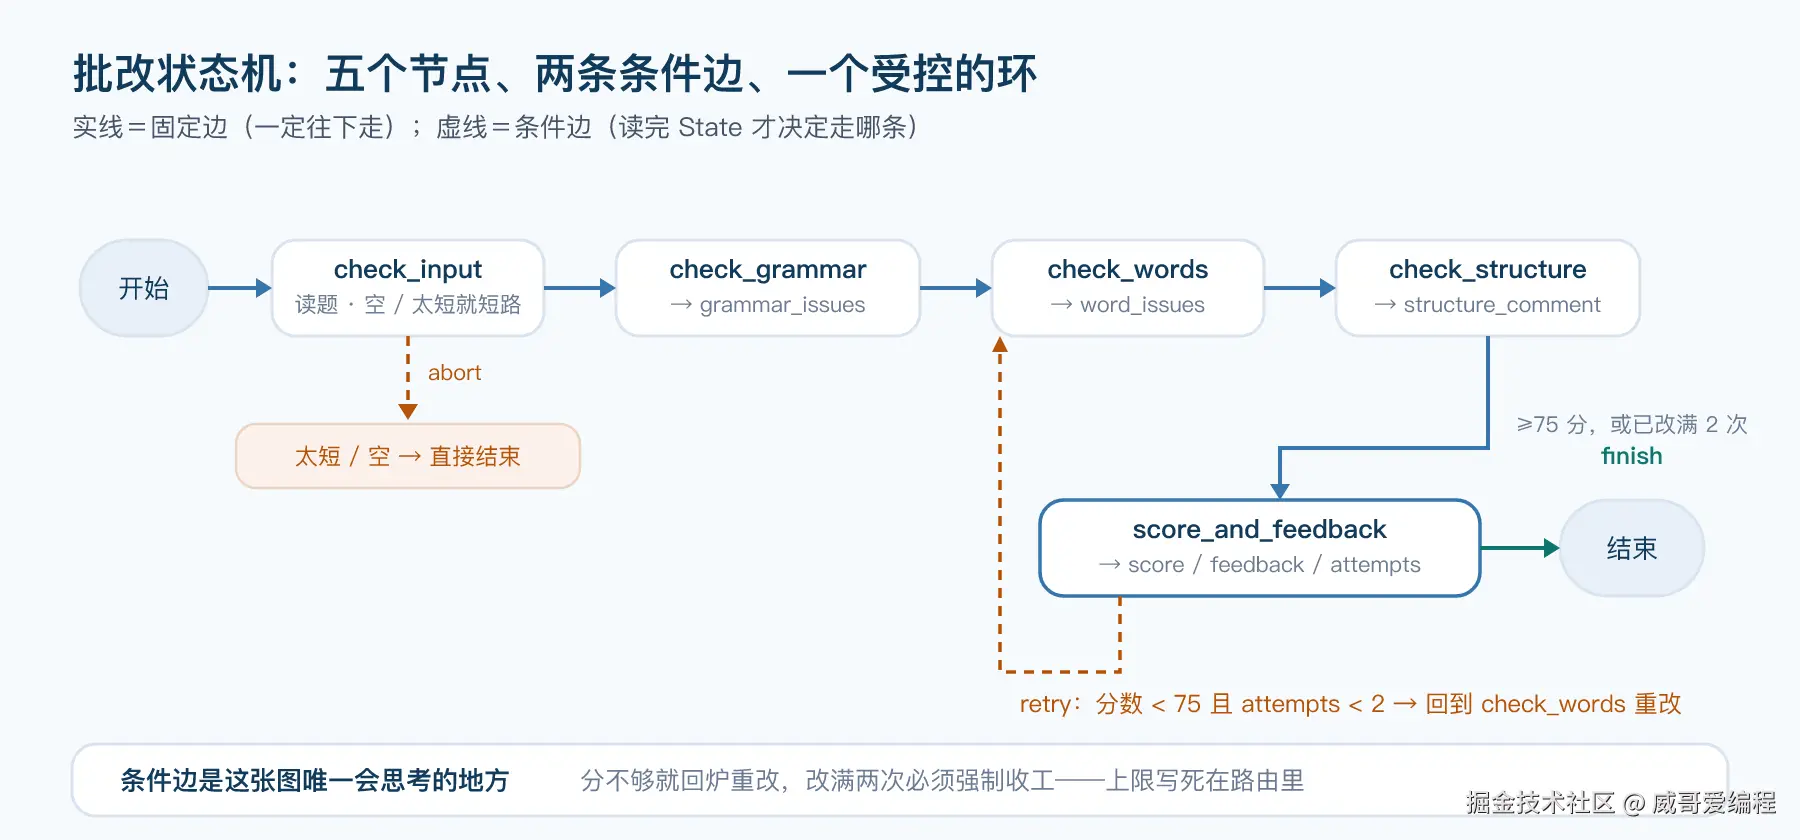
| Node | 一个函数:进 State,返回"部分更新" | 五个节点:check_input / check_grammar / check_words / check_structure / score_and_feedback |
| Edge | 节点之间怎么走 | 固定边(一定走)+ 条件边(读完 State 才决定) |
两个本篇的重头戏:
条件边(add_conditional_edges)。 普通边写死"A 完了去 B";条件边挂一个路由函数,每次节点跑完,拿当前的 State 问它"下一步去哪"。回炉重改、入口短路,都是条件边。
循环 + 次数上限。 有了条件边就能画出环:分数低于 75 就回到 check_words 重改。但环必须带刹车------一篇怎么改都不及格的作文,会让图永远转下去,每一圈都是真金白银。所以路由函数里有两个条件:分数不够且重改次数没到上限,才允许回去。
条件边还有个容易被略过的细节:add_conditional_edges 的第三个参数是张映射表,路由函数返回什么字符串,就走映射表里对应的去处,映射表里没登记的返回值直接报错。这等于把"所有可能的去向"显式列了一遍------在函数里,if 分支漏写一个 else 只会静默跳过,在图里则当场爆炸。我更喜欢后者。
checkpoint(MemorySaver + thread_id)。 编译图时挂一个 MemorySaver,每次运行用 thread_id 标记,LangGraph 会自动把每一步的 State 存下来。跑到一半想停下?换个 thread_id 就是全新一次,同一个 thread_id 再 invoke 就接着上次的状态跑。批改到一半要人工确认、服务重启要续跑,靠的都是它。
还有一件事必须先掰清:State 不是"上帝变量"。 上帝变量是一个谁都能写、什么时候被改了没人知道的大字典;State 是一份有主人的契约------每个字段写明了归哪个节点管、新值是替换还是追加。分配原则就一句:每个节点只写自己那几个字段,别碰别人的。
二、工程目录
沿用系列的工程结构,settings.py 和 llm.py 与第 1 篇完全一致,原样复用:
bash
06-LangGraph编排/
├── src/
│   ├── settings.py   # 复用第 1 篇
│   ├── llm.py        # 复用第 1 篇:真模型 / 离线假模型 两条通路
│   ├── state.py      # EssayState:整张图唯一的数据契约
│   ├── nodes.py      # 五个节点纯函数 + build_nodes(llm) 工厂
│   ├── graph.py      # 装配:节点、边、条件边、循环、mermaid 导出
│   └── run_graph.py  # 运行入口:结果 + 走过的节点顺序
├── tests/            # 40 个用例,离线全绿
├── demo.py           # 三条路径各走一遍
└── pytest.ini / requirements.txt / README.md / .env.example / .gitignore
分层一句话讲完:state 定契约,nodes 干活,graph 定路线,run_graph 负责把结果和路径一起交出来。
三、先写契约:state.py
图还没搭,我先写 State。这是整个工程最重要的决定------中间结果不再藏在局部变量里,而是摊开成一份所有人都能看到的结构。八百行函数改不动的根因就在这:你想知道"用词问题存哪个变量",只能从头读到底。
python
class EssayState(TypedDict):
    """一次作文批改在图中流动的全部数据。"""

    # ── 输入 ──
    essay: str

    # ── 各节点的产出(覆盖语义)──
    grammar_issues: list[str]      # 由 check_grammar 写
    word_issues: list[str]         # 由 check_words 写
    structure_comment: str         # 由 check_structure 写
    score: float                   # 由 score_and_feedback 写
    feedback: str
    attempts: int                  # 打过几次分,循环的刹车片
    error: str                     # 入口判死的硬错误,非空即短路

    # ── 累加字段(Annotated + add)──
    errors: Annotated[list[str], add]   # 节点内部异常,谁出事谁追加
    trace: Annotated[list[str], add]    # 走过的节点名,按顺序累积
重点讲 覆盖 vs 累加,这是 LangGraph 状态合并的核心规则:
- 没写
Annotated的字段一律覆盖。 节点返回什么,字段就变成什么。score、feedback、word_issues都该这样------回炉重跑一次,就该拿全新的结果,绝不能和上一轮的旧答案拼在一起。 - 写了
Annotated[..., add]的字段按 reducer 合并。errors和trace必须累加:每个节点各追加自己的那一条,后跑的节点没有权力清掉先跑的记录。要是用覆盖语义,你会发现trace里永远只剩最后一个节点------等于没有日志。
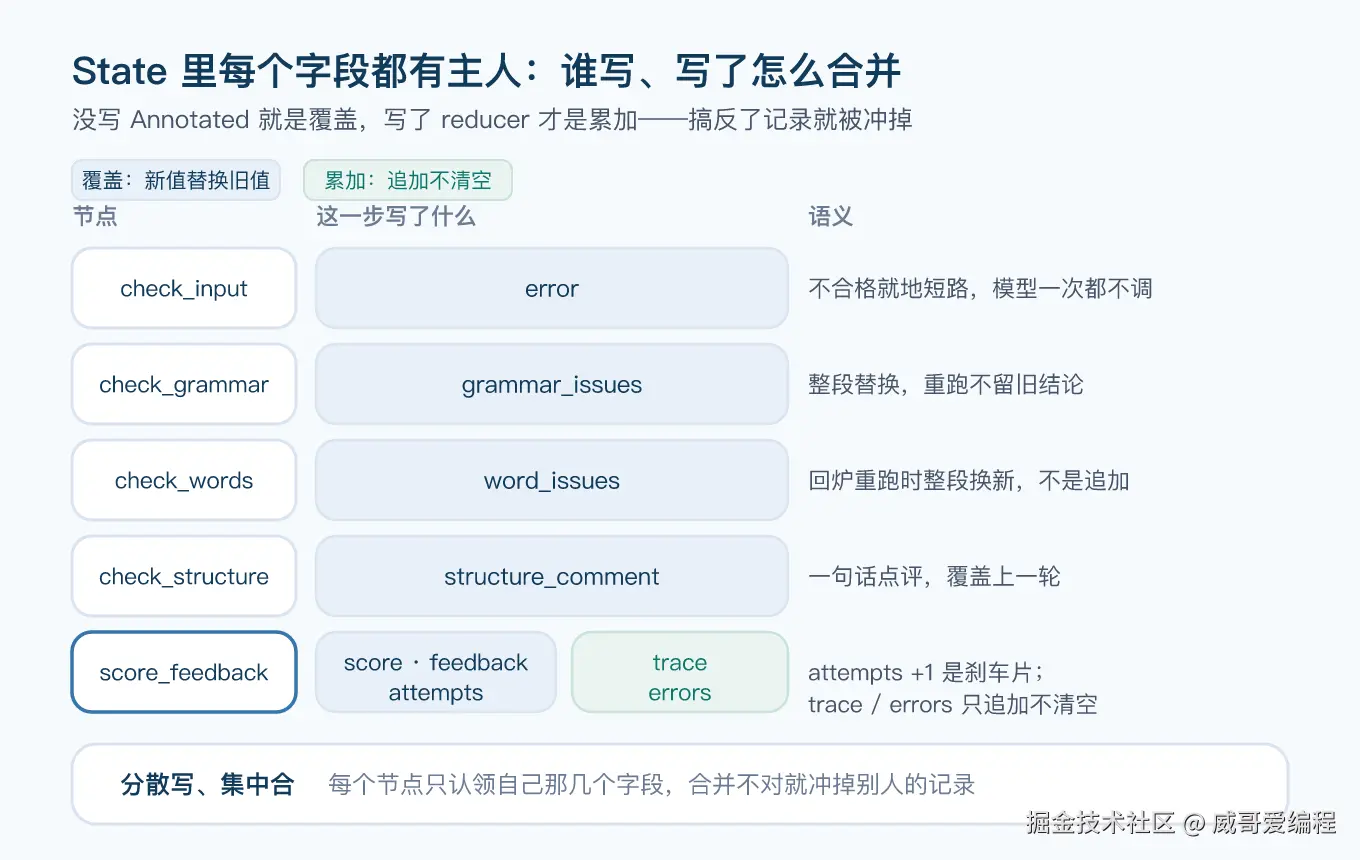
配套还有个 empty_state() 工厂,给每个字段一个安全的初始值。它存在的原因很小但很疼:累加字段的初始值必须是空列表 ------节点里要往 trace 里追加,初始值是 None 的话第一次 append 就是 AttributeError;而覆盖字段给空值,是为了节点里 state.get("score", 0.0) 拿到的永远是数字而不是 None,别让字符串拼接在深夜炸给你看。
字段旁边我全部写了注释声明"由谁写"。这不是装饰------后来测试里真有一条"每个节点只写自己那几个字段"的断言,就是照着这份注释写出来的。
四、五个节点:nodes.py
节点只有三条硬规矩:入 State、出"部分更新" dict;内部调模型必须 try/except 转 errors 字段;节点不知道下一步是谁。
先看最简单的入口节点:
python
def check_input(state: EssayState) -> dict:
    """入口节点:先挡掉没写作文就提交的情况,一个 token 都不浪费。"""
    essay = (state.get("essay") or "").strip()
    if not essay:
        return {"error": "作文是空的,没法批改。", "trace": ["check_input"]}
    if len(essay) < MIN_ESSAY_LEN:
        return {"error": f"作文太短了({len(essay)} 字,至少 {MIN_ESSAY_LEN} 字)。",
                "trace": ["check_input"]}
return {"error": "", "trace": ["check_input"]}两个设计决定。其一,返回 dict 而不是整个 State :返回值里写着"我只改了 error 和 trace",一眼看清,也不会误伤别的字段。其二,硬错误就地短路------空作文和三句话的作文不值得花六个模型调用,在这里判死,后面的节点压根不会执行。
再看核心的 score_and_feedback,它身上有两个容易写错的点:
python
def score_and_feedback(state: EssayState) -> dict:
    """打分 + 写评语,同时把 attempts +1。"""
    human = (
        f"作文原文:\n{state.get('essay', '')}\n\n"
        f"语法问题:\n" + "\n".join(f"- {item}" for item in grammar) + "\n\n"
        f"用词问题:\n" + "\n".join(f"- {item}" for item in words) + "\n\n"
        f"结构点评:{structure}"
    )
    try:
        reply = llm.invoke([SystemMessage(SCORE_SYSTEM), HumanMessage(human)])
        score = _parse_score(str(reply.content))
        feedback = _split_feedback(str(reply.content))
    except Exception as exc:
        # 打分失败也算一次尝试:score 保持空缺,路由会送它去重改,
        # 而不是把一篇没分的作文当成"已完成"交出去。
        return {
            "trace": ["score_and_feedback"],
            "attempts": state.get("attempts", 0) + 1,
            "errors": [f"score_and_feedback 调用失败:{type(exc).__name__}: {exc}"],
        }
    return {
        "trace": ["score_and_feedback"],
        "score": score,
        "feedback": feedback,
        "attempts": state.get("attempts", 0) + 1,
    }
第一,异常转字段,不抛到图外。 模型超时、Key 失效、输出乱七八糟,都是运行时常态。异常抛出去,整条批改链路直接崩,前面三步白跑;转成 errors 字段,图继续往下走,最后一起交账。八百行函数时代,一个 try 包住全部六步,出了错你根本不知道是第几步炸的------现在每个节点自己兜自己。
第二,失败也算一次尝试。 attempts + 1 写在 except 分支里,这不是顺手为之:打分失败如果不算次数,路由就会认为"还有预算",让一篇永远打不出分的作文无限重试。
还有一处值得单说:回炉那轮的 check_words 必须带着上一轮的评语去问模型,否则它会吐出一模一样的清单------循环空转,跑两次花两份钱,结论一点没变:
python
if attempts > 0:
    human = (
        f"作文原文:\n{essay}\n\n"
        f"上一轮评语:{state.get('feedback', '')}\n"
        f"上一轮用词问题:{state.get('word_issues', [])}\n"
        "请针对上一轮的评语重新检查用词,给出不同的结论。"
    )
另外,五个函数都包在 build_nodes(llm) 工厂里而不是直接拿全局模型------测试时传假模型、生产时传真模型,节点代码一行不改。这个习惯从第 2 篇沿用到第 5 篇,这里依然成立。
五、接线:graph.py
节点是散的,图把它们串起来。先看两条路由函数------条件边的大脑:
python
def route_after_check_input(state: EssayState) -> str:
    """入口节点之后的路由:作文不合格就直接收工。"""
    return GO_ABORT if state.get("error") else "check_grammar"


def route_after_score(state: EssayState) -> str:
    """打分之后的路由:分不够、次数也没用完,才回 check_words。"""
    if state.get("score", 0.0) < PASS_SCORE and state.get("attempts", 0) < MAX_ATTEMPTS:
        return GO_RETRY
    return GO_FINISH
route_after_score 里的两个条件缺一不可 :score < PASS_SCORE 是"有没有必要重改",attempts < MAX_ATTEMPTS 是"还有没有预算"。少了后者,一篇怎么改都低分的作文会让图永远转下去。上限 MAX_ATTEMPTS = 2 是常量,写死在 state.py,不放在哪个节点手里。
装配本体:
python
builder = StateGraph(EssayState)
for name in NODE_NAMES:
    builder.add_node(name, nodes[name])

builder.set_entry_point("check_input")
builder.add_conditional_edges(
    "check_input", route_after_check_input,
    {"check_grammar": "check_grammar", GO_ABORT: END},
)
builder.add_edge("check_grammar", "check_words")
builder.add_edge("check_words", "check_structure")
builder.add_edge("check_structure", "score_and_feedback")
builder.add_conditional_edges(
    "score_and_feedback", route_after_score,
    {GO_RETRY: "check_words", GO_FINISH: END},
)

graph = builder.compile(
    checkpointer=checkpointer if checkpointer is not None else MemorySaver(),
    interrupt_before=interrupt_before,
)读法从上到下:add_node 挂五个节点;set_entry_point 定入口;主干三步用普通边串成一条线;两条条件边分别管"入口短路"和"回炉循环"。compile() 之后这张图就能 invoke 了。
build_graph(llm) 做成工厂,默认送一个 MemorySaver 当 checkpointer。每个用例调一次工厂,就拿到一张全新的图和全新的记忆库,thread_id 之间互不串味。还留了 interrupt_before 参数:想让图跑到某个节点前先停下来等人确认,传一个节点名列表就行。
最后送一个白嫖的福利:
python
def get_mermaid(graph) -> str:
    """导出 mermaid 流程图文本,可直接粘进 Markdown 渲染。"""
    return graph.get_graph().draw_mermaid()
图改了文档不用手动画------一行代码把当前拓扑导成 mermaid 文本。下面第四节的真实输出里有它跑出来的样子。
六、运行入口:run_graph.py
排障时你要问的从来不是"最后这分是多少",而是"它到底走了哪几步、在哪一步拐的弯 "。所以 run_review 把路径和结果一起交出来:
python
def run_review(essay: str, llm, thread_id: str = "essay-default") -> dict:
    graph = build_graph(llm)
    config = {"configurable": {"thread_id": thread_id}}
    final = graph.invoke({"essay": essay}, config=config)

    return {
        "path": list(final.get("trace", [])),   # 走过的节点顺序
        "score": final.get("score", 0.0),
        "feedback": final.get("feedback", ""),
        "grammar_issues": final.get("grammar_issues", []),
        "word_issues": final.get("word_issues", []),
        "structure_comment": final.get("structure_comment", ""),
        "attempts": final.get("attempts", 0),
        "error": final.get("error", ""),
        "errors": final.get("errors", []),
    }
path 的三种形状对应三种结局:五个节点排一列是正常走完;中间多出一段 check_words → check_structure → score_and_feedback 是回炉过;只有 ["check_input"] 是入口短路。日志里一眼可辨,不再需要考古 print。
除了跑完拿结果,还有一个边跑边看的口子 iter_steps:它用 graph.stream(stream_mode="updates") 把每个节点刚写回的那段更新逐个 yield 出来。demo 里那些"每步状态快照"就是它打的------打印这件事归调用方管,节点保持纯函数,比在五个节点里各埋一条 print 干净得多。
七、跑起来:真实输出
python demo.py(离线模式,不联网、不需要 Key,模型回答是预置脚本):
ini
──────────────────────────────────────────────────
案例一 · 正常批改:一次走完全流程
──────────────────────────────────────────────────
作文原文:Last weekend I go to the park with my friends. W...

【每步状态快照】
  ▸ check_input          error=(空)
  ▸ check_grammar        grammar_issues=2 条
  ▸ check_words          word_issues=1 条
  ▸ check_structure      structure_comment=开头交代了时间地点,点题清楚。中间缺少过渡句。
  ▸ score_and_feedback   score=82.0, feedback=意思表达完整,时态错误集中在第一句。, attempts=1

【结果】
  走过路径:check_input → check_grammar → check_words → check_structure → score_and_feedback
  打分次数:1
  最终得分:82.0
案例二,三句话的作文,入口直接判死:
ini
  ▸ check_input          error=作文太短了(3 字,至少 20 字)。
  走过路径:check_input
  拒绝原因:作文太短了(3 字,至少 20 字)。
案例三,第一轮 52 分不及格,回炉重改一轮后 61 分------还是不及格,但重改预算用完了,图在这里强制收工:
ini
  ▸ score_and_feedback   score=52.0, feedback=语法错误较多,建议重写后再提交。, attempts=1
  ▸ check_words          word_issues=1 条
  ▸ check_structure      structure_comment=段落之间加了过渡,但结尾仍然没收住。
  ▸ score_and_feedback   score=61.0, feedback=比上一轮有进步,时态和语序仍需重点练习。, attempts=2

  走过路径:check_input → check_grammar → check_words → check_structure → score_and_feedback → check_words → check_structure → score_and_feedback
  打分次数:2
注意路径末尾那一段回环------它就是那条条件边真实存在过的证据,不是画在图上看的。
八、真实 pytest 输出
arduino
tests/test_state.py::test_all_required_fields_exist PASSED
tests/test_state.py::test_empty_state_has_no_none_values PASSED
tests/test_state.py::test_errors_and_trace_are_annotated_for_accumulate PASSED
tests/test_state.py::test_score_and_feedback_are_plain_overwrite PASSED
tests/test_nodes.py::test_check_input_rejects_empty_essay PASSED
tests/test_nodes.py::test_check_input_rejects_too_short_essay PASSED
tests/test_nodes.py::test_check_grammar_parses_three_issues PASSED
tests/test_nodes.py::test_check_words_retry_round_sends_previous_feedback PASSED
tests/test_nodes.py::test_score_exception_still_counts_as_one_attempt PASSED
tests/test_graph.py::test_happy_path_visits_every_node_once PASSED
tests/test_graph.py::test_mermaid_contains_all_node_names PASSED
tests/test_graph.py::test_short_essay_is_short_circuited_at_entry PASSED
tests/test_graph.py::test_loop_never_exceeds_max_attempts PASSED
tests/test_graph.py::test_same_thread_id_resumes_from_checkpoint PASSED
tests/test_graph.py::test_interrupt_before_then_resume_with_same_thread PASSED
tests/test_edges.py::test_score_branch_retries_when_score_is_low PASSED
tests/test_edges.py::test_score_branch_finishes_when_budget_is_used_up PASSED
tests/test_run_graph.py::test_run_review_reports_the_retry_in_path PASSED

40 passed in 0.81s
40 个用例全绿,全程离线。这组测试我最想让你注意三条:
test_loop_never_exceeds_max_attempts :脚本让模型永远给低分,断言图必须停下来、attempts 停在 2。防死循环不是一句口头承诺,是一条会红的测试。
test_same_thread_id_resumes_from_checkpoint :同一个 thread_id 连续 invoke 两次,断言第二次的 trace 比第一次长、而且前缀完全一致------状态真的被 checkpoint 记住了,换了 thread_id 就互不干扰。
test_interrupt_before_then_resume_with_same_thread :编译时传 interrupt_before=["score_and_feedback"],第一次 invoke 停在打分前(前三步的结果都在、分数还没写),然后 graph.invoke(None, config) 传 None 接着跑,分数补上了。中断续跑的四行代码,一条测试验证完。
剩下的大头给了单节点测试 :check_input 的三种输入、清单解析去序号、"无明显语法错误"当空清单、分数解析的兜底和钳位、四个节点各自的异常转字段、还有一条"节点不许改入参"的纯函数断言(深拷贝一份 State 传进去,跑完比较是否原样)。这些测试都不需要图、不需要编排,build_nodes(假模型)["check_grammar"](state) 一行就能调------能这样测,恰恰说明节点里没有藏全局状态,这是当初把 llm 做成工厂参数的回报。
九、踩坑清单
- 节点贪方便返回了整个 State:把别的节点写的字段也原样带回去了,后跑的节点把先跑的结果整个冲掉,最后的评语里"语法问题"莫名消失。LangGraph 的约定就是部分更新------返回值里只写自己改的字段。
- trace 忘了挂
Annotated[..., add]:用覆盖语义跑全链路,trace里只剩score_and_feedback一个节点名,我还以为是图没走完。排查半小时,就是状态合并语义选错了。这也是我把两条合并语义做成专门测试的原因。 - 路由函数只判了分数没判次数 :写第一个故意永远低分的用例时,LangGraph 直接抛了
GraphRecursionError------它默认最多走 25 步,算是框架替我踩了刹车。但生产上不能指望这个:到 25 步时报错等于白烧 25 轮 token,attempts上限必须写在自己的路由里。 - 回炉那轮结论和第一轮一模一样 :循环跑通了,分数一分没涨。原因是
check_words的提示词两轮完全相同,模型当然给同样的答案。把上一轮评语和问题清单贴进第二轮的提示词,重改才真的在"改"。 set_entry_point("check_input")手滑拼错 :拼错的字符串在装配阶段不报错,compile()也不报,一invoke才炸出找不到节点的异常。后来所有节点名收进NODE_NAMES常量元组,graph 和测试都引用它,字符串再也没裸写过。- 中断续跑时给
invoke传了新输入 :我以为"继续跑"要再传一次{"essay": ...},结果作文被重新处理了一遍。正确姿势是传None------LangGraph 会从 checkpoint 里捞出上次的状态接着走,thread_id才是那把钥匙。
十、本篇收尾
回看那个八百行的 review_once():它和现在这张图干的事一模一样,区别只有两个------步骤从局部变量变成了显式的 State,控制流从循环嵌套变成了边和条件边。但就是这两个变化,让"第 3 步改个判断"从全链路回归变成跑一条 check_words 的单测,让打分超时从全部重跑变成从 checkpoint 续跑。
下一篇解决另一个动手能力问题:Function Calling 工具调用 。前面的"小E"只会说话不会做事------问了课时它只能靠编。下一篇让它真的调用 查询课时、查订单 这样的函数,把"会聊天"变成"能查东西"。
最后一句:状态机不是把函数写得更漂亮,它把"哪一步出了错"从一个谜语变成一行日志------能回退的流程,才配得上迭代。