小E 上线第三天,课程顾问来找我,语气不太友好。
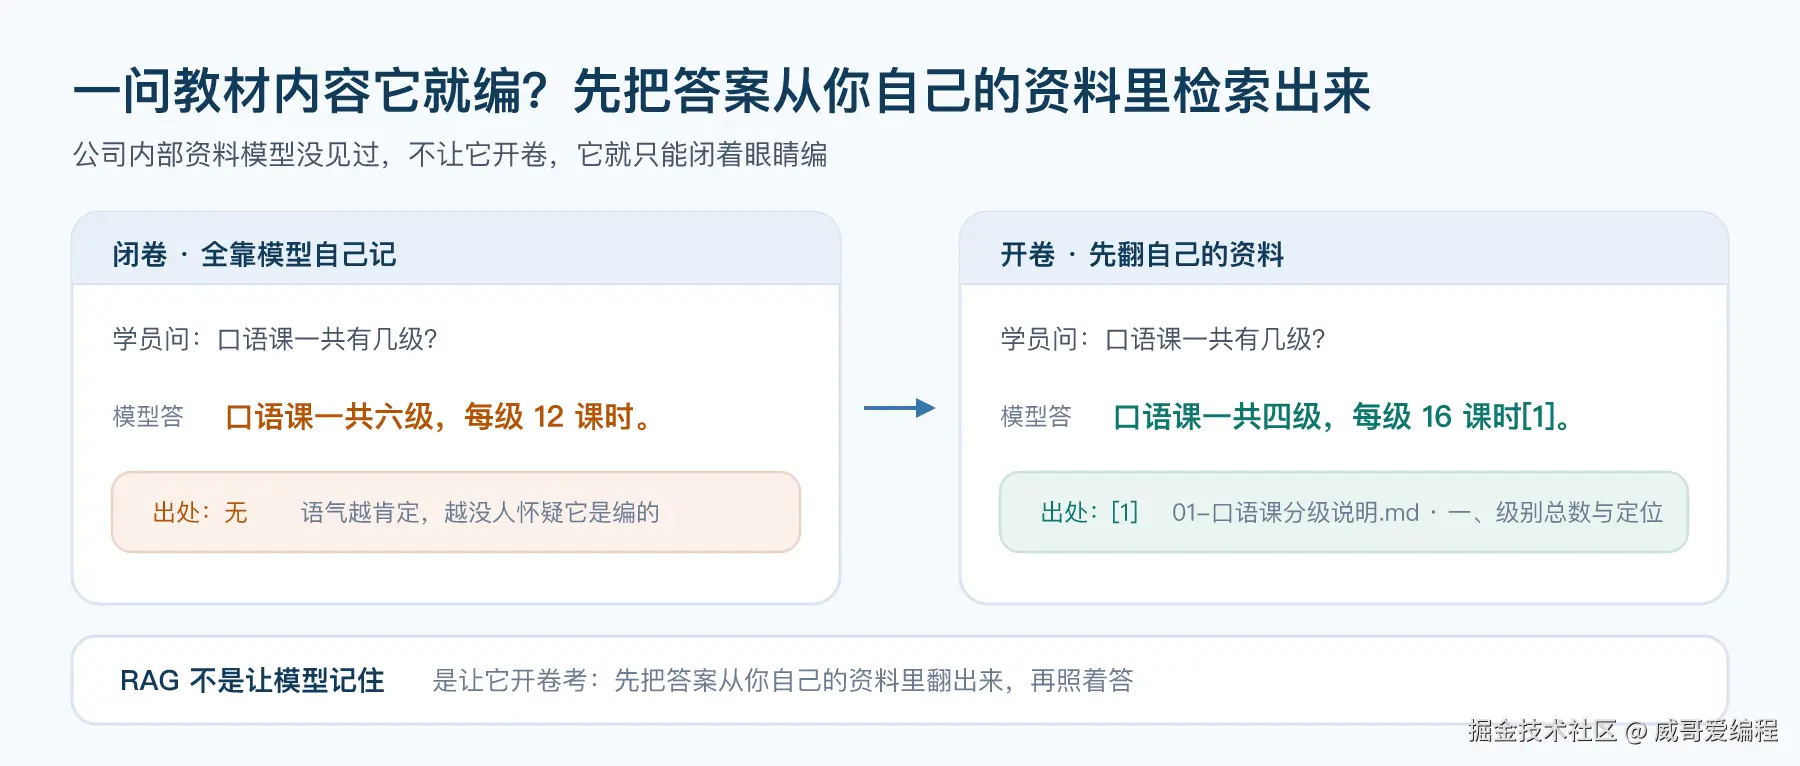
一位学员在 App 里问小E:"启明英语的口语课一共有几级?"小E 回得又快又顺:"一共六级,每级 12 课时,建议从一级开始逐级报读。"学员信了,直接来问四级连报的优惠。顾问只好花十分钟解释:我们只有四级,每级 16 课时,而且没有"逐级报读"这个规定。
同一天下午,另一个学员问退费规则。小E 答:"开课 7 天内可全额退,超过按剩余课时的 80% 退。"这条更危险------80% 这个数字是我们制度里没有的,制度里写的是 5% 手续费。
我把这两段对话拉出来看了一遍,确认问题不在提示词:第 2 篇那套人格模板、第 4 篇那套结构化输出,都老老实实装上了。问题出在更前面一层------这两个问题的答案,根本不在模型见过任何一条语料里,它只能编。而且它编得语法通顺、语气自信、还自带细节,比真话更像真话。
这一篇就解决这件事。
一、先扫盲:RAG 到底在干什么
1. 为什么不能把资料直接贴进 prompt
第一反应都很自然:把口语课说明和退费制度贴到 system prompt 里,不就行了?
我自己试过,两个坎过不去。
第一个坎:装不下。 一份完整的教材动辄几十万字,一份制度汇编加上历史版本能到十几万字。一个模型的上下文窗口是按 token 算的,中文一个字差不多一个 token,十几万字就是十几万 token,很多模型的窗口根本放不下,放得下的那几个也贵得离谱。
第二个坎:贴了也不一定用。 就算装得下,把 10 万字资料和一句提问一起发过去,模型要在 10 万字里自己找那 50 个字。找错了不稀奇,找对了也花了不少输入 token------每一次提问都要付一遍这 10 万字的钱。
所以思路要反过来:不是把整本书都给模型,而是每次只把和这个问题相关的两三段给模型。
2. RAG 的四段
这个"先翻资料再回答"的套路叫 RAG(Retrieval-Augmented Generation,检索增强生成)。LangChain 官方文档把索引阶段拆成四步,和我们的四段一一对应:
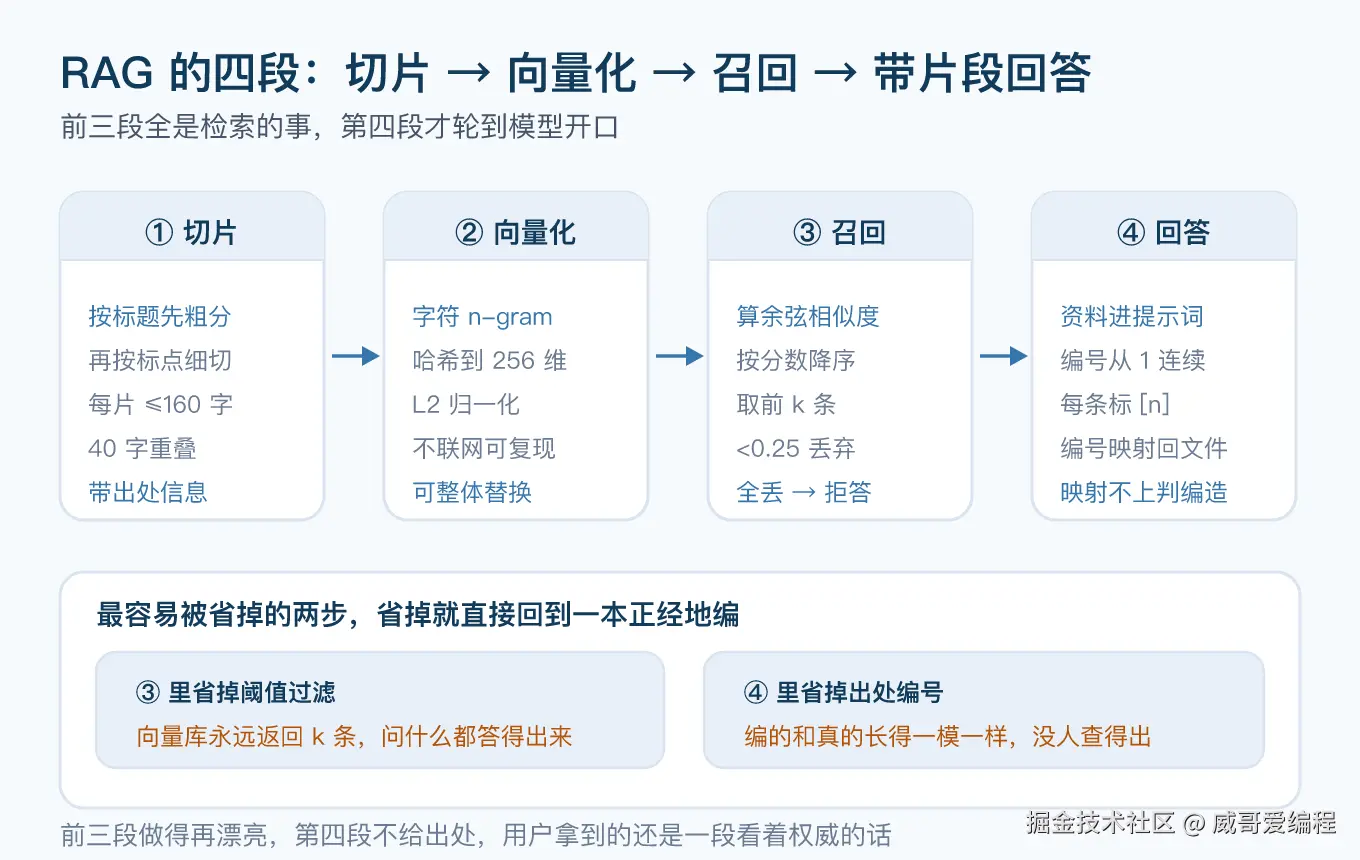
- 切片:把整份资料切成一小段一小段。切法决定后面一切,这一篇的一半篇幅都在讲它。
- 向量化:把每一段变成一个向量------一串数字。意思相近的段落,向量也相近。
- 召回:把提问也变成向量,算它和所有片段的相似度,取最像的几条。
- 带着片段回答:把这几段塞进提示词,让模型照着答,并标出每条结论来自哪一段。
一句话记住它:RAG 不是让模型记住,是让它开卷考。 模型的脑子我们换不掉,但考卷旁边放哪几本书,是我们说了算的。
3. 两个必须先说清楚的事
第一,embedding 接口到底哪家有,请以官方文档为准。 我写这篇的时候专门去查了,也劝你别凭印象断言"某家有没有 embedding 接口"------模型名都会退役,服务列表更会变。所以本工程干脆不依赖任何厂商的 embedding 服务,用一个自己写的确定性实现把链路跑通,要做语义检索时再换成真货。这不是回避问题,是把"依赖谁"变成一个可以随时替换的决定。
第二,RAG 不能保证模型不编。 它只能保证:召回不到东西的时候,你有机会让模型闭嘴。真正把"编"堵死的是两个动作------召回为空就拒答,以及每条结论必须带出处。这两个动作是本篇的硬规则,后面会用测试钉死。
二、工程长什么样
bash
05-RAG检索/
├── docs/                     # 小E 唯一能引用的知识范围
│   ├── 01-口语课分级说明.md
│   ├── 02-退费与转班制度.md
│   └── 03-助教小E使用手册.md
├── src/
│   ├── settings.py           # 复用第 1 篇
│   ├── llm.py                # 复用第 1 篇
│   ├── loader.py             # 切片:读 md → 按标题粗分 → 按标点细切
│   ├── embeddings.py         # 向量化:HashingEmbeddings + 余弦相似度
│   ├── index.py              # 索引:建库、召回、算分
│   ├── rag.py                # 回答:召回 → 过滤 → 拼资料 → 提问
│   └── references.py         # 溯源:[编号] 映射回文件和小节
├── tests/                    # 40 个用例,全程离线
└── demo.py
settings.py 和 llm.py 与前几篇完全一致。新增五个模块,每个只干一件事。
三、切片:先按标题粗分,再按标点细切(loader.py)
切片这一步我最先踩的坑,是想一步到位------拿整篇文档按 200 字一刀切下去。
切出来的东西是这样的:"......单笔最低收取 50 元。示例:学员实付 4800 元报了口"+"语课一级(总课时 16),上了 4 课时后申请退费。"上一段的下半句接下一段的上半句,检索到之后人读不懂,模型也容易串。
所以这里改成两步:先按 markdown 标题粗分,再在每节内部细切。
python
HEADING_RE = re.compile(r"^#{1,6}\s+(.+)$")

def split_by_heading(text: str) -> list[tuple[str, str]]:
    """按 markdown 标题粗分,返回 [(标题, 正文)]。

    标题本身不进正文:
      标题是"导航信息",是给人扫一眼用的,
      而这一段讲什么,正文里自己会说。
      把标题留进正文,每个片段都顶着一行 "# 启明英语 · ...",
      宝贵的 chunk_size 就被这十几个字白白吃掉了。
    """
    sections: list[tuple[str, str]] = []
    title = ""
    body: list[str] = []

    for line in text.splitlines():
        match = HEADING_RE.match(line)
        if match:
            if title or body:                      # 遇到新标题,先把上一节收掉
                sections.append((title, "\n".join(body).strip()))
            title = match.group(1).strip()
            body = []
        else:
            body.append(line)

    if title or body:
        sections.append((title, "\n".join(body).strip()))

    return [item for item in sections if item[1]]
粗分完,每一节已经是"只讲一件事"的正文了。细切用的是经典的递归分隔符算法:先试最粗的分隔符,切完还有超长的片,就换下一级分隔符再切。
python
DEFAULT_SEPARATORS: tuple[str, ...] = ("\n\n", "\n", "。", ",", " ")

def _recursive_split(text: str, separators, chunk_size: int) -> list[str]:
    """递归切,直到每一片都不超过 chunk_size。"""
    separator, rest = _pick_separator(text, separators)
    pieces: list[str] = []

    for part in _split_keep_separator(text, separator):
        if len(part) <= chunk_size:
            pieces.append(part)
        elif rest:
            pieces.extend(_recursive_split(part, rest, chunk_size))
        else:
            pieces.append(part)                    # 切到最细还是长,只能整片留下

    return pieces
两个参数的取舍,我说说我最后怎么定的:
- chunk_size = 160。给中文定的。小了,一个问答对被劈成两半,单独看哪一半都答不出问题;大了,一个片段塞进三四个知识点,召回时"最像的那条"其实只对了三分之一。
- chunk_overlap = 40。块与块之间留 40 字的重叠,目的是接得上------"问:口语课一共有几级?"和"答:四级"如果正好被切在两边,没有重叠就永远召不回同一片。
还有一行必须强调:中文要自己把句号逗号加进分隔符列表 。框架默认那套 ["\n\n", "\n", " "] 是为英文设计的,遇到整段没有换行的中文,会被按单字硬切。
说明一下:
RecursiveCharacterTextSplitter在独立包langchain-text-splitters里(已列入 requirements.txt)。我为了让整套代码在没有外网的机器上也能跑通,按同样的算法写了一份零依赖实现放在loader.py里,装上那个包之后把split_text()换成splitter.split_text()即可,下游一行不用改。
每个片段都会带上出处信息,这是后面溯源的全部基础:
python
chunks.append(Document(
    page_content=piece,
    metadata={"source": path.name, "heading": heading, "chunk": index},
))
三份 md 切完是 21 个片段,平均 91 字。
四、向量化:一个离线、可复现的 Embeddings(embeddings.py)
这一层是我全篇最想讲清楚的设计点。
LangChain 把"把文字变向量"这件事抽象成了 Embeddings 接口,只要实现两个方法就能接入所有检索组件:
python
class HashingEmbeddings(Embeddings):
    """哈希版 Embeddings:确定性、离线、零依赖。"""

    def __init__(self, dim: int = DEFAULT_DIM, max_n: int = 2) -> None:
        self.dim = dim
        self.max_n = max_n

    def embed_documents(self, texts: list[str]) -> list[list[float]]:
        """批量向量化,索引阶段用。"""
        return [embed_one(text, dim=self.dim, max_n=self.max_n) for text in texts]

    def embed_query(self, text: str) -> list[float]:
        """单条向量化,查询阶段用。"""
        return embed_one(text, dim=self.dim, max_n=self.max_n)
它的原理是哈希技巧:把文字拆成字符 n-gram,每个 n-gram 哈希到向量的某一维上累加,最后 L2 归一化。不需要训练、不需要词表、不需要联网,同一段文字永远得到同一个向量。
为什么要费劲写这个?因为我需要一个能写测试的向量化器。任何依赖外部服务的组件,测试结果都受服务端影响:模型升级、服务抖动、配额用完,测试就红了,而你什么都没改。这一篇有 40 个用例要断言"召回的第 1 条就是那一段",前提是向量化必须可复现。
写它的过程中我踩了一个很隐蔽的坑:第一版用的是 Python 内置的 hash()。本地跑得好好的,换台机器召回结果全变------内置 hash() 对字符串的结果受 PYTHONHASHSEED 影响,同一个字符串换个进程就换个值 。后来换成了 hashlib.blake2b,才把"可复现"三个字坐实。
它的边界也要说清楚:它只认字面重叠,不认语义。"退费"和"退款"在它眼里是两个词。真要上线,请换成真正的语义向量服务------而换成真货时代码长这样:
python
store = build_index(chunks, embeddings=你自己的Embeddings())index.py、rag.py、references.py 一行都不用动。因为它们只依赖 Embeddings 这个抽象,不依赖任何具体实现。这就是依赖倒置:高层不依赖低层,两边都依赖抽象。 这一条是我认为 RAG 工程里最值得提前做的决定,没有之一。
五、索引:InMemoryVectorStore 与一个 numpy 的坑(index.py)
存储用的是 LangChain 自带的 InMemoryVectorStore,几十个片段的规模完全够:
python
def build_index(chunks: list[Document], embeddings: Embeddings | None = None) -> InMemoryVectorStore:
    """用片段建一个内存向量库。"""
    store = InMemoryVectorStore(embedding=embeddings or HashingEmbeddings())
    store.add_documents(chunks)
    return store
真正花时间的是召回。我一开始直接调 store.similarity_search_with_score(),本地直接抛 ImportError: cosine_similarity requires numpy------它内部那个余弦函数硬依赖 numpy,而我们这台机器装不了。
片段总共 21 个,纯 Python 算一遍余弦根本不费事,于是我干脆自己排:
python
def _rank(store, query: str, k: int):
    embedding = store.embeddings.embed_query(query)

    scored = []
    for order, record in enumerate(store.store.values()):
        score = cosine_similarity(embedding, record["vector"])
        document = Document(id=record["id"], page_content=record["text"],
                            metadata=dict(record["metadata"]))
        scored.append((score, order, document))

    scored.sort(key=lambda row: (-row[0], row[1]))      # 分数相同按入库顺序
    return scored[:k]
排序键里那个 order 别省。只按 -score 排,遇到两条分数相同的片段,不同环境可能给出不同顺序,[1][2][3] 的编号就会漂------今天 1 是课程文件,明天变成制度文件,学员点开原文发现对不上。带上入库顺序做第二键,结果永远稳定,断言才敢写死编号。
片段规模上万之后,这一层就该换成带 ANN 索引的向量库了。也正因为检索逻辑集中在这一个文件里,到时候要改的只有这里。
六、回答:召回不到就直接拒答(rag.py)
本篇的硬规则只有一条,写在最前面:
召回不到任何片段,就直接拒答,不许让模型自由发挥。
python
def answer(question: str, store, llm: BaseChatModel,
           k: int = DEFAULT_K, min_score: float = MIN_SCORE) -> RAGAnswer:
    """问一句,答一句,顺带把出处带回来。"""
    scored = search_with_score(store, question, k=k)
    hits = [doc for doc, score in scored if score >= min_score]

    # 硬规则:一条都没剩下,就地拒答,模型这次连出场机会都没有
    if not hits:
        return RAGAnswer(question=question, text=REFUSAL_TEXT, hits=(), refused=True)

    response = llm.invoke(build_messages(question, hits))

    return RAGAnswer(question=question, text=response.content,
                     hits=tuple(hits), refused=False)
这条规则最难的不是写,是忍。模型明明能编出"六级,每级 12 课时",你却要让它说"资料里没写"。但对内部资料问答来说,编造的伤害远大于不回答:学员拿着"六级"去找顾问,顾问还得花三分钟解释那是模型编的。
实现上真正要紧的是那行阈值过滤。向量库有个很危险的特性:它永远会返回 k 条结果,哪怕最像的那条也只有 0.03 分。不过滤,就等于告诉模型"总有几条资料给你,你随便说点什么"。
python
MIN_SCORE = 0.25这个 0.25 不是拍脑袋,是拿三份资料一格一格试出来的:三个正常问题,最差的命中片段是 0.268;而"雅思保过班多少钱"这种资料里根本没有的提问,最像的片段也只有 0.191。阈值就卡在这两个数中间。这个数字必须自己拿真实语料测,抄别人的一定不准------换了语料、换了向量化方法,分数分布就全变了。
拼提示词也有讲究:资料放 human,规矩放 system。
python
SYSTEM_PROMPT = """你是「启明英语」的 AI 助教小E,回答学员关于课程与制度的问题。

规矩:
1. 只使用下面给出的参考资料作答,资料里没有的绝对不许补充。
2. 每一条涉及课程或制度的结论后面都要标出处编号,格式是 [1]、[2]。
3. 涉及金额必须写出计算公式,不能只给一个数字。
4. 回答控制在 6 句以内,用中文。

如果参考资料不足以回答,直接说:这件事资料里没写,我不能替你们编,请转人工。"""
第 2 篇讲过,模型对 system 的服从度远高于 user,所以"必须标出处"这种每次都要生效的规矩放 system;资料每次都不一样,放 human。混在一起,改资料就得动人格。
拒答文案我也改过好几版,最后定型是这句:"这件事资料里没写,我不能替你们编,请转人工。" 早期版本写过"很抱歉,可能没有找到相关信息",结果学员回一句"那大概呢",对话继续往下编。缓冲词会让拒绝听起来像商量。
七、溯源:编号 必须能落回真实片段(references.py)
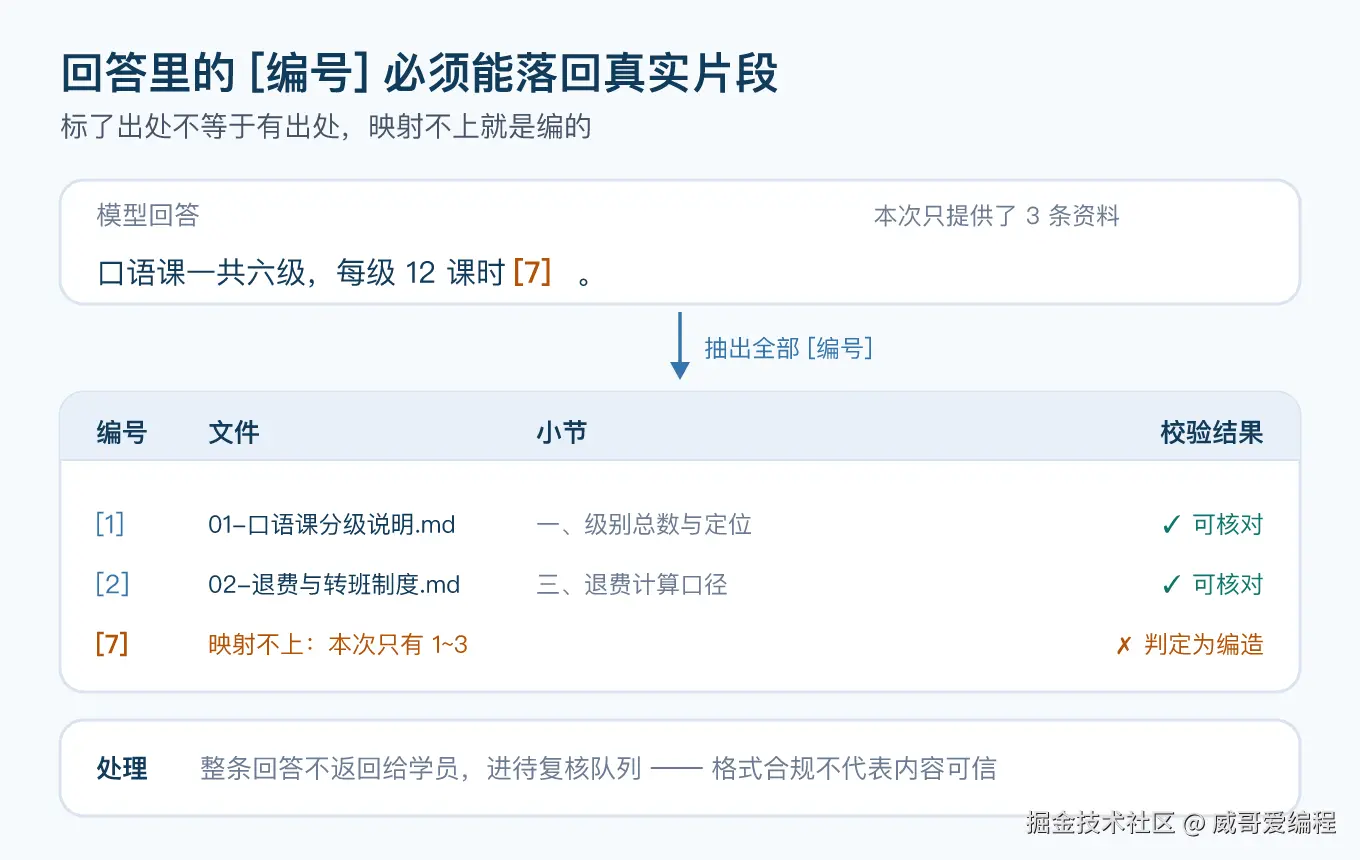
标了出处,不等于有出处。
模型完全可能写出"共六级3"------本次恰好召回过 3 条资料,3 是存在的,但那条资料里根本没提级别。更狠的是写 7,本次压根只给了 3 条。这两种错格式工整、语气自信,看起来比没标出处的回答还专业。
所以需要一道质检:把回答里的 [数字] 全抽出来,逐个对照本次召回的片段表。
python
REF_RE = re.compile(r"\[(\d+)\]")

def check_refs(text: str, hits: list[Document], require: bool = True) -> RefReport:
    """给一条回答做出处体检。"""
    numbers = extract_refs(text)
    maximum = len(hits)
    problems: list[str] = []

    for number in numbers:                          # 情况一:编了不存在的编号
        if not 1 <= number <= maximum:
            problems.append(f"引用了不存在的编号 [{number}],本次只提供了 1~{maximum}")

    if require and not numbers:                     # 情况二:有资料却一条不标
        problems.append("通篇没有标注任何出处编号")

    return RefReport(refs=resolve_refs(text, hits), problems=tuple(problems))
require=False 那个参数是给拒答用的。拒答本来就不该带出处,如果不关掉这条检查,质检就会变成逼着模型给"资料里没写"也编一个出处。
映射上的编号会展开成一张表:编号、文件、小节、片段预览。学员点 1,看到的就是课程文件里的"一、级别总数与定位"那一节;客服核对也只需要这一张表。
八、跑起来:真实输出
python demo.py,三个问题对应三种结局。演示用的是离线假模型(把模型"本来会说的话"预置好),检索部分是真实计算,换真模型时除了答案文本其余全部不变。
问题一,能答上的:
css
  问题:启明英语的口语课一共有几级?
  召回 3 条,阈值 0.25:
    [1] +0.531  命中
         01-口语课分级说明.md · 一、级别总数与定位
    [2] +0.399  命中
         01-口语课分级说明.md · 四、常见问题
    [3] +0.268  命中
         03-助教小E使用手册.md · 一、小E 的能力范围

回答:口语课一共分为四级:入门级、进阶级、流利级、商务级[1]。
      每一级 16 课时,每课时 45 分钟,八周结课[2]。

引用来源:
编号  文件                  小节                片段预览
[1]   01-口语课分级说明.md  一、级别总数与定位  启明英语的口语课一共分为四级,从低到高分别是入门...
[2]   01-口语课分级说明.md  四、常见问题        问:口语课一共有几级? 答:四级,分别是入门级、...
问题二,必须拒答的:
csharp
  问题:你们的雅思保过班多少钱?
  召回 3 条,阈值 0.25:
    [1] +0.191  低于阈值,丢弃
    [2] +0.189  低于阈值,丢弃
    [3] +0.176  低于阈值,丢弃

回答:这件事资料里没写,我不能替你们编,请转人工。
  召回片段:0 条(全部低于阈值,未向模型提问)
模型有没有被问到:没有------三条候选全在阈值以下,直接返回拒答文案注意最后一行:模型这次根本没被调用。不是"让它答完再判断要不要采用"------那样它照样编,钱也照样花。
问题三,跨两份资料的:
css
  问题:我报了口语课三级,学费 4800,上了 4 课时不想学了,能退多少钱?
    [1] +0.526  命中   02-退费与转班制度.md · 三、退费计算口径
    [2] +0.402  命中   01-口语课分级说明.md · 三、学费标准
    [3] +0.377  命中   03-助教小E使用手册.md · 一、小E 的能力范围

回答:口语课三级单报学费 4800 元[2]。退费按剩余课时算:
      可退金额 = 实付学费 ×(剩余课时 ÷ 总课时)− 手续费[1],
      手续费为可退金额的 5%,单笔最低 50 元[1]。
      你上了 4 课时、总课时 16,可退金额 = 4800 × 12 ÷ 16 − 4800 × 12 ÷ 16 × 5% = 3420 元[1]。
      教材费每级 280 元,不退[2]。
答案一半在制度文件、一半在课程文件,两条出处都标了。这就是"开卷考"和"凭记忆"的差别------它不是记住了 3420 这个数,是把两段材料摆在桌面上算出来的。
demo 最后还加演了一段:我硬塞了一句"口语课一共六级,每级 12 课时7",质检立刻报------
css
  出处校验:发现问题
    ✗ 引用了不存在的编号 [7],本次只提供了 1~3
  处理方式:这条回答不返回给学员,记录进待复核队列
九、测试:40 个用例全绿
arduino
tests/test_embeddings.py::test_vector_has_fixed_dimension PASSED
tests/test_embeddings.py::test_vector_is_reproducible_across_embedders PASSED
tests/test_embeddings.py::test_vector_is_normalized PASSED
tests/test_embeddings.py::test_cosine_rejects_mismatched_dimension PASSED
tests/test_embeddings.py::test_batch_matches_single PASSED
tests/test_embeddings.py::test_punctuation_and_case_are_ignored PASSED
tests/test_embeddings.py::test_empty_text_gives_zero_vector PASSED
tests/test_index.py::test_default_embeddings_is_hashing PASSED
tests/test_index.py::test_custom_embeddings_is_really_used PASSED
tests/test_index.py::test_swapping_embeddings_keeps_retrieval_identical PASSED
tests/test_index.py::test_k_is_respected PASSED
tests/test_index.py::test_scores_are_sorted_descending PASSED
tests/test_index.py::test_top_hit_is_the_right_document PASSED
tests/test_index.py::test_refund_question_hits_refund_document PASSED
tests/test_index.py::test_empty_index_returns_nothing PASSED
tests/test_index.py::test_search_keeps_metadata PASSED
tests/test_loader.py::test_load_documents_finds_all_md_files PASSED
tests/test_loader.py::test_every_chunk_carries_source_and_heading PASSED
tests/test_loader.py::test_split_by_heading_separates_sections PASSED
tests/test_loader.py::test_heading_line_is_not_in_body PASSED
tests/test_loader.py::test_split_loses_no_visible_text PASSED
tests/test_loader.py::test_overlap_carries_tail_into_next_chunk PASSED
tests/test_loader.py::test_bigger_chunk_size_gives_fewer_pieces PASSED
tests/test_loader.py::test_overlap_must_be_smaller_than_chunk_size PASSED
tests/test_loader.py::test_default_parameters_are_consistent PASSED
tests/test_rag.py::test_answer_returns_text_and_hits PASSED
tests/test_rag.py::test_empty_index_refuses PASSED
tests/test_rag.py::test_irrelevant_question_refuses PASSED
tests/test_rag.py::test_model_is_not_called_when_refused PASSED
tests/test_rag.py::test_retrieved_text_reaches_the_model PASSED
tests/test_rag.py::test_system_prompt_is_sent_as_system PASSED
tests/test_rag.py::test_reference_numbers_are_continuous_from_one PASSED
tests/test_rag.py::test_min_score_is_a_real_switch PASSED
tests/test_references.py::test_extract_refs_finds_numbers PASSED
tests/test_references.py::test_refs_map_back_to_file_and_heading PASSED
tests/test_references.py::test_excerpt_is_shortened PASSED
tests/test_references.py::test_fabricated_ref_is_caught PASSED
tests/test_references.py::test_missing_refs_is_flagged PASSED
tests/test_references.py::test_refusal_passes_without_refs PASSED
tests/test_references.py::test_answer_knows_its_own_sources PASSED

40 passed in 0.19s
全程离线,不需要 Key。这组里我最想让你看三条。
test_model_is_not_called_when_refused:断言拒答时模型调用次数是 0。它比断言"返回了拒答文案"狠得多------万一有人改成"先让模型答,再判断是否采用",这条立刻变红,因为那种写法模型照样编、钱照样花。
test_swapping_embeddings_keeps_retrieval_identical:把 HashingEmbeddings 包一层计数器传进去,断言召回结果一模一样。这条钉死的是依赖倒置------生产环境换真向量服务时,检索层代码不许变。
test_split_loses_no_visible_text:切片不丢字。这条我写错过一次,见踩坑清单。
十、踩坑清单
- 内置
hash()不可复现 。第一版向量化用hash()做哈希,本机正常、换机器全变------它受PYTHONHASHSEED影响。凡是声称"确定性"的代码,哈希一律走hashlib。 - "切分不丢字"写成等号断言,红了才知道错在自己 。overlap 会让上一块的尾巴在下一块开头再出现一次,拼起来必然比原文长。正确的写法是两条:每一片都是原文的连续子串(没串位),原文是拼接结果的子序列(没丢字、没乱序)。重叠是设计出来的重复,不是丢字。
InMemoryVectorStore的相似度计算硬依赖 numpy 。装不上就ImportError,而且报错出现在运行时而不是 import 时。片段量小就自己算,量大就换带 ANN 的向量库,别在"装 numpy"上耗一下午。- 召回阈值不设,"资料里没有"这个判断就做不出来。向量库永远返回 k 条,最不像的那条也有分数。阈值必须拿自己的语料测出分布再定,抄来的数字毫无意义。
- 中文切分要用中文标点做分隔符。默认分隔符列表是给英文设计的,遇到整段无换行的中文会按单字硬切,切出来的片段没法看。
- 排序只按分数,编号就会漂 。分数相同的片段在不同环境下顺序可能不同,
[1][2][3]对应的文件就变了。第二排序键用入库顺序,结果才稳。
十一、本篇收尾
现在的小E,问课程答课程、问制度答制度,每条结论后面跟着能点开核对的出处;问到资料里没有的东西,它说的是"这件事资料里没写"。那个"一问内部资料就编"的问题,从运气问题变成了两道可以测试的闸门。
下一篇解决流程失控的问题:批改一篇作文要"找错 → 分类 → 打分 → 给建议"四步,全塞进一次调用,模型经常自己省掉一两步。 我们用 LangGraph 把它拆成状态机,每一步可控、可测、可以单独重跑。
最后一句:模型不缺知识,缺的是"这一条我有出处,那一条我闭嘴"的分寸------而分寸只能由代码给它。