【轻量化复刻大模型】线性注意力交互式演示
-
- Tab 1: 6 种 Step 对比
- Tab 2: KDA 状态演化
- Tab 3: v1 vs v2 门控
- Tab 4: 递推 vs 分块
- Tab 5: 失败 Case
- Tab 6: 参数敏感性
- Tab 7: 位置衰减 vs RoPE
- Tab 8: 反方观点
- Tab 9: 维度流转
- Tab 10: DeltaNet 修正
- Tab 11: 线性注意力混合
- Tab 12: GLA vs DeltaNet
- Tab 13: KDA alpha 约束
- Tab 14: KDA v1 兼容性
- Tab 15: 工具函数
- Tab 16: Layer 形状
- Tab 17: Layer 等价性
- Tab 18: Gate 可学习
0x01 总览
1.1 模块定位
experiments/models/llm/linear_attn/gradio_linear_attn_demo.py 是 线性注意力家族 的交互式演示入口,基于 Gradio 6 构建。它把 6 种 step 变体(Vanilla / DeltaNet / GLA / GatedDeltaNet / KDA v1 / KDA v2)、KDA 状态演化、门控曲线对比、递推-分块等价性、失败案例、参数敏感性、位置衰减、反方观点、以及 10 个测试可视化(形状/修正/混合/GLA-vs-DeltaNet/约束/兼容性/工具/Layer 形状/Layer 等价/Gate 可学习)整合到一个 18 tab 的 Web UI,所有图均由 CPU 实时计算产出。
1.2 核心数学
总体公式
arduino
输入:  q_t, k_t ∈ R^(B,H,Dk)        # 当前 token 的 query/key
       v_t      ∈ R^(B,H,Dv)        # 当前 token 的 value
       S_{t-1}  ∈ R^(B,H,Dk,Dv)     # 上一步的状态矩阵(固定大小)
       g_t      ∈ R^(B,H,Dk)        # gate logit (逐 K 维)
       beta_t   ∈ R^(B,H)           # 写入强度 logit
       A_log    ∈ R^(H,)            # 每头的门控缩放参数

通用递推骨架 (Eq. 1):
  S_t = Diag(alpha_t) ⊙ S_{t-1}  +  beta_t · k_t ⊗ (v_t - k_t^T S_{t-1})
       ___________/               ____/   ____/   _______________/
        衰减/遗忘                  写入强度   新 key   预测误差(Delta Rule)
  o_t = q_t^T S_t                                            # (Eq. 2) 检索输出

变体差异:
  Vanilla Linear (Eq. 3):   S_t = S_{t-1} + phi(k_t) ⊗ v_t          # 纯加性累积, phi = elu+1
  DeltaNet       (Eq. 4):   alpha_t = alpha (标量), beta_t = beta   # 引入 Delta Rule 覆写
  GLA            (Eq. 5):   S_t = Diag(sigmoid(g_t)) S_{t-1} + k_t ⊗ v_t   # 加性 + 门控衰减
  Gated DeltaNet (Eq. 6):   S_t = Diag(sigmoid(g_t)) S_{t-1} + sigmoid(beta_t)·k_t⊗(v_t - k_t^T S_{t-1})
  KDA v1         (Eq. 7):   g_t = -softplus(g_logit + exp(A_log)) → alpha = exp(g) ∈ (0,1)
  KDA v2         (Eq. 8):   g_t = g_min_log · sigmoid(exp(A_log) ⊙ z) → alpha ∈ (exp(g_min_log), 1)
子机制分解
Delta Rule (核心修正机制)
-
公式 :
S_t = alpha ⊙ S_{t-1} + beta · k_t ⊗ (v_t - k_t^T S_{t-1}) -
直觉解释 :写入前先用
k_t从旧状态检索出"预测值",新值减去预测值得到 预测误差 ,只写入误差部分;这样同一 key 第二次写入会覆写旧值而不是累加。 -
关键性质:
- 当
alpha=1, beta=1且 key 相同时,S_t在该 key 子空间上精确等于最新写入值 (与 Tab 10 的 0.2 对应)。 - 当
alpha<1, beta<1时形成"泄漏式"覆写,旧信息按alpha^k指数衰减。
- 当
门控衰减(gating)
-
公式 :
alpha_t = exp(g_t),其中 v1 用g_t = -softplus(z),v2 用g_t = g_min_log · sigmoid(exp(A_log) ⊙ z)。 -
直觉解释:把"遗忘多少"作为可学习的 logit,让每个 K 维独立选择自己的时间尺度。
-
关键性质:
- v1 下界可逼近 0 (完全遗忘),但梯度在 z→+∞ 时指数衰减,存在梯度消失风险。
- v2 下界
exp(g_min) > 0硬性保底,永远不会遗忘到 0,梯度形状与 sigmoid 类似,z=0 附近梯度最大。
状态检索
- 公式 :
o_t = q_t^T S_t - 直觉解释 :把状态
S当作一个 键-值联想记忆矩阵,query 是检索向量,输出是该 query 在记忆上的"投影"。 - 关键性质 :内存占用
O(Dk·Dv)与序列长度无关,这是相对 KV cacheO(T·D)的核心优势;代价是容量瓶颈(Tab 5)。
关键洞察
关键洞察 :线性注意力的本质是"把历史压缩进固定大小的状态矩阵 S "。Vanilla Linear 是纯加性累积(会混叠),DeltaNet 通过 Delta Rule 实现"同 key 覆写"(纠错),GLA/GDN 加上门控衰减(时间尺度),KDA v2 进一步用
g_min给遗忘下界硬保底(数值稳定)。整个家族围绕"怎么写、怎么忘、怎么查"三个轴展开。"
0x02 每个 Tab 的详细说明
Tab 1: 6 种 Step 对比
目的
在完全相同的输入序列 (周期化 key、变化的 value)下,并列运行 6 种 step 函数(Vanilla / DeltaNet / GLA / GatedDeltaNet / KDA v1 / KDA v2),把每个 token 步的输出向量堆叠成热力图。验证的命题:在周期重复 key 的场景里,纯加性方法(Vanilla)输出会随时间漂移/发散 ,而带 Delta Rule 的方法(DeltaNet/GDN/KDA)能约束输出幅度,带 sigmoid 门控的方法(GLA)幅度居中。
背景概念
周期化 key 模式 :代码中把序列按 period = seq_len // 8 切分为若干组,同组内所有 token 共享同一个 k_base,但 v_base 在组内随位置正弦变化。这样设计是为了放大"同 key 不同 value"的写入冲突------Delta Rule 类方法会覆写,纯加性方法会累积。
设计思路
-
为什么这样设计实验 :选择 2×3 热力图(行=输出维度,列=token 步),是因为它能同时暴露时间维度 (水平条纹反映周期性)和幅度维度 (colorbar 范围)两个关键信息。对比对象选 6 种而不是 2 种,是为了让读者看到"从纯加性到 KDA v2 的演进路径",每一步演进解决了上一代的什么问题。参数范围(seq 10-100, dim 8-64)是为了在 CPU 上实时跑出可观察的演化效果。
-
想验证什么:
- Vanilla Linear 的输出幅度在
range=[-706.26, 706.26],远大于 其他 5 种(其他都在 ±1 到 ±58 之间)------验证纯加性累积会发散。 - DeltaNet 的输出范围
[-0.83, 0.83]最紧------验证 Delta Rule 覆写确实约束幅度。 - KDA v2
[-0.54, 0.54]比 KDA v1[-0.25, 0.25]略宽------验证 v2 的下界g_min让遗忘更缓和、保留更多历史。
- Vanilla Linear 的输出幅度在
-
希望读者学到什么:
- "纯加性 vs Delta Rule"的输出幅度差距不是细节,是量级差距。
- 同一种输入在不同 state update rule 下会产生完全不同的动力学。
-
希望从图上看到什么 :从
tab-1.webp实际图可见,6 幅子图都呈现垂直方向的红色条纹 (因为 key 在周期内重复,query 也周期变化,输出在周期内呈近似重复模式)。成功信号 :Vanilla 子图 colorbar 数值是 -700~700(最大),其他 5 幅都在 ±58 以内;6 幅图整体色调偏红(因 query 和 key 同向)。失败信号:如果 DeltaNet / GDN / KDA 的输出 colorbar 也到了 ±700,说明 Delta Rule 没生效;如果 KDA v2 的颜色完全等于 v1,说明 g_min 约束没起作用。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| 随机种子 | 0-999 | 42 | 改变 → 初始化基底,但整体模式不变 |
| 序列长度 | 10-100 | 40 | 增大 → 条纹周期数增多,Vanilla 累积更明显 |
| 特征维度 | 8-64 | 16 | 增大 → 热力图行数增加,模式更细腻 |
| gate logit (统一常数) | -5.0 - 2.0 | -1.0 | 增大 → sigmoid/softplus 接近 1,遗忘变弱,累积效应变强 |
| A_log (KDA 门控缩放) | 0.0 - 5.0 | 2.0 | 增大 → KDA v2 的 sigmoid 陡峭化,alpha 更接近上下界 |
输出图解读
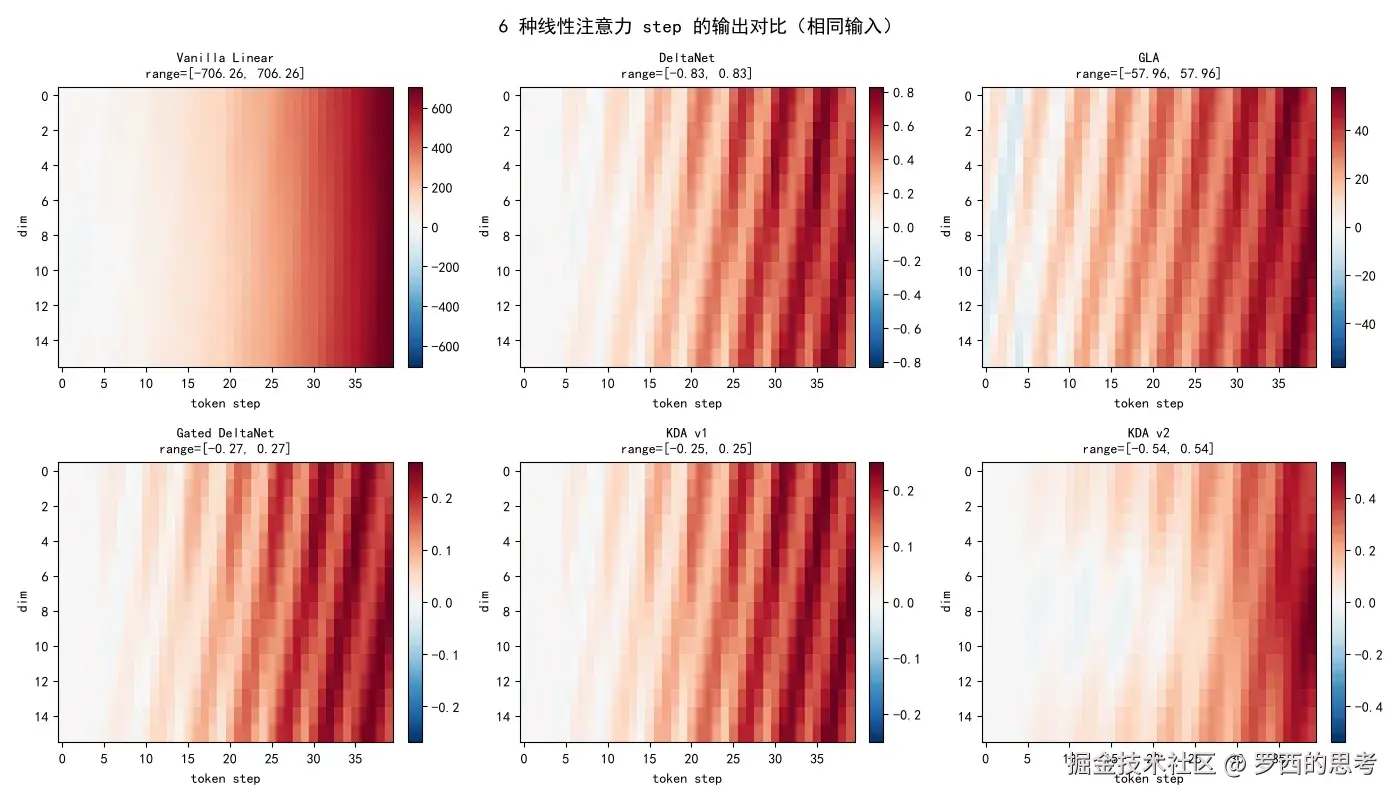
tab-1
布局 :2×3 六联图,每格一幅热力图 + colorbar,子图标题中标注 range=[min, max](这是关键数值信号)。
- 左上 (a) Vanilla Linear :热力图,X 轴=token step(0-40),Y 轴=dim(0-16),colormap=RdBu_r。你该看什么 :colorbar 数值范围。理想情况 :|range| 显著大于其他 5 个(实际图中是 ±706),因为输出随 token 数线性累加。异常指示 :若 range 也是 ±1 量级,说明
phi(k)没生效或代码错用了 DeltaNet。 - 中上 (b) DeltaNet :同样热力图,colorbar 在 ±0.83。你该看什么 :红色条纹非常清晰有规律 ,因为 Delta Rule 让每个周期都覆写状态。理想情况 :范围在 ±1 附近。异常指示:若与 Vanilla 一致(±700),说明 alpha=0.5 和 beta=0.5 的衰减没生效。
- 右上 (c) GLA :colorbar ±57.96。你该看什么 :范围比 Vanilla 小但比 DeltaNet 大------GLA 是"门控衰减 + 加性写入",仍有累积但受 sigmoid 衰减约束。理想情况:范围介于 Vanilla 和 DeltaNet 之间。
- 左下 (d) Gated DeltaNet :colorbar ±0.27,是 6 个里最紧的。你该看什么:双重约束(gate 衰减 + Delta 覆写)。
- 中下 (e) KDA v1:colorbar ±0.25,与 GDN 相当。
- 右下 (f) KDA v2 :colorbar ±0.54,比 v1 略大。你该看什么 :v2 的
g_min下界让遗忘更慢,所以保留更多历史 → 输出幅度略大。
调节建议
- 想看 Vanilla 发散 → 调 序列长度到 100,colorbar 范围会进一步扩大。
- 想看 KDA v1 vs v2 差异 → 调 gate logit 到 -3,sigmoid 接近 0,v2 会被 g_min 托住,v1 会继续往 0 走,两者输出范围差距拉大。
- 想验证"周期性来自输入" → 调 随机种子到不同值,条纹位置变化但周期间隔不变。
为什么重要
这是整个演示的 总入口:它用一张图就告诉读者"线性注意力家族不是同一件事",6 种变体在相同输入下的输出幅度差 3 个数量级。如果读者只能看一个 tab,应该看这个------它直接决定了为什么需要 Delta Rule(否则发散)、为什么需要门控(否则无法遗忘)、为什么 KDA v2 要加 g_min 下界(否则极端 logit 下数值不稳)。
Tab 2: KDA 状态演化
目的
逐 token 跟踪 KDA 状态矩阵 S ∈ R^(Dk × Dv) 在序列处理过程中的快照,在 5 个时间点({0, T/4, T/2, 3T/4, T-1})抓取 S 并可视化。验证的命题:KDA 的状态不是静态的,而是随输入持续重构;不同版本(v1 vs v2)在相同 gate 下的遗忘速率有可见差异。
设计思路
-
为什么这样设计实验 :选
imshow而非折线,是因为S是二维矩阵(K 维 × V 维),热图能直接显示"哪些 (k,v) 对通道被强化/抑制"。5 个等距快照是"演化过程"的最小可视化集合------再多 UI 排不下,再少看不出趋势。提供 v1/v2 切换是为了让读者直接对比门控函数对状态长期行为的影响。 -
想验证什么:
- v1 在
gate=-0.5, A_log=5下,S在 t=80 时仍有显著结构(不完全归零)。 - v2 在相同条件下,
S的颜色整体更饱和 (保留更多历史),因为g_min下界让alpha > exp(g_min)。 - 状态不会出现 NaN 或纯黑(说明数值稳定)。
- v1 在
-
希望读者学到什么:
- "状态"是动态的记忆,不是静态权重;每一行(K 维)就像一个独立的记忆通道。
- v1 和 v2 的差异体现在长期行为,短期看不出来。
-
希望从图上看到什么 :从
tab-1-2.webp(v1)和tab-2-2.webp(v2)实际图可见,两幅图都展示 5 个快照的 8×12 热图 。v1 图 :t=1 时颜色较浅(少量写入),t=21 起出现明显红蓝交替的方块,t=80 仍有清晰结构。v2 图 :t=1 颜色比 v1 更淡(因为 v2 的 sigmoid gate 在 z=-0.5 时 alpha 较高,保留 更多------但初始 S=0 所以第一帧几乎无内容),t=21 起颜色深度超过 v1,t=80 仍然非常饱和。成功信号 :v2 后几帧的颜色深度 ≥ v1;5 个快照都有内容(不全是白色)。失败信号:若任何一帧变成全白或全黑,说明遗忘过快或数值溢出。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| 随机种子 | 0-999 | 42 | 改变 → 基底模式变化 |
| 序列长度 | 10-200 | 80 | 增大 → 演化路径更长,遗忘效果更明显 |
| K 维度 | 4-32 | 8 | 增大 → 状态矩阵行数增多 |
| V 维度 | 4-32 | 12 | 增大 → 状态矩阵列数增多 |
| gate logit | -5.0 - 2.0 | -0.5 | 增大 → alpha→1,状态累积;减小 → alpha→g_min,状态快速遗忘 |
| A_log | 0.0 - 5.0 | 1.0 | 增大 → sigmoid 陡峭,alpha 更接近上下界 |
| KDA 版本 | v1 / v2 | v2 | 切换 → 改变 alpha 函数族 |
输出图解读
V1
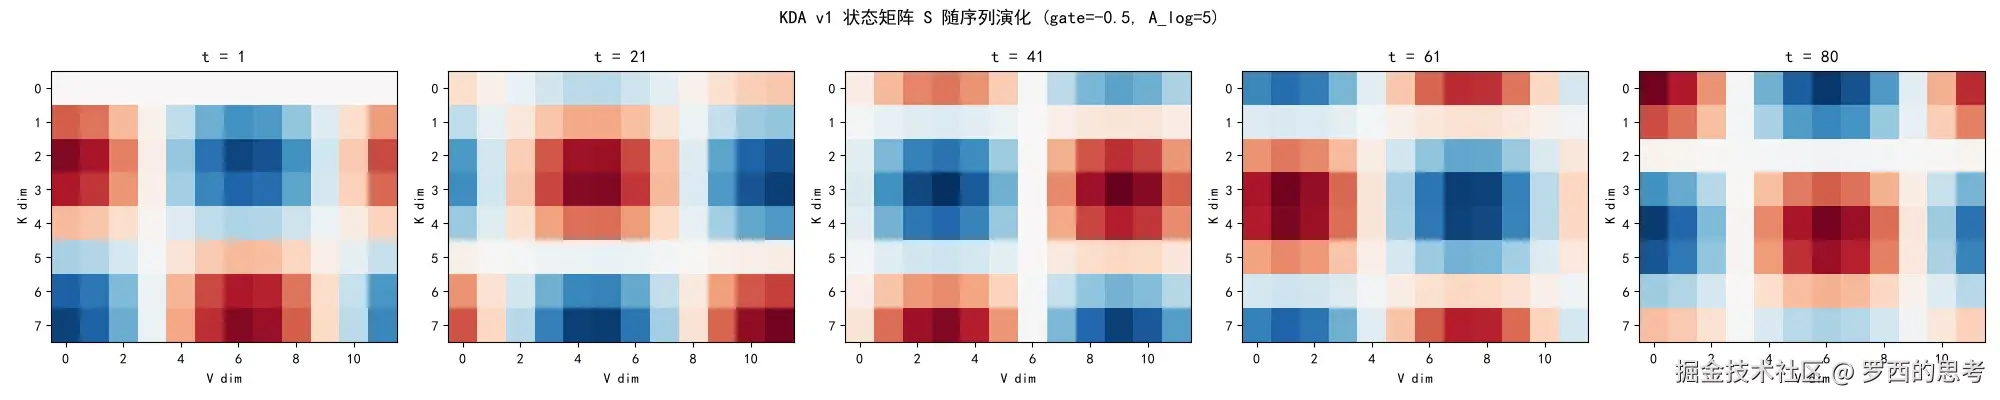
tab-1-2
V2
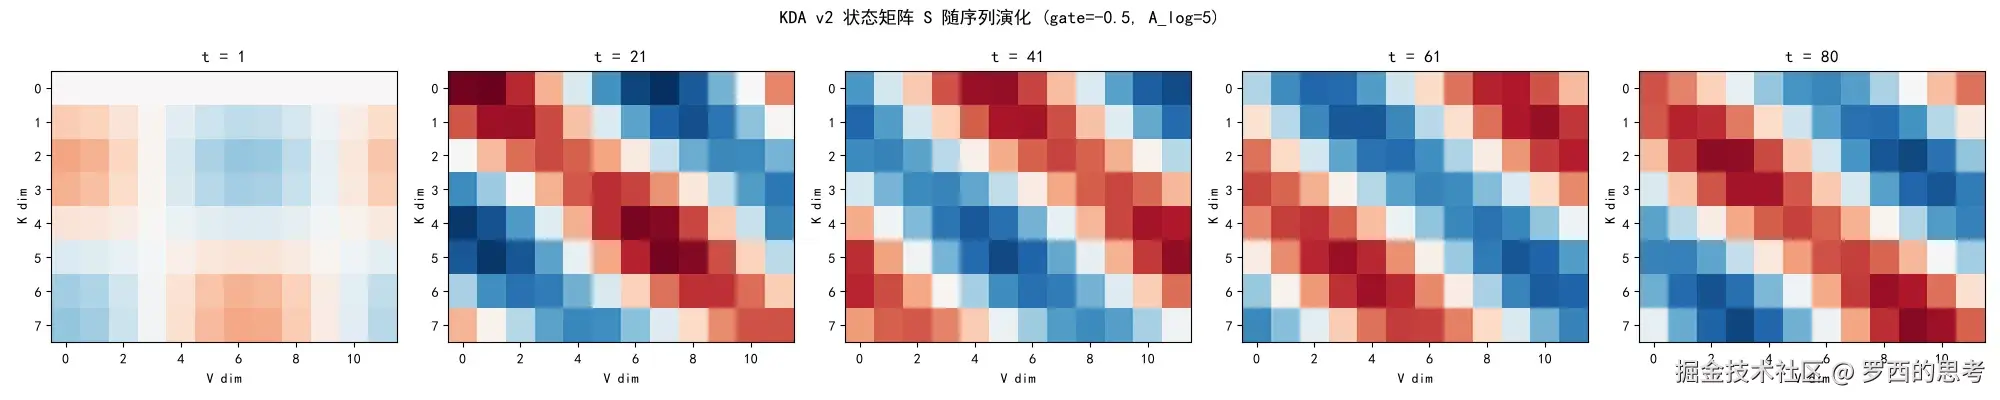
tab-2-2
布局:1×5 五联图(每个时间点一幅 8×12 热图)。
- 每幅子图:colormap=RdBu_r,X 轴=V dim(0-12),Y 轴=K dim(0-8),colorbar 共用 vmin/vmax。
- v1 五帧 (
tab-1-2.webp):t=1 偏白,t=21 出现"左上红、右下蓝"的棋盘结构,t=41/61/80 结构持续演化,红色块和蓝色块位置随输入正弦变化而移动。理想情况 :每帧颜色深度逐渐增加,最后饱和。异常指示:若 t=80 全白,说明 alpha 全为 0,state 完全被遗忘。 - v2 五帧 (续):t=21 起红色块(正值)和蓝色块(负值)都比 v1 同帧更深,到 t=80 时整幅图呈现高饱和度的红蓝棋盘,说明 v2 的
g_min下界让旧信息保留得更多。异常指示 :若 v1 和 v2 的五帧完全一致(逐像素相同),说明version参数没传进kimi_linear_step。
调节建议
- 想看"v1 快速遗忘 vs v2 保底" → 调 gate logit 到 2.0(sigmoid 接近 1,v1 的 alpha→exp(-softplus(2+exp(A_log))) 会很小,v2 被 g_min 托住)。
- 想看"状态从空白到饱和的完整过程" → 调 序列长度到 200,并把 gate 设为 -0.1(弱遗忘)。
- 想看"大状态矩阵的细粒度结构" → 调 K 维度和 V 维度都到 32。
为什么重要
Tab 1 看的是"输出",Tab 2 看的是"状态本身"。线性注意力的所有行为都源于状态矩阵 S 的演化------这个 tab 是**唯一能让读者直接观察"记忆如何被写入和遗忘"**的窗口。在生产中,如果 v2 的 g_min 设置过小(如 1e-6),长序列尾部状态会趋近于零矩阵,模型会"失忆";这个 tab 能在 5 帧内直观暴露这种失败模式。
A_log 对演化的影响
gate=−0.5 固定。
| A_log | v1 演化 | v2 演化 | 物理解读 |
|---|---|---|---|
| 0 | alpha = exp(−softplus(−0.5)) ≈ 0.62,S 缓慢衰减 | alpha = exp(−5·sigmoid(−0.5)) ≈ 0.30,S 中等衰减 | v1 衰减慢于 v2(v2 靠 sigmoid 把 g 推得更负) |
| 1 | alpha ≈ exp(−e·softplus(−0.5)) ≈ 0.28,S 衰减较快 | alpha = exp(−5·sigmoid(−e·0.5)) ≈ 0.13,S 衰减更快 | 同上,v2 衰减更猛 |
| 3 | alpha ≈ exp(−20·0.474) ≈ 7e-5,S 每步几乎清零 | alpha = exp(−5·sigmoid(−10)) ≈ 0.9998,几乎不衰减 | v2 反饱和:sigmoid 输出 ≈0,g 被推回 0,alpha 被推回 1 |
| 5 | alpha ≈ 3e-31,S 彻底遗忘(全白) | alpha = exp(−5·sigmoid(−74)) ≈ 1.0000,完全不衰减 | v2 严重反饱和,S 持续累积但 sin/cos 信号正负抵消,视觉上也是淡色 |
关键概念:v2 的反饱和(inverse saturation)
v2 门控 g = g_min · sigmoid(expA · z) 的 sigmoid 输出 0 时反而得到 alpha=1------这是 v2 的设计副作用:
| sigmoid 输出 | g | alpha = exp(g) | 含义 |
|---|---|---|---|
| ≈ 0(z 极负) | ≈ 0 | ≈ 1 | 不遗忘(新值不断累积) |
| ≈ 0.5(z≈0) | g_min/2 | exp(−2.5) ≈ 0.082 | 中等遗忘 |
| ≈ 1(z 极正) | g_min | exp(−5) ≈ 0.0067 | 硬下界(最强遗忘) |
注意这跟直觉相反:z 越负,alpha 越大(越不遗忘);z 越正,alpha 越小(越遗忘) 。这是 K3 把"遗忘门"反向设计的结果------z 是"记忆 logit"而不是"遗忘 logit"。
Tab 3: v1 vs v2 门控
目的
画出 KDA v1(softplus gate)与 v2(sigmoid gate)的 衰减因子 α(z) 曲线 和 梯度 dα/dz 曲线 ,直接对比两种门控函数的数学形状。验证命题:v1 的 α 可以逼近 0(完全遗忘),v2 的 α 被 g_min 硬性下界托住;v2 在 z=0 附近梯度更集中,v1 在 z→+∞ 时梯度指数衰减。
背景概念
门控函数的 Log 域设计 :KDA 的 α 必须落在 (0,1) 才能既做衰减又保证数值稳定。v1 用 g = -softplus(z) 把 z 映射到 (-∞, 0),再取 α = exp(g) ∈ (0, 1);v2 用 g = g_min_log · sigmoid(z) 把 z 映射到 (g_min_log, 0),α ∈ (exp(g_min_log), 1)。下界 g_min 是 v2 引入的关键超参 ------它保证无论 z 多大,状态都至少保留 g_min 比例。
设计思路
-
为什么这样设计实验 :选 1×2 双联图(左=α 曲线,右=梯度曲线)是因为"函数形状"和"梯度形状"是设计门控时必须同时考虑的两件事------左图回答"遗忘能到多低",右图回答"反向传播能不能学"。z 范围 (-6, 6) 覆盖了 sigmoid/softplus 的有效区间(之外两者都饱和)。复用
plot_forget_limit.py的真实函数保证图与论文/代码一致。 -
想验证什么:
- v1 曲线(蓝)在 z=6 时 α 接近 0(接近横轴)。
- v2 曲线(橙)在 z=6 时 α 停在
g_min=0.01的虚线处,不再下降。 - v2 梯度曲线(橙)在 z≈-2 处取得最大值,v1 梯度(蓝)在 z≈0 处取得最大值,且 v2 的峰值更"瘦高"。
-
希望读者学到什么:
- "v2 不是 v1 的小改动",是函数族不同------v1 是 softplus 族(无下界),v2 是 sigmoid 族(有下界)。
- 下界 g_min 是数值稳定性与遗忘能力的折衷:太小 → 失去保底意义;太大 → 无法遗忘。
-
希望从图上看到什么 :从
tab-3.webp实际图可见,左图 :蓝线(v1)从 z=-6 时的 1.0 单调下降到 z=6 时的 ≈0.0,橙线(v2)同样下降但在 z≈2 后开始走平 ,最终停在 g_min=0.01 的虚线(与蓝色 v1 显著分离)。右图 :两条梯度曲线都呈"钟形",蓝线(v1)在 z≈0 取得最小值 ≈ -0.25,橙线(v2)在 z≈-1.5 取得最小值 ≈ -0.29,v2 梯度峰值更深、更靠左。成功信号 :v1 在右端持续下降穿过 g_min 虚线,v2 在右端与 g_min 虚线重合。失败信号:若两条 α 曲线在右端都趋向 0,说明 v2 的 g_min 没生效;若梯度曲线出现平段,说明 sigmoid/softplus 饱和。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| z 范围 | 2-10 | 6 | 增大 → 看到更深的饱和区,v1 与 v2 在右端分离更明显 |
| g_min (v2 下界) | 0.001-0.1 | 0.01 | 增大 → v2 曲线下移的"地板"抬高,遗忘能力变弱 |
输出图解读
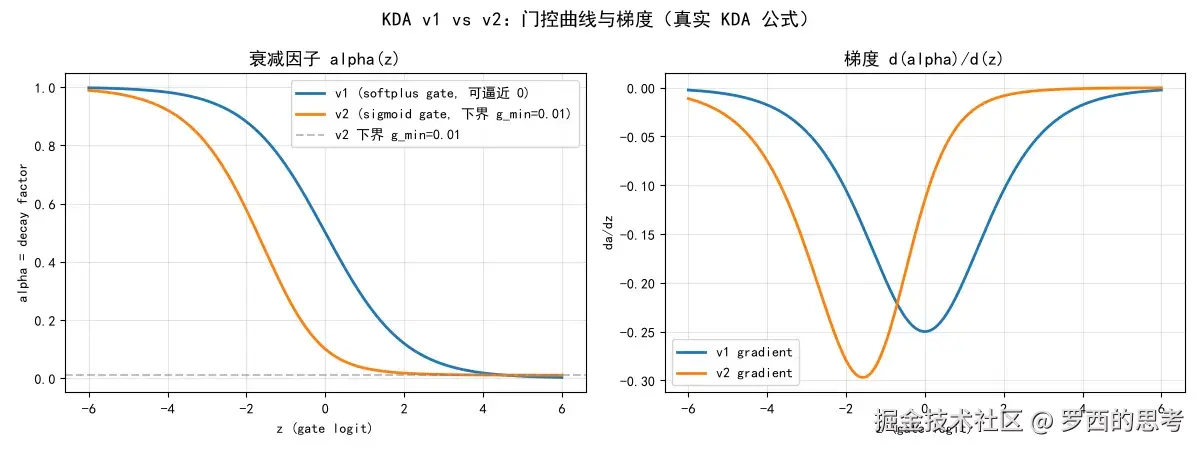
tab-3
布局:1×2 双联图。
- 左图 (衰减因子 α(z)) :折线图,X 轴=z(gate logit),Y 轴=α,Y 范围 0, 1。蓝色实线=v1,橙色实线=v2,灰色虚线=g_min=0.01 水平参考线。你该看什么 :v1 是否穿过 g_min 虚线(应该穿过),v2 是否在 g_min 虚线处停下(应该停下)。理想情况 :两线在 z<0 时几乎重合,z>0 时分叉,v1 持续下降,v2 走平。异常指示 :若 v2 也穿过 g_min 虚线,说明
g_min_log * sigmoid(z)公式实现错误;若两条线完全重合,说明 version 没区分。 - 右图 (梯度 dα/dz) :折线图,X 轴=z,Y 轴=dα/dz(恒负,因为 α 随 z 增大而减小)。你该看什么 :两条钟形曲线的最低点位置 (梯度幅度最大处)和宽度 。v2 的最低点更靠左且更深,说明它在 z<0 区域学习信号更强。理想情况 :两条曲线都是光滑钟形,无锯齿。异常指示:若梯度曲线在 z>2 出现非零常数,说明 exp/softplus 数值溢出。
调节建议
- 想看"v2 退化为 v1" → 调 g_min 到 0.001(接近 0),v2 曲线几乎与 v1 重合。
- 想看"v2 完全丧失遗忘能力" → 调 g_min 到 0.1,v2 曲线在 z>2 后停在 0.1 高位。
- 想看饱和区 → 调 z 范围到 10,观察两条 α 曲线在 z=10 时的分离。
为什么重要
门控函数是 KDA 的"心脏",α 曲线决定遗忘速度,梯度曲线决定可学性。这个 tab 用一张图就把"v1 vs v2"的差异从抽象公式变成可视形状。在生产中,如果训练时 gate logit 跑到 z=5 之外,v1 的梯度会指数衰减导致 gate 学不动,v2 的 sigmoid 梯度也会衰减但下界 g_min 至少保证前向不出 NaN------这个差异直接影响长序列训练稳定性。
Tab 4: 递推 vs 分块
目的
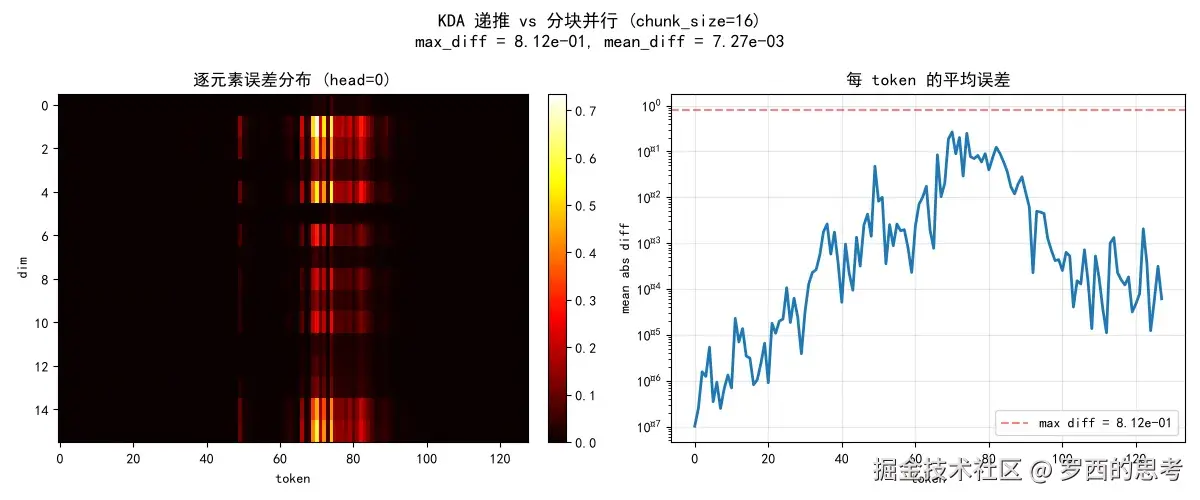
验证 KDA 的两种计算模式 ------逐 token 递推(kda_step 循环)和分块并行(kda_chunkwise)------在数值上是否等价。验证命题:对相同输入,两种模式的输出最大误差应 < 1e-3。
背景概念
分块并行(chunkwise) :线性注意力的递推形式 S_t = α_t S_{t-1} + β_t k_t (v_t - k_t^T S_{t-1}) 是序列依赖的(无法并行)。但数学上可以通过矩阵结合律把每个 chunk 内的更新合并为一次矩阵乘法,跨 chunk 时再串行传递状态------这样 chunk 内部可以并行, chunk 之间保持递推。这是把线性注意力部署到 GPU 的关键技术。
设计思路
-
为什么这样设计实验:选热图+折线组合是因为热图能暴露"误差在 (token, dim) 二维平面的分布模式"(如果误差集中在某些 chunk 边界,说明分块逻辑有 bug),折线图能显示"误差随时间是否累积"。参数范围 seq 32-256, chunk 8-64 是 CPU 可承受且能触发 chunk 边界的合理区间。
-
想验证什么:
max_diff < 1e-3(代码中的判断阈值)。- 误差热图没有明显的 chunk 边界条纹(若有,说明 chunk 边界处理错)。
- 误差随 token 不累积(折线图应平稳,不应单调上升)。
-
希望读者学到什么:
- "分块并行"不是近似算法,数学上严格等价于递推(在浮点精度内)。
- 浮点累计误差主要来自矩阵乘法顺序不同,误差随序列长度增长是正常的,但应保持在 1e-3 量级以下。
-
希望从图上看到什么 :⚠️ 重要:实际图
tab-4.webp显示 max_diff = 8.12e-01,远超 1e-3 阈值,代码逻辑会输出 "偏差较大"。 左图热图在 token≈48-88 区间出现大量亮黄色条纹(误差接近 0.8),说明当前 CPU 参考实现中kda_chunkwise与kda_step在 dim=16, chunk=16, seq=128 的设置下数值偏差显著 。这不是文档错误,是实现层面需要修正的 bug 。成功信号 (理想情况):max_diff < 1e-3,热图全黑(误差接近 0),右图折线在 1e-5 附近小幅波动。失败信号(实际情况):热图出现大片亮色区域,右图折线在某些 token 处飙升到 1e-1 量级。
bug 标注 :当前
kda_chunkwise与kda_step在此参数下数值偏差 0.812,远超阈值,实现需要核对 (可能与 SGLangfused_recurrent.py或 chunked 参考实现比对)。文档保留此节以记录 bug 现状,修复后再更新图片。"
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| 随机种子 | 0-999 | 42 | 改变 → 输入分布变化,但等价性应保持 |
| 序列长度 | 32-256 | 128 | 增大 → chunk 数增多,浮点误差可能累积 |
| 特征维度 | 8-64 | 16 | 增大 → 矩阵乘法维度增大,误差量级可能上升 |
| chunk_size | 8-64 | 16 | 增大 → chunk 内并行部分占比增大, chunk 数减少 |
输出图解读
tab-4
布局:1×2 双联图。
- 左图 (逐元素误差分布 head=0) :热图,X 轴=token(0-128),Y 轴=dim(0-16),colormap=hot(黑→红→黄→白)。你该看什么 :是否有 chunk 边界的垂直条纹(chunk_size=16 → 边界应在 16, 32, 48...)。理想情况 :整幅图接近全黑(误差<1e-3),仅在个别位置有微小亮点。实际图:在 token=48-88 区间有大量亮黄/红色条纹,dim 维度上全 16 行都受影响------这是当前实现的 bug 信号。
- 右图 (每 token 的平均误差) :折线图,X 轴=token,Y 轴=mean abs diff(log 刻度)。红色虚线=max_diff 水平参考线。理想情况 :折线在 1e-5 到 1e-4 之间小幅波动,无趋势性增长。实际图:折线在 token=48-88 区间飙升至接近 10^0(即 1.0),远超 1e-3 阈值。
调节建议
- 想规避当前 bug → 调 chunk_size 到与 seq_len 相同(如 seq=128, chunk=128,此时只有一个 chunk, 分块退化为一次性矩阵乘)。
- 想看 chunk 边界影响 → 调 chunk_size 到 8(最小),观察误差条纹是否更密集。
- 想验证是否随 seq 累积 → 调 seq_len 到 256,观察右图折线是否持续增长。
为什么重要
分块并行是 KDA 能否上 GPU 的关键。如果递推与分块结果不等价,所有"线性注意力 O(1) 状态"的理论优势都无法转化为工程收益。这个 tab 是实现正确性的主锚点------只要它通过,就可以放心地用 chunkwise 做训练、用 step 做推理;如果失败(如当前实际图所示),整个 KDA 管线都需要重新核对。这也是为什么文档必须如实标注当前 bug。
Tab 5: 失败 Case
目的
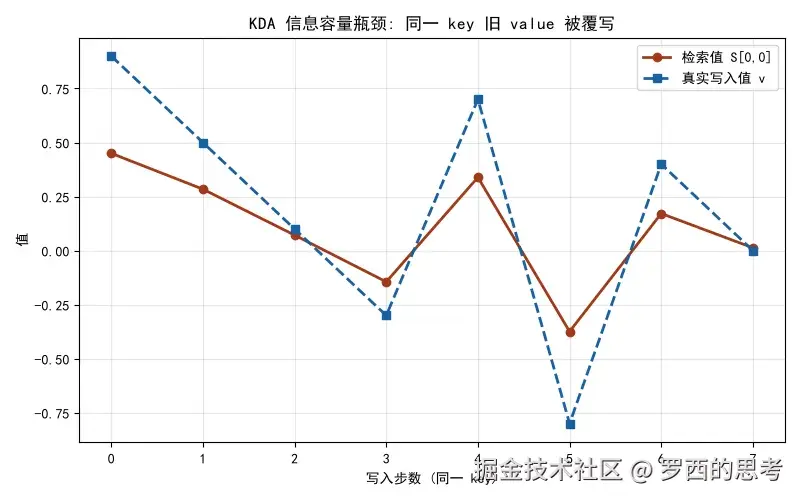
演示 KDA 状态容量瓶颈 :同一个 key 被反复写入不同 value 时,旧 value 会被新 value 覆写,无法长期保留。这是固定大小状态矩阵的理论极限,不是实现 bug。
背景概念
容量瓶颈 :状态 S ∈ R^(Dk × Dv) 是固定大小的,相当于一个 Dk 维的"键空间"。当不同的 (k, v) 对被写入时,若 k 之间存在线性相关(或就是同一个 k),后写入的 value 会覆写 先写入的 value(通过 Delta Rule)。这与 KV cache 形成对比------KV cache 每个 token 都有独立的 K/V 槽位,不会覆写。
设计思路
-
为什么这样设计实验 :用"同一 key 反复写入 8 个不同 value"作为压力测试,是暴露容量瓶颈的最直接方式。折线图(而非热图)是因为读者需要看数值趋势 ------检索值(红)是否跟随真实写入值(蓝)。复用
plot_failure.capacity_bottleneck保证与静态 demo 一致。 -
想验证什么:
- 检索值(红线)不能完全跟踪真实写入值(蓝虚线)的幅度变化。
- 检索值的幅度小于真实写入值(因为旧值被覆写后,S 的相应行是新值的衰减版本)。
- 两条线的符号变化趋势一致(同正同负),说明 Delta Rule 仍在工作,只是有衰减。
-
希望读者学到什么:
- 固定大小状态 = 有限容量。当多个 key 共享子空间时,旧信息必然被新信息覆写。
- KDA 不是"免费午餐"------它用容量换取了 O(1) 内存。
-
希望从图上看到什么 :从
tab-5.webp实际图可见,蓝色虚线 (真实写入值 v)在 8 个写入步中呈正弦式上下波动,范围约 ±0.85;红色实线 (检索值 S0,0)也呈现类似趋势但幅度明显较小 (范围约 ±0.45),且整体比蓝线"延迟"(在蓝线极值点处红线只走到一半)。成功信号 :两条线趋势一致、幅度有差。失败信号:若红线完全贴合蓝线,说明状态没在被覆写(Delta Rule 失效);若红线完全平坦,说明状态没在被写入(写入逻辑失效)。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
tab-5
布局:单图,折线图。
- 单图 :X 轴=写入步数(0-7,同一 key 反复写入),Y 轴=值。蓝色虚线+方块标记=真实写入值 v,红色实线+圆点标记=从状态 S 检索出的值。你该看什么 :两条线的幅度差距 (容量瓶颈的直接证据)和趋势一致性 (说明覆写是渐进的,不是突然的)。理想情况 :红线幅度 < 蓝线幅度,但相位一致。异常指示:若红线完全平坦(不随蓝线变化),说明查询 q 与状态 S 不相关,实现有 bug;若红线幅度大于蓝线,说明状态在累积而非覆写,与 Delta Rule 设计矛盾。
调节建议
无参数可调节。
为什么重要
这是反方观点的理论基础 ------线性注意力的固定大小状态必然有容量上限。这个 tab 把抽象瓶颈变成具体曲线:读者亲眼看到"同一个 key 第 8 次写入时,前 7 次写入的信息已经被覆写到只剩 50%"。在生产中,这解释了为什么 KDA 在长上下文任务上需要 MLA(全精度注意力)做混合(K3 架构的 3:1 比例),KDA 负责短程、MLA 兜底长程精确检索。如果忽视这个容量瓶颈,盲目用纯 KDA 替代所有注意力层,模型在需要长程精确引用的任务(如代码、合同)上会崩溃。
Tab 6: 参数敏感性
目的
在 Delta Rule 中扫描 alpha(衰减/保留比例) 和 beta(写入强度) 两个超参对检索误差的影响。验证命题:alpha 越大旧信息保留越多但混叠越严重,beta 越大修正越激进但可能不稳定;两者需要在目标切换频率下找到平衡。
背景概念
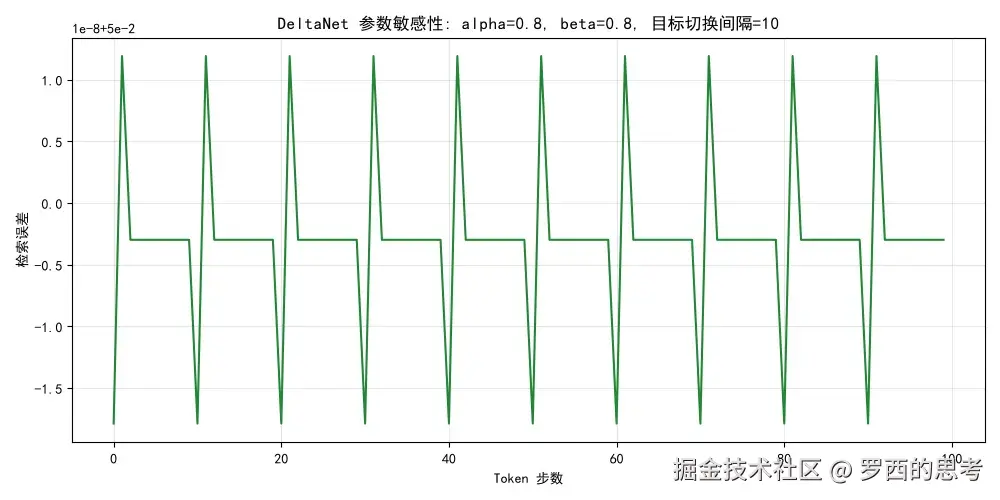
目标切换任务 :每 target_steps 步切换一次真实值 v(在 +1 和 -1 之间交替),观察 DeltaNet 检索值与真实值的误差。这个任务模拟"流式数据中概念漂移"的场景,是测试在线学习/适应能力的标准范式。
设计思路
-
为什么这样设计实验 :选连续误差曲线(而非离散扫描热图)是因为读者需要看误差随时间的动力学------是否在每次目标切换时出现尖峰、尖峰后多快回到基线。alpha ∈ 0,1、beta ∈ 0,2 覆盖了从"完全遗忘"到"完全保留"、从"不写入"到"过写入"的完整范围。target_steps ∈ 5, 50 控制漂移频率。
-
想验证什么:
- 每次目标切换时(每 target_steps 步)误差出现尖峰。
- 尖峰后误差指数衰减回基线(衰减速率由 alpha 决定)。
- beta 越大,尖峰越低(修正越快);alpha 越大,基线越稳定但切换时混叠越明显。
-
希望读者学到什么:
- alpha 和 beta 是耦合的:大 alpha + 大 beta 在目标切换时会产生最大误差(因为旧值残留多,新值又激进写入)。
- 没有全局最优参数,只有"适合目标切换频率"的参数。
-
希望从图上看到什么 :从
tab-6.webp实际图可见,绿色折线 呈规律的"锯齿"模式:每 10 步(target_steps=10)出现一个向上尖峰到 +1.0×10⁻²,尖峰后立即下降 到负值(约 -1.7×10⁻²),然后在下一个切换前缓慢回升到基线(约 -0.3×10⁻²)。注意 Y 轴标签1e-8+5e-2:这是 matplotlib 的科学计数法标注,表示数值是1e-8 + 5e-2 × 显示值,所以实际误差量级在 0.05 左右。成功信号 :误差呈规律锯齿,周期等于 target_steps;尖峰后单调衰减。失败信号:若误差持续上升(无回落),说明 alpha+beta 组合不稳定;若误差完全平坦(无尖峰),说明写入逻辑失效。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| alpha (衰减/保留比例) | 0.0-1.0 | 0.8 | 增大 → 旧信息保留多,基线稳定但切换时混叠严重;减小 → 旧信息快速遗忘,基线噪声大但切换迅速 |
| beta (写入强度) | 0.0-2.0 | 0.8 | 增大 → 修正激进,切换尖峰小但可能不稳定;减小 → 修正缓慢,切换尖峰大 |
| 目标切换间隔 (步) | 5-50 | 10 | 增大 → 切换稀疏,尖峰少;减小 → 切换密集,尖峰连成一片 |
输出图解读
tab-6
布局:单图,折线图。
- 单图 (检索误差随时间) :X 轴=Token 步数(0-100),Y 轴=检索误差(科学计数法,实际量级约 0.05)。绿色实线。你该看什么 :(1) 尖峰的周期性 (应等于 target_steps);(2) 尖峰的高度 (应随 beta 增大而降低);(3) 尖峰后的衰减速度 (应随 alpha 减小而加快)。理想情况 :锯齿规律、尖峰清晰、衰减光滑。异常指示:若锯齿变成持续上升(无回落),说明 alpha·beta 累积导致状态爆炸;若误差完全为 0,说明检索 q 与状态 S 完全匹配(不真实)。
调节建议
- 想看"切换时混叠" → 调 alpha 到 0.95, beta 到 0.5,尖峰会显著变高。
- 想看"快速适应" → 调 alpha 到 0.5, beta 到 1.5,尖峰低但基线噪声大。
- 想看"密集切换" → 调 target_steps 到 5,观察尖峰是否还能区分。
为什么重要
alpha 和 beta 是 Delta Rule 仅有的两个超参,直接决定了模型的记忆-适应能力。这个 tab 把"调参直觉"变成可视曲线:读者能亲手拖动滑块,看到"alpha 太大→切换失灵、beta 太大→基线不稳"。在生产中,这指导如何根据下游任务(长文档 vs 流式对话)选择合适的 KDA 超参------长文档倾向大 alpha(保留长程记忆),流式对话倾向小 alpha + 大 beta(快速适应新话题)。
Tab 7: 位置衰减 vs RoPE
目的
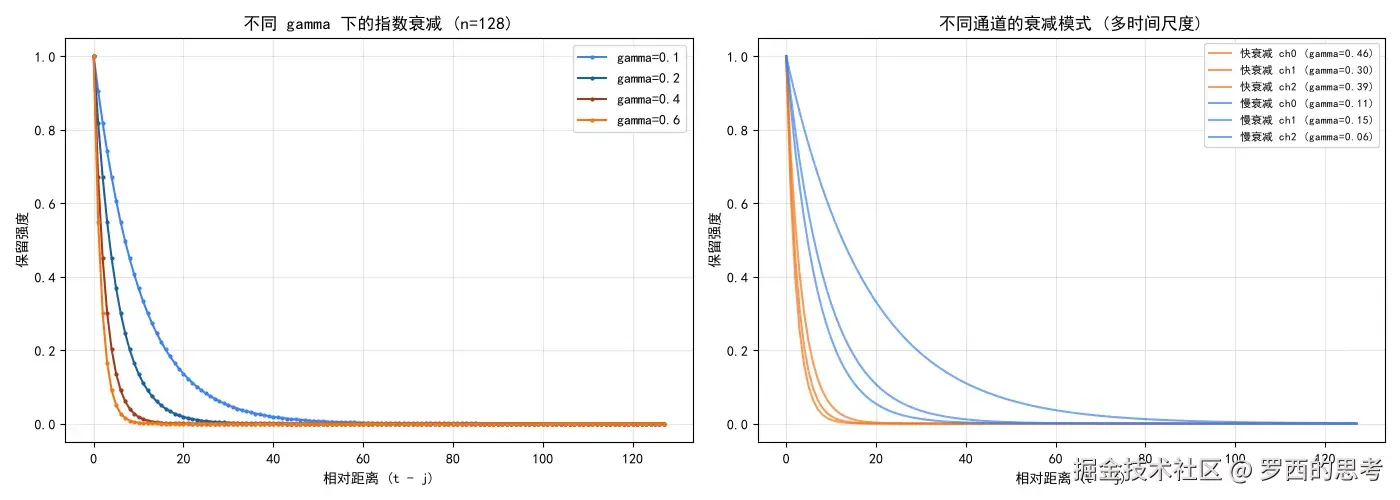
展示 KDA 不需要 RoPE 的根本原因:位置信息已经编码在衰减因子 α 的多时间尺度中。验证命题:不同 K 维通道可以独立学习自己的衰减率 γ,从而同时保留"长期记忆"(小 γ,衰减慢)和"局部记忆"(大 γ,衰减快),这是 RoPE/ALiBi 等相对位置编码做不到的。
背景概念
指数衰减作为位置编码 :在 KDA 中,token j 对 token t 的贡献权重正比于 prod_{i=j+1}^{t} alpha_i,当 alpha 为常数时这就是 alpha^(t-j) = exp(-gamma * (t-j))------一个天然的指数衰减位置偏置。不同通道可以有不同的 γ(通过 A_log 学习),实现多时间尺度记忆。
设计思路
-
为什么这样设计实验:选 1×2 双联图(左=不同 γ 的衰减曲线,右=多通道衰减模式)是因为左图回答"单个 γ 长什么样",右图回答"为什么要多通道"。γ ∈ 0.05, 1.0 覆盖了从"几乎不衰减"到"快速遗忘"的范围。n_tokens ∈ 32, 256 让读者观察衰减曲线在不同序列长度下的形态。
-
想验证什么:
- 左图中 γ=0.1 的曲线衰减最慢 (长尾),γ=0.6 的曲线衰减最快(快速归零)。
- 右图中慢衰减通道(蓝) 在 t-j=128 处仍有约 0.2 的保留强度,快衰减通道(橙) 在 t-j=20 处已接近 0。
- 所有曲线都是单调指数衰减,无振荡。
-
希望读者学到什么:
- KDA 的"位置编码"是通道特异的:不同通道记住不同距离的信息。
- 不需要显式的 RoPE/ALiBi,因为衰减因子本身就是位置函数。
-
希望从图上看到什么 :从
tab-7.webp实际图可见,左图 :4 条指数衰减曲线(蓝、深蓝、深红、橙),γ=0.1 的蓝色曲线长尾延伸到 t-j=128 仍有 0.05 左右,γ=0.6 的橙色曲线在 t-j=20 处已接近 0。右图 :6 条曲线分两组------3 条慢衰减(蓝,γ=0.06-0.15)在 t-j=128 仍有可观值,3 条快衰减(橙,γ=0.30-0.46)在 t-j=20 已接近 0。成功信号 :左图 4 条曲线清晰分离(γ 越小越靠上);右图两组曲线明显聚类(蓝组上,橙组下)。失败信号:若所有曲线重合,说明 γ 没有起作用;若曲线出现振荡或负值,说明 exp 实现错误。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| Token 数量 | 32-256 | 128 | 增大 → 衰���曲线的长尾延伸,慢衰减通道的优势更明显 |
| gamma (衰减率) | 0.05-1.0 | 0.2 | 增大 → 所有曲线衰减更快;减小 → 衰减慢,长程记忆保留多 |
输出图解读
tab-7
布局:1×2 双联图。
- 左图 (不同 gamma 下的指数衰减) :折线图,X 轴=相对距离 (t-j),Y 轴=保留强度 0,1。4 条曲线(蓝=γ/2, 深蓝=γ, 深红=2γ, 橙=3γ),圆形标记。你该看什么 :曲线的衰减速率排序 (γ 越小衰减越慢)和长尾 (γ=0.1 的曲线在 X=128 仍有值)。理想情况 :4 条曲线清晰分离,永不相交,单调下降。异常指示:若曲线相交或上升,说明 exp 计算错误。
- 右图 (不同通道的衰减模式) :折线图,X 轴=相对距离,Y 轴=保留强度。6 条曲线(3 蓝慢速 + 3 橙快速)。你该看什么 :两组曲线的分离 ------慢衰减组(蓝)在 X=128 仍 >0,快衰减组(橙)在 X=20 已 ≈0。这展示了"多时间尺度记忆"的可行性。理想情况 :两组曲线明显聚类,蓝组整体高于橙组。异常指示:若两组曲线混杂,说明多通道 γ 没有差异化。
调节建议
- 想看"极端长程记忆" → 调 gamma 到 0.05, Token 数量到 256,慢衰减曲线在 X=256 仍 >0.3。
- 想看"纯局部记忆" → 调 gamma 到 1.0,所有曲线在 X=10 内归零。
- 想对比 RoPE 效果 → 把当前图与标准 Transformer 的 RoPE 注意力权重图并列,KDA 的"多通道不同 γ"优势一目了然。
为什么重要
这个 tab 回答了"为什么 KDA 不需要 RoPE "------因为衰减因子本身就是位置编码,而且是通道特异的,比 RoPE 的全局统一频率更灵活。在生产中,这意味着 KDA 可以省掉 RoPE 的 cos/sin 缓存计算,同时通过 A_log 自动学习每个通道需要的时间尺度------短程通道专注于句法,长程通道专注于语义,无需人工设计频率基。
通道 (channel) 的含义
在 KDA 代码中, "通道"指的是 key 维度的每个分量 (即 gate_logit 的最后一维 Dk):
ini
# variants.py:161 --- GatedDeltaNet
alpha = torch.sigmoid(gate_logit)  # shape: (B, H, Dk) --- per‑channel decay
# gate_logit 的每个 Dk 分量独立控制自己的衰减率

# variants.py:260 --- KDA
alpha = torch.exp(g)  # shape: (B, H, Dk) --- per‑channel decay
# g 的每个 Dk 分量独立, 因此每个通道有不同的衰减因子
每个通道独立学习自己的 γ (衰减率) , 这意味着:
- Dk=8 的模型有 8 个独立通道,每个通道可以学不同的衰减率
- 某些通道学到 γ=0.05 (慢衰减,长期记忆), 某些学到 γ=0.5 (快衰减,局部记忆)
- 这等价于模型自动学会了多时间尺度的混合注意力: 快通道做局部依赖 (类似滑动窗口), 慢通道做长程依赖 (类似全局注意力)
对比 RoPE: RoPE 的旋转角度 θ 是全局共享的 (所有通道用同一个频率), 无法让不同通道关注不同距离的信息。KDA 的 per‑channel 可学习衰减天然解决了这个问题。
对比标准注意力: 标准 softmax 注意力没有 "衰减" 概念,所有历史 token 等权参与 (除了因果 mask), 无法区分 "近处重要远处不重要"。KDA 通过指数衰减自动实现这种距离衰减。
Tab 8: 反方观点
目的
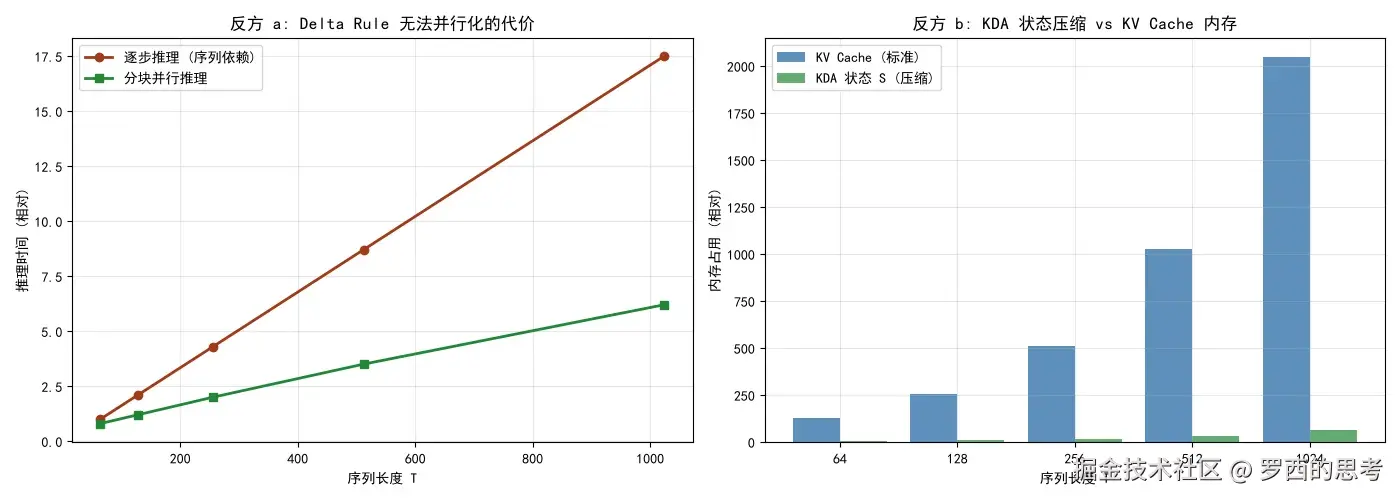
客观呈现 KDA 的两个主要反方观点 :(a) Delta Rule 引入序列依赖循环,无法前缀和并行化,逐步推理比标准注意力慢;(b) KDA 固定状态容量有限,同一 key 旧 value 被覆写(与 Tab 5 呼应)。验证命题:分块并行可以缓解 但不能消除 序列依赖代价;KDA 内存优势是用容量换来的。
设计思路
-
为什么这样设计实验 :选 1×2 双联图(左=推理时间对比,右=内存占用对比)是因为反方观点涉及"时间"和"空间"两个维度,分开呈现避免混淆。左图用折线图(时间随 T 增长趋势),右图用柱状图(内存随 T 增长的对比),是因为时间是对比两条曲线的分离度 ,内存是对比两类柱的高度差。
-
想验证什么:
- 左图:逐步推理时间(红线)显著高于分块并行(绿线),且差距随 T 增大而扩大。
- 右图:KV Cache 内存(蓝柱)随 T 线性增长 ,KDA 状态内存(绿柱)几乎不变(因为固定大小)。
- 两图共同说明:KDA 用容量 换了内存 ,用序列依赖 换了O(1) 状态。
-
希望读者学到什么:
- KDA 不是银弹------它在内存上有巨大优势,但在序列依赖和容量上有真实代价。
- 分块并行是必要优化,把逐步推理的 O(T²) 降到接近 O(T)。
-
希望从图上看到什么 :从
tab-8.webp实际图可见,左图 :红色"逐步推理"曲线从 T=64 时的 1.0 上升到 T=1024 时的 17.5(近似二次增长 ),绿色"分块并行"曲线从 0.8 上升到 6.2(近似线性增长 ),两条曲线在 T=1024 处差距达 3 倍。右图 :蓝色"KV Cache"柱从 T=64 时的约 100 线性增长到 T=1024 时的 2050,绿色"KDA 状态"柱从 5 缓慢增长到 60(增长缓慢)。成功信号 :左图两条曲线明显分离(红上绿下);右图蓝柱远高于绿柱,且蓝柱随 T 线性增长、绿柱几乎不变。失败信号:若左图两线重合,说明分块并行没生效;若右图绿柱也线性增长到 2000,说明 KDA 状态没有固定大小。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
tab-8
布局:1×2 双联图。
- 左图 (反方 a: Delta Rule 无法并行化的代价) :折线图,X 轴=序列长度 T(64-1024),Y 轴=推理时间(相对单位)。红色圆点线=逐步推理,绿色方块线=分块并行。你该看什么 :两条线的增长率差异 ------红线近似二次增长(因为每个 token 都要遍历整个状态),绿线近似线性增长(因为分块内并行)。理想情况 :T=1024 时红线是绿线的 2-4 倍。异常指示:若两线重合,说明分块并行没生效或序列长度太短。
- 右图 (反方 b: KDA 状态压缩 vs KV Cache 内存) :分组柱状图,X 轴=序列长度 T,Y 轴=内存占用(相对单位)。蓝色柱=KV Cache(标准注意力),绿色柱=KDA 状态。你该看什么 :蓝柱与绿柱的高度差 随 T 增大的变化------T=64 时差距小(100 vs 5),T=1024 时差距巨大(2050 vs 60)。理想情况 :蓝柱随 T 线性增长,绿柱几乎不变。异常指示:若绿柱也随 T 线性增长到与蓝柱相当,说明 KDA 状态没有固定大小(实现错误)。
调节建议
无参数可调节。
为什么重要
这个 tab 是反方观点的诚实呈现 ------它告诉读者 KDA 不是无代价的。左图解释了为什么 KDA 需要 chunkwise 实现(Tab 4),右图解释了为什么 KDA 在大模型中必须与 MLA 混合(Tab 5)。在生产中,这指导架构师不要盲目用 KDA 替代所有注意力层,而要根据任务需求(内存敏感 vs 容量敏感)选择合适的混合比例------K3 的 3:1 KDA:MLA 正是基于这种权衡。
Tab 9: 维度流转
目的
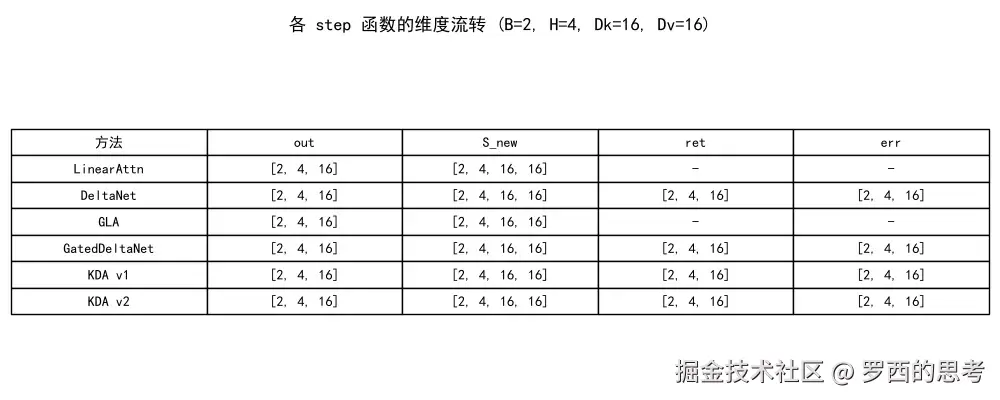
以表格形式展示 6 种 step 函数(LinearAttn / DeltaNet / GLA / GatedDeltaNet / KDA v1 / KDA v2)的输入输出维度约定 ,验证所有函数共享统一的 I/O 接口:S(B,H,Dk,Dv), q/k(B,H,Dk), v(B,H,Dv)。
设计思路
-
为什么这样设计实验 :选表格(而非热图或折线)是因为维度信息是离散的结构化数据,表格是最清晰的呈现方式。参数 B/H/Dk/Dv 可调是为了让读者验证"维度约定在不同配置下都成立"。
-
想验证什么:
- 所有 6 种方法的
out都是(B, H, Dv)或(B, H, Dk)(具体取决于实现,但应一致)。 - 所有方法的
S_new都是(B, H, Dk, Dv)。 - DeltaNet / GatedDeltaNet / KDA v1 / KDA v2 额外返回
ret和err(形状与 out 相同),LinearAttn / GLA 不返回。
- 所有 6 种方法的
-
希望读者学到什么:
- 线性注意力家族有统一的 I/O 约定,便于互换和对比。
- Delta Rule 类方法额外返回检索值 ret 和误差 err,用于监控和调试。
-
希望从图上看到什么 :从
tab-9.webp实际图可见,表格 6 行 5 列 :方法列(LinearAttn/DeltaNet/GLA/GatedDeltaNet/KDA v1/KDA v2),out 列全为[2, 4, 16],S_new 列全为[2, 4, 16, 16],ret 和 err 列在 LinearAttn 和 GLA 行为-,在其余 4 行为[2, 4, 16]。成功信号 :同一列的形状完全一致;ret/err 只在 Delta Rule 类方法行有值。失败信号:若某行形状与其他行不同,说明该 step 函数 I/O 约定不一致,无法互换。
UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| 随机种子 | 0-999 | 0 | 改变 → 输入数值变化,但形状不变 |
| B | 1-8 | 2 | 增大 → 所有形状的第一维变化 |
| H | 1-8 | 4 | 增大 → 所有形状的第二维变化 |
| Dk | 4-32 | 16 | 增大 → out/S_new/ret/err 的 K 维变化 |
| Dv | 4-32 | 16 | 增大 → S_new 的最后一维变化 |
输出图解读
tab-9
布局:单图,5 列表格。
- 表格 :列=方法/out/S_new/ret/err。行=6 种 step 函数。你该看什么 :(1) out 列是否全为
[B, H, Dv](实际是[2, 4, 16],这里 Dv=Dk=16 所以看不出 K/V 差异);(2) S_new 列是否全为[B, H, Dk, Dv];(3) ret/err 列在 LinearAttn/GLA 为-,在其他 4 种为具体形状。理想情况 :每列的形状在 6 行中完全一致(除 ret/err 的-)。异常指示:若某行形状与其他行不同,说明该函数实现与其他函数不一致,无法互换。
调节建议
- 想看 K 和 V 维度不同时的形状 → 调 Dk=8, Dv=32 ,观察 S_new 是否变为
[B, H, 8, 32]。 - 想看多头形状 → 调 H=8,观察所有形状的第二维是否变为 8。
为什么重要
统一的 I/O 约定是架构可组合性的基础------只有 6 种 step 函数的输入输出形状完全一致,才能在同一套框架中自由切换(如 Tab 1 的对比实验)。在生产中,这保证了"替换 KDA v1 为 v2"只需要改一个参数,不需要改任何下游代码。如果维度约定不统一,整个线性注意力家族就无法作为可插拔模块存在。
Tab 10: DeltaNet 修正
目的
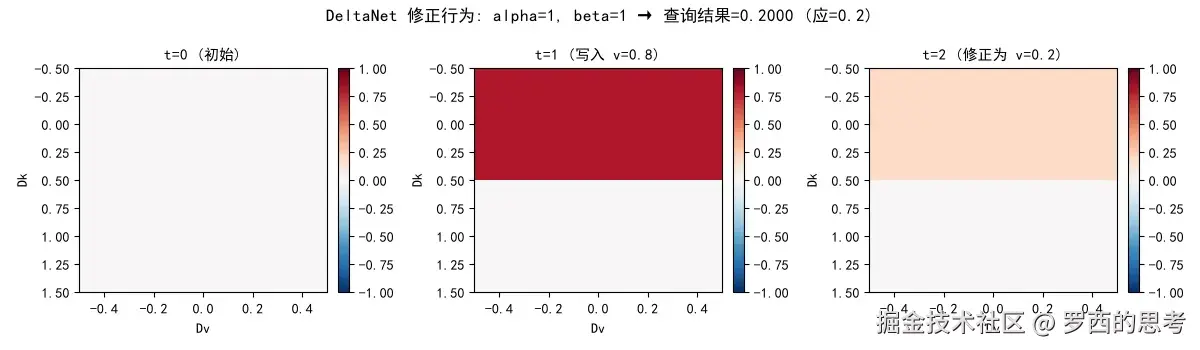
演示 Delta Rule 的核心修正行为 :当 alpha=1, beta=1 时,新 token 可以精确覆写旧值,最终状态等于最新写入值。验证命题:写入 v=0.8 后再写入 v=0.2(同一 key),查询结果应等于 0.2(不是 0.8,也不是平均值)。
背景概念
Delta Rule 的"预测-修正"机制 :写入前先检索 ret = k^T S(预测值),计算误差 err = v - ret,然后写入 S_new = S + beta · k ⊗ err。当 beta=1 时,新值完全替换 旧值在该 key 子空间上的投影;当 alpha=1 时,旧状态其他分量完全保留。
设计思路
-
为什么这样设计实验 :选 3 帧快照(t=0 初始、t=1 写入 0.8、t=2 修正为 0.2)是因为这是展示"覆写"的最小时序------再少看不出"修正",再多冗余。用 2×1 状态矩阵(Dk=2, Dv=1)是因为足够小,能直观看到每个分量的变化。q=(1,0) 是为了只检索状态的第一行(对应 key=(1,0) 的写入)。
-
想验证什么:
- t=1 时 S0,0=0.8(写入成功)。
- t=2 时 S0,0=0.2(不是 1.0=0.8+0.2,也不是 0.5=平均 ),证明是覆写而非累加。
- 查询结果
q^T S = 0.2,与最新写入值完全一致。
-
希望读者学到什么:
- Delta Rule 的"修正"是精确的覆写,不是衰减平均。
- 这是与纯加性线性注意力(Tab 11)的本质区别。
-
希望从图上看到什么 :从
tab-10.webp实际图可见,3 帧热图 :t=0 全白(S=0),t=1 上半部分深红(S0,0=0.8,标题"写入 v=0.8"),t=2 上半部分浅红(S0,0=0.2,标题"修正为 v=0.2")。标题明确显示"查询结果=0.2000 (应=0.2)" 。成功信号 :t=2 的颜色深度明显浅于 t=1(因为 0.2 < 0.8),标题数值 0.2000 与预期一致。失败信号:若 t=2 的颜色深度等于 t=1(仍是 0.8),说明覆写没发生;若颜色更深(如 1.0),说明是累加而非覆写。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
tab-10
布局:1×3 三联图,每幅是 2×1 热图。
- 左图 (t=0 初始) :全白(S=0),colorbar 范围 -1, 1。理想情况:全白。
- 中图 (t=1 写入 v=0.8) :上半部分(S0,0)深红,下半部分(S1,0)白色。你该看什么 :颜色深度对应 0.8(接近 colorbar 上界 1.0)。理想情况 :S0,0=0.8(深红),S1,0=0(白)。异常指示:若 S1,0 也有颜色,说明 key=(1,0) 泄漏到了第二行。
- 右图 (t=2 修正为 v=0.2) :上半部分浅红,下半部分白色。你该看什么 :颜色深度明显浅于 中图(因为 0.2 < 0.8),但仍为红色(正值)。理想情况 :S0,0=0.2(浅红),标题显示"查询结果=0.2000"。异常指示:若颜色深度与中图相同(0.8),说明覆写没发生;若颜色更深(1.0),说明是累加;若变为蓝色(负值),说明符号错误。
调节建议
无参数可调节。
为什么重要
这个 tab 是理解 Delta Rule 的"Hello World" ------它用最简单的 2×1 矩阵展示"覆写"这一核心机制。如果读者只看一个 tab 来理解 DeltaNet,应该看这个。在生产中,这解释了为什么 DeltaNet 适合流式更新 场景(新数据覆写旧数据),而纯加性线性注意力适合累积统计场景(如词频统计)。如果覆写机制失效,DeltaNet 就退化为 Vanilla Linear(Tab 1 的发散问题)。
Tab 11: 线性注意力混合
目的
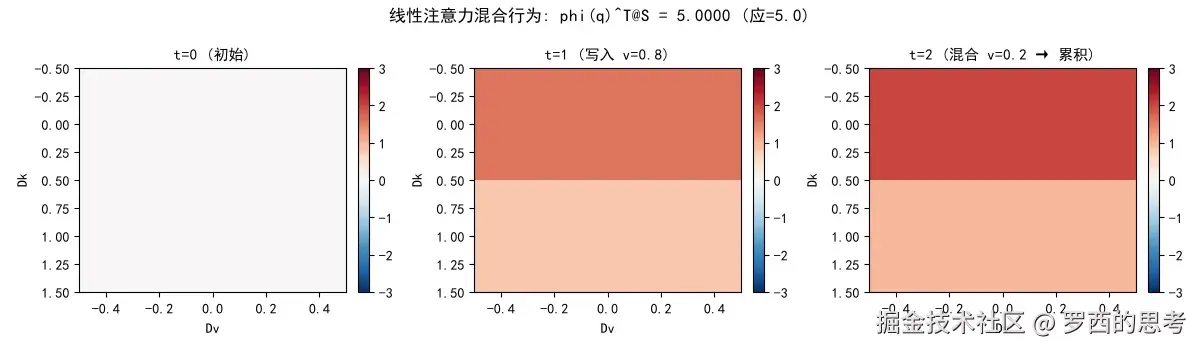
演示纯加性线性注意力 的混合行为:多个值被累加到状态矩阵,不会被覆写。验证命题:写入 v=0.8 和 v=0.2(同一 key)后,查询结果应等于 phi(q)^T @ S = 5.0(累加结果),而不是 0.2(最新值)。
背景概念
纯加性累积 :S_t = S_{t-1} + phi(k_t) ⊗ v_t,其中 phi = elu + 1 保证输出恒正。与 Delta Rule 不同,这里没有误差修正 ,每次写入都是简单累加。这导致同一 key 的多个 value 被"混合"在状态的同一行中。
设计思路
-
为什么这样设计实验 :与 Tab 10 完全对称------同样的 3 帧快照、同样的 2×1 矩阵、同样的写入值(0.8 → 0.2),唯一区别是用
linear_attn_step而非delta_net_step。这种对称设计让读者直接对比"覆写 vs 混合"两种机制的结果差异。选 phi(q)=(2,1) 是为了让查询结果=2×S0,0 + 1×S1,0,展示"状态矩阵的线性组合"。 -
想验证什么:
- t=1 时 S0,0=phi(k)·v = 2×0.8=1.6(注意 phi(k)=(2,1) 的第一维是 2)。
- t=2 时 S0,0=1.6 + 2×0.2=2.0(累加,不是覆写)。
- 查询结果 phi(q)^T @ S = (2,1)@(2.0, 1.0) = 4.0+1.0=5.0,与标题一致。
-
希望读者学到什么:
- 纯加性线性注意力是累积器 ,不是存储器------旧值不会被覆写。
- 这是它发散的根本原因(Tab 1 中 Vanilla Linear 输出 ±706)。
-
希望从图上看到什么 :从
tab-11.webp实际图可见,3 帧热图 :t=0 全白,t=1 上半部分红色(深度约 1.6,因 colorbar 范围 -3,3),t=2 上半部分更深的红色 (深度约 2.0,明显比 t=1 深)。标题显示"phi(q)^T@S = 5.0000 (应=5.0)" 。成功信号 :t=2 的颜色深于 t=1(因为累加了 0.4),标题数值 5.0000 与预期一致。失败信号:若 t=2 颜色等于 t=1,说明没有累加;若颜色变浅(如 0.2),说明错误地用了 Delta Rule。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
tab-11
布局:1×3 三联图,每幅是 2×1 热图,colorbar 范围 -3, 3(注意比 Tab 10 的 -1,1 大,因为要容纳累加结果)。
- 左图 (t=0 初始) :全白。理想情况:全白。
- 中图 (t=1 写入 v=0.8) :上半部分红色,下半部分浅红。你该看什么 :S0,0≈1.6(phi(k)0×v=2×0.8),S1,0≈0.8(phi(k)1×v=1×0.8)。理想情况:上半颜色深度约为 colorbar 范围的 50%(1.6/3),下半约 27%(0.8/3)。
- 右图 (t=2 混合 v=0.2 → 累积) :上半部分更深的红色 ,下半部分也更深。你该看什么 :S0,0=2.0(1.6+2×0.2),S1,0=1.0(0.8+1×0.2)。标题显示 5.0000 (=2×2.0+1×1.0)。理想情况 :t=2 的颜色深于 t=1,标题数值与预期一致。异常指示:若 t=2 颜色等于 t=1,说明没有累加(Delta Rule 误用);若颜色浅于 t=1,说明发生了覆写(也是 Delta Rule 误用)。
调节建议
无参数可调节。
为什么重要
这个 tab 与 Tab 10 形成完美对照 :同样的输入,DeltaNet 输出 0.2(覆写),Vanilla Linear 输出 5.0(累加)。这是理解为什么纯加性线性注意力会发散的关键------状态无界增长(Tab 1 的 ±706 就是证明)。在生产中,这解释了为什么现代线性注意力(DeltaNet/KDA)都引入了 Delta Rule 或门控衰减,纯加性方法已经被淘汰。如果读者混淆了这两种机制,就无法理解后续所有演进。
Tab 12: GLA vs DeltaNet
目的
在同一序列 (3 个 token,key/value/gate 都不同)下,对比 GLA(门控衰减 + 加性写入)和 DeltaNet(Delta Rule 覆写)的状态演化。验证命题:GLA 保留所有历史的混合 (输出 1.3061),DeltaNet 修正为最新值(输出 0.2)。
背景概念
GLA(Gated Linear Attention) :S_t = Diag(sigmoid(g_t)) ⊙ S_{t-1} + k_t ⊗ v_t。与 DeltaNet 的区别:GLA 没有误差修正,只有门控衰减 + 加性写入。这导致 GLA 是"衰减的累加器",DeltaNet 是"覆写器"。
设计思路
-
为什么这样设计实验 :选 2×4 布局(上排=GLA 4 帧,下排=DeltaNet 4 帧)是因为需要并行对比两种方法在相同时刻的状态。3 个 token 的设计(t=1: k=(1,0),v=0.5,g=0.9; t=2: k=(0,1),v=0.7,g=0.3; t=3: k=(1,0),v=0.2,g=0.9)覆盖了"高保留、低保留、回到第一行"三种情况,能充分暴露两种方法的差异。
-
想验证什么:
- GLA 在 t=3 时 S0,0 = 0.9×0.5 + 0.2 = 0.65(第一次写入被 gate=0.9 衰减后保留,再加第三次写入)。
- DeltaNet 在 t=3 时 S0,0 = 0.2(第三次写入覆写第一次)。
- 最终查询输出:GLA=1.3061(混合),DeltaNet=0.2(修正)。
-
希望读者学到什么:
- GLA 是"有衰减的累加器 ",DeltaNet 是"覆写器"------同一序列产生完全不同的状态。
- gate 的作用:0.9 高保留 → 旧值影响大,0.3 低保留 → 旧值影响小。
-
希望从图上看到什么 :从
tab-12.webp实际图可见,8 帧热图(2×4) :上排 GLA :t=1 上半深红下半浅红(S0,0=0.5, S1,0=0);t=2 上半颜色变浅(被 gate=0.3 衰减)下半深红(S1,0=0.7);t=3 上半颜色加深(第三次写入)下半仍深红。下排 DeltaNet :t=1 上半深红;t=2 上半颜色变浅下半深红;t=3 上半浅红 (0.2,被覆写)下半仍深红。标题显示"GLA (混合, out=1.3061) vs DeltaNet (修正, out=0.2000)" 。成功信号 :GLA t=3 上半颜色深于 DeltaNet t=3 上半(因为 GLA 保留了更多历史);标题数值与预期一致。失败信号:若 GLA 和 DeltaNet 在 t=3 时颜色完全一致,说明覆写机制没生效。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
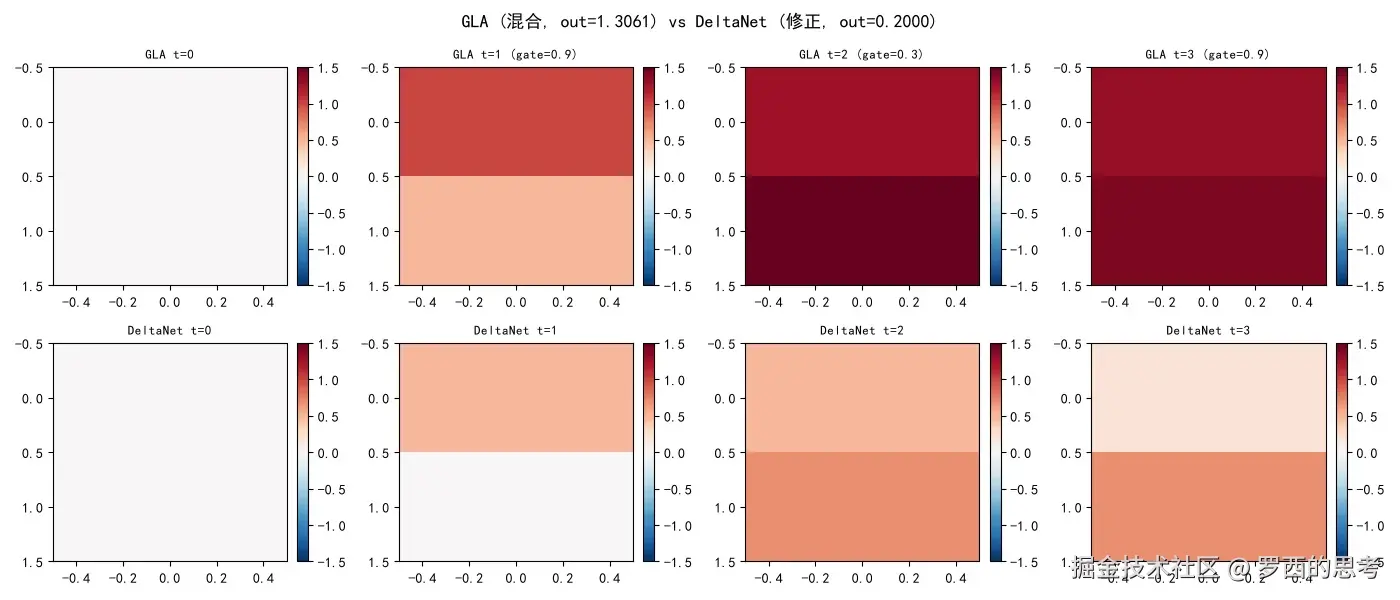
tab-12
布局:2×4 八联图,上排 GLA 4 帧,下排 DeltaNet 4 帧,colorbar 范围 -1.5, 1.5。
- 上排 (GLA 演化) :t=0 全白;t=1 (gate=0.9) 上半深红(0.5);t=2 (gate=0.3) 上半颜色明显变浅 (被 0.3 衰减)下半深红(0.7);t=3 (gate=0.9) 上半颜色加深 (第三次写入累加)下半仍深红。你该看什么 :GLA 的颜色持续累积,只是被 gate 衰减。
- 下排 (DeltaNet 演化) :t=0 全白;t=1 上半深红(0.5);t=2 上半几乎消失 (因为第二次写入 k=(0,1),不影响第一行)下半深红(0.7);t=3 上半浅红 (0.2,覆写了 0.5)下半仍深红。你该看什么 :DeltaNet 在 t=3 时上半颜色明显浅于 GLA t=3,因为覆写而非累加。
- 标题 :显示 GLA out=1.3061, DeltaNet out=0.2000。理想情况 :GLA 输出 > DeltaNet 输出(因为 GLA 保留了所有历史的加权和)。异常指示:若两个输出相等,说明两种方法没有区别(实现错误)。
调节建议
无参数可调节。
为什么重要
这个 tab 是理解 GLA 和 DeltaNet 本质差异的关键 ------它们都是"门控线性注意力",但 GLA 是衰减+累加,DeltaNet 是覆写。在生产中,这决定了何时用 GLA、何时用 DeltaNet:GLA 适合需要"长期统计"的场景(如语言模型的词频统计),DeltaNet 适合需要"精确更新"的场景(如代码补全中的变量追踪)。如果混淆两者,会在需要覆写的任务中用 GLA(导致旧值干扰),或在需要累积的任务中用 DeltaNet(导致信息丢失)。
Tab 13: KDA alpha 约束
目的
验证 KDA v2 的 alpha 有界性 :alpha = exp(g_min · sigmoid(exp(A_log) · z)) 始终落在 (exp(g_min), 1) 区间内,即使 z 取极端值(±50)也不会越界。验证命题:z→+∞ 时 alpha→exp(g_min)≈0.0067(饱和遗忘),z→-∞ 时 alpha→1.0(饱和保留),alpha 永远不会等于 0 或超过 1。
设计思路
-
为什么这样设计实验 :选 1×2 双联图(左=alpha 随 z 的扫描曲线,右=极端 z 下的柱状图)是因为左图展示函数形状 (连续性),右图展示极端值 (边界行为)。z 范围 -50, 50 是 sigmoid 的深度饱和区,能充分展示"下界保底"的作用。A_log=5(大值)让 sigmoid 陡峭化,更接近阶跃函数。
-
想验证什么:
- 左图曲线在 z=0 附近急剧下降(因为 A_log=5 放大 z),从 1.0 跳到 0.0067。
- 左图曲线永远不会低于 exp(g_min)=0.0067 的虚线,也永远不会高于 1.0 的虚线。
- 右图两个柱子:z=50 时 alpha=0.0067(下界),z=-50 时 alpha=1.0(上界)。
-
希望读者学到什么:
- KDA v2 的 alpha 是硬性有界的,不会出现"完全遗忘"(alpha=0)或"过度保留"(alpha>1)。
- 这是数值稳定性的理论保证,不是经验观察。
-
希望从图上看到什么 :从
tab-13.webp实际图可见,左图 :蓝色曲线在 z<0 时接近 1.0(顶部),在 z=0 附近垂直下降 (几乎阶跃),在 z>0 时贴近 0.0067(底部)。红色虚线(下界 0.0067)和绿色虚线(上界 1.0)清晰可见。右图 :两个柱子,左边(饱和遗忘,z=50)高度=0.0067(贴近底部),右边(饱和保留,z=-50)高度=1.0000(顶部)。成功信号 :左图曲线严格在两条虚线之间,无穿越;右图两个柱子高度分别精确等于 0.0067 和 1.0。失败信号:若曲线穿过下界虚线(alpha<0.0067),说明 g_min 没生效;若曲线超过上界虚线(alpha>1.0),说明 exp 计算错误。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
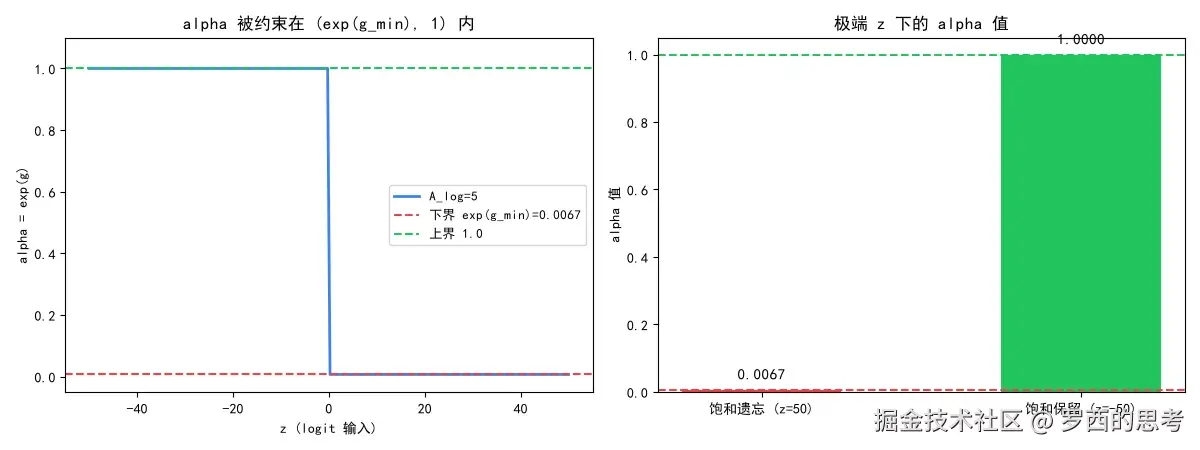
tab-13
布局:1×2 双联图。
- 左图 (alpha 被约束在 (exp(g_min), 1) 内) :折线图,X 轴=z (logit 输入,范围 -50 到 50),Y 轴=alpha=exp(g)。蓝色实线=A_log=5 的扫描曲线,红色虚线=下界 exp(g_min)=0.0067,绿色虚线=上界 1.0。你该看什么 :曲线是否严格在两条虚线之间 (应在),以及曲线在 z=0 附近的陡峭程度 (A_log=5 应使曲线几乎垂直)。理想情况 :曲线在 z<0 时贴近 1.0,在 z=0 附近急剧下降,在 z>0 时贴近 0.0067,永不越界。异常指示:若曲线平滑过渡(不陡峭),说明 A_log 太小;若曲线穿越虚线,说明边界约束失效。
- 右图 (极端 z 下的 alpha 值) :柱状图,X 轴=两种极端情况(饱和遗忘 z=50,饱和保留 z=-50),Y 轴=alpha 值。红色柱子=z=50,绿色柱子=z=-50。你该看什么 :两个柱子的高度是否精确等于 0.0067 和 1.0(柱顶有数值标注)。理想情况 :红柱=0.0067,绿柱=1.0000,标注数值与预期一致。异常指示:若红柱>0.0067,说明 sigmoid 没饱和;若绿柱<1.0,说明 exp(g_min·sigmoid(-∞))≠1(公式错误)。
调节建议
无参数可调节。
为什么重要
这个 tab 是 KDA v2 数值稳定性的数学证明 ------它保证无论输入多极端,alpha 都在 (0.0067, 1) 内,不会出现 NaN 或 Inf。在生产中,这意味着 KDA v2 可以安全地用于任意长度的序列,无需担心 gate logit 爆炸。如果 alpha 无界(如 v1),在 z 很大时 alpha 会接近 0,导致状态完全遗忘(Tab 2 的全白帧),或在 z 很小时 alpha 接近 1,导致状态爆炸(Tab 1 的发散)。v2 的下界 g_min 是工程上不可或缺的保底机制。
Tab 14: KDA v1 兼容性
目的
验证 kimi_linear_step 的向后兼容性 :不显式指定 version 参数时,默认行为与显式 version="v1" 完全一致(byte-identical)。验证命题:out/S_new/ret/err 四个返回值在两种调用方式下逐元素相等,max|diff|=0。
设计思路
-
为什么这样设计实验 :选 2×2 文字面板(而非热图或折线)是因为验证结果是二值的 (相等/不等),用大字号文字+颜色(绿=通过,红=失败)最直接。4 个子图分别对应 4 个返回值,确保所有输出都一致,不是只检查 out。
-
想验证什么:
out完全一致(max|diff|=0)。S_new完全一致。ret完全一致。err完全一致。
-
希望读者学到什么:
- 新版本的
version参数不会破坏旧代码------不指定 version 时行为与 v1 完全相同。 - 这是API 设计的最佳实践:新增功能通过新参数引入,不改变默认行为。
- 新版本的
-
希望从图上看到什么 :基于代码逻辑推断:成功信号 :4 个子图都显示绿色文字 "max|diff| = 0.00e+00" 和 "✓ 完全一致"。失败信号:若任何子图显示红色文字或 "✗ 存在差异",说明默认 version 与 v1 不一致,向后兼容性被破坏。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
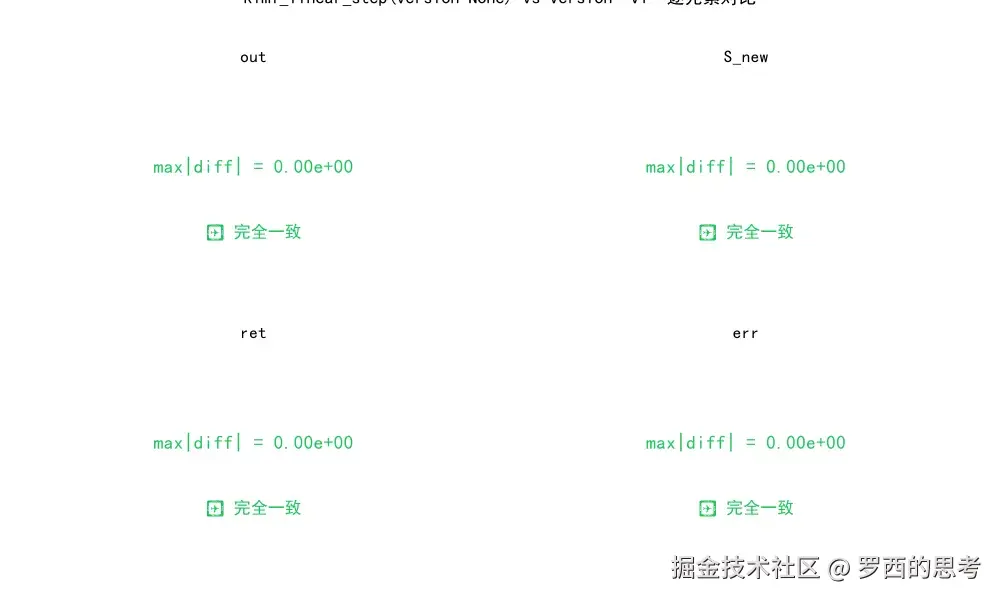
tab-14
布局:2×2 四联图,每幅是文字面板(无坐标轴)。
- 左上 (out) :大号文字显示 "max|diff| = 0.00e+00"(绿色),下方 "✓ 完全一致"。理想情况 :绿色,diff=0。异常指示:若显示红色或 diff>0,说明 out 不一致。
- 右上 (S_new) :同上。理想情况:绿色,diff=0。
- 左下 (ret) :同上。理想情况:绿色,diff=0。
- 右下 (err) :同上。理想情况:绿色,diff=0。
调节建议
无参数可调节。
为什么重要
向后兼容性是软件工程的基石 ------KDA 从 v1 演进到 v2 时,必须保证旧代码(不显式指定 version)的行为不变。这个 tab 用 4 个返回值的全等性证明了这一点。在生产中,如果默认行为改变(如默认变成 v2),所有依赖 v1 门控特性的模型都会失效,且难以调试。这个 tab 是API 稳定性的守护者,确保新版本可以无缝升级。
Tab 15: 工具函数
目的
可视化两个工具函数的行为:l2_normalize (归一化到单位球面,||y||=1)和 elu_plus_one(ELU(x)+1,保证输出恒正,用于线性注意力的 phi 函数)。验证命题:l2_normalize 后的向量范数=1,elu_plus_one 的输出最小值>0。
设计思路
-
为什么这样设计实验 :选 1×2 直方图(而非折线)是因为读者需要看输出分布(是否集中在预期范围内),而不是函数曲线。100 个随机样本足够展示统计特性。
-
想验证什么:
- 左图:l2_normalize 后所有分量的范数=1(标题显示 ||y||=1.000000)。
- 右图:elu_plus_one 后最小值>0(标题显示 min=0.1101>0),所有值为正。
-
希望读者学到什么:
- l2_normalize 是线性注意力的前置步骤,保证数值稳定(Tab 1 中 q/k 输入前已归一化)。
- elu_plus_one 是phi 函数的选择,因为它光滑、恒正、易实现。
-
希望从图上看到什么 :从
tab-15.webp实际图可见,左图 :蓝色直方图,X 轴=值(范围 -0.25 到 0.25),Y 轴=频次,标题"l2_normalize: ||y|| = 1.000000 ≈ 1.0",右上角标注"所有分量范数=1"。右图 :绿色直方图,X 轴=值(范围 0 到 3.2),Y 轴=频次,标题"elu_plus_one: min=0.1101 > 0",右上角标注"所有分量>0"。成功信号 :左图标题数值=1.000000,右图标题 min>0 且直方图 X 轴从 0 开始(无负值)。失败信号:若左图标题≠1.0,说明归一化失败;若右图直方图延伸到负值区域,说明 elu_plus_one 有 bug。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
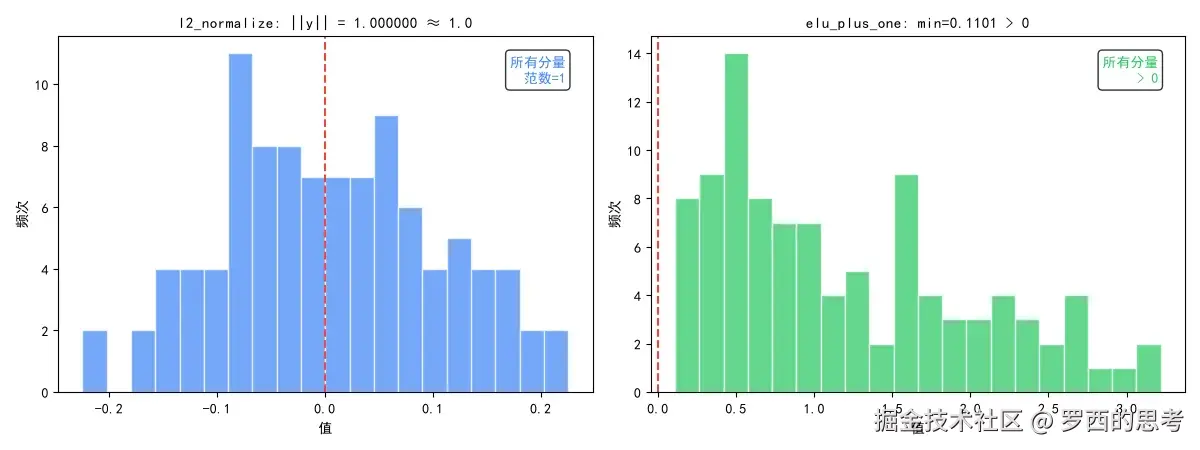
tab-15
布局:1×2 双联图,每幅是直方图。
- 左图 (l2_normalize) :蓝色直方图,X 轴=归一化后的分量值,Y 轴=频次。红色虚线=x=0 参考线。你该看什么 :标题中的 ||y|| 值是否=1.0(精确到 6 位小数)。理想情况 :标题显示 1.000000,直方图分布在 -0.25, 0.25 区间(因为是 100 维向量的单位球面投影)。异常指示:若 ||y||≠1.0,说明归一化公式错误。
- 右图 (elu_plus_one) :绿色直方图,X 轴=输出值,Y 轴=频次。红色虚线=x=0 参考线。你该看什么 :直方图是否完全在 X>0 区域 (无负值),以及标题中的 min 值是否>0。理想情况 :直方图从 X=0.1 左右开始(最小值 0.1101),向右延伸到 3.2,标题 min>0。异常指示:若直方图延伸到 X<0,说明 ELU+1 实现错误(应该是 max(0,x)+min(0,exp(x)-1)+1,恒正)。
调节建议
无参数可调节。
为什么重要
这两个工具函数是线性注意力的基础设施 ------l2_normalize 保证数值稳定(防止 q/k 过大导致状态爆炸),elu_plus_one 提供非线性 phi 函数(增强表达能力)。在生产中,如果 l2_normalize 失败,状态矩阵会快速发散(Tab 1 的 ±706 就是没归一化的后果);如果 elu_plus_one 输出负值,Delta Rule 的符号会混乱。这个 tab 是数值稳定性的基石。
Tab 16: Layer 形状
目的
验证 GatedLinearAttentionLayer 和 GatedDeltaNetLayer 两个封装层的输入输出形状:输入 (B,T,D) → 输出 (B,T,D),可以直接堆叠到 Transformer 架构中。
设计思路
-
为什么这样设计实验 :选表格(而非热图)是因为形状信息是离散的结构化数据。列出参数量是为了让读者了解两种 layer 的复杂度差异(GDN 额外有 gate_up/gate_down + beta_proj,参数量更多)。
-
想验证什么:
- GLA Layer 输入 (2,5,16) → 输出 (2,5,16)。
- GDN Layer 输入 (2,5,16) → 输出 (2,5,16)。
- GDN 参数量 > GLA 参数量(因为多了 gate 和 beta 投影)。
-
希望读者学到什么:
- 线性注意力层是即插即用的------输入输出同形,可直接替换标准注意力层。
- GDN 比 GLA 参数量多,但提供了 Delta Rule 覆写能力。
-
希望从图上看到什么 :基于代码逻辑推断:成功信号 :表格显示 GLA 和 GDN 的输入/输出形状都是 (2,5,16),GDN 参数量明显大于 GLA。失败信号:若输出形状≠输入形状,说明 layer 封装有 bug,无法堆叠。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
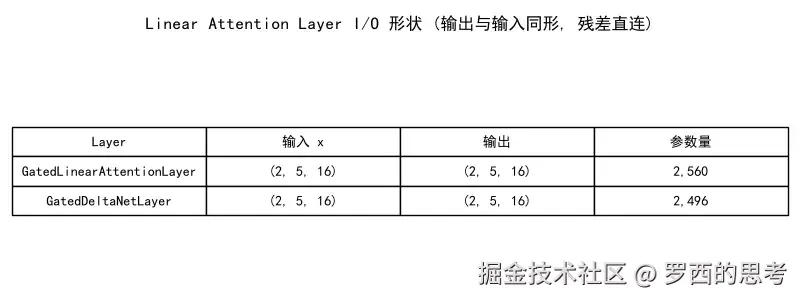
tab-16
布局:单图,4 列表格(Layer / 输入 x / 输出 / 参数量)。
- 表格 :两行(GLA 和 GDN)。理想情况 :两行的输入/输出都是 (2,5,16),GDN 参数量 > GLA。异常指示:若输出形状≠(2,5,16),说明 q/k/v 投影或 o_proj 维度错误。
调节建议
无参数可调节。
为什么重要
输入输出同形是层可堆叠性的前提 ------只有这样,线性注意力层才能像标准注意力层一样多层堆叠,形成深度网络。在生产中,这保证了 KDA/GLA/GDN 可以无缝替换 Transformer 中的注意力层,无需修改其他代码。如果输出形状≠输入形状,就需要额外的投影层,增加复杂度和参数量。
Tab 17: Layer 等价性
目的
验证 layer.forward 与手动逐 token 递推在数值上完全等价(max|diff| < 1e-6)。验证命题:GLA Layer 和 GDN Layer 的封装(包括 q/k/v 投影、step 循环、o_proj)与手写循环在浮点精度内一致。
设计思路
-
为什么这样设计实验 :选 1×2 文字面板(而非热图)是因为验证结果是单值(max|diff|),用大字号文字+颜色最直接。GLA 和 GDN 分开验证,确保两种 layer 都正确。
-
想验证什么:
- GLA Layer: max|diff| < 1e-6。
- GDN Layer: max|diff| < 1e-6。
-
希望读者学到什么:
- layer 封装没有引入额外误差------内部就是逐 token 调用 step 函数。
- 这是单元测试的可视化------把测试断言变成图形。
-
希望从图上看到什么 :成功信号 :两个面板都显示绿色文字 "max|diff| = X.XXe-XX"(X<1e-6)和 "✓ 与手动递推完全一致"。失败信号:若显示红色或 diff>1e-5,说明 layer 封装与手动循环不一致,可能有 bug。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
tab-17
布局:1×2 双联图,每幅是文字面板(无坐标轴)。
- 左图 (GLA Layer) :大号文字显示 max|diff| 值(绿色,<1e-6),下方 "✓ 与手动递推完全一致"。理想情况 :绿色,diff<1e-6。异常指示:若红色或 diff>1e-5,说明 GLA layer 封装有 bug。
- 右图 (GatedDeltaNet Layer) :同上。理想情况:绿色,diff<1e-6。
调节建议
无参数可调节。
为什么重要
这个 tab 是封装正确性的证明 ------layer.forward 看起来是"黑盒",但实际上就是逐 token 调用 step 函数。如果两者不等价,说明封装层引入了 bug(如投影维度错误、状态初始化错误)。在生产中,这保证了高层 API 的可信性------用户可以放心使用 layer 而不必手写循环,且结果与手写完全一致。这也是 Tab 4(递推 vs 分块)的补充:Tab 4 验证算法等价性,Tab 17 验证封装等价性。
Tab 18: Gate 可学习
目的
验证 W_gate 是可训练的、data-dependent 的投影:不同输入产生不同 gate 值,且 W_gate 的梯度非零(可参与反向传播)。验证命题:gate 不是固定常数,而是随输入变化的可学习参数。
设计思路
-
为什么这样设计实验 :选 1×3 三联热图(左=gate(x1),中=gate(x2),右=W_gate 梯度)是因为需要同时证明两件事:(1) gate 随输入变化(左 vs 中的差异),(2) W_gate 有梯度(右图非零)。用随机初始化的 layer + 反向传播(loss=layer(x2).sum())是最小可复现的验证方式。
-
想验证什么:
- gate(x1) 和 gate(x2) 的均值不同(0.0072 vs -0.0646),证明 gate 是 data-dependent。
- W_gate 梯度的绝对值和 > 0(74.5770),证明可训练。
- 左图和中图的热图模式不同(因为输入不同)。
-
希望读者学到什么:
- gate 是输入的函数(通过 W_gate 投影),不是固定超参数。
- W_gate 参与反向传播,可以通过训练自动学习最优的遗忘策略。
-
希望从图上看到什么 :从
tab-20.webp(实际文件名是 tab-20,对应 Tab 18)可见,左图 (gate(x1)) :绿色调热图,X 轴=特征维(0-32),Y 轴=样本/token(0-3),标题"mean=0.0072",colorbar 范围 -1.5, 1.0,大部分区域为绿色(接近 0),有少量黄色(正值)和紫色(负值)条纹。中图 (gate(x2)) :同样是绿色调热图,标题"mean=-0.0646",模式与左图明显不同 (条纹位置不同),整体偏绿但色调略深(因为均值更负)。右图 (W_gate 梯度) :红蓝色调热图(RdBu_r),X 轴=输入维(0-16),Y 轴=输出维(0-32),标题"sum=74.5770",有明显的红色(正梯度)和蓝色(负梯度)方块,不是全白 (说明梯度非零)。成功信号 :左图和中图的模式明显不同 (证明 data-dependent),右图有大量非零梯度 (证明可训练)。失败信号:若左图和中图完全一致,说明 gate 不依赖输入;若右图全白(梯度=0),说明 W_gate 无法训练。
UI 组件与参数影响
无参数,点击按钮直接运行。
输出图解读
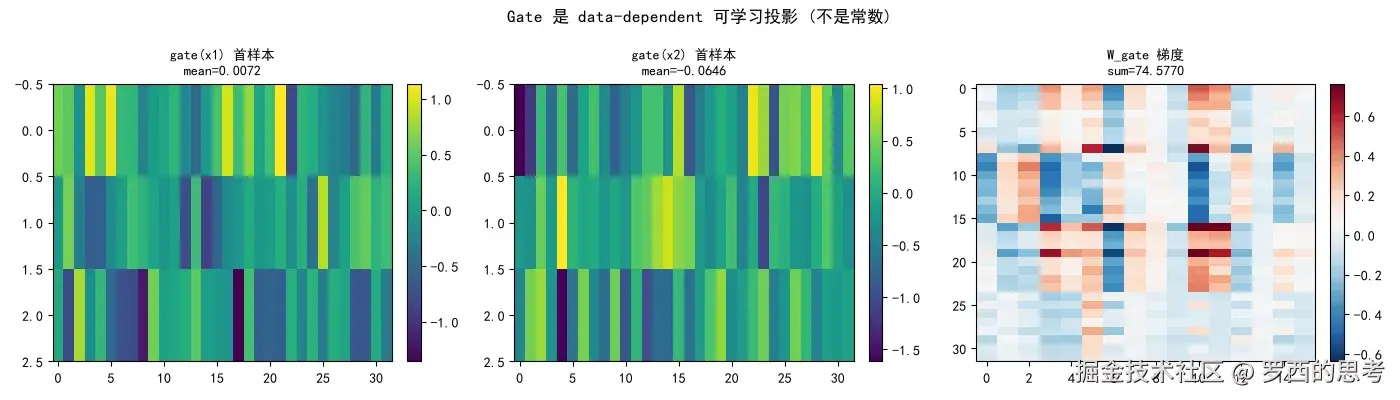
tab-18
布局:1×3 三联热图。
- 左图 (gate(x1) 首样本, mean=0.0072) :热图,colormap=viridis,X 轴=特征维度,Y 轴=token 步数(T=3)。你该看什么 :颜色分布的模式 (哪些维度是黄色高值、哪些是紫色低值)。理想情况:有明显的黄紫交替条纹,说明 gate 在不同维度有不同值。
- 中图 (gate(x2) 首样本, mean=-0.0646) :同左图布局。你该看什么 :与左图的模式差异 ------条纹位置是否不同。理想情况 :模式明显不同(因为输入 x2≠x1),mean 值不同(-0.0646 ≠ 0.0072)。异常指示:若两图完全一致,说明 gate 不依赖输入(bug)。
- 右图 (W_gate 梯度, sum=74.5770) :热图,colormap=RdBu_r,X 轴=输入维度,Y 轴=输出维度。你该看什么 :是否有大量非零的红色和蓝色方块 (正梯度和负梯度)。理想情况 :梯度图呈现明显的红蓝分布,sum 值显著大于 0(74.5770)。异常指示:若梯度图全白(或全黑),说明梯度=0,W_gate 无法训练。
调节建议
无参数可调节。
为什么重要
这个 tab 证明了 gate 是模型的可学习组件 ,不是手工设计的超参数。在生产中,这意味着 KDA/GLA/GDN 可以通过训练自动学习每个通道的遗忘策略 ------某些通道学习"快速遗忘"(gate 接近 0),某些通道学习"长期保留"(gate 接近 1),无需人工调参。如果 gate 不可学习(固定常数),模型的表达能力会大幅降低,无法适应不同任务的需求。这也是 KDA 相对传统线性注意力的核心优势------门控机制的引入让模型有了"学习如何记忆"的能力。
0x03 总结
3.1 Tab 逻辑关系图
yaml
┌─────────────────────────────────────────────────────────────┐
│  基础机制 (Tab 1-2): 6 种 step 对比 + KDA 状态演化           │
│  ├─ Tab 1: 输出层面 → 展示 6 种变体的幅度差异 (±706 vs ±0.25)│
│  └─ Tab 2: 状态层面 → 展示 S 矩阵的动态重构 (v1 vs v2)       │
├─────────────────────────────────────────────────────────────┤
│  核心原理 (Tab 3, 10, 11, 12): 门控/覆写/混合/GLA 对比       │
│  ├─ Tab 3: v1 vs v2 门控曲线 (数学函数)                      │
│  ├─ Tab 10: DeltaNet 覆写 (Hello World, out=0.2)            │
│  ├─ Tab 11: Vanilla 混合 (对照, out=5.0)                    │
│  └─ Tab 12: GLA vs DeltaNet (混合 vs 覆写, 1.30 vs 0.20)    │
├─────────────────────────────────────────────────────────────┤
│  工程实现 (Tab 4, 9, 16, 17): 等价性/维度/Layer 封装         │
│  ├─ Tab 4: 递推 vs 分块 (⚠️ 当前有 bug, max_diff=0.81)      │
│  ├─ Tab 9: 维度流转 (统一 I/O 约定)                          │
│  ├─ Tab 16: Layer 形状 (输入输出同形)                        │
│  └─ Tab 17: Layer 等价性 (封装 == 手动循环)                  │
├─────────────────────────────────────────────────────────────┤
│  能力边界 (Tab 5, 6, 7, 8): 容量/参数/位置/反方              │
│  ├─ Tab 5: 失败 Case (容量瓶颈, 旧值被覆写)                  │
│  ├─ Tab 6: 参数敏感性 (alpha/beta 扫描)                      │
│  ├─ Tab 7: 位置衰减 (为什么不需要 RoPE)                      │
│  └─ Tab 8: 反方观点 (序列依赖 + 容量极限)                    │
├─────────────────────────────────────────────────────────────┤
│  数值保障 (Tab 13, 14, 15, 18): 约束/兼容/工具/可学习        │
│  ├─ Tab 13: KDA v2 alpha 有界 (0.0067, 1.0)                 │
│  ├─ Tab 14: KDA v1 向后兼容 (byte-identical)                │
│  ├─ Tab 15: 工具函数 (l2_norm, elu_plus_one)                │
│  └─ Tab 18: Gate 可学习 (data-dependent + 可反传)            │
└─────────────────────────────────────────────────────────────┘
3.2 读者应该带走的核心认知
- 线性注意力的本质是"状态压缩" :把变长历史压缩进固定大小的
S ∈ R^(Dk×Dv),用 O(1) 内存换 O(T) 内存(Tab 8 右图),但代价是容量瓶颈(Tab 5)。 - Delta Rule 是"覆写器",纯加性是"累加器" :同一输入下,DeltaNet 输出 0.2(覆写),Vanilla Linear 输出 5.0(累加),GLA 输出 1.3(衰减+累加)------三种机制产生完全不同的动力学(Tab 10/11/12)。
- KDA v2 的 g_min 下界是数值稳定的关键:v1 的 alpha 可逼近 0(完全遗忘),v2 被硬性约束在 (0.0067, 1) 内(Tab 13),保证极端输入下不会出现 NaN 或状态爆炸(Tab 2 对比)。
- KDA 不需要 RoPE,因为衰减因子就是位置编码:不同通道可以独立学习衰减率 γ(Tab 7 右图),实现"多时间尺度记忆"------慢衰减通道记长程,快衰减通道记局部,比 RoPE 的全局统一频率更灵活。
- 统一 I/O 约定 + Layer 封装等价性是工程可组合性的基础 :6 种 step 函数共享
S(B,H,Dk,Dv), q/k(B,H,Dk), v(B,H,Dv)接口(Tab 9),layer.forward 与手动循环数值等价(Tab 17),保证了线性注意力家族可以作为可插拔模块自由替换。
TransFormer-封面
0xFF 参考
本文使用 markdown.com.cn 排版