List 是 Redis 里最容易被"想当然地用错"的类型 ------很多人觉得它不就是个链表嘛,LPUSH+RPOP 就是队列,BRPOP 就是阻塞队列,结果线上踩了阻塞连接不释放、消费者重复消费、大 List 阻塞、阻塞超时丢消息等一连串坑却不知道根因。
本篇只聚焦三件事:命令组合(栈/队列/环形三种用法)、quicklist 编码(为什么 List 从 3.2 起换了底层、list-max-listpack-size 怎么调)、阻塞操作的 6 个边界(BLPOP/BRPOP 最容易踩的坑)。quicklist 的压缩节点结构、rax 树的源码实现、消息队列的完整架构选型(包括消费者组、消息确认、死信)我会放到后面的原理篇与 Stream 篇来讲,本篇只回答"List 本身能不能胜任你手头的队列任务"这一个问题。
一、开篇导读
1.1 List 在 Redis 体系中的定位
Redis 有 7 种基础数据类型:String、List、Hash、Set、Sorted Set、Bitmap、HyperLogLog。其中 List 是唯一一个天然支持有序集合操作的类型------你可以从左边推入、右边弹出,也可以按索引随机访问、按范围截取。这种"既像队列又像栈、还能当数组用"的灵活性,让 List 成为 Redis 最常被误用的类型之一。
1.2 开发者普遍存在的认知误区
我在生产环境见过太多"用 List 干不该它干的事"的案例:
- 把 List 当消息队列用,结果 BRPOP 超时设成 0(无限阻塞),进程一挂消息全丢;
- 用 LPUSH + LTRIM 做"最新 N 条"列表,结果列表长到几十万条,LTRIM 每次都要遍历删除旧元素,CPU 直接打满;
- 用 List 存用户时间线,一条推文就 2KB,10 万粉丝的时间线 List 就 200MB,GET 一次阻塞主线程半秒;
- 用 LPUSH/RPOP 实现工作队列,没有重试机制、没有死信队列,消息丢了连日志都没有。
这些问题的根因,是对 List 的底层机制不了解 、对命令的边界条件没把握。
1.3 本文结构
我们将按以下顺序展开:
- 核心命令全集:覆盖 LPUSH/RPOP 家族、阻塞操作、范围操作、List 专属冷门命令,附 .NET API 对照;
- 底层编码机制:从 ziplist 到 quicklist 的演进,节点阈值配置如何影响你的性能;
- 生产场景实战:消息队列、最新列表、栈/队列/环形缓冲区、消费者组替代方案;
- 内存占用估算:单 Key 容量公式 + 百万条数据的内存测算;
- 与 Stream 的选型对比:List 队列 vs Stream 消费者组,一张表选清楚;
- 高频线上坑点:10 条生产踩坑总结。
1.4 读完本文的收获
- 掌握 List 全部命令及 .NET/Java SDK 对应 API;
- 理解 quicklist 的节点阈值配置及调优方法;
- 能用 List 实现可靠的消息队列、时间线、栈/队列/环形缓冲区;
- 知道 List 在什么场景该换 Stream,选型有据可依;
- 避开 10 个生产环境常见坑。
二、核心命令全集
本节只讲 List 命令语义、参数边界、时间复杂度;不聊底层存储格式。
2.1 写入与弹出:四种组合决定四种结构
List 的写入只有两端,弹出也只有两端。写端和取端的组合,决定了它在逻辑上是队列、栈还是环形缓冲。
ini
LPUSH key v1 v2 v3     # 从左端依次插入,最终顺序 v3, v2, v1
RPUSH key v1 v2 v3     # 从右端依次插入,最终顺序 v1, v2, v3
LPOP key [count]       # 从左端弹出,count 参数 6.2+
RPOP key [count]       # 从右端弹出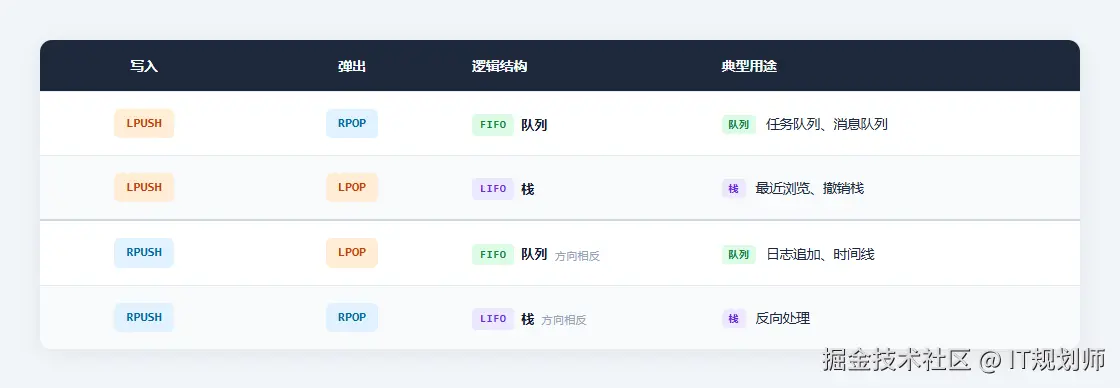
关键语义 :LPUSH key a b c 的结果是 [c, b, a],不是 [a, b, c]。这一点在"用 LPUSH + RPOP 做 FIFO"时必须心里有数:先 push 的 a 被挤到右端,RPOP 最先弹出的正是 a,顺序是对的。但如果误用 LPUSH + LPOP,就变成了 LIFO,队列顺序会反过来。
count 参数的边界 :LPOP key 100 在 List 只剩 3 个元素时返回 3 个,不报错。这在批量消费时很实用,但要注意:一次弹出 100 个元素,这 100 个元素在一条命令里全部离开 Redis,没有"部分成功"的概念------如果业务处理到第 50 个崩溃,后 50 个也已经不在 List 里了。
LPUSH / RPUSH 支持一次写入多个值,返回写入后的 List 长度。批量写入比循环单条写入少很多 RTT,但单条命令携带的 value 总量过大也会增加主线程的处理时间,生产上建议单次批量控制在合理范围内。
2.2 范围读取:LRANGE 与 LINDEX
perl
LRANGE key start stop       # 读取区间,支持负数(-1 表示末尾)
LINDEX key index            # 读取指定下标,支持负数
LLEN key                    # 长度
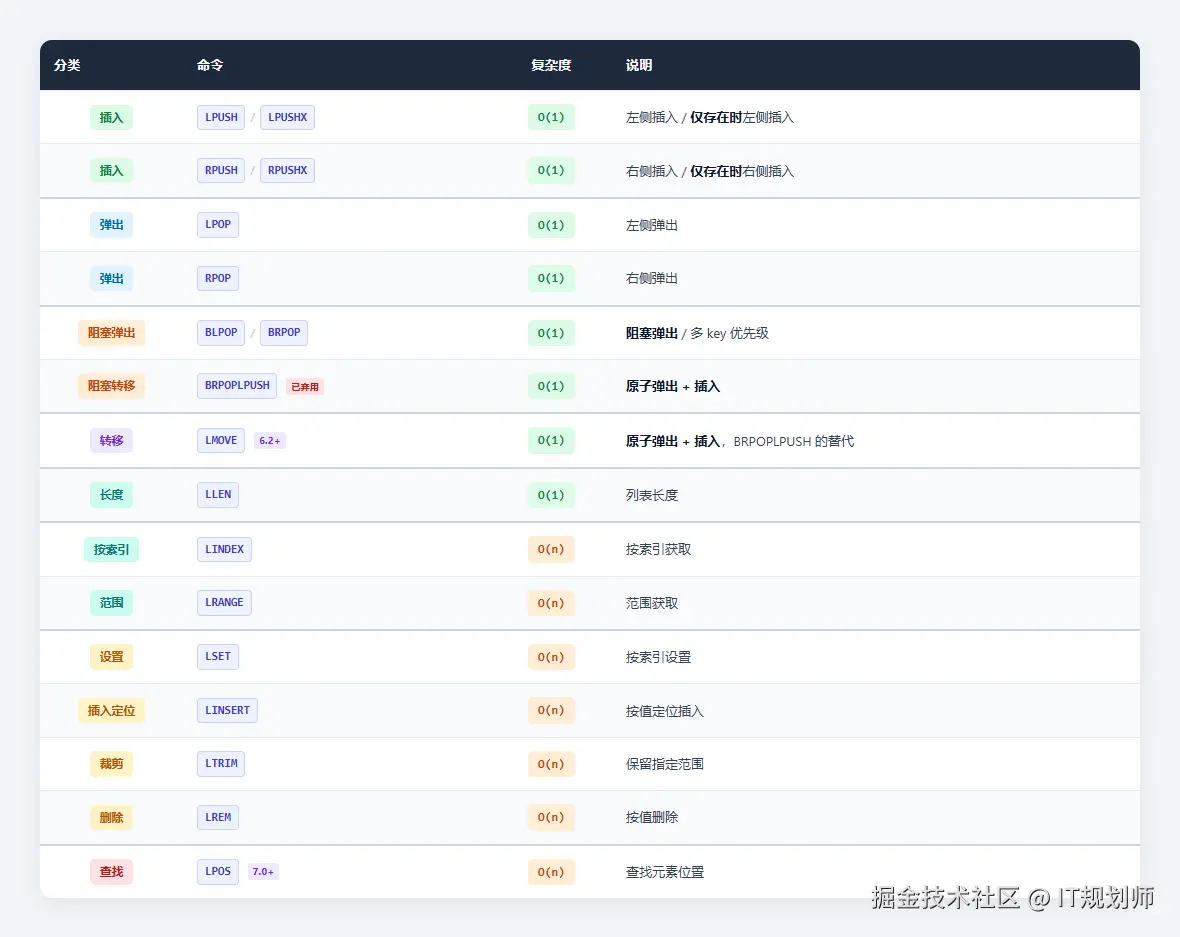
LRANGE key 0 -1 返回全量,这是 List 最危险的读命令之一 。一个百万元素的 List,LRANGE 0 -1 会把整个 List 序列化后通过网络返回,主线程在序列化阶段就被阻塞,网络缓冲区也可能被打满。生产上分页读取用 LRANGE key offset offset+pageSize-1,并且对 LLEN 有上限预期。
LINDEX 平均复杂度 O(N),需要从头或尾遍历到指定下标;索引越靠近两端越快,越靠中间越慢。因此不要对长 List 高频 LINDEX 中间位置
2.3 阻塞弹出:BLPOP / BRPOP / BLMOVE / BLMPOP
css
BLPOP key [key ...] timeout     # 阻塞式左端弹出,返回 [key, value]
BRPOP key [key ...] timeout     # 阻塞式右端弹出
BLMOVE source destination LEFT|RIGHT LEFT|RIGHT timeout
BLMPOP timeout numkeys key [key ...] LEFT|RIGHT [COUNT count]  # 7.0+
阻塞命令是 List 作为"实时队列"的关键:消费者在没有消息时挂起,不消耗 CPU;消息到达时立刻返回。但阻塞命令的语义细节,正是 6 个边界里最容易踩坑的部分,第四节专门展开。
2.4 元素操作与冷门命令
ini
LREM key count value        # 删除 count 个等于 value 的元素
LTRIM key start stop        # 保留区间,其余删除
LSET key index value        # 设置指定下标的值
LINSERT key BEFORE|AFTER pivot value
LPOS key element [RANK rank] [COUNT num]  # 6.0+,查找元素位置
LTRIM 是"固定长度最新列表"的核心:LPUSH log:events "new" + LTRIM log:events 0 999,永远只保留最近 1000 条。LTRIM 的复杂度是 O(N),N 是被删除的元素数量。稳定使用时(每次 LPUSH 只多 1 条,LTRIM 只删 1 条)实际是 O(1);但如果一次性裁掉几十万条,就会阻塞主线程。大 List 的清理要分批做。
LREM key 0 value 删除所有等于 value 的元素,复杂度 O(N),同样在长 List 上需要谨慎。
LPOS 是 Redis 6.0+ 的查找命令,返回元素下标;LPOS key element RANK -1 可以从尾部反向查找。平均复杂度 O(N),搜索靠近两端或使用 MAXLEN 时可能接近 O(1),但仍不适合对长 List 高频调用。
2.5 命令速查表
2.6 .NET API 对照与坑(StackExchange.Redis)
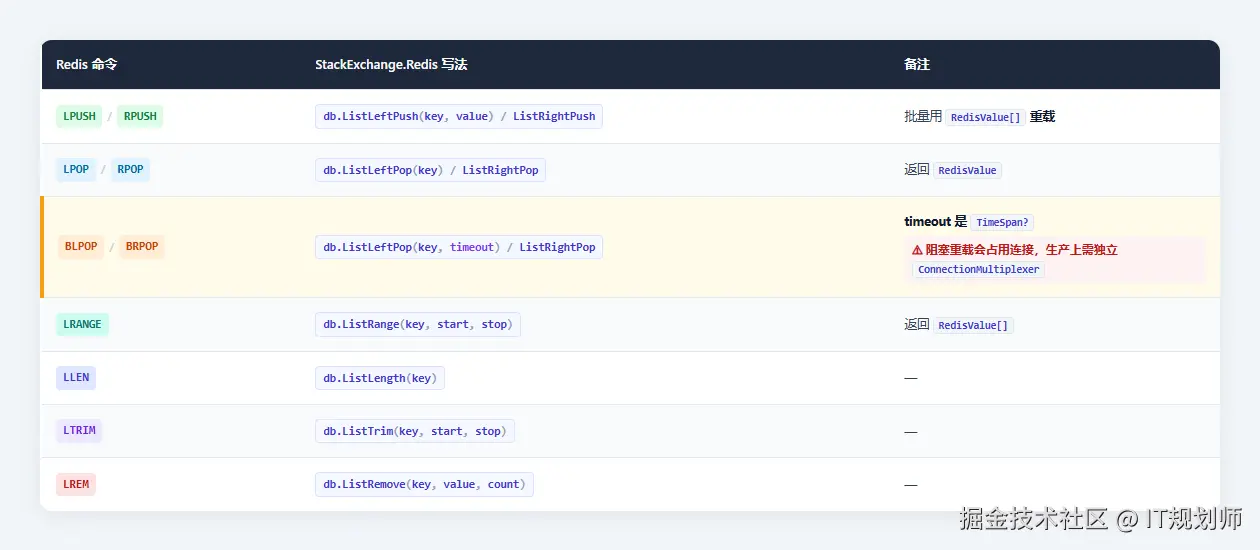
.NET 客户端二个坑:
- 阻塞弹出必须使用独立连接 。
StackExchange.Redis的ListLeftPop(key, timeout)在阻塞期间会占用一个连接;如果和普通读写共享同一个多路复用连接,BRPOP的阻塞会把该连接上其他命令的响应拖住。生产上阻塞消费者应该使用单独的ConnectionMultiplexer或至少确保连接池隔离。 - 阻塞命令的 timeout 必须小于客户端 socket timeout 。AWS 的 Redis 最佳实践明确指出:
BLPOP这类阻塞命令的 timeout 应该设得比 socket timeout 短,否则客户端会先于服务端超时,抛TimeoutError。
三、底层编码与核心机制(业务视角)
3.1 一句话说清底层结构
Redis 3.2 之前,List 底层有两种编码:元素少且短用 ziplist(压缩列表,连续内存、省内存但修改 O(N)),元素多或长用 linkedlist(双向链表,修改 O(1)但每个节点有 prev/next 指针开销、内存碎片多)。3.2 起统一为 quicklist ------它是"双向链表 + 每个节点是一个 listpack(原 ziplist)"的混合结构,兼顾了链表的修改效率 和压缩列表的内存效率。
用大白话说:quicklist 不是把所有元素放在一个大 ziplist 里,也不是每个元素单独一个链表节点,而是把元素分成一段一段的,每一段是一个紧凑的压缩列表节点,节点之间用双向指针连起来。
3.2 影响一:内存占用比纯链表省 50% 以上
纯 linkedlist 每个节点要存 prev/next 两个指针(16字节)+ redisObject(16字节)+ 数据本身,存一个短字符串光开销就 32+ 字节,实际数据可能只有几字节。quicklist 每个节点是一个 listpack,一个节点里塞几十个短字符串,平摊下来每个元素的指针开销几乎可以忽略,内存占用直接砍半。
对你的影响:3.2 起统一用 quicklist 后,对于'元素多、单个元素短'的 List,内存占用通常比旧版纯 linkedlist 明显下降;但对于元素很少或元素很大的 List,收益不一定明显,甚至可能因为节点拆分略有增加。不要把它当成无条件的内存优化。
3.3 影响二:两端操作仍然是 O(1),中间操作仍然慢,但没那么慢
由于 quicklist 节点之间是双向链表,两端 push/pop 仍然是 O(1),队列/栈的效率不受影响。中间插入和按索引访问仍然是 O(N):先定位节点,再在 listpack 内部插入或遍历。节点内连续内存对'顺序扫描'友好,但'中间插入'可能触发 listpack 搬移,不要因为 quicklist 就认为中间操作便宜。。
对你的影响:
LRANGE 0 20(取最新20条)这种操作,因为元素都在第一个 quicklist 节点里,实际非常快;但LRANGE 0 -1(取全部)如果 List 有几十万元素,仍然是 O(N) 全量遍历,会阻塞主线程。
3.4 影响三:节点大小可配置,根据场景调
quicklist 有几个关键配置项(redis.conf),直接决定每个压缩节点存多少元素、是否压缩:
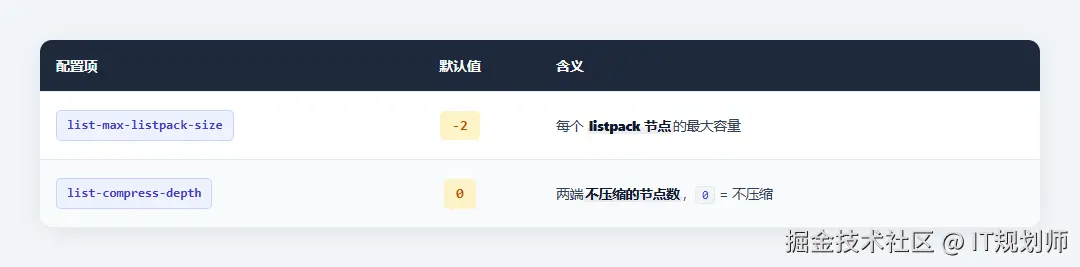
list-max-listpack-size 的取值规则:
- 正数 :表示每个节点最多存多少个元素,例如
5表示每个节点最多 5 个元素。 - 负数(推荐) :
-1:每个节点最大 4KB-2(默认):每个节点最大 8KB(性能与内存的最佳平衡)-3:每个节点最大 16KB-4:每个节点最大 32KB-5:每个节点最大 64KB
list-compress-depth = N 表示 quicklist 首尾各 N 个节点 不压缩,中间节点 LZF 压缩;例如 1 表示首尾各 1 个(共 2 个)不压缩。
0:不压缩(默认)1:两端各 1 个节点不压缩,中间压缩2:两端各 2 个节点不压缩,中间压缩
对你的影响:如果你的 List 是"只追加、很少修改、很长的历史数据"(如日志、消息历史),可以把
list-compress-depth设为 1 或 2,能再省 30~50% 内存;如果是高频两端操作的队列,保持默认 0 即可。
3.5 编码转换边界
List 的编码转换比 String 简单------3.2 之后所有 List 统一使用 quicklist 编码,不再有 ziplist/linkedlist 的切换。也就是说:
- 3.2 之前:短 List → ziplist,长 List → linkedlist,有编码转换开销。
- Redis 3.2~6.2:所有 List 统一为 quicklist(节点是 ziplist),无 ziplist↔linkedlist 转换。
- Redis 7.0+:小列表可能使用纯
listpack编码,较大列表使用quicklist(节点是 listpack)。因此OBJECT ENCODING可能返回listpack或quicklist,取决于版本和 List 大小。
你可以用 OBJECT ENCODING key 验证:
redis
LPUSH testlist a b c d e
OBJECT ENCODING testlist
历史补充:为什么 3.2 要换?因为 ziplist 在元素多了之后连锁更新的问题非常严重(一个元素变长可能引发后续所有节点级联重分配),而 linkedlist 内存开销太大。quicklist 通过"分段+每段紧凑"同时解决了这两个问题。
3.6 亲手验证
写一段 redis-cli 脚本,验证 list-max-listpack-size 配置对内存的影响(需要重启 Redis 加载不同配置):
redis
# 清空测试库
FLUSHDB
# 推入10000个短字符串
EVAL "for i=1,10000 do redis.call('RPUSH',KEYS[1],'item:'..i) end" 1 testlist
# 查看内存占用
MEMORY USAGE testlist
# 对比:用 -2(默认8KB节点)和 -5(64KB节点),同样10000个元素内存占用差异约10~20%
四、生产业务场景实战
List 的核心能力是:双端插入/弹出 O(1)、按索引范围读取、用 LTRIM 维持定长。它适合"最新 N 条、简单队列、可靠队列雏形、栈、环形缓冲区、多优先级队列"等场景;不适合深分页、需要按分数排序、需要 ACK/消费组/死信队列的强可靠场景。下面统一约定:LPUSH 从头部写入最新数据,LRANGE 0 N-1 读取最新数据,LTRIM 0 N-1 保留最新 N 条。
4.1 场景一:最新 N 条列表 / 时间线 Feed
需求 :用户动态、新闻资讯、消息列表,只展示"最新 N 条",新数据从头部插入,老数据自动淘汰。
方案 :LPUSH 写入最新,LTRIM 裁剪定长,LRANGE start stop 分页读取。
redis
# 用户发动态,推入个人时间线头部
LPUSH timeline:user:1001 "{\"id\":9527,\"content\":\"今天写了一篇Redis文章\",\"time\":1730000000}"
# 只保留最新500条
LTRIM timeline:user:1001 0 499
# 第一页:最新20条
LRANGE timeline:user:1001 0 19
# 第二页:20~39条
LRANGE timeline:user:1001 20 39
csharp
/// <summary>
/// 向指定用户的时间线头部写入一条动态,并裁剪到最多 maxItems 条。
/// Redis 语义:LPUSH 从 List 头部插入最新数据,LTRIM 保留索引 0~maxItems-1。
/// </summary>
/// <param name="userId">用户 ID,用于拼接时间线 key</param>
/// <param name="postJson">动态内容 JSON 字符串,由调用方负责序列化</param>
/// <param name="maxItems">时间线最大保留条数,默认 500</param>
public async Task AddPostAsync(long userId, string postJson, int maxItems = 500)
{
    // 每个用户一个时间线 key,例如 timeline:user:1001
    var key = $"timeline:user:{userId}";

    // 从头部写入最新动态,保证最新数据在索引 0 位置
    await db.ListLeftPushAsync(key, postJson);

    // 裁剪到只保留最新 maxItems 条;必须与上面的 LPUSH 成对出现,避免 List 无限增长
    await db.ListTrimAsync(key, 0, maxItems - 1);
}

/// <summary>
/// 按页读取指定用户的时间线,最新动态在前。
/// 采用偏移量分页:page 从 1 开始,第 1 页为 0~pageSize-1。
/// </summary>
/// <param name="userId">用户 ID,用于拼接时间线 key</param>
/// <param name="page">页码,从 1 开始;调用方需保证 page >= 1</param>
/// <param name="pageSize">每页条数,建议 20~50 条,硬上限 100 条;调用方需保证 pageSize >= 1</param>
/// <returns>当前页的动态 JSON 列表;无数据时返回空列表</returns>
public async Task<List<string>> GetPostsAsync(long userId, int page = 1, int pageSize = 20)
{
    // 与写入时使用同一个 key 规则
    var key = $"timeline:user:{userId}";

    // 计算 Redis LRANGE 的起止索引(包含 stop)
    // 第 1 页:start=0, stop=pageSize-1
    // 第 2 页:start=pageSize, stop=2*pageSize-1
    var start = (page - 1) * pageSize;
    var stop = start + pageSize - 1;

    // 只读取当前页范围,禁止使用 LRANGE 0 -1 全量拉取
    var posts = await db.ListRangeAsync(key, start, stop);

    // RedisValue 转 string,返回给上层;空结果会得到空 List
    return posts.Select(p => p.ToString()).ToList();
}
4.2 场景二:简单任务队列(接受丢失风险)
需求 :异步发邮件、发短信、站内信、写日志等轻量任务,允许少量丢失或可人工补发,追求简单高效。
方案 :生产者 LPUSH,消费者 BRPOP 阻塞消费。多消费者同时 BRPOP 同一 List 时会天然争抢消息,每条消息只会被一个消费者拿到,形成简单负载均衡。
redis
LPUSH queue:email "{\"to\":\"user@example.com\",\"subject\":\"欢迎\"}"
BRPOP queue:email 30
csharp
// 消费端使用独立的 ConnectionMultiplexer,不要和业务多路复用连接共用;详见 8.1 坑点 2
using var consumerMux = await ConnectionMultiplexer.ConnectAsync("localhost:6379");
var consumerDb = consumerMux.GetDatabase();

// 消费循环:直到外部取消信号触发才退出
while (!ct.IsCancellationRequested)
{
    try
    {
	    // StackExchange.Redis 没有真正封装 `BRPOP`;
	    // 带 `TimeSpan` 的重载是'非阻塞弹出 + 客户端等待/轮询',
	    // 阻塞期间会占用多路复用连接。生产上阻塞消费者应使用独立的
	    // `ConnectionMultiplexer`,并优先考虑用 Stream 的
	    // `XREAD BLOCK` 替代 List 阻塞消费。
	    //
        // BRPOP:从 queue:email 尾部阻塞弹出,最多等 2 秒
        // timeout 2 秒 < socket timeout(默认 5 秒),避免连接被判定超时
        // 队列为空且等待超时返回 RedisValue.Null,HasValue 为 false
        var item = await consumerDb.ListRightPopAsync(
            "queue:email", TimeSpan.FromSeconds(2));

        if (!item.HasValue)
        {
            continue; // 队列为空或等待超时,继续下一轮
        }

        // 注意:消息此刻已从 List 删除,后续处理异常无法靠重试本方法找回
        // 将 RedisValue 转成 string 传给业务方法,避免把 Redis 类型泄漏到业务层
        await ProcessEmailAsync(item.ToString());
    }
    catch (OperationCanceledException) when (ct.IsCancellationRequested)
    {
        // 正常停机:外部取消,退出循环,不当作错误记录
        break;
    }
    catch (Exception ex)
    {
        // 消息已经从 List 弹出,异常后默认丢失,只能记录日志并人工兜底
        // 若业务不能接受丢消息,应改用 BRPOPLPUSH/BLMOVE 做 processing 备份,
        // 或直接用 Stream;这不是靠加 try-catch 能解决的问题
        _logger.LogError(ex, "处理邮件任务失败,消息可能已丢失");
    }
}
4.3 场景三:可靠队列防丢(BRPOPLPUSH / BLMOVE + processing 备份)
需求 :消息不能因消费者宕机而直接丢失。
方案 :BRPOPLPUSH source processing timeout 或 Redis 6.2+ 的 BLMOVE source processing RIGHT LEFT timeout,原子地把消息从主队列移到"处理中"队列;业务成功后 LREM 删除备份,失败则留在 processing,由补偿任务捞回。
redis
# 原子转移:从 queue:pending 右端弹出,压入 queue:processing 左端
BRPOPLPUSH queue:pending queue:processing 10
# 或 Redis 6.2+
BLMOVE queue:pending queue:processing RIGHT LEFT 10

# 处理成功后删除备份
LREM queue:processing 1 "order:1001|welcome"
csharp
// 非阻塞 RPOPLPUSH,源队列为空时立即返回 null,外层循环需要处理空结果
//
// BRPOPLPUSH 原子转移:从 queue:pending 右端弹出,同时压入 queue:processing 左端
// - 两个动作在 Redis 内原子完成,不会出现"弹出后崩溃导致消息丢失"
// - TimeSpan.FromSeconds(2) 是"等待源 List 有数据"的超时,不是业务处理超时
//   → 拿到消息后业务处理超过 2 秒,消息不会自动回 pending,仍留在 processing
// - 源队列为空且等待超时,返回 RedisValue.Null,HasValue 为 false
var job = await consumerDb.ListRightPopLeftPushAsync(
    "queue:pending", "queue:processing", TimeSpan.FromSeconds(2));

// 只有真正拿到消息才进入处理;超时返回 null 时直接进入下一轮循环
if (job.HasValue)
{
    try
    {
        // 业务处理:建议传 job.ToString(),避免把 RedisValue 泄漏到业务层;
        // RedisValue 是 struct,job! 的 ! 没有实际作用
        await ProcessAsync(job.ToString());

        // 处理成功:从 processing 删除备份,count=1 表示只删 1 条匹配值
        // 删除后消息才算真正"消费完成";若此处失败,watchdog 可能会重复投递
        await consumerDb.ListRemoveAsync("queue:processing", job, 1);
    }
    catch (Exception ex)
    {
        // 处理失败:故意不删除 processing 中的消息,让 watchdog 扫描后重入主队列
        // 如果这里也删了,消息就彻底丢了
        // 注意:watchdog 需要能判断"超时未删除",所以 processing 中的消息
        // 建议带 EnqueuedAt / Retry 等元数据,否则无法区分"正在处理"和"消费者已崩溃"
        _logger.LogError(ex, "处理失败,留在 processing");
    }
}
补偿任务骨架 :processing 中的消息建议带 payload、入队时间、retry 等元数据。定时扫描超过阈值(如 5 分钟)仍未删除的任务:重试次数未超限则 LREM processing 后重新 LPUSH queue:pending;超过 3 次则移入 queue:deadletter。
4.4 场景四:栈、撤销缓冲与环形缓冲区
LPUSH + LPOP 是天然 LIFO 栈,适合编辑器撤销、最近操作记录、浏览器后退等场景。
redis
LPUSH undo:user:1001 "{\"action\":\"edit\",\"docId\":123}"
LTRIM undo:user:1001 0 49
LPOP undo:user:1001
csharp
private const int MaxUndoDepth = 50; // 最多保留 50 步撤销

/// <summary>
/// 压入一步可撤销操作,并把撤销栈裁剪到最近 MaxUndoDepth 步。
/// </summary>
public async Task PushActionAsync(long userId, string action)
{
    var key = $"undo:user:{userId}";

    // 头部压栈,最新操作在索引 0
    await db.ListLeftPushAsync(key, action);

    // 限制栈深度,与 LPUSH 成对出现;否则长期积累会变成大 List
    await db.ListTrimAsync(key, 0, MaxUndoDepth - 1);
}

/// <summary>
/// 弹出最近一步操作;栈空时返回 RedisValue.Null。
/// </summary>
public Task<RedisValue> PopActionAsync(long userId)
    => db.ListLeftPopAsync($"undo:user:{userId}");
边界 :撤销/重做通常需要 undo + redo 两个栈;撤销时从 undo 弹出并压入 redo,重做时反向操作。栈也必须 LTRIM 限制深度,避免长期积累成大 Key。
环形缓冲区 :用 LPUSH + LTRIM 维护固定大小,最新数据在头部:
redis
LPUSH ring_buffer "data1"
LPUSH ring_buffer "data2"
LPUSH ring_buffer "data3"
LTRIM ring_buffer 0 2       # 只保留最新 3 个
LRANGE ring_buffer 0 2      # 最新在前;如需时间正序,应用层反转
4.5 场景五:多优先级队列
需求 :高优任务先消费,高优为空时才消费低优。
方案 A :BRPOP queue:high queue:low 5,按 key 顺序检查,高优有数据先返回。
方案 B(Redis 7.0+) :BLMPOP 0 2 queue:high queue:low RIGHT COUNT 10,从第一个非空 List 原子弹出。
redis
# `BLMPOP` 在 `MULTI/EXEC` 或 Lua 脚本中不会阻塞,行为等同于 `LMPOP`;
# 需要真正阻塞时不要在事务或 Lua 中使用。
BRPOP queue:high queue:low 5
BLMPOP 0 2 queue:high queue:low RIGHT COUNT 10
边界 :不要用 LINSERT 往 List 中间插任务来实现优先级。手动"先 RPOP high,再阻塞 RPOP low"的两次操作不是原子的,高优可能在两次操作之间被写入,导致低优先被先消费;需要原子性就用 BLMPOP。另外,优先级只解决"从哪个 List 取",不改变 List 没有 ACK 的事实,高优消息处理失败一样会丢。
4.6 场景六:滑动窗口与榜单
滑动窗口限流雏形 :用 List 维护最近 N 次请求,配合 LTRIM 截断窗口;但严格限流更常用 ZSet 滑动日志或令牌桶。List 只适合"按时间先后保留最近 N 条"的简单窗口,不支持按分数排序。
榜单:List 只能表达插入顺序,不能表达分数排名;排行榜、在线用户排名等应使用 ZSet。
4.7 场景七:消费者组替代方案与选型
List 本身没有消费者组。若只能用 List 模拟,可选:
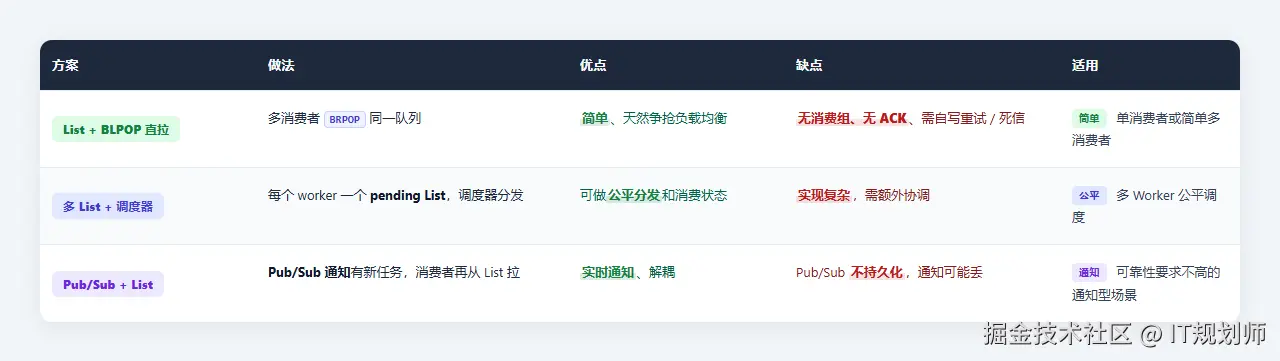
多 List 调度器可以用 Lua 做非阻塞原子分发,但不要在 Lua 里执行 BLPOP 这类阻塞命令:
redis
EVAL "
  local task = redis.call('RPOP', 'task:queue')
  if not task then return nil end
  local target = 'task:worker1:pending'
  redis.call('LPUSH', target, task)
  return target
" 0结论:需要消费者组、消息确认、死信队列时,直接用 Stream 比用 List 模拟更可靠、更简单。List 适合简单"生产-消费"队列和轻量异步任务。
七、与 Stream / PubSub 在队列场景的选型对比
角度:只做 List / PubSub / Stream 三方在"队列场景"的局部对比,帮你判断当前场景 List 够不够用。
List 最常见的"误用",是被当成企业级消息队列。List 本身没有 ACK、没有消费组、没有 Pending,弹出即删除;它能做的是"轻量任务分发",不是"可靠消息队列"。下面先在 List 层面做局部对比。
7.1 三方对比总表
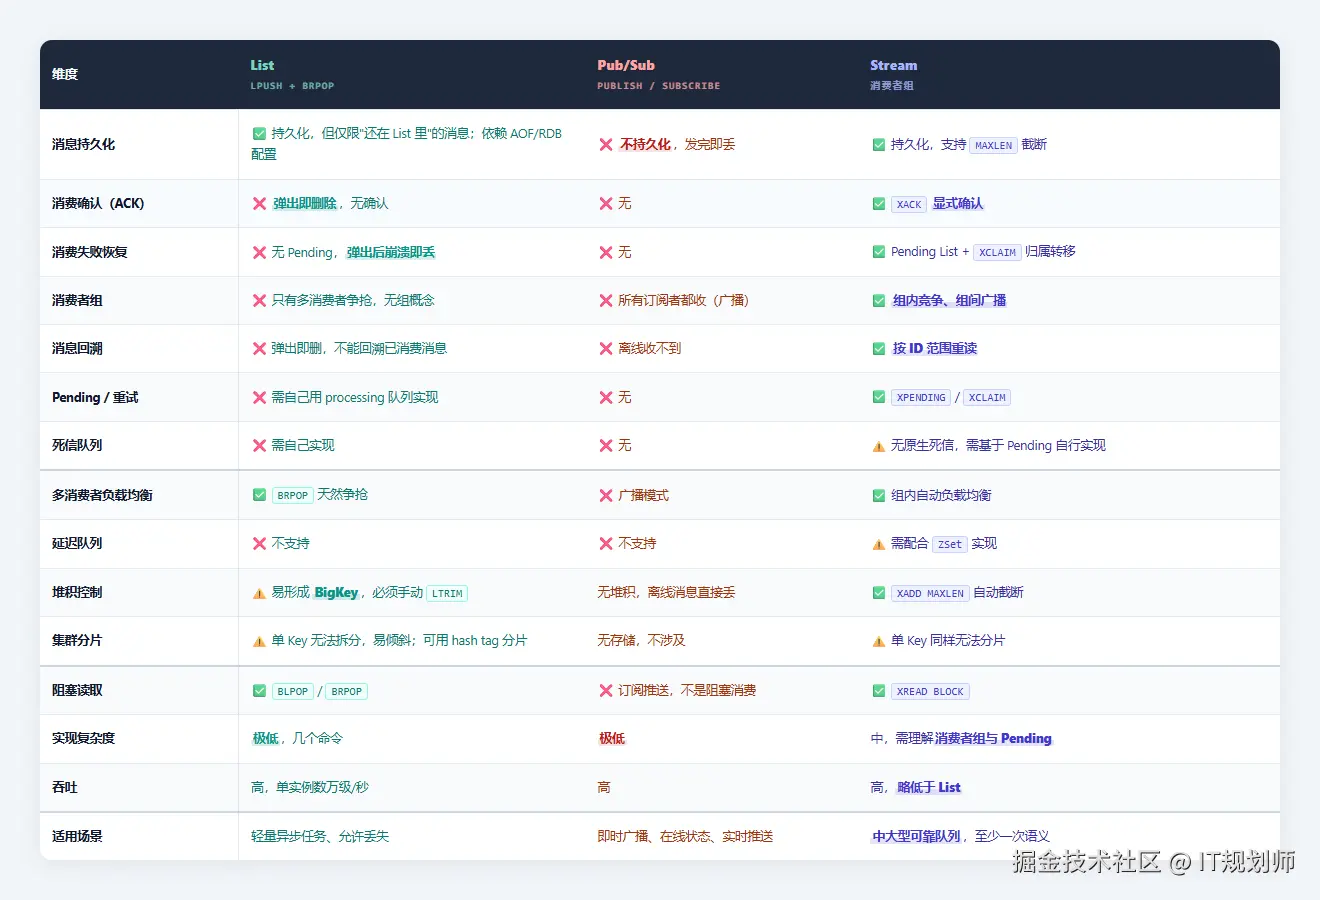
一句话结论 :轻量级异步任务(发邮件、打日志、非核心通知)List 完全够用;需要消费确认、消费者组、消息回溯、故障恢复的核心链路(订单、支付、数据同步)直接用 Stream;即时广播(在线状态、实时推送)用 Pub/Sub。一旦业务说"这条消息不能丢",List 就应该让位给 Stream 或专业 MQ。
7.2 关键差异解读
持久化不等于可靠。 List 和 Stream 都受 AOF/RDB 保护,但 List 的 BRPOP 是"弹出即删除"------消息一旦被消费者取走,就从 List 里消失了,持久化只保证"还没被消费的消息"不丢。Stream 的 XACK 之前,消息一直留在 Pending 里,消费者崩溃后可以用 XCLAIM 转移归属。这是两者最本质的区别。
List 不能回溯。 常见误区是"List 可以用 LRANGE 重复读取,所以能回溯"。这只对"还没被弹出的消息"成立;已经被 BRPOP 消费的消息已经不在 List 里,LRANGE 读不到。Stream 可以按 ID 范围 XREAD 重读历史,才是真正的回溯。
Stream 没有原生死信队列。 XCLAIM 做的是"把 Pending 中超时未 ACK 的消息转移给另一个消费者",不是"自动进死信"。死信需要你在 XPENDING 基础上自行实现:重试超过 N 次仍失败的消息,手动 XADD 到死信 Stream 并 XACK 原消息。原文表格里"XCLAIM + 死信队列原生支持"的说法不准确。
Pub/Sub 不是阻塞消费。 Pub/Sub 是订阅推送模型:订阅者在线就收,离线就丢,没有"阻塞等待"和"消费确认"的概念。它适合"在线状态广播、实时通知"这类允许丢失的即时推送,不能当队列用。
多消费者不等于消费者组。 List 上多个消费者同时 BRPOP 同一 key,会天然争抢消息,每条消息只被一个消费者拿到,这确实是负载均衡;但没有"组"的概念------无法按组广播、无法查看组内消费位点、无法做组级别的 Pending 管理。需要这些语义就用 Stream。
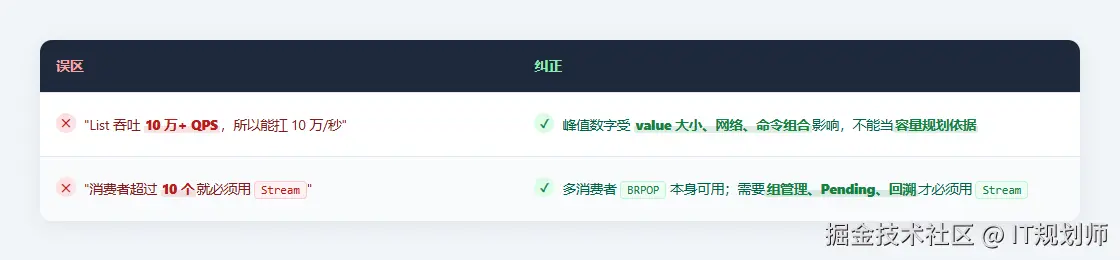
吞吐口径要统一。 List 和 Pub/Sub 的单实例吞吐在数万级/秒,Stream 略低。原文里"List 10 万+ QPS"与"QPS 不超过 5 万"前后矛盾,实际取决于 value 大小、网络和命令组合,不要拿峰值数字当容量规划依据。
7.3 选型决策
- 临时轻量任务、允许少量丢消息、不需要重试回溯 → 选 List(
LPUSH+BRPOP,需要防丢再加BRPOPLPUSH/BLMOVE+ processing)。 - 需要消息确认、重试、死信、多消费分组、消息回溯 → 直接选 Stream,不要自己用 List 造轮子;手写"可靠 List"本质上是在重复实现一个不完整的 Stream。
- 高吞吐、海量堆积、多分区、严格可靠性、跨机房 → 选 Kafka/RabbitMQ 等专业 MQ。
List 仍然值得用的非队列场景 :最新 N 条列表/时间线(LPUSH + LTRIM + LRANGE,不需要队列语义)、栈/撤销缓冲、环形缓冲区、简单通知、允许补发的异步任务。这些场景 List 的简单性和 O(1) 双端操作就是优势,不需要为了"看起来更可靠"而换 Stream。
7.4 常见误区速查
八、内存占用估算
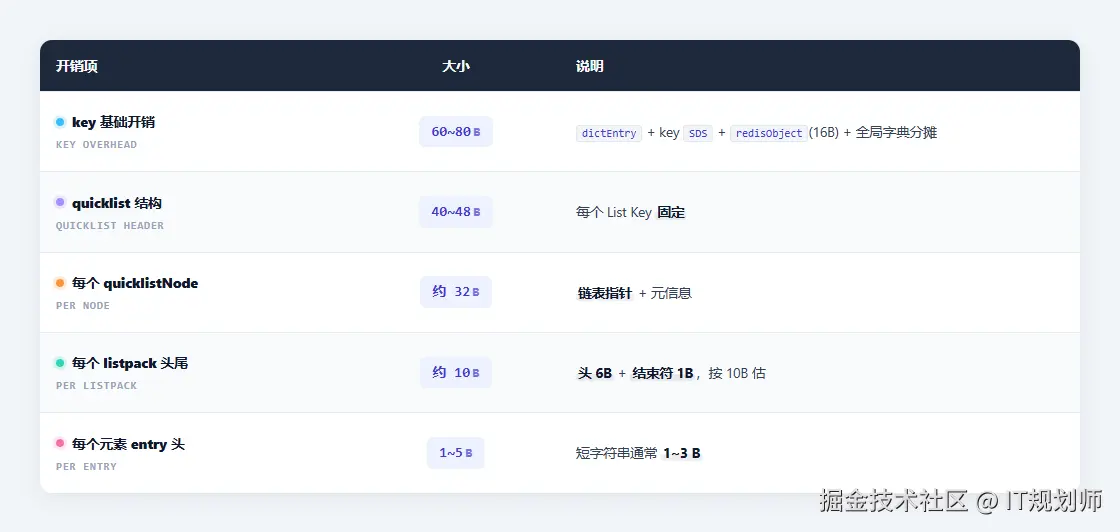
8.1 List 的内存构成
Redis 7.x 中,List 的底层是 quicklist(双向链表)+ listpack(压缩块);一个 List Key 的内存由五部分组成:
- Key 本身 :dictEntry + key SDS + redisObject。redisObject 本身 16 字节,但加上 dictEntry、key SDS、全局字典分摊和过期字典,一个 key 的基础开销约 60~80 字节。
- quicklist 结构本体 :每个 List Key 固定约 40~48 字节。
- 每个 quicklistNode :prev/next 指针 + 元信息,约 32 字节。
- 每个 listpack 块 :listpack 头(约 6 字节)+ 结束符(1 字节),按 10 字节估。
- 每个元素 :listpack entry 头(长度和编码,短字符串约 1~3 字节)+ 元素数据本身。
8.2 刚性开销速查
8.3 估算公式
text
总内存 ≈ key基础(60~80) + quicklist(40~48)
       + N_nodes × (32 + 10)
       + N × (entry头 + L)
       + 冗余
其中 N_nodes = ceil(N × (L + entry头) / 节点字节上限)。默认 list-max-listpack-size = -2,每个 listpack 节点约 8KB;负值表示按字节切分,正数表示每个节点最多存几个元素。
简化速算 :短字符串元素每个约 L + 3~5 字节,加上每 key 约 100~150 字节基础开销,再乘 1.1~1.2 的 jemalloc 对齐和元数据冗余。精确值务必用 MEMORY USAGE key 实测,公式只用于容量规划。
8.4 演算一:100 万用户的消息通知 List
假设每个用户一个 List,平均 50 条通知,每条 100 字节 JSON,默认 -2(8KB/节点)。
- 元素数据:50 × (100 + 3) ≈ 5,150 B
- 节点数:
ceil(50 × 103 / 8000) = 1,节点开销 1 × 42 = 42 B - key 基础 + quicklist:约 80 + 40 = 120 B
- 小计约 5,312 B,乘 1.15 冗余 ≈ 6.1 KB/用户
- 100 万用户 ≈ 6.1 GB
对比"一消息一 String key":每个 key 基础约 150 B × 50 + 50 × 100 = 12,500 B/用户,100 万用户约 12.5 GB 。List 比"一消息一 key"省约一半内存,这就是 quicklist + listpack 紧凑存储的价值。
8.5 演算二:1 万条 200 字节消息的队列
list-max-listpack-size = -1(4KB/节点):每节点约4096 / (200+3) ≈ 20个,节点数 500;总内存 ≈ 80 + 40 + 500×42 + 10000×203 ≈ 2.03 MB,乘 1.15 冗余 ≈ 2.3 MB。list-max-listpack-size = 5(每节点最多 5 个元素):节点数 2000;总内存 ≈ 80 + 40 + 2000×42 + 10000×203 ≈ 2.12 MB,乘冗余 ≈ 2.4 MB。
两者总内存差异不大,但节点数 500 vs 2000,指针开销和内存局部性差别明显。大列表建议用负值按字节切分,减少节点数;正数配置适合元素很小、需要严格控制单节点元素个数的场景。
8.6 演算三:百万级用户 ID(仅内存估算示例)
100 万个 "user:1000001" 这类平均 11 字节的 ID:
- 按 4KB/节点:每节点约
4096 / (11+3) ≈ 292个,节点数约 3,425;总内存 ≈ 80 + 40 + 3425×42 + 1,000,000×14 ≈ 14.15 MB,乘冗余 ≈ 16 MB。 - 按每节点 5 个元素:节点数 200,000;总内存 ≈ 80 + 40 + 200000×42 + 14,000,000 ≈ 22.4 MB,乘冗余 ≈ 25 MB。
节点数从 20 万降到 3 千多,遍历和插入的性能收益比内存差异更值得关注。注意:在线用户状态和排名应该用 ZSet,这里只是 List 内存估算示例,不代表 List 适合做排名。
8.7 长度上限比内存估算更重要
对 List 来说,长度上限是比"单元素大小"更关键的生产指标 。原因不是内存本身,而是 O(N) 操作的风险:LRANGE 0 -1 会一次性返回所有元素,LTRIM 大幅裁剪会释放大量节点,两者都可能阻塞主线程。
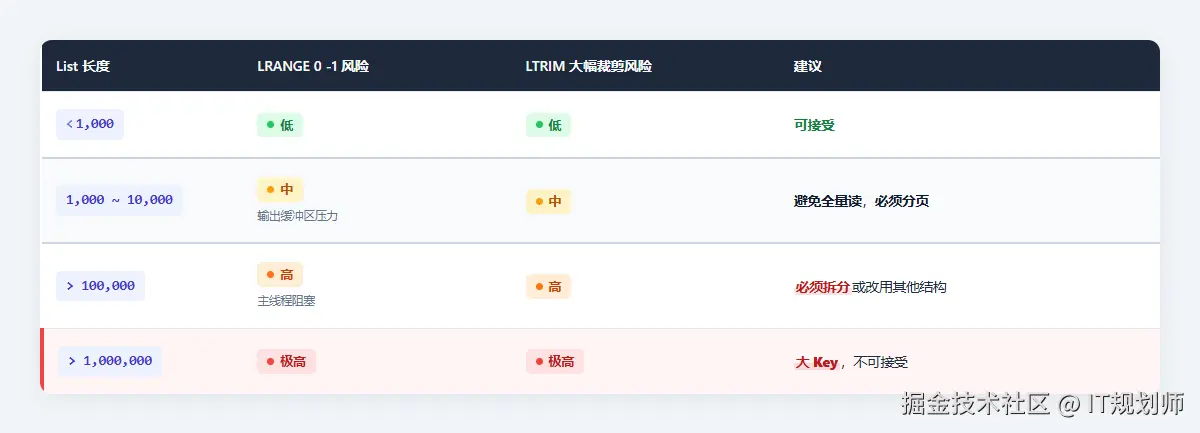
实操建议:
- 用
LLEN监控 List 长度,给业务 List 设定明确上限(如 10,000),每次写入时用LTRIM维持上限。 - 禁止
LRANGE 0 -1全量读取,分页必须传start/stop,建议 20~50 条,硬上限 100 条。 - 如果 List 长度失控(不做
LTRIM涨到几十万条),内存会线性增长,且相关 O(N) 命令会拖慢整个实例。除了LTRIM,也可以给整个 List 设 TTL(如通知 30 天后整条 List 过期删除)。 - 存 10KB 的 JSON 大 value 时,1 万条就是 100MB,属于典型大 Key,必须拆分;拆分策略(按时间分 Key、按业务维度 Sharding)见 S19。
- 公式估算只用于容量规划,上线前用
MEMORY USAGE key和MEMORY STATS实测校准。
九、高频线上坑点汇总
本节按主题归类:阻塞消费与连接管理、List 长度与 O(N) 操作、顺序/幂等/可靠队列认知、Key 管理与集群。每条保留"现象 / 根因 / 规避"三要素,方便直接对照排查。
9.1 阻塞消费与连接管理
1. BRPOP key 0 永久阻塞,连接被独占、blocked_clients 持续增长
现象 :消费端用 BRPOP key 0 永久阻塞,跑一段时间后 Redis 连接数耗尽,其他业务请求超时;服务端 blocked_clients 只增不减。
根因:阻塞期间连接被该命令独占,不能复用于其他命令;用连接池时一个阻塞命令占住一个连接,池很快耗尽;消费者崩溃后无限阻塞的连接也不会自动清理。
规避 :阻塞 timeout 设为 1~30 秒,不要用 0;消费端单独建连接,不要复用业务多路复用连接;监控 blocked_clients,必要时 CLIENT UNBLOCK;循环阻塞时外层包异常捕获与退避。
2. 同一连接既做阻塞消费又做普通查询
现象:业务查询偶发超时、延迟抖动大,但 Redis 本身指标正常。
根因 :StackExchange.Redis 等多路复用客户端的一个连接被 BLPOP/BRPOP 占住后,其他命令排队等待。
规避 :消费者必须用独立的 ConnectionMultiplexer,不要和业务查询共用。
3. 阻塞 timeout 大于客户端 socket timeout
现象 :客户端抛 TimeoutError,服务端仍认为客户端在阻塞。
根因 :客户端 SyncTimeout / socket timeout 小于 BRPOP 的阻塞 timeout,两个超时数字错位。
规避 :客户端 socket timeout 要比阻塞 timeout 大 510 秒,例如 10 秒。BRPOP 2 秒、socket timeout 5
4. 超时返回 nil 后空转打满 CPU
现象:消费者进程 CPU 100%,Redis QPS 异常高但没有消息。
根因 :BRPOP 超时返回 nil 后没有 continue 或退避,直接进入下一次循环;连接异常断开时立即重试,形成死循环。
规避 :拿到 null 时 continue;异常时加 1 秒退避;连续 N 次空转后加短暂延迟。
5. 空 List 反复 BRPOP 打日志打爆磁盘
现象 :日志文件几小时涨几个 G,全是 BRPOP 返回 nil 的记录。
根因:每次超时都打 INFO/ERROR 日志,空转也打,没有采样。
规避:正常超时(返回 nil)只打 DEBUG,不打 ERROR;连续空转做日志采样。
6. BLPOP/BRPOP 多 key 的"饥饿"与顺序误用
现象:高优先级队列一直有消息时,低优先级队列永远不被消费;或把低优 key 写在前面导致高优饿死。
根因 :BLPOP/BRPOP 按 key 顺序检查,只要第一个 key 有数据就返回,不会轮询;这是设计行为,不是 bug。
规避 :多优先级队列把高优 key 写在前面;需要公平轮询就在应用层做轮询,或给不同优先级分配不同消费者实例;不要指望多 key BRPOP 自动公平。多 key BRPOP 和 BLMPOP 都是'按 key 顺序优先',不是轮询;需要公平轮询必须在应用层实现。
7. 多消费者假设"先阻塞先消费"
现象:消费顺序不符合预期。
根因:Redis 不保证阻塞唤醒的公平性,多个客户端同时阻塞时谁先被唤醒没有严格顺序。
规避:顺序敏感场景用单消费者,或按业务 key 分片,保证同一业务维度只有一个消费者。
8. 在 MULTI/EXEC 里使用阻塞命令
现象 :事务中的 BRPOP 行为异常。
根因:阻塞命令在事务里不会按预期阻塞,语义与单独执行不同。
规避 :不要在 MULTI/EXEC 里使用 BLPOP/BRPOP/BLMOVE 等阻塞命令。
9. 阻塞期间 Redis 重启/主从切换,客户端假死
现象:主从切换后消费端一直阻塞不返回,也不报错。
根因:部分客户端在连接断开后不会自动取消阻塞命令,会一直等下去。
规避:阻塞命令必须设合理超时,不要用 0;客户端加心跳检测,连接异常时重连。
9.2 List 长度与 O(N) 操作
10. 不做 LTRIM,List 无限增长变成大 Key
现象 :某个 List 涨到几十万条,LRANGE 0 -1 直接阻塞 Redis 几秒,所有请求超时。
根因 :写了 LPUSH 忘了 LTRIM,或 LTRIM 的 N 设得太大;或根本没意识到这个 key 会一直涨。
规避 :所有"最新 N 条"场景必须配 LTRIM,N 建议 100~1,000,不要超过 1 万;用 LLEN 监控长度,定期 redis-cli --bigkeys 扫描。
11. LRANGE 0 -1 一次性取全部
现象 :接口偶发超时,慢查询日志出现 LRANGE;Redis 内存突增、客户端 OOM、主线程延迟飙升。
根因 :代码图省事直接 ListRangeAsync(key) 不传 start/stop,长 List 一次性返回所有元素,输出缓冲区和网络传输都承压。
规避 :所有 LRANGE 必须传 start/stop,页大小不超过 50~100;对未知长度 List 禁止全量读。
12. LTRIM 大范围裁剪阻塞主线程
现象 :执行 LTRIM 后 Redis 卡顿,CPU 飙升。
根因 :LTRIM 删除超出范围的元素,删除量大时是 O(N),会阻塞主线程。
规避 :维持 List 长度稳定,每次只裁少量(正常使用下每次 LPUSH 只多 1 条,LTRIM 只删 1 条);大 List 清理用后台任务分批裁剪,不要一次裁几十万。
13. LINDEX 按索引访问大 List 很慢
现象 :LINDEX key 10000 耗时几毫秒到几十毫秒,随机访问延迟忽高忽低。
根因 :List 不是数组,LINDEX 要从头或从尾遍历到第 N 个位置,O(N)。
规避:不要把 List 当数组用;需要随机访问用 Hash(按 field)或 ZSet(按分数/排名)。
14. LREM 在长 List 上全量扫描
现象:删除一个元素耗时随 List 长度线性增长。
根因 :LREM 是 O(N) 遍历。
规避 :避免在长 List 上高频 LREM;用 LTRIM 控制长度;可靠队列的 processing 清理尽量按批、按超时扫描,而不是每次全量 LREM。
15. LINSERT 找不到 pivot 返回 0 而非错误
现象 :LINSERT 插入失败但代码没报错,消息"丢了"。
根因 :LINSERT 找不到 pivot 时返回 0(key 不存在返回 -1),代码容易误判为成功。
规避:检查返回值:-1 表示 key 不存在,0 表示 pivot 不存在,>0 才是插入后的长度;不要只看是否大于 0。
16. List 元素存太大的 JSON,变成大 Value
现象 :List 只有几百条,但每条是几 KB 的大 JSON,LRANGE 20 条就要传几十到上百 KB,网络慢。
根因:单元素太大,即使数量不多总 value 也很大;大元素还会让 quicklist 的 listpack 节点频繁拆分。
规避:List 元素尽量控制在 1KB 以内;大对象拆分存 Hash,List 只存 ID;超过 8KB 的消息先外部存储,List 只存消息 ID。
9.3 顺序、幂等与"可靠队列"认知
17. LPUSH 多值顺序写反
现象:推入 a、b、c,取出来是 c、b、a,顺序和预期相反。
根因 :LPUSH key a b c 是逐个从左插入:先 a 在头,再 b 到 a 前面,再 c 到最前,最终 c、b、a。
规避 :需要 FIFO 正序用 RPUSH + LPOP,或 LPUSH + RPOP 并验证顺序;批量 LPUSH 时先反转数组,或直接改用 RPUSH。
18. 多消费者并发消费没有幂等
现象:processing 重入后同一条消息被处理两次(如发了两封邮件)。
根因 :List 没有 ACK,processing 补偿存在重复投递窗口;消费者崩溃、LREM 失败、watchdog 重入都可能导致重复。它不是'至少一次'语义,而是'最多可能重复'的简化方案。
规避:消费逻辑必须幂等,用消息 ID 去重;不能假设消息只会被消费一次。
19. BRPOPLPUSH 处理成功但 LREM 失败,消息永久留在 processing
现象:processing 队列越来越长,消息堆积;或下次启动补偿扫描又把它重新入队,造成重复消费。
根因 :业务成功但 LREM 时网络闪断/进程崩溃,消息没从备份队列删掉;processing 没有自动超时和归属转移。
规避 :消费逻辑做幂等;启动时和定时任务扫描 processing 中超时未删除的消息重新入队或送死信;LREM 失败记日志告警。
20. 把"可靠 List"当成完整队列
现象:processing 中的消息因消费者崩溃永久卡住,没人捞回。
根因:手写的"处理中 List"没有超时和归属转移,只是降低丢失概率,不是 Pending。
规避 :理解 BRPOPLPUSH/BLMOVE + processing 只是"简化可靠";需要完整故障恢复、消费组、重试计数、死信时直接用 Stream 的 Pending + XCLAIM。
9.4 Key 管理、集群与数据形态
21. 列表 key 没有设置过期时间导致内存泄漏
现象:Redis 内存持续增长,OOM 后杀死进程。
根因 :队列 List 没有 TTL,消息消费完后 key 不会自动删除;LTRIM 只裁内容,key 还在。
规避 :临时队列设 TTL;持久队列用 LTRIM 控制大小 + 定期清理;监控空 List 数量。
22. WRONGTYPE 报错
现象 :key 本是 String,又执行 LPUSH,报 WRONGTYPE。
根因:不同业务共用 key 命名空间,类型冲突。
规避 :命名空间隔离,队列统一加 :queue 前缀;上线前用 TYPE key 检查。
23. 集群模式下 List 跨 slot
现象 :批量操作多个 List key 时报 CROSSSLOT Keys in operation don't hash to the same slot。
根因:Redis 集群要求同一事务/批量操作的所有 key 必须哈希到同一个 slot。
规避 :用 hash tag 让相关 key 同 slot(如 {queue1}:pending、{queue1}:processing);或确保批量操作只涉及单个 key。hash tag 能解决 CROSSSLOT,但会让相关 key 集中在同一节点;高吞吐场景要权衡'原子性'和'分片均匀性',不要把所有队列都用同一个 tag 绑在一起。
24. 核心业务队列做成单 Key,集群下倾斜
现象:集群内存和 QPS 分布不均,某个节点压力明显高于其他节点。
根因:单 Key 无法拆分,全部落在同一个 slot/节点。
规避:按业务维度哈希拆成多个 List(如按用户 ID 分片);但注意拆分后消费端要能覆盖所有分片,且不要破坏需要原子性的多 key 操作。
25. 用 List 存会话状态
现象 :频繁 LINDEX 查中间态,延迟高。
根因:List 适合两端操作和顺序场景,不适合按 field 随机读写。
规避:会话状态用 Hash;List 只做事件流、时间线、队列。
9.5 可直接落地的速查清单
1. 禁止 BRPOP 0 永久阻塞,统一 5~30 秒超时,客户端循环重试。
2. 消费者使用独立 ConnectionMultiplexer,不与业务查询共用;socket timeout 比阻塞 timeout 大 5~10 秒。
3. 所有"最新 N 条"和队列 List 必须配 LTRIM,长度控制在 1 万以内,用 LLEN 监控。
4. 只在 List 两端读写;禁止 LRANGE 0 -1 全量遍历;分页每页建议 20~50 条,硬上限 100 条。
5. 需要降低丢失概率时用 BRPOPLPUSH/BLMOVE + processing 备份,并配 watchdog 扫描超时任务;同时明确它仍不是完整 Pending,不能丢的消息上 Stream。
6. 消费逻辑必须幂等,用消息 ID 去重;不要假设"只消费一次"。
7. 大消息(>8KB)不要直接存 List,先外部存储,List 只存消息 ID。
8. 多优先级队列把高优 key 写在前面;需要公平轮询就在应用层实现,不要依赖多 key BRPOP 自动公平。
9. 不要在 MULTI/EXEC 里使用阻塞命令;不要用 LINDEX 把 List 当数组;不要用 List 存会话状态。
10. 集群下相关 key 用 hash tag 保证同 slot;核心队列按业务维度拆分,避免单 Key 倾斜。
十、本篇小结
List 是一个用起来简单、用好需要边界感 的类型:双端操作 O(1),命令组合能搭出栈、队列、阻塞队列、固定长度列表,quicklist 的底层设计也兼顾了内存与性能;但它不是企业级消息队列,没有 ACK、没有消费者组、没有消息回溯,核心链路硬用它一定会出事。
1. 记住四种组合模式 :LPUSH + LPOP 是栈,LPUSH + RPOP 是队列,LPUSH + BRPOP 是阻塞队列,LPUSH + LTRIM 是固定长度列表。这四个模式覆盖 List 90% 的用法。需要随机访问、按分数排序、会话状态时不要用 List,分别用 Hash、ZSet、Hash。
2. 底层编码和调优参数要记准 :Redis 3.2 起 List 默认编码是 quicklist,Redis 7 用 listpack 替代了 ziplist;关键配置是 list-max-listpack-size(默认 -2,约 8KB 一个节点)和 list-compress-depth(长列表可开压缩)。list-max-listpack-size 控制的是节点大小,不是"listpack→quicklist 的切换阈值";128/64 是 Hash/ZSet 的阈值,不是 List 的。
3. 阻塞消费的边界要刻在脑子里 :不永久阻塞(timeout 不要用 0)、不独占业务连接(消费者用独立 ConnectionMultiplexer)、socket timeout 要大于阻塞 timeout、超时返回 nil 不空转打日志、消费逻辑必须幂等、processing 队列要有 watchdog 补偿、异常要退避。BRPOPLPUSH/BLMOVE + processing 只是"简化可靠",不是 Stream 的 Pending,没有超时归属转移。
4. 长度上限比内存估算更重要 :LRANGE 0 -1、LTRIM 大幅裁剪、LREM、LINDEX 都是 O(N) 主线程操作,List 长度失控会从高效队列变成线上灾难。所有"最新 N 条"和队列 List 必须配 LTRIM,长度控制在 1 万以内;禁止全量 LRANGE,分页每页建议 20~50 条,硬上限 100 条;大消息(>8KB)先外部存储,List 只存 ID。
5. 队列选型的红线:轻量异步任务、允许少量丢失,List 够用;需要消息确认、失败重试、消费者组、历史回溯,直接用 Stream;百万级 QPS、跨机房、严格顺序、事务消息,用 Kafka/RabbitMQ 等专业 MQ。不要在 List 上硬凑可靠队列,你花在补偿、重试、死信上的代码量,通常比直接用 Stream 多得多。