MultiNet7 每轮都 clean,ESP32-P4 内存为什么还在掉?
clean() 已经按超时调用,内部堆却持续变小。此时再多调用一次清理函数,未必能回答问题:究竟是应用忘了清理、堆碎片化,还是库内部的某类对象仍存活?ESP-SR issue #225 给了一个值得拆开的用户案例。
报告者的板上运行环境是 ESP32-P4、ESP-IDF 5.5.4、ESP-SR 1.9.5、mn7_en_quantized。他另称在 ESP-SR 2.4.7 的预编译 libmultinet.a 中看到同类调用目标缺口;这里的 2.4.7 证据是报告者的二进制分析 ,不是 2.4.7 的板上回归结果。报告者把 MultiNet 当常开检测器,持续输入 16 kHz 音频,每次 512 个采样点;每次 ESP_MN_STATE_TIMEOUT 后调用 clean()。本文没有对这两版做板卡复现或独立反汇编。下面的数据均是报告者观察,不能外推成所有 MultiNet7 版本和调用模式的通病。
第一层:free 下降,尚不能定位漏在哪里
报告者记录内部空闲量约以 5.5 B/s 下降。仅这一条曲线还不足以认定库泄漏:其他任务可能同时分配,碎片化会令可分配的最大连续块变化,最低水位本来就不回升。ESP-IDF 5.5 的 ESP32-P4 堆调试文档 分别提供当前空闲量、最大连续空闲块、最低水位和堆追踪。
现场应同步保存三列:当前内部 free、largest free block、minimum free。前两者是当前状态,第三者是启动以来的低点。若只凭最低水位一路下降,就把正常峰值误写成"每轮不回收"。
三条堆曲线,不能用一条替另两条
另一种假设是总 free 大体恢复,最大块却变小。它提醒我们关注碎片化与后续大分配,但不能直接归因某个模型的存活对象。相反,总 free 与特定调用点活块字节数持续变化,才更接近对象累计的线索。三项都使用同一种内存能力范围,并注明统计时间点,避免把内部堆、其他区域或不同查询口径混在同一趋势里。
测量点应尽量落在相同业务阶段。初始化期间、识别中间、超时之后、后台发送完成之后,分配需求本来不同;拿其中最低的一次和另一轮空闲期比较没有意义。可以给每轮记录阶段标签,再比较同阶段数据。若后台任务尚未完成,就说明当次快照包含并发工作,不强行把全部差值都算给 MultiNet。
判断缓慢下降,先控制其他任务的分配
长时间常开设备可能同时维护网络、日志、音频队列和业务结果。总量变小可能是其中任意一个路径的增长。第一组受控实验保留必要识别输入,同时记录其他任务是否开启;若暂时隔离网络或业务用于定位,就将它标为诊断构建。它能帮助判断增长归属,不能代替最终整机负载的稳定性验证。
也别用一次重启恢复内存证明泄漏根因。重启会释放大量状态,自然能够回到启动时水平,但它没有告诉我们哪些对象未释放。作为临时恢复操作可以有价值,作为归因证据却很弱。需要继续保留调用点与生命周期,让问题报告从"过一会就要重启"转为可调查的分配关系。
第二层:同一调用点的活块在累计
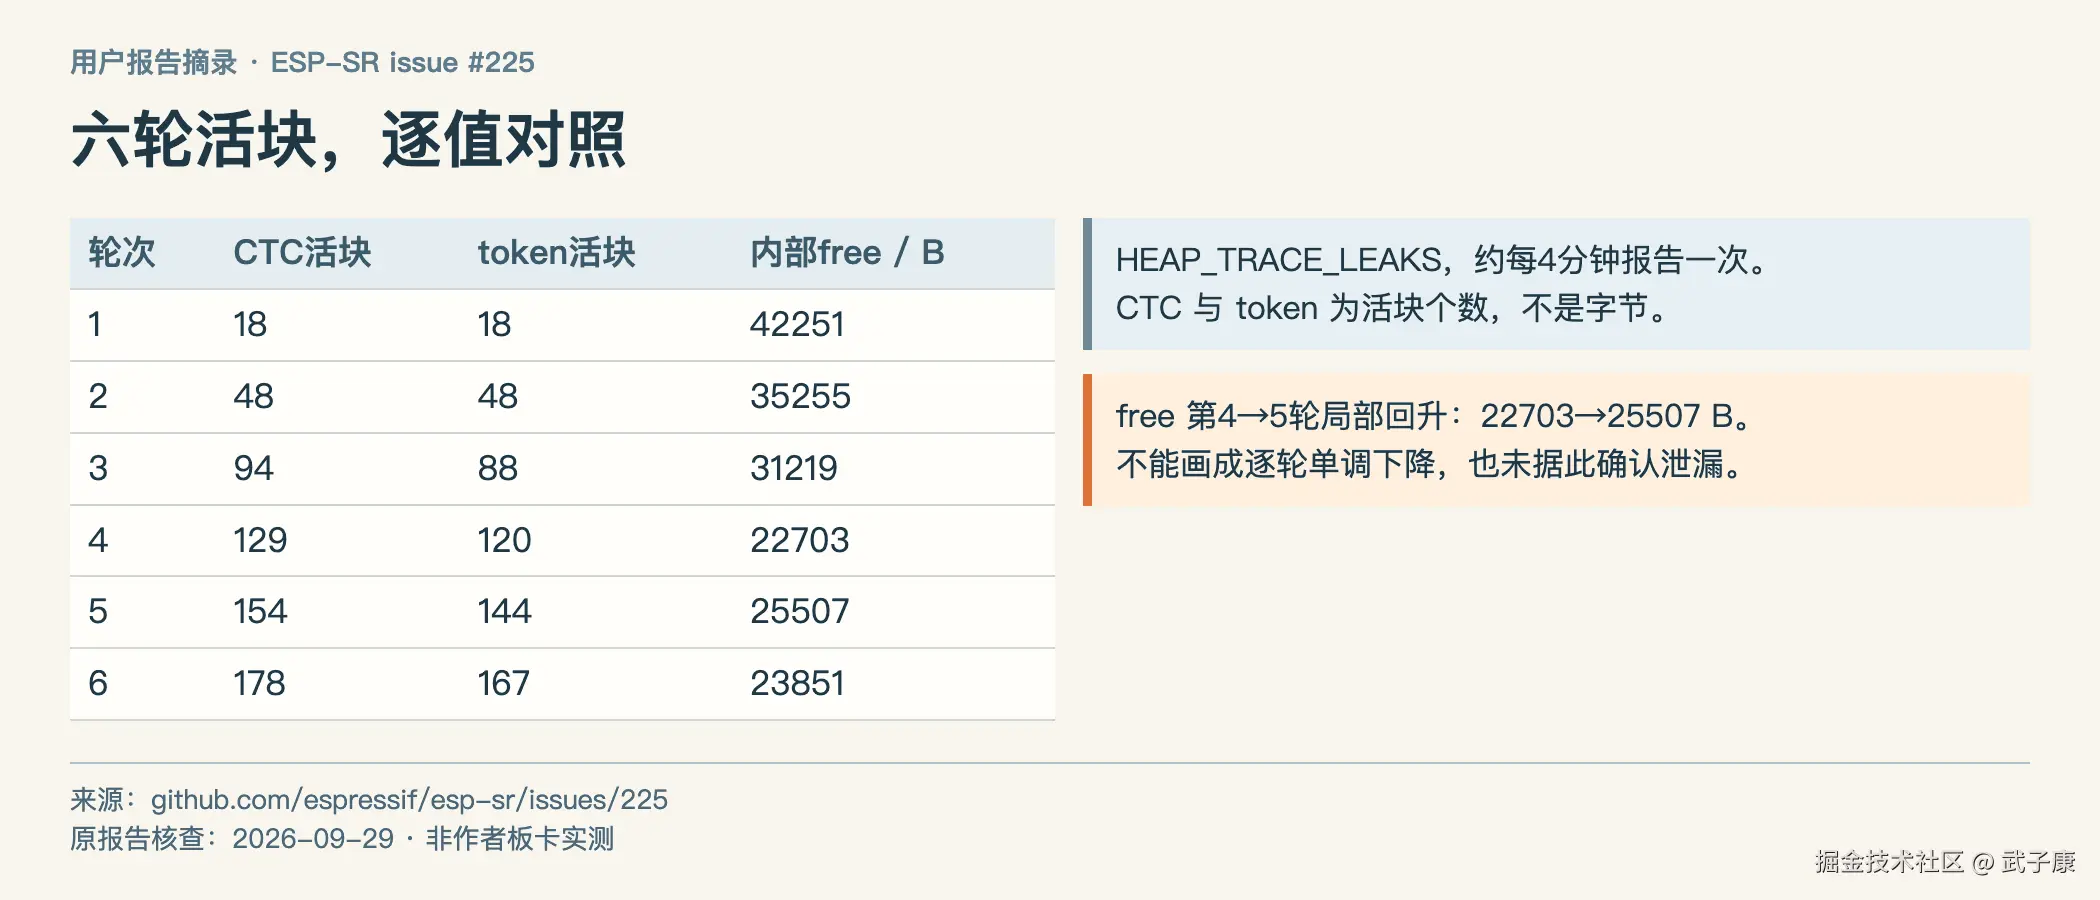
issue #225 的报告者每约 4 分钟取一次 HEAP_TRACE_LEAKS 快照,共六轮。其 ctc_path_alloc 活块依次为 18、48、94、129、154、178;关联 token 数组从 18 增至 167。两组活块在约 26 分钟里都未回落。再看同一组原始记录,内部 free 是 42251、35255、31219、22703、25507、23851 字节,其中 22703 到 25507 曾回升;活块数量却继续增加。因此这里应区分下降趋势与每个采样点的单调下降,free 的一次回升也不能直接证明目标分配已经回收。报告者还比较了安静和背景音乐,活块每轮增长相近(约 +24/+25);至少在该场景里,不能只把噪声当唯一触发条件。这比总 free 的单一曲线更有定位价值:它把关注点从"整堆少了多少"推进到"哪些分配点还活着"。
但堆追踪不是自动判决。官方文档指出,追踪窗口结束后才释放的正常对象也会列出;缓冲区溢出会漏记录,追踪本身影响性能。复测要固定窗口与负载,确认无 overflow,再比较多轮趋势及停帧、销毁后的恢复,不能凭一次快照写"确定泄漏"。
活块数量和活块字节数一起看
某个调用点分配数量增加,可以指向重复创建对象;字节数则说明它对余量的实际贡献。假设数量增加但每块很小,总 free 的主要下降仍可能来自另一个大对象路径;假设数量稳定但块大小增长,则应看容量扩张而非单纯对象遗留。将数量和字节数并列,不用一个数字承担所有内存解释。
追踪还需要对象的时间关系。某轮快照看到活块,可能只是它还未到释放阶段;下一轮仍看到相同地址,才有连续存活线索;多轮新增地址持续保留,则更支持累计。地址复用也需要注意,释放后再次分配到同一地址,不等于同一对象一直存活。应依据追踪记录中的分配与释放事件解释,而非只比较截图里的地址列表。
窗口边界会制造看起来像泄漏的对象
假设追踪在识别中段停止,结果队列仍持有本轮对象,稍后业务消费才释放。这个快照中的活块有正常解释。可以延长到轮次结束,或增加停止送帧后的观察点,看看它们是否恢复。这里提出的是对照设计,不指定通用等待时间,因为目标应用的异步消费没有给出。
如果追踪发生 overflow,缺失的释放或分配可能改变判断。报告应注明窗口、记录容量与溢出状态,不能只截剩下的调用点列表。扩大追踪容量后,还要考虑它自己的内存开销;使用不同追踪设置的总 free 数据也不应直接相减。追踪帮助归因,它不是不影响被测系统的理想观察者。
安静与背景音乐增长近似的用户观察,排除了该组条件下"只有音乐才增长"的简单解释;它不排除其他音频内容、模式或版本影响。自己的实验可以固定相同运行时长和帧数,比较两组输入,但不要从这组对照扩大为所有声学环境都无关。
第三层:确认调用路径,才谈清理是否有效
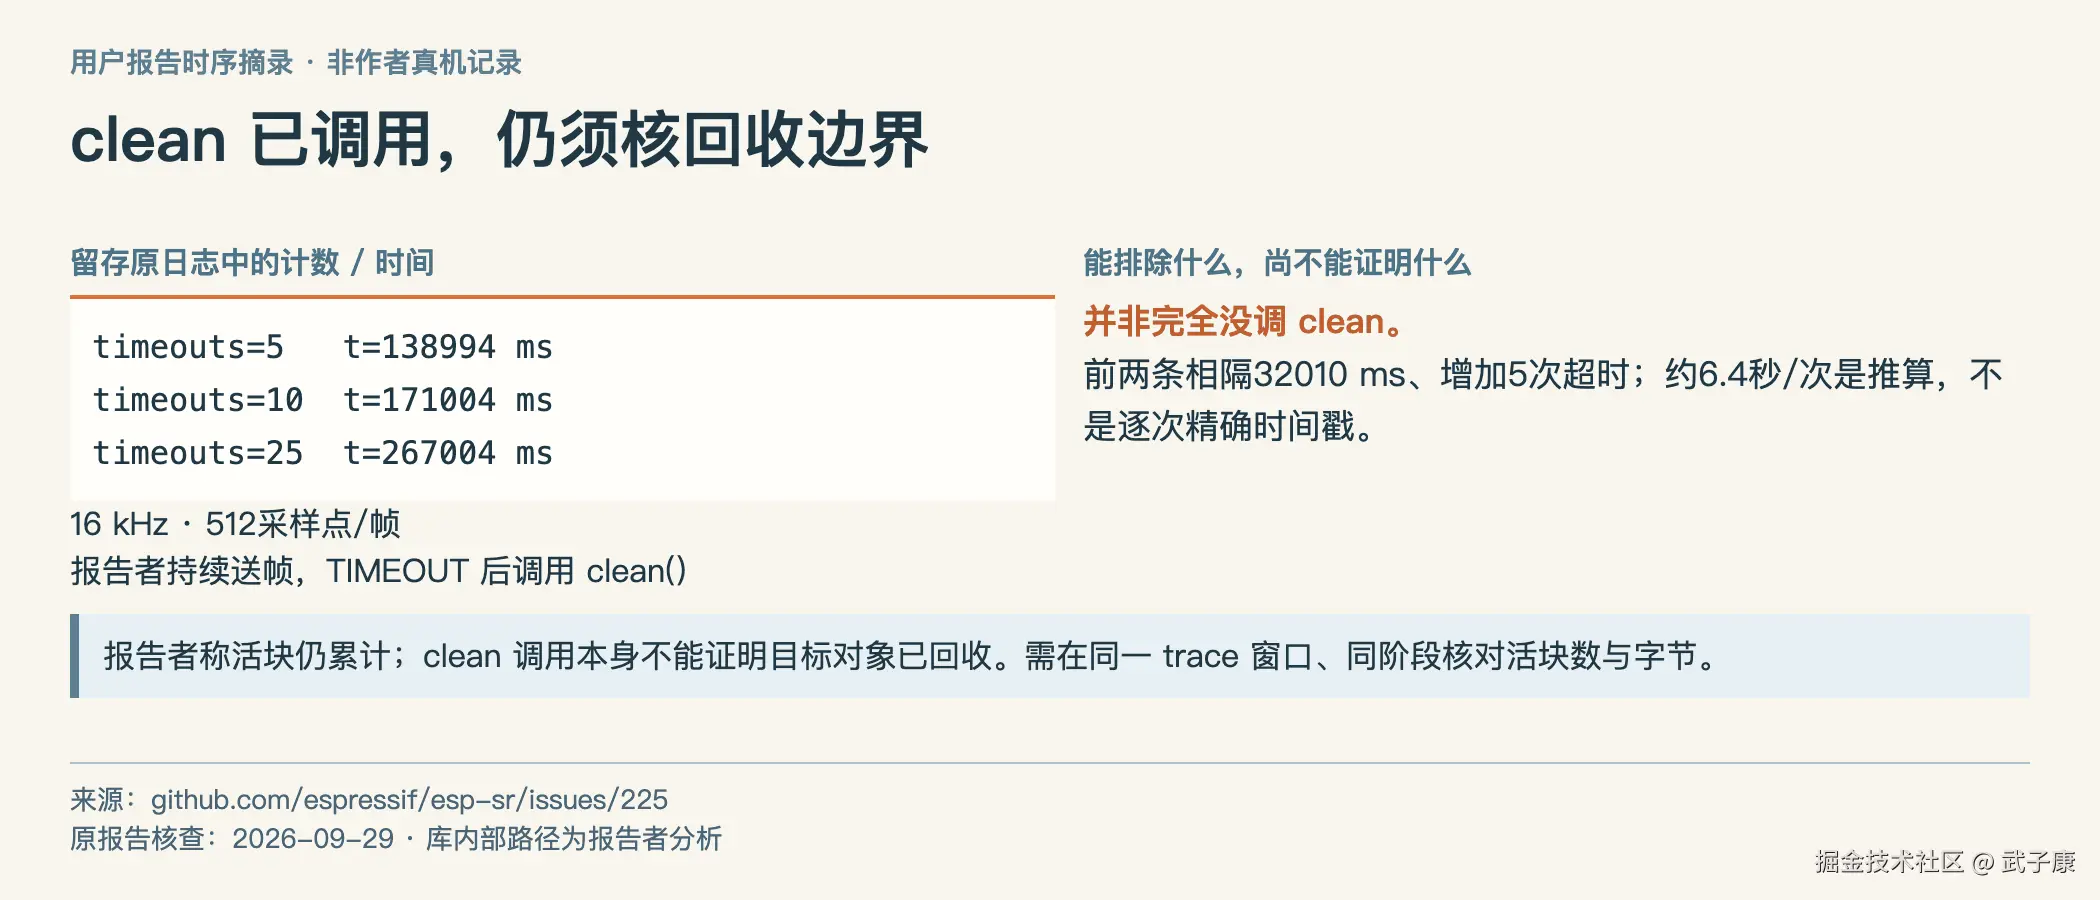
报告中约 32 秒新增 5 次 TIMEOUT,折合约每 6.4 秒一次;应用每次都调用 clean(),活块继续增长。这个对照至少排除了"报告者完全没调 clean"这一简单解释,却不说明 clean() 承诺释放了所有 CTC 对象。
报告者进一步称,销毁和重建模型也没有回收这些路径。他对 ESP-SR 1.9.5 与 2.4.7 所用预编译 libmultinet.a 的分析认为:model_reset()、model_destroy() 有 RNNT beam 释放调用,缺少相应 ctc_beams_free()。这是报告者对其二进制的机制判断;本文没有独立核实,更不能把它写成维护者已确认根因或某版已修复事实。2026 年 10 月 13 日再次核对 issue 正文和评论,页面仍为 open,未看到维护者提供的对应修复或报告者的新板卡回归结果。它支持继续调查指定调用路径,不替代当前项目的版本化验证。
记录调用次数还要记录调用发生的位置
TIMEOUT 次数与 clean 次数一致,能证明应用不是完全漏掉清理;但 clean 是否在正确模型实例上执行、是否与 detect 并发、是否位于预期退出边界,仍需从当前代码确认。这里不是指认报告者存在这些错误,而是给本机核验补足调用关系。模型句柄与轮次记录对应之后,才能解释"调用了"具体清理的是哪个实例。
如果应用同时运行多个实例,总清理次数一致也可能掩盖分配与清理对象错位。可以按已有实例标识保存摘要,不需要建立额外管理框架。对单实例项目,明确单实例即可减少这类疑问。重建模型时先确认旧消费者退出,不让异步任务继续向旧对象调用 detect;这属于应用生命周期需要检查的边界,而非本文为库设定未经证实的线程安全保证。
销毁、退出识别与停止送帧是不同实验
停止送帧让识别不再获得新输入,退出识别改变业务窗口,销毁释放模型实例,三者作用不同。若停止后活块保持但销毁后恢复,可以继续调查正常驻留状态;若销毁后仍保持,则对象归属与释放路径更值得核查。需要先确保异步任务不再持有本轮数据,否则看见的存活对象也可能来自外层应用。
官方流程与报告场景不完全相同
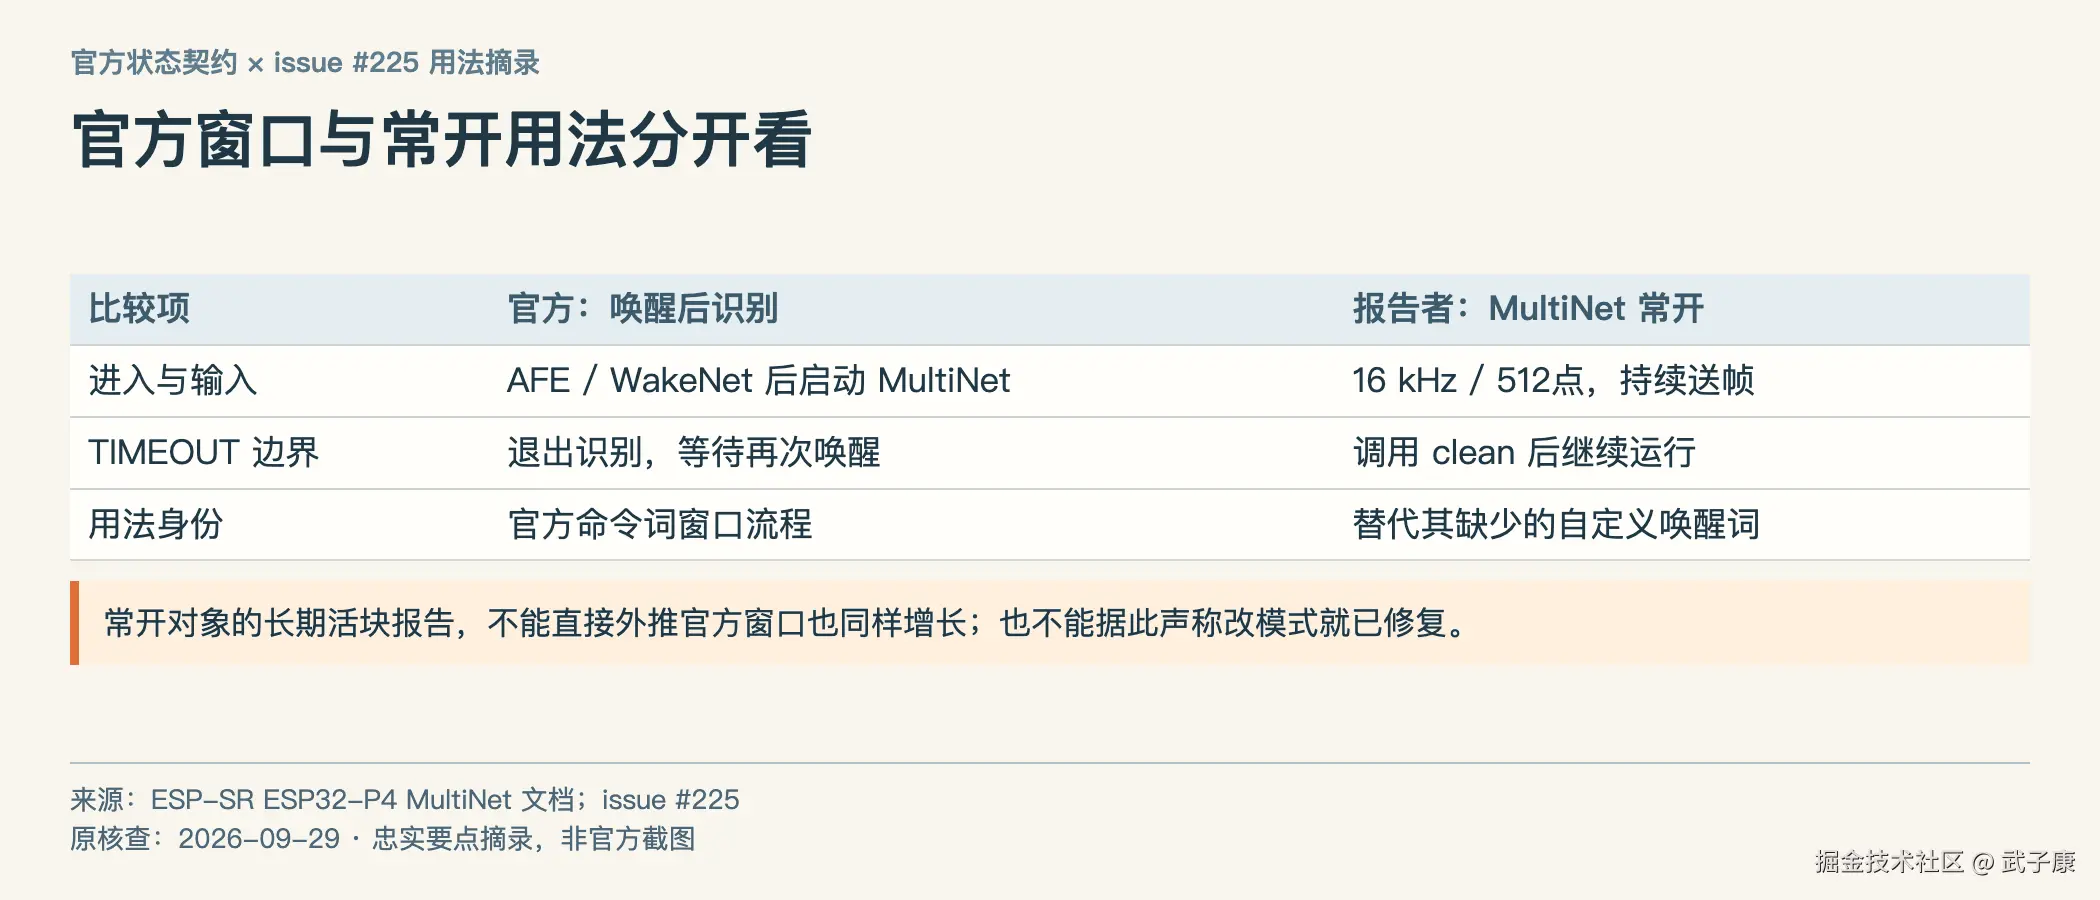
乐鑫 ESP32-P4 MultiNet 文档把 MultiNet 放在 WakeNet 唤醒之后做命令识别;长时间没有命令时 TIMEOUT 退出,等待再次唤醒。issue 报告者因没有可用自定义 WakeNet 模型,把 MultiNet 用成常开唤醒替代。这正好形成长时生命周期压力测试,但不能据此断定官方短时命令识别流程也有同样增长。
"改回标准模式"可以缩短运行窗口,却不自动解释报告中的存活分配;反过来,报告中的增长也不能证明所有常开方案不可用。需要用相同版本和明确模式实测。
模式决定生命周期压力,也决定结论范围
唤醒后短时命令窗口与持续常开,最明显的差别是重复检测、超时与清理发生的频率和持续时间。一次短窗口通过不能证明连续运行安全,连续运行出现累计也不能直接证明短窗口必然发生同量增长。报告应写实际模式、总时长、输入帧数和轮次,而非仅用"运行了一会"描述压力。
可以在同一版本上安排两种模式的受控对照,保持模型和合法词表一致,分别记录生命周期。若常开增长而短窗口暂未增长,只能确认这组时间和输入下观察不同,仍需判断是否因为总检测量不同。比较时兼看墙钟时间与处理帧数,避免将空闲时间更长的模式自然增长更慢理解成某路径完全修复。
不要通过提前退出窗口来宣称库内对象已释放。它可能减少增长机会,是一种使用模式调整,但真正的对象生命周期问题仍需要活块证据。业务如果确实不需要常开,可以回到原定短时路径;这属于产品范围选择。若业务要求常开,则需要按该压力验证目标版本,不能用官方短时示例替代。
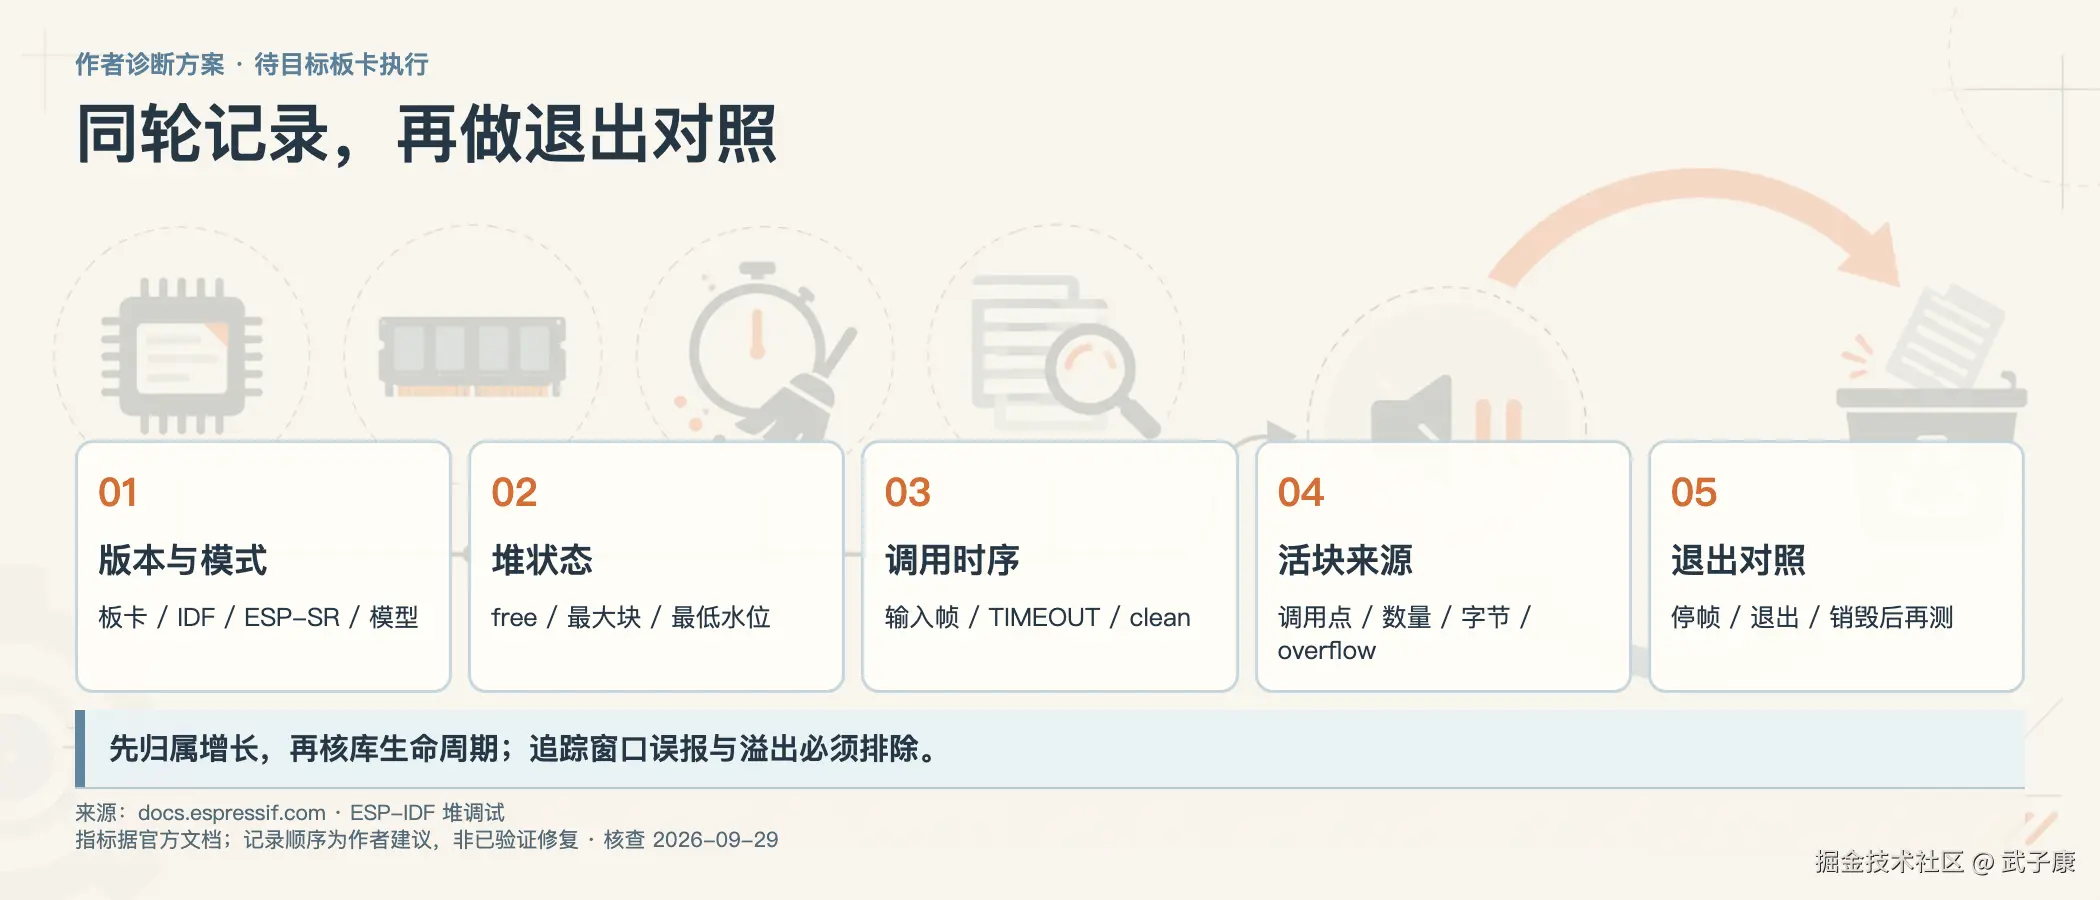
把争论变成同轮记录
为表中记录关联同一配置版本、输入文件标识、追踪窗口与轮次边界,避免把不同运行的截图拼成一次调用的证据。
| 每轮记录 | 目的 |
|---|---|
| 板卡、IDF/ESP-SR 精确版本、模型、常开或唤醒后模式 | 限定结论适用范围 |
| 当前内部 free、largest free block、minimum free | 区分当前余量、碎片风险、历史低点 |
输入帧数、TIMEOUT 次数、实际 clean() 次数 |
证明或排除应用调用遗漏 |
| CTC/其他调用点活块数和字节数、追踪窗口、overflow | 找到增长归属并排除不完整追踪 |
| 同条件安静/背景音乐两组,以及停止送帧、退出识别、销毁后的活块变化 | 判断输入环境影响,分辨持续工作缓存与真正未回收对象 |
若 free 下降而同一调用点活块没有持续增加,先查其他任务与碎片;若活块稳定随轮次增加且 clean 已执行,才检查目标版本的库生命周期。若停帧和销毁后仍不回收,把堆追踪、调用路径、精确二进制版本交给维护者。这是建议的诊断实验,不是作者已完成的板卡测试。
复制运行:同阶段快照比对,先阻止三种误判
下面把同轮表变成一个可运行的标准库例。它只比对构造记录,不读取主机真实内存,不调用 ESP-IDF,也不分配或运行 MultiNet。固定字段包括运行身份、构建身份、内存能力范围、阶段、轮次、free/largest/minimum、追踪是否 overflow,以及带独立分配事件标识的活块列表。字节数是记录中的业务数据,不是这个 Python 进程实际用了多少内存。
程序只选择 after_clean 阶段;during_detect 保留在输入里,却不拿它和下一轮结束状态直接比较。每条归一化记录字段完整、轮次有序,同一 run/build/caps 才有比较资格。allocation_id 表示分配事件身份,不是把一个原始指针永久当成同一对象;采集层若要解析真实日志,应先结合分配与释放事件建立身份。这份最小例不实现日志解析器或实时监控服务。
保存为 heap_snapshot_compare.py,用 Python 3.8 或以上运行,无需依赖安装。断言自检不要使用 -O。
bash
python3 heap_snapshot_compare.py
python
"""Compare constructed same-stage heap snapshots; no ESP-IDF or model execution."""
from copy import deepcopy


def compare(rows, site="ctc_path_alloc"):
    selected = [r for r in rows if r["phase"] == "after_clean"]
    if len(selected) < 2:
        raise ValueError("need at least two after_clean snapshots")
    identity = (selected[0]["run"], selected[0]["build"], selected[0]["caps"])
    counts, sizes = [], []
    for row in selected:
        if (row["run"], row["build"], row["caps"]) != identity:
            raise ValueError("mixed run/build/capability scope")
        if not 0 <= row["minimum"] <= row["free"] or not 0 <= row["largest"] <= row["free"]:
            raise ValueError("invalid heap metric relationship")
        if len({a["allocation_id"] for a in row["live"]}) != len(row["live"]):
            raise ValueError("duplicate live allocation identity")
        if any(type(a["bytes"]) is not int or a["bytes"] <= 0 for a in row["live"]):
            raise ValueError("invalid allocation size")
        target = [a for a in row["live"] if a["site"] == site]
        counts.append(len(target))
        sizes.append(sum(a["bytes"] for a in target))
    first, last = selected[0], selected[-1]
    if any(b["round"] <= a["round"] or b["minimum"] > a["minimum"]
           for a, b in zip(selected, selected[1:])):
        raise ValueError("invalid round or low-watermark order")
    free_delta = last["free"] - first["free"]
    largest_delta = last["largest"] - first["largest"]
    minimum_delta = last["minimum"] - first["minimum"]
    if any(r["overflow"] for r in selected):
        signal = "TRACE_INCOMPLETE"
    elif all(b > a for a, b in zip(counts, counts[1:])) and all(b > a for a, b in zip(sizes, sizes[1:])):
        signal = "TARGET_LIVE_ACCUMULATING"
    elif free_delta == 0 and minimum_delta < 0:
        signal = "CURRENT_RECOVERED_HISTORY_LOW"
    elif free_delta == 0 and largest_delta < 0:
        signal = "CONTIGUOUS_SPACE_SMALLER"
    elif free_delta < 0 and sizes[-1] == sizes[0]:
        signal = "OTHER_SITE_OR_UNATTRIBUTED"
    else:
        signal = "NO_SIMPLE_PATTERN"
    return {"signal": signal, "free_delta": free_delta, "largest_delta": largest_delta,
            "minimum_delta": minimum_delta, "counts": counts, "bytes": sizes,
            "selected": len(selected)}


def live(count, site="ctc_path_alloc", size=44):
    return [{"allocation_id": f"{site}-{i}", "site": site, "bytes": size} for i in range(count)]


def snapshot(round_id, free, largest, minimum, allocations, phase="after_clean"):
    return {"run": "run-1", "build": "demo-build", "caps": "INTERNAL",
            "round": round_id, "phase": phase, "free": free, "largest": largest,
            "minimum": minimum, "overflow": False, "live": allocations}


def main():
    peak = [snapshot(0, 1000, 800, 1000, live(1)),
            snapshot(1, 600, 500, 600, live(1), "during_detect"),
            snapshot(1, 1000, 800, 600, live(1))]
    result = compare(peak)
    assert result["signal"] == "CURRENT_RECOVERED_HISTORY_LOW" and result["selected"] == 2
    print("peak recovered: free_delta=0 minimum_delta=-400 selected=2")
    fragment = [snapshot(0, 1000, 800, 1000, live(1)), snapshot(1, 1000, 500, 1000, live(1))]
    assert compare(fragment)["signal"] == "CONTIGUOUS_SPACE_SMALLER"
    print("fragmentation clue: free_delta=0 largest_delta=-300")
    growth = [snapshot(i, 1000 - 44 * i, 800 - 44 * i, 1000 - 44 * i, live(i + 1)) for i in range(3)]
    result = compare(growth)
    assert result["signal"] == "TARGET_LIVE_ACCUMULATING" and result["bytes"] == [44, 88, 132]
    print("same-site growth: counts=[1, 2, 3] bytes=[44, 88, 132] free_delta=-88")
    other = [snapshot(0, 1000, 800, 1000, live(1)),
             snapshot(1, 900, 700, 900, live(1) + live(1, "network_log", 100))]
    assert compare(other)["signal"] == "OTHER_SITE_OR_UNATTRIBUTED"
    print("free drops/target stable: OTHER_SITE_OR_UNATTRIBUTED")
    incomplete = deepcopy(growth)
    incomplete[-1]["overflow"] = True
    assert compare(incomplete)["signal"] == "TRACE_INCOMPLETE"
    print("trace overflow: TRACE_INCOMPLETE")
    for key, value in (("build", "other-build"), ("caps", "SPIRAM"), ("run", "other-run")):
        mixed = deepcopy(growth)
        mixed[-1][key] = value
        try:
            compare(mixed)
        except ValueError:
            print(f"mixed {key}: REJECTED")
        else:
            raise AssertionError("mixed identity accepted")
    resized = [snapshot(0, 1000, 800, 1000, live(1)), snapshot(1, 956, 756, 956, live(1, size=88))]
    assert compare(resized)["signal"] == "NO_SIMPLE_PATTERN"
    print("stable count/growing size: bytes=[44, 88] (not count accumulation)")
    print("PASS: same-stage, metric and attribution assertions")


if __name__ == "__main__":
    main()
2026 年 10 月 13 日本地实际运行,退出码 0,标准输出如下:
text
peak recovered: free_delta=0 minimum_delta=-400 selected=2
fragmentation clue: free_delta=0 largest_delta=-300
same-site growth: counts=[1, 2, 3] bytes=[44, 88, 132] free_delta=-88
free drops/target stable: OTHER_SITE_OR_UNATTRIBUTED
trace overflow: TRACE_INCOMPLETE
mixed build: REJECTED
mixed caps: REJECTED
mixed run: REJECTED
stable count/growing size: bytes=[44, 88] (not count accumulation)
PASS: same-stage, metric and attribution assertions
峰值恢复组共有三个输入快照:第一轮结束、下一轮识别中、下一轮结束。识别中 free 由 1000 降到 600,结束恢复为 1000,minimum 仍为 600。程序只选两个 after_clean 快照,得到 free_delta=0 与 minimum_delta=-400。如果把中间峰值和第一轮空闲快照直接相减,或者把最低水位变化当作未释放,就会写出错误结论。实际记录不仅要有数字,还要有业务阶段。
连续空间组总 free 都是 1000,largest 从 800 降到 500。输出表示连续空间变小的线索,不是"已经证实碎片化根因"。真实系统可能还有不同内存区域、不同能力限制或并发分配;同口径下的 largest/free 差异提示进一步查布局与目标大分配,不能用目标调用点没有增长就宣布内存完全可用。
活块累计组的同一调用点数量为 1、2、3,字节数为 44、88、132,free 从 1000 降至 912。44 仅用于这个构造数据,与 issue 中报告的某类分配大小对应,不测真实库对象。程序同时检查数量和字节数,给出 TARGET_LIVE_ACCUMULATING,表示"这些输入快照中的目标活块持续增加";不是漏泄裁决,没有证明它们应在 clean 时释放。
再换一组,目标调用点始终只有一个 44 字节对象,但 network_log 新增 100 字节,free 下降。输出 OTHER_SITE_OR_UNATTRIBUTED,提醒不要给原嫌疑路径定罪。这一标签同时容纳其他路径和未被追踪覆盖的差额,因为仅有目标对象稳定,还不足以确认所有差值都来自网络。输入中恰好列了 network_log,不代表真实平台的全堆开销与列表字节数永远精确相等。
不完整记录先停判定,而不是补一条成功曲线
同一组累计快照,只把最后一轮 overflow 改为真,输出就变为 TRACE_INCOMPLETE。程序仍保留输入数字,但优先提示追踪不完整,不给它增长归因标签。真实堆追踪可能遗漏分配或释放,漏记后的列表不能当作完整对象账本;先收缩窗口或调整容量,再用相同负载重测,且说明追踪设置变化带来的内存开销。
build、caps 和 run 的混合输入分别被拒绝。两个构建可以各自看起来合理,内部堆与 PSRAM 的 free 也都是字节,但不能因此放在一条同轮差值里。若需要比较升级前后,应各自先完成相同阶段的运行,再在带版本说明的对照报告里比较;不要把跨构建的快照塞进这个函数,让一个差值暗示连续生命周期。
最后的反例保持活块数量为 1,把大小从 44 改为 88。它可能是容量扩张或记录含义改变,程序输出 NO_SIMPLE_PATTERN,而不是"新增对象累计"。没有列出的模式保持无简单判定,避免为了给每组数据起一个原因名而越权推断。当前函数每次返回一个优先匹配的线索,不能保证同时枚举所有共存问题;它交付的是原始差值与需要调查的方向。
接入真机记录,还需要哪些生命周期证据
如果现场日志能填进相同字段,下一步仍是停帧、等待外层消费完成、退出识别和销毁后的同阶段观察。目标活块在识别窗口末尾增加,可能是正常延后释放;在合理退出边界之后还存活,才值得继续查对象归属。等待多久要由当前异步任务的完成条件决定,不能从这段代码的两个或三个快照推导固定等待秒数。
示例中的 allocation_id 有意保持稳定,但函数只统计当下活块数量与大小,不证明每个对象横跨几轮存活。真实追踪应保留事件序号、地址、调用点、分配时间与释放事件;地址被再次分配时建立新身份。若只有截图中的同一个地址,最多说明位置相同,不足以说对象从未释放。把这条限制贴在活块累计旁,能防止工具输出被误用成库泄漏证据。
最小例的价值是先把可比较条件和测量口径固定住,再决定下一次记录什么。它没有测得 5.5 B/s,没有复现 ctc_path_alloc 的分配,也没有确认 ctc_beams_free() 缺口。公开 issue 负责给出该特定配置的调查线索,本地断言负责检查比对规则,板卡生命周期实验负责最终核验,三者不能互相替代。
候选处理后的回归,不只看"没有崩"
如果升级组件或调整使用方式,复测原来的帧数、轮次和观察窗口,并确认追踪没有 overflow。没有崩溃可能只是余量尚够,free 与活块趋势仍应保存。若原增长路径消失,却出现另一个分配点累计,也不能称内存整体稳定。已定位的问题可以确认改善,新问题需要继续分流,二者同时记录。
还要恢复最终应用负载,观察与音频、网络、播放同时工作时的余量。诊断构建中的表现用于定位,产品构建中的表现用于范围内交付。若尚未覆盖长时间数据,只能报告已完成时长与轮次;本文没有为任何设备计算寿命或设定安全余量,因为没有本机趋势和业务分配需求。
给维护者的最小材料包括实际组件与库身份、输入和模式、每轮 clean 路径、追踪设置、活块调用点与停止/销毁结果。内部机制仍不明时,可以准确提出"这些对象在这些生命周期边界之后仍存活",不需要写一个未经核实的内部修复猜想。生命周期证据越清楚,越容易区分应用持有、正常缓存和库内未释放。
接到自己的设备时,先让输入阶段、目标调用点、清理与退出记录落在同一运行上,再解释增长。clean 有调用记录是一个条件,活块在应当结束的边界后是否恢复才是下一个需要回答的问题。