💡 一句话总结:一项 866 任务 × 5 模型 × 5 重复的受控研究发现------推理模式写代码「不一定值」:有的基准白烧 2000+ 思考 token 换不来显著提升,轨迹更长不等于更准,而且已生成的思考轨迹砍掉一半再写答案,正确率几乎不掉。做推理服务、agent 管线、模型评测的人都该看看这套算法。
导语:你的推理模型,可能一直在「白想」
先问一个可能戳到你的问题:你开推理模式跑代码任务时,看过账单里那串思考 token 数吗?
现在的推理模型(Qwen3、QwQ、DeepSeek-R1 这类)写代码前会先「打草稿」------在 <think> 标签里生成一大段推理轨迹,然后再给出最终代码。你为这些思考 token 付的是真金白银,但几乎所有评测榜只报一个 pass@1(一次生成能通过测试的比例)。思考花了多少、花在哪、值不值,榜单上一概看不见。
一篇 2026 年 10 月挂上 arXiv 的实证研究把这个账算了:论文标题很直白------Does More Thinking Pay Off?(多想真的值吗?),来自 Massey University、山东财经大学、奥塔哥大学和杭州师范大学的团队。他们在 HumanEval Pro、MBPP Pro、BugsInPy 三个基准共 866 个 Python 任务上,对 5 个模型配置各跑 5 次重复实验,把「正确率」和「思考开销」第一次放在同一张账单上对比。
结论有点扎心:多想,不一定值。
想自己动手看?
- 📄 论文:arXiv 2610.36952
- 📊 基准:BugsInPy(真实开源项目 bug 库)
白想了 2000 个 token,是什么体验?
论文开篇的例子堪称行为艺术。HumanEval Pro 第 20 题,让模型写个函数:找出列表里距离最近的两个数。
Qwen3-32B 开推理模式,先写了 7,430 个思考 token,然后交出 12 行、103 token 的正确答案。这 7,430 个 token 都花哪了?
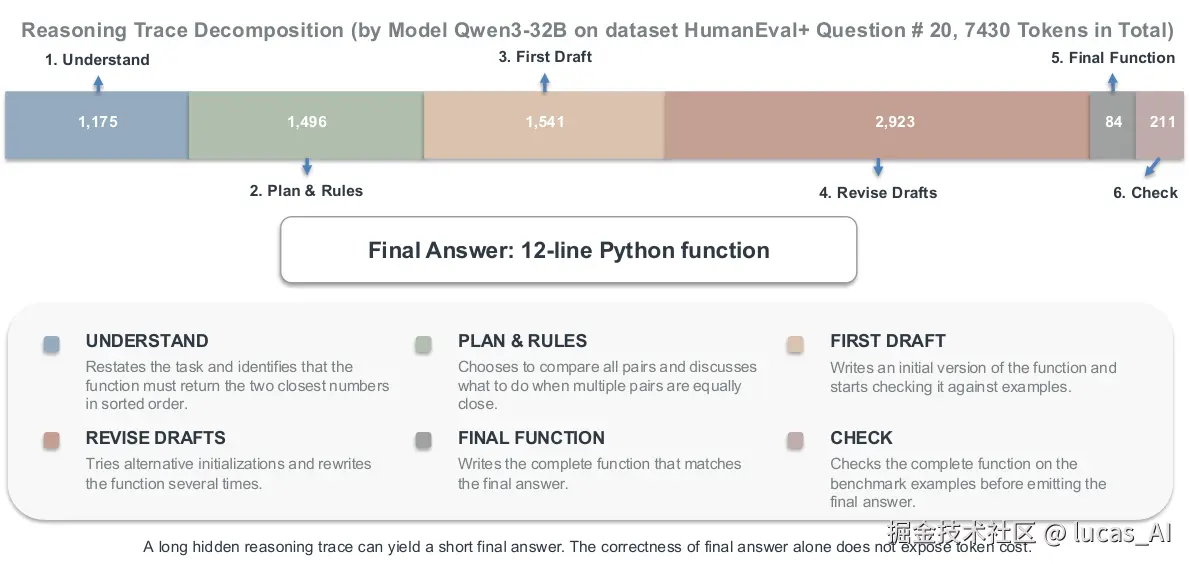 图说:7,430 个思考 token 里,最大块是反复修改代码(2,923)和草拟代码(1,541),真正写最终答案只用了 84 个 token------而且完整答案在轨迹中段就已经出现了。
更妙的是:完整的答案代码在思考中段就已经成型了,模型又继续「思考」了 211 个 token 才收尾。像不像你写周报时明明写完了,又从头检查了半小时,最后交上去的还是原稿?
这只是个例。但接下来的系统性实验说明,这种「白想」不是偶发。
怎么把「值不值」变成一道可计算的题?
研究者的思路说穿了很简单:控制变量 + 记账。
第一招:同权重只切开关。 Qwen3-32B 有个官方推理开关,开了有 <think> 轨迹、关了直接写代码,模型权重一个字节都不变。同一批任务、同一个模型、只切这一个开关,各跑 5 次(temperature 0.6 有随机性,单次不作数),再用 McNemar 检验(一种配对统计检验,专门看「同一任务两次结果翻转」是否失衡)逐次检验。这样量出来的差异,才能干净地归因给「推理」本身,而不是「换个更强模型」。
第二招:给思考也记账。 他们定义了 TTC(Thinking Token Count,思考 token 数),和正确率并列汇报。账单长这样:
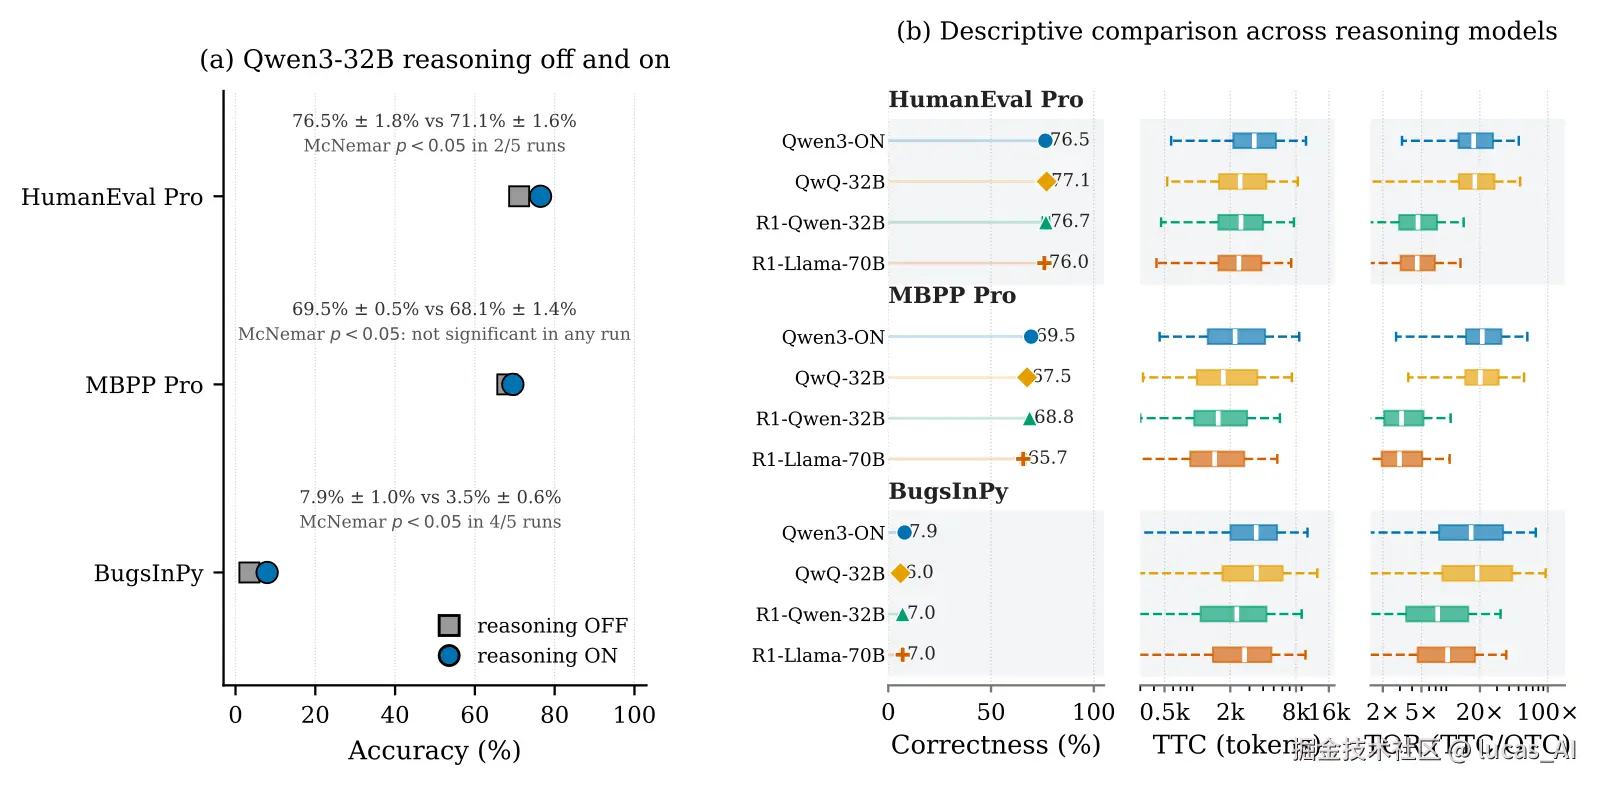 图说:左图是 Qwen3-32B 关/开推理的配对对比,右图是四个推理模型的跨模型对比------注意箱线图(思考量分布)和点的位置(正确率)根本不成正比。
第三招:不只数长度,还看内容。 他们人工标注了 104 条轨迹、切出 3,943 个片段,归纳成六类行为:理解题意(Sensemaking)、制定策略(Strategy Formation)、检查验证(Verification)、诊断定位(Diagnosis and Localization)、收尾(Closure)和其他。
第四招:砍轨迹做再生实验。 把已经生成好的推理轨迹砍掉一截,只留前缀,喂给另一个「不思考」的模型让它照着写答案------对比喂完整轨迹的同一模型,看正确率掉不掉。这一招对应真实场景:很多推理管线会把一个模型的思考轨迹存下来、转交给另一个模型写最终代码(所谓 offloaded reasoning),轨迹存多长直接决定下游调用的输入成本。
这里有个特别讲究的细节:不能拿「砍过的轨迹写出的答案」直接对比「原始答案」------因为重新写答案这一步本身就有随机性,掉点可能只是重写抖动。论文的基线是同一个模型喂完整轨迹重新写答案,这样两组唯一的区别就是保留了多少思考,公平。
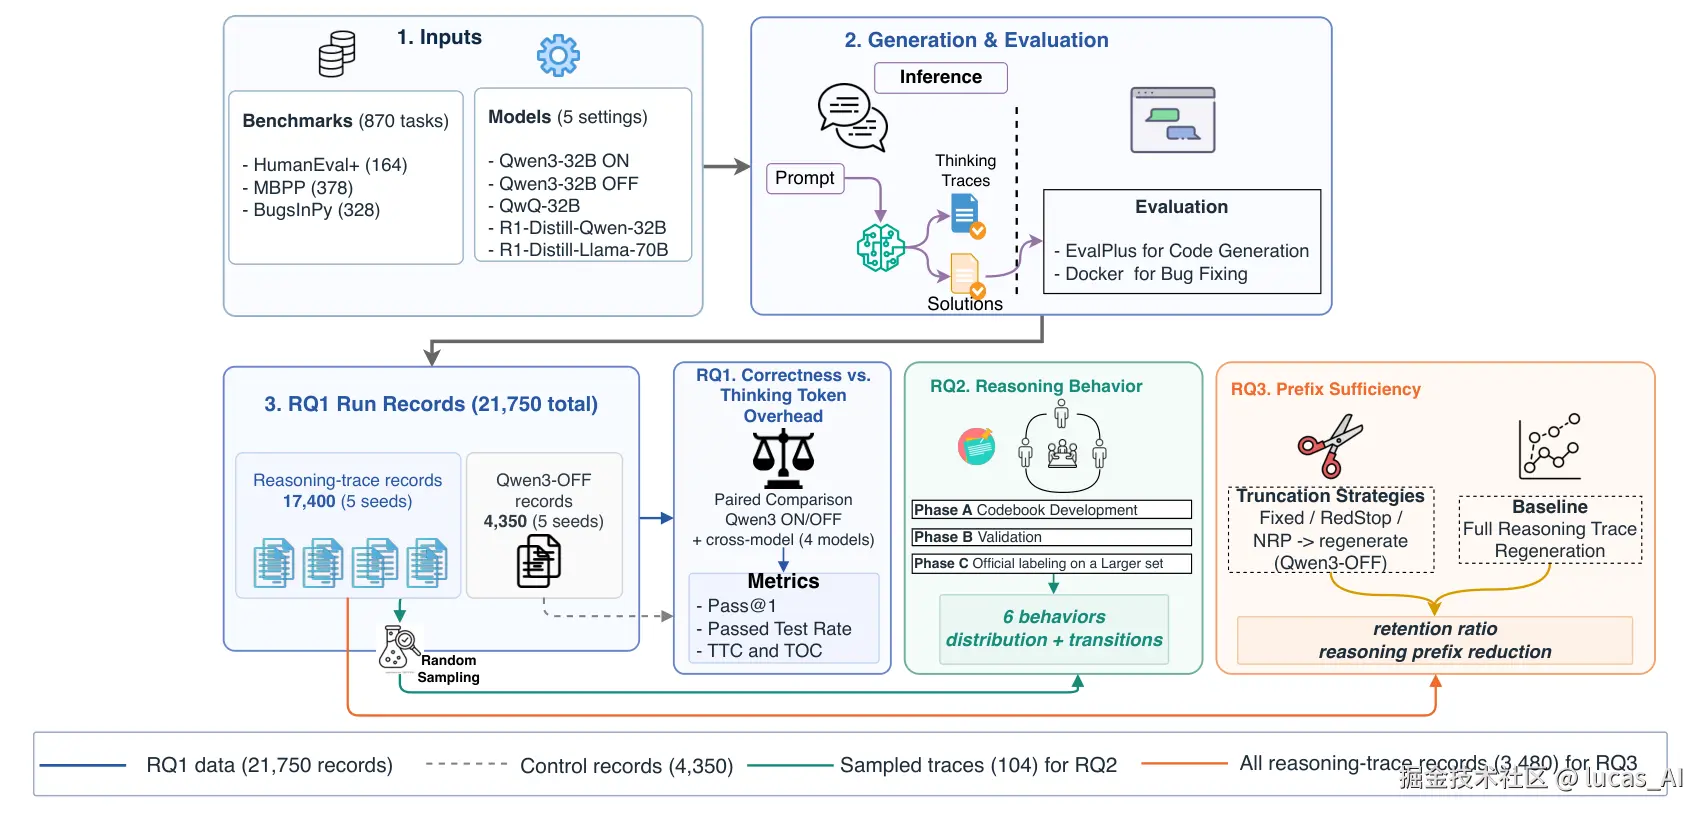 图说:左侧 866 个任务分三路------RQ1 配对开关实验、RQ2 人工行为标注、RQ3 轨迹截断再生,互相独立、互不污染。
账单出来了:三个扎心的数字
数字一:2,221 个思考 token,换 1.4 个点,还不显著
MBPP Pro 基准上,Qwen3-32B 开推理后正确率从 68.1% 涨到 69.5%------1.4 个百分点,5 次重复实验的配对检验没有一次显著 (95% 置信区间 -0.8 ~ +3.6,跨着零)。而每个任务的思考开销中位数是 2,221 token。
翻译成人话:为了一道普通难度、68% 的题本来就能做对的基准,模型平均多「想」两千多个 token,涨的那点分和抛硬币没区别。同一个开关在 HumanEval Pro(+5.4 个点,部分 run 显著)和 BugsInPy(+4.4 个点,5 次里 4 次显著)上就真金白银地有用------推理的收益强依赖任务,不存在「开了就赚」。
数字二:想得多 ≠ 想得对
四个推理模型横向一比更明显:HumanEval Pro 上大家正确率挤在 76.0%~77.1% 的窄带里,思考量却差出一截。更惨的是 MBPP Pro:R1-Distill-Llama-70B------一个 70B 的大个子------每任务烧约 1,450 思考 token,正确率 65.7%,输给了不思考的 Qwen3-32B(68.1%)。
轨迹长度和正确率之间,没有可靠的相关性。用「这家模型思考长」来判断「这家模型更强」,从此可以戒了。
数字三:思考砍一半,正确率不掉
RQ3 的再生实验给出了最有实用价值的结论:把存储轨迹砍掉前 50%(Fixed-50),再生答案的正确率与喂完整轨迹相比,所有模型 × 两个代码生成基准 × 3 次再生,经 Holm 校正后没有一组显著掉点,偶尔还反超(R1-Distill-Qwen-32B 在 HumanEval Pro 上砍半后反而高了 0.4 个点)。
反倒是两个「聪明」的截断策略翻车了:
- RedStop(检测车轱辘话,一重复就停):代码生成轨迹上只砍掉 2.2%~6.4%------模型根本不怎么重复自己,这条规则基本不触发;
- NRP(答案代码一出现就停):砍 30%~46%,但跨模型表现忽好忽坏,最好的情况下还比不过无脑的定长截断。
朴素的一刀切,赢了精心设计的停机规则。这大概是全文最幽默的一处。
思考的内容也很有意思
行为标注显示,写代码和修 bug 的「思考姿势」完全不同:
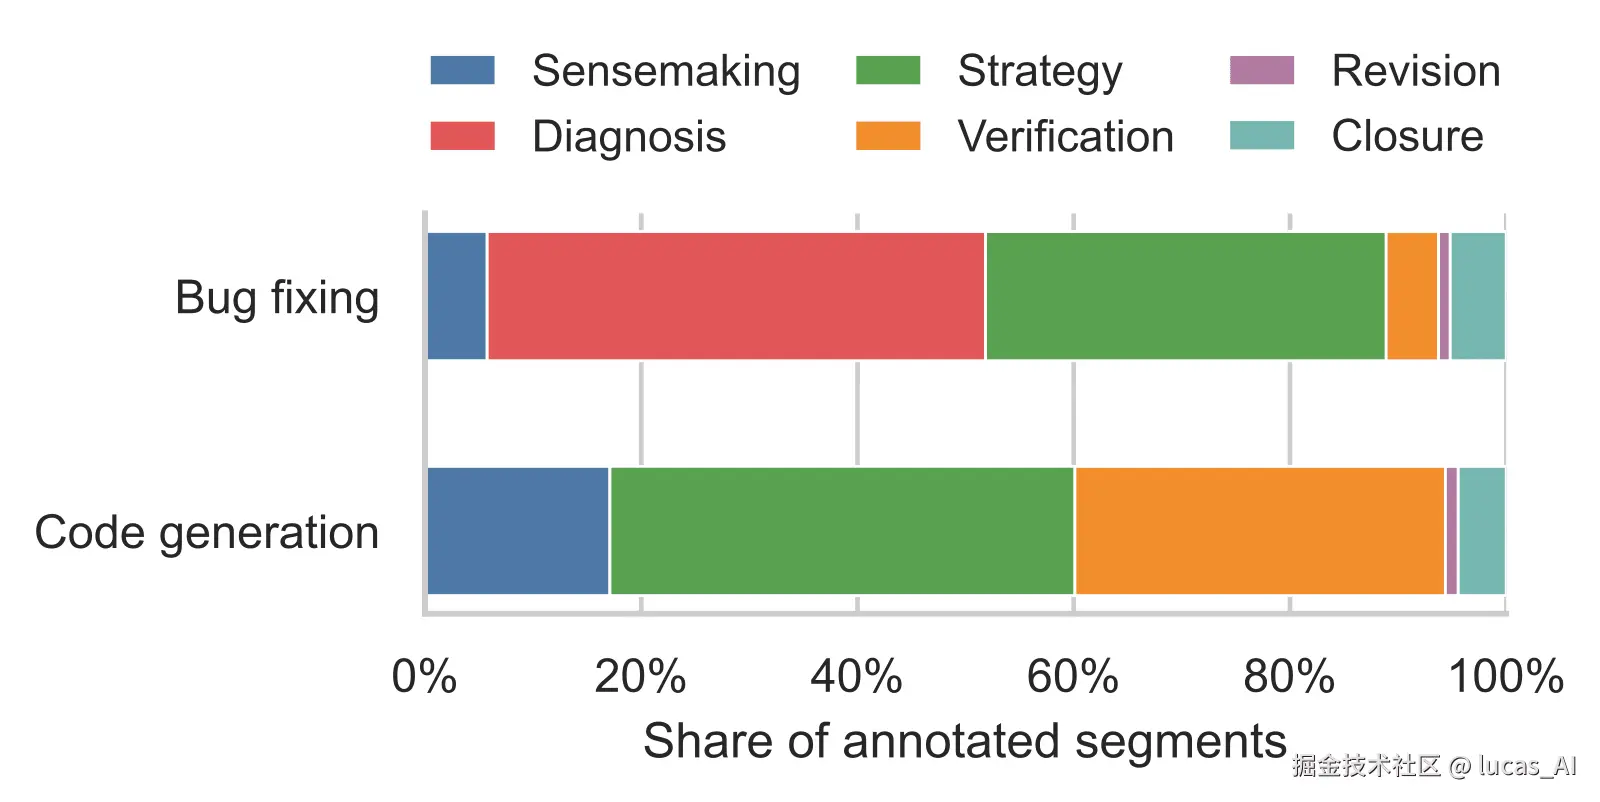 图说:写代码的思考 94% 花在「选方案 + 检查」上,是个规划-检查循环;修 bug 的思考近一半花在「找病灶」上,验证只占 4.8%。
写代码时模型在「理解题意 → 选实现 → 检查行为」之间打转;修 bug 时则一头扎进「定位故障」(占 46.1%),基本不回头检查。同样 3000 个思考 token,一个是反复斟酌方案,一个是埋头翻尸体找凶器------只报 token 数,看不见这些结构差异。
顺带一提,BugsInPy(真实项目修 bug)对所有模型都是噩梦:开推理最好的成绩也只有 7.9%。推理救不了真实仓库里的 bug 修复,这和 SWE-bench 榜单外的体感倒是意外一致。
这笔账怎么算到你头上?
如果你做推理服务或网关:按任务类型定价和分配预算。数学/符号类任务推理收益稳(前人已证),代码任务要分基准看------普通函数生成(MBPP 类)可能根本不值得开推理,复杂修复类(BugsInPy 类)开了也就从「完全不行」到「勉强能看」。
如果你做 agent / 多模型管线(一个模型出思考、另一个写答案):存储和传输轨迹时,砍前一半是当下最稳的省钱姿势,有统计背书;那些花哨的「智能截断」反而别急着上。
如果你做模型评测:请把思考开销和正确率并列汇报------这是论文反复敲的黑板。只报 pass@1 的推理模型榜,信息量少一半。
如果你只是用户:开推理模式前想想你的任务值不值。改个正则、写个 CRUD,关掉 thinking 可能又快又便宜又不掉点;卡了很久的疑难 bug,再让它想。
泼点冷水:这账单别全信
- 全是量化推理:五个模型都用 4-bit AWQ 量化塞进一张 A100。量化对思考行为的影响没做对照,结论严格说只在量化部署下成立。
- 全是 Python + 开源中小模型:最大 70B,没有闭源模型。 frontier 级模型的思考性价比可能完全是另一张表。
- 修 bug 的截断结论是弱证据:BugsInPy 正确率全体 <8%,大家都几乎不及格时看不出「砍一半亏不亏」。
- 「离线砍轨迹」≠「边想边停」:实验是生成完再砍(省的是下游输入成本),真想省生成时的算力,得靠模型自己早停------那是另一套机制,本文没测。
理性看待
这篇论文的价值不在发现多惊艳,而在把一个模糊的体感变成了可复现的协议:同权重切开关、配对检验、Holm 校正、再生基线------以后谁宣称「我的推理砍 X% 不掉点」,照这套流程验一遍就知道真假。
「多想不一定值」这句话,两年前大家只是抱怨账单时嘀咕两句;现在它有了 866 个任务、21,650 条生成记录的实证背书。推理模型还在狂奔,但至少从今天起,「思考」这项服务,开始有了价目表。
(uncertain:论文未公布生成记录与代码仓库,复现需自行搭管线;文中所有数字以 arXiv 2610.36952 v1 为准。)