【上期回顾】
上一篇讲了价值 :状态价值 Vπ(s) 是照策略 π 走的平均回报,动作价值 Qπ(s,a) 是先做动作 a、再照策略走的平均回报。贝尔曼方程 说,这一格的价值可以从下一格的价值推出来;贝尔曼最优方程 说,每格都挑最好的动作,就能得到最优策略:走廊里是一路向右, V∗=6.2, 8, 10。
那些方程能直接解,是因为我们知道走廊的全部规则。这一篇就从"规则"说起:知道规则怎么办,不知道又怎么办?顺着这个问题,把强化学习的各种算法放到一张地图上。
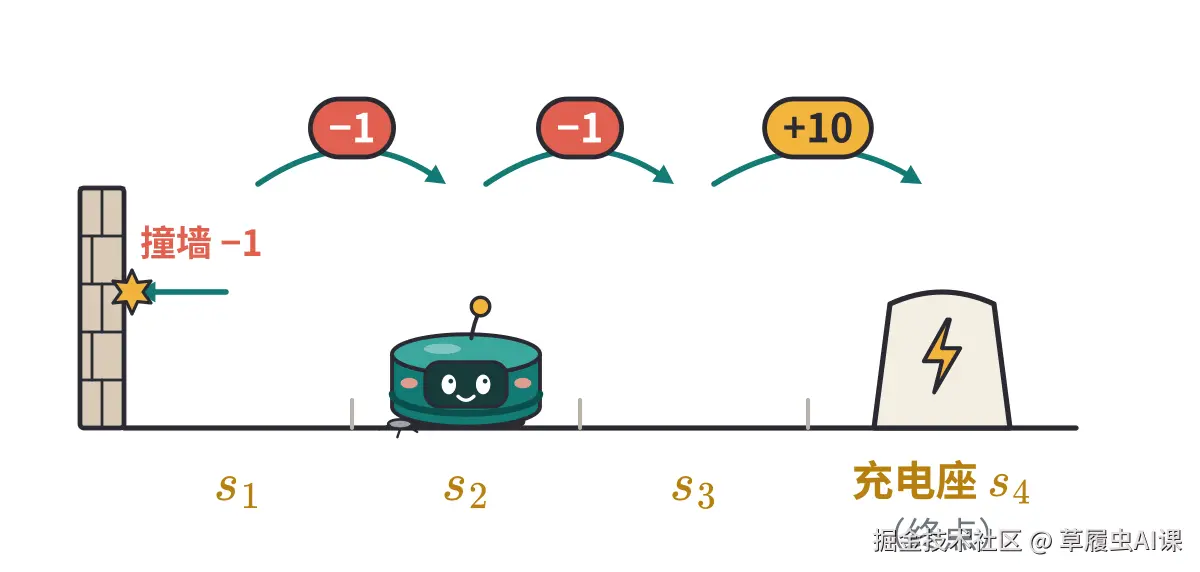
▲ 图 1 本篇例子:走廊里的扫地机器人(规则同前两篇)
【设定】走廊的规则
- 状态 :三个格子 s1,s2,s3,加上充电座 s4。进了充电座,这一回合就结束。
- 动作 :往左 ←、往右 →,结果是确定的;在 s1 按 ← 会撞墙,原地不动。
- 奖励:每走一步 −1,撞墙那一步也一样;走进充电座的那一步 +10。
- 折扣因子 : γ=0.9。
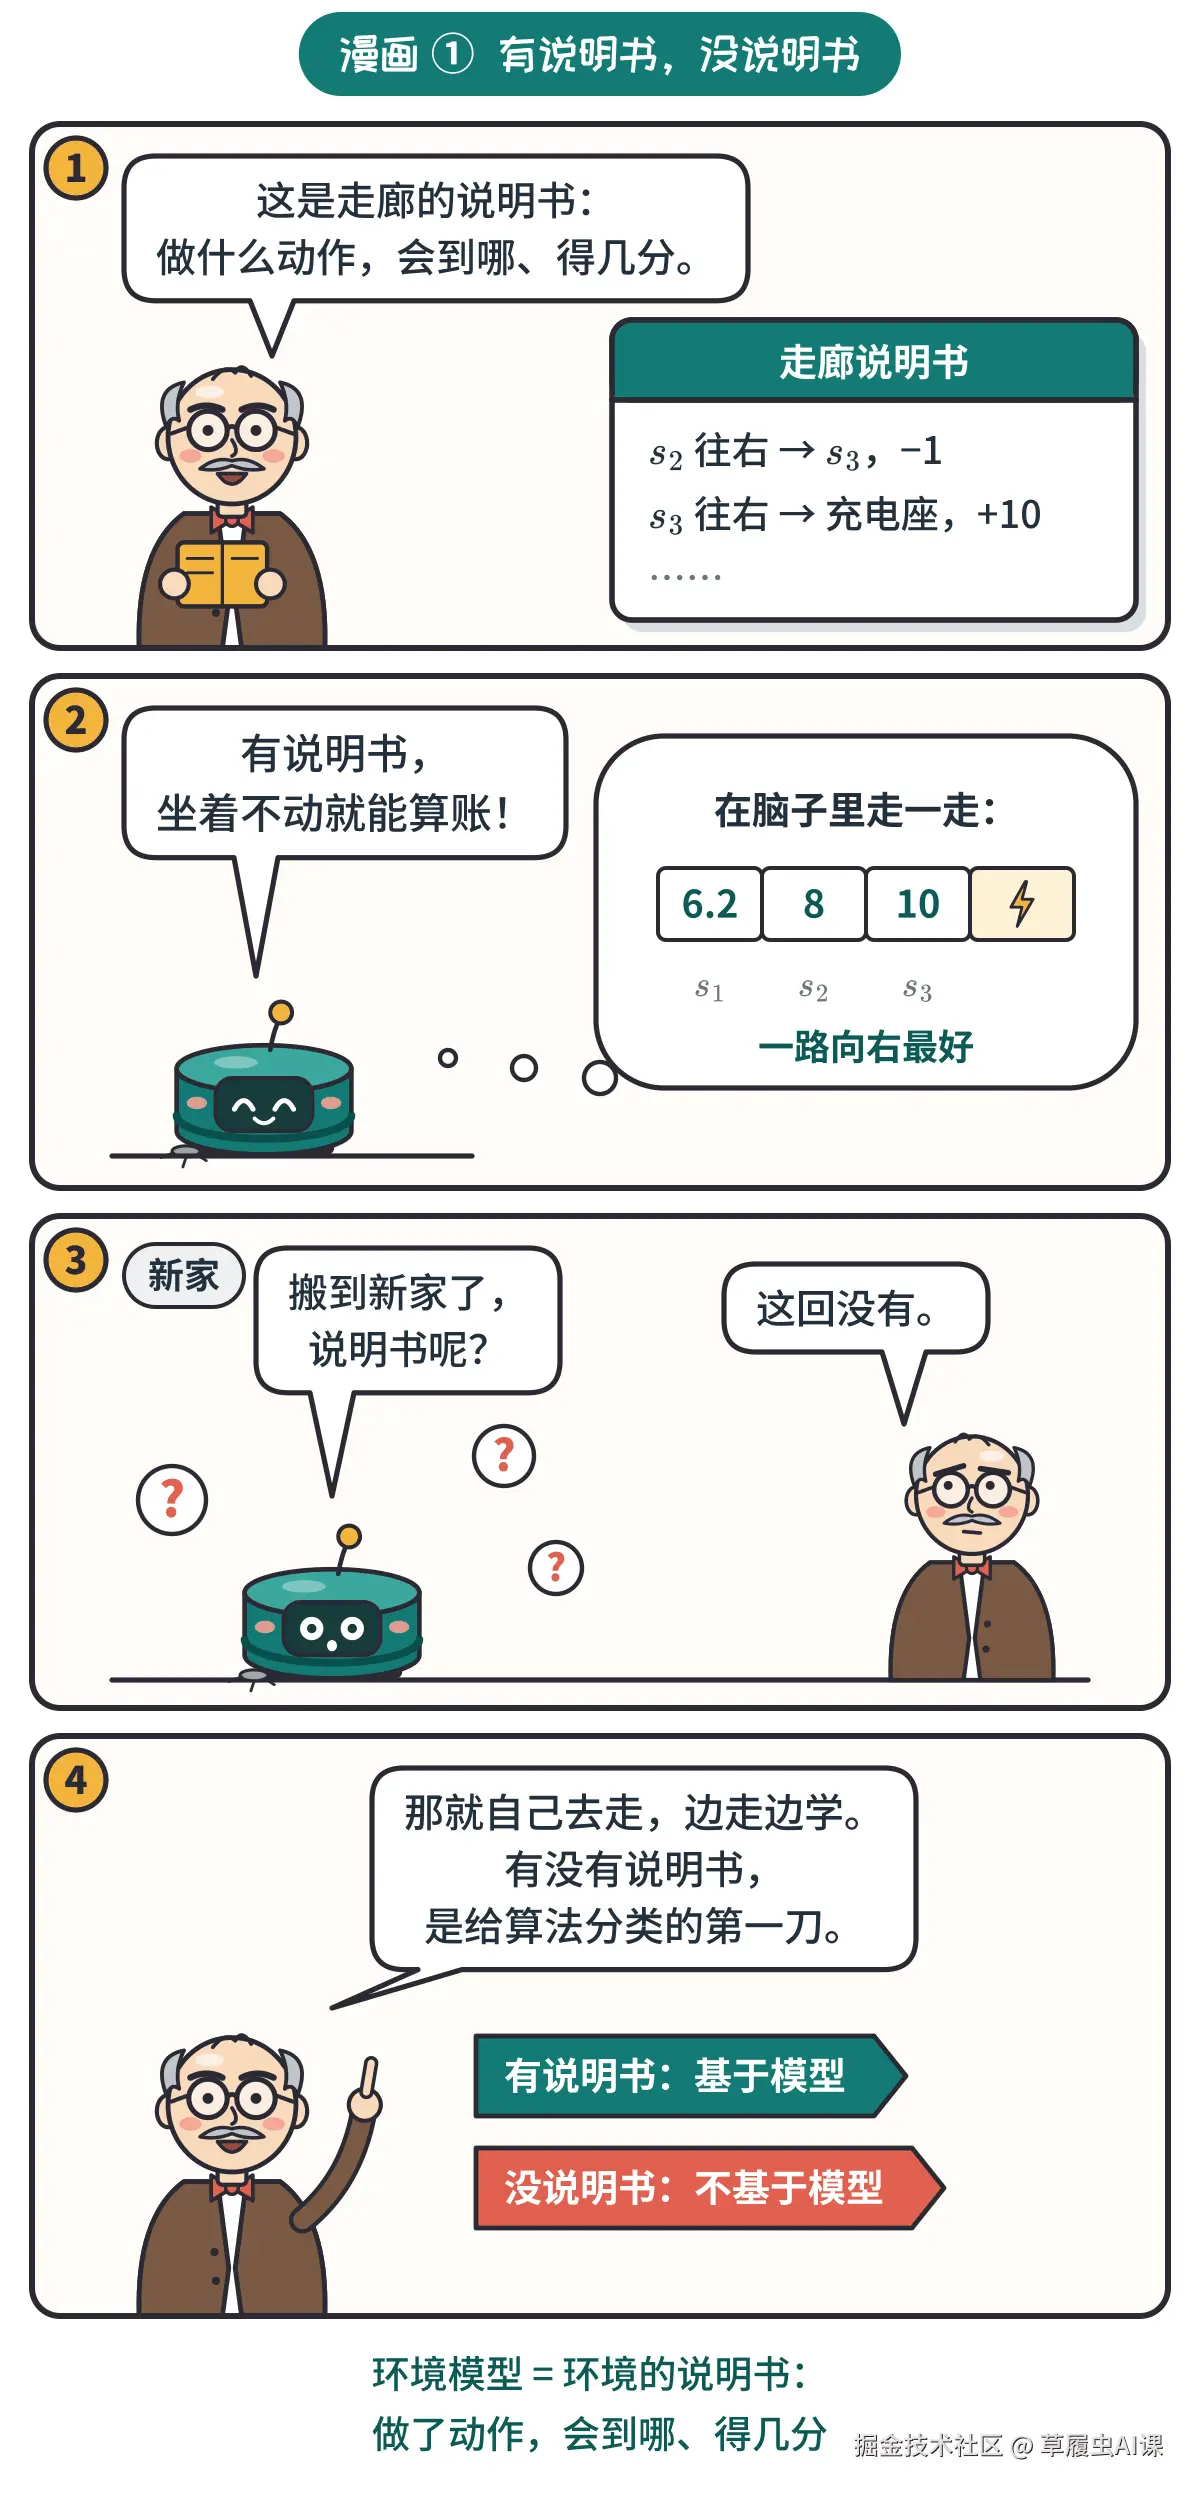
▲ 图 2 漫画 ① 有说明书,没说明书
一、环境模型:环境的说明书
漫画里的"说明书",正式的名字叫环境模型 (model of the environment),简称模型。它回答两个问题:
- 会到哪 :在状态 s 做动作 a,下一步到各个状态 s′ 的概率,也就是第 1 篇的转移概率 p(s′∣s,a);
- 得几分 :这一步拿到的奖励 r(s,a)。
说白了,模型就是马尔可夫决策过程五要素里的 p 和 r。有了模型,不用真走,也能预测"做了这个动作会怎样"。
【说法对照】漫画说大白话,正文用正式说法
- 漫画里的说明书 = 环境模型 (简称模型 ),也就是 p 和 r;
- 前两篇的账本 = 价值 V、 Q;
- 前两篇的手册 = 策略 π。
下面的正文、例题和插图都用正式说法,漫画里还是老样子。
【例 1】写出走廊的环境模型
三个格子、两个动作,一共 6 种情况,一张表就写完了:
| 状态 | 动作 | 到哪 | 奖励 |
|---|---|---|---|
| s1 | ← | s1(撞墙) | −1 |
| s1 | → | s2 | −1 |
| s2 | ← | s1 | −1 |
| s2 | → | s3 | −1 |
| s3 | ← | s2 | −1 |
| s3 | → | 充电座 | +10 |
走廊里动作的结果是确定的,所以"到哪"只有一个答案。要是地板会滑(第 1 篇的滑地板),在 s3 按 → 就要拆成两行:0.8 的概率进充电座,+10;0.2 的概率打滑留在 s3,−1。
有了这张表,上一篇的计算都能在纸上完成。比如在 s2 先往右:查表知道会到 s3、奖励 −1,于是 Q∗(s2,→)=−1+0.9×10=8,一步都不用真走。
这种不真走、只拿模型往前推算的做法,叫规划 (planning);从真实走出来的经验里学,叫学习(learning)。
【注意】这里的"模型"不是"大模型"
平时说"模型",常指神经网络、大语言模型。强化学习里说"基于模型",指的是环境模型,也就是环境的规则:会到哪、得几分。它和用不用神经网络无关。
二、算法地图:用不用模型
给强化学习算法分类,第一刀就切在"用不用环境模型"上:
- 基于环境模型(model-based):手里有模型(现成的,或者自己学出来的),先在脑子里推演,再决定怎么走。
- 不基于环境模型(model-free):不用模型,直接从一次次真实的尝试里学价值或策略。
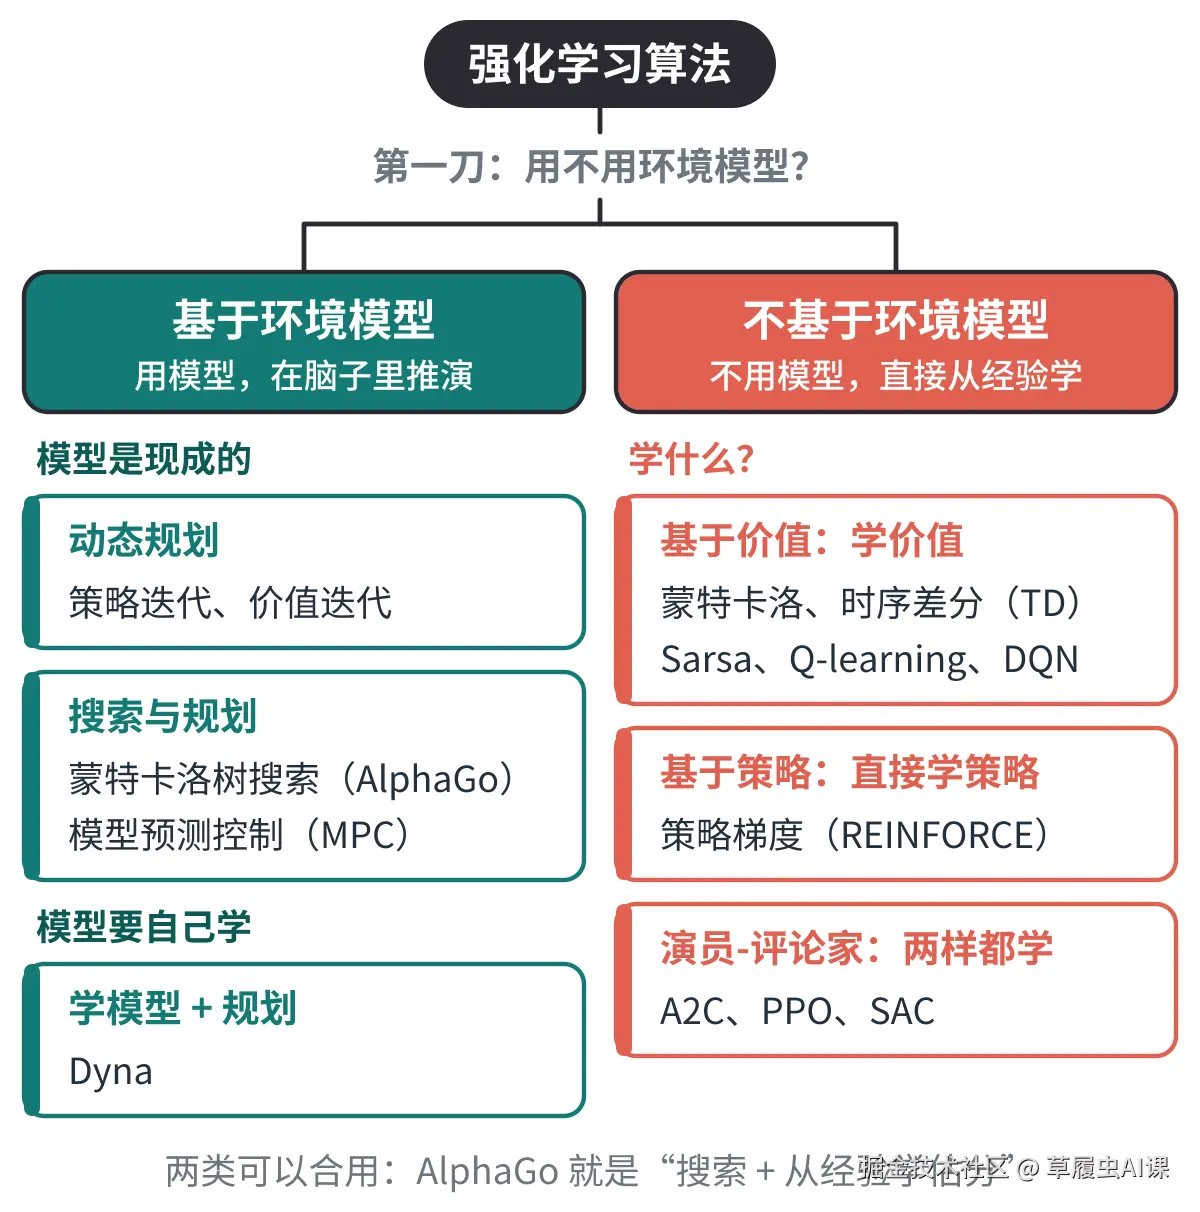
▲ 图 3 强化学习的算法地图:第一刀切在"用不用环境模型"上
右半边又按"学什么"分成三类:基于价值 的方法学价值( V 或 Q),再按价值挑动作;基于策略 的方法直接学策略;演员-评论家两样都学,策略负责选动作,价值负责打分。
上一篇例 2 让小扫跑 1 万个回合、把回报取平均来估价值,就是最简单的不基于模型的方法:它从头到尾没用过转移概率 p。
下面先看左半边(第三节),再看右半边(第四节)。
三、基于模型:在脑子里推演
地图左半边的方法都要用模型。模型有两种来路:现成的 (规则已知),或者自己从经验里学(规则未知)。不管哪种,拿到模型以后都是在脑子里推演。先看模型现成的情况。
动态规划
上一篇例 6 解方程组,能算出一个策略的价值。可它只能一个个评估,想找最优策略还得挨个比;格子一多,方程组也大得解不动。
所以模型现成、格子又不多时,最常用的是动态规划:反复用贝尔曼方程,把每一格的价值都算出来,再挑出最优策略。它有两种做法,下一篇细讲,这里先看个大概。
策略迭代:先拿一个策略,算出它的价值(策略评估);再在每一格换成价值更高的动作(策略改进);反复做,直到策略不再变。漫画②就是这个过程:
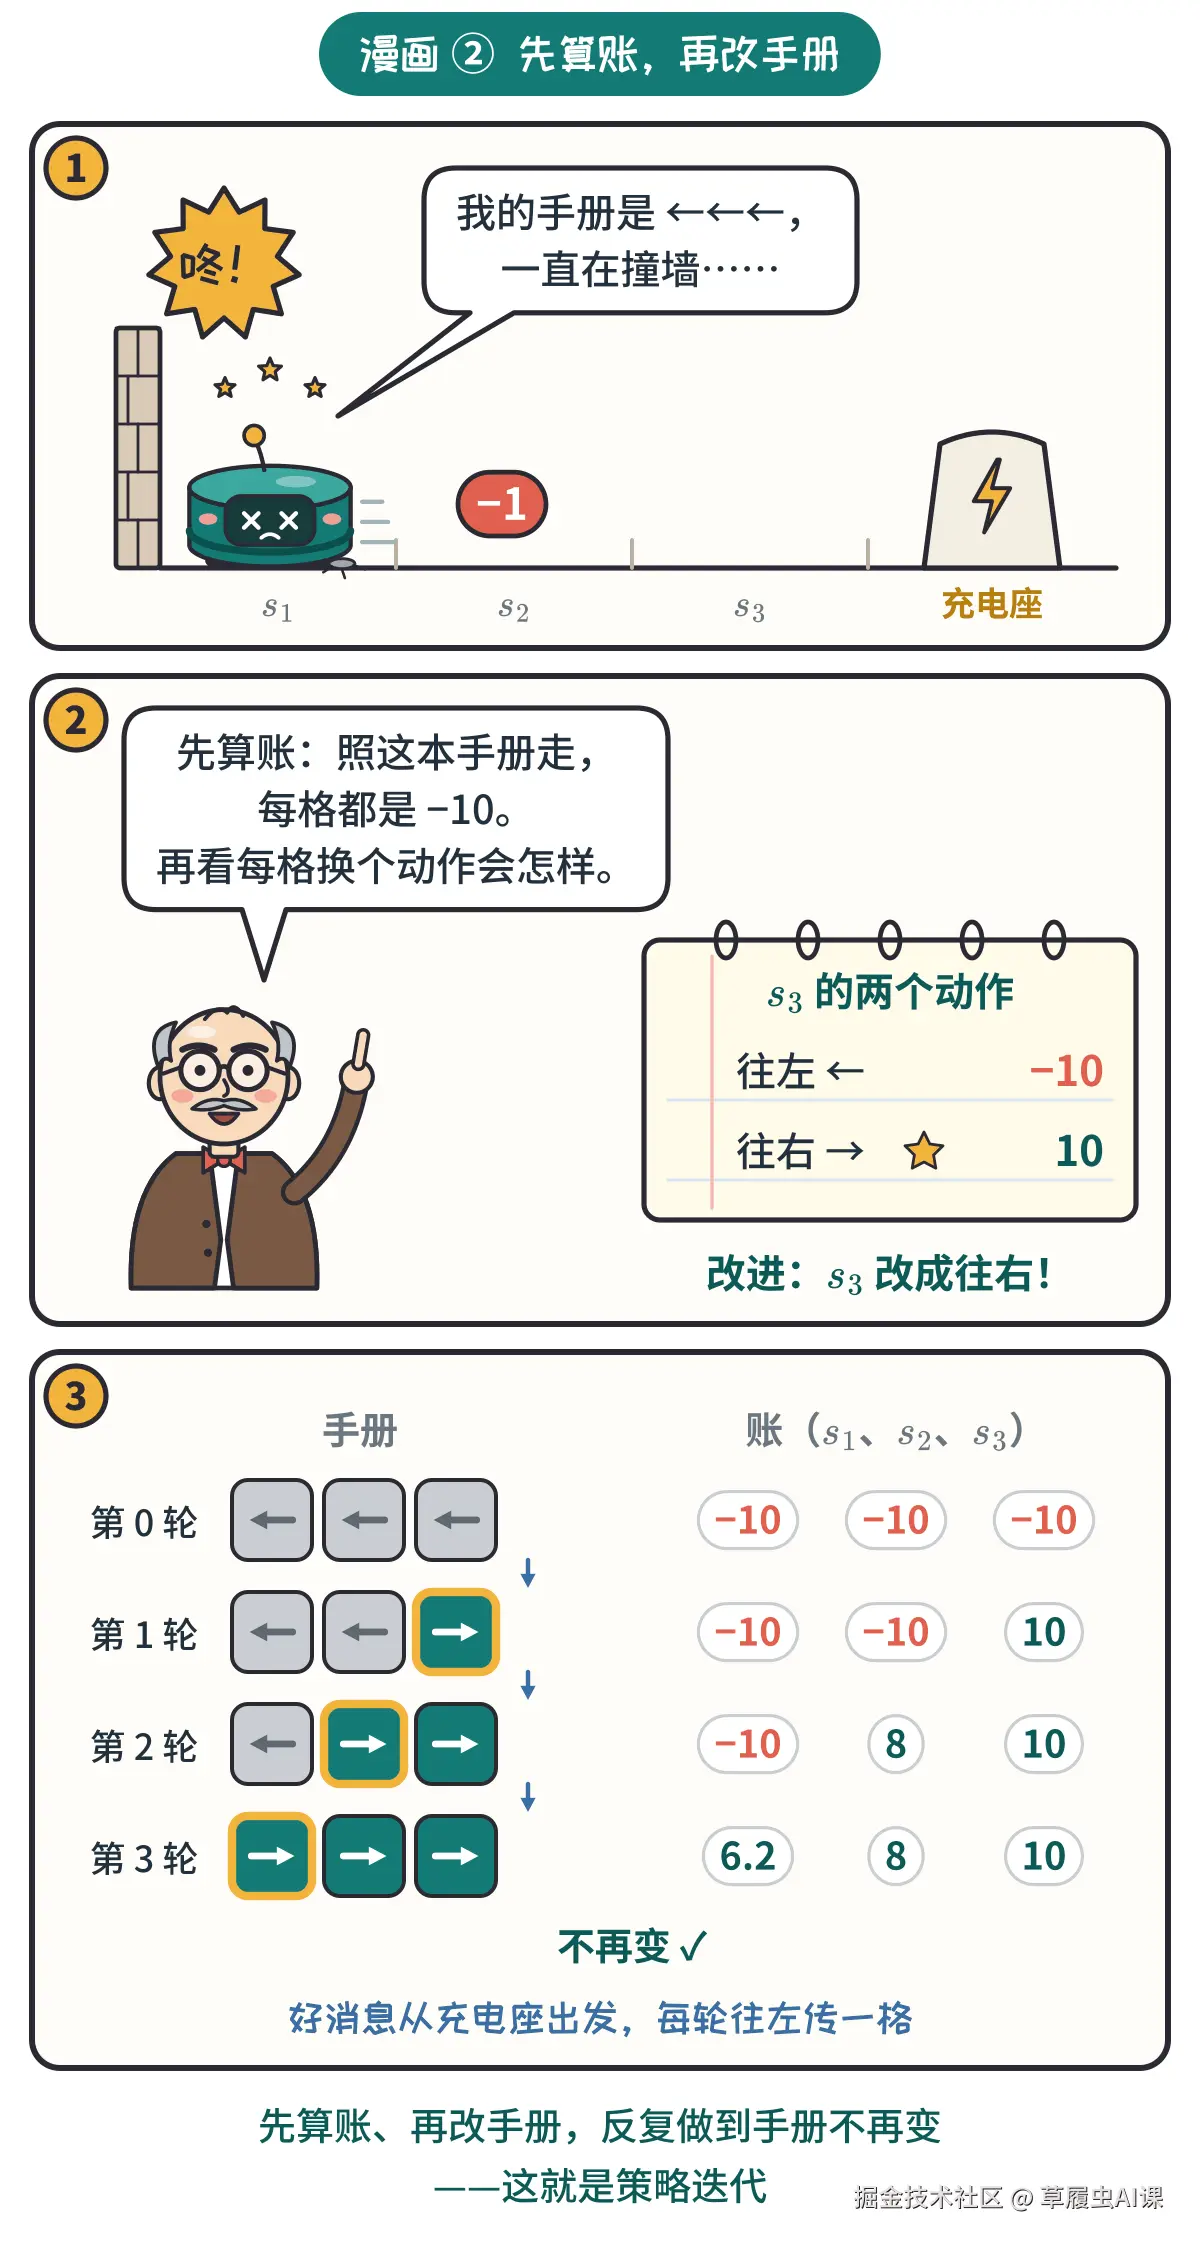
▲ 图 4 漫画 ② 先算账,再改手册
从最差的策略 ←←← 出发,改 3 次,就变成了一路向右的 →→→。
价值迭代:先不管策略,把每一格的价值都设成 0,然后一遍遍按贝尔曼最优方程重算:每格比一比两个动作的"这一步的奖励 + 0.9 × 下一格上一遍的价值",取大的。价值算准了,再每格挑最好的动作。
【例 2】价值迭代:从 0 开始
| 第几遍 | V(s1) | V(s2) | V(s3) |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 1 | −1 | −1 | 10 |
| 2 | −1.9 | 8 | 10 |
| 3 | 6.2 | 8 | 10 |
| 4 | 6.2 | 8 | 10 |
比如第 2 遍的 s2:往左 −1+0.9×(−1)=−1.9,往右 −1+0.9×10=8,取 8。第 3 遍以后就不再变了,正是上一篇的 V∗=(6.2, 8, 10);每格挑最好的动作,还是 →→→。
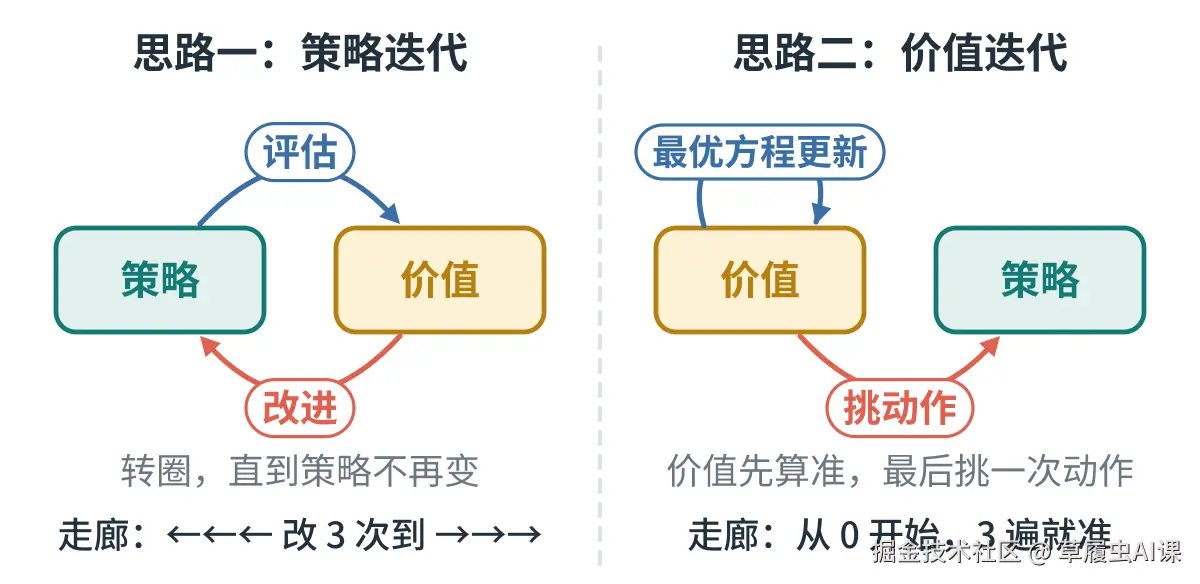
▲ 图 5 两种做法:策略迭代在策略和价值之间转圈;价值迭代先把价值算准,最后挑一次动作
两种做法都要一遍遍查模型、算遍所有格子,所以只适合模型现成、格子不多的情况。它们为什么一定能找到最优策略,留到下一篇。
模型预测控制:看几步,走一步
动态规划要给每一个格子算价值。走廊只有 3 格,可围棋每一步大约有 250 种下法,一盘棋大约下 150 步,局面多到数不清,根本算不过来。
换个思路:别的局面先不管,只为眼前这一个局面做规划。在脑子里把接下来几步的走法过一遍,挑出最好的第一步走出去;到了新局面,再重新想。
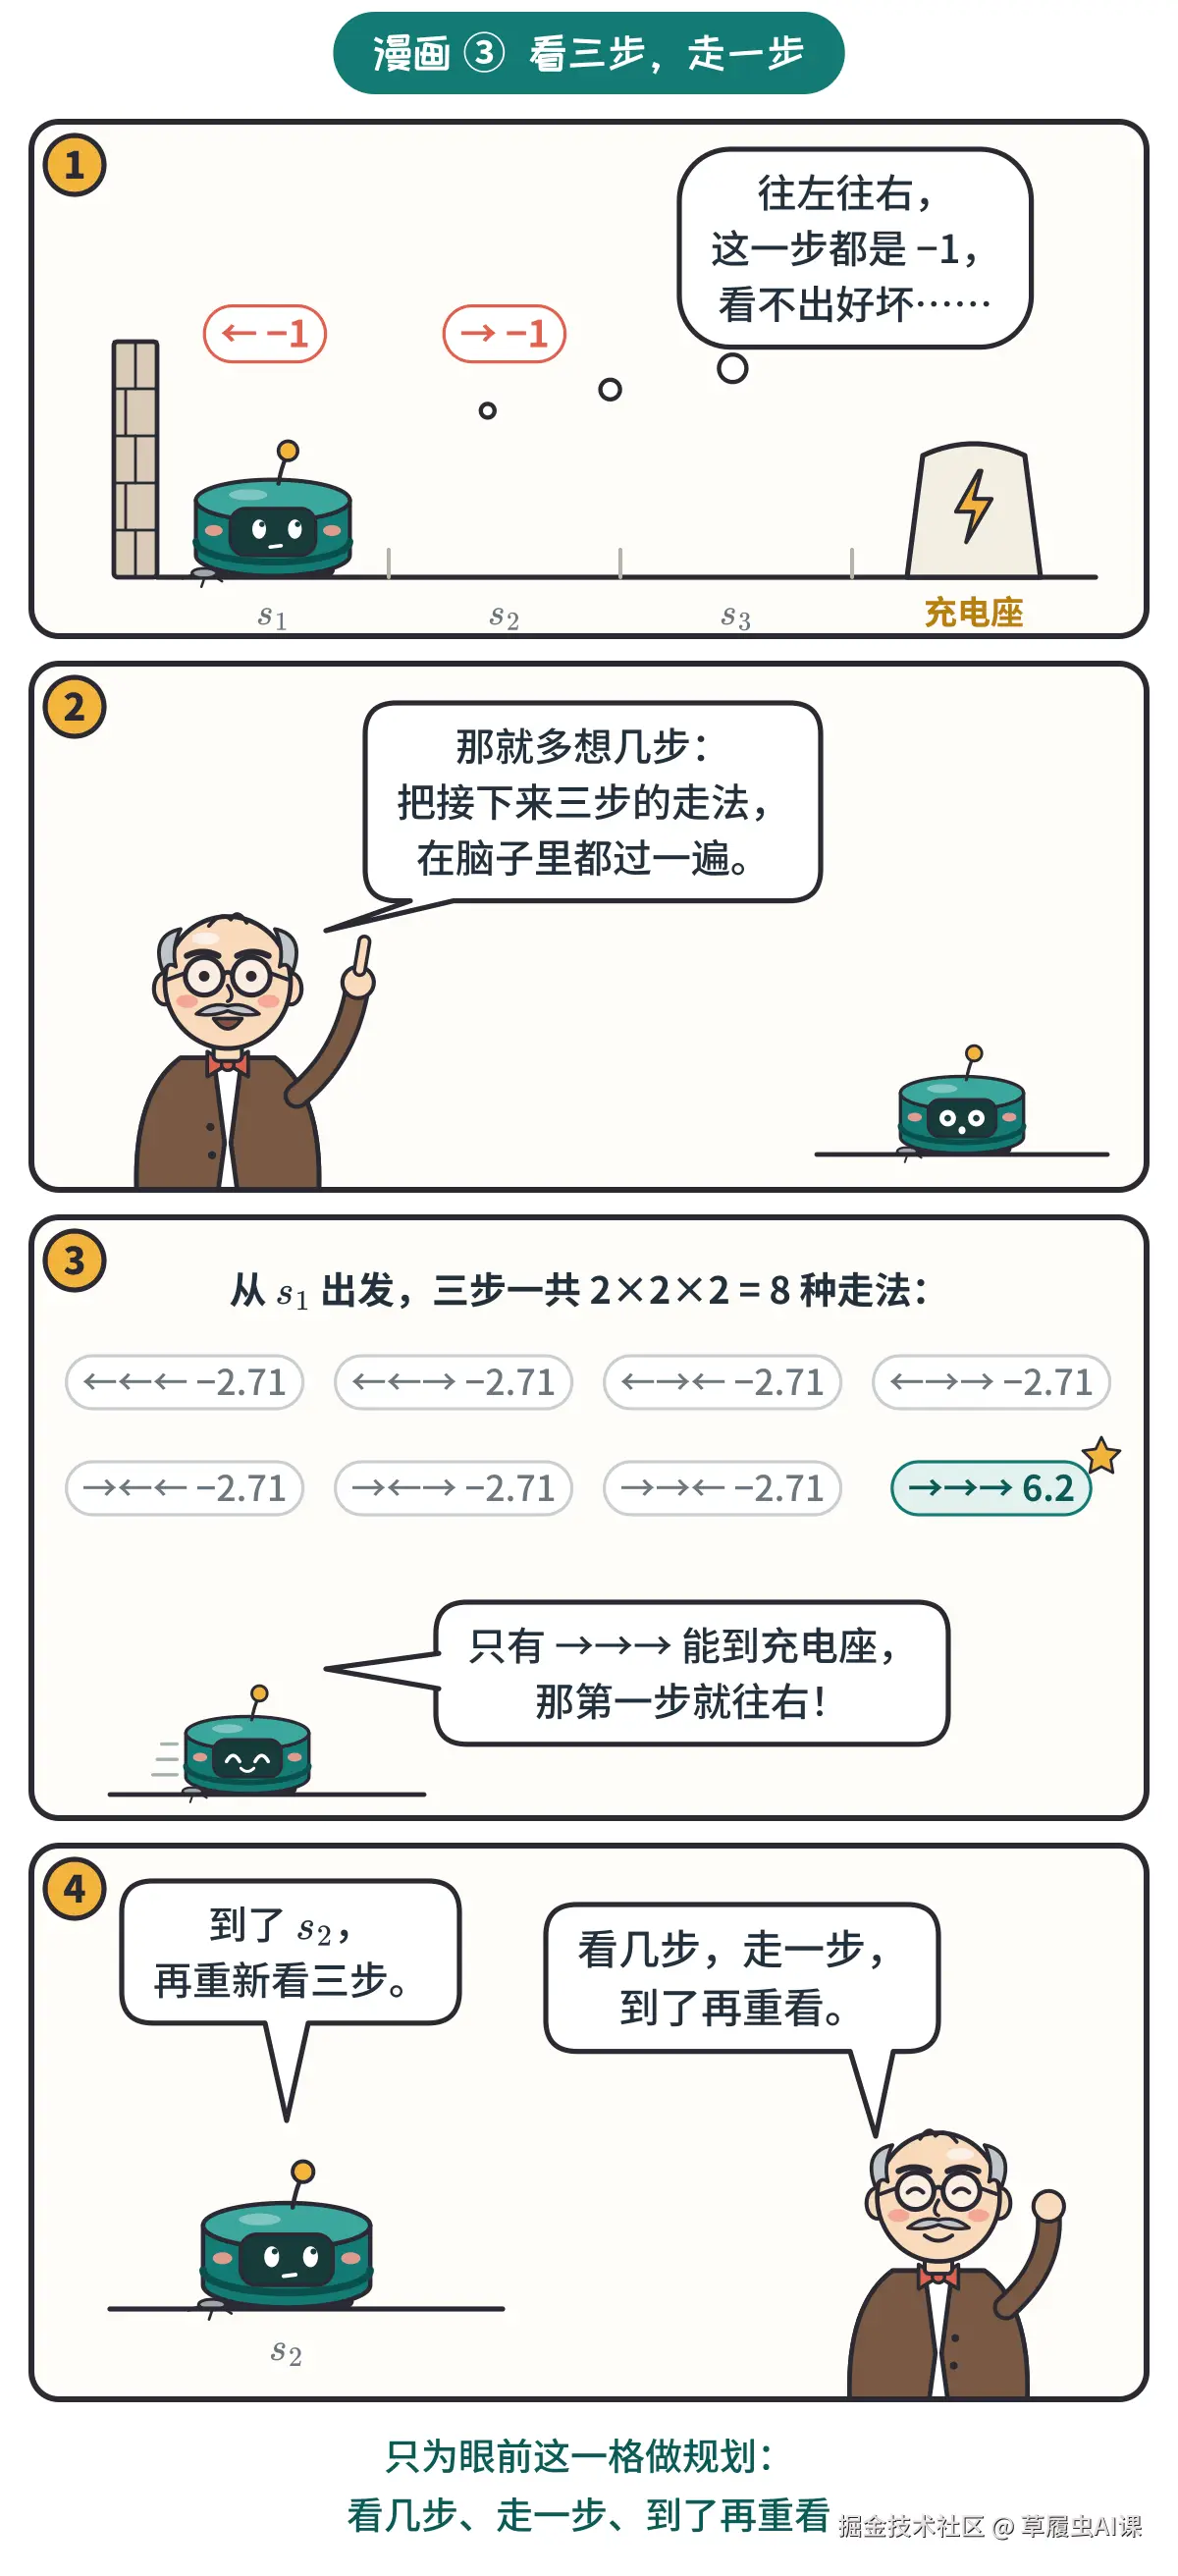
▲ 图 6 漫画 ③ 看三步,走一步
【例 3】从 s1 向前看几步
小扫在 s1,用模型在脑子里把接下来几步的走法都算一遍,回报照常打折:
- 看 1 步:往左、往右都是 −1,分不出好坏。
- 看 2 步 :4 种走法都是 −1−0.9=−1.9,还是分不出。
- 看 3 步 :8 种走法里,只有 →→→ 能走进充电座,回报 −1−0.9+0.92×10=6.2;其余 7 种都是 −1−0.9−0.81=−2.71。
于是第一步往右。走到 s2 以后,再从 s2 重新看 3 步,以此类推。
看得不够远怎么办?可以在最后加一个估分 :走完 2 步,再加上 0.92× 停下那一格的价值。拿 V∗ 当估分,4 种走法是:
| 走法 | 停在 | 2 步回报 + 估分 |
|---|---|---|
| →→ | s3 | −1.9+0.81×10 = 6.2 ★ |
| ←→ | s2 | −1.9+0.81×8 = 4.58 |
| ←← | s1 | −1.9+0.81×6.2 = 3.12 |
| →← | s1 | −1.9+0.81×6.2 = 3.12 |
只看 2 步,也分出好坏了。AlphaGo 也用了这一招:搜不到终局,就用一个神经网络给局面估分。
这种"看几步、走一步、到了再重看"的做法,在控制领域叫模型预测控制(model predictive control,MPC),工厂、机器人、自动驾驶里都很常见。
每走一步都重看,还有一个好处:模型和真实环境有出入时(比如地板打滑,没挪过去),下一步会从真实到达的格子重新算,不会一错到底。
【档案】
1978 Jacques Richalet(里沙莱)等
法国 · ADERSA/GERBIOS
发表"模型预测启发式控制":用过程的模型预测未来,每一步重新规划。它用在了炼油厂催化裂化装置的分馏塔、PVC 工厂和一台 250 兆瓦电站的蒸汽发生器上。这一类做法后来统称模型预测控制。
蒙特卡洛树搜索
看的步数一多,走法会爆炸:走廊看 3 步是 23=8 种,看 10 步是 1024 种;围棋每步约 250 种下法,看 10 步约有 1024 种。只能挑着看。
蒙特卡洛树搜索 (Monte Carlo tree search,MCTS)就是挑有希望的路多看几眼。它把想过的局面记成一棵树,每个节点写两个数"赢的局数 / 下的局数":比如 2/3 表示从这个局面往下模拟了 3 局,赢了 2 局。然后把下面几步重复成千上万次:
- 选择:从当前局面出发,沿着树往下走,每一步挑"UCB 分"最高的那一支。UCB 分可以先理解成"胜率 + 照顾分":赢得多的分高,下得少的也照顾一下,公式在这几步后面讲;
- 扩展:走到树的边上,给树长出一个新节点;
- 模拟:从新节点开始,照着规则随手下到终局,看输赢。这就是上一篇的"跑回合",只是在脑子里跑;
- 回传:把输赢记回路上的每一个节点,改的是节点里的"赢的局数 / 下的局数";
- 更新:用新的数重新算各支的 UCB 分,下一轮再从第 1 步按新分数挑。教科书里常把这一步算进下一轮的"选择",所以一般说 MCTS 有四步。
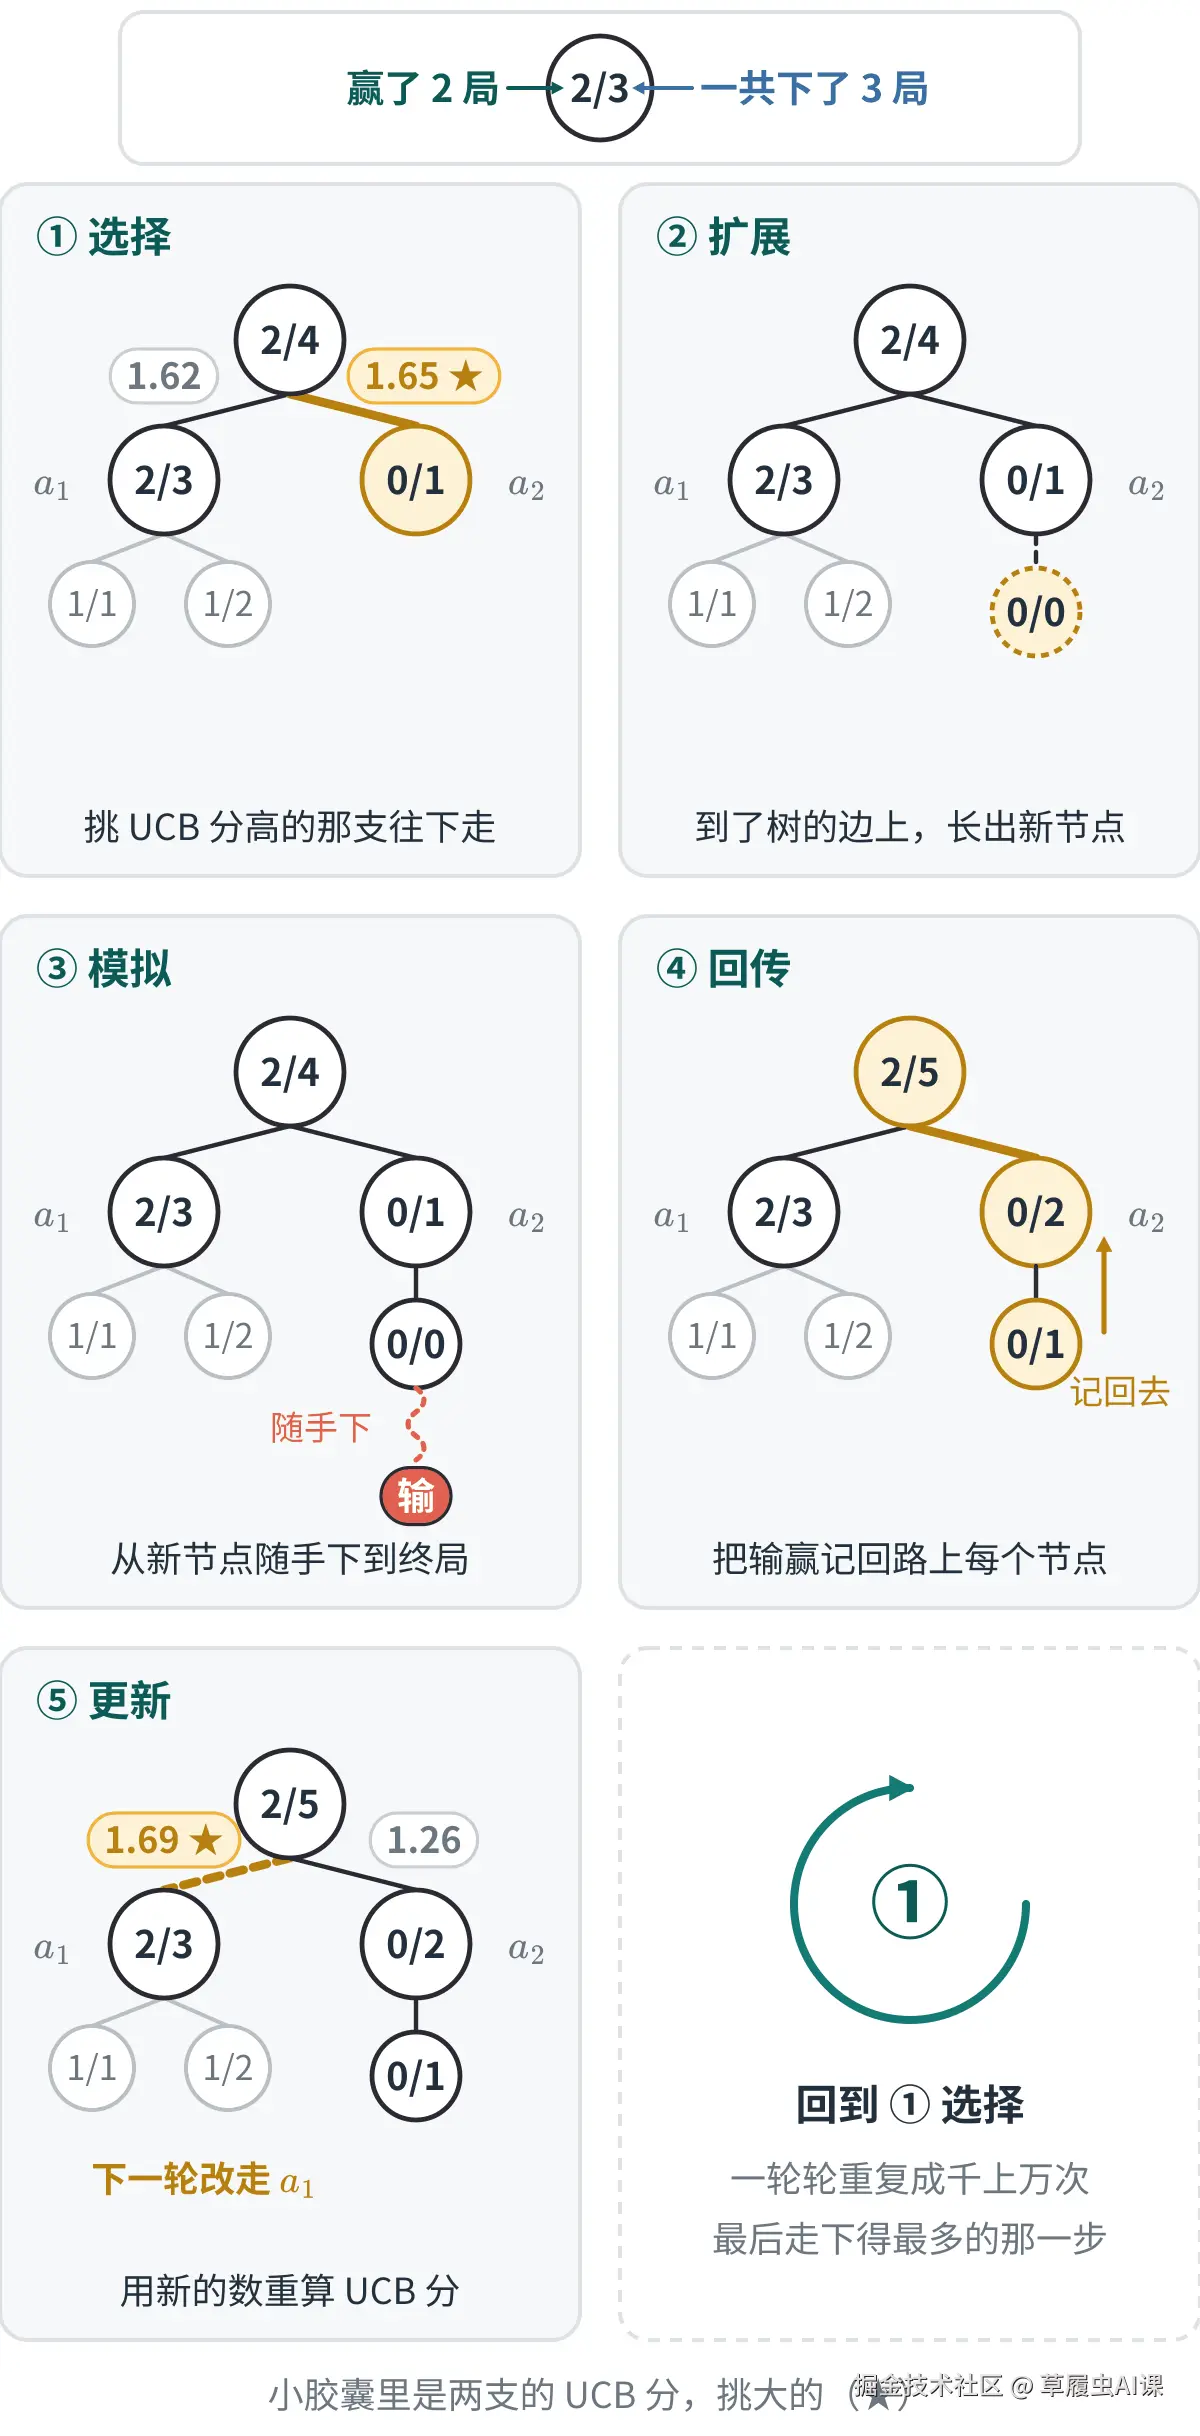
▲ 图 7 蒙特卡洛树搜索的一轮:节点里的数是"赢的局数 / 下的局数"
想够了,就选根节点下试得最多的那一步,真的走出去。
现在看第 1 步的 UCB 分。它要在"挑赢得多的"和"试试没怎么下过的"之间找平衡:
UCB=nw+cnlnN
w、 n 是这一支赢的局数、下的局数(就是节点里的两个数), N 是上一层一共下了几局, c 是一个常数,常取 1.4 左右。第一项是胜率,赢得多就高;第二项是"照顾分",下得越少越高,免得一步好棋因为开头运气差,就再也没人去试。
【例 4】该试哪一步
根节点下有两步棋: a1 下了 3 局、赢 2 局(节点上写 2/3); a2 只下了 1 局,输了(0/1)。一共下了 N=4 局,取 c=1.4:
a1a2: 32+1.43ln4 =0.667+0.952=1.618: 10+1.41ln4 =0+1.648=1.648
a2 的胜率是 0,可只下过 1 局,照顾分高,这次选它。假如 a2 又输了, N=5:
a1a2: 0.667+1.43ln5 =0.667+1.025=1.692: 20+1.42ln5 =0+1.256=1.256
a2 下了 2 局都输,照顾分降下来,下一次就选回 a1。下的局数越多,照顾分越小,最后主要看胜率。
蒙特卡洛树搜索要在脑子里一盘盘"随手下到终局",离不开规则。围棋的规则是完全清楚的,所以它属于基于模型的方法。
蒙特卡洛树搜索在强化学习系列里就讲到这儿,不再展开。今后的大模型(LLM)系列教程里还会再详细介绍它,感兴趣的话点个关注,不迷路~
【档案】
2006 Rémi Coulom(库隆)
法国 · 里尔第三大学
在论文里第一次提出"蒙特卡洛树搜索"这个名字,用在他的围棋程序 Crazy Stone 上。
2006 Levente Kocsis、Csaba Szepesvári
匈牙利 · 匈牙利科学院计算机与自动化研究所
把 UCB 公式用到搜索树的每一个节点上,提出 UCT 算法。本篇"胜率 + 照顾分"的挑法就来自这里。
2016 DeepMind 团队(AlphaGo)
英国 · 谷歌 DeepMind
AlphaGo 把蒙特卡洛树搜索和两个神经网络(一个选棋、一个估分)合在一起:2015 年 10 月以 5:0 战胜欧洲冠军樊麾,论文 2016 年 1 月发表在《自然》上;2016 年 3 月在首尔以 4:1 战胜李世石。
模型要自己学
前面几种方法,模型都是现成的。可大多数时候并没有现成的模型:机器人不知道地板有多滑,推荐系统不知道用户下一步会点什么。这时有两条路。
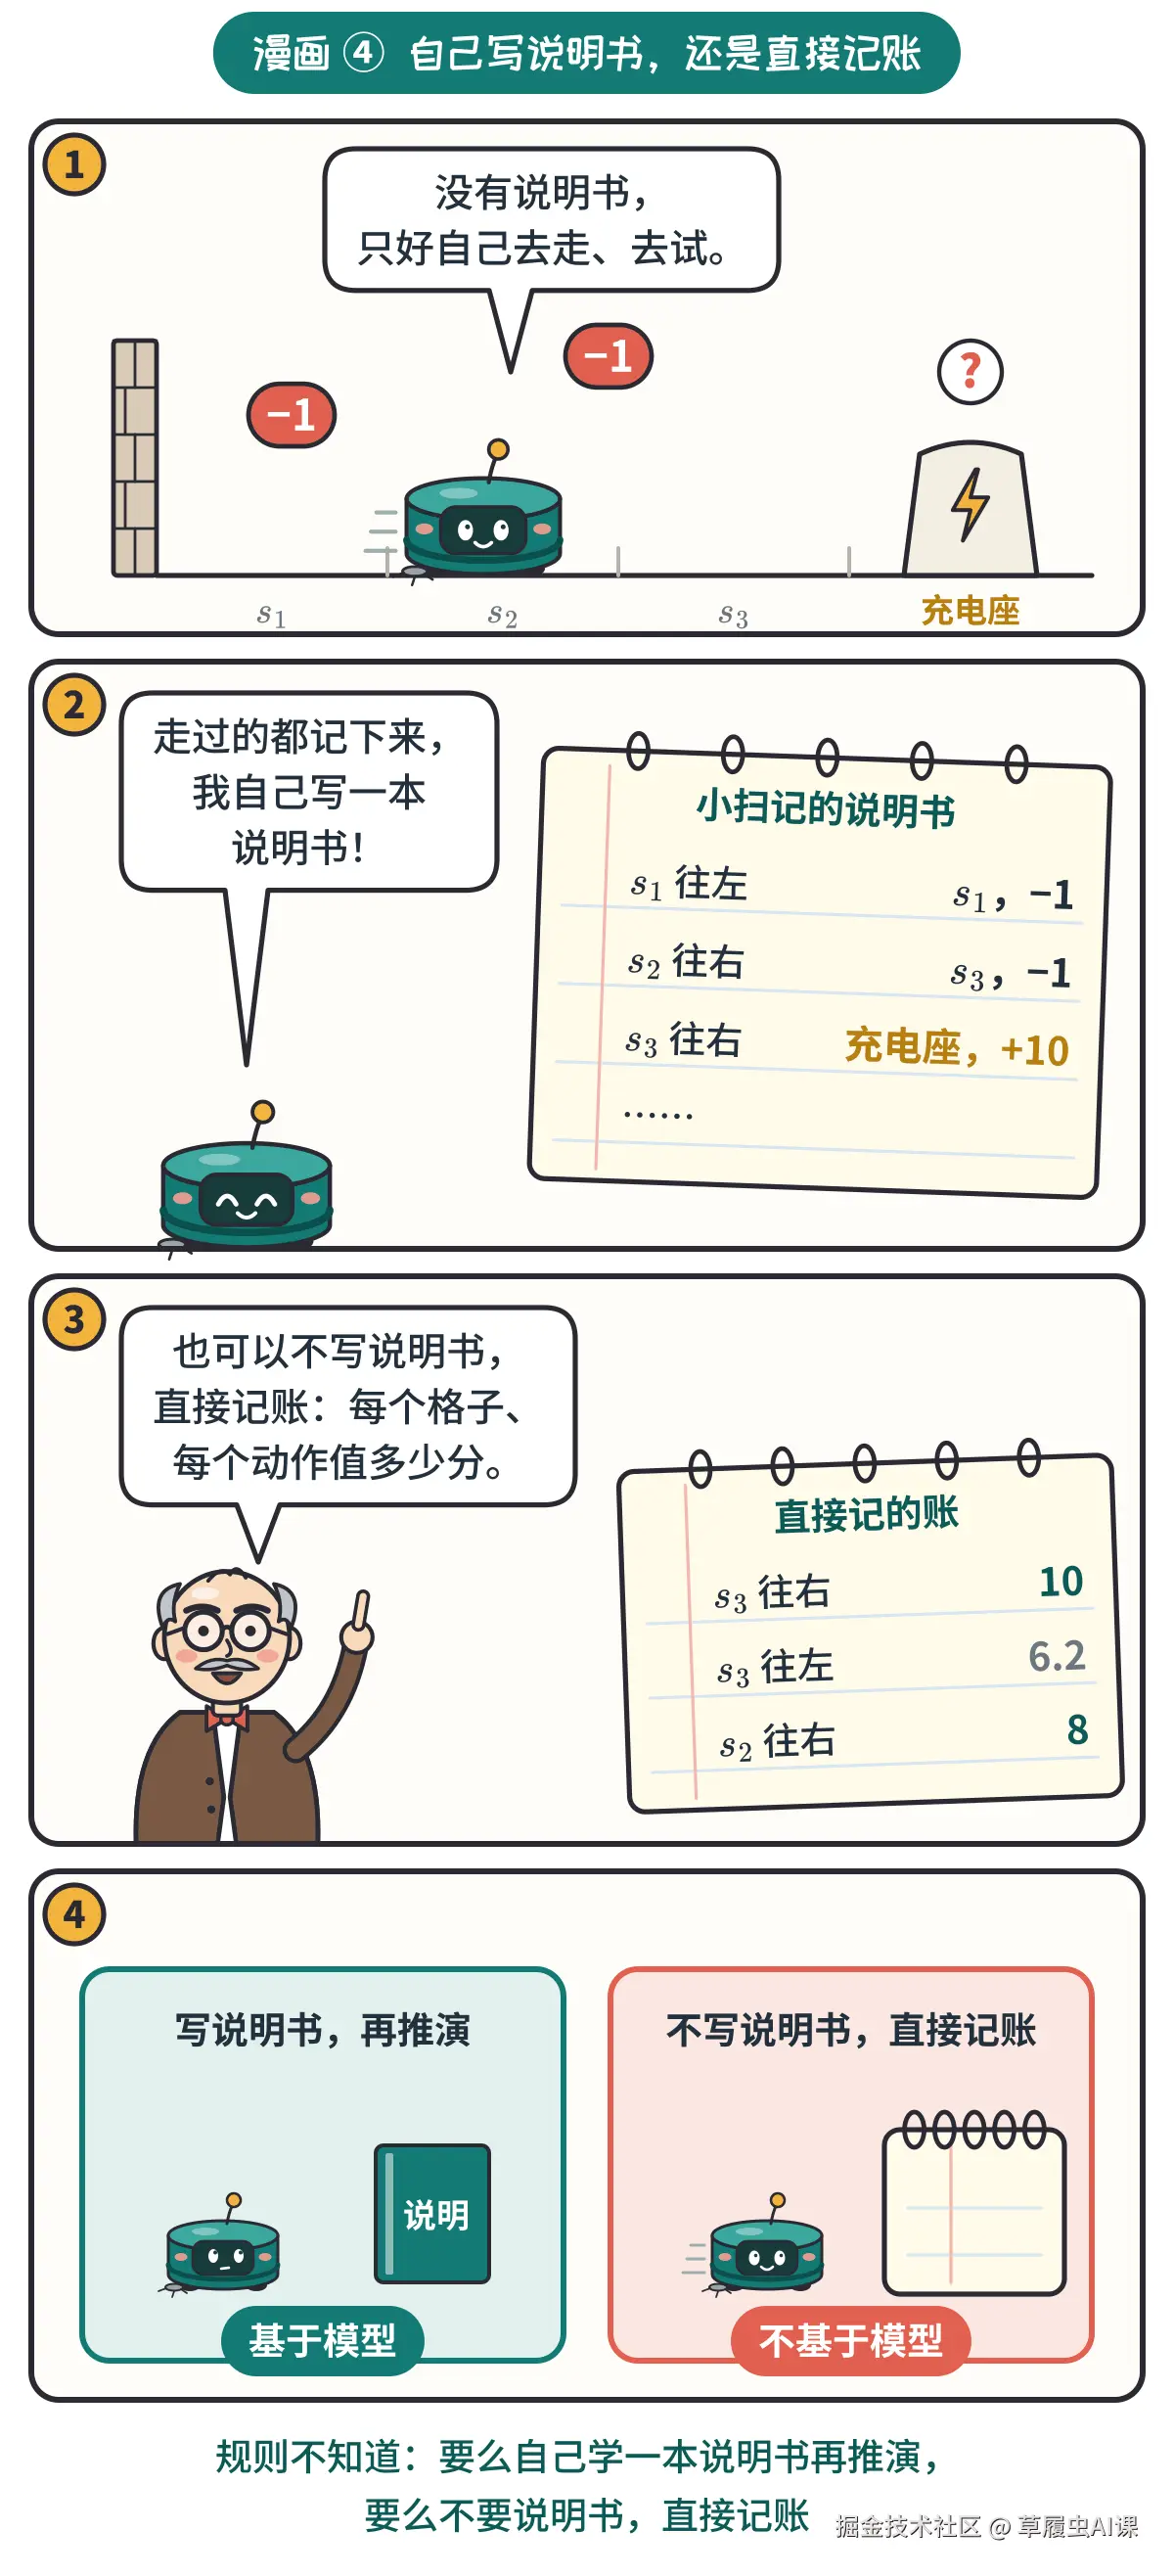
▲ 图 8 漫画 ④ 自己写说明书,还是直接记账
第一条路:从走过的经验里,把模型学 出来,再拿它去规划。模型虽然是学来的,用法和前面一样,所以这条路仍然属于基于模型。学法很朴素:记次数,算比例。
【例 5】从经验里学模型
地板会打滑。小扫在 s3 按了 10 次 →,记下每次的结果:8 次进了充电座(+10),2 次打滑留在原地(−1)。于是它估出:
p^(s4∣s3,→)p^(s3∣s3,→)=108=0.8=102=0.2
p 上面加个尖帽,表示这是估出来的。真实的转移概率正是 0.8(第 1 篇的滑地板),试的次数越多,估得越准。奖励也一样,记下每次拿了几分,取平均。
有了学来的模型,就能像前面那样,在脑子里规划。
【注意】模型学错了,算得再准也没用
假如小扫在 s3 只按了 2 次 →,碰巧两次都打滑(概率 0.2×0.2=0.04,25 次里大约有 1 次),它就会写下 p^(s4∣s3,→)=0:充电座永远进不去。
照这个模型规划,怎么走都拿不到 +10,每格的价值都是 −10,哪个动作都一样,最优策略就找不出来了。所以学模型的方法要提防模型误差:模型要边走边改,也不能全信。
学模型和规划,还可以和真实的尝试一起做 :每走一步,一边直接用这一步的经验更新价值或策略,一边用它改进模型,再拿模型在脑子里多推演几遍。这就是 Sutton 1990 年提出的 Dyna 框架。
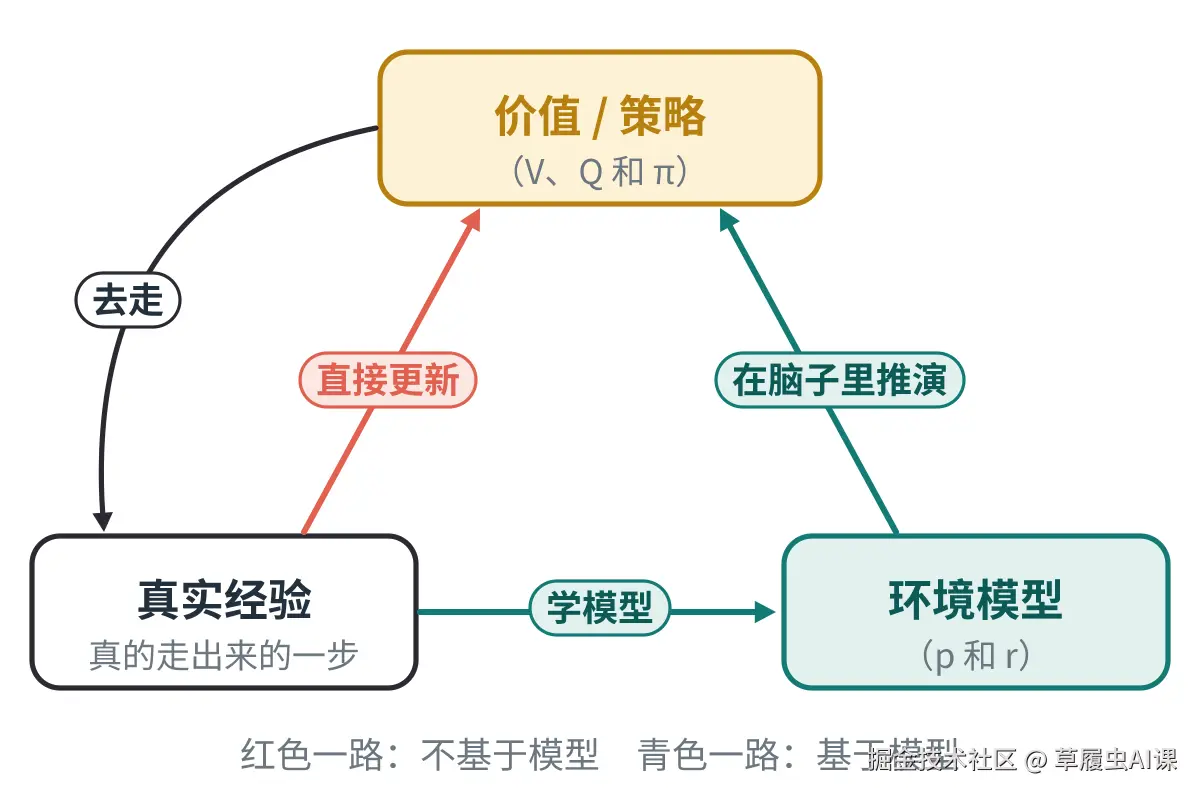
▲ 图 9 Dyna:真实的一步,既直接用来更新价值和策略,也用来学模型、在脑子里多推演几遍
【档案】
1990 Richard Sutton(萨顿)
美国 · GTE 实验室
提出 Dyna:从经验里学一个环境模型,再用它生成"想象的经验"来规划,把学习、规划、行动三件事放进一个框架。
四、不基于模型:直接从经验学
不用模型,直接学
第二条路(漫画④里老评说的"直接记账"):干脆不用模型,直接从经验里学价值或策略。上一篇例 2 就是这么做的:让小扫跑 1 万个回合、把回报取平均,从头到尾没用过 p。地图右半边的方法都属于这一类:
- 蒙特卡洛:跑完一整个回合,再拿回报取平均(上一篇例 2);
- 时序差分(TD):不等回合结束,走一步就用"奖励 + γ × 下一格的价值"更新一次,像在真实环境里用贝尔曼方程;
- Q-learning、Sarsa、DQN :直接学 Q,学好了每格挑 Q 最大的动作,用不着模型;
- 策略梯度、演员-评论家:直接调策略里每个动作的概率,好的动作调高,差的调低。
代价是要多试:有模型,可以在脑子里推演,省下真实的尝试;没有模型,每一点经验都得真的走出来。
这些不基于模型的方法,是这个系列的重头戏,后面会一个个详细介绍。
两类方法比一比
| 基于模型 | 不基于模型 | |
|---|---|---|
| 要什么 | 环境模型(现成的或学出来的) | 能和环境互动就行 |
| 用经验 | 学模型,再在脑子里推演 | 直接更新价值或策略 |
| 好处 | 推演不花真实尝试,试得少 | 不怕模型学错,简单通用 |
| 难处 | 模型难得,写错了就算错 | 要大量真实尝试 |
| 例子 | 动态规划、MCTS、MPC、Dyna | 蒙特卡洛、TD、Q-learning、PPO |
两类方法并不对立。AlphaGo 用蒙特卡洛树搜索在脑子里推演,又用神经网络从棋谱和自我对弈里学估分、学选棋;Dyna 也是两条路一起走。
五、小结
| 概念 | 一句话 | 走廊里 |
|---|---|---|
| 环境模型 | 环境的规则:会到哪( p)、得几分( r) | 6 行的表 |
| 基于模型 | 用模型在脑子里推演 | 策略迭代、价值迭代 |
| 不基于模型 | 不用模型,直接从经验里学 | 跑 1 万回合取平均 |
| 策略迭代 | 评估 → 改进,转到策略不再变 | ←←← 改 3 次到 →→→ |
| 价值迭代 | 反复用最优方程更新,再挑动作 | 从 0 开始,3 遍得 6.2、8、10 |
| 向前看几步 | 只为眼前做规划:看几步、走一步 | 看 3 步才分出好坏 |
| MCTS | 挑有希望的路多看几眼 | UCB = 胜率 + 照顾分 |
一句话串起来:环境模型 就是环境的规则;有模型,就能在脑子里规划 ,用动态规划算遍所有格子,或者只为眼前向前看几步 ;没有模型,要么自己学一个 ,要么直接从经验里学价值或策略。
附一 动手算一算
下面的 Python 代码只用到标准库,把本篇的三个例子算一遍:价值迭代、向前看几步、UCB 分。函数 step 就是例 1 的环境模型。
python
from itertools import product
from math import log, sqrt

GAMMA = 0.9
S = (1, 2, 3)
A = (-1, 1)  # 往左、往右

def step(s, a):
    """环境模型:a=+1 往右,a=-1 往左"""
    if s == 3 and a == 1:
        return 4, 10  # 进充电座
    return max(1, s + a), -1

def Q(V, s, a):
    """查模型走一步,再加 γ × 下一格"""
    s2, r = step(s, a)
    return r + GAMMA * V[s2]

def show(V):
    return [round(V[s], 2) for s in S]

def name(acts):
    return "".join("→" if a > 0 else "←"
                   for a in acts)

# ---- 价值迭代:从 0 开始
V = {1: 0, 2: 0, 3: 0, 4: 0}
for k in range(1, 5):
    new = dict(V)
    for s in S:
        new[s] = max(Q(V, s, a)
                     for a in A)
    V = new
    print(k, show(V))
# 3 [6.2, 8.0, 10.0],第 4 遍不再变

# ---- 从 s1 向前看 h 步
def rollout(s, acts):
    """照模型走一串动作,算回报"""
    G = 0
    for t, a in enumerate(acts):
        s, r = step(s, a)
        G += GAMMA ** t * r
        if s == 4:
            break
    return G

for h in (1, 2, 3):
    for acts in product(A, repeat=h):
        G = round(rollout(1, acts), 2)
        print(h, name(acts), G)
# 看 3 步:只有 →→→ 是 6.2

# ---- UCB:胜率 + 照顾分
def ucb(w, n, N, c=1.4):
    return w / n + c * sqrt(log(N) / n)

print(round(ucb(2, 3, 4), 3))  # 1.618
print(round(ucb(0, 1, 4), 3))  # 1.648
附二 参考文献
- Richalet J, Rault A, Testud J L, Papon J. Model predictive heuristic control: Applications to industrial processes. Automatica, 1978, 14: 413--428.
- Sutton R S. Integrated architectures for learning, planning, and reacting based on approximating dynamic programming. Proceedings of the 7th International Conference on Machine Learning (ICML), 1990: 216--224.
- Auer P, Cesa-Bianchi N, Fischer P. Finite-time analysis of the multiarmed bandit problem. Machine Learning, 2002, 47: 235--256.
- Coulom R. Efficient selectivity and backup operators in Monte-Carlo tree search. Computers and Games (CG 2006), Springer, 2007: 72--83.
- Kocsis L, Szepesvári C. Bandit based Monte-Carlo planning. European Conference on Machine Learning (ECML 2006), Springer, 2006: 282--293.
- Silver D, Huang A, Maddison C J, et al. Mastering the game of Go with deep neural networks and tree search. Nature, 2016, 529: 484--489.
- Sutton R S, Barto A G. Reinforcement Learning: An Introduction (2nd ed.). MIT Press, 2018.
【下期预告】动态规划
本篇用策略迭代、价值迭代在走廊里找到了最优策略,只是点到为止。
下一篇细讲动态规划:策略迭代和价值迭代具体怎么做,为什么能找到最优策略。
【关注】谢谢你看到这里这个系列会一直更新下去。关注我,新文章一发布就会出现在你的关注动态里,不会错过后面的内容。
也可以收藏本系列专栏,全部文章按顺序排在一起,随时回看。
感谢关注和支持!有问题也欢迎在评论区聊聊~
------ 强化学习从零到一 · 第 3 篇 · 完 ------