别再死磕提示词了:Anthropic 说,AI Agent 真正的胜负手是"上下文工程"
你有没有遇到过这种情况?
跟 AI 聊到第 50 轮,它开始忘记你前面说过的要求。让 Agent 跑一个长任务,做到一半,它开始重复劳动,甚至答非所问。
很多人的第一反应是:提示词写得不够好。
于是反复改提示词、加规则、加例子。
但 Anthropic 在一篇研究文章里给出了另一个答案:问题可能不在"说什么",而在模型此刻"看到了什么"。
这就是最近很火的概念------上下文工程(Context Engineering)。
这篇文章,我把 Anthropic 的这篇研究,和他们配套的 Cookbook 实战案例,一起拆给你看。
一、从提示词工程,到上下文工程
先说结论:Anthropic 把上下文工程看作提示词工程的自然演进。
›
提示词工程:研究怎么写、怎么组织指令,尤其是系统提示词。
›
上下文工程 :研究怎么在推理过程中,挑选并维护那组最优的 token。
这里的"上下文",指的是采样时放进模型的全部 token。
不只有你写的提示词,还包括:
›
系统指令
›
工具(Tools)
›
MCP
›
外部数据
›
消息历史
早期用大模型,多是一次性的分类、生成任务,写好提示词就够了。
但 Agent 不一样。它在循环里跑:每一轮都会产生新数据,这些数据下一轮可能有用,也可能没用。
所以上下文工程的本质,是从这个不断膨胀的信息宇宙里,挑出能放进有限窗口的那一小部分。
文章里有个很准的定义:现在的问题变成了------
"什么样的上下文配置,最可能让模型产生我们想要的行为?"
二、为什么上下文越多,反而越糟?
直觉上,窗口越大越好。
但 Anthropic 指出一个现象:上下文腐烂(context rot)。
随着窗口里的 token 增多,模型准确回忆其中信息的能力会下降。有的模型下降得温和些,但这个现象在所有模型上都存在。
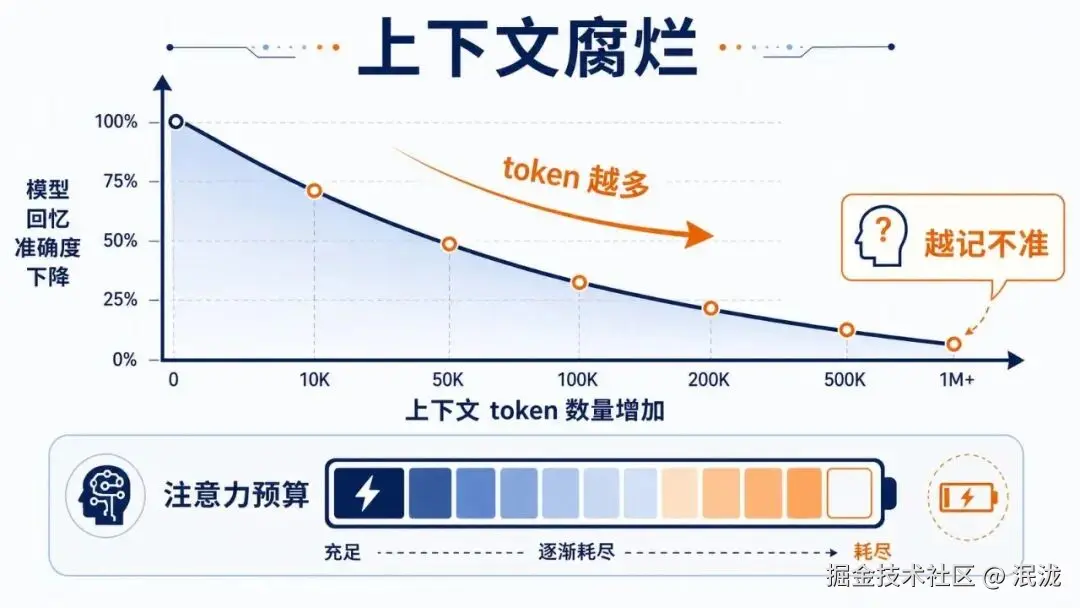
因此,上下文必须被当作一种"边际收益递减的有限资源"。
文章用了一个很形象的比喻:注意力预算。
就像人的工作记忆有限,LLM 解析大量上下文时也要消耗预算。每多一个 token,预算就被消耗一点。
原因来自 Transformer 架构:每个 token 都要和其他所有 token 建立关联,n 个 token 就有 n² 组两两关系。上下文一长,注意力就被"摊薄"了。
再加上训练数据里短序列更常见,模型对超长依赖的经验也更少。
但请注意,这不是一道"悬崖",而是一个性能渐变的坡:长上下文下模型依然很强,只是检索精度和长程推理会打折扣。
所以 Anthropic 给出的指导原则很简洁:
找到最小的一组高信号 token,让期望结果出现的可能性最大化。
三、好的上下文长什么样?
文章分别拆了几个组成部分。
→1. 系统提示词:找到"合适的高度"
两种常见的失败方式:
›
太死板:在提示词里硬编码复杂、脆弱的逻辑,维护成本越来越高。
›
太模糊:只给空泛的高层指引,没有具体信号,还默认模型"懂你的背景"。
最佳状态是中间的"金发姑娘区":足够具体以引导行为,又足够灵活以提供强启发。
另外两个提醒:
›
用 XML 标签或 Markdown 标题把提示词分区,但格式本身会随着模型变强而越来越不重要。
›
"最小"不等于"短"。该给的信息要给够。
建议的做法:先用最好的模型测试一个最简提示词,再根据发现的失败模式逐步补充指令和例子。
→2. 工具:别搞"大杂烩"
工具是 Agent 与环境之间的契约。
最常见的失败,就是工具集臃肿,功能重叠,让人(和模型)不知道该选哪个。
文章里有句话很扎心:
如果人类工程师都说不清某种情况该用哪个工具,就别指望 AI Agent 能做得更好。
好的工具应当自包含、容错、用途清晰,返回的信息要节省 token。
→3. 示例:要"经典",别"穷举"
少样本提示依然值得推荐。
但不要把一长串边缘情况全塞进去。更好的做法是挑一组多样且有代表性的经典示例。
对 LLM 来说,示例就是"一图胜千言"里的那张图。
四、让 Agent 自己去"找"信息:即时检索
Anthropic 现在对 Agent 的定义很简单:LLM 在循环中自主使用工具。
传统做法是推理前用 embedding 检索,把相关内容预先塞进上下文。
现在越来越多团队加入"即时(just-in-time)"策略:
不预先加载所有数据,只保留轻量级的引用(文件路径、已存储的查询、网页链接),需要时再用工具动态加载。
Claude Code 就是这样处理大型数据库分析的:写有针对性的查询、保存结果、用 head、tail 等命令,从不把完整数据对象装进上下文。
这和人类很像。我们不会背下整个图书馆,而是依赖文件系统、收件箱、书签来按需查找。
引用本身的元数据也是信号:
›
tests 文件夹里的 test_utils.py,和 src/core_logic/ 里的同名文件,含义完全不同。
›
文件大小暗示复杂度,命名暗示用途,时间戳暗示相关性。
这带来了渐进式披露:Agent 逐层探索,只把必要的东西留在工作记忆里。
当然也有代价:运行时探索比预先检索更慢,而且需要精心设计,否则 Agent 可能误用工具、钻死胡同。
所以很多场景适合混合策略:
Claude Code 会把 CLAUDE.md 直接放进上下文以求速度,同时用 glob、grep 实现按需检索。法律、金融这类动态内容较少的场景,混合策略可能更合适。
Anthropic 的建议依然是那句:"do the simplest thing that works"(做最简单有效的事)。
五、长任务怎么办?三个杀手锏
当任务持续几十分钟甚至数小时(比如大型代码库迁移、综合性研究),token 总量必然超过窗口。
等更大的窗口行不行?Anthropic 认为不行:至少在可预见的未来,任何尺寸的窗口都会面临上下文污染和相关性问题。
于是他们总结了三种技术:
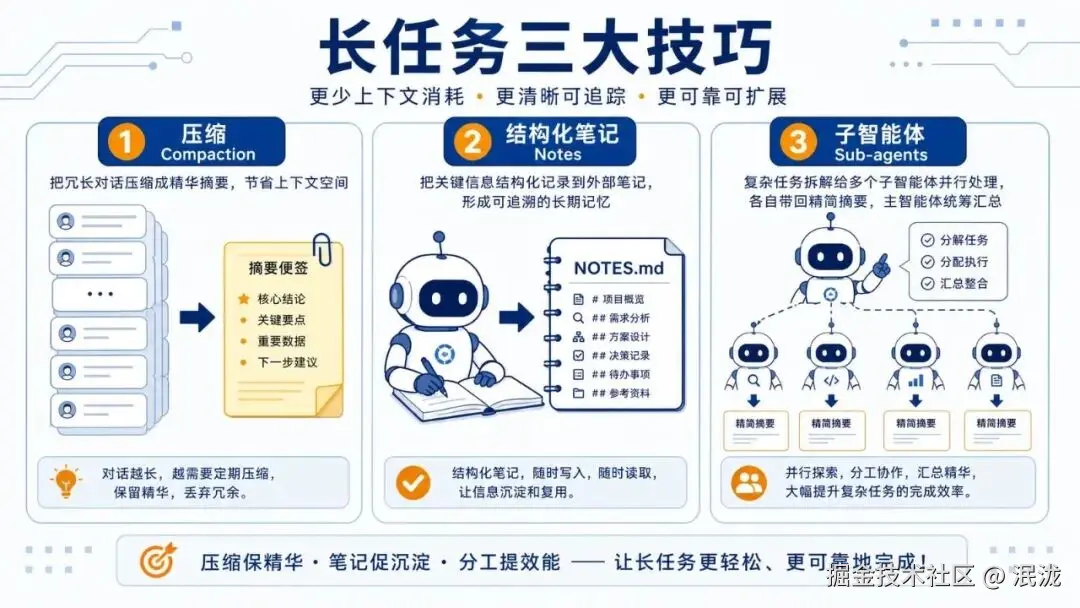
→技巧 1:压缩(Compaction)
当对话接近窗口上限时,总结内容,用摘要开启一个新窗口。
在 Claude Code 里,做法是让模型总结关键细节:保留架构决策、未解决的 bug、实现细节,丢弃冗余的工具输出,再加上最近访问的 5 个文件继续工作。
压缩的艺术在于取舍:压得太狠,可能丢掉当下看不出、之后才发现很关键的细节。
文章给工程师的建议是:
先最大化召回,确保压缩提示词覆盖所有相关信息;
再迭代提高精确度,删掉多余内容。
最安全、最轻量的压缩方式之一,是清理工具调用结果:一个工具在历史深处被调用过,Agent 为什么还需要再看一遍原始结果?这项能力已在 Claude 开发者平台上线。
→技巧 2:结构化笔记(Agentic Memory)
让 Agent 定期把笔记写到上下文窗口之外,需要时再读回来。
就像 Claude Code 列待办清单,或自定义 Agent 维护一个 NOTES.md。
文章举了个有趣的例子:Claude 玩《宝可梦》。
它能在数千步里精确记账,比如"过去 1,234 步我一直在 1 号道路训练,皮卡丘已经提升了 8 级,目标是 10 级"。没有任何关于记忆结构的提示,它自己就画出了已探索区域的地图,记下了解锁的成就和战斗策略。
上下文重置后,它读自己的笔记,继续数小时的训练或探险。
配合 Sonnet 4.5 发布,Anthropic 还推出了文件式的记忆工具(公开测试版)。
→技巧 3:子智能体架构(Sub-agents)
主 Agent 负责高层规划,专门的子 Agent 在干净的上下文里处理聚焦任务。
每个子 Agent 可能探索用掉几万 token 甚至更多,但只返回一份精炼的摘要,通常是 1,000--2,000 token。
详细的搜索上下文被隔离在子 Agent 内部,主 Agent 专心做综合分析。在复杂研究任务上,这种模式比单 Agent 有显著提升。
六、实战:5 个工单,Token 消耗差了多少?
理论讲完,看 Cookbook 里的真实案例。
场景是一个客服 Agent 处理一队工单。每张工单要走 7 步:
取工单 → 分类 → 查知识库 → 设优先级 → 转派团队 → 起草回复 → 标记完成
5 张工单,就是 35 次以上的工具调用。
→不压缩会怎样?
每一轮,整个历史(包括之前所有工具结果)都要重新发给模型。
结果是线性增长:
›
共 37 轮
›
输入 token:204,416
›
输出 token:4,422
›
总计:208,838
›
最后一轮单次输入已涨到 9,475
处理第 5 张工单时,上下文里还背着前 4 张工单的全部细节。
→开启自动压缩呢?
只需要在工具运行器里加一个 compaction_control 参数。这里阈值设为 5,000 token。
机制是:
监控每轮的 token 用量;
超过阈值,注入一条总结请求;
模型生成包裹在 <summary></summary> 标签里的摘要;
清空历史,只带着摘要继续。
实际发生了 2 次压缩:第一次消息数从 31 条降为 1 条,第二次从 15 条降为 1 条。
›
共 26 轮
›
输入 token:82,171
›
输出 token:4,275
›
总计:86,446
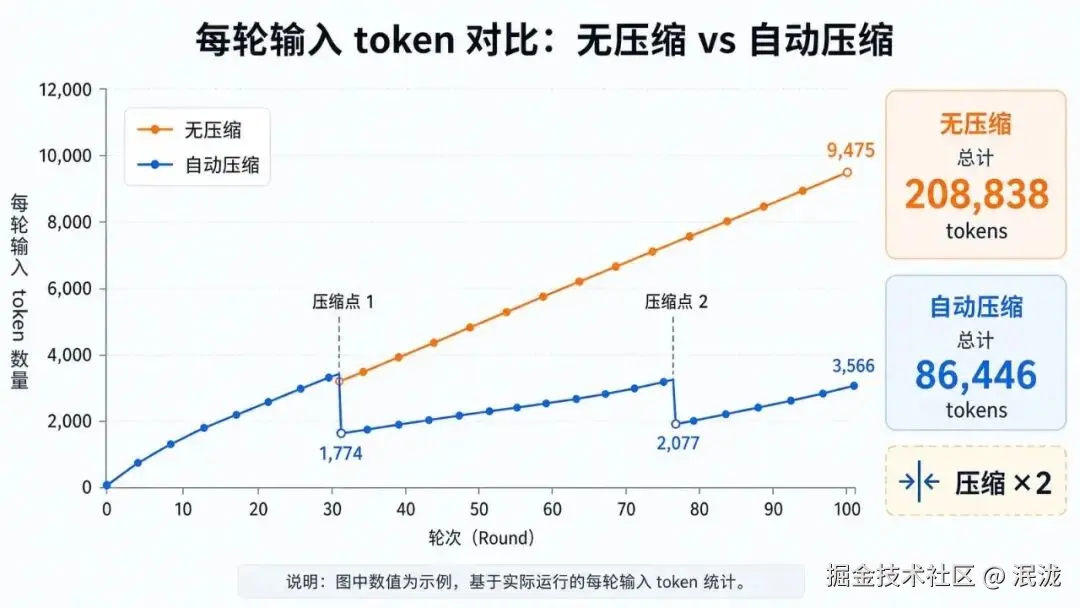
总消耗从 208,838 降到 86,446,减少约 59%。(这是我根据文中总数算出的比例。)
而且质量没掉:5 张工单依然全部完成分类、定优先级、转派并起草回复。
摘要里保留了每张工单的客户、问题、类别、优先级、团队、状态,还有"已学到的知识库信息"和"下一步"。
这很像真实的客服:处理完一单,简要登记,关掉,下一单。 你不会一直开着每篇知识库文章和完整回复草稿。
小提醒:Cookbook 正文里有一处写"只用了 79,000 tokens",与其给出的统计表(总计 86,446)不一致。本文以统计表里的数字为准。
七、怎么配置?什么时候别用?
→可调的关键点
›
阈值:不要设得太低,否则摘要本身就可能再次触发压缩。演示用 5,000 只是为了看效果,实际要多试。
›
摘要模型:可以用更快更便宜的模型来生成摘要。
›
自定义摘要提示词:告诉模型必须保留哪些信息。
›
没有工具的聊天应用:同样的原则,需要自己实现:统计 token → 超阈值请求摘要 → 用摘要替换历史 → 继续对话。
另外,如果你用的是 Claude Opus 5.5 或 Sonnet 5.5,Cookbook 推荐直接用服务端压缩,无需 SDK 层配置。本文介绍的 SDK 方式,适合不支持服务端压缩的模型,或想用另一个更便宜模型做摘要的情况。
→适合压缩的场景
›
逐项顺序处理(像工单)
›
多阶段工作流,每阶段可先总结再推进
›
分块处理大数据集
›
长时间的分析会话
›
每项相互独立的批量操作
→不适合压缩的场景
›
短任务:50k--100k token 内就能完成,压缩只是额外开销
›
需要完整审计留痕的任务
›
每步都严重依赖之前全部细节的高度迭代任务
›
服务端采样循环(如服务端网页搜索工具):缓存 token 会累积,可能基于缓存内容而非真实对话历史提前触发压缩
还要记住一点:摘要必然有损。 对工单这类场景通常可以接受,但要有意识。
八、给你的 5 条行动清单
把两篇文章合起来,可以这样落地:
先问自己: 此刻放进窗口的,哪些是高信号,哪些是噪音?
精简工具集: 能合并就合并,让"该用哪个"一目了然。
用经典示例代替规则清单。
让 Agent 保留引用,而不是堆满原文, 需要时再加载。
长任务先找"天然压缩点": 每处理完一项、每完成一个阶段就总结一次;阈值从 5k--10k 起试,看触发时机,检查质量,再调整。
写在最后
Anthropic 的结论很朴素:
即使模型越来越强,把上下文当作珍贵而有限的资源,依然是构建可靠 Agent 的核心。
更聪明的模型,需要的"手把手"规定更少。但每一步让什么信息进入模型有限的注意力预算,这件事不会过时。
下次你的 Agent "变笨"了,先别急着改提示词。
先看看它的上下文里,塞了多少不该塞的东西。
互动一下: 你在做 Agent 或长对话应用时,踩过哪些"上下文爆炸"的坑?欢迎留言聊聊。觉得有用,点个"在看"转给做 AI 的朋友吧。
资料来源:
›
*Anthropic:*Effective context engineering for AI agents
›
*Claude Cookbook:*Automatic context compaction