最近一周有三个案例,都在让 coding agent 跑完一整段工程流程,而不只是写一段代码。它们回答的是同一个问题:哪些事交给 agent,人在哪一步介入。
- Anthropic 用一个 Claude Code 会话在预发环境连续压测两周。Claude Docs 上线后,20 亿次请求只出了 60 个服务器错误,没有回滚过。
- OpenAI 的 Performance Factory 在三个多月里自动做了 1,700 多次性能退化排查,平均每天 17 次,找到了 600 多个根因。
- 腾讯开源的 LoopForge 把需求交付拆成由 agent、脚本和人工介入节点组成的 SOP,本周在 GitHub Go 语言周榜涨了 4,716 星。
本文依次拆解三个案例里 agent 做哪些事、人做哪些事、两者在哪里交接,最后对比三者,并给出给自己的流程分工的做法。
三套做法的触发方式和规模差别很大,分工却一致:
- 人的工作集中在开跑前和交接点。 开跑前,人写下完成标准、需要批准的决定和 agent 的权限。运行中,人不盯每一步,只在 agent 停下来交接时做决定。
- 能撤销的事 agent 自己做,不可逆的那一步留给人。 Anthropic 让 Claude 把修复直接部署到预发环境,改数据库 schema 要先问人;OpenAI 的 agent 从找根因一直做到开 PR,合入和部署归工程师;LoopForge 发起 MR 的节点被禁止合并。
三者的分歧在任务状态放在哪里。Anthropic 让一个会话连续跑两周,依赖模型在多次上下文压缩之后仍然记得目标。OpenAI 和 LoopForge 把状态写进任务记录或产物文件,每一步起一个新的 agent,人随时可以接手,agent 也能在人处理完之后接着做。大多数团队照搬的应该是后一种。
三个案例概览
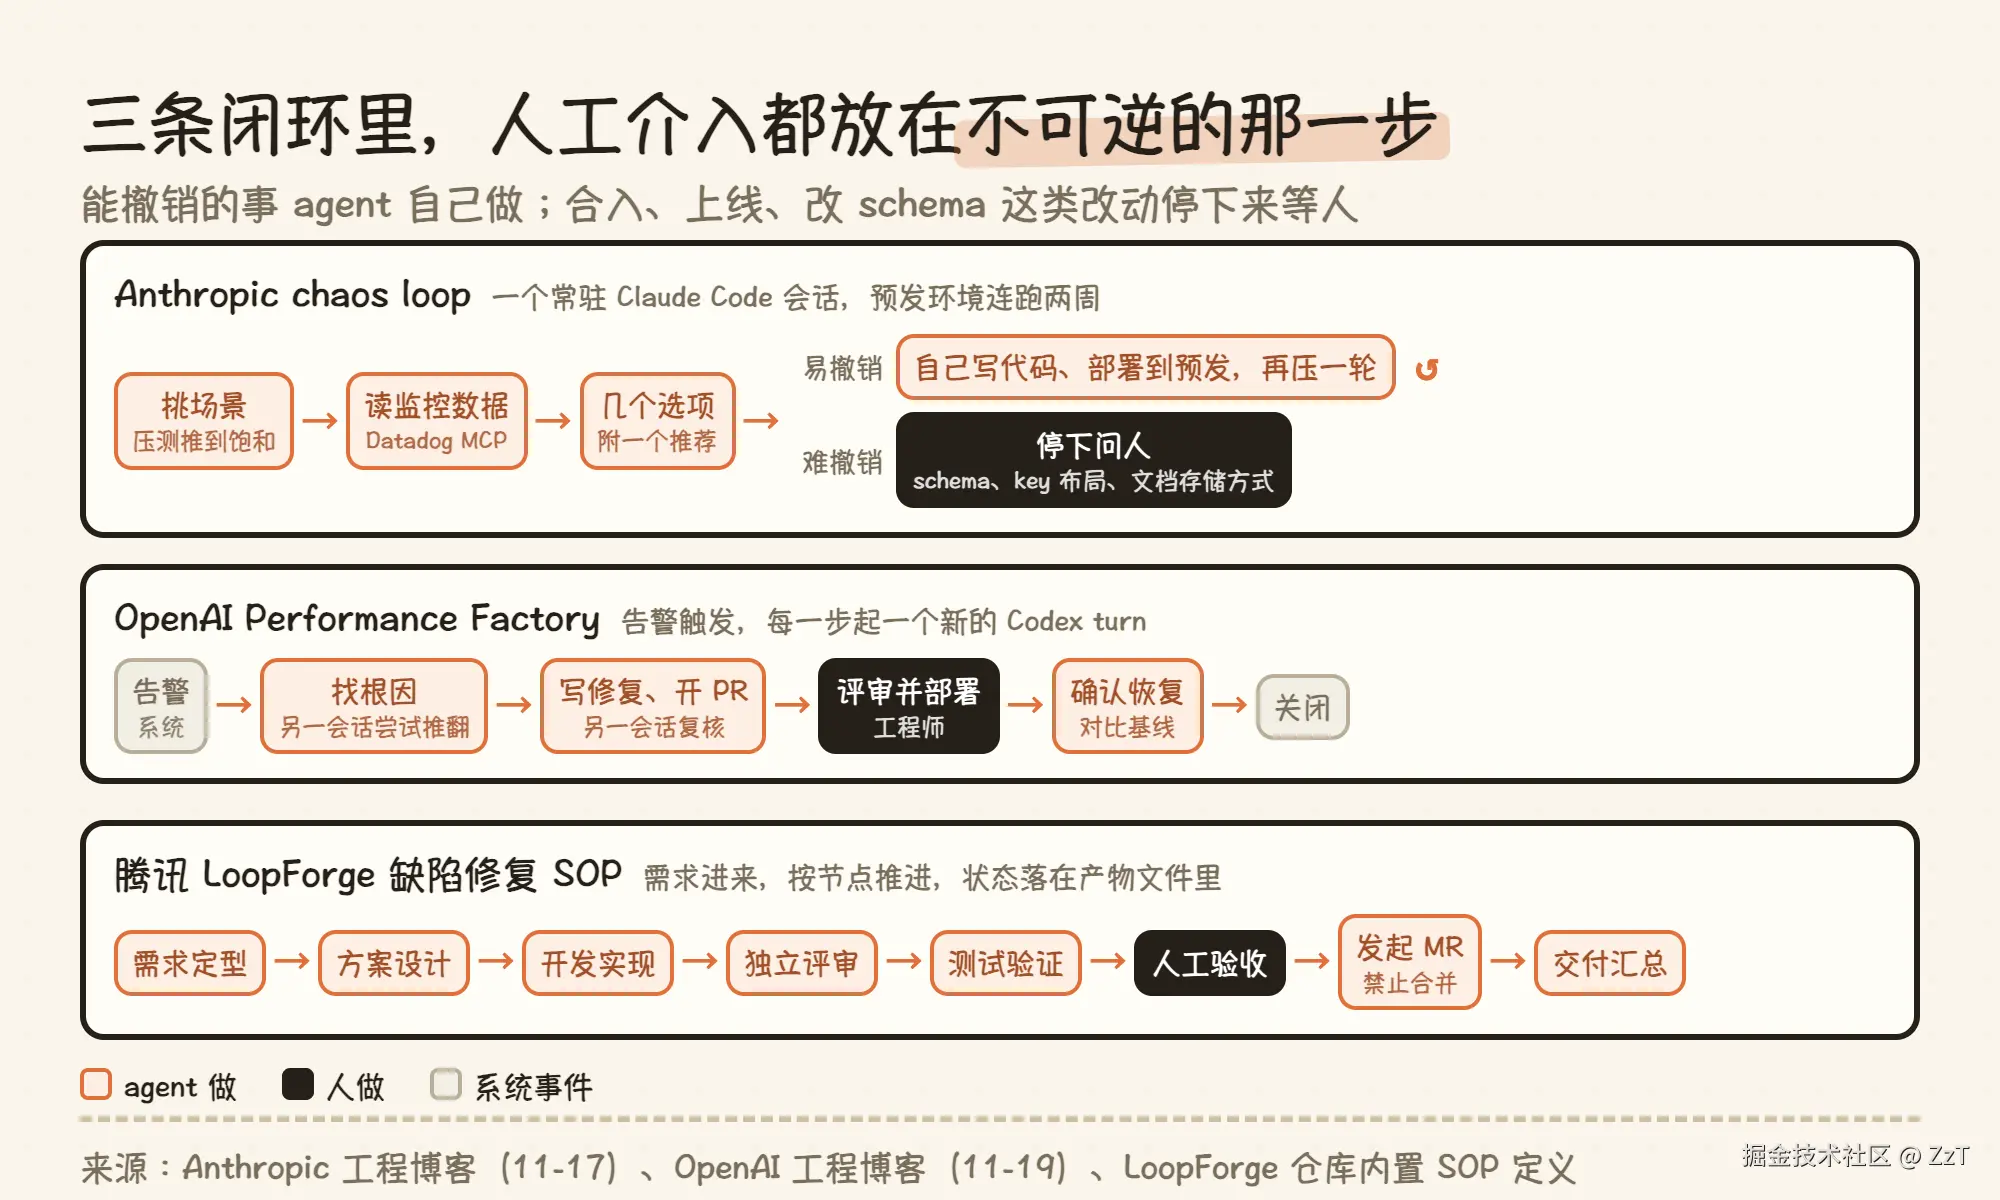
三个案例解决的问题不同:
- chaos loop 是一次性的上线前加固。一名工程师带着 Claude Code,在两周里把一个新服务压到上线规模。
- Performance Factory 是常驻系统。性能告警一触发就开任务,agent 一路做到上线后确认指标恢复。
- LoopForge 是团队工作台。需求进来后按 SOP 走完方案、实现、评审、测试和验收,最后提交 PR。
前两个是公司内部系统,只能读它们的工程博客。LoopForge 是开源代码,下文关于它的机制都来自源码和仓库文档。
Anthropic 的 chaos loop
Claude Docs 是 Anthropic 9 月 16 日上线的文档编辑器,人和任意一个 Claude 会话可以同时读写同一份文档。上线前三周,它还是单节点上的概念验证版本,只有几千名内部用户。团队自己的估计是上线头几天就会有几百万份文档。
循环结构
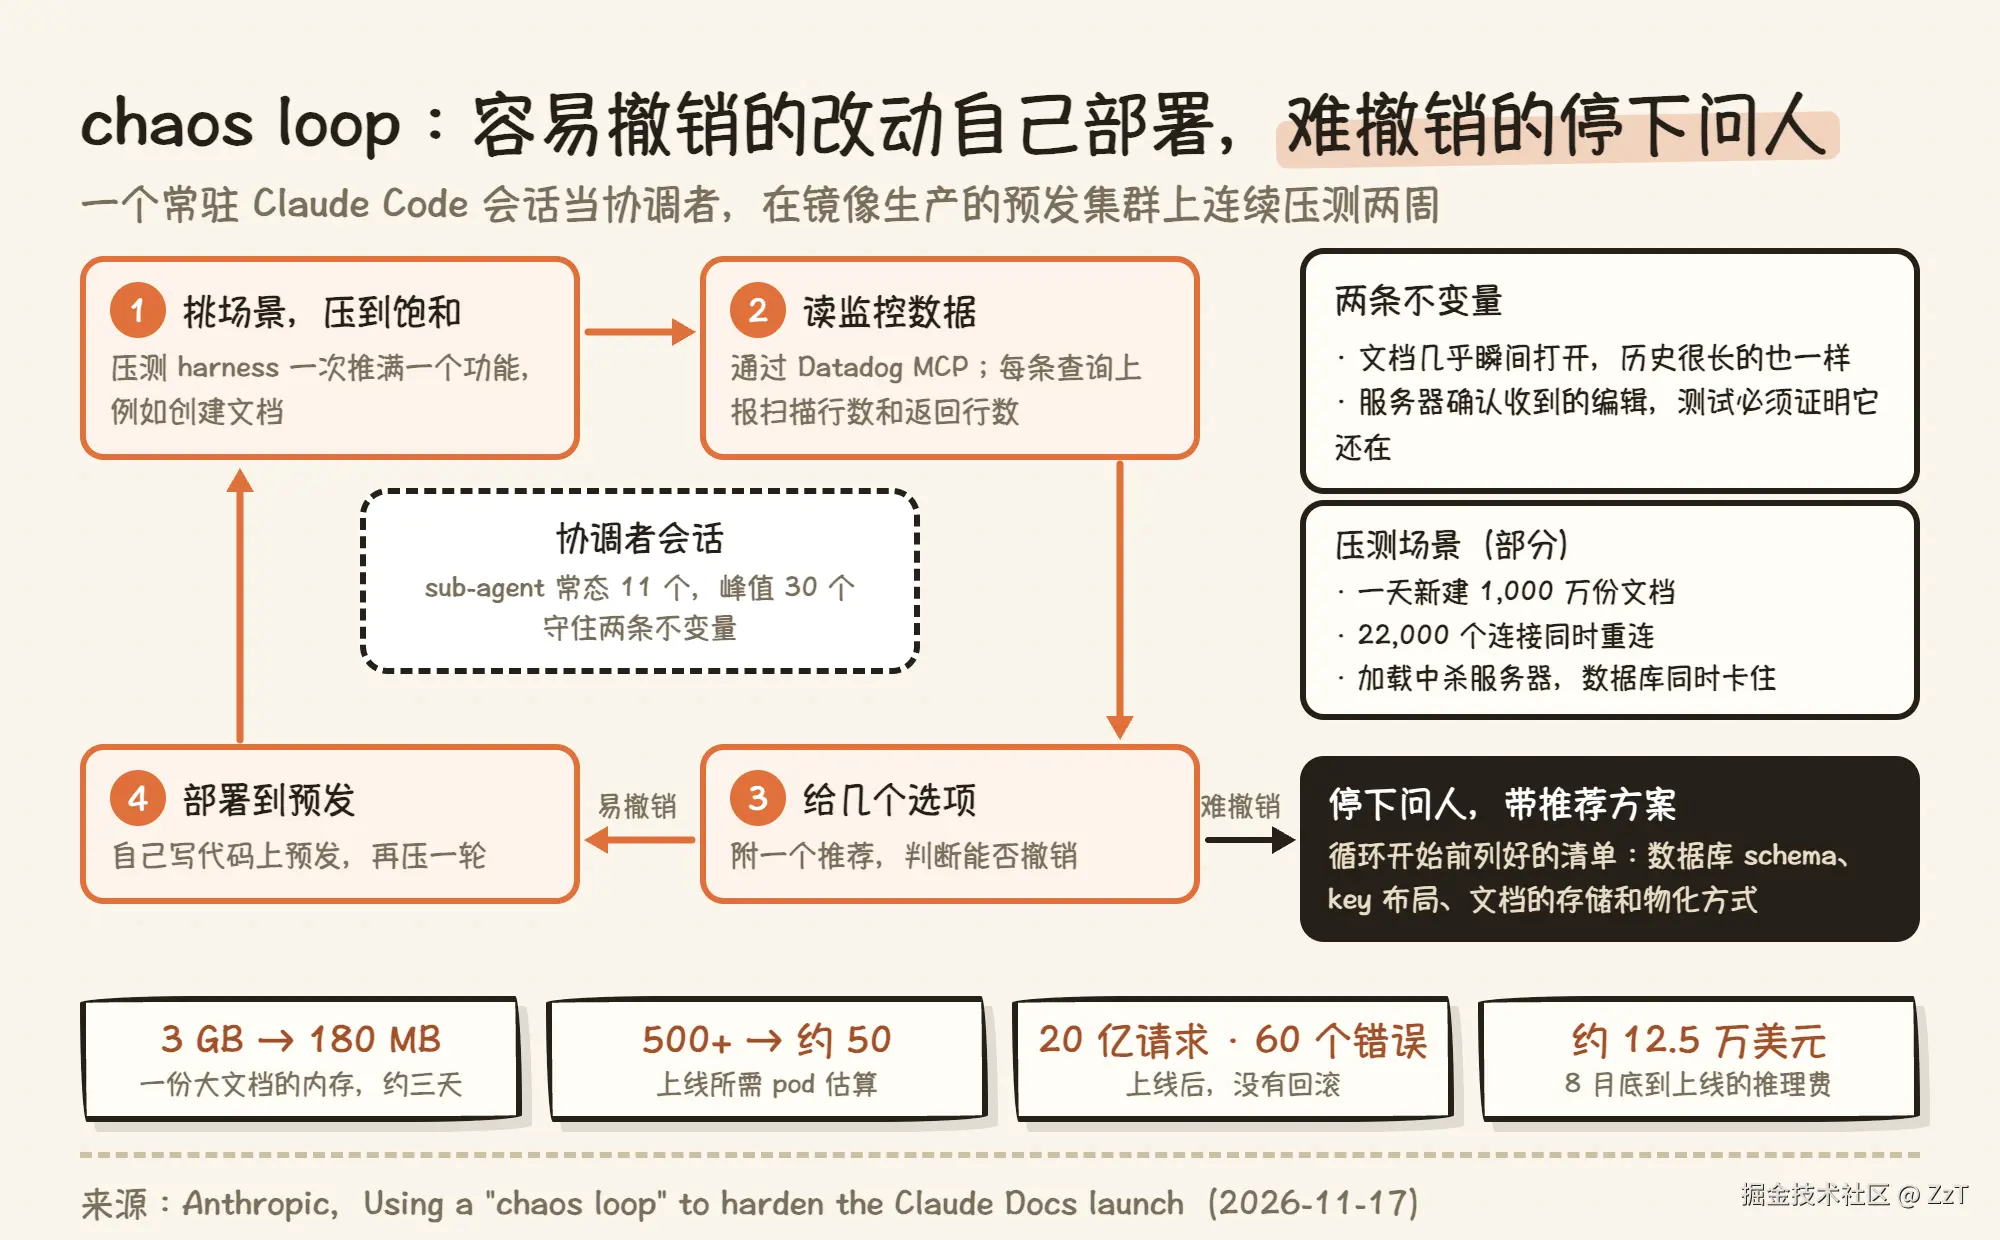
9 月 4 日,也就是上线前大约两周,工程师让 Claude 接管一个镜像生产环境的预发集群,每天生成 100 多万份合成文档,并故意弄坏核心组件,然后让它一直跑。压测场景是按「偏执」的标准挑的,例如一天新建 1,000 万份文档、22,000 个连接同时重连。
每一轮的步骤见上图:压测 harness 把一个功能推到饱和,Claude 通过 Datadog MCP 读监控数据(指标、日志、trace 等,原文叫 telemetry),给出几个选项和一个推荐。改动容易撤销,它就自己写代码、部署到预发,再压一轮;难以撤销的,停下来问工程师。
执行循环的是一个常驻的 Claude Code 会话。它充当协调者,大部分工作分给 sub-agent,最忙的一周通常同时有约 11 个在跑,峰值 30 个。协调者还通过 Slack MCP 联系 Anthropic 内部其他基础设施团队的 agent,让它们按自己踩过的坑检查扩容方案。
监控数据与技术选型
循环能自己闭合,前提是每一轮的监控数据都准确。团队为此做了两件事。
第一,服务的每个操作都会上报监控数据。例如每条数据库查询都上报名字、扫描行数和返回行数,Claude 据此找出写得不好的查询并重写。Claude 每轮读监控数据时,还会补上它认为缺的埋点。以前埋点大多是出了事才补,现在由 Claude 边做边写。
内存问题是最典型的例子。压测初期,一份大文档在 pod 上占了约 3 GB。Claude 先缩小了一个缓存,下一轮压测显示内存其实在某个依赖库的缓存里,它就撤回了这个改动。继续用更细的内存 profiling 排查后,它发现每敲一个键,文档都会被复制进好几个数据结构,于是改成 copy-on-write。约三天后,这份文档的内存稳定在约 180 MB,上线需要的 pod 估算从 500 多个降到约 50 个。
第二,选能测清楚的技术栈。服务用 Rust 写,没有垃圾回收,内存增长都能对应到自己定义的结构上。依赖压到最少,必须用的几个直接 vendor 进来,方便阅读和测量。原文的理由是模型在信号干净时 hill climb 得最好,而垃圾回收会让内存和延迟随回收时机波动。作者也说明,他们没有拿 Go 和 Rust 做对比实验,这只是他们的经验。
上线结果与成本
上线后服务扛住了:
- 头 100 万份文档用了约 30 小时,9 月 22 日超过 460 万份。
- 20 亿次请求只出了 60 个服务器错误。
- 9 月生产环境发布 629 次,一次都没有回滚。
- 预发环境演练过的 10 个场景,有 7 个在生产环境真的发生了。
作者认为几个月前这套做法还行不通。旧模型在长循环里跑到第 10 到 20 轮,就会忘记在优化什么,要人重新说一遍目标。这次用的是一个内部研究模型,能力大致相当于 Claude Fable 5.2,在多次上下文压缩之后仍守住了所有不变量。
成本按 Fable 5.2 的 API 标价折算,从 8 月底到上线约 12.5 万美元,大部分花在读监控数据、写方案、生成修复和评审代码上。作者估计,如果一开始就知道怎么搭,花一半就够。他按小团队常见配置(两台规格适中的 Kubernetes 节点加一个 Postgres)重新估算,同样两周的投入约 3,000 到 10,000 美元,并注明这个数字没有实际跑过。
人的分工
开跑前,工程师做了四件事,Claude 后面两周的自主运行都建立在这上面:
- 写下两条不变量,作为每一轮判断修复是否合格的标准:文档必须几乎瞬间打开,历史很长的也一样;服务器确认收到的编辑,测试必须能证明它还在。
- 列出需要他批准的决定,标准是改动能不能撤销,例如数据库 schema、key 的布局、文档的存储和物化方式。
- 挑压测场景,接好 Datadog MCP。
- 选能测清楚的技术栈,让监控数据里的数字都能对应到自己写的代码。
运行中,他基本不干预,原文的说法是「I just left it running」。只有 Claude 碰到清单上的决定时,才停下来给他几个选项和一个明确的推荐,他通常批准的就是这个推荐。他以 schema 为例解释为什么这类决定要问人:合理的答案往往有好几个,选错了再换方向代价很大。
上线那一周,出问题时由团队翻运行时开关。开关后面的修复,Claude 在预发环境里早就做好了。
OpenAI 的 Performance Factory
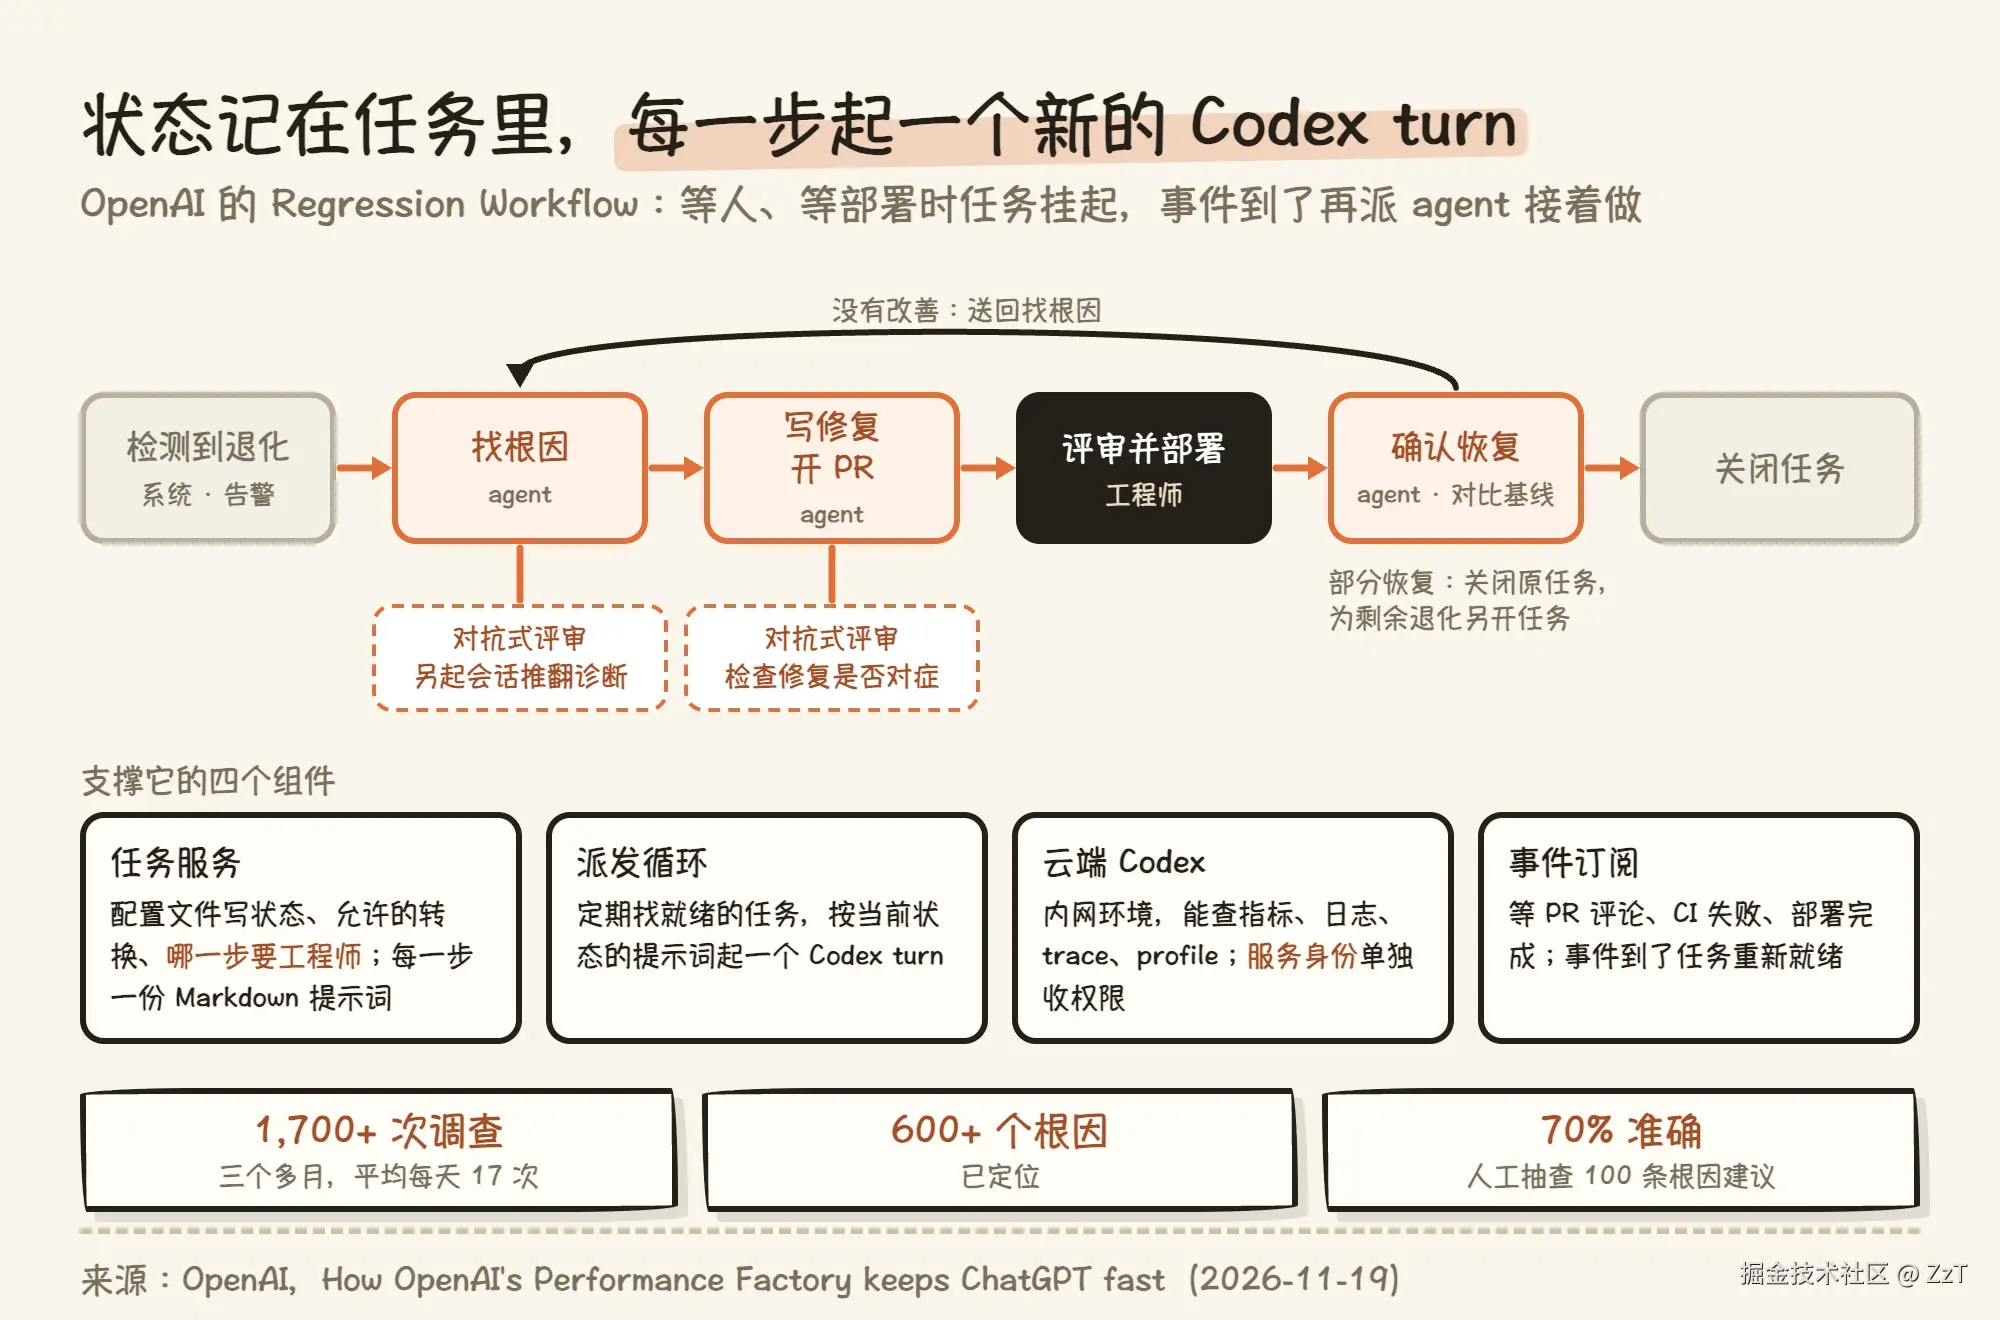
Performance Factory 是 OpenAI 用来排查和修复 ChatGPT 性能问题的系统,跑在云端的 Codex 上。第一个上线的流程叫 Regression Workflow:性能告警触发后自动开任务,agent 找根因、写修复,工程师评审并部署,上线后 agent 再确认性能是否恢复。
三个多月里,这个流程跟踪了 1,700 多次调查,找到 600 多个根因,平均每天 17 次。
演进过程
原文把团队的变化分成六个阶段,看的是人在排查里的角色怎么变。
早期工程师手工排查,累计做了 30 多个性能工具。有了 Codex 后,工程师先和它一起查,再把排查流程写成 perf-forensics skill,用过去的退化案例做 evals,做到给一条告警、一次运行就能拿回诊断。这时工程师发现自己只是在中转:把告警复制给 Codex,再把结论贴回 Slack。于是告警改为直接在云端启动 Codex,但修复和验证仍靠人。最后才是 Performance Factory,从告警到上线后确认恢复都由系统推进。
四个组件
Performance Factory 由四部分组成:
- 任务服务:一个配置文件加几份 Markdown 提示词定义一个 workflow,配置里写状态、允许的转换和哪一步需要工程师。
- 派发循环:定期找出可以进入下一步的任务,用当前状态对应的提示词启动一个 Codex turn。agent 做完后记录进展,把任务推到下一个状态。
- 云端 Codex:每个 turn 跑在内网环境里,能访问代码仓库和指标、日志、trace、CPU profile、内存快照。
- 事件订阅:任务要等人或等部署时,订阅 PR 评论、CI 失败这类事件,事件到了再派 agent 接着做。
任务的状态和发现记录在任何一个 agent 的上下文之外,所以工作能在 agent 和工程师之间来回传递。原文的说法是,把大任务拆成一个个聚焦的 Codex turn 效果更好。
对抗式评审
早期的 agent 常常在找到第一个说得通的解释时就停下,其中一些诊断是错的。团队因此加了对抗式评审:另起一个 Codex 会话,专门尝试推翻这个诊断。它会做反事实检验,比如没有收到这次发布的同类请求是否正常,回滚被怀疑的改动后指标是否恢复。
原文举了一个例子。一个 agent 把 ChatGPT 对话失败归因到图片下载出错,并标记为已找到根因。评审的 Codex 发现,负责定位文件的内部服务已经恢复,图片请求却还在失败,这个诊断解释不了持续的失败,于是重新打开了调查。
团队人工抽查了 100 条根因建议,70% 判为准确,30% 需要补充,或者没有完全证明因果。
原文说修复比找根因更难。agent 写的改动有时比需要的复杂,或者引入新问题,所以修复也要过一轮对抗式评审。修复合入并部署后,agent 被唤醒,检查性能是否回到原来的基线:
- 完全恢复,任务关闭。
- 只恢复一部分,关闭原任务,为剩下的退化另开一个任务,因为原因可能不同。
- 没有改善,记录情况,把任务送回调查阶段。
评测与自修复
升级模型或修改 skill,可能让一些案例变好、另一些变差,所以每次改动 agent 前先测。团队分开测两件事。
- 调查能力:用过去的生产事故回测。每个案例起一个新的 Codex,只给去掉泄题细节的原始告警,不能用之前调查留下的记忆,也不能读事故报告,事后还要检查 transcript 有没有偷看答案。「什么时候开始、影响多大」和「归因到哪次部署」分开打分,因为时间判断对了,原因仍可能归错。
- 给工程师的摘要:用保存下来的任务快照回测,由独立的 grader 检查不熟悉系统的工程师能不能看懂、有用的图表有没有保留、建议的下一步有没有证据支撑。
agent 本身也要被监控。性能分析工具坏了、少一个权限,都会让 agent 无法证明根因,而这类问题在最终报告里很难看出来。团队每天跑一个 agent,扫最近运行的消息和日志,找工具失败和权限错误。同一个工具错误挡住了好几次调查,它就开任务去修,再由工程师评审合入。
人的分工
开跑前,工程师定义整个流程:
- 在 workflow 配置里写清任务有哪些状态、怎样转换、哪一步需要工程师。
- 为每一步写提示词,把排查方法写成 perf-forensics skill,并用过去的事故做回测。
- 给 agent 一个服务身份,单独限定权限,也能区分哪些操作来自性能 agent。
运行中,工程师可以在 Slack 或 workflow 界面里跟进、补充上下文,但必须由人做的只有一步:评审修复的 PR,决定是否合入并部署。团队在这次交接上花了很多功夫:
- 每个任务自动生成报告,写清退化、影响、根因和修复,附指标时序图、CPU 火焰图和 trace。
- 同一次退化在多个告警和频道里出现时,系统把它们关联起来,按团队关心的指标分组,并估算影响排序。原文的说法是,希望工程师把注意力花在决定上,而不是重建 agent 的工作过程。
- 工程师可以直接改 PR,也可以参考诊断自己写修复;在 PR 上留评论,会唤醒 agent 去处理。
- 涉及架构取舍的修复由人权衡。例如加缓存能提速,但会带来数据过期,这需要熟悉服务的工程师判断。
事后,团队对比 agent 提的修复和工程师最终合入的改动,找出提议的不足,补进 evals。
腾讯的 LoopForge
项目概况
LoopForge 是腾讯开源的自托管团队工作台,MIT 协议(第三方组件按各自协议),7 月 28 日创建,总星数 5,500 多。它有两种用法:在对话里把需求交给 Main Bot,由它开 Docker 沙箱、检出仓库、把任务分给项目角色;或者把验证过的做法存成 SOP,之后的需求按同一套流程交付。
写代码的仍是现成的 agent CLI,支持 CodeBuddy、Codex、Claude Code、OpenCode、Cursor CLI 等 10 种,内置 SOP 默认用 CodeBuddy,每个角色可以单独换。LoopForge 负责外面那一层:角色、沙箱、检查点和留痕。
它是腾讯内部平台的公开导出版本,Go 模块名仍是内部的 agentflow。仓库的验证记录写着,导出范围内 1,718 个源文件里,1,466 个和内部主干完全一致,178 个做了适配。也就是说,流程引擎用的是内部那套实现。
SOP 由五种节点组成:Agent(一个角色,含提示词、执行器、模型、规则、Skills 和 MCP 工具)、脚本、人工介入、子 SOP 和预览构建。仓库内置四条 SOP:后端交付、前端交付、缺陷修复、产品方案。
缺陷修复 SOP
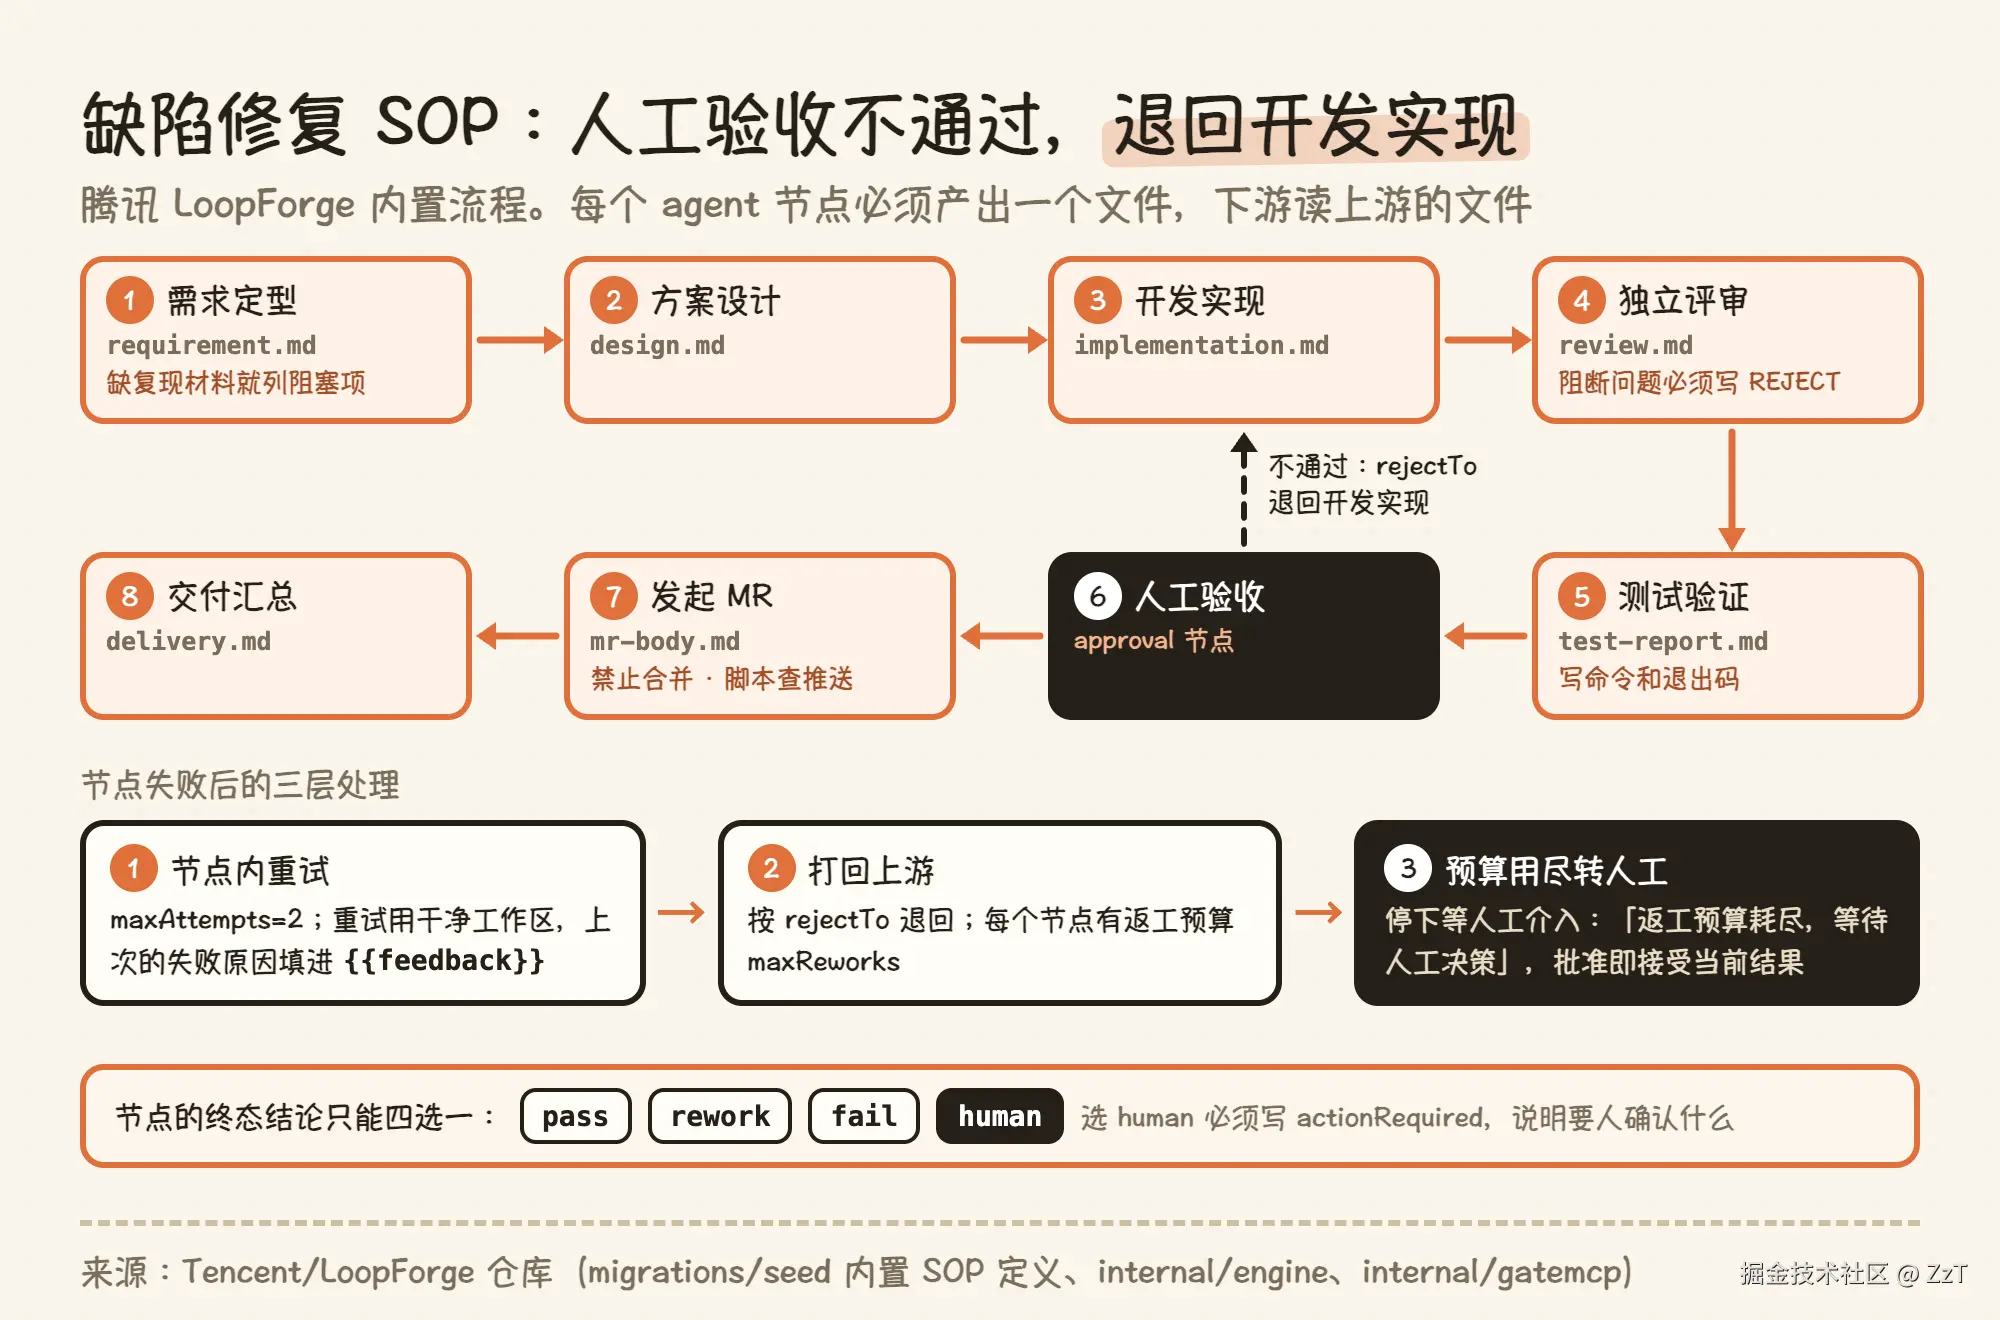
内置缺陷修复 SOP 的描述是「先复现,再修复,独立评审并回归」,8 个节点和各自的产物文件见上图。每个 agent 节点都必须产出一个 Markdown 文件,下游节点读上游的文件,流程状态落在这些文件里,而不是某个 agent 的上下文里。
几个角色的提示词里写了明确的禁止项:
- 需求定型:拿不到待修代码和复现材料时,列出阻塞项请求补充,「不得编造复现或声称已修复」。
- 独立评审:按严重程度列出缺陷,「发现阻断问题必须明确写出 REJECT。不得伪造通过结论」。
- 测试验证:把命令、退出码、结果和未验证的范围写进报告。
- 发起 MR:只在人工验收通过后执行,提交到工作分支并推送,「不得合并 MR/PR,不得推送主分支或强推」。节点结束前,一段脚本检查分支确实已推送到远端,另一项检查确认 MR 已创建,任一不通过都让 agent 继续处理。
所有角色共享一条规则:不得伪造测试或交付证据,未经任务授权不得合并主分支。
失败处理
节点失败后的三层处理见上图。值得注意的是第三层:agent 一直要求打回、但上游的返工预算已经用完时,引擎不把它判为失败,而是停下来等人工介入,提示「返工预算耗尽,等待人工决策」。重试和打回都由引擎自动处理,返工预算用尽才交给人。重试时引擎会把上一次的失败原因填进提示词里的 {{feedback}},因为重试用的是干净工作区。
agent 怎么给出结论也有约束。节点通过一个专用的 MCP 工具提交唯一的终态结论,只能是 pass、rework、fail、human 四种。选 human 时必须填 actionRequired,写清楚需要人确认什么。
源码注释还记录了一个误触发人工介入的问题。有些检查用 grep 在 agent 的报告里找 ALL_GREEN=true 或 NEED_HUMAN=true 判断结论,而 agent 解释「为什么这条不适用」时也会引用这些词。不加限制的 grep 会把解释当成结论,流程就停下来等人,其实并没有需要人回答的问题。所以引擎会把这类 grep 改成只匹配独占一行的结论。
人的分工
开跑前,团队设计 SOP:哪些节点由 agent 做,每个角色的提示词和规则,人工介入放在哪个节点,不通过时退回哪一步,每一步最多返工几次。
运行中,人有三种介入方式:
- 在人工介入节点上做决定:确认通过,继续下游;补充信息,让当前节点重跑;或者退回上游某个节点重做。
- 回答 agent 主动提的问题 :节点结论是 human 时,
actionRequired写明了要人确认什么;返工预算用尽时,由人决定是否接受当前结果。 - 在对话里随时暂停、引导或接管正在运行的流程。
人拿来做决定的是节点产物:评审报告,以及写了命令、退出码和「未验证范围」的测试报告。MR 由 agent 发起,合入仍由人决定。验证有效的流程存成新版本的 SOP,下一个需求按新流程走。
验证范围与部署边界
用之前要知道两件事。
第一,接 Claude Code 和 Codex 的验证程度。仓库 10 月 16 日的验证记录写明,Codex 和 Claude CLI 的用例是对着本地协议服务测的,「not paid-provider model runs」;真实交付用例跑的是 CodeBuddy 加 deepseek-v4.1-flash。付费的 Codex、Claude 服务被列在「没有完整实测」里。
第二,信任边界。默认的 Docker Compose 部署把宿主机的 Docker socket 挂进平台容器,文档原话是这「equivalent to root on the host」。所有登录用户都能看到实例里的全部项目和运行记录,所以只适合可信团队,不要开放到不可信网络。文档还提醒,agent CLI 在无人值守的 SOP 运行里同样会应用仓库自带的配置,包括 AGENTS.md、CLAUDE.md、.claude/settings.json 里的 hooks 和 .mcp.json,这些都可能在沙箱里启动命令,只应该绑定内容可信的仓库。
协作方式对比
| Anthropic chaos loop | OpenAI Performance Factory | 腾讯 LoopForge | |
|---|---|---|---|
| 开跑前人定什么 | 两条不变量、需要批准的决定、压测场景 | workflow 的状态和转换、每步提示词、skill 和回测 | SOP 节点、角色提示词、人工介入位置、返工预算 |
| agent 连续做什么 | 压测、读监控数据、写修复、部署到预发 | 找根因、互相复核、写修复、开 PR、上线后确认恢复 | 需求定型到测试验证,再发起 MR |
| 人在哪一步介入 | 难以撤销的设计决定 | 评审 PR、合入并部署 | 人工验收;agent 结论为 human;返工预算用尽 |
| 交给人的东西 | 几个选项和一个推荐 | 报告:影响、根因、修复,附图表和 trace | 评审报告、测试报告、要人确认的事项 |
| 人能做什么 | 批准推荐,或选别的方案 | 合入、直接改 PR、留评论让 agent 改 | 通过、补充信息重跑、退回上游 |
| 事后怎么改进 | 作者总结出可复用的步骤和成本估算 | 对比 agent 的修复和人合入的改动,补 evals | 把验证有效的流程存成新版本 SOP |
三者的共同点有三条。
人的工作集中在开跑前和交接点。 三个案例里,人花时间最多的地方都是开跑前写规则:Anthropic 的不变量和审批清单,OpenAI 的 workflow 配置和 skill,LoopForge 的 SOP。运行中人不盯每一步,OpenAI 演进过程里「工程师在告警和 Codex 之间复制粘贴」那个阶段,正是被当成要消除的环节。
人工介入都放在不可逆的那一步。 Anthropic 的划分标准写得最明白,就是改动能不能撤销。三家公开的材料里,都没有让 agent 自己合入主分支或部署生产。OpenAI 说正在探索让低风险修复不经人工直接上线,目前还没有做。
复核和执行由不同的主体完成。 OpenAI 的对抗式评审是专门为了解决「agent 停在第一个说得通的解释上」加的,诊断和修复各过一轮。LoopForge 把评审做成独立角色,要求明确写 REJECT。Anthropic 的循环里,判断修复是否有效的是下一轮压测的监控数据,而不是写修复的那个会话自己的判断。人介入时看到的,已经是复核过的结果。
分歧在任务状态。Anthropic 的循环依赖一个会话守住目标两周,作者也承认,换成几个月前的模型,十几轮之后就会跑偏。OpenAI 和 LoopForge 把状态写在 agent 之外,流程可以停下来等人:OpenAI 靠事件订阅在 PR 评审和部署之后接着做,LoopForge 能从任意节点重试或重跑。前者适合一名工程师主导的一次性冲刺,后者适合长期运行、要等人的流程。
使用建议
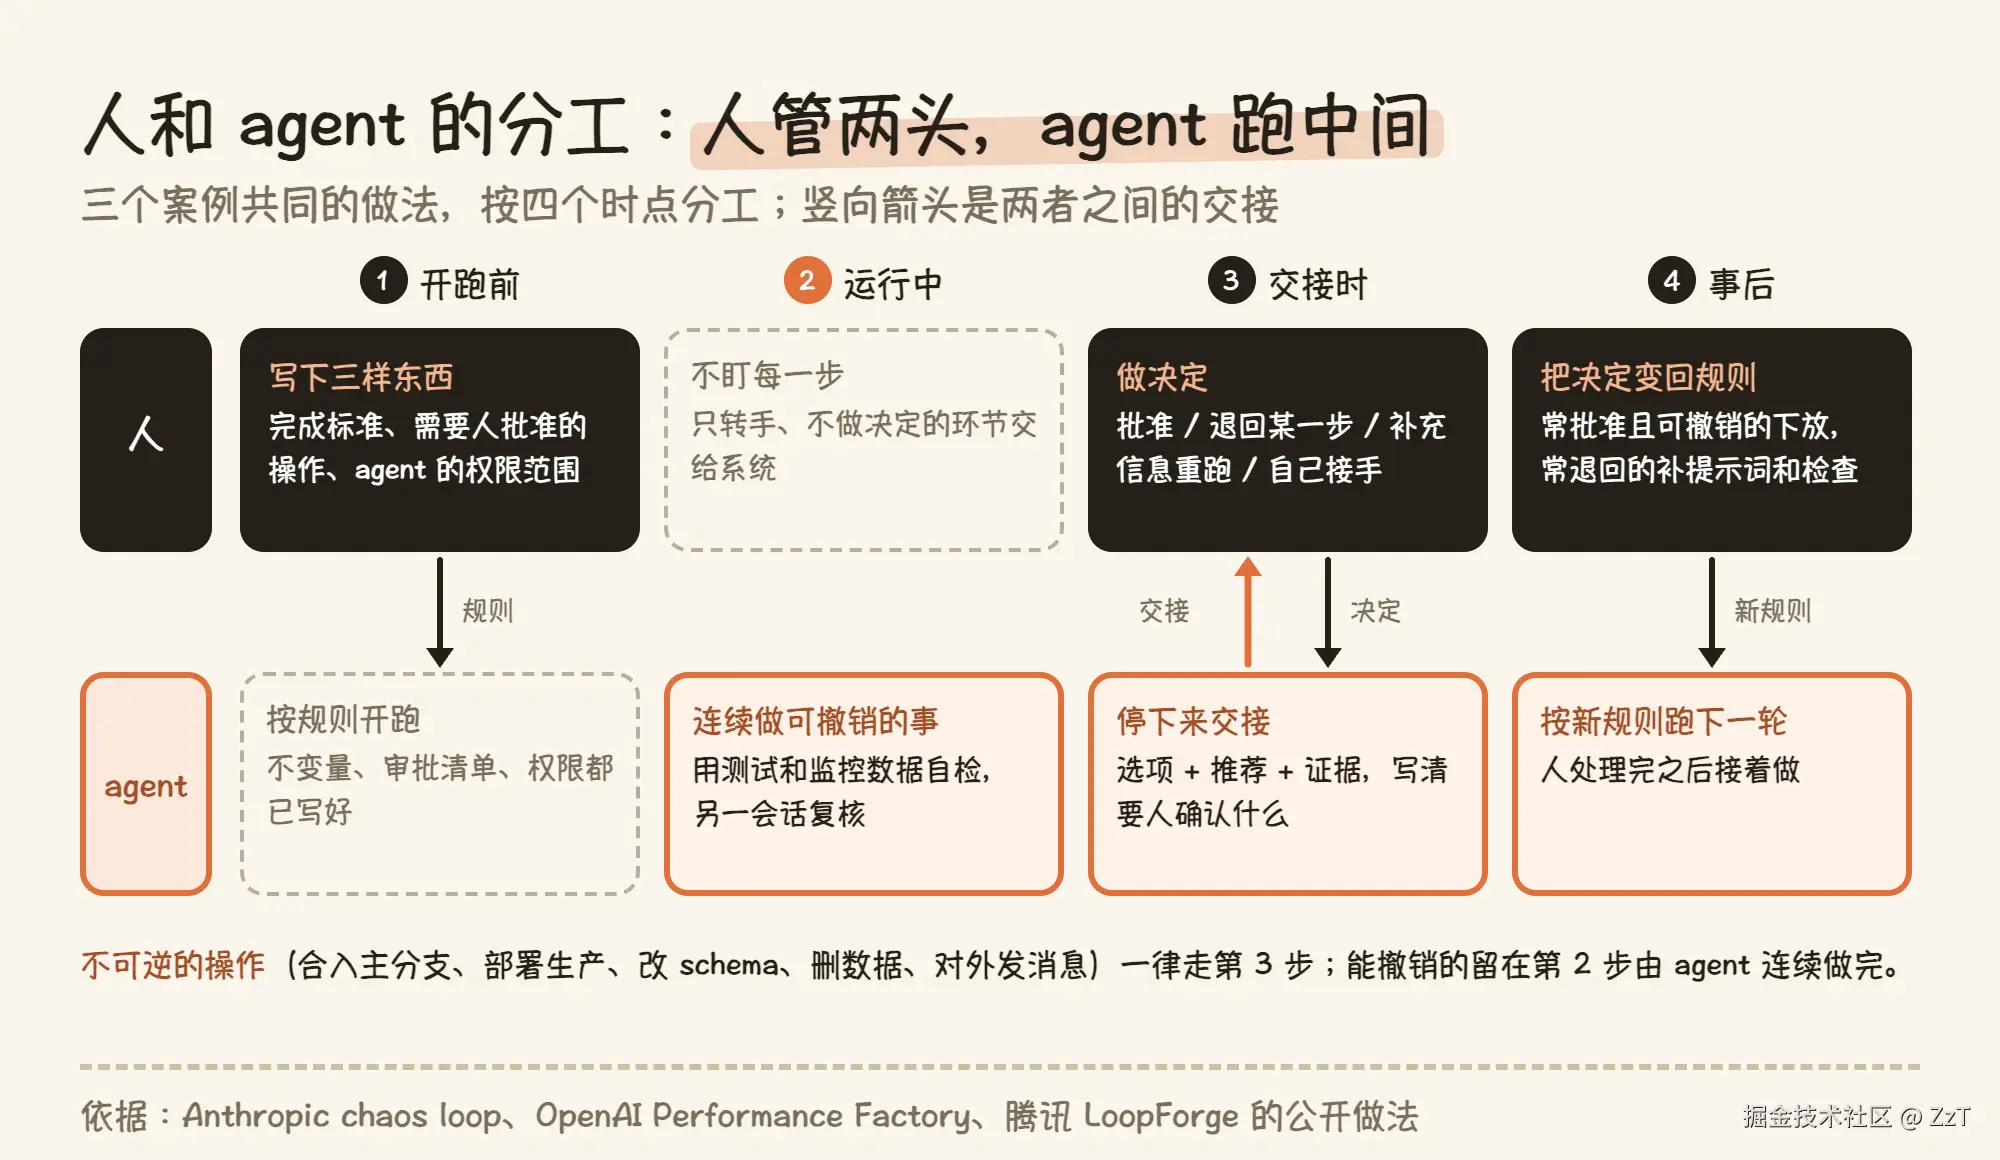
三个案例的规模都比一般团队大,但分工方法可以直接用在自己的 agent 流程上,包括日常用 Claude Code 或 Codex 做开发。按上图的四个时点,人和 agent 各做各的事。
开跑前
人写下三样东西:
- 完成标准:agent 每一轮用来判断「做好了没有」的条件,最好能用测试或监控数据自动检查。Anthropic 的两条不变量就是这一类。
- 需要人批准的操作:判断标准是能不能撤销。合入主分支、部署生产、改数据库 schema、删数据、对外发消息,都属于这一类。
- agent 的权限范围:只给完成任务需要的环境,例如只能部署到预发,或者像 OpenAI 那样给 agent 一个单独的服务身份。
在 Claude Code 里,前两样可以写进 CLAUDE.md,让 agent 知道什么时候该停下来问人。但官方文档写明 CLAUDE.md「aren't enforced configuration」,只是上下文。真正不能出错的操作,例如推送主分支、跑数据库迁移,要用 PreToolUse hook 拦下来,不能只靠 agent 自觉。
运行中
可撤销的步骤让 agent 连续做完,人不在每一步之间转手。agent 的自检要靠测试结果、退出码、监控数据这类机器能读的信号,再让另一个会话或角色去复核,而不是让写代码的 agent 自己判断。
交接时
agent 停下来找人时,交出的东西要能让人在几分钟内做决定:
- 几个选项加一个明确的推荐,这是 Anthropic 的做法。
- 影响、根因、修复和证据图表,这是 OpenAI 的做法。
- 一句话写清要人确认什么,这是 LoopForge 的
actionRequired。
人的操作也应该限定在几种:批准;退回某一步重做;补充信息后重跑;自己接手。操作越明确,agent 越容易在人处理完之后接着做。
事后
对比 agent 的提议和人最终的决定,把差异变回规则:
- 人总是批准同一类、而且能撤销的提议,这一类可以考虑交给 agent 自己做。OpenAI 正在探索的就是让低风险修复不经人工上线。不可逆的操作即使总是批准也要留给人:Anthropic 的作者通常批准 Claude 的推荐,仍然要求 schema 改动先问他。
- 人总是退回同一类结果,说明上游的提示词、skill 或检查要补。OpenAI 用合入的改动补 evals,LoopForge 把改进后的流程存成新版本 SOP。
想参考现成的实现,可以按场景对照:上线前的压测加固看 Anthropic 的 chaos loop;告警触发、反复出现的排查看 OpenAI 的 Performance Factory;团队需求交付、需要审批留痕看 LoopForge,部署前先读上文的验证范围和信任边界。
参考链接
- Anthropic,Using a "chaos loop" to harden the Claude Docs launch:claude.dev/blog/chaos-...
- OpenAI,How OpenAI's Performance Factory keeps ChatGPT fast:openai.com/index/how-o...
- Tencent/LoopForge:github.com/Tencent/Loo...
- LoopForge 验证记录:github.com/Tencent/Loo...
- LoopForge 部署文档:github.com/Tencent/Loo...