在本地笔记本上跑代码模型,开发者最常遇到一个死结。
参数太小的模型,写单行补全还行,一旦让它接手多文件修改或智能体任务,推理链条很快就会断掉。参数稍微大一点,动辄上百 GB 显存,普通人的电脑根本装不下,只能继续掏钱买云端 API。
2026 年 11 月 20 日,Thinking Machines Lab 正式开源了 Inkling 2 Mini,顺带还放出了一个专门供社区研究用的变循环版本 TML-d24-varloop-research。在官方演示里,研究人员直接把一台 48GB 内存的 M5 Pro MacBook Pro 切到飞行模式,几分钟内就在完全断网的状态下用它写出了一款可运行的飞行模拟器,还在同一台离线 Mac 上同时驱动了 20 个像素小镇居民日常互动。
这个模型总参数量只有 26.4B,内存占用约 20GB,官方明确支持在 32GB 及以上内存的 MacBook 或 Mac Mini 上通过 Ollama 本地运行。消息放出后迅速冲上 Hacker News 热门榜,拿下了超过 1200 个赞。
让社区真正停下来仔细研究的,是它背后的结构选择:既然参数量塞不进更多层,那就让同一批网络层在推理时多跑几遍。
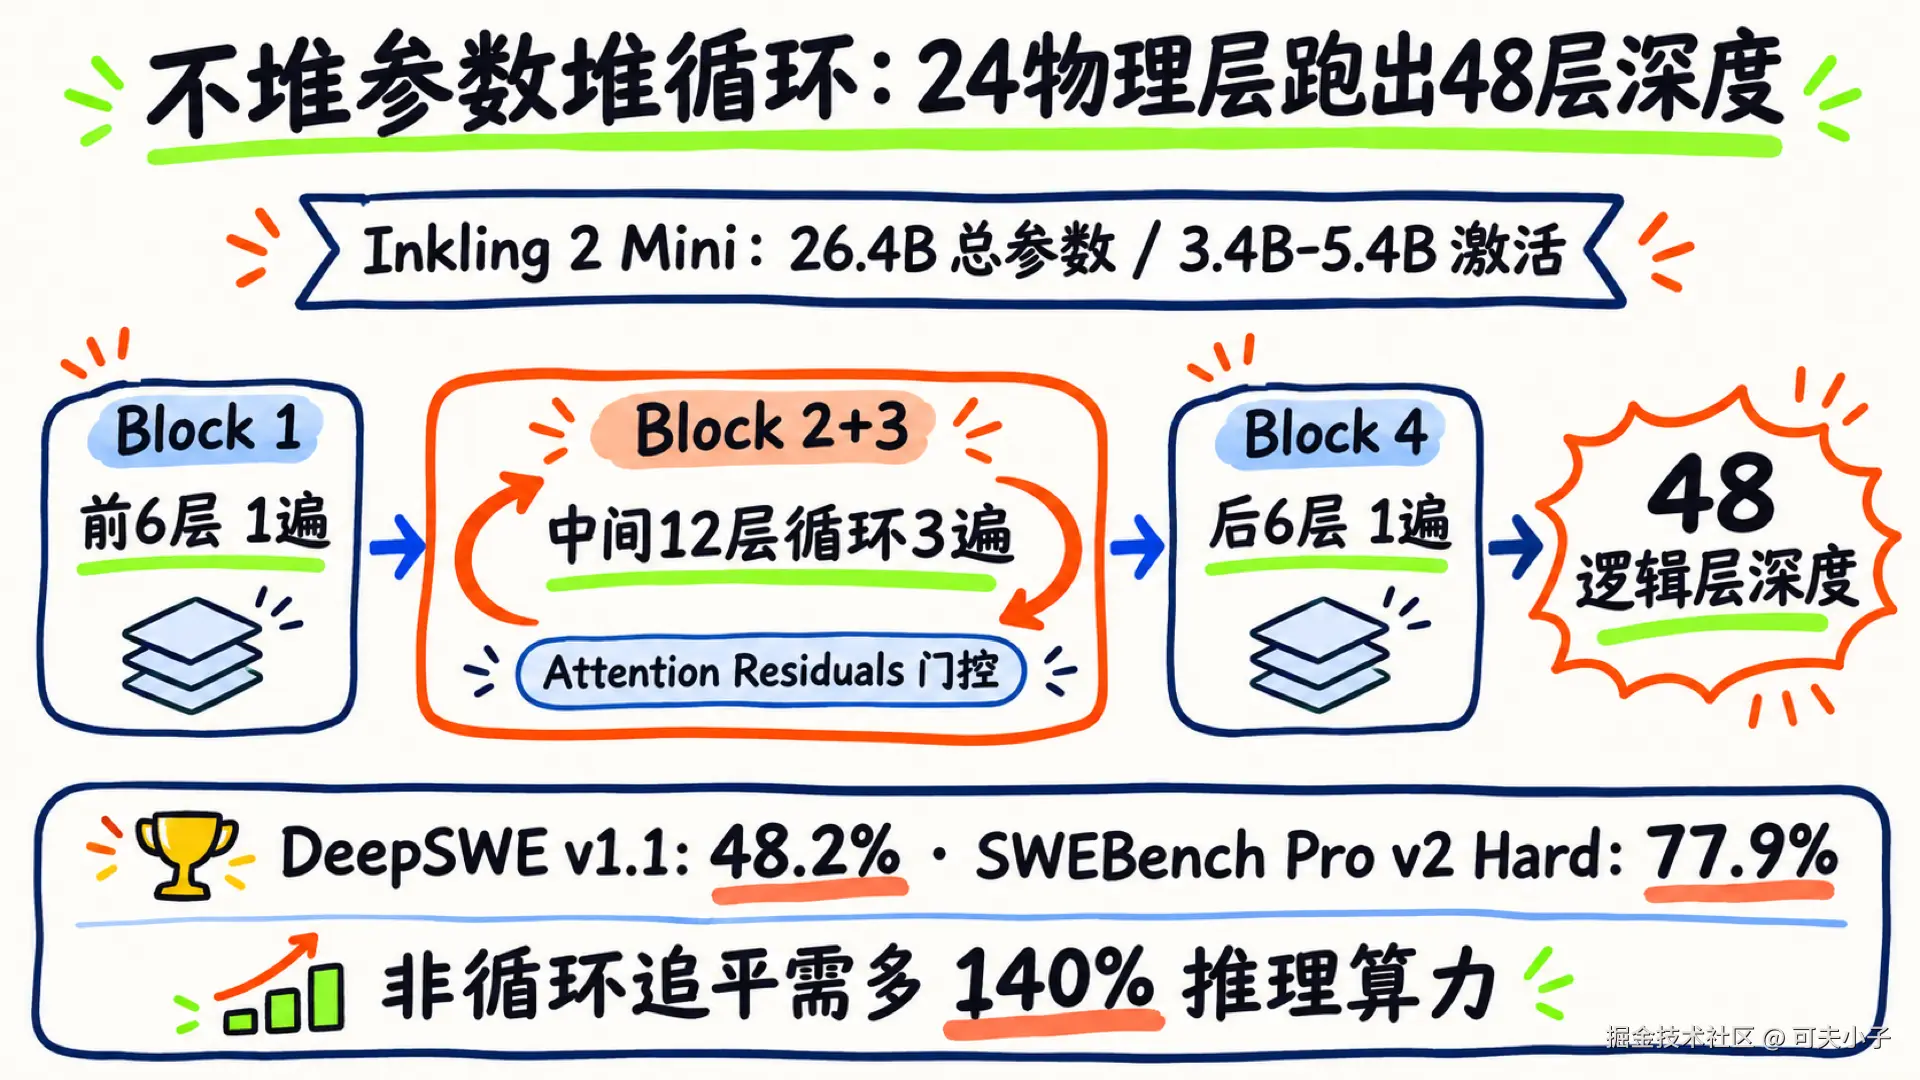
不靠堆参数,靠把中间 12 层循环跑 3 遍
常规 Transformer 处理每个 token 时,都是从第一层一路走到最后一层,每一层只经过一次。如果想要更深的连续推理能力,传统做法只有一条路:继续往上加层数、堆参数,把模型越做越胖。
Inkling 2 Mini 换了一种思路。它只有 24 个物理层,分为 4 个各含 6 层的模块。第一块和最后一块只跑 1 遍,负责把输入输出翻译成内部表征;中间的两块共 12 层(第 7 层到第 18 层)则被设计成连续循环跑 3 遍。
这样一来,模型在磁盘和内存里只存了 24 层的权重,但每个 token 实际经历了 48 个逻辑层的计算深度。因为采用混合专家(MoE)架构,它总共有 26.4B 参数,单遍激活 3.4B,把中间层循环 3 遍计入在内,每个 token 的权重激活量为 5.4B。
为了让循环真正发挥作用,团队没有简单把上一轮结果直接相加,而是引入了 Kimi 团队提出的 Attention Residuals 机制。从第二轮循环开始,中间层会通过一个训练学出来的门控开关,按需读取上一轮循环的输出,再结合第一块的初始特征继续推演。训练初期这个门控几乎关闭,让模型平稳起步,随着训练推进再逐步放开跨轮信息传递。
这套做法在算力账上非常划算。Thinking Machines Lab 在未剪枝版本的消融对比中测算过,非循环模型虽然训练时能省下 7.5% 的算力,但到了推理阶段,在 512k token 的长程智能体轨迹上要达到同样的损失水平,非循环模型需要多付出 140% 的推理算力。
循环深度增加还带来一个直接副产品:废话变少了。在官方释放的变循环研究模型 TML-d24-varloop-research 上,面对同一个 GPQA Diamond 科学推理题集,跑 1 遍循环平均需要输出 3703 个推理 token,而跑 5 遍循环只需要 1661 个 token,思维链长度直接砍半,句子可读性和词表规范度却基本没变。模型只是在内部想清楚了,减少了输出"等一下""不对重来"这类试探性回溯。
反映在官方自报的基准成绩上,Inkling 2 Mini 在 100B 参数以下的开源权重模型里拿下了多项领先:DeepSWE v1.1 达到 48.2%(同表对比的 Qwen3.8-27B 为 42.2%,Gemma 4 31B 为 0.3%),SWEBench Pro v2 (Hard) 达到 77.9%,SWEBench Verified (bash only) 达到 79.2%,Vals Index v2.2 达到 46.5%。
需要说明的是,这些跑分数据均出自官方技术报告的自报测试,且各对比模型的评测框架与运行配置并不完全一致,实际落地表现仍需结合自己的业务代码库验证。
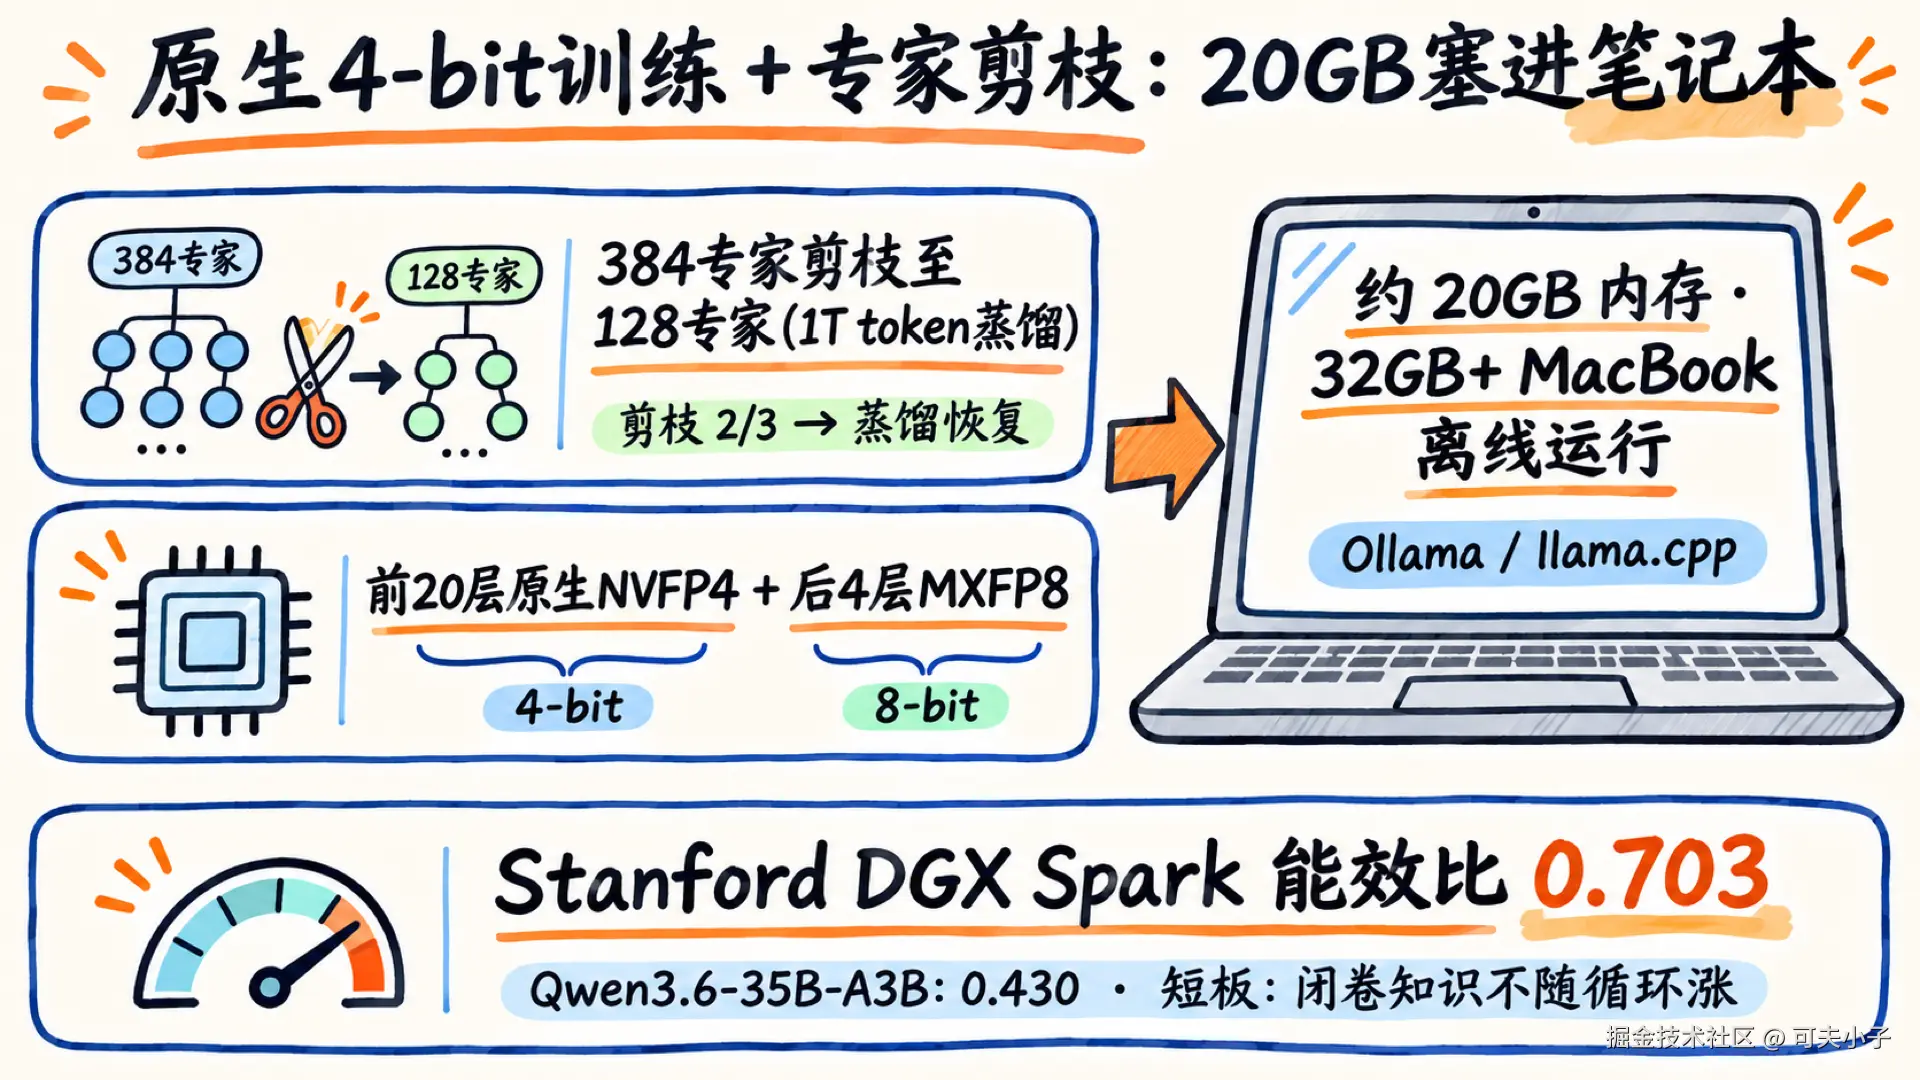
训练就是 4-bit,20GB 直接塞进 32GB 笔记本
很多模型号称能跑在消费级设备上,往往是训练完 16-bit 权重后,再由社区硬压成 4-bit 量化版。压完之后体积是小了,代码和推理能力经常跟着掉一截。
Inkling 2 Mini 的另一项核心工程改动,就是从预训练到强化学习全流程直接用低比特精度训练。模型前 20 层全程跑在原生 4-bit 的 NVFP4 精度上,配合 NVIDIA GB300 平台的专用算子加速;最后 4 层则保留 8-bit 的 MXFP8 精度。部署出来的权重和训练时使用的数值精度完全一致,省去了事后量化带来的转换损失。
为了把总体积进一步压进普通笔记本的内存甜点区,模型在中期训练阶段做了一次激进瘦身:原本每层有 384 个专家,每次选 8 个;团队直接剪掉了三分之二最不常用的专家,只留下 128 个高频专家,随后用内部大模型蒸馏了 1T token 帮剩余专家"补课",恢复剪枝损失的精度,最后再完成 SFT 和总计 2.2T token、2000 步的强化学习。
最终成品的内存占用压到了约 20GB。这意味着一台 32GB 内存的 MacBook 或 Mac Mini,不用外接显卡集群,也能稳稳装下整个模型并留出系统余量。生态适配也在发布当天同步到位,Hugging Face 开放了完整权重,Ollama、vLLM、SGLang、Unsloth 和 llama.cpp 全部第一时间跟进支持。
在独立第三方测试方面,斯坦福大学 Hazy Research Lab 与 Scaling Intelligence Lab 提前拿到了测试权限,在 128GB 版 NVIDIA DGX Spark 上用 MXFP8 精度实测了单位能耗下的智能效率(Intelligence per Watt)。Inkling 2 Mini 拿到了 0.703 分,明显高于同台测试的 Qwen3.6-35B-A3B(0.430)、Gemma-4-26B-A4B(0.159)和 Qwen3.5-27B(0.036)。对需要长期挂在本地跑多智能体后台任务的开发者来说,这个能耗比很有参考价值。
循环也有边界:能省推理 token,但补不了知识容量
把同一个模型当成万能小钢炮之前,有几道边界必须看清,官方自己在局限性章节里也写得很直白。
循环计算能增加推理深度,却无法让权重凭空记住更多冷门事实。在 TML-d24-varloop-research 的变循环实验中,只要涉及长上下文检索或需要多步推演的任务,增加循环次数就能稳步提分;可一旦换成闭卷知识问答(比如 SimpleQA Verified 和 WorldVQA),无论循环跑几遍,准确率几乎纹丝不动。在事实性评测 AA-Omniscience v1.1 上,Inkling 2 Mini 的得分是 -8.6,低于 Qwen3.8-27B 的 -6.4。
官方给出的解法是让模型勤用搜索和外部工具来补足知识短板,它在 BrowseComp(79.0%)、DeepSearchQA(85.3%)和 MCP Atlas(82.7%)上的表现确实领先同体量开源模型。反过来说,如果你的场景是纯离线、不接检索工具的百科问答,它并不占优势。
多轮对话和复杂约束跟随也是它的弱项。在 MultiChallenge 上它只拿到 50.0%,ComplexConstraints v1.1 只有 33.4%,两项都明显落后于 Qwen3.8-27B。如果你需要的是一位严格遵守十几条排版格式要求、做精细文案改写的助手,同尺寸的稠密模型可能更稳妥。
同时,内部循环越多,模型在"心里默算"而不写进思维链的比例也会提高。虽然 Thinking Machines Lab 在当前规模下尚未检测到监控可读性明显下降或恶意欺骗倾向抬头,但他们也坦言,如果未来更大规模的循环模型在更高循环次数下做强化学习,如何监督模型内部的隐式推理,仍然是一个开放课题。
对于一线开发者而言,Inkling 2 Mini 给出的信号很明确。如果你手里只有一台 32GB 内存的电脑,想在本地离线跑一个能接终端工具、能拆解长程代码任务、响应又快的编程智能体,它提供了一个过去很难拿到的性价比甜点。但如果你的核心需求是闭卷知识库问答或者严苛的多轮指令遵循,先拿自己的真实测试集跑一遍再决定切不切过去,会比直接看榜单稳妥得多。