具体怎么学习pytorch,看b站刘二大人的视频。
完整代码:
python
import numpy as np
import os
from PIL import Image
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import datasets, transforms
from torch.utils.data import DataLoader, Subset
# 设置随机种子
torch.manual_seed(42)
np.random.seed(42)
'''https://zhuanlan.zhihu.com/p/156926543'''
# 定义图片目录
image_dir = 'images'

# 初始化图片路径列表
img_list = []

# 遍历指定目录及其子目录中的所有文件
for parent, _, filenames in os.walk(image_dir):
    for filename in filenames:
        # 拼接文件的完整路径
        filename_path = os.path.join(parent, filename)
        img_list.append(filename_path)

# 初始化图像张量列表和标签列表
image_tensors = []
y_list = []

for image_path in img_list:
    # 提取标签 (假设标签是文件名的第一个字符)
    label = int(os.path.basename(image_path)[0])
    y_list.append(label)

    # 打开图像
    img = Image.open(image_path)

    # 获取图像尺寸
    width, height = img.size

    # 定义裁剪的区域(假设要保留图像中心的 100x100 区域)
    left = (width - 100) / 2
    top = (height - 100) / 2
    right = (width + 100) / 2
    bottom = (height + 100) / 2

    # 裁剪图像
    img = img.crop((left, top, right, bottom))

    # 将图像转换为 NumPy 数组
    img_array = np.asarray(img)

    # 将 NumPy 数组转换为 PyTorch 张量
    img_tensor = torch.from_numpy(img_array).float()

    # 如果图像是 RGB,将其转换为 (C, H, W) 格式
    if img_tensor.ndimension() == 3 and img_tensor.shape[2] == 3:
        img_tensor = img_tensor.permute(2, 0, 1)  # 从 (H, W, C) 变为 (C, H, W)

    # 增加 batch 维度
    img_tensor = img_tensor.unsqueeze(0)  # 从 (C, H, W) 变为 (1, C, H, W)

    # 规范化到0-1之间
    img_tensor = img_tensor / 255.0

    # 添加到图像张量列表
    image_tensors.append(img_tensor)

    # 打印图像张量的形状
    print(f"当前图像形状: {img_tensor.shape}")

# 将图像张量列表转换为四维张量
x_data = torch.cat(image_tensors, dim=0)
# 遍历 y_list 中的每个元素,并将每个数减去 1
for i in range(len(y_list)):
    y_list[i] -= 1

# 将标签列表转换为张量
y_labels = torch.tensor(y_list).long()  # 注意这里使用 .long() 方法将标签转换为长整型

print(x_data.shape,y_labels.shape)
print(y_labels)

# 定义数据集和数据加载器
class CustomDataset(torch.utils.data.Dataset):
    def __init__(self, x_data, y_labels):
        self.x_data = x_data
        self.y_labels = y_labels

    def __len__(self):
        return len(self.x_data)

    def __getitem__(self, idx):
        return self.x_data[idx], self.y_labels[idx]


# 使用自定义数据集和数据加载器
custom_dataset = CustomDataset(x_data, y_labels)
train_size = int(0.8 * len(custom_dataset))
val_size = len(custom_dataset) - train_size
train_set, val_set = torch.utils.data.random_split(custom_dataset, [train_size, val_size])

train_loader = DataLoader(train_set, batch_size=32, shuffle=True)
val_loader = DataLoader(val_set, batch_size=32, shuffle=False)

# 定义卷积神经网络模型
class SimpleCNN(nn.Module):
    def __init__(self):
        super(SimpleCNN, self).__init__()
        self.conv1 = nn.Conv2d(3, 16, kernel_size=3, stride=1, padding=1)
        self.conv2 = nn.Conv2d(16, 32, kernel_size=3, stride=1, padding=1)
        self.pool = nn.MaxPool2d(2, 2)
        self.fc1 = nn.Linear(32 * 25 * 25, 128)
        self.fc2 = nn.Linear(128, 5)  # 假设有5个类别

    def forward(self, x):
        x = self.pool(torch.relu(self.conv1(x)))
        x = self.pool(torch.relu(self.conv2(x)))
        x = torch.flatten(x, 1)
        x = torch.relu(self.fc1(x))
        x = self.fc2(x)
        return x


# 训练模型
model = SimpleCNN()
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)

for epoch in range(50):  # 假设训练50个epoch
    running_loss = 0.0
    for inputs, labels in train_loader:
        optimizer.zero_grad()
        outputs = model(inputs)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()
        running_loss += loss.item()
    print(f"Epoch {epoch + 1}, Loss: {running_loss / len(train_loader)}")

    # 在每个epoch结束后,计算并打印验证集的准确率
    model.eval()  # 将模型设置为评估模式
    correct = 0
    total = 0
    with torch.no_grad():
        for inputs, labels in val_loader:
            outputs = model(inputs)
            _, predicted = torch.max(outputs.data, 1)
            total += labels.size(0)
            correct += (predicted == labels).sum().item()
    val_accuracy = correct / total
    print(f'Validation Accuracy after Epoch {epoch + 1}: {val_accuracy}')
本数据集中x_data的维度是四维张量(203,3,100,100),y_labels的维度是一维张量
代码中需要注意的点,卷积模型接受的是四维张量,因此要转变为四维张量。
全连接层中输入的特征数,需要自己计算,通过前面卷积层和池化层后,计算总的维度数。一般是最后的通道数*高度*宽度
定义模型中的forward函数中,在经过全连接层计算前,需要将四维的x转为2维
如果 x 的形状是 (64, 32, 28, 28),表示一个批次大小为64的图像张量,其中每个图像有32个通道,高度和宽度都是28像素。现在,我们希望将这个张量展平为一个二维张量,以便输入到全连接层进行进一步处理。
通过 torch.flatten(x, 1) 操作,我们将在指定维度(这里是第一个维度,也就是通道维度)上对张量进行展平。展平后的张量形状将变为 (64, 32*28*28),其中64是批次大小,而 32*28*28 是展平后的特征数量,即每个图像的特征数量。这与前面定义的全连接层的输入特征数要一致。
Dataloader中batch_size就是设置第一个维度,比如这里的batch_size是32,那么
python
for inputs, labels in train_loader:这里的inputs维度是(32,3,100,100)
新学习pytorch中的分割数据集与测试集方法。
python
# 使用自定义数据集和数据加载器
custom_dataset = CustomDataset(x_data, y_labels)
train_size = int(0.8 * len(custom_dataset))
val_size = len(custom_dataset) - train_size
train_set, val_set = torch.utils.data.random_split(custom_dataset, [train_size, val_size])

train_loader = DataLoader(train_set, batch_size=32, shuffle=True)
val_loader = DataLoader(val_set, batch_size=32, shuffle=False)
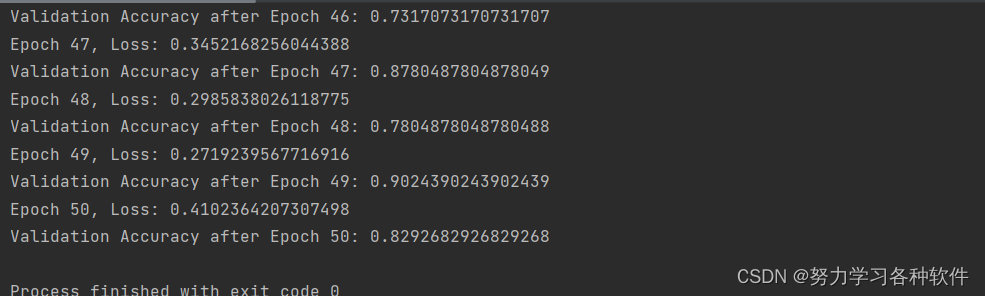
结果展现,可以看见准确率有0.82: