分布式hadoop集群访问web服务

一、启动和关闭节点

1、在NameNode节点上

(1)启动hdfs

复制代码
start-dfs.sh 

(2)关闭hdfs

复制代码
stop-dfs.sh 
2、在ResourceManager节点上

(1)启动yarn

复制代码
start-yarn.sh

(2)关闭yarn

复制代码
stop-yarn.sh

(3)开启任务历史服务(开启后会存储已提交的任务,有效期为七天)

复制代码
mapred --daemon start historyserver

(4)关闭任务历史服务

复制代码
 mapred --daemon stop historyserver

开启的服务都要在关闭虚拟机前关闭!

二、访问Web服务

1、访问NameNode的Web服务

(1)查看hdfs-site.xml配置文件

复制代码
cd /opt/softs/hadoop3.1.3/etc/hadoop/

 cat hdfs-site.xml

获取到Web网址
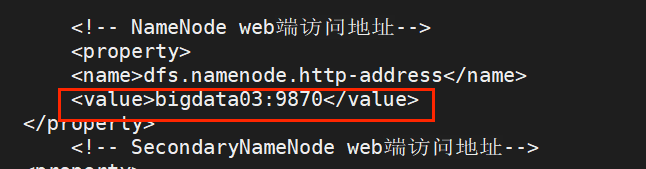
http://bigdata03:9870

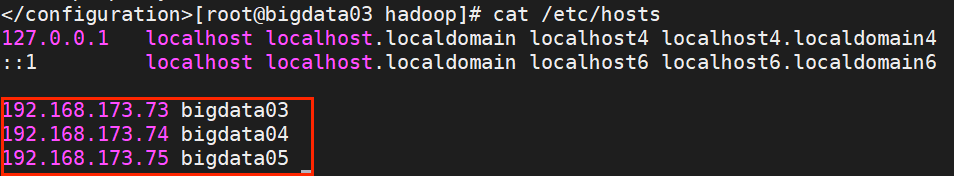
(2)查看/etc/hosts

复制代码
cat /etc/hosts

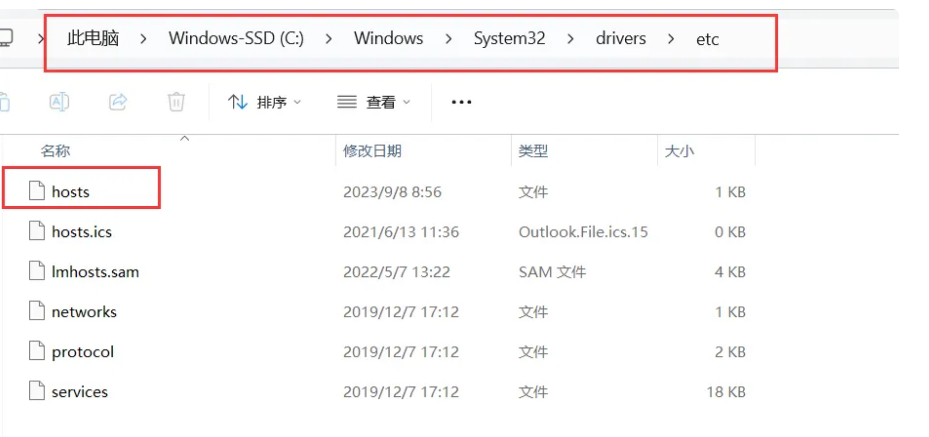
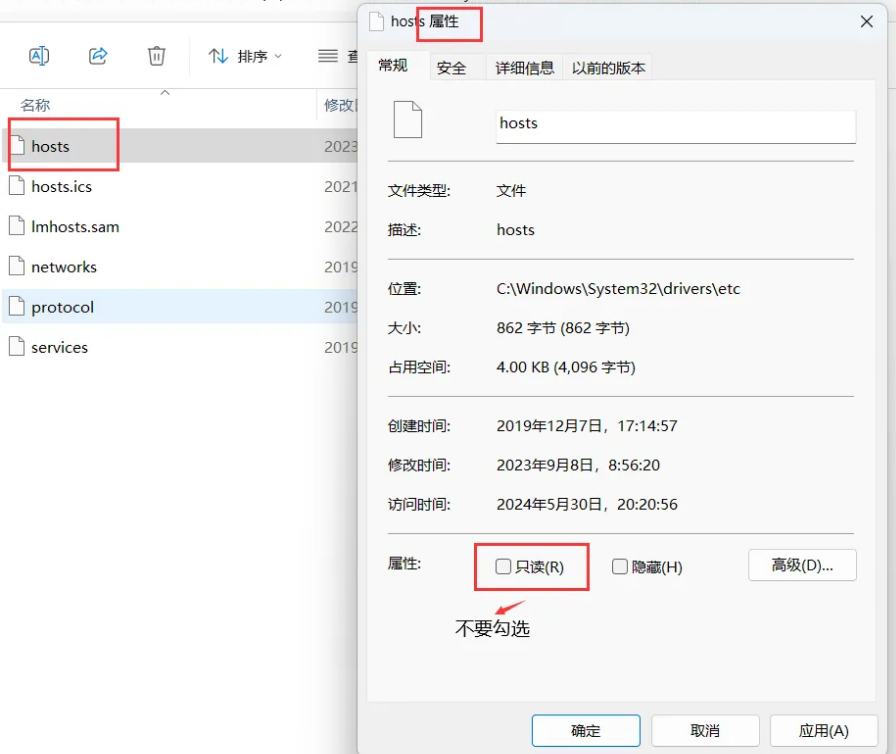
(3)将映射配置复制粘贴到C:\Windows\System32\drivers\etc下的hosts

① 查找位置
② 修改文件权限
③ 在文件末尾加入对应映射关系

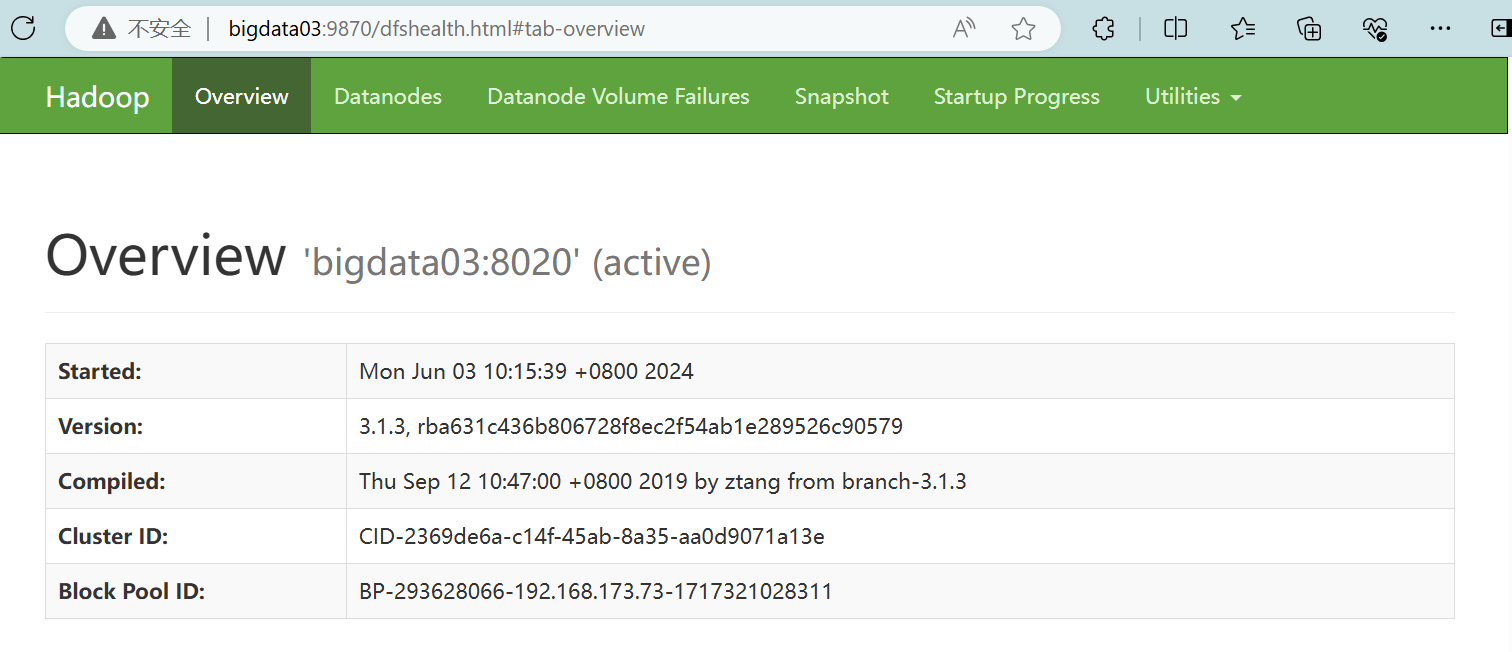
(4)在Windows的浏览器中访问http://bigdata03:9870
2、访问yarn的Web服务

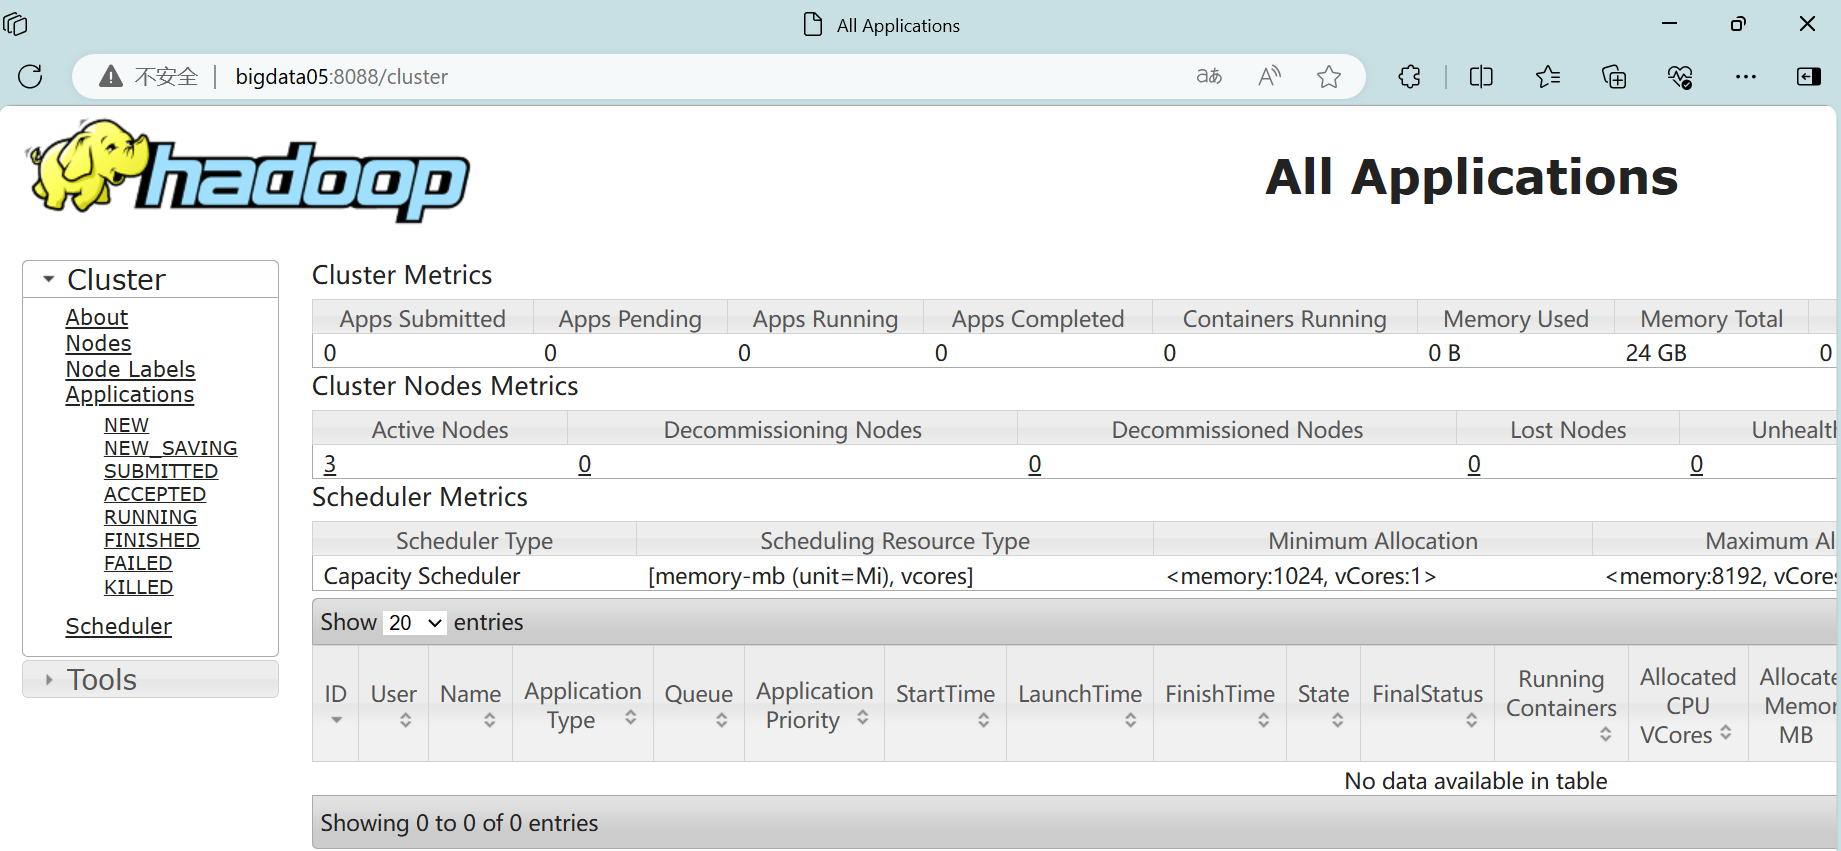
前面已经配置过了映射关系,可在Windows里直接访问http://bigdata05:8080
3、访问任务历史服务的Web服务

在ResourceManager节点上查看web网址

复制代码
cd /opt/softs/hadoop3.1.3/etc/hadoop
cat yarn-site.xml

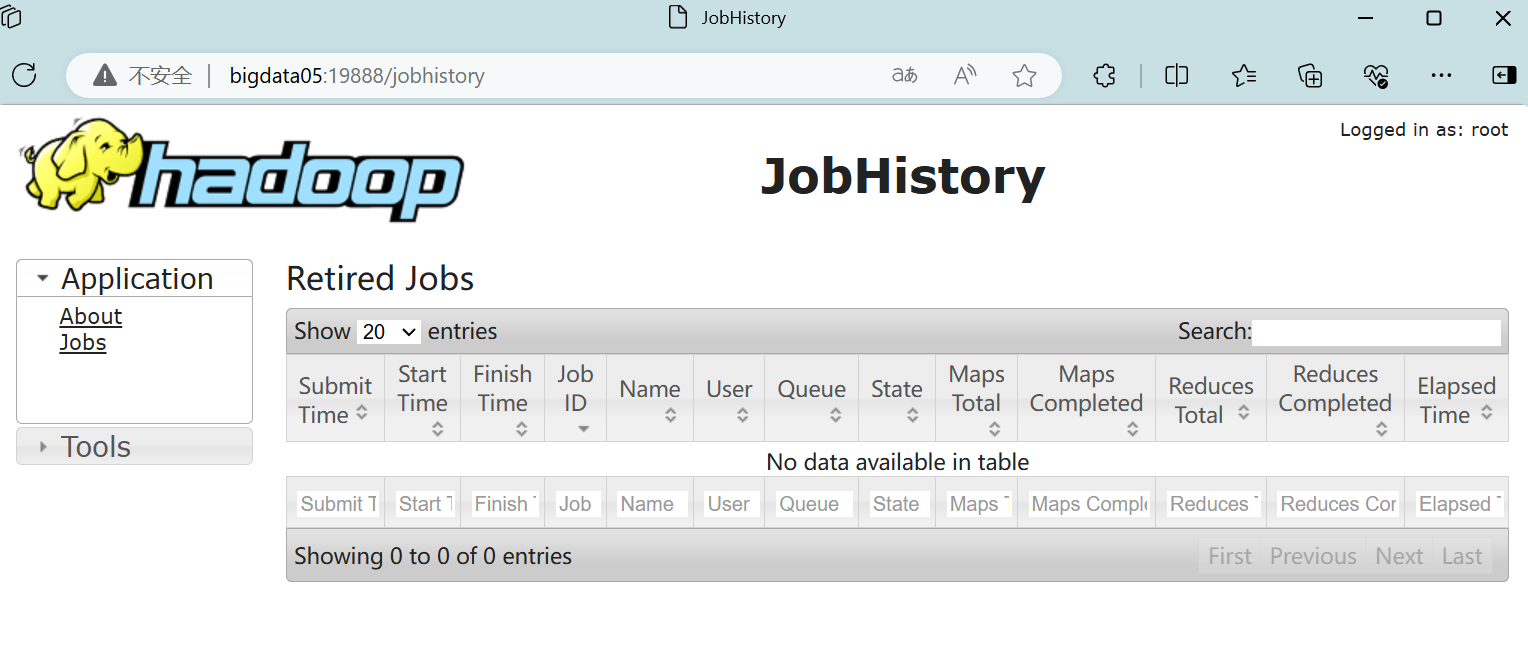
在Windows中访问网址:http://bigdata05:19888/jobhistory
相关推荐
数字融合15 分钟前
透明化视频驱动化工生产动态三维重建管控技术
大数据·人工智能·python
演艺大赏1 小时前
两个 NameNode 一起起不来以及Hadoop 3.3.2 里那个认不出自家 JournalNode 的 Servlet
大数据·hadoop
知行产研1 小时前
会感知、能协同,金科【钻孔】智能化路线 | bauma CHINA 2026
大数据·人工智能
演艺大赏2 小时前
RESTServer 起不来,日志只有一行:headerCacheSize 65536 exceeds maximum value of 65534
大数据·hadoop·hbase
时间的拾荒人2 小时前
Redis 典型应用:缓存与分布式锁原理
redis·分布式·缓存·面试·架构
Databend2 小时前
活动邀请函|AI 时代的湖仓实践,从应用场景到 Cloud Agent 上手
大数据·数据库·agent
数字新视界19 小时前
数据中心DCIM管理系统助力提升机房管理效率与安全性
大数据·人工智能·物联网·信息与通信·动环监控系统
阿里云大数据AI技术19 小时前
孩子王基于阿里云Data Agent的智能体实践:300+Agent 覆盖400+业务场景
大数据·人工智能·agent
武子康21 小时前
H3-World 扩展跳跃与开门:新动作怎样进入训练数据?
大数据·人工智能·算法
软件技术NINI1 天前
DeepSeek 大模型落地应用实战指南
大数据·人工智能